MapReduce计算框架:
MapReduce是一个批处理分布式计算框架,其分为两个过程,map和reduce
要理解MapReduce,需要理解函数式编程,MapReduce就是一个高阶函数实现的编程框架。
像Lisp, ML等编程语言,是函数式编程语言,也叫做高阶函数,理解其两个典型函数map和fold:
map, fold 是两个过程,或者说是两个函数,一个叫做映射过程,一个叫做折叠过程。
map : map(f())
接受一个函数为参数,并将其应用于列表中的所有元素;从而生成一个结果列表;
"Ou Yangfeng", "Dongfang Bubai", "Saodi Seng", "Dugu Qiubai"
fold: fold(g(), init)
接受两个参数:函数,初始值
"Hamo Gong", "Kuihua Baodian", "Yijin jing", "Dugu Jiujian"
second third
MapReduce:也分为两个过程
mapper, reducer两个过程,就是map task任务过程和reduce task任务过程
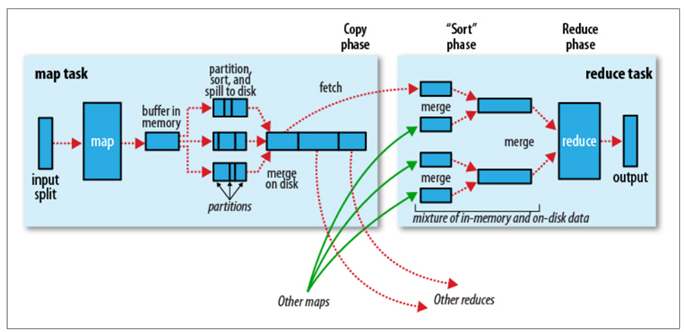
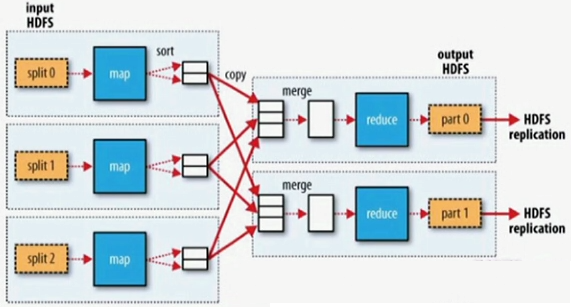
map过程,即Map(映射)函数,用来把一组键值对映射成一组新的键值对,map task也分为多个子过程,首先是读入分片信息,这个过程,需要一个计算,就是把保存在HDFS中的文件进行分片(一般就是按HDFS的shard大小,当然也可以不同),这个就是上图中的input split过程。分片后,每个分片会启动一个map task任务(2.0中,应该是一个map Container),map会把分片中的内容进行划分,形成键值对的集合,一般都是以词频统计为例子,就是对一个大的文件中出现的词,即word进行统计,看看其出现的次数。map的过程,就是把分片中的内容按照一定的规则,将其中的词分拆开,拆开的过程形成一组键值对,经过map,形成新的键值对,一般是词为key,次数为value,如"hello:1","world:1"这种形式,形成新的键值对集合后,又对这个集合进行分区、排序、合并,然后按照不同的key,发送给不同的reduce过程,这个分区、排序、合并的过程,被称为shuffle过程(shuffle,有洗牌,打乱次序,变换位置的意思)。shuffle的结果称为中间结果。
reduce过程,对中间结果中相同"键"的所有"值"进行规约,以得到最终结果,用来保证所有映射的键值对中的每一个共享相同的键组。
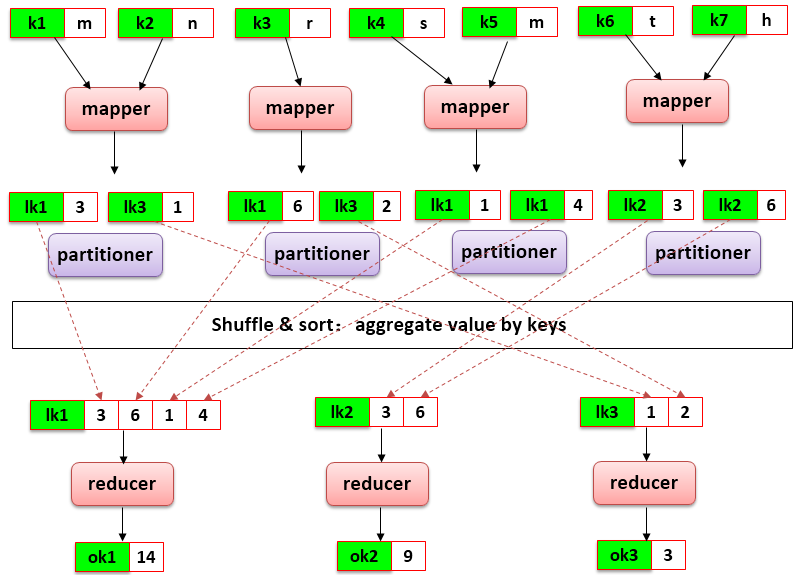
partitioner负责实现哪些key发送给哪个reducer。mapper过程中,输入输出的键可以不同,reducer过程的输入输出键可以不同,但是partitioner过程键不变的。
mapper的中间结果出来之后,还可以加一个环节,对中间结果做一次合并,增加combiner:
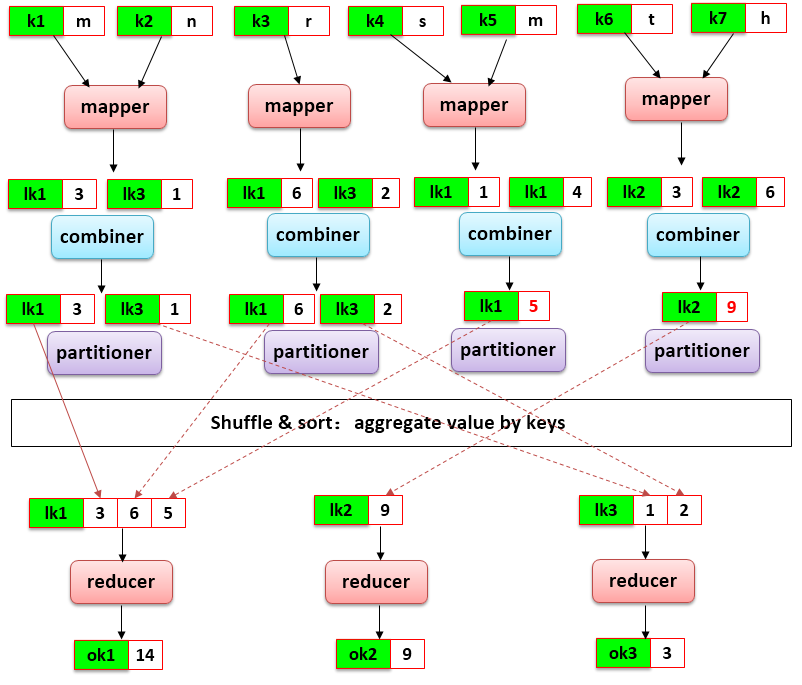
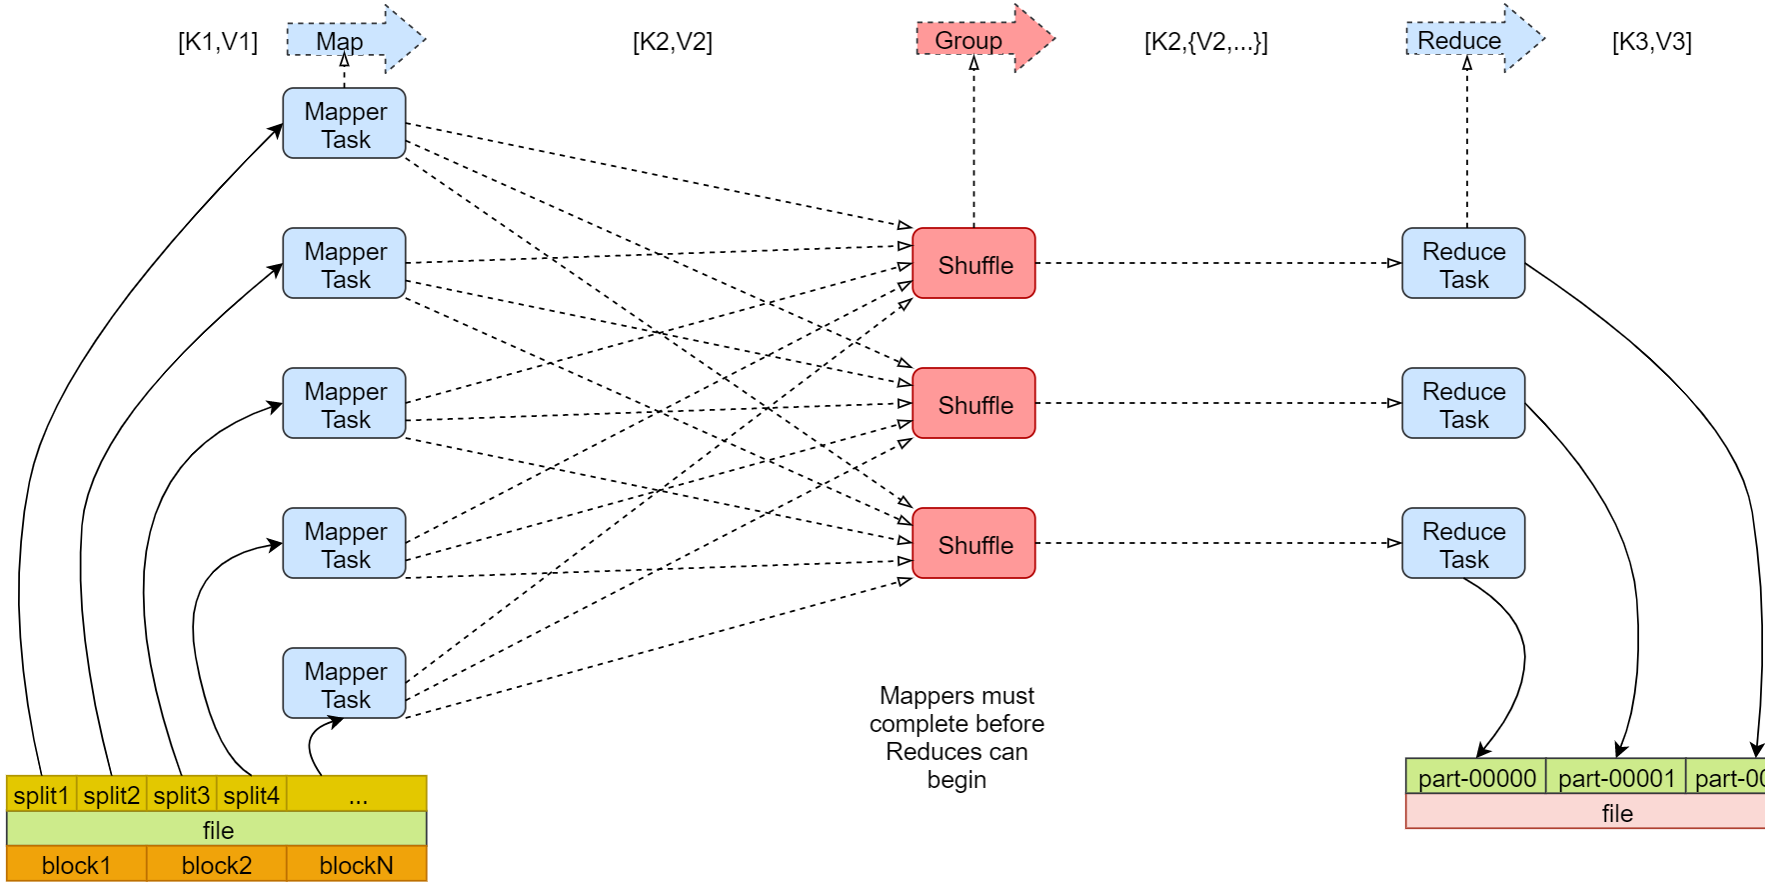
整体流程可以大致分为三个阶段:Map、Shuffle、Reduce,但实际上在进入三个阶段前,还有一个数据分片阶段,因此可以将整体流程分为以下四个步骤:
1、输入数据分片:将数据分割成多个逻辑块,每个块被一个 Mapper 处理。
2、Map 阶段:处理输入数据,将其转化为键值对 (key, value)。
3、Shuffle 阶段:对 Map 阶段的输出进行分区、排序和分组。
4、Reduce 阶段:对同一键的所有值进行聚合或计算,最终输出结果。
对三个阶段的再一次描述:
Map 阶段 : 将输入数据转化为中间键值对 (key, value) 的形式。
工作原理 : 输入格式:Hadoop 的 InputFormat(默认是 TextInputFormat)将原始数据分割成逻辑记录,传递给 Mapper。
1、每个逻辑块由一个 Mapper 处理,读取输入数据并生成中间结果。
2、用户需实现 map() 方法,定义如何将输入转化为中间 (key, value) 对。
示例: 输入数据:
hello hadoop
hello world
输出数据
(hello, 1), (hadoop, 1), (hello, 1), (world, 1)
Shuffle 阶段 : 将 Map 阶段的中间结果组织为 Reducer 可用的形式,包括分区、排序和分组。
是介于 Map 和 Reduce 之间的一个过程,可以分为 Map 端的 shuffle 和 Reduce 端的 Shuffle。具体步骤:
分区(Partition) : 根据分区函数(默认是哈希函数 hash(key) % num_reducers)将中间键值对分配到不同的 Reducer。 相同键值对会被发送到同一个 Reducer。
排序(Sort) : 对中间键值对按键进行全局排序。
排序可以在 Mapper 端局部排序,也可以在 Reducer 端进行全局合并排序。
分组(Combine 和 Grouping) :
在 Reducer 端,具有相同键的所有值被合并为一个列表。
可选地使用 Combiner 函数在 Mapper 端预聚合中间结果,以减少网络传输量。
示例 :
输入数据:
(hello, 1), (hadoop, 1), (hello, 1), (world, 1)
输出数据:
Reducer 1: (hadoop, 1)
Reducer 2: (hello, 1, 1), (world, 1)
注意:Shuffle 阶段可能成为性能瓶颈,因为涉及大量数据的网络传输和排序操作。
Reduce 阶段 : 对 Shuffle 阶段分组后的中间结果进行聚合或计算,输出最终结果。
工作原理 :
1、输入:<key, list(values)>,即每个键和其对应的值列表。
2、用户需实现 reduce() 方法,定义如何对同一键的所有值进行处理。
示例 输入数据:
(hadoop, 1)
(hello, 1, 1)
(world, 1)
输出数据
(hadoop, 1)
(hello, 2)
(world, 1)
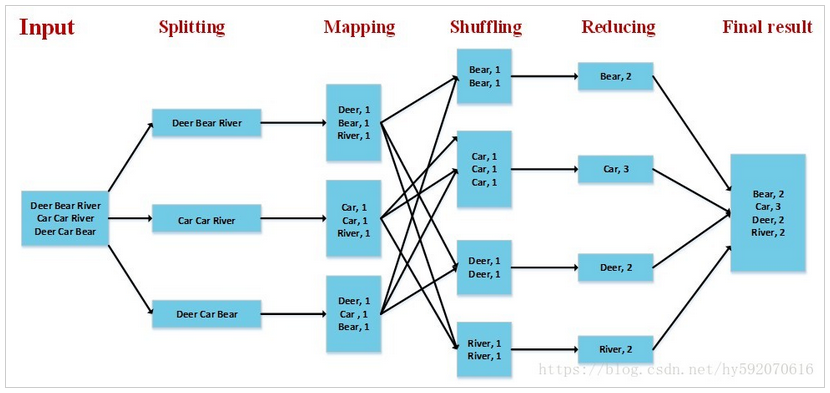
一个词频统计的过程图:
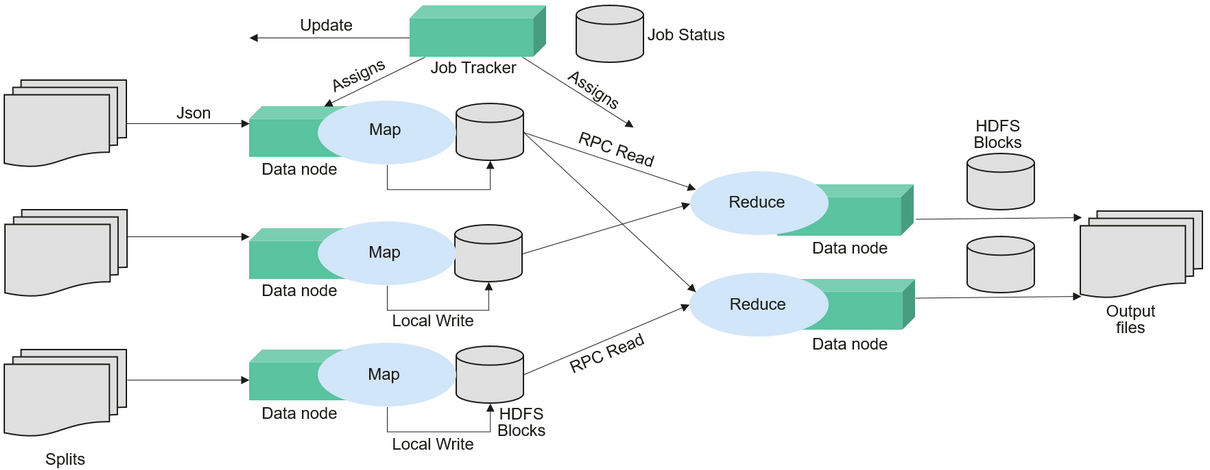
MapReduce是一个分布式批处理大数据框架,本身是一个计算集群,其又是构建于HDFS集群之上,是两个集群的集合:
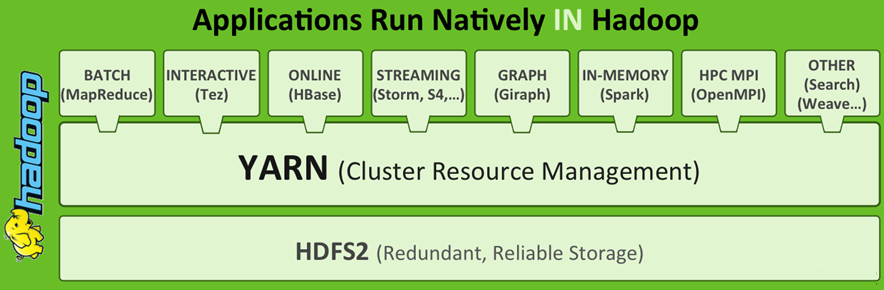
Hadoop生态系统:
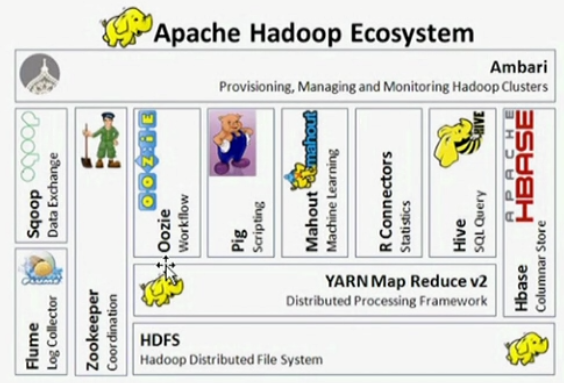
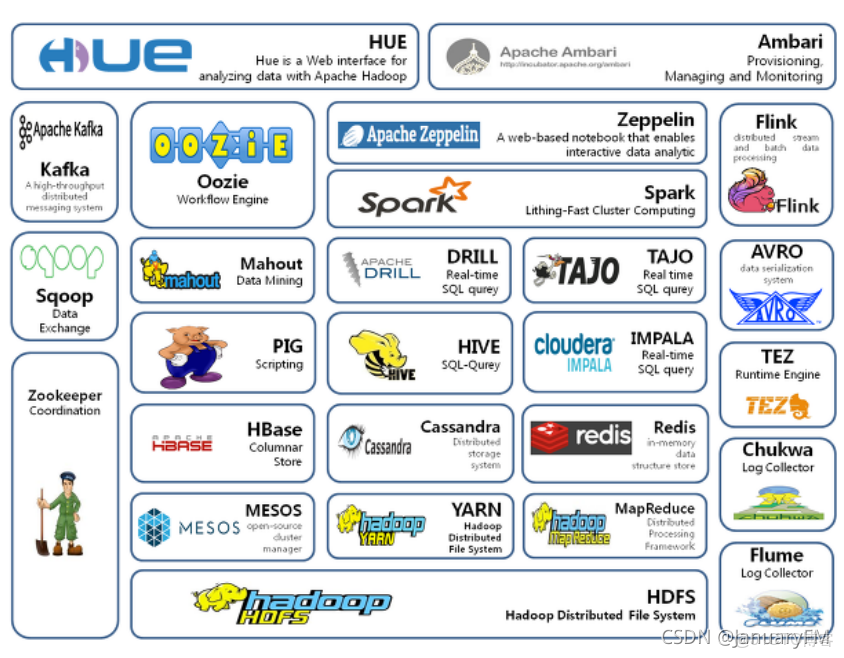
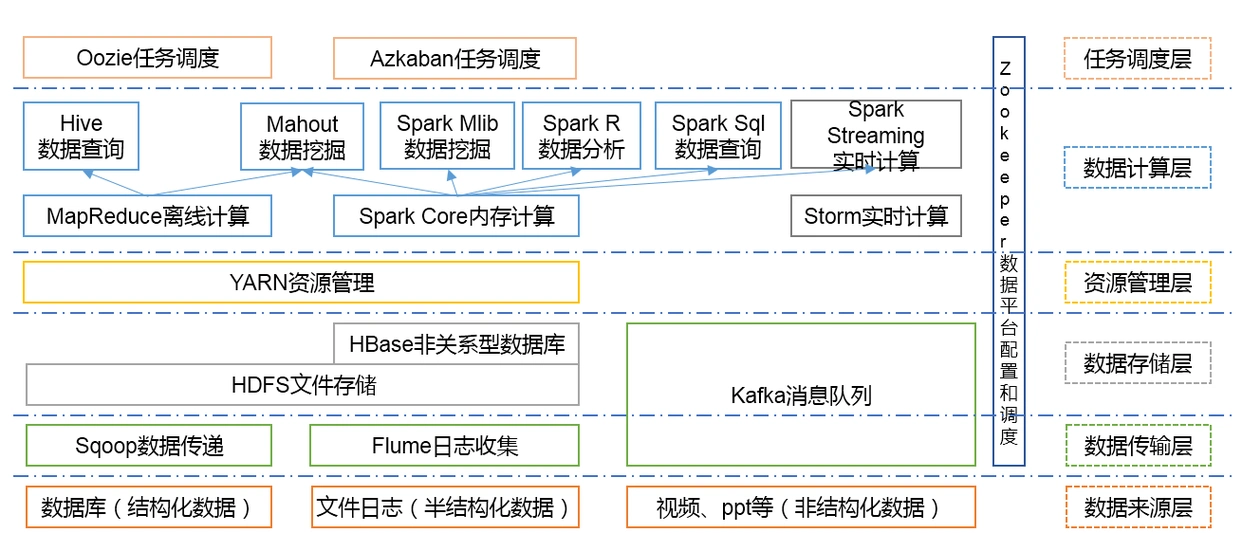
MapReduce是一个计算框架,map过程、reduce过程及中间过程是需要写代码完成的,也就是来一个需求,就要编写相应的程序,效率比较低,于是,便有了在MapReduce之上的扩展,借助MapReduce,提供一个便于使用的交互接口,降低使用难度,提高效率,也有是针对其他需求进行的扩展,如需要实时处理、流处理等。
下面是Hadoop生态系统的几个图示:
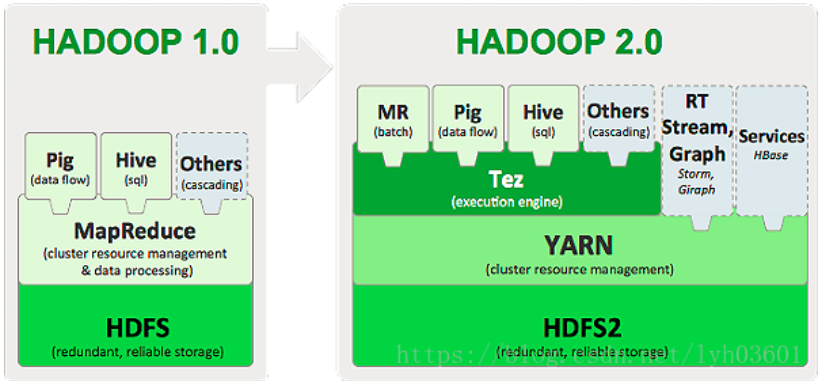
Tez:是构建在YARN之上的数据处理框架,核心在于用有向无环图(DAG ------ Directed Acyclic Graph)替代MapReduce的多阶段串行模型,将Map和Reduce两个操作进一步拆分,分解后的元操作可以任意灵活组合,产生新的操作,这些操作经过一些控制程序组装后,可形成一个大的DAG作业。大幅减少中间结果落盘HDFS的开销,提高执行效率,传统的MapReduce、Hive、Pig等可以构建于Tez上,加速执行,能显著缩短查询响应时间。所以,Tez又称为Runtime Engine或Execution Engine,执行引擎。
Tez在Hadoop生态系统中的位置:
Hive:是构建在 Hadoop 生态之上的开源分布式数据仓库工具,它通过类 SQL 的 HiveQL 接口,将海量结构化数据的分析任务自动转换为分布式计算作业,让熟悉 SQL 的用户无需编写复杂的 MapReduce 代码,就能高效处理 PB 级别的离线数据集。也就是减少编程,给熟悉SQL的用户提供快速上手的一个工具。Hive本身不存储数据,只负责管理元数据并把SQL翻译成计算任务。
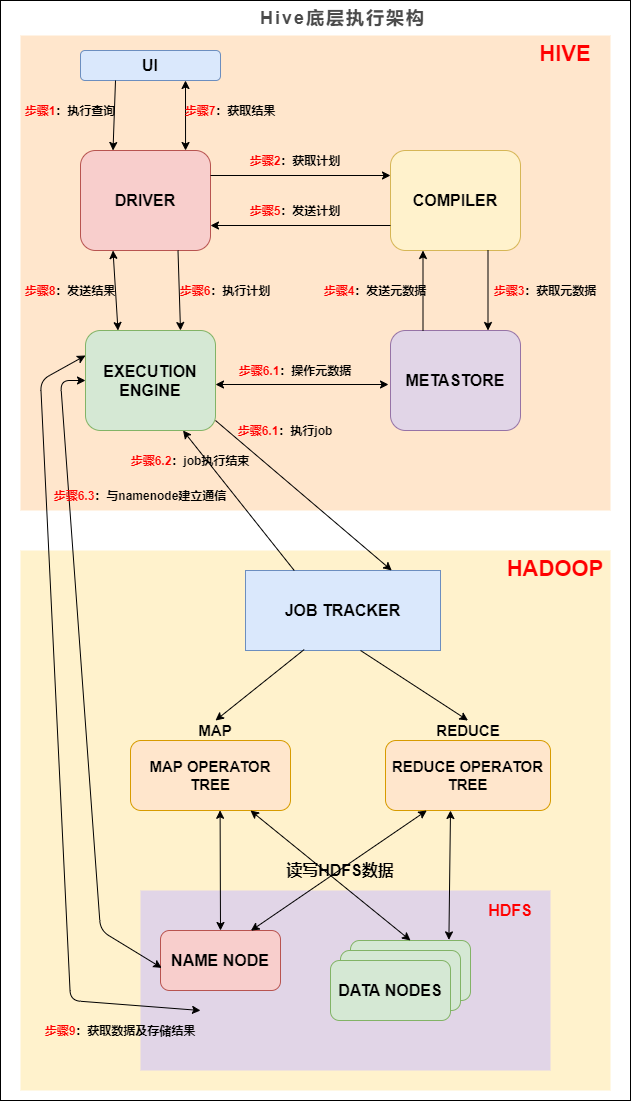
Hive的执行框架图:
核心架构与关键组件
Hive 的架构完全解耦了元数据管理、查询编译和执行调度,核心组件分为 5 部分:
1)Driver 驱动模块:接收用户提交的 HiveQL 请求,全程管控查询的解析、优化、执行和结果返回全流程。
2)Compiler 编译器:将 HiveQL 语句经过多轮处理,生成可在分布式引擎上运行的执行计划。
3)Metastore 元数据存储:独立的元数据服务,通常搭配 MySQL、TiDB 等关系型数据库,存储表结构、分区信息、数据存储路径等元数据,和实际业务数据完全分离。
4)Execution Engine 执行引擎:默认将执行计划转换为 MapReduce 任务,同时支持 Tez、Spark 作为替代执行引擎,大幅提升查询性能。
5)CLI/JDBC 客户端:提供命令行、JDBC/ODBC 接口,支持和 Tableau、Power BI 等 BI 工具无缝对接。
HiveQL 完整执行流程
一条 HiveQL 从提交到返回结果,会经过 7 个标准化处理阶段:
1)词法语法解析:通过 Antlr 解析 SQL 语句,生成抽象语法树 AST Tree,校验语句语法合法性。
2)语义解析:遍历语法树,校验表名、字段名是否存在,提取查询核心信息生成 QueryBlock 查询块。
3)生成逻辑执行计划:将查询块转换为 OperatorTree 操作树,明确数据扫描、过滤、聚合等操作的执行顺序。
4)逻辑层优化:自动执行谓词下推、列裁剪等优化,将过滤条件下推到数据源侧,只读取查询需要的字段,大幅减少后续处理的数据量。
5)生成物理执行计划:将优化后的逻辑操作树,转换为对应执行引擎的分布式任务(MapReduce/Tez/Spark)。
6)物理层优化:自动触发 MapJoin、分区裁剪等优化,大表关联小表时直接将小表加载到内存,跳过 Shuffle 和 Reduce 阶段;分区表查询时自动跳过无关分区,避免全表扫描。
7)任务提交执行:将最终生成的分布式作业提交到 YARN 集群调度运行,执行完成后将结果返回给用户。
Pig:是构建在 Hadoop 生态之上的开源大规模数据分析平台,它通过面向数据流的高级脚本语言 Pig Latin,将用户编写的数据处理逻辑自动转换为可在 Hadoop 集群上运行的 MapReduce 或 Tez DAG 作业,让开发者无需编写复杂的 Java MapReduce 代码,就能高效完成海量数据集的 ETL(Extract-抽取,Transform-转换,Load-加载) 转换与分析工作。pig主要使用类似shell的脚本语言来开发应用。与 Hive 同属 Hadoop上层的计算抽象层,但设计思路完全不同:
-
Hive 面向熟悉 SQL 的数据分析人员,以关系代数和声明式查询为核心。
-
Pig 面向程序员和数据工程师,以数据流管道式处理为核心,更适合灵活的 ETL 流水线开发
它天然兼容 HDFS、HBase 等 Hadoop 生态存储组件,支持结构化、半结构化甚至非结构化数据的处理,在日志分析、数据清洗、特征工程等场景中被广泛使用。
Hbase:是 Hadoop 生态中面向海量结构化数据的分布式 NoSQL 列存数据库,Google BigTable 的开源实现,依托 HDFS 提供分布式持久化存储,支持 PB 级数据的毫秒级随机实时读写,是大数据场景下高吞吐低延迟在线服务层的核心组件。核心数据模型是多维稀疏排序Map,列式存储,以列族为存储单位。
分布式核心架构 ------ HBase 采用完全去中心化的主从架构,核心组件各司其职,通过 ZooKeeper 实现分布式协同:
1)HMaster(集群主控节点)
作为集群的"大脑",负责元数据管理、表结构DDL操作、Region 分配与故障转移、全集群负载均衡。最新版本支持多活部署,解决单点故障问题 。
2)RegionServer(数据服务节点)
实际承载数据读写服务的工作节点,每个节点可管理数十个数据分片 Region。内部通过 MemStore(内存写缓存)、BlockCache(读缓存)和持久化 HFile 三层结构,实现高吞吐的读写性能,单节点可支撑每秒数十万级的读写请求 。
3)ZooKeeper(分布式协调中枢)
维护集群节点状态、活跃 HMaster 选举结果、元数据表入口位置,提供分布式锁服务,所有节点的心跳检测和故障感知都依赖它完成 。
4)HDFS(底层持久化存储)
所有数据最终以 HFile 格式持久化存储在 HDFS 上,依托 HDFS 的三副本机制保证数据不丢失,实现存算分离的架构设计 。
核心运行机制 :
1)数据分片与自动负载均衡
表中的数据按 RowKey 字典序排序,自动切分为多个 10GB 左右的 Region 分片,均匀分布在所有 RegionServer 节点上。当单个 Region 超过大小阈值时会自动在线分裂,完全无需人工干预,HMaster 会持续监控集群负载,自动迁移热点 Region 实现资源均衡 。
2)写入流程
客户端先通过 ZooKeeper 定位目标 Region 所在节点,写入操作先追加到 WAL 预写日志保证数据不丢,再写入内存中的 MemStore,当 MemStore 达到阈值后,后台线程自动将其刷写到 HDFS 生成持久化的 StoreFile,全程无随机磁盘IO,写入性能极高 。
3)读取流程
优先查询 BlockCache 读缓存,未命中则查询 MemStore,最后通过布隆过滤器快速过滤无关的磁盘 HFile,仅读取目标数据所在的物理块,热点数据的访问延迟可稳定控制在毫秒级 。
ZooKeeper:是 Hadoop 生态中核心的分布式协调服务,被称为分布式系统的"中枢神经",专门解决分布式场景下的一致性难题,为 Hadoop、HBase、Kafka、Dubbo 等各类分布式组件提供统一的协同能力,是Google Chubby的Java开源实现,是高可用的和可靠的分布式协同(coordination)系统,提供分布式锁之类的基本服务,用于构建分布式应用。
ZooKeeper 本质是一个轻量级的分布式内存数据库,以 CP 架构(强一致性+分区容错性)为核心设计目标,不适合存储海量业务数据,专门用于存放分布式系统的关键元数据和状态信息:
全局强一致性 :所有客户端看到的数据视图完全一致,无论连接集群中哪个节点,读取到的都是同一份最新数据。
高可用性 :基于 Quorum 过半存活机制,集群只要超过半数节点正常运行,就能对外提供稳定服务。
顺序性保证 :所有更新操作都被分配全局唯一的递增事务 ID,严格按照操作先后顺序执行。
Watch 事件机制 :支持客户端对指定节点注册监听,节点数据发生变化时主动向客户端推送事件通知,无需轮询检测。
通过上面的Hadoop生态系统图,其各个模块大都是以动物图标表示,ZooKeeper这个动物园管理者正是管理协调它们的关系,很形象。
分布式系统CAP理论:C(Consistency)一致性,A(Availability)可用性,P(Partition tolerance)分区容错性,是分布式系统设计中三个无法同时完全满足的核心特性,三者最多只能同时实现两点,不可能三者兼顾 。一般只能在CP和AP之间做取舍:
CP 架构 :优先保证强一致性,网络分区发生时宁可暂停部分服务,也绝不返回不一致的错误数据,典型代表是 ZooKeeper、HBase 这类对数据准确性要求极高的系统 。
AP 架构:优先保证服务持续可用,网络分区发生时允许短暂返回旧数据,待网络恢复后通过异步同步实现数据最终一致,典型代表是电商商品浏览、社交媒体点赞这类允许数据短暂不一致的场景 。
Spark:是专为大规模数据处理设计的统一分布式分析引擎,是一个内存计算架构,性能强劲,是大数据生态中应用最广泛的通用计算引擎。诞生于加州大学伯克利分校的 AMPLab 实验室,核心设计目标是解决 MapReduce 多轮计算中间结果落盘导致的性能瓶颈:
-
基于内存计算模型,中间计算结果直接保存在集群内存中,避免大量磁盘IO开销。
-
统一的编程范式,一套引擎同时支持批处理、SQL查询、流处理、机器学习、图计算等多种场景。
-
提供 Scala、Java、Python 多语言高级API,开发者可以快速上手编写分布式处理逻辑,大幅降低开发门槛。
核心架构与运行机制------Spark 采用经典的主从分布式架构,核心组件分工明确,可对接多种集群资源管理器:
Driver 驱动进程 :运行用户程序的主入口,创建 SparkContext 负责作业调度、DAG 生成和任务分发,协调整个作业的执行流程。
Executor 执行进程 :运行在集群工作节点上,负责执行 Driver 分配的具体计算任务,提供内存存储能力,支持数据缓存。
集群资源管理器 :支持对接 Hadoop YARN、Apache Mesos 或 Spark 自带的独立集群管理器,自动分配集群计算资源。
核心调度机制 :基于 DAG 有向无环图调度引擎,自动将作业拆分为多个阶段,通过 RDD(弹性分布式数据集)的血缘关系实现高效容错,任务失败时无需全量重跑,仅需回溯丢失的分片重新计算。
五大核心组件栈 ------Spark 生态提供了一套完整的上层工具集,覆盖几乎所有大数据处理场景: Spark Core :引擎底层核心,提供RDD抽象、任务调度、内存管理等基础能力,是所有上层组件的运行基础.
Spark SQL :支持标准ANSI SQL接口,可直接处理Hive表、Parquet、JSON等多种数据源,性能远超传统Hive MapReduce引擎.
Structured Streaming :基于Spark SQL构建的流处理引擎,支持事件时间语义和 Exactly-Once 一致性,将流数据当作无限增长的表来处理,实现流批一体.
MLlib :分布式机器学习库,提供分类、回归、聚类、推荐等上百种常用算法的分布式实现,支持大规模数据集的模型训练.
GraphX :分布式图计算框架,提供Pregel-like图处理接口,支持社交网络分析、路径计算等复杂图场景。
Spark可直接读取HDFS、HBase等存储系统的数据,依托YARN实现资源调度,是当前大数据平台中承上启下的核心通用计算引擎。
Mahout:是Apache的开源大规模数据挖掘和分布式机器学习算法库,专为大数据场景设计,提供聚类、分类、协同过滤等经典机器学习算法的可扩展实现,帮助开发者快速构建高性能智能应用,是Hadoop生态中机器学习领域的核心组件。
Mahout 在北印度语中意为"驱象人",对应Hadoop的大象,寓意驾驭大数据集群完成机器学习任务。
Storm:是Hadoop生态中最早成熟的分布式实时计算系统,专为无界流式数据的毫秒级处理设计,解决了传统MapReduce批处理无法满足低延迟场景的痛点,是实时计算领域的里程碑式产品。完全面向流式数据处理场景,和批处理引擎形成明确互补: 极致低延迟、原生高可靠、分布式无状态、多语言兼容。
Storm 采用主从架构,完全依托ZooKeeper实现分布式协同,核心组件分工清晰:
Nimbus 主控节点 :集群的"大脑",负责任务提交、资源分配、作业监控和故障调度。它本身是无状态设计,宕机后正在运行的实时作业完全不会中断,仅影响新任务的提交,不会引发业务雪崩。
Supervisor 工作节点 :实际承载计算任务的从节点,根据Nimbus分配的资源启动和管理Worker进程,通过配置supervisor.slots.ports定义可用计算槽位,每个槽位对应一个独立的Worker进程。
ZooKeeper 协调中枢 :仅存储集群元数据、任务分配状态和节点心跳信息,不参与实际数据传输,保证集群状态的强一致性,是Nimbus和Supervisor之间的协同桥梁。
分层执行模型 :作业提交后,每个Topology会拆分为多个Worker进程,每个Worker内部启动多个Executor线程,每个线程可运行多个Spout/Bolt Task,实现细粒度的资源隔离和并行度控制。
Storm 作为第一代实时计算引擎,目前主流场景逐步被Flink替代。
Flink:是当前大数据生态中最主流的分布式有状态流处理引擎,专为无界实时数据流的高性能、高可靠处理设计,凭借流批一体架构和毫秒级低延迟能力,成为实时计算领域的事实工业标准。采用主从分布式架构,核心设计理念是流是第一性的,批是流的特例:
-
以原生流处理为核心,将批处理作为有界流的特殊场景实现,彻底打破了传统流批引擎分离的架构壁垒。
-
基于内存计算架构,同时实现毫秒级低延迟和每秒百万级高吞吐,性能远超Storm和Spark Streaming。
-
内置完整的Exactly-Once状态一致性保障,从底层机制上保证数据处理不丢不重,满足金融等强合规场景要求。
Sqoop:是Hadoop生态中专门用于关系型数据库与大数据平台之间批量数据传输的开源工具,全称为 SQL-to-Hadoop,是离线数仓建设中打通传统业务系统与大数据集群的核心数据桥梁。
-
完全基于MapReduce引擎实现数据传输,天然依托YARN集群的并行计算能力,支持TB级数据的高速迁移。
-
自动处理数据类型映射,保证关系型数据库与Hive/HDFS之间的数据类型安全转换,无需手动编写复杂的分布式传输代码。
Sqoop 本质是封装了MapReduce的JDBC数据迁移工具,整个传输流程完全没有Reduce阶段,所有数据处理都在Map端并行完成。
核心功能与关键特性:
双向数据传输 :支持从MySQL、Oracle、PostgreSQL等主流关系型数据库导入数据到HDFS、Hive、HBase,也支持将Hive/HDFS中的聚合结果导出回关系型数据库,供业务系统直接查询使用。
增量同步能力 :支持基于自增ID或时间戳的增量导入,仅同步上次传输后新增/变更的记录,大幅减少每日全量同步的资源开销,是离线数仓ODS层每日数据接入的标准方案。
Hive深度集成 :支持自动将源表的表结构转换为Hive表结构,直接创建Hive外部表并完成数据导入,无需手动编写建表语句,自动适配Hive的默认分隔符和空值处理规则。
自动化调度适配 :提供完整的命令行接口,可无缝对接Oozie、Airflow等大数据调度系统,实现每日定时自动同步,无需人工干预。
高性能直连模式:支持绕过标准JDBC,直接调用数据库原生的批量加载工具(如MySQL的mysqldump),进一步提升超大规模数据的传输速度。
Flume:是 Hadoop 生态中分布式、高可靠的海量日志采集、聚合与传输系统,专门负责将分散在各业务服务器上的海量日志数据,高效、稳定地汇聚到大数据平台的各类存储与计算组件中,是大数据采集层的核心基础设施。是大数据世界的"日志物流系统",专为流式日志数据的端到端传输设计,类似前面学习过的Logstash。
Kafka:是 Hadoop 生态中分布式高吞吐事件流平台,专为海量实时数据流的发布、订阅、持久化存储和流式处理设计,核心定位是高吞吐、可持久化的分布式消息队列,是当前大数据生态中实时数据传输层的事实工业标准。Kafka 最初为解决 LinkedIn 海量日志实时传输问题而设计,如今已从单一消息队列演进为完整的分布式事件流平台。Kafka 采用完全去中心化的分布式集群架构,依托 ZooKeeper(新版本已支持 KRaft 无 ZooKeeper 模式)实现集群元数据协同。
典型适用场景:
- 实时数据管道枢纽:作为 Flume 采集层和 Flink 实时计算层之间的缓冲层,承接全量日志、业务事件等海量数据流,削峰填谷,避免下游计算系统被突发流量打垮。
- 实时数仓数据接入:所有业务系统的实时变更数据通过 CDC 工具同步到 Kafka,作为实时数仓的统一数据源,支撑后续秒级指标计算。
- 系统解耦异步通信:微服务架构中不同业务系统之间通过 Kafka 异步传递事件,实现系统之间的完全解耦,避免一个系统故障引发全链路雪崩。
- 日志汇聚传输:将分布在数百台业务服务器上的访问日志、运行日志统一汇聚到 Kafka,后续供离线数仓和实时监控系统同时消费。
- 事件溯源与日志审计:所有业务操作事件全部写入 Kafka 持久化存储,作为不可篡改的操作日志,支撑全链路数据审计和故障回溯。
Cassandra:是一款无主架构的分布式开源NoSQL数据库,融合了HBase的宽列数据模型与Amazon Dynamo的去中心化架构设计,凭借极致的线性扩展能力和跨多活数据中心的高可用特性,成为全球互联网、金融行业承载核心 mission-critical 数据的主流分布式存储方案。以高可用、线性扩展和写入性能著称。核心设计目标是解决超大规模分布式场景下的无单点故障问题:
完全无主(Masterless)架构,集群中没有任何中心化管控节点,所有节点完全对等,不存在单点故障风险。
线性水平扩展能力,新增节点无需重启集群,性能随节点数量同步线性提升,单集群可轻松承载PB级数据。
原生跨多数据中心复制能力,是业界多活容灾能力最顶尖的分布式数据库,可容忍整个数据中心完全宕机且不丢失任何数据。
基于普通x86商用硬件即可部署,无需专用高端存储设备,大幅降低超大规模集群的建设成本。
Cassandra适合写入密集型、多数据中心、高可用要求场景。
Oozie:是 Hadoop 生态中专门用于大数据作业编排的分布式工作流调度引擎,完全基于有向无环图(DAG)定义作业执行逻辑,是传统离线数仓场景下最普及的定时任务调度系统,负责串联Hive、Spark、MapReduce等各类大数据作业,实现全链路ETL流水线的自动化运行。Hadoop生态原生的调度系统,专为大数据集群的作业调度场景量身打造。
三层调度架构体系 ------ Oozie 采用分层递进的调度模型,从基础作业流到全局批量管控,形成完整的调度能力体系:
Workflow 基础工作流层 :最核心的基础单元,通过workflow.xml定义单个业务的完整作业执行DAG,支持Start、Action、Kill、End等标准节点,可实现作业的串行、并行、分支选择等复杂编排逻辑,描述一个完整的ETL业务流程.
Coordinator 定时触发层 :构建在Workflow之上,通过coordinator.xml实现工作流的定时调度、数据可用性触发,支持按固定时间周期(每日/每小时)自动触发作业,也可监控HDFS指定路径下的文件是否生成,数据就绪后自动触发后续作业执行,是离线数仓每日定时跑批的核心能力。
Bundle 全局管控层:构建在Coordinator之上,提供对多个Coordinator调度任务的统一批量管理,支持一次性启动、停止、暂停数十上百个关联的定时作业,大幅降低大规模数仓场景下的调度运维成本。
Ambari: 是 Hadoop 生态中企业级一站式集群部署、管理与监控平台,通过可视化Web界面和RESTful API,彻底解决了传统Hadoop集群手动部署复杂、运维难度高的痛点,是大数据集群运维领域的事实工业标准。Hadoop生态系统中存在如此众多的子系统,手工单个安装与部署肯定要麻烦的很,Abmari就是解决这些子系统、子模块的安装部署问题,类似一键安装功能。