ForkJoinPool内部WorkQueue的Lock-Free数组操作以及并发任务窃取原理剖析
- 前言
- WorkQueue的Lock-Free数组操作以及并发任务窃取原理
-
- [一、 WorkQueue 数据结构与 Cache Line 内存拓扑](#一、 WorkQueue 数据结构与 Cache Line 内存拓扑)
-
- [JDK 源码级数据结构与对齐声明 (`java/util/concurrent/ForkJoinPool.java`)](#JDK 源码级数据结构与对齐声明 (
java/util/concurrent/ForkJoinPool.java))
- [JDK 源码级数据结构与对齐声明 (`java/util/concurrent/ForkJoinPool.java`)](#JDK 源码级数据结构与对齐声明 (
- [二、 所有者线程 LIFO 压栈 (`push`) 算法与 Store 内存屏障](#二、 所有者线程 LIFO 压栈 (
push) 算法与 Store 内存屏障) -
- 压栈算法核心逻辑
- [OpenJDK 源码深度逐行解析 (`push`)](#OpenJDK 源码深度逐行解析 (
push))
- [三、 所有者线程 LIFO 出栈 (`pop`) 与临界竞争握手协议](#三、 所有者线程 LIFO 出栈 (
pop) 与临界竞争握手协议) -
- 临界竞争握手协议 (Boundary Handshake Protocol)
- [OpenJDK 源码深度逐行解析 (`pop` & `popSlow`)](#OpenJDK 源码深度逐行解析 (
pop&popSlow))
- [四、 窃取者线程 FIFO 并发窃取 (`poll`) 算法](#四、 窃取者线程 FIFO 并发窃取 (
poll) 算法) -
- 窃取算法流程图与状态机
- [OpenJDK 源码深度逐行解析 (`poll`)](#OpenJDK 源码深度逐行解析 (
poll))
- [五、 底层 CPU 指令与 C++ 内存模型 (Memory Order) 映射表](#五、 底层 CPU 指令与 C++ 内存模型 (Memory Order) 映射表)
- [六、 交互式 `WorkQueue` 并发压栈/窃取与屏障模拟器](#六、 交互式
WorkQueue并发压栈/窃取与屏障模拟器) - [七、 总结与工程推演](#七、 总结与工程推演)
前言
本文旨在记录近期研读Java源码的学习心得与疑难问题。由于个人理解水平有限,文中内容难免存在疏漏,恳请读者不吝指正。
WorkQueue的Lock-Free数组操作以及并发任务窃取原理
一、 WorkQueue 数据结构与 Cache Line 内存拓扑
在 ForkJoinPool 中,每个工作线程(ForkJoinWorkerThread)都拥有一个私有的 WorkQueue。为了避免伪共享(False Sharing)并在无锁(Lock-Free)高并发下维持内存连续性,WorkQueue 在 JVM 堆中采用了极其严密的数据结构与字段对齐设计。
                       [ 窃取端 FIFO: Thief ]
                               [base]
                                 │
                                 ▼
+---+---+---+---+---+---+---+---+---+---+---+---+---+---+---+---+
|   |   | T1| T2| T3| T4| T5|   |   |   |   |   |   |   |   |   |  <- Array (Capacity = 2^N)
+---+---+---+---+---+---+---+---+---+---+---+---+---+---+---+---+
                             ▲
                             │
                          [top]
                   [ 压栈/出栈端 LIFO: Owner ]
JDK 源码级数据结构与对齐声明 (java/util/concurrent/ForkJoinPool.java)
java
// OpenJDK 21+: java.util.concurrent.ForkJoinPool.WorkQueue
// 使用 @jdk.internal.vm.annotation.Contended 消除 L1/L2/L3 Cache Line (64 Bytes) 伪共享
@jdk.internal.vm.annotation.Contended
static final class WorkQueue {

    // ================= 1. 热点竞争变量分区 =================
    // base 指针:窃取者 (Thief) 窃取任务的起始索引。多线程并发读取/修改
    volatile int base;

    // top 指针:Owner 线程压入/弹出任务的栈顶索引。仅单Owner写,多Thief并发读
    int top;

    // 标识当前 Queue 的模式/状态 (如 FIFO_QUEUE, SHARED_QUEUE, 阻塞状态等)
    volatile int source;

    // 在 ForkJoinPool 内部 queues 数组中的下标索引
    int mainIndex;

    // ================= 2. 环形数组与引用定义 =================
    // 存储任务引用的环形数组,长度必须为 2 的幂次 (2^N),便于使用 Mask 位运算取模
    ForkJoinTask<?>[] array;

    // 关联的 ForkJoinPool 主控制器实例
    final ForkJoinPool pool;

    // 拥有该 WorkQueue 的工作线程;若为外部提交队列 (Shared Queue),则 owner 为 null
    final ForkJoinWorkerThread owner;

    // ================= 3. VarHandle 句柄(直接映射 JVM 底层 Unsafe 内存屏障)=================
    static final VarHandle QA;   // 数组元素读写句柄 (支持 Acquire/Release/CAS 语义)
    static final VarHandle TOP;  // top 指针句柄
    static final VarHandle BASE; // base 指针句柄

    static {
        try {
            MethodHandles.Lookup l = MethodHandles.lookup();
            // 获取数组 Slot 的 VarHandle,用于直接控制底层内存屏障
            QA = MethodHandles.arrayElementVarHandle(ForkJoinTask[].class);
            TOP = l.findVarHandle(WorkQueue.class, "top", int.class);
            BASE = l.findVarHandle(WorkQueue.class, "base", int.class);
        } catch (ReflectiveOperationException e) {
            throw new ExceptionInInitializerError(e);
        }
    }

    // ... 算法实现细节见下文
}
二、 所有者线程 LIFO 压栈 (push) 算法与 Store 内存屏障
push 操作由 单生产者 (Owner Thread) 独占调用。因为不存在多个 Producer 同时竞争 top 指针的情况,该过程无需 LOCK CMPXCHG(CAS)指令,而是通过 Release 语义屏障 保证内存写入顺序。
压栈算法核心逻辑
-
写任务引用到 Slot :使用
Release语义写入array[top & mask],强制生成StoreStore屏障。 -
递增
top指针 :使用Release或Opaque语义自增top。 -
容量与唤醒判断 :计算当前任务数 d = top − base d = \text{top} - \text{base} d=top−base,触发
signalWork()或growArray()。[Owner 线程] [CPU Store Buffer] [主内存 / L3 Cache]
- Task 对象构造/初始化 ─────────────────────────────────────────────────────────► [Task Payload]
- QA.setRelease(a, index, task) ──(StoreStore Barrier: 防止Task未完全初始化即显现)──► [array[index] = task]
- TOP.setRelease(this, top + 1) ──(Release 屏障: 保证 array 写入对 Thief 绝对可见)─────► [top = top + 1]
OpenJDK 源码深度逐行解析 (push)
java
/**
 * 仅由 WorkQueue 的 Owner 线程调用的压栈操作 (LIFO 顺序)
 *
 * @param task 待压入的 ForkJoinTask
 * @param p 关联的 ForkJoinPool 实例
 */
final void push(ForkJoinTask<?> task, ForkJoinPool p) {
    ForkJoinTask<?>[] a = array;
    int s = top; // 读取当前单线程私有的 top 指针 (无锁)

    if (a != null) {
        int m = a.length - 1; // 2^N - 1 掩码,做快速位运算取模 (等价于 s % a.length)
        int index = m & s;

        /*
         * 【内存屏障要点 1:QA.setRelease】
         * 相当于 C++ std::memory_order_release。
         * 在 x86 架构下,底层生成普通的 mov 指令,但在 CPU 内部阻止 StoreStore 重排序。
         * 保证:Task 对象的内部成员变量初始化(Store)必定先于将该 Task 引用写入数组槽位(Store)。
         * 避免其他 Thief 线程抢到该任务时读取到"未初始化完成半成品"对象。
         */
        QA.setRelease(a, index, task);

        /*
         * 【内存屏障要点 2:TOP.setRelease】
         * 强行刷新 Store Buffer 或保持 StoreStore 屏障。
         * 保证:数组槽位 array[index] 的写入语义,绝对先于 top = s + 1 的写入可见性。
         * Thief 线程一旦以 Acquire 语义读取到新的 top / base 边界,就必定能在 array 中读到非 null 的 task 对象。
         */
        TOP.setRelease(this, s + 1);

        int al = a.length;
        int d = s - base; // 计算压栈后的任务队列深度 (Distance)

        /*
         * 【扩容与唤醒逻辑】
         * 如果 d == 0 说明队列原本为空,此时压入新任务,尝试唤醒阻塞在 Pool 中的 Worker 线程。
         * 如果 d >= al - 1 说明数组装满,触发无锁动态扩容。
         */
        if (d == 0) {
            if (p != null) p.signalWork(); // 触发线程唤醒/创建机制
        } else if (d >= al - 1) {
            growArray(); // 触发环形数组 2 倍扩容并重新排列任务
        }
    }
}
三、 所有者线程 LIFO 出栈 (pop) 与临界竞争握手协议
出栈由 Owner 线程从 top - 1 位置弹出任务。大多数情况下(队列中任务数 d ≥ 2 d \ge 2 d≥2 时),Owner 的 pop 与 Thief 的 poll 操作在数组的两端进行,互不干扰,完全无锁。
然而,当队列中仅剩最后一个任务 (即 s − b = 1 s - b = 1 s−b=1)时,Owner 的 pop 索引与 Thief 的 poll 索引指向同一个 Slot,此时会发生极度临界的并发竞争。
临界竞争握手协议 (Boundary Handshake Protocol)
                     仅剩 1 个任务时的边界状态 (s - b == 1)

                            base        top - 1
                             │             │
                             ▼             ▼
               Array: [ null | Task X | null ]
                                 ▲
                        ┌────────┴────────┐
                        │                 │
                Thief (poll)        Owner (pop)
尝试 CAS base 先预扣除 top- **Owner 预判并先扣除
top**:TOP.setOpaque(this, ns),将top减 1(令 n s = t o p − 1 ns = top - 1 ns=top−1)。 - 屏障判断:
- 无竞争路径 ( n s > b ns > b ns>b):说明队列任务数 ≥ 2 \ge 2 ≥2,Thief 不可能偷到 n s ns ns 位置。Owner 直接提取任务,无需 CAS!
- 临界竞争路径 ( n s = = b ns == b ns==b):说明争抢最后一个任务。Owner 转向慢速路径
popSlow(),通过 CAS 原子清理槽位(QA.compareAndSet(a, j, task, null))。 - 若 CAS 成功:Owner 夺得最后一个任务。
- 若 CAS 失败 :说明该任务已经被并发的 Thief 先一步
poll()抢走,Owner 必须恢复top指针(top = s)并返回null。
OpenJDK 源码深度逐行解析 (pop & popSlow)
java
/**
 * 仅由 WorkQueue 的 Owner 线程调用的出栈操作 (LIFO 顺序)
 *
 * @return 弹出的任务;若队列为空或竞争失败则返回 null
 */
final ForkJoinTask<?> pop() {
    ForkJoinTask<?>[] a = array;
    int b = base, s = top;

    // 快速检查:如果 s == b 说明队列为空,直接返回 null
    if (a != null && b != s) {
        int m = a.length - 1;
        int ns = s - 1; // 预估弹出后的新 top 索引

        /*
         * 【步骤 1:预先扣除 top 指针】
         * 使用 Opaque 或 Release 语义写入 top = ns。
         * 此处的关键意义在于:向所有的 Thief 声明"当前线程准备提取 ns 位置的任务"。
         * 使得 concurrent poll() 读取到的 (top - base) 瞬间减少 1,从而阻止后续新 Thief 的进入。
         */
        TOP.setOpaque(this, ns);

        int j = m & ns; // 计算对应的 array 槽位索引

        /*
         * 【步骤 2:判断是否存在并发竞争】
         * 情况 A:ns > b (即 s - b >= 2)
         * 说明在扣除 top 之前,队列中至少有 2 个任务!
         * 即使此时有 Thief 正在对 base 位置执行 poll(),它偷取的也是 j - 1 或更早的位置。
         * 因此,Owner 与 Thief 作用的 Slot 完全隔离!Owner 拥有绝对独占权,无需执行重量级的 CAS!
         */
        if (ns > b) {
            // 直接以 getAndSet (或普通 Write + Barrier) 将数组槽位置 null 并提取 Task
            ForkJoinTask<?> t = (ForkJoinTask<?>) QA.getAndSet(a, j, null);
            if (t != null) {
                return t; // 快速路径成功,无锁直接返回
            }
        }

        /*
         * 情况 B:ns <= b (即 s - b == 1,队列仅剩最后一个任务)
         * 此时 Owner (pop) 与 Thief (poll) 目标指向同一 Slot (j = m & ns)。
         * 必须进入慢速路径,通过 CAS 进行严格的冲突判定。
         */
        return popSlow(ns);
    }
    return null;
}

/**
 * 处理仅剩单个任务时的临界冲突慢速路径
 *
 * @param s 已预先扣除 1 后的 top 值 (即 original_top - 1)
 */
private ForkJoinTask<?> popSlow(int s) {
    ForkJoinTask<?>[] a = array;
    if (a != null) {
        int m = a.length - 1;
        int j = m & s;

        /*
         * 读取槽位中的任务对象 (Acquire 语义)
         */
        ForkJoinTask<?> t = (ForkJoinTask<?>) QA.get(a, j);

        if (t != null) {
            /*
             * 【核心 CAS 竞争原语】
             * 使用 compareAndSet 将数组槽位从 t 原子性地替换为 null。
             * 底层汇编指令:LOCK CMPXCHG (x86)
             * 如果 CAS 成功:说明 Owner 抢在 Thief 之前把槽位清空了,成功获得该任务。
             */
            if (QA.compareAndSet(a, j, t, null)) {
                return t;
            }
        }
    }

    /*
     * 【恢复 top 指针机制】
     * 如果走到这里,说明上述 CAS 失败(或者槽位已经被 Thief 先一步清空为 null)。
     * 证明最后一个任务已经被 Thief 成功窃取!
     * Owner 必须将之前预扣除的 top 指针加回恢复 (top = s + 1),还原队列为空的正确状态。
     */
    TOP.setOpaque(this, s + 1);
    return null;
}
四、 窃取者线程 FIFO 并发窃取 (poll) 算法
并发任务窃取(Work-Stealing)允许多个 Thief 线程同时试图偷取同一个 WorkQueue 中 base 指针处的任务。由于 Thief 端是 多生产者/多消费者并发模型 (MPMC) ,必须依赖 base 读取语义 + 槽位 CAS 清空 + base 自增屏障 的三重组合。
窃取算法流程图与状态机
Thief 线程开始 poll()
        │
        ▼
 读取 a = array, b = base, s = top
        │
  (b - s < 0)? ──── NO ───► [队列为空,返回 null]
        │
       YES
        ▼
 读取槽位 t = QA.getAcquire(a, b & mask)
        │
  (t != null)? ──── NO ───► [可能在扩容或已被清空,重试/退出]
        │
       YES
        ▼
【核心 CAS 争抢槽位】
QA.compareAndSet(a, b & mask, t, null)
        │
   ┌────┴──────────────────────────┐
   │                               │
[成功]                           [失败]
   │                               │
   ▼                               ▼
BASE.setRelease(this, b + 1)   [已被其他 Thief 抢走]
返回 t                          重新循环或寻找下一个队列
OpenJDK 源码深度逐行解析 (poll)
java
/**
 * 由其他并发 Thief 线程(或 External 提交者)调用的窃取操作 (FIFO 顺序)
 *
 * @return 窃取到的任务;若窃取失败或队列为空则返回 null
 */
final ForkJoinTask<?> poll() {
    ForkJoinTask<?>[] a;
    int b;

    /*
     * 循环检查:条件 (b = base) - top < 0 成立说明队列中存在至少 1 个任务。
     * 注意:此处 base 采用 volatile 读取,保证能够感知到其他 Thief 导致的 base 递增。
     */
    while ((a = array) != null && (b = base) - top < 0) {
        int m = a.length - 1;
        int j = m & b; // 获取当前 base 对应的槽位索引

        /*
         * 【内存屏障要点 1:QA.getAcquire】
         * 相当于 C++ std::memory_order_acquire。
         * 在 ARM64 架构下生成 LDAR 指令,在 x86 下阻止 LoadLoad / LoadStore 重排序。
         * 保证:读到的 Task 引用及其内部字段,绝不会因为 CPU 乱序执行而提前读取到旧的值。
         */
        ForkJoinTask<?> t = (ForkJoinTask<?>) QA.getAcquire(a, j);

        // 二次检查:校验在读取槽位期间,base 指针是否已经被其他并发 Thief 改变
        if (b == base) {
            if (t != null) {
                /*
                 * 【内存屏障要点 2:QA.compareAndSet 槽位占坑】
                 * 多 Thief 并发争抢的核心裁决点!
                 * 原子性地检查 array[j] 是否仍为 t,若是则将其替换为 null。
                 *
                 * 为什么先清空槽位,而不是先递增 base 指针?
                 * 答:若先递增 base 指针,Owner 线程或其他 Thief 就会以为该 Slot 已空,
                 * 导致在 Thief 真正提取出 t 之前,该 Slot 可能被 Owner 的 push 重新复用覆盖,造成数据损坏!
                 */
                if (QA.compareAndSet(a, j, t, null)) {

                    /*
                     * 【内存屏障要点 3:BASE.setRelease】
                     * 当且仅当槽位占坑 CAS 成功后,才将 base 指针递增 1。
                     * 使用 Release 语义更新,确保当前 Thief 对槽位的置 null 操作对后续所有的 Thief 可见。
                     */
                    BASE.setRelease(this, b + 1);

                    return t; // 窃取成功,返回任务
                }
            }
            // 如果槽位 t == null,但 b + 1 - top >= 0,说明队列恰好被 Owner 清空
            else if (b + 1 - top >= 0) {
                break;
            }
        }
    }
    return null;
}
五、 底层 CPU 指令与 C++ 内存模型 (Memory Order) 映射表
ForkJoinPool 放弃了 JVM 传统的 synchronized 锁,全面借力 JEP 193 的 VarHandle。下表对比了底层 Java API、C++ 规范语义、x86 架构与 ARM64 架构汇编指令的映射关系:
Java VarHandle API |
C++ std::memory_order |
x86-64 汇编映射 | ARM64 汇编映射 | 系统工程作用 |
|---|---|---|---|---|
QA.setRelease |
memory_order_release |
mov [mem], reg |
(TSO天然保证StoreStore) | stlr reg, [mem]
(带Store-Release屏障) | 压栈时保证 Task 初始化先于数组槽位赋值 |
| TOP.setRelease | memory_order_release | mov [mem], reg | stlr reg, [mem] | 保证槽位赋值先于 top 指针更新 |
| QA.getAcquire | memory_order_acquire | mov reg, [mem]
(TSO天然保证LoadLoad) | ldar reg, [mem]
(带Load-Acquire屏障) | 窃取时保证读取槽位 Task 先于读其内部成员 |
| QA.compareAndSet | memory_order_seq_cst | lock cmpxchg [mem], reg
(锁总线/锁定Cache Line) | casl reg1, reg2, [mem]
(或 LDXR/STXR 独占环) | 解决多 Thief 并发抢夺同一 Slot 的原子裁决 |
| TOP.setOpaque | memory_order_relaxed | mov [mem], reg | str reg, [mem] | 阻止编译器重排序,但不插入全局硬件屏障 |
六、 交互式 WorkQueue 并发压栈/窃取与屏障模拟器
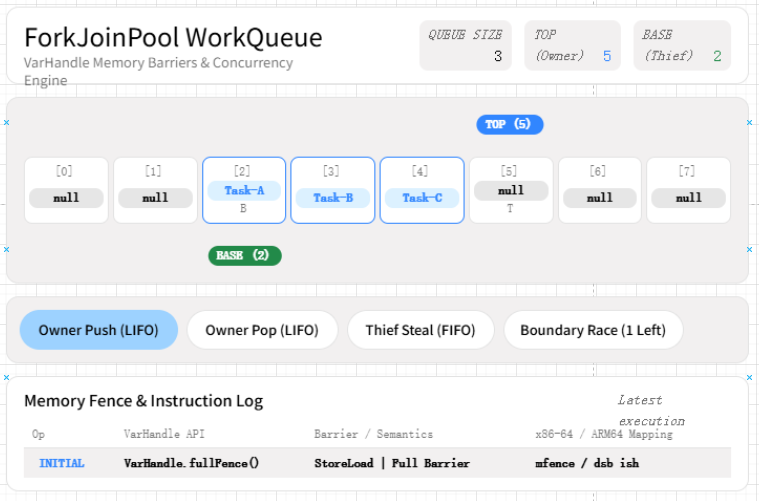
通过下方可视化交互组件,可以动态模拟 Owner 线程的 LIFO 压栈 (push)、出栈 (pop),以及多 Thief 线程并发 FIFO 窃取 (poll) 过程中指针变化与内存屏障的具体执行日志:
七、 总结与工程推演
- 完全解耦读写端 :
ForkJoinPool通过将 Owner 限制在top端的 LIFO 单线程操作,将极其频繁的子任务分割与恢复(Pop/Push)开销降低至单线程无锁指令级别(仅需普通mov+ Release 屏障)。 - 渐进式锁升级与边界握手 :只有在 s − b = 1 s - b = 1 s−b=1 的极罕见碰撞时刻,
pop才会从普通内存屏障写操作"升级"为LOCK CMPXCHG(CAS)指令,最大程度规避了多核 CPU 下的 Cache Line 伪共享刷盘(Cache Bouncing)与总线锁定开销。 - ABA 与溢出免疫 :通过依赖 32 位整型递增的
top/base结合环形数组 2 的幂取模算法 ( l e n g t h − 1 ) & i n d e x (length - 1) \ \& \ index (length−1) & index,配合 Slot 提取后强制置null的 GC 友好设计,从结构上消除了经典 Lock-Free 算法中的 ABA 漏洞。