文章目录
- 前言
- 零、论文基本信息
- 一、背景与问题:为什么"全部送进记忆"并不稳妥
-
- [1. 长上下文不能自动解决长期一致性](#1. 长上下文不能自动解决长期一致性)
- [2. "写得越多"不等于"答得越好"](#2. “写得越多”不等于“答得越好”)
- [3. 情景记忆为什么比裸对话片段更适合回答](#3. 情景记忆为什么比裸对话片段更适合回答)
- [二、相关工作:EMA 改变的是记忆生命周期的哪一步](#二、相关工作:EMA 改变的是记忆生命周期的哪一步)
- [三、EMA 总览:准入、管理与调用三段式结构](#三、EMA 总览:准入、管理与调用三段式结构)
- 四、EMU:一条情景记忆到底包含什么
- 五、MemDecider:在写入入口做重要性判断
-
- [1. 为什么需要一个独立模块](#1. 为什么需要一个独立模块)
- [2. 语义嵌入](#2. 语义嵌入)
- [3. 语言统计特征](#3. 语言统计特征)
- [4. 句法与实体特征](#4. 句法与实体特征)
- [六、MemDecider 怎样训练:监督初始化加策略优化](#六、MemDecider 怎样训练:监督初始化加策略优化)
-
- [1. 第一阶段:监督初始化](#1. 第一阶段:监督初始化)
- [2. 第二阶段:用下游回答质量调整写入策略](#2. 第二阶段:用下游回答质量调整写入策略)
- [3. 策略梯度的含义](#3. 策略梯度的含义)
- [七、Memory Manager:把被接受的对话变成可维护事件](#七、Memory Manager:把被接受的对话变成可维护事件)
-
- [1. EMU 构建](#1. EMU 构建)
- [2. Memory Linking](#2. Memory Linking)
- [3. Self-Update](#3. Self-Update)
- [4. EMU 重组](#4. EMU 重组)
- [八、Caller:查询时怎样把 EMU 变成答案依据](#八、Caller:查询时怎样把 EMU 变成答案依据)
- 九、实验设置:这些数字是在什么条件下得到的
-
- [1. 数据集与划分](#1. 数据集与划分)
- [2. Baseline 与模型](#2. Baseline 与模型)
- [3. 指标与成本口径](#3. 指标与成本口径)
- [十、LoCoMo 主实验:EMA 的优势与 MemDecider 的非单调收益](#十、LoCoMo 主实验:EMA 的优势与 MemDecider 的非单调收益)
- 十一、Long-MT-Bench+:跨数据集迁移和它的边界
- 十二、消融实验:哪些模块真正提供了收益
-
- [1. All-Accept:最值得注意的反例](#1. All-Accept:最值得注意的反例)
- [2. Random:不是随便少记一点就够了](#2. Random:不是随便少记一点就够了)
- [3. 去掉 NER 与链接](#3. 去掉 NER 与链接)
- 十三、阈值、启发式与窗口敏感性
-
- [1. 写入阈值:太低噪声多,太高证据少](#1. 写入阈值:太低噪声多,太高证据少)
- [2. 与简单规则相比](#2. 与简单规则相比)
- [3. 短窗口下的表现](#3. 短窗口下的表现)
- 十四、效率应如何理解
- [十五、与现有 Agent Memory 方法的横向比较](#十五、与现有 Agent Memory 方法的横向比较)
-
- [1. 与 A-MEM:写入准入和动态链接可组合](#1. 与 A-MEM:写入准入和动态链接可组合)
- [2. 与 MAGMA:不同层面的复杂性](#2. 与 MAGMA:不同层面的复杂性)
- [3. 与 CoM、SeCom:前置过滤和后置压缩](#3. 与 CoM、SeCom:前置过滤和后置压缩)
- [4. 与 ReMemR1:准入决策不等于写入时回溯](#4. 与 ReMemR1:准入决策不等于写入时回溯)
- [5. 与 RecMem:即时重要性判断与复现触发](#5. 与 RecMem:即时重要性判断与复现触发)
- [6. 与 Mem²Evolve:固定阈值仍可被反馈改进](#6. 与 Mem²Evolve:固定阈值仍可被反馈改进)
- [十六、对 Coding Agent、Tool Agent、Multi-Agent 的工程启发](#十六、对 Coding Agent、Tool Agent、Multi-Agent 的工程启发)
-
- [1. Coding Agent:从海量日志中挑出"值得长期记"的事件](#1. Coding Agent:从海量日志中挑出“值得长期记”的事件)
- [2. Tool Agent:成本过滤不能越过高风险规则](#2. Tool Agent:成本过滤不能越过高风险规则)
- [3. Multi-Agent:筛选前需要知道来源与责任](#3. Multi-Agent:筛选前需要知道来源与责任)
- 十七、局限性与失败场景
-
- [1. 误拒绝的代价不对称](#1. 误拒绝的代价不对称)
- [2. 训练与评价规模有限](#2. 训练与评价规模有限)
- [3. 主要指标是词面匹配](#3. 主要指标是词面匹配)
- [4. 隐私与同意机制缺失](#4. 隐私与同意机制缺失)
- [5. 多模态能力有限](#5. 多模态能力有限)
- [6. 论文描述与数字有几处张力](#6. 论文描述与数字有几处张力)
- 十八、我的理解与启发
-
- [1. 这篇论文最有价值的是把"记忆准入"独立成策略](#1. 这篇论文最有价值的是把“记忆准入”独立成策略)
- [2. EMU 是一份事件档案,而不是一句摘要](#2. EMU 是一份事件档案,而不是一句摘要)
- [3. 更安全的未来方向是"双层准入"](#3. 更安全的未来方向是“双层准入”)
- [4. 记忆质量不能只按平均 F1 判断](#4. 记忆质量不能只按平均 F1 判断)
- 十九、总结
- 参考资料
前言
长期对话里的"记忆",并不是把聊天记录保存下来就结束了。假设用户周一说:"项目 A 因预算削减,发布日期推迟到下个月 15 日。"几轮闲聊后,他又让 Agent 给项目组起草进度邮件。Agent 若没有记住改期,就可能写出"我们仍按原计划上线";但如果它把每一句寒暄、追问和重复确认都送进记忆系统,真正重要的变更又会淹没在噪声中。
此前的 Agent Memory 系列已经从多个角度处理这一矛盾:A-MEM 让记忆笔记动态链接,MAGMA 强调多粒度关系组织,CoM 与 SeCom 关注压缩和去噪,ReMemR1 让写入过程能够回看历史,RecMem 则等主题反复出现后再执行昂贵巩固。它们的记忆结构与更新方式各不相同,但"哪些新对话一开始就不值得送入记忆流水线"仍是一个需要单独回答的问题。
EMA 的切入点正是记忆准入。它先用轻量的 MemDecider 判断输入对话是否值得保留,再把通过筛选的内容整理为带时间、人物、摘要、标签、重要性、置信度和跨事件链接的 Episodic Memory Unit(EMU)。回答时,由 Caller 检索 EMU、恢复上下文并生成答案。
本文的唯一核心增量可以概括为:
将"是否值得写入记忆"的判断前移到 Agent Memory 流水线入口,用可训练、可移植的 MemDecider 过滤原始对话,再用结构化情景记忆单元承接被筛选的事件。
这里的"选择性"主要发生在写入前,不是查询时才从已经建好的记忆中删掉无关片段。这个位置差异决定了它既可能减少后续构建和查询的开销,也可能因为一次误拒绝而永久失去重要证据。论文的实验价值与工程风险,都应围绕这一点理解。
零、论文基本信息
- 论文名称: EMA: An Episodic Memory Agent for Efficient and Selective Memory
- 发表平台: Findings of the Association for Computational Linguistics: ACL 2026
- 代码仓库: https://github.com/Hongyi4221/EMA
- 作者: Hongyi Lan, Jiaqi Song, Zhengjia Zhong, Hui Li, Hong Liu, Xianming Lin, Rongrong Ji
一、背景与问题:为什么"全部送进记忆"并不稳妥
1. 长上下文不能自动解决长期一致性
延长模型上下文窗口,确实能在一次调用中放入更多历史。但长期 Agent 的对话会持续增长,历史信息的价值又高度不均匀:项目延期、偏好变化、过敏约束可能长期有用;一次性的礼貌回复和重复措辞通常没有同等价值。
如果每轮对话都参与记忆构建,系统需要付出更多编码、摘要、链接、更新和检索成本。即使窗口允许容纳全部历史,模型仍可能受到无关内容干扰。论文把这类做法称为缺乏 importance filtering 的输入处理。
2. "写得越多"不等于"答得越好"
记忆系统至少存在两种相反的失败:
- 过度保留: 冗余和低质量片段占据预算,检索器可能返回噪声;
- 过度过滤: 一次性的关键事实被拒绝写入,后续再没有恢复机会。
EMA 试图在两者之间寻找一个准入阈值。它不是把筛选责任完全交给后续大模型 Prompt,而是在内容进入正式 EMU 构建之前,单独使用一个轻量分类器。
3. 情景记忆为什么比裸对话片段更适合回答
人类的情景记忆通常把"什么事情、在什么时间、涉及谁、有什么背景"绑定在一起。EMA 借鉴这一思想,不把每条对话只当作一个字符串,而把它整理为可定位、可连接的事件单元。
例如"项目 A 推迟"不只是句子本身;它还应关联发布日期、原因、说话者、发生时间,以及后续与该项目相关的更新。EMU 承担的是这种事件级封装。需要强调的是,这是一种工程设计灵感,并不意味着系统严格模拟了人类认知过程。
二、相关工作:EMA 改变的是记忆生命周期的哪一步
RAG 式方法通常先存储原始文本,再按查询检索;优点是简单、保留原文,缺点是对跨轮事件缺少明确组织。框架式 Memory 方法会构建摘要、层级或网络,能够进行复杂更新,但如果原始输入不加筛选,噪声同样会进入后续流程。
SeCom 已经使用分段和压缩来去噪,LightMem 也有预压缩与聚合。因此不能说 EMA 是第一篇"关注记忆去噪"的论文。更准确的定位是:它把一个单独训练的写入准入模块放在正式记忆构建之前,并检验这个模块插入其他框架后的影响。
这也解释了为什么 MemDecider 在已有内部压缩环节的 LightMem、SeCom 上,边际收益不如在 A-MEM 等方法上稳定:二者有功能重叠。
三、EMA 总览:准入、管理与调用三段式结构
要理解 EMA,先看一轮对话从输入到回答经过哪些模块。
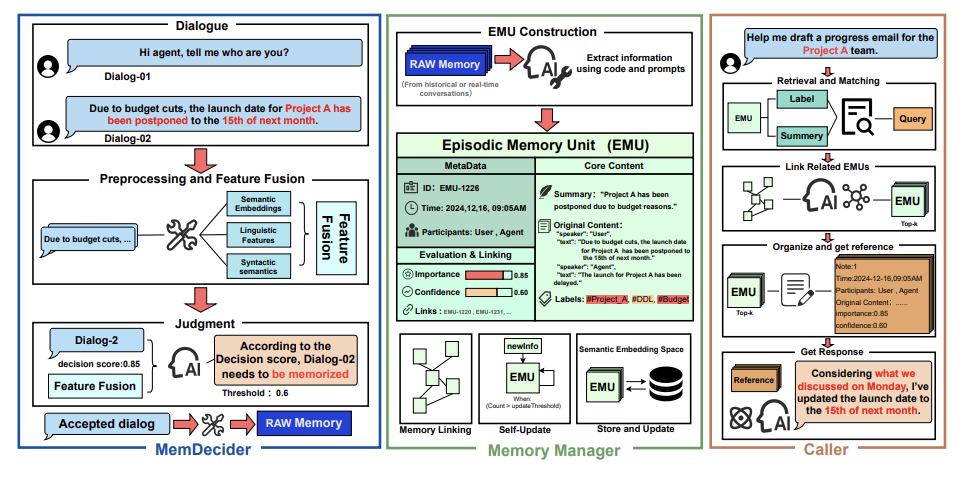
Figure 2:EMA 方法总览。 MemDecider 在入口判断对话是否写入;Memory Manager 把通过筛选的内容构建、链接和维护为 EMU;Caller 检索相关 EMU 并生成带历史依据的回答。
图中左侧是最关键的决策点:不是所有输入都会进入 RAW Memory;通过阈值的内容才被 Memory Manager 处理。中间的 EMU 兼具摘要和原始对话,右侧 Caller 根据查询召回事件及其相关链接。
整体可以写成:
Dialogue → MemDecider Accepted Content → Memory Manager EMUs → Caller Response \text{Dialogue} \xrightarrow{\text{MemDecider}} \text{Accepted Content} \xrightarrow{\text{Memory Manager}} \text{EMUs} \xrightarrow{\text{Caller}} \text{Response} DialogueMemDecider Accepted ContentMemory Manager EMUsCaller Response
这条链路中,MemDecider 决定记什么 ,Memory Manager 决定怎样组织与维护 ,Caller 决定回答时调用什么。三者相互依赖,但论文最鲜明的增量仍是第一步。
四、EMU:一条情景记忆到底包含什么
给定对话序列 D = ( u 1 , ... , u T ) D=(u_1,\ldots,u_T) D=(u1,...,uT),系统将满足触发条件的片段抽象为 EMU 集合。单个 EMU 在论文中定义为:
e i = ⟨ i d i , τ i , P i , ϕ i , C i , s i , c i , L i , x i ⟩ e_i=\langle id_i,\tau_i,P_i,\phi_i,C_i,s_i,c_i,L_i,x_i\rangle ei=⟨idi,τi,Pi,ϕi,Ci,si,ci,Li,xi⟩
各字段分别表示:
- i d i id_i idi:该 EMU 的唯一编号;
- τ i \tau_i τi:事件时间;
- P i P_i Pi:参与者集合;
- ϕ i \phi_i ϕi:事件级摘要;
- C i C_i Ci:语义或上下文标签;
- s i ∈ 0 , 1 s_i\in0,1 si∈0,1:重要性;
- c i ∈ 0 , 1 c_i\in0,1 ci∈0,1:置信度;
- L i L_i Li:关联 EMU 的链接集合;
- x i x_i xi:原始对话内容。
这个设计同时保存高层概括 与原始证据。摘要和标签有助于检索;原文让系统在需要精确日期、实体和措辞时回到证据;链接则把跨时间的相关事件连起来。
例如项目 A 延期的 EMU 可以包含:"因预算问题推迟到下个月 15 日"的摘要、项目与截止日期标签、用户和 Agent 参与者、当时的原始对话,以及后来"进度邮件""再次改期"等 EMU 链接。
它与普通"问答事实条目"的区别在于,EMU 保存一个带时间背景的事件,而不只保存一个孤立属性。它与直接保存完整聊天记录的区别是,EMU 具有明确元数据、摘要和关系入口。
五、MemDecider:在写入入口做重要性判断
1. 为什么需要一个独立模块
如果直接让 Memory Manager 处理所有输入,再请 LLM 删除不重要的内容,嵌入、抽取、链接、更新等成本已经发生。MemDecider 被放在上游,目标是用较小代价先做一次 accept/reject 决策。
这个决策不依赖单一"关键词规则"。论文使用三类特征:预训练模型的语义嵌入、语言统计特征、句法与实体特征。
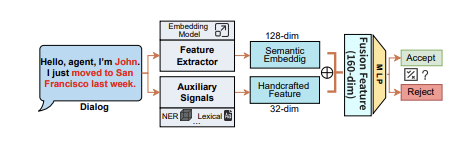
Figure 3:MemDecider 的结构。 对话同时经过语义嵌入和辅助特征提取,融合后进入 MLP,输出记忆写入的接受或拒绝决策。
图中的实现示意给出 128 维语义表示与 32 维手工特征,融合为 160 维输入。维度数字是图示配置;理解机制的关键是语义与显式信号互补,而不是 160 这个数字本身。
2. 语义嵌入
原始内容 C C C 经预训练嵌入模型 M \mathcal{M} M 得到表示:
E = MeanPool ( M ( C ) ) ∈ R d e E=\operatorname{MeanPool}(\mathcal{M}(C))\in\mathbb{R}^{d_e} E=MeanPool(M(C))∈Rde
E E E 主要负责抽象语义:两句话可能没有共同词,却都在表达项目变更、偏好更新或待办事项。仅靠数字、时间和实体规则捕捉不到这种关系。
3. 语言统计特征
论文定义:
L = f l e n , f u n i q , f d i g i t , f p u n c t , f u p p e r , f i m g , f q L=f_{len},f_{uniq},f_{digit},f_{punct},f_{upper},f_{img},f_q L=flen,funiq,fdigit,fpunct,fupper,fimg,fq
分别衡量长度、词汇多样性、数字数量、标点、大写字母、多模态元素存在与否,以及疑问词或问号频次。这些特征很廉价,也很直观:包含明确日期或数字的陈述有时比一般闲聊更可能成为未来问答的证据。
不过它们只能提供线索,不能直接等同重要性。"今天 15 度"有数字,却未必值得长期保留;"我以后不想讨论这个项目"没有数字,却可能是关键约束。
4. 句法与实体特征
论文进一步提取:
S = f p e r s o n , f g p e , f t i m e , f n o u n , f v e r b S=f_{person},f_{gpe},f_{time},f_{noun},f_{verb} S=fperson,fgpe,ftime,fnoun,fverb
其中前三项来自命名实体识别,分别反映人物、地理实体和时间表达;后两项来自词性标注,表示名词和动词数量。它们帮助模块辨别"谁在何时何地做了什么"。
最终将三类特征拼接:
z = Φ ( C ) = E ; L ; S ∈ R d e + d l + d s z=\Phi(C)=E;L;S\in\mathbb{R}^{d_e+d_l+d_s} z=Φ(C)=E;L;S∈Rde+dl+ds
MLP 对 z z z 输出接受分数 p ( C ) p(C) p(C),仅当分数达到决策阈值 τ \tau τ 时才进入 EMU 构建:
a ( C ) = 1 p ( C ) \> τ a(C)=\mathbb{1}p(C)\>\\tau a(C)=1p(C)\>τ
τ \tau τ 控制成本与遗漏之间的权衡:太低会留下噪声,太高会拒绝潜在重要信息。论文后面的阈值实验正是在检验这个权衡。
六、MemDecider 怎样训练:监督初始化加策略优化
EMA 不是端到端训练整套记忆框架。论文明确说明:只有 MemDecider 模块接受训练;Memory Manager 和 Caller 主要依赖已有模型、代码规则与 Prompt。
1. 第一阶段:监督初始化
训练样本为 ( c i , y i ) (c_i,y_i) (ci,yi),其中 y i ∈ { 0 , 1 } y_i\in\{0,1\} yi∈{0,1} 表示内容是否应被记忆接受。二元交叉熵损失为:
L B C E = − ∑ i y i log p i + ( 1 − y i ) log ( 1 − p i ) \mathcal{L}_{BCE}=-\sum_i\lefty_i\\log p_i+(1-y_i)\\log(1-p_i)\\right LBCE=−i∑yilogpi+(1−yi)log(1−pi)
p i p_i pi 是 MemDecider 对样本 i i i 的接受概率。这一阶段先让轻量模型掌握基本区分能力,避免后续 RL 从随机策略起步。
2. 第二阶段:用下游回答质量调整写入策略
一个事实是否值得记住,最终要看它有没有帮助后续回答。论文因此设计了组合终局奖励:
R q a = w 1 ⋅ F 1 + w 2 ⋅ R O U G E - L + w 3 ⋅ B L E U - 1 + w 4 ⋅ E M R_{qa}=w_1\cdot F1+w_2\cdot ROUGE\text{-}L+w_3\cdot BLEU\text{-}1+w_4\cdot EM Rqa=w1⋅F1+w2⋅ROUGE-L+w3⋅BLEU-1+w4⋅EM
并与逐步奖励合并:
R t o t a l = α R q a + β ∑ t = 1 T r s t e p , t R_{total}=\alpha R_{qa}+\beta\sum_{t=1}^{T}r_{step,t} Rtotal=αRqa+βt=1∑Trstep,t
其中 w 1 , ... , w 4 w_1,\ldots,w_4 w1,...,w4 控制回答指标的相对权重; α , β \alpha,\beta α,β 平衡终局表现和中间反馈。论文说明,中间奖励对正确定位证据给出 + 2.0 +2.0 +2.0,对冗余存储给出 − 0.5 -0.5 −0.5。这让策略既重视后续答题,也避免把所有输入一股脑保留下来。
附录最终使用的指标权重为:
( w 1 , w 2 , w 3 , w 4 ) = ( 0.5 , 0.2 , 0.2 , 0.1 ) (w_1,w_2,w_3,w_4)=(0.5,0.2,0.2,0.1) (w1,w2,w3,w4)=(0.5,0.2,0.2,0.1)
这些系数是实验配置,不是"F1 必然比 EM 重要五倍"的一般理论。
3. 策略梯度的含义
论文把写入动作 a t ∈ { 0 , 1 } a_t\in\{0,1\} at∈{0,1} 看成策略 π θ ( a t ∣ s t ) \pi_\theta(a_t\mid s_t) πθ(at∣st) 的采样结果,并给出包含优势基线和熵正则的 REINFORCE 式更新:
∇ θ J ( θ ) ≈ ∑ t = 1 T ( R t o t a l − b θ ) ∇ θ log π θ ( a t ∣ s t ) + λ ∇ θ H ( π θ ( s t ) ) \nabla_\theta J(\theta)\approx \sum_{t=1}^{T}(R_{total}-b_\theta)\nabla_\theta\log\pi_\theta(a_t\mid s_t) +\lambda\nabla_\theta H(\pi_\theta(s_t)) ∇θJ(θ)≈t=1∑T(Rtotal−bθ)∇θlogπθ(at∣st)+λ∇θH(πθ(st))
b θ b_\theta bθ 用于降低梯度方差,熵项防止策略过早固定为"全收"或"全拒"。直觉上,若某次保留决策最终帮助回答,模型未来更倾向于保留类似内容;若某类记录只增加噪声和成本,其接受概率就应下降。
需要注意:论文给出了奖励与更新表达式,但没有在正文展开完整状态构造、训练轨迹与方差统计。因此这是一套有明确方向的训练方案,而非可仅凭正文逐行复现的完整 RL 规范。
七、Memory Manager:把被接受的对话变成可维护事件
1. EMU 构建
MemDecider 接受内容后,Memory Manager 使用代码规则和 Prompt 提取 trigger event、context tags、salience 与 confidence,再生成 EMU。附录给出的构建 Prompt 要求 JSON 输出,避免仅留下自由形式的散文摘要。
这样做把"这段话值得记住"推进为"它属于什么事件、何时发生、关联谁、有多重要、可信度如何"。
2. Memory Linking
新 EMU 会根据关键词、摘要和语义相似度与已有 EMU 建立链接。链接使系统可以从"项目 A 延期"走到"给项目组写邮件",也可以把跨会话讨论同一事件的片段串起来。
链接提高了多跳召回的可能性,但也会引入错误边:两个事件主题相近,不一定涉及同一人或同一项目。论文主要用结果证明链接有用,尚未提供系统性的链接精度分析。
3. Self-Update
如果新事件更新了旧事件状态,Manager 可以调整相关记忆。例如用户周一说"下周去纽约",周三又取消,旧计划不能继续以"有效行程"被召回。Self-Update 的目标是去冗余、维护状态准确性。
这里的实现描述相对概括,论文没有给出一套形式化的冲突消解算法。实际系统还需要区分"新消息推翻旧状态"和"新消息讨论另一次相似活动"。
4. EMU 重组
随着链接和更新不断增加,Manager 在操作频率达到预设阈值后执行全局重新嵌入与整合,减少冗余并改善长期检索。论文没有给出可泛化的阈值公式,也没有单独测量重组的成本或收益,因此不能把它视为已充分验证的独立算法贡献。
八、Caller:查询时怎样把 EMU 变成答案依据
Caller 先对用户问题 I I I 做命名实体识别,得到 E N E R ( I ) E_{NER}(I) ENER(I),再把实体与原问题合并为结构化查询:
Q = I ⊕ E N E R ( I ) Q=I\oplus E_{NER}(I) Q=I⊕ENER(I)
随后对查询编码:
v q = E ( Q ) v_q=\mathcal{E}(Q) vq=E(Q)
每条 EMU 的检索表示来自标签、摘要和链接:
v m i = E ( m i . l a b e l ⊕ m i . s u m m a r y ⊕ m i . l i n k s ) v_{m_i}=\mathcal{E}(m_i.label\oplus m_i.summary\oplus m_i.links) vmi=E(mi.label⊕mi.summary⊕mi.links)
Caller 取回 Top- k k k 相关 EMU,再从 Manager 获得原始内容、时间、重要性和置信度等完整元数据:
C c o m p l e t e = { ( m . c o n t e n t , m . t i m e s t a m p , m . i m p o r t a n c e , m . c o n f i d e n c e ) ∣ m ∈ M r e t r i e v e d } C_{complete}=\{(m.content,m.timestamp,m.importance,m.confidence)\mid m\in M_{retrieved}\} Ccomplete={(m.content,m.timestamp,m.importance,m.confidence)∣m∈Mretrieved}
最后生成答案:
R = LLM ( Q , C c o m p l e t e ) R=\operatorname{LLM}(Q,C_{complete}) R=LLM(Q,Ccomplete)
这一过程要与 MemDecider 区分:MemDecider 在写入前 决定内容有没有资格形成 EMU;Caller 在回答时决定从已有 EMU 中取回哪些内容。若前者拒绝了关键信息,后者再好的检索也无从恢复。
九、实验设置:这些数字是在什么条件下得到的
1. 数据集与划分
实验使用 LoCoMo 和 Long-MT-Bench+。LoCoMo 的问题覆盖 Multi-Hop、Temporal、Open-Domain、Single-Hop;Long-MT-Bench+ 更强调从多轮对话里找回已有事实。
MemDecider 的训练使用 50% 的 LoCoMo;评估使用另外未见过的 50%,即 5 个 topic、128 个 session、999 个问题。Long-MT-Bench+ 使用完整数据:11 个 topic、54 个 session、288 个问题,且 MemDecider 不再针对它微调。
因此,LoCoMo 结果不是完整十组样本上的无条件比较;Long-MT-Bench+ 才更能检验跨数据集迁移。
2. Baseline 与模型
对比方法包括 Only LLM、Naive RAG、MemoryBank、A-MEM、LightMem、SeCom 与 MemoryOS。为了检验可插拔性,作者还把 MemDecider 接入多个既有方法。
核心主表采用本地小模型 Qwen3-4B,分别设置 8192 和 32768 Token 的上下文窗口;附录及 Figure 4 还比较 Llama3-3B、Qwen2.5-3B、Qwen3-8B 等模型。
实验主要遵循 MemoryOS 的评价设置,检索方法默认取 Top-10;各方法优先沿用原有 Prompt 和 embedding 模型,不适用时采用 LoCoMo Prompt。对部分基线使用分块和重试以应对短上下文。所有模型运行五次并报告平均结果。
这些控制提高了实验可用性,但不同基线保留各自 Prompt 与 embedding,也意味着它不是"完全同构、只替换记忆模块"的严格对照。
3. 指标与成本口径
论文使用 F1、BLEU,并在训练奖励中使用 ROUGE-L 与 EM。Token Cost 的单位在主表中是千 Token,数值如 6581.66 代表约 658 万 Token,而不是 6581 个 Token。
Naive RAG 的流程与其他系统不同,论文没有报告它的 Token Cost,因此不能在成本列中把 "---" 理解为零成本。
十、LoCoMo 主实验:EMA 的优势与 MemDecider 的非单调收益
主表列很多,下面保留四类问题的 F1 和 Token Cost。BLEU 的整体趋势可在原表核对;这里先集中讨论论文最重要的准确率---成本关系。
Qwen3-4B, 8192 Multi Temporal Open Single Token(K) A-MEM 20.18 27.79 3.96 27.38 8395.01 A-MEM+Decider 24.99 ∗ 35.03 ∗ 8.22 ∗ 41.06 ∗ 6578.41 LightMem 5.24 4.15 3.84 11.18 1102.92 LightMem+Decider 5.00 4.05 2.89 11.55 ∗ 705.96 MemoryOS 14.82 24.84 5.77 31.61 7019.78 MemoryOS+Decider 15.45 ∗ 24.95 ∗ 3.66 32.86 ∗ 6915.63 EMA 31.10 34.65 7.42 40.93 6581.66 \begin{array}{l|rrrr|r} \text{Qwen3-4B, 8192} & \text{Multi} & \text{Temporal} & \text{Open} & \text{Single} & \text{Token(K)}\\ \hline \text{A-MEM} & 20.18 & 27.79 & 3.96 & 27.38 & 8395.01\\ \text{A-MEM+Decider} & 24.99^{*} & 35.03^{*} & 8.22^{*} & \mathbf{41.06}^{*} & 6578.41\\ \text{LightMem} & 5.24 & 4.15 & 3.84 & 11.18 & 1102.92\\ \text{LightMem+Decider} & 5.00 & 4.05 & 2.89 & 11.55^{*} & 705.96\\ \text{MemoryOS} & 14.82 & 24.84 & 5.77 & 31.61 & 7019.78\\ \text{MemoryOS+Decider} & 15.45^{*} & 24.95^{*} & 3.66 & 32.86^{*} & 6915.63\\ \text{EMA} & \mathbf{31.10} & 34.65 & 7.42 & 40.93 & 6581.66 \end{array} Qwen3-4B, 8192A-MEMA-MEM+DeciderLightMemLightMem+DeciderMemoryOSMemoryOS+DeciderEMAMulti20.1824.99∗5.245.0014.8215.45∗31.10Temporal27.7935.03∗4.154.0524.8424.95∗34.65Open3.968.22∗3.842.895.773.667.42Single27.3841.06∗11.1811.55∗31.6132.86∗40.93Token(K)8395.016578.411102.92705.967019.786915.636581.66
Table 1:LoCoMo、8192 窗口的主要 F1 与 Token Cost。 EMA 在 Multi-Hop 领先,但 A-MEM 接入 MemDecider 后在 Temporal、Open-Domain 和 Single-Hop 具有竞争力。上标 ∗ * ∗ 沿用原表,表示该指标在接入 MemDecider 后改善,不代表统计显著性。
在较短窗口下,EMA 的 Multi-Hop F1 为 31.10,高于 A-MEM 的 20.18;Temporal 为 34.65,A-MEM+MemDecider 则达到 35.03;Single-Hop 为 40.93,也略低于 A-MEM+MemDecider 的 41.06。严格来说,EMA 并不是每一列都赢。
MemDecider 对 A-MEM 的作用非常明显:Token Cost 从 8395.01K 降到 6578.41K,约减少 21.6%,同时四类 F1 均提升。这支持"复杂记忆管理流程可从上游筛选受益"的解释。
但 LightMem 是反例:加入 MemDecider 后成本从 1102.92K 降到 705.96K,节省约 36%,却在 Multi-Hop、Temporal、Open-Domain 三类 F1 上下降。对已有压缩去噪流程的系统,额外过滤可能造成信息过早丢失。
Qwen3-4B, 32768 Multi Temporal Open Single Token(K) A-MEM 21.50 23.39 4.93 26.21 8409.09 A-MEM+Decider 18.78 26.56 ∗ 5.41 ∗ 24.19 7662.84 MemoryOS 15.80 25.19 4.15 33.21 7098.47 MemoryOS+Decider 15.47 25.41 ∗ 4.58 ∗ 32.90 6969.33 MemoryBank 2.77 3.39 3.87 9.92 1238.02 MemoryBank+Decider 3.23 ∗ 3.79 ∗ 2.89 10.28 ∗ 1157.69 EMA 30.21 36.37 9.26 39.14 6554.79 \begin{array}{l|rrrr|r} \text{Qwen3-4B, 32768} & \text{Multi} & \text{Temporal} & \text{Open} & \text{Single} & \text{Token(K)}\\ \hline \text{A-MEM} & 21.50 & 23.39 & 4.93 & 26.21 & 8409.09\\ \text{A-MEM+Decider} & 18.78 & 26.56^{*} & 5.41^{*} & 24.19 & 7662.84\\ \text{MemoryOS} & 15.80 & 25.19 & 4.15 & 33.21 & 7098.47\\ \text{MemoryOS+Decider} & 15.47 & 25.41^{*} & 4.58^{*} & 32.90 & 6969.33\\ \text{MemoryBank} & 2.77 & 3.39 & 3.87 & 9.92 & 1238.02\\ \text{MemoryBank+Decider} & 3.23^{*} & 3.79^{*} & 2.89 & 10.28^{*} & 1157.69\\ \text{EMA} & \mathbf{30.21} & \mathbf{36.37} & \mathbf{9.26} & \mathbf{39.14} & 6554.79 \end{array} Qwen3-4B, 32768A-MEMA-MEM+DeciderMemoryOSMemoryOS+DeciderMemoryBankMemoryBank+DeciderEMAMulti21.5018.7815.8015.472.773.23∗30.21Temporal23.3926.56∗25.1925.41∗3.393.79∗36.37Open4.935.41∗4.154.58∗3.872.899.26Single26.2124.1933.2132.909.9210.28∗39.14Token(K)8409.097662.847098.476969.331238.021157.696554.79
Table 1(续):LoCoMo、32768 窗口的主要 F1 与 Token Cost。 EMA 在四类 F1 中均领先;但将 MemDecider 接入既有方法时,个别类别仍会下降。
更大窗口下,EMA 四类 F1 均为表中最高。它的 Token Cost 为 6554.79K,低于 A-MEM 与 MemoryOS,却高于 LightMem、SeCom、MemoryBank。由此应得出的结论是质量与成本之间有较好折中,而不是 EMA 的绝对成本最低。
论文报告,MemDecider 接入多个基线后,在 8192 窗口平均节省 12.35% Token、32768 窗口平均节省 10.6%,两者平均为 11.48%。这是跨基线、跨这两种窗口设置的汇总,不是"EMA 自己比所有方法省 11.48%",也不能保证每个基线的准确率同步上升。
十一、Long-MT-Bench+:跨数据集迁移和它的边界
这一数据集没有针对 MemDecider 继续微调,所以更适合观察写入准入策略是否能迁移。
KaTeX parse error: Undefined control sequence: \multicolumn at position 29: ...}{l|rrr|rrr} & \̲m̲u̲l̲t̲i̲c̲o̲l̲u̲m̲n̲{3}{c|}{8192\te...
Table 2:Long-MT-Bench+ 的 F1、BLEU 与 Token Cost。 EMA 在两种窗口下取得最高 F1;上标 ∗ * ∗ 表示接入 MemDecider 后对应指标改善。Token Cost 普遍降低,但 SeCom、MemoryOS 的回答指标反而下降。
8192 窗口下,EMA 的 F1 33.79,相比 A-MEM 的 32.73 略高;32768 窗口下,EMA 达到 37.42,相比 A-MEM+MemDecider 的 35.95 高 1.47。这个结果说明其结构在新数据集上仍有竞争力,但优势幅度远小于某些 LoCoMo 子任务中的差距。
同时,论文正文说 MemDecider 能提高其他方法表现,但完整表格更加复杂:SeCom 接入后 F1 在 8192 窗口从 26.37 降到 25.91;MemoryOS 从 21.52 降到 20.16,32768 窗口也从 20.13 降到 19.59。Token 确实减少了,但"性能普遍改善"并不成立。
这一反例很重要:可插拔只表示接口上能接入,不表示统计收益跨架构稳定为正。
十二、消融实验:哪些模块真正提供了收益
Setting Avg F1 Avg BLEU Token(K) EMA 28.52 22.31 6581.65 All-Accept 28.90 22.10 6994.37 Random 26.65 20.28 6619.52 w/o NER in Caller 28.28 21.08 6419.38 w/o Link in Caller 25.16 19.19 5043.45 \begin{array}{l|rrr} \text{Setting} & \text{Avg F1} & \text{Avg BLEU} & \text{Token(K)}\\ \hline \text{EMA} & 28.52 & \mathbf{22.31} & 6581.65\\ \text{All-Accept} & \mathbf{28.90} & 22.10 & 6994.37\\ \text{Random} & 26.65 & 20.28 & 6619.52\\ \text{w/o NER in Caller} & 28.28 & 21.08 & 6419.38\\ \text{w/o Link in Caller} & 25.16 & 19.19 & 5043.45 \end{array} SettingEMAAll-AcceptRandomw/o NER in Callerw/o Link in CallerAvg F128.5228.9026.6528.2825.16Avg BLEU22.3122.1020.2821.0819.19Token(K)6581.656994.376619.526419.385043.45
Table 3:EMA 的模块消融。 全接收使平均 F1 略高于 EMA,但增加 Token;随机接收和移除 Caller 的链接检索明显降低质量。
1. All-Accept:最值得注意的反例
All-Accept 的平均 F1 为 28.90,比 EMA 的 28.52 高 0.38;EMA 的 BLEU 则为 22.31,略高于 All-Accept 的 22.10。All-Accept 成本 6994.37K,EMA 6581.65K,减少约 5.9%。
因此,这个消融只能证明"过滤在该配置下以较少 Token 保持接近的质量,并改善平均 BLEU",不能证明过滤提高了所有准确率指标。论文附录承认全接收在总体性能上可能更高,而正文"全接收带来退化"的概括应谨慎阅读。
2. Random:不是随便少记一点就够了
Random 的平均 F1 为 26.65、BLEU 为 20.28,低于 EMA。即便 Token Cost 接近,随机丢弃依然损害效果。结果支持 MemDecider 至少学到了比随机筛选更有用的准入模式。
3. 去掉 NER 与链接
去掉 Caller 的 NER,F1 从 28.52 降到 28.28,幅度较小;去掉链接检索则降到 25.16,幅度较大。这说明 EMU 跨事件连接对于多轮问答有明显价值。
但 w/o Link 的 Token Cost 也从 6581.65K 降到 5043.45K。部分质量下降可能来自输入证据变少,而不仅是"缺少图结构"本身。因此,在更严格的实验中应控制检索 Token 预算后再比较链接收益。
十三、阈值、启发式与窗口敏感性
1. 写入阈值:太低噪声多,太高证据少
为理解如何选择 τ \tau τ,论文同时报告曲线与精确数值。
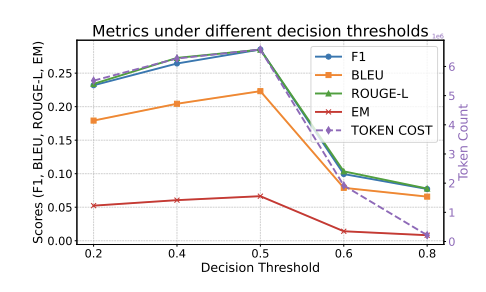
Figure 5:不同决策阈值下的质量和 Token Cost。 F1、BLEU、ROUGE-L 与 EM 在中间阈值附近较好;高阈值急剧降低 Token,也同时损害多数问答指标。
τ Multi F1 Temporal F1 Open F1 Single F1 Token(K) 0.2 22.75 30.48 7.51 32.01 5513.84 0.4 27.10 34.50 6.59 37.56 6272.98 0.5 31.10 34.66 7.43 40.93 6581.66 0.6 10.04 10.01 7.61 12.11 1919.86 0.8 5.71 4.33 10.69 10.15 215.08 \begin{array}{c|rrrr|r} \tau & \text{Multi F1} & \text{Temporal F1} & \text{Open F1} & \text{Single F1} & \text{Token(K)}\\ \hline 0.2 & 22.75 & 30.48 & 7.51 & 32.01 & 5513.84\\ 0.4 & 27.10 & 34.50 & 6.59 & 37.56 & 6272.98\\ 0.5 & \mathbf{31.10} & \mathbf{34.66} & 7.43 & \mathbf{40.93} & 6581.66\\ 0.6 & 10.04 & 10.01 & 7.61 & 12.11 & 1919.86\\ 0.8 & 5.71 & 4.33 & \mathbf{10.69} & 10.15 & 215.08 \end{array} τ0.20.40.50.60.8Multi F122.7527.1031.1010.045.71Temporal F130.4834.5034.6610.014.33Open F17.516.597.437.6110.69Single F132.0137.5640.9312.1110.15Token(K)5513.846272.986581.661919.86215.08
Table 13:不同写入阈值的分任务 F1 和成本。 τ = 0.5 \tau=0.5 τ=0.5 在多跳、时间和单跳任务上较强;过高阈值使这些任务崩溃,但 Open-Domain 的走势不同。
阈值从 0.5 提高到 0.6,Multi-Hop F1 从 31.10 跌至 10.04,Temporal 从 34.66 跌至 10.01;这表明重要历史片段被拒绝写入后,后续检索无法补救。阈值 0.8 虽使成本降至 215.08K,但多数类别几乎不可用。
反过来,0.2 的较低阈值也没有提高性能:噪声太多,可能干扰链接和更新。但 Open-Domain 有不同走势,在 0.8 时 F1 反而达到 10.69,高于 0.5 的 7.43。这提醒我们,"中等阈值对所有问题最好"并非事实。
论文正文称 τ = 0.4 \tau=0.4 τ=0.4 是稳健的质量---效率平衡,附录则明确说明后续实验默认采用 τ = 0.5 \tau=0.5 τ=0.5。我的理解是:0.4 可能更偏节省 Token,0.5 更偏主实验得分;但论文没有给出统一的阈值选择目标函数,因此不能把二者写成同一个确定配置。
2. 与简单规则相比
附录 Table 11 比较了"只保留含日期""只保留含数字""保留含日期或数字"三种启发式。四类问题中,规则的分数普遍远低于 EMA,例如 Category 1 中 EMA 为 0.3021,三种规则约 0.045。这说明一个显式时间或数字信号无法覆盖"关系变化、偏好、任务状态"等更广泛的重要内容。
但 Table 11 没有清楚解释 Category 1--4 与正文任务类别的逐项映射,且数值口径与主表展示方式不同。因此适合把它当作"规则不足"的辅助证据,不宜据此计算与主表 F1 的精确提升倍数。
3. 短窗口下的表现
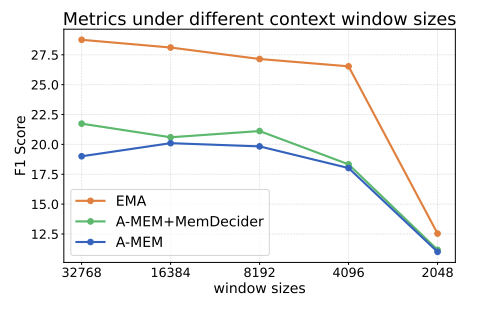
Figure 6:不同上下文窗口下的平均 F1。 EMA 在 32768 至 4096 Token 的窗口范围中保持高于 A-MEM 及 A-MEM+MemDecider 的分数;缩至 2048 Token 时三种方法都明显退化。
附录 Table 9 给出 EMA 在 32768、16384、8192、4096、2048 Token 窗口下的 F1 分别为 28.76、28.11、27.15、26.54、12.54。它证明 EMA 对窗口压缩有一定韧性,却不能解释为"2048 Token 下仍无明显问题"。
十四、效率应如何理解
EMA 的效率收益主要来自减少进入记忆流水线的内容,而不是把每一个已接受事件的构建、链接和回答都变成常数成本。
主表 Token Cost 也显示,不同框架的基线成本跨度很大。EMA 在 LoCoMo、8192 窗口消耗 6581.66K,显著低于 A-MEM 的 8395.01K,却远高于 LightMem 的 1102.92K、SeCom 的 1094.24K。若只说"EMA 更高效"而不指明比较对象,会误导读者。
此外,论文没有单独分解 MemDecider 推理、嵌入、EMU 构建、链接/更新、Caller 查询的耗时与 Token,也没有完整延迟曲线。摘要提到降低推理延迟和 API 成本,但正式实验最直接量化的是 Token Cost。实际部署还要计入拒绝决策的额外推理开销、重组成本和误拒绝代价。
十五、与现有 Agent Memory 方法的横向比较
1. 与 A-MEM:写入准入和动态链接可组合
A-MEM 的重点是让记忆笔记之间建立可演化链接;EMA 在它前面增加"是否值得写入"的判断。LoCoMo 8192 窗口下,A-MEM+MemDecider 四类 F1 都上升、Token 下降,说明上游去噪确实可能让后续链接更有效。
但在 32768 窗口,A-MEM 接入 MemDecider 的 Multi-Hop 与 Single-Hop F1 下降。因此组合不是无条件正收益。链接系统特别依赖完整的跨事件证据,一次误过滤就可能切断推理链。
2. 与 MAGMA:不同层面的复杂性
MAGMA 聚焦多粒度、多图结构的组织与推理;EMA 聚焦原始交互的准入和较轻量的 EMU 网络。二者不互相替代。若将 MemDecider 放在多图记忆前,需要重点检测:筛掉的"普通"交互是否恰好是跨图关系的桥接节点。
3. 与 CoM、SeCom:前置过滤和后置压缩
CoM、SeCom 更偏向对已进入系统的历史进行组织、压缩或段落级去噪;EMA 尝试更早地减少输入。两类方法可以叠加,但也会重复过滤。SeCom 在 Long-MT-Bench+ 上接入 MemDecider 后 F1 下降,就是功能重叠可能产生过度压缩的现实信号。
4. 与 ReMemR1:准入决策不等于写入时回溯
ReMemR1 让记忆写入过程能 callback 旧内容,解决边读边记的信息损失;EMA 先决定本轮是否进入写入。若 EMA 的判断错了,后续回溯机制并不会自动知道这条被拒绝的信息;若判断对了,回溯又可提高 EMU 更新的准确性。两者解决不同位置的问题。
5. 与 RecMem:即时重要性判断与复现触发
RecMem 先保留原始交互,再等相关主题反复出现才调用 LLM 巩固;EMA 则在入口依据当前内容特征立即决定 accept/reject。
这是一个重要权衡:EMA 更早省成本,但一次性关键事实被误拒绝后风险较高;RecMem 对一次性内容保留更完整,却要维护持续增长的原始向量库。未来可以采用"原始低成本保留 + 学习型晋升 + 复现触发"的混合策略。
6. 与 Mem²Evolve:固定阈值仍可被反馈改进
Mem²Evolve 强调从任务反馈中演化记忆机制。EMA 已通过 RL 使用下游回答反馈训练准入模块,但部署时仍使用单一决策阈值。一个更进一步的方向是根据用户、任务、风险和后续纠错动态调整阈值,而不是全局固定为 0.4 或 0.5。
十六、对 Coding Agent、Tool Agent、Multi-Agent 的工程启发
下面是我基于论文方法做出的工程推演,并非论文已有实验。
1. Coding Agent:从海量日志中挑出"值得长期记"的事件
Coding Agent 会产生大量终端输出、搜索结果和临时诊断。把每条日志都提炼为项目记忆,既贵又容易污染检索。一个 MemDecider 式模块可以优先接纳接口变更、用户确认的约束、可复现故障、已验证修复和跨任务重复出现的问题。
但它不应直接丢弃原始日志。更稳妥的实现是:原始日志保留在可检索的短期/审计层,分类器只决定是否晋升到长期项目记忆。这比论文中的纯 reject 更适合需要追责和复现的开发环境。
2. Tool Agent:成本过滤不能越过高风险规则
用户可能只说一次"付款前必须先确认"或"我对花生过敏"。这类信息不应因为预测分数略低于阈值而被拒绝。Tool Agent 应把安全、隐私、预算和不可逆动作约束设置为高优先级规则,覆盖统计分类器。
因此真实系统的准入策略可以是:
Write = Safety Rule ∨ Explicit User Request ∨ p ( C ) \> τ \text{Write}= \text{Safety Rule} \lor\text{Explicit User Request} \lorp(C)\>\\tau Write=Safety Rule∨Explicit User Request∨p(C)\>τ
这条公式是工程建议,不是论文原公式。
3. Multi-Agent:筛选前需要知道来源与责任
多 Agent 系统里,研究 Agent 的推测、执行 Agent 的事实、用户的明确命令具有不同可信度。EMU 的 participants、confidence、timestamp、raw content 和 links 很适合作为共享记忆对象。
但 MemDecider 若只看文本,不看来源和任务角色,就可能把"子 Agent 反复猜测"误判为重要经验。实际部署应把 provenance 和验证状态纳入准入特征,并允许其他 Agent 对已有 EMU 提出更正,而不是直接覆盖。
十七、局限性与失败场景
1. 误拒绝的代价不对称
MemDecider 拒绝一条无关闲聊,最多节省一点成本;拒绝一次性的关键约束,可能导致未来严重错误。论文训练奖励包含回答质量和冗余惩罚,但没有提供按风险类型分层的误拒绝分析,也没有明确的原始信息后备通道。
2. 训练与评价规模有限
LoCoMo 只用 5 个未见 topic、999 个问题评测;Long-MT-Bench+ 有 288 个问题。虽然实验重复五次,规模仍不足以覆盖长期个性化助手、工具调用、跨月状态变化和高风险场景。
3. 主要指标是词面匹配
F1、BLEU、ROUGE-L 和 EM 适合检验简短答案,却可能低估语义正确但措辞不同的回答,也未必能充分度量时间状态、用户偏好的一致性。作者也在局限性中承认,长期记忆一致性的鲁棒指标仍是开放问题。
4. 隐私与同意机制缺失
EMA 会保存原始对话、人物、时间、标签和链接,但论文没有显式讨论用户同意、删除权、敏感字段脱敏和访问权限。作者将隐私保护列为未来工作。对真实个人助手,这不是可选优化,而是部署前提。
5. 多模态能力有限
特征列表包含"是否存在多模态元素",但整个记忆建模和主实验主要围绕文本。论文明确没有进一步处理图像等模态,因此不能把它称为成熟的多模态情景记忆系统。
6. 论文描述与数字有几处张力
All-Accept 的平均 F1 略高于 EMA;MemDecider 接入 SeCom、MemoryOS 后在 Long-MT-Bench+ 上有退化;正文与附录对阈值 0.4/0.5 的表述不同。这些不推翻"选择性写入有价值",但提醒我们:质量---成本权衡必须看完整结果,不能只看摘要中的平均 Token 节省。
十八、我的理解与启发
1. 这篇论文最有价值的是把"记忆准入"独立成策略
许多记忆系统把写入视为默认动作,之后再优化结构和检索。EMA 明确提出:写入本身也应是一项可学习决策。这个视角能解释为什么越来越强的下游组织模块,仍会被入口噪声拖累。
2. EMU 是一份事件档案,而不是一句摘要
一个好的情景记忆不应只有"用户提到项目延期"。它应保留时间、参与者、摘要、原文、可信度以及与后续事件的关系。EMU 的价值在于把这些维度封装进同一个可更新对象。
不过字段越多,构建和维护成本越高。EMA 的 Token Cost 并不是所有系统中最低,也正反映了"丰富结构"与"轻量存储"的交换。
3. 更安全的未来方向是"双层准入"
我更倾向于把 MemDecider 解释为"是否晋升为高层 EMU",而不是"是否保存任何痕迹"。即:
- 原始对话进入低成本、可过期的证据层;
- MemDecider 判断是否立即构建 EMU;
- 被拒绝的内容若在未来被问到、复现或触发风险规则,仍可二次晋升;
- EMU 摘要和原始证据保持可追溯关系。
这能结合 EMA 的入口效率与 RecMem 的原始证据保险,同时降低一次误拒绝造成的不可逆损失。
4. 记忆质量不能只按平均 F1 判断
All-Accept 略高的平均 F1、不同问题类型的阈值偏好,以及接入不同基线的退化,共同说明没有一个"最重要性阈值"适合所有情况。实际 Agent 应关注最糟糕的漏记案例、约束违背、跨时间状态错误和隐私风险。
十九、总结
EMA 将长期对话记忆拆成三个环节:MemDecider 在入口筛选值得记忆的对话;Memory Manager 将其构建、链接和维护为包含元数据与原始证据的 EMU;Caller 检索相关 EMU,组合回答上下文。
论文在 LoCoMo 与 Long-MT-Bench+ 上展示了有竞争力的回答质量,并报告将 MemDecider 接入多个基线后,在两种上下文窗口设置中平均节省 11.48% Token。实验也显示:它不是对所有基线、所有类别都提升准确率;All-Accept 的平均 F1 略高,过高阈值会严重漏记,SeCom 与 MemoryOS 在部分迁移实验中出现性能退化。
一句话总结:
EMA 的核心不是造一个更大的记忆库,而是让 Agent 在对话进入正式记忆流程之前先做一次可学习的价值判断,再把被接纳的内容组织成可检索、可链接、可更新的情景事件。
参考资料
- EMA: An Episodic Memory Agent for Efficient and Selective Memory,Findings of ACL 2026。
- EMA 官方代码仓库。
- LoCoMo: Evaluating Very Long-Term Conversational Memory of LLM Agents。
- Long-MT-Bench+: Long-Term Multi-Turn Dialogue Benchmark。
- A-MEM: Agentic Memory for LLM Agents。
- MemoryOS: A Memory OS for AI System。
- RecMem: Recurrence-based Memory Consolidation for Efficient and Effective Long-Running LLM Agents。