本篇目标:
1.认识排序的基础概念
2.学会插入排序,希尔排序。选择排序,堆排序的算法思路
一. 什么是排序
排序是数据结构中最基础、也最能体现"用数据特征换取效率"的主题之一。表面看,排序只是把一组数字按升序或降序排列;实际工程中,元素往往是一条完整记录,真正参与比较的只是记录中的某个关键字。
设有记录序列:
cpp
R₁, R₂, ..., Rₙ每条记录分别对应一个关键字:
cpp
k₁, k₂, ..., kₙ排序的目标是找到原记录序列的一种排列:
cpp
Rₚ₁, Rₚ₂, ..., Rₚₙ使其对应的关键字满足:
cpp
kₚ₁ ≤ kₚ₂ ≤ ... ≤ kₚₙ此时,记录序列便按照关键字完成了升序排列。
最终得到按关键字非递减排列的记录序列。若把不等号反过来,就是非递增排序。
例如,学生记录可能包含学号、姓名、年龄和成绩:
cpp
typedef struct Student
{
    int stuNo;
    char name[20];
    int age;
    double score;
} Student;如果按成绩升序排列 ,score 是排序关键字,而整条 Student 记录必须随着关键字一起移动。理解这一点后,"稳定性"为什么重要也就自然清楚了:两个学生成绩相同时,稳定排序能够保留他们原来的先后关系。
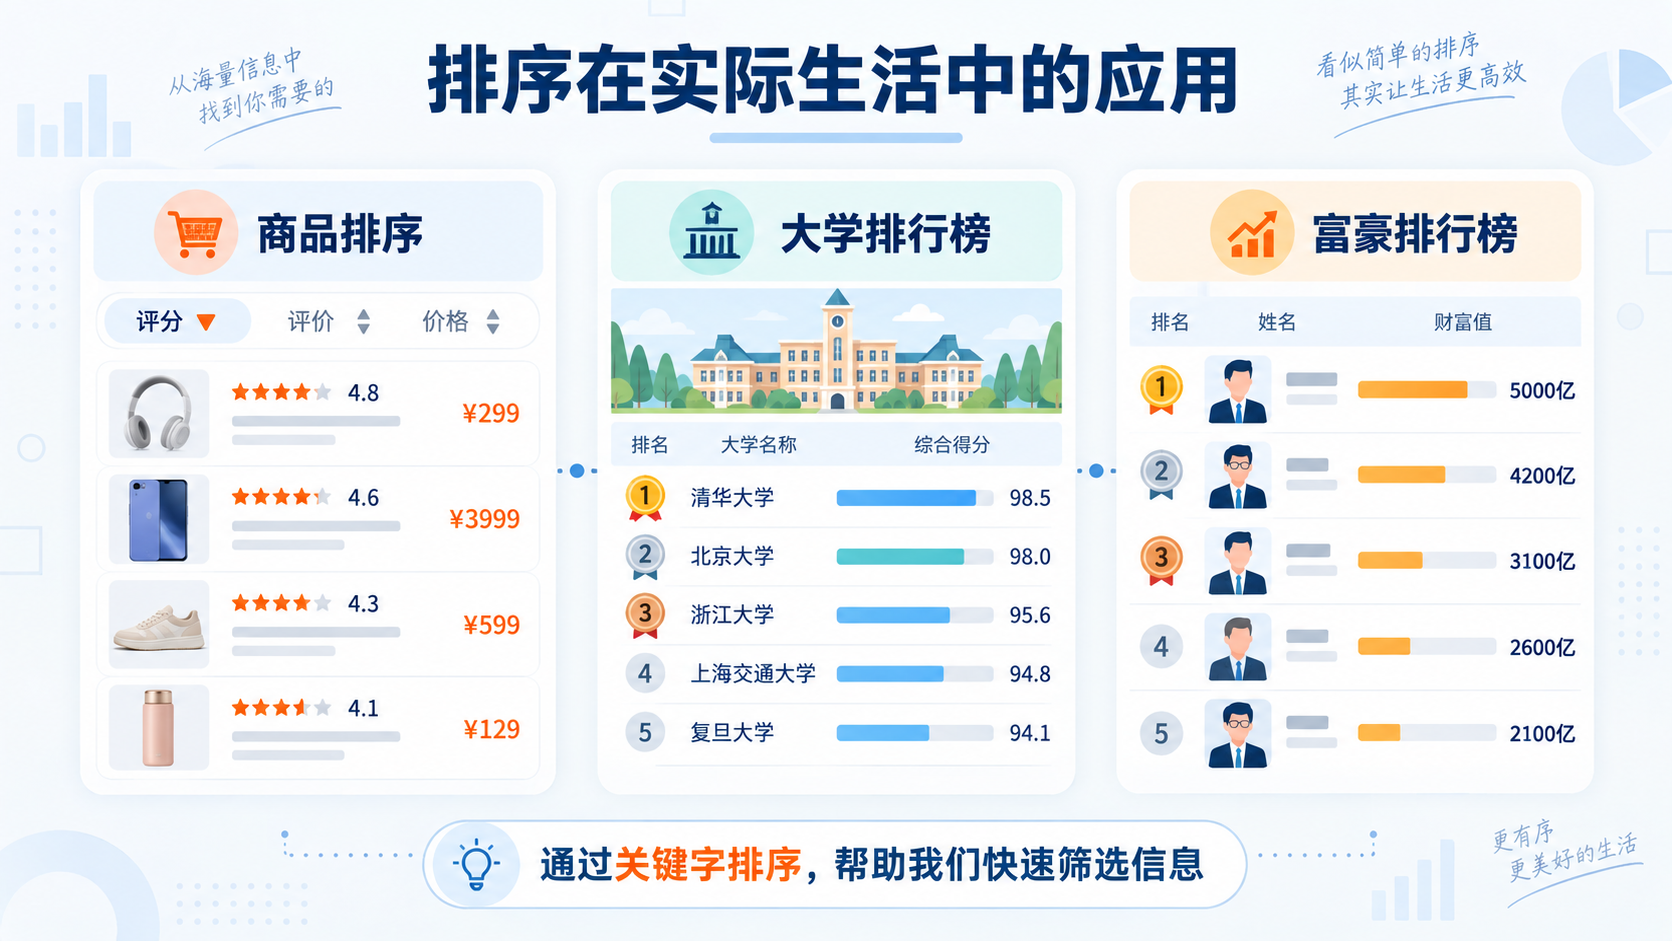
排序在实际生活中也随处可见,如购物软件 中通过综合评分、评价、价格等排序商品方便筛选。再或者大学综合实力排行榜,再或者华润富豪排行榜等等,如图:
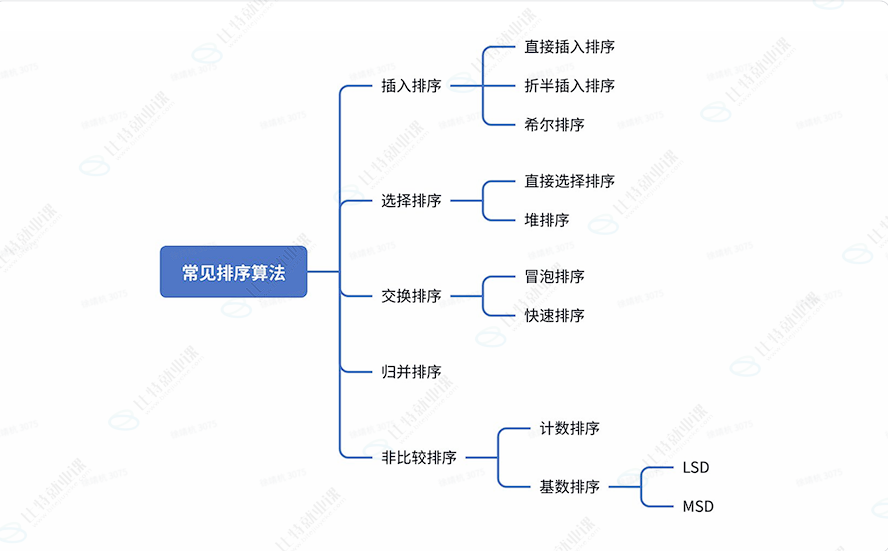
常见内部排序可以从两个角度分类:
按基本操作分 :插入排序、选择排序、交换排序、归并排序等。
按是否比较关键字分:比较排序与非比较排序。计数排序、基数排序属于后者。
如图:
所谓"内部排序",是指待排序数据能够整体放入内存。若数据大到必须借助磁盘分批处理,则属于外部排序,典型方法是外部归并。
二. 评价排序算法的三个核心指标
1. 时间复杂度
排序不只要看一个笼统的复杂度,还应区分最好、平均和最坏情况。例如,直接插入排序在数组已经有序时只需线性扫描,时间复杂度是 O(n);但在完全逆序时需要大量移动,最坏达到 O(n²)。
分析时通常关注两类操作:
cpp
关键字比较次数;
记录移动或交换次数。
这两个指标并不总是同步变化。折半插入排序能显著减少比较次数,却不能减少为了空出插入位置而进行的元素移动,因此其总体最坏时间复杂度仍是 O(n²)。
2. 空间复杂度
如果算法只使用若干临时变量,额外空间是 O(1),通常称为原地排序。直接插入、希尔、简单选择和堆排序都可以原地完成。
注意:
cpp
"原地"并不等于"不使用任何额外内存",而是额外空间不会随着输入规模 `n` 增长。3. 稳定性
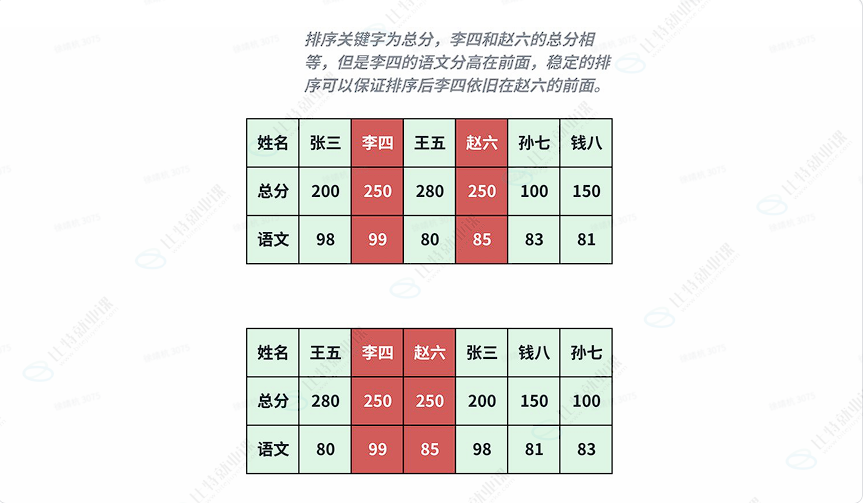
设两个元素 Ri、Rj 的关键字相等,并且排序前 Ri 位于 Rj 前面。如果排序后仍能保证 `Ri` 在 `Rj` 前面,则该排序算法是稳定的。
稳定性只对"相等关键字的记录"有意义。纯整数数组里的两个 `5` 看起来没有区别,但如果它们分别是:
cpp
text
(成绩=90, 提交时间=09:00)
(成绩=90, 提交时间=09:05)
稳定排序就能在按成绩排序后继续保留提交时间的先后关系。多关键字排序中,稳定性尤其重要:可以先按次关键字稳定排序,再按主关键字稳定排序。
例如如图所示:
4. 性能测试代码
后面要用的代码:
cpp
void TestPerformance()
{
    srand(static_cast<unsigned int>(time(nullptr)));

    const int N = 10'000'000;

    int* a1 = static_cast<int*>(malloc(sizeof(int) * N));
    int* a2 = static_cast<int*>(malloc(sizeof(int) * N));
    int* a3 = static_cast<int*>(malloc(sizeof(int) * N));
    int* a4 = static_cast<int*>(malloc(sizeof(int) * N));
    int* a5 = static_cast<int*>(malloc(sizeof(int) * N));
    int* a6 = static_cast<int*>(malloc(sizeof(int) * N));
    int* a7 = static_cast<int*>(malloc(sizeof(int) * N));
    int* a8 = static_cast<int*>(malloc(sizeof(int) * N));
    int* a9 = static_cast<int*>(malloc(sizeof(int) * N));

    // 生成相同的测试数据
    for (int i = 0; i < N; ++i)
    {
        a1[i] = rand() + i;

        // 如果只使用 rand(),重复数据会比较多
        // a1[i] = rand();

        a2[i] = a1[i];
        a3[i] = a1[i];
        a4[i] = a1[i];
        a5[i] = a1[i];
        a6[i] = a1[i];
        a7[i] = a1[i];
        a8[i] = a1[i];
        a9[i] = a1[i];
    }

    // 插入排序
    clock_t begin1 = clock();
    // InsertSort(a1, N);
    clock_t end1 = clock();

    // 希尔排序
    clock_t begin2 = clock();
    // ShellSort(a2, N);
    clock_t end2 = clock();

    // 选择排序
    clock_t begin3 = clock();
    // SelectSort(a3, N);
    clock_t end3 = clock();

    // 堆排序
    clock_t begin4 = clock();
    // HeapSort(a4, N);
    clock_t end4 = clock();

    // 冒泡排序
    clock_t begin5 = clock();
    // BubbleSort(a5, N);
    clock_t end5 = clock();

    // 快速排序
    clock_t begin6 = clock();
    // QuickSort(a6, 0, N - 1);
    clock_t end6 = clock();

    // 归并排序
    clock_t begin7 = clock();
    // MergeSort(a7, N);
    clock_t end7 = clock();

    // 计数排序
    clock_t begin8 = clock();
    // CountSort(a8, N);
    clock_t end8 = clock();

    // 基数排序
    clock_t begin9 = clock();
    // RadixSortLSD(a9, N);
    clock_t end9 = clock();

    printf("InsertSort   : %lld ms\n",
           static_cast<long long>(end1 - begin1));
    printf("ShellSort    : %lld ms\n",
           static_cast<long long>(end2 - begin2));
    printf("SelectSort   : %lld ms\n",
           static_cast<long long>(end3 - begin3));
    printf("HeapSort     : %lld ms\n",
           static_cast<long long>(end4 - begin4));
    printf("BubbleSort   : %lld ms\n",
           static_cast<long long>(end5 - begin5));
    printf("QuickSort    : %lld ms\n",
           static_cast<long long>(end6 - begin6));
    printf("MergeSort    : %lld ms\n",
           static_cast<long long>(end7 - begin7));
    printf("CountSort    : %lld ms\n",
           static_cast<long long>(end8 - begin8));
    printf("RadixSortLSD : %lld ms\n",
           static_cast<long long>(end9 - begin9));

    free(a1);
    free(a2);
    free(a3);
    free(a4);
    free(a5);
    free(a6);
    free(a7);
    free(a8);
    free(a9);
}排序算法可视化网站:
<1>.VisuAlgo由新加坡国立大学(NUS)计算机学院的 Steven Halim 博士牵头创建。
https://visualgo.net/en/sorting https://visualgo.net/en/sorting
<2>.Comparison Sorting由美国旧金山大学(University of San Francisco)计算机科学系提供。
Comparison Sorting Visualizationhttps://www.cs.usfca.edu/~galles/visualization/ComparisonSort.html
三. 直接插入排序
1. 思路及过程
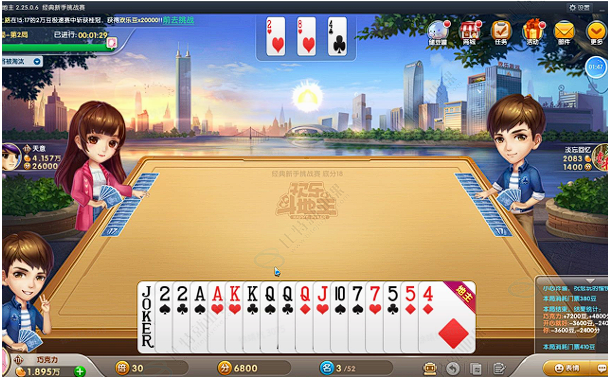
直接插入排序与打牌时整理手牌非常相似:左侧牌已经有序,每次从右侧取出一张新牌,在左侧找到合适位置,将较大的牌依次右移,再把新牌插进去。
如图:
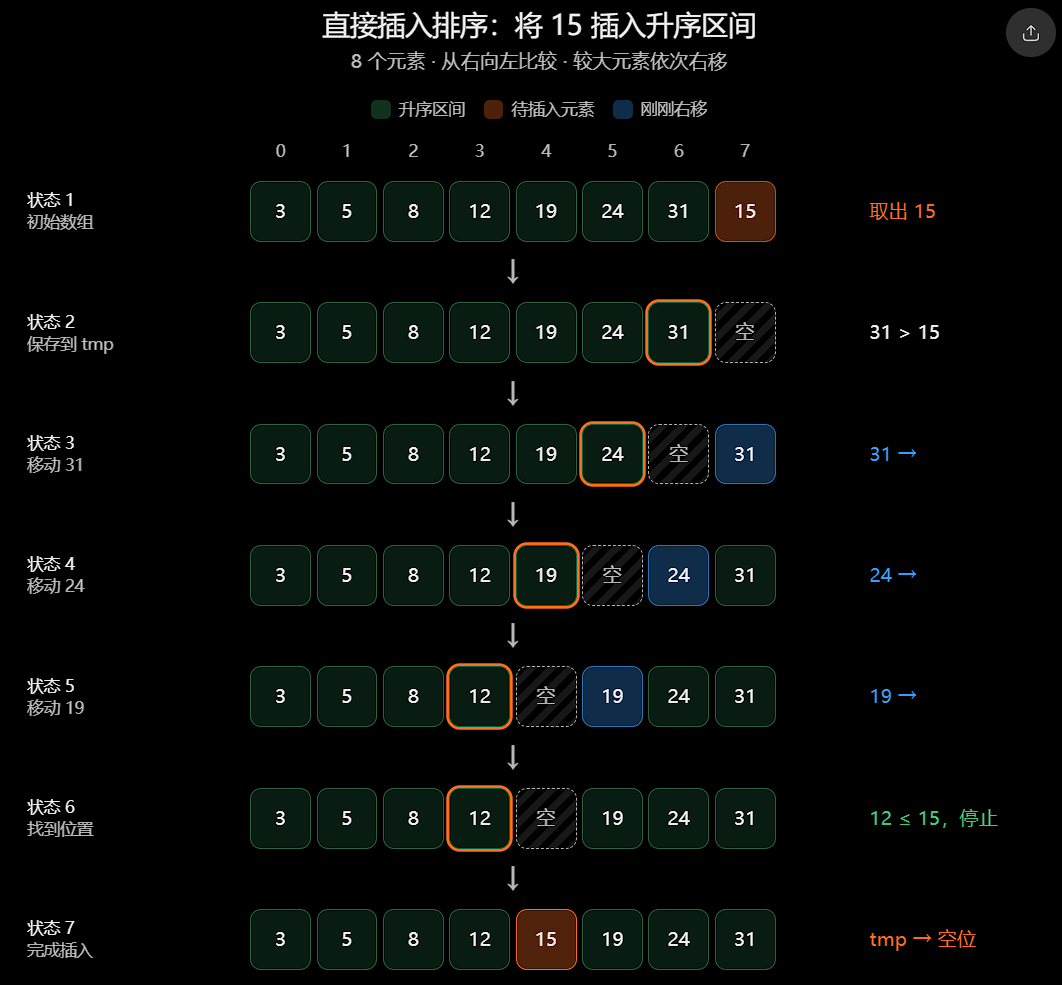
单次插入示意图:
若 0, end 已经有序,那么一次插入要完成的任务是:把 aend + 1 插入 0, end,使 0, end + 1 有序。
流程如图:
代码块:
cpp
int end=6;
int tmp = a[end + 1];

while (end >= 0)
{
    if (tmp < a[end])
    {
        // 依次往后挪动
        a[end + 1] = a[end];
        --end;
    }
    else
    {
        // 挪动结束,跳出循环
        break;
    }
}

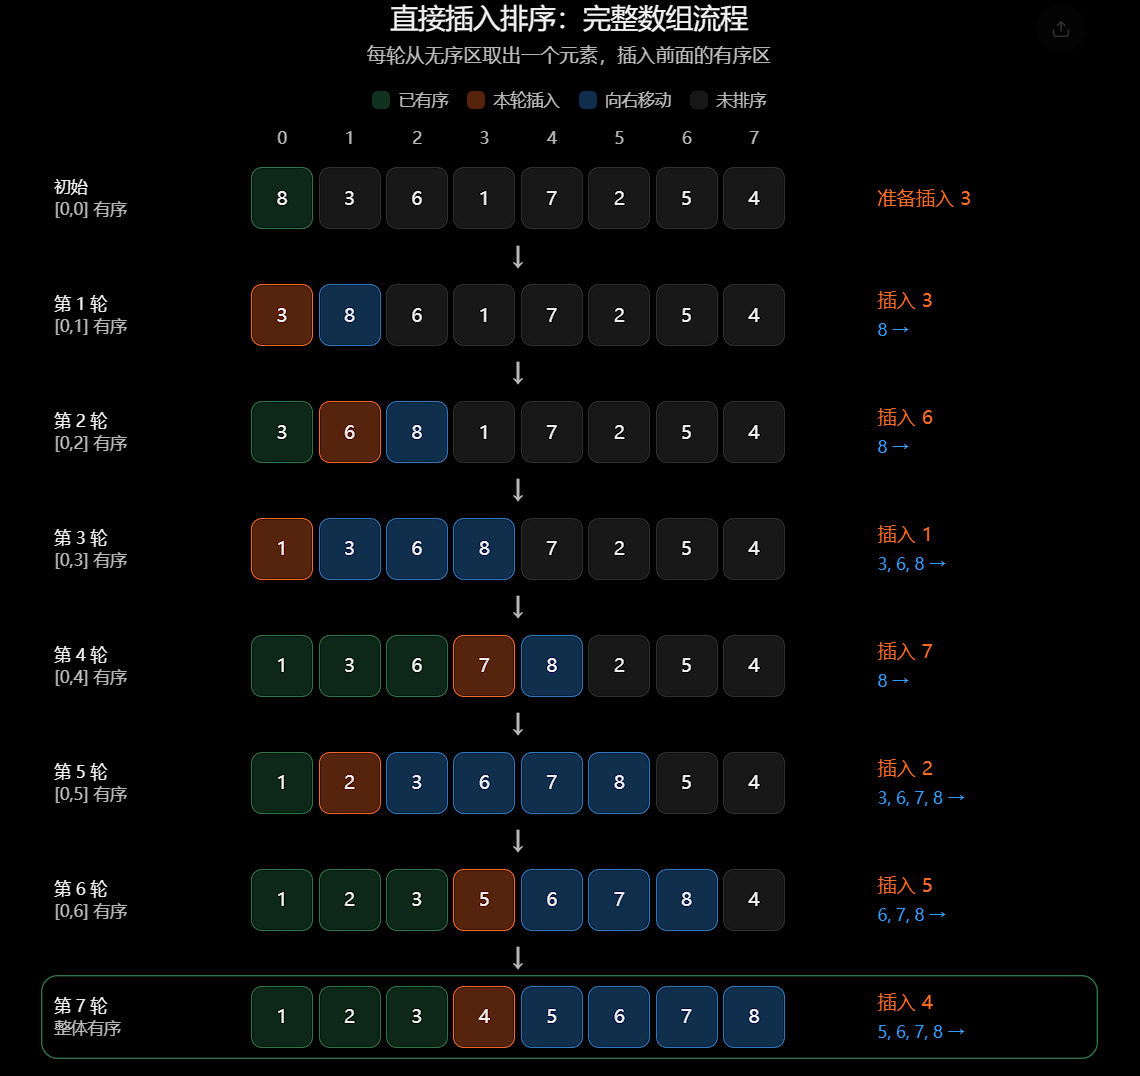
a[end + 1] = tmp;那么整体流程思路呢?
整体插入思想:
cpp
<1>.直接插入排序最开始将 [0, 0] 作为第一个有序区间,把下标为 1 的元素插入 [0, 0],此时 [0, 1] 区间有序。

<2>.再把下标为 2 的元素插入 [0, 1],此时 [0, 2] 区间有序。

<3>.以此类推,不断重复上述过程,直至 [0, n - 2] 区间有序。

<4>.最后把下标为 n - 1 的元素插入 [0, n - 2],此时 [0, n - 1] 整体有序。
流程图:
代码块:
cpp
void InsertSort(int* a, int n)
{
    // 将 [1, n-1] 位置的值依次插入前面的有序区间
    for (int i = 0; i < n - 1; i++)
    {
        // [0, end] 有序,将 end+1 位置的值插入 [0, end],保持有序
        int end = i;
        int tmp = a[end + 1];

        while (end >= 0)
        {
            if (tmp < a[end])
            {
                // 依次往后挪动
                a[end + 1] = a[end];
                --end;
            }
            else
            {
                // 挪动结束,跳出循环
                break;
            }
        }

        a[end + 1] = tmp;
    }
}
这里故意使用 aend > key,而不是 aend >= key。遇到相等元素时停止移动,新元素会放在已有相等元素之后,从而保持稳定性。
测试代码:
cpp
void PrintArray(int* a, int n)
{
    for (int i = 0; i < n; i++)
    {
        printf("%d ", a[i]);
    }

    printf("\n");
}

void TestInsertSort()
{
    int a[] = {2, 4, 1, 7, 8, 3, 9, 2};

    InsertSort(a, sizeof(a) / sizeof(int));
    PrintArray(a, sizeof(a) / sizeof(int));
}
2. 复杂度与稳定性
时间复杂度:最好情况:原序列已经升序,每个元素只比较一次,时间复杂度 O(n);最坏情况:原序列完全逆序,移动次数约为 1 + 2 + ... + (n - 1),时间复杂度 O(n²);平均时间复杂度:O(n²)。
空间复杂度:O(1)。
稳定性:稳定。
直接插入排序很"挑数据":当序列规模较小,或者大部分元素已经有序时,它往往非常高效。这也是很多混合排序在处理小区间时切换到插入排序的原因。
四. 希尔排序
1. 思路及过程
直接插入排序在逆序数组上很慢,是因为一个很小的元素每轮只能通过连续移动逐步靠近前端。希尔排序的改进思路是:先允许元素以较大步长移动,让远距离逆序快速减少;最后再用步长为 1 的直接插入排序收尾。
希尔排序又称"缩小增量排序"。给定增量 gap,把下标相差 gap 的元素看成一组,并对每组进行直接插入排序。例如 gap = 3 时:
cpp
text:
第 0 组:a[0], a[3], a[6], ...
第 1 组:a[1], a[4], a[7], ...
第 2 组:a[2], a[5], a[8], ...例如d==3时 ,随机数组进行预排序过程展示:
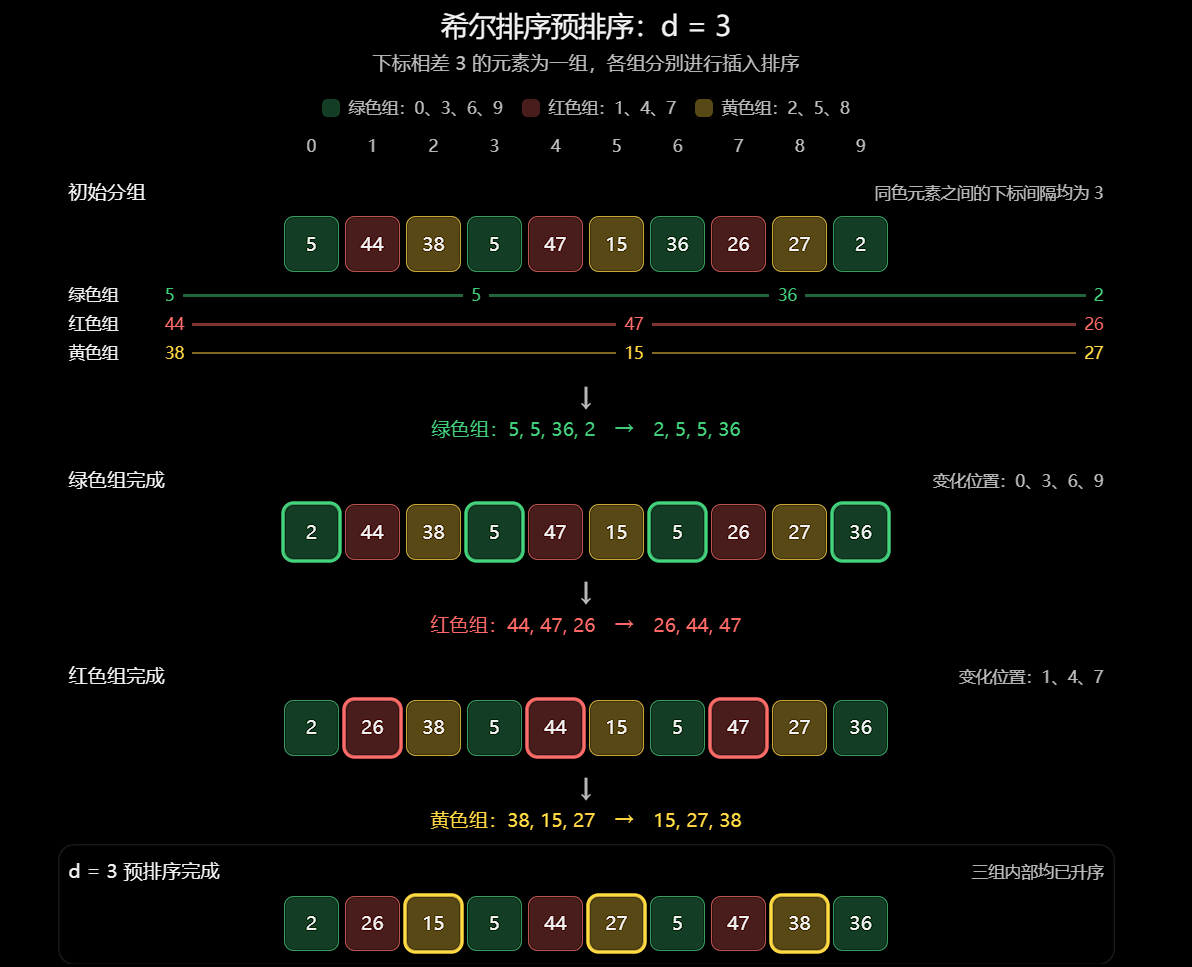
通过上面的过程我们就可以得出间距为d的单趟插入代码实现:
cpp
// [0, end] 区间中,间距为 d 的数据已经有序,
// 将 end+d 位置的元素插入对应的 d 间距分组中
int d = 3; // 增量
for (size_t i = 0; i < n - d; ++i)
{
    int end = i;
    int tmp = a[end + d];

    while (end >= 0)
    {
        if (tmp < a[end])
        {
            a[end + d] = a[end];
            end -= d;
        }
        else
        {
            break;
        }
    }

    a[end + d] = tmp;
}
当 gap > 1 时,可以把这些轮次理解为预排序 ;当 gap == 1 时,它就是一次普通的直接插入排序。由于前面的预排序已经让数组接近有序,最后一轮通常很快。
可是这个d应该如何变化呢?那么就要讲到下面的增量序列了。
2. 增量序列
希尔排序的效率高度依赖增量序列。常见方案包括:
Shell:不断令 gap = gap / 2;
Knuth:1, 4, 13, 40, ...,满足 gap = 3 * gap + 1;
Sedgewick:由若干公式交错生成。
而 Knuth 方案高效、简洁且应用广泛。下面采用 Knuth 增量。
希尔排序:
cpp
void ShellSort(int* a, int n)
{
    int d = n;
    while (d > 1)
    {
        // +1 保证最后一个 d 一定是 1
        // d > 1 时是预排序
        // d == 1 时是直接插入排序
        d = d / 3 + 1; // 缩小增量
        // 关键点:
        // ++i 控制多个间隔为 d 的组串联并行插入排序
        for (size_t i = 0; i < n - d; ++i)
        {
            int end = i;
            int tmp = a[end + d];

            while (end >= 0)
            {
                if (tmp < a[end])
                {
                    a[end + d] = a[end];
                    end -= d;
                }
                else
                {
                    break;
                }
            }

            a[end + d] = tmp;
        }
    }
}
测试代码:
cpp
void TestShellSort()
{
    int a[] = {9, 1, 2, 5, 7, 4, 6, 3, 5};
    /*
    int a[] = {
        9, 1, 2, 5, 7, 4, 6, 3, 5,
        9, 1, 2, 5, 7, 4, 6, 3, 5,
        9, 1, 2, 5, 7, 4, 6, 3, 5,
        9, 1, 2, 5, 7, 4, 6, 3, 5,
        9, 1, 2, 5, 7, 4, 6, 3, 5
    };
    */
    PrintArray(a, sizeof(a) / sizeof(int));
    ShellSort(a, sizeof(a) / sizeof(int));
    PrintArray(a, sizeof(a) / sizeof(int));
}
3. 复杂度与稳定性
时间复杂度:希尔排序的复杂度不能脱离增量序列单独讨论, 其平均性能约为 O(n^1.3),最坏可到 O(n²);有些精心设计的增量序列可以得到更好的理论界。
空间复杂度:O(1)。
稳定性:不稳定。
它不稳定的根本原因,是相同关键字可能被分到不同增量组,在远距离移动中改变相对次序。即使每个组内的插入过程是稳定的,整体仍不一定稳定。
判断某一趟希尔排序可能采用什么增量时,可以把结果按候选 gap 分组:如果每个组内都已经有序,该增量才可能成立。
六. 简单选择排序
1. 思路及过程
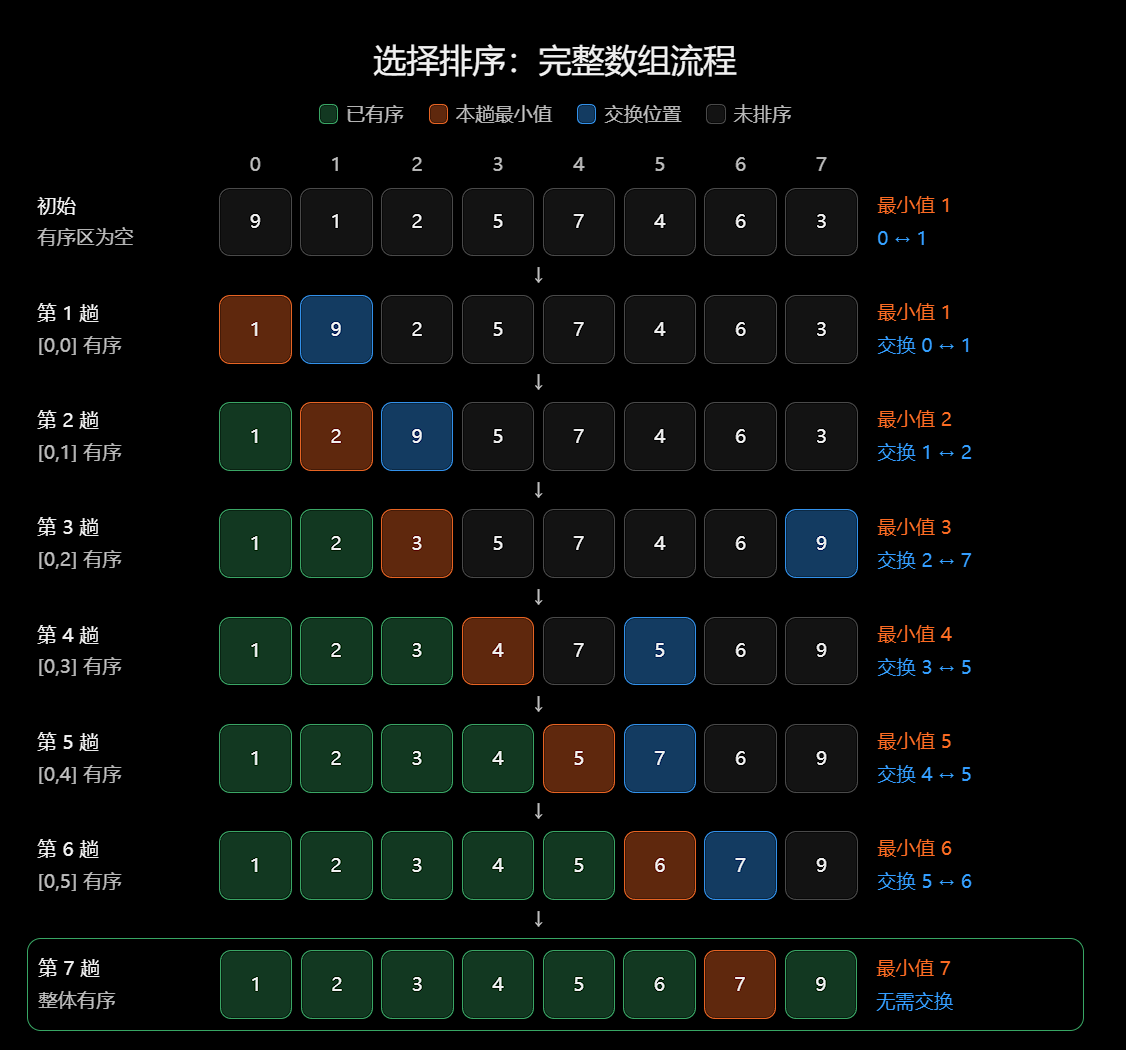
第 i 趟从未排序区间 i, n - 1 中找出最小元素,把它交换到位置 i。前 i 个元素构成有序区间,后面的元素继续参与选择。
流程图:
代码块:
cpp
void SelectSort(int* a, int n)
{
    for (int i = 0; i < n - 1; ++i)
    {
        // 在区间 [i + 1, n - 1] 中寻找最小元素的位置
        int min = i;
        for (int j = i + 1; j < n; ++j)
        {
            if (a[j] < a[min])
            {
                min = j;
            }
        }
        // 如果最小元素不在当前位置,则进行交换
        if (min != i)
        {
            int tmp = a[i];
            a[i] = a[min];
            a[min] = tmp;
        }
    }
}
测试代码:
cpp
void TestSelectSort()
{
    int a[] = {9, 1, 2, 5, 7, 4, 6, 3};
    int n = sizeof(a) / sizeof(int);

    PrintArray(a, n);
    SelectSort(a, n);
    PrintArray(a, n);
}
2. 复杂度与稳定性
不论数组原来是升序、降序还是随机,简单选择排序每一趟都必须扫描未排序区间:
cpp
(n - 1) + (n - 2) + ... + 1 = n(n - 1) / 2因此:
cpp
最好、平均、最坏时间复杂度均为 O(n²);
交换次数至多 n - 1,比冒泡排序少;
额外空间复杂度为 O(1);
不稳定。
**为什么不稳定?**考虑带身份标记的序列:
简单选择排序⽆法保持稳定性,如{5,6,5,0,2,0,3}我们可以遍历⼀遍选出第⼀个0交换到最左边的位 置,保持0的相对顺序,但是在交换过程中5的相对顺序就被破坏了,所以简单选择排序⽆法保持稳 定性。
七. 堆排序
堆排序在堆的那一篇文章里面就已经提到过了,这里就简单的说一下。
1. 思路及过程
简单选择排序每一趟靠线性扫描找最值,找一次需要 O(n)。堆排序把数组逻辑上看作完全二叉树,利用堆顶始终为最值的性质完成选择:
排升序时建立大堆,堆顶是当前最大值;
将堆顶与当前未排序区间的末尾交换;
缩小堆的有效范围;
对新的堆顶执行向下调整,恢复大堆。
数组下标为 `parent` 的结点,其孩子下标是:
cpp
left  = 2 * parent + 1
right = 2 * parent + 2向下调整有一个前提:当前结点的左右子树已经是堆 ,只有该结点可能破坏堆序。每次选出更大的孩子与父结点比较;若孩子更大,就交换并继续向下,否则调整完成。
代码块:
cpp
void Swap(int* x, int* y)
{
    int tmp = *x;
    *x = *y;
    *y = tmp;
}
// 向下调整算法
void AdjustDown(int* a, int n, int parent)
{
    // 假设 parent 的左右子树已经是大堆,
    // child 先指向左孩子
    int child = parent * 2 + 1;
    // child >= n 时,说明孩子不存在,
    // parent 已经指向叶子结点,调整结束
    while (child < n)
    {
        // 比较左右孩子,让 child 指向较大的孩子
        if (child + 1 < n && a[child + 1] > a[child])
        {
            ++child;
        }
        // 如果孩子大于父亲,则交换,并继续向下调整
        if (a[child] > a[parent])
        {
            Swap(&a[child], &a[parent]);
            parent = child;
            child = parent * 2 + 1;
        }
        else
        {
            break;
        }
    }
}
void HeapSort(int* a, int n)
{
    /* 建堆:O(N),升序排序:建立大堆,降序排序:建立小堆 */
    for (int i = (n - 2) / 2; i >= 0; --i)
    {
        AdjustDown(a, n, i);
    }
    // 依次将堆顶元素交换到数组末尾
    int j = 1;

    while (j < n)
    {
        // 将第 j 大的元素放到倒数第 j 个位置
        Swap(&a[0], &a[n - j]);
        // 排除已经有序的末尾部分,重新调整为大堆
        AdjustDown(a, n - j, 0);
        ++j;
    }
}
测试代码:
cpp
void TestHeapSort()
{
    int a[] = {9, 1, 2, 5, 7, 4, 6, 3};
    int n = sizeof(a) / sizeof(int);

    PrintArray(a, n);
    HeapSort(a, n);
    PrintArray(a, n);
}
建堆不是 O(n log n),而是 O(n):越靠近底层,结点越多但可下沉的高度越小;把所有结点的调整代价累加,结果为线性级。之后要执行约 n - 1次堆顶交换与向下调整,每次最多 O(log n),所以排序阶段为 O(n log n)。
2. 复杂度与稳定性
时间复杂度:最好、平均、最坏均为 O(n log n);
空间复杂度:O(1);
稳定性:不稳定。
不稳定的原因仍是远距离交换。堆顶记录与末尾记录交换时,可能跨过多个相同关键字,破坏它们原有的相对次序。
堆排序的优势是最坏情况也有 O(n log n) 保证,而且原地;缺点是访问不连续、缓存局部性通常不如快速排序,常数开销也不算小。
总结:
数据量小或数组接近有序:优先直接插入排序。
希望保持原地、代码不复杂,又想明显快于普通 O(n²) 排序:可考虑希尔排序。
关键字比较昂贵,但元素交换非常昂贵且数据规模不大:简单选择排序交换次数少,可能有价值。
需要最坏 O(n log n)、只能使用常数额外空间:堆排序是可靠选择。
必须稳定:本篇算法中优先直接插入;希尔、简单选择和堆排序都不稳定。