目录
引言
在之前的文章中,我带大家讲解了在Linux系统中进程的相关概念,包括进程的基本概念、进程状态,进程切换等一系列知识,了解了进程的底层原理。接下来,我将带大家了解进程控制相关的内容,学习进程到底该怎么使用
1、进程创建
进程创建在我们之前的文章中就有接触过了,主要就是利用fork这个系统调用函数来创建子进程,接下来我们来简单回顾一下。
fork函数会创建一个新的进程,并且给父进程返回创建的子进程的pid,给子进程返回0。在创建时,子进程会将父进程的代码和数据全部拷贝一份,并且继续执行后面的代码。当子进程要对父子共享的变量进行修改时,会触发写时拷贝,为什么要有写时拷贝呢?因为当父进程里数据个数特别多时,如果创建子进程时每个子进程都拷贝一份,效率就会变低,而且子进程也不太可能对父进程里的每一个数据都进行修改,如果都拷贝一份就浪费了太多的空间,所以编译器选择在子进程不修改数据时父子进程共享数据,你要修改哪个数据,再拷贝一份出来给你修改。
2、进程终止
一个进程退出时,可能会有三种退出场景。场景一:代码运行完毕,结果正确;场景二:代码运行完毕,结果错误;场景三:代码异常终止。那么我们在平常使用时,该怎么知道我们的进程到底是怎么退出的呢?接下来我们就来学习一下。
相信很多人从C语言学习之初就一直有一个疑问,我们每次写main函数时都要在后面写一个return 0,这个返回值返回给了谁呢?返回值是否有特殊的意义呢?
main函数的返回值就表明了你的程序执行情况,如果代码运行结果正确,就返回0,如果代码运行结果不正确就返回非0,不同的值表示不同的出错原因,这个返回的数字被称为退出码。我们可以通过一个代码来看一下都有多少种退出码以及它们的退出原因都是什么。
cpp
#include<iostream>
#include<cstring>

int main()
{
     for (int i = 0; i < 200; i++)
     {
         printf("%d->%s\n", i, strerror(i));
     }
     return 0;
}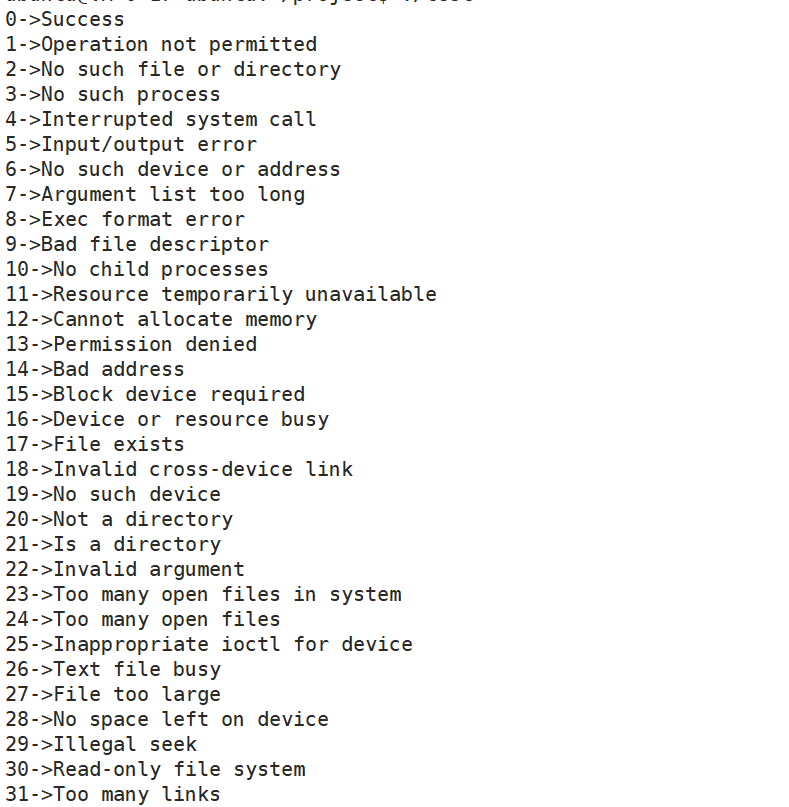
通过这个代码我们就可以看到在C语言标准库中有多少种退出码以及都代表着什么错误原因,以上是我截出来的一部分,实际上总共有133个退出码。我们也可以用一个指令来获取最近退出的一个程序的退出码。
bash
echo $? //获取最近退出的一个程序的退出码
可以看到上一个程序我们执行成功了,退出码就为0。那这个退出码是返回给谁的呢?相信很多人已经猜到了,就是返回给父进程的,为了获取子进程的执行情况,父进程需要获取子进程的退出码,return返回的返回值就是main函数的退出码。进程退出码会被写进进程的task_struct内部,这也是为什么会有僵尸状态的原因之一。所以我们平常在命令行中输入命令时,如果命令执行失败也会打印失败原因,这个失败原因也是根据退出码来打印的。
但是以上都是必须在进程正常退出的前提下才能成立的,如果进程异常退出,退出码就无意义了。因为代码压根就没执行完成,要退出码也没有意义。
至于父进程是如何获取退出码,又是如何知道程序是异常退出的,我们到后面进程等待的部分一起进行讲解。
exit和_exit
除了main函数结束时进程自动结束之外,还有一种方式可以结束一个进程,就是使用exit或_exit函数。在代码的任何一个地方调用exit,便是进程立即结束,后续代码也不再执行,并返回子进程的退出码给父进程,具体用法如下
cpp
exit(退出码) //括号内填退出码_exit功能上也与exit一致,那它们两个有什么区别呢?exit是C语言内部自己的函数,在使用exit退出时,编译器会进行一系列收尾工作,比如刷新缓冲区之类的,然后再结束进程。而_exit是系统调用函数,使用它的话会直接从系统层面将整个进程结束,不会进行对应的收尾工作。
3、进程等待
首先,为什么进程需要等待?这个原因我们之前也提到很多次了:1、子进程要退出,如果父进程不管,就可能造成僵尸进程的问题,从而导致内存泄漏。2、父进程要获取子进程的运行结果,父进程通过进程等待的方式,回收子进程资源,获取子进程退出信息。
wait
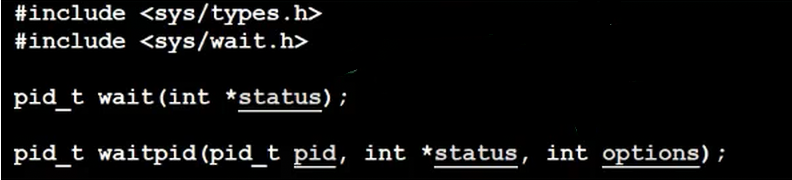
我们可以通过两个系统调用来进行进程的等待,wait和waitpid。wait的作用是等待任意一个退出的子进程,并获取子进程的pid,至于后面的参数部分我们在讲解waitpid时再一起讲。如果父进程的代码运行到wait所在行时,没有一个子进程退出,那么父进程就会阻塞在这一行,直到有任意一个子进程退出为止。
waitpid
waitpid比wait多了两个参数,现在我们来讲讲这三个参数的作用。
第一个参数,很明显,它表示的是你想等待的子进程的pid,可以指定等待某个子进程。如果传-1,就代表等待任意一个子进程,与wait等价。
第二个参数,*status,这个参数比较重要,它是用于获取子进程的退出信息的,里面不仅有退出码,还有信号。status这个参数在内部其实是一个位图结构,位图结构我们之前在讲进程调度时有提到,这里就不再重复说了,int类型的对象里总共有32个比特位,在这个系统调用中,我们只使用这个对象的低16位,也就是0~15位比特位。
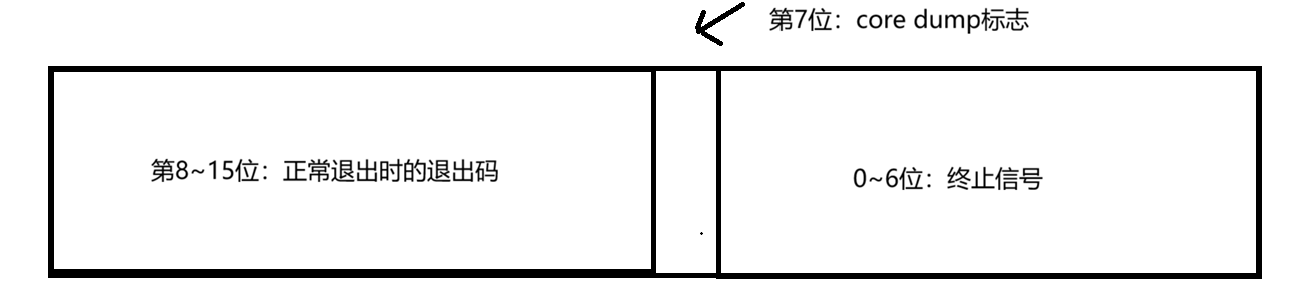
这16个比特位都存储了什么信息呢?在这16位里,8~15位这段比特位存储的就是就是退出码的信息,当这8个比特位全为零时,就代表程序运行正确;若不为零,按二进制转十进制后为多少退出码就为多少。
第7位这个位置存储的是core dump标志,这个我们赞数不做了解,到后期进行信号的学习时我们才会讲解它。
第0~6这七个比特位中存储的是终止信号,如果代码运行时出现异常,比如出现了野指针,堆溢出等问题时,程序就会异常终止,并且获取异常信号,将信号存储到这7个比特位内部,如果这7个比特位全为零,就表示程序正常退出,没有异常信息,若不为就转换为十进制数并获取退出信号。
父进程在获取退出码和异常信息时,顺序是:先检查终止信号是否为零,若终止信号不为零,就获取终止信号,不再看退出码为多少;若终止信号为零,再获取退出码,获取退出信息。操作系统中提供了两个宏,一个是WEXITSTATUS(status),若status非零,就提取退出码,不用我们自己进行位运算了;另一个是WIFEXITED(status),检测信号值是否为零,也就是子进程是否正常退出。
上述一系列操作,waitpid是怎么做到的呢?信息是从哪里拿到的呢?其实在task_struct里有对应的一系列变量来专门存储这些信息,父进程通过调用waitpid这样的系统调用,通过操作系统提供的接口找到子进程中用于存储这一部分信息的变量,通过位操作拿到这些信息,之前的getpid和getppid也是类似的原理。
最后一个参数options。options值表示waitpid用什么方式等待子进程退出。options默认值为0,当其为默认值时,waitpid为阻塞调用状态,意思是没等到子进程就不返回。还可以设置为WNOHANG,当设置为这个值时,则为非阻塞调用,意思是如果当前没有子进程正处于僵尸状态,或指定的子进程还在运行,没进入僵尸进程状态,就立刻返回。简单来说就是,waitpid会去检测一遍子进程,如果子进程结束了,就回收信息,如果子进程没有结束,就返回零,并继续执行后面的代码,而不像之前一样一直等在那里直到子进程结束。
所以我们要进行非阻塞轮询,就是通过循环每隔一段时间检查一次子进程状态,在这一段时间内父进程可以继续进行自己的操作,返回值大于零则表示等待成功,等于零表示继续等待,小于零代表等待失败。
4、进程程序替换
在我们的程序中,我们也可以进行替换要执行的程序,比如我们创建了一个子进程,但是并不想让它接着执行后面的代码,而是想让它执行别的程序的代码,就可以进行进程程序替换。
进程程序替换的原理是:当我们用函数指名要替换的进程的路径时,当系统执行这条指令时,会从磁盘上找到这个程序,将程序内的代码和数据分别替换进我们当前程序的代码段和数据段,相当于将后面的所有代码和数据都覆盖了,一代程序替换成功,就去执行新代码了,原始代码的后半部分已经不存在了,我们可以写个简单的程序替换来看看效果。
cpp
#include<iostream>
#include<unistd.h>
#include<sys/types.h>
using namespace std;

int main()
{
    printf("我是一个进程,进程开始\n");
    pid_t id = fork();
    if (id == 0)
    {
        execl("/usr/bin/ls", "ls", "-a", "-l", NULL);
    }
    sleep(1);
    printf("进程结束\n");
    return 0;
}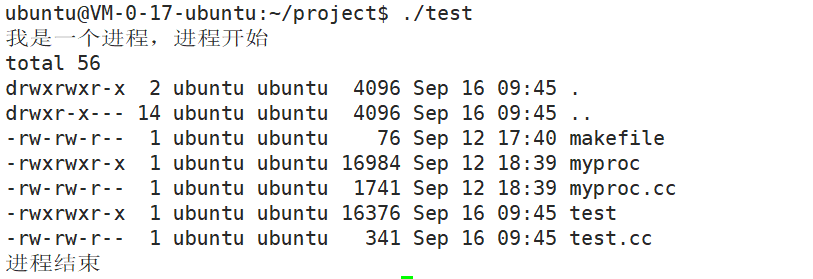
可以看到我们的子进程就执行了"ls -a -l"这一串代码。接下来我们来介绍一下exec这个系列的使用方式。首先是execl,第一个参数为要替换的路径和程序名,后面的参数我们可以看到是可变参数,在命令行中我们是怎么写这个命令的,我们在后面也怎么写就行了,就像我上面的演示代码中那样,命令名和选项之间用逗号隔开,需要注意的是必须以NULL结尾表示参数传递完成。
cpp
execl(const char* path,cosnt char* arg,...);其他的函数都是在execl的基础上进行的,就不写代码了。execlp,第一个参数变为只需要传文件名,不需要传路径,execlp会自动在环境变量中查找指定的命令。
execv,其他地方与execl完全一样,只有传命令的格式不一样,execl是直接在括号内传一串命令,execv是传一个命令行参数表,也就是一个指针数组。
execvp,与execlp同理。
execvpe、execlpe,在前两者的基础上将环境变量也传过去。
结语
本文梳理了Linux进程控制四大核心:进程创建、进程退出、进程等待与程序替换。进程退出标记生命周期结束,wait/waitpid用于回收子进程,避免僵尸进程;exec系列系统调用实现程序替换,在保留进程资源的前提下加载新程序。理解这套机制,能看清进程从创建到消亡的完整流程,也是操作系统并发编程的重要基础。