论文题目:Spherical Transformer for LiDAR-based 3D Recognition (用于 LiDAR 三维识别的球面 Transformer)
会议:CVPR 2023
摘要:LiDAR 三维点云识别已经广泛用于自动驾驶与机器人等场景,但大多数方法没有专门考虑 LiDAR 点云随距离变化的稀疏分布,因此容易出现信息断连和感受野受限的问题,尤其影响远距离稀疏点。本文研究 LiDAR 的 varying-sparsity 特性,并提出 SphereFormer,使远距离稀疏点能够直接从近距离密集区域聚合信息。核心模块是 radial window self-attention:将空间划分为多个互不重叠、狭长的径向窗口,从而在单个操作中显著扩大感受野。为了适配这种长而窄的窗口,作者进一步提出 exponential splitting 获得更细粒度的位置编码,并利用 dynamic feature selection 让不同位置的点自适应选择局部或全局信息。SphereFormer 在 nuScenes 和 SemanticKITTI 语义分割 benchmark 上分别达到 81.9% 和 74.8% mIoU,并在 nuScenes 3D 检测 benchmark 上取得 72.8% NDS、68.5% mAP。
源码:https://github.com/dvlab-research/SphereFormer
一、研究背景:真正困难的是远距离稀疏点
室外 LiDAR 有一个非常明确的物理特性:距离传感器越近,点越密;距离越远,点越稀疏。 但很多已有方法仍然在所有位置使用相同的局部算子,例如 SparseConv 或普通 cubic-window attention,没有显式适配这种 varying-sparsity 分布。
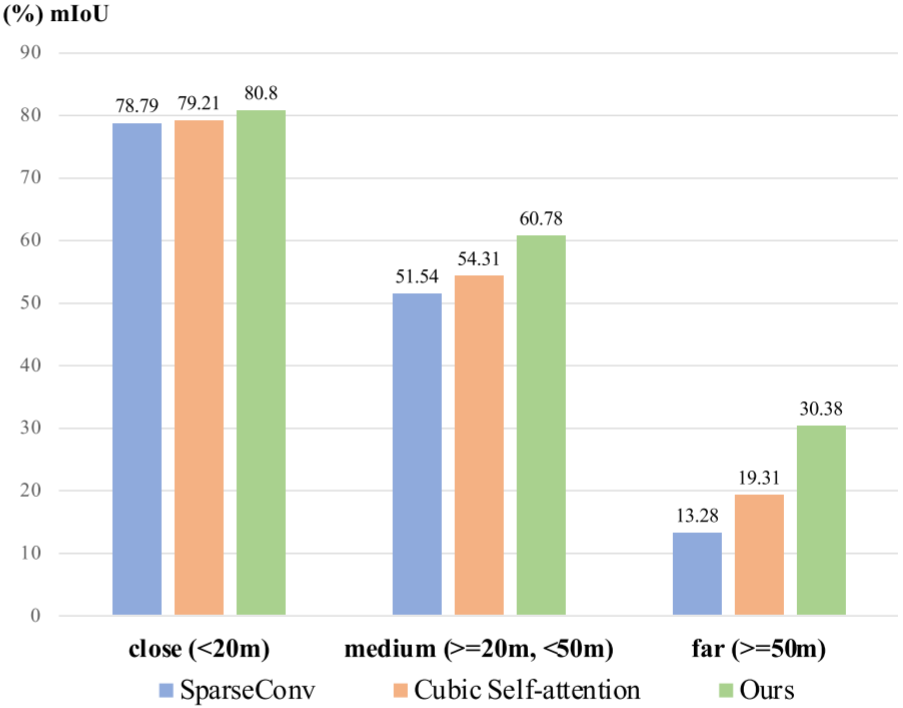
论文 Figure 1:不同距离区间上的 nuScenes 语义分割性能
Figure 1 很直观地说明了问题。SparseConv 对近距离点的 mIoU 已经达到 78.79% ,但 50 m 以外的 far points 只有 13.28% ;换成普通 cubic self-attention 后,远距离也仅提升到 19.31%。SphereFormer 则把 far-point mIoU 提升到 30.38%。
作者认为根本原因不是网络"不够深",而是 information disconnection。远处点太稀,周围邻居数量不足,局部算子即使不断堆叠,也很难把有效信息传播过去,因此 Effective Receptive Field 无法真正扩展。
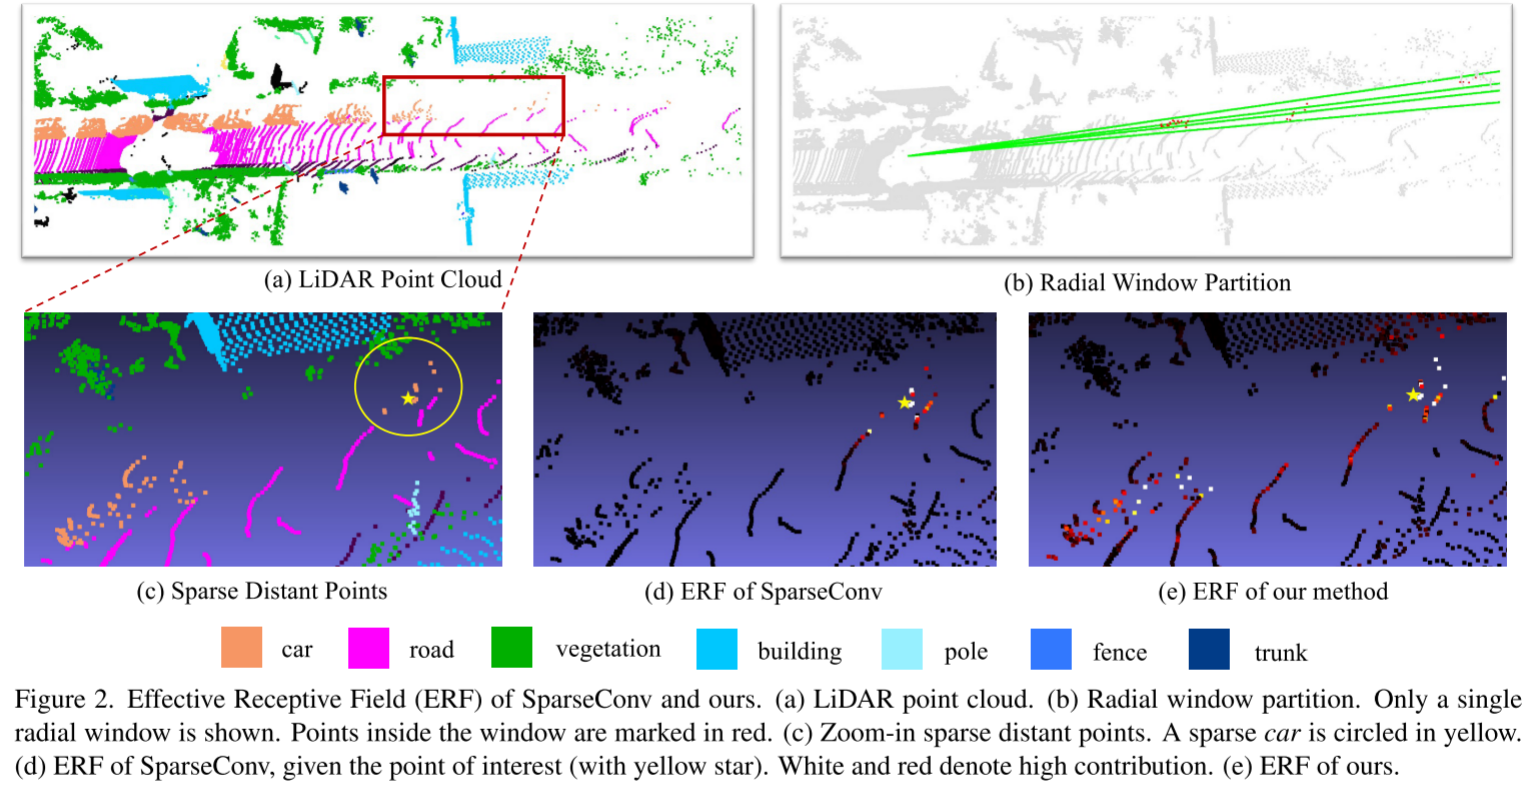
论文 Figure 2:SparseConv 与 SphereFormer 的 Effective Receptive Field 对比
Figure 2 中,SparseConv 对远处车辆的有效感受野基本被限制在稀疏局部区域,而 SphereFormer 可以沿径向窗口直接连接到近处密集区域。也就是说,它不是靠"多堆几层"扩大感受野,而是直接改变邻域连接方式。
二、SphereFormer:把局部立方体换成长条径向窗口
SphereFormer 采用 spherical coordinate (r, θ, ϕ) 表示点云,并且只沿 θ 和 ϕ 两个角度方向进行空间划分,从而得到多个互不重叠的 radial windows。每个窗口不是局部立方体,而是从 LiDAR 原点向外延伸的狭长区域。
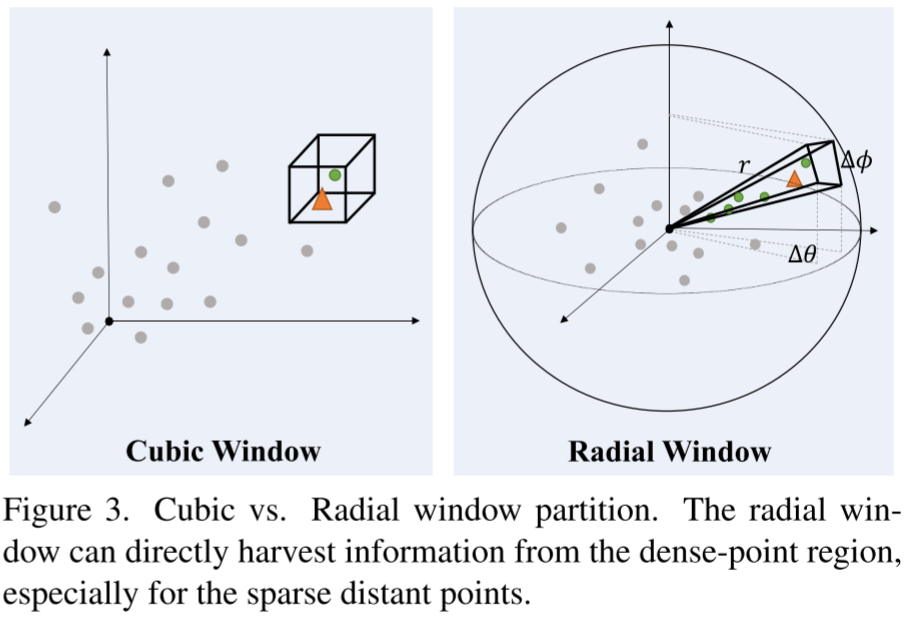
论文 Figure 3:Cubic Window 与 Radial Window 的对比
径向窗口中,远距离点和同一方向上的近距离点可以直接进入同一个 attention window,因此远处稀疏点能够在一次 self-attention 中获得来自近处密集区域的上下文。窗口索引为:
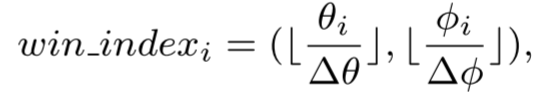
其中 Δθ 和 Δϕ 分别表示两个角度维度上的窗口大小。同一个 window 内再进行标准 multi-head self-attention。
作者特别强调 SphereFormer 是一个 plugin module,可以插入 SparseConvNet、MinkowskiNet 或局部窗口 Transformer 等 backbone。论文实验中,语义分割以 SparseConv 为 baseline,把 SphereFormer 放在每个 encoder stage 的末尾;检测任务则以 CenterPoint 为 baseline,插入第二、第三 stage。
与 Cylinder3D 有什么不同?
这篇论文也专门比较了 Cylinder3D。两者都利用极坐标/球坐标适配 LiDAR 分布,但目标不同:Cylinder3D 更强调让不同距离区域的点分布更均衡,本质上仍然使用局部邻居;SphereFormer 则直接改变邻域连接方式,让远处点跨长距离获取近处信息。因此它解决的核心问题不是 voxel density,而是 receptive field 与 information disconnection。
三、Exponential Splitting:长窗口下的位置编码
径向窗口虽然扩大了感受野,但也带来新的问题:一个窗口的 r 方向可能超过 50 m。如果仍然像普通局部窗口一样对相对距离均匀离散,区间会非常粗,两个实际距离差异较大的点可能落入同一个 position bin。
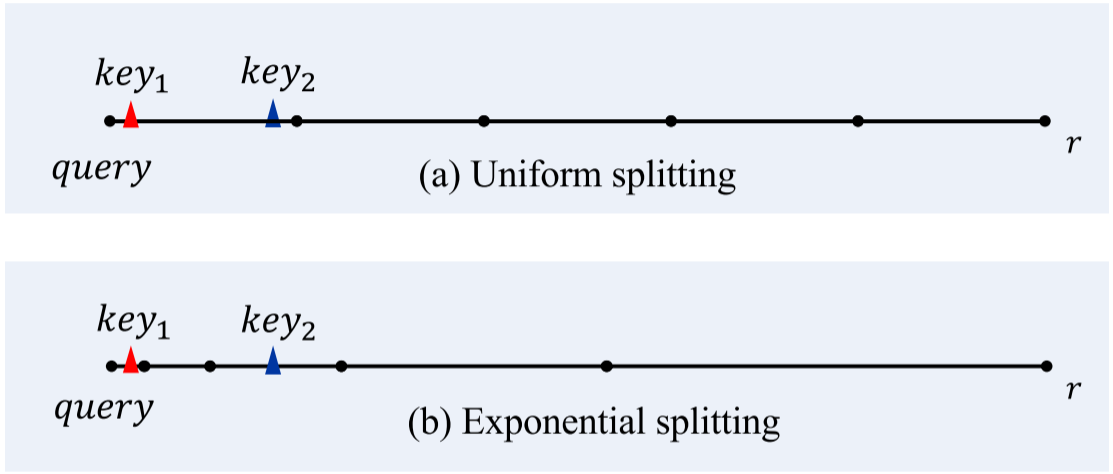
论文 Figure 4:Uniform Splitting 与 Exponential Splitting 对比
作者因此对 r 方向采用 exponential splitting :靠近 query 的区域划分得更细,距离越远,区间逐渐指数增大;而 θ 和 ϕ 方向仍使用均匀划分。
直观上,这个设计符合几何需求:近距离 token pair 的相对位置更重要,需要细粒度区分;远距离 pair 本身就不需要那么精细的位置刻画。这样在 embedding table 长度不增加的情况下,可以同时兼顾近距离精度和长距离覆盖。
四、Dynamic Feature Selection:近点和远点不能一视同仁
仅使用 global radial context 也不是最优方案。近距离点本身已经拥有大量密集邻居,例如近处汽车的局部几何通常足够清晰;如果强行注入太多全局信息,反而可能带来干扰。远距离点则相反,更依赖长程上下文。
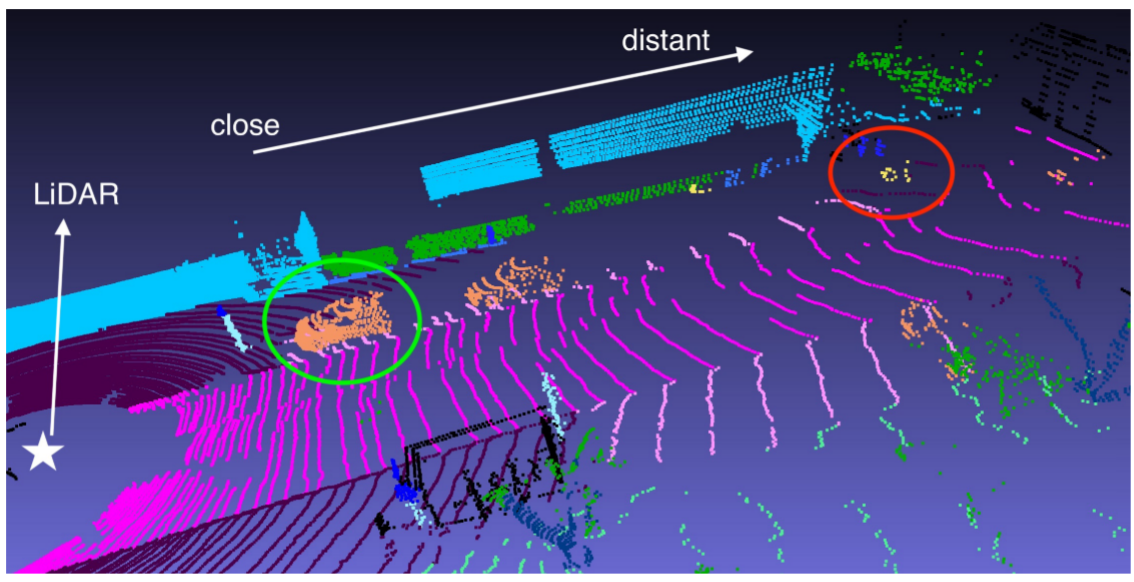
论文 Figure 5:近距离密集车辆与远距离稀疏自行车的点分布差异
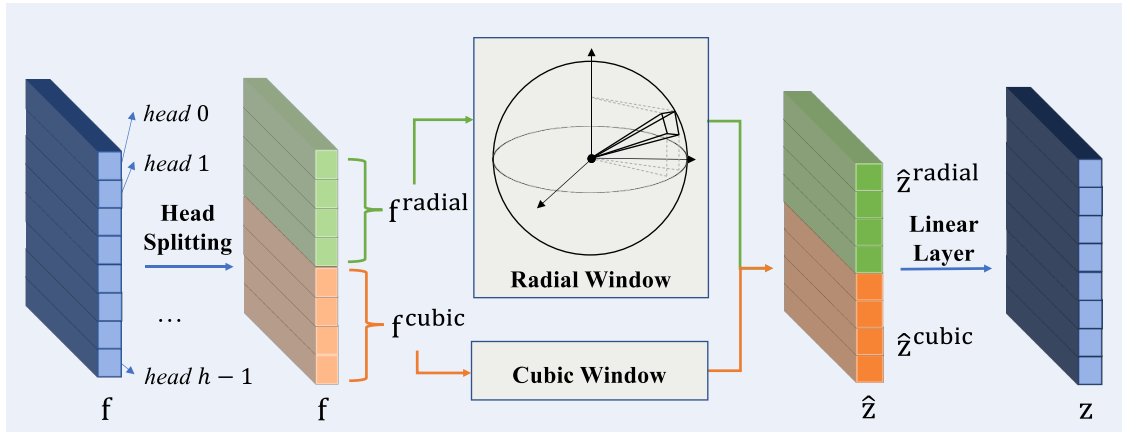
论文 Figure 6:Dynamic Feature Selection 结构
作者将 multi-head attention 的一半 heads 用于 radial-window attention ,另一半用于 cubic-window attention,最后把两部分特征拼接并线性投影。这样不同 query 可以通过后续特征融合,自适应地利用局部与全局信息。
因此 SphereFormer 并不是简单地"把所有 local attention 换成 global attention",而是保留两种尺度:远处缺几何时补 global context,近处信息充足时保留 local structure。
五、实验结果与消融分析
5.1 SemanticKITTI 与 nuScenes
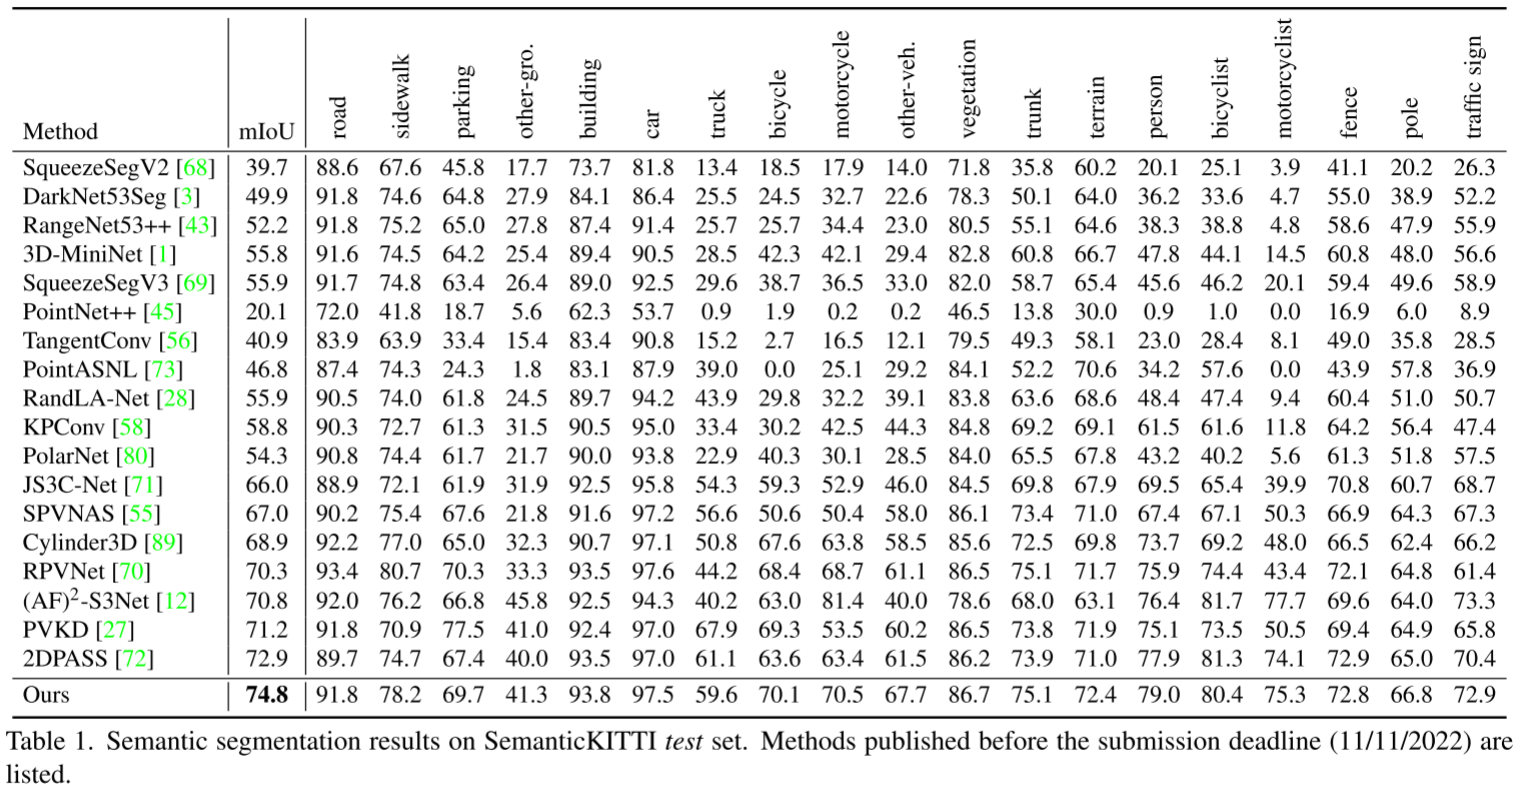
论文 Table 1:SemanticKITTI test set 语义分割结果
SphereFormer 在 SemanticKITTI test set 达到 74.8% mIoU,高于表中的 2DPASS 72.9、PVKD 71.2 和 Cylinder3D 68.9。值得注意的是,2DPASS 训练阶段还使用了额外图像信息,而 SphereFormer 为 LiDAR-only。
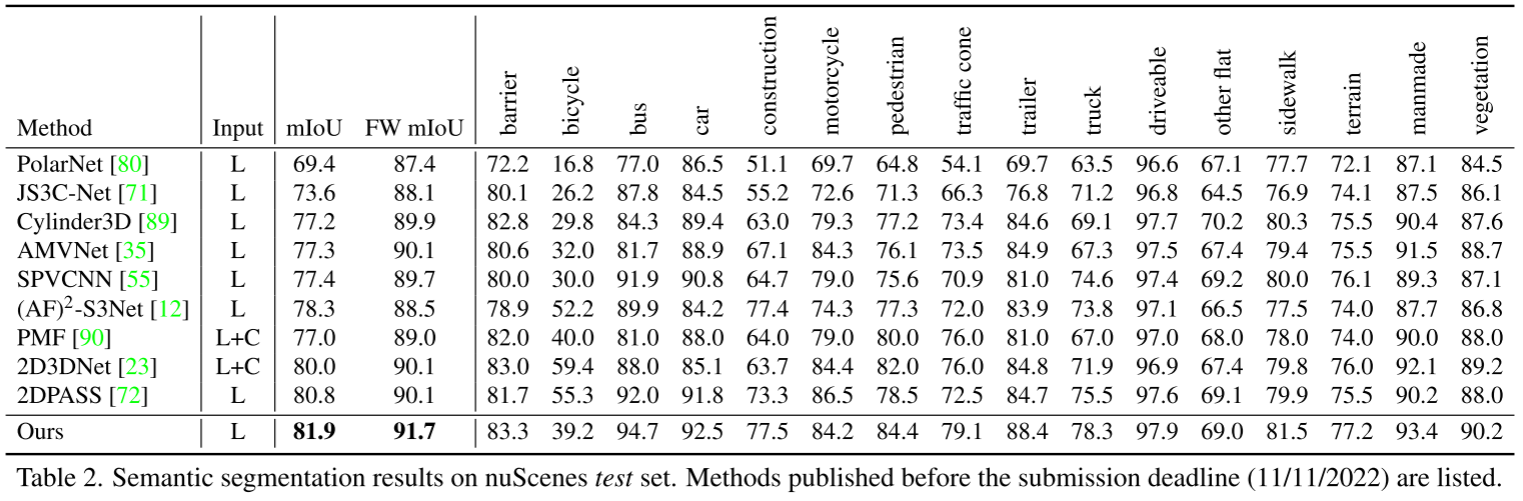
论文 Table 2:nuScenes test set 语义分割结果
nuScenes test 上,SphereFormer 达到 81.9% mIoU,高于 2DPASS 的 80.8、2D3DNet 的 80.0 以及 Cylinder3D 的 77.2,并在论文提交时排名第一。
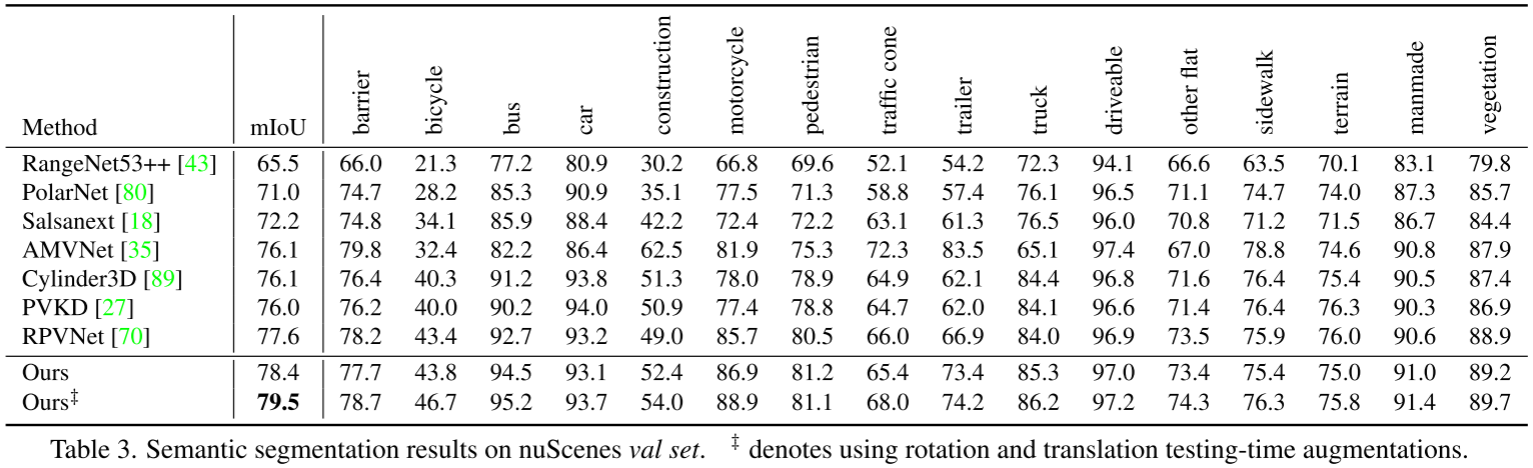
论文 Table 3:nuScenes validation set 结果
nuScenes val 上,不使用测试时增强时为 78.4% mIoU ;加入 rotation 和 translation test-time augmentation 后达到 79.5%。
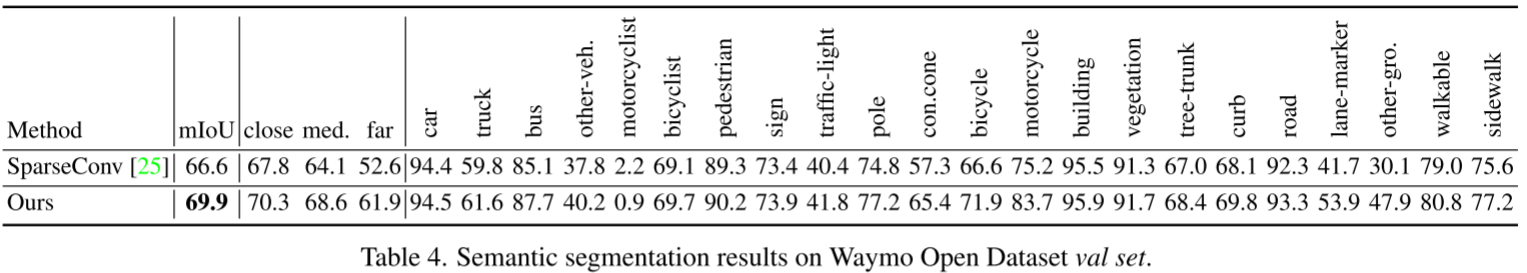
论文 Table 4:Waymo Open Dataset validation set 结果
在 Waymo 上,SphereFormer 将 SparseConv baseline 的 mIoU 从 66.6 提升到 69.9 。更关键的是,far points 从 52.6 提升到 61.9 ,增加 9.3 个点,再次验证方法主要改善远距离稀疏区域。
5.2 核心模块消融
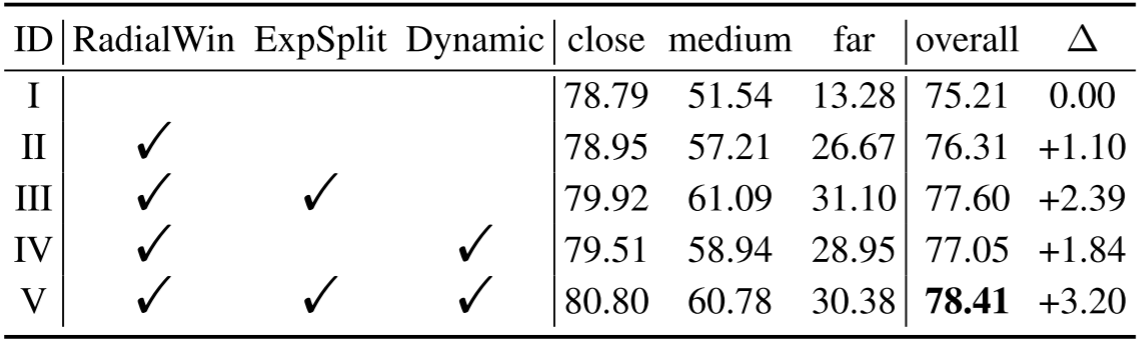
论文 Table 5:Radial Window、Exponential Splitting 和 Dynamic Feature Selection 消融
SparseConv baseline 的 overall mIoU 为 75.21 。只加入 radial window 后提升到 76.31 ,其中 medium 和 far 分别提升 5.67 和 13.39 个点;进一步加入 exponential splitting 后达到 77.60 ;三者全部加入后达到 78.41。
Dynamic Feature Selection 带来约 0.8 mIoU 的整体增益,而且提升主要来自 close points。这与方法动机一致:近距离点不需要过度依赖全局信息,保留 cubic local context 更合理。
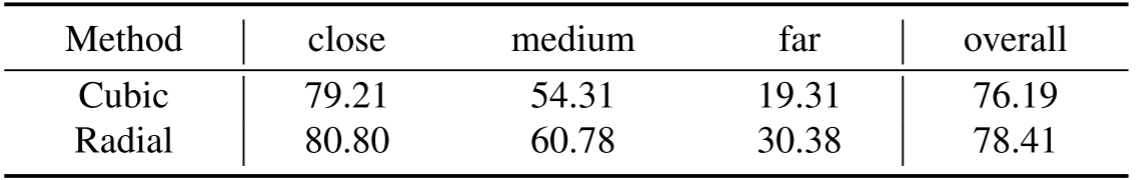
论文 Table 6:Radial Window 与 Cubic Window 的直接对比
使用 cubic window 时 far-point mIoU 为 19.31 ,radial window 达到 30.38 ;整体 mIoU 也从 76.19 提升到 78.41。这个结果直接说明,SphereFormer 的收益并不只是"用了 Transformer",而主要来自 window geometry 与 LiDAR 分布的匹配。
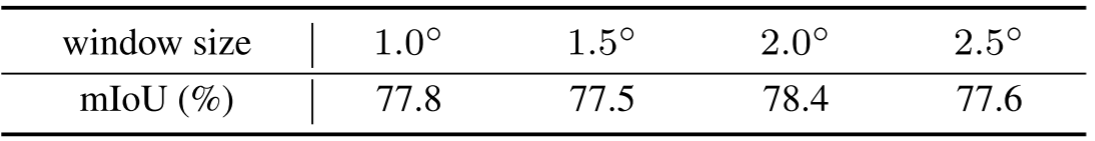
论文 Table 7:不同角度窗口大小的影响
θ/ϕ = 2.0° 时性能最好,为 78.4 mIoU。窗口过小不易获得足够长程信息,过大则增加优化难度,因此 radial window 仍需要控制合适的角度范围。
5.3 3D Object Detection
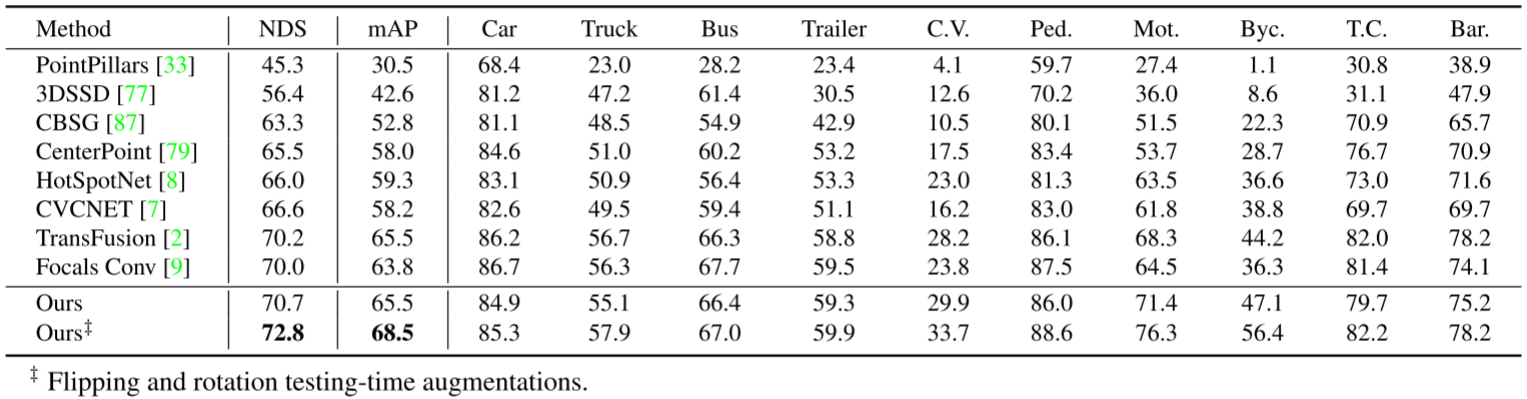
论文 Table 8:nuScenes test set 3D object detection 结果
以 CenterPoint 为基础加入 SphereFormer 后,模型达到 70.7 NDS / 65.5 mAP ;使用 flipping 和 rotation 测试增强后进一步达到 72.8 NDS / 68.5 mAP,在当时 nuScenes LiDAR-only detection benchmark 排名第三。说明 radial long-range aggregation 不只对语义分割有效,也可以迁移到实例级检测任务。
5.4 定性结果
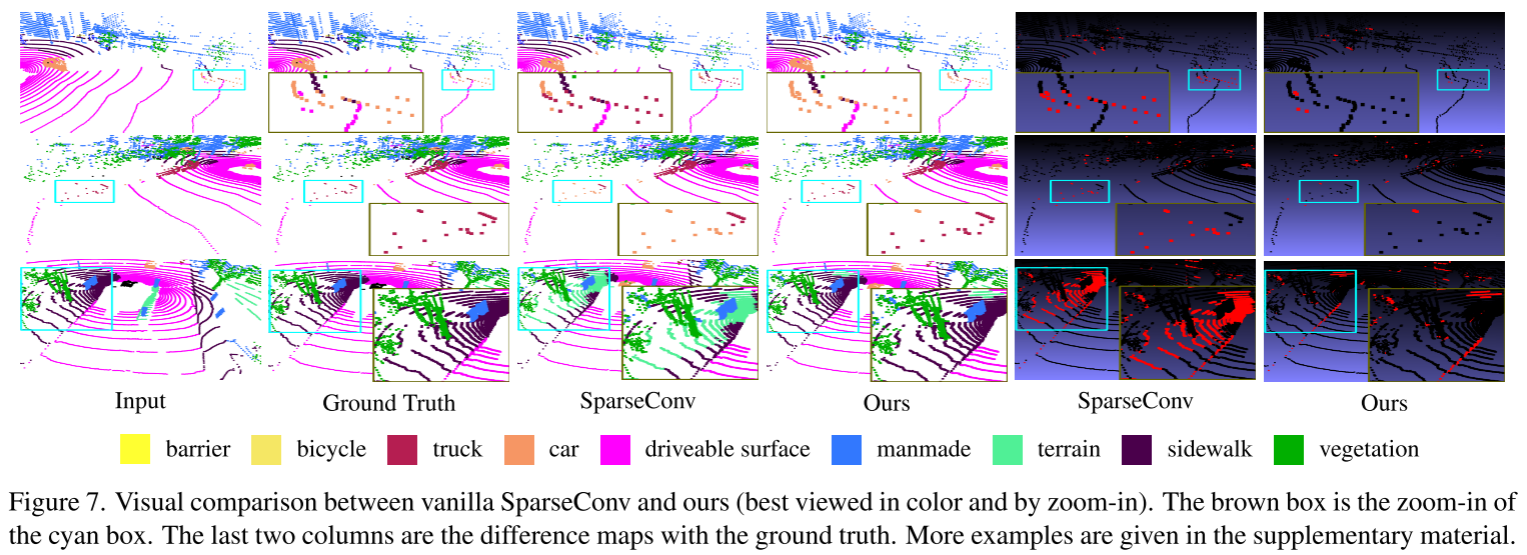
论文 Figure 7:SparseConv 与 SphereFormer 的可视化比较
Figure 7 中,作者重点标出了远距离稀疏物体。相比 SparseConv,SphereFormer 能识别更多 distant objects,差异图中的错误区域也明显减少,与前面的距离分段实验形成了完整证据链。
六、总结与思考
如果把 SphereFormer 压缩成一句话,它的核心思想是:
不要让所有 LiDAR 点都使用相同形状的局部邻域,而应该利用传感器中心的几何结构,让远距离稀疏点直接连接近距离密集区域。
这篇论文最有价值的地方不是 Transformer 本身,而是先抓住了 LiDAR 的 varying-sparsity,再让 window shape、position encoding 和 feature selection 全部围绕这一特性设计。Radial Window 解决"看不远",Exponential Splitting 解决"长距离位置编码太粗",Dynamic Feature Selection 解决"近点和远点需求不同"。
从后续研究角度看,SphereFormer 提供了一个很有启发性的方向:邻域设计不一定只由欧氏距离决定,也可以由传感器成像几何、距离和点密度共同决定。 对 LiDAR segmentation 来说,这比单纯扩大 KNN、增加 dilation 或堆叠更多 attention 层更值得继续研究。