论文题目: FE-CLIP: Frequency Enhanced CLIP Model for Zero-Shot Anomaly Detection and Segmentation
中文翻译: FE-CLIP:面向零样本异常检测与分割的频率增强 CLIP 模型
会议: ICCV 2025
摘要: 零样本异常检测(ZSAD)要求模型利用辅助数据训练后,在目标数据集完全没有训练样本的情况下检测异常。近年来 WinCLIP、AnomalyCLIP 等 CLIP-based 方法依靠视觉语言模型强大的零样本迁移能力取得了较好效果,但大多只在空间域和语义层面建模,忽略了图像频率信息。FE-CLIP 从"异常区域在频域上也会产生可辨识变化"这一观察出发,在 CLIP 视觉编码器中引入 Frequency-aware Feature Extraction(FFE)和 Local Frequency Statistics(LFS)两个互补适配器,并通过 DCT 挖掘局部频率模式。实验覆盖工业缺陷和医学异常等 10 个数据集,结果表明频域信息能够有效增强跨域零样本异常检测和异常分割能力,同时也能用于 Few-Normal-Shot 场景。
一、研究动机:为什么异常检测还要看频域?
Zero-Shot Anomaly Detection 的困难在于:测试时面对的目标数据集没有任何训练样本,模型必须把从其他数据中学到的"正常 / 异常"概念迁移过去。
CLIP 经过大规模图文预训练,可以利用 "normal object" 和 "damaged object" 等文本语义判断异常。但 FE-CLIP 注意到一个此前较少被利用的信息源:频率。 裂纹、孔洞、印痕等缺陷常伴随局部纹理和边缘变化,转换到频域后可能比空间域更容易区分。
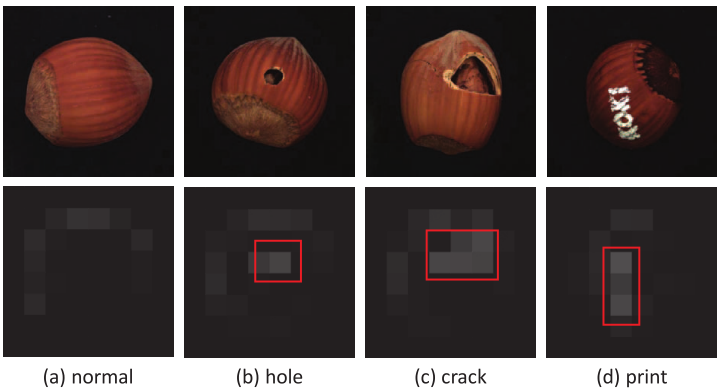
论文 Figure 1:正常样本以及 hole、crack、print 异常区域的局部频率统计对比
Figure 1 给出了最直接的动机:异常区域对应的局部频率统计,与周围正常区域以及正常图像相同位置都存在差异。作者因此提出一个很自然的问题:
既然 CLIP 已经提供了强语义迁移能力,能不能再给它补充一条"频率异常"线索?
FE-CLIP 的答案就是:在不破坏 CLIP 原有知识的前提下,把频域建模嵌入视觉编码过程。
二、整体框架:空间语义 + 两条频率支路
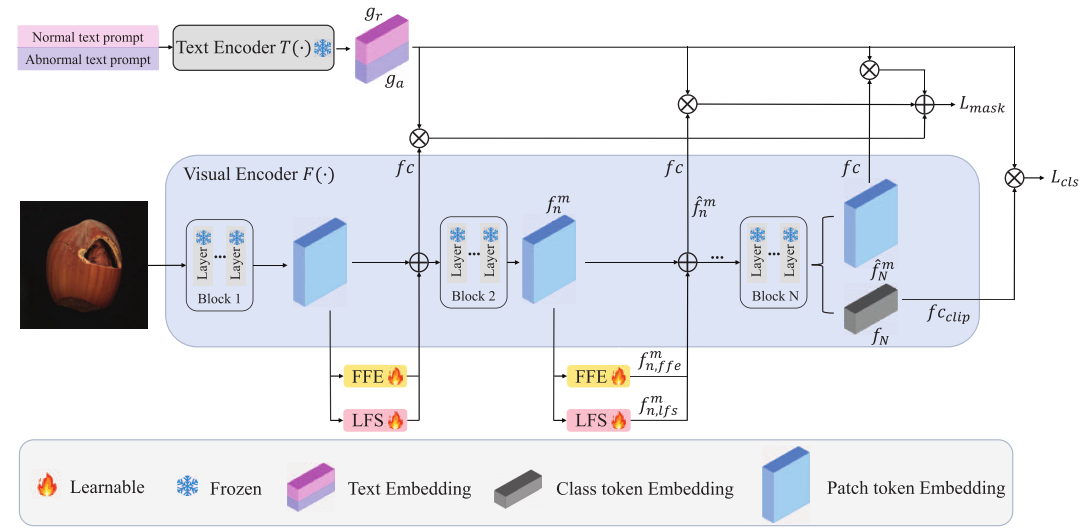
论文 Figure 2:FE-CLIP 整体框架
FE-CLIP 保留 CLIP 的文本编码器和视觉编码器,并冻结原始 CLIP 参数,只在视觉编码器的多个 Block 中加入两个可学习模块:
-
FFE:Frequency-aware Feature Extraction Adapter
-
LFS:Local Frequency Statistics Adapter
假设第 (n) 个视觉 Block 输出 Patch Token (),FFE 和 LFS 分别输出两种频率特征,再与原始空间特征融合:
论文设置 (。也就是说,模型仍以原始 CLIP 表征为主,频域信息只作为辅助增量注入,这样可以尽量保留 CLIP 的预训练知识。
文本端反而非常简单,只使用两个 Prompt:
-
A photo of a normal object -
A photo of a damaged object
两者经过冻结的 CLIP Text Encoder 得到正常与异常文本特征。
在每个 Block 上,Patch Token 与异常文本特征匹配得到局部异常图,Class Token 则产生图像级异常分数,最后对多个 Block 的预测取平均。因此 FE-CLIP 仍保留 CLIP 的核心 Zero-Shot 机制,只是让视觉特征额外具备频率感知能力。
三、两个频域模块到底在做什么?
3.1 FFE:先进入频域,再回到空间域
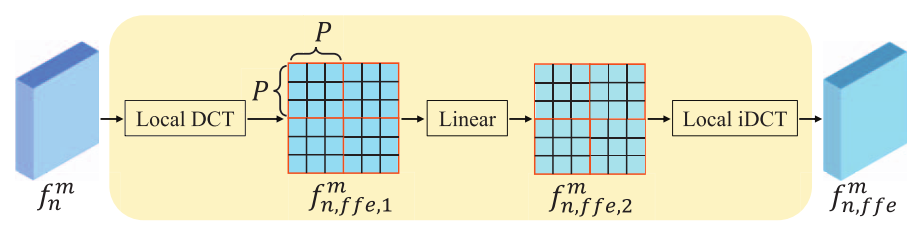
论文 Figure 3:Frequency-aware Feature Extraction(FFE)Adapter
FFE 的目标是让 Patch Feature 本身获得频率感知能力。
对于第 (n) 个 Block 的特征 (f_n^m),作者先把特征图划分成互不重叠的 (P\times P) 小窗口,默认 (P=3)。随后对每个局部窗口执行 DCT,将空间特征转换到频域。
DCT 后的表示经过 Linear 和 GELU,再通过逆 DCT 回到空间域。因此 FFE 的作用不是直接输出频谱,而是利用频域重新加工局部特征,再把频率信息带回空间表示。
3.2 LFS:直接统计局部频率分布
FFE 最终还是回到了空间域,因此作者又设计了第二条支路 LFS,直接显式描述局部频率统计。
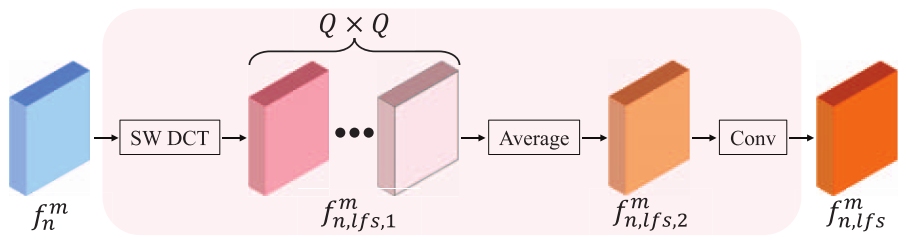
论文 Figure 4:Local Frequency Statistics(LFS)Adapter
LFS 对 Patch Feature 做 Sliding Window DCT。默认窗口大小为 (),其中 (Q=3)。
一个 () DCT 窗口可以产生从低频到高频的多组响应。作者将这些局部频率响应求平均,得到一个与原空间 Feature Map 保持相同位置结构的多通道频率统计图,之后再通过:
得到最终 LFS Feature。
两者并不重复:FFE 让空间特征具备频率意识,LFS 则显式描述局部频率分布。
四、训练与推理:这里的 Zero-Shot 到底是什么意思?
训练时,CLIP 的视觉编码器和文本编码器全部冻结,只优化 FFE、LFS 以及相关对齐层。
图像级异常检测使用二分类损失 (),像素级异常分割同时使用 Focal Loss 和 Dice Loss:
最终:
这里必须注意论文对 Zero-Shot 的定义:FE-CLIP 并不是完全不使用异常数据训练 ,而是做跨数据集迁移。测试其他数据集时用 MVTec AD 辅助训练,测试 MVTec AD 时改用 VisA。因此更准确地说,它属于 Cross-Dataset Zero-Shot Anomaly Detection:模型见过其他数据集的异常,但没有见过目标数据集训练样本。
实验使用 CLIP ViT-L/14@336px,训练 9 个 Epoch,Adam 学习率为 (),Batch Size 为 16,并对 5 次运行结果取平均。
五、实验结果:频率信息到底带来了什么?
5.1 Zero-Shot 图像级异常检测
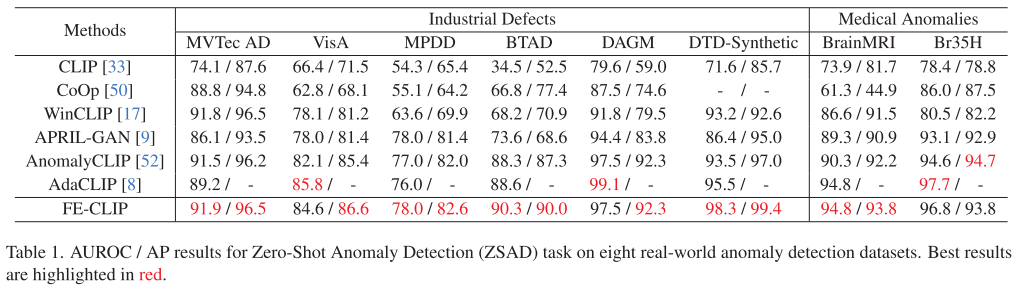
论文 Table 1:8 个工业与医学数据集上的 ZSAD 结果
Table 1 比较的是图像级 AUROC / AP。
FE-CLIP 在多个数据集上取得明显优势。例如:
-
MVTec AD:91.9 / 96.5
-
VisA:84.6 / 86.6
-
BTAD:90.3 / 90.0
-
DTD-Synthetic:98.3 / 99.4
-
BrainMRI:94.8 / 93.8
值得注意的是,FE-CLIP 并非在所有 ZSAD 指标上都绝对第一,例如 DAGM 上 AdaCLIP 的 AUROC 更高。因此更准确的结论是:
FE-CLIP 在大多数数据集上具有较强图像级 Zero-Shot 检测能力,并体现出跨工业与医学领域的泛化能力。
5.2 Zero-Shot 异常分割
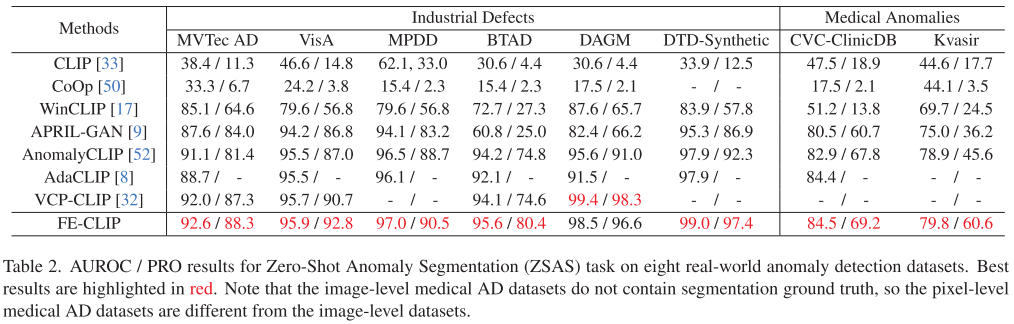
论文 Table 2:8 个工业与医学数据集上的 ZSAS 结果
像素级结果反而是 FE-CLIP 更突出的部分。
例如:
-
MVTec AD:AUROC 92.6 ,PRO 88.3
-
VisA:AUROC 95.9 ,PRO 92.8
-
MPDD:AUROC 97.0
-
BTAD:AUROC 95.6
-
DTD-Synthetic:AUROC 99.0
-
CVC-ClinicDB:AUROC 84.5
FE-CLIP 在 Zero-Shot Anomaly Segmentation 上的优势更稳定。原因是 FFE 和 LFS 直接作用于 Patch Token,频率信息能直接增强局部异常 Feature Map;而图像级分类使用 Class Token,频率信息只能通过 Self-Attention 间接传入全局表征。也就是说,频率信息尤其适合回答**"异常具体在哪里?"**
5.3 两个模块是否都需要?
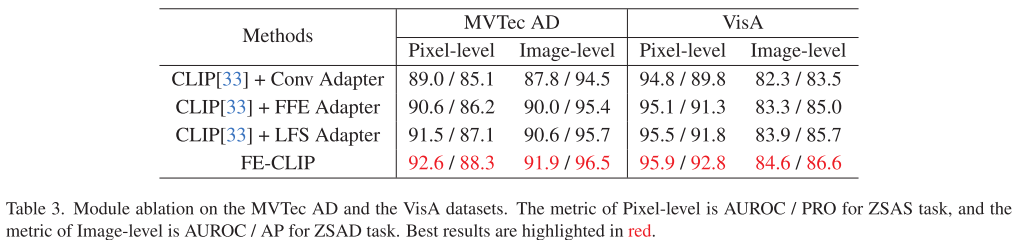
论文 Table 3:FFE 与 LFS 模块消融
在 MVTec AD 上,普通 Conv Adapter 的 Pixel-level AUROC / PRO 为 89.0 / 85.1。
单独使用 FFE 后提升到 90.6 / 86.2 ,单独使用 LFS 后达到 91.5 / 87.1 ,完整 FE-CLIP 则进一步达到 92.6 / 88.3。
VisA 上也有类似趋势。
这说明提升不只是来自"多加参数",而是频域结构本身有效,并且 FFE 与 LFS 具有互补性。
5.4 一定要 DCT 吗?
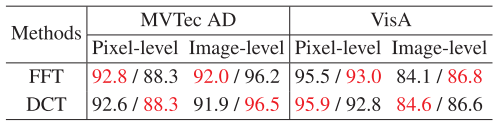
论文 Table 4:DCT 与 FFT 对比
作者进一步把 DCT 换成 FFT。
FFT 和 DCT 的整体性能非常接近,因此关键并不是某一种变换,而是给 CLIP 注入频率信息。作者选择 DCT,主要因为实数计算更方便。
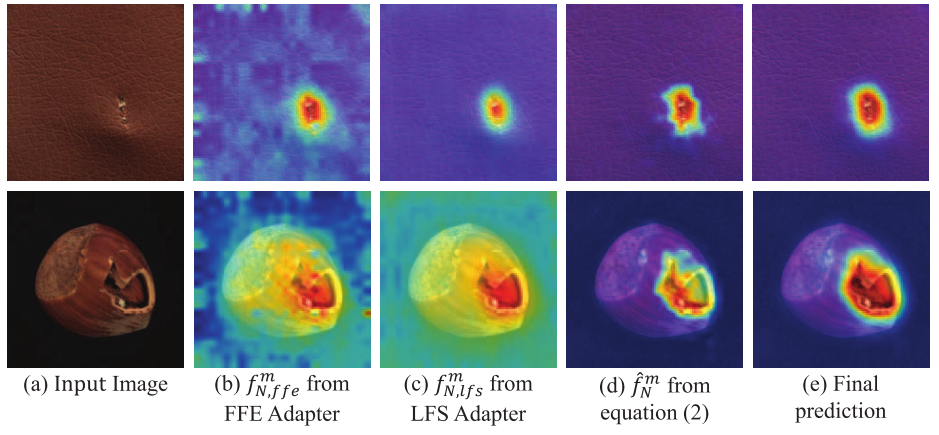
论文 Figure 5:FFE、LFS 以及融合后频率特征的可视化
Figure 5 进一步显示,FFE 和 LFS 学到的响应都能明显聚焦异常区域;经过融合后,最终特征对异常位置的响应更加集中。
六、Few-Normal-Shot:给一两张正常图还能继续提升
FE-CLIP 还研究了 1-shot、2-shot、4-shot 场景。
这里和前面的 Zero-Shot 最大区别是:测试类别现在允许提供少量正常图像。
做法不是重新训练整个模型,而是把这些正常图送入同一个 FE-CLIP Visual Encoder,提取中间 Patch Feature,并存入 Memory Bank。
测试时,对每个输入 Patch Token,寻找 Memory Bank 中最相似的正常 Patch Feature。与正常参考越不像,异常分数就越高。
FE-CLIP 原本的 Zero-Shot 异常图记为 (Sa),Memory Bank 得到的 Few-Shot 异常图记为 (),二者直接相加得到最终定位结果;图像级分数则将 FE-CLIP 的异常分数与 Few-Shot 异常图中的最大值结合。
Few-Shot 阶段因此同时利用了通用异常先验 和少量正常图提供的目标类别正常外观先验。
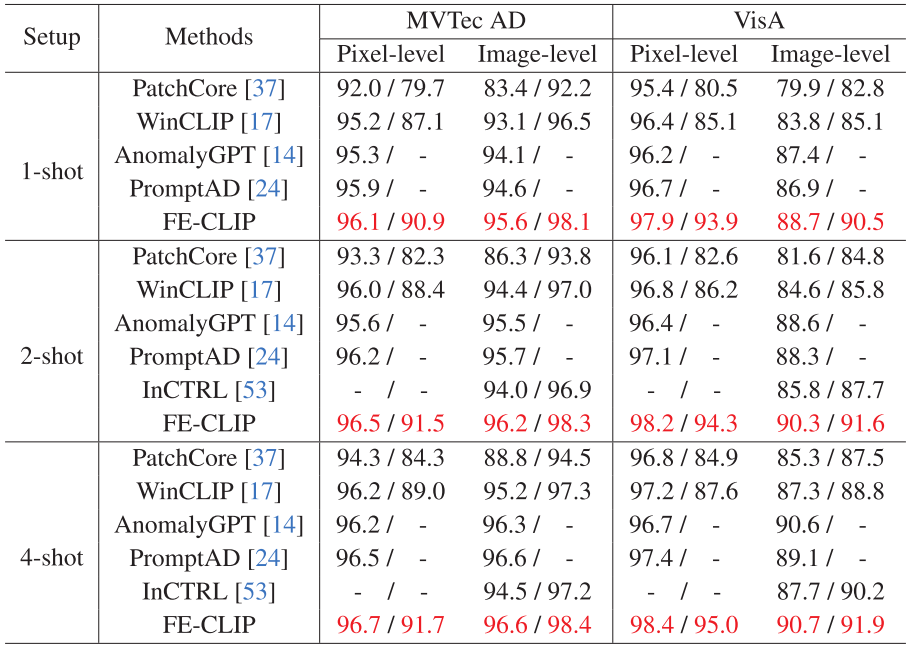
论文 Table 5:1-shot、2-shot、4-shot Few-Normal-Shot 对比
在 MVTec AD 上,FE-CLIP 的 1-shot Image-level AUROC 达到 95.6% ,2-shot 为 96.2% ,4-shot 为 96.6% ;Pixel-level AUROC 则从 96.1% 提升到 96.7%。
VisA 上,1-shot / 2-shot / 4-shot Image-level AUROC 分别为 88.7%、90.3%、90.7%,表现同样随正常参考样本增加而提升。
因此 FE-CLIP 可以自然扩展到 Few-Shot:Zero-Shot 提供通用异常认知,少量正常图补充目标类别的正常外观。
七、总结与思考
FE-CLIP 最值得记住的地方其实非常简单:
异常不仅有语义差异,也有频率差异。
以往 CLIP-based 异常检测主要围绕文本 Prompt、跨模态对齐和空间特征展开,而 FE-CLIP 证明了频率信息可以成为另一条有效线索。
它用 FFE 和 LFS 分别完成两件事情:
-
FFE:在频域加工局部特征,再返回空间域;
-
LFS:直接统计并表达局部频率分布。
两条支路与 CLIP 原始特征逐层融合,同时只训练轻量 Adapter,尽可能保留 CLIP 的预训练迁移能力。
实验体现出三个现象:频域增强能跨工业与医学数据迁移;对 Pixel-level Segmentation 的帮助尤其明显;FFT 与 DCT 都能取得类似收益,说明真正有价值的是频率信息本身。
当然,这条路线也有明确边界。论文自己举了"被压扁的饺子"例子:如果异常只是整体形状发生变化,但没有产生明显纹理、边缘或内部结构差异,那么频率模式未必足够突出。因此 FE-CLIP 更适合作为 CLIP 语义能力的补充,而不是替代空间与语义特征。
从更一般的角度看,这篇工作的启发是:
做 Zero-Shot 异常检测时,不一定只能继续堆 Prompt 或语言语义。异常本身的低层视觉规律------频率、纹理、边缘和局部统计------同样可以成为跨类别、跨领域泛化的重要先验。