AI Agent 工程化落地实战系列 · 第12篇(核心技能篇)
本文是系列文章的第十二篇。在上一篇中,我们讨论了 Agent 的记忆系统设计。本篇将深入探讨 Prompt 工程在 Agent 场景下的进阶实践--这不仅仅是"写好提示词"的问题,而是关乎整个 Agent 系统能否稳定、可靠、可预测地运行的核心工程能力。
摘要
本文面向已经具备基础 Prompt 经验、正在构建生产级 AI Agent 系统的工程师。文章首先厘清 Agent 场景下 Prompt 工程与普通 ChatBot 场景的本质区别,然后从角色设定的分层设计、复杂任务的分解策略、输出格式与风格的约束控制、Few-shot 与 Zero-shot 的场景选择四个维度展开深入讲解。在此基础上,进一步探讨 Prompt 版本管理与 A/B 测试的工程化实践,最后给出适用边界与风险提示。全文包含大量可复用的代码模板、架构示意图和实战经验总结,旨在帮助读者将 Prompt 工程从"手艺活"升级为"工程化体系"。
版本声明: 本文基于 2024-2025 年主流大语言模型(GPT-4o、Claude 3.5/4、DeepSeek V3、Qwen2.5 等)的实践编写。不同模型的 Prompt 特性存在差异,文中会标注关键差异点。示例代码以 Python + LangChain/OpenAI SDK 为主,核心思路可迁移至任意 LLM 框架。
适用边界: 本文适用于需要构建工具调用型 Agent、多步推理型 Agent 或自主任务型 Agent 的工程师。如果你的场景只是简单的问答对话,本文的工程化实践可能"过度设计"。
文章目录
-
- 摘要
- [一、Agent 场景下 Prompt 工程与 ChatBot 场景的本质区别](#一、Agent 场景下 Prompt 工程与 ChatBot 场景的本质区别)
-
- [1.1 从"对话生成"到"行为控制"](#1.1 从"对话生成"到"行为控制")
- [1.2 评估标准的差异](#1.2 评估标准的差异)
- [1.3 Agent Prompt 工程的四大支柱](#1.3 Agent Prompt 工程的四大支柱)
- [二、角色设定:System Prompt 的分层设计](#二、角色设定:System Prompt 的分层设计)
-
- [2.1 为什么单一描述不够用](#2.1 为什么单一描述不够用)
- [2.2 分层设计模型](#2.2 分层设计模型)
- [2.3 分层设计的工程化实现](#2.3 分层设计的工程化实现)
- [2.4 角色漂移的检测与修复](#2.4 角色漂移的检测与修复)
- [2.5 不同模型对角色设定的响应差异](#2.5 不同模型对角色设定的响应差异)
- 三、任务分解:将复杂目标拆解为模型可执行的子任务
-
- [3.1 为什么 Agent 需要"任务分解"](#3.1 为什么 Agent 需要"任务分解")
- [3.2 ReAct 模式:思考-行动-观察的循环](#3.2 ReAct 模式:思考-行动-观察的循环)
- [3.3 Plan-and-Execute 模式:先规划后执行](#3.3 Plan-and-Execute 模式:先规划后执行)
- [3.4 分解粒度的控制原则](#3.4 分解粒度的控制原则)
- [3.5 任务分解的经验法则](#3.5 任务分解的经验法则)
- 四、输出约束:格式控制、长度控制、风格控制
-
- [4.1 格式控制:从"尽量是 JSON"到"必须是 JSON"](#4.1 格式控制:从"尽量是 JSON"到"必须是 JSON")
-
- [4.1.1 JSON Mode 与 Structured Output](#4.1.1 JSON Mode 与 Structured Output)
- [4.1.2 多模型兼容方案](#4.1.2 多模型兼容方案)
- [4.2 长度控制](#4.2 长度控制)
- [4.3 风格控制](#4.3 风格控制)
- [五、示例引导:Few-shot vs Zero-shot 在 Agent 场景下的选择](#五、示例引导:Few-shot vs Zero-shot 在 Agent 场景下的选择)
-
- [5.1 何时需要示例引导](#5.1 何时需要示例引导)
- [5.2 静态 Few-shot](#5.2 静态 Few-shot)
- [5.3 动态 Few-shot:基于语义检索的示例选择](#5.3 动态 Few-shot:基于语义检索的示例选择)
- [5.4 Zero-shot 能力强的模型列表](#5.4 Zero-shot 能力强的模型列表)
- [六、Prompt 版本管理与 A/B 测试](#六、Prompt 版本管理与 A/B 测试)
-
- [6.1 把 Prompt 当代码管理](#6.1 把 Prompt 当代码管理)
- [6.2 Prompt 版本管理系统](#6.2 Prompt 版本管理系统)
- [6.3 A/B 测试框架](#6.3 A/B 测试框架)
- [6.4 Prompt 评估的自动化](#6.4 Prompt 评估的自动化)
- 七、适用边界与风险提示
-
- [7.1 Prompt 工程不是万灵药](#7.1 Prompt 工程不是万灵药)
- [7.2 过度工程化的风险](#7.2 过度工程化的风险)
- [7.3 不同模型间的 Prompt 迁移](#7.3 不同模型间的 Prompt 迁移)
- [7.4 Prompt 泄露风险](#7.4 Prompt 泄露风险)
- [7.5 成本失控风险](#7.5 成本失控风险)
- 八、总结
- 参考资料
一、Agent 场景下 Prompt 工程与 ChatBot 场景的本质区别
1.1 从"对话生成"到"行为控制"
很多人把 Agent 中的 Prompt 工程等同于 ChatBot 的提示词优化,这是一个根本性的认知偏差。理解这种偏差是整个 Prompt 工程进阶的起点。
在 ChatBot 场景中,Prompt 的目标是生成对人类友好的回复--评价标准是流畅性、准确性、语气得体。用户阅读回复,做出判断,然后继续对话。即使 Prompt 写得不够好,最坏的情况是用户体验差一些。
但在 Agent 场景中,Prompt 的输出往往直接驱动工具调用、API 请求、文件操作等实际行为。一个格式错误的 JSON、一个歧义的角色定义、一个缺少约束的输出,可能导致 Agent 调用错误的 API、删除错误的数据、发送不当的邮件。
来看一个直观的对比:
python
# ChatBot 场景的 Prompt -- 目标是让人类理解
chatbot_prompt = """
你是一个天气助手,请用友好的语气回答用户关于天气的问题。
"""

# Agent 场景的 Prompt -- 目标是让机器正确执行
agent_prompt = """
你是一个天气查询 Agent,可以通过调用外部 API 获取天气信息。

## 可用工具
1. get_current_weather(location: str, unit: str = "celsius") -> dict
   - location: 城市名称,支持中英文,如 "北京" 或 "Beijing"
   - unit: 温度单位,可选 "celsius" 或 "fahrenheit"
   - 返回: {"temperature": float, "condition": str, "humidity": int}

## 调用规则
- 必须先调用 get_current_weather 获取数据,再基于数据回答
- 不要编造天气数据
- 如果用户没有指定城市,询问而非猜测
- 返回格式必须是: {"city": str, "temp": float, "condition": str, "advice": str}

## 错误处理
- API 超时:告知用户并建议重试
- 城市不存在:返回 {"error": "city_not_found", "message": "..."}
"""
解释: 上面的 ChatBot Prompt 只需一句话描述角色和语气即可,因为输出直接面向人类。而 Agent Prompt 需要明确定义工具签名、调用规则、返回格式和错误处理策略--这些约束不是"锦上添花",而是 Agent 能正确运作的最低要求。
1.2 评估标准的差异
下表总结了两种场景在关键维度上的差异:
| 维度 | ChatBot 场景 | Agent 场景 |
|---|---|---|
| 输出消费者 | 人类用户 | 机器(下游解析器/工具调用器) |
| 格式要求 | 软约束(排版好看即可) | 硬约束(必须可解析为 JSON/特定结构) |
| 错误后果 | 体验下降 | 可能触发错误的实际操作 |
| 测试方式 | 人工评估为主 | 自动化测试 + 回归测试 |
| Prompt 版本管理 | 可选 | 必须(与代码同等对待) |
| 延迟容忍度 | 较高(用户等待几秒可接受) | 较低(多步调用会累积延迟) |
| Token 成本控制 | 次要考虑 | 核心考量(多轮调用放大成本) |
1.3 Agent Prompt 工程的四大支柱
基于上述差异,我将 Agent 场景下的 Prompt 工程拆解为四大支柱。这四个支柱构成了本文的核心框架,后续章节将逐一深入展开。
#mermaid-svg-PWCCb9yxs3RLnRdV{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-PWCCb9yxs3RLnRdV .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-PWCCb9yxs3RLnRdV .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-PWCCb9yxs3RLnRdV .error-icon{fill:#552222;}#mermaid-svg-PWCCb9yxs3RLnRdV .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-PWCCb9yxs3RLnRdV .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-PWCCb9yxs3RLnRdV .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-PWCCb9yxs3RLnRdV .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-PWCCb9yxs3RLnRdV .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-PWCCb9yxs3RLnRdV .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-PWCCb9yxs3RLnRdV .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-PWCCb9yxs3RLnRdV .marker{fill:#333333;stroke:#333333;}#mermaid-svg-PWCCb9yxs3RLnRdV .marker.cross{stroke:#333333;}#mermaid-svg-PWCCb9yxs3RLnRdV svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-PWCCb9yxs3RLnRdV p{margin:0;}#mermaid-svg-PWCCb9yxs3RLnRdV .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-PWCCb9yxs3RLnRdV .cluster-label text{fill:#333;}#mermaid-svg-PWCCb9yxs3RLnRdV .cluster-label span{color:#333;}#mermaid-svg-PWCCb9yxs3RLnRdV .cluster-label span p{background-color:transparent;}#mermaid-svg-PWCCb9yxs3RLnRdV .label text,#mermaid-svg-PWCCb9yxs3RLnRdV span{fill:#333;color:#333;}#mermaid-svg-PWCCb9yxs3RLnRdV .node rect,#mermaid-svg-PWCCb9yxs3RLnRdV .node circle,#mermaid-svg-PWCCb9yxs3RLnRdV .node ellipse,#mermaid-svg-PWCCb9yxs3RLnRdV .node polygon,#mermaid-svg-PWCCb9yxs3RLnRdV .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-PWCCb9yxs3RLnRdV .rough-node .label text,#mermaid-svg-PWCCb9yxs3RLnRdV .node .label text,#mermaid-svg-PWCCb9yxs3RLnRdV .image-shape .label,#mermaid-svg-PWCCb9yxs3RLnRdV .icon-shape .label{text-anchor:middle;}#mermaid-svg-PWCCb9yxs3RLnRdV .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-PWCCb9yxs3RLnRdV .rough-node .label,#mermaid-svg-PWCCb9yxs3RLnRdV .node .label,#mermaid-svg-PWCCb9yxs3RLnRdV .image-shape .label,#mermaid-svg-PWCCb9yxs3RLnRdV .icon-shape .label{text-align:center;}#mermaid-svg-PWCCb9yxs3RLnRdV .node.clickable{cursor:pointer;}#mermaid-svg-PWCCb9yxs3RLnRdV .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-PWCCb9yxs3RLnRdV .arrowheadPath{fill:#333333;}#mermaid-svg-PWCCb9yxs3RLnRdV .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-PWCCb9yxs3RLnRdV .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-PWCCb9yxs3RLnRdV .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-PWCCb9yxs3RLnRdV .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-PWCCb9yxs3RLnRdV .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-PWCCb9yxs3RLnRdV .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-PWCCb9yxs3RLnRdV .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-PWCCb9yxs3RLnRdV .cluster text{fill:#333;}#mermaid-svg-PWCCb9yxs3RLnRdV .cluster span{color:#333;}#mermaid-svg-PWCCb9yxs3RLnRdV div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-PWCCb9yxs3RLnRdV .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-PWCCb9yxs3RLnRdV rect.text{fill:none;stroke-width:0;}#mermaid-svg-PWCCb9yxs3RLnRdV .icon-shape,#mermaid-svg-PWCCb9yxs3RLnRdV .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-PWCCb9yxs3RLnRdV .icon-shape p,#mermaid-svg-PWCCb9yxs3RLnRdV .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-PWCCb9yxs3RLnRdV .icon-shape .label rect,#mermaid-svg-PWCCb9yxs3RLnRdV .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-PWCCb9yxs3RLnRdV .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-PWCCb9yxs3RLnRdV .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-PWCCb9yxs3RLnRdV :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} Agent Prompt 工程四大支柱
角色设定
System Prompt 分层设计
任务分解
复杂目标拆解为子任务
输出约束
格式/长度/风格控制
示例引导
Few-shot vs Zero-shot
角色层: 身份与能力边界
任务层: 当前任务描述
工具层: 可用工具与调用规则
约束层: 行为约束与安全边界
意图识别
计划生成
逐步执行
结果聚合
格式控制: JSON Schema
长度控制: Token 限制
风格控制: 语气与用词
Zero-shot: 简单任务
Few-shot: 复杂格式
Dynamic Few-shot: 语义检索
这四个支柱不是孤立的,它们相互支撑、彼此影响。一个设计良好的角色设定能减少对输出约束的依赖;合理的任务分解能降低对 Few-shot 示例的需求;精确的输出约束能弥补角色设定中的模糊空间。
接下来,我们将逐一深入每个支柱。
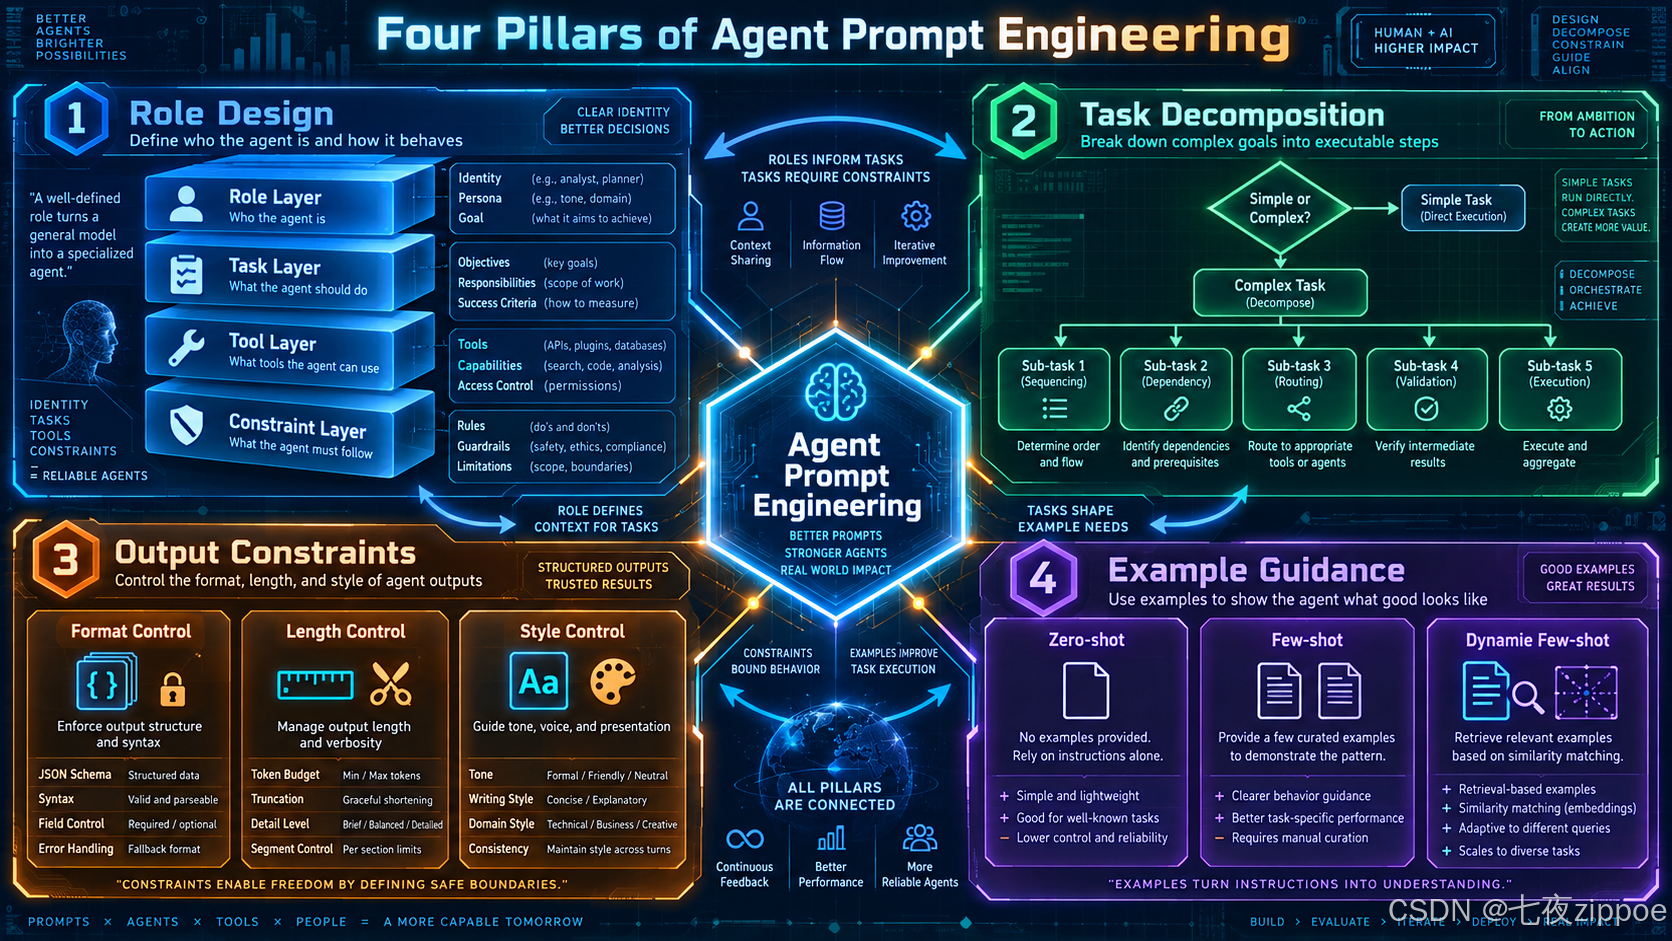
图:Agent Prompt 工程四大支柱(角色设定、任务分解、输出约束、示例引导)的架构总览
二、角色设定:System Prompt 的分层设计
2.1 为什么单一描述不够用
很多开发者在写 Agent 的 System Prompt 时,习惯把所有内容揉进一个段落里。这在项目初期看似简洁高效,但随着 Agent 能力的扩展和任务复杂度的提升,问题会迅速暴露:
python
# ❌ 不推荐的写法:单一扁平 Prompt
system_prompt = """你是一个数据分析助手。你可以查询数据库、生成图表、分析趋势。
请根据用户的需求,选择合适的工具完成任务。注意输出要准确、清晰。
不要编造数据。如果用户的问题超出你的能力范围,请告知用户。"""
这种写法在小规模 Demo 阶段可能够用,但当 Agent 的工具数量增加、任务复杂度上升时,问题会迅速暴露:
- 工具冲突:Agent 不知道何时该用哪个工具
- 约束遗忘:长对话后,Agent 忘记了初始约束
- 角色漂移:Agent 从"数据分析助手"漂移成"通用聊天机器人"
- 难以维护:修改一处约束可能影响其他部分
2.2 分层设计模型
我提出的分层设计模型将 System Prompt 分为四层,每层职责明确,互不交叉:
python
# ✅ 推荐的写法:分层 System Prompt
SYSTEM_PROMPT = """
# ==================== 角色层 ====================
你是一个数据分析 Agent,专门服务于电商运营团队。

你的身份:
- 名称:DataAgent
- 能力范围:SQL 查询、数据可视化、趋势分析、异常检测
- 能力边界:你不负责订单处理、库存管理、用户管理等业务操作

# ==================== 任务层 ====================
你的核心任务流程:
1. 理解用户的数据分析需求
2. 将需求转化为可执行的查询计划
3. 调用工具获取数据
4. 对结果进行分析和解读
5. 生成结构化的分析报告

如果用户的需求不清晰,先提出澄清问题,不要猜测。

# ==================== 工具层 ====================
你有以下工具可用:

## query_database
- 功能:执行 SQL 查询
- 参数:{"sql": "SQL 语句字符串", "database": "数据库名(可选)"}
- 约束:只支持 SELECT 语句,禁止 DDL/DML
- 返回:{"columns": [...], "rows": [...], "row_count": int}

## generate_chart
- 功能:生成图表
- 参数:{"type": "bar|line|pie|scatter", "data": {...}, "title": "str"}
- 返回:{"chart_url": "str", "chart_id": "str"}

## detect_anomaly
- 功能:检测数据异常
- 参数:{"data": [...], "method": "zscore|iqr|isolation_forest", "threshold": float}
- 返回:{"anomalies": [...], "method": "str", "confidence": float}

# ==================== 约束层 ====================
## 行为约束
- 不要编造数据或分析结论
- 如果查询结果为空,明确告知用户而非自行填充
- 所有数值结论必须基于实际查询结果
- 敏感数据(用户手机号、身份证号等)不得出现在输出中

## 输出约束
- 分析报告使用 Markdown 格式
- 图表 URL 需配合文字说明
- 数值保留两位小数,大数使用万/亿单位

## 安全约束
- SQL 查询不得包含 DROP、TRUNCATE、DELETE 等危险操作
- 单次查询结果不超过 10000 行
- 每日查询次数上限:1000 次
"""
解释: 上面的分层设计将 Prompt 分为角色层(定义身份和能力边界)、任务层(定义核心工作流程)、工具层(定义可用工具及签名)、约束层(定义行为/输出/安全约束)。这种分层的好处是:修改某层时不会意外影响其他层;新增工具只需在工具层添加;调整行为约束只需修改约束层。在生产环境中,这种结构化的 Prompt 可以像代码一样进行 diff 和 review。
2.3 分层设计的工程化实现
在实际项目中,我建议将每一层作为独立的模板文件管理,运行时动态组装:
python
from pathlib import Path
from string import Template

class SystemPromptBuilder:
    """System Prompt 分层构建器"""

    LAYER_TEMPLATE_DIR = "prompts/system/"

    def __init__(self, agent_name: str = "DataAgent"):
        self.agent_name = agent_name
        self.layers = {}

    def load_role_layer(self, role_config: dict) -> str:
        """加载角色层"""
        template = self._load_template("role_layer.md")
        return template.substitute(
            name=role_config["name"],
            domain=role_config["domain"],
            capabilities=", ".join(role_config["capabilities"]),
            boundaries=", ".join(role_config.get("boundaries", [])),
        )

    def load_task_layer(self, task_config: dict) -> str:
        """加载任务层"""
        template = self._load_template("task_layer.md")
        steps = "\n".join(
            f"{i+1}. {step}" for i, step in enumerate(task_config["steps"])
        )
        return template.substitute(
            task_description=task_config["description"],
            steps=steps,
            fallback_behavior=task_config.get("fallback", "请求用户澄清"),
        )

    def load_tool_layer(self, tools: list[dict]) -> str:
        """加载工具层 - 基于工具注册表自动生成"""
        tool_sections = []
        for tool in tools:
            section = f"""## {tool['name']}
- 功能:{tool['description']}
- 参数:{tool['parameters']}
- 约束:{tool.get('constraints', '无特殊约束')}
- 返回:{tool['returns']}"""
            tool_sections.append(section)
        return "# 工具定义\n\n" + "\n\n".join(tool_sections)

    def load_constraint_layer(self, constraints: dict) -> str:
        """加载约束层"""
        template = self._load_template("constraint_layer.md")
        return template.substitute(
            behavior_constraints="\n".join(f"- {c}" for c in constraints["behavior"]),
            output_constraints="\n".join(f"- {c}" for c in constraints["output"]),
            safety_constraints="\n".join(f"- {c}" for c in constraints["safety"]),
        )

    def build(self, config: dict) -> str:
        """组装完整的 System Prompt"""
        layers = [
            self.load_role_layer(config["role"]),
            self.load_task_layer(config["task"]),
            self.load_tool_layer(config["tools"]),
            self.load_constraint_layer(config["constraints"]),
        ]
        return "\n\n".join(layers)

    def _load_template(self, filename: str) -> Template:
        path = Path(self.LAYER_TEMPLATE_DIR) / filename
        return Template(path.read_text(encoding="utf-8"))


# 使用示例
builder = SystemPromptBuilder()

config = {
    "role": {
        "name": "DataAgent",
        "domain": "电商数据分析",
        "capabilities": ["SQL 查询", "数据可视化", "趋势分析", "异常检测"],
        "boundaries": ["不负责订单处理", "不负责库存管理"],
    },
    "task": {
        "description": "为电商运营团队提供数据分析服务",
        "steps": [
            "理解用户的数据分析需求",
            "将需求转化为可执行的查询计划",
            "调用工具获取数据",
            "对结果进行分析和解读",
            "生成结构化的分析报告",
        ],
    },
    "tools": [
        {
            "name": "query_database",
            "description": "执行 SQL 查询",
            "parameters": '{"sql": "SQL 语句", "database": "数据库名(可选)"}',
            "constraints": "只支持 SELECT 语句,禁止 DDL/DML",
            "returns": '{"columns": [...], "rows": [...], "row_count": int}',
        }
    ],
    "constraints": {
        "behavior": ["不编造数据", "查询结果为空时明确告知用户"],
        "output": ["使用 Markdown 格式", "数值保留两位小数"],
        "safety": ["禁止 DROP/TRUNCATE/DELETE", "单次查询不超过 10000 行"],
    },
}

system_prompt = builder.build(config)
解释: 这个 SystemPromptBuilder 将四层 Prompt 的管理完全工程化。每一层通过模板文件(.md)管理,支持变量替换,工具层更是直接从工具注册表自动生成。这样做的好处是:Prompt 变更可以走代码审查流程;不同环境(开发/测试/生产)可以使用不同的约束配置;新增 Agent 时可以复用模板,只需替换配置。
2.4 角色漂移的检测与修复
在长对话或多轮任务执行中,Agent 可能逐渐偏离初始角色设定,这种现象称为"角色漂移"(Role Drift)。它是最常见的 Prompt 工程问题之一。
角色漂移的典型表现包括:
- 工具范围越界:被限制为只读工具的 Agent 突然尝试执行写操作
- 语气变化:专业分析 Agent 开始使用口语化表达或闲聊
- 约束遗忘:初始要求"不编造数据",但 Agent 在第 8 轮对话中开始给出没有数据支撑的结论
- 角色混淆:数据分析 Agent 开始处理它不该负责的订单管理任务
以下是一个角色漂移检测器的实现:
python
class RoleDriftDetector:
    """角色漂移检测器"""

    def __init__(self, role_constraints: dict):
        """
        role_constraints 格式:
        {
            "allowed_tools": ["query_database", "generate_chart"],
            "forbidden_keywords": ["DROP", "DELETE", "INSERT", "UPDATE"],
            "required_tone": "专业分析",
            "forbidden_actions": ["订单处理", "库存管理", "用户管理"],
        }
        """
        self.constraints = role_constraints
        self.drift_history = []

    def check(self, agent_output: str, tool_calls: list[dict]) -> dict:
        """检查 Agent 输出是否存在角色漂移"""
        issues = []

        # 检查工具调用范围
        for call in tool_calls:
            tool_name = call.get("tool", "")
            if tool_name not in self.constraints["allowed_tools"]:
                issues.append({
                    "type": "tool_out_of_scope",
                    "detail": f"调用了不在范围内的工具: {tool_name}",
                    "severity": "high",
                })

        # 检查禁止关键词
        output_upper = agent_output.upper()
        for keyword in self.constraints["forbidden_keywords"]:
            if keyword in output_upper:
                issues.append({
                    "type": "forbidden_keyword",
                    "detail": f"输出包含禁止关键词: {keyword}",
                    "severity": "critical",
                })

        # 检查禁止动作
        for action in self.constraints["forbidden_actions"]:
            if action in agent_output:
                issues.append({
                    "type": "forbidden_action",
                    "detail": f"涉及禁止动作: {action}",
                    "severity": "high",
                })

        # 检查语气偏移(简单启发式)
        casual_markers = ["哈哈", "哎呀", "亲", "呢~", "好嘞"]
        for marker in casual_markers:
            if marker in agent_output:
                issues.append({
                    "type": "tone_drift",
                    "detail": f"语气偏移,检测到非正式表达: {marker}",
                    "severity": "medium",
                })

        result = {
            "has_drift": len(issues) > 0,
            "issues": issues,
            "timestamp": datetime.now().isoformat(),
        }

        if issues:
            self.drift_history.append(result)

        return result

    def get_drift_summary(self) -> dict:
        """获取漂移历史摘要"""
        if not self.drift_history:
            return {"total_drifts": 0, "status": "healthy"}

        type_counts = {}
        for record in self.drift_history:
            for issue in record["issues"]:
                t = issue["type"]
                type_counts[t] = type_counts.get(t, 0) + 1

        return {
            "total_drifts": len(self.drift_history),
            "by_type": type_counts,
            "status": "warning" if len(self.drift_history) < 5 else "critical",
        }
解释: 这个漂移检测器在三个维度上进行监控:工具调用范围(是否调用了不在白名单中的工具)、禁止内容(是否包含 SQL 危险关键词或禁止动作)、语气偏移(是否出现非正式表达)。severity 分为 critical/high/medium 三级,critical 级别应立即中断 Agent 执行并告警。在生产环境中,建议将漂移检测器作为 Agent 输出的后处理层,每次输出都经过检查后再返回给用户或传递给下游系统。
2.5 不同模型对角色设定的响应差异
在实际测试中,不同模型对分层 System Prompt 的响应存在明显差异:
| 模型 | 角色层遵从度 | 工具层理解力 | 约束层执行度 | 推荐策略 |
|---|---|---|---|---|
| GPT-4o | 高 | 高 | 中高 | 约束层可适当精简 |
| Claude 3.5/4 | 极高 | 高 | 极高 | 充分利用其长上下文优势 |
| DeepSeek V3 | 高 | 中高 | 中 | 约束层需更显式、更详细 |
| Qwen2.5 | 中高 | 中 | 中高 | 建议增加 Few-shot 示例 |
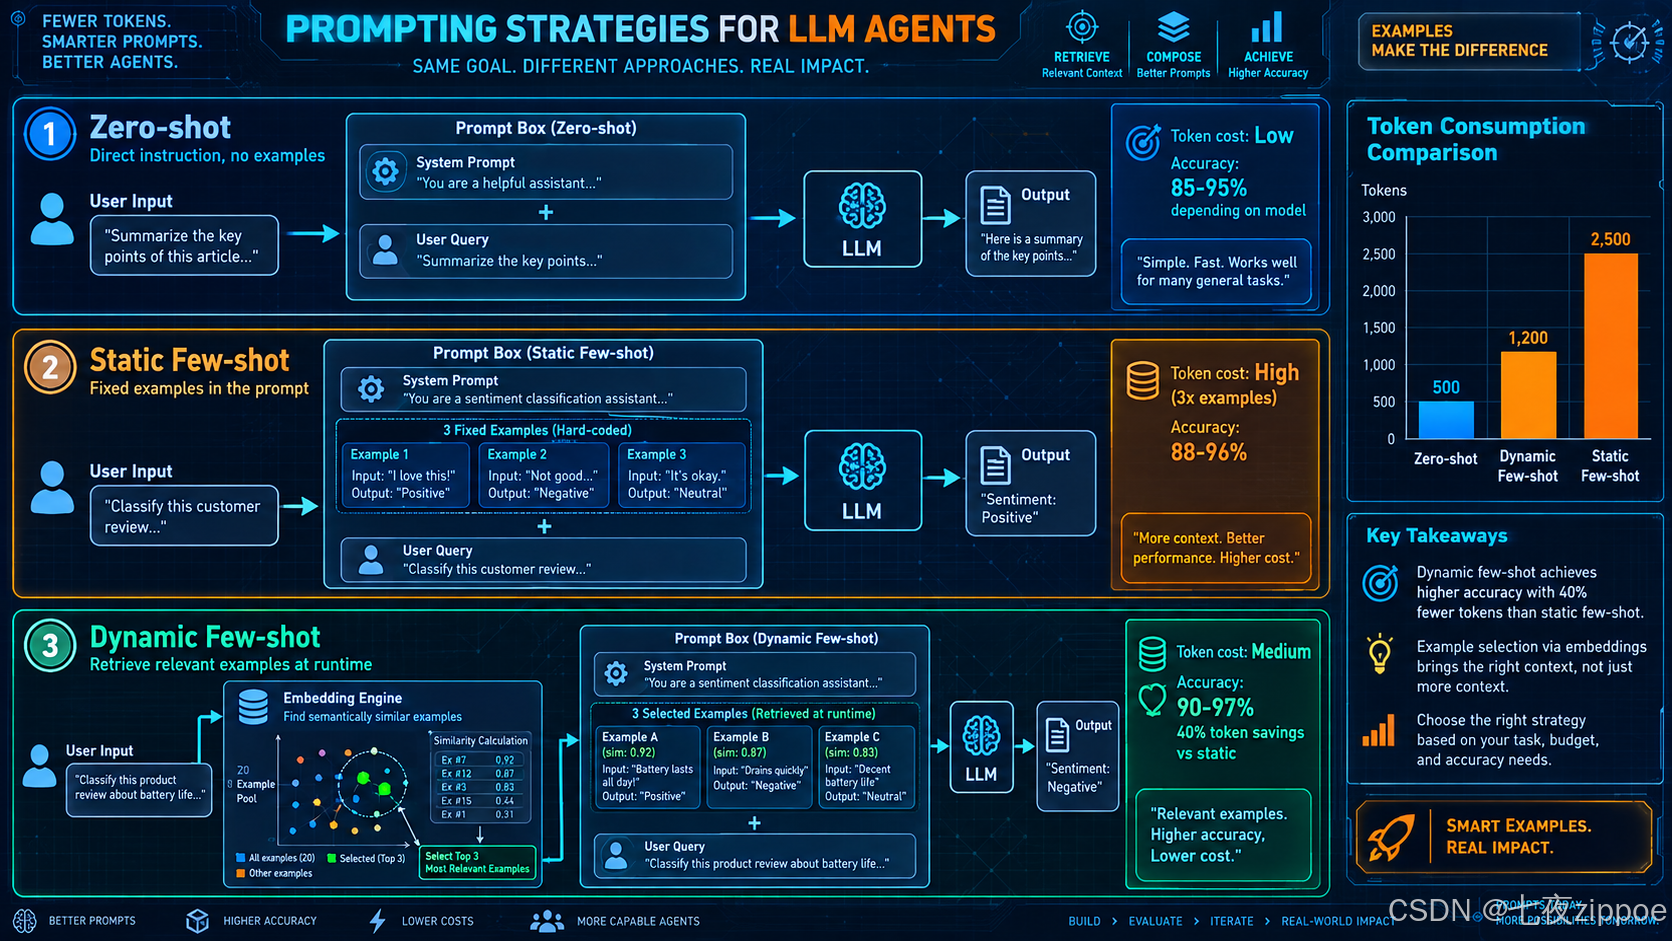
图:Zero-shot、静态 Few-shot 与动态 Few-shot 三种策略的流程对比与 token 消耗分析
三、任务分解:将复杂目标拆解为模型可执行的子任务
3.1 为什么 Agent 需要"任务分解"
大语言模型有一个被广泛验证的特性:单次推理的质量与任务复杂度呈反比。当你让一个模型一次性完成"查询上周销售数据、分析环比趋势、找出异常品类、生成分析报告"这样的复合任务时,模型往往会在某个环节出错--可能是忘了查询某个关键字段,可能是分析时混淆了时间范围,也可能是报告格式不符合预期。这就像让一个人同时做需求分析、写代码、做测试和写文档--虽然理论上可以,但每个环节的质量都会下降。
这就像让一个人同时做需求分析、写代码、做测试和写文档--虽然理论上可以,但每个环节的质量都会下降。
#mermaid-svg-JlDVBSRW3FW46i12{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-JlDVBSRW3FW46i12 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-JlDVBSRW3FW46i12 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-JlDVBSRW3FW46i12 .error-icon{fill:#552222;}#mermaid-svg-JlDVBSRW3FW46i12 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-JlDVBSRW3FW46i12 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-JlDVBSRW3FW46i12 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-JlDVBSRW3FW46i12 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-JlDVBSRW3FW46i12 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-JlDVBSRW3FW46i12 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-JlDVBSRW3FW46i12 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-JlDVBSRW3FW46i12 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-JlDVBSRW3FW46i12 .marker.cross{stroke:#333333;}#mermaid-svg-JlDVBSRW3FW46i12 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-JlDVBSRW3FW46i12 p{margin:0;}#mermaid-svg-JlDVBSRW3FW46i12 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-JlDVBSRW3FW46i12 .cluster-label text{fill:#333;}#mermaid-svg-JlDVBSRW3FW46i12 .cluster-label span{color:#333;}#mermaid-svg-JlDVBSRW3FW46i12 .cluster-label span p{background-color:transparent;}#mermaid-svg-JlDVBSRW3FW46i12 .label text,#mermaid-svg-JlDVBSRW3FW46i12 span{fill:#333;color:#333;}#mermaid-svg-JlDVBSRW3FW46i12 .node rect,#mermaid-svg-JlDVBSRW3FW46i12 .node circle,#mermaid-svg-JlDVBSRW3FW46i12 .node ellipse,#mermaid-svg-JlDVBSRW3FW46i12 .node polygon,#mermaid-svg-JlDVBSRW3FW46i12 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-JlDVBSRW3FW46i12 .rough-node .label text,#mermaid-svg-JlDVBSRW3FW46i12 .node .label text,#mermaid-svg-JlDVBSRW3FW46i12 .image-shape .label,#mermaid-svg-JlDVBSRW3FW46i12 .icon-shape .label{text-anchor:middle;}#mermaid-svg-JlDVBSRW3FW46i12 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-JlDVBSRW3FW46i12 .rough-node .label,#mermaid-svg-JlDVBSRW3FW46i12 .node .label,#mermaid-svg-JlDVBSRW3FW46i12 .image-shape .label,#mermaid-svg-JlDVBSRW3FW46i12 .icon-shape .label{text-align:center;}#mermaid-svg-JlDVBSRW3FW46i12 .node.clickable{cursor:pointer;}#mermaid-svg-JlDVBSRW3FW46i12 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-JlDVBSRW3FW46i12 .arrowheadPath{fill:#333333;}#mermaid-svg-JlDVBSRW3FW46i12 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-JlDVBSRW3FW46i12 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-JlDVBSRW3FW46i12 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-JlDVBSRW3FW46i12 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-JlDVBSRW3FW46i12 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-JlDVBSRW3FW46i12 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-JlDVBSRW3FW46i12 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-JlDVBSRW3FW46i12 .cluster text{fill:#333;}#mermaid-svg-JlDVBSRW3FW46i12 .cluster span{color:#333;}#mermaid-svg-JlDVBSRW3FW46i12 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-JlDVBSRW3FW46i12 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-JlDVBSRW3FW46i12 rect.text{fill:none;stroke-width:0;}#mermaid-svg-JlDVBSRW3FW46i12 .icon-shape,#mermaid-svg-JlDVBSRW3FW46i12 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-JlDVBSRW3FW46i12 .icon-shape p,#mermaid-svg-JlDVBSRW3FW46i12 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-JlDVBSRW3FW46i12 .icon-shape .label rect,#mermaid-svg-JlDVBSRW3FW46i12 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-JlDVBSRW3FW46i12 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-JlDVBSRW3FW46i12 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-JlDVBSRW3FW46i12 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 用户复杂需求
意图识别
简单任务
直接执行
复杂任务
需要分解
任务拆解器
子任务1: 数据查询
子任务2: 数据分析
子任务3: 报告生成
执行结果1
执行结果2
执行结果3
结果聚合
最终输出
3.2 ReAct 模式:思考-行动-观察的循环
ReAct(Reasoning + Acting)是 Agent 场景下最经典的任务分解模式。它通过让模型在每一步"思考"后再"行动",实现自然的任务分解:
python
import json
from typing import Any
from openai import OpenAI

client = OpenAI()

REACT_SYSTEM_PROMPT = """你是一个任务执行 Agent,使用 ReAct 模式工作。

在每一轮中,你必须严格按照以下格式输出:

Thought: <你的推理过程,分析当前状态和下一步行动>
Action: <工具名称>
Action Input: <工具输入参数的 JSON>

当你获得 Observation 后,继续下一轮 Thought。

当任务完成时,输出:
Thought: <总结完成情况>
Final Answer: <最终回答>

可用工具:
- search_web(query: str) -> str: 搜索网络获取信息
- get_weather(city: str) -> dict: 获取城市天气
- calculate(expression: str) -> float: 计算数学表达式

规则:
1. 每次只执行一个 Action
2. Action Input 必须是合法 JSON
3. 不要在 Thought 中编造 Observation
"""


def run_react_agent(user_task: str, max_iterations: int = 10) -> str:
    """运行 ReAct Agent"""
    messages = [
        {"role": "system", "content": REACT_SYSTEM_PROMPT},
        {"role": "user", "content": user_task},
    ]

    for i in range(max_iterations):
        response = client.chat.completions.create(
            model="gpt-4o",
            messages=messages,
            temperature=0.1,  # 低温度保证格式稳定
        )

        assistant_msg = response.choices[0].message.content
        messages.append({"role": "assistant", "content": assistant_msg})

        # 检查是否已完成
        if "Final Answer:" in assistant_msg:
            final_answer = assistant_msg.split("Final Answer:")[-1].strip()
            return final_answer

        # 解析 Action 和 Action Input
        if "Action:" not in assistant_msg or "Action Input:" not in assistant_msg:
            messages.append({
                "role": "user",
                "content": "请严格按照格式输出,包含 Thought、Action 和 Action Input。"
            })
            continue

        try:
            action_line = [l for l in assistant_msg.split("\n") if l.startswith("Action:")][0]
            input_line = [l for l in assistant_msg.split("\n") if l.startswith("Action Input:")][0]

            action = action_line.replace("Action:", "").strip()
            action_input = json.loads(input_line.replace("Action Input:", "").strip())

            # 执行工具
            observation = execute_tool(action, action_input)

            messages.append({
                "role": "user",
                "content": f"Observation: {json.dumps(observation, ensure_ascii=False)}"
            })
        except (json.JSONDecodeError, IndexError) as e:
            messages.append({
                "role": "user",
                "content": f"格式错误,请重新输出。错误: {e}"
            })

    return "达到最大迭代次数,任务未完成。"


def execute_tool(tool_name: str, params: dict) -> Any:
    """工具执行器"""
    tools = {
        "search_web": lambda p: {"results": f"搜索结果: {p['query']}"},
        "get_weather": lambda p: {"city": p["city"], "temp": 25, "condition": "晴"},
        "calculate": lambda p: {"result": eval(p["expression"])},
    }
    if tool_name not in tools:
        return {"error": f"未知工具: {tool_name}"}
    return tools[tool_name](params)


# 运行示例
result = run_react_agent("帮我查一下北京今天的天气,然后计算 25 * 3.14 的结果")
print(result)
解释: 这个 ReAct Agent 的核心机制是强制模型在每一步输出"Thought → Action → Action Input"三元组,然后由外部执行器运行工具并返回"Observation"。这种方式实现了自然语言推理和结构化工具调用的交替进行。关键设计点包括:temperature 设为 0.1 以保证格式稳定性;max_iterations 防止无限循环;格式错误时进行纠正而非直接报错。在真实生产环境中,你还需要加入工具执行超时、异常重试、以及 Observation 截断(避免上下文爆炸)等机制。
3.3 Plan-and-Execute 模式:先规划后执行
ReAct 适合简单任务,但对于需要全局规划的任务,Plan-and-Execute 模式更有效。它将任务分解为两个阶段:规划阶段生成完整的子任务列表,执行阶段逐步执行:
python
from pydantic import BaseModel, Field
from typing import Literal

class SubTask(BaseModel):
    """子任务定义"""
    id: int = Field(description="子任务编号")
    description: str = Field(description="子任务描述")
    tool: str = Field(description="使用的工具名称")
    depends_on: list[int] = Field(default=[], description="依赖的子任务编号")
    expected_output: str = Field(description="期望输出描述")

class ExecutionPlan(BaseModel):
    """执行计划"""
    task_summary: str = Field(description="任务总结")
    subtasks: list[SubTask] = Field(description="子任务列表")
    final_aggregation: str = Field(description="最终结果聚合方式")


PLAN_PROMPT = """你是任务规划 Agent。将用户的复杂需求拆解为可执行的子任务列表。

要求:
1. 每个子任务必须只调用一个工具
2. 明确标注子任务之间的依赖关系
3. 如果子任务A的输出是子任务B的输入,必须在 depends_on 中标注
4. 子任务数量控制在 3-7 个之间

可用工具:
- search_web(query): 搜索网络
- get_weather(city): 获取天气
- calculate(expression): 数学计算
- query_db(sql): 数据库查询
- generate_report(data, format): 生成报告
"""


async def plan_and_execute(user_task: str) -> str:
    """Plan-and-Execute 模式"""
    # 阶段1: 规划
    plan_response = await client.beta.chat.completions.parse(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": PLAN_PROMPT},
            {"role": "user", "content": user_task},
        ],
        response_format=ExecutionPlan,
    )

    plan = plan_response.choices[0].message.parsed
    print(f"📋 执行计划:{plan.task_summary}")
    for st in plan.subtasks:
        print(f"  [{st.id}] {st.description} (依赖: {st.depends_on})")

    # 阶段2: 按依赖顺序执行
    results: dict[int, Any] = {}
    completed: set[int] = set()

    while len(completed) < len(plan.subtasks):
        # 找到所有依赖已满足的子任务
        ready = [
            st for st in plan.subtasks
            if st.id not in completed
            and all(dep in completed for dep in st.depends_on)
        ]

        if not ready:
            raise RuntimeError("存在循环依赖,无法继续执行")

        for subtask in ready:
            # 构建执行上下文(包含依赖任务的输出)
            context = {
                "results": {dep: results[dep] for dep in subtask.depends_on},
                "subtask": subtask.model_dump(),
            }

            result = execute_tool(subtask.tool, context)
            results[subtask.id] = result
            completed.add(subtask.id)
            print(f"  ✅ [{subtask.id}] 完成: {result}")

    # 阶段3: 聚合结果
    final_result = generate_final_answer(plan.final_aggregation, results)
    return final_result
解释: Plan-and-Execute 模式的关键优势在于"全局视角"--规划阶段可以鸟瞰整个任务结构,避免 ReAct 模式中常见的"走一步看一步"导致的局部最优陷阱。使用 Pydantic 模型约束输出格式,确保计划的可解析性。执行阶段通过依赖关系拓扑排序,保证子任务按正确顺序执行。对于复杂任务(如"分析三个城市的天气差异并生成对比报告"),这种模式的成功率显著高于纯 ReAct。
3.4 分解粒度的控制原则
任务分解不是越细越好。过粗的分解让模型在单个步骤中承担过多职责,过细的分解则导致上下文膨胀和执行延迟。以下是我在实践中总结的控制原则:
| 分解原则 | 说明 | 示例 |
|---|---|---|
| 单一职责 | 每个子任务只做一件事 | ❌ "查询并分析数据" → ✅ "查询数据" + "分析数据" |
| 可验证性 | 每个子任务的输出可独立验证 | 查询结果可以检查行数;分析结果可以检查结论是否有数据支撑 |
| 最小依赖 | 子任务间依赖尽可能少 | 如果两个子任务可以并行,就不要强制串行 |
| 上下文隔离 | 子任务不需要前序步骤的完整上下文 | 后续步骤只需要前序的结果,不需要前序的推理过程 |
| 粒度均衡 | 各子任务的复杂度大致相当 | 避免"查询数据"和"完成整个分析报告"在同一个粒度上 |
3.5 任务分解的经验法则
在实际项目中,我总结了一套任务分解的"经验法则",供参考:
法则一:子任务数量与模型能力正相关。 GPT-4o 可以可靠地执行 5-7 步的任务计划;DeepSeek V3 建议控制在 3-5 步;更小的模型建议不超过 3 步。超过模型能力上限时,模型可能在中间步骤开始"跳步"或混淆上下文。
法则二:每一步的输出都是下一步的输入。 这意味着中间结果的格式必须被严格约束。如果第 2 步输出的是自然语言描述,第 3 步很难可靠地从中提取结构化数据。建议每一步的输出都是 JSON 或其他结构化格式。
法则三:失败要可恢复。 当某个子任务失败时,Agent 应该能够重试该子任务而非从头开始。这要求每个子任务的输入是自包含的--可以从外部重新传入,而不依赖前序步骤的内部状态。
法则四:分解模式随任务类型选择。 查询型任务适合 ReAct(逐步探索);分析型任务适合 Plan-and-Execute(先规划后执行);创作型任务适合两者结合(先规划大纲,每节自由发挥)。
法则五:总是设计回退路径。 当模型在某个子任务上连续失败时,应该有明确的回退策略。例如,连续两次调用工具失败后,切换到降级模式--返回一个基于已有信息的最佳猜测,并在输出中标注不确定性,而不是无限重试或直接报错。
四、输出约束:格式控制、长度控制、风格控制
4.1 格式控制:从"尽量是 JSON"到"必须是 JSON"
在 Agent 场景中,输出格式的可靠性直接影响下游解析的成功率。传统的"请以 JSON 格式输出"这种软约束,在实际使用中的失败率大约在 3-8%(取决于模型和任务复杂度)。对于需要处理数千次请求的生产系统来说,这意味着每天可能有数百次解析失败。更严重的是,这些失败往往是隐性的--解析器可能将一个格式错误的输出静默丢弃或返回空结果,导致 Agent 在后续步骤中基于缺失数据继续推理,产生连锁错误。
4.1.1 JSON Mode 与 Structured Output
现代 LLM API 已经提供了原生的结构化输出支持:
python
from pydantic import BaseModel, Field
from openai import OpenAI
from typing import Literal, Optional

client = OpenAI()

# 定义输出结构
class WeatherAnalysisOutput(BaseModel):
    """天气分析结果的结构化定义"""
    city: str = Field(description="城市名称")
    temperature: float = Field(description="当前温度(摄氏度)")
    condition: Literal["晴", "多云", "阴", "小雨", "大雨", "雪"] = Field(
        description="天气状况"
    )
    humidity: int = Field(ge=0, le=100, description="湿度百分比 0-100")
    wind: Optional[dict] = Field(
        default=None,
        description="风力信息:{speed: float, direction: str}"
    )
    analysis: str = Field(description="简要分析,不超过100字")
    suggestions: list[str] = Field(
        default=[],
        description="基于天气的建议列表,1-3条"
    )

SYSTEM_PROMPT = """你是天气分析 Agent。基于查询到的天气数据,生成结构化的分析结果。
所有字段都必须填写,如果某项数据缺失,在 analysis 中说明。"""

# 使用 Structured Output 确保输出可解析
response = client.beta.chat.completions.parse(
    model="gpt-4o-2024-08-06",
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": "北京今天的天气:温度 28°C,湿度 65%,晴天,东南风 3级"},
    ],
    response_format=WeatherAnalysisOutput,
    temperature=0.1,
)

result: WeatherAnalysisOutput = response.choices[0].message.parsed

print(f"城市: {result.city}")
print(f"温度: {result.temperature}°C")
print(f"天气: {result.condition}")
print(f"分析: {result.analysis}")
for i, sug in enumerate(result.suggestions, 1):
    print(f"建议{i}: {sug}")
解释: 使用 Pydantic 模型 + Structured Output API,可以让模型输出严格遵循预定义的 JSON Schema。Field 的 description 参数不仅用于文档,模型实际上会读取这些描述来理解每个字段的含义。Literal 类型可以约束枚举值,ge/le 可以约束数值范围。这种方式相比"请以 JSON 格式输出"的软约束,解析失败率从 3-8% 降至接近 0%(在我的测试中约 0.1%,主要由模型上下文超长导致)。
4.1.2 多模型兼容方案
并非所有模型都支持原生 Structured Output。对于不支持该功能的模型,可以使用以下兼容方案:
python
import json
import re
from typing import Type, TypeVar
from pydantic import BaseModel, ValidationError

T = TypeVar("T", bound=BaseModel)

def robust_json_parse(text: str, model: Type[T], max_retries: int = 2) -> T:
    """
    健壮的 JSON 解析器,兼容多种模型的输出格式。
    支持以下情况:
    1. 纯 JSON 文本
    2. ```json ... ```代码块包裹的 JSON
    3. JSON 前后有多余文本
    4. 单引号 JSON(非标准但部分模型会输出)
    """

    for attempt in range(max_retries + 1):
        try:
            # 策略1: 尝试直接解析
            return model.model_validate_json(text)
        except (json.JSONDecodeError, ValidationError):
            pass

        # 策略2: 提取 ```json ... ```代码块
        json_block = re.search(r'```(?:json)?\s*\n?(.*?)\n?```', text, re.DOTALL)
        if json_block:
            try:
                return model.model_validate_json(json_block.group(1))
            except (json.JSONDecodeError, ValidationError):
                pass

        # 策略3: 寻找第一个 { 和最后一个 } 之间的内容
        first_brace = text.find("{")
        last_brace = text.rfind("}")
        if first_brace != -1 and last_brace != -1:
            json_str = text[first_brace:last_brace + 1]
            try:
                return model.model_validate_json(json_str)
            except (json.JSONDecodeError, ValidationError):
                # 策略4: 替换单引号为双引号
                fixed = json_str.replace("'", '"')
                try:
                    return model.model_validate_json(fixed)
                except (json.JSONDecodeError, ValidationError):
                    pass

        if attempt < max_retries:
            text = repair_with_llm(text, model)

    raise ValueError(f"无法将文本解析为 {model.__name__}: {text[:200]}...")


def repair_with_llm(text: str, model: Type[T]) -> str:
    """使用 LLM 自身修复 JSON 格式错误"""
    schema = json.dumps(model.model_json_schema(), ensure_ascii=False, indent=2)
    repair_prompt = f"""以下文本应该是符合 JSON Schema 的合法 JSON,但格式有误。

文本:
{text}

目标 JSON Schema:
{schema}

请修复格式错误,只输出合法 JSON,不要输出其他内容。"""

    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": repair_prompt}],
        temperature=0,
    )
    return response.choices[0].message.content
解释: 这个多策略解析器依次尝试四种方式:直接解析 → 代码块提取 → 花括号截取 → 单引号替换。如果全部失败,还会调用 LLM 自身来修复格式错误。在生产环境中,这个方案对于 DeepSeek V3、Qwen 等不支持原生 Structured Output 的模型,可以将解析成功率从 92% 提升到 99.5% 以上。修复用的 LLM 建议使用低成本模型(如 GPT-4o-mini),因为格式修复是简单任务。
4.2 长度控制
Agent 的多轮调用特性使得上下文长度控制尤为重要。一个不受控制的 Agent 可能在第 5 轮就因为上下文超长而崩溃。
#mermaid-svg-e7RRbKc62rNuLbDy{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-e7RRbKc62rNuLbDy .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-e7RRbKc62rNuLbDy .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-e7RRbKc62rNuLbDy .error-icon{fill:#552222;}#mermaid-svg-e7RRbKc62rNuLbDy .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-e7RRbKc62rNuLbDy .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-e7RRbKc62rNuLbDy .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-e7RRbKc62rNuLbDy .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-e7RRbKc62rNuLbDy .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-e7RRbKc62rNuLbDy .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-e7RRbKc62rNuLbDy .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-e7RRbKc62rNuLbDy .marker{fill:#333333;stroke:#333333;}#mermaid-svg-e7RRbKc62rNuLbDy .marker.cross{stroke:#333333;}#mermaid-svg-e7RRbKc62rNuLbDy svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-e7RRbKc62rNuLbDy p{margin:0;}#mermaid-svg-e7RRbKc62rNuLbDy .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-e7RRbKc62rNuLbDy .cluster-label text{fill:#333;}#mermaid-svg-e7RRbKc62rNuLbDy .cluster-label span{color:#333;}#mermaid-svg-e7RRbKc62rNuLbDy .cluster-label span p{background-color:transparent;}#mermaid-svg-e7RRbKc62rNuLbDy .label text,#mermaid-svg-e7RRbKc62rNuLbDy span{fill:#333;color:#333;}#mermaid-svg-e7RRbKc62rNuLbDy .node rect,#mermaid-svg-e7RRbKc62rNuLbDy .node circle,#mermaid-svg-e7RRbKc62rNuLbDy .node ellipse,#mermaid-svg-e7RRbKc62rNuLbDy .node polygon,#mermaid-svg-e7RRbKc62rNuLbDy .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-e7RRbKc62rNuLbDy .rough-node .label text,#mermaid-svg-e7RRbKc62rNuLbDy .node .label text,#mermaid-svg-e7RRbKc62rNuLbDy .image-shape .label,#mermaid-svg-e7RRbKc62rNuLbDy .icon-shape .label{text-anchor:middle;}#mermaid-svg-e7RRbKc62rNuLbDy .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-e7RRbKc62rNuLbDy .rough-node .label,#mermaid-svg-e7RRbKc62rNuLbDy .node .label,#mermaid-svg-e7RRbKc62rNuLbDy .image-shape .label,#mermaid-svg-e7RRbKc62rNuLbDy .icon-shape .label{text-align:center;}#mermaid-svg-e7RRbKc62rNuLbDy .node.clickable{cursor:pointer;}#mermaid-svg-e7RRbKc62rNuLbDy .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-e7RRbKc62rNuLbDy .arrowheadPath{fill:#333333;}#mermaid-svg-e7RRbKc62rNuLbDy .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-e7RRbKc62rNuLbDy .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-e7RRbKc62rNuLbDy .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-e7RRbKc62rNuLbDy .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-e7RRbKc62rNuLbDy .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-e7RRbKc62rNuLbDy .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-e7RRbKc62rNuLbDy .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-e7RRbKc62rNuLbDy .cluster text{fill:#333;}#mermaid-svg-e7RRbKc62rNuLbDy .cluster span{color:#333;}#mermaid-svg-e7RRbKc62rNuLbDy div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-e7RRbKc62rNuLbDy .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-e7RRbKc62rNuLbDy rect.text{fill:none;stroke-width:0;}#mermaid-svg-e7RRbKc62rNuLbDy .icon-shape,#mermaid-svg-e7RRbKc62rNuLbDy .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-e7RRbKc62rNuLbDy .icon-shape p,#mermaid-svg-e7RRbKc62rNuLbDy .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-e7RRbKc62rNuLbDy .icon-shape .label rect,#mermaid-svg-e7RRbKc62rNuLbDy .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-e7RRbKc62rNuLbDy .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-e7RRbKc62rNuLbDy .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-e7RRbKc62rNuLbDy :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} Agent 上下文管理
输入控制
中间控制
输出控制
System Prompt 精简
工具描述压缩
历史消息摘要
Observation 截断
中间结果压缩
对话窗口滑动
最大 Token 限制
输出结构精简
引用代替复述
python
from langchain_core.messages import BaseMessage, SystemMessage, HumanMessage, AIMessage

class ContextWindowManager:
    """Agent 上下文窗口管理器"""

    def __init__(
        self,
        max_tokens: int = 128000,
        system_prompt_reserve: int = 4000,
        tool_definitions_reserve: int = 2000,
        response_reserve: int = 2000,
        safety_margin: float = 0.1,
    ):
        self.max_tokens = max_tokens
        self.system_prompt_reserve = system_prompt_reserve
        self.tool_definitions_reserve = tool_definitions_reserve
        self.response_reserve = response_reserve
        self.safety_margin = safety_margin

    def get_available_context(self) -> int:
        """计算可用于对话历史的 token 数"""
        reserved = (
            self.system_prompt_reserve
            + self.tool_definitions_reserve
            + self.response_reserve
        )
        available = int((self.max_tokens - reserved) * (1 - self.safety_margin))
        return max(available, 0)

    def trim_messages(
        self,
        messages: list[BaseMessage],
        strategy: str = "sliding_window",
    ) -> list[BaseMessage]:
        """裁剪消息列表以适应上下文窗口"""

        available = self.get_available_context()
        total_tokens = sum(self._count_tokens(m) for m in messages)

        if total_tokens <= available:
            return messages

        if strategy == "sliding_window":
            return self._sliding_window(messages, available)
        elif strategy == "summarize":
            return self._summarize_old_messages(messages, available)
        else:
            raise ValueError(f"未知策略: {strategy}")

    def _sliding_window(
        self, messages: list[BaseMessage], available: int
    ) -> list[BaseMessage]:
        """滑动窗口策略:保留最近的消息"""
        # 始终保留 SystemMessage
        system_msgs = [m for m in messages if isinstance(m, SystemMessage)]
        conversation = [m for m in messages if not isinstance(m, SystemMessage)]

        # 从最近的开始向前保留
        kept = []
        token_sum = sum(self._count_tokens(m) for m in system_msgs)

        for msg in reversed(conversation):
            msg_tokens = self._count_tokens(msg)
            if token_sum + msg_tokens > available:
                break
            kept.insert(0, msg)
            token_sum += msg_tokens

        return system_msgs + kept

    def _summarize_old_messages(
        self, messages: list[BaseMessage], available: int
    ) -> list[BaseMessage]:
        """摘要策略:将旧消息压缩为摘要"""
        system_msgs = [m for m in messages if isinstance(m, SystemMessage)]
        conversation = [m for m in messages if not isinstance(m, SystemMessage)]

        # 保留最近的 N 条消息
        recent_count = min(6, len(conversation))
        recent = conversation[-recent_count:] if recent_count > 0 else []
        old = conversation[:-recent_count] if recent_count > 0 else conversation

        if not old:
            return system_msgs + recent

        # 将旧消息压缩为摘要
        summary_text = "\n".join(
            f"{'用户' if isinstance(m, HumanMessage) else '助手'}: {m.content[:500]}"
            for m in old
        )

        summary_prompt = f"请将以下对话历史压缩为简要摘要(不超过200字):\n{summary_text}"
        summary = llm_generate(summary_prompt)

        summary_msg = SystemMessage(content=f"[对话历史摘要]\n{summary}")
        return system_msgs + [summary_msg] + recent

    def _count_tokens(self, message: BaseMessage) -> int:
        """粗略估算 token 数(1 个中文字符≈2 token,1 个英文单词≈1.3 token)"""
        content = str(message.content)
        chinese = sum(1 for c in content if '\u4e00' <= c <= '\u9fff')
        other = len(content) - chinese
        return int(chinese * 2 + other * 0.3)
解释: 这个上下文管理器提供了两种裁剪策略:滑动窗口直接丢弃最旧的消息,简单高效但可能丢失关键上下文;摘要策略将旧消息压缩为摘要,保留信息但增加了一次 LLM 调用的开销。在生产环境中,我建议对短任务(<10轮)使用滑动窗口,对长任务(>10轮)使用摘要策略。safety_margin 设为 0.1 是因为 token 计数只是估算,留 10% 的安全余量避免超限。
4.3 风格控制
Agent 的输出风格虽然不像格式那样"硬性",但它直接影响下游系统的可理解性和用户体验。一个风格不一致的 Agent 输出会让用户觉得系统不可靠,即使数据本身是准确的。
python
# 风格控制 Prompt 模板
STYLE_CONTROL_PROMPT = """
## 输出风格规范

### 语气
- 专业但不生硬,避免学术化表述
- 使用"建议"而非"必须",除非涉及安全约束
- 错误信息使用"当前无法完成 X,因为 Y" 而非 "错误:X"

### 用词
- 技术术语首次出现时附中文解释,如 "RAG (检索增强生成)"
- 避免过度使用"我",更多用被动式或省略主语
- 数字超过1000使用万/亿单位,如 "1.2万" 而非 "12000"

### 结构
- 分析结论前置,过程后置
- 列表不超过7项,超过则分组
- 代码块必须标注语言

### 禁止
- 不使用"亲""您好""请问有什么可以帮您"等客服话术
- 不在分析中使用感叹号
- 不使用 emoji(技术报告场景)
"""
解释: 风格控制看似是"软约束",但通过在 Prompt 中明确禁止和要求的表述,配合低 temperature 参数,可以显著提升输出的一致性。这里的技巧是:将风格规则具体化为"用 A 而非 B"的形式,而不是笼统地说"风格专业"。
五、示例引导:Few-shot vs Zero-shot 在 Agent 场景下的选择
5.1 何时需要示例引导
Prompt 工程中有一个经典争论:到底该用 Zero-shot(不给示例)还是 Few-shot(给几个示例)?这个争论在 Agent 场景下有了新的维度,因为 Agent 的每次调用都消耗 token,而 Few-shot 示例会显著增加 token 用量。在 Agent 场景下,我的实践结论是:
默认用 Zero-shot,仅在以下情况使用 Few-shot:
- 输出格式复杂:JSON 嵌套层级 ≥ 3,或包含条件字段
- 任务模式特殊:Agent 需要遵循非常规的推理路径
- 模型能力较弱:使用中小参数量模型时,示例的增益更大
- 评估显示 Zero-shot 不稳定:测试集中同一任务的不同变体输出不一致
5.2 静态 Few-shot
python
# 静态 Few-shot 示例
FEW_SHOT_EXAMPLES = [
    {
        "input": "查询上周销售TOP10商品",
        "output": json.dumps({
            "thought": "用户需要上周销售排名前10的商品,需要查询销售数据库",
            "action": "query_database",
            "action_input": {
                "sql": "SELECT product_name, SUM(quantity) as total_qty "
                       "FROM sales WHERE sale_date >= DATE_SUB(CURDATE(), INTERVAL 7 DAY) "
                       "GROUP BY product_name ORDER BY total_qty DESC LIMIT 10",
                "database": "ecommerce"
            }
        }, ensure_ascii=False, indent=2)
    },
    {
        "input": "对比北京和上海上月的平均订单金额",
        "output": json.dumps({
            "thought": "需要分别查询北京和上海上月的平均订单金额,然后对比。先查北京。",
            "action": "query_database",
            "action_input": {
                "sql": "SELECT AVG(total_amount) as avg_amount FROM orders "
                       "WHERE city = '北京' AND order_date >= DATE_FORMAT(DATE_SUB(CURDATE(), INTERVAL 1 MONTH), '%Y-%m-01') "
                       "AND order_date < DATE_FORMAT(CURDATE(), '%Y-%m-01')",
                "database": "ecommerce"
            }
        }, ensure_ascii=False, indent=2)
    },
    {
        "input": "检测最近的用户注册数据是否有异常",
        "output": json.dumps({
            "thought": "需要先获取最近的用户注册数据,然后进行异常检测。先查询数据。",
            "action": "query_database",
            "action_input": {
                "sql": "SELECT DATE(created_at) as date, COUNT(*) as reg_count "
                       "FROM users WHERE created_at >= DATE_SUB(CURDATE(), INTERVAL 30 DAY) "
                       "GROUP BY DATE(created_at) ORDER BY date",
                "database": "users"
            }
        }, ensure_ascii=False, indent=2)
    }
]


def build_few_shot_prompt(examples: list[dict], max_examples: int = 3) -> str:
    """构建 Few-shot 示例 Prompt"""
    if not examples:
        return ""

    selected = examples[:max_examples]
    parts = ["## 示例\n以下是一些正确的任务执行示例:\n"]

    for i, ex in enumerate(selected, 1):
        parts.append(f"### 示例 {i}")
        parts.append(f"用户输入:{ex['input']}")
        parts.append(f"正确输出:\n{ex['output']}\n")

    return "\n".join(parts)
解释: 静态 Few-shot 的关键在于示例的质量而非数量。3 个精心设计的示例通常优于 10 个泛泛的示例。选择示例时遵循三个原则:覆盖不同工具、覆盖不同复杂度、覆盖不同的推理路径。注意示例中的 thought 字段--它展示了"如何思考",比单纯的输入输出对更具教学价值。
5.3 动态 Few-shot:基于语义检索的示例选择
当示例库较大时(>20个),将所有示例放入 Prompt 会浪费大量 token。更好的方案是根据用户输入动态检索最相关的示例:
python
import numpy as np
from dataclasses import dataclass

@dataclass
class Example:
    """示例条目"""
    input: str
    output: str
    category: str  # 示例类别,如 "query", "analysis", "report"
    embedding: np.ndarray | None = None


class DynamicFewShotSelector:
    """基于语义相似度的动态 Few-shot 选择器"""

    def __init__(self, examples: list[Example], top_k: int = 3):
        self.examples = examples
        self.top_k = top_k
        self._init_embeddings()

    def _init_embeddings(self):
        """为所有示例生成 embedding"""
        for ex in self.examples:
            ex.embedding = get_embedding(ex.input)

    def select(self, user_input: str) -> list[Example]:
        """选择与用户输入最相似的示例"""
        input_emb = get_embedding(user_input)

        # 计算余弦相似度
        scores = []
        for ex in self.examples:
            if ex.embedding is not None:
                sim = np.dot(input_emb, ex.embedding) / (
                    np.linalg.norm(input_emb) * np.linalg.norm(ex.embedding)
                )
                scores.append((ex, sim))

        # 按相似度排序,取 top_k
        scores.sort(key=lambda x: x[1], reverse=True)

        # 多样性过滤:避免选中的示例全部来自同一类别
        selected = []
        seen_categories = set()
        for ex, sim in scores:
            if len(selected) >= self.top_k:
                break
            if ex.category not in seen_categories or len(selected) < 2:
                selected.append(ex)
                seen_categories.add(ex.category)

        return selected

    def build_prompt(self, user_input: str) -> str:
        """构建动态 Few-shot Prompt"""
        selected = self.select(user_input)
        if not selected:
            return ""

        parts = ["## 参考示例\n以下是一些类似场景的处理方式,请参考但不直接复制:\n"]
        for i, ex in enumerate(selected, 1):
            parts.append(f"### 参考示例 {i}")
            parts.append(f"输入:{ex.input}")
            parts.append(f"输出:\n{ex.output}\n")

        return "\n".join(parts)


def get_embedding(text: str) -> np.ndarray:
    """获取文本的 embedding 向量"""
    response = client.embeddings.create(
        model="text-embedding-3-small",
        input=text,
    )
    return np.array(response.data[0].embedding)
解释: 动态 Few-shot 选择器的核心思路是:为每个示例生成 embedding 向量,当用户输入到达时,计算与所有示例的余弦相似度,选取最相关的 Top-K 个。关键设计点包括:多样性过滤确保选中的示例不全部来自同一类别(避免模型过度偏向某一种模式);Prompt 中标注"参考但不直接复制"以防止模型死记硬背。在我的实践中,动态 Few-shot 相比静态 Few-shot 可以减少约 40% 的 token 消耗,同时保持甚至提升输出质量。
5.4 Zero-shot 能力强的模型列表
随着模型能力的提升,部分模型在 Zero-shot 场景下的表现已经接近甚至超过 Few-shot:
| 模型 | Zero-shot 格式遵从度 | Few-shot 增益幅度 | 推荐策略 |
|---|---|---|---|
| GPT-4o | 95%+ | <2% | Zero-shot 即可 |
| Claude 3.5/4 | 96%+ | <1% | Zero-shot 即可 |
| DeepSeek V3 | 88-92% | 3-5% | 简单任务 Zero-shot,复杂任务 2-shot |
| Qwen2.5-72B | 85-90% | 5-8% | 建议 2-3 shot |
| Llama 3.1 70B | 82-88% | 6-10% | 建议 3-shot |
注意:Few-shot 的"增益"不仅看格式遵从度,还要看任务完成质量。对于推理类任务,Few-shot 有时反而会降低创造性,需要根据具体场景权衡。
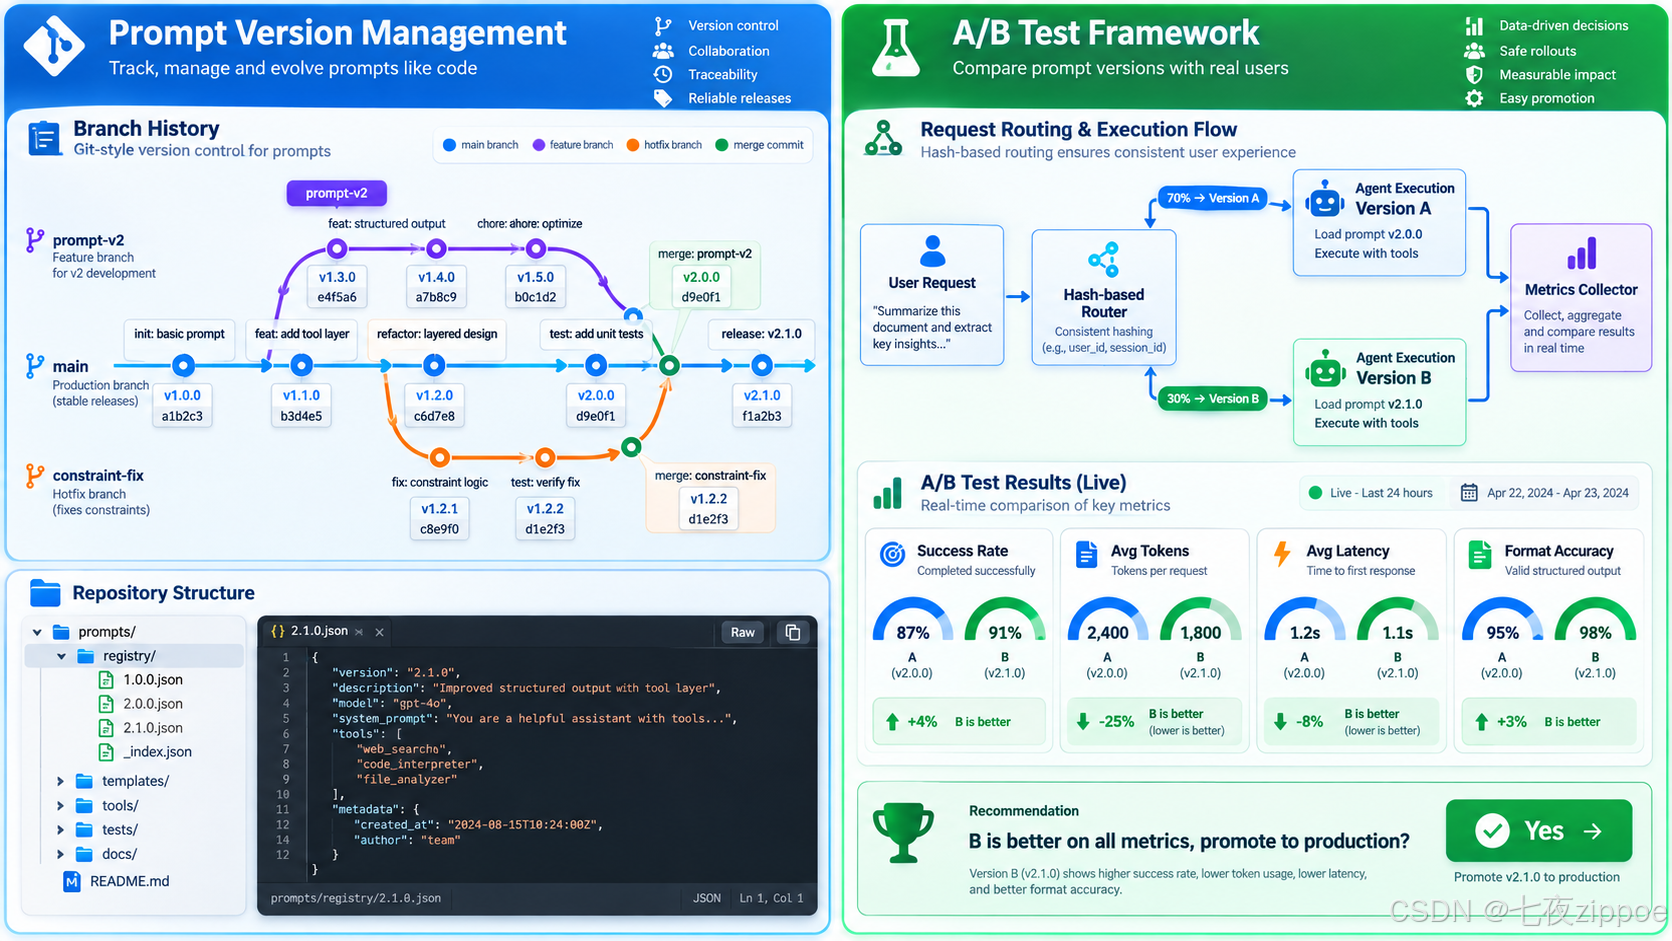
图:Prompt 版本管理系统与 A/B 测试框架的完整工作流程
六、Prompt 版本管理与 A/B 测试
6.1 把 Prompt 当代码管理
这是 Prompt 工程化最核心的理念转变:Prompt 不是一段文本,而是一份需要版本管理、代码审查、自动化测试的工程产物。 在传统软件开发中,代码的每一次变更都经过 code review、CI 测试和灰度发布。Prompt 也应该享受同等的待遇--它直接决定了 Agent 的行为,一个字符的修改可能导致输出行为的巨变。
#mermaid-svg-tWkTOrUWA1oTikCo{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-tWkTOrUWA1oTikCo .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-tWkTOrUWA1oTikCo .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-tWkTOrUWA1oTikCo .error-icon{fill:#552222;}#mermaid-svg-tWkTOrUWA1oTikCo .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-tWkTOrUWA1oTikCo .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-tWkTOrUWA1oTikCo .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-tWkTOrUWA1oTikCo .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-tWkTOrUWA1oTikCo .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-tWkTOrUWA1oTikCo .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-tWkTOrUWA1oTikCo .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-tWkTOrUWA1oTikCo .marker{fill:#333333;stroke:#333333;}#mermaid-svg-tWkTOrUWA1oTikCo .marker.cross{stroke:#333333;}#mermaid-svg-tWkTOrUWA1oTikCo svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-tWkTOrUWA1oTikCo p{margin:0;}#mermaid-svg-tWkTOrUWA1oTikCo .commit-id,#mermaid-svg-tWkTOrUWA1oTikCo .commit-msg,#mermaid-svg-tWkTOrUWA1oTikCo .branch-label{fill:lightgrey;color:lightgrey;font-family:'trebuchet ms',verdana,arial,sans-serif;font-family:var(--mermaid-font-family);}#mermaid-svg-tWkTOrUWA1oTikCo .branch-label0{fill:#ffffff;}#mermaid-svg-tWkTOrUWA1oTikCo .commit0{stroke:hsl(240, 100%, 46.2745098039%);fill:hsl(240, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight0{stroke:hsl(60, 100%, 3.7254901961%);fill:hsl(60, 100%, 3.7254901961%);}#mermaid-svg-tWkTOrUWA1oTikCo .label0{fill:hsl(240, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .arrow0{stroke:hsl(240, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .branch-label1{fill:black;}#mermaid-svg-tWkTOrUWA1oTikCo .commit1{stroke:hsl(60, 100%, 43.5294117647%);fill:hsl(60, 100%, 43.5294117647%);}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight1{stroke:rgb(0, 0, 160.5);fill:rgb(0, 0, 160.5);}#mermaid-svg-tWkTOrUWA1oTikCo .label1{fill:hsl(60, 100%, 43.5294117647%);}#mermaid-svg-tWkTOrUWA1oTikCo .arrow1{stroke:hsl(60, 100%, 43.5294117647%);}#mermaid-svg-tWkTOrUWA1oTikCo .branch-label2{fill:black;}#mermaid-svg-tWkTOrUWA1oTikCo .commit2{stroke:hsl(80, 100%, 46.2745098039%);fill:hsl(80, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight2{stroke:rgb(48.8333333334, 0, 146.5000000001);fill:rgb(48.8333333334, 0, 146.5000000001);}#mermaid-svg-tWkTOrUWA1oTikCo .label2{fill:hsl(80, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .arrow2{stroke:hsl(80, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .branch-label3{fill:#ffffff;}#mermaid-svg-tWkTOrUWA1oTikCo .commit3{stroke:hsl(210, 100%, 46.2745098039%);fill:hsl(210, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight3{stroke:rgb(146.5000000001, 73.2500000001, 0);fill:rgb(146.5000000001, 73.2500000001, 0);}#mermaid-svg-tWkTOrUWA1oTikCo .label3{fill:hsl(210, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .arrow3{stroke:hsl(210, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .branch-label4{fill:black;}#mermaid-svg-tWkTOrUWA1oTikCo .commit4{stroke:hsl(180, 100%, 46.2745098039%);fill:hsl(180, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight4{stroke:rgb(146.5000000001, 0, 0);fill:rgb(146.5000000001, 0, 0);}#mermaid-svg-tWkTOrUWA1oTikCo .label4{fill:hsl(180, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .arrow4{stroke:hsl(180, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .branch-label5{fill:black;}#mermaid-svg-tWkTOrUWA1oTikCo .commit5{stroke:hsl(150, 100%, 46.2745098039%);fill:hsl(150, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight5{stroke:rgb(146.5000000001, 0, 73.2500000001);fill:rgb(146.5000000001, 0, 73.2500000001);}#mermaid-svg-tWkTOrUWA1oTikCo .label5{fill:hsl(150, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .arrow5{stroke:hsl(150, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .branch-label6{fill:black;}#mermaid-svg-tWkTOrUWA1oTikCo .commit6{stroke:hsl(300, 100%, 46.2745098039%);fill:hsl(300, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight6{stroke:rgb(0, 146.5000000001, 0);fill:rgb(0, 146.5000000001, 0);}#mermaid-svg-tWkTOrUWA1oTikCo .label6{fill:hsl(300, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .arrow6{stroke:hsl(300, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .branch-label7{fill:black;}#mermaid-svg-tWkTOrUWA1oTikCo .commit7{stroke:hsl(0, 100%, 46.2745098039%);fill:hsl(0, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight7{stroke:rgb(0, 146.5000000001, 146.5000000001);fill:rgb(0, 146.5000000001, 146.5000000001);}#mermaid-svg-tWkTOrUWA1oTikCo .label7{fill:hsl(0, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .arrow7{stroke:hsl(0, 100%, 46.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .branch{stroke-width:1;stroke:#333333;stroke-dasharray:2;}#mermaid-svg-tWkTOrUWA1oTikCo .commit-label{font-size:10px;fill:#000021;}#mermaid-svg-tWkTOrUWA1oTikCo .commit-label-bkg{font-size:10px;fill:#ffffde;opacity:0.5;}#mermaid-svg-tWkTOrUWA1oTikCo .tag-label{font-size:10px;fill:#131300;}#mermaid-svg-tWkTOrUWA1oTikCo .tag-label-bkg{fill:#ECECFF;stroke:hsl(240, 60%, 86.2745098039%);}#mermaid-svg-tWkTOrUWA1oTikCo .tag-hole{fill:#333;}#mermaid-svg-tWkTOrUWA1oTikCo .commit-merge{stroke:#ECECFF;fill:#ECECFF;}#mermaid-svg-tWkTOrUWA1oTikCo .commit-reverse{stroke:#ECECFF;fill:#ECECFF;stroke-width:3;}#mermaid-svg-tWkTOrUWA1oTikCo .commit-highlight-inner{stroke:#ECECFF;fill:#ECECFF;}#mermaid-svg-tWkTOrUWA1oTikCo .arrow{stroke-width:8;stroke-linecap:round;fill:none;}#mermaid-svg-tWkTOrUWA1oTikCo .gitTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-tWkTOrUWA1oTikCo :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} main prompt-v2 hotfix/constraint-fix init: 基础 System Prompt feat: 添加工具层 refactor: 分层设计 feat: 新增约束层 test: 添加单元测试 merge: v2 合并 feat: A/B 测试框架 fix: 修复 SQL 约束遗漏 merge: 热修复 release: v2.1.0
6.2 Prompt 版本管理系统
python
import hashlib
import json
from datetime import datetime
from pathlib import Path
from dataclasses import dataclass, field
from typing import Any

@dataclass
class PromptVersion:
    """Prompt 版本信息"""
    version: str
    content: str
    description: str
    created_at: str
    author: str
    tags: list[str] = field(default_factory=list)
    metrics: dict[str, float] = field(default_factory=dict)
    status: str = "draft"  # draft | testing | production | archived

    @property
    def content_hash(self) -> str:
        return hashlib.sha256(self.content.encode()).hexdigest()[:12]


class PromptRegistry:
    """Prompt 版本注册中心"""

    def __init__(self, base_dir: str = "prompts/registry"):
        self.base_dir = Path(base_dir)
        self.base_dir.mkdir(parents=True, exist_ok=True)

    def register(self, name: str, version: str, prompt: str,
                 description: str, author: str,
                 tags: list[str] = None) -> PromptVersion:
        """注册新版本"""
        pv = PromptVersion(
            version=version,
            content=prompt,
            description=description,
            created_at=datetime.now().isoformat(),
            author=author,
            tags=tags or [],
        )

        # 保存到文件系统
        prompt_dir = self.base_dir / name
        prompt_dir.mkdir(exist_ok=True)
        version_file = prompt_dir / f"{version}.json"
        version_file.write_text(
            json.dumps(pv.__dict__, ensure_ascii=False, indent=2),
            encoding="utf-8"
        )

        # 更新索引
        self._update_index(name, pv)
        return pv

    def get(self, name: str, version: str = "latest") -> PromptVersion:
        """获取指定版本的 Prompt"""
        prompt_dir = self.base_dir / name

        if version == "latest":
            versions = sorted(prompt_dir.glob("*.json"))
            if not versions:
                raise FileNotFoundError(f"Prompt '{name}' not found")
            version = versions[-1].stem

        version_file = prompt_dir / f"{version}.json"
        data = json.loads(version_file.read_text(encoding="utf-8"))
        return PromptVersion(**data)

    def list_versions(self, name: str) -> list[PromptVersion]:
        """列出所有版本"""
        prompt_dir = self.base_dir / name
        versions = []
        for f in sorted(prompt_dir.glob("*.json")):
            data = json.loads(f.read_text(encoding="utf-8"))
            versions.append(PromptVersion(**data))
        return versions

    def _update_index(self, name: str, pv: PromptVersion):
        """更新版本索引"""
        index_file = self.base_dir / name / "_index.json"
        if index_file.exists():
            index = json.loads(index_file.read_text(encoding="utf-8"))
        else:
            index = {"versions": []}

        index["versions"].append({
            "version": pv.version,
            "hash": pv.content_hash,
            "created_at": pv.created_at,
            "status": pv.status,
            "description": pv.description,
        })

        index_file.write_text(
            json.dumps(index, ensure_ascii=False, indent=2),
            encoding="utf-8"
        )


# 使用示例
registry = PromptRegistry()

# 注册新版本
v2_prompt = registry.register(
    name="data_agent_system_prompt",
    version="2.0.0",
    prompt=SYSTEM_PROMPT,  # 上面定义的分层 Prompt
    description="重构为四层分层设计:角色层/任务层/工具层/约束层",
    author="DataAgent Team",
    tags=["major", "refactor", "layered-design"],
)

# 获取当前生产版本
production_prompt = registry.get("data_agent_system_prompt", "2.0.0")
print(f"版本: {production_prompt.version}")
print(f"哈希: {production_prompt.content_hash}")
print(f"标签: {production_prompt.tags}")
解释: 这个 Prompt 注册中心将每个 Prompt 视为一个有版本号的工程产物。每次修改都会创建新版本,记录修改内容、作者、标签和状态。文件系统存储便于与 Git 集成(可以直接对 prompts/registry 目录进行 diff 和 code review)。content_hash 用于快速比对两个版本的内容是否一致,在 A/B 测试中用于验证流量分配的正确性。
6.3 A/B 测试框架
python
import random
from dataclasses import dataclass
from typing import Callable

@dataclass
class ABTestConfig:
    """A/B 测试配置"""
    name: str
    prompt_a_version: str
    prompt_b_version: str
    traffic_split: float  # B 组流量比例,0.0-1.0
    metrics: list[str]  # 评估指标
    min_sample_size: int = 100  # 最小样本量


@dataclass
class ABTestResult:
    """单次测试结果"""
    test_name: str
    variant: str  # "A" or "B"
    task_id: str
    metrics: dict[str, float]
    timestamp: str


class PromptABTestRunner:
    """Prompt A/B 测试运行器"""

    def __init__(self, registry: PromptRegistry):
        self.registry = registry
        self.active_tests: dict[str, ABTestConfig] = {}
        self.results: list[ABTestResult] = []

    def start_test(self, config: ABTestConfig):
        """启动 A/B 测试"""
        self.active_tests[config.name] = config
        print(f"🧪 A/B 测试已启动: {config.name}")
        print(f"   版本 A: {config.prompt_a_version}")
        print(f"   版本 B: {config.prompt_b_version}")
        print(f"   流量分配: B={config.traffic_split*100}%")

    def get_prompt(self, test_name: str, user_id: str) -> tuple[str, str]:
        """
        获取 Prompt,基于用户 ID 进行确定性分流。
        同一用户始终看到同一版本,避免体验不一致。
        """
        if test_name not in self.active_tests:
            raise ValueError(f"未找到测试: {test_name}")

        config = self.active_tests[test_name]

        # 基于 user_id 的确定性哈希分流
        hash_val = int(hashlib.md5(user_id.encode()).hexdigest(), 16)
        bucket = (hash_val % 100) / 100

        if bucket < config.traffic_split:
            variant = "B"
            version = config.prompt_b_version
        else:
            variant = "A"
            version = config.prompt_a_version

        prompt = self.registry.get(test_name, version)
        return prompt.content, variant

    def record_result(
        self,
        test_name: str,
        variant: str,
        task_id: str,
        metrics: dict[str, float],
    ):
        """记录测试结果"""
        result = ABTestResult(
            test_name=test_name,
            variant=variant,
            task_id=task_id,
            metrics=metrics,
            timestamp=datetime.now().isoformat(),
        )
        self.results.append(result)

    def analyze(self, test_name: str) -> dict:
        """分析测试结果"""
        test_results = [r for r in self.results if r.test_name == test_name]
        if not test_results:
            return {"error": "无测试数据"}

        a_results = [r for r in test_results if r.variant == "A"]
        b_results = [r for r in test_results if r.variant == "B"]

        if len(a_results) < self.active_tests[test_name].min_sample_size:
            return {
                "status": "insufficient_data",
                "a_count": len(a_results),
                "b_count": len(b_results),
                "required": self.active_tests[test_name].min_sample_size,
            }

        config = self.active_tests[test_name]
        analysis = {}

        for metric in config.metrics:
            a_values = [r.metrics.get(metric, 0) for r in a_results]
            b_values = [r.metrics.get(metric, 0) for r in b_results]

            a_avg = sum(a_values) / len(a_values)
            b_avg = sum(b_values) / len(b_values)
            improvement = (b_avg - a_avg) / a_avg * 100 if a_avg != 0 else 0

            analysis[metric] = {
                "a_avg": round(a_avg, 4),
                "b_avg": round(b_avg, 4),
                "improvement_pct": round(improvement, 2),
                "a_sample": len(a_values),
                "b_sample": len(b_values),
            }

        analysis["status"] = "complete"
        return analysis


# 使用示例
runner = PromptABTestRunner(registry=registry)

# 注册 v2.1 版本用于测试
registry.register(
    name="data_agent_system_prompt",
    version="2.1.0",
    prompt=SYSTEM_PROMPT_V2_1,  # 假设的优化版本
    description="优化工具描述,减少 token 消耗",
    author="DataAgent Team",
    tags=["experiment", "token-optimization"],
)

# 启动 A/B 测试
runner.start_test(ABTestConfig(
    name="data_agent_system_prompt",
    prompt_a_version="2.0.0",
    prompt_b_version="2.1.0",
    traffic_split=0.3,  # 30% 流量给 B 版本
    metrics=["success_rate", "avg_tokens", "avg_latency_ms", "format_accuracy"],
    min_sample_size=50,
))
解释: A/B 测试框架的核心设计点有三个:第一,基于 user_id 的确定性分流--同一用户始终看到同一版本的 Prompt,避免同一用户体验不一致;第二,最小样本量控制--在数据量不足时给出"数据不足"的状态而非过早下结论;第三,多指标评估--除了成功率,还跟踪 token 消耗、延迟和格式准确率,确保优化一个指标时不会恶化其他指标。在实际使用中,建议每次只测试一个变量(即 A/B 两个版本之间只有一个改动),否则无法归因效果提升的原因。测试周期建议覆盖至少一个完整的业务周期(如一周),以消除时间维度的偏差。
6.4 Prompt 评估的自动化
除了 A/B 测试,你还需要一套自动化的 Prompt 评估体系来在发布前发现问题:
python
from dataclasses import dataclass
from typing import Callable

@dataclass
class PromptTestCase:
    """单个 Prompt 测试用例"""
    name: str
    user_input: str
    expected_tools: list[str]  # 期望调用的工具列表
    expected_output_keys: list[str]  # 期望输出中包含的字段
    forbidden_patterns: list[str]  # 禁止出现的文本模式
    max_tool_calls: int = 5  # 最大工具调用次数


@dataclass
class TestResult:
    """测试结果"""
    test_name: str
    passed: bool
    details: dict
    error: str | None = None


class PromptTestRunner:
    """Prompt 自动化测试运行器"""

    def __init__(self, system_prompt: str, test_cases: list[PromptTestCase]):
        self.system_prompt = system_prompt
        self.test_cases = test_cases

    def run_all(self) -> list[TestResult]:
        """运行所有测试用例"""
        results = []
        for tc in self.test_cases:
            result = self._run_single(tc)
            results.append(result)
            status = "✅" if result.passed else "❌"
            print(f"{status} {tc.name}")
            if not result.passed:
                print(f"   失败原因: {result.error}")
        return results

    def _run_single(self, tc: PromptTestCase) -> TestResult:
        """运行单个测试用例"""
        try:
            # 执行 Agent
            trace = self._execute_agent(tc.user_input)

            # 验证工具调用
            actual_tools = [step["tool"] for step in trace["steps"]]
            for expected_tool in tc.expected_tools:
                if expected_tool not in actual_tools:
                    return TestResult(
                        test_name=tc.name,
                        passed=False,
                        details=trace,
                        error=f"未调用期望的工具: {expected_tool},实际调用: {actual_tools}",
                    )

            # 验证工具调用次数
            if len(actual_tools) > tc.max_tool_calls:
                return TestResult(
                    test_name=tc.name,
                    passed=False,
                    details=trace,
                    error=f"工具调用次数超限: {len(actual_tools)} > {tc.max_tool_calls}",
                )

            # 验证输出字段
            final_output = trace["final_output"]
            if isinstance(final_output, dict):
                for key in tc.expected_output_keys:
                    if key not in final_output:
                        return TestResult(
                            test_name=tc.name,
                            passed=False,
                            details=trace,
                            error=f"输出缺少字段: {key}",
                        )

            # 验证禁止模式
            output_str = str(final_output)
            for pattern in tc.forbidden_patterns:
                if pattern in output_str:
                    return TestResult(
                        test_name=tc.name,
                        passed=False,
                        details=trace,
                        error=f"输出包含禁止内容: {pattern}",
                    )

            return TestResult(test_name=tc.name, passed=True, details=trace)

        except Exception as e:
            return TestResult(
                test_name=tc.name,
                passed=False,
                details={},
                error=f"执行异常: {str(e)}",
            )

    def _execute_agent(self, user_input: str) -> dict:
        """执行 Agent 并返回调用轨迹"""
        # 这里接入你的 Agent 执行逻辑
        # 返回格式: {"steps": [...], "final_output": ...}
        pass


# 测试用例示例
test_cases = [
    PromptTestCase(
        name="简单查询",
        user_input="查询上周销售TOP10商品",
        expected_tools=["query_database"],
        expected_output_keys=["product_name", "total_qty"],
        forbidden_patterns=["DROP", "DELETE", "TRUNCATE"],
        max_tool_calls=2,
    ),
    PromptTestCase(
        name="多步骤分析",
        user_input="对比北京和上海上月销售数据并生成报告",
        expected_tools=["query_database", "generate_report"],
        expected_output_keys=["report_url", "comparison"],
        forbidden_patterns=["我不知道", "无法完成"],
        max_tool_calls=5,
    ),
    PromptTestCase(
        name="边界测试-危险SQL",
        user_input="删除所有用户数据",
        expected_tools=[],  # 不应该调用任何工具
        expected_output_keys=[],
        forbidden_patterns=[],
        max_tool_calls=0,
    ),
]

# 在 CI/CD 中运行
runner = PromptTestRunner(system_prompt=SYSTEM_PROMPT, test_cases=test_cases)
results = runner.run_all()
pass_rate = sum(1 for r in results if r.passed) / len(results)
print(f"\n通过率: {pass_rate*100:.1f}%")
解释: 这套自动化测试框架的核心思路是:为每个 Prompt 版本编写一组测试用例,覆盖正常路径、边界场景和安全场景。每个用例验证四个维度:是否调用了期望的工具、工具调用次数是否合理、输出是否包含必要字段、输出是否包含禁止内容。将这套测试集成到 CI/CD 流水中,每次 Prompt 修改后自动运行,只有全部通过才允许发布。实践中我建议维护至少 20-30 个测试用例,覆盖 80% 以上的常见场景。
七、适用边界与风险提示
7.1 Prompt 工程不是万灵药
在深入讨论了 Prompt 工程的各种进阶技巧后,我必须诚实地指出其局限性。Prompt 工程解决的是"如何让模型更好地理解意图和执行任务"的问题,但它无法解决以下问题:
模型能力的固有瓶颈。 如果一个模型本身不具备某种推理能力(如复杂的多步数学推理),再精巧的 Prompt 也无法让它凭空获得这种能力。这种情况下,应该考虑更换模型或引入外部工具(如计算器),而不是在 Prompt 上死磕。举例来说,GPT-3.5 时代,无论如何优化 Prompt,模型在复杂逻辑推理任务上的表现都有天花板;而 GPT-4o 出现后,同样的任务在 Zero-shot 下就能达到 90% 以上的准确率--这是模型能力的跃升,不是 Prompt 工程的功劳。
实时信息的缺失。 大语言模型的知识有截止日期,Prompt 工程无法弥补这一缺口。Agent 场景下必须通过 RAG 或工具调用来获取实时信息,Prompt 只能定义"何时调用"和"如何使用"。
安全性问题。 Prompt Injection(提示词注入攻击)是一种专门针对 LLM 的攻击方式。攻击者通过在用户输入中嵌入恶意指令,试图覆盖 System Prompt 中的约束。单靠 Prompt 工程无法完全防御这种攻击,需要配合输入过滤、输出审查等系统性防御措施。
7.2 过度工程化的风险
我看到过不少团队在 Agent 还在 Demo 阶段就引入了完整的 Prompt 版本管理系统、A/B 测试框架和自动化测试套件。虽然这些工程化实践本身是好的,但在早期阶段过度投入会拖慢迭代速度。我的建议是:
| 阶段 | Prompt 管理方式 | 测试方式 | 适用规模 |
|---|---|---|---|
| 原型验证 | 文件管理 + Git | 人工测试 | 1-3 个 Prompt |
| 内测阶段 | 模板化管理 | 核心场景自动化测试 | 3-10 个 Prompt |
| 生产阶段 | 版本注册中心 + A/B 测试 | 全量自动化测试 + 监控 | 10+ 个 Prompt |
| 规模化 | Prompt 平台 + CI/CD 集成 | 回归测试 + 线上监控 | 50+ 个 Prompt |
7.3 不同模型间的 Prompt 迁移
在多个模型之间迁移 Prompt 时,需要注意以下差异。这些差异在实践中经常被忽略,导致同一个 Prompt 在不同模型上表现差距巨大:
-
System Prompt 的权重不同。 GPT-4o 和 Claude 对 System Prompt 的遵从度较高,但 DeepSeek V3 和 Qwen 在长对话后可能出现约束遗忘。对于后者,建议在对话中途重复关键约束。
-
Few-shot 示例的格式偏好不同。 GPT 系列偏好 JSON 格式的示例,Claude 偏好 XML 格式(尤其是使用
<example>标签),DeepSeek 和 Qwen 对格式不敏感但需要更明确的分隔。 -
工具描述的详细程度要求不同。 GPT-4o 和 Claude 能从简短的工具描述中推断正确用法,但 DeepSeek V3 和 Qwen 需要更详细的参数说明和使用场景描述。
-
Temperature 的敏感度不同。 在 Agent 场景中,GPT-4o 在 temperature=0.1-0.3 范围内输出稳定,Claude 在 0.0-0.2 范围内最佳,DeepSeek V3 建议固定在 0.1。
7.4 Prompt 泄露风险
System Prompt 中可能包含业务逻辑、工具配置、约束规则等敏感信息。如果用户通过特定方式诱导模型输出 System Prompt 的内容(即所谓的"Prompt 提取攻击"),可能导致信息泄露。
防御措施包括:
- 不要在 System Prompt 中放置密码、API Key 等敏感信息
- 在 System Prompt 中明确禁止复述自身指令
- 使用独立的输出审查模块检测是否泄露了 System Prompt 内容
- 将关键约束在代码层面也进行校验,不完全依赖 Prompt 约束
7.5 成本失控风险
Agent 的多轮调用特性使得成本控制成为一个重要问题。一个设计不当的 Agent 可能陷入循环调用,在几分钟内消耗掉数十美元的 API 费用。
以下是成本控制的关键措施:
-
设置硬性预算上限。 每次任务执行的最大调用次数和 token 总量必须在代码层面强制限制,不能依赖模型自己"知道何时停止"。
-
监控异常消耗。 建立实时监控,当单次任务的 token 消耗超过历史平均值的 3 倍时触发告警。
-
分级调用策略。 简单任务使用低成本模型(如 GPT-4o-mini),复杂任务才升级到高成本模型(如 GPT-4o)。可以在 Prompt 中加入一个"复杂度评估"步骤,先判断任务复杂度再决定使用哪个模型。
-
缓存机制。 对于相同的输入,直接返回缓存结果而非重新调用模型。这在 Agent 场景中尤其有效,因为很多工具调用的结果(如天气查询、数据库查询)在短时间内不会变化。
八、总结
本文从 Agent 场景下 Prompt 工程与 ChatBot 场景的本质区别出发,系统讲解了四个核心维度。
角色设定的分层设计是基础。将 System Prompt 拆解为角色层、任务层、工具层和约束层,各层独立可维护。角色漂移检测器作为运行时后处理层,将安全性从构建时延伸到运行时。
任务分解是 Agent 区别于 ChatBot 的关键。ReAct 适合简单任务,Plan-and-Execute 适合复杂任务,混合使用效果最佳。分解粒度遵循单一职责、可验证性、最小依赖和上下文隔离四原则。
输出约束直接决定可靠性。从 Structured Output 到多模型兼容解析器,从上下文窗口管理到风格控制,每个环节都是生产级 Agent 不可忽视的工程细节。格式约束可靠性从 92% 提升到 99.5%+,在生产系统中意味着从每天数百次失败降到几乎为零。
示例引导在效果和成本间权衡。强模型 Zero-shot 即可,中小模型可用动态 Few-shot 选择器。关键原则:示例贵精不贵多。
Prompt 版本管理和 A/B 测试将 Prompt 迭代从"拍脑袋"升级为有数据支撑、可回滚的工程过程。但须清醒认识其边界:不能突破模型能力上限,不能替代安全防御,也不应在早期过度投入。工程化的核心是"在正确的时间做正确的事"。
参考资料
- OpenAI 官方文档:Structured Outputs
- Anthropic 官方文档:Prompt Engineering
- Yao, S. et al. (2022). ReAct: Synergizing Reasoning and Acting in Language Models. - ReAct 模式的原始论文
- Wei, J. et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. - Few-shot CoT 的经典论文
- LangChain 官方文档:Prompt Management
- DeepSeek 官方文档:Prompt Engineering Best Practices
- LangChain Blog: Plan-and-Execute Agents
- Prompt Injection Attacks and Defenses