当 AI Coding、Agent 办公等成为企业级"日常生产力",一次推理不再是一次简单的 API 调用,而是一场围绕 Token 的持续博弈------如何以最低的成本、最稳的 SLO、把每一颗 Token 都算得更快、算得更省、算得更聪明?阿里云人工智能平台 PAI 面向 Agentic Cloud 正式推出产品模块 InferX,将 LLM智能路由、KVCache、模型预热、全球调度和用户Token管理等推理"关键工序"统一到一个平台之下,用一整套"Token 炼金术",为企业客户交付真正可承诺 SLO、可核算成本、可无限扩展的企业专属推理服务。
一、为什么需要 InferX:Agent 时代的推理已经变了
过去十年,AI 推理平台经历了三次深刻的架构演进:从传统机器学习时代的同步推理 (毫秒级、QPS 型负载),到 AIGC 时代的异步推理 (Stable Diffusion、文生视频等分钟级长任务),再到当下大语言模型主导的Token 流式推理时代。而进入 2025 年,随着 Claude Code、Qoder等 Coding Agent 大规模落地,推理场景又发生了一次质变:
-
一次会话 = 一场长跑: 单次对话动辄几十轮、上下文长达数十万 Token,Prefill 与 Decode 的分离成为标配,同一个 Query 需要在多个服务实例之间协同完成;
-
KV Cache 不再是"临时中间态": 它是决定 TTFT、决定成本、决定用户体验的核心资产。在多轮对话、共享 System Prompt、Coding Agent 前缀复用等场景中,一次 4K Token 请求的 KV Cache 就能膨胀到 200MB 以上,是否命中直接决定单位 Token 成本的高低;
-
传统网关彻底失灵: 无状态的 Round Robin、一致性哈希已经无法感知推理引擎内部的 Cache 分布;Anthropic Messages、OpenAI Chat Completions、Responses API 等多协议并存,让流量入口变成了"翻译中心+调度中心+计费中心"三位一体的复杂系统;
-
SLO 从"平均延迟"变成"分位延迟 × 命中率 × 单价": 客户不再只关心 P99 延迟,而是要求"在给定 SLO 下的百万 Token 成本"这一个综合指标。
一句话:推理的服务单位,正在从"资源"演化为"Token"。 而 InferX,正是阿里云 PAI 为这个"Token 时代"打造的专属推理服务底座。
二、InferX 是什么:把每一颗 Token 都炼成"高保障 SLO 服务"
InferX 是阿里云 PAI 在线推理平台(PAI-EAS)上全新推出的产品模块,聚焦大模型推理场景下Token 的高效生产、调度与监控治理。它将推理网关、推理引擎、KV Cache、全球调度等能力统一封装,形成一整套"Token 炼金"工具链。核心功能如下:
1. LLM智能路由:Token 时代的专用流量入口
InferX 内置 LLM 智能路由,是一款专门为大模型场景打造的智能网关:
-
PD 分离流量编排: 支持 Prefill 代理、网关调度、Decode 主导三种主流 PD 分离模式,自动完成流量拆分、首 Token 直返、后续 Token 流式合并;
-
Token 流控管理: 可定制化的企业内部 Coding 订阅与 Token 订阅,为每个用户分配不同的 Quota 的限流管理套餐,精准匹配用户不同时段 Token 的真实消耗;
-
多协议统一入口: 天然兼容 OpenAI Chat Completions、Anthropic Messages、通义百炼等多种 API 协议,让 Claude Code、CodeX 等非 OpenAI 协议客户端零改造直接接入;
-
多模型路由与默认兜底: 统一
v1/models接口聚合多个后端模型,支持模型按权重比例或请求前缀比例分流等企业级流量策略; -
轻量租户体系: 无需 RAM 复杂授权,为每个内部用户/团队动态分配 API Key,支持按租户核算 Token 消耗、缓存命中率、请求量,为企业内部 AI Coding 平台的成本分摊与治理提供开箱即用能力;
-
全球调度:一次接入,全球可用。当本地地域推理资源紧张时,LLM智能路由自动将业务流量调度至其他空闲地域的推理实例,把"多地域算力"聚合成"一个可承诺的算力池"------削峰填谷、按需接力、跨 Region 统筹,让企业客户不必再为单一地域库存告急而牺牲 SLO 或超额预留资源。
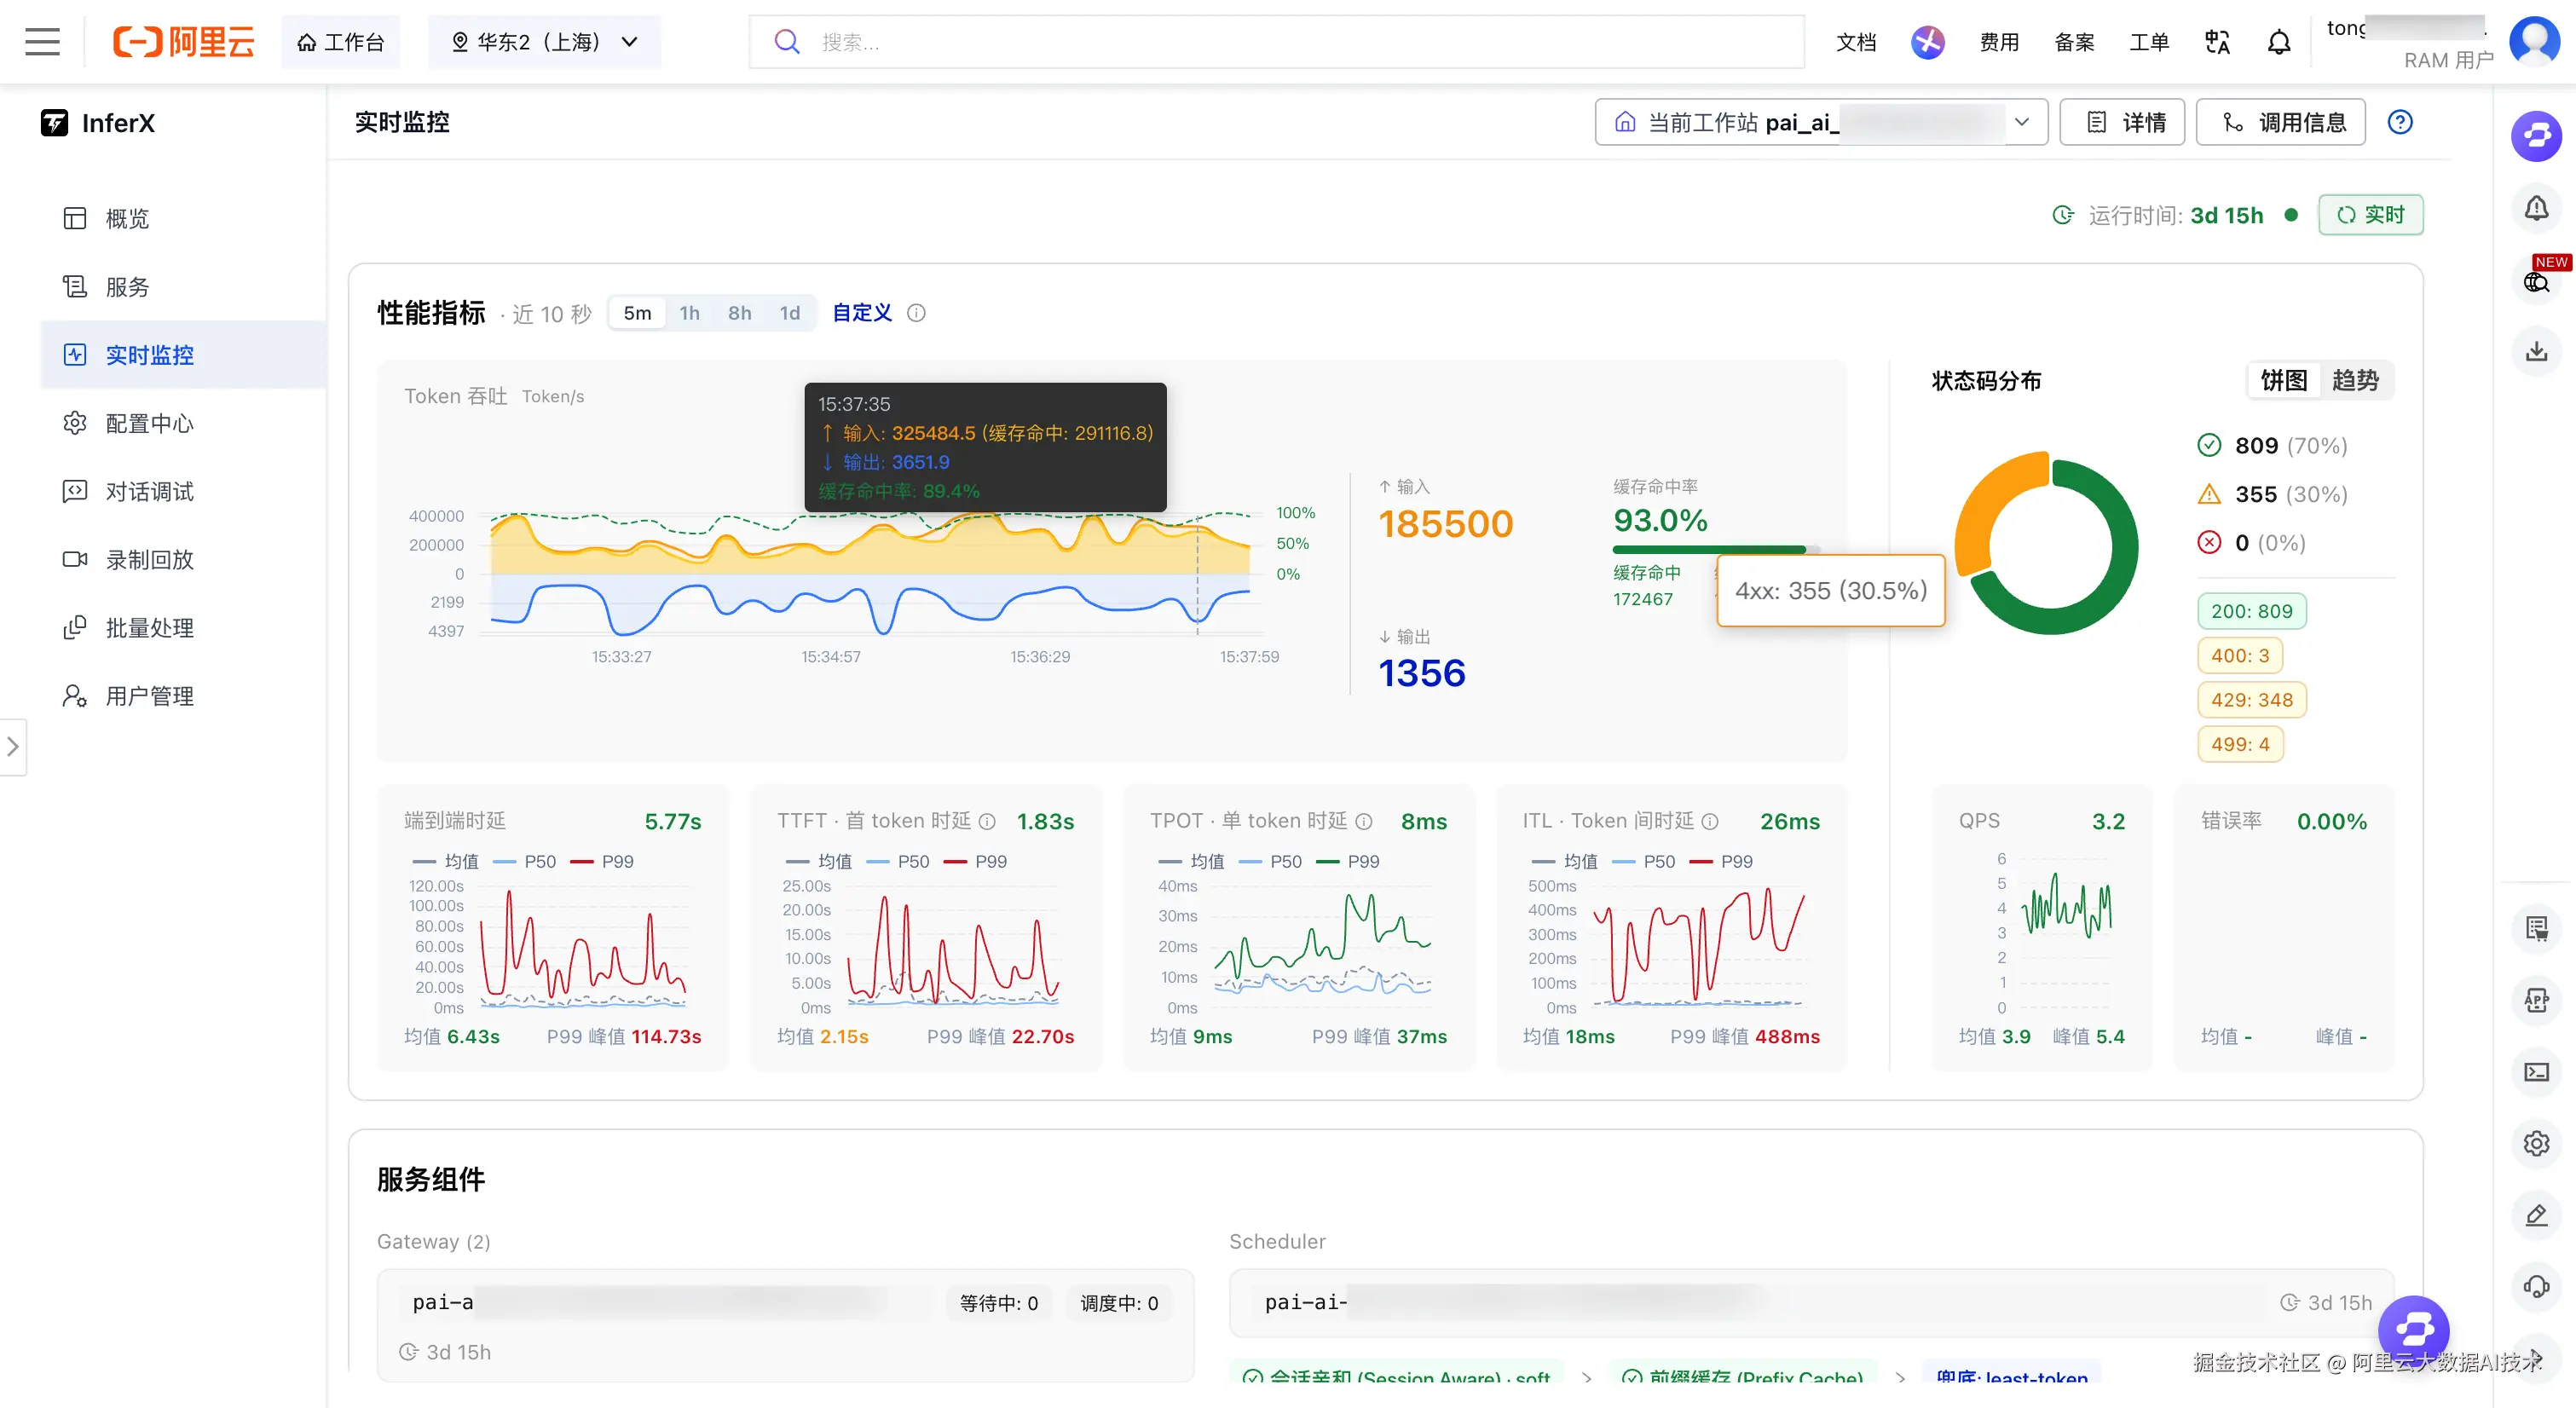
实时监控LLM服务的调用情况和缓存命中率等核心指标
2. 引擎深度优化:面向 MoE 与 Hybrid Attention 类下一代大模型架构而生
● 大规模 EP 分布式并行: 原生支持专家并行(Expert Parallelism)的大规模分布式部署,一键管理跨机跨卡的 MoE 拓扑,屏蔽底层通信与路由复杂度,让百 B~千 B 参数级 MoE 模型平滑上线;
● 异构 PD 分离部署: 支持 Prefill / Decode 异构分离部署,针对两阶段截然不同的算力与访存特征分别选型硬件、独立扩缩,兼顾首 Token 延迟(TTFT)与生成吞吐(TPOT),彻底摆脱"一种规格通吃全阶段"的资源浪费;
● PPU 网络与算子协同优化: 面向 PPU 芯片深度定制网络通信路径与专用算子内核,覆盖MoE 关键通信原语与热点算子,把硬件亲和的性能红利完整兑现到端到端 SLO 上,让"国产芯片的推理性价比"从口号变成可测可交付的数字。
● HiSparse 显存稀疏: 面向 DSA 类稀疏注意力模型的显存布局优化方案,把注意力矩阵的稀疏模式真正翻译成显存与带宽层面的节省,让稀疏模型的效率优势不再停留在论文数字上;
● DSpark / DFlash 块扩散投机采样: 基于块扩散思想的自研投机采样引擎,一次前向吐出更长的候选序列并做批量验证,显著提升 Decode 阶段的每步产出,配合稀疏注意力把 TPOT 打到新的量级;
● PPD 与 Decode Radix Cache: PPD(Prefill / Prefill-capable Decode Disaggregation)让 Decode 节点在多轮对话中就地承接增量 Prefill,从根源上削减跨节点 KV 传输开销;Decode Radix Cache 则以前缀树组织 KV,让投机采样与多分支 Decode 的候选路径共享同一份物理 KV,实现"零冗余"复用;
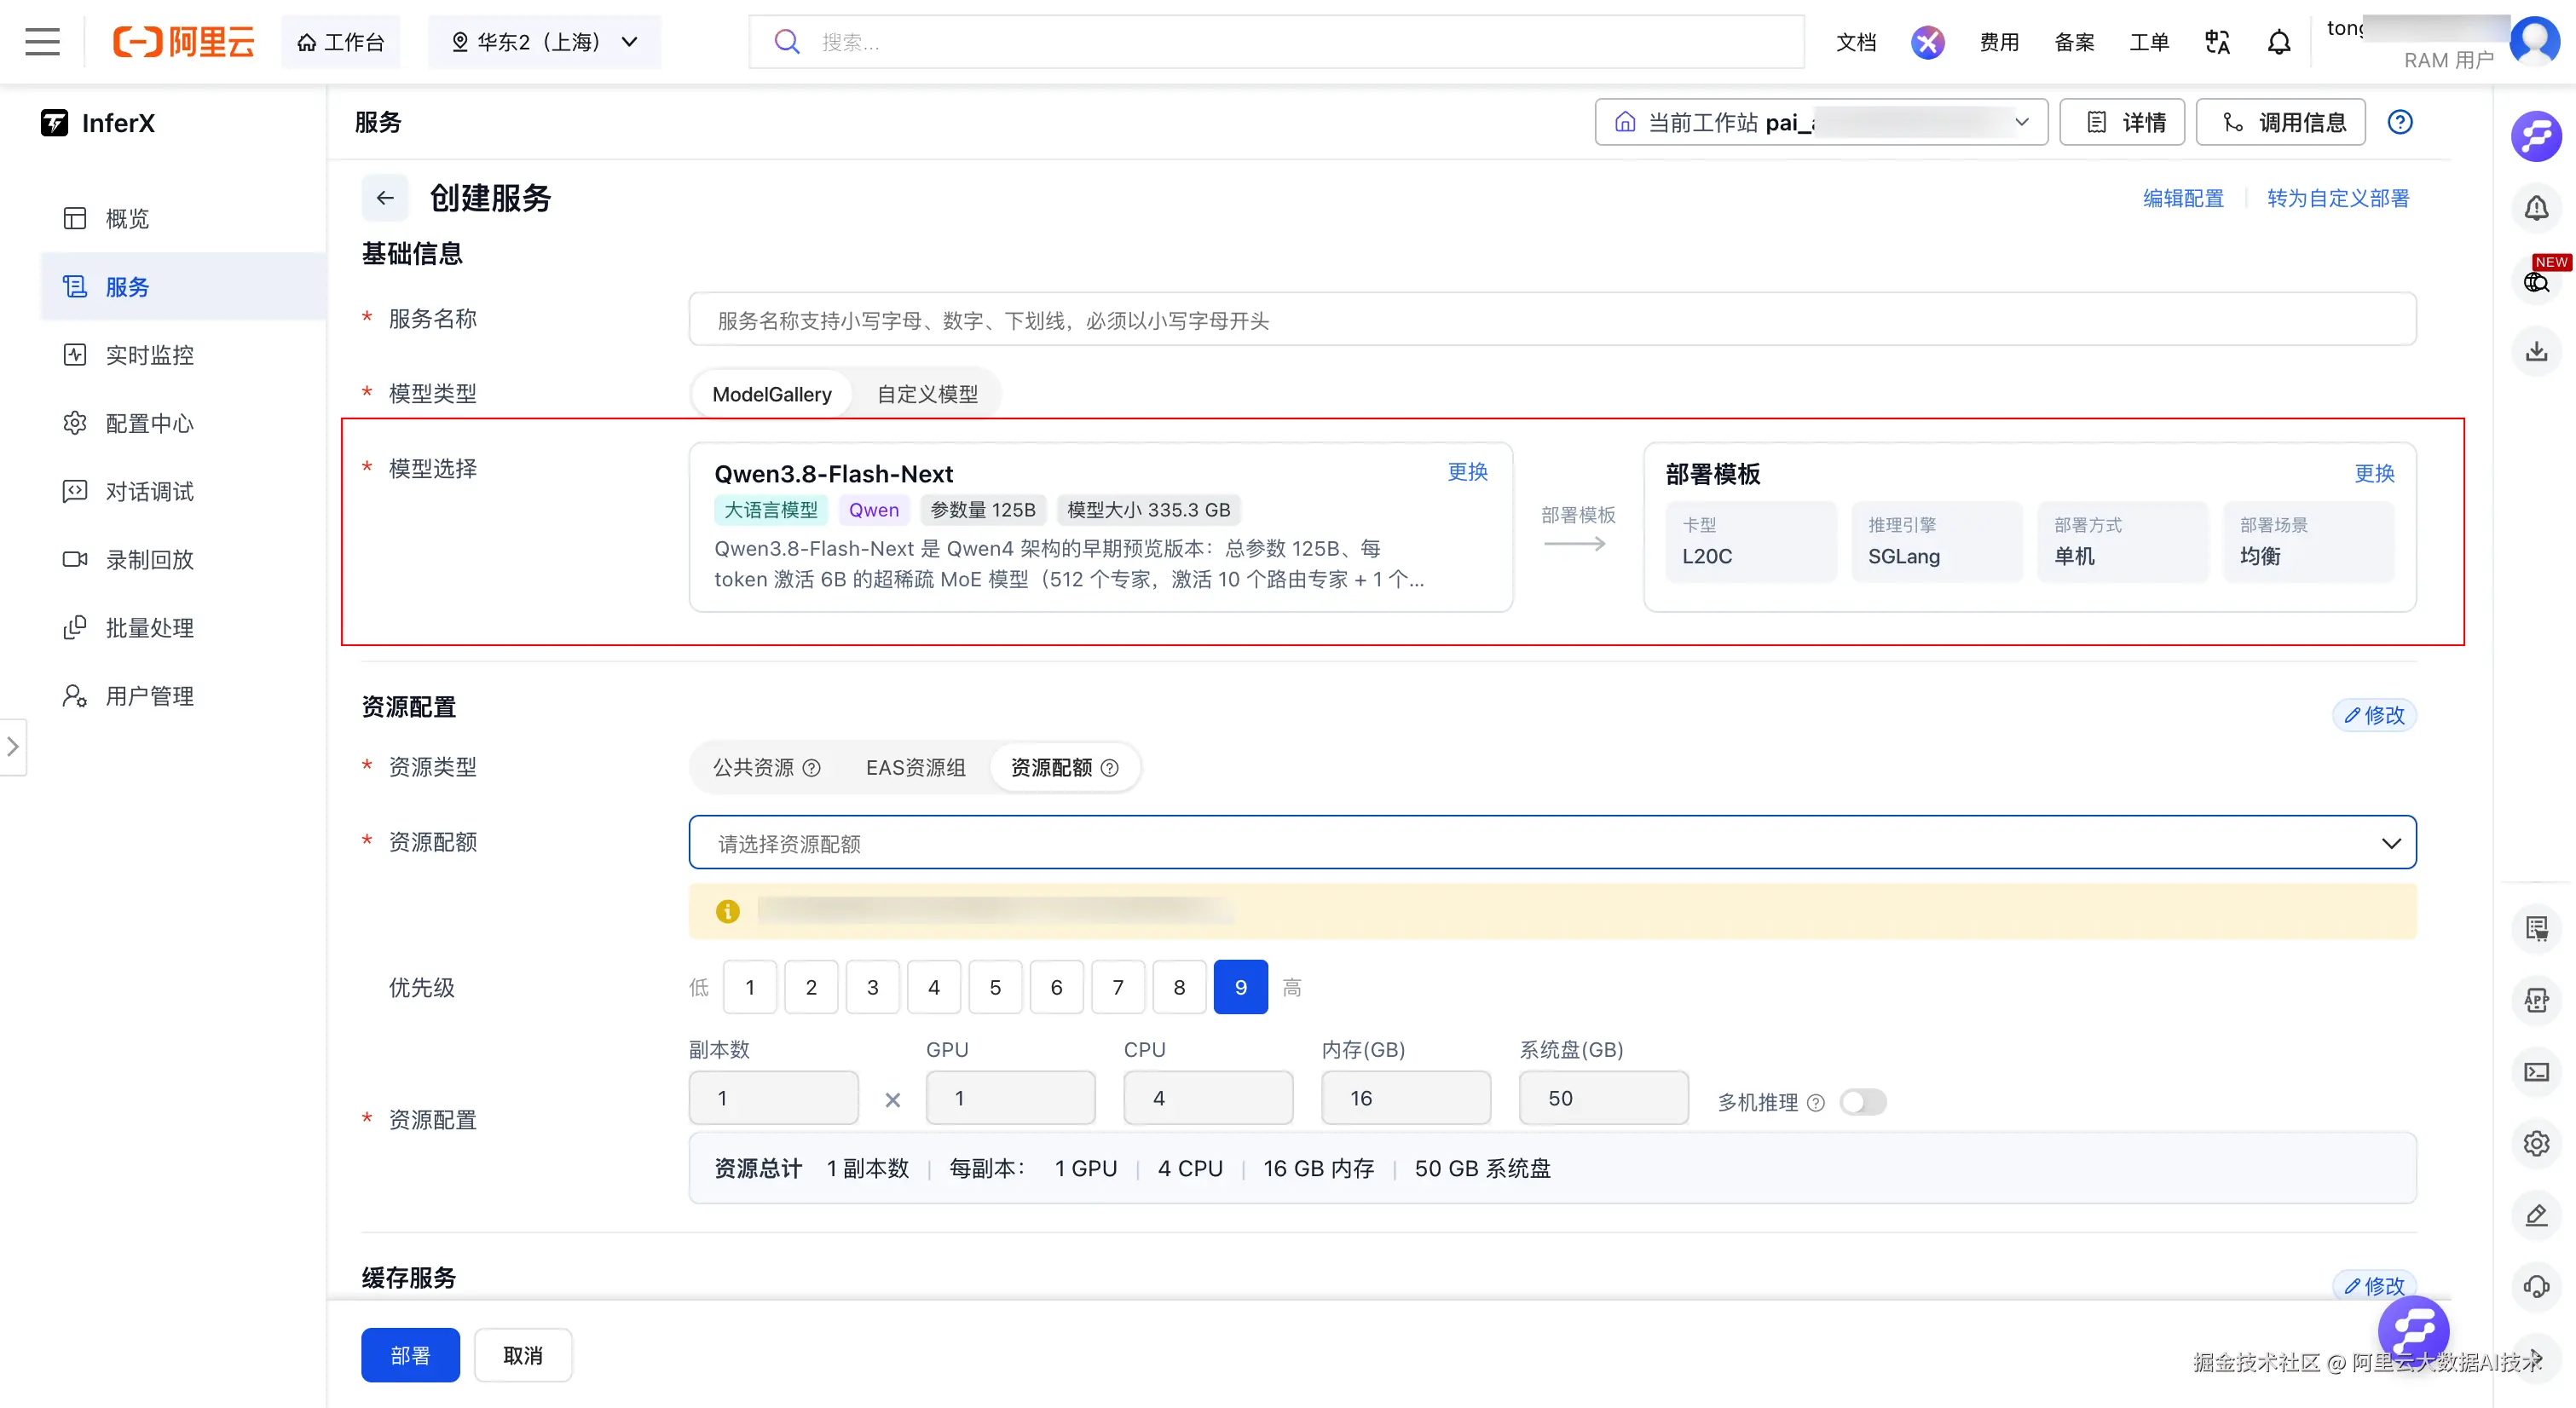
一键部署高性能与高保障SLO的推理服务
3. 流量高效调度:把调度优化从"黑盒"变成"资产"
InferX 内置了针对大模型推理的多级智能调度体系,让流量真正"跟着 Cache 走":
-
Session-Aware 调度: 用户可显式声明会话归属,同一 Session 的请求始终路由到同一实例,保障 KV Cache 极致命中;
-
Cache-Aware 调度: 感知 Context Prefix Cache 所在节点,将请求优先路由到命中最长前缀的实例,同时具备过载保护------当单实例排队/推理数量超标时自动分流,避免热点节点被打穿;
-
PD 差异化调度: Prefill 走 KV Cache 感知路径,最大化前缀匹配;Decode 走 Latest Token 调度,实例间负载动态均衡;
-
DP 维度细粒度调度: 面向 DeepSeek、GLM 等 MoE 模型 Decode 阶段的 DP+EP 混合并行,感知 Pod 内每张 GPU 的 DP Rank,避免"部分卡爆了、部分卡闲着"的错峰浪费。
在 Coding Agent 这类"高前缀复用"的典型场景下,InferX 可将 KV Cache 命中率推向理论上限的 95% 以上,直接把单位 Token 成本再压一个数量级。
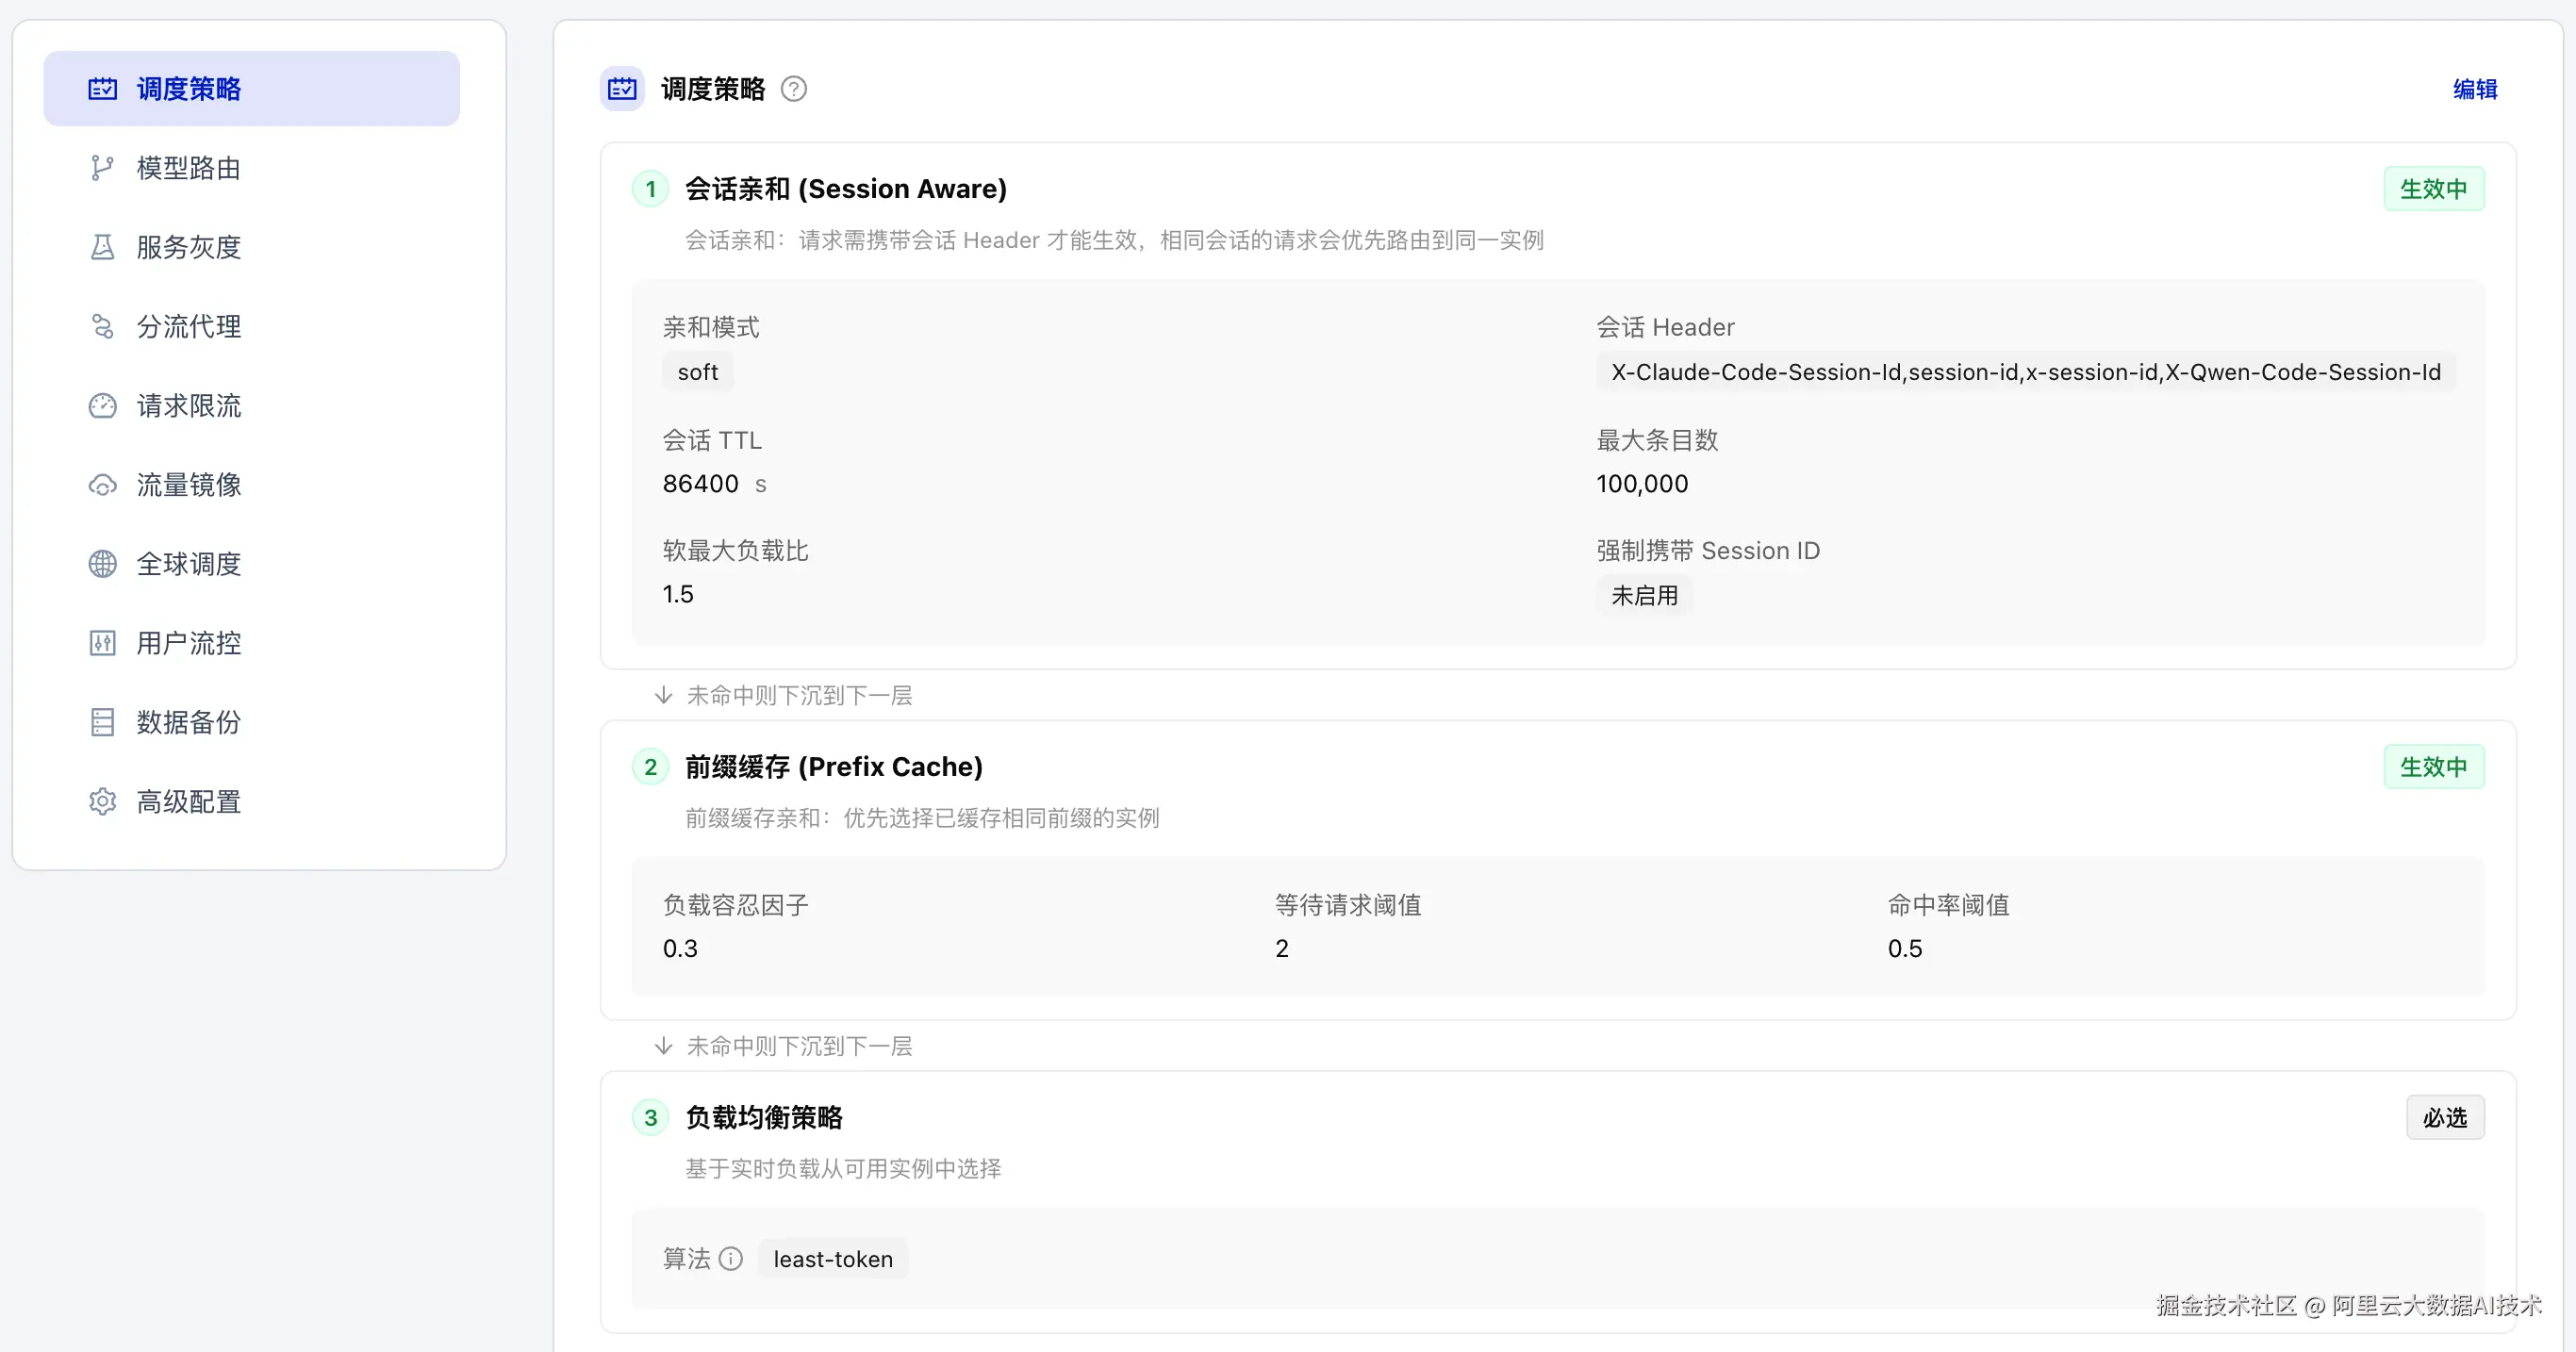
一键配置多级管理的服务调度系统
4. KV Cache:跨节点、跨层级的 Token 记忆中枢
InferX 将 KV Cache 从推理引擎内部的"本地缓存"升级为跨节点、跨层级的共享存储资产:
-
打破单机瓶颈: 突破 vLLM、SGLang 等主流引擎"单机 L1+L2 缓存"的天花板,将集群各节点空闲的内存与 SSD 磁盘聚合为独立于推理服务的分布式 KV Cache,构建 L3 级 Cache 池,使 Prefix 存储容量提升数十倍;
-
多节点协同复用: 不同 Pod、不同 PD 角色间可共享同一段前缀 KV,多轮对话和 RAG 场景的 TTFT 显著下降;
-
面向 DSA/MoE 深度优化: 针对 GLM-5.2、DeepSeek V3/V4 的 Sparse Attention 等新型 Attention 结构进行 KV 组织与压缩优化,在长上下文场景下依旧保持高命中、低延迟。
5. 模型预热分布式缓存:让千亿模型"秒级扩容、秒级冷启动"
大模型体积动辄数百 GB、乃至 TB 级别,传统从 OSS/NAS 拉取模型的方式在扩容时会造成存储侧带宽被打爆、启动耗时高达几十分钟。InferX 集成两套模型分发加速引擎:
-
分布式缓存: 全对称、去中心化的 P2P 缓存系统,扩容加载从"数十分钟"压缩到 1 分钟内、甚至秒级;
-
模型预热缓存: 中心化冷启动加速方案,为 Model Gallery 中的开源模型内置公共缓存服务,用户也可为自有模型自建缓存服务,让首个实例的冷启动同样飞快。
三、InferX 为客户带来什么:三个"更"的价值兑现
更省的成本: 通过 Cache-Aware 调度、KV Cache、Binpack 打包、Spot/弹性/预付费多类型资源混合调度,客户在 Coding Agent、多轮对话、RAG 等 KV 敏感场景下,单位 Token 成本相较传统方案可下降 30%~70%;企业内部的 AI Coding 服务,可以像水电一样按用量精准核算到人、到团队。
更稳的 SLO: 从传统的"P99 延迟"升级为"P99 首 Token 延迟 × Token 吞吐 × 缓存命中率 × 单位成本"的立体 SLO 体系,配合专属网关、租户级限流、过载保护和 Gang Scheduling,让企业敢于把核心业务大规模跑在推理平台之上。
更快的落地: 天然兼容 OpenAI 与 Anthropic Messages 协议,Claude Code、Cursor、通义灵码等主流 Coding Agent 无需修改一行代码即可接入;Model Gallery + 模型预热缓存让新模型上线时间从"数天"缩短到"数十分钟"。
四、结语:从"资源"到" Token",PAI 正在重塑推理的商业契约
如果说过去的推理平台是把 GPU 装进 Pod,把 Pod 摆成机架,那么在 Agent 时代,我们要做的是把每一颗 Token 都变成一份"可承诺、可核算、可复用的算力资产"。
InferX,就是阿里云 PAI 为这份新契约准备的答卷------一套面向企业专属推理服务的"Token 炼金术",让 Coding Agent 更聪明、让企业推理更稳、让每一颗 Token 都物尽其用。
现已在阿里云 PAI 上线。欢迎联系 PAI 团队,一同开启 Token 时代的推理新范式。更多使用方法详见文档。