一、为什么需要核密度估计?
假设调查了 100 个人的身高,得到了 100 个离散的数字:165cm、172cm、168cm......
如果直接画直方图,会得到一堆高低不平的矩形条。直方图虽然直观,但有两个问题:
- 不连续:矩形条之间有断崖式的跳跃
- 受分组影响:组距宽一点或窄一点,图形可能完全不同
我们想要的,是一条连续、光滑的曲线,能自然反映数据的分布形态。这就是核密度估计(Kernel Density Estimation, KDE)要解决的问题。
二、核心思想:在每个数据点放一座「钟形小山」
核密度 估计的做法非常优雅:
在每个数据点上方放置一个「核函数」(一座小山峰),然后把所有山峰叠加起来,就得到了整体的密度曲线。
用公式表示为:
p^(x)=1nh∑i=1nK(x−xih) \hat{p}(x) = \frac{1}{nh}\sum_{i=1}^{n}K\left(\frac{x-x_i}{h}\right) p^(x)=nh1i=1∑nK(hx−xi)
其中:
• K(⋅)K(\cdot)K(⋅) 是核函数,决定了「小山峰」的形状
• hhh 是带宽(bandwidth),决定了山峰的「胖瘦」
• xix_ixi 是已有的数据点(固定不动)
• xxx 是你想查询密度的位置(可以任意滑动)

三、什么是高斯核?
高斯核就是选用标准正态分布的密度函数作为核函数:
K(x)=12πe−x2/2 K(x) = \frac{1}{\sqrt{2\pi}}e^{-x^2/2} K(x)=2π 1e−x2/2
它的特点 是:
• 光滑、连续、无限可导,叠加出来的曲线也非常平滑
• 呈钟形,中心在数据点处,向两侧对称衰减
• 是目前最常用的一种核函数
你可以这样理解:高斯核密度估计 = 在每个数据点放一个钟形小山,把这些钟形曲线全部加起来,形成一条连续的密度曲线。

特别分享1:核密度估计公式里的xxx 和 xix_ixi 到底有什么区别?**
xix_ixi = 「原料」(数据点)
x1,x2,...,xnx_1, x_2, \dots, x_nx1,x2,...,xn 是已有的观测值。比如 100 个人的身高。这些数字固定不动,是核函数的中心位置。
xxx = 「探针」(查询位置)
xxx 是在横轴上任意选取的一个位置。比如想知道「这里密度是多少?」,就把探针放在这里。
xxx 可以是数据里没有的值。 比如数据里没人恰好是 173.5cm,但仍然可以问:「173.5cm 处的密度是多少?」
举个例子
假设有 3 个数据点:x1=0.2, x2=0.5, x3=0.8x_1=0.2,\; x_2=0.5,\; x_3=0.8x1=0.2,x2=0.5,x3=0.8,带宽 h=0.1h=0.1h=0.1。
问:x=0.35x=0.35x=0.35 处的密度是多少?
计算
核高度
第1个核
K(0.35−0.20.1)=K(1.5)K\left(\frac{0.35-0.2}{0.1}\right) = K(1.5)K(0.10.35−0.2)=K(1.5)
0.1295
第2个核
K(0.35−0.50.1)=K(−1.5)K\left(\frac{0.35-0.5}{0.1}\right) = K(-1.5)K(0.10.35−0.5)=K(−1.5)
0.1295
第3个核
K(0.35−0.80.1)=K(−4.5)K\left(\frac{0.35-0.8}{0.1}\right) = K(-4.5)K(0.10.35−0.8)=K(−4.5)
≈ 0.0000
求和
0.1295+0.1295+00.1295 + 0.1295 + 00.1295+0.1295+0
0.2590
除以 nhnhnh
0.2590÷(3×0.1)0.2590 \div (3 \times 0.1)0.2590÷(3×0.1)
p^(0.35)≈0.863\hat{p}(0.35) \approx 0.863p^(0.35)≈0.863
现在把 xxx 换成 0.6,再问一次------每个核的贡献又变了,最终密度值也变了。把成千上万个这样的 xxx 连起来,就是那条光滑的密度曲线。
特别分享2:「纵向相加」到底是什么意思?
很第一次听到「把钟形小山纵向相加」时可能会困惑:很多小山叠在一起,不会坑坑洼洼吗?
答案是:不会。因为叠加不是「拼拼图」,而是「合唱」。
关键区别
• 拼拼图:横向划分领地,「这块归你、那块归我」
• 纵向相加:固定一个横坐标 xxx,把所有核函数在这个位置的高度(y 值)加起来
具体过程
想象有一条红色竖线在横轴上滑动。竖线每停在一个位置 xxx,就会与每个钟形核相交于一个点。这些交点的高度分别是 K1,K2,...,KnK_1, K_2, \dots, K_nK1,K2,...,Kn。
纵向相加就是:把这个 xxx 位置的所有交点高度加起来。
总高度=K1+K2+⋯+Kn \text{总高度} = K_1 + K_2 + \dots + K_n 总高度=K1+K2+⋯+Kn
然后再除以 nhnhnh 做归一化,就得到了密度曲线在这个 xxx 处的高度。
为什么结果是光滑的?
因为每个高斯核本身都是光滑函数(无限可导),而光滑函数的和仍然是光滑函数。就像 sinx\sin xsinx 和 cosx\cos xcosx 叠加后还是光滑的,不会因为有两个波峰就变得凹凸不平。
你看到的「起伏」其实是数据分布的真实特征(比如某个区域数据更密集,叠加后密度就更高),而不是叠加本身造成的噪声。
特别分享3:「近大远小」
公式里的分子 x−xix - x_ix−xi 决定了每个数据点的贡献大小:
x−xih \frac{x - x_i}{h} hx−xi
距离 = ∣x−xi∣|x - x_i|∣x−xi∣,即探针位置和数据点位置之间差的绝对值。
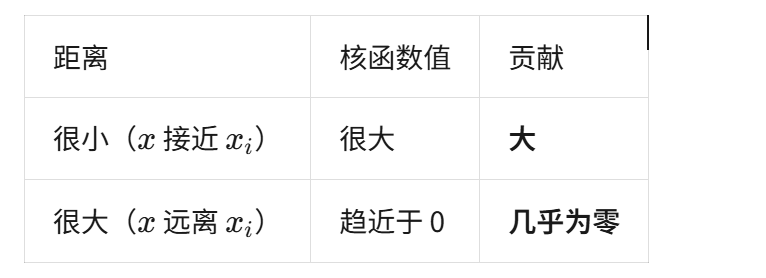
xxx 就像一盏探照灯:照到哪个数据点附近,那个数据点的核函数就「亮」起来,对密度值的贡献就大。离得远的,就「暗」下去了。
七、带宽 hhh:平滑与忠实的平衡
带宽 hhh 是核密度估计中最重要的超参数:
• hhh 很小:每个核很「瘦高」,叠加后的曲线更贴近原始数据的局部起伏,可能过拟合噪声
• hhh 很大:每个核很「矮胖」,叠加后的曲线更平滑,但可能抹掉真实的分布特征
选择合适的 hhh 需要在「忠实数据」和「平滑噪声」之间找到平衡。
八、总结
核密度估计就是:用无数座光滑的「钟形小山」覆盖数据点,然后在每一个想知道的位置 xxx,把所有小山在那个位置的「高度」加起来,连成一条连续的密度曲线。
• xix_ixi 是「原料」(数据)
• xxx 是拿着「探针」到处问「这里密度多少?」的位置
• K(⋅)K(\cdot)K(⋅) 是「钟形小山」的形状
• hhh 是「小山」的胖瘦
• 纵向相加是所有数据点在同一位置的「合唱」
今日分享到此结束。