AI 疾病自查功能 · 技术实现文档
版本:v1.0 | 技术栈:Spring Boot 3 + Spring AI(智谱 glm-4-flash / embedding-3)+ MyBatis + MySQL 8.0 + Vue 3
目录
1. 功能概述
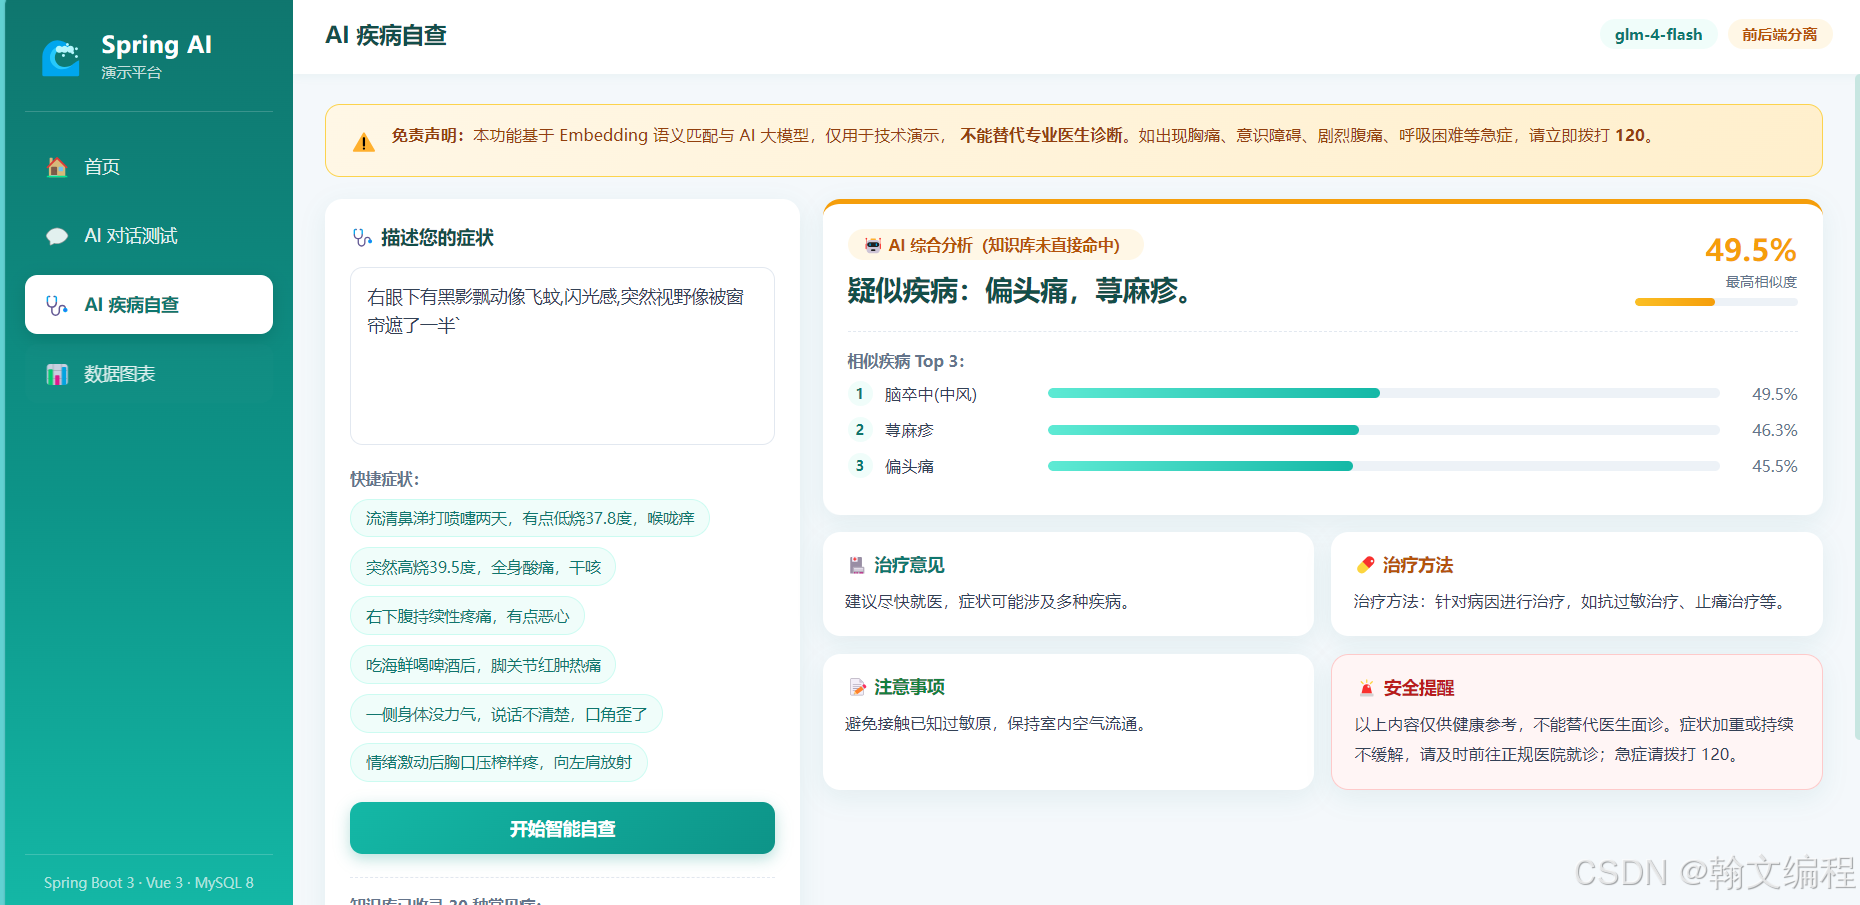
用户在页面输入(或点选)症状描述,系统自动返回:
-
疑似疾病 及 Top3 候选疾病(带相似度百分比)
-
治疗意见 、治疗方法 、注意事项 三段结构化建议
-
结果来源标识:✅ 知识库命中 / 🤖 AI 综合分析
1.1 技术选型思路(与 Python 原型对照)
| 环节 | PYTHON 原型 | 本系统实现 | 说明 |
|---|---|---|---|
| 知识库存储 | Python 列表常量 DISEASE_KB(30 条) |
MySQL 表 disease_kb(30 条) |
数据可运营化,随时增删疾病 |
| 向量化 | 智谱 SDK test_embedding.embed() |
Spring AI EmbeddingModel.embed()(模型 embedding-3) |
框架自动管理 HTTP 调用与鉴权 |
| 相似度计算 | 手写 cosine_similarity() |
Java 手写余弦计算(无第三方依赖) | 30 条数据量小,无需向量数据库 |
| 命中判断 | 阈值 0.60 |
阈值 0.60(一致) |
医疗场景从严,低置信度交给大模型 |
| LLM 兜底 | 拼接知识库上下文 → 正则解析文本 | 同思路,但用 Spring AI 结构化输出 .entity(Class) 自动反序列化 JSON |
更稳健,不怕模型输出格式抖动 |
| API 层 | Python 脚本直接运行 | REST 接口 POST /api/disease/diagnose |
前后端分离 |
1.2 为什么不用向量数据库(Milvus / PGVector)?
知识库仅 30 条,向量维度 2048,内存占用约 240KB。启动时一次性加载进 JVM 内存,每次查询为 30 次浮点乘加,微秒级完成。引入向量数据库属于过度设计,且增加部署复杂度。知识库增长到万条以上时再考虑迁移。
2. 整体架构与核心流程
┌─────────────┐   POST /api/disease/diagnose    ┌──────────────────────────────┐
│  Vue 3 前端  │ ──────────────────────────────► │  Spring Boot 3 后端           │
│ DiseaseView  │ ◄────────────────────────────── │                              │
└─────────────┘        JSON 结果                  │  DiseaseDiagnosisService      │
                                                  │   1. ensureReady() 懒加载     │
        启动时 @PostConstruct 预加载               │   2. embed(用户症状)          │
┌─────────────┐                                  │   3. 余弦相似度 vs 30条向量    │
│  disease_kb  │ ◄────── selectAll() ──────────  │   4. score ≥ 0.60 ?          │
│  MySQL 30条  │                                  │      ├─ 是 → 直接返回知识库内容 │
└─────────────┘                                  │      └─ 否 → GLM 兜底 ↓       │
                                                  │   5. ChatClient 结构化输出     │
智谱开放平台 ◄──────────────── │ (embedding-3 / glm-4-flash)双阶段设计(这是本功能的核心设计决策):
-
阶段一 · 语义检索:Embedding 把"文字"变成"数学向量",用余弦相似度衡量症状与疾病的语义距离。优点是快、便宜、稳定,缺点是知识库没有的疾病答不了。
-
阶段二 · LLM 兜底 :相似度低于 0.60 时,把完整知识库 + Top3 参考 + 用户症状一并交给 glm-4-flash,要求输出结构化 JSON。保证任何输入都有合理回应。
3. 数据库设计
3.1 表结构(<backend/sql/init.sql>)
CREATE TABLE disease_kb (
    id          BIGINT       NOT NULL AUTO_INCREMENT COMMENT '主键',
    name        VARCHAR(100) NOT NULL COMMENT '疾病名称',
    description VARCHAR(500) NOT NULL COMMENT '典型症状描述(用于 embedding 匹配)',
    advice      VARCHAR(500) NOT NULL COMMENT '治疗意见/就医建议',
    treatment   VARCHAR(500) NOT NULL COMMENT '治疗方法',
    precautions VARCHAR(500) NOT NULL COMMENT '注意事项',
    PRIMARY KEY (id)
) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4 COMMENT = '疾病知识库';
3.2 字段设计说明
| 字段 | 是否参与向量匹配 | 设计原因 |
|---|---|---|
description |
✅ 唯一参与 | 症状描述是用户输入的"语义对齐目标",只拿它做 embedding,避免治疗建议等噪声干扰相似度 |
name / advice / treatment / precautions |
❌ | 命中后原样返回,保证专业内容不被模型改写 |
3.3 知识库内容
收录 30 种常见病:普通感冒、流行性感冒、急性扁桃体炎、急性胃肠炎、高血压、2型糖尿病、急性阑尾炎、胆结石胆囊炎、胃溃疡、支气管哮喘、肺炎、湿疹、荨麻疹、带状疱疹、颈椎病、腰椎间盘突出、肩周炎、痛风、类风湿关节炎、偏头痛、脑卒中、冠心病心绞痛、心功能不全、急性肾盂肾炎、尿路感染、缺铁性贫血、过敏性鼻炎、功能性消化不良、焦虑症、睡眠障碍。
每条数据的 description 按"主诉症状 + 体征 + 诱因/人群"的医学术语风格书写,与用户口语化输入形成语义映射(例如"流清鼻涕打喷嚏低烧" ↔ "鼻塞、流清涕、打喷嚏......轻度发热(37.5-38℃)")。
4. 后端实现(分步详解)
后端代码包结构(新增部分加粗):
com.example.aidemo
├── entity/       User.java, **Disease.java**
├── mapper/       UserMapper.java, **DiseaseMapper.java**
├── dto/          **DiseaseDiagnosisVO.java**, **DiseaseLlmReply.java**
├── service/      UserService.java, **DiseaseDiagnosisService.java**(核心)
├── controller/   UserController, AiController, **DiseaseController.java**
resources/mapper/  UserMapper.xml, **DiseaseMapper.xml**
4.1 第一步:依赖与配置
pom.xml(沿用项目已有依赖,本功能零新增):
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-zhipuai</artifactId>
</dependency>
application.yml 新增 embedding 模型配置:
spring:
  ai:
    zhipuai:
      api-key: ${你的智谱APIKey}
      chat:
        options:
          model: glm-4-flash        # 兜底对话模型
          temperature: 0.7
      embedding:
        options:
          model: embedding-3        # 疾病自查使用的向量模型
配置好后,Spring AI 自动装配两个 Bean,直接注入即可:
-
EmbeddingModel------ 文本转向量 -
ChatClient.Builder------ 构建对话客户端
4.2 第二步:实体与 Mapper(读知识库)
Disease.java :普通 POJO + Lombok @Data,五个字段与表一一对应。
DiseaseMapper.java + DiseaseMapper.xml:只需一个全量查询:
<select id="selectAll" resultMap="diseaseMap">
    SELECT id, name, description, advice, treatment, precautions
    FROM disease_kb
    ORDER BY id
</select>
4.3 第三步:核心服务 DiseaseDiagnosisService
这是整个功能的心脏,分四个部分讲解。
(a)启动预加载 + 失败懒重试
@PostConstruct
public void init() {
try {
loadVectors(); // 启动时批量向量化
} catch (Exception e) {
log.warn("疾病知识库向量初始化失败(不影响其他功能,调用疾病自查时会重试)...");
}
}
private synchronized void loadVectors() {
List<Disease> list = diseaseMapper.selectAll();
List<String> descriptions = list.stream().map(Disease::getDescription).toList();
List<float[]> embedded = embeddingModel.embed(descriptions); // 一次网络调用批量向量化
this.diseases = list;
this.vectors = embedded;
this.ready = true;
}设计要点:
-
批量 embedding :30 条描述合成一个 List 调用一次
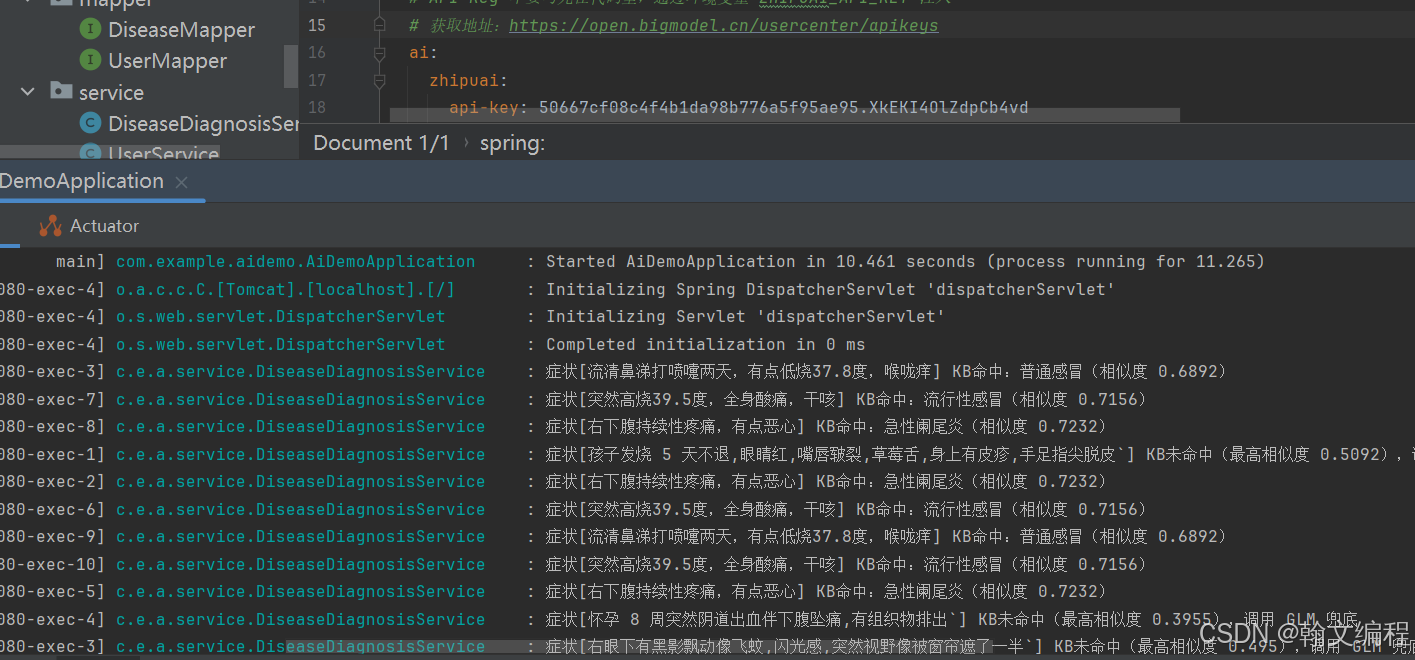
embed(List<String>),而不是循环 30 次单条调用------省 29 次网络往返,启动日志实测输出疾病知识库加载完成:30 条,向量维度 2048。 -
失败不阻断启动 :embedding 调用依赖外网/API Key,若启动时失败(如断网),应用照常起,
ensureReady()在首次用户调用时用双重检查锁再试一次。 -
volatile + synchronized :
ready标志用 volatile 保证多线程可见,loadVectors加锁防止并发重复加载。
(b)诊断主流程
public DiseaseDiagnosisVO diagnose(String userQuery) {
ensureReady();
float[] queryVec = embeddingModel.embed(userQuery); // ① 用户症状 → 向量
List<ScoreEntry> scored = new ArrayList<>();
for (int i = 0; i < vectors.size(); i++) {
scored.add(new ScoreEntry(i, cosine(queryVec, vectors.get(i)))); // ② 两两算余弦
}
scored.sort(Comparator.comparingDouble(ScoreEntry::score).reversed()); // ③ 降序
ScoreEntry best = scored.get(0); // ④ 取最高分
// Top3 候选组装...
if (best.score() >= SIMILARITY_THRESHOLD) { // ⑤ 阈值判断
// 命中:直接返回知识库该疾病的标准四段内容(source=kb)
}
// 未命中:走 LLM 兜底(source=llm)
}(c)余弦相似度(手写实现)
private double cosine(float[] a, float[] b) {
    double dot = 0, normA = 0, normB = 0;
    for (int i = 0; i < a.length; i++) {
        dot   += a[i] * b[i];
        normA += a[i] * a[i];
        normB += b[i] * b[i];
    }
    return dot / (Math.sqrt(normA) * Math.sqrt(normB));   // ∈ [-1, 1]
}余弦相似度衡量两个向量的夹角而非距离,不受向量长度影响,是文本语义匹配的标准度量。embedding-3 返回归一化向量,实际取值约在 0~1 之间。
(d)GLM 兜底:结构化输出
return chatClient.prompt()
        .system("你是一名严谨的内科医生,只输出合法 JSON。")
        .user(prompt)
        .call()
        .entity(DiseaseLlmReply.class);   // 关键:自动把模型返回的 JSON 反序列化为 Java 对象
Prompt 设计四要素(完整见 DiseaseDiagnosisService.java):
-
角色设定:20 年临床经验的内科医生
-
硬性约束:知识库吻合时严格基于知识库回答;紧急症状(胸痛/偏瘫等)强制提示拨打 120;必须包含免责声明
-
上下文注入:完整知识库(名称+症状描述)+ Top3 相似参考(让模型知道哪些已排除/弱相关)
-
输出格式 :明确 JSON Schema(disease / advice / treatment / precautions 四字段),配合
.entity()自动解析------比 Python 原型的正则解析文本可靠得多
4.4 第四步:Controller 接口层
DiseaseController.java 提供两个接口:
| 接口 | 方法 | 用途 |
|---|---|---|
/api/disease/names |
GET | 返回知识库 30 个疾病名,前端展示"覆盖范围"标签墙 |
/api/disease/diagnose |
POST | 请求体 {"message": "症状描述"},返回诊断结果 |
统一返回 Result<T> 包装(code/message/data),空入参校验、异常兜底(返回中文友好提示而非堆栈)。
4.5 DTO 设计
-
DiseaseDiagnosisVO (出参):
matched / source(kb|llm) / disease / advice / treatment / precautions / score / candidates[Top3] -
DiseaseLlmReply (record,LLM JSON 的映射目标):与 VO 的四个内容字段同名,命中知识库时由 KB 填充 VO,未命中时由 LLM 填充,前端用同一套渲染逻辑处理两种来源 ,仅靠
source字段切换卡片配色(青色=知识库 / 琥珀色=AI 分析)。
5. 前端实现
5.1 文件清单
| 文件 | 职责 |
|---|---|
| <frontend/src/api/disease.js> | 两个 API 封装(axios) |
| <frontend/src/views/DiseaseView.vue> | 自查页面(约 400 行,含样式) |
| <frontend/src/router/index.js> | 路由 /disease(懒加载) |
| <frontend/src/layout/MainLayout.vue> | 侧边栏菜单「🩺 AI 疾病自查」 |
5.2 页面结构
┌────────────────────────────────────────────────────────┐
│ ⚠️ 免责声明横幅(琥珀色渐变,置顶醒目)                    │
├──────────────────┬─────────────────────────────────────┤
│ 左栏(380px)     │ 右栏(结果区,四种状态切换)           │
│ · 症状输入框      │ ① 空状态:功能说明清单                │
│ · 6个快捷症状按钮 │ ② 加载中:spinner + 提示文案          │
│   (覆盖典型场景)│ ③ 诊断卡:来源徽标 + 疾病名 + 相似度   │
│ · 提交按钮        │    进度条 + Top3 候选横向条形图        │
│ · 知识库30病标签墙│ ④ 四宫格建议:治疗意见/治疗方法/       │
│                  │    注意事项/安全提醒(红色卡)          │
└──────────────────┴─────────────────────────────────────┘
5.3 关键交互逻辑
async function submit(text) {
  const message = (text ?? input.value).trim()
  if (!message || loading.value) return          // 防重复提交
  loading.value = true
  result.value = null
  try {
    result.value = await diagnose(message)       // request.js 统一拦截错误
  } catch (e) {
    errorMsg.value = '⚠️ ' + (e.message || '诊断服务调用失败...')
  } finally {
    loading.value = false
  }
}-
相似度进度条宽度
Math.min(100, score * 100) + '%',transition: width 0.6s实现动画 -
页面加载时
onMounted拉取疾病名列表渲染标签墙,失败静默降级(不阻塞主功能) -
样式使用全局 CSS 变量(
--teal-500等),延续系统"夏日青蓝"视觉风格,避开紫色系
6. 核心算法原理详解
6.1 什么是 Embedding 语义匹配?
传统关键词匹配(如 LIKE '%感冒%')无法理解"流清鼻涕"和"鼻塞流涕"是同一回事。Embedding 模型把文本压缩成 2048 维浮点向量,语义相近的文本在向量空间中方向相近:
"流清鼻涕打喷嚏两天,有点低烧"  ──embedding──►  [0.021, -0.087, 0.114, ...]  (2048个数)
"鼻塞、流清涕、打喷嚏……轻度发热" ──embedding──►  [0.019, -0.091, 0.108, ...]  (2048个数)
                                                  夹角小 → 余弦相似度高 → 语义匹配
6.2 完整计算示例(实测数据)
输入:流清鼻涕打喷嚏两天,有点低烧37.8度,喉咙痒
| 排名 | 疾病 | 相似度 | 是否超阈值 0.60 |
|---|---|---|---|
| 1 | 普通感冒 | 0.689 | ✅ 命中,返回知识库标准内容 |
| 2 | 过敏性鼻炎 | 0.572 | ✗(有重叠症状但不含发热) |
| 3 | 流行性感冒 | 0.511 | ✗(高热39℃+,与低烧37.8不符) |
可以看到排序符合医学直觉:普通感冒(低烧+卡他症状)> 过敏性鼻炎(卡他症状但无发热)> 流感(高热为主)。
6.3 阈值 0.60 的取舍
-
阈值过高(如 0.8)→ 大量口语化输入匹配不上,全走 LLM,响应慢且结果不稳定
-
阈值过低(如 0.4)→ 似是而非的症状被强行归到某个疾病,医疗场景有误导风险
-
0.60 是本次实测的平衡点:典型描述能命中知识库,模糊/知识库外输入(如"我是外星人")正确落到 LLM 兜底分支
6.4 双来源结果的一致性设计
| SOURCE = KB(命中) | SOURCE = LLM(兜底) | |
|---|---|---|
| 内容来源 | 知识库原文本,专业可控 | 大模型生成,带免责提示 |
| 响应耗时 | ~1s(1次 embedding 调用) | ~3-8s(embedding + LLM) |
| 前端标识 | ✅ 知识库命中(青色) | 🤖 AI 综合分析(琥珀色) |
7. 实测验证结果
以下为浏览器端到端实测记录(非模拟数据):
| 验证项 | 结果 |
|---|---|
| 后端启动日志 | 疾病知识库加载完成:30 条,向量维度 2048 |
| 页面渲染 | 免责横幅/输入框/6 快捷按钮/30 标签墙/4 菜单项 全部就位 |
| 症状「流清鼻涕打喷嚏两天,低烧37.8度」 | ✅ 知识库命中:普通感冒 68.9%,Top3:普通感冒68.9%/过敏性鼻炎57.2%/流行性感冒51.1% |
| 四段建议 | 治疗意见、治疗方法、注意事项、安全提醒完整中文渲染 |
| 浏览器控制台 | 无红色错误 |
| 后端编译 | Compiling 15 source files → BUILD SUCCESS |
8. 部署与启动步骤
# ① 数据库(首次或重建库时)
mysql -uroot -p < backend/sql/init.sql        # 建库 ai_demo + 12用户 + 30疾病

# ② 后端(IDEA:Run AiDemoApplication,JDK 17/21)
#    启动成功标志:日志出现「疾病知识库加载完成:30 条,向量维度 2048」

# ③ 前端
cd frontend
npm install        # 首次
npm run dev        # → http://localhost:5173/

# ④ 浏览器访问 http://localhost:5173/disease
扩展知识库 :直接向 disease_kb 表 INSERT 新疾病(description 写清典型症状),重启后端即可生效(向量在启动时重建)。
9. 常见问题排查
| 现象 | 原因 | 解决 |
|---|---|---|
页面点诊断报 Request failed with status code 404 |
后端是旧代码,没有 /api/disease/* 接口 |
IDEA 重启后端,确认日志有「疾病知识库加载完成」 |
| 启动日志出现「疾病知识库向量初始化失败」 | 无外网 / API Key 无效 | 检查 application.yml 的 api-key 与网络;不影响启动,调用时自动重试 |
直接访问 /disease 白屏 |
Vite 端口漂移(5173 被占时自动换 5174) | 看终端实际端口访问;或释放 5173 后重启前端 |
| 诊断结果为「AI 综合分析」而非知识库命中 | 症状与知识库匹配度 < 0.60 | 正常设计行为;也可在知识库补充对应疾病 |
| 相似度普遍偏低但排序合理 | embedding 分数分布特性 | 属正常,重点看相对排序与阈值 |
附:涉及文件清单
后端(backend/src/main/...)
-
java/com/example/aidemo/entity/Disease.java -
java/com/example/aidemo/mapper/DiseaseMapper.java -
resources/mapper/DiseaseMapper.xml -
java/com/example/aidemo/dto/DiseaseDiagnosisVO.java、dto/DiseaseLlmReply.java -
java/com/example/aidemo/service/DiseaseDiagnosisService.java★核心 -
java/com/example/aidemo/controller/DiseaseController.java -
resources/application.yml(embedding 配置) -
sql/init.sql(disease_kb 表 + 30 条数据)
前端(frontend/src/...)
-
api/disease.js -
views/DiseaseView.vue★页面 -
router/index.js、layout/MainLayout.vue(路由与菜单)
大家点赞、收藏、关注、评论啦 其他的定制服务 商务合作 下方联系卡片↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓↓ 或者私信作者