文章目录
- 一、前言
- [二、为什么要引入 RNN?](#二、为什么要引入 RNN?)
-
- [2.1 什么是序列数据](#2.1 什么是序列数据)
- [2.2 传统神经网络存在的问题](#2.2 传统神经网络存在的问题)
- [三、RNN 的核心思想](#三、RNN 的核心思想)
-
- [3.1 引入隐状态 h:让网络拥有"记忆"](#3.1 引入隐状态 h:让网络拥有"记忆")
- [3.2 循环的由来:从"循环结构"到"展开结构"](#3.2 循环的由来:从"循环结构"到"展开结构")
- [3.3 RNN 的数学公式](#3.3 RNN 的数学公式)
- [3.4 RNN 的重要特点:参数共享](#3.4 RNN 的重要特点:参数共享)
- [3.5 输入输出等长](#3.5 输入输出等长)
- [四、RNN 的局限:长期依赖与梯度消失](#四、RNN 的局限:长期依赖与梯度消失)
- 五、LSTM:让网络学会"记忆"与"遗忘"
-
- [5.1 从生活经验说起](#5.1 从生活经验说起)
- [5.2 细胞状态与三种门](#5.2 细胞状态与三种门)
- [5.3 遗忘门:决定忘记什么](#5.3 遗忘门:决定忘记什么)
- [5.4 输入门:更新细胞状态](#5.4 输入门:更新细胞状态)
- [5.5 输出门:确定下一个隐藏状态](#5.5 输出门:确定下一个隐藏状态)
- [5.6 GRU(门控循环单元)](#5.6 GRU(门控循环单元))
- 六、总结
一、前言
在深度学习中,我们常会遇到两类数据:一类是相互独立的(如图片、表格中的单条记录),另一类是前后存在关联的序列数据(如文本、语音、股价走势)。对于后者,普通神经网络(如全连接网络)往往"力不从心"------因为它把每个样本当作孤立的点,既看不到先后顺序,也看不到上下文。
循环神经网络(Recurrent Neural Network,RNN) 正是为解决这类问题而设计的。
二、为什么要引入 RNN?
2.1 什么是序列数据
序列数据是指"当前数据的内容与前面的数据有关"的一类数据,常见的有:
| 类型 | 例子 |
|---|---|
| 文本 | 一句话中每个词的含义依赖上下文 |
| 语音 | 相邻音频帧之间连续变化 |
| 股票 / 金融数据 | 今天的价格受历史价格影响 |
| 时间序列 | 气温、销量、传感器读数等 |
以文本为例:要预测"我昨天吃了____"中的空缺词,必须结合前面的"吃了"。这说明序列数据具有时序依赖的特性,先后的信息会相互影响。
2.2 传统神经网络存在的问题
传统神经网络(如全连接前馈网络)在处理序列数据时有两个明显的问题:
- 无法训练出具有顺序的数据:输入之间被当作相互独立,网络结构本身没有"顺序"的概念;
- 模型搭建时没有考虑数据上下之间的关系:每个样本被单独送入网络,丢失了与相邻样本的上下文关联。
如果把一句话"切开"后逐词丢进普通网络,网络既不知道词的先后顺序,也看不到相邻词之间的关联,自然很难学好。
三、RNN 的核心思想
3.1 引入隐状态 h:让网络拥有"记忆"
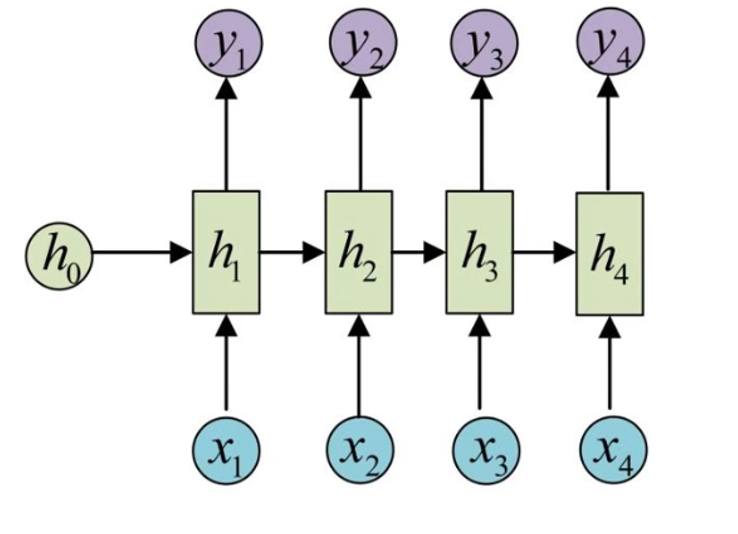
RNN 提出了一种新的网络结构:在处理序列输入时具有记忆性,可以保留之前输入的信息,并继续作为后续输入的一部分进行计算。
这里的关键概念是隐状态(hidden state)h。隐状态相当于网络的"记忆",它可以对序列类型的数据提取特征,再转换为输出。
3.2 循环的由来:从"循环结构"到"展开结构"
一个 RNN 单元可以看作一个带自环的结构:模块 A 接收当前输入 x t x_t xt,输出隐状态 h t h_t ht,同时把信息"传回"给自己,参与到下一步的计算中。
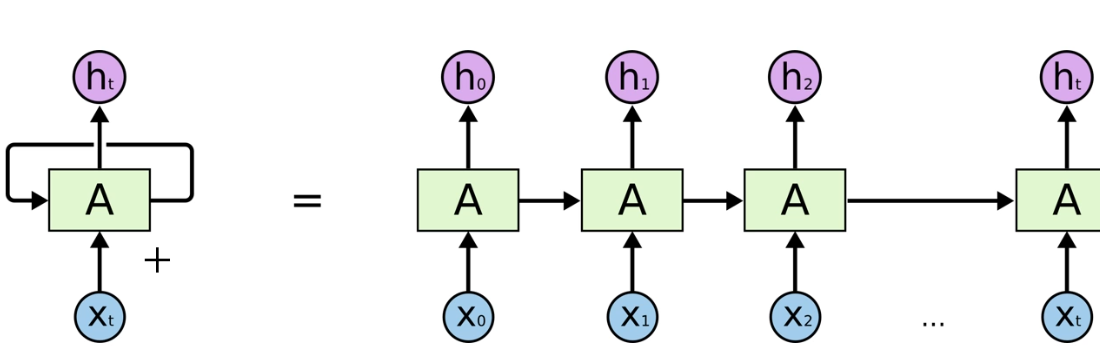
为了方便推导和理解,通常把循环结构按时间展开 成链式结构: x 0 → A → h 0 x_0 \to A \to h_0 x0→A→h0, x 1 → A → h 1 x_1 \to A \to h_1 x1→A→h1,......, x t → A → h t x_t \to A \to h_t xt→A→ht。
展开后可以看到,每一步的隐状态都承接了上一步的隐状态,信息在链上依次传递。
3.3 RNN 的数学公式
h 1 = f ( U x 1 + W h 0 + b ) h_1 = f(Ux_1 + Wh_0 + b) h1=f(Ux1+Wh0+b)
h 2 = f ( U x 2 + W h 1 + b ) h_2 = f(Ux_2 + Wh_1 + b) h2=f(Ux2+Wh1+b)
推广到一般形式:
h t = f ( U x t + W h t − 1 + b ) h_t = f(Ux_t + Wh_{t-1} + b) ht=f(Uxt+Wht−1+b)
输出为:
y t = Softmax ( V h t + c ) y_t = \text{Softmax}(Vh_t + c) yt=Softmax(Vht+c)
其中:
- x t x_t xt:第 t t t 步的输入;
- h t h_t ht:第 t t t 步的隐状态(网络记忆);
- U U U、 W W W、 V V V:权重矩阵;
- b b b、 c c c:偏置;
- f f f:激活函数。
3.4 RNN 的重要特点:参数共享
RNN 一个非常重要的特点是参数共享 :在计算时,每一步使用的参数 U U U、 W W W、 b b b 都是一样的。也就是说,同一个模型被反复应用在序列的每一步上。
这样做有两个好处:
- 大大减少了参数量;
- 模型可以处理任意长度的序列。
3.5 输入输出等长
在基本 RNN 结构中,输入是 x 1 , x 2 , ... , x n x_1, x_2, \dots, x_n x1,x2,...,xn,输出为 y 1 , y 2 , ... , y n y_1, y_2, \dots, y_n y1,y2,...,yn,即输入和输出序列是等长的。
四、RNN 的局限:长期依赖与梯度消失
RNN 理论上可以处理长期依赖,但在实践中却很难学好。一个例子:
"我的职业是程序员,......,我最擅长的是____。"
要预测最后一个词"电脑",需要依赖离当前位置很远的上下文"职业是程序员"。这说明相关信息和当前预测位置之间的间隔可能相当大。
为什么 RNN 学不好这种长期依赖?
原因是:梯度会随着时间的推移不断下降减少 。RNN 的训练使用随时间反向传播(BPTT,Backpropagation Through Time),误差信号每向前传播一个时间步,就要乘以一次权重矩阵。经过多个时间步后,梯度会指数级衰减(梯度消失)。当梯度值变得非常小时,模型就无法继续学习,也就"记不住"太远的信息。
五、LSTM:让网络学会"记忆"与"遗忘"
5.1 从生活经验说起
LSTM(Long Short-Term Memory,长短时记忆网络)是 RNN 的一种特殊类型,可以学习长期依赖信息 。它大部分与 RNN 相同,但使用了不同的函数来计算隐状态。
举例:
当你想在网上购买生活用品时,一般都会查看一下其他已购买用户的评价。当你浏览评论时,大脑会下意识记住重要的关键词,比如"好看"和"真酷"这样的词汇,而不太会关心"我""也""是"等字样。如果朋友第二天问你用户评价都说了什么,你不可能会全部记住它,而是说出大脑里记得的主要观点,比如"下次肯定还会来买",无关紧要的内容自然会从记忆中逐渐消失。
LSTM 和 GRU 就是模仿这种机制:它们可以学习只保留相关信息来进行预测,并忘记不相关的数据。简单说,因为记忆能力有限,所以要"记住重要的,忘记无关紧要的"。
5.2 细胞状态与三种门
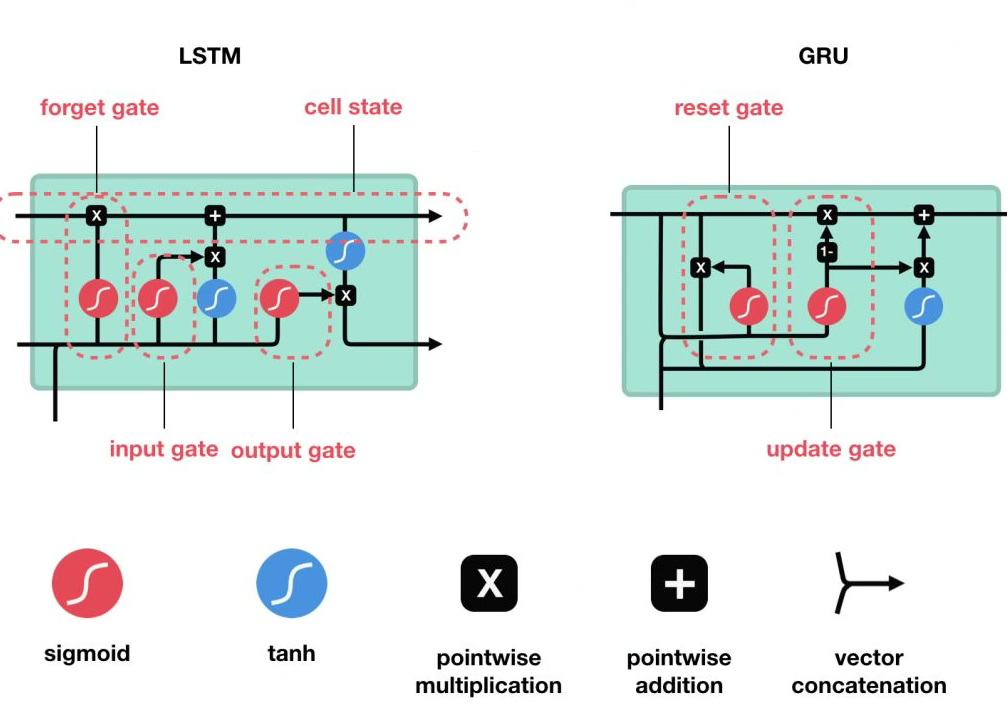
LSTM 引入了细胞状态(cell state) C t C_t Ct ,让信息可以几乎无损地在序列中传递。同时,LSTM 内部设计了 3 种"门"结构来调节信息流:
| 门结构 | 主要作用 |
|---|---|
| 遗忘门(forget gate) | 决定应丢弃哪些信息 |
| 输入门(input gate) | 决定应把哪些新信息写入细胞状态 |
| 输出门(output gate) | 决定输出 / 传递哪些信息给下一个隐藏状态 |
图中的图例含义:
- sigmoid:输出 0~1,决定信息"保留多少";
- tanh:输出 -1~1,用于生成候选值;
- 逐点相乘(pointwise multiplication)/ 逐点相加(pointwise addition):对应元素相乘、相加;
- 向量拼接(vector concatenation):把两个向量拼接成一个。
5.3 遗忘门:决定忘记什么
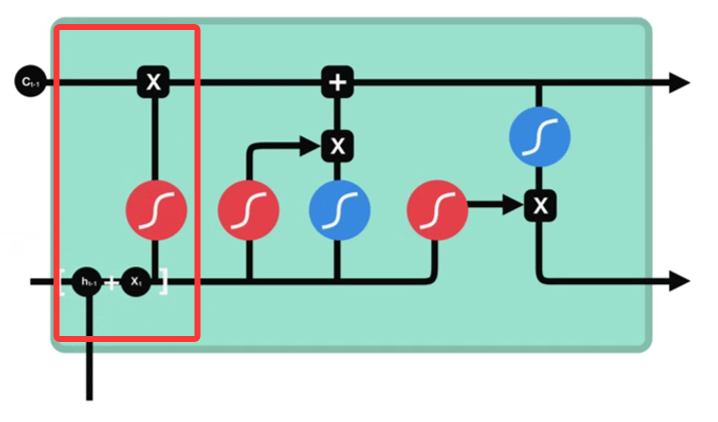
功能:决定应丢弃哪些关键词信息。
步骤 :来自前一个隐藏状态 h t − 1 h_{t-1} ht−1 的信息和当前输入 x t x_t xt 的信息,同时传递到 sigmoid 函数中去,输出值介于 0 和 1 之间------越接近 0 意味着越应该丢弃,越接近 1 意味着越应该保留。
f t = σ ( W f ⋅ h t − 1 , x t + b f ) f_t = \sigma(W_f \cdot h_{t-1}, x_t + b_f) ft=σ(Wf⋅ht−1,xt+bf)
5.4 输入门:更新细胞状态
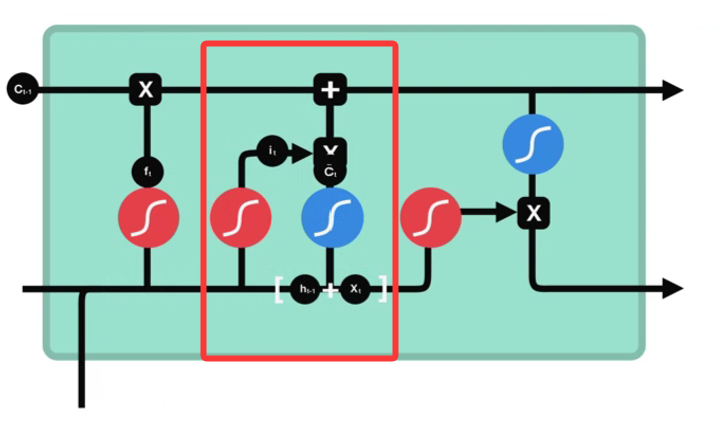
功能:用于更新细胞状态。
步骤:
- 首先将前一层隐藏状态的信息和当前输入的信息传递到 sigmoid 函数中,将值调整到 0~1 之间,决定要更新哪些信息(0 表示不重要,1 表示重要);
- 将前一层隐藏状态的信息和当前输入的信息传递到 tanh 函数中,创造一个新的候选值向量 C ~ t \tilde{C}_t C~t;
- 最后将 sigmoid 的输出值与 tanh 的输出值相乘------sigmoid 的输出值决定 tanh 的输出值中哪些信息是重要且需要保留下来的。
i t = σ ( W i ⋅ h t − 1 , x t + b i ) i_t = \sigma(W_i \cdot h_{t-1}, x_t + b_i) it=σ(Wi⋅ht−1,xt+bi)
C ~ t = tanh ( W C ⋅ h t − 1 , x t + b C ) \tilde{C}_t = \tanh(W_C \cdot h_{t-1}, x_t + b_C) C~t=tanh(WC⋅ht−1,xt+bC)
旧细胞状态先与遗忘门相乘(丢弃不重要的信息),再加上输入门筛选出的新信息,得到新的细胞状态:
C t = f t ⊙ C t − 1 + i t ⊙ C ~ t C_t = f_t \odot C_{t-1} + i_t \odot \tilde{C}_t Ct=ft⊙Ct−1+it⊙C~t
5.5 输出门:确定下一个隐藏状态
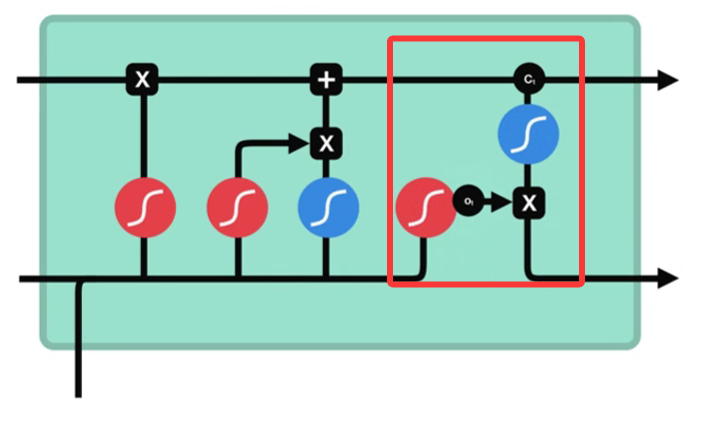
功能:用来确定下一个隐藏状态的值。
步骤:
- 将前一个隐藏状态和当前输入传递到 sigmoid 函数中,然后将新得到的细胞状态 C t C_t Ct 传递给 tanh 函数;
- 将 tanh 的输出与 sigmoid 的输出相乘,确定隐藏状态应携带的信息;
- 再将隐藏状态作为当前细胞的输出,把新的细胞状态和新的隐藏状态传递到下一个时间步中去。
o t = σ ( W o ⋅ h t − 1 , x t + b o ) o_t = \sigma(W_o \cdot h_{t-1}, x_t + b_o) ot=σ(Wo⋅ht−1,xt+bo)
h t = o t ⊙ tanh ( C t ) h_t = o_t \odot \tanh(C_t) ht=ot⊙tanh(Ct)
一句话总结:遗忘门决定"忘什么",输入门决定"记什么",两者共同更新细胞状态;输出门决定"对外说什么"。
5.6 GRU(门控循环单元)
GRU(Gated Recurrent Unit,门控循环单元) 是 LSTM 的简化版本,只有两个门:
- 重置门(reset gate):决定有多少过去的信息需要被遗忘;
- 更新门(update gate):类似 LSTM 遗忘门 + 输入门的组合,决定新信息与旧信息的比例。
GRU 参数更少、训练更快,在很多任务上与 LSTM 表现接近。
六、总结
| 要点 | 结论 |
|---|---|
| 序列数据 | 当前内容与前文相关,如文本、语音、股票、时间序列 |
| 传统神经网络的不足 | 无法处理有序数据,没有考虑数据上下之间的关系 |
| RNN 的核心 | 引入隐状态 h h h,具有记忆性;参数共享;按时间展开 |
| RNN 的局限 | 长期依赖难以学习,梯度随时间推移不断衰减(梯度消失) |
| LSTM 的改进 | 细胞状态 + 遗忘门 / 输入门 / 输出门,记住重要的、遗忘无关的 |
| GRU | LSTM 的简化版,只有重置门和更新门,参数更少 |