机器学习:KNN算法(怎么取K的值,交叉验证和网格搜索)

目录标题

一、KNN算法思想

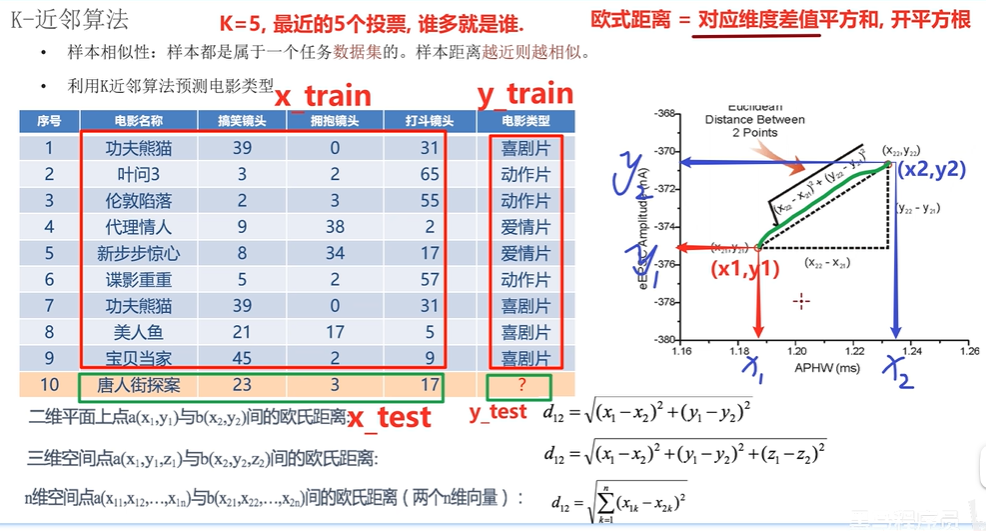
如果一个样本在特征空间中的K个最相似的样本中的大多数属于某一个类别,则该样本也属于这个类别

如何确定样本的相似性? 距离 距离越近,越相似
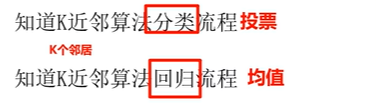
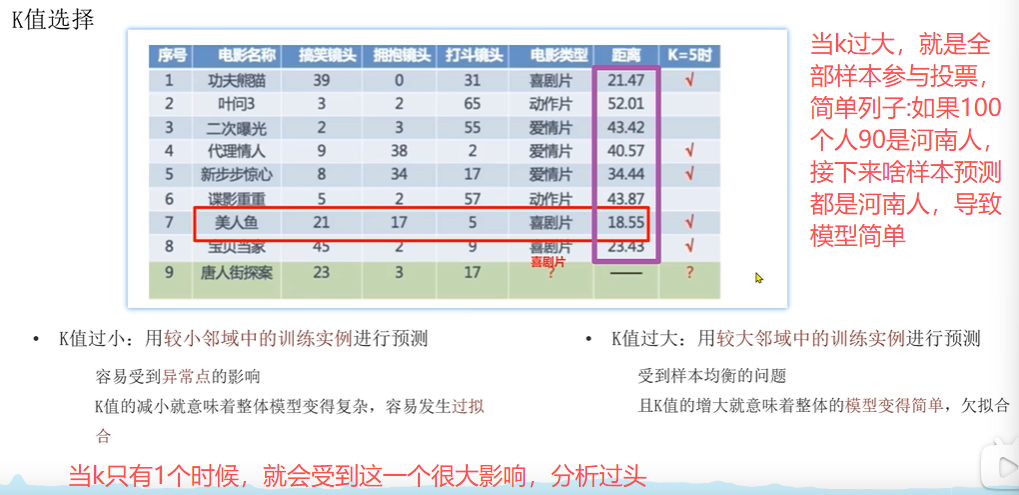
K值小过拟合,K值过大欠拟合,那如何选择合适的K值 交叉验证和网络搜索
二、KNN怎么算最近距离

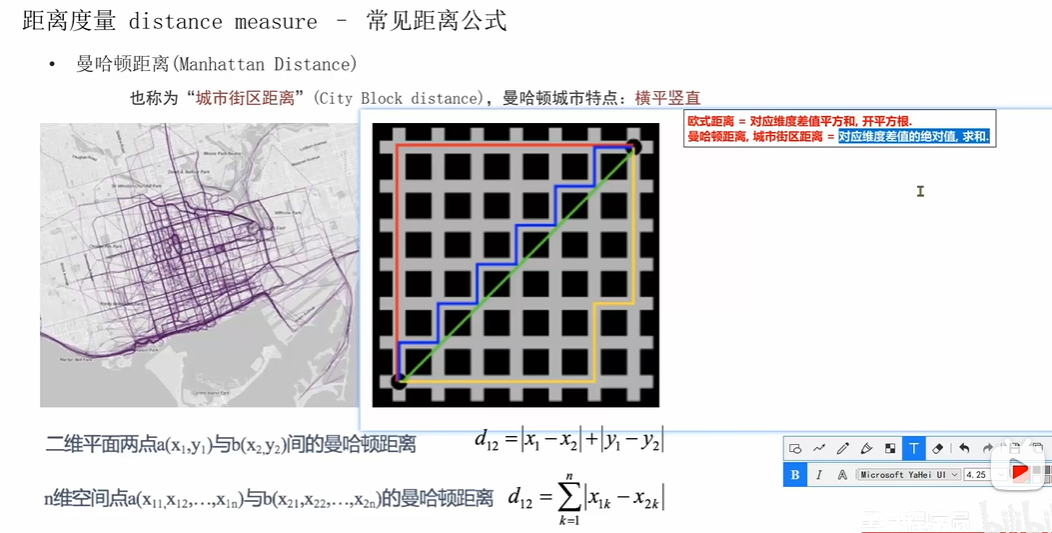
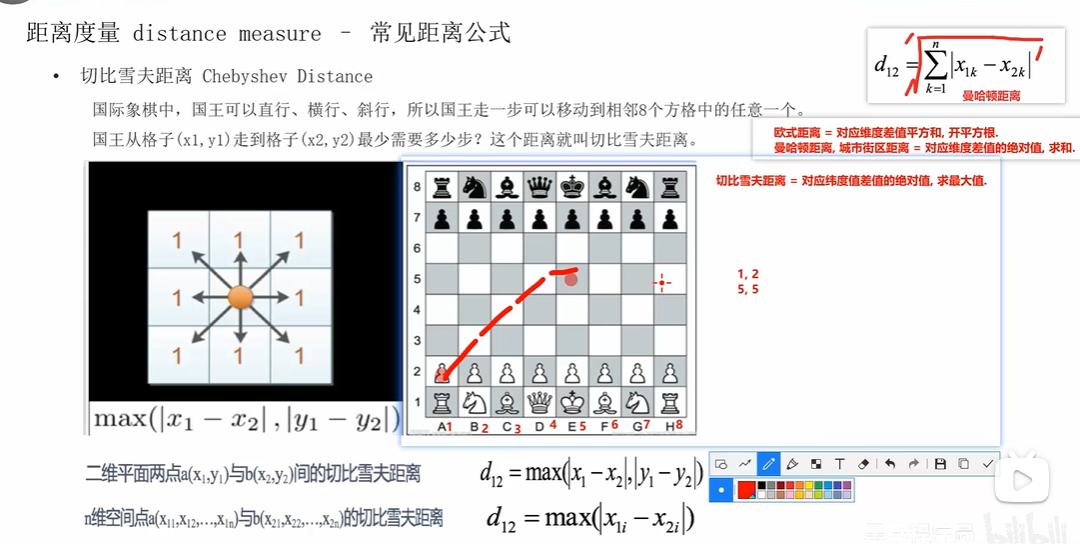
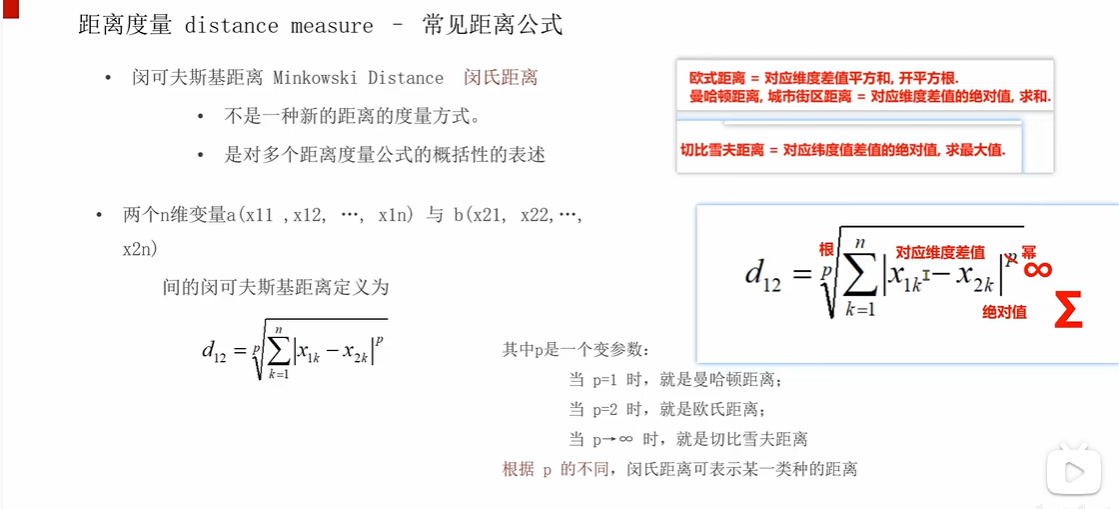
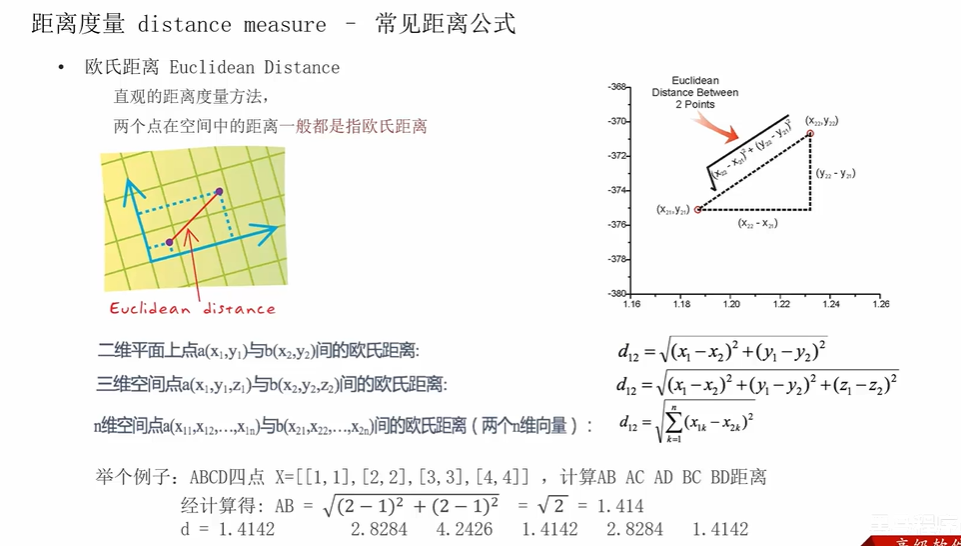
欧式距离(闵时距离2次方),曼哈顿距离(闵时距离1次方),切比雪夫距离((闵时距离无穷次方)),闵可夫斯距离
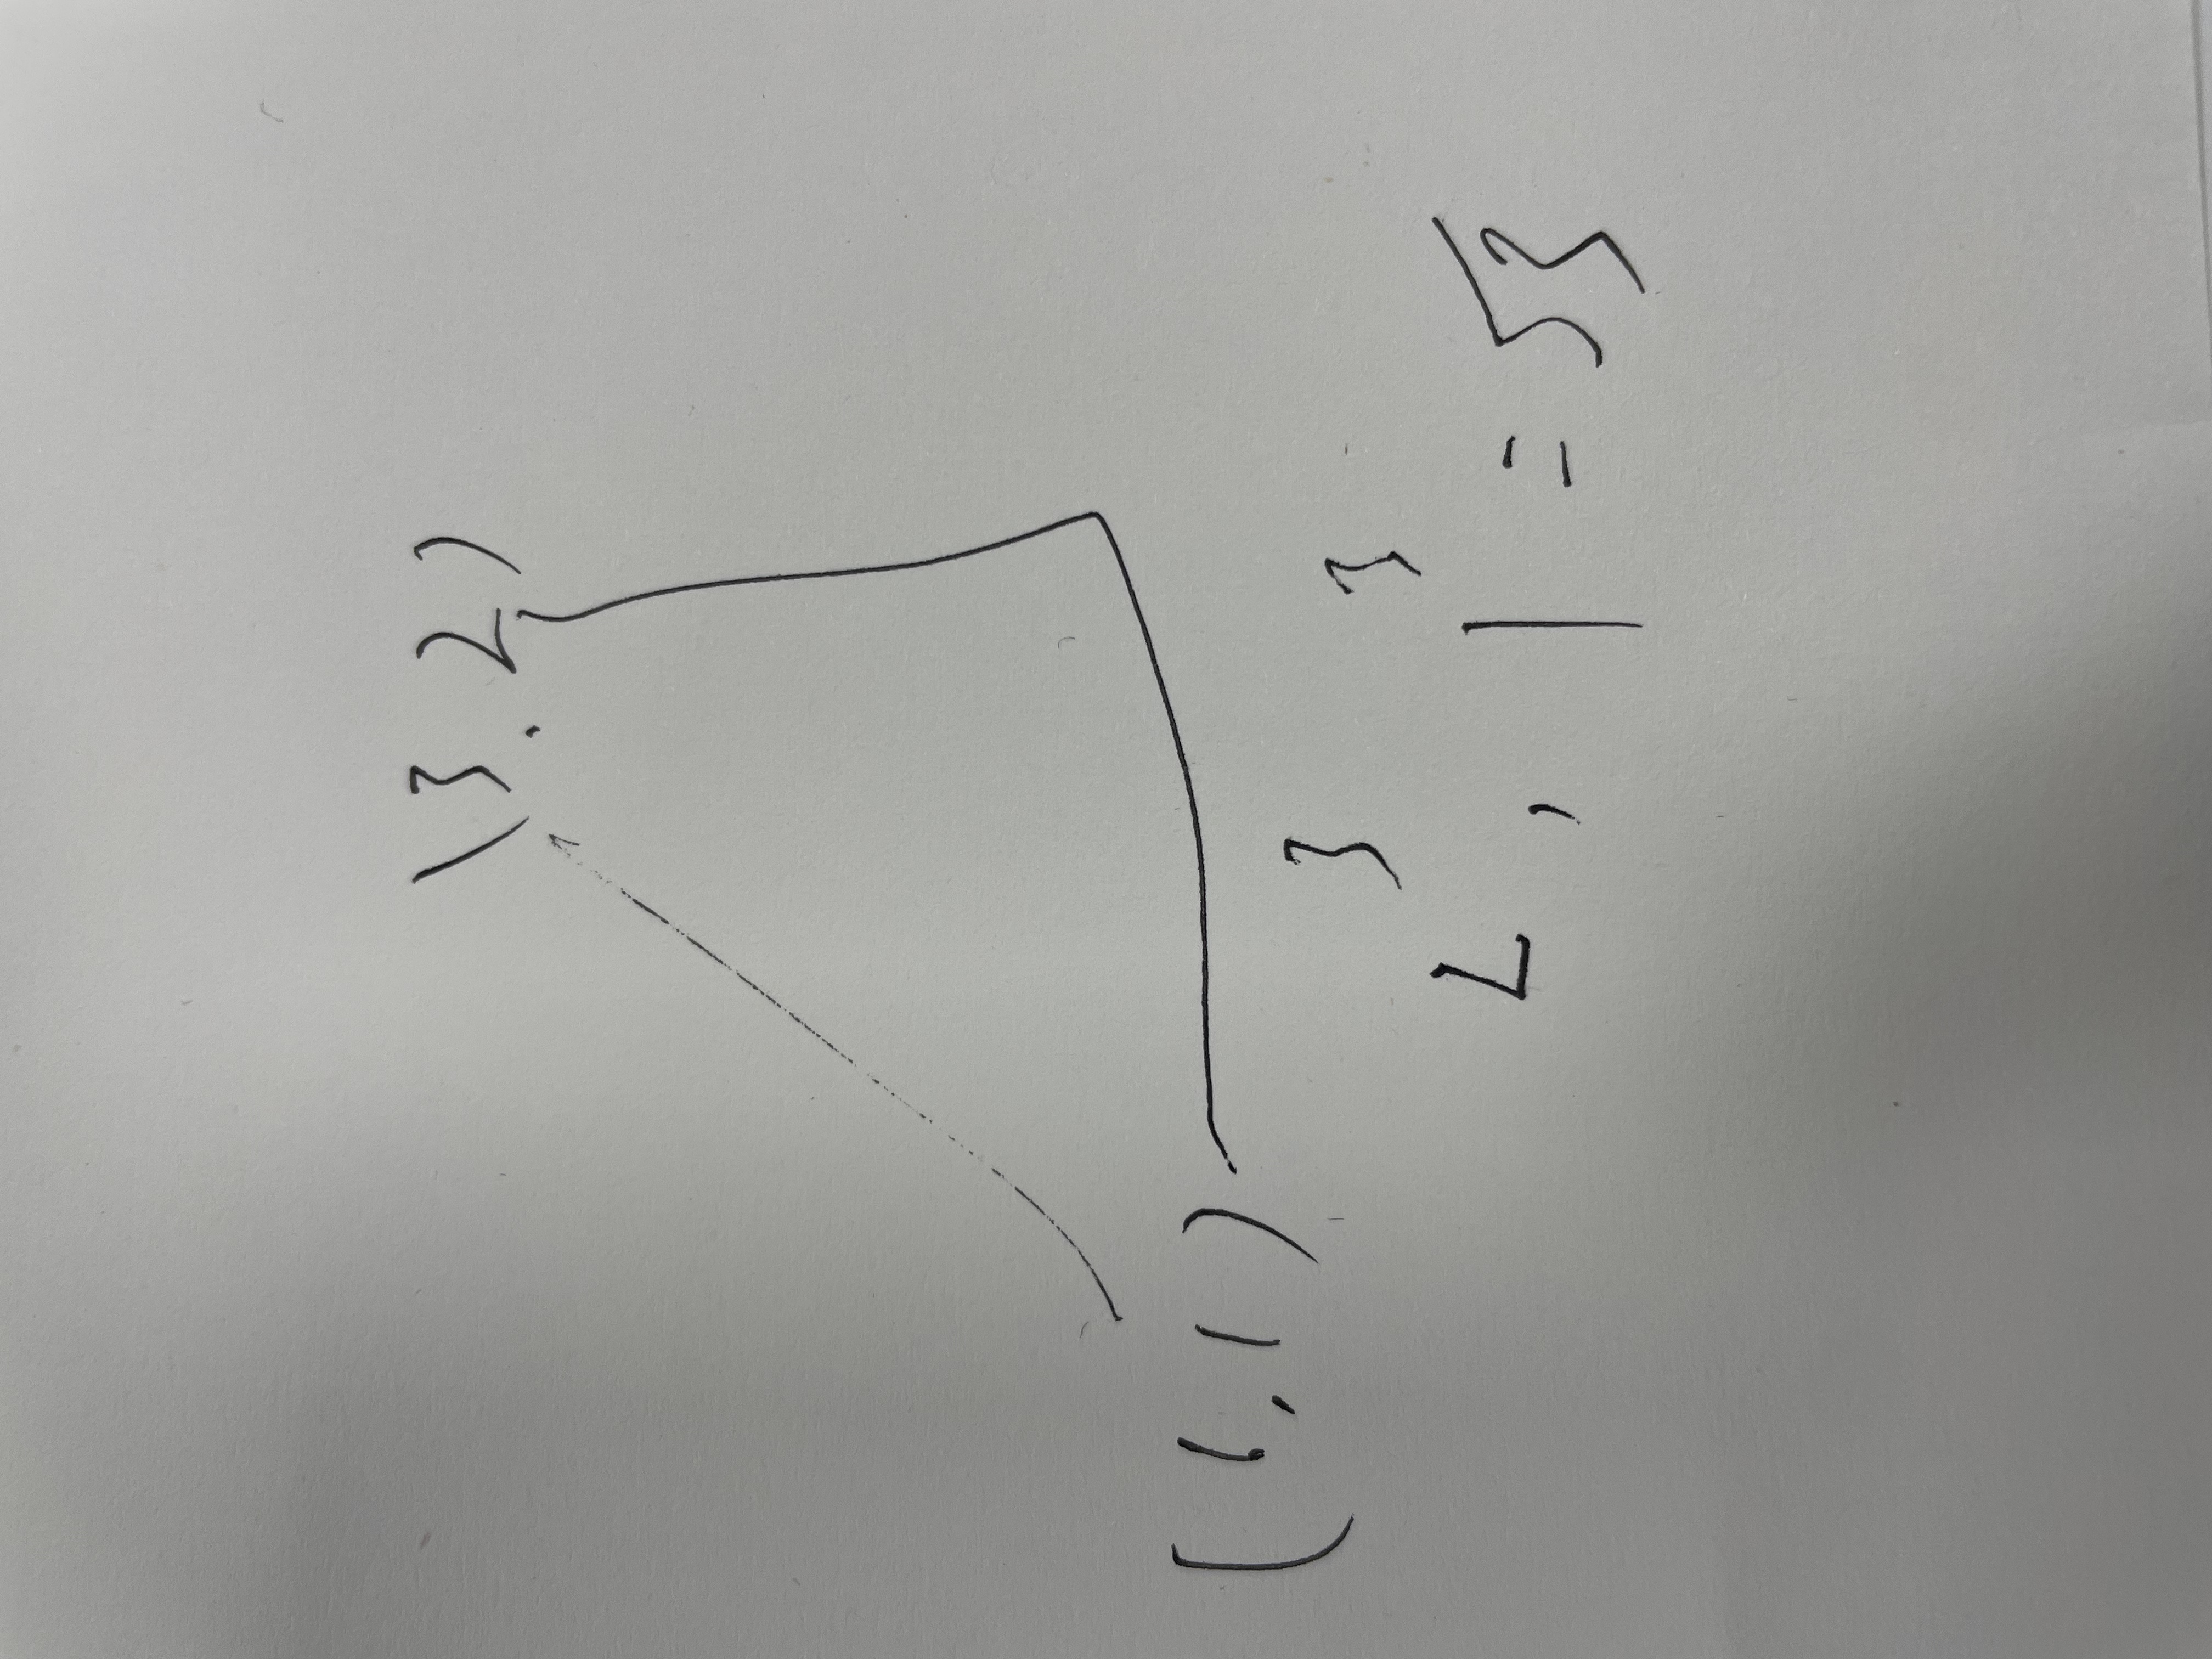
举个例子:看看无穷大时候时切比雪夫距离(一次方和二次方不看)

这是二维下 p是3次方两个点距离,

当p变成无穷大时候, 2^∞ + 1 ^∞ 开无穷根号,值越来越像 2 ^ ∞靠近,忽略 1 ^ ∞,所以最后就是选择大的一边,就是切比雪夫距离
三、这个k值怎么取(就是调用api里面的超参,参考之前鸢尾花实验)

因为 K值小过拟合,K值过大欠拟合

交叉验证就是复验几次,为啥要反复验证呢?

把一份数据切成多份,轮流当验证集,来更准确地评估同一个模型

你有一份数据,如果只切一次(比如 80% 训练,20% 测试),会有一个问题:这次切分可能运气好或运气坏。

如果测试集里刚好全是简单样本,模型准确率 95%,你会误以为模型很好。

如果测试集里刚好全是难样本,模型准确率 60%,你会误以为模型很差
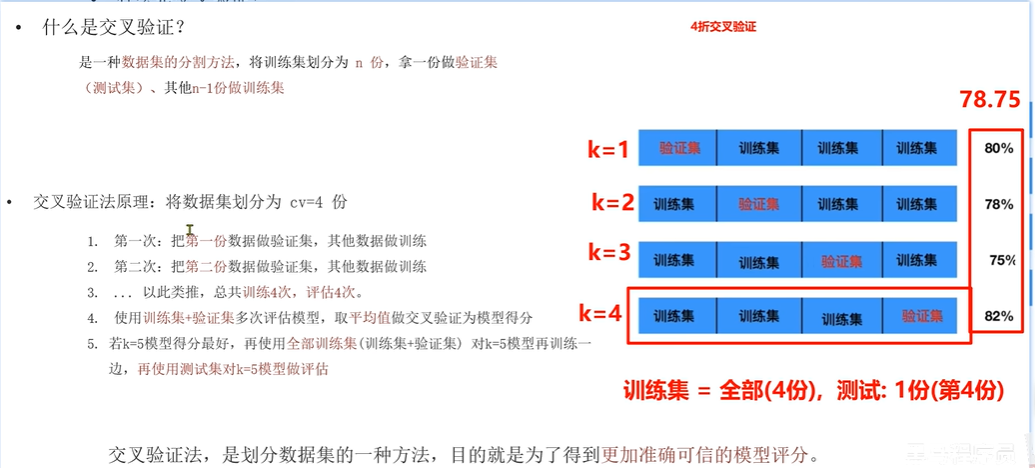
交叉验证:评估模型的好坏的方法

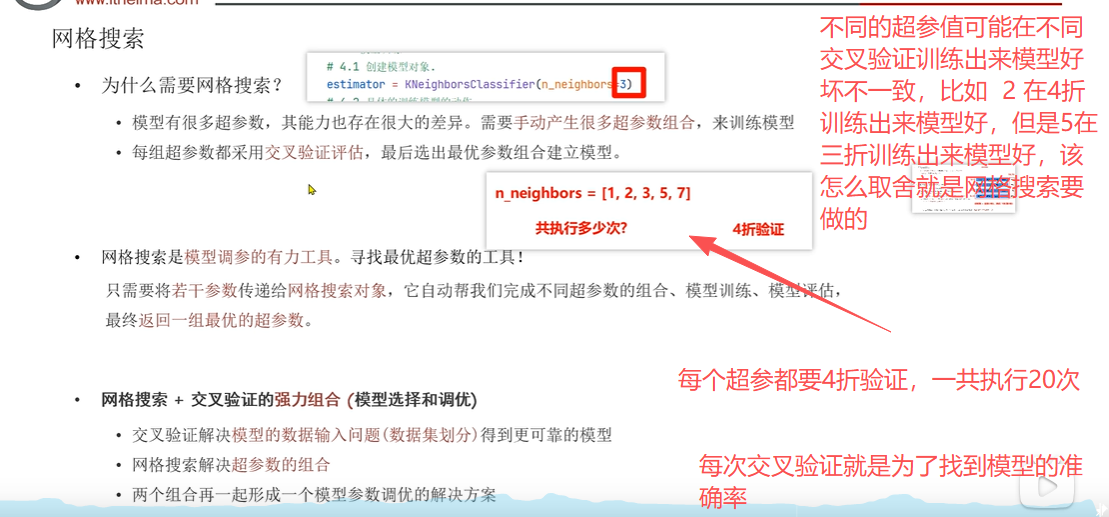
网格搜索:自动调各种超参组合,选出最优超参
四、knn里面找距离远近的曼哈顿,欧式等和损失函数里面找距离远近有啥区别

两个都是算距离,衡量差异

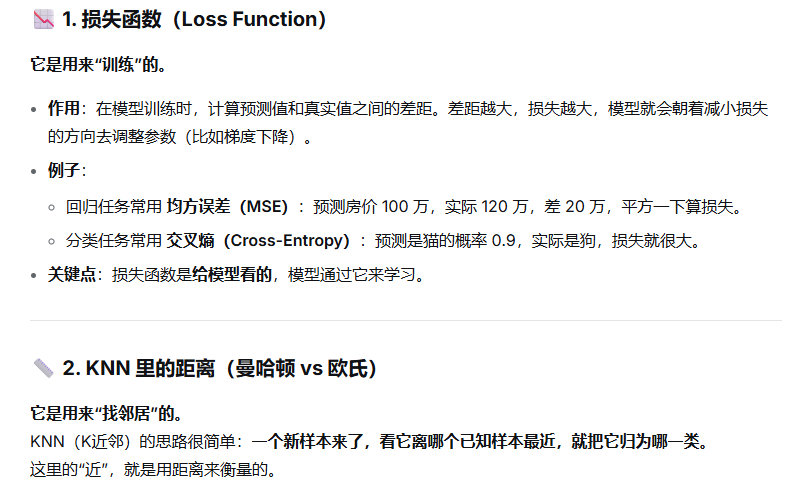
**损失函数:**用来训练模型,告诉模型"你错得有多离谱",然后模型根据它来调整参数

曼哈顿/欧氏距离:用来衡量样本之间的相似度,在 KNN 里就是用来找"谁离我最近"
相关推荐
Be for thing15 小时前
Pytorch【12】transforms进阶|图像数据增强实战,提升模型泛化能力
人工智能·pytorch·机器学习
武子康16 小时前
AI通关了,游戏就算通过测试了吗?
人工智能·游戏·机器学习
linweidong21 小时前
RTX 4090 Ubuntu + ComfyUI + comfy-kitchen 0.2.41 完整部署文档
机器学习·云原生·conda·pandas·scikit-learn
咕泡科技21 小时前
关于机器学习,如何通俗理解全连接层(fully connected layer)?
人工智能·深度学习·机器学习
龙腾AI白云21 小时前
具身智能模仿学习与人类示教:从观察中习得动作
数据库·机器学习·知识图谱·pygame
电科_银尘21 小时前
【大模型算法与工程 01】机器学习的问题定义:监督、无监督、自监督与强化学习
人工智能·算法·机器学习
罗西的思考1 天前
【轻量化复刻大模型 / KIMI K3】Multi-Token Prediction(MTP / EAGLE-3)(2)
人工智能·算法·机器学习
罗西的思考1 天前
【轻量化复刻大模型 / KIMI K3】Multi-Token Prediction(MTP / EAGLE-3)(1)
人工智能·算法·机器学习
武子康1 天前
H3-World 接入 Game Agent:谁来判断门真的打开了?
人工智能·算法·机器学习
XLYcmy2 天前
基于大语言模型的智能漏洞检测与修复系统 作品报告评审分析报告 下
机器学习·llm·prompt·api·token·漏洞修复·漏洞检测