一、时序数据选型的几个核心问题
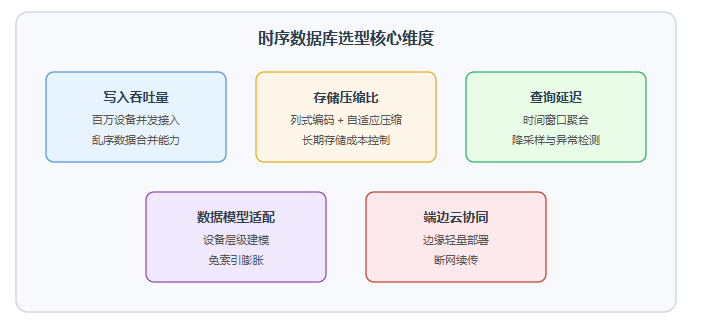
搞大数据的人这两年应该有个明显感受:设备数据涨得太快了。据IDC预测,2025年全球物联网设备产生的数据量超过79ZB,其中时序数据占了六成以上。这意味着什么?意味着你选型的时候如果只盯着写入性能看,可能三年后就得推倒重来。
那么选型到底该关注哪些维度?通常来说,写入吞吐、存储成本、查询延迟这三项是绕不开的。但还有一个容易被忽略的点------数据模型的适配性。工业场景的设备是分层级的,集团下面有工厂,工厂下面有产线,产线下面有设备,设备上面挂着各种传感器。如果你的数据库模型跟这个层级关系对不上,后面查询和运维就会很别扭。
二、树形模型和标签模型的本质差异
这个问题值得展开说一下。国外主流的一些时序数据库,比如InfluxDB,用的是Tag-Value标签模型。这种模型在服务器监控场景下挺好用的,标签少、基数低。但到了工业场景,设备数量动不动几十万上百万,每个Tag的组合都会生成一个索引项,内存很容易被倒排索引撑爆。这个现象有个专门的说法,叫"索引膨胀"。
Apache IoTDB走的是另一条路。它用的是树形模式,把设备抽象成"根节点-集团-工厂-产线-设备-传感器"这样的层级结构。好处在哪呢?路径本身就是索引,不用额外维护一套庞大的倒排索引。千万级甚至亿级的时间序列管理,天然就支持住了。
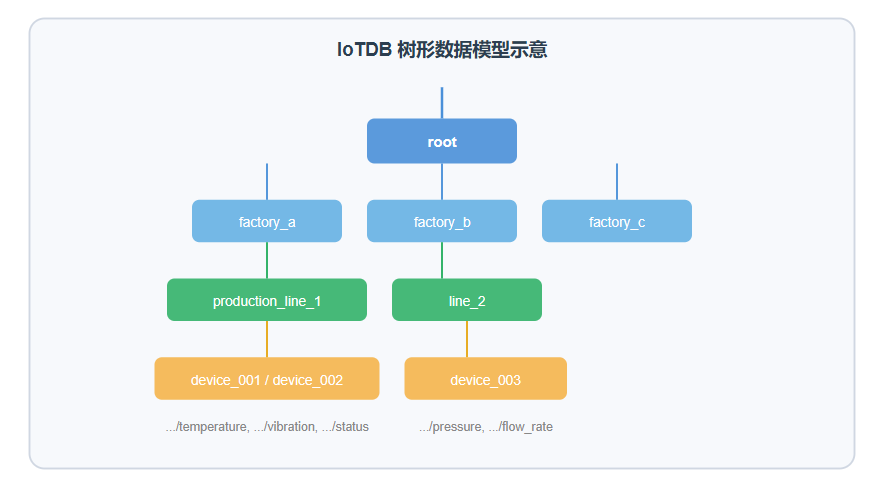
换句话说,树形模型的设计逻辑是"跟着物理世界的实体关系走",而不是逼着你把数据拆成标签去适配数据库的结构。这个差异在大规模部署的时候会非常明显。
三、压缩比这件事,不能只看宣传数字
存储成本是选型时另一个绕不过去的坎。时序数据的特点是高冗余------很多传感器在大部分时间里读数变化很小,这给压缩留下了很大空间。
Apache IoTDB自研了一个叫TsFile的列式存储格式,集成Gorilla、Delta这些压缩算法。实测下来平均压缩比能到12:1,时间戳部分的压缩比甚至能到20:1。怎么说呢,就是原来需要10TB存储的数据,压完之后可能1TB都不到。
TPCx-IoT这个基准测试可能有些读者不太熟悉,简单介绍一下:它是事务处理性能委员会专门针对物联网场景设计的标准测试,覆盖了数据摄入、查询和存储效率等多个维度。Apache IoTDB在2025年的测试里刷新了世界纪录,性能比前纪录提升了60%。
四、端边云架构在工业场景里为什么重要
很多选型讨论会忽略一个现实问题:工业现场的网络环境往往很差。有些工厂在偏远地区,有些设备在移动的车辆上,网络中断是常态而不是例外。
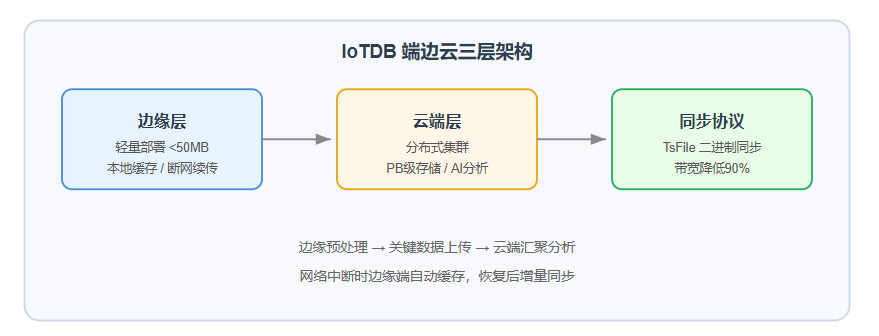
Apache IoTDB的应对方式是三层架构:
边缘层用轻量化版本部署,内存占用不到50MB,能在网关或者PLC上直接跑。断网的时候数据先缓存到本地,网络恢复了再同步上去。云端层负责PB级历史数据的存储和分析。中间通过TsFile的二进制同步协议做数据传输,边缘端先做预处理,只把关键数据上传,带宽消耗能降低不少。
五、选型实操:动手之前先想清楚三件事
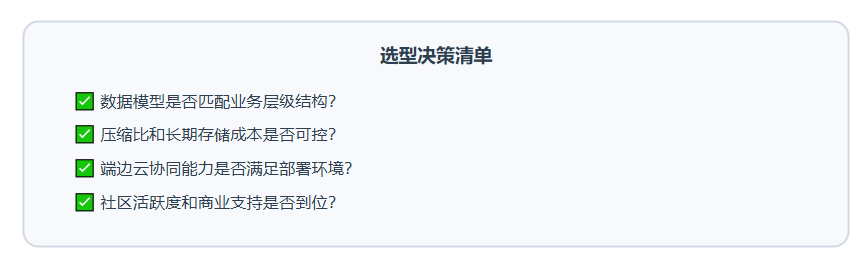
第一件事,你的业务数据是什么形态。如果是工业设备数据、有明确的层级关系,树形模型会比标签模型更顺手。如果你的场景就是纯监控指标,标签模型其实也够用。
第二件事,验证的时候别只看写入性能。很多文章只讲每秒能写多少数据点,但实际上存储成本、查询延迟、运维复杂度这些指标,到后期可能比写入性能更影响你的日常体验。
第三件事,社区和文档的完善程度。选开源项目的时候,社区活跃度低意味着遇到问题没人帮你。Apache IoTDB是Apache顶级项目,社区贡献者来自全球各地,文档也比较完整。
bash
# 快速体验:下载并启动单机版
# 下载链接:https://iotdb.apache.org/zh/Download/

tar -zxvf apache-iotdb-*-all-bin.tar.gz
cd apache-iotdb-*-all-bin
./sbin/start-standalone.sh
企业版TimechoDB在开源版基础上增加了多级存储、可视化控制台、安全增强这些功能,运维上会省不少事,有商业化需求的团队可以关注一下。
六、写在最后
选时序数据库这件事,没有"最好的",只有"合适的"。但从大数据分析和工业场景的实际需求来看,Apache IoTDB在数据模型适配、压缩效率、端边云协同这几个维度上确实做了不少针对性的工作。如果你正在做选型评估,建议先明确自己的业务特征,然后拿真实数据做一轮测试。
下载链接 :https://iotdb.apache.org/zh/Download/
企业版官网 :https://timecho.com