摘要 :Go 1.18 引入泛型后,许多过去靠复制粘贴或
interface{}反射实现的"通用"代码,可以用类型参数重写为一份既类型安全又零运行时开销的实现。本文从重复代码痛点出发,讲清类型参数、类型推断与约束(constraints)的设计哲学,重点区分comparable(相等)与cmp.Ordered(有序,Go 1.21 标准库),并落地到可复用的泛型栈、队列与 Map/Filter/Reduce,以及后端缓存、任务池等真实场景。所有示例均可运行。
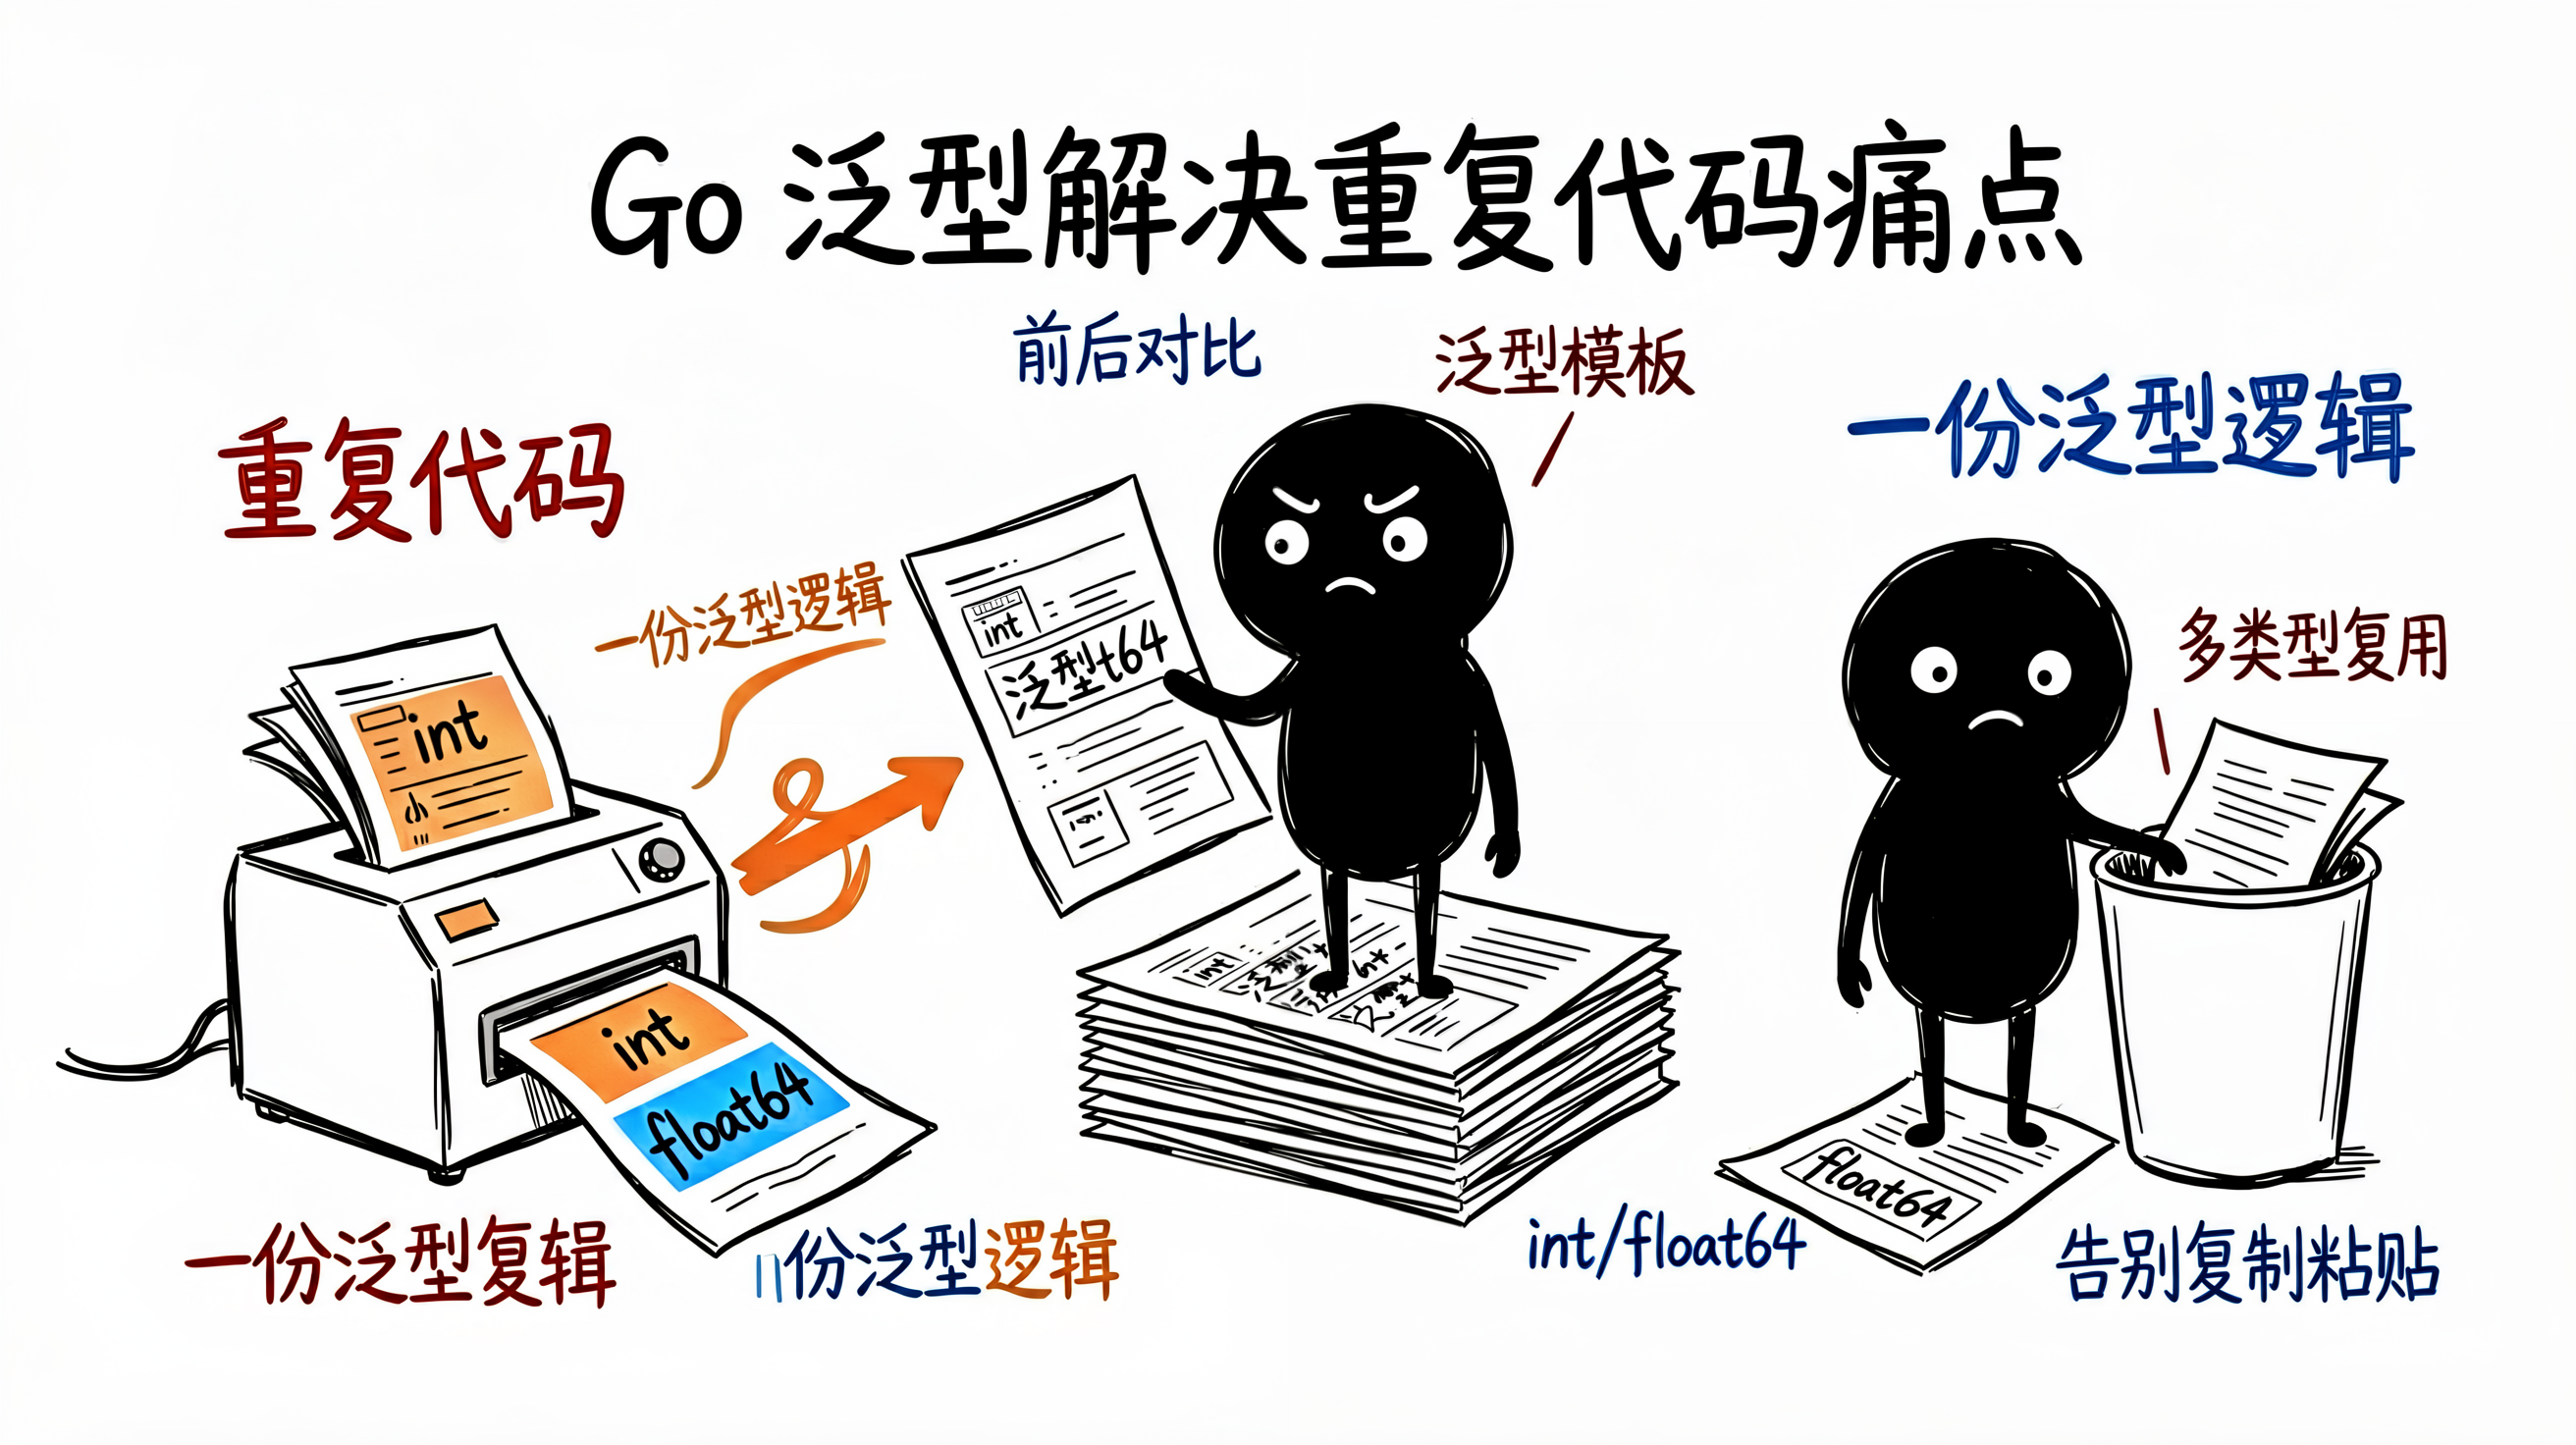
一、为什么需要泛型:从重复代码说起
泛型(generics) 指的是让函数或类型用「类型参数」占位,由编译器在编译期为不同具体类型分别生成专用代码。这样你写一份逻辑,就能安全覆盖多种类型,而不必为每种类型重复实现。
在没有泛型之前,最常见的痛点就是"同逻辑、多类型"。比如要统计一个 map 里的值之和,键是 string、值是 int64 和 float64 时,往往要写两份几乎一样的函数。
下面是非泛型写法和泛型写法的对照。注意泛型版本用 [K comparable, V int64 | float64] 声明了类型参数与约束,逻辑只写一次:
go
package main

import "fmt"

// 非泛型:为每种值类型各写一份,逻辑完全重复
func SumInts(m map[string]int64) int64 {
    var s int64
    for _, v := range m {
        s += v
    }
    return s
}

func SumFloats(m map[string]float64) float64 {
    var s float64
    for _, v := range m {
        s += v
    }
    return s
}

// 泛型:一份实现覆盖两类值类型
func SumNumbers[K comparable, V int64 | float64](m map[K]V) V {
    var s V
    for _, v := range m {
        s += v
    }
    return s
}

func main() {
    ints := map[string]int64{"a": 1, "b": 2}
    floats := map[string]float64{"a": 1.5, "b": 2.5}
    fmt.Println(SumInts(ints), SumFloats(floats))
    fmt.Println(SumNumbers(ints), SumNumbers(floats))
}
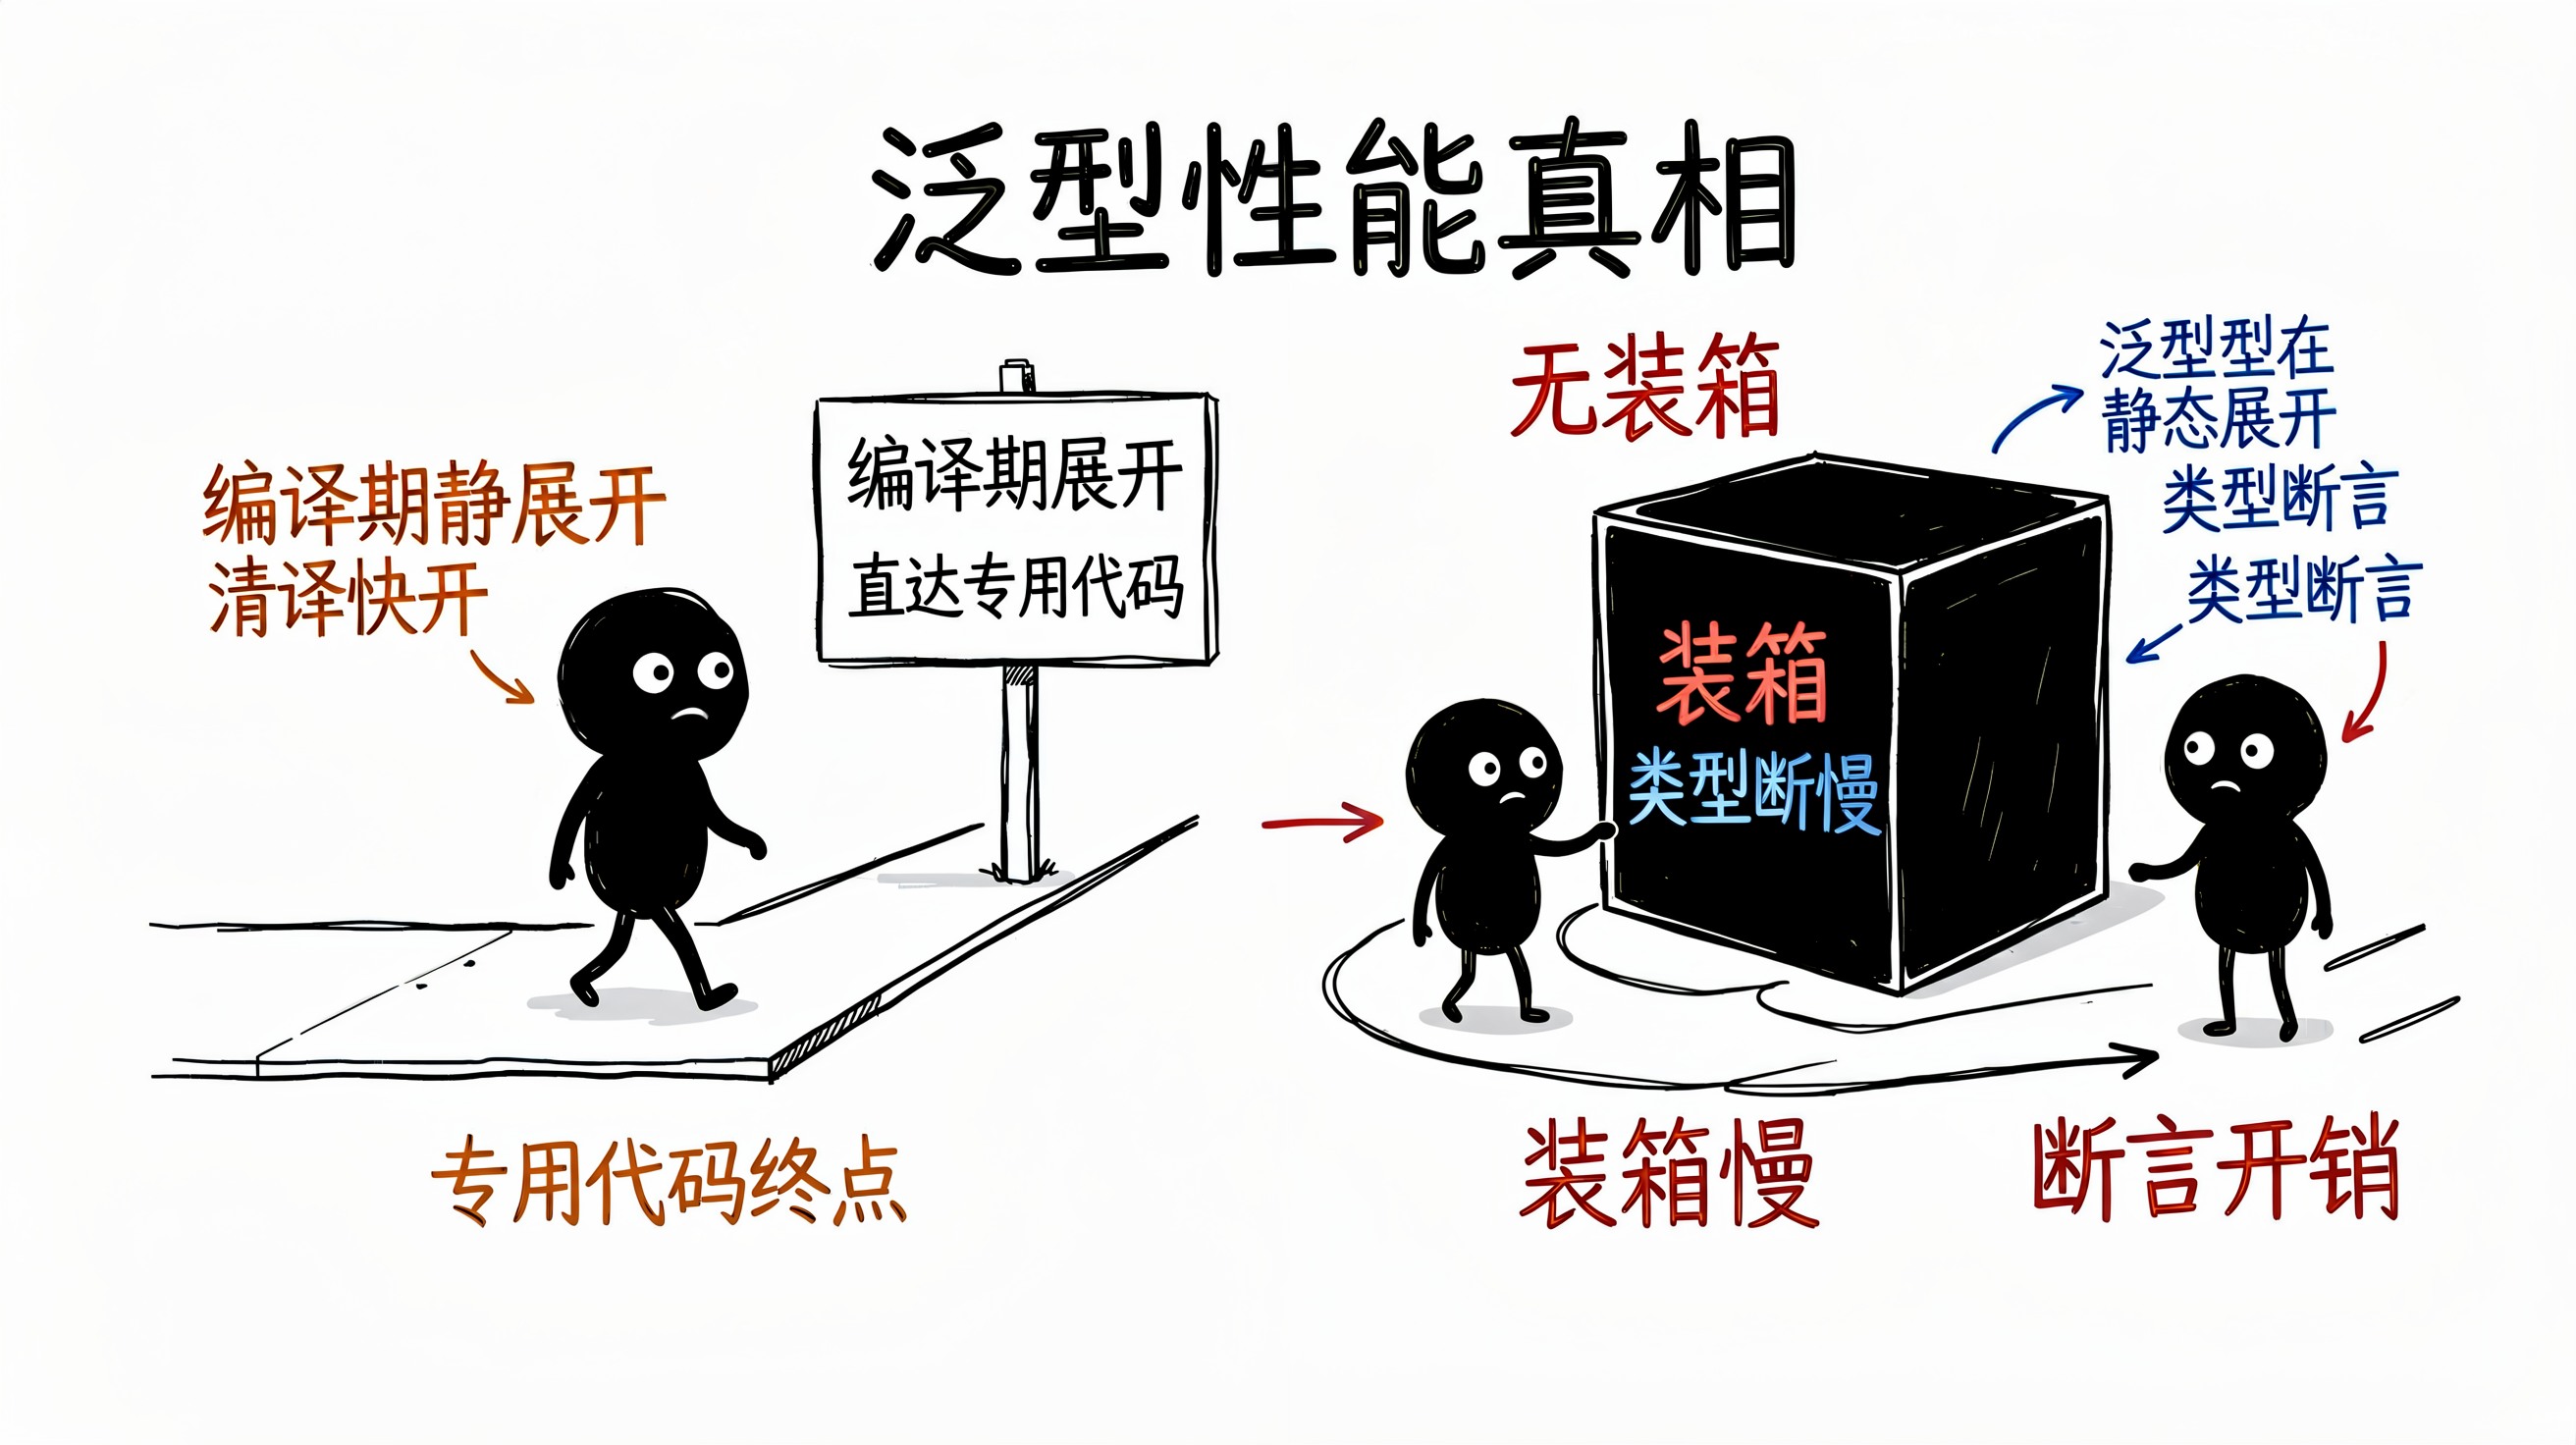
使用 interface{} 虽然也能"通吃"类型,但代价是装箱、运行时类型断言,既丢掉了编译期类型安全,又带来性能损耗。泛型则在编译期展开,无装箱、无断言,性能与手写专用代码基本一致。
小结一下三者的取舍:复制粘贴维护成本高、易出错;interface{} 灵活但失去类型安全与性能;泛型兼顾了复用、类型安全与运行时效率。
二、泛型基础:类型参数与类型推断
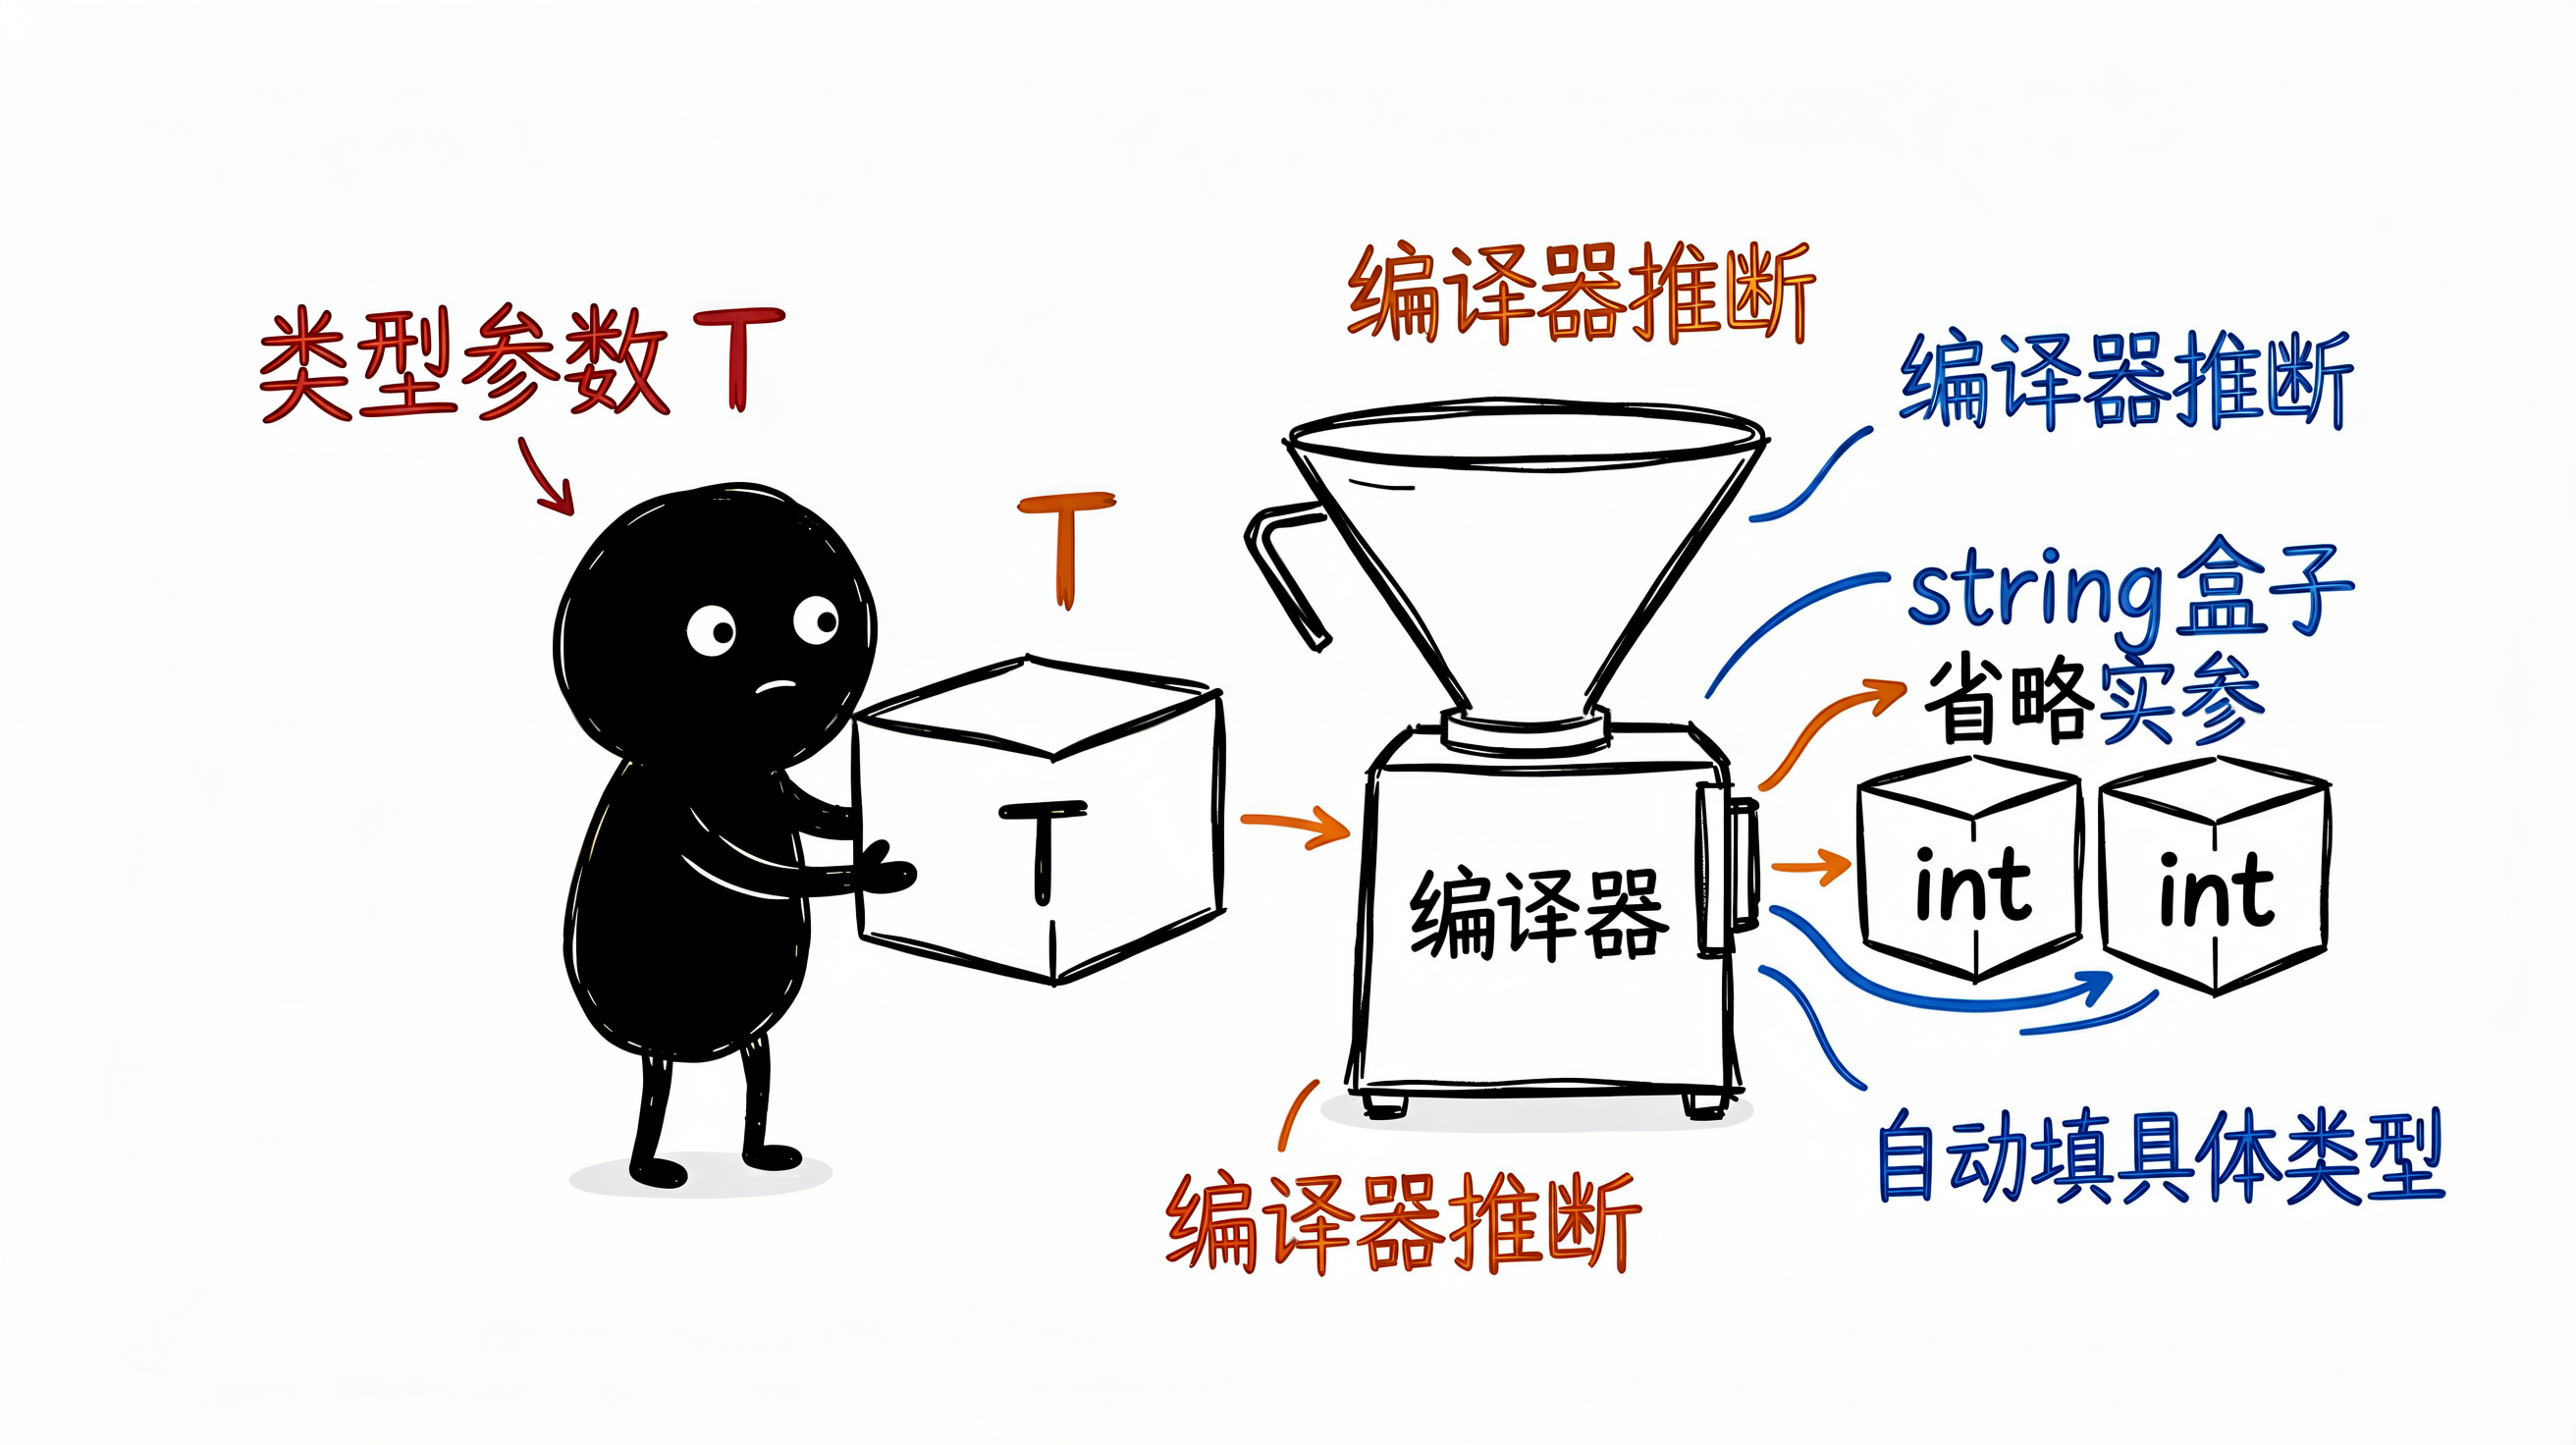
类型参数(type parameter) 是写在方括号里的占位类型,语法为 func F[T any](v T) T。其中 any 是 Go 1.18 引入的预声明标识符,等价于 interface{},表示"任意类型都可以"。
约束(constraints)写在类型参数后面的接口位置,用来限定 T 能接受哪些类型。下面这个例子展示了一个返回切片首元素的泛型函数,以及"类型推断"带来的调用便利:
go
package main

import "fmt"

// 类型参数 T 受 any 约束,可接收任意类型切片
func First[T any](s []T) (T, bool) {
    if len(s) == 0 {
        var zero T
        return zero, false
    }
    return s[0], true
}

func main() {
    head, ok := First([]string{"x", "y"})
    fmt.Println(head, ok) // 输出: x true
    // 类型推断:编译器从实参 []string 推出 T=string,无需写 First[string](...)
}
多数情况下你可以省略类型实参,编译器会自动从函数实参推导出 T。只有无法推导(如返回类型与入参无关)时才需要显式写出。官方分步教程也建议这条演进路径:非泛型 → 泛型函数 → 去掉类型实参 → 声明约束,循序渐进最不容易踩坑。
下表对照了"显式传参"与"依赖推断"两种调用方式:
| 场景 | 调用写法 | 是否需要显式类型实参 |
|---|---|---|
| 入参含 T | First([]int{1,2}) |
否,编译器自动推断 |
| 入参与 T 无关 | NewBox[int](10) |
是,需显式指定 |
| 多类型参数 | Pair[string, int]("a", 1) |
通常需显式指定 |
三、约束(constraints):泛型的"门禁"
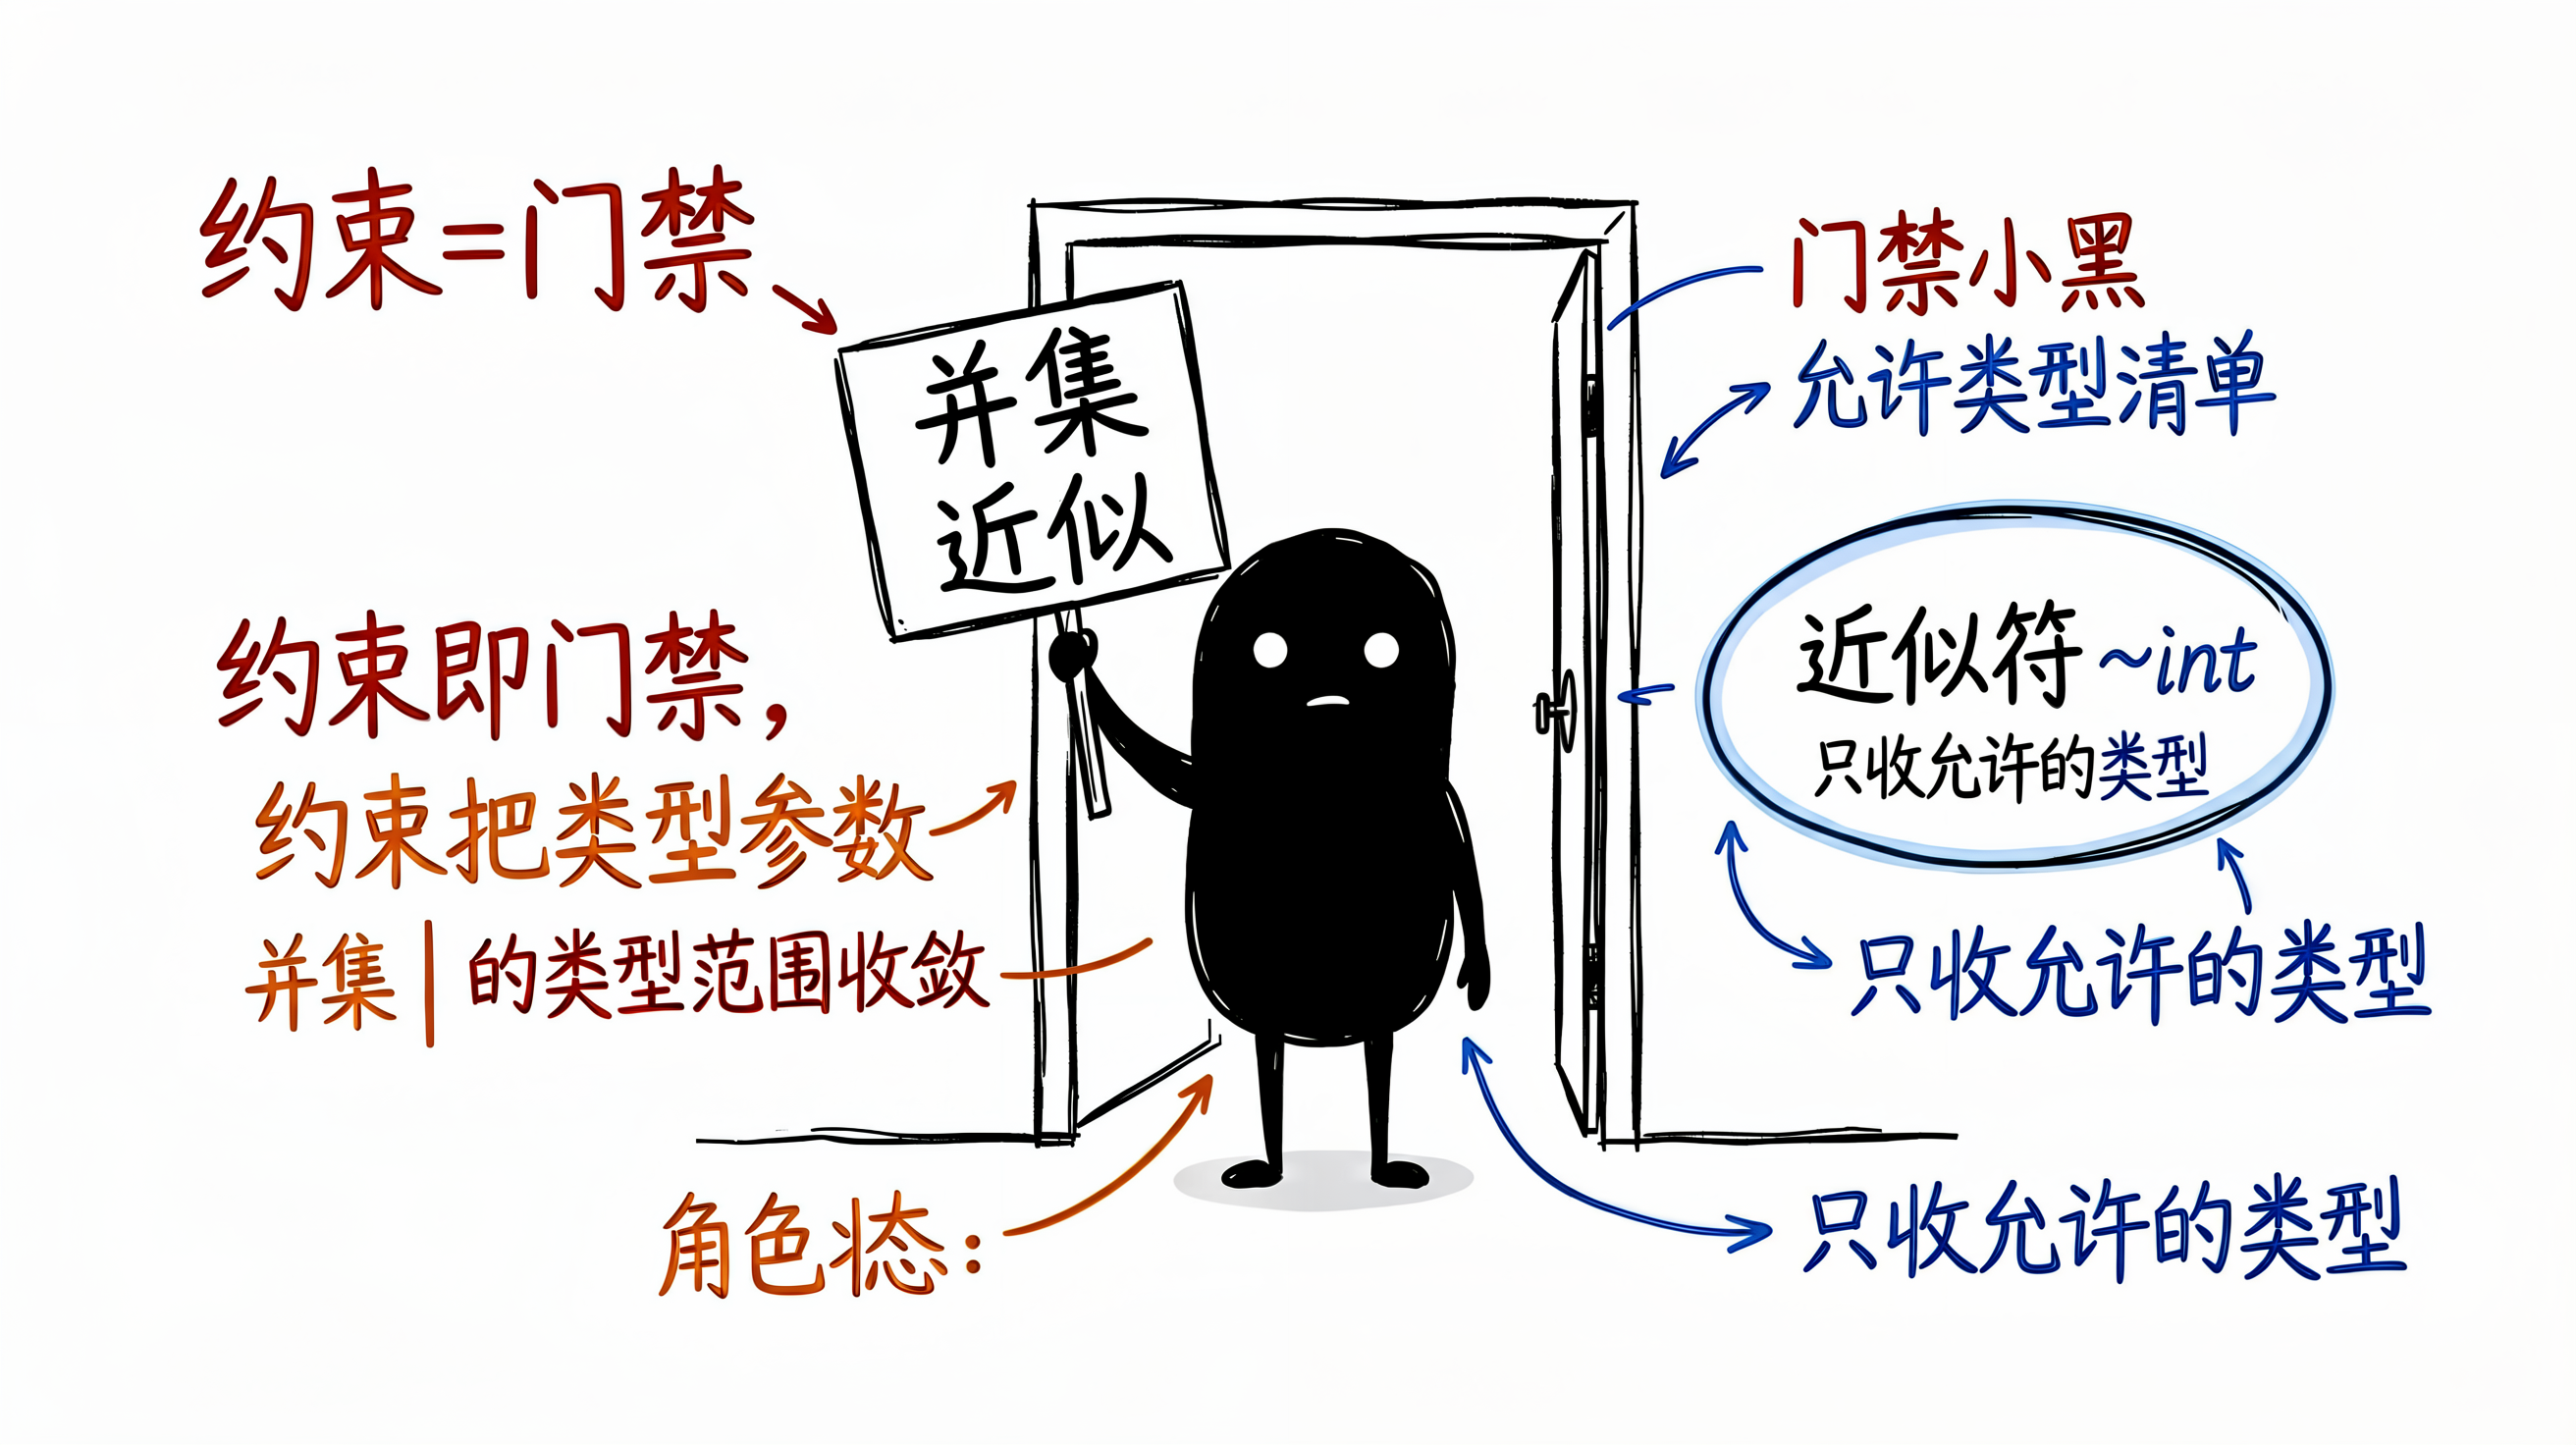
为什么约束必须是接口?因为 Go 把接口视作**"类型集合"**:接口不再只是方法集,还可以用并集、近似符显式描述"允许哪些类型"。约束就是把类型参数能接受的类型范围收敛起来。
并集(union) 用 | 表示"或",近似符(approximation) 用 ~T 表示"底层类型为 T 的所有类型"。例如你定义了一个 type MyInt int,它和原生 int 不是同一类型,但 ~int 能同时接纳二者。
go
package main

import "fmt"

// 自定义约束:允许底层类型为 int / int64 / float64 的类型
type Number interface {
    ~int | ~int64 | ~float64
}

// Add 只接受满足 Number 约束的类型,因而才能使用 + 运算符
func Add[T Number](a, b T) T {
    return a + b
}

type MyInt int

func main() {
    fmt.Println(Add(1, 2))         // 原生 int
    fmt.Println(Add(MyInt(1), MyInt(2))) // 自定义底层 int 类型也OK
}
约束最小化是一条重要原则:只把业务真正需要的类型收进来,避免一上来就写 any。过宽的约束既削弱了类型安全,也让函数能使用的运算变少(比如 any 上你连 + 都不能用)。
四、comparable 与 cmp.Ordered:别再误用旧 constraints.Ordered
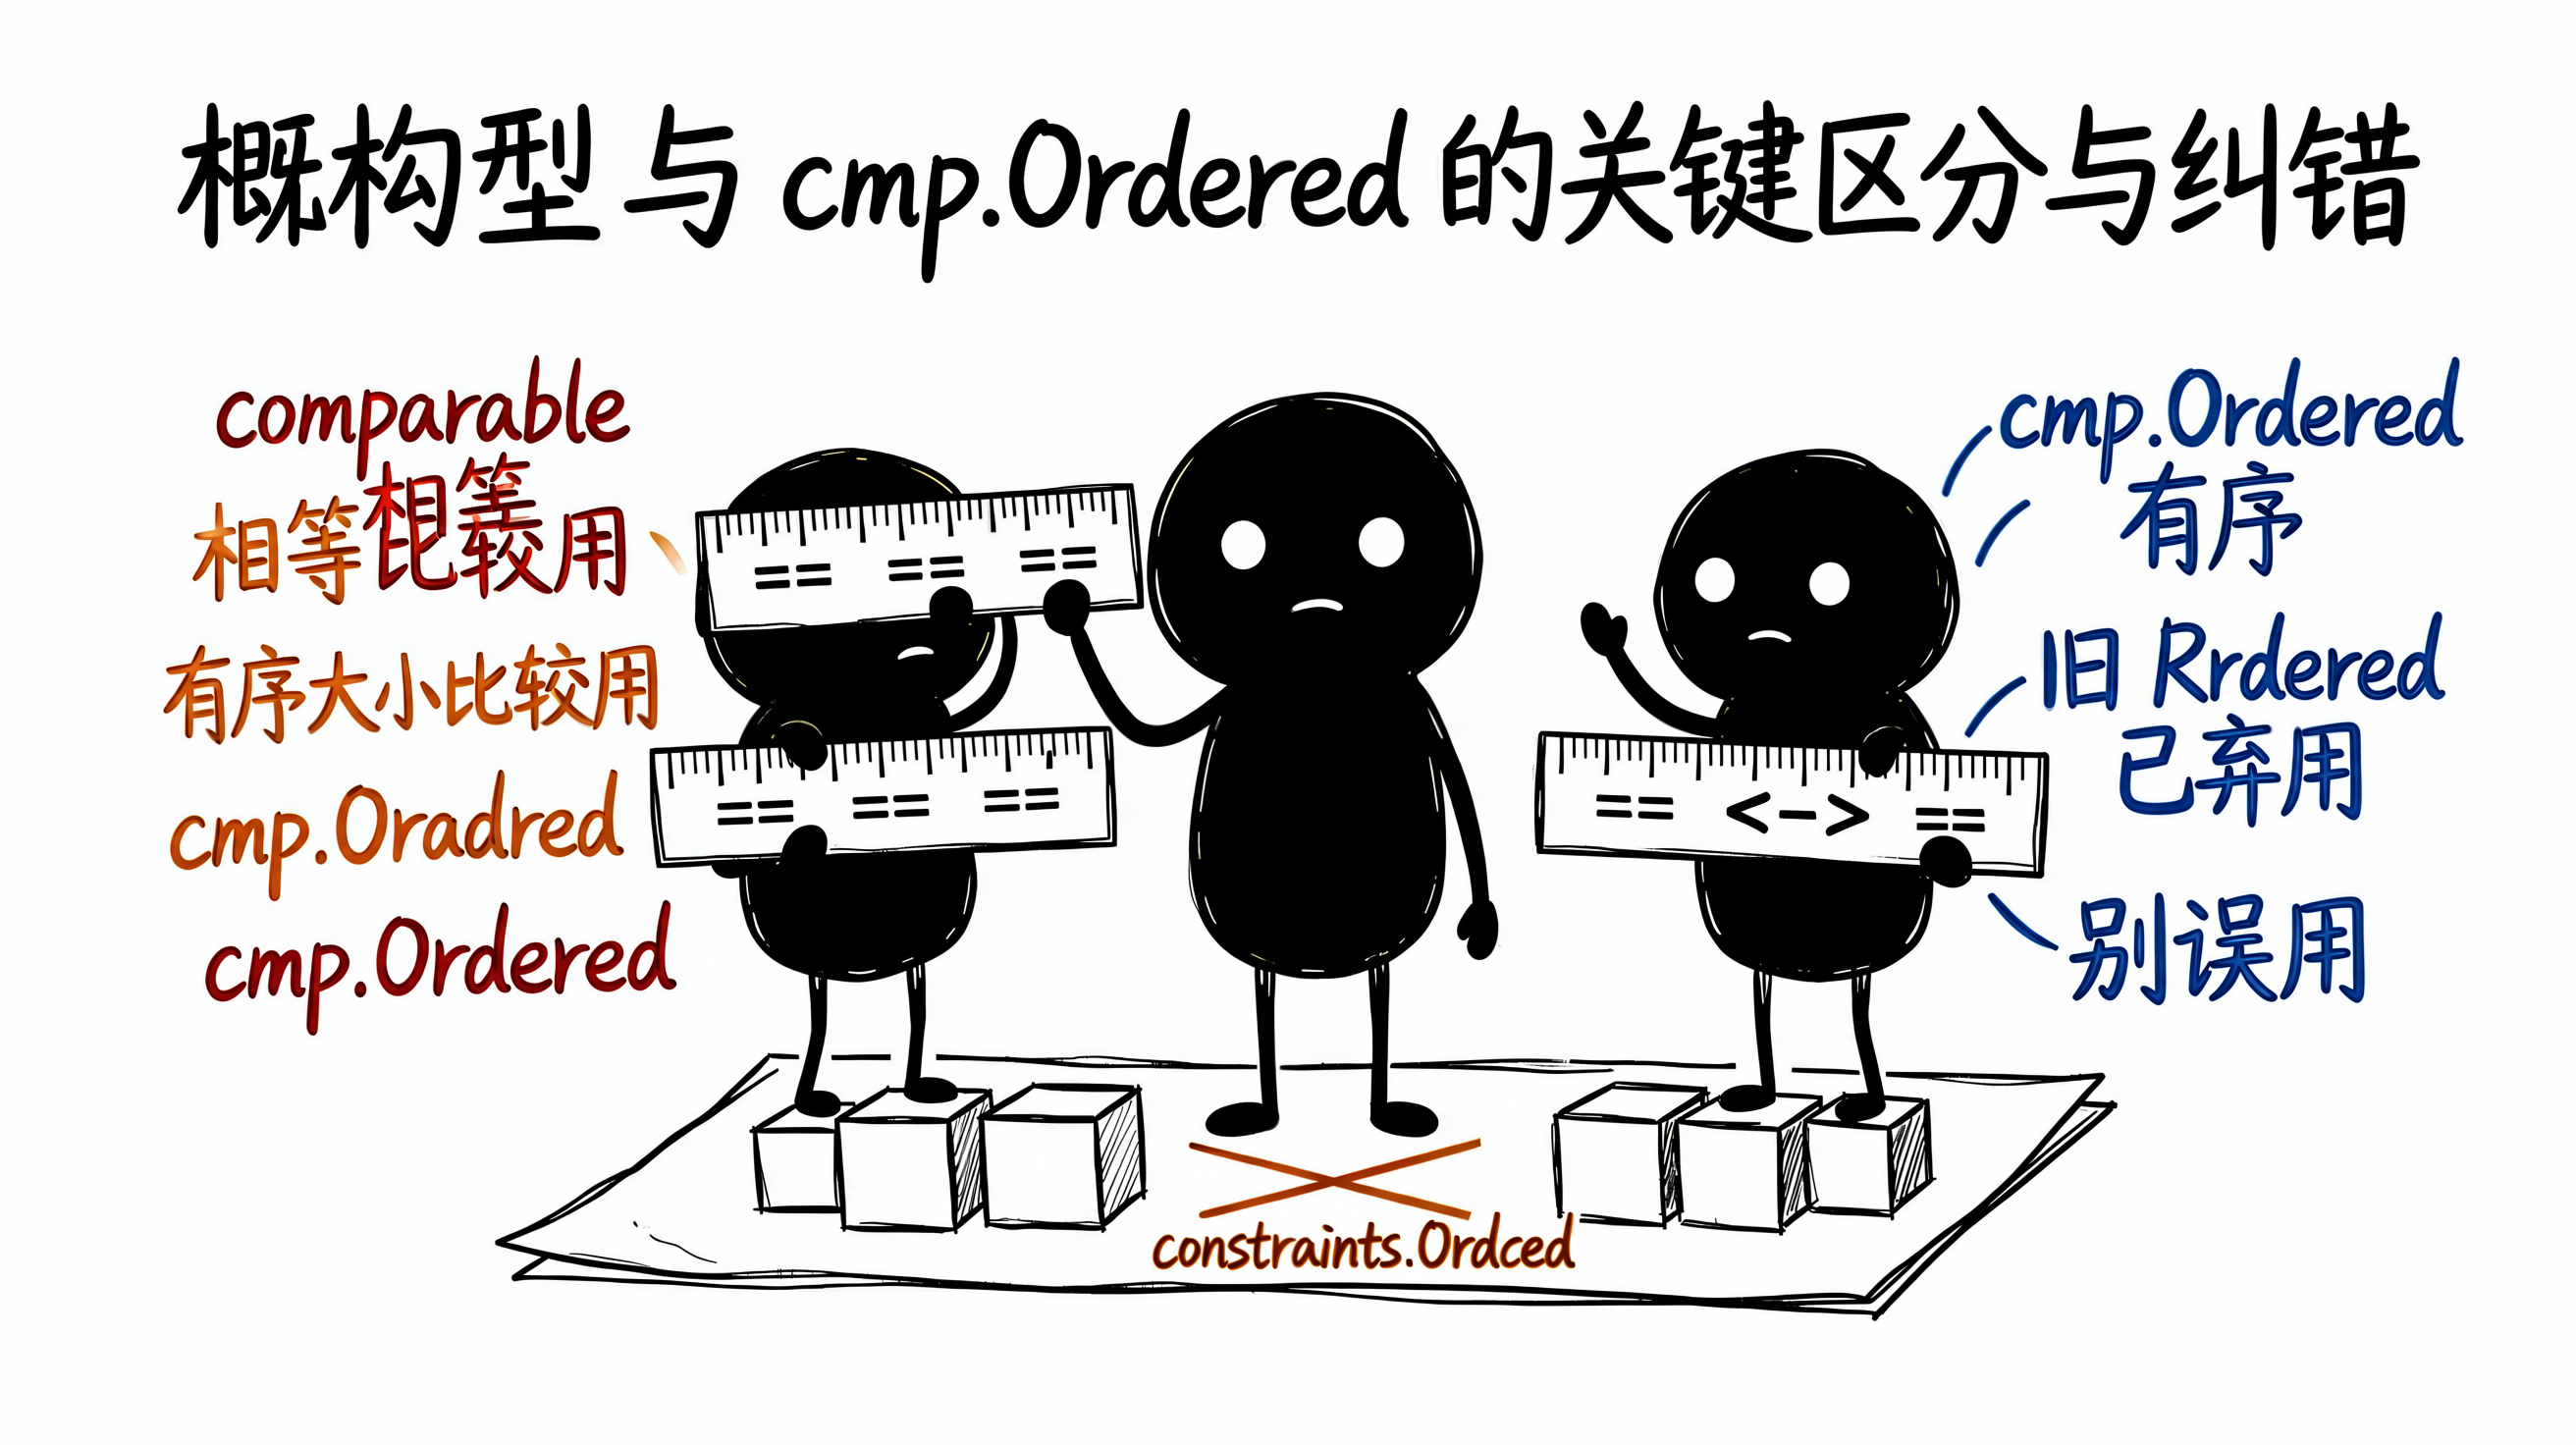
comparable 是 Go 1.18 预声明的约束,要求类型支持 == 与 !=。它常用于需要 map 键、查找、去重的场景。注意它只保证"相等可比较",并不保证能比大小。
cmp.Ordered 来自 Go 1.21 引入的标准库 cmp 包,约束那些支持 <、<=、>=、> 的有序类型,是当前做"大小比较"的推荐写法。
这里有个重要纠错:旧写法 golang.org/x/exp/constraints.Ordered 属于实验性扩展包,并非标准推荐。新项目请直接使用 cmp.Ordered ,不要再照搬旧文章里的 constraints.Ordered。
| 对比项 | comparable | cmp.Ordered |
|---|---|---|
| 来源版本 | Go 1.18 预声明 | Go 1.21 标准库 cmp 包 |
| 可用运算 | ==、!= |
<、<=、>=、> |
| 典型用途 | map 键、查找、去重 | 取最值、排序、二分 |
| 是否标准推荐 | 是 | 是(替代旧 constraints.Ordered) |
官方 cmp 包除了提供 Ordered 约束,还附带了 cmp.Compare、cmp.Less、cmp.Or 等泛型辅助函数。下面用 cmp.Ordered 实现一个通用 Max:
go
package main

import (
    "cmp"
    "fmt"
)

// Max 接受任意有序类型,返回较大者
func Max[T cmp.Ordered](a, b T) T {
    if cmp.Less(a, b) {
        return b
    }
    return a
}

func main() {
    fmt.Println(Max(3, 7))      // 7
    fmt.Println(Max("go", "go!")) // go!(按字典序)
}
与之相对,下面这个 IndexOf 只需要"相等比较",用 comparable 即可,不必升级到 cmp.Ordered:
go
package main

import "fmt"

// IndexOf 仅需 == ,用 comparable 约束即可
func IndexOf[T comparable](s []T, target T) int {
    for i, v := range s {
        if v == target {
            return i
        }
    }
    return -1
}

func main() {
    fmt.Println(IndexOf([]int{10, 20, 30}, 20)) // 1
}
五、实战一:可复用泛型容器------栈与队列
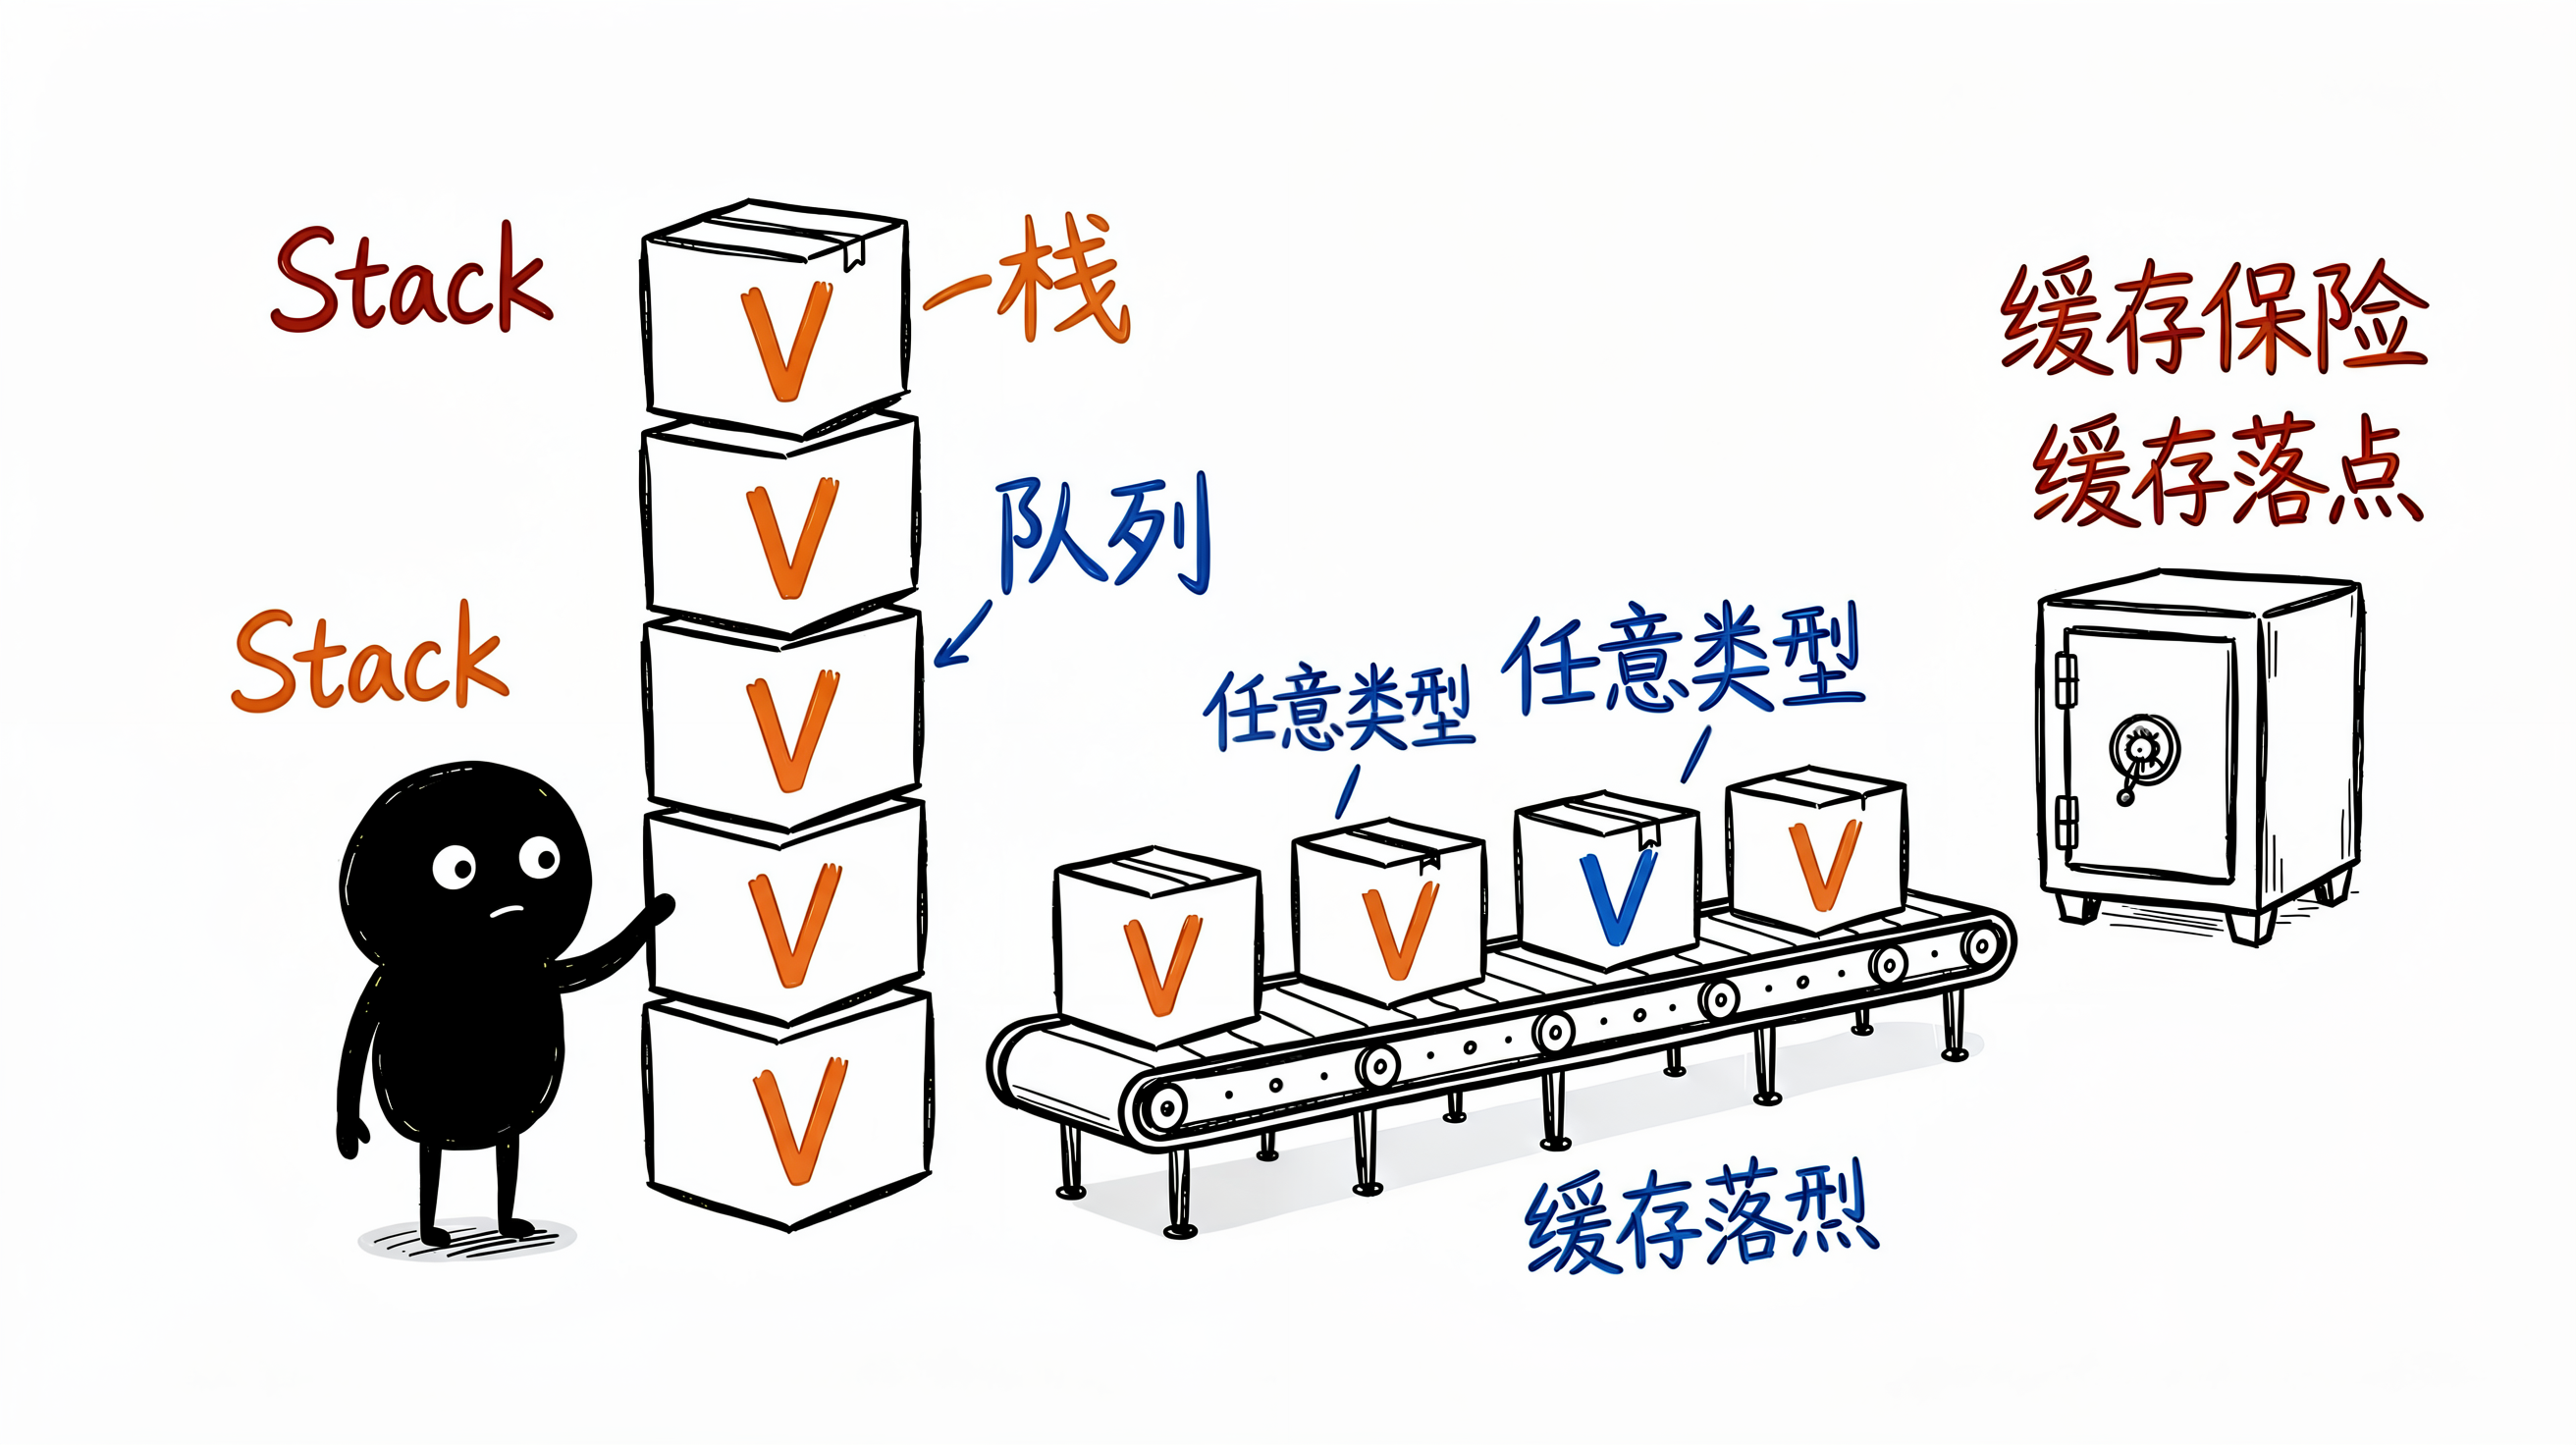
泛型最适合的落点之一,就是数据结构(容器) 。下面先实现一个泛型栈 Stack[T any],底层用切片承载,出栈返回 (T, bool) 以区分"空栈"与"零值元素"的歧义:
go
package main

import "fmt"

// Stack 泛型栈:用切片承载元素
type Stack[T any] struct {
    data []T
}

func (s *Stack[T]) Push(v T) {
    s.data = append(s.data, v)
}

// Pop 返回 (元素, 是否成功);空栈返回零值与 false
func (s *Stack[T]) Pop() (T, bool) {
    if len(s.data) == 0 {
        var zero T
        return zero, false
    }
    last := s.data[len(s.data)-1]
    s.data = s.data[:len(s.data)-1]
    return last, true
}

func (s *Stack[T]) Len() int {
    return len(s.data)
}

func main() {
    var st Stack[int]
    st.Push(1)
    st.Push(2)
    fmt.Println(st.Pop()) // 2 true
    fmt.Println(st.Len()) // 1
}
队列(Queue)则适合用切片加头指针的方式,避免每次出队都 copy 整段切片:
go
package main

import "fmt"

// Queue 泛型队列:head 记录队头偏移
type Queue[T any] struct {
    data []T
    head int
}

func (q *Queue[T]) Enqueue(v T) {
    q.data = append(q.data, v)
}

func (q *Queue[T]) Dequeue() (T, bool) {
    if q.head >= len(q.data) {
        var zero T
        return zero, false
    }
    v := q.data[q.head]
    q.head++
    return v, true
}

func (q *Queue[T]) Len() int {
    return len(q.data) - q.head
}

func main() {
    var q Queue[string]
    q.Enqueue("task-1")
    q.Enqueue("task-2")
    fmt.Println(q.Dequeue()) // task-1 true
}
实际应用场景 :在后端里,泛型栈可以当作 undo 操作栈、泛型队列可以当作并发 worker 的任务缓冲池。若多个 goroutine 同时访问,需额外用 sync.Mutex 包裹 Push/Pop 等方法,或用 atomic 保护头指针,避免数据竞争。
六、实战二:泛型工具函数 Map / Filter / Reduce
函数式风格的工具函数也是泛型的经典用武之地。下面给出 Map(映射)、Filter(过滤)、Reduce(归约)三件套:
go
package main

import "fmt"

// Map 把切片 A 经 f 映射为切片 B
func Map[A, B any](s []A, f func(A) B) []B {
    out := make([]B, len(s))
    for i, v := range s {
        out[i] = f(v)
    }
    return out
}

// Filter 按谓词保留元素
func Filter[T any](s []T, pred func(T) bool) []T {
    var out []T
    for _, v := range s {
        if pred(v) {
            out = append(out, v)
        }
    }
    return out
}

// Reduce 用初值 acc 与累加函数 f 归约出结果
func Reduce[T, R any](s []T, acc R, f func(R, T) R) R {
    for _, v := range s {
        acc = f(acc, v)
    }
    return acc
}

func main() {
    nums := []int{1, 2, 3, 4}
    doubled := Map(nums, func(x int) int { return x * 2 })
    evens := Filter(nums, func(x int) bool { return x%2 == 0 })
    sum := Reduce(nums, 0, func(a, x int) int { return a + x })
    fmt.Println(doubled, evens, sum) // [2 4 6 8] [2 4] 10
}不过在生产环境,手写这套并非最优。slices 与 maps 包本体随 Go 1.21 引入 ,里面有经过充分测试、性能更优的泛型实现;而 slices.Collect、slices.Values、maps.Keys、maps.Values、maps.Collect 这批迭代器辅助函数 则是随 Go 1.23 的 iter 包一同新增的。下表给出对照,建议新代码优先用标准库:
| 能力 | 手写泛型实现 | 标准库对应(版本) |
|---|---|---|
| 切片映射 | 上面的 Map |
slices 1.21 无内建 Map/Filter,直接用本文 Map;或基于 1.23 迭代器用 slices.Collect 收尾 |
| 切片过滤 | 上面的 Filter |
slices 1.21 无内建 Filter,直接用本文 Filter |
| 遍历 map 的键/值 | 自行遍历 | maps.Keys / maps.Values(Go 1.23,返回 iter.Seq) |
| 收集为切片/map | make + 遍历 |
slices.Collect / maps.Collect(Go 1.23,收尾迭代器) |
| 稳定性与性能 | 自行维护 | 官方维护,覆盖边界情况 |
易错点:
slices.Collect的真实签名是func Collect[E any](seq iter.Seq[E]) []E,它只接受一个iter.Seq[E]迭代器实参,再物化为切片。标准库没有slices.Map、slices.Filter或slices.Prefix这类函数------想"映射/过滤"切片时,用本文实战二的自写Map/Filter最直接;若要走迭代器路线,需用 Go 1.23 的for rangeover func 自行产出序列,再交给slices.Collect收尾。
七、实战三:泛型算法与可排序容器(进阶)
约束还能让算法"通用又可比较大小"。下面是一个依赖 cmp.Ordered 的泛型二分查找,它要求元素可比较,因此能直接用于 int、string 等有序类型:
go
package main

import (
    "cmp"
    "fmt"
)

// BinarySearch 在已升序切片中查找 target,返回下标与是否命中
func BinarySearch[T cmp.Ordered](s []T, target T) (int, bool) {
    lo, hi := 0, len(s)-1
    for lo <= hi {
        mid := (lo + hi) / 2
        switch {
        case cmp.Less(s[mid], target):
            lo = mid + 1
        case cmp.Less(target, s[mid]):
            hi = mid - 1
        default:
            return mid, true
        }
    }
    return -1, false
}

func main() {
    fmt.Println(BinarySearch([]int{1, 3, 5, 7, 9}, 5))  // 2 true
    fmt.Println(BinarySearch([]int{1, 3, 5, 7, 9}, 4))  // -1 false
}
需要优先队列时,可以用标准库 container/heap 适配一个泛型实现:Heap[T any] 持有一个切片,并接收一个比较函数 less func(a, b T) bool,从而把"顺序规则"从约束里解耦出来。这样既保留了泛型复用,又比"约束内建运算符"更灵活------代价是多传一个闭包。
取舍上:能用 cmp.Ordered 约束就优先用它,编译期内联后性能更好;当排序规则是动态的(如按多个字段),再退回到"传比较函数"的方案。
八、进阶:自引用约束与泛型接口
Go 的接口本身也可以带类型参数。借助自引用约束 ,你可以要求"类型能与自身同类比较",从而省掉类型断言样板。例如定义一个 Comparer[T any] 接口:
go
package main

import "fmt"

// Comparer 是带类型参数的泛型接口
type Comparer[T any] interface {
    CompareTo(other T) int
}

// 自引用约束:E 既要实现 Comparer,又必须和"自己这种类型"比较
type OrderedE[E Comparer[E]] interface {
    Comparer[E]
}

type Point struct{ X, Y int }

func (p Point) CompareTo(o Point) int {
    if p.X != o.X {
        return p.X - o.X
    }
    return p.Y - o.Y
}

// Nearest 找出离 base 最近的点,约束保证 o 与 base 同类型
func Nearest[E OrderedE[E]](base E, candidates []E) (E, bool) {
    if len(candidates) == 0 {
        var zero E
        return zero, false
    }
    best := candidates[0]
    for _, c := range candidates[1:] {
        if c.CompareTo(best) < 0 {
            best = c
        }
    }
    return best, true
}

func main() {
    base := Point{0, 0}
    pts := []Point{{1, 1}, {-1, 2}, {2, -3}}
    fmt.Println(Nearest(base, pts)) // {-1 2} true
}
这种"接口即类型集合 + 自引用"的组合,是 Go 泛型区别于其他语言泛型的关键设计,适合实现泛型二叉搜索树、可排序集合等需要元素互相比较的**数据结构(算法)**组件。
九、性能与最佳实践
性能真相先说结论:泛型是编译期静态展开 的,没有运行时类型断言、没有接口装箱,通常比 interface{} 方案更快,编译器还能内联。用 any 或 interface{} 包裹数值会触发堆分配与装箱,而 SumNumbers[int64] 这类专用展开不会。
几条可落地的最佳实践:
- 约束最小化:优先用内置
comparable,复杂场景再定义专属约束,避免随手写any。 - 何时不用泛型:当涉及的类型极少、且各类型逻辑差异很大时,普通代码反而更清晰,不必强行泛型化。
- 优先标准库:Go 1.21 引入的
slices/maps包已覆盖大量通用操作(其中的迭代器辅助函数slices.Collect/maps.Collect等随 Go 1.23 引入),生产代码直接用它们更稳。
一个典型后端落点------泛型缓存 Cache[K comparable, V any]:用 comparable 约束做键、泛型值类型存任意业务对象,既能做本地内存缓存,又能顺带保证键的相等比较在编译期就合法,比 map[string]interface{} 安全得多。
十、总结与行动清单
回顾主线:从"重复代码"出发,到"类型参数与类型推断",再到"约束设计",最后落地到可复用的容器(数据结构) 与算法(函数式工具) 。版本记忆点务必记牢:comparable(Go 1.18)做相等、cmp.Ordered(Go 1.21)做有序,旧的 constraints.Ordered 已不推荐。
约束速查:需要 ==/!= 用 comparable;需要 < 等大小比较用 cmp.Ordered;需要自定义类型集合用 interface{ ~T | ~U }。
建议立刻上手的三个小练习:第一,把团队里重复的 SumInts/SumFloats 类函数重构为泛型;第二,用 Stack[T]/Queue[T] 替换散落的 []interface{} 缓冲;第三,尝试用标准库 slices 改写手写的 Map/Filter。如果想看更多社区实战示例,可以参考这篇深入 Go 泛型编程:从基础到实战应用,它与本文的"容器+算法"主线高度互补。
参考资料
- Go 官方泛型入门教程:https://go.dev/doc/tutorial/generics
- Go 官方博客 --- An Introduction To Generics (Go 1.18):https://go.dev/blog/intro-generics
- Go 标准库 --- package cmp (Go 1.21+):https://go.dev/pkg/cmp/
- Go 官方博客 --- All your comparable types:https://go.dev/blog/comparable
- Go 官方博客 --- Generic interfaces:https://go.dev/blog/generic-interfaces
© 2026 | 转载请注明出处
结论:PASS