AI Agent 真正跨过"会回答"到"会办事"的那一步,往往不是再加一个提示词,而是给它一台可以持续运行、可以看见、也可以随时接管的电脑。
很多 Agent Demo 能打开网页、点击按钮,但一进入真实业务就会遇到新的边界:任务可能跨越浏览器、终端、文件管理器和桌面应用;登录状态需要保留;执行过程需要让人看见;关键操作还必须由人确认。
这时,一个"Agent 云主机"就有了意义。
什么是 Agent 云主机
可以把它理解成一台专门交给 AI 使用的远程电脑:
- 云端运行 Linux 桌面、Chrome、终端和业务应用;
- Agent 通过截图或结构化状态观察桌面;
- Agent 发送鼠标、键盘或命令行操作;
- 用户通过浏览器实时查看,并在必要时接管;
- 系统保存任务状态、操作记录和产物。
它不是"在服务器上跑一个大模型"这么简单,而是把模型、执行环境、远程桌面和会话生命周期组合成一个可控系统。
不过先说一个重要边界:如果任务只发生在网页里,并且 DOM 稳定,优先使用 Playwright 一类浏览器自动化。云桌面更适合必须操作桌面应用、保留完整系统环境、连续运行很久,或者需要人工接管的任务。
整体架构
最小架构可以画成这样:
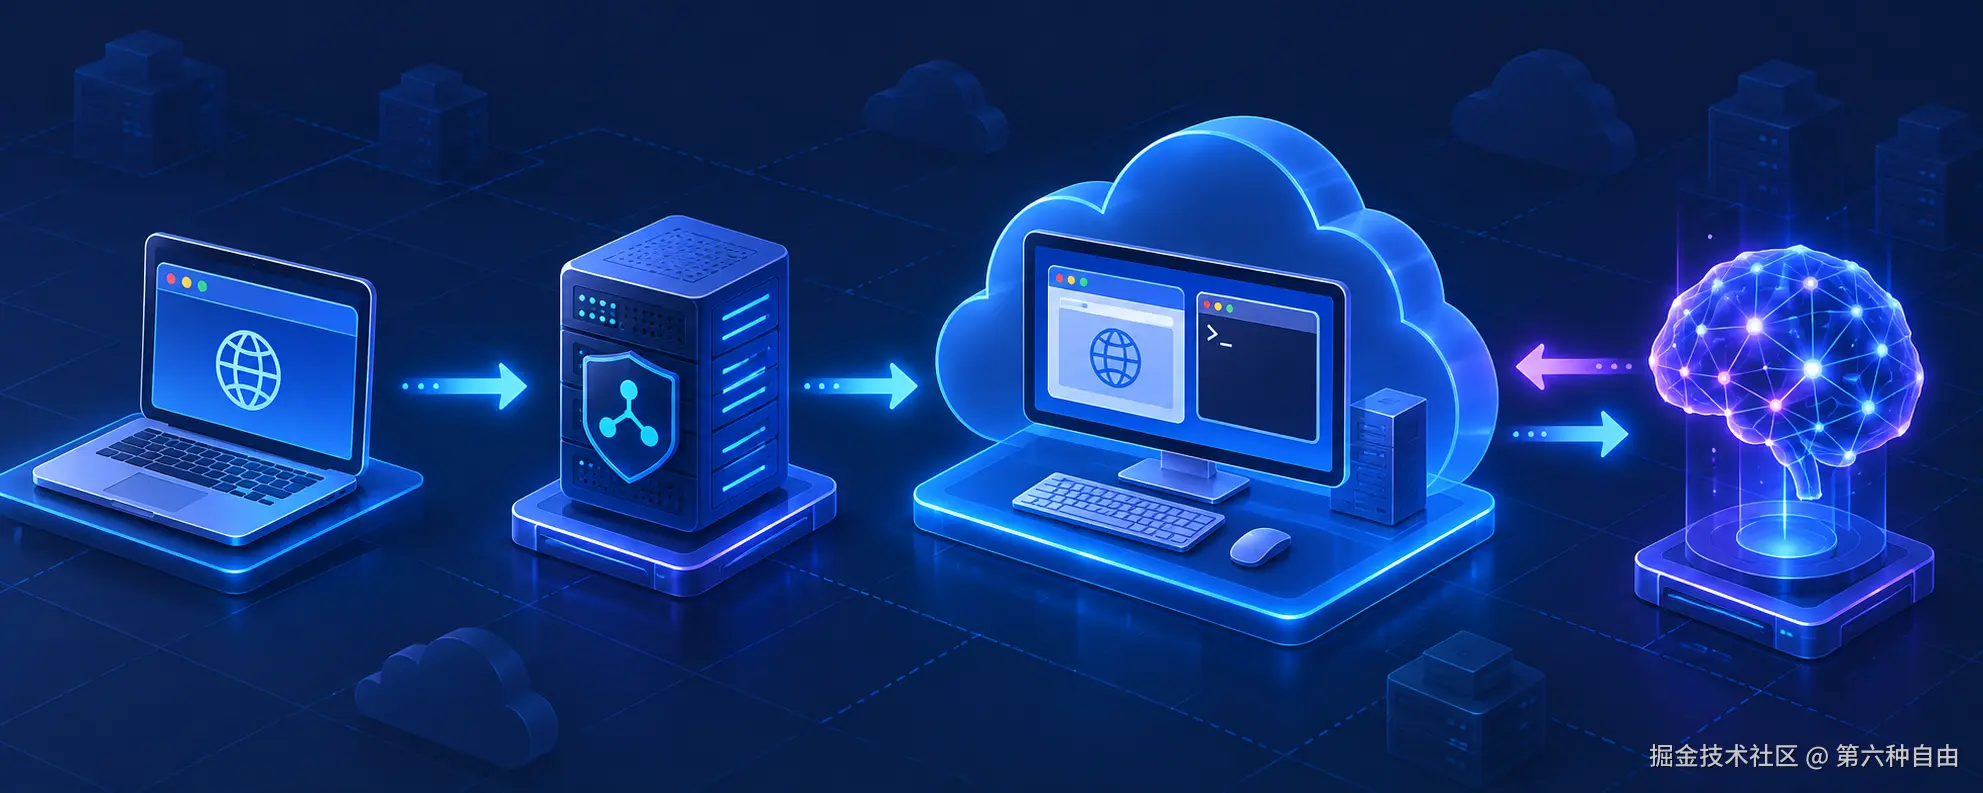
text
                  用户
                   │
             Web 控制台
                   │
                noVNC
                   │ WebSocket
              websockify
                   │ TCP
              VNC Server
                   │
        Linux Desktop / Chrome / App
                   ▲
                   │ 截图 + 鼠标键盘事件
             Agent Runtime
                   │
             LLM / Tools
这里有两个方向的数据流:
- 桌面画面从 VNC Server 传到 noVNC,最终绘制在浏览器 Canvas 中;
- 用户或 Agent 的鼠标、键盘事件反向发送到云端桌面。
noVNC 在里面负责什么
noVNC 是浏览器端的 VNC 客户端,不负责创建桌面,也不是 Agent 本身。它主要做四件事:
- 通过 WebSocket 接收远程桌面数据;
- 解析 RFB/VNC 协议;
- 将桌面内容绘制到 Canvas;
- 将鼠标和键盘事件传回 VNC Server。
浏览器不能直接连接传统 VNC 的 TCP 端口,所以通常还需要 websockify 做一层桥接:
text
浏览器 ── WebSocket ──> websockify ── TCP ──> VNC Server这套链路解决的是"人如何在网页里看到并控制远程桌面"。至于 Agent 如何思考、何时点击、任务如何恢复,需要由上层运行时负责。
Agent 的控制循环
一个最小 Agent 不需要复杂框架,核心就是"观察---决策---执行---校验"循环:
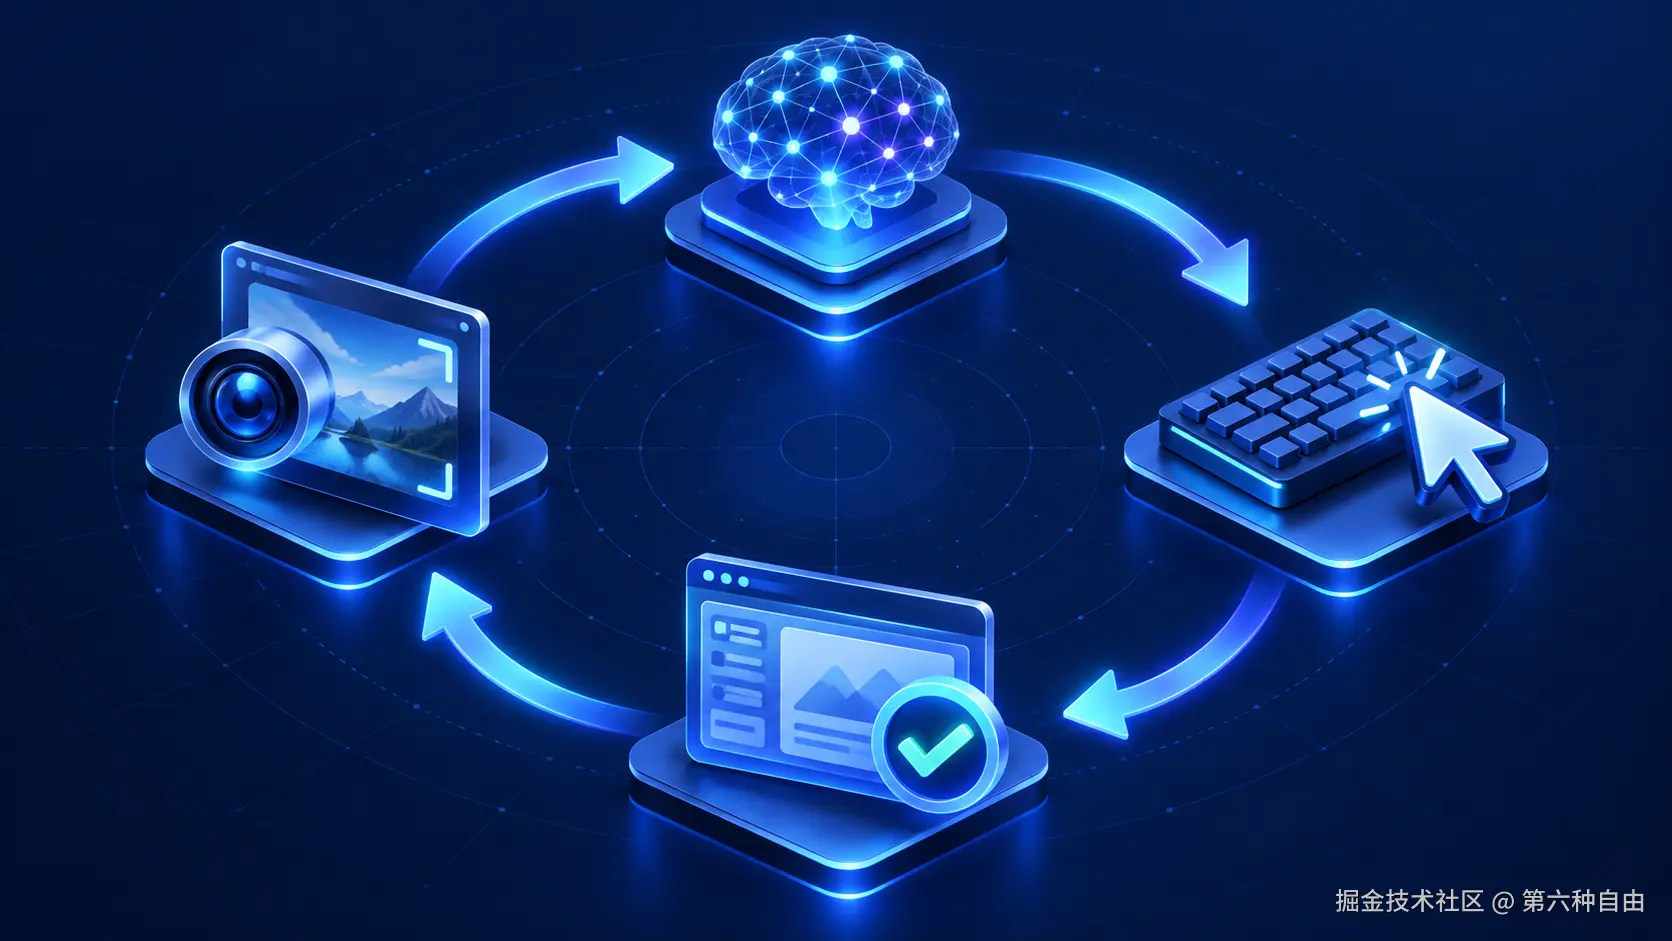
python
async def run_task(session, goal):
    while not session.finished:
        frame = await session.desktop.screenshot()
        context = await session.recent_events()

        action = await model.plan(
            goal=goal,
            screenshot=frame,
            context=context,
        )

        if action.requires_confirmation:
            await session.pause_for_user(action)
            continue

        await session.desktop.execute(action)
        await session.record(action)

        if await session.is_goal_reached():
            session.finished = True
动作协议也可以保持简单:
json
{
  "type": "click",
  "x": 816,
  "y": 492,
  "reason": "打开搜索结果"
}
常见动作只需要覆盖:
click(x, y)type(text)key(name)scroll(delta)wait(ms)shell(command)finish(result)
真正重要的不是动作种类多,而是每次执行后重新观察,确认界面是否真的发生了预期变化。
会话管理:让任务可以持续运行
云主机与一次性脚本最大的区别,是它有会话生命周期。最少需要下面几个状态:
text
CREATING → READY → RUNNING → PAUSED → FINISHED
                         └──────→ FAILED
一个会话通常包含:
python
class AgentSession:
    id: str
    goal: str
    status: str
    desktop_id: str
    owner: str
    created_at: datetime
    last_active_at: datetime
    result: dict | None
创建任务时,系统启动隔离环境和桌面服务;运行中持续写入事件;完成后保存产物;空闲超时则回收机器。这样 Agent 才能离开用户电脑继续工作,又不会让云资源无限占用。
必须设计"人工接管"
Agent 操作桌面时,人和 Agent 不能同时争夺鼠标。最简单的做法是维护一个控制权状态:
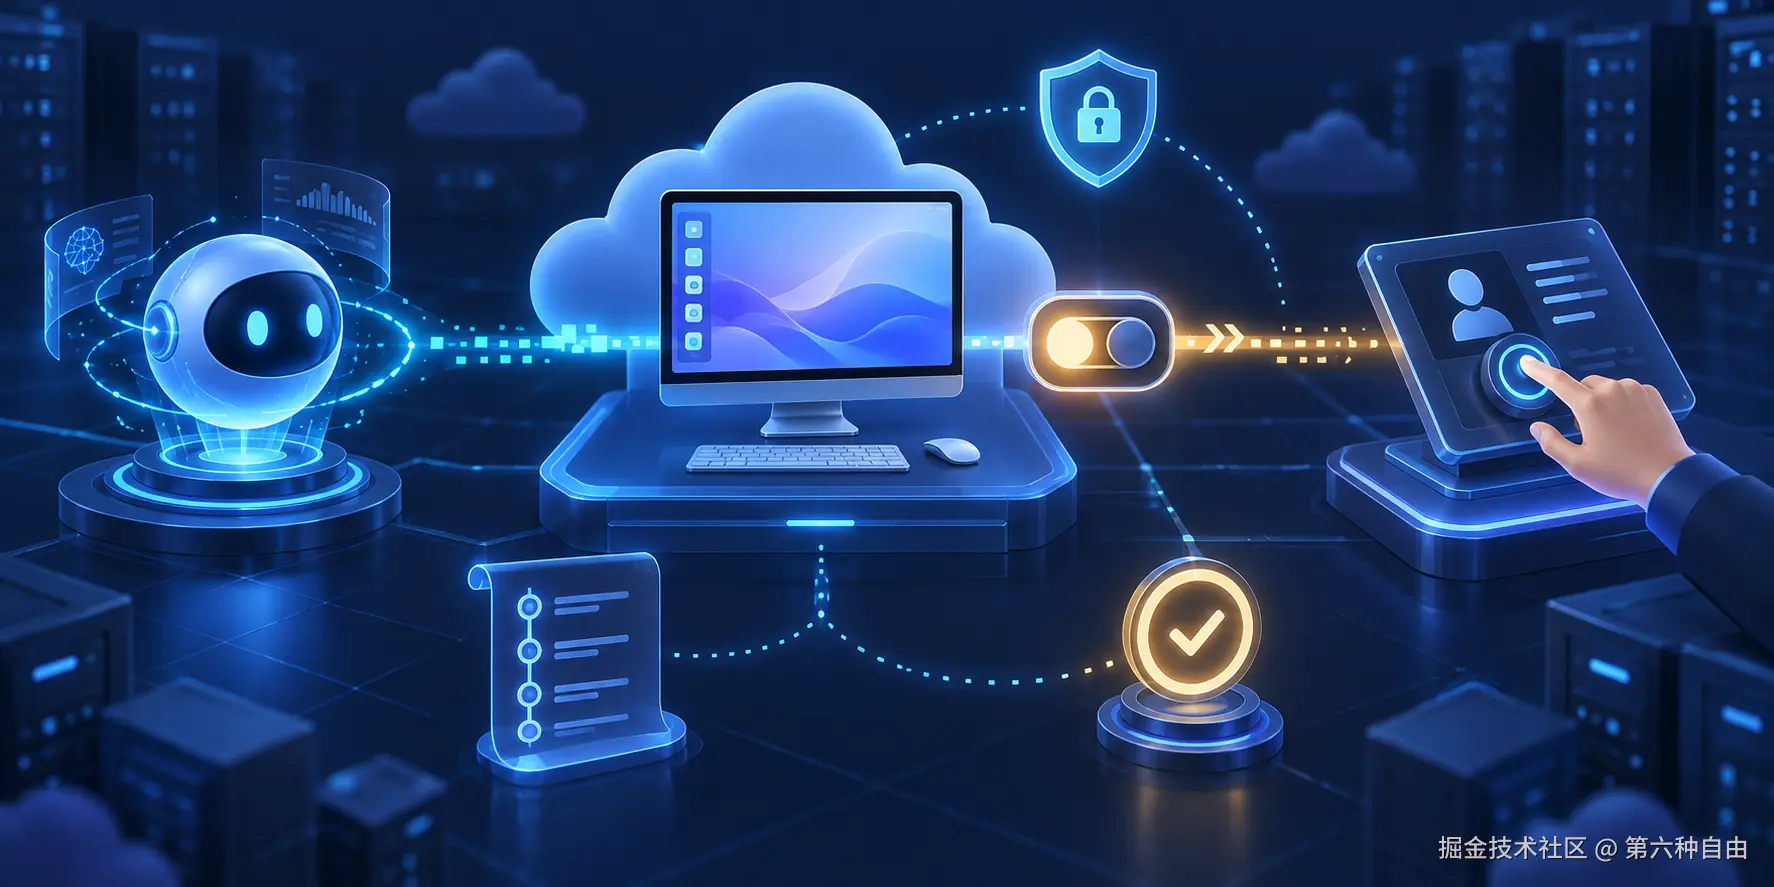
text
controller = agent | human用户点击"接管"后:
- 暂停 Agent 循环;
- 等待当前动作结束;
- 将输入控制权切换给用户;
- 用户完成登录、验证码或关键确认;
- 再把控制权交还给 Agent。
这比让 Agent 处理所有环节更可靠。验证码、支付、发送消息、删除数据等高风险动作,本来就应该停下来由人确认。
最小可用版本怎么做
如果只是验证方案,不需要一开始就做调度平台、容器编排或多 Agent 系统。一个能工作的 MVP 只需要:
- 一台 Linux 云主机;
- 一个轻量桌面环境和 VNC Server;
- noVNC + websockify;
- 一个创建/停止会话的 HTTP API;
- 一个 Agent 进程,负责截图、规划和输入;
- 一个浏览器控制台,用于观看、暂停和接管。
伪代码如下:
python
class AgentHost:
    async def create_session(self, goal):
        desktop = await start_desktop()
        vnc = await start_vnc(desktop)
        proxy = await start_websockify(vnc.port)

        session = AgentSession(
            goal=goal,
            status="READY",
            desktop_id=desktop.id,
        )

        asyncio.create_task(run_task(session, goal))
        return {
            "session_id": session.id,
            "viewer_url": proxy.viewer_url,
        }
第一版甚至可以固定一台机器、一次只运行一个任务。等真实任务证明并发、恢复和成本控制确实是问题,再引入容器池、队列和自动扩缩容。
生产环境最容易踩的坑
1. 只看截图,成本和延迟都很高
截图适合通用桌面,但每一步都把整张图交给模型会很慢。浏览器任务最好同时提供 DOM、可访问性树或应用内部状态,让 Agent 优先使用结构化信息,截图负责兜底。
2. 坐标会漂移
窗口大小、缩放、弹窗和网络延迟都会让固定坐标失效。每次动作后都要重新观察;能按元素定位时,不要只记坐标。
3. 会话隔离不足
不同用户的 Cookie、下载文件和剪贴板不能混用。至少要做到独立工作目录、独立浏览器配置、独立凭证注入和任务结束清理。
4. 凭证进入模型上下文
密码、Token 和 Cookie 不应该出现在提示词或日志里。更安全的方式是由宿主系统短暂注入,Agent 只获得"已完成登录"或"凭证可用"的结果。
5. 缺少可审计记录
只保存最终截图不够。建议记录动作、时间、页面地址、关键截图、执行结果和人工确认点,这些信息既用于排错,也用于责任边界。
云桌面与浏览器自动化如何选择
可以用一个很简单的判断:
- 只操作网页、追求稳定和速度:浏览器自动化;
- 需要桌面应用、系统环境或人工接管:Agent 云主机;
- 两者都有:结构化工具优先,云桌面兜底。
最实用的系统通常不是"纯视觉 Agent",而是把浏览器 API、命令行和桌面控制放在同一个运行时里。模型选择成本最低、成功率最高的工具,只有没有结构化接口时才去"看屏幕、点鼠标"。
结语
Agent 云主机的核心并不神秘:一台隔离的远程电脑、一条可视化控制链路、一个持续运行的 Agent 循环,再加上人工接管和审计。
noVNC 很适合承担"看见并控制桌面"这一层,但它只是基础设施的一部分。真正决定系统能否落地的,是会话生命周期、工具选择、失败恢复、安全边界,以及关键动作前能不能稳稳地停下来等人确认。
如果从零开始,我会先做一个单机、单会话的版本,让 Agent 完成一条真实任务链路。跑通之后,再谈并发、调度和规模化。