第 11 篇:实践三 ------ 表单 / 合同字段抽取
源码定位
- 服务:
com.example.llm.service.ExtractService- DTO:
com.example.llm.dto.biz.ExtractDtos- 提示词:
com.example.llm.prompt.Prompts#EXTRACT_SYSTEM- 接口:
POST /ai/extract- 高风险字段:
ExtractService#HIGH_RISK_FIELDS = ["amount", "signDate"]
一、这类场景和分类有什么不同
字段抽取做的事,是把一段非结构化文本变成一行数据库记录 ------ 合同、发票、简历、病历、快递单都是这个套路。
它和上一篇的分类有一个关键差别:
分类是从封闭集合里选一个,选错了最多是分错类,后面还能改;抽取是从开放文本里生成内容,抽错了可能是把 12.8 万写成 128 万,这是要赔钱的。
所以做这类场景时,我在代码里贯彻一条底线:
模型的输出,当成「来自不可信第三方的输入」来处理。
这一篇的重点不是「怎么让模型抽得更准」,而是「模型抽错了,系统怎么兜住」。抽得准是模型的事,兜得住才是工程的事。
二、目标
- 用 Schema 约束输出结构,缺失字段返回
null,而不是空串或猜测值; - 三道关卡依次把关:结构校验 → 业务后处理 → 一致性校验;
- 高风险字段(金额、日期)一律送进人工复核队列;
- 交叉校验:模型给的金额必须能在原文里找到出处,找不到就高度怀疑是编造;
- 服务不可用时,返回「空对象 + 全字段待复核」。
三、前置
- 第 05 篇结构化输出;
- 第 08 篇容错降级。
四、两个绕不开的概念
4.1 null 是有业务含义的
java
/**
 * 注意这里全部使用包装类型:null 是有业务含义的,
 * 表示「原文里确实没有这个字段」,而 0 或空字符串会掩盖这个事实。
 */
private BigDecimal amount;
private String signDate;
如果用 double amount 这种原始类型,缺失时字段值就是 0,下游拿到 0 会以为「合同金额是 0 元」,而不是「没抽到金额」。「缺失」和「是零」是两回事,用包装类型加 null 才能区分开。
4.2 三道关卡
   模型输出
      │
      ▼
 ┌─────────────────┐
 │ ① 结构校验       │  Jackson 反序列化:字段名/类型对不对
 └────────┬────────┘
          ▼
 ┌─────────────────┐
 │ ② 业务后处理     │  数值归一(万元→元)、日期归一(yyyy-MM-dd)
 └────────┬────────┘
          ▼
 ┌─────────────────┐
 │ ③ 一致性校验     │  金额能否在原文定位、甲乙是否同名、日期是否合法
 └────────┬────────┘
          ▼
   结果 + needReview 标记
这三道关卡的分工是:能被业务规则拦住的错误,就别指望模型自己不犯。
五、代码实操
5.1 提示词:把「不许编造」写死
java
public static final String EXTRACT_SYSTEM = """
        你是一名合同信息抽取助手。
        要求:
        1. 只从用户提供的原文中抽取字段,禁止推理、禁止编造;
        2. 原文中找不到的字段必须返回 null,不要用空字符串或猜测量代替;
        3. amount 只输出数字(单位:元),不要带货币符号和千分位;
        4. signDate 统一格式为 yyyy-MM-dd;
        5. 必须只返回一个 JSON 对象,不要输出 Markdown 代码块,不要输出任何解释性文字。

        输出 JSON 结构:
        {"contractNo": null, "partyA": null, "partyB": null, "amount": null, "currency": null, "signDate": null}
        """;
输出结构示例里,所有字段都写成 null,这是故意的。它等于在告诉模型:null 是合法且被接受的输出。如果你在示例里放一个 "HT-2026-001",模型往往会顺着这个格式「也编一个类似的」来迎合你。
5.2 后处理:逐字段校验
java
private ExtractDtos.Result postProcess(ExtractDtos.Result result, String source) {
    List<String> needReview = new ArrayList<>();

    // 1) 金额:负数、异常大的值都要拦下来
    if (result.getAmount() != null && result.getAmount().compareTo(BigDecimal.ZERO) <= 0) {
        log.warn("模型返回了非正数金额 {},已置空", result.getAmount());
        result.setAmount(null);
    }
    if (result.getAmount() == null) {
        needReview.add("amount");
    } else if (!amountMatchesSource(result.getAmount(), source)) {
        // 模型给的金额在原文里找不到对应数字 ------ 高度怀疑是编造的
        log.warn("模型返回的金额 {} 无法在原文中定位,标记待复核", result.getAmount());
        needReview.add("amount");
    }
    ...
}
金额这一块的处理分三层:非法值(比如负数)直接置空,这是硬错误;缺失就进复核;如果金额在原文里定位不到,同样进复核。第三层见下一节。
5.3 交叉校验:金额必须能在原文找到出处
java
private boolean amountMatchesSource(BigDecimal amount, String source) {
    if (source == null || source.isBlank()) {
        return false;
    }
    String digits = amount.stripTrailingZeros().toPlainString().replace(".0", "");
    if (source.replace(",", "").contains(digits)) {
        return true;
    }
    // 万元换算:128000 元对应原文里的 12.8 万
    BigDecimal inWan = amount.divide(new BigDecimal("10000"), 4, RoundingMode.HALF_UP)
            .stripTrailingZeros();
    if (source.contains(inWan.toPlainString())) {
        return true;
    }
    Matcher matcher = AMOUNT_IN_TEXT.matcher(source);
    return matcher.find();
}
这段是我认为本篇最有价值的部分,思路其实很朴素:模型说「金额是 128000」,那原文里就应该能找到 128000,或者 128,000,或者 12.8 万。三种都找不到,这个数字十有八九是编的。
java
private static final Pattern AMOUNT_IN_TEXT = Pattern.compile(
        "(?:合同金额|合同总价|总金额|金额|价款|总价)[^0-9]{0,8}([0-9][0-9,]*)(\\.[0-9]+)?\\s*(万元|元)");
兜底这条正则放得更宽:只要原文里有「金额 / 总价 / 价款」这类词,后面跟着数字和单位,就认为存在一个可对账的金额。
5.4 日期归一
java
private String normalizeDate(String raw) {
    String s = raw.trim()
            .replace("年", "-").replace("月", "-").replace("日", "")
            .replace("/", "-").replace(".", "-");
    String[] parts = s.split("-");
    if (parts.length != 3) {
        return null;
    }
    try {
        int year = Integer.parseInt(parts[0].trim());
        int month = Integer.parseInt(parts[1].trim());
        int day = Integer.parseInt(parts[2].trim());
        if (year < 1900 || year > 2999 || month < 1 || month > 12 || day < 1 || day > 31) {
            return null;
        }
        return String.format("%04d-%02d-%02d", year, month, day);
    } catch (NumberFormatException e) {
        return null;
    }
}
模型可能返回 2026年9月12日、2026/9/12、2026.9.12,这里统一归一成 2026-09-12。范围校验不能省,否则模型会抽出 13 月 45 日 这种值,格式上「像」个日期,但完全非法。归一失败就进复核,不猜。
生产环境更稳的做法是用
DateTimeFormatter配多个parseBest模式,这里手写字符串替换是为了教学时让逻辑一眼看清。
5.5 一致性校验与强制复核
java
// 4) 甲乙双方同名,几乎一定是抽取错误
if (result.getPartyA() != null && result.getPartyA().equals(result.getPartyB())) {
    needReview.add("partyA");
    needReview.add("partyB");
}

// 5) 高风险字段一律进人工复核队列
for (String field : HIGH_RISK_FIELDS) {
    if (!needReview.contains(field)) {
        needReview.add(field);
    }
}
最后这一步是本篇我最想强调的地方:
凡是金额、日期这类「错了要赔钱」的字段,一律标记
needReview,强制进入人工复核队列。
哪怕它已经通过了前面所有校验,也还是得有人看一眼。这不代表不信任模型,而是按风险分级来设计系统。一个系统成熟与否,往往就看它清不清楚「哪些环节不能全自动」。
5.6 降级
java
private ExtractDtos.Result fallback(AiException e) {
    ExtractDtos.Result result = new ExtractDtos.Result();
    result.setNeedReview(List.of("contractNo", "partyA", "partyB", "amount", "signDate"));
    result.setDegraded(true);
    log.info("返回降级空结构,错误码={}", e.getErrorCode().getCode());
    return result;
}
降级返回的是全空加全字段待复核,语义很直接:「服务挂了,我什么都没抽出来,请全部人工填」。这比抛一个 500 让前端直接崩掉要好。
六、验证
$ curl -X POST http://127.0.0.1:8080/ai/extract -d '{"text":"合同编号:HT-2026-0912,甲方:浙江示例科技有限公司..."}'
HTTP 200
{
  "code": 0,
  "message": "成功",
  "traceId": "0af2b5b266704a14",
  "data": {
    "contractNo": "HT-2026-0912",
    "partyA": "浙江示例科技有限公司",
    "partyB": "杭州演示信息技术有限公司",
    "amount": 128000,
    "currency": "CNY",
    "signDate": "2026-09-12",
    "needReview": ["amount", "signDate"],
    "degraded": false
  }
}
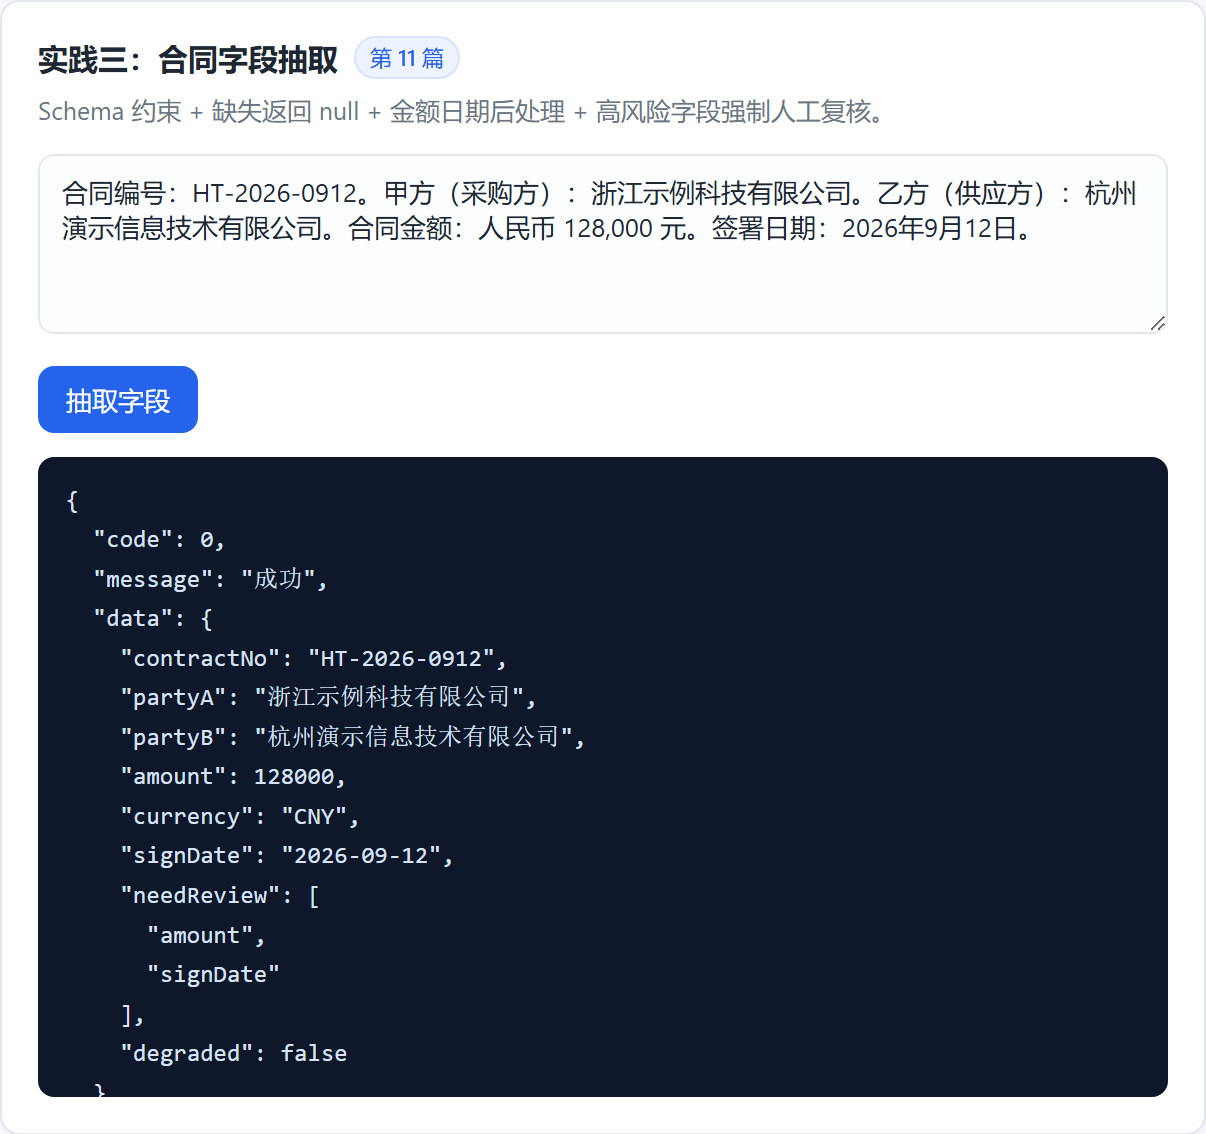
注意 amount 和 signDate 这两个字段:抽对了、格式也对,照样出现在 needReview 里。这不是 bug,正是设计意图 ------ 高风险字段即便抽对,也还是要人来确认一遍。
如果把原文里的金额故意去掉,就会看到 amount: null,同时 needReview 里带着 "amount"。
演示页实拍(needReview 里强制包含了 amount 与 signDate):
七、几个容易踩的坑
坑 1:用 double/long 承载可能缺失的数值。
null 被变成 0 之后,下游就分不清「金额是 0」和「没抽到金额」了。
坑 2:只校验格式,不校验存在性。
模型返回的 128000 格式完全合法,但原文里根本没这个数字。这种纯编造只能靠「能否在原文定位」把它揪出来。
坑 3:金额单位不统一。
原文写「12.8 万元」,模型可能返回 12.8 却不带单位,也可能返回 128000 而你的系统当成万元。提示词里要写清「单位:元」,后处理里还要做万元换算。
坑 4:日期不做范围校验。
2026-13-45 这种值就是从这里漏出去的。归一失败要进复核,不能猜。
坑 5:高风险字段全自动。
金额、日期、身份证号、银行账号这类字段,错了要赔钱。设计上得留一个人工复核的出口,宁可多一步人工,也别上一个会出错的自动化。
坑 6:把 needReview 当成 degraded。
这两者含义不同:needReview 是字段需要人看,degraded 是服务挂了。它们互相独立,别混用。
八、小结与下一篇
字段抽取给出一条通用原则:AI 的输出是「建议」,不是「事实」。服务端的职责,是把这个「建议」经过校验、归一、交叉验证,变成「可入库的事实」,拿不准的交给人工。
下一篇是四个实践里唯一一个不能全自动的场景 ------ 工单回复建议。它的输出要直接发给客户,风险不一样。我们看怎么用「知识片段 + 强制人工审核」来管理这种对外的输出。