昨天刚发完文章,网站流量突然就增长了好几倍,而且一直持续到了现在,这效果简直无敌。
但是细看了一下,数据明显不正常,不像真实的人类行为。
我只能看出不正常,这看起来很像爬虫行为,但背后的抓取逻辑是什么,是谁在抓,抓去干嘛用的,我是完全没有思路!
所以我又来了一次实战测试,让 Codex+GPT-5.6 Sol 对真实的流量数据进行分析,探索流量异常的本质。
最后发现好像问题不大!
基本确定不是真人,但是无恶意!
下面我就来和大家分享一下真实的数据分析过程。现在还在搞网站或者想搞网站的可以关注一下,实践数据非常宝贵。
我都是边干边学!
1、人工分析
首先来看一下 GA4 的统计数据:
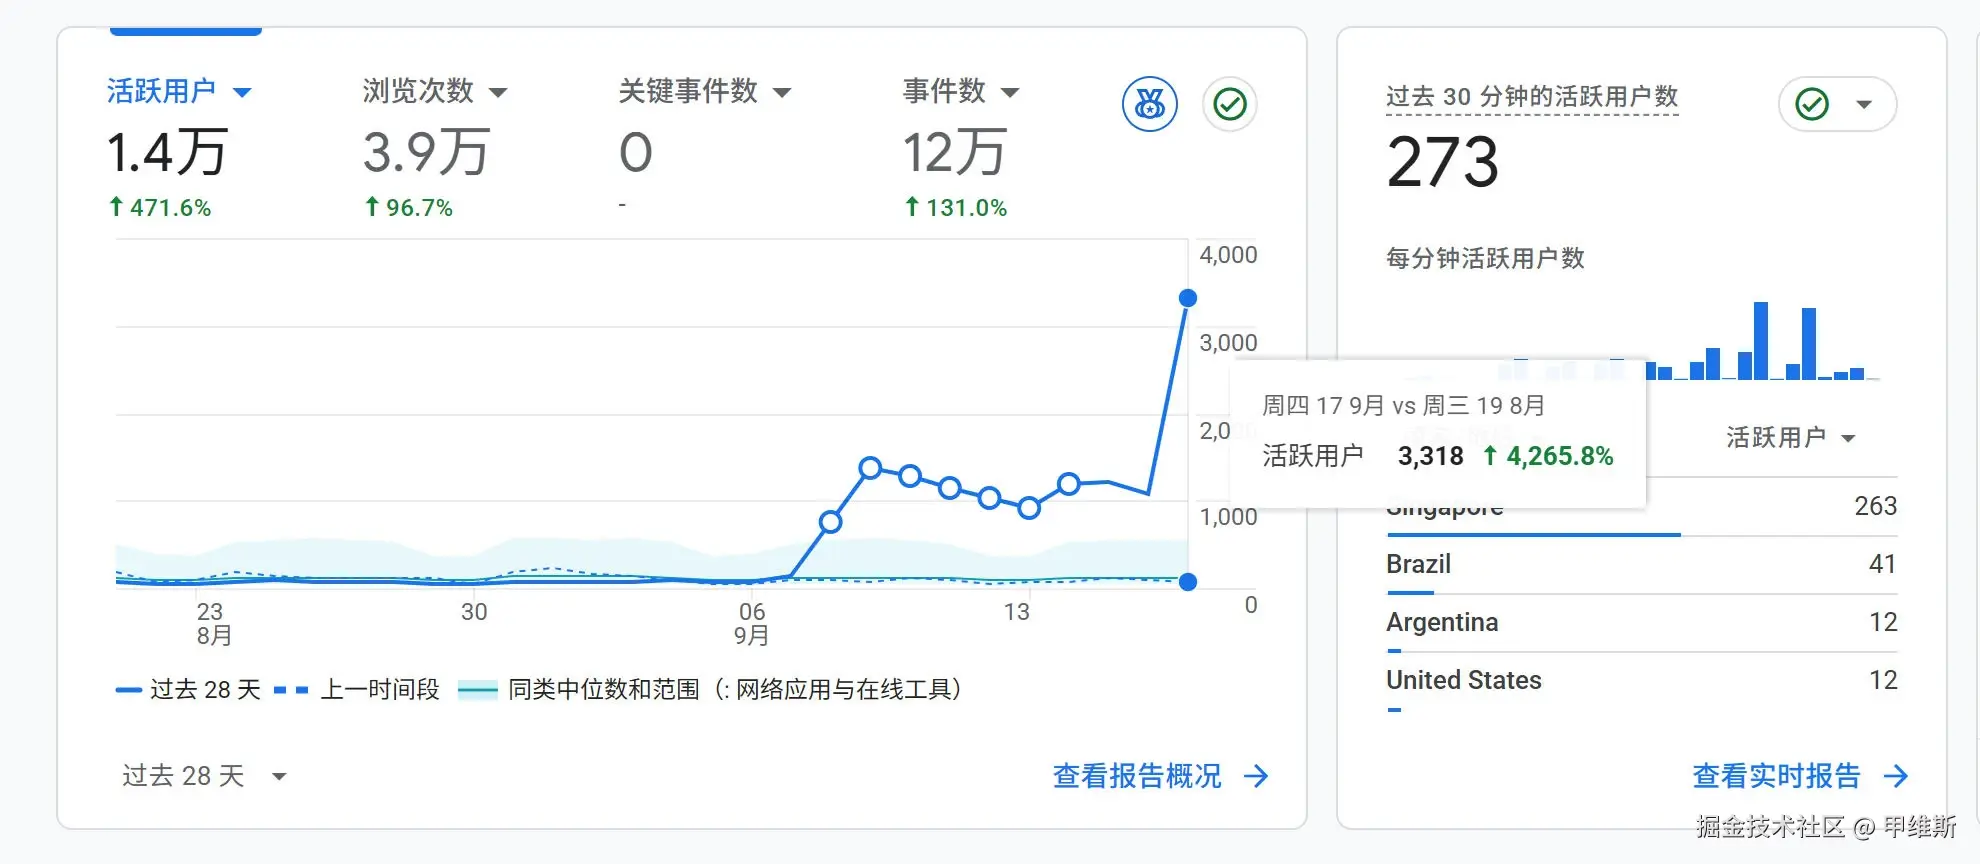
数据变化非常明显,直接从 1000 左右到了 3300,今天估计得破万了!
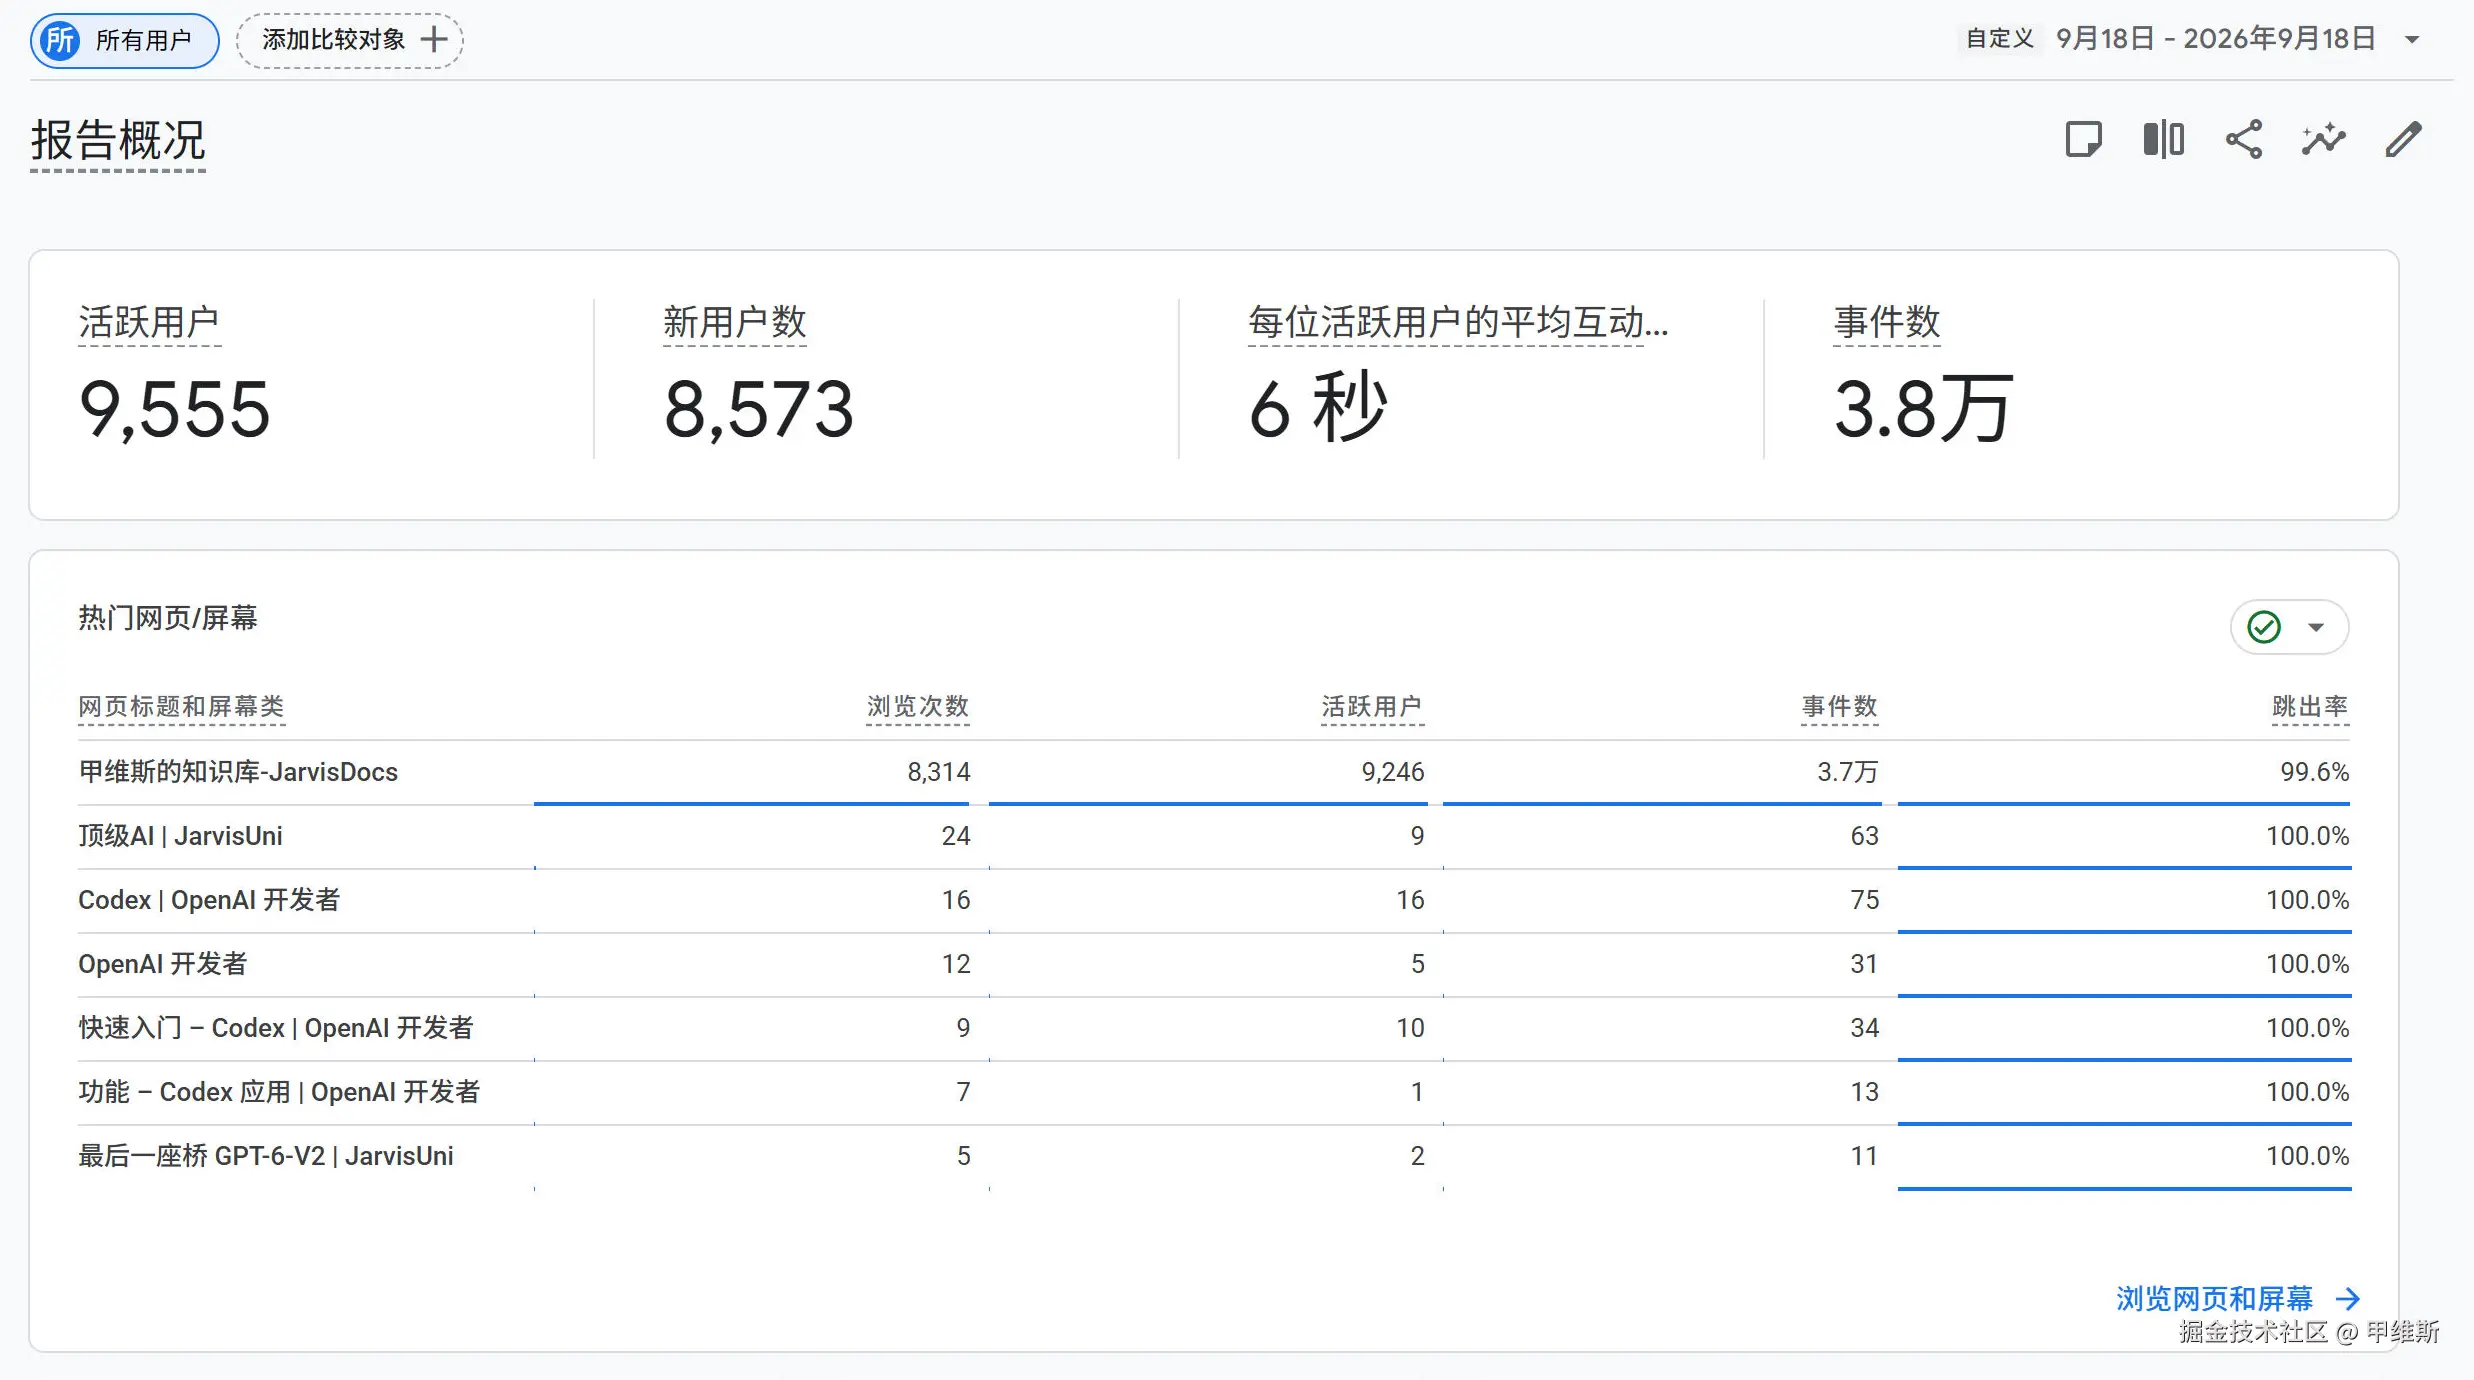
汇总数据中显示活跃用户涨了 471%,然后有一个对比数据中涨了 4265%(40 倍)
这波动,肯定是超过正常范围了!
我刚开始是怀疑:我分享了网站链接之后,其他人转发了,所以流量一下子大了。
但是当我看了一些具体数据之后,基本上排除了这种情况。
下面是来源和城市分析:
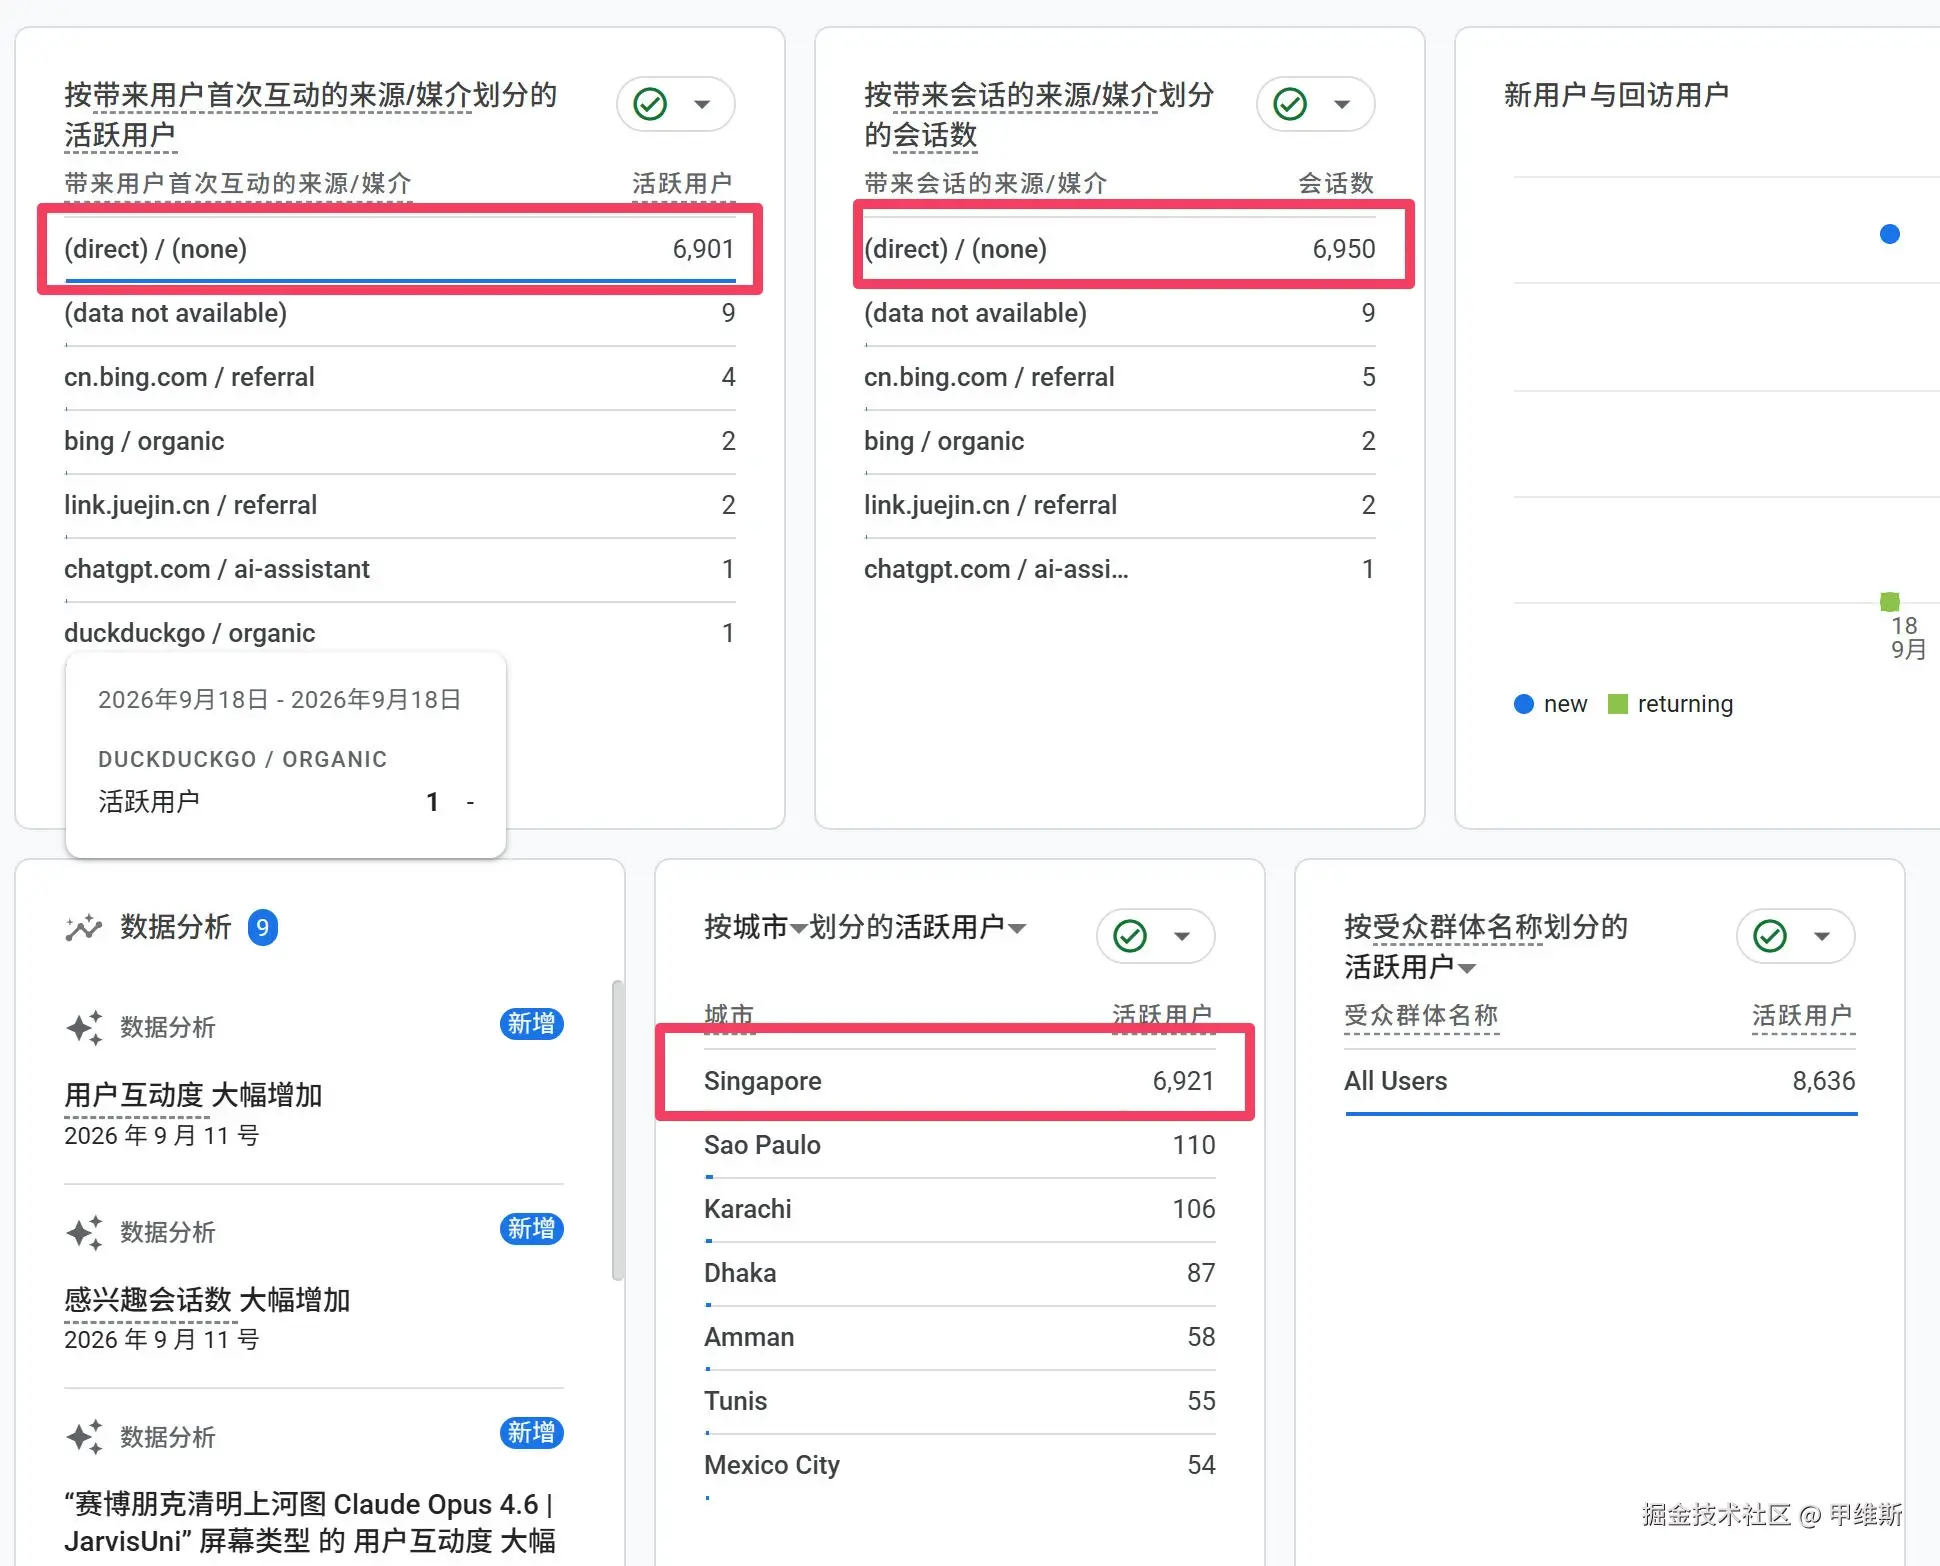
首先大部分都是直接访问,其次大量新加坡用户,然后还有一些乱七八糟的国家的 IP。这些人肯定不是我网站的目标用户,我的用户基本在中国、美国。新加坡也有,但是占比不会这么高!
另外看了下过去30分钟的数据:
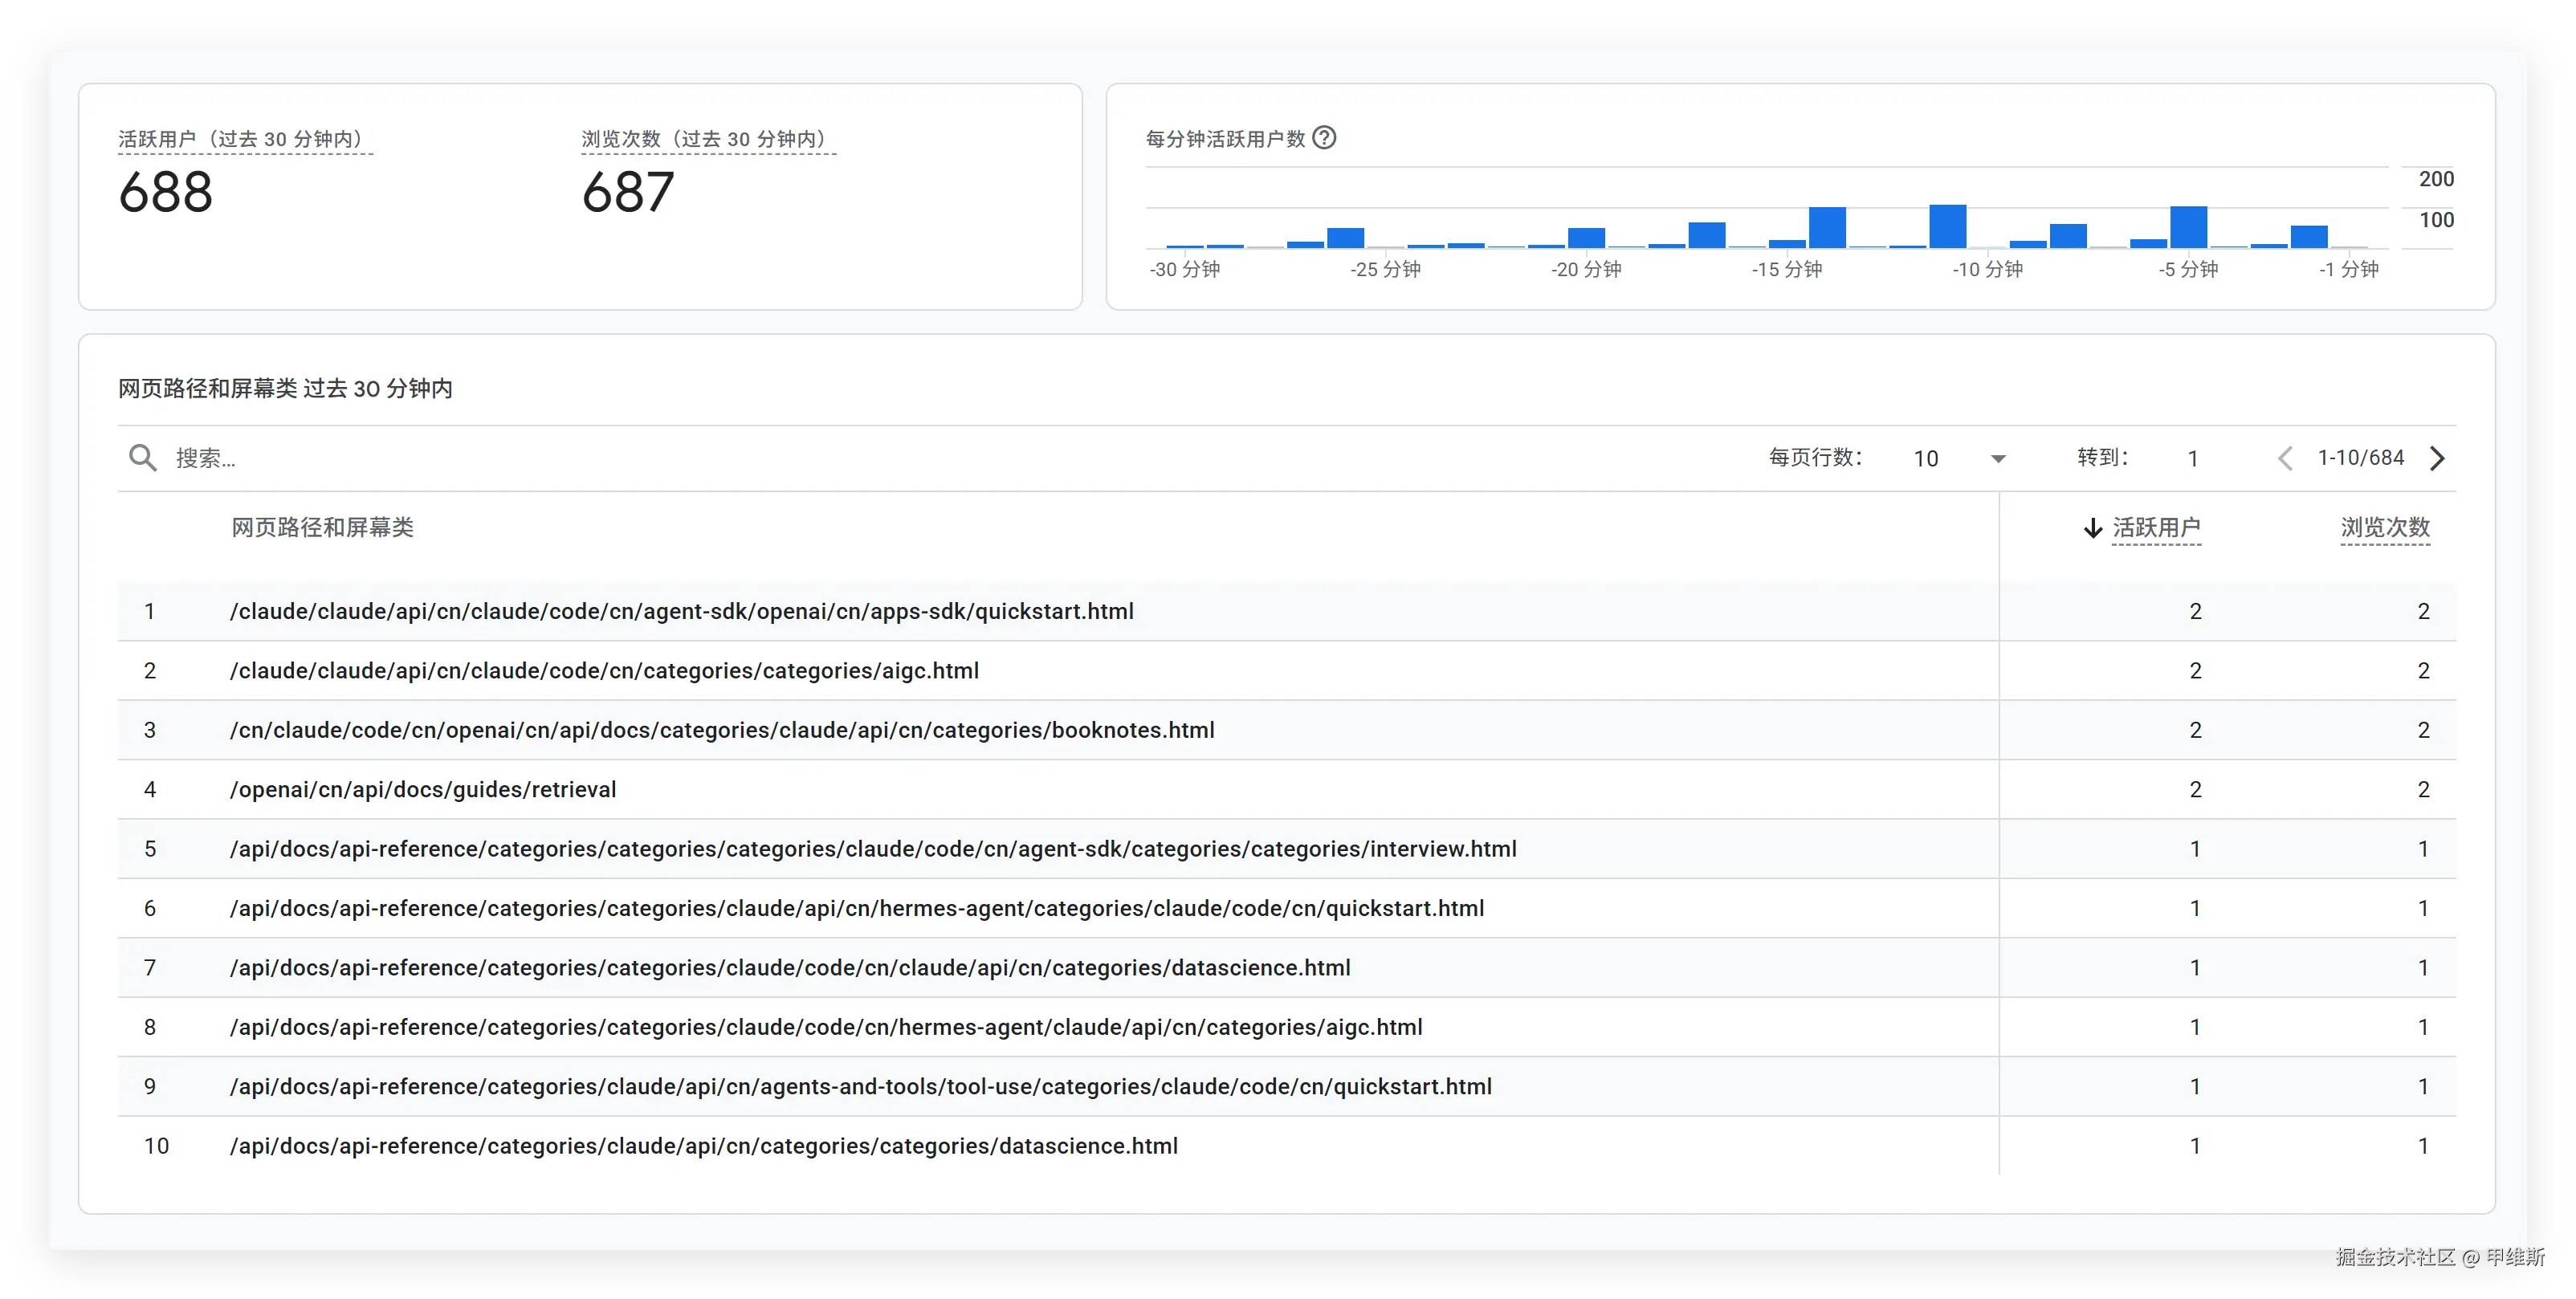
30 分钟有 600 多人,而浏览次数也是 600 多次。这一看就有问题!
再看看下面的受访地址,一看就是机器拼接的,目的是遍历潜在的网站内容。
(这遍历有点呆吧,如果是 AI 处理,一下子能找出所有正确的链接)
这一波太明显了,装都不装!
看右边的柱状图,基本上也能感受出来,这是机器行为。
但是这种爬虫好像比直接抓取的爬虫要高级一点,它还假装访问了一下首页,还模拟浏览器来进行抓取的。
说起流量分析,网站防御,那不就巧了么,我刚把网站托管在 CF 上啊!
CF 是"老司机",看看它的统计数据:
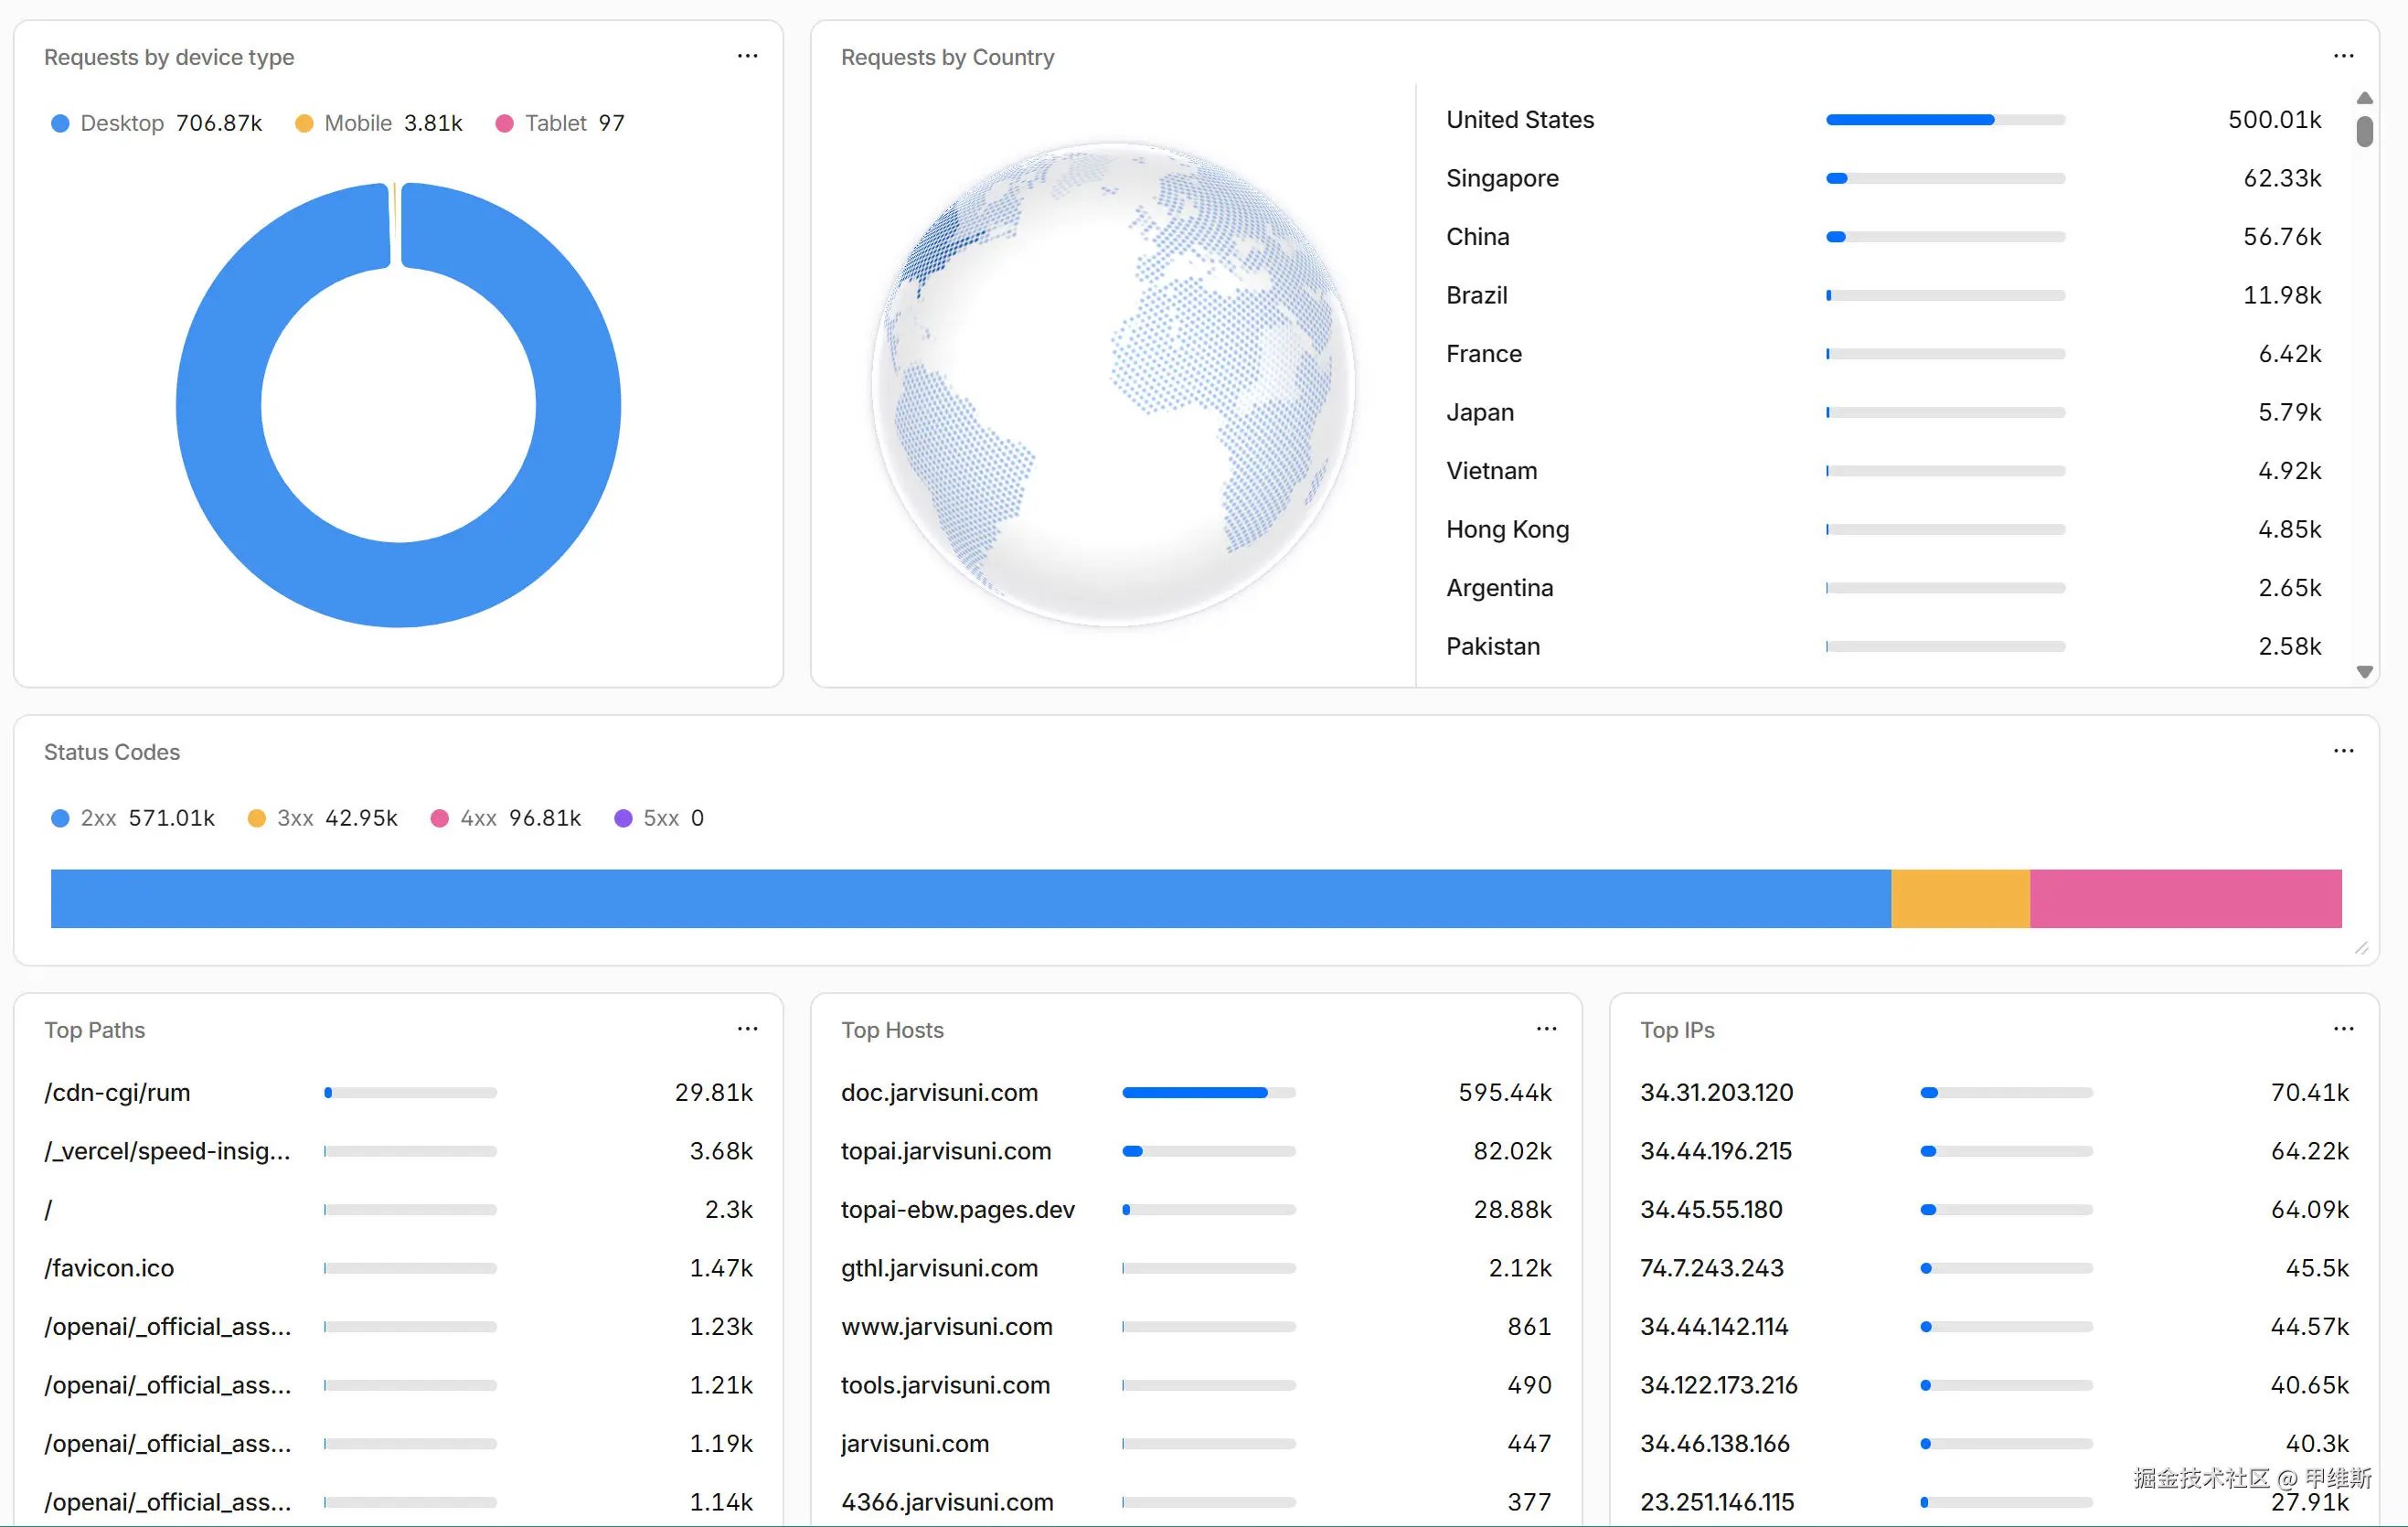
它这里显示大部分数据来自美国、新加坡、中国,然后就是一些乱七八糟的国家了。
访问的顶级路径是 cdn-cgi/rum,
访问的顶级域名是 doc.jarvisuni.com。
访问最多的 IP 是......单个 IP 这么多量么?我不是很确定这个数据是指什么量!
另外看了一下浏览器,操作系统,排在第一个的都是未知!排在第二的才是 Chrome 和 MacOSX
浏览器 Agents 排第一的是:Mozilla/5.0 AppleWeb!
然后看看它的网站浏览分析:
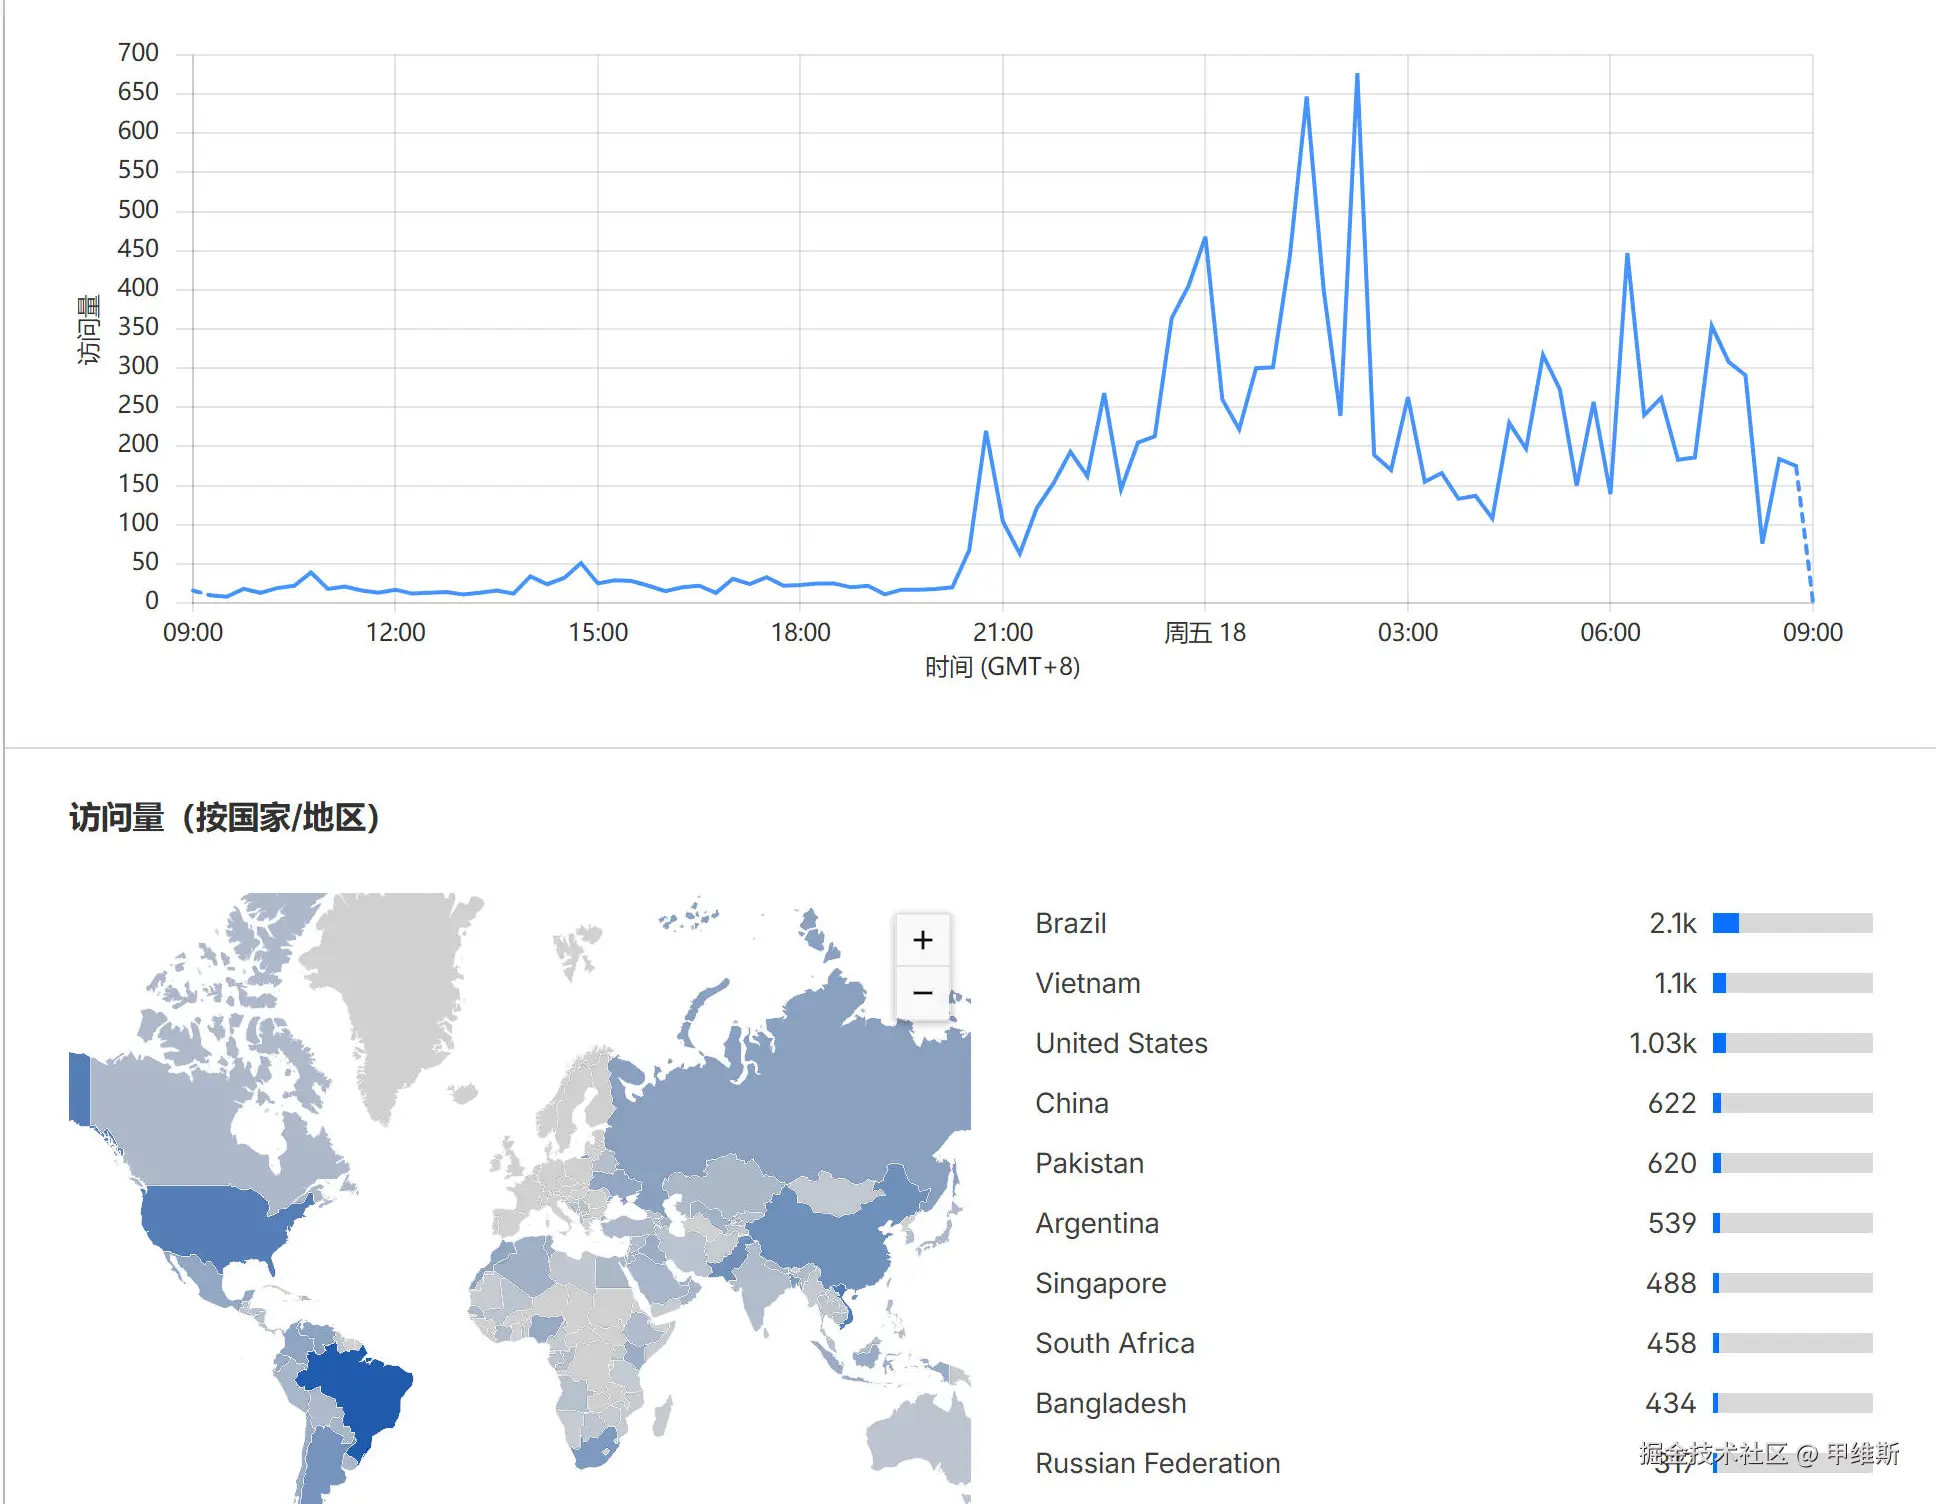
从昨天晚上八点多开始,就出现了明显的异常流量,半夜搞得特别凶,今天早上还在持续,但是低调很多了。
下面的访问国家地区又给我整迷糊了,排在第一个的是 Brazil(巴西),排第二的是 Vietnam(越南),后面是中国、美国,接下来有一些奇奇怪怪的国家,反正看起来就不是我的目标用户。
再看一下子项:
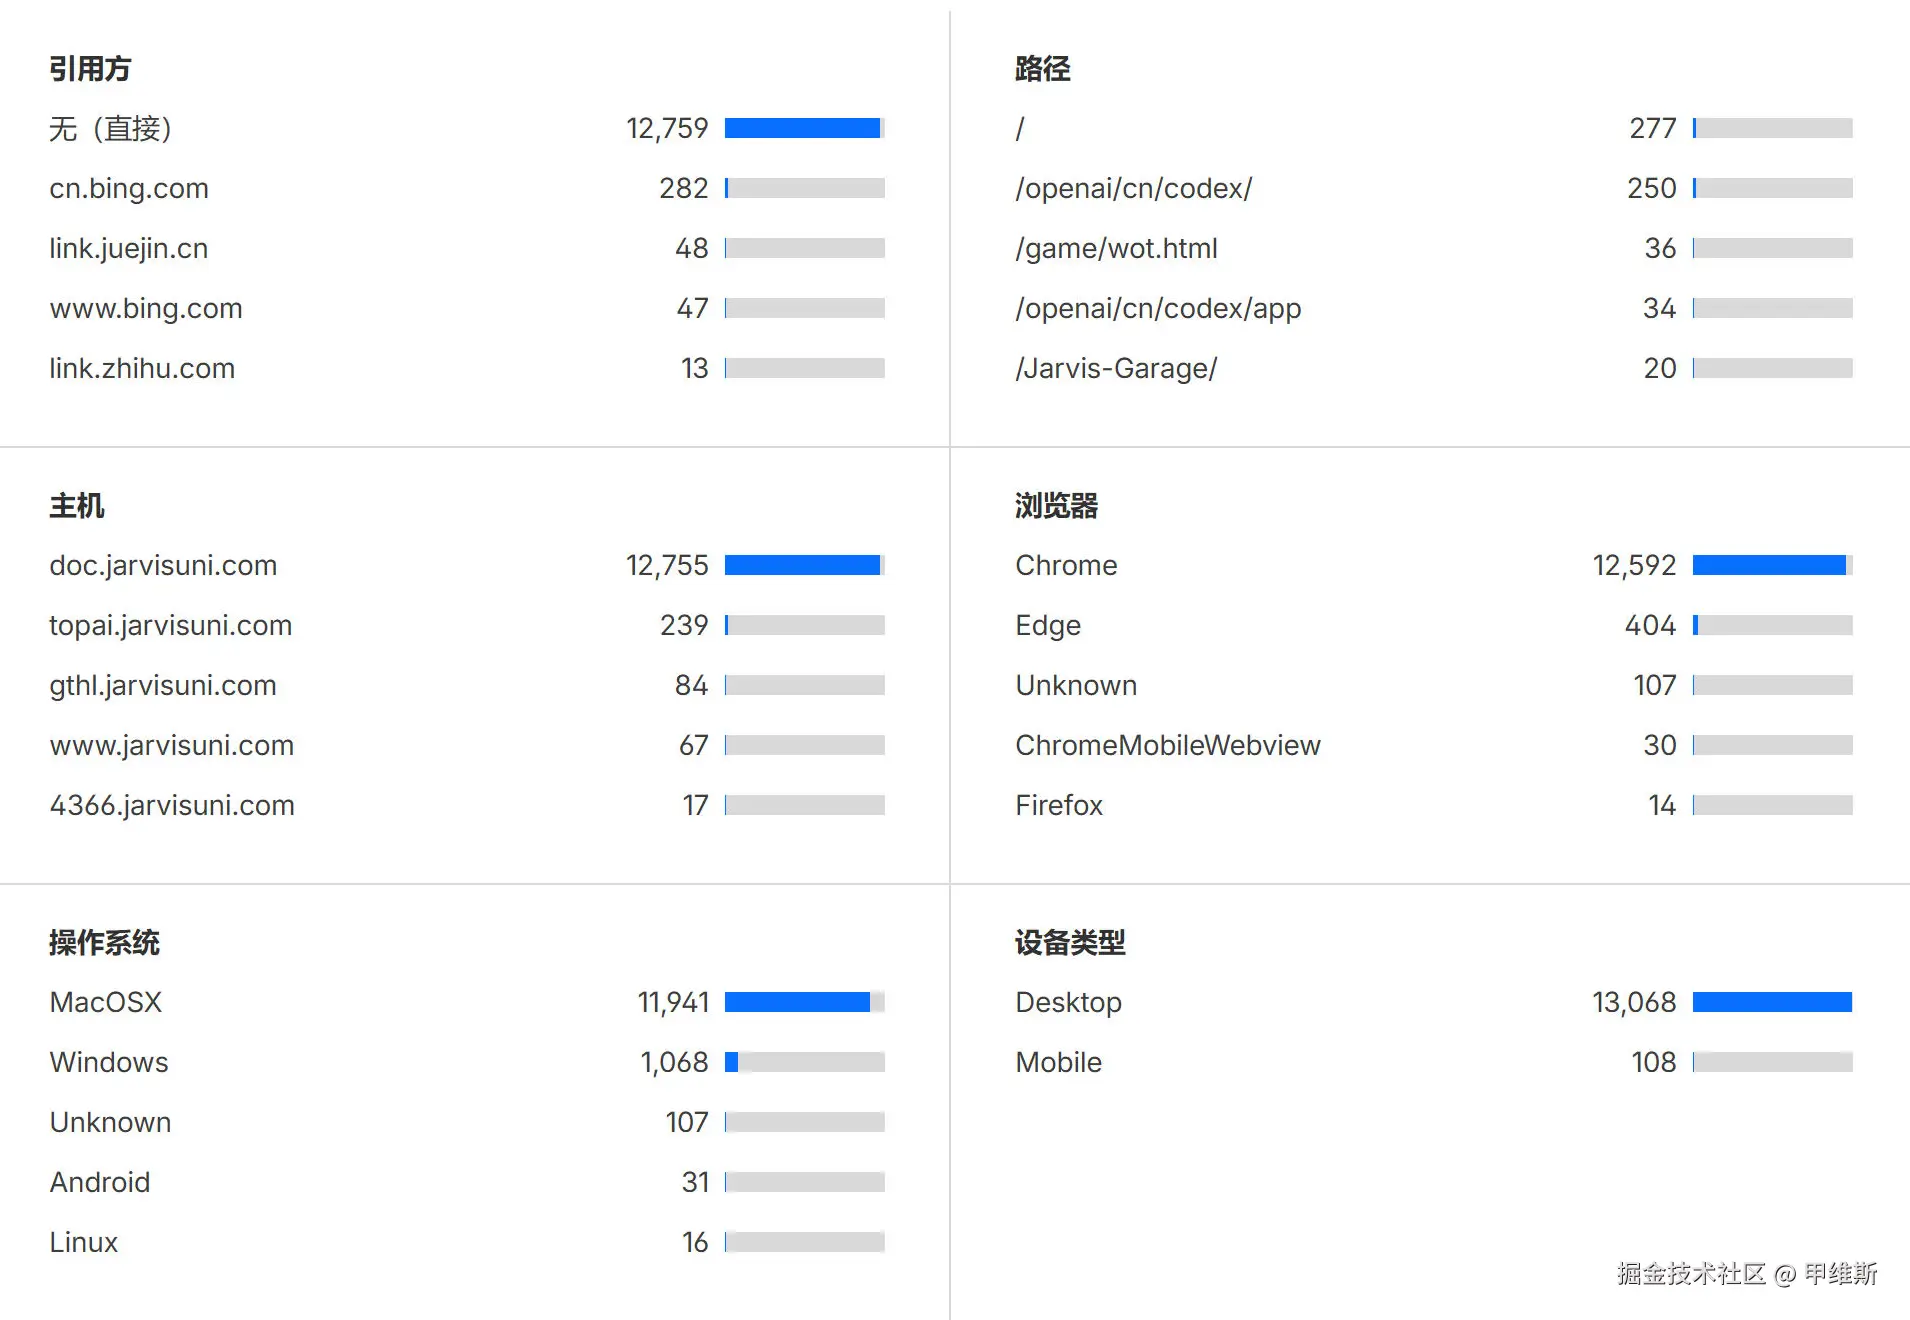
这个数据和之前的数据又有些不一样!但是单条记录特别突出,肯定不正常!
整个看下来,这数据肯定不正常,但是具体哪里有问题,我也说不清楚!
2、AI分析
遇事不决问 AI,这个任务给 Codex 比较适合!
它办事儿,我还是放心的。
有人可能要问,为啥不用我天天吹的Claude?
因为它有其它重要的任务,在帮我开发坦克世界的联机对战功能呢,这个"延迟"处理是真的难搞,由于服务器在国外,真的很难搞。国内又要备案,也很麻烦。目前只能是在技术上做优化,我已经和 Claude 开房间打了好久了。
说回正题,先来分析今天这个问题!
我的提问是这样的:
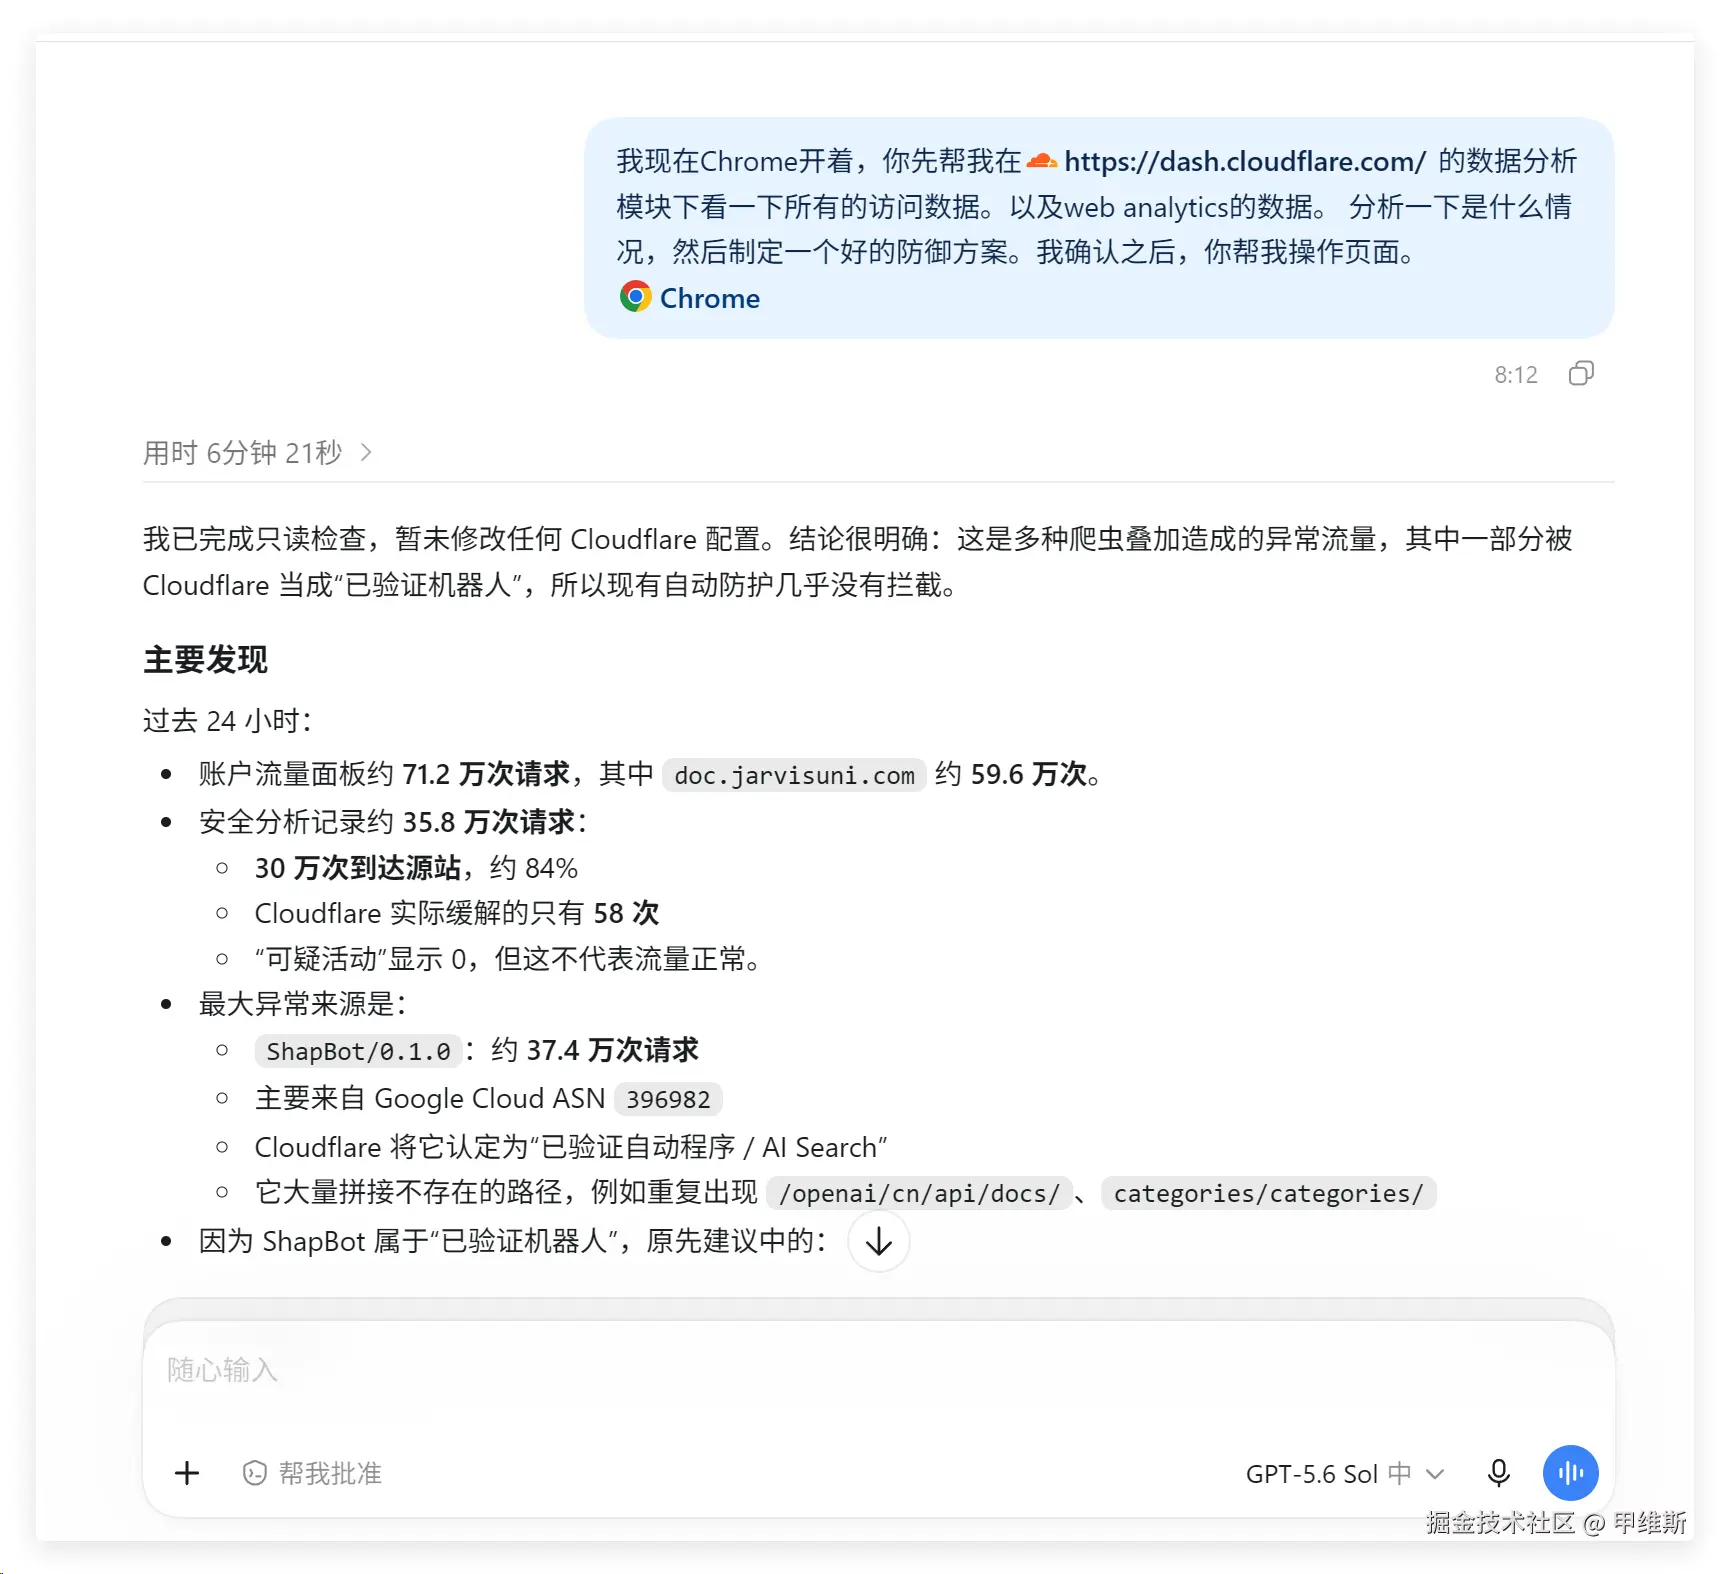
因为事关真实的网站安全,所以我是选择了 GPT-5.6 Sol。这次没有用那个 Luna,它应该也可以,但是我希望能用一个脑子更好的模型。
它给我的结论是:
diff
账户流量面板约 71.2 万次请求,其中 doc.jarvisuni.com 约 59.6 万次。
安全分析记录约 35.8 万次请求:- 30 万次到达源站,约 84%
- Cloudflare 实际缓解的只有 58 次
- "可疑活动"显示 0,但这不代表流量正常。

最大异常来源是:- ShapBot/0.1.0:约 37.4 万次请求
- 主要来自 Google Cloud ASN 396982
- Cloudflare 将它认定为"已验证自动程序 / AI Search"
- 它大量拼接不存在的路径,例如重复出现 /openai/cn/api/docs/、categories/categories/
另外它还看了AI爬虫的情况:
diff
AI Crawl Control 还显示:
- GPTBot:28,810 次失败请求,只有 1 次成功
- PerplexityBot:约 8,130 次
- ChatGPT-User:约 4,420 次
- BingBot:864 次
- AI 爬虫请求中约 29,440 次为 404
我之前都不知道,有这么多类型的爬虫。
要制定规则也不容易,既要拦住恶意流量,又不能误伤正常的用户和正常的爬虫!
它的结论是:
这批 Direct/macOS/Chrome 不能按真人理解,更像会执行 JavaScript 或伪装浏览器指纹的自动化流量。
同时它也帮我看了下目前CF配置规则:
markdown
- 自定义规则:**0/5**
- 速率限制规则:**0/1**
- Bot Fight Mode:关闭
- AI Maze:关闭
- AI Crawl Control 中各爬虫阻止开关均关闭
也就是没有开启任何特定的防御,全部属于 CF 的默认状态!确实如此,我没有手动配置过任何特殊防御。
一般来说,默认配置就是最佳配置。只有需要的时候才开启特定设置。
推荐的防御方案
它根据看到的数据,给我定制了防御方案。
它建议分两阶段,避免影响 Bing、Google 和有价值的 AI 引荐。
第一阶段立即执行,误伤风险最低:
1、建立精确的 ShapBot 自定义规则
2、建立异常路径规则,拦截已观察到的重复拼接路径。
3、在 AI Crawl Control 中只阻止 GPTBot(抓训练数据的 bot)
4、增加一条脚本客户端规则,对空 UA、python-requests、scrapy、httpclient 等执行 Managed Challenge。
第二阶段观察约 30 分钟后启用:
5、建立唯一一条免费速率限制规则......
6、为静态文档和短期 404 响应增加边缘缓存,减少爬虫漏网时对 Vercel 源站的消耗
它不建议现在开启全局 Bot Fight Mode 或 Under Attack Mode,因为它们会覆盖整个 jarvisuni.com Zone,可能影响其他子域名、搜索引擎和 AI 引荐。
这个方案看起来还是比较稳的!
我只要确认方案,它可以立马帮我设置好。
到这里我已经大概知道情况了。
这个事情主要来自ShapBot! 我只要确定这个机器人是良性的还是恶意的就好了。
然后我让它分析了一下这个机器人。
结论是:
ShapBot 不是一个普通用户在偷偷镜像你的网站,而是 Parallel Web Systems 的官方商业爬虫。它属于"AI 搜索索引/内容检索基础设施",但确实会复制、保存并结构化公开网页内容,供第三方 AI 应用调用。
Parallel 官方说明:
markdown
- `ShapBot` 自动抓取公开网页,用于建立和维护 Parallel 的搜索索引。
- 该索引服务于 Parallel 的搜索 API、AI Agent、聊天机器人和工作流。
- 与之区分的 `Shap-User` 才是某个用户发起请求后、临时读取指定网页的访问。
因此它更准确的分类是:
| 性质 | 判断 |
|---|---|
| Google/Bing 式传统搜索收录 | 不是 |
| AI 搜索索引 | 是 |
| 模型训练爬虫 | 官方没有把它描述为训练爬虫 |
| 用户实时请求 | 不是,实时请求使用 Shap-User |
| 商业内容采集 | 是 |
| 某个人针对你的网站做镜像 | 暂无证据 |
根据这个信息,Codex 也做了一定的风险判断:
- 有人专门盗取并克隆你的网站:目前证据较低。
- Parallel 将你的内容收入商业索引、供第三方 AI 提取:确定存在。
- ShapBot 当前的异常抓取损害网站资源:证据很强。
- 完全放行对你是否有实际流量价值:目前看不到明显价值。
因此,它建议修改第一阶段:暂时不全面封禁 ShapBot,先实施"异常路径阻止 + ShapBot 专属限速 + 404 缓存",同时保留正常页面收录。若它仍持续失控,或者你不接受 Parallel 商业化提取内容,再升级为完全阻止。
看到这里基本上明白了,就是有一个商业爬虫在爬我的数据!
这么一看问题不是太大,还好我刚从 Vercel 转到了 CF,否则要被刷破产了!
现在还没消停:
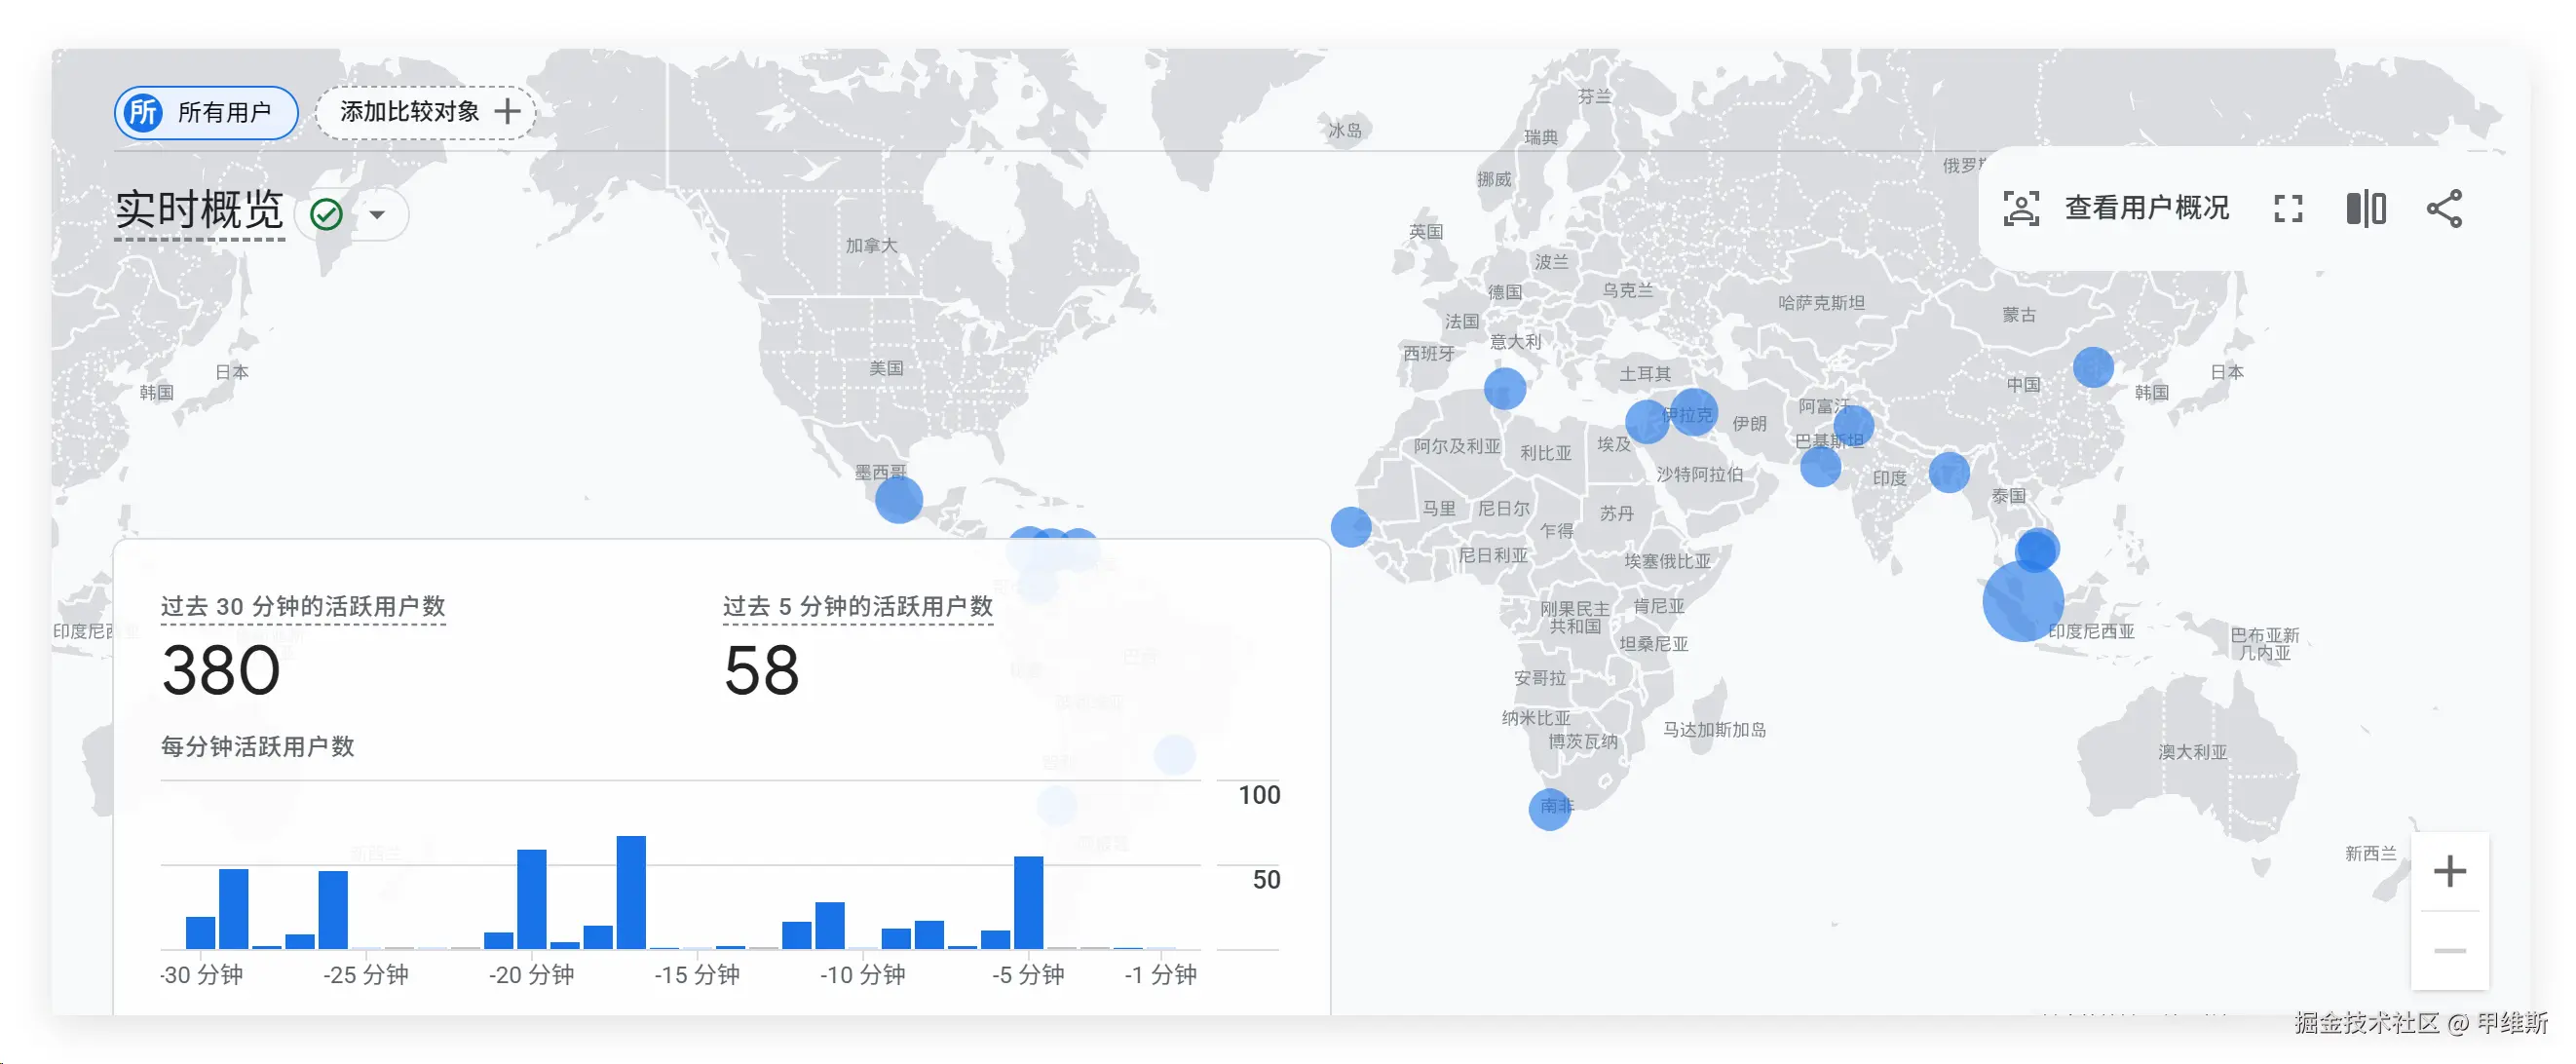
我严重怀疑是我的读者驱动了这个事情。因为这个链接我只在文章中发过!
抓一下也问题不大,反正我也是从OpenAI和Claude那里住过来的。
不过我也是花了一些功夫的。
当时为了保证整个网页高度还原官方的结构和样式,以及让所有内链的正常工作,还是花了些功夫的。全部用LLM来翻译,也是消耗了巨多的Tokens!
我先观察一下吧,我怎么感觉这个爬虫策略不太对,起的有点猛,而且不太聪明的样子。
我准备按兵不动,给它24小时,吃饱了,就可以停了啊。
这个ShapBot给我一种网站流量爆了的错觉,让我很伤心😭!
有本事,你给我搞一些真人来,我就原谅你了!
在这个场景中,其实Codex是完全可以读取和操作CloudFlare的,在功能上绝对没有任何问题!而且搞起来也非常快。
但是,我觉得作为人类有必要搞清楚前因后果,以及不同操作的后果,然后做出最合适的选择!
AI可以快速分析问题,给出建议,辅助我理解各种概念,但是我必须真的能理解这个事情,然后才能掌控全局。
我这里分析的都是真实的AI测试结果,看到的都是真人真事儿,欢迎持续关注!