2026 年 9 月 17 日,智谱创始人兼首席科学家唐杰在 X 上发了一篇长文,同时转发了官方技术博客。这次的主角不是又一个新模型,而是一份工程复盘:由 GLM-5.3 驱动的 Infra Agent,在超过 10 万张国产芯片的集群上,从零设计、调试并优化了 GLM-5.3-Flash 的生产级推理系统。
数字口径需要先说清楚,因为各家转述并不一致。唐杰原文给出的是端到端吞吐提升 3.2 倍,英文分析稿 explainx 精确到「13 天 / 3.22x」,而多数中文报道写作「不到两周提升至 3 倍」。团队同时声称硬件利用效率与单 Token 成本已达到主流 NVIDIA GPU 的相当水平,系统支持 1M 上下文窗口与多模态请求。
更值得注意的是 Agent 的闭环形态:它自主分析性能瓶颈、定位精度缺陷、修改底层代码、执行分层测试,再按实验反馈迭代------不是「生成一段代码给人抄」,而是完整地跑完了一轮基础设施优化。
一、为什么这件事值得单独拿出来讲
先看这套系统实际承载了什么。GLM-5.3-Flash 曾以匿名模型 Ox-Alpha (中文社区叫「牛来」)的身份在 2026 年 8 月 20 日晚登陆 OpenRouter,配置约 100 万 token 上下文,支持文本、图像、视频多模态输入,预览期免费。据 OpenRouter 数据,它上线首日即登顶平台并刷新单日用量纪录,终结了 DeepSeek 连续 56 天的榜首位置;6 天 Token 调用量超过 62 万亿,使用量达 DeepSeek 两倍以上。OpenCode 公告称其背后每天有 100 万亿(100T)tokens 的算力供给。智谱在 8 月 26 日晚间认领,当晚发布权重、以 MIT 协议完全开源------总参数 320B、激活参数 18B,是 GLM-5 系列首个原生多模态模型。
背景里还有一层时间窗:DeepSeek-V4-Flash 于 7 月底上线后,8 月 17 日起实行峰谷定价,空出近 10 万亿 token 的日常需求缺口,智谱以匿名身份在这个窗口期承接了外溢流量。
所以「真实流量验证」这句话不是修辞------测试和发布后的线上服务,全部由这 10 万张国产芯片的集群承载,测试期间累计处理流量 62T Token。据业内推测,芯片供应商可能来自华为、摩尔线程与海光(智谱官方并未点名)。
市场端的反应也很直接:消息公布后,智谱港股 8 月 27 日收涨 12.62%,报 1160 港元/股,市值重返 5000 亿港元。
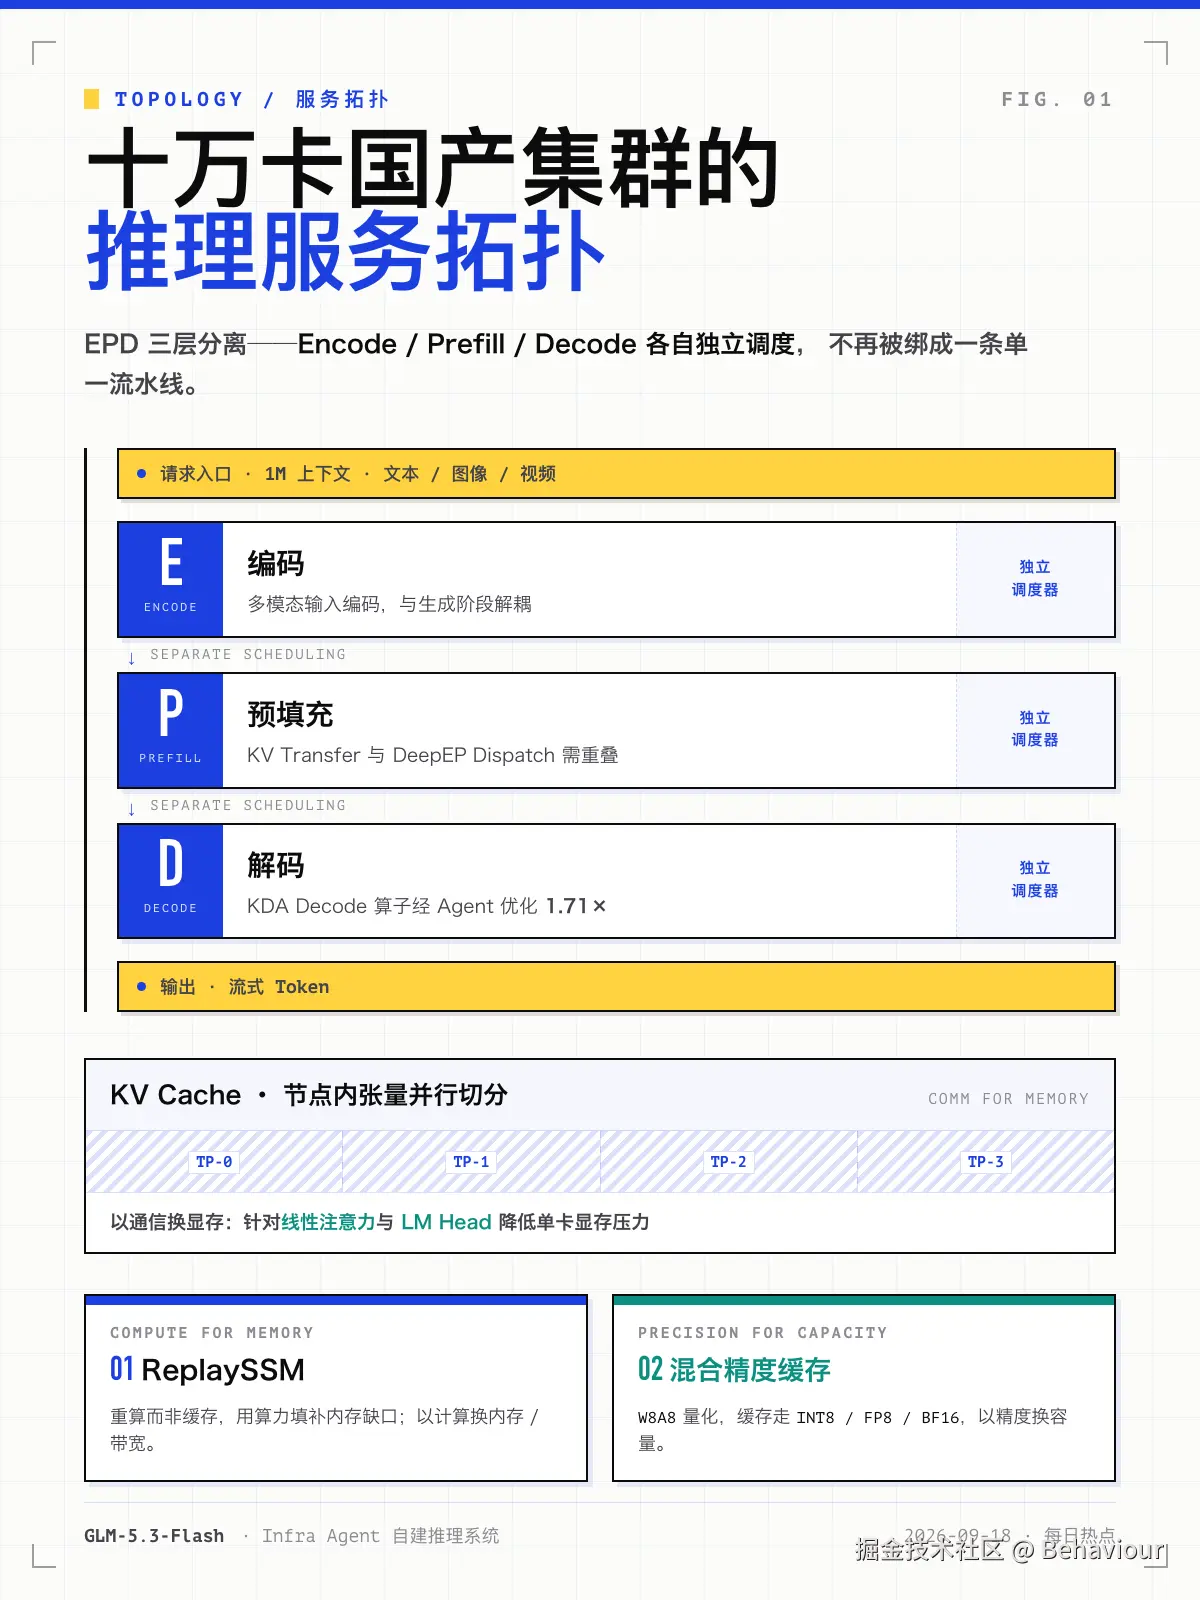
二、受限硬件上的四组权衡
官方博客对困境的描述相当坦率:国产芯片内存容量与带宽受限、软件生态不成熟、算子不完备、文档基本靠猜。这不是「换个后端跑起来」的问题,而是要重做一整套工程决策。团队最终归纳出四组权衡,每一组都是拿一种资源换另一种资源:
- 以计算换内存 / 带宽 ------ ReplaySSM。重算而非缓存,用算力填补内存缺口。
- 以通信换显存 ------ 节点内张量并行。针对线性注意力和 LM Head 降低显存压力。
- 以精度换容量 ------ W8A8 量化,以及 INT8 / FP8 / BF16 混合精度缓存量化,提升容量利用率。
- 以解耦换调度自由度 ------ Encode--Prefill--Decode(EPD)分离式架构,让 Prefill、Decode、编码等不同推理阶段独立灵活调度,而不是被绑成一条单一流水线。
此外还涉及 Layer Split 等技术。这套组合本身不新鲜,NVIDIA 生态里各有多家实践;真正稀缺的是在国产芯片的约束下同时成立,并且有 62 万亿 token 的真实流量背书。
三、三个具体案例:Agent 到底改了什么
抛开方法论叙事,这次最能立住的是三个被点名的具体问题。数字都很硬。
案例一:KV Transfer 的 Python GIL 阻塞。 验收标准是「Prefill + KV Transfer」的总开销控制在单独 Prefill 基线的 5% 以内,Agent 实测差距超过 20% (部分中文报道写传输开销超 30%)。根因追溯到 DeepEP v1.2.1:节点内 dispatch / combine 调用没有释放 Python GIL,导致同进程里的 Mooncake Transfer 线程抢不到 GIL,传输任务调度滞后,KV Transfer 与 DeepEP Dispatch 无法重叠。修复后,同条件下的性能差距被压到 1% 以内。
这类问题很典型------不是算法错了,也不是 kernel 写慢了,而是并发模型层面的资源争用。传统 profiling 工具很难直接告诉你「GIL 在这里」,因为它表现为一个说不清来源的调度延迟。
案例二:KDA Decode 算子 1.71× 加速。 V 维度的切分(tiling)导致同一组归一化与门控计算被重复执行了四次。Agent 重新组织计算结构,取得了 1.71× 的提升。值得一提的是思路来源:它学习了 SGLang、Flash Linear Attention、DeepGEMM 等现成 kernel 的实现方式,并把这类改动提炼成可复用的 "optimization skeleton"。
案例三:KDA 上下文并行的精度漂移。 这是全篇唯一一条可以独立验证的外部证据 ,因为修复已经上游合入了开源仓库,不依赖智谱自述。问题出在 KCP(三 kernel 前缀扫描)上:前两个 kernel 用 tl.dot(f32, f32, input_precision="tf32") 合并仿射参数 M 与 H。即使输入是 FP32,tl.dot 仍默认走 TF32 计算,舍入误差在状态变换合并与状态更新中链式累积,序列越长越明显,直接拖累长上下文精度。
修复方式是在 pre_process_fwd_kernel_merged、pre_process_bwd_kernel_merged、merge_fwd_bwd_kernel 中显式指定更高精度的计算模式。要点示意如下:
python
# 修复前:输入是 FP32,但 tl.dot 默认走 TF32,误差在长序列上链式累积
# M & H 两个仿射参数的合并
acc = tl.dot(M, H, input_precision="tf32")

# 修复后:用三次 TF32 Tensor Core 运算模拟更高精度
# 依据 Ootomo & Yokota, IJHPCA 2022
acc = tl.dot(M, H, input_precision=PRECISION)

# PRECISION 由 FLACPContext 上的开关决定:
#   use_tf32x3_affine_chain=True  -> "tf32x3"
#   默认(关闭)                   -> "tf32"(NVIDIA 行为与修复前逐位一致)
#   不支持 TF32 的平台             -> "ieee"
#      (AMD、NPU、NVIDIA compute capability < 8.0 显式回退)
这个开关被挂在 FLACPContext 的 use_tf32x3_affine_chain 上,默认关闭时 NVIDIA 上的行为与之前逐位一致------也就是说,上游合入时保留了向后兼容。测试加在 tests/context_parallel/test_cp_kda.py 的 -k tf32x3 下,跑 2 / 4 GPU,单卡 runner 跳过。PR 作者是 iclementine,由 zhiyuan1i 合入。
一个 Agent 能定位到「FP32 输入 + tl.dot 默认 TF32」这种精度陷阱,并且提交出带平台回退分支、带回归测试、默认行为逐位兼容的上游 PR------这比吞吐数字更能说明能力边界在哪。
四、dense feedback:这次真正的方法论
如果只记一个概念,就是 dense feedback(稠密反馈)。
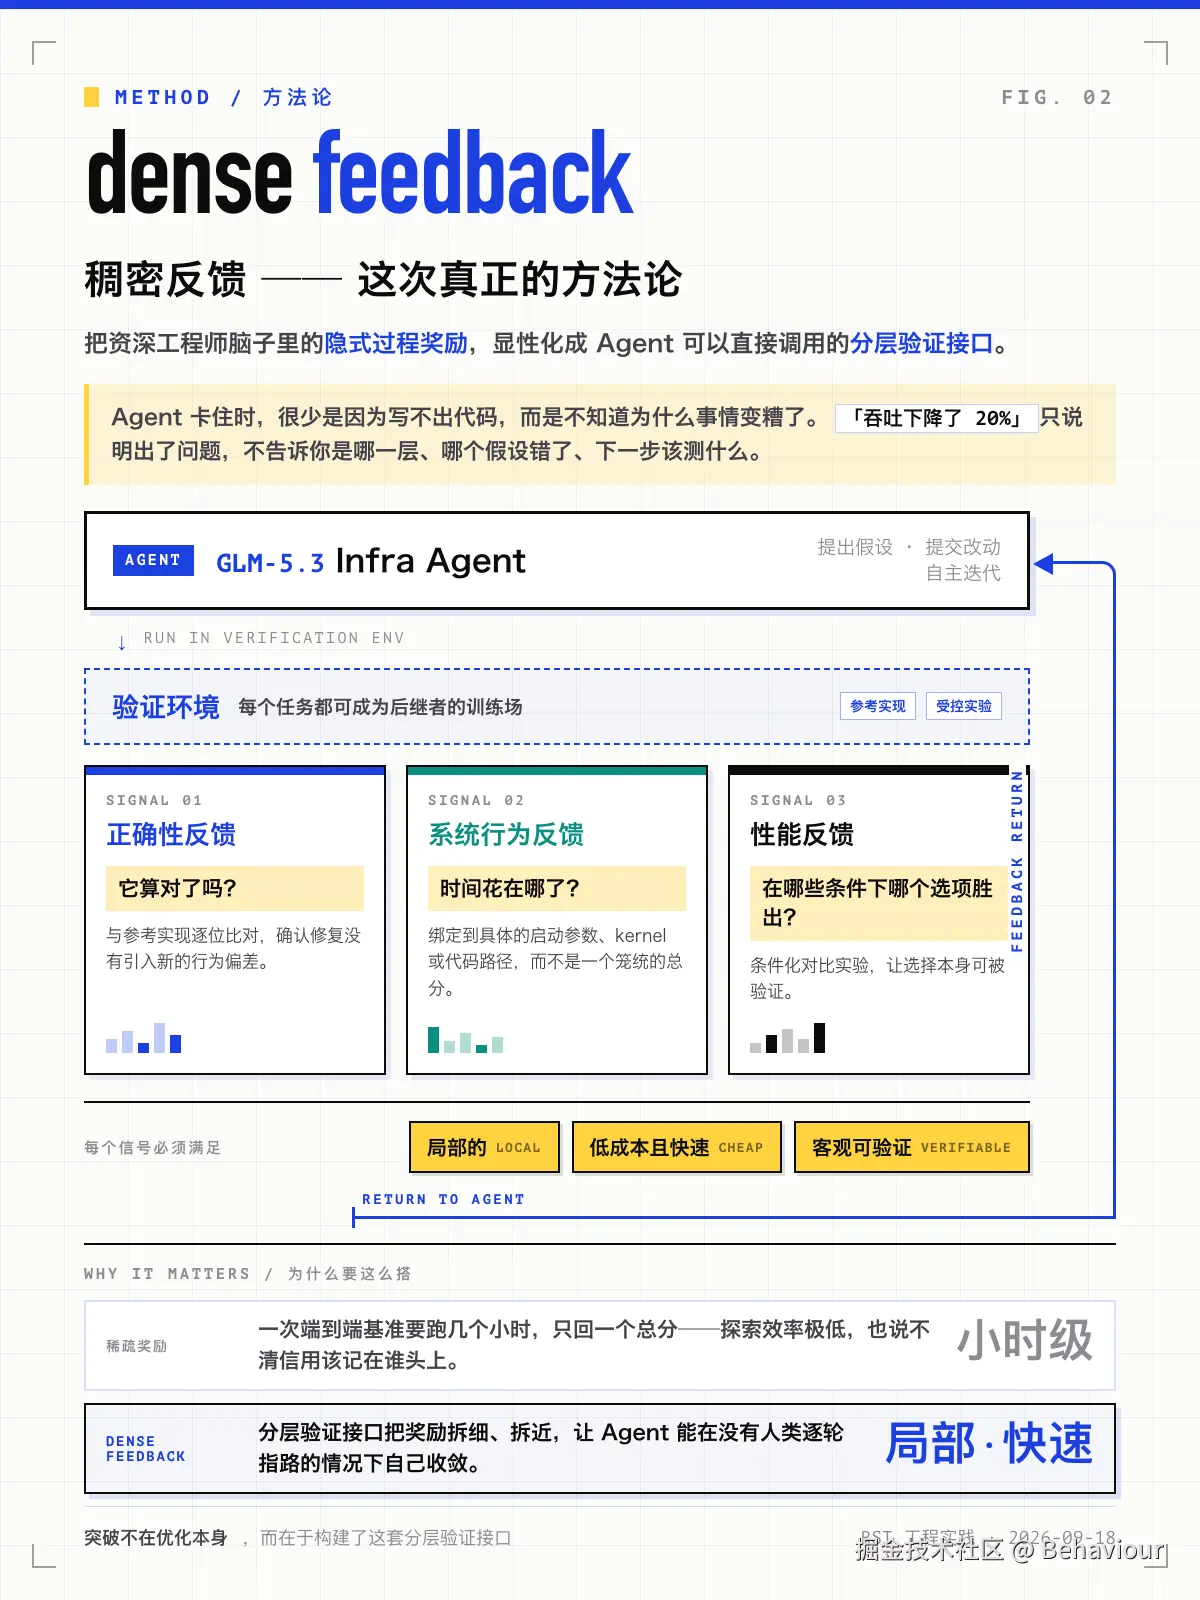
团队的问题陈述很具体:Agent 卡住时,很少是因为写不出代码,而是不知道**「为什么事情变糟了」**。「吞吐下降了 20%」只说明出了问题,不告诉你是哪一层、哪个假设错了、下一步该测什么。用强化学习的术语,这是稀疏奖励加信用分配问题;而一次端到端基准测试要跑几个小时,探索效率极低。
解法是把资深工程师脑子里的隐式过程奖励,显性化成 Agent 可以直接调用的分层验证接口。三类信号:
- 正确性反馈:它算对了吗?
- 系统行为反馈:时间花在哪了?
- 性能反馈:在哪些条件下哪个选项胜出?
每个信号必须满足三个条件:局部的 (绑定到具体启动参数、kernel 或代码路径,而不是一个笼统的总分)、低成本且快速的 、客观可验证的(通过参考实现和受控实验验证)。
唐杰强调,这次真正的突破不在优化本身,而在于构建了这套分层验证接口。这也解释了为什么它值得被叫作「RSI 工程实践」而不是「AI 辅助调优」------前者要求 Agent 能在没有人类逐轮指路的情况下自己收敛。
五、三方竞逐,但口径并不对等
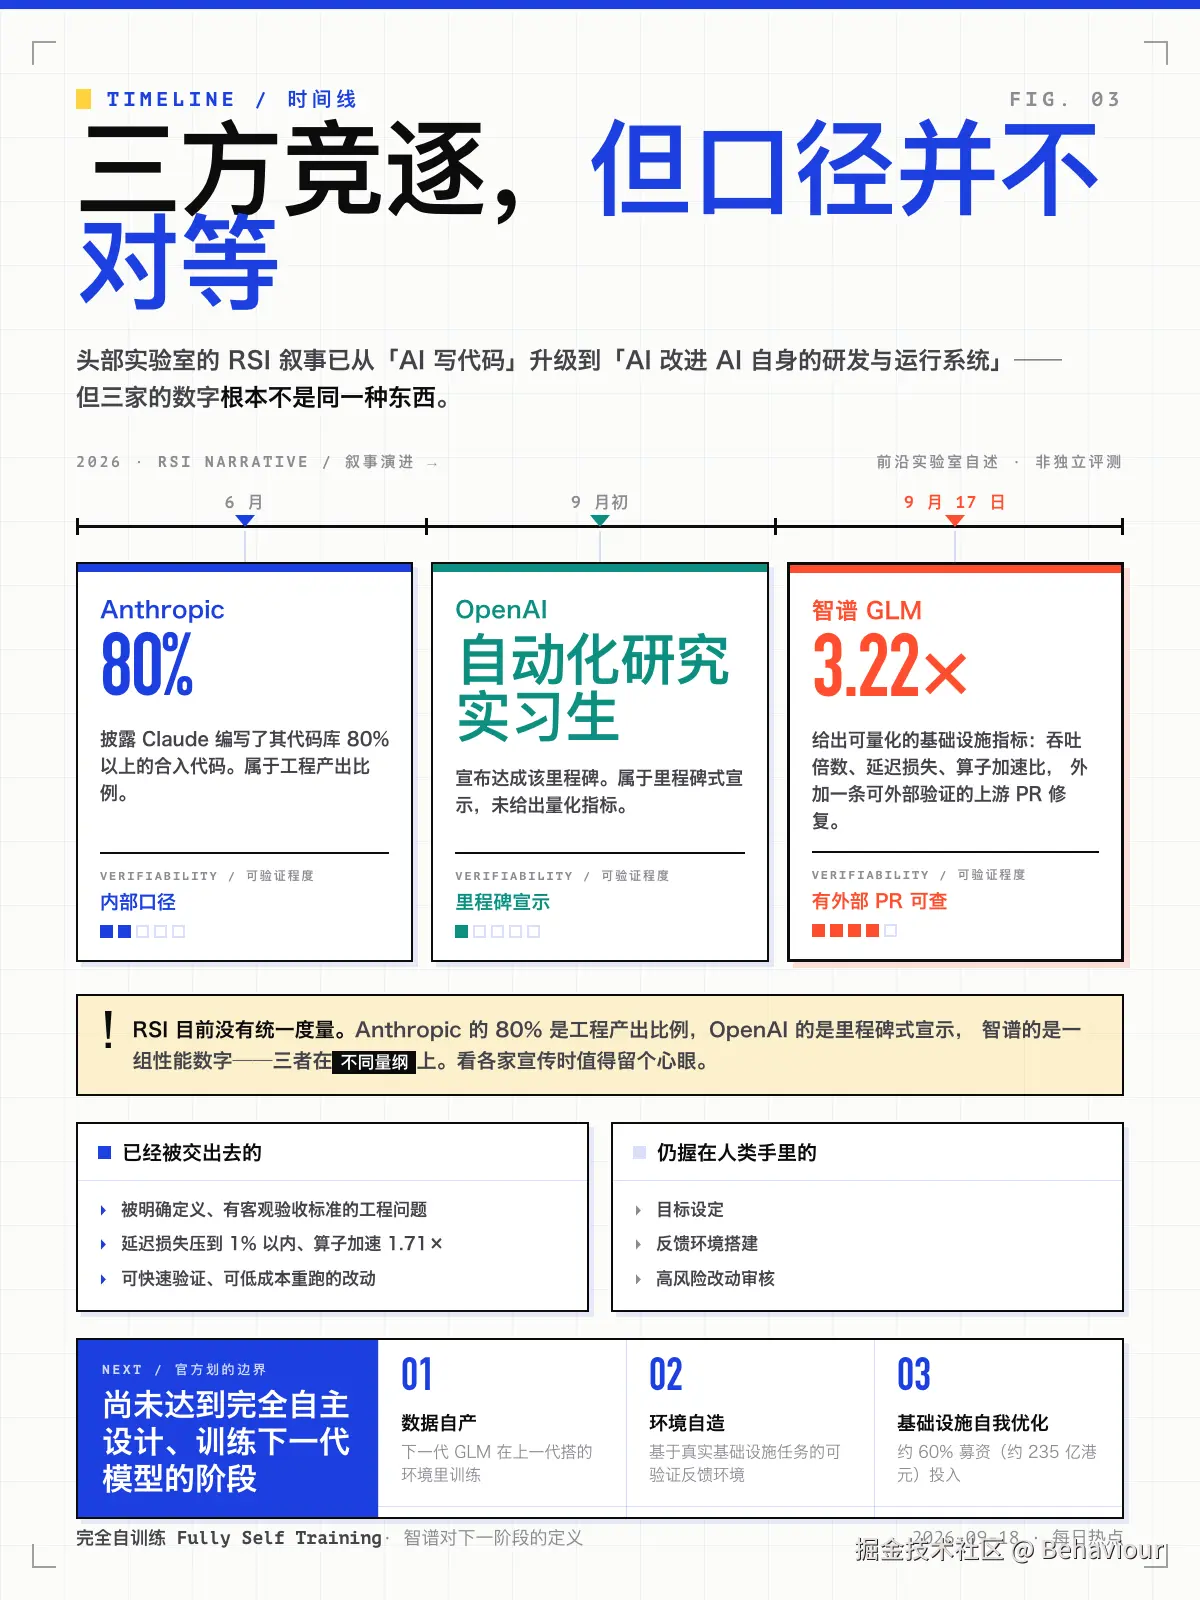
把时间线拉平看,头部实验室在 RSI 上的叙事已经从「AI 写代码」升级到「AI 改进 AI 自身的研发与运行系统」:
- Anthropic:6 月披露 Claude 编写了其代码库 80% 以上的合入代码。
- OpenAI:9 月初宣布达成「自动化研究实习生」里程碑。
- 智谱 GLM:9 月 17 日入场,给出的是可量化的基础设施指标------吞吐倍数、延迟损失、算子加速比,外加一个有外部 PR 可验证的修复。
三家口径其实并不对等:Anthropic 的 80% 是工程产出比例,OpenAI 的是里程碑式宣示,智谱的是一组性能数字。RSI 目前没有统一度量,这一点在看各家宣传时值得留个心眼。但方向是清楚的:谁也没在比「AI 会不会写代码」,比的是「AI 能不能闭环地改进一个真实系统」。
六、边界:它做到了什么,哪些还没做到
这一节可能是全文最重要的部分,因为 GLM 团队自己划了线。
官方明确表示,系统尚未达到完全自主设计和训练下一代模型的阶段,但 RSI 的早期形态已经出现------「模型建设推理系统,系统再反过来支撑模型运行」。唐杰的说法是「最小循环已经开始运转」「正一步步走向取代我们」。
人类工程师的角色正从「直接解决每个问题」转向「设计反馈系统」。也就是说,人从解题者变成了出题人和裁判。
智谱把这个方向称为「完全自训练」(Fully Self Training),即下一代 GLM 将在上一代 GLM 搭建的环境里训练,涵盖三个维度:数据自产、环境自造、基础设施自我优化。唐杰另有一个观点值得引用:这套「基于真实基础设施任务构建的可验证反馈环境」,恰恰是训练下一代模型最需要的,每个 Agent 完成的任务都可以成为其后继者的训练场。
资本层面也在跟进。据港交所公告,智谱约 60% 的募资(约 235 亿港元)将投入下一代 GLM 基础模型和「完全自训练」体系研发。
所以理性的结论应该是:这次披露的是一份扎实的工程报告,而不是「AI 开始自我进化」的宣言。Agent 解决的是被明确定义、有客观验收标准、可快速验证的工程问题------延迟损失压到 1% 以内、算子加速 1.71×、精度漂移修复并合入上游。目标设定、反馈环境搭建、高风险改动审核,仍然牢牢握在人类手里。
对做基础设施的开发者来说,真正的启示也许不是「会不会被替代」,而是你的工作里有多少部分可以被定义成带客观验收标准的任务。能被这样定义的部分,就是接下来最先被 Agent 接手的部分;而设计那套验证环境的能力,会变得比手写 kernel 更值钱。
参考链接
- 量子位:唐杰发布智谱 RSI 首个成果 www.qbitai.com/2026/09/491...
- flash-linear-attention 上游修复 PR #1180 github.com/fla-org/fla...
- explainx:GLM-5.3 Infra Agent 与 dense feedback 技术分析 explainx.ai/blog/glm-5-...
- IT之家:智谱 GLM 公开国内首个 RSI 实践 m.ithome.com/html/100370...
- 新浪财经:Ox-Alpha 认领与开源 finance.sina.cn/2026-08-26/...
- 华尔街见闻:技术手段拆解 wallstreetcn.com/articles/37...
- 第一财经:边界与资本投入 www.yicai.com/brief/10336...
- 腾讯新闻:三方 RSI 进展对照 news.qq.com/rain/a/2026...