2026 年 8 月 3 日,MiniMax 开源了 H3-Base------一个 33B 参数、能同时生成画面与立体声音频的音视频联合扩散 Transformer(DiT)。权重可下载,是视频生成领域少见的"前沿模型开放"事件。但开放权重只解决了"能不能玩",没解决"玩不玩得起":在单张 B200 上,用 50 步生成一段 14.4 秒的 768p 视频,仅 DiT 去噪就要约 14 分钟。以 vLLM-Omni 披露的工作负载为例,一次请求的 packed 序列长达 58,758 个有效 token------文本、音频、视频条件与噪声潜码被拼成一条超长序列联合去噪。注意力路径(RoPE/QKV/Norm/SDPA)合计占掉单层运行时 85% 以上(口径见第五节:284.1/332.5ms),它随序列长度二次增长,而视频恰恰是最长的序列。
此后两个月内,社区与产业界沿至少三个正交方向交出了有代表性的答卷(同期还有 SANA、M4V 等其他探索,本文聚焦这三条):VDN-H3 (UC Berkeley / OpenVDN)改注意力架构,FastH3 (FastVideo + Nuva Lab + NVIDIA FastGen)压缩采样步数、用训练换取注意力稀疏度,QuantFunc 4bit (QuantFunc 公司)砍权重精度、把模型送进消费级显卡。另外还有一个参照系------vLLM-Omni 用纯系统栈优化给出无损 1.445×,它不改变本文的三路线主线,却为所有倍率数字提供了计量原点。看懂这三条路线加一个参照系,就看懂了未来两年视频模型推理优化的整张地图。
补充说明:"九秒生成十四秒视频"目前只有 VDN-H3 在 8×B200 数据中心配置下达成(预热后 DiT 去噪约 6.9 秒、端到端约 9.0 秒)。若按 vLLM-Omni 更严格的"完整 MP4 响应时间短于播放时长"(RTF ≤ 1)口径,4 步 FastH3 在 8×B300 上已做到 10.125 秒视频 8.7 秒出片------数据中心级的"实时"已由 VDN-H3(自家栈)与 FastH3+vLLM-Omni(联合栈)分别达成,硬件门槛不同。
一、先把成本公式拆开
一段视频的端到端延迟可以粗写成:
延迟 ≈ N × max(A(seq²)/ 算力,W(精度)/ 带宽 )+S(系统栈)先声明:这是启发式分解,不是物理定律。max 的两项对应 roofline 模型的两类瓶颈------计算密度与显存带宽,数据中心大卡上 DiT 常偏计算瓶颈,消费级显卡上则几乎总是带宽瓶颈;写成 max 而非连乘,是为了避免暗示"各因子加速倍率可以直接相乘"。末尾的 S 是系统栈开销:编码器驻留、VAE 解码、跨进程传输、MP4 封装。
公式含四个量:N、A、W、S。其中 S 是所有路线共用的底座,由参照系(vLLM-Omni)单独展示;剩下三个因子在优化方向上可分别切入(但不是变量独立的:量化会影响 kernel 效率,稀疏同时减少计算与搬运),三条路线分别占据:
- VDN-H3 改 A:二次 Softmax 换成"局部精确 + 长程线性"混合架构,注意力成本随长度线性增长;
- FastH3 改 N 和 A(唯一动两个因子的路线):蒸馏把 49 次调用压到 4 次(V1)或 8 次(V2),可训练稀疏注意力让每个头只算 20% 的 tile;
- QuantFunc 改 W:16-bit 权重压到 4-bit,显存带宽消耗降到四分之一,8GB 卡也能跑。
而 S 属于所有人共用的底座------这正是 vLLM-Omni 作为"参照系"而非"第四条路线"的原因:它不与你竞争,它决定你怎么计量竞争。
二、路线一:VDN-H3------给视频模型换一套"视网膜"
项目:OpenVDN(UC Berkeley、Impossible、UT Austin 等),代码与训练流程全开源(Apache-2.0),2026 年 9 月 6 日发布博客、代码与权重(I2VA/L2VA/FL2VA 等多模式能力的说明随后几日补充更新),配套 arXiv 论文 2609.20744《Video DeltaNet: A Video-Native Hybrid Attention for Livestream Video Generation》(2026-10-02 已更新至 v3,摘要数字未变;正文已并入 v3 新增的 FastH3 正面对比、Radial Attention 基线与 kernel 级消融)。
2.1 问题:线性注意力直接搬到视频上会崩
前沿 LLM 早已用线性注意力替换 Softmax(Gated DeltaNet、Kimi Linear 等),速度大幅提升,但质量有代价:线性注意力难以在长序列上维持主体身份、场景布局和时间依赖。原因藏在更新规则里------经典 Delta Rule 是逐 token 的梯度下降步:
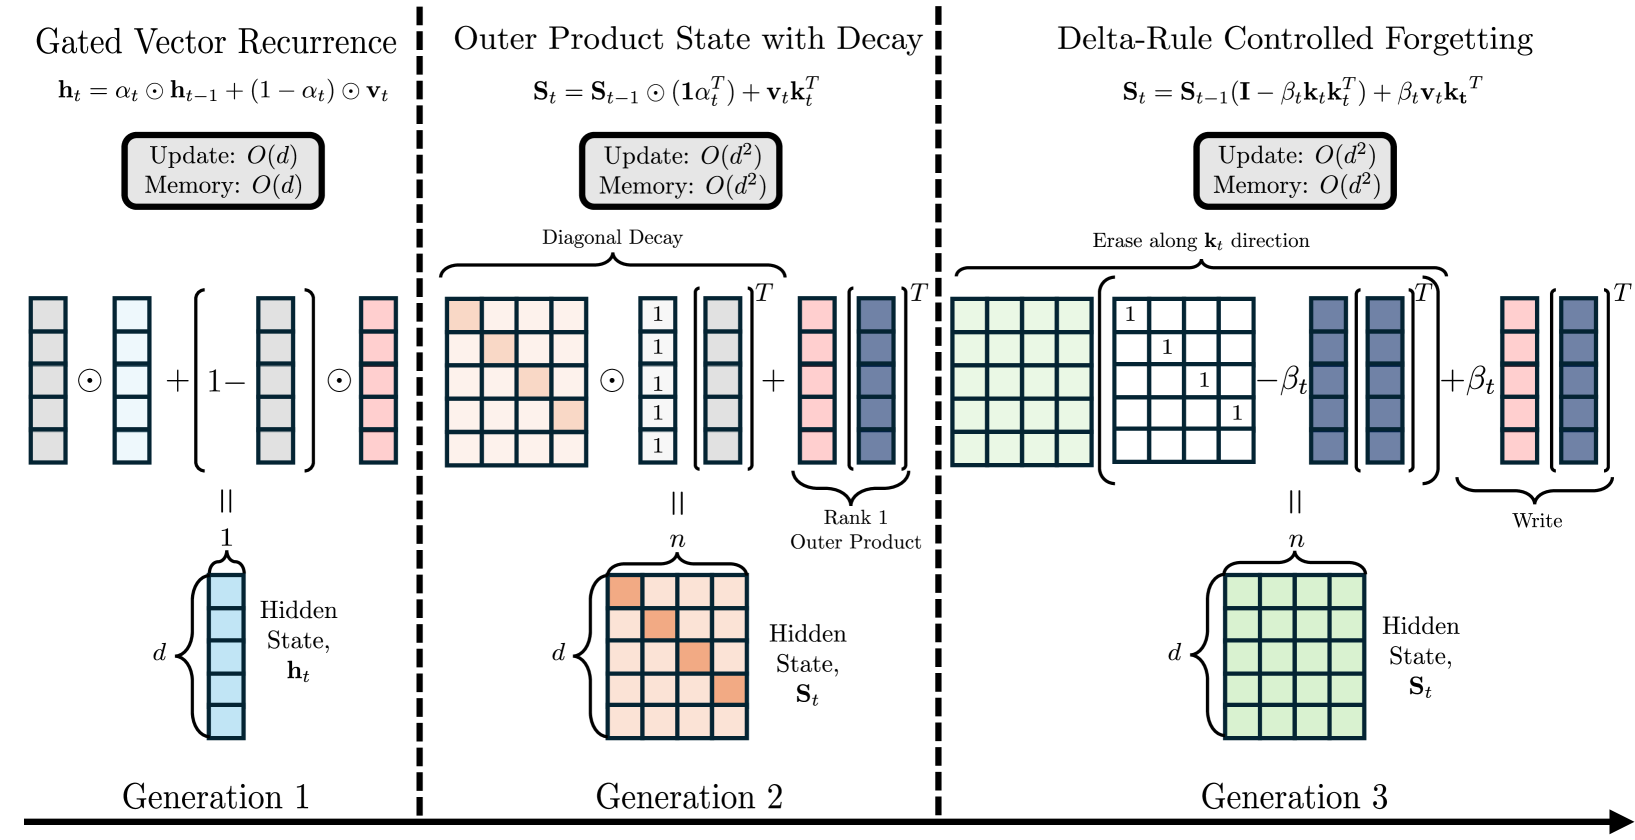
S_t =S̄ +β(v − S̄k)kᵀ (S̄ = 衰减后的旧状态)每个 token 各自从同一个"冻结"的旧状态上读取、写入,互不知晓。视频里一帧有 U 个空间 token,重复纹理(一片天空、一面墙)会让大量 key 高度相关,独立更新只是把冗余证据无脑累加。下图直观展示了三代线性注意力更新规则的差异------从门控向量递推、外积衰减,到沿 key 方向"擦除再写入"的 Delta Rule,状态始终是整个序列共享的一块矩阵:
2.2 VDA:把逐 token 更新变成逐帧"联立求解"
VDN 的核心创新 Video Delta Attention(VDA)只有一步,但性质完全不同:不逐 token 走梯度步,而是把整帧的所有 token 写成一个联合正则化目标,直接解正规方程:
min_S  ½‖S − S̄‖²_F + ½ Σ_u β_u‖Sk_u − v_u‖²
⟹  S_t =(S̄ +B)(I+A)⁻¹,A=KᵀDiag(β)K,B=VᵀDiag(β)K
这一步在谱域上有清晰的几何解释。A 是半正定矩阵,对 A 的第 i 个特征方向,继承状态的乘子是 1/(1+λᵢ):证据稀疏的方向几乎原样保留(→1),证据拥挤(大量 key 共线)的方向被温和压制(→0),永远不会翻转到负值,也永远不超过 1。
对比之下,此前的方案各有妥协:
- GDN/KDA(Kimi Delta Attention)给 key 做单位归一化,保证单 token 不扩张,但帧内 U 个 token 共线时 λᵢ(A) 可达 U,帧级更新可能爆炸;
- SANA-WM 被迫再给 key 乘一个 1/√U 的帧大小因子换取稳定性,代价是每个独立方向也被削弱------重复 key 的方向拿不到"多数票加成",正交 key 的方向被无辜株连。
VDA 的 (I+A)⁻¹ 从观测到的 Gram 谱里"就地取材"------在理想数值条件下(A 半正定、0≤β≤1),对任意 token 数量与对齐方式天然非扩张,且不需要任何尺寸相关的缩放(工程实现中矩阵求逆的条件数仍需关注)。这把线性注意力从"token 级的联想记忆"升级成了"帧级的协商写入"------correlated patches 在更新内部就解开了共享方向。
2.3 混合架构:精确与近似的分工
单有线性分支不够,视频生成需要精确的局部匹配。VDN 把视频-视频注意力拆成两支:
- 局部 Softmax 支:双向滑动窗口(对齐 H3 VAE 的 5 帧 chunk,形成 15 帧窗口),算邻近帧的精确注意力;再加"4 向边界锚点"------每帧可见首末两帧的全部 token,首尾帧也可见所有帧------只增加 3.57% 的注意力密度,却显著稳住长程一致性;
- 长程线性支:双向 VDA。前向状态 S→ 总结窗口之前的帧,反向状态 S← 总结窗口之后的帧,两区域不相交,query 读两侧状态相加,没有任何一帧被重复计入;文本条件在扫描初始化时以 S_T/2 各写一次进两个状态,相加后文本贡献恰好被计一次。
两支输出不做简单相加(量纲不同),而是各自经过内容相关的 sigmoid 门控 + 独立输出投影后汇入残差流。Softmax 门控校准"窗口被裁掉大部分 key 后质量被过度重新分配"的问题;线性支走 RMSNorm + 门控,允许两支住在不同的输出空间里。
必须说清楚的是:精确支只覆盖局部窗口和边界锚点,长程一致性仍依赖线性近似的质量。VDN 对质量的主张不是"近似被精确兜底",而是"局部精确保底 + 长程线性近似"------这正是它必须做重教师对齐训练的根本原因。
2.4 训练:怎么给卡好表的预训练模型动手术
向一个已经校准好的 33B 主干里塞随机初始化的分支,朴素端到端训练会直接毁掉画质。VDN 用三阶段课程:
- A1 逐层对齐(200 步):每个新线性分支单独校准(Taylor-Calibrate 式),拿到更好的初始化,Softmax 门控固定在 0.99 初始值;
- A2 端到端分支适配 (500 步):装配所有混合块联合训练,Softmax 支、QKVO、FFN 全部冻结;
- B LoRA 共适配(2000 步):给 QKV/O 加 LoRA,与线性分支联合微调,其余参数冻结。
论文披露训练数据为 10,015 条 1344×768、345 帧(14.375 秒)视频片段,预编码为视频/音频 latent 与 Qwen3-VL 文本嵌入后缓存------VAE 与文本编码器完全移出训练循环,这让三阶段课程的总成本可控。
一个反直觉的设计:Softmax 门控在 A1/A2 全程冻结。因为在线性分支学好之前,可训练的 Softmax 门控会给优化器一条"偷懒的捷径"------压低原分支的输出就能降 loss,而不是真正学会线性分支。
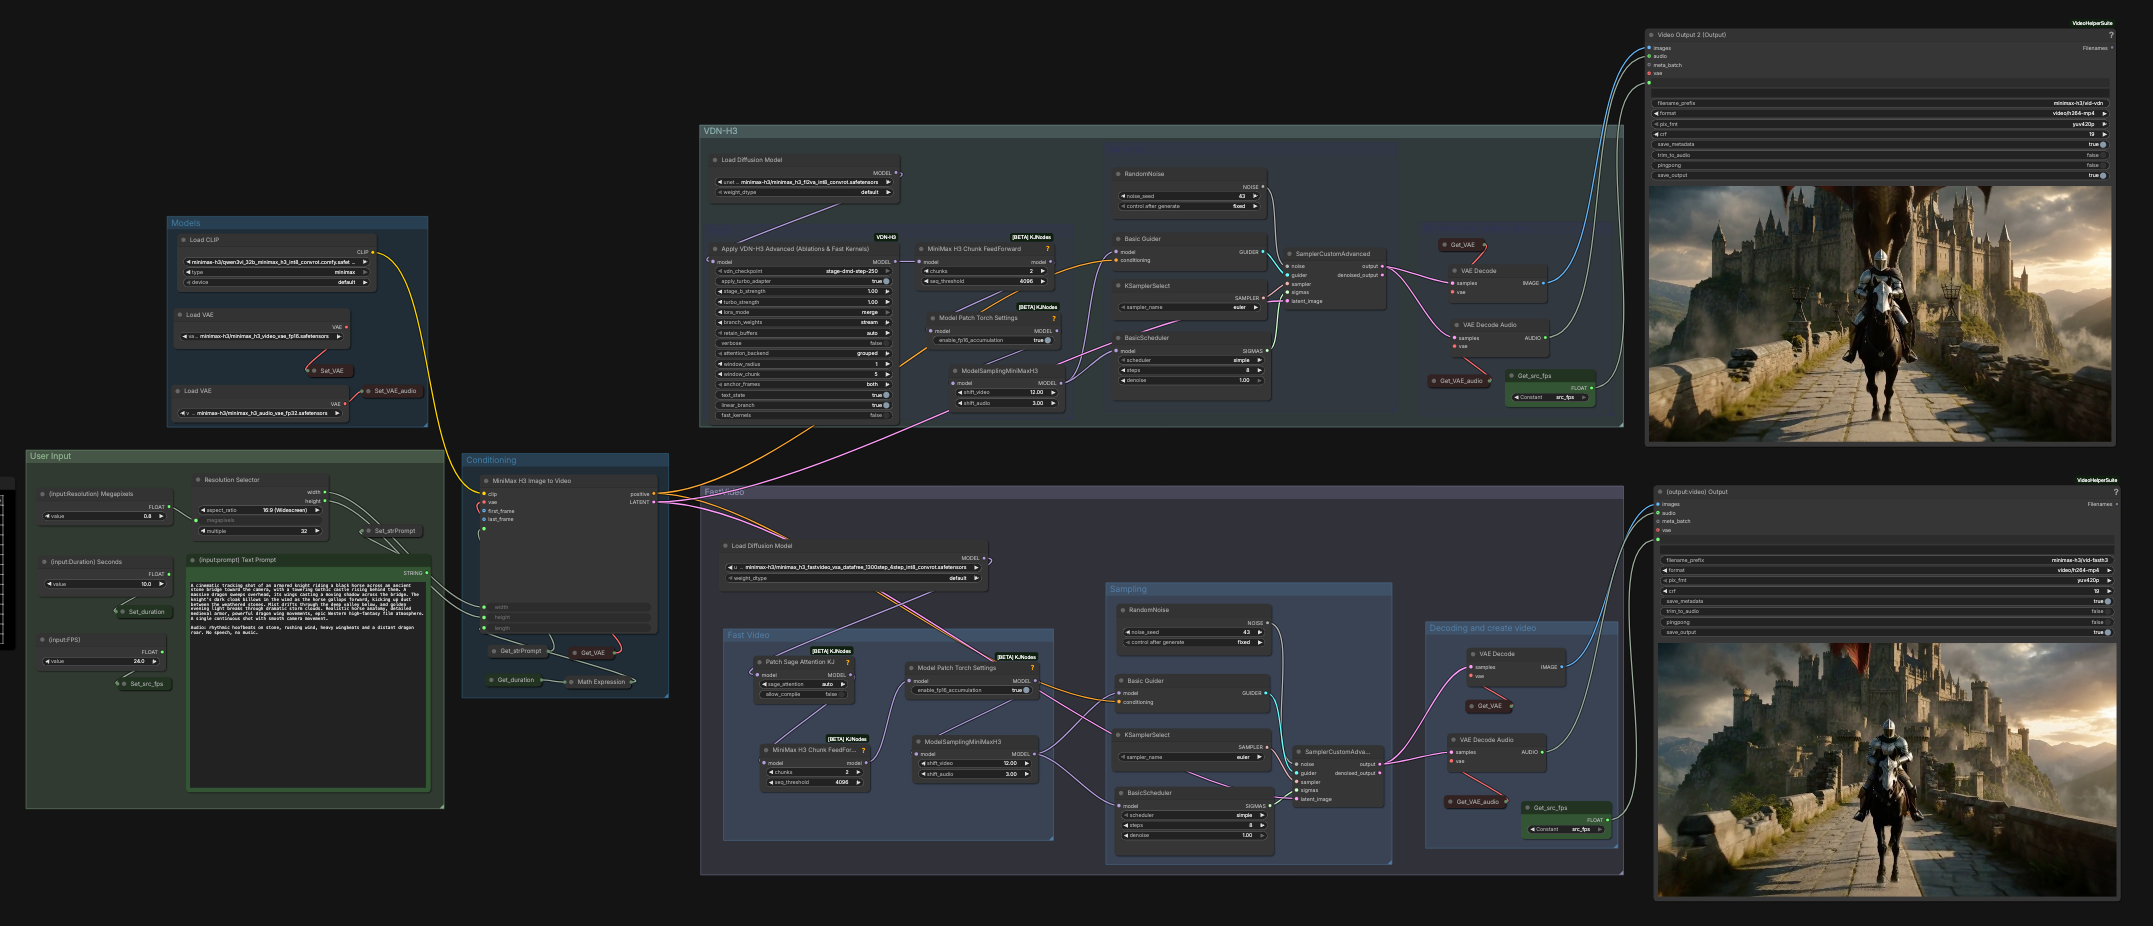
交付物结构很轻:一个独立线性分支 + 两个小 LoRA ,推理时 merge 进主干,原 H3 权重一行不改;同一 checkpoint 同时支持 T2VA / I2VA / L2VA / FL2VA 四种模式。第三方报道补充了单机数字:B200 上 dense 50 步 13.95 分钟 → VDN FP8 5.3 分钟;H200 上 27.3 → 9.4 分钟。社区随后把 VDN-H3 接进了 ComfyUI(runcomfy 等工作流已给出可复现配置):
2.5 数字:50 步是本体,8 步是蒸馏产物
需要澄清一条容易误读的路径:VDN-H3 的架构适配是在 50 NFE 下完成的(先证明混合架构本身不损失质量),之后再用 DMD2(去掉 GAN 项)蒸馏到 8 步 ------学生从社区 LarryVRH 的 H3-Turbo LoRA 初始化,对着 VDN-H3 自己的 50 步采样器训练 250 个 generator 步,把"步数压缩"与"架构转换"解耦;实现上,generator、real-score、fake-score 三个角色共享一个 FSDP 主干、各挂独立适配器,每个 generator 步配 3 次 fake-score 更新。发布物包含 50 步与 8 步两个 checkpoint。
效率链条(14.4 秒、768p 工作负载,345 帧 @ 24fps = 14.375 秒;论文摘要按 14.3 秒计):
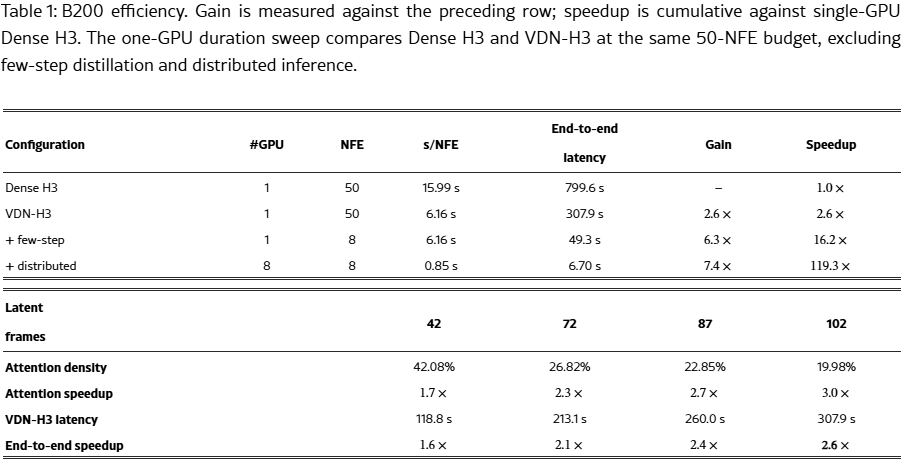
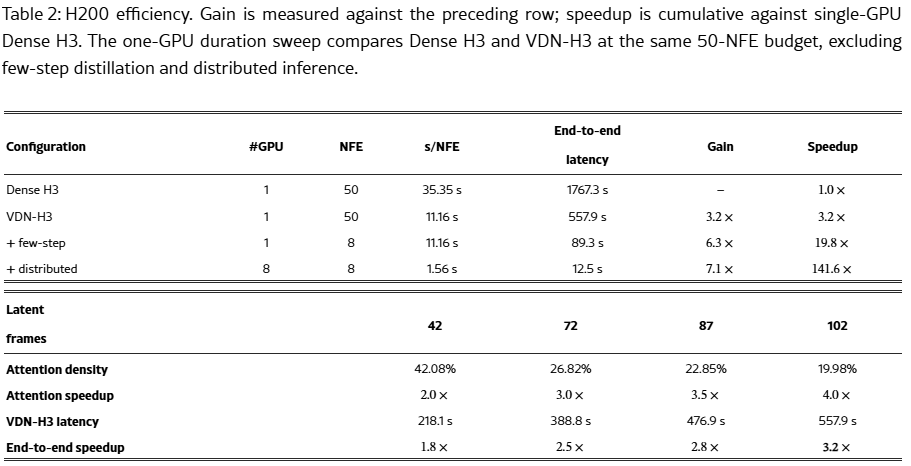
- 仅架构改造:单 B200 单次前向 16.0s → 6.2s(2.6× ),单 H200 35.35s → 11.16s(3.2× );序列从 42 帧拉长到 102 帧时,Softmax 注意力密度从 42.1% 降至 20.0%,全骨干加速从 1.6× 升到 2.6×(B200)、1.8× 升到 3.2×(H200)------越长越快是线性化的标志性特征;
- 叠加 8 步蒸馏:单 B200 去噪 307.9s → 49.3s;
- 再叠加 8 卡推理:官方博客口径为 DiT 去噪 6.9s (8×H200 为 12.5s)、端到端约 9.0s ,比播放速度还快(论文表格中 8 卡去噪 6.70s 为另一测量口径,与博客的 6.9s 属同一量级)。对同卡数 50 步 Dense H3 为 14.5×。第三方报道提醒:宣传中的 74.5× 是 8 卡并行 + FA4 + FP8 + 8 步蒸馏的组合数字,单机架构改造的真实幅度就是 2.6× 左右。
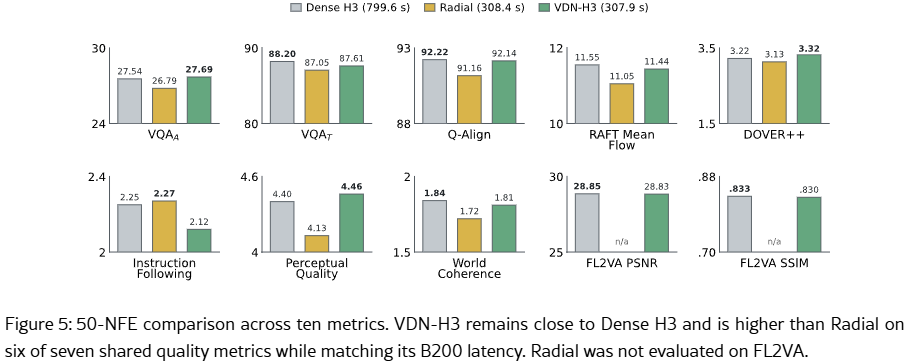
质量方面(固定第三方 103 prompt 基准,50 NFE):VDN-H3 与 50 步 Dense H3 在十项指标上互有胜负但差距微小------Q-Align 差 0.08、FIRM 世界一致性差 0.03、FL2VA PSNR 差 0.02dB、SSIM 差 0.0024,同时在 VQAA、DOVER++、FIRM 感知质量三项上反超;对免训练的稀疏基线 Radial Attention(密度对齐到同等延迟)在七个共享指标上赢六个。注意这是作者自家基准上的结果。
2.6 与 FastH3 的正面对比,以及 kernel 级消融
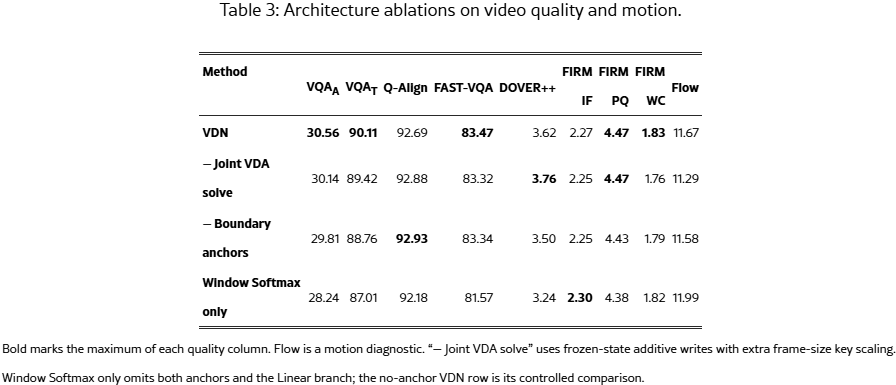
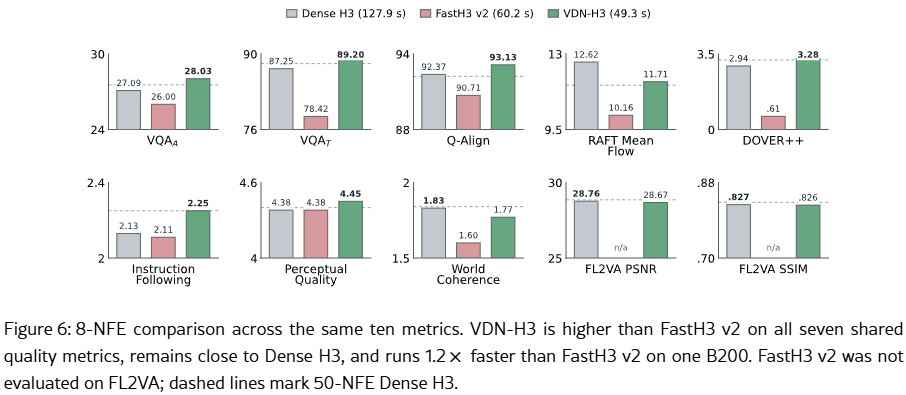
v3 论文新增了与同代加速路线的正面对比(同为作者自家基准,单方数据):8 NFE 下,VDN-H3 在七项共享质量指标上全部高于 FastH3 v2 ------VQAT 领先 10.78 分、DOVER++ 领先 2.67 分------同时在单张 B200 上比 FastH3 v2 再快 1.2×;4 NFE 下对 FastH3 v1 的 VQAT 领先达 12.64 分,FL2VA 端点保真也更好。架构消融同样提供了量化证据:把 VDA 的联合求解换回"冻结状态 + 1/√U 缩放"的逐 token 加性写入,八项指标输掉五项(VQAA -0.42、VQAT -0.69);去掉边界锚点,VQAT 掉 1.35 分;去掉线性支只留窗口 Softmax,VQAA 掉 1.57 分------混合架构的两个支、一类锚点,各自都有不可替代的消融证据。
论文还罕见地公开了 kernel 级消融,说明架构红利是如何被工程兑现的:四个融合 Triton kernel 中,VDA-Prep 把 H200 上 18.0ms 的 K/V 数据准备压到 1.6ms;逐帧小矩阵求逆用单 kernel 寄存器内高斯-约当消元替代多 kernel Cholesky 路径,提速 4.6--5.0×;chunk 级转移矩阵组合把双向扫描从 4.6ms 压到 1.1ms(8 卡、每卡 7 头);窗口 Softmax 用 varlen 打包从 69.5ms 压到 56.1ms(B200)。一句话:线性化吃掉的是渐近复杂度,毫秒级吃掉的却是常数因子,两者相乘才是 2.6×。
需要两句限定:以上对比全部出自 VDN 论文 v3 的自有基准(固定 103 prompt),FastH3 官方未在相同基准上回应,宜视为单方数据;且两者的部署场景并不完全重叠------FastH3 的强项在于与 vLLM 生产栈的深度集成(RTF 0.86 的完整响应实时)和已成的 ComfyUI 生态,VDN-H3 则胜在四任务覆盖与注意力复杂度的根治。并列呈现不等于分胜负。
三、路线二:FastH3------压缩步数,也用训练换稀疏
项目:FastVideo(Hao AI Lab)+ Nuva Lab + NVIDIA FastGen,2026-08-27 发布 4 步 V1,随后推出 8 步 V2;vLLM 团队于 9 月初将其接入 vLLM-Omni 生产服务栈。
3.1 双管齐下:49 次调用砍到 4 次(V1),再回退到 8 次(V2)
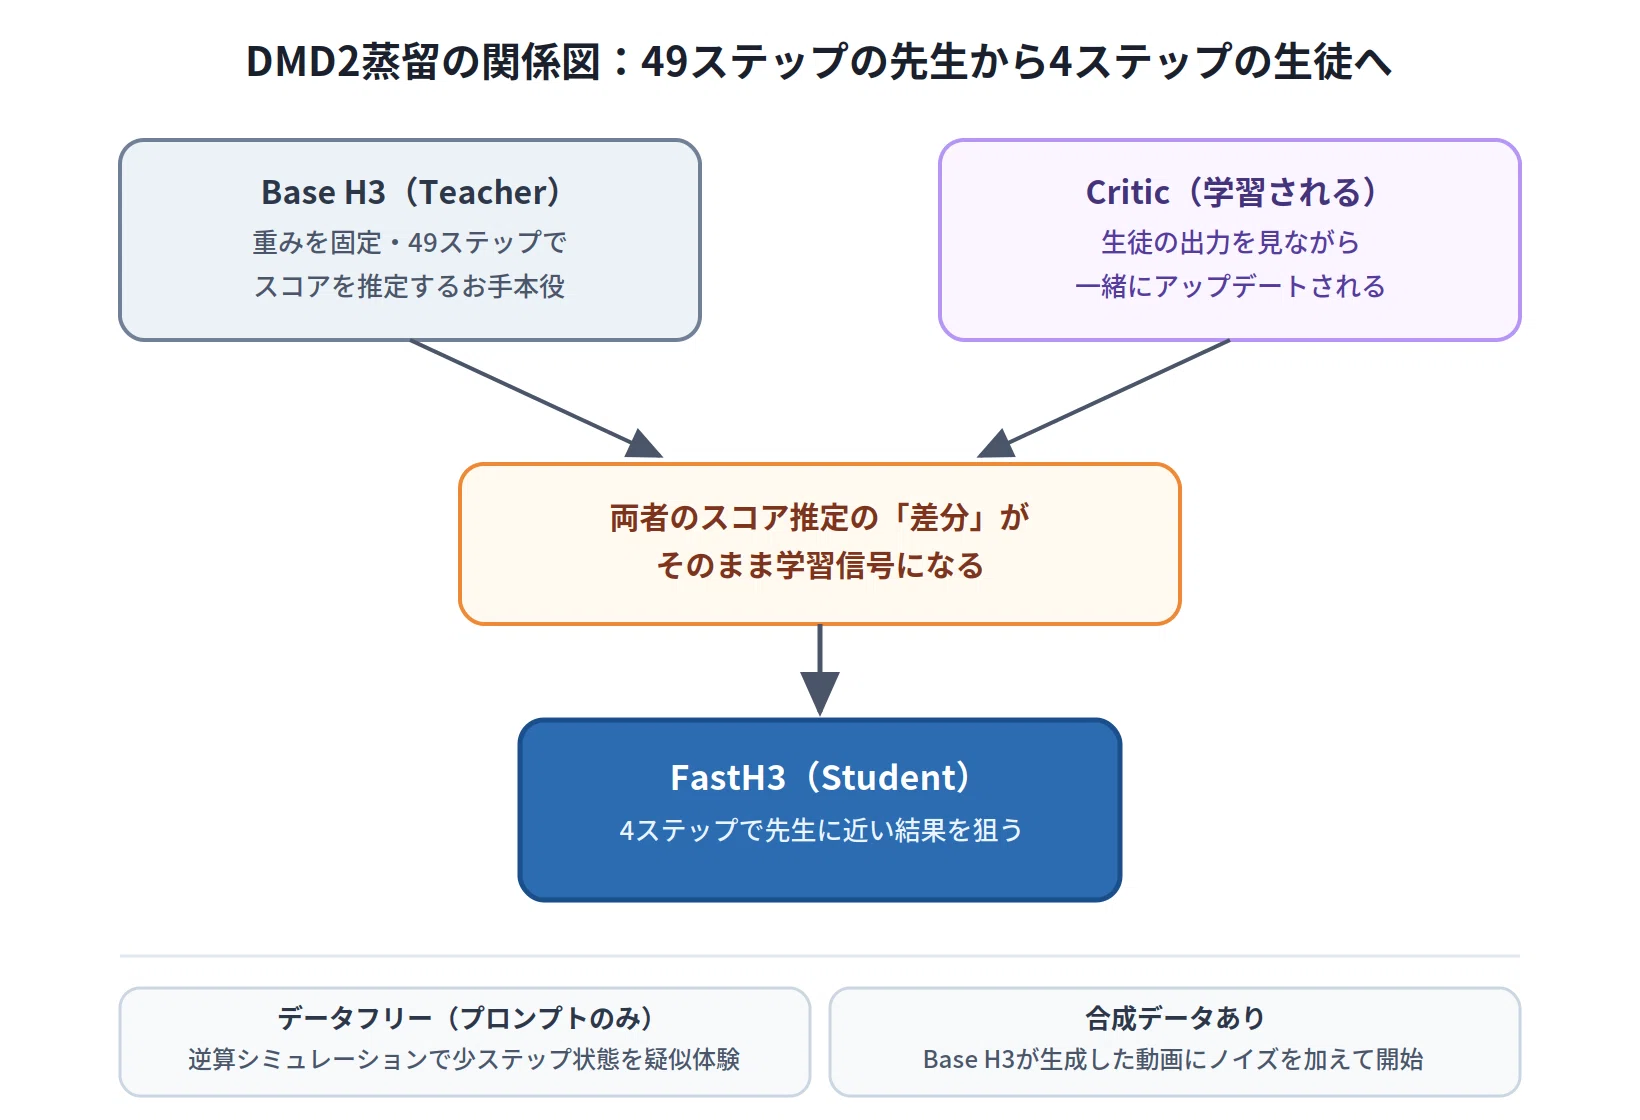
H3 的标准调度是 50 个 sigma 点、49 次 DiT 前向。FastH3 的第一刀是 DMD2 蒸馏:冻结的 Base H3 教师 + 一个可学习 critic,用二者 score 估计之差当训练信号。特别之处在于 data-free:只用文本 prompt、不用任何真实视频------"backward simulation"让学生在自己推理时真正会走到的少步状态上训练(V2 为 8 次前向,采样阶梯对应 step-1300 checkpoint,scheduler shift 从基座的 12 改为 10),避免训练/推理分布错位。
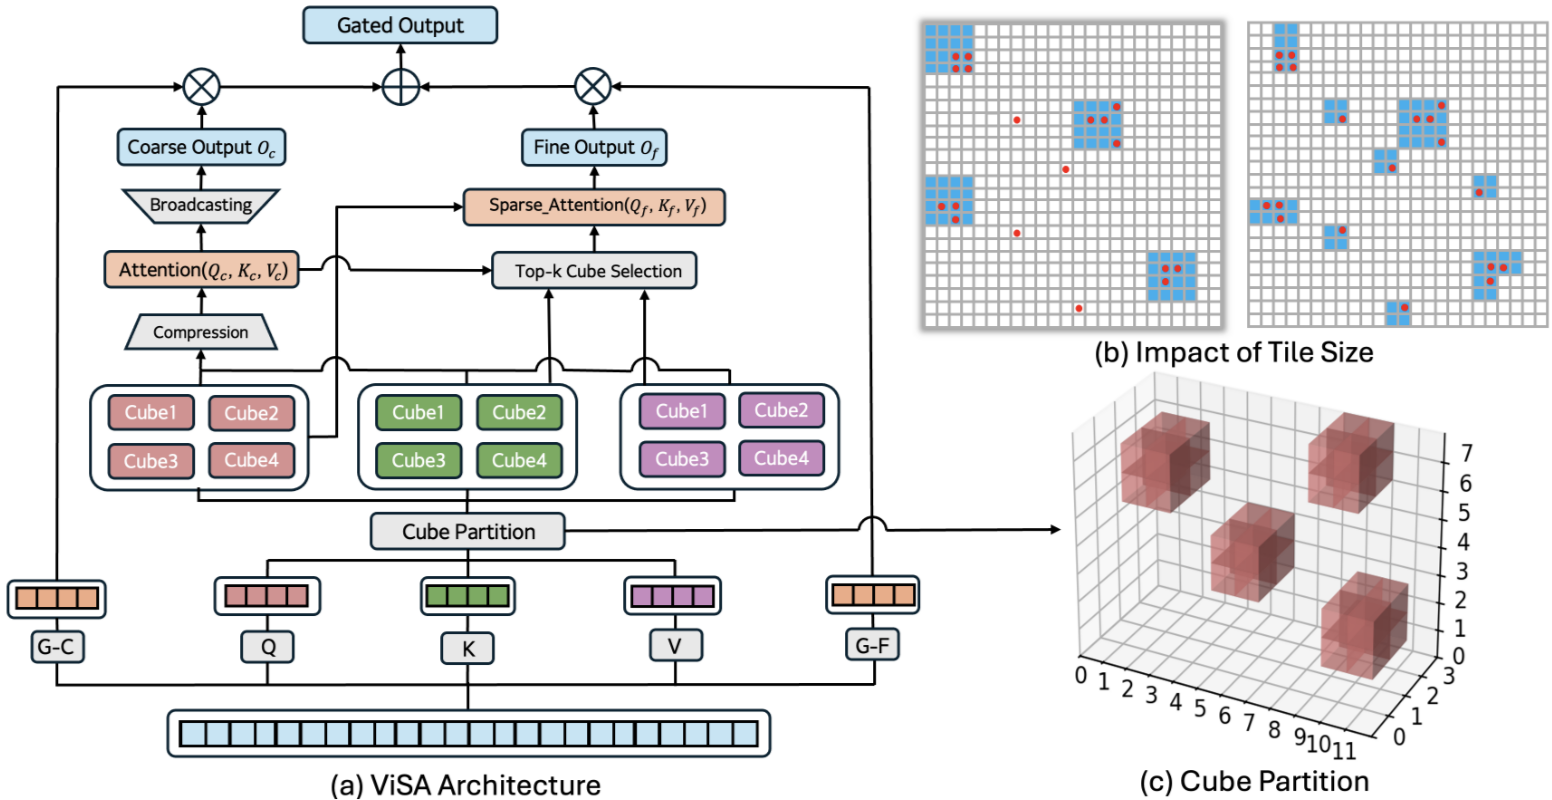
第二刀更激进:VSA-H3 可训练稀疏注意力 。每个注意力块加一个轻量打分层,把 packed 序列切成 64-token 的 4×4×4 三维 tile(视频 token 天然是时空立方体),视频 query 只为 top-64 个视频 tile 和全部前缀 tile 算注意力;文本/条件/音频保持 dense。V1 训练在 90% 稀疏度,V2 回退到 80% 稀疏 + 8 步------用一点速度换质量,是官方对 4 步 preview 质量局限的坦率回应。
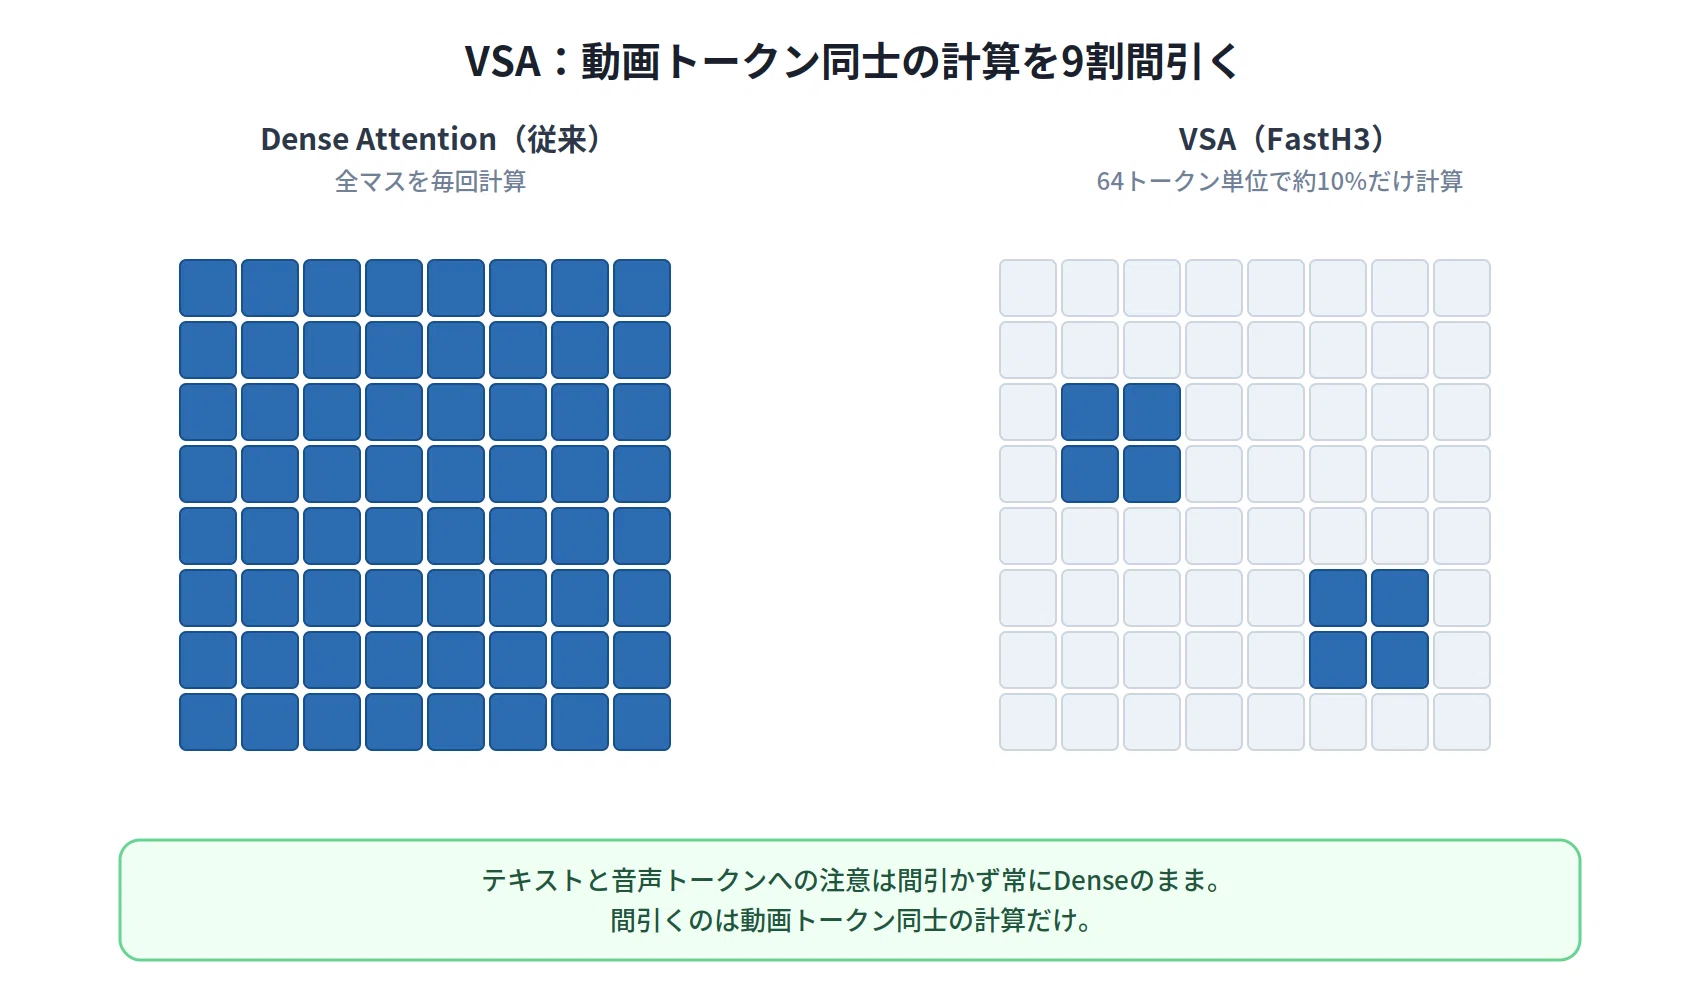
一个关键细节:教师和 critic 全程 dense。稀疏学生永远对着"全量正确答案"学习,这让 90% 的注意力省略有了可靠的质量锚点------这与"先训 dense 再事后剪枝"的稀疏方法有本质区别:稀疏模式从训练第一天就是模型工作点的一部分。
3.2 数字与代价
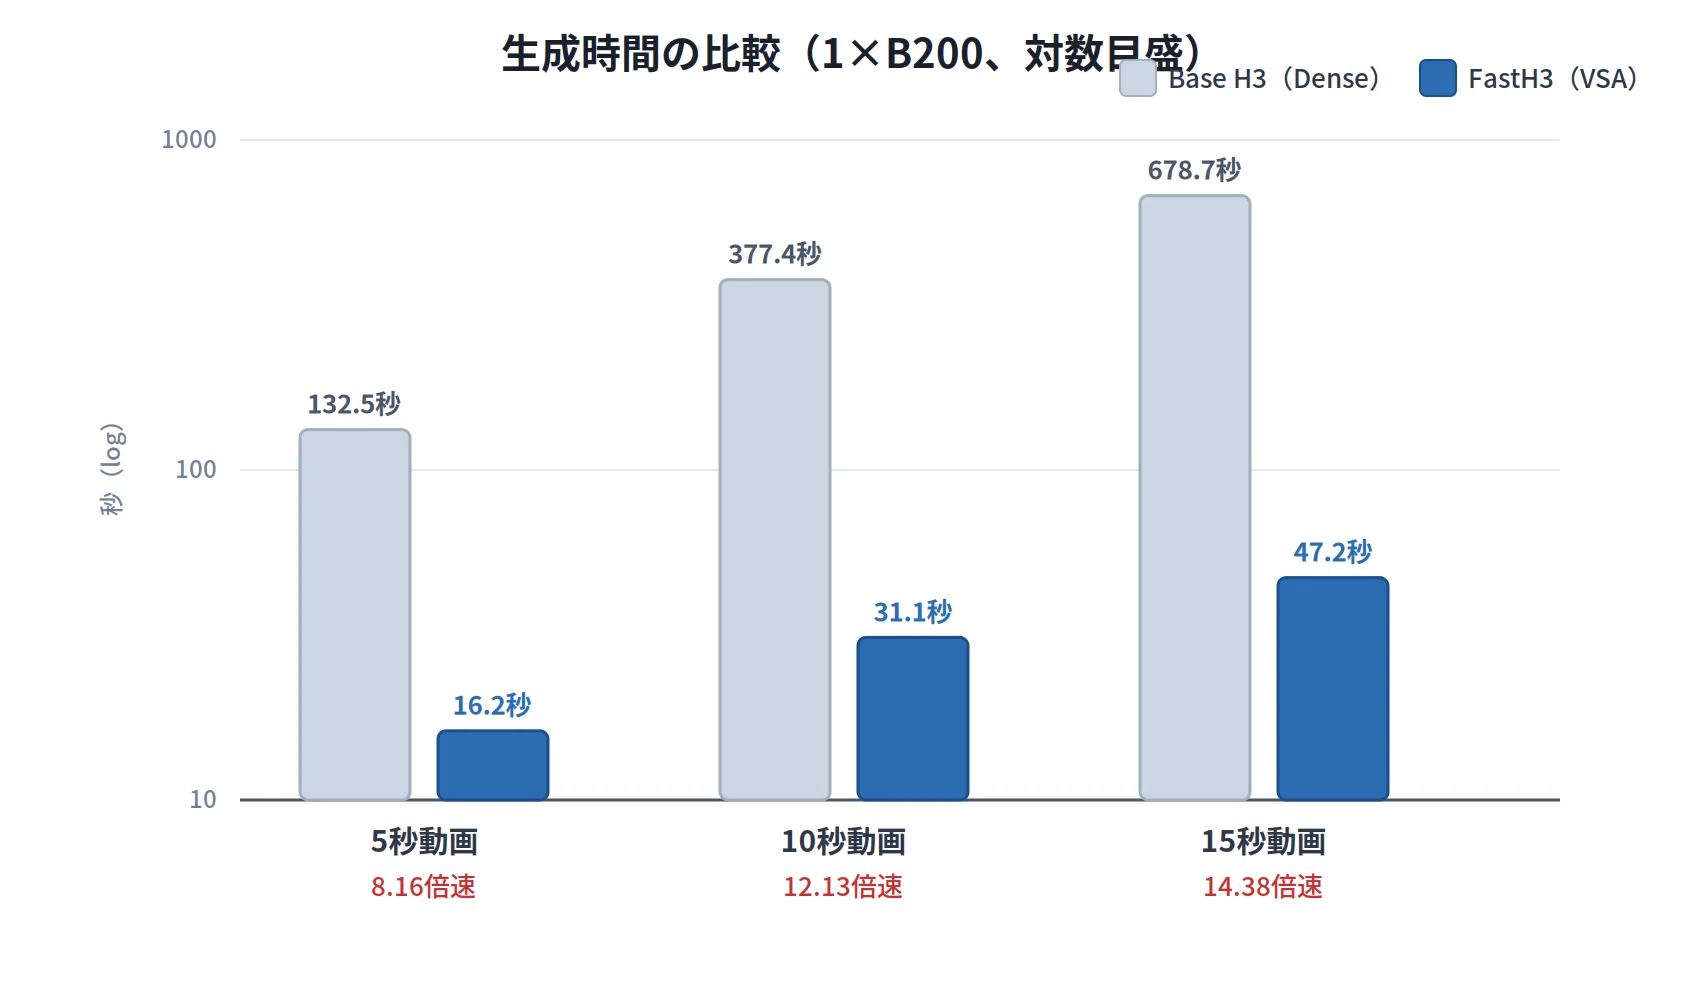
B200 上 15 秒 768p 视频端到端(FastVideo 自家栈):单卡 47.2s(14.38×),8 卡 12.88s------已经比播放快。官方博客明确写道训练使用了 1k+ B200 卡时(出处:FastVideo 官方博客《FastH3 Preview v1》TL;DR 段)。
代价也要客观列出:V2 只蒸馏了 T2VA,FL2VA/Ref2VA 还在开发;官方明说难动作、细细节和部分音频可能落后基座;推理被深度绑死在 FastVideo 栈上(tile-64 CUDA/Triton kernel、区域化 compile、FA4、纯 Ulysses 序列并行)。
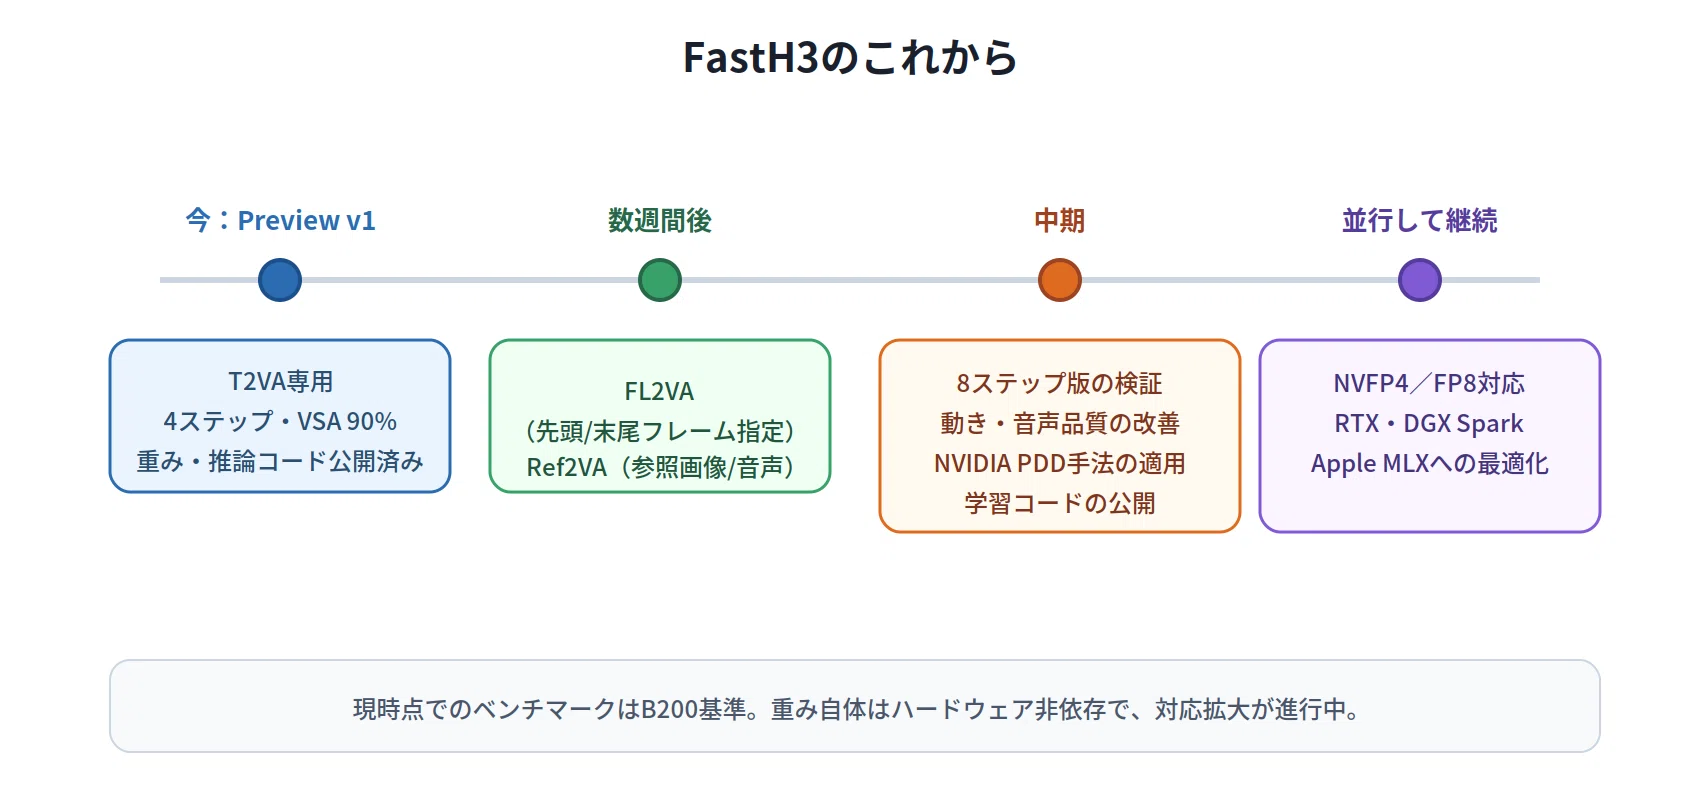
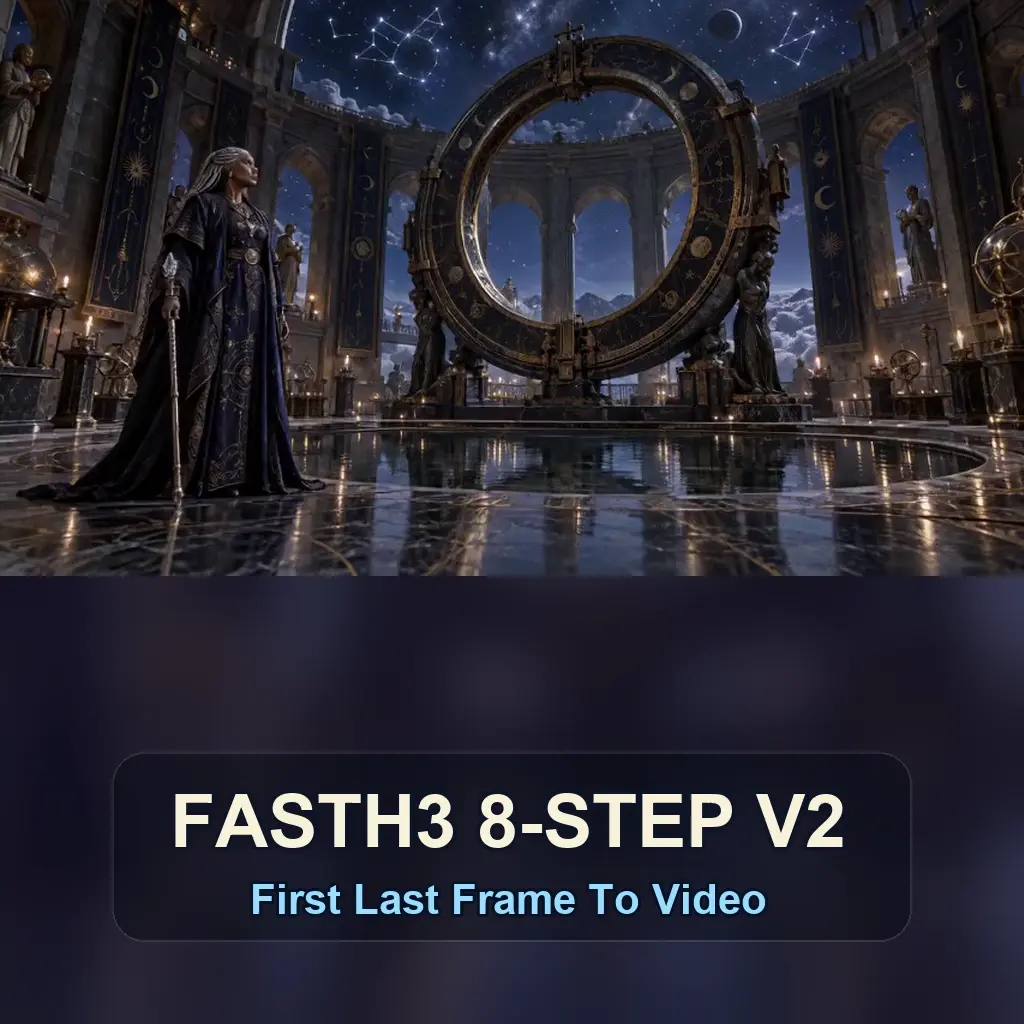
社区工作流的生成帧。需要说明:官方 V2 发布时仅蒸馏了 T2VA,FL2VA 属于后续扩展,故该图展示的是"FastH3 蒸馏权重 + 社区工作流"的组合效果,而非 V2 官方发布物。
3.3 被低估的一环:FastH3 不是 LoRA,而是一纸"serving contract"
vLLM-Omni 的集成文档披露了两个此前容易被忽略的事实:
- FastH3 的 artifact 不是普通 LoRA 。除低秩因子外,它携带 full-rank delta 与替换权重------普通 LoRA 层无法表达------所以 vLLM 选择在权重流入时先做融合再切分,而不是按请求热切换。这解释了为什么 FastH3 的加速无法像 LoRA 那样"即插即用"。
- 组合兼容性有硬性边界 :FastH3 + VSA 仅在 CUDA + fastvideo-kernel + 纯 Ulysses(Ring/AllGather 被拒绝)下受支持;FastH3 + DLO(层式 offload)明确不支持;FastH3 + 分离式编码器尚未验证。
四、路线三:QuantFunc 4bit------不动数学,动数字
项目:QuantFunc(商业推理引擎公司),2026-09-28 发布 H3 量化版。值得注意的是,H3 只是其模型库的一员:官网列出的支持列表包括 Flux.1-dev、SDXL、Wan、LTX-2.5、Krea-2、HiDream、Qwen-Image-2.1、Stable Audio、MusicGen、ACE-Step 等十余个模型------视频量化是它的一个产品线,不是全部。
4.1 技术:W4A4 与"小显存流式"
前两条路线都在"改模型",QuantFunc 的哲学相反:模型数学一行不改,只把承载数字的比特数砍下来。DiT 推理在消费级显卡上是权重带宽受限的------33B 参数的 16-bit 权重每步都要从显存完整过一遍。H3 版把核心权重和激活压到 4-bit(W4A4 INT4,SVDQuant rank-128、group size 64),核心权重视野降到原来的四分之一,代价是同 prompt 同 seed 下约 23.7dB PSNR 的有损扰动,属于可控、有界的数值误差。
两个工程点(出处均为 QuantFunc 官网与模型卡):
- 小显存卡运行:官网明确写道,显卡装不下全部权重时,引擎会从系统内存流式补给而不是直接报错,模型参与 ComfyUI 自身的显存管理------口号是"让消费级显卡跑起过去要 24GB 的模型"(具体调度细节未公开);
- 组件级精度特化:Token Refiner、Refiner 用 INT4,Conv Sidecar 用 INT8,adaLN 折叠进 fp16(输出相对误差 ~7.58e-4),CUDA 12/13 预编译 kernel 覆盖 SM75+、零 JIT 卡顿。
4.2 数字与口径
官方口径(RTX 4090,同模型 FP8 对照,768×768、124 帧单步):MiniMax-H3 3.2s vs FP8 10.2s(3.19×) ;兄弟模型 Krea-2 去噪 3.13×。注意:11× 是 Krea-2 在 8/12GB 小显存卡上的数字,不是 H3------H3 在 4090 上就是 3.19×。发布物为 FL2VA 4 步 / Ref2VA 8 步两个变体,加速 LoRA、Token Refiner、INT4 Refiner 全部预熔进权重。这些数字全部来自厂商自家对比表,宜谨慎引用。
4.3 商业模式:免费插件 + 付费 SDK 的"剃刀-刀片"
QuantFunc 的商业逻辑很直接:4-bit 把权重体积砍到四分之一 → 8GB 卡跑得动 → 免费插件(免费、不限量)扩大装机基数 → 付费 SDK / API($20/月单设备起)变现。表面卖的是"4-bit",实质是"同卡几倍速 + 不操心"的一站式交付。
4.4 效果:INT4 直出 showcase
以下四帧均为 INT4 量化权重直接生成(896×1184、124 帧,来源:QuantFunc 官方模型卡):
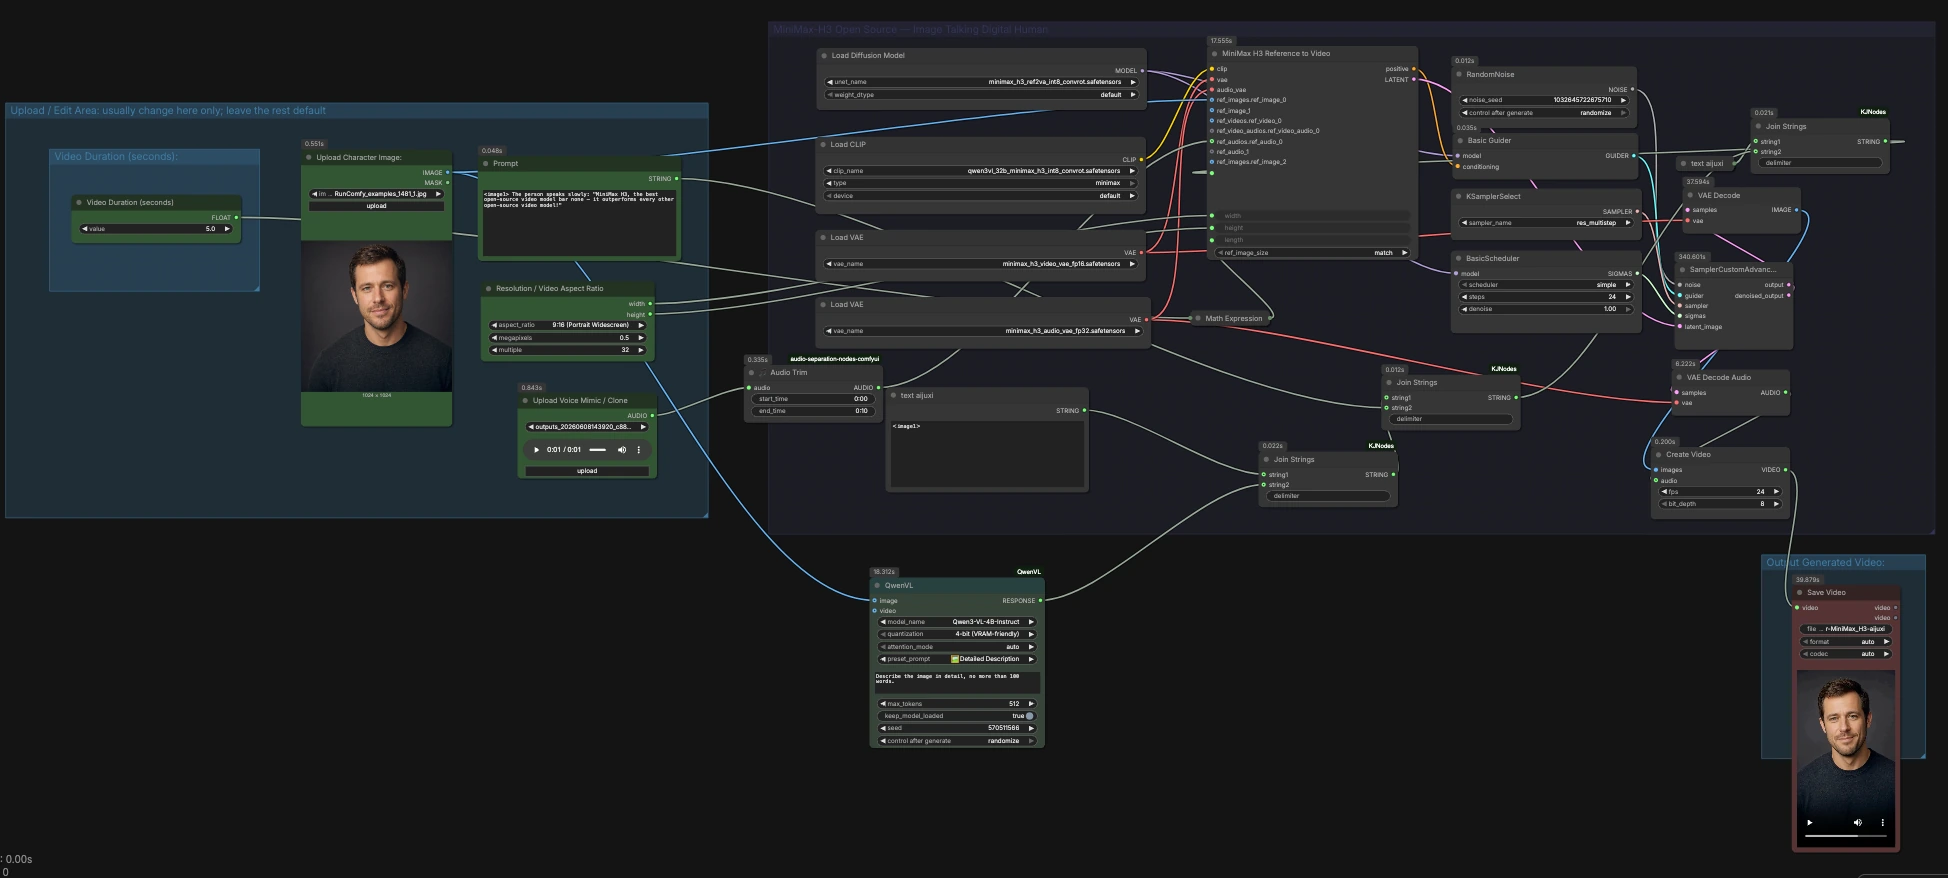
消费端生态也在快速成形------ComfyUI 官方 MiniMax-H3 工作流已支持社区加速 checkpoint,下面是社区 H3 工作流在 ComfyUI 中的完整节点图(数字人语音克隆示例):
五、参照系:vLLM-Omni 给出的三个坐标
在评估三条路线之前,必须先看清牌桌本身。vLLM 团队 9 月的博客用 8×B300 的冻结对照实验证明:一行模型不改,纯系统栈优化(注意力通信、算子融合、VAE 并行解码、uint8 输出传输减 75% 负载、直写 planar H.264)就能从 Diffusers 的 82.2s 挤出 56.9s 端到端,1.445× 且零质量损失(vLLM 官方博客实测表)。它给所有倍率数字提供了三个坐标:
- 参照系坐标:任何改模型的方法,至少要先证明自己比"什么都不改、只换好栈"更值得。三条路线都缺少"无损回退到通用栈且保留全部加速"的路径------VDN 离开专用 backend 分支会被静默跳过,FastH3 离开 fastvideo-kernel 跑不起来,QuantFunc 权重离开自家 loader 读不出来。这不是态度问题,是架构使然;它构成一道阶段性迁移成本,能否沉淀为长期壁垒,取决于各家栈被复现和标准化的难度。
- 证据纪律坐标 :vLLM 博客使用冻结的 SHA、prompt、seed,两条实验车道(base 系统优化 vs FastH3)分开报告,在得到同源 A/B 之前拒绝推导 base→FastH3 的倍率------并明确把"实时"定义为完整 MP4 响应(含音频、封装)短于播放时长,而非首帧延迟。这种克制在倍率通胀的当下并不多见。
- 叠加边界坐标 :同一栈上,4 次前向的 FastH3 产出完整 10.125 秒 MP4 仅 8.678--8.710 秒(RTF≈0.86)------但兼容性有硬性边界:FastH3 + VSA 要纯 Ulysses,FastH3 + DLO 明确不支持,分离式编码器尚未验证。
这也回答了"叠加之后瓶颈去哪了":base 车道里 DiT 占总端到端的 91%(51.8/56.9s),FastH3 车道里 4 次前向只剩约 4 秒,非 DiT 部分(双 VAE 解码、音频、传输、封装)占比过半------需要加限定:这一瓶颈转移只在 FastH3+vLLM 这种最激进的组合下成立------对 VDN-H3(DiT 去噪占端到端约 77%:6.9/9.0s)和 QuantFunc 的消费卡场景(DiT 单步 × 步数是绝对大头),DiT 仍是主要成本。"战场离开 Transformer"不是普遍结论,而是最激进组合的专属风景。
六、对照表:三个模型侧因子、三条路线、一个参照系
| 维度 | VDN-H3 | FastH3(V1 4 步 / V2 8 步) | QuantFunc 4bit |
|---|---|---|---|
| 切入因子 | 架构 A:O(n²)→O(n) | 步数 N(49→4/8)× 注意力 A(−80%) | 带宽 W:16bit→4bit + 小显存流式 |
| 模型数学 | 改(新增线性分支) | 不改拓扑,改训练目标 | 完全不改 |
| 训练成本 | 高(A1 200 / A2 500 / B 2000 步 + 蒸馏 250 步,未公开卡时) | 官方公开 1k+ B200 卡时(与步数口径不同,不宜直接排名) | 极低(data-free 量化) |
| 质量主张 | 自家基准上持平或略超 50 步 Dense | preview 级:VQAT 落后 Dense 2.7--12.7 分(单方基准†) | 23.7dB PSNR 的有界误差 |
| 典型质量风险 | 超长视频长程一致性的渐进漂移(线性近似固有) | 快速运动模糊、动作幅度不足(RAFT 9.19 vs 11.55 px)、音频细节 | 色彩偏移与细节噪点(4-bit 数值噪声) |
| 推理栈耦合 | SGLang 专用 backend | fastvideo-kernel + artifact 加载时融合 | 私有 sealed 格式 + loader |
| 硬件取向 | 数据中心 8×B200 | 数据中心 B200/B300 为主 | 消费卡优先(8GB 起) |
| 覆盖任务 | 四种模式同 checkpoint | 仅 T2VA(V2) | FL2VA / Ref2VA |
| 代表数字 | 去噪 6.9s(8×B200,8 步,14.5×) | 15s 视频 47.2s/12.88s(1/8×B200 自家栈);8.7s 出 10.1s MP4(+vLLM 联合栈,RTF 0.86) | 单步 3.2s(4090,3.19× vs FP8) |
† 该对比出自 VDN 论文在其自有基准(固定 103 prompt)上的测试,FastH3 官方未在相同基准上回应,宜视为单方数据。另:三条路线的倍率均依赖各自运行栈,跨栈比较请先回到第五节参照系。
失败案例:这些路线都是被失败雕刻出来的
只看成功面会高估这些方法的必然性。前三个是技术路线 的失败,第四个是测量方法论的失败------性质不同,但同样塑造了今天的格局:
- 失败一:线性注意力直接替换 Softmax。视频 DiT 的多次尝试(如 M4V 的 Mamba 路线)表明直接替换在长视频上画质明显退化,主体身份和场景布局维持不住。VDN 的答案不是"替换"而是"混合"------精确支保住局部,线性支吃掉长程。
- 失败二:4 步 + 90% 稀疏推得太狠。FastH3 V1 的极限配置在难动作和细细节上露了怯,V2 主动回退到 8 步 + 80% 稀疏。这种"官方回退换质量"的做法在报道中并不多见。
- 失败三:事后剪枝式稀疏。先 dense 训练再 mask 的做法在视频 DiT 上质量不稳,VSA 的应对是让稀疏模式从训练第一天就成为模型的工作点,且教师永远 dense。
- 失败四:用"倍率"代替"口径"。vLLM 的"证据契约"(冻结 SHA/prompt/seed、车道分离、不混算倍率)本质上是把行业常见的失败模式写成了反例教材。
共识与差别
两个真正的共识 :其一,三条路线共享同一个瓶颈背景------长序列下的二次计算成本与权重带宽墙------但火力落点不同:VDN 和 FastH3 直接改注意力(结构、参与范围),QuantFunc 则绕开注意力、从权重与激活精度侧面切入;其二,倍率必须连同运行时一起读------VDN 需要专用 backend,FastH3 需要专用 kernel 与加载时融合,QuantFunc 需要私有 loader。一个值得注意的动向是:VDN 论文致谢里出现了 Kernel Design Agents(kernel 设计智能体)------连 kernel 都开始用 AI 设计了,算法与 kernel 一体化的门槛正在从人力转向算力与数据。
三种不同的"守恒":VDN 守质量守恒(架构换复杂度,训练工程最重,赌"线性注意力视频化"终将接管视频 DiT);FastH3 守算力守恒(以 1k+ B200 卡时的蒸馏预算压缩推理成本,赌蒸馏+可学习稀疏的配方可以流水线化复制到下一个模型);QuantFunc 守恒带宽(显存越小杠杆越大,赌"精度换带宽"永远有市场------因为消费显存的增速追不上模型权重的增速)。
"可分离"的另一面:叠加已发生,无缝叠加未验证
三个因子概念上可分离,工程兼容性却是另一回事:VDN 的线性分支要 SGLang backend,FastH3 的 VSA 要 fastvideo-kernel,两者同驻一个推理进程时栈复杂度会非线性上升;QuantFunc 的 sealed 格式预熔了 LoRA,想再叠加 VDN 的适配器就要先过格式关;vLLM 的兼容性矩阵更是白纸黑字(第五节)。目前可见的"叠加"都是串行式的:QuantFunc 量化别人蒸馏好的权重、社区量化 VDN-H3(drbaph 的预量化 INT8 ConvRot 版,线性分支再提速 2.7×)、vLLM 融合 FastH3 artifact 进自家栈。三条方法同时落在一个 checkpoint 且各自拿到全部加速------还没有人完整做过。
七、尾声:开源权重引发的"分工大爆炸",以及一个被算账修正的预测
H3 开源后两个月内发生的事几乎是一次完整的技术史样本:基础模型一开放,优化市场立刻沿"架构---蒸馏---量化"三个方向分层,学术团队做架构、研究 lab 做蒸馏流水线、商业公司做量化引擎,每层都有清晰的守恒律,各层通过 checkpoint 格式与推理栈接口互相啮合;而开源 serving 社区把"无损基线"抬到了 1.445×,让所有人心里的尺子变长了。
壁垒的悬念也埋在这里:VDN 依赖三阶段课程的重训练工程,FastH3 依赖千卡时级蒸馏预算,QuantFunc 依赖私有格式与免费+付费 SDK 的转化漏斗------三种壁垒,三种被商品化(commoditize)的路径:课程式适配正被自动化工具简化,蒸馏预算可能被 Parallel Decoding Distillation(PDD,并行解码蒸馏)这类新算法压缩(FastH3 路线图已列出与 NVIDIA FastGen 的合作),私有格式永远面临下一个开源替代。谁先被商品化,谁就失去定价权。
至于"个人设备上实时生成带声音的视频"------先算账再下结论,而且这次要把口径算对:QuantFunc 的 3.2 秒/步测于 768×768、124 帧(按 24fps 约 5 秒视频),生成 14 秒视频时序列更长、单步只会更慢------就算乐观地按 3.2 秒/步、8 步估算,DiT 也要约 26 秒,加 VAE 与音频逼近半分钟,这已是下界 ;距"实时"(生成时间 ≤ 视频时长)约两倍,若按直播级低延迟(秒级出片)衡量差距更大。而数据中心一侧,vLLM-Omni + 4 步 FastH3 已把"完整响应实时"(RTF 0.86)做成冻结可复现的测量值。个人实时生成需要三个模型侧因子(N/A/W)同时再进一步,还要 VAE 与音频管线的同步瘦身------VDN 论文把下一代目标直接写进了标题:Livestream Video Generation(直播级视频生成)。成本结构已被改写,主要坐标已经点亮,但终局尚未到来:架构买长度,蒸馏买步数,量化买显存,系统工程兜底其余。
创作不易,禁止抄袭,转载请附上原文标题及其链接
参考来源
- OpenVDN 官方博客:https://openvdn.github.io/ ;VDN-H3 论文:Xi et al., arXiv:2609.20744
- FastVideo 官方博客:https://haoailab.com/blogs/fasth3-preview/
- QuantFunc 官网:https://www.quantfunc.com/ ;Hugging Face 模型卡:QuantFunc/Minimax-H3-Quantfunc-4bit
- vLLM 博客:《MiniMax H3 on vLLM-Omni》,https://vllm.ai/blog/2026-09-01-minimax-h3-production-serving
- MiniMax 官方集成列表:https://github.com/MiniMax-AI/awesome-minimax-h3-integration
- VSA 论文:Zhang et al., arXiv:2505.13389;DMD2 论文:Yin et al., arXiv:2405.14867;线性注意力谱系:arXiv:2507.06457
- 第三方报道:comfyui-wiki(VDN-H3 实测)、AlphaSignal(FastH3 ComfyUI 版)、note.com AI-Driven Lab(FastH3 图解)、runcomfy(社区工作流效果图)