摘要:容器隔离能力不是 Docker 发明的------chroot、FreeBSD Jails、Linux VServer/OpenVZ 到 LXC 四代技术逐步补齐了文件系统、进程集合、资源分区与内核视图四层隔离。本文按演进顺序拆解每代技术的隔离机制与边界,最后讲透 Namespace 与 Cgroups 的内核分工,帮助你真正看懂"容器是什么"。
关键词:chroot;FreeBSD Jails;OpenVZ;LXC;Namespace;Cgroups;容器隔离;Linux 内核
排查线上问题时,你有没有遇到过这几个现象:
- 在 Pod 里执行
ps,看到进程 PID 是从 1 开始的,和宿主机top里的进程号对不上; - 两个容器同时监听 8080 端口,居然不冲突;
- 一个容器把内存吃满,被杀的是容器里的进程,宿主机其他进程毫发无损;
- 容器里
hostname和宿主机完全不一样,但df -h看到的文件系统和宿主机又有点像。
这些现象背后是两套内核机制:Namespace 决定进程"看得见什么",Cgroups 决定进程"用得了多少"。但这两套机制并不是 Docker 发明的,甚至不是 LXC 发明的------它们是从 1979 年的 chroot 开始,一代一代演进出来的。
很多用 Docker、K8s 的工程师把容器当黑盒:出问题了就重启,资源被抢了就加 limit。这篇不聊 Docker 怎么用,把容器隔离的"祖宗们"从头捋一遍,讲清楚每一代解决了什么问题、留下了什么边界。理解了这些,K8s 的 requests/limits、Pod 的 PID 视图、JVM 容器内存参数才不再是玄学。 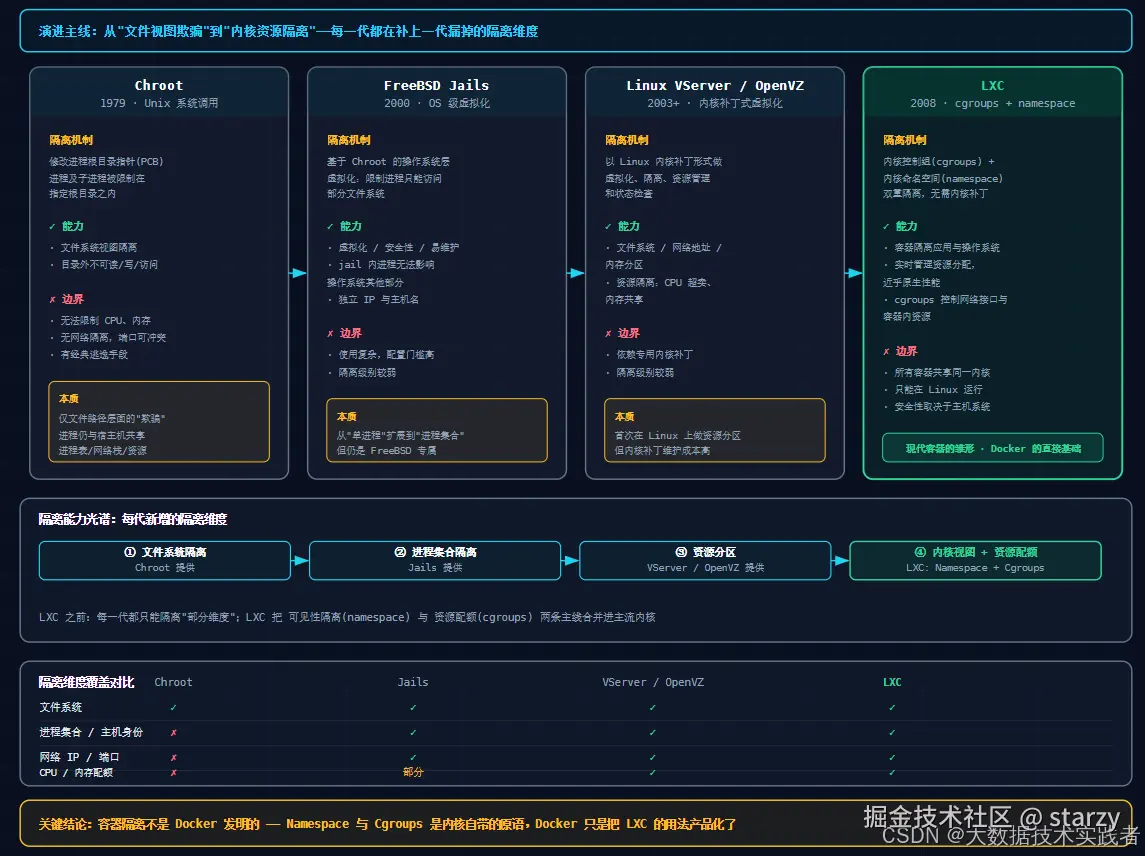
一、Chroot:一切的开端(1979)
chroot 是 Unix 系统调用,作用很直接:改变正在运行的进程及其子进程的根目录。
原理:修改 PCB 实现限制功能
chroot 的实现并不神秘。Linux 里每个进程的 fs_struct 结构体维护了两个路径指针:root(根目录)和 pwd(当前工作目录)。chroot 系统调用就是把进程的 root 指针替换成新的路径,之后这个进程的所有路径解析(/etc/passwd、/usr/lib/...)都从新根开始。
c
// 内核 fs_struct 的核心字段(简化)
struct fs_struct {
    struct path root;   // 进程看到的 "/" 指向哪里
    struct path pwd;    // 当前工作目录
    // ...
};
被 chroot 设置根目录的程序,不能访问、读取、写操作指定根目录之外的文件------不是权限不够,而是它的路径解析根本到不了外面。
实际用一下
bash
# 准备一个最小根目录:目录结构 + 静态编译的 busybox
mkdir -p /tmp/jail/{bin,etc}
cp /bin/busybox /tmp/jail/bin/

# 进入新根:/bin/busybox 是静态链接的,不依赖 /lib 动态库
chroot /tmp/jail /bin/busybox sh有个关键细节:必须用静态编译的 busybox 。如果你 cp 一个动态链接的 /bin/bash 进去,它会因为找不到 /lib/x86_64-linux-gnu/ 下的动态库而直接报 No such file or directory。静态链接把整个解释器和库都打进二进制里,才不依赖宿主机的 /lib------这也是后来容器镜像只打包"二进制 + 依赖库"思路的雏形。
chroot 的坑
-
不改变当前工作目录 。
chroot之后如果不chdir到新根目录,进程的工作目录还在旧文件系统里,依然能访问旧路径。所以标准用法是先chdir("/")再chroot("/")。 -
经典逃逸 。如果进程是 root 权限,可以在新根里
mknod创建一个块设备节点,直接访问宿主机磁盘:bash# 在 chroot 环境内(root 权限下)创建设备节点访问宿主机磁盘 mknod /tmp/sda b 8 0 dd if=/tmp/sda of=/tmp/leak bs=512 count=1chroot 之后还能
chdir逃出根目录(先 cd 到新根外再 chroot 也是经典逃逸路径)。所以 chroot 从来不是安全边界,它只是一个路径视图的"欺骗"。 -
无法限制 CPU、内存、网络端口号 。chroot 环境里的进程和宿主机进程完全共享 CPU、内存和网络栈,一个进程
bind了 8080,另一个进程就绑不了。
判断 :chroot 隔离了"文件系统视图",仅此而已。但它确立了一个重要思想:不虚拟化硬件,只虚拟化进程的"视角"------这正是容器和虚拟机的分水岭。
二、FreeBSD Jails:从"单进程"到"进程集合"(2000)
chroot 隔离的是单个进程,太单薄。2000 年 FreeBSD 4.0 引入 Jails,基于 chroot 的操作系统层虚拟化技术:jail 内的进程只能访问部分文件系统,且不能影响操作系统的其他部分。
解决了什么
- 虚拟化:每个 jail 是一组进程 + 独立 IP + 独立主机名,看起来像一台独立的小主机;
- 安全性:jail 内进程被限制,无法影响系统其他部分(这是对 chroot"进程级"隔离的升级,变成"环境级"隔离);
- 易维护:相比完整虚拟机,jail 复用宿主内核,创建销毁都轻量。
代价
- 使用复杂:配置一个 jail 需要手工设置 IP、挂载点、用户映射,运维门槛比虚拟机还高;
- 隔离级别较弱:jail 内仍是 FreeBSD 内核,内核漏洞会直接影响所有 jail,jail 之间的资源(CPU/内存)也没有硬配额。
Jails 是第一个把"进程集合 + 网络身份"打包隔离的实践,但它绑定 FreeBSD,没能进入 Linux 生态。Linux 生态等来了自己的方案。
三、Linux VServer / OpenVZ:内核补丁式虚拟化(2003+)
Linux VServer 和 OpenVZ 是同一思路的两个实现:类似 Jails 机制,可以对计算机系统上的资源(文件系统、网络地址、内存)进行分区 。它们以 Linux 内核补丁 的形式实现虚拟化、隔离、资源管理和状态检查。
能力与代价
- 资源隔离性:支持 CPU 超卖(多个容器共享 CPU,按权重分配)、内存共享(内存可以超额分配,靠换页兜底)------这是 VPS 行业黄金时代的技术底座;
- 隔离级别较弱:和 Jails 一样,容器内进程共享内核,无独立内核视图(没有 PID 隔离、没有独立挂载表)。
历史遗留问题
OpenVZ 的容器需要运行在打了专用补丁的内核上,这意味着:宿主机不能用主线内核,内核升级要等 OpenVZ 团队适配。用过 OpenVZ VPS 的应该记得,想升级内核版本基本不可能,只能等商家。这也是它最终被 LXC 生态取代的原因之一。
顺带一提:2010 年代初很多人"租"到的便宜 VPS 其实就是 OpenVZ 容器------
/proc/user_beancounters这个文件就是 OpenVZ 的资源记账接口,看到它说明你在一台 OpenVZ 容器里。
四、LXC:现代容器的雏形(2008)
2008 年 LXC(Linux Containers)出现,它把前几代的思路收敛成一套干净的机制:使用内核控制组(cgroups)和内核命名空间(namespace)隔离,轻量级地同时运行多个虚拟单元 。 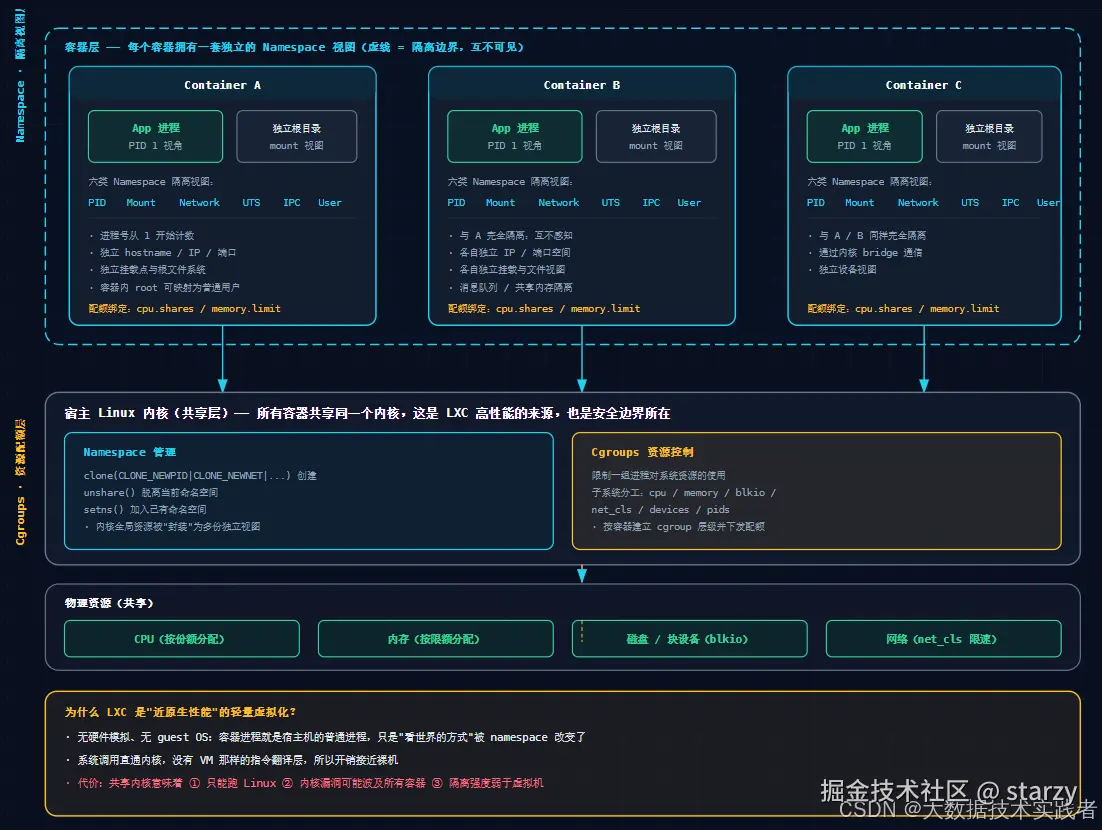
优势
- 通过容器隔离应用程序和操作系统:每个容器有独立的 PID、挂载、网络、UTS、IPC、User 视图,看起来是一台独立的 Linux;
- 实时管理资源分配,近乎原生性能:容器进程就是宿主机内核上的普通进程,没有硬件模拟、没有 guest OS,系统调用直通内核,性能损耗接近零;
- 通过 cgroups 控制网络接口和容器内的资源:CPU 份额、内存上限、块设备 IO、网络带宽都可以按容器粒度限制。
缺陷(至今仍是容器的边界)
- 所有 LXC 容器使用相同的内核 :容器里
uname -r看到的永远是宿主机的内核版本; - 只能在 Linux 操作系统运行:因为依赖 Linux 内核的 namespace/cgroups 原语;
- LXC 并不安全,安全性取决于主机系统:共享内核意味着内核漏洞(如脏牛 Dirty COW)一旦被利用,容器隔离形同虚设。
bash
# LXC 的典型使用(Ubuntu/Debian 示例)
sudo apt install lxc
sudo lxc-create -n app01 -t download -- -d ubuntu -r 22.04 -a amd64
sudo lxc-start -n app01
sudo lxc-attach -n app01    # 进入容器,类似 docker exec

# 容器里看到的内核版本和宿主机一致------这就是"共享内核"的直接证据
lxc-attach -n app01 -- uname -r
LXC 首次把"隔离视图"与"资源限制"两条主线合并进主流内核实现,成为现代容器的雏形。Docker 早期的 runtime 就是直接调用 lxc-start 的,后来才换成了自研的 libcontainer(再后来演进为 runc)。
五、两大基石:Namespace 与 Cgroups
LXC 的整套能力建立在两个内核原语上。分开拆。
5.1 Namespace:内核全局资源的封装
Namespace 是对内核全局资源的封装:每个 namespace 是一份独立的资源,不同进程在各自 namespace 中对同一种资源的使用互不干扰。
六类常用 namespace:
| Namespace | 隔离的资源 | 工程影响 |
|---|---|---|
| PID | 进程号 | 容器内 PID 从 1 开始,ps 只见本容器进程树 |
| Mount | 挂载点 | 容器有独立根文件系统与挂载视图(chroot 的超集) |
| Network | 网络栈 | 独立 IP/端口/路由/iptables,端口不再冲突 |
| UTS | 主机名与域名 | 容器内 hostname 独立 |
| IPC | 消息队列/共享内存/信号量 | 容器间进程间通信互不可见 |
| User | 用户 ID | 容器内 root 可映射为宿主机非特权用户 |
在命令行里可以直接观察:
bash
# 查看当前进程属于哪些 namespace(每个都有独立的 inode 编号)
ls -l /proc/self/ns/
# 输出示例:
# lrwxrwxrwx ... ipc -> 'ipc:[4026531839]'
# lrwxrwxrwx ... mnt -> 'mnt:[4026531841]'
# lrwxrwxrwx ... net -> 'net:[4026531992]'
# lrwxrwxrwx ... pid -> 'pid:[4026531836]'

# 新建一个 Network namespace 并查看里面的网络视图
unshare -n bash
ip addr    # 只剩 lo 回环,没有 eth0 ------ 独立的网络栈
unshare -n bash 之后你会发现 ip addr 里只有 lo,这就是"新 namespace 里资源是独立的一份"最直观的证明。
5.2 Cgroups:一组进程的资源限制
Cgroups 用于限制和隔离一组进程对系统资源的使用,对不同资源的具体管理由各个子系统分工完成。
| 子系统 | 管理内容 |
|---|---|
| cpu | CPU 时间片权重(shares)与上限(quota) |
| memory | 内存限额,超限触发 OOM 回收 |
| blkio | 块设备读写带宽与 IOPS |
| net_cls / net_prio | 网络流量分类标记与优先级 |
| devices | 设备节点访问控制(GPU 挂载靠它放行) |
| pids | 进程/线程数上限,防 fork 炸弹 |
bash
# cgroup 文件系统在 /sys/fs/cgroup 下,按控制器分目录
cat /sys/fs/cgroup/cpu/cpu.shares      # CPU 权重,默认 1024
cat /sys/fs/cgroup/memory/memory.limit_in_bytes   # 内存上限

# docker 的 --cpus / --memory 参数最终就落到这些文件上
docker run --cpus=2 --memory=1g my-image
# 等价于在容器的 cgroup 目录写入:
#   cpu.cfs_quota_us / cpu.cfs_period_us = 200000 / 100000
#   memory.limit_in_bytes = 1073741824
两个真实坑
坑一:JVM 不感知 cgroup。 JDK 8u131 之前,JVM 的 -Xmx 默认按宿主机内存计算------在一台 128G 的机器上,容器 --memory=1g,JVM 默认堆却能冲到 32G,直接 OOM 被杀。而且被杀的还是容器内进程,日志难查。解法是显式设置 -Xmx 或用 JDK 10+ 的 -XX:MaxRAMPercentage=75(它按 cgroup 限额计算)。Java 工程师排查容器 OOM 的第一课就是它。
坑二:pids.max 撞上线程池。 如果一个应用(比如 Spark Executor 或者高并发网关)每请求开线程,pids 控制器的 pids.max 会先于内存把容器卡死,现象是 fork: Cannot allocate memory,但 free -m 内存还有富余。遇到这种报错先查 /sys/fs/cgroup/pids/pids.max,别盯着内存。
六、演进脉络:四代技术的边界与个人判断
四代技术的隔离能力对比,一句话概括:
- Chroot(1979):只隔离文件系统视图,限制不了 CPU、内存、网络;
- FreeBSD Jails(2000):隔离进程集合与网络身份,但绑定 FreeBSD、配置复杂、隔离弱;
- Linux VServer / OpenVZ(2003):在 Linux 上做文件系统/网络/内存分区,支持 CPU 超卖与内存共享,但依赖专用内核补丁、隔离弱;
- LXC(2008):用 namespace + cgroups 双支柱,把"可见性隔离"和"资源配额"统一进主线内核,成为现代容器雏形。
我的三个判断
第一,学容器要从 namespace/cgroups 学起,而不是从 Docker 学起。 Docker/K8s 是产品层,namespace/cgroups 是内核层。搞懂了 unshare 和 /sys/fs/cgroup,K8s 的 requests/limits 就变成了"写配置文件"的琐事,而不是玄学。排查 Pod 被 OOMKilled、CPU throttling,最终都要回到这两套原语。
第二,共享内核是容器隔离强度的天花板,安全边界要靠组合拳补。 LXC 时代就承认"容器并不安全,安全性取决于主机"。现代容器加了 user namespace(容器内 root 映射为非特权用户)、seccomp(限制系统调用)、capabilities(最小特权)、AppArmor/SELinux,本质都是在补共享内核的短板。任何"容器等于虚拟机"的宣传都不可信。
第三,AI 场景的容器化要单独算账。 GPU 容器的本质是 devices cgroup 放行 GPU 设备 + NVIDIA Container Toolkit 注入驱动库;大模型推理的显存是硬配额,--memory 管不到显存,OOM 会直接杀进程。另外 AI 训练任务的 IO 往往是瓶颈,blkio 的配额设置不好,几个训练任务抢磁盘带宽,整机吞吐都会塌------这比 CPU/内存问题隐蔽得多。
容器技术演进 40 余年,核心就一句话:不虚拟化硬件,只虚拟化进程的"视角"和"预算"。视角由 Namespace 给,预算由 Cgroups 给,两者都出自 Linux 内核本身------这才是容器轻量、快速、普及的根本原因。下一篇可以接着聊 Docker 的 runtime 演进(lxc → libcontainer → runc)以及镜像层是怎么构建的,欢迎持续关注。