🔥 本文专栏:Docker
🌸作者主页:努力努力再努力wz


思维导图
text
程序部署
   ↓
不仅需要可执行文件
还依赖动态库 / 配置文件 / 用户态运行环境
   ↓
Docker Image
   ↓
镜像不是一个必须整体传输的大文件
   ↓
Manifest + Config + Layers
   │
   ├── Config:应用进程默认怎么启动
   │
   └── Layers:提供未来 rootfs 的文件系统内容
          ↓
      多层按顺序叠加
          ↓
        rootfs

镜像需要远程存储与分发
   ↓
Docker Registry
   ↓
不是"远程文件夹"
而是基于 HTTP API 的网络服务
   ↓
Repository + Tag
   ↓
Manifest / Image Index
   ↓
Digest
   ↓
Config / Layer 实际内容

镜像还必须考虑运行平台
   ↓
OS + CPU Architecture
   ↓
linux/amd64
linux/arm64
...

常用命令
   ↓
docker login
   ↓
docker pull
   ↓
docker push
   ↓
docker logout
一、先回顾 Docker 到底解决了什么问题
1. 一个程序并不只有一个可执行文件
假设我们实现了一个 C++ 网络服务器:
text
server
├── libstdc++.so
├── glibc
├── libssl.so
├── protobuf
├── 配置文件
└── 其他用户态依赖
真正部署时,并不是把 server 这个可执行文件复制过去就结束了。
如果目标节点缺少程序依赖的动态库、配置文件或者对应版本的运行环境,那么这个程序仍然无法正常启动。
最原始的解决方式当然是:
text
部署节点 A
→ 手工安装依赖
→ 修改配置
→ 启动程序

部署节点 B
→ 再重新安装依赖
→ 再修改配置
→ 再启动程序
节点一多,部署成本就会迅速放大。
Docker 最核心的思想之一就是:
不再只交付一个可执行程序,而是把程序运行所需要的用户态文件内容一起组织起来,形成一个可重复分发的镜像。
2. Docker 和虚拟机的思路并不一样
传统虚拟机更像重新构造一台完整计算机:
text
应用程序
   ↓
Guest OS 用户态
   ↓
Guest Kernel
   ↓
虚拟 CPU / 内存 / 磁盘 / 网卡
   ↓
虚拟化层
   ↓
物理硬件
而 Linux Container 的思路是:
text
容器进程
   ↓
Linux System Call
   ↓
宿主 Linux Kernel
   ↓
物理 CPU / 内存 / 磁盘 / 网卡
也就是说,容器里的进程本质上仍然是一个普通 Linux 进程,它仍然由宿主机内核进行:
text
线程调度
内存管理
文件系统访问
网络协议栈处理
系统调用处理
Docker 自己并不重新实现一个内核。
它更多是在描述和组织:
text
这个进程能看到什么?
这个进程最多能使用多少资源?
这个进程看到的根目录是什么?
这个进程使用什么网络视图?
真正完成这些隔离与限制的,仍然是 Linux Kernel。
因此可以继续固定之前的心智模型:
text
Namespace
→ 隔离"能看到什么"

Cgroup
→ 限制"能使用多少"

rootfs / mount
→ 决定进程看到什么文件系统
二、LXC、libcontainer、runc:Docker 为什么不断拆运行时
1. LXC:先把底层系统调用封装起来
如果 Docker 自己直接使用 Linux 的底层能力,那么它需要亲自处理很多细节,例如:
text
clone / unshare
namespace
cgroup
mount
capability
rootfs
网络配置
...
早期已经存在 LXC 这样的容器工具,它将这些 Linux 底层能力封装起来,并提供更高层的容器生命周期语义,例如:
text
create
start
stop
destroy
因此早期 Docker 可以借助 LXC 完成底层容器环境构建。
但是这样又产生了一个问题:
Docker 想定义自己的容器模型,却必须经过 LXC 这一层。
如果 Docker 想灵活控制:
text
创建哪些 namespace
怎么 mount
怎么配置 cgroup
怎么处理 capability
就会受到 LXC 接口设计与版本变化的约束。
于是 Docker 后来实现了自己的 libcontainer,重新把底层 Linux 容器能力掌握到自己手中。
进一步演进后,这套低层运行时能力最终进入了我们今天熟悉的:
text
runc2. runc 并不是一个长期守着容器的后台进程
这里非常容易产生一个误区:
text
shim
 ↓
runc
 ↓
container
然后认为 runc 会一直运行。
实际上更准确的模型是:
text
shim
  │
  │ 临时调用
  ↓
runc
  ↓
根据运行时配置创建 / 操作容器
  ↓
runc 完成任务后退出
容器进程可以继续运行,而 runc 本身并不需要一直存在。
所以可以把 runc 理解成:
一个短生命周期的低层 OCI Runtime,它根据标准化运行材料真正调用 Linux 内核接口,把容器进程创建出来。
三、Docker CLI、dockerd、containerd、shim 到底是什么关系
Docker 整体上也是一个典型的 C/S 架构。
当我们在 Shell 中输入:
bash
docker run nginx首先经历的是:
text
用户输入字符串
   ↓
Shell 解析命令行
   ↓
发现 docker 是外部命令
   ↓
fork
   ↓
execve 启动 docker CLI
Shell 最终会把参数整理成类似:
text
argv[0] = docker
argv[1] = run
argv[2] = nginx
接着 Docker CLI 根据命令语义构造 Docker API 请求,发送给 Docker Engine 服务端。
整体链路可以先记成:
text
用户
 ↓
Shell
 ↓
docker CLI
 ↓
Docker API
 ↓
dockerd
 ↓
containerd
 ↓
containerd-shim
 ↓
runc
 ↓
Linux Kernel
 ↓
容器进程
1. containerd:全局运行时管理者
这里可以用我们熟悉的 Reactor 服务器做一个类比。
在网络服务器中:
text
主线程
   ↓
accept 新连接
   ↓
把连接分配给某个从线程
   ↓
从线程长期处理该连接上的事件
主线程不会因为某一个连接而长期阻塞,否则它就无法继续:
text
accept
分发新连接
管理其他连接
containerd 的设计思想有相似之处:
text
containerd
   │
   ├── shim A → task A
   ├── shim B → task B
   └── shim C → task C
containerd 负责全局管理多个容器 task,而不是自己长期贴着某一个具体 task 工作。
典型情况下,一个运行中的 task 会有对应的 shim 来承接:
text
进程 IO
退出状态
生命周期承接
容器进程退出以后,shim 可以把退出状态等信息反馈给 containerd。
不过这里还要区分:
text
Container
和
Task
进程退出意味着 task 结束,但并不代表 Docker 中这个 Container 的元数据必须立刻消失。
否则:
bash
docker ps -a就不可能继续看到已经退出的容器。
四、重新认识镜像:先别急着背 Manifest、Config、Layer
前面我们最早建立的镜像模型是:
text
Image
≈
可执行程序
+
动态库
+
应用配置文件
+
其他用户态依赖
这个模型没有错,只是它还停留在"使用目的"这一层。
接下来要进入实现层,就必须先回答:
这些程序、动态库、配置文件,最后到底是为了什么?
答案就是:
为未来的容器进程提供它所看到的 rootfs 文件内容。
五、从 LXC 的 rootfs 理解 Docker Image
我们之前实战 LXC 时,看到过非常直观的容器目录结构:
text
container/
├── config
└── rootfs/
    ├── bin/
    ├── etc/
    ├── lib/
    ├── usr/
    └── ...
这里:
text
rootfs/就是未来容器进程看到的根目录内容。
宿主机上真实路径可能是:
text
/var/lib/lxc/test/rootfs/但是容器进程看到的是:
text
/
├── bin
├── etc
├── lib
└── usr
因此 Docker 镜像里的可执行程序、动态库、应用配置文件,本质上也是在为未来容器的 rootfs 提供内容。
例如:
text
/
├── app/
│   └── server          ← 可执行文件
├── lib/
│   └── libxxx.so       ← 动态库
└── etc/
    └── server.conf     ← 应用配置文件
六、Image Config 和 Runtime Config 不是一回事
这里我们曾经把两个 Config 混在了一起,需要明确拆开。
1. Image Config:偏进程级
镜像中的 Image Config 主要描述:
text
默认启动哪个程序
默认参数是什么
环境变量是什么
工作目录是什么
以哪个用户运行
例如:
text
CMD=/app/server
WORKDIR=/app
ENV PORT=8080
USER=app
它回答的是:
这个镜像中的应用进程默认应该怎么启动?
2. Runtime Config:偏容器运行环境级
真正执行:
bash
docker run ...以后,还需要形成某一个具体容器的运行时配置,例如:
text
创建哪些 namespace
cgroup 限制多少 CPU / 内存
hostname 是什么
网络怎么配置
mount 怎么做
rootfs 在哪里
进程怎么启动
它回答的是:
要给这个进程构造一个怎样的隔离运行环境?
所以可以直接区分成:
text
Image Config
→ 应用进程怎么启动

Runtime Config
→ 容器运行环境怎么构建
七、OCI Bundle:把一个具体容器的运行材料统一交给 Runtime
前面我们已经认识到,镜像中的 Image Config 主要描述的是:
这个镜像中的应用进程默认应该如何启动。
比如:
text
启动命令
命令行参数
环境变量
工作目录
运行用户
但是当我们真正执行:
bash
docker run myapp创建一个具体容器时,仅仅知道"进程怎么启动"显然还不够。
因为 Docker 还需要确定:
text
这个容器需要哪些 namespace?
应该加入哪个 cgroup?
CPU、内存等资源如何限制?
hostname 是什么?
有哪些 mount?
rootfs 在哪里?也就是说,这里还需要一份针对具体容器实例的运行配置。
因此可以把两者区分为:
text
Image Config
↓
镜像级配置
主要描述应用默认怎么启动


Runtime Config
↓
具体容器实例的运行配置
描述这个容器到底应该怎么运行
这里尤其需要注意:
Runtime Config 并不只是"容器级配置"。
它实际上同时包含两部分信息。
一部分描述:
text
容器运行环境如何构建例如:
text
namespace
cgroup
hostname
mount
rootfs
资源限制
另一部分则描述:
text
容器中的初始进程如何启动例如:
text
args
env
cwd
user
因此可以理解为:
text
Runtime Config
│
├── 容器环境配置
│   ├── namespace
│   ├── cgroup
│   ├── mount
│   ├── hostname
│   └── rootfs
│
└── 初始进程配置
    ├── args
    ├── env
    ├── cwd
    └── user
而这份 Runtime Config 并不是凭空产生的。
Docker 会综合:
text
镜像中的 Image Config
+
用户 docker run 指定的参数
+
Docker / containerd 的默认配置
最终生成当前这个具体容器的运行配置:
text
Image Config
+
docker run 参数
+
Docker / containerd 默认配置
        ↓
Runtime Config
例如镜像中的 Image Config 描述:
text
WORKDIR=/app
ENV PORT=8080
CMD=/app/server
而用户执行:
bash
docker run --memory=512m --hostname=node1 myapp那么最终生成的 Runtime Config 中,就可能同时包含:
text
进程相关:

cwd=/app
env=PORT=8080
args=/app/server


容器相关:

memory=512MB
hostname=node1
namespace=...
cgroup=...
rootfs=...
为了让不同的容器 Runtime 都能够按照统一格式获取这些运行材料,OCI Runtime 又规定了一套标准化的组织方式。
这里就引出了:
text
OCI Bundle可以先把 OCI Bundle 理解成:
交给 runc 干活的一套容器运行材料目录。
其典型心智模型可以表示为:
text
bundle/
├── config.json
└── rootfs/
其中:
text
config.json
→ 当前这个具体容器实例的 Runtime Config

rootfs/
→ 容器进程最终看到的根文件系统
这里一定要区分清楚:
text
镜像中的 Config
≠
bundle/config.json
前者是:
text
Image Config是镜像本身携带的默认运行信息。
而后者:
text
bundle/config.json则是:
text
OCI Runtime Config是针对当前这个具体容器实例最终生成出来的完整运行配置。
因此整个过程就可以串起来:
text
Docker Image

Image Config
+
Layers
        ↓

docker run 参数
+
Docker / containerd 默认配置
        ↓

生成具体容器的 Runtime Config
        ↓

OCI Bundle
├── config.json
└── rootfs/
        ↓

shim 调用 runc
        ↓

runc 读取 config.json
        ↓

根据配置:
创建 namespace
配置 cgroup
完成 mount
准备 rootfs
        ↓

在这个运行环境中
启动容器初始进程
这里还有一个很重要的点:
容器运行环境并不是每启动一个进程就重新创建一次。
第一次创建容器时:
text
namespace
cgroup
mount
rootfs
...
这些环境会被构建出来,然后再在这个环境中启动容器的初始进程。
后续如果我们再往这个容器中启动新的进程,例如:
bash
docker exec xxx bash并不是:
text
重新创建 namespace
重新创建 cgroup
重新构建整个容器
而是让新的进程:
text
加入已有 namespace
加入已有 cgroup
使用已有文件系统视图
        ↓
在同一个容器运行环境中启动
所以最终可以形成这样一个认知:
text
Image Config
↓
镜像提供的默认进程启动信息

Runtime Config
↓
某个具体容器实例的完整运行配置

OCI Bundle
↓
把 Runtime Config 和 rootfs
按照统一方式组织起来

runc
↓
根据这些材料真正调用 Linux Kernel
创建容器环境并启动进程
这样一来,镜像、容器运行配置以及 Runtime 之间的关系就串起来了。
八、Layer:镜像里的真实文件内容到底怎么保存
现在终于进入镜像最容易抽象的部分:
text
Layer我们先不讲术语,只抓住一个核心:
Layer 不是一句"如何创建文件"的说明,而是真正携带这一层文件系统变化的数据。
例如:
text
Layer 1:
/bin/sh
/lib/libc.so
/etc/...

Layer 2:
/app/server

Layer 3:
/etc/server.conf
逻辑上按照顺序逐层应用:
text
Layer 1
   ↓
基础 rootfs

+ Layer 2
   ↓
加入 /app/server

+ Layer 3
   ↓
加入 / 修改配置文件
最终得到容器需要的文件系统视图。
1. Layer 不是一份完整 rootfs
每一层更准确地表示:
相对于前一层文件系统状态产生的变化。
可能包括:
text
新增文件
修改文件
删除文件
所以:
text
Layer 2不需要把 Layer 1 的所有文件再复制一遍。
2. Layer 在传输时是什么形态?
为了存储与网络传输,一层文件系统变化通常会被打包,并常常进一步压缩。
你可以先理解成:
text
Layer
≈
一个装着这一层真实文件变化内容的数据包
也就是说:
text
Layer ≠ 构建说明书
Layer = 实际文件数据
在心智模型上,可以理解为客户端下载 Layer 后逐层应用,形成最终 rootfs。
这里我们先不去关注 Docker 在底层究竟通过什么机制来组织这些 Layer,只需要抓住镜像分层最核心的逻辑即可:
每一个 Layer 都保存了当前这一层相对于前面文件系统状态所产生的变化,例如新增了哪些文件、修改了哪些文件。Docker 会按照 Layer 的先后顺序逐层应用这些内容,最终得到容器进程所看到的完整根文件系统。
text
Layer 1
   ↓
Layer 2
   ↓
Layer 3
   ↓
逐层叠加
   ↓
完整 rootfs
因此,在当前阶段我们只需要建立这样一个心智模型:
Layer 负责保存每一层的文件系统变化,多个 Layer 按照顺序叠加之后,最终形成容器运行时所使用的 rootfs。
至于这些 Layer 在底层具体如何存储、如何复用以及如何组合,可以等后面真正学习 Docker 存储机制时再继续深入。
九、Config、Layer 都有了,为什么还需要 Manifest?
刚开始很容易觉得:
text
镜像里已经有 Config 和 Layers
直接找到它们不就行了?
Manifest 有什么用?
这个疑惑的根源,是我们脑子里还默认:
text
镜像 = 一个完整大文件比如想象成:
text
image.tar
├── config
├── layer1
├── layer2
└── layer3
如果镜像真的永远以一个完整大包存在,那么 Manifest 确实显得没那么必要。
但 Registry 中真正的模型不是这样。
Config 和 Layer 可以作为独立内容分别存储:
text
Config A
Config B

Layer 1
Layer 2
Layer 3
Layer 4
...
那么问题来了:
myapp:v1到底由哪个 Config、哪些 Layers、以什么顺序组成?
这就是 Manifest 的作用。
例如:
text
Manifest A
├── Config → Config A
├── Layer1 → Layer 1
├── Layer2 → Layer 2
└── Layer3 → Layer 3
因此:
text
Config
→ 应用怎么启动

Layers
→ rootfs 文件系统内容

Manifest
→ 这个镜像到底由哪个 Config 和哪些 Layers 组成
十、镜像为什么不整体传输?细粒度传输才方便复用
假设:
text
Image A
├── Layer 1  500MB
├── Layer 2  200MB
└── Layer 3   20MB

Image B
├── Layer 1  500MB
├── Layer 2  200MB
└── Layer 4   30MB
如果每次都把完整镜像打成一个大包:
text
pull A
→ 再传一遍 Layer1 + Layer2 + Layer3

pull B
→ 再传一遍 Layer1 + Layer2 + Layer4
其中 Layer1 + Layer2 被重复传输了。
而现在:
text
先获取 Manifest
   ↓
知道需要哪些 Layer
   ↓
检查本地已有内容
   ↓
只下载缺失 Layer
如果本地已经拥有:
text
Layer 1
Layer 2
那么拉 Image B 时只需要:
text
Layer 4因此这里优化的核心不是:
text
网络请求次数更少而是:
text
传输粒度更细
→ 避免重复数据
→ 总传输字节数更少
→ Layer 可以复用
十一、HTTP 请求多了,会不会反而更慢?
Docker Registry 并没有重新设计类似 Redis RESP 那样的一套全新传输协议,而是在 HTTP 之上定义 Registry API。
因此拉取镜像时会产生多个资源请求:
text
Manifest
Config
Layer1
Layer2
Layer3
...
这里并不等于每请求一次资源就一定重新建立一次 TCP 连接。
HTTP 可以复用已有连接。
另外,客户端为了并行下载多个 Layer,也可以维护少量多条连接:
text
连接 A → Layer1
连接 B → Layer2
连接 C → Layer3
下载完后继续复用连接。
1. 为什么 HTTP/1.1 Pipeline 仍然可能有队头阻塞?
HTTP/1.1 Pipeline 可以做到在同一连接连续发送:
text
Request 1
Request 2
Request 3
但响应需要按顺序返回:
text
Response 1
Response 2
Response 3
假设:
text
Response 1 = 1GB Layer
Response 2 = 5MB Config
即使 Response 2 已经准备好了,也不能直接越过 Response 1 完成发送。
因此会出现应用层队头阻塞。
多条 HTTP/1.1 连接可以把不同资源放进不同 TCP 字节流,从而避免一个大响应卡住其他资源。
所以这里真正需要建立的认知是:
text
一条 TCP 连接
≠
天然支持多个逻辑响应完全独立并发
十二、正式进入 Docker Registry:它不是一个远程文件夹
镜像需要远程存储、查询、上传和分发,因此自然会出现:
text
RegistryRegistry 本质上仍然是一个典型的网络服务程序:
text
客户端
   ↓
HTTP API
   ↓
Registry Server
   ↓
查询 / 上传 / 下载镜像相关内容
它对外提供的核心能力可以概括成:
text
查询
上传
下载 / 分发
例如拉取一个镜像:
text
客户端
   ↓
请求 Manifest
   ↓
Registry 返回 Manifest
   ↓
客户端解析需要哪些 Config / Layers
   ↓
继续请求具体内容
   ↓
Registry 根据标识找到内容并返回
十三、Registry、Namespace、Repository、Tag 到底怎么分层
这里最容易被各种名字绕进去。
先看一个完整镜像引用:
text
example.com/team/backend:v1可以先按使用习惯拆成:
text
example.com
→ Registry Host

team
→ Namespace

backend
→ Repository

v1
→ Tag
逻辑层级可以先画成:
text
Registry
└── Namespace
    └── Repository
        └── Tag → Manifest
如果用 C++ 做类比:
text
Namespace
≈ 外层命名作用域

Repository
≈ 内层镜像作用域

Tag
≈ Repository 里的 key
在镜像命名中,可以把 team/backend 理解为两层逻辑结构,其中 team 是 Namespace,backend 是 Repository。需要注意的是,在 Registry 的实际 API 请求中,team/backend 通常会作为一个完整的 Repository 名称参与请求。因此这里的 Namespace 主要用于帮助我们理解镜像名称的逻辑层级,而不需要进一步纠结 Registry 内部是否真的单独维护一个 Namespace 对象。
1. Tag:人为可读的名字
例如:
text
latest
v1
v1.0
stable
Repository 内可以存在类似映射:
text
latest → Manifest A
v1     → Manifest B
v2     → Manifest C
所以 Tag 的核心作用就是:
在某个 Repository 作用域内,用一个人类可读的名字定位 Manifest。
Tag 是可变的。
今天:
text
latest → Manifest A过几天发布新版本以后:
text
latest → Manifest Blatest 名字没有变化,但它指向的内容可以变化。
十四、Digest:不靠名字,而是靠内容本身定位
Registry 中会存很多独立数据:
text
Config A
Config B
Layer 1
Layer 2
Layer 3
...
那么这些数据怎么稳定定位?
答案就是:
text
digest可以先把 digest 理解成:
根据内容本身计算出来的"内容指纹"。
例如:
text
Layer 二进制内容
   ↓
SHA-256
   ↓
sha256:ABC123...
这里和 Tag 最大区别是:
text
Tag
→ 人为起的名字

Digest
→ 根据内容算出来的指纹
内容只要发生变化,digest 就会随之变化。
工程上通常把 SHA-256 这样的密码学哈希当作内容唯一标识使用。
严格来说哈希函数理论上存在碰撞可能,但概率低到工程实践中可以忽略。
十五、Blob 又是什么?
blob 这个词不要想复杂。
从 Registry 的角度看:
text
Layer
→ 一块二进制数据

Config
→ 也是一块二进制数据
Registry 并不需要理解:
text
这个 Layer 里到底是 libc
还是 server
还是配置文件
它只需要知道:
text
sha256:AAA
→ 对应一块实际数据
这种按 digest 寻址的二进制内容就可以统称为 Blob。
所以可以先固定:
text
Blob
≈ Registry 中按 digest 管理的一块实际内容数据
十六、Tag 到 Manifest,再到 Layer:完整定位链终于串起来了
假设:
bash
docker pull team/backend:v1逻辑定位链就是:
text
Repository = team/backend
Tag = v1
   ↓
Tag 映射
   ↓
Manifest B
   ↓
Manifest 中记录:

Config → sha256:CCC
Layer1 → sha256:AAA
Layer2 → sha256:BBB
   ↓
客户端分别按 digest 请求内容
   ↓
Registry 根据 digest 定位实际数据
所以这里其实存在两套定位关系:
text
逻辑定位:
Repository + Tag
        ↓
Manifest

内容定位:
digest
        ↓
实际 Config / Layer 数据
十七、从 Tag 到 Digest:Registry 内部是如何组织镜像数据的
这里需要先建立一个非常重要的认知:
Registry 对外看到的 Repository、Tag、Manifest 等关系,本质上是一套逻辑组织结构,并不意味着底层磁盘一定按照相同的目录层级去存储。
为了方便理解,我们完全可以先把 Registry 内部的一些关系抽象成几张哈希表。
对于每一个 Repository,首先会维护一份:
text
Tag → Manifest的映射关系。
例如可以粗略抽象成:
cpp
unordered_map<string, ManifestRef> tag_table;

tag_table["latest"] = ManifestA;
tag_table["v1"]     = ManifestB;
tag_table["v2"]     = ManifestC;
也就是说:
text
Repository A:

latest → Manifest A
v1     → Manifest B
v2     → Manifest C
而对于另外一个 Repository,则会有自己独立的一套 Tag 映射关系:
text
Repository B:

latest → Manifest D
v1     → Manifest E
所以这里也能看出:
Tag 并不是整个 Registry 范围内唯一的,它的作用域属于某个具体 Repository。
同样一个:
text
latest在不同 Repository 中完全可以指向不同的 Manifest。
除了 Tag → Manifest 之外,每个 Repository 还需要知道:
自己当前能够引用哪些内容数据。
而这些内容数据,就是通过 digest 来标识的。
所以我们还可以把它抽象成一个集合:
cpp
unordered_set<string> accessible_digests;比如:
text
Repository A 可以引用:

sha256:AAA
sha256:BBB
sha256:CCC
这里并不是说 Repository A 自己保存了一份:
text
sha256:AAA → Layer而只是说:
text
Repository A
有权引用 / 访问
digest = sha256:AAA
真正的数据,可以放在整个 Registry 的全局内容存储中。
于是 Registry 全局还可以再抽象出一张哈希表:
cpp
unordered_map<string, DataLocation> content_table;例如:
text
sha256:AAA → Layer A 的存储位置
sha256:BBB → Layer B 的存储位置
sha256:CCC → Config 的存储位置
这里的 DataLocation 可以先理解成:
这块实际数据存放在哪里。
比如可能是:
text
某个文件路径
某个对象存储 key
某条数据库记录
其他存储后端中的定位信息
所以整个访问过程就可以抽象成:
text
客户端请求某个 Repository 下的某个 digest
        ↓
先检查当前 Repository
是否允许引用这个 digest
        ↓
如果允许
        ↓
拿 digest 去全局 content_table 查找
        ↓
digest → DataLocation
        ↓
定位实际 Layer / Config 数据
        ↓
读取并返回
用 C++ 的方式来想,大概就是:
cpp
// Repository 自己维护
unordered_map<string, ManifestRef> tag_table;
unordered_set<string> accessible_digests;

// 整个 Registry 全局维护
unordered_map<string, DataLocation> content_table;
于是整体关系可以表示为:
text
Repository A
│
├── Tag 映射表
│   ├── latest → Manifest A
│   └── v1     → Manifest B
│
└── 可引用 digest 集合
    ├── sha256:AAA
    ├── sha256:BBB
    └── sha256:CCC


Repository B
│
├── Tag 映射表
│   └── latest → Manifest C
│
└── 可引用 digest 集合
    ├── sha256:AAA
    └── sha256:DDD


Registry 全局内容表
│
├── sha256:AAA → DataLocation A
├── sha256:BBB → DataLocation B
├── sha256:CCC → DataLocation C
└── sha256:DDD → DataLocation D
这里就能非常直观地看出 Layer 复用为什么成立。
假设:
text
Repository A
引用 sha256:AAA

Repository B
也引用 sha256:AAA
那么底层根本没有必要保存两份相同的 Layer。
因为整个 Registry 中:
text
sha256:AAA
        ↓
只对应一份实际数据
两个 Repository 只需要都保存对这个 digest 的逻辑引用即可。
所以最终可以把这一套模型总结成:
Repository 负责维护自己的逻辑关系,例如
Tag → Manifest的映射,以及当前 Repository 可以引用哪些 digest;而整个 Registry 再维护一份全局的digest → DataLocation内容索引。这样既能保证不同 Repository 之间的逻辑隔离,又能让相同的 Layer 或 Config 在底层只保存一份,实现内容复用。
需要注意的是,这里的 unordered_map、unordered_set 只是为了帮助我们建立心智模型,并不代表 Registry 的真实源码一定就是用这几个 C++ 容器实现的。真实实现可能使用数据库、文件索引或者对象存储等方式,但逻辑关系是类似的。
1. 相同 Layer 为什么可以跨 Repository 复用?
假设:
text
Repository A
需要 sha256:AAA

Repository B
也需要 sha256:AAA
由于二进制内容完全相同,digest 也相同。
物理上没必要保存两份:
text
全局 Content Store

sha256:AAA
   ↓
实际 Layer 数据只存一份
然后:
text
Repository A → 引用 AAA
Repository B → 也引用 AAA
可以把这种关系粗略类比成"多个逻辑指针都指向同一份物理数据"。
但注意:
text
物理内容全局存在
≠
任意 Repository 自动拥有访问权限
Repository 仍然存在自己的逻辑作用域和访问关系。
所以最终模型是:
text
物理内容共享
+
逻辑引用独立
2. Registry 架构图
下面这张图把前面的 Tag、Manifest、digest、Content Store 关系放在了一起:
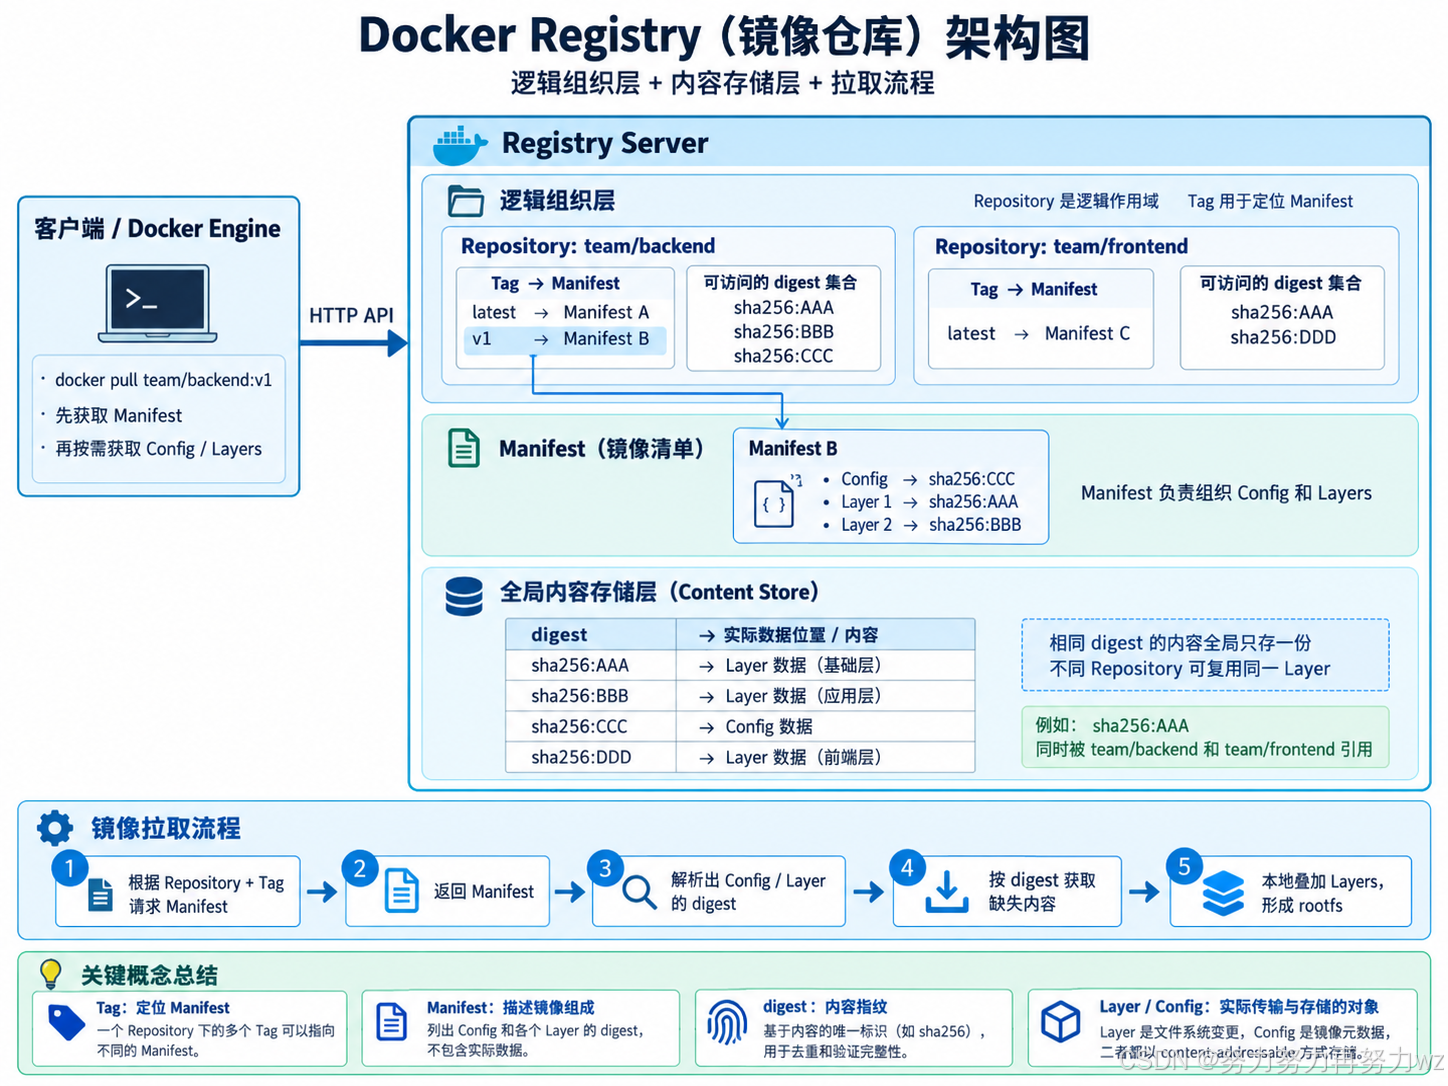
可以用一句话概括:
Registry 上层通过 Repository + Tag 组织和定位 Manifest;Manifest 再通过 digest 引用 Config 与 Layers;底层内容存储则根据 digest 定位真实数据。
十八、公有仓库和私有仓库
理解了 Registry 本质以后,公有和私有就很好理解了。
1. 公有 Repository
公有的核心不是"任何人什么都能做",而是:
text
pull
→ 通常可以公开读取

push
→ 仍然需要对应写权限
因此:
text
Public Repository

读取:通常公开
写入:受权限控制
2. 私有 Repository / Registry
私有可以有两层限制。
第一层:网络可达性。
text
企业内网 Registry
   ↓
公网根本无法路由访问
第二层:应用层认证与授权。
即使公网可达:
text
TCP 连接建立
   ↓
HTTP 请求到达
   ↓
身份认证
   ↓
权限校验
   ↓
允许 / 拒绝 pull、push
所以:
"私有"不等于 TCP 一定连不上;核心是未授权客户端不能访问受保护镜像内容。
3. 私有仓库常见搭建方案
如果只是学习 Registry 原理,可以使用 Docker Distribution / Registry 这一类基础 Registry 服务。
企业场景往往还需要:
text
Web UI
项目隔离
用户与权限管理
漏洞扫描
镜像复制
审计
HTTPS
这时经常会使用:
text
Harbor可以先建立:
text
基础 Registry
→ 解决镜像存储与分发

Harbor
→ 在 Registry 能力上增加企业级管理能力
十九、镜像为什么还要区分 linux/amd64、linux/arm64?
镜像中最终会包含已经编译、链接完成的可执行程序。
例如 C++ 程序:
text
源代码
   ↓
编译 + 链接
   ↓
二进制可执行文件
   ↓
CPU 读取并执行机器指令
不同 CPU 架构使用不同指令集:
text
x86-64
ARM64
ARMv7
...
因此:
text
给 x86-64 编译的二进制不能默认直接在 ARM64 CPU 上执行。
这就是镜像需要考虑 CPU Architecture 的原因之一。
1. 还不只是 CPU,内核体系也必须兼容
Docker Container 共享底层内核。
Linux 应用最终会调用:
text
fork
epoll_wait
mmap
read
write
...
这些最终进入 Linux System Call 接口。
因此 Linux 用户态程序不仅依赖 CPU 指令集,也依赖 Linux 内核提供的系统调用语义。
所以镜像平台通常写成:
text
OS / Architecture例如:
text
linux/amd64
linux/arm64
windows/amd64
可以把兼容性理解成:
text
镜像能否运行
=
CPU 指令集是否兼容
+
OS / Kernel 接口是否兼容
二十、Windows 为什么也能运行 Linux Docker 容器?
这里曾经是一个很自然的疑问:
Docker 明明依赖 Linux Namespace、Cgroup 和 Linux syscall,为什么 Windows 上安装 Docker Desktop 也能运行 Linux 容器?
答案是:
Windows 必须先借助虚拟化环境提供一个 Linux Kernel。
最常见的路径就是 WSL 2。
可以先理解成:
text
Windows
   ↓
WSL 2 / 轻量虚拟化环境
   ↓
完整 Linux Kernel
   ↓
Docker Engine
   ↓
namespace / cgroup
   ↓
Linux Containers
因此 Linux 容器里的进程真正调用的是:
text
Linux syscall
   ↓
WSL2 中的 Linux Kernel
并不是直接调用 Windows Kernel。
需要注意:Docker Desktop 的 Windows GUI、docker.exe 等仍然可以是 Windows 进程;Linux 侧的 Docker Engine、containerd、shim、runc 和 Linux 容器运行在对应 Linux 环境中。
所以一句话总结:
Windows 想运行 Linux Container,就需要先补上一层 Linux Kernel 环境。
二十一、进入 Docker Hub:把理论和真实页面对应起来
Docker Hub 是我们最熟悉的公共镜像服务之一。
刚登录 Docker 官网时,首先看到的往往还是 Docker 产品入口,而不是镜像列表本身:
真正进入 Docker Hub 后,可以看到自己账号相关的 Repository 管理入口:
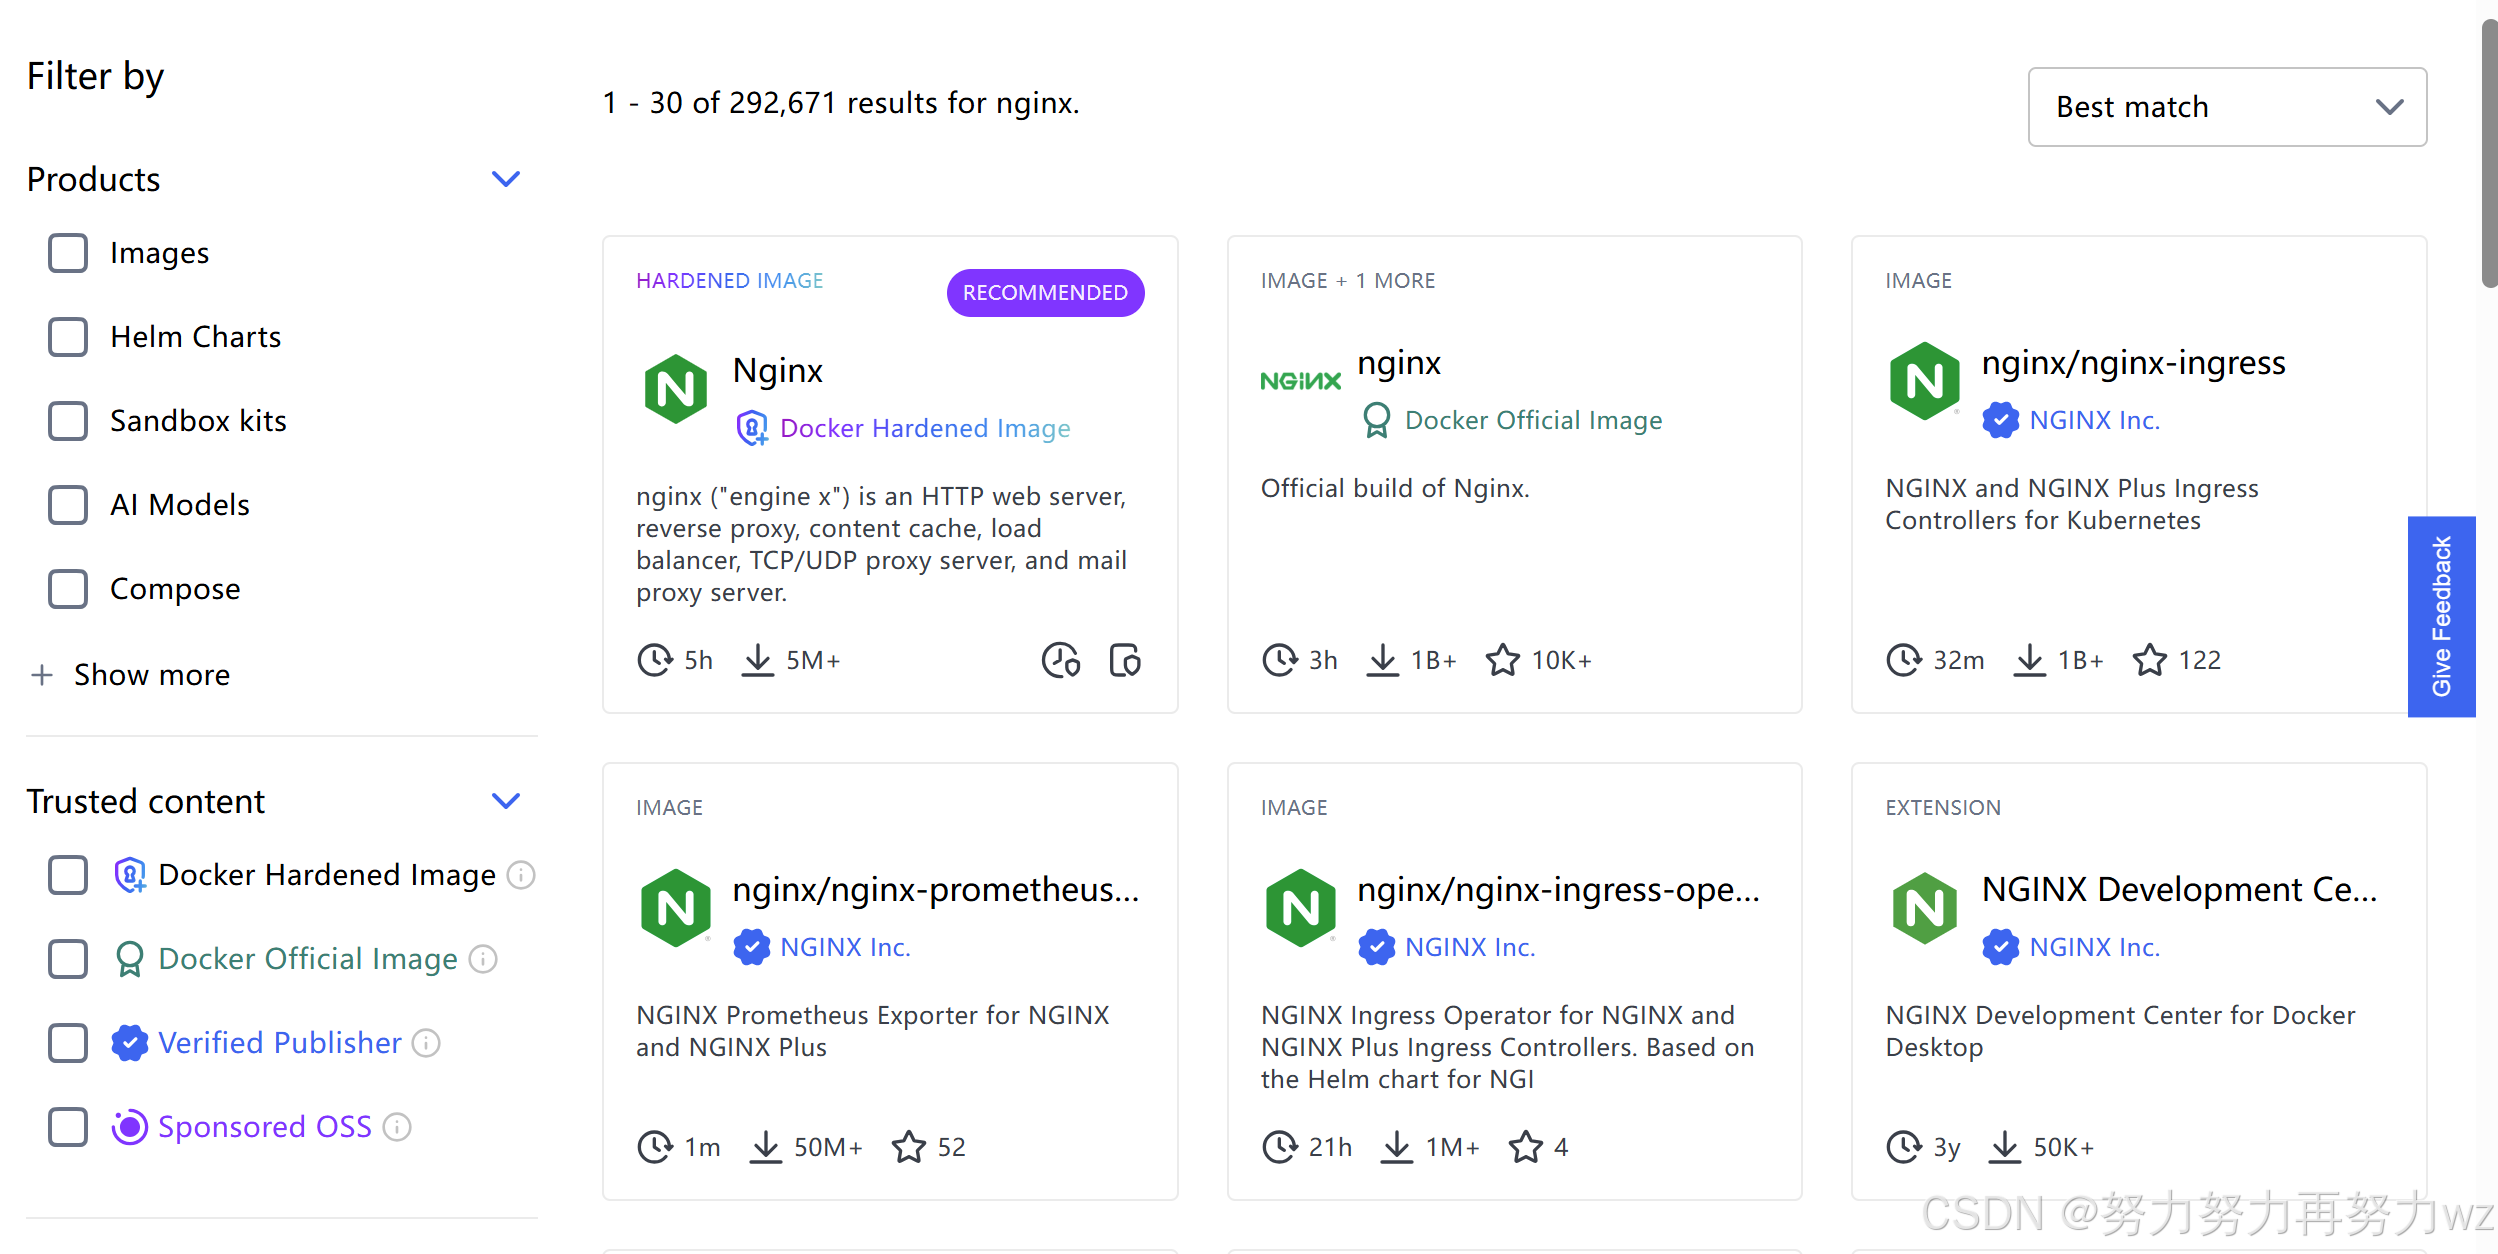
如果搜索 nginx,会出现大量结果:
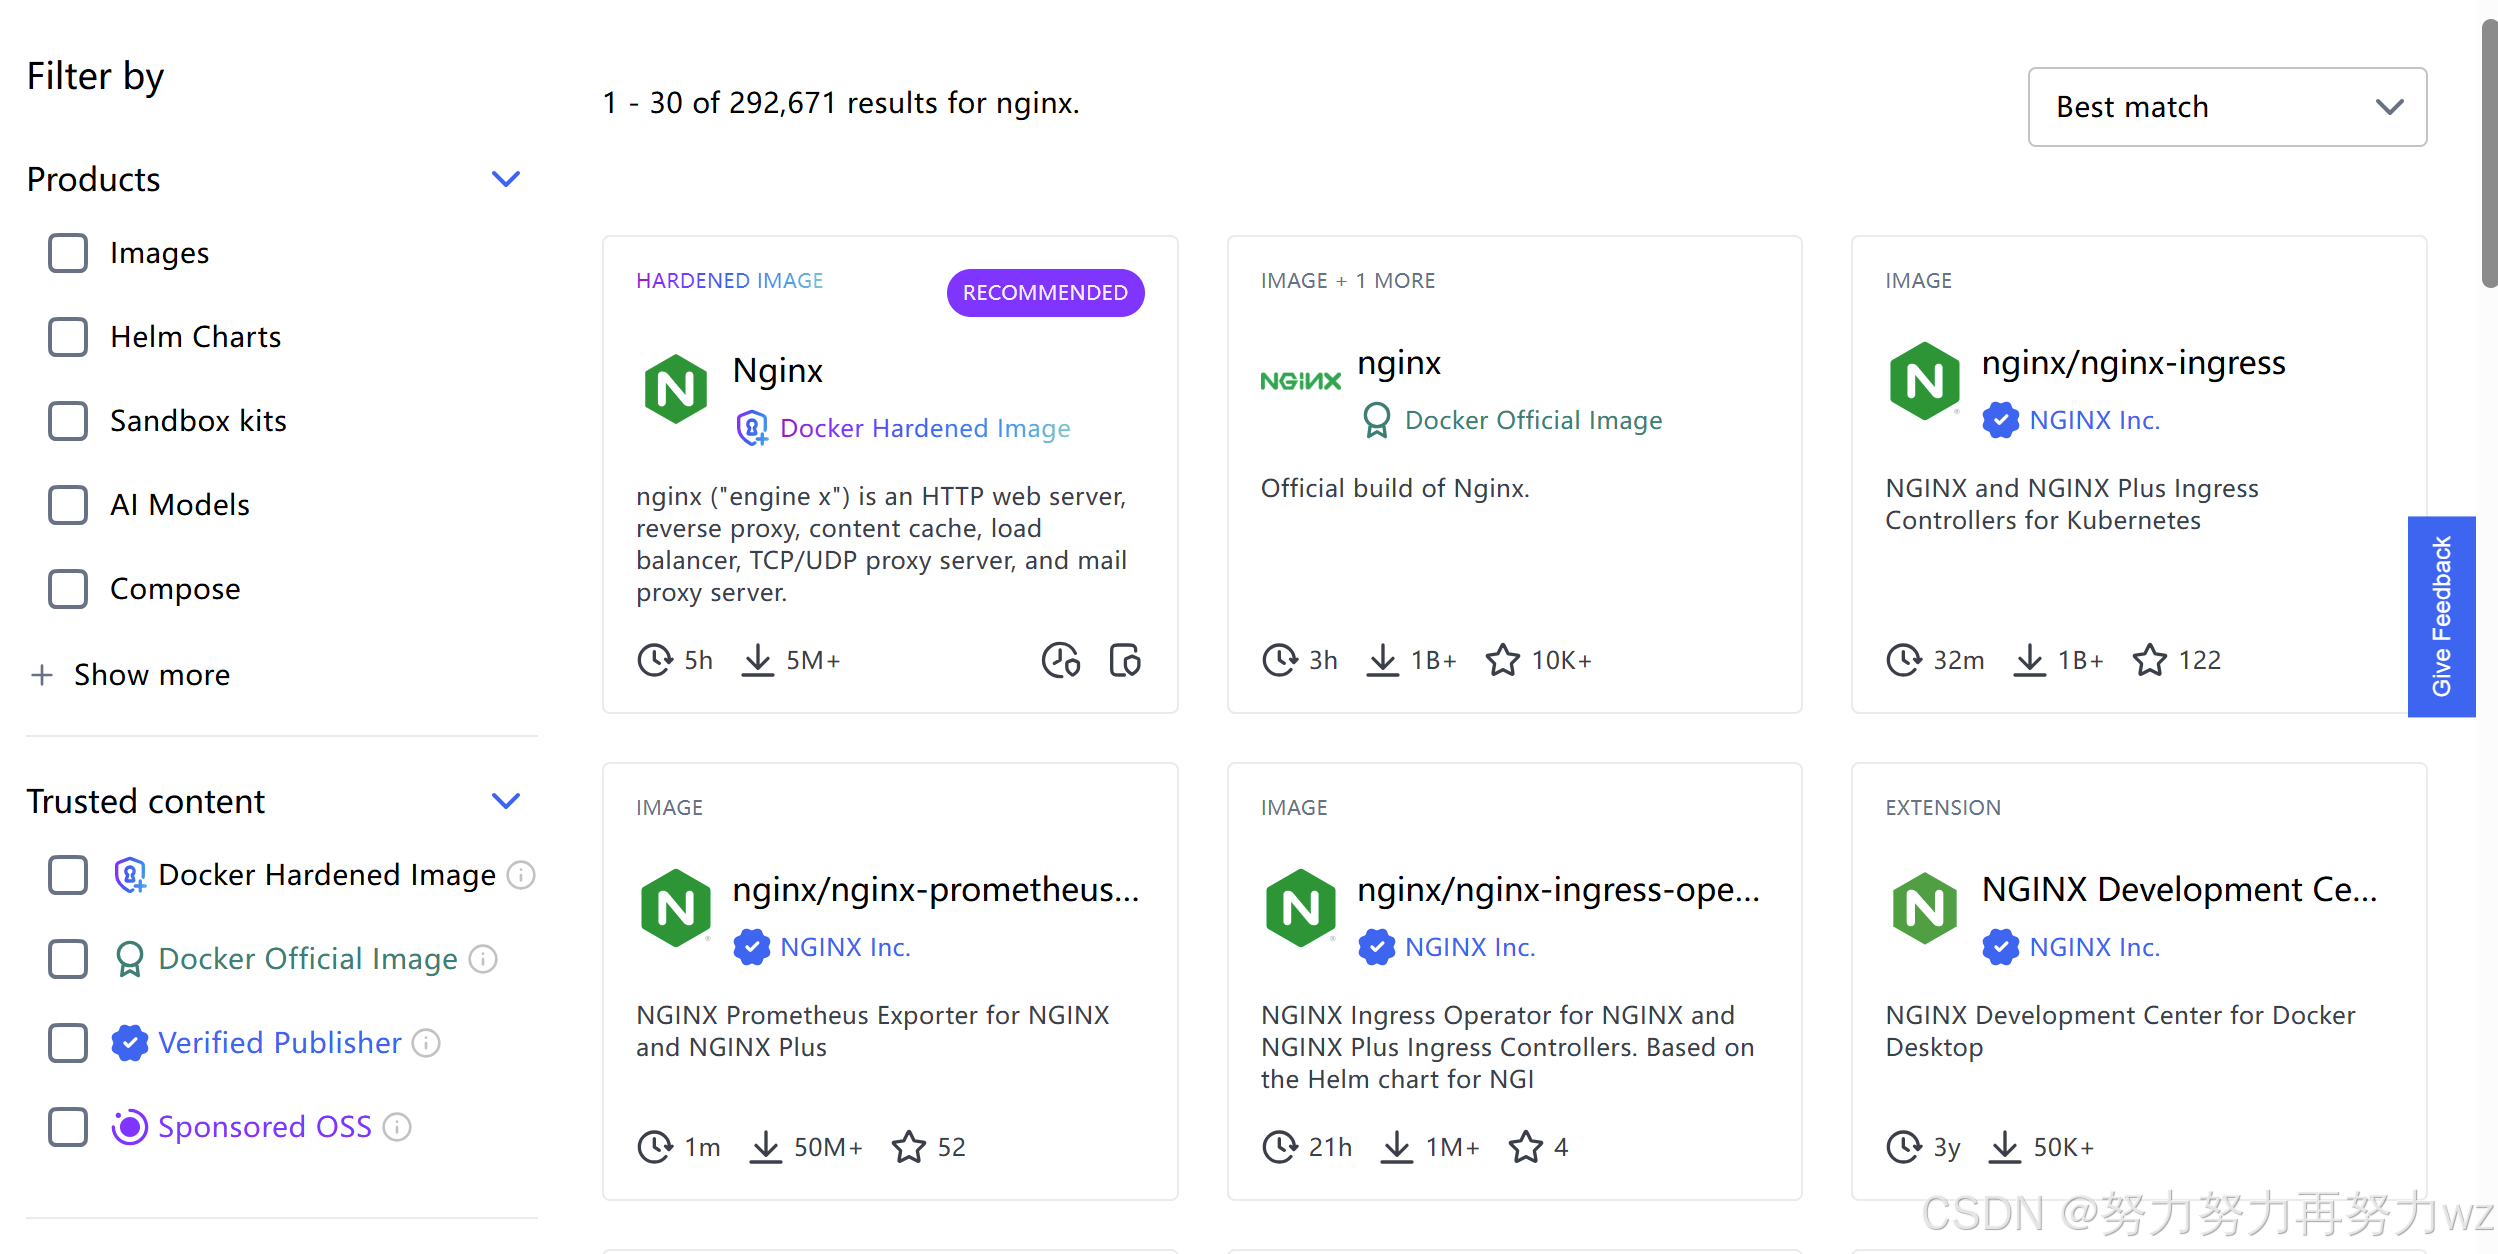
这里需要注意区分:
text
Docker Official Image和:
text
Docker Hardened ImageHardened Image 会额外展示 FIPS、SBOM、漏洞、供应链等安全能力,这并不是我们理解 Registry 基本结构的重点
学习 Registry 时,更适合先看普通官方 nginx Repository。
二十三、多平台镜像:一个 Tag 为什么下面会出现很多 OS/ARCH
进入 nginx 的 Tags 页面以后,会看到类似:
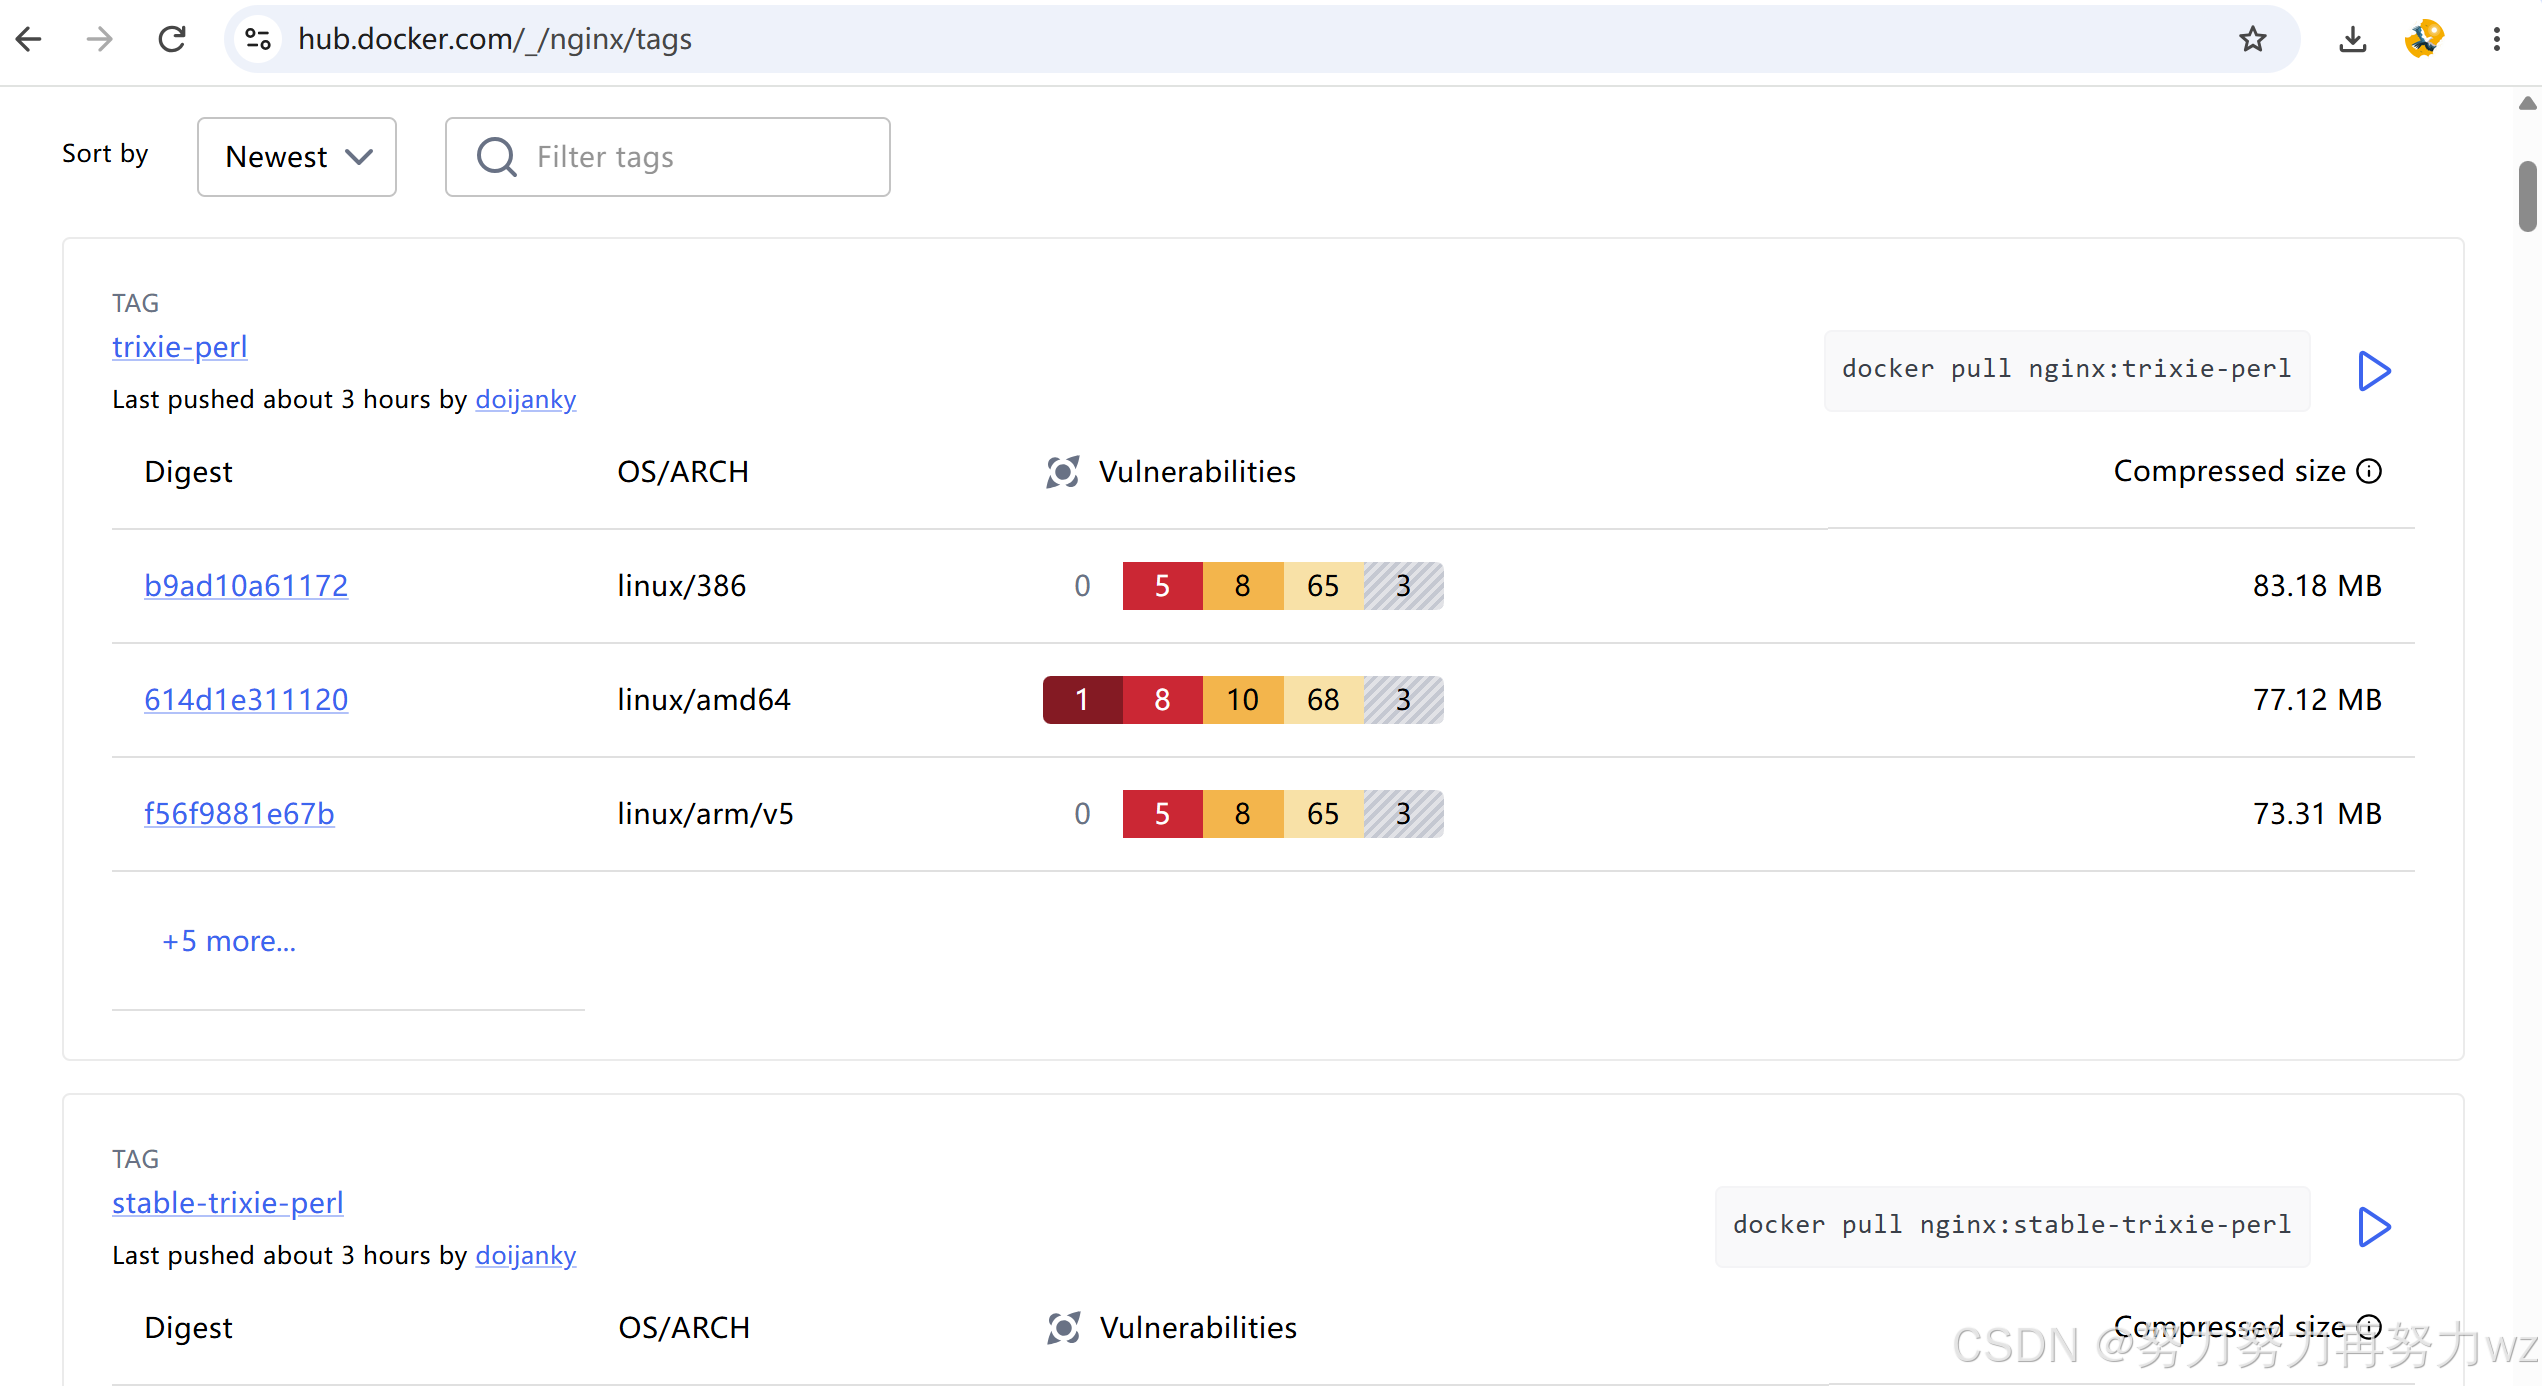
例如某个 Tag:
text
trixie-perl下面同时有:
text
linux/386
linux/amd64
linux/arm/v5
...
这说明:
同一个 Tag 可以同时提供多个平台版本。
这里就不能再简单理解成:
text
Tag → 一个普通 Manifest更准确的是:
text
Tag
 ↓
Image Index / Manifest List
 ↓
根据 OS/ARCH 选择
 ↓
具体平台 Manifest
 ↓
Config + Layers
例如:
text
trixie-perl
   ↓
Image Index
   ├── linux/amd64 → Manifest A
   ├── linux/arm64 → Manifest B
   └── linux/386   → Manifest C
点击具体平台以后,可以进一步看到:
text
INDEX DIGEST和:
text
MANIFEST DIGEST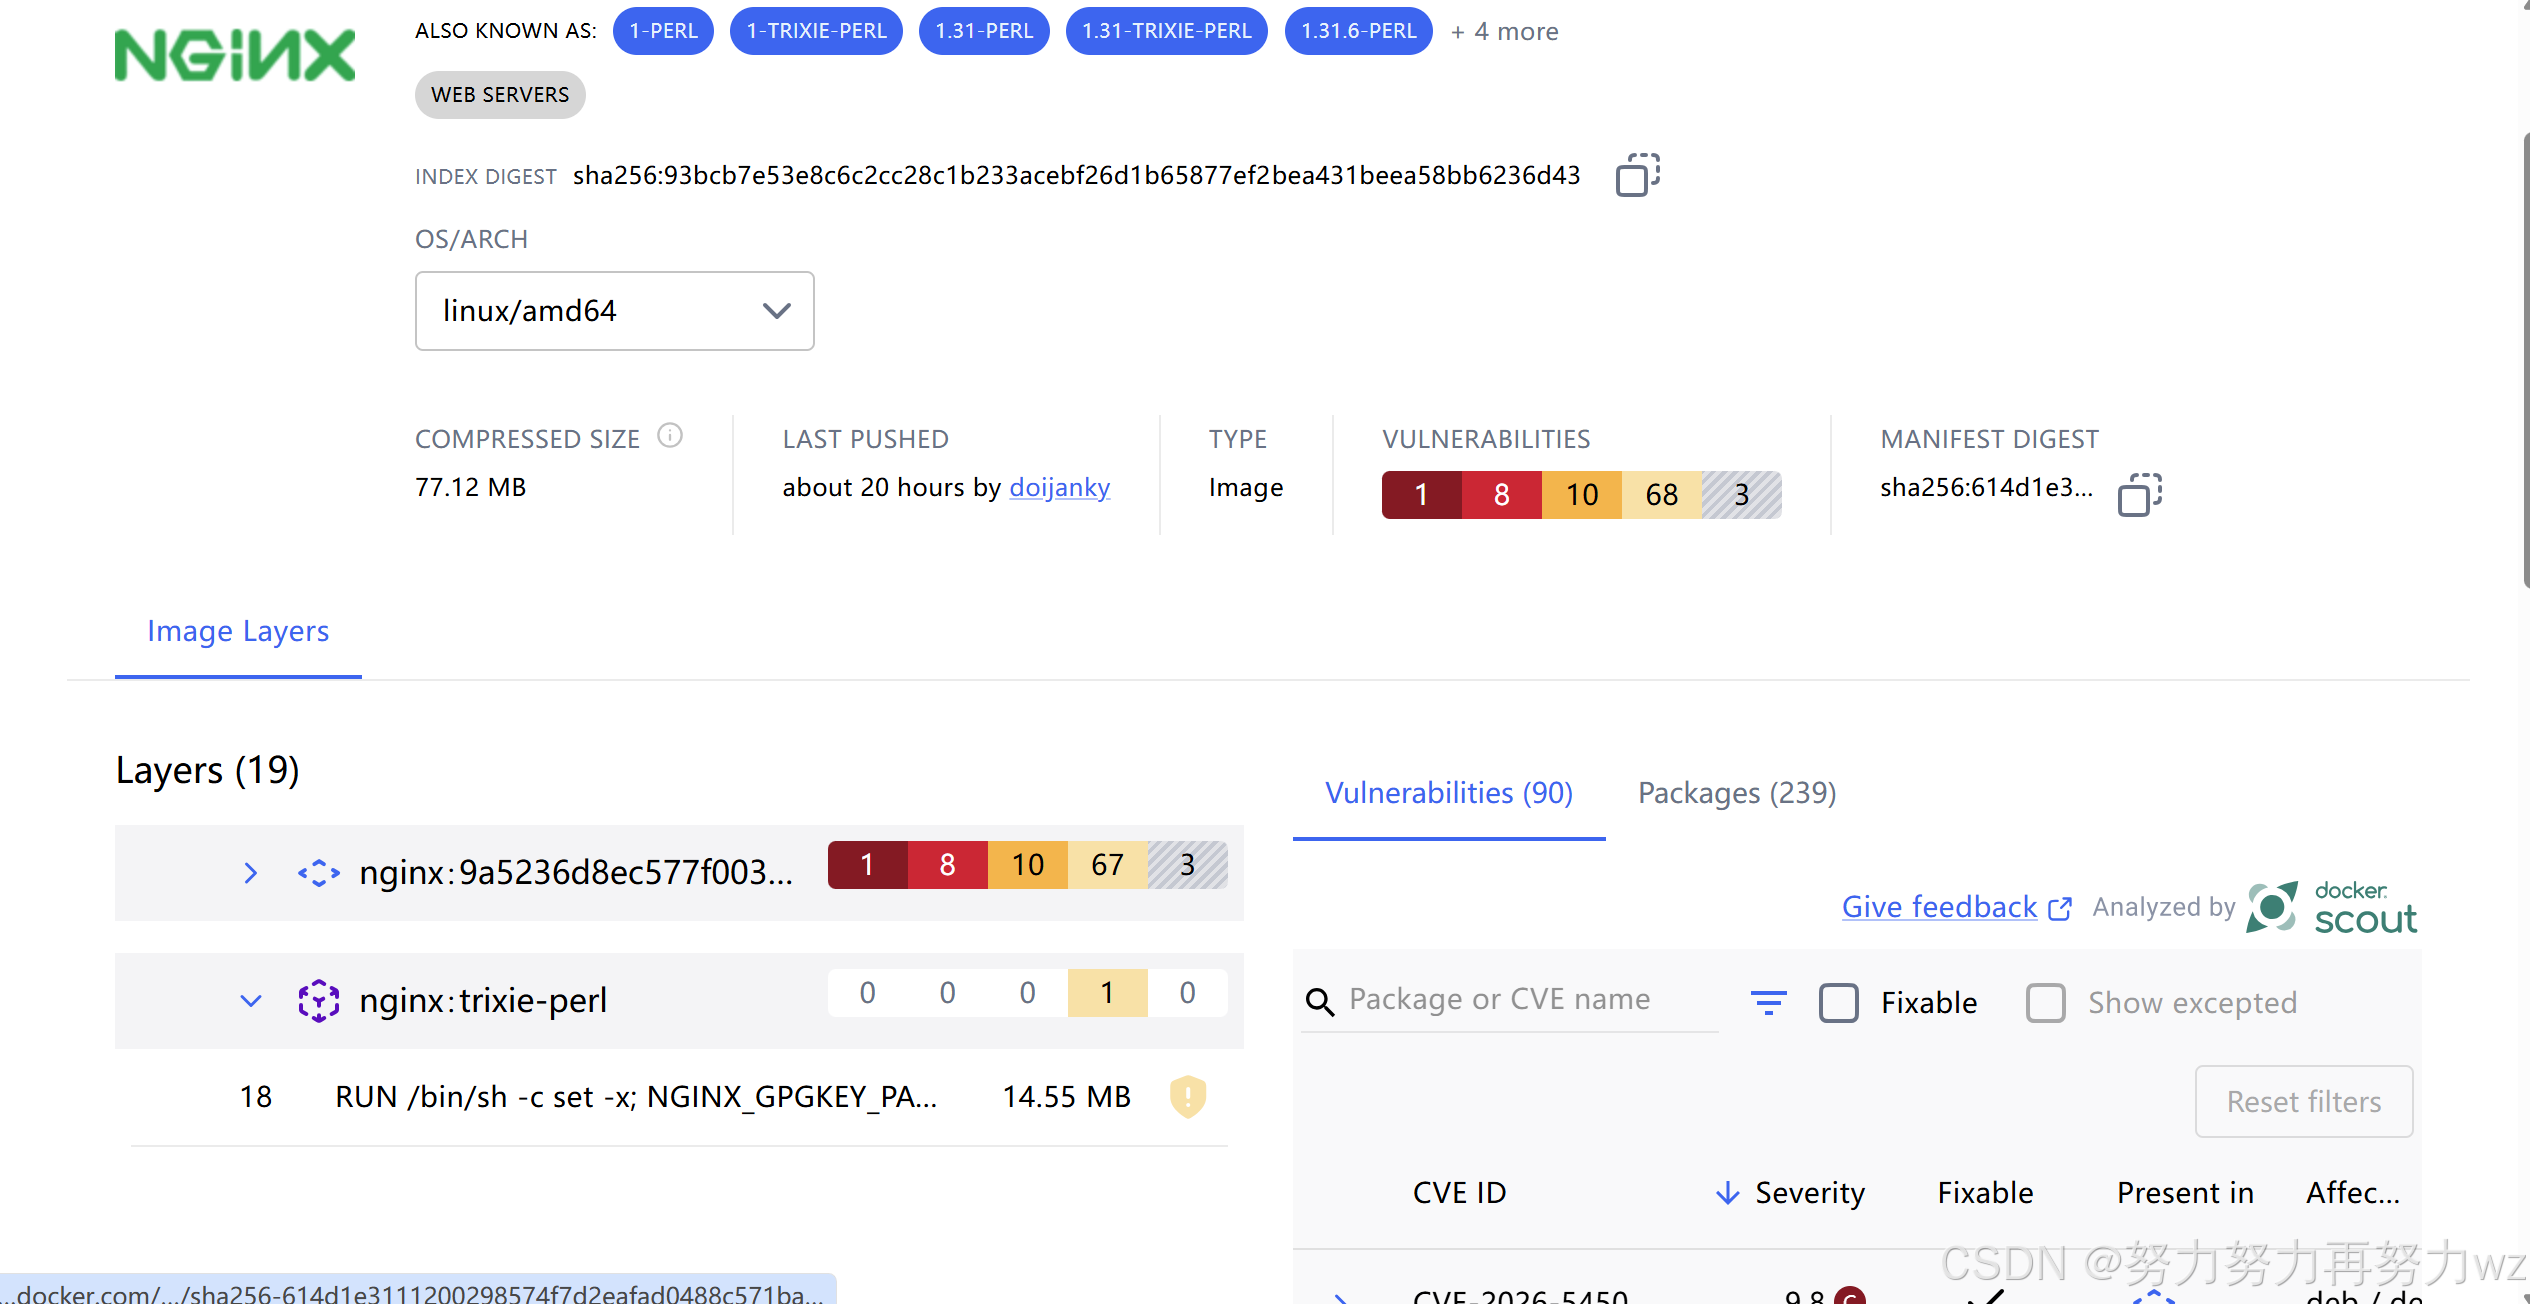
所以需要区分:
text
Index Digest
→ 整个多平台索引的内容指纹

Manifest Digest
→ 某个具体平台 Manifest 的内容指纹
而这个具体平台 Manifest 里面,才继续记录:
text
Config digest
Layer digest
Layer digest
...
因此完整链路就是:
text
Repository
 ↓
Tag
 ↓
Image Index(多平台时)
 ↓
根据 OS/ARCH 选择具体 Manifest
 ↓
Config + Layers
单平台镜像则可以简化成:
text
Tag
 ↓
Manifest
 ↓
Config + Layers
对于这种多平台镜像,Tag 首先会指向一个 Image Index。在 Docker 的早期叫法中,也经常把它称为 Manifest List。
可以把 Image Index 理解成一张"平台索引表",其中每一个条目描述一个具体平台,并指向该平台对应的 Manifest。
二十四、Docker Registry 的 HTTP API 是怎么表达资源定位的
Registry 没有为镜像重新造一套完全不同于 HTTP 的传输层协议,而是在 HTTP 上定义资源语义。
例如客户端要定位某个 Manifest,核心信息就是:
text
Repository
+
Tag(或 Digest)
概念上请求路径类似:
text
/v2/<repository>/manifests/<tag-or-digest>拿到 Manifest 以后,再根据里面记录的 digest 去请求具体内容:
text
/v2/<repository>/blobs/<digest>这里 HTTP 负责:
text
GET / PUT / HEAD
Header
Status Code
TCP 连接承载
Registry API 负责定义:
text
什么 URL 表示 Manifest
什么 URL 表示 Blob
Tag 怎么定位 Manifest
Digest 怎么定位内容
这也是 OCI Distribution Spec 解决的问题:
统一规定镜像仓库之间如何通过 HTTP 查询、上传与分发镜像内容。
二十五、Docker 常用 Registry 命令
理解完 Registry 的底层模型以后,再来看命令就会非常自然。
1. docker login:登录的是 Registry,不是本机 dockerd
基本语法:
bash
docker login [SERVER]例如:
bash
docker login默认登录 Docker Hub。
私有 Registry:
bash
docker login registry.company.com如果 Registry 使用其他端口:
bash
docker login registry.company.com:5000SERVER 应该是 Registry 的主机名(可带端口),而不是某个具体 Repository 路径。
当前 Docker Hub 的一个实际细节
当前 Docker Hub 在直接执行:
bash
docker login时,可能默认使用浏览器 / device code 登录流程;如果显式指定 --username,则可以走命令行凭据输入流程。
所以不要死记成"执行 login 后一定出现 Username / Password 两行提示"。
login 的核心是什么?
认证成功后,Docker 会把 Registry 凭据保存在配置的 Credential Store 中;如果没有额外凭据存储工具,则可能写入 Docker CLI 配置文件。
本质上:
text
Registry Host
   ↓
对应一份 credential / token
以后访问受保护资源时,客户端 / Engine 才能够携带身份信息完成认证与授权。
2. 认证和授权不是一回事
服务端会先判断:
text
Authentication
→ 你是谁?
然后再判断:
text
Authorization
→ 你有没有权限做这件事?
所以完全可能出现:
text
身份合法
但只有 pull 权限
没有 push 权限
3. 身份认证不应该和 TCP 连接状态混为一谈
这里非常容易把我们之前实现网络服务器时的"连接对象"模型套得太死。
TCP Connection 负责的是:
text
通信通道
HTTP Keep-Alive
连接复用
而身份认证通常体现在请求携带的:
text
Authorization
Bearer Token
其他认证凭据
所以可以记成:
text
TCP Connection
→ 负责怎么通信

Token / Credential
→ 负责你是谁
服务端收到受保护请求后:
text
HTTP Request
   ↓
读取 Authorization 信息
   ↓
认证身份
   ↓
检查权限
   ↓
允许 / 拒绝请求
这就是请求级认证思路。
二十六、docker pull:把前面所有镜像知识真正串起来
例如:
bash
docker pull nginx:latest从使用者角度是:
从远程 Registry 拉取 nginx:latest 到本地。
底层逻辑可以整理成:
text
docker CLI
   ↓
把 pull 请求交给 Docker Engine
   ↓
Engine / containerd 访问 Registry
   ↓
根据 Repository + Tag 定位 Manifest / Index
   ↓
如果是多平台镜像
根据当前 OS + ARCH 选出具体 Manifest
   ↓
解析 Config digest + Layer digests
   ↓
检查本地已经有哪些内容
   ↓
只下载缺失 Config / Layers
   ↓
校验 digest
   ↓
保存到本地内容存储
所以 docker pull 绝对不是:
text
下载一个完整 image.img 大文件而是:
text
先拿清单
→ 再按需获取组成部分
1. docker pull 可以按 Tag 拉,也可以按 Digest 拉
按 Tag:
bash
docker pull nginx:latest逻辑上:
text
latest
 ↓
Manifest / Index
按 Digest:
bash
docker pull nginx@sha256:xxxxxx...这里的 digest 通常用于精确定位 Manifest 或 Image Index,而不是某一个 Layer。
区别就是:
text
Tag
→ 可变的人类可读名字

Digest
→ 内容指纹,精确锁定内容
因此需要可重复部署、精确锁定版本时,Digest 更可靠。
二十七、docker push:可以理解为 pull 的反向过程
例如:
bash
docker push registry.company.com/team/myapp:v1大体流程:
text
Docker Engine 找到本地镜像
   ↓
连接目标 Registry
   ↓
认证 / 权限校验
   ↓
检查 Registry 已经有哪些 Blob
   ↓
只上传缺失的 Config / Layers
   ↓
最后上传 Manifest
   ↓
建立 / 更新 Tag → Manifest 关系
这里同样不是把镜像整体压成一个大文件一次性上传。
如果 Registry 已经存在:
text
Layer A
Layer B
那么新镜像只缺:
text
Layer C就只需要上传缺失内容。
1. 为什么经常先 docker tag 再 docker push
假设本地有:
text
myapp:v1如果目标是企业 Registry,需要让镜像引用携带目标 Registry 与 Repository 名字:
bash
docker tag myapp:v1 registry.company.com/team/myapp:v1然后:
bash
docker push registry.company.com/team/myapp:v1docker tag 本身并不会重新复制所有 Layer 数据,它更像给本地镜像增加一个新的名称 / 引用。
二十八、Tag 命名有什么要求
Tag 常见格式:
text
latest
v1
v1.0
release-2026
release_2026
可以先记住:
text
最多 128 个字符常见合法字符:
text
字母
数字
_
.
-
第一个字符不能是 . 或 -。
可以粗略记成:
text
[A-Za-z0-9_][A-Za-z0-9_.-]{0,127}另外:
text
Tag 可以出现大写字母但 Repository 命名通常要求小写,这两个规则不要混在一起。
二十九、docker logout 清除的是客户端登录凭据,而不是服务端用户信息
在理解 docker logout 时,需要先区分服务端保存的用户信息 和客户端保存的登录凭据。
对于 Registry 服务端来说,它需要维护的是用户身份以及对应权限,例如:
text
userA
↓
可以访问哪些 Repository
↓
是否具有 pull 权限
↓
是否具有 push 权限
也就是说,服务端需要知道:
当前这个用户是谁,以及这个用户能够执行哪些操作。
但是服务端并不一定需要长期维护一个类似:
text
userA 当前是否处于登录状态这样的状态。
客户端在执行 docker login 并完成认证以后,会在本机保存后续访问 Registry 所需要的认证凭据,例如 credential 或 token。之后执行:
bash
docker pull ...
docker push ...
时,请求会携带相应的认证信息,Registry 再根据这些信息确认客户端身份,并进一步检查当前用户是否具有对应操作权限。
因此可以把两侧的职责理解为:
text
客户端
↓
保存:
"我使用什么凭据证明自己的身份"

服务端
↓
保存:
"这个用户是谁,以及这个用户拥有什么权限"
所以执行:
bash
docker logout时,核心操作并不是删除服务端用户,也不是简单地关闭一条 TCP 连接,而是:
text
找到本机保存的 Registry 认证凭据
        ↓
删除这份凭据
        ↓
后续请求无法继续直接使用原来的身份信息
        ↓
需要时重新执行登录认证
因此:
text
docker login
→ 在客户端本地保存后续访问 Registry 所需要的认证凭据

docker logout
→ 删除客户端本地保存的这份认证凭据
而 Registry 服务端原本保存的用户账号、身份信息以及权限关系通常仍然存在。
所以这里最核心的认知就是:
服务端保存"用户是谁、用户能做什么",客户端保存"以后拿什么证明自己是谁";
docker logout主要清理的是客户端这一侧保存的登录凭据。
三十、再纠正一个细节:并不是所有 Docker 命令都完全走同一条路径
对于 Docker 的大部分命令,我们都可以沿用前面已经建立的客户端---服务器模型。
例如:
bash
docker ps
docker run nginx
docker pull nginx
docker push myapp:v1
用户首先通过 docker CLI 输入命令:
text
用户
 ↓
docker CLI
 ↓
解析命令行参数
 ↓
通过 Docker API
 ↓
dockerd
docker CLI 主要负责提供用户操作入口,而真正涉及容器、镜像等资源管理的工作,主要由 Docker 服务端完成。
例如:
bash
docker run nginx可以理解成:
text
docker CLI
 ↓
告诉 dockerd:
"启动一个 nginx 容器"
 ↓
dockerd / containerd
 ↓
完成后续容器创建与启动
而:
bash
docker pull nginx则可以理解成:
text
docker CLI
 ↓
告诉 dockerd:
"我要拉取 nginx 镜像"
 ↓
dockerd / containerd
 ↓
访问远程 Registry
 ↓
获取 Manifest、Config、Layers
所以这里其实存在两条通信链:
text
用户
 ↓
docker CLI
 ↓
dockerd

以及:

dockerd / containerd
 ↓
远程 Registry
不过 docker login 和 docker logout 需要额外注意一点。
执行:
bash
docker login的目的,是完成对 Registry 的身份认证。
认证成功之后,Docker 还需要把认证凭据保存在当前这台客户端机器上,这样以后再执行:
bash
docker pull
docker push
时,就可以继续使用已经保存的身份信息访问 Registry,而不需要每次重新输入用户名和密码。
所以可以理解成:
text
docker login
 ↓
完成 Registry 身份认证
 ↓
认证成功
 ↓
把认证凭据保存到本机
 ↓
以后 pull / push 时继续使用
而:
bash
docker logout主要就是反过来:
text
找到本机保存的 Registry 凭据
 ↓
删除
 ↓
以后再访问需要认证的镜像资源时
需要重新登录因此,login / logout 和普通 Docker 命令相比,多了一层:
text
本地认证凭据管理最终可以把三个角色这样区分:
text
Docker CLI
→ 用户操作入口
→ 解析命令
→ 管理本地登录凭据

dockerd / containerd
→ 真正执行容器、镜像相关操作

Registry
→ 远程存储和分发镜像
→ 对 pull / push 等请求进行认证和授权
这样理解就不需要去死记:
text
所有 Docker 命令
都只是简单地从 CLI 转发给 dockerd
而应该理解为:
Docker CLI 始终是用户入口,但不同命令的具体职责不同。容器和镜像操作主要由服务端执行,而
login / logout还涉及客户端本机认证凭据的保存与删除。
三十一、把整个知识链重新串起来
最后把本文所有内容重新压缩成一条主线。
text
程序部署需要:
可执行文件 + 动态库 + 配置文件 + 用户态依赖
   ↓
Docker Image
   ↓
镜像核心组成:
Manifest / Config / Layers
   ↓
Config
→ 应用默认怎么启动

Layers
→ 文件系统增量内容
→ 多层组合成 rootfs

Manifest
→ 描述该镜像使用哪个 Config、哪些 Layers
   ↓
镜像需要远程分发
   ↓
Registry
   ↓
Repository + Tag
   ↓
Manifest / Image Index
   ↓
Digest
   ↓
Config / Layer Blob
   ↓
内容寻址 + 层复用
   ↓
减少重复存储与重复网络传输
如果是多平台镜像:
text
Tag
 ↓
Image Index
 ↓
linux/amd64 → Manifest A
linux/arm64 → Manifest B
...
 ↓
具体 Manifest
 ↓
Config + Layers
如果真正启动容器:
text
镜像内容
+
Image Config
+
docker run 参数
   ↓
Runtime Config
   ↓
OCI Bundle
   ↓
shim
   ↓
runc
   ↓
Linux Kernel
   ↓
容器进程
如果是 Windows 上运行 Linux Container:
text
Windows
 ↓
WSL2 / Linux 虚拟化环境
 ↓
Linux Kernel
 ↓
Docker Engine
 ↓
Linux Container
最后再看常用命令:
text
docker login
→ 获取 / 保存 Registry 凭据

docker pull
→ 根据 Tag / Digest 定位 Manifest,并按需下载镜像内容

docker push
→ 上传缺失内容,再提交 Manifest 与 Tag 关系

docker logout
→ 删除本地 Registry 凭据
到这里,Docker 镜像、Registry、Digest、多平台镜像以及常见仓库命令就不再是几个孤立术语,而是已经形成了一套完整的心智模型。