开篇介绍:
hello 大家,本篇博客我们来学习Redis是如何作为缓存的~
在互联网后端开发中,缓存是高并发、高性能系统的 "命门",而 Redis 又是缓存方案中的 "绝对王者",90% 以上的互联网公司都会用 Redis 做数据库缓存。不管是电商、社交、短视频、金融,只要有高并发请求,就一定离不开 Redis 缓存。
开篇:先搞懂一个核心问题 ------ 没有缓存,我们的系统会怎么样?
在正式讲缓存之前,我们先看一个场景,看完你就知道,缓存有多重要:
你做了一个简单的电商网站,核心功能就是展示商品、用户下单,用 MySQL 存储所有数据(商品、用户、订单)。刚开始用户很少,每天只有几百人访问,MySQL 跑得稳稳当当,查询一个商品详情只要 0.1 秒,下单、支付都很流畅,你觉得自己的系统做得很好。
突然有一天,你给网站做了一场小型促销活动,1 小时内涌进来 10 万用户,所有人都在疯狂查询商品详情、加购物车。这时候,诡异的事情发生了:
- 用户打开商品页面,加载了 10 秒还没出来,最后显示 "加载失败";
- 你登录服务器查看,发现 MySQL 的 CPU 占用率 100%,硬盘 IO 直接拉满,日志里全是 "查询超时";
- 再过几分钟,MySQL 直接卡死、宕机,整个网站彻底打不开,用户投诉炸锅,促销活动直接凉凉,还损失了一大笔订单。
这就是没有缓存、高并发下数据库扛不住压力的典型问题。而导致这个问题的核心原因,就是 MySQL 本身的性能瓶颈 ------ 它根本不是为 "高并发、快速度" 设计的。
而Redis 缓存,就是解决这个问题的 "终极神器"------ 它像一个 "前置护盾",帮 MySQL 挡住绝大部分查询请求,让 MySQL 只处理核心的写请求(比如下单、修改商品),从根源上提升系统性能、扛住高并发。
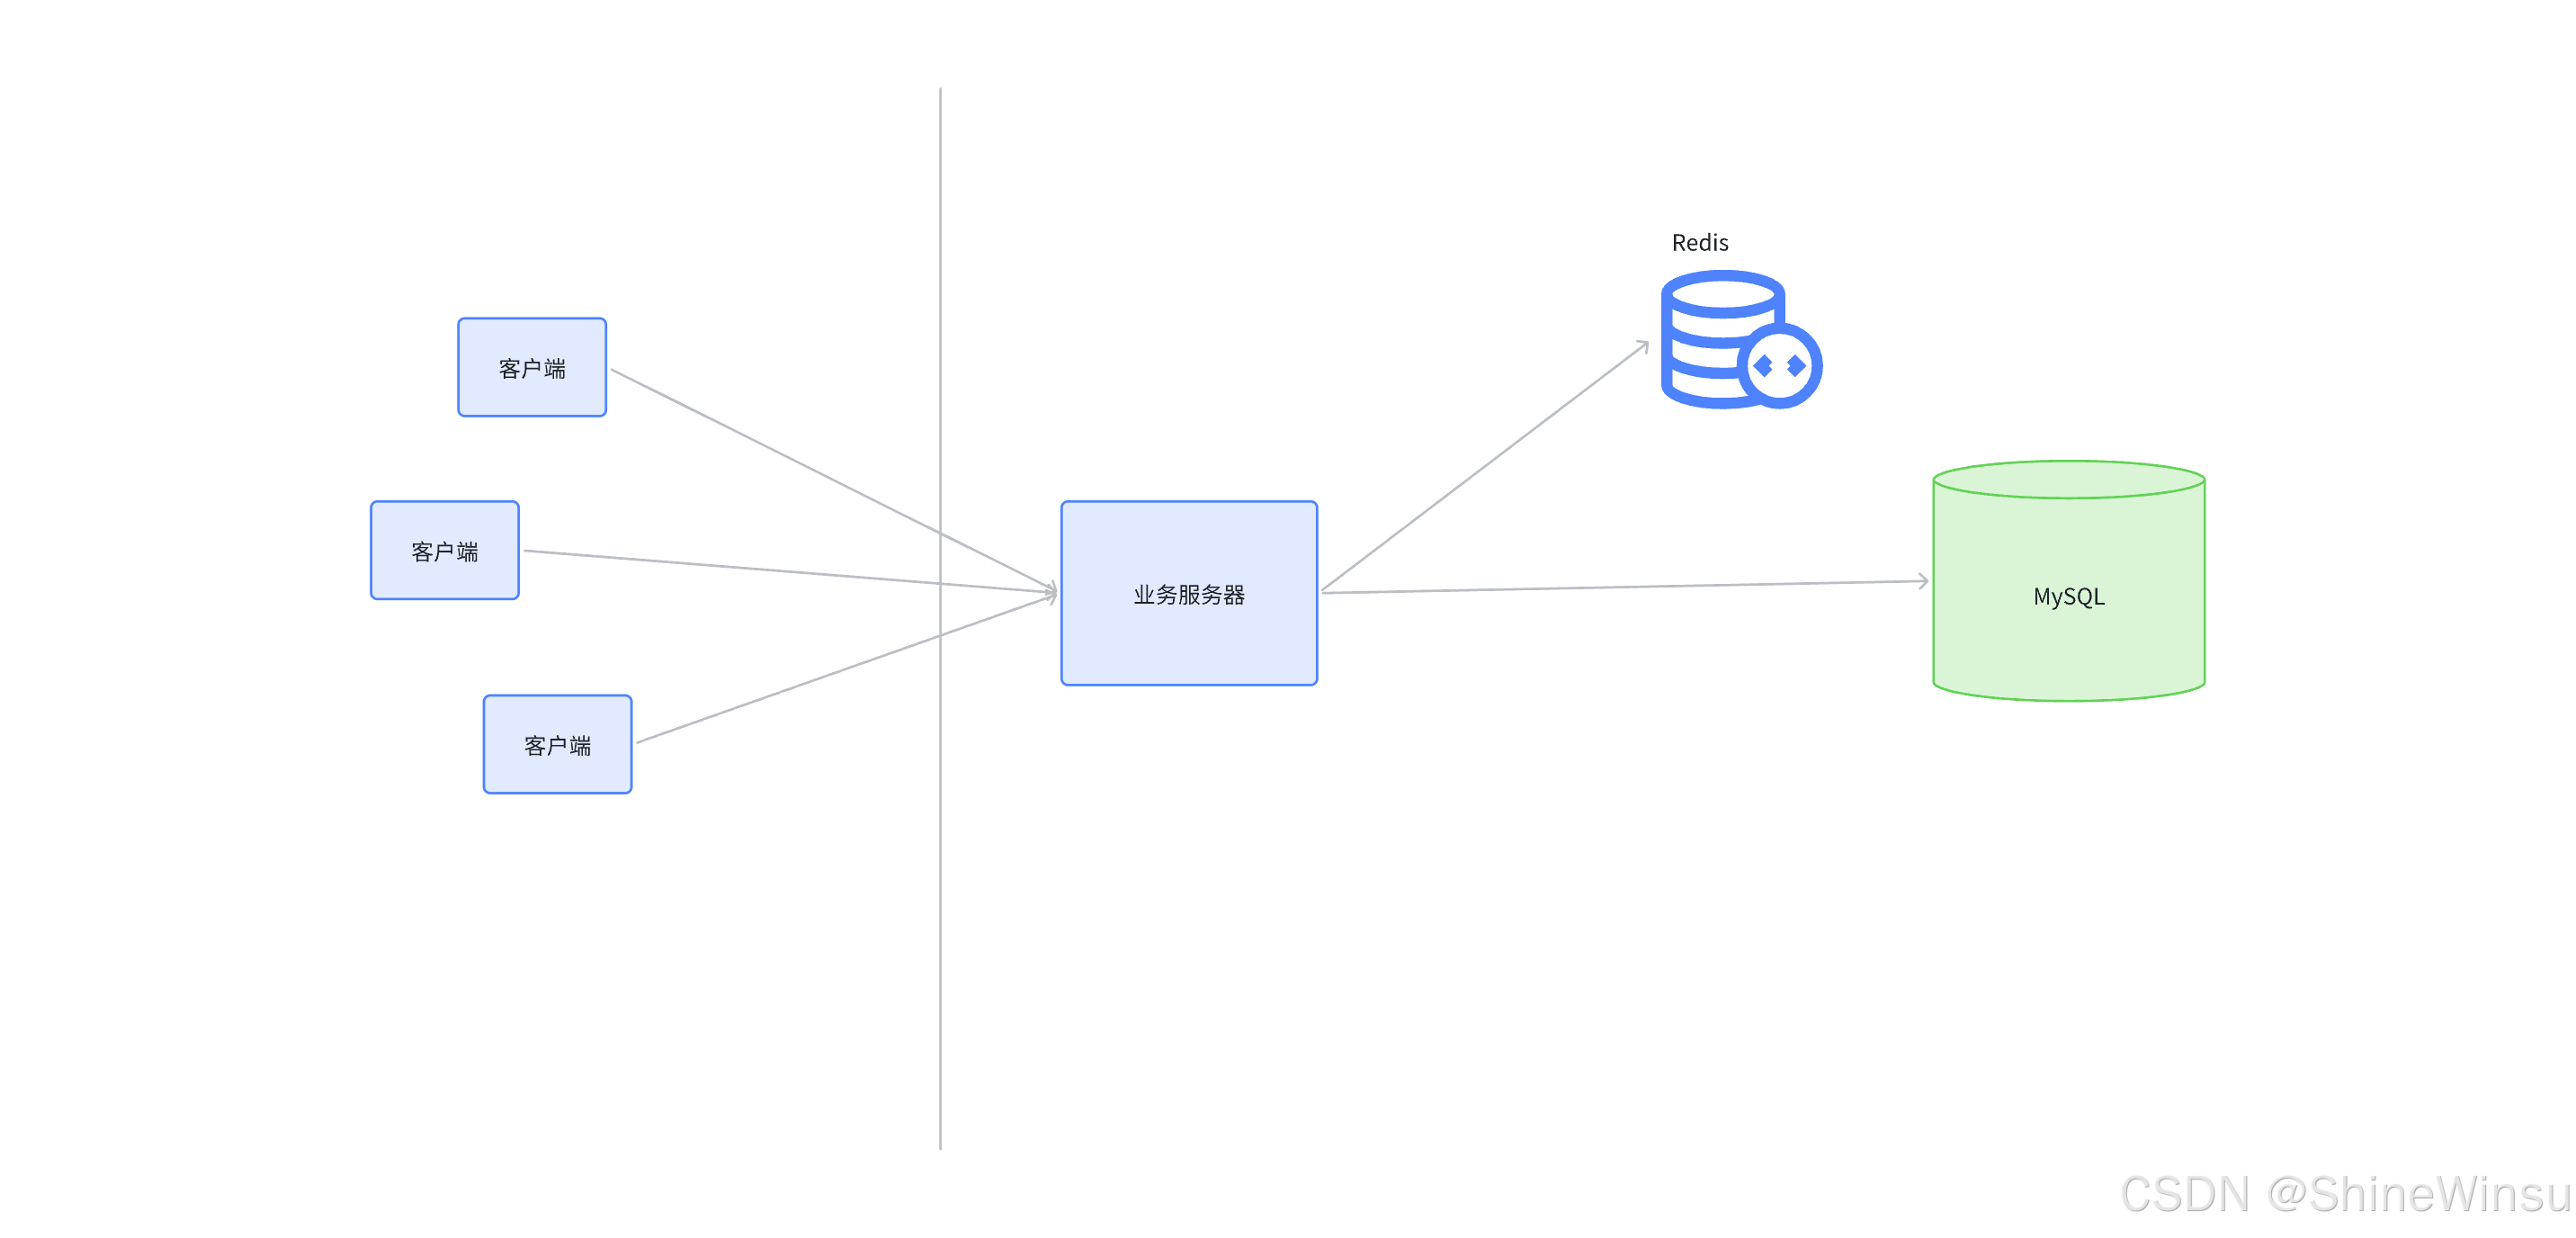
有了 Redis 缓存之后,还是刚才的场景:10 万用户查询商品详情,其中 8 万用户的请求会直接被 Redis 挡住,只有 2 万用户的请求(缓存未命中)会打到 MySQL。MySQL 压力大减,CPU 占用率维持在 30% 以内,网站加载速度依然是 0.1 秒,促销活动顺利进行,用户体验拉满。
这就是缓存的魔力。
1.1 彻底搞懂:什么是缓存?计算机世界的 "就近存取" 哲学
1.1.1 缓存的核心本质:把常用数据放在 "触手可及" 的地方
缓存(Cache) 是计算机领域最经典、最基础的设计思想,没有之一 ------ 它不是 Redis 独有的,不是后端开发独有的,而是贯穿整个计算机体系的通用思想,小到我们的手机、电脑,大到服务器、互联网集群,到处都有缓存的影子。
它的核心逻辑简单到极致,一句话就能说透:把频繁使用、需要反复读取的数据,存放在访问速度更快、拿取更方便的地方,需要用时直接取,不用再去远的、慢的地方找。
再通俗一点:缓存就是 "临时仓库",专门存那些我们经常用、反复用的东西,不用每次都去 "大仓库"(原始存储)找,节省时间、提高效率。
举个贴近生活的例子(每个人每天都在用):你每天早上起床,都会穿衣服、刷牙、洗脸,然后上班。你的衣服放在衣柜里(大仓库,原始存储),牙刷、牙膏放在卫生间的洗手台上(临时仓库,缓存)。
为什么不把牙刷、牙膏也放在衣柜里?因为你每天都要用、反复用,放在洗手台上(触手可及),刷牙时伸手就能拿到,不用每次都去衣柜里翻找 ------ 这就是缓存的逻辑。洗手台就是衣柜的 "缓存",牙刷、牙膏就是 "热点数据"(频繁使用的数据)。
再举一个例子:你平时看手机视频,第一次看一个视频时,会加载很久(因为要从网络上下载到手机);但第二次看同一个视频时,加载速度会特别快,几乎是秒开 ------ 这就是手机的 "本地缓存":第一次下载的视频,会临时存在手机的内存 / 硬盘里(缓存),第二次看的时候,不用再从网络上下载,直接从手机本地取,速度极快。
手机本地缓存、卫生间洗手台、我们平时放钥匙的玄关挂钩、办公室的桌面文件架...... 这些都是缓存的生活化体现。核心都是一样的:就近存取,提速增效。
1.1.2 计算机硬件中的缓存层级:从寄存器到网络,层层缓存
回到计算机世界,硬件的访问速度是有明确层级的 ------ 速度越快的硬件,单位成本越高,存储空间越小;速度越慢的硬件,单位成本越低,存储空间越大。这是计算机世界的铁律,永远不会变。
我们先记住这个硬件访问速度从快到慢的排序:CPU 寄存器 > CPU 高速缓存 > 内存 > 硬盘 > 网络
每一层相对下一层,都是 "触手可及" 的,因此每一层都可以作为下一层的缓存 ------ 也就是说,计算机的缓存是 "层层嵌套" 的,目的就是为了最大化提升数据访问速度。
1. CPU 寄存器:速度最快的 "临时记事本"(缓存 CPU 频繁使用的数据)
CPU 是计算机的 "大脑",负责所有计算操作。它每次计算,都需要用到数据,但它的计算速度太快了(纳秒级),如果每次都去内存里拿数据(微秒级),会浪费大量时间 ------ 就像一个学霸做题,每次都要去书包里找课本,浪费时间。
因此,CPU 内置了寄存器(相当于学霸的 "临时记事本"),把最近频繁计算的数据,临时存在寄存器里。CPU 计算时,先看寄存器里有没有,有就直接用,没有再去内存里拿 ------ 这就是寄存器的作用,它是内存的缓存。
特点:速度最快(纳秒级,1 纳秒 = 10 的 - 9 次方秒),空间最小(只有几 KB~ 几十 KB),成本最高。
2. CPU 高速缓存:寄存器的 "补充仓库"(缓存内存高频数据)
寄存器空间太小,只能存极少数数据,因此 CPU 旁边还有一个高速缓存(L1、L2、L3 缓存,相当于学霸的 "桌面文件夹"),空间比寄存器大(几 MB~ 几十 MB),速度比寄存器慢一点,但依然比内存快很多。
它的作用是:缓存内存中频繁被 CPU 访问的数据,当寄存器里没有数据时,CPU 先查高速缓存,有就直接用,没有再去内存里拿 ------ 它也是内存的缓存,是寄存器和内存之间的 "中间层"。
特点:速度快(十几纳秒~几十纳秒),空间中等,成本中等。
3. 内存:硬盘的 "前置仓库"(缓存硬盘高频数据)
我们平时用的软件(微信、浏览器、MySQL),运行时的数据都会存放在内存里(相当于我们的 "书桌")。硬盘的读写速度很慢(毫秒级),如果软件运行时,每次都去硬盘里拿数据,会特别卡 ------ 就像你办公,每次都去仓库里找文件,效率极低。
因此,内存的作用是:缓存硬盘中频繁被访问的数据(比如软件运行时的核心数据),软件运行时,先从内存里拿数据,有就直接用,没有再去硬盘里拿 ------ 内存是硬盘的缓存。
特点:速度快(微秒级,1 微秒 = 10 的 - 6 次方秒),空间较大(几 GB~ 几百 GB),成本中等。
4. 硬盘:网络的 "本地仓库"(缓存网络高频数据)
我们从网络上下载文件(比如视频、图片),第一次下载时,会从网络上获取数据,然后存到硬盘里;第二次再需要这个文件时,不用再从网络上下载,直接从硬盘里拿 ------ 这就是硬盘的缓存作用,它是网络的缓存。
特点:速度慢(毫秒级),空间极大(几 TB~ 几十 TB),成本极低。
5. Redis(内存数据库):MySQL(硬盘数据库)的 "前置护盾"(我们的核心)
我们后端开发中,MySQL 是硬盘数据库(相当于 "大仓库"),数据存在硬盘里,访问速度慢;Redis 是内存数据库(相当于 "小仓库"),数据存在内存里,访问速度快。
Redis 的作用是:缓存 MySQL 中频繁被查询的数据(热点数据),客户端查询时,先查 Redis,有就直接返回,没有再去 MySQL 里查 ------Redis 是MySQL 的缓存,也是我们今天要讲的核心内容。
总结一下硬件缓存层级的核心逻辑:每一层都在缓存下一层的高频数据,目的是 "就近存取",减少访问慢设备的次数,最大化提升速度。 而 Redis 缓存,就是这个层级中,专门为 MySQL 设计的 "前置缓存",也是后端开发中最常用、最核心的缓存方案。
9.1.3 缓存的天然矛盾:速度 vs 空间 vs 成本
通过上面的拆解,我们能发现一个核心矛盾 ------缓存的速度、空间、成本,三者不可兼得,这是缓存的天然矛盾,也是我们设计缓存时必须考虑的核心点。
我们用一张通俗的表格,把这个矛盾讲透:
| 存储设备 | 访问速度 | 存储空间 | 单位成本 | 对应缓存角色 |
|---|---|---|---|---|
| CPU 寄存器 | 最快(纳秒级) | 最小(几 KB) | 最高 | 内存的缓存 |
| CPU 高速缓存 | 很快(十几纳秒) | 较小(几 MB) | 较高 | 内存的缓存 |
| 内存(Redis) | 快(微秒级) | 中等(几 GB) | 中等 | MySQL 的缓存 |
| 硬盘(MySQL) | 慢(毫秒级) | 大(几 TB) | 低 | 原始存储 |
| 网络 | 最慢(秒级) | 无限 | 最低 | 原始存储 |
从表格中能清晰看到:
- 速度越快 → 空间越小 → 成本越高(比如 CPU 寄存器);
- 速度越慢 → 空间越大 → 成本越低(比如硬盘、网络)。
这就意味着:缓存虽然快,但空间永远是不足的,不可能把所有原始数据都放进缓存(比如我们不可能把硬盘里的几 TB 数据,都放进几 GB 的内存里)。
因此,缓存的设计原则只有一个,也是最核心的原则:只存热点数据(频繁访问的数据),不存冷数据(几乎不用、偶尔访问的数据)。
只有这样,才能用有限的缓存空间,发挥最大的作用 ------ 用极小的成本,换来极致的性能提升。
1.1.4 二八定律:缓存高效的底层逻辑,20% 数据扛 80% 流量
很多小白会问:为什么只存热点数据,就能提升整体系统的性能?根源就是二八定律(也叫帕累托法则),这个法则在缓存领域的体现,比在任何领域都明显。
二八定律的核心内容:20% 的关键因素,能决定 80% 的结果。
在缓存领域,这个法则的具体体现是:20% 的热点数据,能够应对 80% 的访问请求。
我们用 3 个最常见的互联网场景,帮你理解这个法则,看完你就明白,缓存为什么能这么高效:
场景 1:电商网站(比如淘宝、京东)
电商网站的商品有几百万、几千万,但真正被用户频繁查询的,只有 20% 的爆款商品(比如促销商品、热门品类);剩下 80% 的商品,每天只有寥寥几次查询,甚至几天都没人查。
比如双 11 期间,淘宝上的商品有上亿件,但大家都在查 "手机、羽绒服、护肤品" 这些爆款,这些爆款商品(20%),承担了 80% 以上的商品查询流量。我们只需要把这些爆款商品的信息,放进 Redis 缓存,就能挡住 80% 的查询请求,不用再去访问 MySQL。
场景 2:短视频平台(比如抖音、快手)
短视频平台的视频有几十亿条,但真正被用户频繁播放的,只有 20% 的热门视频(比如网红发布的视频、热点事件视频);剩下 80% 的视频,播放量寥寥无几,甚至没人看。
比如某网红发布一条新视频,一天播放量 1 亿次,而平台上其他几十万条视频,一天播放量加起来也不到 1 亿次。我们把这条热门视频的信息(封面、时长、播放量)放进 Redis 缓存,就能挡住绝大部分播放请求,提升平台加载速度。
场景 3:搜索引擎(比如百度、谷歌)
搜索引擎每天要处理几十亿次搜索请求,但用户搜索的关键词,只有 20% 是高频的(比如 "天气、时间、美食、旅游");剩下 80% 的关键词,都是低频的(比如 "2010 年的电视剧有哪些""某个小众品牌的说明书")。
搜索引擎会把这些高频关键词的搜索结果,放进缓存,用户搜索时,直接从缓存里拿,不用再去数据库里查询、计算,加载速度瞬间提升。
这里要强调一点:二八定律不是绝对的 ,不是所有场景都是严格的 20% 数据扛 80% 流量,可能是 19%、30%,但核心逻辑是不变的 ------少数热点数据,承担了大部分访问请求。
我们只需要把这部分少数热点数据,放进缓存,就能挡住大部分请求,不用再去访问慢的原始存储(MySQL),整体系统的性能,就能得到指数级的提升 ------ 这就是缓存的核心价值,也是我们用 Redis 做缓存的根本原因。
1.1.5 缓存的核心价值:3 个维度
通过上面的拆解,我们总结一下缓存的 3 个核心价值,不管是计算机硬件缓存,还是 Redis 缓存,核心都是这 3 点:
- 提升访问速度:这是最核心的价值,把慢设备的高频数据,放到快设备里,减少访问慢设备的次数,从微秒级、毫秒级,提升到纳秒级、微秒级;
- 降低原始存储压力:减少对慢设备(比如 MySQL、硬盘)的访问次数,避免慢设备因为请求过多、资源耗尽而宕机;
- 提升系统并发能力:快设备(比如 Redis、内存)能支持的并发请求,比慢设备多得多(Redis 单机能扛 10 万 + QPS,MySQL 单机只能扛 1 万左右 QPS),缓存能帮系统扛住更多并发。
一句话总结缓存的价值:用有限的缓存空间,换极致的速度、更低的压力、更高的并发。
1.2 为什么一定要用 Redis 做缓存?MySQL 的痛点与 Redis 的优势
在业务开发中,我们最常用的持久化存储是关系型数据库(MySQL),所有核心业务数据(用户、订单、商品、支付)都存在 MySQL 里 ------ 因为 MySQL 功能强大,支持事务、联表查询、权限控制,能保证数据的安全和一致性。
但 MySQL 有一个致命缺陷:性能差、扛不住高并发,尤其是查询请求多的时候,很容易卡死、宕机。而 Redis,就是为了解决这个问题而生的 ------ 它不是要替代 MySQL,而是要作为 MySQL 的 "前置缓存",帮 MySQL 挡住绝大部分查询请求。
1.2.1 先搞懂:关系型数据库 MySQL 的性能瓶颈到底在哪?
很多小白会问:MySQL 功能这么强,为什么性能不行?我们拆解 5 个核心原因,全是大白话,不涉及任何源码、不超纲,每个痛点都配具体场景,让你一看就懂:
痛点 1:数据存在硬盘,IO 速度极慢(最核心的痛点)
MySQL 是硬盘数据库 ,所有数据都存在物理硬盘上 ------ 硬盘的读写速度(IO 速度)和内存比起来,差了100~1000 倍,尤其是随机读写(比如根据商品 ID 查询商品详情),速度慢到离谱。
举个具体的例子:
- 从内存中读取一条数据,只需要 0.1 微秒;
- 从硬盘中读取同一条数据,需要 100 微秒~1 毫秒;
- 速度差了 1000 倍,相当于 "伸手拿桌上的笔" 和 "跑 1 公里去拿一支笔" 的差距。
如果用户每次查询商品详情,都要去硬盘里拿数据,哪怕只有 1 万次查询,MySQL 也要处理 1 秒以上,用户会觉得网站特别卡;如果有 10 万次查询,MySQL 直接就扛不住了。
痛点 2:无索引查询 = 全表遍历,IO 爆炸(最容易踩的坑)
MySQL 查询数据时,如果 SQL 语句没有命中索引,就会进行全表扫描------ 也就是一行一行地找数据,直到找到目标数据为止。
举个具体的例子:一个商品表,有 100 万条商品数据,没有索引,用户查询 "商品 ID=123456" 的商品详情,MySQL 就要从第 1 行开始,一行一行找,直到找到第 123456 行 ------ 这个过程,要进行 123456 次硬盘 IO 操作,耗时几秒甚至几十秒,直接拖慢整个系统。
哪怕有索引,如果索引设计不合理(比如索引字段选错、索引失效),也会触发全表扫描,导致 MySQL 性能断崖式下跌 ------ 这是很多新手开发,最容易踩的坑。
痛点 3:SQL 执行流程复杂,消耗大量资源
MySQL 执行一条 SQL 查询,不是直接去硬盘里拿数据,而是要做一整套复杂的流程,每个流程都要消耗 CPU、内存资源,步骤越多,消耗的资源越多,速度越慢。
我们用大白话,拆解 MySQL 执行一条 SQL 的流程:
- 语法解析:判断 SQL 语句有没有语法错误(比如少写分号、字段名写错);
- 权限校验:判断当前用户,有没有查询这个表、这个字段的权限;
- 查询优化:MySQL 会自动优化 SQL 语句(比如调整联表顺序),生成最优的执行计划;
- 执行计划:按照优化后的计划,去硬盘 / 内存里拿数据;
- 结果处理:把查询到的数据,整理成用户需要的格式,返回给客户端。
这一整套流程,看似简单,但每一步都要消耗资源 ------ 而 Redis,根本没有这些复杂流程,拿到请求,直接去内存里拿数据,返回结果,速度自然快很多。
痛点 4:复杂查询效率极低,计算量暴增
MySQL 支持联表查询、子查询、分组统计、排序、笛卡尔积等复杂查询 ------ 这些查询,虽然功能强大,但计算量极大,会让 MySQL 的 CPU 占用率瞬间拉满,性能直接崩溃。
举个具体的例子:查询 "某个分类下,销量前 10 的商品,并且显示商品的所属商家、商家的评分"------ 这个查询需要关联 3 张表(商品表、商家表、销量表),还要分组、排序、限制条数,MySQL 执行这样一条 SQL,可能需要几百毫秒甚至几秒, 如果有 1000 次这样的查询,MySQL 直接卡死。
而 Redis,根本不支持这样的复杂查询 ------ 它只支持简单的 Key-Value 键值对查询,没有复杂的计算,处理请求极快。
痛点 5:持久化保证安全,但牺牲速度
MySQL 为了保证数据不丢失(比如服务器断电、宕机),会做持久化操作------ 把内存中的数据,定期写入硬盘,还要记录日志(binlog、redo log),一旦出现故障,能通过日志恢复数据。
这些持久化操作,虽然保证了数据安全,但也牺牲了速度 ------ 每次写入数据,都要额外写入日志、落盘,增加了硬盘 IO 操作,拖慢了 MySQL 的速度。
总结一下 MySQL 的核心痛点:MySQL 是为了 "数据安全、功能强大" 设计的,不是为了 "高并发、快速度" 设计的------ 它就像一个 "细心的档案管理员",虽然能把档案整理得井井有条、保证不丢失,但找档案的速度很慢,处理不了太多人同时找档案。
而我们的互联网系统,需要的是 "快速响应、扛住高并发"------ 这就是 MySQL 做不到的,也是我们需要 Redis 做缓存的根本原因。
1.2.2 高并发下,数据库为什么会宕机?资源耗尽的真相
再回答一个问题:为什么并发量高了,MySQL 就会宕机? 很多新手以为,是 MySQL "不够强",其实不是,核心原因是 ------服务器的硬件资源是有限的。
我们用拆解宕机的过程,就像 "排队买东西" 的场景,看完你就懂:
1. 服务器处理请求,需要消耗资源
服务器(不管是 MySQL 服务器,还是 Redis 服务器),每次处理一个请求,都要消耗硬件资源------ 主要是 CPU、内存、硬盘 IO、网络带宽。
比如,用户查询一次商品详情,MySQL 需要:
- 用 CPU 解析 SQL、执行查询;
- 用内存存储查询过程中的临时数据;
- 用硬盘 IO 读取商品数据;
- 用网络带宽把数据返回给客户端。
一个请求,消耗一份资源;10 个请求,消耗 10 份资源;10000 个请求,消耗 10000 份资源 ------ 而一台服务器的硬件资源,是有限的(比如 CPU 只有 8 核、内存只有 16GB、硬盘 IO 每秒只能处理 1000 次)。
2. 并发量超过承载极限,资源耗尽
当并发请求数,超过 MySQL 服务器的承载极限时,就会出现 "资源耗尽" 的情况:
- CPU 占用率 100%:所有 CPU 资源都用来处理请求,没有多余的资源处理新请求;
- 内存耗尽:所有内存都用来存储临时数据,新请求无法分配到内存,直接报错;
- 硬盘 IO 满了:硬盘每秒只能处理 1000 次 IO 操作,但有 10000 次查询请求,IO 队列堆积,所有请求都要排队,超时失败;
- 网络带宽满了:数据无法及时返回给客户端,请求超时,服务器压力越来越大。
3. 资源耗尽后,MySQL 宕机
当资源耗尽,且请求还在不断涌入时,MySQL 的程序就会出现 "线程阻塞、队列堆积"------ 就像排队买东西,队伍排得太长,收银员忙不过来,后面的人越来越多,最终收银员直接累倒,没人收银了。
再严重一点,MySQL 的程序代码会因为 "资源不足" 而崩溃,服务器进程终止,MySQL 直接宕机 ------ 整个业务的核心存储,彻底失效,网站、APP 无法正常运行,造成巨大的损失。
举个具体的例子:一台 MySQL 服务器,单机最多能扛 1 万 QPS(每秒 1 万次查询请求),当并发量达到 2 万 QPS 时,CPU 占用率瞬间 100%,硬盘 IO 满了,新请求无法处理,队列堆积,再过 5 分钟,MySQL 进程崩溃,宕机。
这就是高并发下,MySQL 必挂的根本原因 ------ 不是 MySQL 不行,是它的设计,就不适合处理这么多并发请求。
1.2.3 数据库扛高并发的两大方案:开源 vs 节流
既然 MySQL 扛不住高并发,那我们怎么让数据库,能扛住高并发请求(比如双 11 的 10 万 + QPS)?核心思路只有两条路,生产环境中,这两条路一定是搭配使用的:
方案 1:开源 ------ 加机器,堆硬件(用钱解决问题)
核心逻辑:买更多的服务器,部署更多的 MySQL 实例,做成主从复制、分库分表集群,用机器的数量,来扛住高并发请求。
简单说,就是 "一个人扛不住,就找一群人一起扛"------ 比如一台 MySQL 能扛 1 万 QPS,10 台 MySQL 就能扛 10 万 QPS,就能应对双 11 的高并发。
具体实现:
- 主从复制:一台主 MySQL(负责写请求,比如下单、修改商品),多台从 MySQL(负责读请求,比如查询商品),主库的数据同步到从库,读请求分散到多台从库,减轻主库压力;
- 分库分表:把一个大的数据库,分成多个小数据库(分库),把一张大表,分成多个小表(分表),比如把 1 亿条订单数据,分成 10 个小表,每个小表 1000 万条数据,查询速度更快,也能分担压力。
优点:
- 能扛住极大的并发请求(比如 10 万 +、100 万 + QPS);
- 能存储极大的数据量(比如几十亿、几百亿条数据);
- 稳定性高,一台机器宕机,其他机器能继续工作。
缺点:
- 成本极高:需要买更多的服务器、更多的硬件资源,还需要专人维护;
- 架构复杂:主从复制、分库分表的配置、维护,非常复杂,新手很难搞定;
- 运维难度大:集群中的机器越多,出现故障的概率越高,运维成本越高。
这种方案,适合大型互联网公司(比如阿里、腾讯、京东),他们有足够的资金、足够的运维人员,能支撑起复杂的集群架构。
方案 2:节流 ------ 加缓存,挡请求(用技术解决问题)
核心逻辑:引入Redis 缓存,把 MySQL 中的热点数据,放到 Redis(内存数据库)里,让绝大部分查询请求,都直接访问 Redis,不访问 MySQL------ 相当于 "在 MySQL 前面,加了一道护盾",挡住绝大部分请求,减轻 MySQL 的压力。
简单说,就是 "不让太多人去麻烦 MySQL,让 Redis 先挡一部分"------ 比如 10 万 QPS 的查询请求,8 万 QPS 被 Redis 挡住,只有 2 万 QPS 访问 MySQL,MySQL 就能轻松扛住。
具体实现(后续详细讲,这里先了解):
- 客户端查询数据时,先查 Redis,有就直接返回;
- 没有就查 MySQL,查到后,把数据写入 Redis,方便下次查询;
- 写请求(比如下单),直接写 MySQL,写完后,更新 / 删除 Redis 中的旧数据,保证数据一致。
优点:
- 成本极低:Redis 可以部署在单机上,不需要太多硬件资源,甚至可以和 MySQL 部署在同一台服务器(测试环境);
- 架构简单:配置、维护都很简单,新手也能快速上手;
- 性能提升极快:Redis 的速度是 MySQL 的 1000 倍以上,能瞬间提升系统的访问速度;
- 门槛低:不需要复杂的运维知识,只要掌握基本的 Redis 操作,就能实现。
缺点:
- 只能加速读请求:缓存不能加速写请求(写请求必须写 MySQL);
- 不能存储大量数据:Redis 是内存数据库,空间有限,只能存热点数据,不能存全量数据;
- 存在数据一致性问题:缓存和 MySQL 的数据,可能会出现不一致(后续会讲怎么解决)。
这种方案,适合所有互联网公司 ------ 不管是小型创业公司,还是大型互联网公司,都会用 Redis 做缓存,它是 "节流" 的核心,也是最性价比最高的高并发解决方案。
生产环境的标准做法:
开源 + 节流,搭配使用:
- 用 Redis 缓存,挡住 80% 的查询请求,减轻 MySQL 压力;
- 用 MySQL 主从复制、分库分表集群,扛住剩下的 20% 请求,存储全量数据;
- 两者结合,既能保证高并发、快速度,又能保证数据安全、稳定性。
1.2.4 Redis 凭什么成为缓存王者?
同样是存数据,为什么 Redis 能做缓存,MySQL 不行?为什么不用其他内存数据库(比如 Memcached)做缓存?因为 Redis 有四大天生优势,完美适配缓存场景,碾压 MySQL,也比其他内存数据库更强大 ------ 这四大优势,是 Redis 成为缓存王者的根本原因
优势 1:纯内存读写,速度极致(最核心的优势)
Redis 是内存数据库,所有数据都存在内存中,不存在硬盘 IO 的瓶颈 ------ 这是 Redis 速度快的核心原因,也是和 MySQL 最本质的区别。
我们用具体的数值,感受一下 Redis 和 MySQL 的速度差距:
- Redis:单机支持 10 万 + QPS(每秒处理 10 万次请求),响应时间 0.1~1 微秒;
- MySQL:单机支持 1 万左右 QPS(每秒处理 1 万次请求),响应时间 10~100 毫秒;
速度差距 100~1000 倍 ------ 相当于 "火箭" 和 "自行车" 的差距。
举个具体的例子:10 万用户同时查询商品详情,用 Redis,1 秒就能处理完所有请求,用户感觉秒开;用 MySQL,10 秒才能处理完,用户早就不耐烦,关掉网站了。
而且,Redis 的读写操作,都是内存操作,没有硬盘 IO 的消耗,也没有复杂的 SQL 解析流程,处理请求极快 ------ 拿到请求,直接根据 Key 找数据,找到就返回,全程没有多余步骤。
优势 2:数据结构简单,无复杂逻辑,消耗资源极少
Redis 只支持Key-Value 键值对存储,数据结构非常简单(字符串、哈希、列表、集合、有序集合),没有 MySQL 的联表、子查询、事务、权限校验等复杂逻辑 ------ 这就意味着,Redis 处理请求时,消耗的 CPU、内存资源,比 MySQL 少得多。
举个例子:Redis 处理一个查询请求,只需要做两件事:
- 根据 Key,在内存中找到对应的值;
- 把值返回给客户端。
全程不需要解析 SQL、不需要校验权限、不需要优化查询计划,消耗的资源微乎其微 ------ 哪怕有 10 万次请求,Redis 的 CPU 占用率,也不会超过 50%。
而 MySQL 处理一个查询请求,要做一整套复杂流程(前面讲过),消耗的资源比 Redis 多得多 ------10 万次请求,MySQL 的 CPU 直接拉满,宕机。
优势 3:单线程 + IO 多路复用,高并发无压力
很多小白会有疑问:Redis 是单线程的,为什么能扛住 10 万 + QPS?单线程不是应该很慢吗?
这里要纠正一个误区:单线程不一定慢,多线程不一定快------ 尤其是在 IO 密集型场景(比如缓存查询,大部分时间都在等待 IO 操作),单线程反而更快,因为没有线程切换的开销。
Redis 的单线程设计,有两个核心优势:
- 没有线程切换开销:多线程需要频繁切换线程,每次切换都要消耗 CPU 资源,而单线程不需要,全程只执行一个线程,资源消耗极少;
- 没有线程安全问题:多线程会出现线程安全问题(比如多个线程同时修改同一份数据),需要加锁,而单线程不需要,避免了锁的开销。
再加上 Redis 采用了IO 多路复用技术(通俗说,就是 "一个线程,同时处理多个 IO 请求")------ 相当于一个收银员,同时处理多个排队的顾客,不用每个顾客都安排一个收银员,效率极高。
举个生活化的例子:一个收银员(单线程),同时处理 10 个顾客的付款请求,顾客付款时,需要找零、扫码(相当于 IO 等待),收银员可以在顾客找零的间隙,处理下一个顾客的扫码 ------ 这就是 IO 多路复用,一个线程,能同时处理多个请求,提升并发能力。
正是因为 "单线程 + IO 多路复用",Redis 单机就能扛住 10 万 + QPS,比多线程的 MySQL、Memcached,并发能力更强,资源消耗更少。
优势 4:功能丰富,完美适配缓存场景(比其他内存数据库强)
Redis 不仅速度快、并发高,还支持很多实用功能,完美适配缓存的所有需求 ------ 这也是它比其他内存数据库(比如 Memcached)更受欢迎的原因。
我们重点讲几个缓存场景中,最常用的功能:
- 过期时间:可以给每个 Key 设置过期时间,自动删除过期数据,不用手动清理(比如商品缓存,设置 1 小时过期,避免缓存数据一直占用内存);
- 淘汰策略:当 Redis 内存满了,会自动触发淘汰策略,删掉不热门的数据,腾空间存新数据(比如淘汰最久未使用的数据);
- 持久化:支持 RDB、AOF 两种持久化方式,能把内存中的数据,定期写入硬盘,避免 Redis 宕机后,数据丢失;
- 集群支持:支持主从复制、哨兵、集群,能实现高可用(一台 Redis 宕机,其他 Redis 能继续工作),扛住更大的并发;
- 原子操作:支持 incr、decr 等原子操作,能避免并发问题(比如商品库存,多个用户同时下单,不会出现超卖)。
这些功能,都是缓存场景中,必须用到的 ------ 比如过期时间、淘汰策略,是缓存的核心需求;持久化、集群,是生产环境的必备需求。
而其他内存数据库(比如 Memcached),功能非常简单,不支持过期时间、持久化、集群,无法满足生产环境的缓存需求 ------ 这就是 Redis 成为缓存王者的关键,也是我们首选 Redis 做缓存的原因。
总结一下 Redis 的核心优势:纯内存读写(快)+ 数据结构简单(省资源)+ 单线程 + IO 多路复用(高并发)+ 功能丰富(适配缓存) ------ 这四大优势,让 Redis 成为缓存的 "绝对王者",也是 MySQL 最完美的 "前置护盾"。
1.2.5 Redis 缓存的标准工作流程:读写分离
Redis 作为 MySQL 的缓存,有标准的读写流程------ 读请求走 Redis,写请求走 MySQL,写完 MySQL 再更新 Redis,保证数据一致。所有业务开发,都是按这个流程实现的
我们拆成「读请求流程」和「写请求流程」两步讲
1.2.5.1 读请求流程(核心,缓存加速的关键)
读请求是缓存发挥作用的核心场景 ------80% 的读请求,都会被 Redis 挡住,不访问 MySQL。
标准流程(共 4 步):
- 客户端(比如用户的手机 APP、浏览器)发起查询请求(比如查询商品 ID=123 的商品详情),请求打到业务服务器(比如 Java 服务器、Python 服务器);
- 业务服务器收到请求后,先查询 Redis:根据 Key(比如 "goods:123"),在 Redis 中查找对应的数据;
- ✅ 如果 Redis 中有数据(称为 "缓存命中"):业务服务器直接从 Redis 中拿到数据,不用访问 MySQL,直接返回给客户端;
- ❌ 如果 Redis 中没有数据(称为 "缓存未命中"):业务服务器再去查询 MySQL;
- 业务服务器从 MySQL 中查到数据后,把数据写入 Redis(方便下次查询时,能命中缓存),同时给数据设置一个过期时间(避免缓存数据一直占用内存);
- 业务服务器把从 MySQL 中查到的数据,返回给客户端。
流程图:
客户端 → 业务服务器 → 查 Redis → 缓存命中 → 返回数据↓缓存未命中 → 查 MySQL → 写入 Redis → 返回数据
通俗类比(排队买东西):
- 客户端 = 买东西的顾客;
- 业务服务器 = 导购员;
- Redis = 导购员的 "小仓库"(存热门商品);
- MySQL = 商场的 "大仓库"(存所有商品)。
顾客(客户端)问导购员(业务服务器):"有没有商品 123?"导购员先去自己的小仓库(Redis)找,有就直接给顾客(缓存命中);没有,就去商场的大仓库(MySQL)找,找到后,先放一个在自己的小仓库(写入 Redis),再给顾客(返回数据);下次再有顾客问商品 123,导购员直接从小仓库拿,不用再去大仓库。
核心注意点:
- 必须 "先查 Redis,再查 MySQL":不能反过来,否则缓存就失去了作用;
- 缓存未命中后,一定要 "写入 Redis":否则下次查询,还是会查 MySQL,缓存永远无法生效;
- 一定要给缓存数据设置 "过期时间":避免缓存数据一直占用内存,也避免缓存数据和 MySQL 数据不一致(后续讲)。
1.2.5.2 写请求流程(重点:缓存不负责写加速,只负责同步)
写请求(比如新增商品、修改商品、下单、删除商品),不能走缓存 ------ 因为缓存是内存存储,断电数据会丢,无法保证数据安全,必须直接写 MySQL。
写请求的核心要求:保证缓存和 MySQL 的数据一致------ 写完 MySQL 后,必须更新 / 删除 Redis 中的旧数据,避免 Redis 中存的是旧数据,客户端查询时,拿到错误的数据。
标准流程(共 4 步):
- 客户端发起写请求(比如修改商品 ID=123 的价格,从 100 元改成 120 元),请求打到业务服务器;
- 业务服务器收到请求后,直接写 MySQL:把商品价格修改到 MySQL 中(保证数据安全);
- 写完 MySQL 后,更新 / 删除 Redis 中的旧数据:
- 方案 1(推荐):直接删除 Redis 中对应的 Key(比如 "goods:123")------ 下次客户端查询时,缓存未命中,会查 MySQL,拿到新数据,再写入 Redis,保证数据一致;
- 方案 2:直接更新 Redis 中对应的 Value------ 把商品价格从 100 改成 120,这种方式也可以,但不如删除安全(比如更新失败,会导致 Redis 和 MySQL 数据不一致);
- 业务服务器返回 "写入成功" 给客户端。
流程图:
客户端 → 业务服务器 → 写 MySQL → 更新 / 删除 Redis → 返回写入成功
通俗类比(修改商品价格):
顾客(客户端)让导购员(业务服务器):"把商品 123 的价格,改成 120 元";导购员先去商场的大仓库(MySQL),把商品 123 的价格改成 120 元(保证数据安全);然后,导购员把自己小仓库(Redis)里的商品 123,要么删掉,要么把价格改成 120 元(避免下次给顾客旧价格);最后,告诉顾客 "修改成功"。
核心注意点:
- 必须 "先写 MySQL,再更新 / 删除 Redis":不能反过来(先删 Redis,再写 MySQL)------ 如果先删 Redis,再写 MySQL,中间有其他客户端查询,会查 MySQL,拿到旧数据,写入 Redis,导致数据不一致;
- 写请求不能走 Redis:不能直接写 Redis,再写 MySQL------Redis 是内存存储,断电数据会丢,一旦 Redis 宕机,写请求的数据就会丢失;
- 推荐用 "删除 Redis Key" 的方式,同步数据:比更新 Value 更安全,避免更新失败,导致数据不一致;
- 如果写请求频繁(比如频繁修改商品价格),可以适当延迟删除 Redis Key(比如延迟 1 秒),减少 Redis 的删除操作,提升性能(后续实战会讲)。
1.2.6 关键提醒:缓存只加速读,写操作别指望缓存
这里必须敲黑板、划重点,强调一个核心误区------ 刚接触缓存时,都会犯这个错:
缓存只能加快「读操作」的速度,绝对不能加快「写操作」的速度!
原因有两个:
- 写操作需要 "保证数据绝对安全、不丢失":写请求(比如下单、修改商品),是核心业务数据,必须存到硬盘(MySQL)中,才能保证数据不丢失;而 Redis 是内存存储,断电数据会丢,不能存核心写数据 ------ 哪怕你先写 Redis,最后还是要写 MySQL,反而多了一步操作,变慢了;
- 写操作的瓶颈,不在 "查询",而在 "持久化":写请求的核心开销,是 MySQL 的硬盘 IO、日志落盘,这些开销,缓存无法解决 ------ 缓存只能解决 "读请求的查询速度",无法解决 "写请求的持久化速度"。
举个具体的例子:
- 读请求:查询商品详情,用 Redis,0.1 微秒就能返回;用 MySQL,10 毫秒才能返回 ------ 缓存能加速 100 倍;
- 写请求:修改商品价格,写 MySQL,需要 1 毫秒(硬盘 IO + 日志落盘);用 Redis,写内存需要 0.01 微秒,但最后还是要写 MySQL,总耗时 1.01 微秒 ------ 几乎没有加速效果,还增加了数据不一致的风险。
因此,所有写操作,都要老老实实写 MySQL,不要指望缓存能加速写操作 ------ 缓存的核心价值,就是 "帮 MySQL 挡读请求",不是 "帮 MySQL 加速写请求"。
1.3 缓存的更新与淘汰:如何让缓存永远存的是 "热点数据"?
通过前面的拆解,我们知道:缓存空间是有限的(Redis 是内存数据库,空间不可能无限大),不可能把 MySQL 中的所有数据,都放进 Redis 缓存 ------ 我们只能存热点数据(频繁访问的数据)。
但这里有两个核心问题:
- 热点数据怎么来? ------ 我们怎么知道,哪些数据是频繁访问的热点数据,哪些是偶尔访问的冷数据?(这就是缓存更新策略);
- 缓存满了怎么办? ------ 当 Redis 内存满了,新的热点数据要写入,没有空间了,该删掉哪些数据,腾空间存新数据?(这就是缓存淘汰策略)。
这两个问题,是缓存设计的核心,也是生产环境中,最容易踩坑的地方 ------ 如果缓存更新、淘汰策略设计不好,缓存中存的都是冷数据,热点数据反而没地方存,缓存就失去了作用,MySQL 依然会被打崩。
1.3.1 缓存数据从哪来?两种热点数据生成策略
缓存中的热点数据,不是 "手动录入" 的 ------ 手动录入效率低、实时性差,无法适配业务的动态变化(比如突发热点数据)。
1.3.1.1 策略 1:定期生成(离线统计高频数据,稳但实时性差)
核心逻辑
每隔一个固定的周期(比如 1 天、1 周、1 个月),离线统计MySQL 中所有数据的访问频次,选出访问量最高的前 N% 数据(比如前 20%),作为热点数据,提前写入 Redis 缓存 ------ 相当于 "每天凌晨,统计一下昨天的热门商品,手动放进 Redis 缓存"。
具体实现步骤:
- 日志收集:业务服务器,记录每一次用户的查询请求(比如用户查询了哪个商品、哪个用户、哪个订单),生成访问日志,存在硬盘里;
- 离线统计:每天凌晨(业务低峰期),用大数据工具(比如 Hadoop、Spark,小白不用懂,知道有这个工具就行),分析昨天的所有访问日志,统计每个数据的访问次数;
- 筛选热点:选出访问次数最高的前 20% 数据(比如昨天查询次数前 1000 的商品),作为热点数据;
- 写入缓存:写一个定时脚本,把筛选出的热点数据,批量写入 Redis 缓存,同时设置过期时间(比如 1 天,和统计周期一致);
- 循环执行:每天凌晨,重复上面的步骤,更新缓存中的热点数据。
实战案例:搜索引擎高频词缓存(最典型的定期生成场景)
百度、谷歌等搜索引擎,就是用这种策略,生成热点数据缓存:
- 记录所有用户的搜索日志(比如用户什么时候、搜索了什么关键词);
- 每天凌晨,用大数据工具,分析昨天的搜索日志,统计每个关键词的搜索次数;
- 选出搜索次数最高的前 20% 关键词(比如 "天气、美食、旅游、手机"),作为高频关键词;
- 把这些高频关键词的搜索结果,提前写入 Redis 缓存;
- 用户搜索这些高频关键词时,直接从 Redis 中拿搜索结果,不用再去数据库里查询、计算,加载速度极快。
再比如电商网站的 "每日爆款商品":每天凌晨,统计昨天所有商品的查询次数、下单次数,选出爆款商品,提前写入 Redis 缓存,第二天用户访问时,直接从缓存中拿,提升访问速度。
优点:
- 逻辑简单,容易实现:不用复杂的代码,只要收集日志、离线统计、批量写入,就能实现;
- 不影响在线业务:统计、写入缓存,都是在业务低峰期(凌晨)执行,不会占用在线业务的资源,不会影响用户访问;
- 缓存数据稳定:热点数据是提前筛选好的,不会频繁变动,缓存命中率高(用户查询时,大概率能命中缓存)。
缺点):
- 实时性极差(最核心的缺点):热点数据是 "昨天的",无法应对突发热点数据 ------ 比如春节期间,"春晚" 这个关键词,平时搜索次数很少,属于冷数据,不会被统计到,但春节当天,搜索次数暴涨,成为超级热点数据,而定期生成策略,要等到第二天凌晨,才能把 "春晚" 写入缓存,春节当天的大量搜索请求,都会直接打 MySQL,导致 MySQL 被打崩;
- 热点数据更新慢:统计周期是 1 天,热点数据只能每天更新一次 ------ 如果某个商品,上午突然成为热点,要等到第二天凌晨,才能被写入缓存,上午的大量查询请求,还是会打 MySQL;
- 无法适配动态变化的业务:业务是动态变化的,热点数据也会动态变化(比如某网红突然推荐一个商品,该商品瞬间成为热点),定期生成策略,无法及时捕捉这种动态变化;
- 统计成本高:如果业务量大,访问日志会非常多(比如每天 10 亿条日志),分析这些日志,需要大数据工具、大量的服务器资源,成本很高。
适用场景:
- 热点数据相对稳定,不会有突发热点的业务(比如企业内部系统、后台管理系统,访问量稳定,热点数据变化慢);
- 对实时性要求不高的业务(比如每日爆款商品、高频搜索词,允许有一天的延迟)。
1.3.1.2 策略 2:实时生成(按需写入 + 自动淘汰)
核心逻辑
这种策略完全抛弃 "离线统计",采用 "按需写入、自动淘汰" 的思路,全程自动化,不用人工干预,能完美适配动态变化的业务和突发热点数据,核心逻辑就 3 步:
- 先给 Redis 设置内存上限(通过 maxmemory 参数,比如设置 1GB),明确缓存的最大空间,避免 Redis 占用过多内存,导致服务器卡顿;
- 用户发起查询请求时,按需写入缓存:业务服务器先查 Redis,命中就直接返回;未命中就查 MySQL,查到后,立刻把数据写入 Redis,供下次查询使用;
- 当 Redis 内存达到设置的上限(缓存满了),自动触发缓存淘汰策略(比如淘汰最久未使用的数据),删掉缓存中 "相对不热门" 的冷数据,腾出新的空间,存新的热点数据。
简单说,就是 "用户查一次,就存一次,满了就删不常用的"------ 持续一段时间后,Redis 缓存中,自然就只剩下 "频繁被查询" 的热点数据,冷数据会被自动淘汰,不用人工筛选、不用离线统计。
具体实现步骤
结合前面讲的 Redis 缓存读请求流程,实时生成策略的实现步骤,其实就是读请求的标准流程:
- 配置 Redis 内存上限和淘汰策略:
- 设置 maxmemory 1gb(Redis 最大内存 1GB);
- 设置 maxmemory-policy allkeys-lru(内存满时,淘汰所有 Key 中最久未使用的,生产首选);
- 客户端发起查询请求(比如查询商品 ID=456 的商品详情),打到业务服务器;
- 业务服务器先查 Redis,根据 Key(goods:456)查找数据:
- 缓存命中:直接返回数据,流程结束;
- 缓存未命中:去 MySQL 查询数据;
- 从 MySQL 查到数据后,立刻把数据写入 Redis(Key=goods:456,Value = 商品详情),同时设置过期时间(比如 3600 秒 + 随机 600 秒,避免大量 Key 同时过期,后续讲缓存雪崩会详细说);
- 返回数据给客户端;
- 当 Redis 内存达到 1GB(设置的上限),新的查询请求未命中,查 MySQL 后要写入 Redis 时,Redis 会自动触发 allkeys-lru 策略,淘汰最久未使用的 Key(比如一个星期没被查询的商品缓存),腾空间存新的数据;
- 循环执行 2-6 步,持续一段时间后,Redis 中存的,都是频繁被查询的热点数据,冷数据被自动淘汰。
实战案例:电商网站商品详情缓存
几乎所有电商网站的商品详情缓存,都用这种实时生成策略:
- 没有人工统计热点商品,也没有凌晨批量写入缓存;
- 用户查询任何一个商品,只要缓存未命中,就查 MySQL,然后写入 Redis;
- 当 Redis 内存满了,自动淘汰最久未使用的商品缓存(比如一个月没人查的小众商品);
- 当某网红突然推荐一个小众商品,该商品的查询请求瞬间暴涨:
- 第一个用户查询,缓存未命中,查 MySQL,写入 Redis;
- 第二个、第三个...... 第 10000 个用户查询,都命中缓存,直接返回,不用查 MySQL;
- 该商品瞬间成为热点数据,被 Redis 缓存起来,挡住所有查询请求;
- 当该商品热度下降,查询次数减少,长时间未被查询,Redis 会自动淘汰它的缓存,腾空间存其他热点商品。
再比如短视频平台的视频详情缓存:
- 用户播放任何一个视频,第一次播放(缓存未命中),查 MySQL(获取视频详情、播放量),写入 Redis;
- 后续用户播放该视频,都命中缓存,秒开视频;
- 视频热度下降,长时间未被播放,Redis 自动淘汰它的缓存,腾空间存新的热门视频。
优点
- 实时性拉满(最核心的优点):能瞬间捕捉突发热点数据 ------ 只要有用户查询,就能把数据写入缓存,下一个用户查询,就能命中缓存,不管是春晚、网红推荐,还是突发事件,都能完美应对,不会出现 "热点数据没缓存" 的情况;
- 完全自动化,无需人工干预:不用收集日志、不用离线统计、不用批量写入,全程由 Redis 的淘汰策略和业务流程自动完成,节省人力、物力;
- 能适配动态变化的业务:业务是动态的,热点数据也是动态的,这种策略能实时跟随业务变化,缓存中的数据,永远是当前最热门的,缓存命中率高;
- 成本极低:不用大数据工具,不用额外的服务器资源,只要配置好 Redis 的内存上限和淘汰策略,就能实现,适合所有规模的业务(从创业公司到大型互联网公司);
- 缓存空间利用率最高:Redis 会自动淘汰冷数据,腾空间存热点数据,有限的缓存空间,能发挥最大的作用,不会出现 "缓存空间被冷数据占用" 的情况。
缺点
- 缓存冷启动问题:Redis 刚启动时,缓存是空的,所有查询请求都会直接打 MySQL,导致 MySQL 在 Redis 启动初期,会有短暂的压力 ------ 这个问题,后续讲 "缓存预热" 时,会详细说解决方案(提前写入部分热点数据,缓解冷启动压力);
- 缓存命中率初期较低:Redis 刚启动时,缓存是空的,缓存命中率几乎为 0,随着用户查询增多,缓存逐渐被填充,命中率会慢慢提升(一般运行 1-2 小时后,命中率能达到 80% 以上);
- 可能出现 "缓存抖动":如果某个数据,偶尔被查询一次,写入缓存后,很快又被淘汰,反复写入、反复淘汰,会消耗少量 Redis 资源 ------ 这个问题,可通过设置合理的过期时间,缓解(比如给不常用的数据,设置较短的过期时间)。
适用场景
- 所有有突发热点数据的业务(比如电商、短视频、社交、新闻、搜索引擎);
- 对实时性要求高的业务(比如商品详情、视频详情、新闻内容,要求热点数据能瞬间被缓存);
- 业务量不确定、热点数据动态变化的业务(比如创业公司的业务,用户量、热点数据变化快);
- 所有中小规模业务、大部分大型互联网公司的核心业务(90% 的业务,都适合用这种策略)。
两种热点数据生成策略对比
| 对比维度 | 策略 1:定期生成 | 策略 2:实时生成 |
|---|---|---|
| 核心逻辑 | 离线统计,批量写入 | 按需写入,自动淘汰 |
| 实时性 | 极差(延迟 1 天 / 1 周) | 极高(瞬间缓存) |
| 是否需要人工干预 | 需要(配置统计脚本、批量写入) | 不需要(完全自动化) |
| 缓存命中率 | 初期高,突发热点时低 | 初期低,运行后高(80%+) |
| 成本 | 高(需要大数据工具、额外服务器) | 低(仅需配置 Redis) |
| 适用业务 | 热点稳定、实时性要求低 | 突发热点多、实时性要求高 |
| 生产使用率 | 10% | 90% |
选型建议
- 如果你是做企业内部系统、后台管理系统,访问量稳定,热点数据变化慢,对实时性要求不高 → 用策略 1:定期生成;
- 如果你是做电商、短视频、社交、新闻等面向 C 端用户的业务,有突发热点,对实时性要求高 → 用策略 2:实时生成(生产首选);
- 如果你不确定,直接用策略 2:实时生成 ------ 它的适配性最强,成本最低,能应对绝大多数业务场景,后续遇到问题,再针对性优化即可。
1.3.2 缓存满了怎么办?四大通用缓存淘汰策略
1.3.2.1 补充说明:缓存淘汰的触发条件
在拆解具体策略之前,我们先明确一个核心问题:**什么时候会触发缓存淘汰?**只有满足两个条件,才会触发缓存淘汰,缺一不可:
- Redis 内存达到了设置的上限(maxmemory 参数,比如 1GB);
- 有新的数据要写入 Redis(比如缓存未命中,查 MySQL 后,要把数据写入 Redis);
如果 Redis 内存没满,哪怕有冷数据,也不会触发淘汰;如果 Redis 内存满了,但没有新的数据要写入,也不会触发淘汰 ------ 只有 "内存满了 + 要写入新数据",才会触发淘汰,删掉一部分旧数据,腾空间存新数据。
举个具体的例子:
- Redis 设置 maxmemory 1gb,当前已用内存 990MB,有新数据要写入(大小 10MB),此时内存会达到 1000MB(1GB),不会触发淘汰,直接写入即可;
- Redis 设置 maxmemory 1gb,当前已用内存 1gb,有新数据要写入(大小 1MB),此时内存会超过上限,触发淘汰,删掉 1MB 以上的旧数据,腾空间存新数据;
- Redis 设置 maxmemory 1gb,当前已用内存 1gb,没有新数据要写入,哪怕有很多冷数据,也不会触发淘汰,Redis 正常运行。
1.3.2.2 策略 1:FIFO(First In First Out)先进先出 ------ 谁先来,谁先走
核心原理
淘汰缓存中存在时间最久的数据 ------ 也就是 "最早写入 Redis 的旧数据",不管这个数据,最近有没有被访问、访问次数多不多,只要它是最早来的,就先被淘汰。
皇帝选妃通俗版
后宫佳丽三千,皇帝规定:"谁最早入宫,谁就先被冷落"------ 皇后是最早入宫的,虽然她偶尔还会被皇帝宠幸,但只要有新妃子入宫,后宫人数满了,就先冷落皇后,不管她最近有没有被翻牌。
实现逻辑
- Redis 内部,给每个 Key,记录一个 "写入时间戳"(比如 Key=goods:123,写入时间是 2026-02-11 10:00:00);
- 当 Redis 内存满了,要写入新数据时,Redis 会遍历所有 Key,找出 "写入时间戳最早" 的 Key(最早写入的旧数据);
- 淘汰这个最早写入的 Key,腾空间存新数据;
- 重复上述步骤,每次写入新数据,都淘汰最早写入的旧数据。
实战案例:简单的新闻缓存(FIFO 的典型场景)
一个简单的新闻网站,用 Redis 缓存新闻内容,设置 maxmemory 1gb,淘汰策略用 FIFO:
- 10:00,写入新闻 A(最早写入);
- 10:05,写入新闻 B;
- 10:10,写入新闻 C;
- ......
- 15:00,Redis 内存满了,要写入新闻 Z;
- Redis 遍历所有新闻缓存,找出最早写入的新闻 A,淘汰新闻 A 的缓存;
- 写入新闻 Z,Redis 内存恢复到上限以内。
不管新闻 A,在 15:00 之前,有没有被用户访问、访问次数多不多,只要它是最早写入的,就会被淘汰 ------ 哪怕新闻 A 是热点数据,最近被频繁访问,也会被淘汰。
优点(为什么有人用 FIFO)
- 逻辑最简单,容易实现:只需要记录每个 Key 的写入时间,淘汰时找最早写入的,不用记录访问时间、访问次数,Redis 实现起来,资源消耗极少;
- 公平性强:"先来后到",不管数据热度如何,最早写入的,先被淘汰,没有偏向性;
- 资源消耗少:不需要实时更新访问时间、访问次数,对 Redis 的性能,几乎没有影响。
缺点(为什么生产很少用 FIFO)
- 不区分热点数据和冷数据(最核心的缺点) :这是 FIFO 最大的问题 ------ 它只看 "写入时间",不看 "访问频率",很可能淘汰掉 "最早写入,但最近依然被频繁访问的热点数据",留下 "写入时间晚,但几乎没被访问的冷数据";
- 比如新闻 A,10:00 写入,14:50-14:59,被访问了 1000 次(热点数据),但因为它是最早写入的,15:00 写入新闻 Z 时,还是会被淘汰;
- 而新闻 Y,14:55 写入,只被访问了 1 次(冷数据),却因为写入时间晚,被保留下来;
- 这种情况,会导致缓存命中率急剧下降,大量热点数据被淘汰,查询请求又会打回 MySQL,导致 MySQL 压力增大,缓存失去作用;
- 缓存抖动严重:如果有一批数据,同时写入 Redis,后续又被批量淘汰,会导致缓存命中率,瞬间下降,又瞬间上升,不稳定;
- 适配性差:无法适配任何有热点数据的业务,只能适配 "所有数据访问频率差不多,没有明显热点" 的业务(这种业务极少)。
适用场景(什么时候用 FIFO)
- 所有数据的访问频率,几乎一致,没有明显热点数据、冷数据的业务(比如日志缓存,每条日志的访问频率都很低,且差不多);
- 对缓存命中率要求不高,只需要 "临时存数据,满了就删" 的场景(比如临时缓存用户的登录状态,有效期短,访问频率差不多);
- 对 Redis 性能要求极高,不希望淘汰策略,消耗 Redis 资源的场景(FIFO 资源消耗最少);
- 生产环境中,几乎不用 FIFO,只有极特殊的场景,才会考虑。
1.3.2.3 策略 2:LRU(Least Recently Used)最久未使用 ------ 谁最久没被翻牌,淘汰谁
核心原理
淘汰缓存中最近最久没有被访问的数据 ------ 也就是 "最后一次访问时间,最古老" 的数据,不管这个数据,什么时候写入的,只要它最近最久没被访问,就被淘汰。
皇帝选妃通俗版
皇帝改规矩了:"不看入宫时间,看最近一次被宠幸的时间,谁最久没被宠幸,谁就被冷落"------ 皇后(入宫最早),昨天刚被宠幸;熹妃(入宫中等),3 天前被宠幸;安答应(入宫最晚),1 个月没被宠幸;华妃(入宫较早),2 周没被宠幸;此时,最久没被宠幸的是安答应,哪怕她入宫最晚,也会被冷落。
实现逻辑
- Redis 内部,给每个 Key,记录一个 "最后访问时间戳"(比如 Key=goods:123,最后访问时间是 2026-02-11 14:59:00);
- 每当有用户查询这个 Key(缓存命中),Redis 就会更新这个 Key 的 "最后访问时间戳"(改成当前时间)------ 相当于 "皇帝翻牌,更新妃子的最近宠幸时间";
- 当 Redis 内存满了,要写入新数据时,Redis 会遍历所有 Key,找出 "最后访问时间戳最古老" 的 Key(最近最久没被访问的冷数据);
- 淘汰这个 Key,腾空间存新数据;
- 重复上述步骤,每次写入新数据,都淘汰最近最久未使用的 Key。
实战案例:电商商品缓存(LRU 的典型场景)
电商网站,用 Redis 缓存商品详情,设置 maxmemory 1gb,淘汰策略用 LRU:
- 10:00,写入商品 A(最后访问时间 10:00);
- 10:05,写入商品 B(最后访问时间 10:05);
- 10:10,写入商品 C(最后访问时间 10:10);
- 14:00,用户查询商品 A(更新商品 A 的最后访问时间为 14:00);
- 14:30,用户查询商品 B(更新商品 B 的最后访问时间为 14:30);
- 15:00,Redis 内存满了,要写入商品 Z;
- Redis 遍历所有商品缓存,查看最后访问时间:商品 A(14:00)、商品 B(14:30)、商品 C(10:10);
- 商品 C 的最后访问时间最古老(10:10,最久没被访问),淘汰商品 C 的缓存;
- 写入商品 Z,Redis 内存恢复到上限以内。
这里能看到,商品 C 虽然写入时间不是最早的,但因为它最近最久没被访问,所以被淘汰;而商品 A,虽然写入时间最早,但最近被访问过,被保留下来 ------ 这就是 LRU 的核心优势:能保留热点数据,淘汰冷数据。
补充:Redis 中 LRU 的优化实现
很多小白会问:如果 Redis 中有 100 万条 Key,遍历所有 Key,找出最久未使用的,会不会很慢,消耗很多资源?答案是:不会 ------Redis 没有遍历所有 Key,而是采用了 "近似 LRU" 的实现方式:
- Redis 内部,维护一个 "候选 Key 池"(比如 16 个 Key);
- 淘汰时,从候选池中,找出最久未使用的 Key,淘汰掉;
- 这种方式,不用遍历所有 Key,资源消耗极少,同时能近似实现 LRU 的效果,缓存命中率和纯 LRU 几乎一致;
- 不用懂具体实现细节,知道 "Redis 的 LRU 是优化过的,不消耗资源" 即可。
优点(为什么生产常用 LRU)
- 能区分热点数据和冷数据(最核心的优点):只看 "最近访问时间",最近被频繁访问的热点数据,会被保留,最久没被访问的冷数据,会被淘汰,缓存命中率高(能达到 80% 以上);
- 逻辑简单,适配性强:不用记录访问次数,只记录最后访问时间,实现简单,资源消耗少,适配绝大多数业务场景;
- 缓存命中率稳定:能实时跟随用户访问行为,热点数据被保留,冷数据被淘汰,缓存命中率不会出现大幅波动;
- 能应对突发热点数据:突发热点数据,被频繁访问,最后访问时间会不断更新,不会被淘汰,能挡住大量查询请求。
缺点(为什么有些场景不用 LRU)
- 无法区分 "访问频率"(核心缺点) :LRU 只看 "最近访问时间",不看 "访问次数"------ 比如有两个 Key:
- Key1:最近 1 小时,被访问了 1 次(最后访问时间 1 小时前);
- Key2:最近 1 小时,被访问了 100 次(最后访问时间 2 小时前);
- 此时,Key2 的最后访问时间更古老,LRU 会淘汰 Key2,但 Key2 的访问频率更高,是热点数据,淘汰它会降低缓存命中率;
- 简单说,LRU 只关注 "最近有没有被访问",不关注 "访问了多少次",可能淘汰掉 "访问次数多,但最近没被访问" 的热点数据;
- 对 "周期性访问" 的数据,不够友好:比如某个商品,每天凌晨 2 点,被访问 1000 次(周期性热点),其他时间,几乎不被访问 ------ 在凌晨 2 点之后,这个商品的最后访问时间是凌晨 2 点,到第二天凌晨 1 点,最久没被访问,会被 LRU 淘汰,而第二天凌晨 2 点,大量访问请求,会直接打 MySQL;
- 可能出现 "缓存污染":如果有一个冷数据,被误访问一次(比如用户误点了一个小众商品),写入 Redis,更新了最后访问时间,导致原本该被淘汰的冷数据,被保留下来,而真正的热点数据,被淘汰 ------ 这种情况,称为 "缓存污染",但概率很低,可通过设置合理的过期时间,缓解。
适用场景(什么时候用 LRU,生产首选)
- 绝大多数面向 C 端用户的业务(电商、短视频、社交、新闻),这些业务的热点数据,具有 "最近被频繁访问" 的特点;
- 热点数据的 "访问频率" 和 "最近访问时间",高度相关的业务(比如商品详情、视频详情,最近被频繁访问的,访问次数也多);
- 对缓存命中率要求高,希望保留热点数据、淘汰冷数据的场景;
- 生产环境中,LRU 是最常用的淘汰策略,没有特殊情况,优先选 LRU。
1.3.2.4 策略 3:LFU(Least Frequently Used)最少使用 ------ 谁被翻牌次数最少,淘汰谁
核心原理
淘汰缓存中最近一段时间内,访问次数最少的数据 ------ 也就是 "访问频率最低" 的数据,不管这个数据,什么时候写入的、最近有没有被访问,只要它的访问次数最少,就被淘汰。
皇帝选妃通俗版
皇帝又改规矩了:"不看入宫时间,不看最近宠幸时间,看最近一个月,谁被宠幸的次数最少,谁就被冷落"------ 皇后(最近一个月被宠幸 3 次)、熹妃(15 次)、安答应(1 次)、华妃(10 次);此时,安答应被宠幸的次数最少,哪怕她最近 3 天刚被宠幸过,也会被冷落。
实现逻辑
- Redis 内部,给每个 Key,记录一个 "访问计数器"(比如 Key=goods:123,访问计数器 = 100),同时记录一个 "访问时间窗口"(比如最近 1 小时、最近 1 天);
- 每当有用户查询这个 Key(缓存命中),Redis 就会给这个 Key 的 "访问计数器" 加 1(相当于 "皇帝翻牌,给妃子的宠幸次数加 1");
- 为了避免 "旧数据的访问计数器,一直很高"(比如一个商品,半年前被访问了 1000 次,最近半年没被访问,计数器还是 1000),Redis 会定期 "衰减" 访问计数器 ------ 比如每隔 1 小时,把所有 Key 的访问计数器,除以 2(衰减因子),这样,旧数据的访问次数,会慢慢降低,不会一直占用高计数器;
- 当 Redis 内存满了,要写入新数据时,Redis 会遍历所有 Key,找出 "最近时间窗口内,访问计数器最小" 的 Key(访问次数最少的冷数据);
- 淘汰这个 Key,腾空间存新数据;
- 重复上述步骤,每次写入新数据,都淘汰访问次数最少的 Key。
实战案例:电商商品缓存(LFU 的典型场景)
电商网站,用 Redis 缓存商品详情,设置 maxmemory 1gb,淘汰策略用 LFU,时间窗口为最近 1 小时,衰减因子为 2:
- 10:00-11:00,商品 A 被访问 10 次(计数器 = 10)、商品 B 被访问 5 次(计数器 = 5)、商品 C 被访问 1 次(计数器 = 1);
- 11:00,Redis 定期衰减,商品 A 计数器 = 5、商品 B 计数器 = 2、商品 C 计数器 = 0;
- 11:00-12:00,商品 A 被访问 8 次(计数器 = 5+8=13)、商品 B 被访问 3 次(计数器 = 2+3=5)、商品 C 被访问 0 次(计数器 = 0);
- 12:00,Redis 内存满了,要写入商品 Z;
- Redis 遍历所有商品缓存,查看访问计数器:商品 A(13)、商品 B(5)、商品 C(0);
- 商品 C 的访问计数器最小(0,访问次数最少),淘汰商品 C 的缓存;
- 写入商品 Z,Redis 内存恢复到上限以内。
这里能看到,商品 C 虽然最近 1 小时内,没有被访问(计数器 = 0),访问次数最少,被淘汰;而商品 A,访问次数最多,被保留下来 ------LFU 的核心优势:能精准区分访问频率,保留访问次数多的热点数据。
补充:Redis 中 LFU 的实现
LFU 是 Redis 4.0 版本新增的淘汰策略,和 LRU 一样,Redis 也采用了 "近似 LFU" 的实现方式,不用遍历所有 Key,而是从候选 Key 池中,找出访问计数器最小的 Key,淘汰掉,资源消耗极少,同时能精准实现 "淘汰访问次数最少" 的效果。
优点(为什么有些场景,LFU 比 LRU 更好)
- 能精准区分访问频率(最核心的优点) :LFU 关注 "访问次数",访问次数多的热点数据,会被保留,访问次数少的冷数据,会被淘汰 ------ 解决了 LRU"只看最近访问时间,不看访问次数" 的缺点;
- 比如前面提到的两个 Key:Key1(最近 1 小时访问 1 次)、Key2(最近 1 小时访问 100 次),LFU 会淘汰 Key1(访问次数少),保留 Key2(访问次数多),而 LRU 会淘汰 Key2,LFU 的缓存命中率更高;
- 对 "周期性访问" 的数据,更友好:比如某个商品,每天凌晨 2 点,被访问 1000 次(周期性热点),其他时间,几乎不被访问 ------LFU 的访问计数器,会因为凌晨的 1000 次访问,变得很高,即使其他时间没被访问,计数器衰减后,依然会比冷数据的计数器高,不会被淘汰,第二天凌晨的访问请求,能命中缓存;
- 缓存命中率更高:相比 LRU,LFU 能更精准地识别热点数据,淘汰冷数据,缓存命中率更高,能更好地挡住查询请求,减轻 MySQL 压力;
- 能避免 "缓存污染":误访问一次的冷数据,访问计数器很低,即使更新了访问时间,也会被 LFU 淘汰,不会占用缓存空间,避免了 "缓存污染"。
缺点(为什么 LFU,没有 LRU 常用)
- 逻辑比 LRU 复杂,资源消耗略高:需要维护访问计数器、时间窗口、定期衰减,虽然 Redis 做了优化,但资源消耗,还是比 LRU 略高(但差别不大,生产环境可忽略);
- 对 "新写入的热点数据",不够友好:一个新的热点数据,刚写入 Redis,访问计数器很低(比如 0),此时 Redis 内存满了,要写入新数据,这个新热点数据,可能因为访问计数器低,被 LFU 淘汰 ------ 而 LRU,只要这个新热点数据,最近被访问过,就会被保留;
- 比如某网红推荐一个商品,该商品刚写入 Redis,被访问了 5 次(计数器 = 5),而一个旧的冷数据,访问计数器 = 6,此时 Redis 内存满了,LFU 会淘汰这个新热点数据(计数器 5),留下旧冷数据(计数器 6),导致新热点数据的查询请求,打回 MySQL;
- 配置更复杂:需要设置时间窗口、衰减因子,而 LRU,不用任何额外配置,小白更容易上手。
适用场景(什么时候用 LFU,比 LRU 更好)
- 热点数据的 "访问频率" 和 "最近访问时间",相关性不强的业务(比如搜索引擎的高频关键词,有些关键词,最近没被访问,但访问次数很多,是热点数据);
- 对缓存命中率要求极高,希望精准保留访问次数多的热点数据的场景(比如金融行业的核心数据缓存、电商的爆款商品缓存);
- 存在 "周期性热点数据" 的业务(比如每天固定时间,被频繁访问的数据);
- 业务中,误访问冷数据的情况较多,需要避免 "缓存污染" 的场景。
1.3.2.5 策略 4:Random 随机淘汰 ------ 听天由命,纯看运气
核心原理
淘汰缓存中随机选出的一个数据------ 不看写入时间、不看最近访问时间、不看访问次数,完全随机,就像 "闭着眼睛,随便挑一个删掉"。
皇帝选妃通俗版
皇帝彻底懒了:"不看任何条件,闭着眼睛,随便挑一个妃子冷落"------ 不管皇后、熹妃、安答应,谁被挑中,谁就被冷落,纯看运气,和入宫时间、宠幸次数、最近宠幸时间,都没有关系。
实现逻辑
- Redis 内部,不记录任何 Key 的写入时间、访问时间、访问次数;
- 当 Redis 内存满了,要写入新数据时,Redis 会从所有 Key 中,随机选出一个 Key;
- 淘汰这个随机选出的 Key,腾空间存新数据;
- 重复上述步骤,每次写入新数据,都随机淘汰一个 Key。
实战案例:临时缓存用户行为(Random 的典型场景)
一个社交 APP,用 Redis 临时缓存用户的浏览行为(比如用户浏览了哪个帖子),设置 maxmemory 1gb,淘汰策略用 Random:
- 10:00,写入用户 A 的浏览行为(Key=user:1001);
- 10:05,写入用户 B 的浏览行为(Key=user:1002);
- 10:10,写入用户 C 的浏览行为(Key=user:1003);
- ......
- 15:00,Redis 内存满了,要写入用户 Z 的浏览行为;
- Redis 从所有用户的浏览行为缓存中,随机选出 Key=user:1002(用户 B 的浏览行为);
- 淘汰用户 B 的浏览行为缓存,写入用户 Z 的浏览行为;
- 不管用户 B 的浏览行为,最近有没有被访问、访问次数多不多,只要被随机选中,就会被淘汰。
优点(为什么有人用 Random)
- 逻辑最简单,实现最容易:不用记录任何额外信息(写入时间、访问时间、访问次数),Redis 实现起来,资源消耗最少;
- 资源消耗极低:不用遍历 Key、不用维护计数器、不用定期衰减,淘汰时,直接随机选一个,对 Redis 的性能,几乎没有任何影响;
- 公平性最强(极端角度):不偏向任何一个 Key,所有 Key 被淘汰的概率,都是一样的,没有任何歧视。
缺点(为什么生产几乎不用 Random)
- 完全无法区分热点数据和冷数据(最核心的缺点) :这是 Random 最大的问题 ------ 它完全随机,很可能淘汰掉 "被频繁访问的热点数据",留下 "几乎没被访问的冷数据",甚至可能连续淘汰多个热点数据;
- 比如 Redis 中,有 10 个 Key,9 个是热点数据(被频繁访问),1 个是冷数据(几乎不被访问),Redis 内存满了,随机淘汰一个 Key,有 90% 的概率,淘汰热点数据;
- 这种情况,会导致缓存命中率急剧下降,大量查询请求,直接打回 MySQL,MySQL 压力暴增,缓存失去作用;
- 缓存命中率极低:完全靠运气,缓存命中率是四大策略中最低的,几乎和 "没有缓存" 差不多;
- 稳定性极差:缓存命中率会随机波动,可能某一时刻很高,某一时刻很低,无法保证系统性能的稳定性。
适用场景(什么时候用 Random)
- 所有数据,都没有任何价值差异,淘汰任何一个,都不会影响业务的场景(比如临时缓存用户的无关行为、日志缓存,淘汰任何一条,都不会影响用户体验);
- 对缓存命中率,没有任何要求,只需要 "临时存数据,满了就删" 的场景;
- 对 Redis 性能,要求极高,不允许任何淘汰策略,消耗 Redis 资源的场景(Random 资源消耗最少);
- 生产环境中,几乎不用 Random,只有极特殊的临时缓存场景,才会考虑。
1.3.2.6 四大通用淘汰策略总结
我们做一个详细的对比总结:
| 淘汰策略 | 核心判断依据 | 优点 | 缺点 | 资源消耗 | 缓存命中率 | 适用场景 | 生产使用率 |
|---|---|---|---|---|---|---|---|
| FIFO | 写入时间(最早写入) | 逻辑最简单、公平、资源消耗最少 | 不区分热点 / 冷数据,缓存命中率低 | 极低 | 低 | 无明显热点、临时缓存 | 5% |
| LRU | 最后访问时间(最久未用) | 区分热点 / 冷数据、适配性强、缓存命中率高 | 不看访问频率,可能淘汰高频旧数据 | 低 | 中高 | 绝大多数 C 端业务、热点数据与最近访问相关 | 70% |
| LFU | 访问次数(最少访问) | 精准区分访问频率、缓存命中率最高、避免缓存污染 | 逻辑复杂、对新热点不友好、资源消耗略高 | 中低 | 最高 | 对缓存命中率要求高、有周期性热点、避免缓存污染 | 20% |
| Random | 随机 | 逻辑最简单、资源消耗最低 | 不区分热点 / 冷数据、缓存命中率极低、稳定性差 | 极低 | 最低 | 临时无关数据、对命中率无要求 | 5% |
选型建议
- 没有特殊情况,优先选 LRU(allkeys-lru):适配绝大多数业务,缓存命中率高,逻辑简单,资源消耗少,生产环境中,70% 的业务,都用 LRU;
- 对缓存命中率要求极高,存在周期性热点、误访问冷数据较多 → 选 LFU(allkeys-lfu):比如金融核心数据、电商爆款商品缓存;
- 临时缓存无关数据,对命中率无要求,追求极致 Redis 性能 → 选 Random(allkeys-random):比如临时缓存用户浏览记录(无关紧要);
- 所有数据访问频率差不多,没有明显热点 → 选 FIFO(allkeys-fifo):比如日志缓存(Redis 没有专门的 FIFO 策略,可通过设置过期时间,模拟 FIFO);
- 绝对不要选默认策略 noeviction:内存满了,新写入直接报错,会导致业务崩溃,小白一定要避开!
1.3.3 Redis 内置 8 大缓存淘汰策略
前面我们讲了四大通用淘汰策略,而 Redis 内置了 8 种淘汰策略,在通用策略的基础上,增加了 "针对过期 Key" 和 "针对所有 Key" 的区分 ------ 要注意,Redis 的 8 种策略,不是独立于四大通用策略,而是对四大通用策略的 "场景细分"。
先明确两个核心概念
Redis 的 8 种淘汰策略,核心分为两大类:
- 针对 "所有 Key":淘汰时,从 Redis 中所有的 Key(不管有没有设置过期时间),筛选要淘汰的 Key;
- 适用场景:缓存中,大部分 Key 都是热点数据,没有明显的 "临时 Key" 和 "永久 Key" 区分,希望淘汰所有 Key 中,不热门的;
- 针对 "设置了过期时间的 Key":淘汰时,只从 Redis 中,设置了过期时间的 Key,筛选要淘汰的 Key;未设置过期时间的 Key,永远不会被淘汰;
- 适用场景:缓存中,有 "临时 Key"(设置过期时间,比如用户登录状态,有效期 2 小时)和 "永久 Key"(不设置过期时间,比如爆款商品,永远缓存)区分,希望只淘汰临时 Key,保留永久 Key。
另外,Redis 的默认淘汰策略是noeviction,这个策略绝对不能用在生产环境 ------ 内存满了,新写入直接报错,会导致业务崩溃!
1.3.3.1 第一类:针对所有 Key(生产最常用,优先考虑)
这类策略,淘汰时,从 Redis 中所有的 Key(不管有没有设置过期时间),筛选要淘汰的 Key,适配绝大多数业务场景,生产环境中,优先考虑这类策略。
1. allkeys-lru(生产首选,最常用)
核心逻辑
当 Redis 内存不足以容纳新写入数据时,从所有 Key中,使用 LRU(最久未使用)算法,淘汰最久未使用的 Key------ 也就是我们前面讲的,通用 LRU 策略,针对所有 Key 的场景。
通俗解释
Redis 内存满了,要写入新数据,不管这个 Key 有没有设置过期时间,只要它是 "最近最久未使用" 的,就会被淘汰 ------ 比如缓存中有 "永久 Key(爆款商品)" 和 "临时 Key(用户登录状态)",如果永久 Key,最近最久未使用,也会被淘汰。
实战配置
# Redis配置文件redis.conf
# 设置Redis最大内存1GB
maxmemory 1gb
# 设置淘汰策略为allkeys-lru(所有Key,LRU淘汰)
maxmemory-policy allkeys-lru
适用场景(生产 70% 的业务,都用这个)
- 绝大多数面向 C 端用户的业务(电商、短视频、社交、新闻);
- 缓存中,没有明显的 "临时 Key" 和 "永久 Key" 区分,所有 Key,都是热点数据的候选;
- 希望缓存中,永远保留 "最近被频繁访问" 的热点数据,淘汰最久未使用的冷数据;
- 对缓存命中率要求较高,希望用最简单的策略,实现高命中率。
注意事项
- 该策略,会淘汰所有 Key 中,最久未使用的,包括未设置过期时间的 "永久 Key"------ 如果你的业务中,有必须保留、绝对不能淘汰的 Key(比如核心配置数据),不要用这个策略,改用 "针对过期 Key" 的策略,或者给核心 Key,设置合理的过期时间,同时确保它被频繁访问;
- 该策略,不用额外配置,只要设置 maxmemory 和 maxmemory-policy 即可,小白容易上手。
2. allkeys-lfu(Redis 4.0 + 新增,命中率最高)
核心逻辑
当 Redis 内存不足以容纳新写入数据时,从所有 Key中,使用 LFU(最少使用)算法,淘汰最近一段时间内,访问次数最少的 Key------ 也就是通用 LFU 策略,针对所有 Key 的场景。
通俗解释
Redis 内存满了,要写入新数据,不管这个 Key 有没有设置过期时间,只要它是 "最近访问次数最少" 的,就会被淘汰 ------ 比如缓存中有 "永久 Key" 和 "临时 Key",如果永久 Key 的访问次数最少,也会被淘汰。
实战配置
# Redis配置文件redis.conf
# 设置Redis最大内存1GB
maxmemory 1gb
# 设置淘汰策略为allkeys-lfu(所有Key,LFU淘汰)
maxmemory-policy allkeys-lfu
适用场景(对缓存命中率要求高的业务)
- 对缓存命中率要求极高,希望精准保留访问次数多的热点数据(比如金融核心数据、电商爆款商品缓存);
- 业务中,存在周期性热点数据(比如每天固定时间,被频繁访问的数据);
- 误访问冷数据的情况较多,需要避免 "缓存污染"(比如用户误点小众商品,写入缓存后,不会长期占用空间);
- Redis 版本在 4.0 以上(支持 LFU)。
注意事项
- 该策略,会淘汰所有 Key 中,访问次数最少的,包括未设置过期时间的 "永久 Key"------ 核心 Key,需确保访问次数足够多,避免被淘汰;
- 对新写入的热点数据,不够友好 ------ 新热点数据,访问次数少,可能被淘汰,可通过设置较短的过期时间 + 手动刷新访问次数,缓解;
- 需要 Redis 4.0 以上版本,小白在使用前,先确认 Redis 版本(可通过 redis-cli -v 查看);
- 资源消耗,比 allkeys-lru 略高,但差别不大,生产环境可忽略。
3. allkeys-random(随机淘汰所有 Key)
核心逻辑
当 Redis 内存不足以容纳新写入数据时,从所有 Key中,随机淘汰一个 Key------ 也就是通用 Random 策略,针对所有 Key 的场景。
通俗解释
Redis 内存满了,要写入新数据,不管这个 Key 有没有设置过期时间、最近有没有被访问、访问次数多不多,随机选一个,淘汰掉 ------ 纯看运气,和所有条件无关。
实战配置
# Redis配置文件redis.conf
maxmemory 1gb
maxmemory-policy allkeys-random
适用场景(极少用,仅临时缓存)
- 临时缓存无关紧要的数据,对缓存命中率,没有任何要求(比如临时缓存用户的浏览记录,淘汰了也不影响用户体验);
- 追求极致的 Redis 性能,不希望淘汰策略,消耗任何 Redis 资源(allkeys-random 资源消耗最低);
- 所有数据,都没有价值差异,淘汰任何一个,都不会影响业务(比如日志缓存,每条日志,都无关紧要)。
注意事项
- 缓存命中率极低,稳定性差,绝对不要用在核心业务中(比如商品详情、用户信息缓存),否则会导致大量请求打回 MySQL,MySQL 宕机;
- 仅适合临时缓存无关数据,核心业务,坚决避开!
4. noeviction(默认策略,绝对不要用)
核心逻辑
当 Redis 内存不足以容纳新写入数据时,不淘汰任何 Key,直接拒绝新的写入请求,返回错误(OOM error)------ 也就是 "内存满了,就报错,不做任何处理"。
通俗解释
Redis 内存满了,要写入新数据,不管缓存中有多少冷数据,都不淘汰,直接给业务服务器返回 "写入失败",导致业务无法正常运行(比如用户无法下单、无法修改商品信息)。
实战配置
# Redis默认配置,小白不要主动配置!
maxmemory-policy noeviction
适用场景
- 没有任何适用场景,Redis 设置这个策略,只是作为 "默认兜底",防止小白忘记设置淘汰策略,导致 Redis 无限占用内存;
- 哪怕是临时缓存,也不要用这个策略 ------ 内存满了,新写入直接报错,会导致业务崩溃。
注意事项
- 这是 Redis 的默认策略,小白在部署 Redis 时,第一件事,就是修改这个策略,改成 allkeys-lru(生产首选),否则会导致业务崩溃;
- 记住:noeviction = 内存满了就报错 = 业务崩溃,小白绝对不要用!
1.3.3.2 第二类:针对设置了过期时间的 Key(特殊场景用)
这类策略,淘汰时,只从 Redis 中 "设置了过期时间的 Key" 中,筛选要淘汰的 Key;未设置过期时间的 Key,永远不会被淘汰------ 适合缓存中有 "临时 Key" 和 "永久 Key" 区分的场景。
5. volatile-lru(针对过期 Key,LRU 淘汰)
核心逻辑
当 Redis 内存不足以容纳新写入数据时,从设置了过期时间的 Key中,使用 LRU(最久未使用)算法,淘汰最久未使用的 Key;未设置过期时间的 Key,永远不会被淘汰。
通俗解释
Redis 内存满了,要写入新数据,先看缓存中,哪些 Key 设置了过期时间(临时 Key,比如用户登录状态,有效期 2 小时),从这些临时 Key 中,淘汰最久未使用的;如果缓存中,没有设置过期时间的 Key(永久 Key,比如爆款商品,永远缓存),哪怕这些永久 Key 是冷数据,也不会被淘汰。
实战配置
# Redis配置文件redis.conf
maxmemory 1gb
# 针对设置了过期时间的Key,LRU淘汰
maxmemory-policy volatile-lru
适用场景(有临时 Key 和永久 Key 区分的业务)
- 缓存中有 "永久 Key"(不设置过期时间,比如爆款商品、核心配置数据,必须永远保留)和 "临时 Key"(设置过期时间,比如用户登录状态、临时验证码,过期可淘汰);
- 希望永久 Key,永远不被淘汰,只淘汰临时 Key 中的冷数据;
- 比如电商网站:爆款商品(永久 Key,不设置过期时间)、用户登录状态(临时 Key,有效期 2 小时),内存满了,只淘汰最久未使用的用户登录状态,不淘汰爆款商品。
注意事项
- 仅淘汰设置了过期时间的 Key,永久 Key(未设置过期时间),永远不会被淘汰 ------ 如果永久 Key 过多,占用了大部分内存,导致临时 Key 无法淘汰,最终还是会导致内存满了,新写入报错(所以永久 Key,不要设置太多,避免占用过多内存);
- 如果缓存中,没有设置过期时间的 Key(所有 Key 都是永久 Key),该策略会退化成为 noeviction(不淘汰任何 Key,直接报错),小白要注意;
- 适合有永久 Key 和临时 Key 区分的场景,没有这个区分,优先选 allkeys-lru。
6. volatile-lfu(针对过期 Key,LFU 淘汰)
核心逻辑
当 Redis 内存不足以容纳新写入数据时,从设置了过期时间的 Key中,使用 LFU(最少使用)算法,淘汰最近一段时间内,访问次数最少的 Key;未设置过期时间的 Key,永远不会被淘汰。
通俗解释
Redis 内存满了,要写入新数据,先看缓存中,哪些 Key 设置了过期时间(临时 Key),从这些临时 Key 中,淘汰访问次数最少的;永久 Key(未设置过期时间),哪怕访问次数少,也永远不会被淘汰。
实战配置(小白能落地,特殊场景用)
# Redis配置文件redis.conf
maxmemory 1gb
# 针对设置了过期时间的Key,LFU淘汰
maxmemory-policy volatile-lfu
适用场景(特殊场景,比 volatile-lru 更精准)
- 缓存中有永久 Key 和临时 Key 区分,且对临时 Key 的缓存命中率要求较高;
- 临时 Key 中,存在周期性热点、误访问冷数据较多,需要精准淘汰访问次数最少的临时 Key;
- 比如金融网站:核心用户信息(永久 Key,不设置过期时间)、临时验证码(临时 Key,有效期 5 分钟),内存满了,精准淘汰访问次数最少的临时验证码,保留核心用户信息。
注意事项
- 仅淘汰设置了过期时间的 Key,永久 Key,永远不会被淘汰 ------ 注意控制永久 Key 的数量,避免占用过多内存;
- 如果缓存中,没有设置过期时间的 Key,该策略会退化成为 noeviction,直接报错;
- 需要 Redis 4.0 以上版本,小白先确认 Redis 版本;
- 适合对临时 Key 命中率要求高的场景,没有这个需求,优先选 volatile-lru。
7. volatile-random(针对过期 Key,随机淘汰)
核心逻辑
当 Redis 内存不足以容纳新写入数据时,从设置了过期时间的 Key中,随机淘汰一个 Key;未设置过期时间的 Key,永远不会被淘汰。
通俗解释
Redis 内存满了,要写入新数据,先看缓存中,哪些 Key 设置了过期时间(临时 Key),随机选一个临时 Key,淘汰掉;永久 Key,永远不会被淘汰 ------ 纯看运气,只淘汰临时 Key。
实战配置
# Redis配置文件redis.conf
maxmemory 1gb
# 针对设置了过期时间的Key,随机淘汰
maxmemory-policy volatile-random
适用场景(极少用,仅特殊临时缓存)
- 缓存中有永久 Key 和临时 Key 区分,且临时 Key 的价值完全一致,淘汰任何一个临时 Key,都不会影响业务(比如临时缓存多个用户的验证码,每个验证码的有效期都是 5 分钟,淘汰任何一个,都不影响用户使用);
- 临时 Key 的访问频率差不多,没有明显的热点、冷数据,且追求极致的 Redis 性能(不用维护访问时间、访问次数,资源消耗低);
- 比如某网站的临时验证码缓存(永久 Key 是核心配置,临时 Key 是用户验证码),内存满了,随机淘汰一个验证码,不影响其他用户,也不淘汰核心配置。
注意事项
- 仅淘汰设置了过期时间的临时 Key,永久 Key 永远不会被淘汰 ------ 同样要控制永久 Key 的数量,避免永久 Key 占用过多内存,导致临时 Key 无法淘汰,最终内存满了报错;
- 缓存命中率极低(随机淘汰),仅适合临时 Key 价值一致、无热点的场景,核心临时 Key(比如用户登录状态),坚决不用;
- 生产环境中,使用频率极低,仅在极特殊的临时缓存场景,才考虑。
8. volatile-ttl(针对过期 Key,淘汰快过期的)
核心逻辑
当 Redis 内存不足以容纳新写入数据时,从设置了过期时间的 Key中,淘汰 "剩余过期时间最短" 的 Key(也就是 "快过期的 Key 先淘汰");未设置过期时间的 Key,永远不会被淘汰 ------ 核心看 "剩余存活时间",存活时间越短,越先被淘汰。
皇帝选妃通俗版
皇帝又定了新规矩:"只冷落快要失宠的妃子(快过期的临时 Key),永远不冷落不会失宠的妃子(永久 Key);快要失宠的妃子中,谁离失宠时间最近,谁先被冷落"------ 临时妃子(设置过期时间)中,A 妃子还有 1 分钟失宠,B 妃子还有 10 分钟失宠,C 妃子还有 1 小时失宠,此时先冷落 A 妃子(剩余时间最短)。
实现逻辑
- Redis 内部,给每个设置了过期时间的 Key,记录一个 "过期时间戳"(比如 Key=code:1001,过期时间戳是 2026-02-11 15:05:00);
- 当 Redis 内存满了,要写入新数据时,Redis 会遍历所有 "设置了过期时间的 Key",计算每个 Key 的 "剩余过期时间"(过期时间戳 - 当前时间戳);
- 找出 "剩余过期时间最短" 的 Key(快过期的临时 Key),淘汰它;
- 若缓存中,没有设置过期时间的 Key(所有 Key 都是永久 Key),则不淘汰任何 Key,直接返回写入错误;
- 重复上述步骤,每次写入新数据,都淘汰快过期的临时 Key。
实战案例:临时验证码缓存(volatile-ttl 的典型场景)
某网站,用 Redis 缓存用户登录验证码(临时 Key),核心配置数据(永久 Key,不设置过期时间),设置 maxmemory 1gb,淘汰策略用 volatile-ttl:
- 15:00,写入验证码 A(Key=code:1001,过期时间 15:05,剩余 5 分钟);
- 15:01,写入验证码 B(Key=code:1002,过期时间 15:11,剩余 10 分钟);
- 15:02,写入验证码 C(Key=code:1003,过期时间 15:32,剩余 30 分钟);
- 15:03,写入核心配置 Key(Key=config:redis,不设置过期时间,永久保留);
- 15:04,Redis 内存满了,要写入验证码 D;
- Redis 遍历所有设置了过期时间的 Key(A、B、C),计算剩余过期时间:A(1 分钟)、B(7 分钟)、C(28 分钟);
- 验证码 A 的剩余过期时间最短(快过期),淘汰验证码 A 的缓存;
- 写入验证码 D,Redis 内存恢复到上限以内。
这里能看到,核心配置 Key(永久 Key),哪怕内存满了,也不会被淘汰;临时 Key 中,快过期的先被淘汰,符合 "临时数据快过期了,淘汰它不影响业务" 的逻辑。
实战配置(小白能落地,特殊场景用)
# Redis配置文件redis.conf
maxmemory 1gb
# 针对设置了过期时间的Key,淘汰剩余过期时间最短的
maxmemory-policy volatile-ttl
适用场景(临时 Key 有明确过期优先级的业务)
- 缓存中有永久 Key 和临时 Key 区分,且临时 Key 的 "过期时间" 能体现其价值(快过期的临时 Key,价值更低,淘汰后不影响业务);
- 临时 Key 的有效期差异较大,希望优先淘汰快过期的临时 Key,保留有效期长的临时 Key(比如验证码缓存:有效期 5 分钟的验证码,快过期时,用户大概率已经使用,淘汰它不影响;有效期 30 分钟的验证码,用户可能还未使用,保留它);
- 比如:临时验证码(有效期 5-30 分钟)、用户临时会话(有效期 1-2 小时),内存满了,优先淘汰快过期的,保留有效期长的,提升用户体验。
注意事项
- 仅淘汰设置了过期时间的 Key,永久 Key 永远不会被淘汰 ------ 控制永久 Key 数量,避免内存被永久 Key 占满,导致临时 Key 无法淘汰;
- 若临时 Key 的 "剩余过期时间" 和 "热点程度" 无关,可能淘汰热点临时 Key------ 比如某验证码 A,剩余 1 分钟过期,但此时用户正在使用(热点),volatile-ttl 会淘汰它,导致用户验证失败,这种场景,不适合用该策略;
- 适合临时 Key "快过期即无价值" 的场景,若临时 Key 快过期了,依然可能被频繁访问(热点),优先选 volatile-lru/volatile-lfu。
1.3.3.3 Redis 8 大淘汰策略总结
核心总结表格
| 策略类型 | 策略名称 | 核心逻辑 | 是否淘汰永久 Key | 核心优点 | 核心缺点 | 生产使用率 |
|---|---|---|---|---|---|---|
| 针对所有 Key | allkeys-lru | 淘汰所有 Key 中最久未使用的 | 是 | 适配性强、命中率高、逻辑简单 | 不看访问频率 | 70%(首选) |
| 针对所有 Key | allkeys-lfu | 淘汰所有 Key 中访问次数最少的 | 是 | 命中率最高、避免缓存污染 | 逻辑复杂、对新热点不友好 | 20% |
| 针对所有 Key | allkeys-random | 随机淘汰所有 Key 中的一个 | 是 | 资源消耗最低 | 命中率极低、稳定性差 | 5% |
| 针对所有 Key | noeviction | 不淘汰,直接报错 | 否 | 无 | 内存满即业务崩溃 | 0%(绝对不用) |
| 针对过期 Key | volatile-lru | 淘汰过期 Key 中最久未使用的 | 否 | 保留永久 Key、适配性强 | 无过期 Key 时退化报错 | 3% |
| 针对过期 Key | volatile-lfu | 淘汰过期 Key 中访问次数最少的 | 否 | 保留永久 Key、命中率高 | 无过期 Key 时退化报错 | 1% |
| 针对过期 Key | volatile-random | 随机淘汰过期 Key 中的一个 | 否 | 保留永久 Key、资源消耗低 | 命中率极低 | 1% |
| 针对过期 Key | volatile-ttl | 淘汰过期 Key 中快过期的 | 否 | 保留永久 Key、淘汰无价值临时 Key | 可能淘汰热点临时 Key | 0%(极少用) |
选型口诀
- 核心业务、无永久 Key → 选 allkeys-lru(首选,不会错);
- 核心业务、命中率要求极高 → 选 allkeys-lfu(Redis4.0+);
- 有永久 Key、临时 Key 快过期即无价值 → 选 volatile-ttl;
- 有永久 Key、临时 Key 有热点 → 选 volatile-lru;
- 临时无关数据、不 care 命中率 → 选 allkeys-random/volatile-random;
- 绝对不选 noeviction,选了必崩溃!
小白实战配置步骤
步骤 1:确定 Redis 最大内存(maxmemory)
-
核心原则:Redis 最大内存,不要超过服务器物理内存的 50%(避免 Redis 占用过多内存,导致服务器卡顿、宕机);
-
举例:服务器物理内存 8GB,Redis 最大内存设置为 4GB;服务器物理内存 1GB,Redis 最大内存设置为 512MB;
-
配置方法(修改 Redis 配置文件 redis.conf):
# 单位支持gb、mb、kb,比如4GB写成4gb
maxmemory 4gb
步骤 2:选择合适的淘汰策略(maxmemory-policy)
-
90% 的业务,直接配置:
maxmemory-policy allkeys-lru -
对命中率要求极高(Redis4.0+),配置:
maxmemory-policy allkeys-lfu -
有永久 Key、临时 Key 快过期即无价值,配置:
maxmemory-policy volatile-ttl
步骤 3:重启 Redis,使配置生效
- 停止 Redis 服务:redis-cli shutdown
- 启动 Redis 服务(指定配置文件):redis-server /etc/redis/redis.conf(根据自己的配置文件路径修改)
步骤 4:验证配置是否生效
- 登录 Redis 客户端:redis-cli
- 查看 maxmemory 配置:config get maxmemory → 输出设置的内存大小(比如 4294967296,对应 4GB);
- 查看淘汰策略:config get maxmemory-policy → 输出选择的策略(比如 allkeys-lru);
- 若输出和配置一致,说明配置生效;若不一致,检查配置文件路径,重新启动 Redis。
1.3.4 缓存过期时间的设置
前面我们反复提到,缓存数据需要设置过期时间 ------ 这是缓存设计中,最容易被小白忽略,但却最关键的一步,设置不好,会导致缓存膨胀、数据不一致、缓存雪崩等问题。
1.3.4.1 为什么必须设置缓存过期时间?(3 个核心目的,小白必懂)
很多小白会问:"我的缓存淘汰策略用了 LRU,会自动淘汰冷数据,为什么还要设置过期时间?"------ 答案是:淘汰策略和过期时间,是 "相辅相成" 的,缺一不可,设置过期时间,有 3 个核心目的,缺一不可:
目的 1:避免缓存膨胀,防止 Redis 内存无限占用
- 通俗解释:哪怕用了 LRU 淘汰策略,若缓存中的热点数据,长期被频繁访问(比如爆款商品,每天被访问 10 万次),会一直被保留在 Redis 中,不会被淘汰;随着业务发展,热点数据越来越多,Redis 内存会被慢慢占满,最终触发淘汰策略,但如果热点数据持续增加,淘汰速度跟不上写入速度,依然会导致 Redis 内存无限占用,服务器卡顿、宕机;
- 设置过期时间后,哪怕是长期热点数据,过期后也会被 Redis 自动删除(或触发淘汰),释放内存,避免缓存膨胀;
- 实战案例:某电商网站的爆款商品,设置缓存过期时间 1 小时,哪怕每天被访问 10 万次,每小时也会被自动删除,重新从 MySQL 查询写入 Redis,既保证了数据新鲜,也释放了内存,避免 Redis 内存无限占用。
目的 2:保证缓存数据与 MySQL 数据一致(缓解数据不一致问题)
- 通俗解释:缓存中的数据,是从 MySQL 中查询出来的 "副本",当 MySQL 中的数据发生变化(比如商品价格修改、商品下架),我们会删除 / 更新 Redis 中的旧数据,但如果出现 "更新失败"(比如网络波动、代码 bug),Redis 中的旧数据,会一直保留,导致用户查询到错误数据(比如商品已经下架,用户还能看到,甚至能下单);
- 设置过期时间后,哪怕 Redis 中的旧数据,没有被及时删除 / 更新,过期后也会被自动删除,用户下次查询,会从 MySQL 中获取新数据,写入 Redis,保证数据一致;
- 实战案例:商品价格从 100 元改成 120 元,业务代码删除 Redis 中的商品缓存时,出现网络波动,删除失败,Redis 中依然是 100 元的旧数据;因为设置了 1 小时的过期时间,1 小时后,旧数据被自动删除,用户下次查询,会获取到 120 元的新数据,避免用户看到错误价格。
目的 3:缓解缓存雪崩(后续详细讲,这里先了解)
- 通俗解释:缓存雪崩,是指 "大量缓存 Key 同时过期,导致大量查询请求,瞬间打回 MySQL,MySQL 被打崩";
- 如果我们给每个缓存 Key,设置 "随机的过期时间"(比如 1 小时 ±10 分钟),就能避免大量 Key 同时过期,缓解缓存雪崩的风险;
- 若不设置过期时间,或设置固定的过期时间,一旦大量 Key 同时过期(或 Redis 宕机重启),会瞬间引发缓存雪崩,MySQL 直接宕机。
1.3.4.2 缓存过期时间的设置原则
设置过期时间,不是 "随便设一个时间",而是要遵循 3 个原则,否则会引发新的问题(比如缓存命中率下降、数据不一致、缓存雪崩):
原则 1:过期时间要 "合理"------ 既不太长,也不太短
- 核心逻辑:过期时间太长,会导致缓存数据与 MySQL 数据不一致的时间变长,用户看到错误数据的概率增加;过期时间太短,会导致缓存频繁过期,缓存命中率急剧下降,大量请求打回 MySQL,MySQL 压力增大;
- 合理范围:根据业务场景,设置 "10 分钟~24 小时" 的过期时间,优先选择 "1 小时左右"(兼顾数据一致性和缓存命中率);
- 实战案例(不同业务场景的参考):
- 商品详情缓存:1 小时(商品价格、库存,不会频繁变化,1 小时的不一致,用户可接受);
- 用户登录状态缓存:2 小时(用户登录后,不会频繁重新登录,2 小时过期,兼顾安全和体验);
- 临时验证码缓存:5 分钟(验证码有效期短,5 分钟足够,避免验证码泄露后被滥用);
- 新闻内容缓存:6 小时(新闻内容不会频繁变化,6 小时过期,保证内容新鲜);
- 热门视频详情缓存:12 小时(视频详情变化少,12 小时过期,提升缓存命中率)。
原则 2:避免 "大量 Key 同时过期"------ 给过期时间加随机值
- 核心逻辑:如果所有缓存 Key,都设置固定的过期时间(比如都设置 1 小时),那么这些 Key,会在 "同一时间"(比如 1 小时后)同时过期,此时大量查询请求,会瞬间打回 MySQL,MySQL 被打崩(这就是缓存雪崩的雏形);
- 解决方案:给每个 Key 的过期时间,加上一个 "随机值"(比如 1 小时 ±10 分钟、1 小时 ±60 秒),让 Key 的过期时间,分散在不同的时间点,避免同时过期;
- 实战案例:
- 错误做法:所有商品缓存,都设置过期时间 3600 秒(1 小时),假设 10:00 同时写入 1000 个商品缓存,11:00 这 1000 个商品缓存,会同时过期,11:00 瞬间有 1000 次查询请求,打回 MySQL,MySQL 压力暴增;
- 正确做法:所有商品缓存,设置过期时间为 3600 秒 + 随机 60~600 秒(1~10 分钟),10:00 同时写入的 1000 个商品缓存,过期时间分散在 11:01~11:10 之间,每个时间点,只有 100 左右的 Key 过期,查询请求分散,MySQL 压力小,不会被打崩。
原则 3:结合业务场景,设置 "差异化过期时间"
-
核心逻辑:不同业务场景、不同类型的缓存 Key,数据变化频率、访问频率不同,过期时间也应该差异化,不能 "一刀切"------ 数据变化频繁、访问频率低的 Key,设置较短的过期时间;数据变化少、访问频率高的 Key,设置较长的过期时间;
-
实战案例(差异化设置参考):
缓存 Key 类型 数据变化频率 访问频率 过期时间参考 商品详情(爆款) 低 高 12 小时 + 随机 600 秒 商品详情(小众) 低 低 1 小时 + 随机 60 秒 用户登录状态 中 中 2 小时 临时验证码 高 低 5 分钟 新闻内容(热点) 低 高 6 小时 + 随机 300 秒 新闻内容(冷门) 低 低 1 小时 + 随机 60 秒 商品库存(高频变化) 高 高 10 分钟 + 随机 30 秒
1.3.4.3 缓存过期时间的具体设置方法
设置缓存过期时间,有两种方式:"Redis 命令直接设置" 和 "业务代码中设置",两种方式都要掌握,实战中,主要用 "业务代码中设置"(更灵活,能结合业务场景)
方式 1:Redis 命令直接设置(适合临时测试、手动操作)
Redis 提供了 3 个核心命令,用于设置缓存过期时间:
命令 1:EXPIRE key seconds(给已存在的 Key,设置过期时间,单位:秒)
-
核心逻辑:给已经写入 Redis 的 Key,设置过期时间,到期后,Redis 自动删除该 Key;
-
实战示例:
# 给商品Key(goods:123),设置过期时间3600秒(1小时)
127.0.0.1:6379> SET goods:123 "商品详情:手机,价格1000元"
OK
127.0.0.1:6379> EXPIRE goods:123 3600
(integer) 1 # 返回1,说明设置成功;返回0,说明Key不存在
命令 2:PEXPIRE key milliseconds(给已存在的 Key,设置过期时间,单位:毫秒)
-
核心逻辑:和 EXPIRE 类似,只是单位是毫秒,适合需要设置 "更精确过期时间" 的场景;
-
实战示例:
# 给验证码Key(code:1001),设置过期时间300000毫秒(5分钟)
127.0.0.1:6379> SET code:1001 "123456"
OK
127.0.0.1:6379> PEXPIRE code:1001 300000
(integer) 1 # 设置成功
命令 3:SET key value EX seconds(写入 Key 时,直接设置过期时间,推荐)
-
核心逻辑:写入 Key 和设置过期时间,一步完成,比 "先 SET,再 EXPIRE" 更高效,避免中间出现异常(比如 SET 成功,EXPIRE 失败,导致 Key 没有过期时间);
-
实战示例(推荐用法,结合随机值):
# 写入商品Key(goods:456),同时设置过期时间3660秒(1小时+60秒)
127.0.0.1:6379> SET goods:456 "商品详情:电脑,价格5000元" EX 3660
OK
# 写入商品Key(goods:789),同时设置过期时间3720秒(1小时+120秒)
127.0.0.1:6379> SET goods:789 "商品详情:平板,价格3000元" EX 3720
OK
补充命令:查看 Key 的过期时间(小白必用,验证设置是否生效)
-
命令 1:TTL key → 查看 Key 的剩余过期时间(单位:秒),返回 - 1,说明 Key 没有设置过期时间;返回 - 2,说明 Key 已过期被删除;
127.0.0.1:6379> TTL goods:123 (integer) 3580 # 剩余3580秒过期 127.0.0.1:6379> TTL goods:999 (integer) -2 # Key已过期删除 -
命令 2:PTTL key → 查看 Key 的剩余过期时间(单位:毫秒);
127.0.0.1:6379> PTTL code:1001
(integer) 280000 # 剩余280000毫秒(约4分40秒)过期
方式 2:业务代码中设置
实战中,我们不会手动用 Redis 命令设置过期时间,而是在 "业务代码" 中,写入缓存时,直接设置过期时间(结合业务场景、随机值),这里以最常用的 Java 代码为例:
核心逻辑
- 客户端发起查询请求(比如查询商品详情);
- 业务代码,先查询 Redis,判断缓存是否命中;
- 缓存未命中:查询 MySQL,获取商品数据;
- 写入 Redis 时,设置过期时间(结合业务场景,加上随机值);
- 返回数据给客户端。
实战代码示例
java
// 1. 注入Redis模板(SpringBoot自带,不用自己实现)
@Autowired
private StringRedisTemplate redisTemplate;

// 2. 查询商品详情的方法(核心逻辑)
public String getGoodsDetail(Long goodsId) {
    // 定义Redis的Key(格式:goods:商品ID)
    String redisKey = "goods:" + goodsId;

    // 3. 先查Redis,判断缓存是否命中
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);
    if (goodsDetail != null) {
        // 缓存命中,直接返回数据
        return goodsDetail;
    }

    // 4. 缓存未命中,查询MySQL(这里模拟查询MySQL,实际业务中,替换成真实的MySQL查询)
    goodsDetail = queryGoodsFromMysql(goodsId); // 自己实现的MySQL查询方法

    // 5. 写入Redis,设置过期时间(核心:1小时 + 随机60~600秒)
    // 生成随机值(60~600秒)
    int randomSeconds = new Random().nextInt(541) + 60; // 541=600-60+1,确保范围是60~600
    // 计算总过期时间(3600秒 + 随机值)
    long expireSeconds = 3600 + randomSeconds;
    // 写入Redis,设置过期时间
    redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);

    // 6. 返回数据给客户端
    return goodsDetail;
}

// 模拟MySQL查询方法(实际业务中,替换成真实代码)
private String queryGoodsFromMysql(Long goodsId) {
    // 模拟查询MySQL,返回商品详情
    return "商品ID:" + goodsId + ",商品名称:爆款手机,价格:1000元,库存:1000台";
}
代码说明
- 随机值的生成:
new Random().nextInt(541) + 60→ 确保随机值的范围是 60~600 秒,避免大量 Key 同时过期; - 过期时间的设置:
set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS)→ 第一个参数是 Redis Key,第二个是 Value(商品详情),第三个是过期时间(秒),第四个是时间单位; - 灵活性:可以根据不同的业务场景,修改过期时间的基础值(比如商品库存,基础值设为 10 分钟)和随机值范围(比如 10~30 秒),适配不同的业务需求。
1.3.4.4 缓存过期时间设置的 5 个避坑点
很多小白,虽然设置了过期时间,但因为忽略了这些避坑点,导致缓存出现问题(数据不一致、缓存雪崩、内存膨胀)
避坑点 1:不要设置 "过长的过期时间"(比如 7 天、30 天)
- 后果:缓存数据与 MySQL 数据不一致的时间太长,若 MySQL 中的数据发生变化(比如商品下架、价格修改),用户会长期看到错误数据,影响用户体验,甚至导致业务损失(比如商品已经下架,用户还能下单,导致订单无法履约);
- 解决方案:最长过期时间,不要超过 24 小时,数据变化频繁的 Key(比如商品库存),过期时间不要超过 30 分钟。
避坑点 2:不要设置 "过短的过期时间"(比如 1 分钟、5 分钟)
- 后果:缓存会频繁过期,缓存命中率急剧下降(比如 1 分钟过期,用户每查询一次,都要查 MySQL),大量请求打回 MySQL,MySQL 压力暴增,甚至宕机;
- 解决方案:过短的过期时间,仅适合 "数据变化极快" 的场景(比如临时验证码、实时库存),其他场景,过期时间不要短于 10 分钟。
避坑点 3:不要 "忘记设置过期时间"
- 后果:Key 会永久保留在 Redis 中,不会被淘汰(除非手动删除),随着 Key 的增多,Redis 内存会无限占用,最终导致内存满了,新写入报错,业务崩溃;
- 解决方案:所有缓存 Key,都必须设置过期时间,没有例外;哪怕是爆款商品,也要设置过期时间(比如 12 小时),避免内存膨胀。
避坑点 4:不要设置 "固定的过期时间"(不加分随机值)
- 后果:大量 Key 同时过期,引发缓存雪崩,MySQL 被打崩;
- 解决方案:无论什么业务场景,设置过期时间时,都要加上 "随机值",哪怕随机值很小(比如 10~60 秒),也要加,避免同时过期。
避坑点 5:不要 "频繁修改过期时间"
- 后果:频繁修改 Key 的过期时间,会增加 Redis 的资源消耗(Redis 需要频繁更新过期时间戳),同时可能导致过期时间混乱(比如刚设置 1 小时过期,又改成 10 分钟,导致 Key 提前过期);
- 解决方案:Key 写入时,一次性设置好过期时间,后续不要频繁修改;若确实需要修改(比如商品下架,需要立即过期),直接删除 Key(
DEL key),不要修改过期时间。
1.3.5 缓存冷启动与缓存抖动的解决方案
前面我们讲实时生成策略时,提到了两个小缺点:缓存冷启动、缓存抖动,这两个问题,虽然不致命,但会影响缓存命中率、增加 MySQL 压力,生产环境中,必须解决
1.3.5.1 缓存冷启动(Cache Cold Start)------Redis 刚启动,缓存是空的怎么办?
什么是缓存冷启动?
缓存冷启动,是指 "Redis 刚启动(或宕机重启)时,缓存是空的,所有查询请求,都会直接打回 MySQL,导致 MySQL 在 Redis 启动初期,出现短暂的压力高峰,甚至卡顿"------ 就像 "商场刚开门,导购员的小仓库(Redis)是空的,所有顾客(用户),都要去大仓库(MySQL)找商品,大仓库瞬间挤满人,卡顿不堪"。
为什么会出现缓存冷启动?
- Redis 刚部署,第一次启动,缓存是空的;
- Redis 宕机重启(比如服务器断电、Redis 故障),缓存中的数据,全部丢失(未开启持久化,或持久化失败),重启后缓存为空;
- 手动清空缓存(比如业务升级,需要清空旧数据),清空后缓存为空。
缓存冷启动的危害
- 短期 MySQL 压力暴增:Redis 启动初期,缓存命中率为 0,所有查询请求,都打回 MySQL,若此时有高并发请求(比如 10 万 QPS),MySQL 会瞬间被打崩;
- 用户体验下降:MySQL 压力大,查询速度变慢,用户打开页面,加载时间变长(比如 10 秒以上),甚至加载失败;
- 业务不稳定:MySQL 若被打崩,会导致整个业务无法正常运行(比如用户无法查询商品、无法下单)。
缓存冷启动的 3 个解决方案
根据业务规模、Redis 是否开启持久化,我们有 3 个解决方案:
方案 1:缓存预热(首选,最常用,小白能落地)
核心原理
缓存预热,就是 "在 Redis 启动后、用户访问前,提前把 MySQL 中的热点数据,批量写入 Redis 缓存"------ 相当于 "商场开门前,导购员提前把热门商品,从大仓库(MySQL)搬到自己的小仓库(Redis)",用户开门后,直接从小仓库拿商品,不用去大仓库,缓解 MySQL 的压力。
实现步骤
步骤 1:筛选热点数据(确定要预热的数据)
- 核心:筛选出 MySQL 中,访问频率最高的前 20% 数据(热点数据),比如爆款商品、高频查询的用户信息、热门新闻;
- 筛选方法(小白能实现,不用大数据工具):
- 从业务日志中,统计最近 1 天 / 1 小时,查询次数最多的前 N 条数据(比如前 1000 个商品);
- 结合业务经验,手动筛选热点数据(比如电商网站的促销商品、爆款商品);
- 把筛选出的热点数据,整理成一个列表(比如商品 ID 列表:123, 456, 789, ...)。
步骤 2:批量写入 Redis
- 核心:写一个 "预热脚本"(比如 Java 脚本、Python 脚本),批量查询 MySQL 中的热点数据,写入 Redis,并设置合理的过期时间(加上随机值);
- 实战示例(Java 脚本):
java
// 缓存预热脚本(可以用SpringBoot的CommandLineRunner,启动后自动执行)
@Component
public class CacheWarmUpRunner implements CommandLineRunner {

    @Autowired
    private StringRedisTemplate redisTemplate;

    // 1. 筛选出的热点商品ID列表(实战中,可从日志统计、数据库查询获取)
    private List<Long> hotGoodsIds = Arrays.asList(123L, 456L, 789L, 1011L, 1012L); // 示例:前5个热点商品ID

    @Override
    public void run(String... args) throws Exception {
        // 2. 批量查询MySQL,写入Redis(缓存预热)
        for (Long goodsId : hotGoodsIds) {
            // 2.1 查询MySQL中的商品详情(实际业务中,替换成真实查询)
            String goodsDetail = queryGoodsFromMysql(goodsId);
            // 2.2 定义Redis Key
            String redisKey = "goods:" + goodsId;
            // 2.3 设置过期时间(1小时 + 随机60~600秒)
            int randomSeconds = new Random().nextInt(541) + 60;
            long expireSeconds = 3600 + randomSeconds;
            // 2.4 写入Redis
            redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);
            // 打印日志,确认预热成功
            System.out.println("缓存预热成功:Redis Key=" + redisKey + ",过期时间=" + expireSeconds + "秒");
        }
        System.out.println("所有热点商品缓存预热完成,共预热" + hotGoodsIds.size() + "个商品");
    }

    // 模拟MySQL查询(实际业务中,替换成真实代码)
    private String queryGoodsFromMysql(Long goodsId) {
        return "商品ID:" + goodsId + ",商品名称:爆款手机,价格:1000元,库存:1000台";
    }
}
步骤 3:设置预热时机(确保预热在用户访问前完成)
- 时机 1:Redis 启动后,自动执行预热脚本(比如上面的 Java 脚本,用 CommandLineRunner,Redis 启动后,自动执行预热);
- 时机 2:业务低峰期,手动执行预热脚本(比如每天凌晨 2 点,业务访问量最低时,手动执行脚本,更新预热缓存);
- 时机 3:Redis 宕机重启后,运维人员手动触发预热脚本(确保用户访问前,缓存已预热完成)。
优点(为什么首选缓存预热)
- 彻底解决缓存冷启动问题:Redis 启动后,缓存中已有热点数据,用户访问时,直接命中缓存,不会打回 MySQL;
- 实现简单,成本低:不用复杂的工具,写一个简单的脚本,就能实现,小白也能落地;
- 灵活适配业务:可以根据业务场景,调整热点数据的筛选范围、预热时机,适配不同的业务需求;
- 提升用户体验:用户访问时,缓存已命中,加载速度快,提升用户体验。
缺点(可解决)
- 热点数据筛选不够精准:如果筛选的热点数据,不是当前真正的热点数据,会导致缓存命中率下降 ------ 解决方案:结合实时访问日志,定期更新热点数据列表,每天预热一次;
- 预热时,会增加 MySQL 的短暂压力:批量查询 MySQL 中的热点数据,会给 MySQL 带来短暂的压力 ------ 解决方案:在业务低峰期(比如凌晨)执行预热,避免影响用户访问。
适用场景
- 所有存在缓存冷启动问题的业务(比如 Redis 宕机重启、新部署 Redis);
- 热点数据相对稳定的业务(比如电商、短视频、新闻);
- 对用户体验、系统稳定性要求高的业务。
方案 2:开启 Redis 持久化(辅助方案,避免缓存全部丢失)
核心原理
Redis 的持久化,就是 "把内存中的缓存数据,定期写入硬盘"------ 相当于 "导购员的小仓库(Redis),每天晚上,把仓库里的商品,备份到一个临时仓库(硬盘)",如果小仓库不小心被清空(Redis 宕机),第二天早上,导购员可以从临时仓库,把商品重新搬回小仓库(Redis 重启后,从硬盘恢复数据),避免缓存全部丢失,缓解缓存冷启动压力。
实现方法(优先选 AOF+RDB 混合持久化)
Redis 支持两种持久化方式:RDB 和 AOF,实战中,优先选 "RDB+AOF 混合持久化",既保证数据安全,又保证恢复速度:
1. RDB 持久化配置(定期快照,适合备份)
# Redis配置文件redis.conf
# 1. 开启RDB持久化(默认开启,不用修改)
# 2. 设置快照触发时机(3个条件,满足一个,就触发快照,写入硬盘)
save 900 1    # 900秒(15分钟)内,有1个Key被修改,触发快照
save 300 10   # 300秒(5分钟)内,有10个Key被修改,触发快照
save 60 10000 # 60秒(1分钟)内,有10000个Key被修改,触发快照
# 3. 设置RDB文件保存路径(默认是当前目录,可修改)
dir /var/lib/redis
# 4. 设置RDB文件名(默认是dump.rdb)
dbfilename dump.rdb
2. AOF 持久化配置(实时日志,适合恢复数据)
# Redis配置文件redis.conf
# 1. 开启AOF持久化(默认关闭,必须开启)
appendonly yes
# 2. 设置AOF文件保存路径(和RDB相同,可共用)
dir /var/lib/redis
# 3. 设置AOF文件名(默认是appendonly.aof)
appendfilename appendonly.aof
# 4. 设置AOF同步策略(推荐选everysec,兼顾性能和数据安全)
appendfsync everysec # 每秒同步一次,把内存中的日志,写入硬盘
# appendfsync always # 每次写入Redis,都同步到硬盘(数据最安全,但性能最差)
# appendfsync no     # 由操作系统,随机同步(性能最好,但数据最不安全)
# 5. 开启AOF重写(避免AOF文件过大,自动压缩)
auto-aof-rewrite-percentage 100 # AOF文件大小,达到上次重写后的100%,触发重写
auto-aof-rewrite-min-size 64mb  # AOF文件最小大小,达到64MB,才触发重写
3. 混合持久化配置(Redis 4.0 + 支持,推荐)
# Redis配置文件redis.conf
# 开启混合持久化(默认开启,Redis 4.0+)
aof-use-rdb-preamble yes
核心作用(辅助解决冷启动)
- Redis 宕机重启后,会优先从 AOF 文件中,恢复缓存数据(AOF 数据更完整),如果 AOF 文件不存在,再从 RDB 文件中恢复;
- 恢复后,Redis 缓存中,会保留大部分之前的缓存数据(不是全部,比如刚写入的、未同步到硬盘的数据,会丢失),避免缓存完全为空,缓解冷启动压力;
- 比如 Redis 宕机前,缓存中有 1000 个热点商品,重启后,从 AOF 文件中恢复了 900 个,剩下 100 个,通过缓存预热补充,MySQL 的压力会大大减小。
注意事项
- 持久化是 "辅助方案",不能替代缓存预热 ------ 因为持久化恢复的数据,可能不是最新的(比如未同步到硬盘的数据,会丢失),且可能包含冷数据,还是需要缓存预热,补充最新的热点数据;
- 定期备份 RDB、AOF 文件 ------ 避免硬盘损坏,导致持久化文件丢失,无法恢复数据;
- 不要开启 "appendfsync always"------ 会严重影响 Redis 的性能,实战中,优先选 "everysec"。
方案 3:请求限流 + 降级(兜底方案,应对极端情况)
核心原理
请求限流 + 降级,是 "兜底方案"------ 当 Redis 冷启动(缓存为空),且 MySQL 压力过大时,限制一部分查询请求(不让过多请求打回 MySQL),对被限制的请求,返回 "服务繁忙,请稍后再试"(降级),避免 MySQL 被打崩,保证核心业务(比如下单)能正常运行。
实现步骤
步骤 1:实现请求限流(限制每秒访问 MySQL 的请求数)
用 Redis 的 incr 命令,实现简单的请求限流:
java
// 注入Redis模板
@Autowired
private StringRedisTemplate redisTemplate;

// 限流方法(判断当前请求,是否允许访问MySQL)
private boolean isAllowAccessMysql() {
    // 1. 定义限流Key(比如:mysql:limit:20260211,按天区分,每天重置)
    String limitKey = "mysql:limit:" + LocalDate.now().format(DateTimeFormatter.ISO_LOCAL_DATE);
    // 2. 用incr命令,统计每秒的请求数(incr是原子操作,避免并发问题)
    Long count = redisTemplate.opsForValue().increment(limitKey, 1);
    // 3. 如果是第一次统计,设置过期时间(1天)
    if (count != null && count == 1) {
        redisTemplate.expire(limitKey, 1, TimeUnit.DAYS);
    }
    // 4. 设置限流阈值(比如每秒最多允许1000次请求访问MySQL)
    long limitThreshold = 1000;
    // 5. 判断请求数,是否超过阈值
    return count != null && count <= limitThreshold;
}
步骤 2:实现请求降级(被限流的请求,返回降级提示)
修改之前的商品详情查询方法,加入限流 + 降级逻辑:
java
public String getGoodsDetail(Long goodsId) {
    String redisKey = "goods:" + goodsId;
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);

    // 缓存命中,直接返回
    if (goodsDetail != null) {
        return goodsDetail;
    }

    // 缓存未命中,判断是否允许访问MySQL(限流)
    if (!isAllowAccessMysql()) {
        // 被限流,返回降级提示(兜底,避免MySQL被打崩)
        return "服务繁忙,请稍后再试(缓存冷启动中)";
    }

    // 允许访问MySQL,查询数据
    goodsDetail = queryGoodsFromMysql(goodsId);

    // 写入Redis,设置过期时间
    int randomSeconds = new Random().nextInt(541) + 60;
    long expireSeconds = 3600 + randomSeconds;
    redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);

    return goodsDetail;
}
核心作用(兜底)
- 当 Redis 冷启动,缓存为空,大量请求打回 MySQL 时,限流会限制访问 MySQL 的请求数(比如每秒最多 1000 次),避免 MySQL 被打崩;
- 被限流的请求,返回降级提示,虽然用户体验略有下降,但能保证核心业务(比如下单)能正常运行,避免整个业务崩溃;
- 适合极端情况(比如 Redis 宕机重启,且缓存预热未完成,同时有大量用户访问)。
适用场景(兜底,辅助其他方案)
- 缓存冷启动的极端情况(大量请求同时访问,缓存未预热完成);
- MySQL 压力过大时,兜底保护 MySQL,避免 MySQL 宕机;
- 不能单独使用,必须和缓存预热、持久化,结合使用。
1.3.5.2 缓存抖动(Cache Thrashing)------ 数据反复写入、反复淘汰怎么办?
什么是缓存抖动?
缓存抖动,是指 "某条缓存数据,刚被写入 Redis,很快就被淘汰;淘汰后,又被用户查询,重新写入 Redis;写入后,又很快被淘汰,反复循环"------ 相当于 "导购员把一个商品,刚搬到小仓库(Redis),就被淘汰(删掉);删掉后,又有顾客要这个商品,只能再从大仓库(MySQL)搬过来,搬过来后,又很快被删掉,反复折腾",既消耗 Redis 资源,又增加 MySQL 压力,缓存命中率极低。
为什么会出现缓存抖动?(3 个常见原因)
- 缓存过期时间 "过短":比如设置 1 分钟过期,某条数据,每分钟被查询 1 次,写入 Redis 后,1 分钟过期被淘汰,下一次查询,又要重新写入,反复循环;
- 缓存淘汰策略 "不合理":比如用 Random 随机淘汰,某条热点数据,刚被写入,就被随机淘汰,淘汰后又被查询,重新写入,反复循环;
- 业务访问 "不稳定":某条数据,偶尔被查询一次,写入 Redis 后,长时间不被查询,被 LRU/LFU 淘汰;过一段时间,又被查询,重新写入,反复循环(比如小众商品,偶尔有用户查询)。
缓存抖动的危害
- 消耗 Redis 资源:反复写入、淘汰数据,会增加 Redis 的 CPU、内存消耗,影响 Redis 的性能;
- 增加 MySQL 压力:每次淘汰后,用户查询,都要查 MySQL,重新写入 Redis,MySQL 的查询压力增大;
- 缓存命中率极低:数据反复被淘汰,缓存几乎起不到作用,和 "没有缓存" 差不多,用户访问速度慢,体验差。
缓存抖动的 4 个解决方案
方案 1:合理设置过期时间,避免过短
- 核心逻辑:把过期时间,设置得 "合理一点",避免过短(比如不要短于 10 分钟),让数据能在 Redis 中,停留足够长的时间,减少反复写入、淘汰的频率;
- 实战示例:
- 错误做法:小众商品缓存,设置过期时间 1 分钟,每分钟被查询 1 次,反复写入、淘汰;
- 正确做法:小众商品缓存,设置过期时间 30 分钟 + 随机 10~30 秒,数据能在 Redis 中停留 30 分钟左右,减少反复写入、淘汰的频率,哪怕 30 分钟后过期,重新写入一次,也比每分钟写入一次,消耗的资源少。
方案 2:选择合适的淘汰策略,避免 Random
- 核心逻辑:淘汰策略,优先选 LRU/LFU,避免选 Random------LRU/LFU 能保留热点数据,哪怕是偶尔被查询的数据,只要最近被访问过,就不会被频繁淘汰;而 Random 是随机淘汰,很容易导致热点数据,反复被淘汰;
- 实战建议:
- 核心业务,选 allkeys-lru(首选);
- 对命中率要求高,选 allkeys-lfu;
- 坚决不选 allkeys-random/volatile-random,避免缓存抖动。
方案 3:给 "低频冷数据",设置 "较短的过期时间",避免占用空间
- 核心逻辑:对于 "低频冷数据"(比如小众商品,每天被查询 1~2 次),不要设置过长的过期时间,设置较短的过期时间(比如 10~30 分钟),让它过期后,自然淘汰,不要反复写入、淘汰;
- 原理:低频冷数据,本身访问频率低,缓存的价值不大,设置较短的过期时间,让它过期后,不再缓存,用户下次查询,直接查 MySQL,虽然会增加 MySQL 的少量压力,但能避免缓存抖动,节省 Redis 资源;
- 实战示例:
- 小众商品(每天查询 1~2 次):设置过期时间 10 分钟 + 随机 5~10 秒,过期后,不再缓存,用户下次查询,直接查 MySQL;
- 爆款商品(每天查询 10 万次):设置过期时间 12 小时 + 随机 60~600 秒,保留在 Redis 中,避免反复淘汰。
方案 4:加入 "缓存穿透防护"(后续详细讲),避免无效数据写入
- 核心逻辑:缓存穿透,是指 "用户查询不存在的数据(比如商品 ID=9999,MySQL 中没有),每次查询,都要查 MySQL,然后写入 Redis(空值),空值很快被淘汰,反复循环,导致缓存抖动";
- 解决方案:对 "不存在的数据",设置 "较短的空值缓存"(比如 5 分钟),避免反复查询 MySQL、反复写入空值,从根源上解决这类缓存抖动;同时,对大量不存在的数据查询,可引入布隆过滤器,直接拦截,不允许查询 MySQL、写入 Redis。
- 实战示例:
java
public String getGoodsDetail(Long goodsId) {
    String redisKey = "goods:" + goodsId;
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);

    // 缓存命中(包括空值缓存),直接返回
    if (goodsDetail != null) {
        // 若为空值,返回提示(避免用户看到空数据)
        if ("NULL".equals(goodsDetail)) {
            return "抱歉,该商品不存在";
        }
        return goodsDetail;
    }

    // 缓存未命中,判断是否允许访问MySQL(限流兜底)
    if (!isAllowAccessMysql()) {
        return "服务繁忙,请稍后再试(缓存冷启动中)";
    }

    // 查询MySQL中的商品详情
    goodsDetail = queryGoodsFromMysql(goodsId);

    // 核心:判断MySQL中是否存在该数据
    if (goodsDetail == null || "".equals(goodsDetail.trim())) {
        // 数据不存在,写入空值缓存,设置较短过期时间(5分钟,不加随机值,因为空值无需避免同时过期)
        redisTemplate.opsForValue().set(redisKey, "NULL", 300, TimeUnit.SECONDS);
        return "抱歉,该商品不存在";
    }

    // 数据存在,写入正常缓存,设置过期时间(1小时 + 随机60~600秒)
    int randomSeconds = new Random().nextInt(541) + 60;
    long expireSeconds = 3600 + randomSeconds;
    redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);

    return goodsDetail;
}

// 模拟MySQL查询方法(若商品不存在,返回null)
private String queryGoodsFromMysql(Long goodsId) {
    // 模拟:商品ID>10000时,数据不存在,返回null
    if (goodsId > 10000) {
        return null;
    }
    return "商品ID:" + goodsId + ",商品名称:爆款手机,价格:1000元,库存:1000台";
}- 代码说明:
- 空值缓存用 "NULL" 字符串表示(避免和真实空值混淆),设置过期时间 300 秒(5 分钟),不加随机值 ------ 因为空值缓存无需避免同时过期,且过期时间短,即使同时过期,也不会引发缓存雪崩;
- 当用户查询不存在的商品(比如 ID=10001)时,第一次查询 MySQL 返回 null,写入空值缓存;接下来 5 分钟内,用户再查询该商品,直接命中空值缓存,返回提示,不用再查 MySQL,避免反复写入、淘汰空值,解决这类缓存抖动;
- 空值缓存过期时间不能太长(比如不超过 10 分钟)------ 避免 MySQL 中新增该商品后,用户长时间查询不到(比如商品 ID=10001,后续 MySQL 中新增了该商品,空值缓存 5 分钟后过期,用户下次查询就能获取到新数据)。
缓存抖动解决方案总结
| 解决方案 | 核心逻辑 | 适用场景 | 注意事项 |
|---|---|---|---|
| 合理设置过期时间 | 避免过短(≥10 分钟),结合业务场景差异化设置 | 所有业务,尤其是低频数据 | 高频数据设较长过期时间,低频数据设较短过期时间 |
| 选择合适淘汰策略 | 优先选 LRU/LFU,坚决不选 Random | 所有业务,核心业务必用 | 有永久 Key 选 volatile-lru/lfu,无永久 Key 选 allkeys-lru/lfu |
| 低频冷数据短过期 | 低频冷数据设 10~30 分钟过期,过期后不重复缓存 | 小众商品、冷门新闻等低频数据 | 避免低频数据占用缓存空间,减少反复写入淘汰 |
| 缓存穿透防护 | 不存在的数据,写入 5 分钟空值缓存;大量无效查询用布隆过滤器拦截 | 用户查询不存在数据的场景 | 空值缓存过期时间不能太长,避免数据不一致 |
1.3.6 缓存穿透(Cache Penetration)------ 查询不存在的数据,缓存形同虚设怎么办?
缓存穿透是缓存设计中,最常见的三大异常问题(穿透、击穿、雪崩)之一,小白很容易忽略,一旦出现,会导致大量无效查询直接打回 MySQL,MySQL 压力暴增,甚至宕机
1.3.6.1 什么是缓存穿透?
通俗解释
缓存穿透,是指 "用户反复查询MySQL 中不存在的数据(比如商品 ID=9999、用户 ID=8888,数据库中没有这些数据)",因为数据不存在,所以 Redis 中不会有对应的缓存(即使写入空值,若过期时间设置不合理,也会反复失效),导致每次查询,都要直接打回 MySQL,缓存完全起不到作用,形同虚设 ------ 就像 "商场里没有某件商品,所有顾客,都要去大仓库(MySQL)找一遍,导购员的小仓库(Redis)里,根本没有这件商品,白跑一趟"。
实战场景
- 恶意攻击:黑客批量发送 "查询不存在商品 ID" 的请求(比如商品 ID 从 10001 到 100000,MySQL 中都没有),每秒发送 1000 次,所有请求都直接打回 MySQL,MySQL 瞬间被打崩;
- 用户误操作:用户输入错误的商品 ID(比如商品 ID 是 123,用户输入 12345),查询不存在的数据,每次查询都要查 MySQL;
- 业务逻辑漏洞:代码中,误查询不存在的用户 ID、商品 ID,比如循环查询 ID 从 1 到 10000,其中 5000 个 ID 不存在,导致大量无效查询打回 MySQL。
核心特点
- 查询的 Key,在 MySQL 中不存在;
- Redis 中,没有对应的缓存(或空值缓存已过期);
- 每次查询,都直接穿透缓存,打回 MySQL;
- 若请求量较大,会导致 MySQL 压力暴增,甚至宕机。
1.3.6.2 为什么会出现缓存穿透?
- 未设置 "空值缓存":查询不存在的数据时,MySQL 返回 null,业务代码没有将 "空值" 写入 Redis,导致下次查询该 Key 时,依然要查 MySQL,反复循环;
- 空值缓存 "过期时间过长 / 过短":
- 过期时间过短(比如 1 分钟):空值缓存很快过期,过期后,又有查询请求,打回 MySQL,反复写入、淘汰空值,同时引发缓存抖动;
- 过期时间过长(比如 24 小时):若 MySQL 中,后续新增了该数据(比如商品 ID=10001,后续新增到 MySQL),用户查询时,依然命中空值缓存,返回 "商品不存在",导致数据不一致;
- 恶意攻击 / 业务漏洞:黑客批量发送无效请求,或代码中存在漏洞,批量查询不存在的数据,请求量过大,超过 MySQL 的承载能力。
1.3.6.3 缓存穿透的危害
- MySQL 压力暴增:大量无效查询,直接打回 MySQL,MySQL 的 CPU、内存占用率急剧上升,查询速度变慢;
- MySQL 宕机:若请求量过大(比如每秒 10000 次无效查询),MySQL 会被瞬间打崩,导致整个业务无法正常运行(比如用户无法查询商品、无法下单);
- Redis 资源浪费:若业务代码写入空值缓存,但过期时间不合理,会导致空值反复写入、淘汰,消耗 Redis 资源;
- 用户体验下降:MySQL 压力大,查询速度慢,用户打开页面,加载时间变长,甚至加载失败;若为空值缓存过长,用户查询新增的数据,会返回错误提示,体验极差。
1.3.6.4 缓存穿透的 4 个解决方案
方案 1:设置空值缓存
核心原理(通俗解释)
当用户查询 "MySQL 中不存在的数据" 时,业务代码将 "空值"(比如字符串 "NULL")写入 Redis,设置较短的过期时间(5~10 分钟),后续用户再查询该 Key 时,直接命中空值缓存,返回 "商品不存在",不用再查 MySQL------ 相当于 "导购员发现大仓库里没有某件商品,就在自己的小仓库里,放一个'空盒子',标注'没有该商品',后续顾客来问,直接拿出空盒子,不用再去大仓库跑一趟"。
实现步骤
步骤 1:修改业务代码,判断 MySQL 返回结果,写入空值缓存
java
@Autowired
private StringRedisTemplate redisTemplate;

public String getGoodsDetail(Long goodsId) {
    // 1. 定义Redis Key
    String redisKey = "goods:" + goodsId;

    // 2. 先查Redis,命中(包括空值缓存)直接返回
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);
    if (goodsDetail != null) {
        // 空值缓存,返回用户友好提示
        if ("NULL".equals(goodsDetail)) {
            return "抱歉,该商品不存在或已下架~";
        }
        // 正常缓存,返回数据
        return goodsDetail;
    }

    // 3. 缓存未命中,查询MySQL
    goodsDetail = queryGoodsFromMysql(goodsId);

    // 4. 判断MySQL返回结果,区分"数据存在"和"数据不存在"
    if (goodsDetail == null || "".equals(goodsDetail.trim())) {
        // 4.1 数据不存在,写入空值缓存,设置过期时间5分钟(300秒)
        // 过期时间:5~10分钟,不加分随机值(空值无需避免同时过期)
        redisTemplate.opsForValue().set(redisKey, "NULL", 300, TimeUnit.SECONDS);
        // 返回用户友好提示
        return "抱歉,该商品不存在或已下架~";
    }

    // 4.2 数据存在,写入正常缓存,设置过期时间(1小时 + 随机60~600秒)
    int randomSeconds = new Random().nextInt(541) + 60;
    long expireSeconds = 3600 + randomSeconds;
    redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);

    // 5. 返回正常数据
    return goodsDetail;
}

// 模拟MySQL查询方法(数据不存在返回null)
private String queryGoodsFromMysql(Long goodsId) {
    // 模拟:商品ID≤10000时存在,>10000时不存在
    if (goodsId > 10000) {
        return null;
    }
    return "商品ID:" + goodsId + ",名称:爆款手机,价格:1000元,库存:1000台";
}
步骤 2:设置合理的空值缓存过期时间
- 核心原则:5~10 分钟,既不太长,也不太短;
- 太短(<5 分钟):空值缓存很快过期,反复写入、淘汰,引发缓存抖动,增加 MySQL 压力;
- 太长(>10 分钟):MySQL 中新增该数据后,用户长时间查询不到,导致数据不一致;
- 实战建议:默认设 5 分钟,若业务中 "新增不存在数据" 的频率较高(比如每天新增 100 个商品),可设 3 分钟;若频率较低,可设 10 分钟。
步骤 3:避免空值缓存被误淘汰(可选)
-
若 Redis 淘汰策略用的是 "volatile-lru/volatile-lfu"(针对过期 Key 淘汰),空值缓存设置了过期时间,可能被淘汰 ------ 可给空值缓存,设置 "较高的访问次数"(模拟热点),避免被频繁淘汰;
-
实战代码:
// 写入空值缓存后,模拟1次访问,更新最后访问时间/访问次数,避免被淘汰
redisTemplate.opsForValue().get(redisKey);
优点(为什么首选空值缓存)
- 实现最简单:只需修改业务代码,增加 "空值判断 + 空值写入" 逻辑,小白能直接落地,不用引入额外工具;
- 成本极低:不用增加额外的服务器、组件,仅利用 Redis 的缓存功能,就能解决大部分缓存穿透问题;
- 适配性强:适合所有业务场景,尤其是 "无效请求量不大" 的场景(比如用户误操作、少量恶意请求);
- 能兼顾数据一致性:过期时间设置合理,既能避免反复查询 MySQL,又能保证 MySQL 中新增数据后,用户能及时查询到。
缺点(可解决)
- 无法应对 "大量无效请求":比如黑客批量发送 10000 个不同的 "不存在商品 ID" 请求(ID 从 10001 到 20000),每个 ID 都是第一次查询,空值缓存未命中,所有请求都会打回 MySQL,依然会导致 MySQL 压力暴增;
- 浪费 Redis 缓存空间:大量空值缓存,会占用 Redis 的少量内存(比如每个空值缓存,仅占用几个字节,10000 个空值,仅占用几十 KB,影响可忽略);
- 可能出现短暂数据不一致:空值缓存过期前,MySQL 中新增该数据,用户查询时,依然会返回 "商品不存在",但过期后会恢复正常,属于可接受范围。
适用场景
- 所有业务的 "基础防护":无论无效请求量大小,都要先设置空值缓存,作为第一道防线;
- 无效请求量不大的场景(比如用户误操作、少量恶意请求);
- 中小规模业务:没有足够的资源,部署布隆过滤器、Redis 集群,空值缓存是最优选择。
方案 2:布隆过滤器(Bloom Filter)------ 拦截大量无效请求,终极解决方案
核心原理
布隆过滤器,是一个 "二进制数组"(只有 0 和 1),提前把 MySQL 中 "所有存在的 Key"(比如所有商品 ID、用户 ID),通过哈希算法,映射到这个数组中,标记为 1;当用户发起查询请求时,先通过布隆过滤器,判断该 Key 是否 "可能存在":
- 若布隆过滤器标记为 0:该 Key 一定不存在于 MySQL 中,直接拦截请求,返回 "商品不存在",不查 Redis、不查 MySQL;
- 若布隆过滤器标记为 1:该 Key 可能存在于 MySQL 中(有极小的误判率),再走正常流程(查 Redis→查 MySQL→写缓存);
- 相当于 "商场门口,放一个'商品目录对照表'(布隆过滤器),顾客要找某件商品,先查对照表:对照表上没有,直接告诉顾客'没有该商品',不用进商场;对照表上有,再进商场,找导购员(Redis)、大仓库(MySQL)"。
关键补充
- 布隆过滤器的 "误判率":因为哈希算法的特性,可能会把 "不存在的 Key",误映射到数组的 1 位置,导致布隆过滤器标记为 1,误判为 "可能存在"------ 误判率越低,布隆过滤器的数组越大,占用的内存越多,可根据业务需求,调整误判率(比如 0.1%、1%);
- 布隆过滤器的 "不可删除":一旦把 Key 映射到数组中,标记为 1,就无法删除(删除会影响其他 Key 的判断)------ 适合 "Key 不会被删除" 的场景(比如商品 ID、用户 ID,一旦创建,不会删除,只会下架 / 禁用);若 Key 会被频繁删除,布隆过滤器不适用。
实现步骤
Redis 4.0 + 版本,支持布隆过滤器插件(RedisBloom),不用自己实现,直接部署插件,用 Redis 命令操作,步骤如下:
步骤 1:部署 Redis 布隆过滤器插件
-
下载 RedisBloom 插件(对应自己的 Redis 版本):
- 下载地址:https://github.com/RedisBloom/RedisBloom/releases
- 示例:Redis 6.2.6 版本,下载 redisbloom-2.2.19.so
-
部署插件(两种方式,选一种即可):
-
方式 1:临时部署(重启 Redis 后失效):
# 登录Redis客户端,执行命令,加载插件 127.0.0.1:6379> module load /usr/local/redis/plugins/redisbloom-2.2.19.so OK # 加载成功 -
方式 2:永久部署(重启 Redis 后生效,推荐):
# 修改Redis配置文件redis.conf,添加插件加载命令
loadmodule /usr/local/redis/plugins/redisbloom-2.2.19.so
# 重启Redis,使配置生效
redis-cli shutdown
redis-server /etc/redis/redis.conf
-
-
验证插件是否部署成功:
127.0.0.1:6379> bf.add test key1 # 执行布隆过滤器命令,添加一个Key
(integer) 1 # 返回1,添加成功,说明插件部署成功
步骤 2:初始化布隆过滤器,导入 MySQL 中所有存在的 Key
-
核心:把 MySQL 中,所有存在的 Key(比如所有商品 ID),批量导入布隆过滤器,标记为 1;
-
实战步骤:
-
从 MySQL 中,查询所有存在的商品 ID,导出为列表(比如 goods_ids.txt,每行一个商品 ID);
-
用 Redis 命令,批量导入布隆过滤器:
# 1. 创建布隆过滤器(设置名称为goods_bloom,误判率0.1%,预计存储100000个商品ID)
127.0.0.1:6379> bf.reserve goods_bloom 0.001 100000
OK
# 2. 批量导入商品ID(从文件导入,需用redis-cli的--pipe参数,高效批量导入)
cat goods_ids.txt | redis-cli --pipe bf.add goods_bloom
-
-
命令说明:
- bf.reserve:创建布隆过滤器,三个参数分别是 "过滤器名称、误判率、预计存储的 Key 数量";
- 误判率 0.1%(0.001):表示 1000 个不存在的 Key,可能有 1 个被误判为 "可能存在",误判率越低,占用内存越多;
- 预计存储数量:根据自己的业务,设置合理值(比如实际有 50000 个商品 ID,预计存储 100000 个,预留一定的扩容空间)。
步骤 3:修改业务代码,加入布隆过滤器拦截逻辑
在 "查 Redis" 之前,先通过布隆过滤器,拦截无效请求,修改后的完整代码(Java):
java
@Autowired
private StringRedisTemplate redisTemplate;

// 布隆过滤器名称(和Redis中创建的一致)
private static final String BLOOM_FILTER_NAME = "goods_bloom";

public String getGoodsDetail(Long goodsId) {
    // 1. 先通过布隆过滤器,判断商品ID是否可能存在(核心:拦截无效请求)
    Boolean existsInBloom = redisTemplate.execute((RedisCallback<Boolean>) connection -> {
        // 调用Redis布隆过滤器的bf.exists命令,判断Key是否存在
        return connection.execute("bf.exists",
                BLOOM_FILTER_NAME.getBytes(),
                goodsId.toString().getBytes());
    });

    // 2. 布隆过滤器标记为0:Key一定不存在,直接返回提示,不查Redis、不查MySQL
    if (existsInBloom != null && !existsInBloom) {
        return "抱歉,该商品不存在或已下架~";
    }

    // 3. 布隆过滤器标记为1:Key可能存在,走正常流程(查Redis→查MySQL→写缓存)
    String redisKey = "goods:" + goodsId;
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);

    // 3.1 缓存命中(包括空值缓存),直接返回
    if (goodsDetail != null) {
        if ("NULL".equals(goodsDetail)) {
            return "抱歉,该商品不存在或已下架~";
        }
        return goodsDetail;
    }

    // 3.2 缓存未命中,查询MySQL
    goodsDetail = queryGoodsFromMysql(goodsId);

    // 3.3 判断MySQL返回结果,写入缓存
    if (goodsDetail == null || "".equals(goodsDetail.trim())) {
        // 数据不存在,写入空值缓存(5分钟)
        redisTemplate.opsForValue().set(redisKey, "NULL", 300, TimeUnit.SECONDS);
        return "抱歉,该商品不存在或已下架~";
    }

    // 数据存在,写入正常缓存(1小时 + 随机值)
    int randomSeconds = new Random().nextInt(541) + 60;
    long expireSeconds = 3600 + randomSeconds;
    redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);

    return goodsDetail;
}

// 模拟MySQL查询方法
private String queryGoodsFromMysql(Long goodsId) {
    if (goodsId > 10000) {
        return null;
    }
    return "商品ID:" + goodsId + ",名称:爆款手机,价格:1000元,库存:1000台";
}
步骤 4:定期更新布隆过滤器(关键,避免数据不一致)
- 核心:MySQL 中,新增商品 ID 后,要及时将新的商品 ID,添加到布隆过滤器中;若商品 ID 不会删除,仅需新增时更新;
- 实战代码(新增商品时,同步更新布隆过滤器):
java
// 新增商品方法,同步更新布隆过滤器
public void addGoods(Long goodsId, String goodsDetail) {
    // 1. 新增商品到MySQL(实际业务中,替换成真实的MySQL新增代码)
    insertGoodsToMysql(goodsId, goodsDetail);

    // 2. 将新的商品ID,添加到布隆过滤器中
    redisTemplate.execute((RedisCallback<Void>) connection -> {
        connection.execute("bf.add",
                BLOOM_FILTER_NAME.getBytes(),
                goodsId.toString().getBytes());
        return null;
    });

    // 3. 可选:将新商品,直接写入Redis缓存,避免缓存冷启动
    String redisKey = "goods:" + goodsId;
    int randomSeconds = new Random().nextInt(541) + 60;
    long expireSeconds = 3600 + randomSeconds;
    redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);
}

// 模拟MySQL新增商品方法
private void insertGoodsToMysql(Long goodsId, String goodsDetail) {
    // 实际业务中,执行MySQL的insert语句
    System.out.println("商品新增成功:ID=" + goodsId + ",详情=" + goodsDetail);
}
优点(为什么是终极解决方案)
- 彻底拦截大量无效请求:无论黑客发送多少个不存在的 Key 请求,只要布隆过滤器标记为 0,就会被直接拦截,不查 Redis、不查 MySQL,MySQL 压力为 0;
- 内存占用少:布隆过滤器是二进制数组,占用内存极小(比如存储 100 万个商品 ID,误判率 0.1%,仅占用约 1.2MB 内存);
- 查询速度快:布隆过滤器的查询时间,是固定的(O (1)),不会随着 Key 数量增加,而变慢,不影响接口性能;
- 适配性强:适合 "大量无效请求""Key 不频繁删除" 的场景(比如商品 ID、用户 ID、新闻 ID)。
缺点
- 有极小的误判率:无法 100% 拦截无效请求,误判的无效请求,会走正常流程(查 Redis→查 MySQL),但可通过 "空值缓存",二次拦截,避免 MySQL 压力;
- 不可删除 Key:一旦 Key 被映射到布隆过滤器中,无法删除,若 Key 会被频繁删除(比如临时商品、过期活动),不适用;
- 部署和维护略复杂:需要部署 Redis 布隆过滤器插件,定期更新布隆过滤器,比空值缓存复杂,小白需要花时间学习部署;
- 不适合动态变化的 Key 数量:若 Key 数量远超 "预计存储数量",误判率会急剧上升,需要提前预估合理的数量,预留扩容空间。
适用场景
- 有大量无效请求的场景(比如黑客攻击、批量无效查询);
- Key 不频繁删除的场景(商品 ID、用户 ID、新闻 ID、订单 ID);
- 中大规模业务:有足够的资源,部署和维护布隆过滤器,追求极致的 MySQL 防护;
- 推荐搭配:布隆过滤器(第一道防线)+ 空值缓存(第二道防线),彻底解决缓存穿透问题。
方案 3:限制无效请求频率(兜底方案,辅助防护)
核心原理(通俗解释)
对 "同一 IP、同一用户",限制其 "查询不存在数据" 的频率(比如每分钟最多查询 10 次),超过频率限制,直接拦截请求,返回 "请求过于频繁,请稍后再试"------ 相当于 "商场规定,同一顾客,每分钟最多问 3 次'有没有某件商品',超过次数,就不让问了",避免单一 IP / 用户,发送大量无效请求,打崩 MySQL。
实现步骤
用 Redis 的 incr 命令,实现简单的无效请求频率限制,修改业务代码,加入限流逻辑:
java
// 无效请求限流前缀(区分不同类型的无效请求)
private static final String INVALID_REQUEST_LIMIT_PREFIX = "invalid:limit:";

// 限制频率:同一IP,每分钟最多查询10次不存在的数据
private static final int LIMIT_COUNT = 10;
private static final long LIMIT_SECONDS = 60;

public String getGoodsDetail(Long goodsId, String userIp) {
    // 1. 布隆过滤器拦截(第一道防线)
    Boolean existsInBloom = redisTemplate.execute((RedisCallback<Boolean>) connection -> {
        return connection.execute("bf.exists",
                BLOOM_FILTER_NAME.getBytes(),
                goodsId.toString().getBytes());
    });

    if (existsInBloom != null && !existsInBloom) {
        // 1.1 无效请求,先限流(第二道防线)
        String limitKey = INVALID_REQUEST_LIMIT_PREFIX + userIp;
        Long count = redisTemplate.opsForValue().increment(limitKey, 1);
        // 第一次统计,设置过期时间60秒
        if (count != null && count == 1) {
            redisTemplate.expire(limitKey, LIMIT_SECONDS, TimeUnit.SECONDS);
        }
        // 超过频率限制,拦截请求
        if (count != null && count > LIMIT_COUNT) {
            return "请求过于频繁,请稍后再试~";
        }
        // 未超过限制,返回提示
        return "抱歉,该商品不存在或已下架~";
    }

    // 2. 正常流程(查Redis→查MySQL→写缓存)
    String redisKey = "goods:" + goodsId;
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);

    if (goodsDetail != null) {
        if ("NULL".equals(goodsDetail)) {
            // 空值缓存,也需要限流(避免误判的无效请求,频繁查询)
            String limitKey = INVALID_REQUEST_LIMIT_PREFIX + userIp;
            Long count = redisTemplate.opsForValue().increment(limitKey, 1);
            if (count != null && count == 1) {
                redisTemplate.expire(limitKey, LIMIT_SECONDS, TimeUnit.SECONDS);
            }
            if (count != null && count > LIMIT_COUNT) {
                return "请求过于频繁,请稍后再试~";
            }
            return "抱歉,该商品不存在或已下架~";
        }
        return goodsDetail;
    }

    goodsDetail = queryGoodsFromMysql(goodsId);

    if (goodsDetail == null || "".equals(goodsDetail.trim())) {
        // 数据不存在,写入空值缓存,同时限流
        redisTemplate.opsForValue().set(redisKey, "NULL", 300, TimeUnit.SECONDS);

        String limitKey = INVALID_REQUEST_LIMIT_PREFIX + userIp;
        Long count = redisTemplate.opsForValue().increment(limitKey, 1);
        if (count != null && count == 1) {
            redisTemplate.expire(limitKey, LIMIT_SECONDS, TimeUnit.SECONDS);
        }
        if (count != null && count > LIMIT_COUNT) {
            return "请求过于频繁,请稍后再试~";
        }

        return "抱歉,该商品不存在或已下架~";
    }

    // 写入正常缓存
    int randomSeconds = new Random().nextInt(541) + 60;
    long expireSeconds = 3600 + randomSeconds;
    redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);

    return goodsDetail;
}
优点(兜底防护)
- 实现简单:基于 Redis 的 incr 命令,不用引入额外组件,小白能直接落地;
- 针对性强:专门拦截 "同一 IP / 用户" 的大量无效请求,避免单一来源的恶意攻击;
- 灵活可调:可根据业务需求,调整限流频率(比如每分钟 10 次、每秒 5 次),适配不同的防护需求;
- 辅助防护:搭配布隆过滤器、空值缓存,形成 "三道防线",彻底防护缓存穿透。
缺点(不能单独使用)
- 无法拦截 "分布式恶意攻击":黑客用大量不同的 IP,发送无效请求(比如每秒 1000 个不同 IP,每个 IP 查询 1 次),限流无法拦截,依然会打回 MySQL;
- 可能误拦正常用户:若正常用户,频繁查询不存在的数据(比如误输多次商品 ID),会被限流,影响用户体验;
- 仅能作为兜底方案:不能单独解决缓存穿透,必须和布隆过滤器、空值缓存,结合使用。
适用场景(兜底,辅助防护)
- 恶意攻击场景:拦截单一 IP / 用户的大量无效请求;
- 所有业务的 "三道防线":布隆过滤器(1)→ 无效请求限流(2)→ 空值缓存(3);
- 中小规模业务:没有部署布隆过滤器,可先用 "空值缓存 + 无效请求限流",临时防护。
方案 4:规范 Key 的格式,拦截非法 Key
核心原理(通俗解释)
用户查询的 Key,若格式非法(比如商品 ID 是字母、特殊字符,而正常商品 ID 是数字),直接拦截请求,不查 Redis、不查 MySQL------ 相当于 "商场规定,商品 ID 只能是数字,顾客报字母 ID,直接告诉顾客'没有该商品',不用进商场找",拦截一部分明显的无效请求。
实现步骤
修改业务代码,在最前面,加入 Key 格式校验逻辑:
java
public String getGoodsDetail(String goodsIdStr, String userIp) {
    // 1. 先校验Key格式(基础防护,拦截非法Key)
    Long goodsId;
    try {
        // 正常商品ID是数字,尝试转换为Long类型
        goodsId = Long.parseLong(goodsIdStr);
        // 额外校验:商品ID范围(比如正常商品ID是1~100000,超出范围,直接拦截)
        if (goodsId < 1 || goodsId > 100000) {
            return "抱歉,该商品不存在或已下架~";
        }
    } catch (NumberFormatException e) {
        // 格式非法(比如goodsIdStr是"abc"、"123abc"),直接拦截
        return "抱歉,该商品不存在或已下架~";
    }

    // 2. 后续流程:布隆过滤器→限流→查Redis→查MySQL→写缓存(和前面一致)
    // ......(省略前面的代码,直接复用)
}
优点(基础防护,零成本)
- 零成本:只需添加简单的格式校验代码,不用引入任何组件,不用消耗额外资源;
- 拦截明显无效请求:能拦截大部分 "格式非法" 的无效请求(比如字母、特殊字符、超出范围的 ID),减少 MySQL 的无效查询压力;
- 无副作用:不会影响正常用户的查询,也不会导致数据不一致,属于 "锦上添花" 的基础防护。
缺点(仅基础防护)
- 拦截范围有限:只能拦截格式非法的 Key,无法拦截 "格式合法,但 MySQL 中不存在的 Key"(比如商品 ID=10001,格式合法,但不存在);
- 不能单独使用:仅能作为基础防护,必须和其他方案结合,才能彻底解决缓存穿透。
适用场景(所有业务,基础防护,必做)
- 所有业务的 "第一道基础防线":无论是否部署布隆过滤器、空值缓存,都要加入 Key 格式校验;
- 有非法 Key 请求的场景:比如用户误输入字母 ID、黑客发送特殊字符 ID。
1.3.6.5 缓存穿透解决方案总结
核心防护体系
- 第一道防线:Key 格式校验(零成本,必做)→ 拦截格式非法的无效请求;
- 第二道防线:布隆过滤器(终极防护,优先落地)→ 拦截大量格式合法、但不存在的 Key 请求;
- 第三道防线:空值缓存 + 无效请求限流(兜底防护,必做)→ 拦截布隆过滤器误判的无效请求,避免反复查询 MySQL。
解决方案选型建议
| 业务规模 | 无效请求量 | 推荐解决方案组合 | 实现难度 | 成本 |
|---|---|---|---|---|
| 小规模业务 | 少(仅用户误操作) | Key 格式校验 + 空值缓存 | 低 | 零成本 |
| 中小规模业务 | 中(少量恶意请求) | Key 格式校验 + 空值缓存 + 无效请求限流 | 中 | 零成本 |
| 中大规模业务 | 多(大量恶意攻击) | Key 格式校验 + 布隆过滤器 + 空值缓存 + 无效请求限流 | 中高 | 低(仅需部署 Redis 插件) |
小白避坑点
- 空值缓存,必须设置 "较短的过期时间"(5~10 分钟),避免数据不一致;
- 布隆过滤器,必须 "定期更新"(新增 Key 时同步添加),否则会出现 "Key 存在,但布隆过滤器未标记" 的情况;
- 布隆过滤器的 "误判率",不要设置过低(比如 0.0001%),否则会占用大量内存,性价比不高;默认设 0.1% 即可;
- 无效请求限流,不要设置过严(比如每分钟 3 次),避免误拦正常用户;默认设每分钟 10 次即可;
- 不要单独依赖某一种方案:比如只靠布隆过滤器,忽略空值缓存,会导致误判的无效请求,打回 MySQL;只靠空值缓存,无法应对大量无效请求。
1.3.7 缓存击穿(Cache Breakdown)------ 热点数据缓存过期,大量请求打崩 MySQL 怎么办?
缓存击穿,和缓存穿透、缓存雪崩,并称缓存三大异常,它的特点是 "单一热点数据" 缓存过期,导致大量请求瞬间打回 MySQL,MySQL 压力暴增,甚至宕机 ------ 和缓存雪崩的 "大量 Key 同时过期" 不同,缓存击穿是 "单一 Key 过期",但该 Key 是热点数据,请求量极大,危害同样严重
1.3.7.1 什么是缓存击穿?
通俗解释
缓存击穿,是指 "某条热点数据(比如爆款商品、热门新闻,每秒有 1000 次查询)的缓存,突然过期",此时,大量用户查询该热点数据,因为缓存过期,所有请求都会瞬间打回 MySQL,MySQL 瞬间承受巨大压力,甚至被打崩 ------ 就像 "商场里的爆款商品,导购员的小仓库(Redis)里,刚好卖完(缓存过期),瞬间有 1000 个顾客,都要去大仓库(MySQL)找这件商品,大仓库瞬间被挤爆,无法正常运转"。
实战场景
- 电商促销场景:某爆款商品,每秒有 500 次查询,缓存设置 1 小时过期,1 小时后,缓存过期,瞬间有 500 次请求,全部打回 MySQL,MySQL 查询速度变慢,甚至宕机;
- 热门新闻场景:某热点新闻,每秒有 300 次查询,缓存设置 6 小时过期,过期瞬间,300 次请求打回 MySQL,导致 MySQL 压力暴增;
- 缓存冷启动场景:Redis 宕机重启,某热点数据的缓存未恢复,用户大量查询该数据,全部打回 MySQL,引发缓存击穿。
核心特点
- 查询的 Key,是热点数据(请求量极大,每秒几百次、几千次);
- 该 Key 的缓存,突然过期(或 Redis 宕机,缓存丢失);
- 大量请求,瞬间穿透缓存,打回 MySQL;
- 危害:MySQL 压力暴增,查询速度变慢,甚至宕机,影响核心业务。
1.3.7.2 为什么会出现缓存击穿?
- 热点数据,设置了 "固定的过期时间",且未加随机值:比如爆款商品,所有缓存都设置 1 小时过期,过期瞬间,所有请求都打回 MySQL;
- 热点数据,未设置 "缓存预热":Redis 宕机重启后,热点数据的缓存未恢复,用户大量查询,全部打回 MySQL;
- 热点数据,缓存 "被意外淘汰":比如 Redis 内存满了,热点数据因为 "最久未使用"(LRU)或 "访问次数少"(LFU),被意外淘汰,导致大量请求打回 MySQL。
1.3.7.3 缓存击穿的危害
- MySQL 压力暴增:单一热点数据,过期瞬间,大量请求打回 MySQL,MySQL 的 CPU、内存占用率急剧上升,查询速度变慢;
- MySQL 宕机:若请求量过大(比如每秒 1000 次),MySQL 会被瞬间打崩,导致核心业务无法正常运行(比如用户无法查询爆款商品、无法下单);
- 用户体验下降:MySQL 压力大,查询速度慢,用户打开页面,加载时间变长(比如 10 秒以上),甚至加载失败,大量用户流失;
- 缓存失去作用:热点数据缓存过期后,缓存形同虚设,所有请求都打回 MySQL,缓存的价值无法发挥。
1.3.7.4 缓存击穿的 2 个解决方案
方案 1:互斥锁(Mutex Lock)------ 控制查询 MySQL 的请求数,最常用,小白必落地
核心原理(通俗解释)
当热点数据的缓存过期,大量请求同时查询该数据时,通过 "互斥锁",让只有一个请求,能去查询 MySQL,其他请求,要么等待,要么返回缓存中的旧数据(若有);当查询 MySQL 的请求,获取到数据后,写入 Redis 缓存,其他请求,再从 Redis 中查询数据,避免大量请求同时打回 MySQL------ 相当于 "商场里的爆款商品,导购员的小仓库(Redis)卖完了,只有一个导购员,能去大仓库(MySQL)拿货,其他导购员,都在原地等待,拿货回来后,放到小仓库里,其他顾客,再从小仓库里拿货,避免所有顾客,都去大仓库挤"。
关键补充
- 互斥锁的核心:控制查询 MySQL 的请求数,只允许一个请求查询 MySQL,其他请求等待或返回旧数据;
- 锁的实现:用 Redis 的 SETNX 命令(SET if Not Exists),实现简单的互斥锁 ------ 只有当锁不存在时,才能获取锁,获取锁成功,才能查询 MySQL;
- 锁的过期时间:必须设置锁的过期时间(比如 3 秒),避免查询 MySQL 的请求,出现异常(比如网络波动、代码 bug),导致锁一直不释放,其他请求一直等待,引发死锁。
实现步骤
修改业务代码,加入互斥锁逻辑,完整代码如下:
java
@Autowired
private StringRedisTemplate redisTemplate;

// 互斥锁前缀(区分不同的热点数据锁)
private static final String MUTEX_LOCK_PREFIX = "mutex:lock:";
// 锁的过期时间(3秒,避免死锁)
private static final long LOCK_EXPIRE_SECONDS = 3;
// 等待锁的时间(100毫秒,避免无限等待)
private static final long WAIT_LOCK_TIME = 100;

public String getGoodsDetail(Long goodsId) {
    String redisKey = "goods:" + goodsId;
    String goodsDetail;

    // 1. 先查Redis缓存,尝试获取数据
    goodsDetail = redisTemplate.opsForValue().get(redisKey);
    if (goodsDetail != null && !"NULL".equals(goodsDetail)) {
        // 缓存命中,直接返回数据(包括正常数据,不包括空值)
        return goodsDetail;
    }

    // 2. 缓存未命中(或空值),尝试获取互斥锁,控制查询MySQL的请求数
    String lockKey = MUTEX_LOCK_PREFIX + goodsId;
    boolean locked = false;
    try {
        // 2.1 循环获取锁(最多尝试3次,避免无限等待)
        for (int i = 0; i < 3; i++) {
            // 用Redis的SETNX命令,获取互斥锁(SET if Not Exists,原子操作,避免并发问题)
            // 参数:lockKey(锁的Key)、value(任意值)、过期时间、时间单位
            locked = redisTemplate.opsForValue().setIfAbsent(lockKey, "1", LOCK_EXPIRE_SECONDS, TimeUnit.SECONDS);
            if (locked) {
                // 2.2 获取锁成功,只有当前请求,能查询MySQL
                break;
            }
            // 2.3 获取锁失败,等待100毫秒,再尝试获取(避免频繁尝试,消耗资源)
            Thread.sleep(WAIT_LOCK_TIME);
        }

        if (locked) {
            // 3. 获取锁成功,查询MySQL
            goodsDetail = queryGoodsFromMysql(goodsId);

            // 3.1 判断MySQL返回结果
            if (goodsDetail == null || "".equals(goodsDetail.trim())) {
                // 数据不存在,写入空值缓存(5分钟)
                redisTemplate.opsForValue().set(redisKey, "NULL", 300, TimeUnit.SECONDS);
                return "抱歉,该商品不存在或已下架~";
            }

            // 3.2 数据存在,写入Redis缓存(1小时 + 随机60~600秒,避免再次同时过期)
            int randomSeconds = new Random().nextInt(541) + 60;
            long expireSeconds = 3600 + randomSeconds;
            redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);

            // 3.3 返回数据
            return goodsDetail;
        } else {
            // 4. 获取锁失败,返回缓存中的旧数据(若有),或返回友好提示
            // 再次查询Redis,可能已经有其他请求,写入了新数据
            goodsDetail = redisTemplate.opsForValue().get(redisKey);
            if (goodsDetail != null && !"NULL".equals(goodsDetail)) {
                return goodsDetail;
            }
            // 没有旧数据,返回友好提示,避免用户等待过久
            return "服务繁忙,请稍后再试~";
        }
    } catch (InterruptedException e) {
        // 捕获异常,返回友好提示
        e.printStackTrace();
        return "服务繁忙,请稍后再试~";
    } finally {
        // 5. 关键:无论是否获取锁成功,最终都要释放锁(避免死锁)
        // 只有获取锁成功的请求,才需要释放锁(避免释放别人的锁)
        if (locked) {
            redisTemplate.delete(lockKey);
        }
    }
}

// 模拟MySQL查询方法
private String queryGoodsFromMysql(Long goodsId) {
    // 模拟:商品ID≤10000时存在,>10000时不存在
    if (goodsId > 10000) {
        return null;
    }
    // 模拟MySQL查询耗时(比如50毫秒,模拟真实场景)
    try {
        Thread.sleep(50);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
    return "商品ID:" + goodsId + ",名称:爆款手机,价格:1000元,库存:1000台";
}
代码详细说明
- 锁的获取:用 setIfAbsent 方法(SETNX 命令),原子操作,避免并发问题 ------ 只有当 lockKey 不存在时,才能获取锁,确保 "只有一个请求,能获取锁,查询 MySQL";
- 循环获取锁:最多尝试 3 次,每次失败,等待 100 毫秒,避免无限等待,同时减少频繁尝试,消耗 Redis 资源;
- 锁的过期时间:3 秒 ------ 避免查询 MySQL 的请求,出现异常(比如网络波动、代码 bug),导致锁一直不释放,其他请求一直等待,引发死锁;
- 锁的释放:在 finally 块中,只有获取锁成功的请求,才释放锁(delete lockKey),避免释放别人的锁,引发异常;
- 容错处理:获取锁失败后,再次查询 Redis,可能已经有其他请求,写入了
互斥锁的核心优化点
- 锁的原子性:必须用 setIfAbsent 方法(SETNX 命令),不能用 "先查锁是否存在,再设置锁"(比如先 get lockKey,再 set lockKey)------ 因为 "查 + 设" 不是原子操作,并发场景下,会导致多个请求同时获取到锁,失去互斥作用;
-
错误做法:
// 非原子操作,并发场景下会出问题 Boolean lockExists = redisTemplate.hasKey(lockKey); if (!lockExists) { redisTemplate.opsForValue().set(lockKey, "1", LOCK_EXPIRE_SECONDS, TimeUnit.SECONDS); locked = true; } -
正确做法:直接用 setIfAbsent,原子操作,避免并发问题;
-
- 锁的过期时间:必须设置,且时间要 "合理"------ 不能太短(比如 1 秒),否则查询 MySQL 的请求还没完成,锁就过期了,导致其他请求获取到锁,多个请求同时查 MySQL;不能太长(比如 60 秒),否则请求异常时,锁会占用 Redis 资源,且其他请求要等待很久;
- 合理范围:3~5 秒,根据 MySQL 查询耗时调整(比如 MySQL 查询耗时 50 毫秒,3 秒足够完成查询 + 写入缓存 + 释放锁);
- 循环获取锁:最多尝试 3~5 次,每次等待 100~200 毫秒 ------ 避免无限等待,同时减少频繁尝试锁,消耗 Redis 和 CPU 资源;
- 锁的释放:必须放在 finally 块中,且只有 "获取锁成功" 的请求,才释放锁 ------ 避免请求异常时,锁不释放,引发死锁;同时避免释放别人的锁(比如 A 请求获取锁,B 请求没获取到锁,却去删除 A 的锁)。
优点(为什么是首选方案)
- 针对性强:专门解决 "热点数据过期,大量请求打回 MySQL" 的问题,控制查询 MySQL 的请求数,仅允许一个请求查询,彻底避免 MySQL 压力暴增;
- 实现灵活:可根据业务场景,调整锁的过期时间、循环尝试次数、等待时间,适配不同的请求量和 MySQL 查询耗时;
- 资源消耗低:仅在缓存过期时,才会用到互斥锁,正常缓存命中时,不影响接口性能;锁的占用时间短(3~5 秒),不会消耗过多 Redis 资源;
- 适配性广:适合所有 "热点数据" 场景,无论热点数据变化频率高低,都能使用;
- 小白易落地:基于 Redis 的原生命令,不用引入额外组件,修改业务代码即可实现,代码逻辑简单,能直接抄用。
缺点(可解决)
- 存在 "短暂等待":获取锁失败的请求,会等待 100~200 毫秒,再尝试获取锁,可能导致用户接口响应时间变长(比如原本 10 毫秒响应,变成 200 毫秒),但用户可接受;
- 可能出现 "锁失效":如果 MySQL 查询耗时过长(比如超过锁的过期时间 5 秒),锁会过期,导致其他请求获取到锁,多个请求同时查 MySQL------ 解决方案:根据 MySQL 查询耗时,调整锁的过期时间,确保查询 + 写入缓存 + 释放锁,能在锁过期前完成;
- 极端场景下的死锁:虽然设置了锁的过期时间,但若 Redis 宕机,锁的过期时间无法生效,可能导致锁一直存在 ------ 解决方案:结合 Redis 持久化,避免 Redis 宕机后锁丢失;同时定期清理 Redis 中的过期锁(比如用 Redis 的过期键删除策略)。
适用场景
- 所有存在 "热点数据" 的业务(比如电商爆款商品、热门新闻、用户高频访问的接口);
- 热点数据变化频率较高的场景(比如商品库存、热门活动数据,每小时变化一次);
- 对接口响应时间要求不是 "极致严格"(允许 100~200 毫秒的等待)的场景;
- 中小规模、大规模业务,都能适用,是生产环境中最常用的缓存击穿解决方案。
方案 2:热点数据永不过期(兜底方案,适合热点数据变化少的场景)
核心原理
热点数据永不过期,有两种实现方式,核心都是 "避免热点数据的缓存过期",从而避免大量请求打回 MySQL:
- 方式 1:不给热点数据设置过期时间 ------ 让热点数据永久保留在 Redis 中,不会过期,用户查询时,永远命中缓存,不会打回 MySQL;
- 方式 2:给热点数据设置 "逻辑过期时间"(不是 Redis 的过期时间)------Redis 中不设置过期时间,业务代码中,给数据添加一个 "过期时间字段",后台开启定时任务,定期检查热点数据的逻辑过期时间,若已过期,自动查询 MySQL,更新 Redis 中的数据,用户查询时,不会感知到过期,依然命中缓存。
两种方式中,方式 2 更推荐------ 因为方式 1 会导致热点数据永久占用 Redis 内存,且数据变化时无法及时更新;方式 2 既能避免缓存过期,又能保证数据一致性,还能释放内存(非热点数据依然设置过期时间,会被淘汰)。
实现步骤
步骤 1:定义热点数据的存储格式(添加逻辑过期时间字段)
业务代码中,将热点数据和 "逻辑过期时间",封装成一个对象(比如 Java 中的实体类),存入 Redis------Redis 中不设置过期时间,逻辑过期时间由业务代码控制。
// 定义热点商品缓存的实体类(封装商品数据和逻辑过期时间)
@Data
public class HotGoodsCache {
    // 商品详情数据(真实缓存数据)
    private String goodsDetail;
    // 逻辑过期时间(时间戳,单位:毫秒),比如当前时间+1小时
    private Long logicExpireTime;
}
步骤 2:写入热点数据缓存(不设置 Redis 过期时间,只设置逻辑过期时间)
修改业务代码,写入热点数据时,封装成 HotGoodsCache 对象,不设置 Redis 过期时间:
java
@Autowired
private StringRedisTemplate redisTemplate;

// 热点数据的逻辑过期时间(1小时,单位:毫秒)
private static final long LOGIC_EXPIRE_TIME = 3600 * 1000;

// 写入热点商品缓存(不设置Redis过期时间,只设置逻辑过期时间)
public void setHotGoodsCache(Long goodsId, String goodsDetail) {
    // 1. 封装热点数据和逻辑过期时间
    HotGoodsCache hotGoodsCache = new HotGoodsCache();
    hotGoodsCache.setGoodsDetail(goodsDetail);
    // 逻辑过期时间:当前时间 + 1小时(毫秒)
    hotGoodsCache.setLogicExpireTime(System.currentTimeMillis() + LOGIC_EXPIRE_TIME);

    // 2. 写入Redis,不设置过期时间(Redis中永久保留)
    String redisKey = "goods:" + goodsId;
    // 用JSON格式存入Redis(需要导入Jackson依赖,小白可直接导入)
    redisTemplate.opsForValue().set(redisKey, JSON.toJSONString(hotGoodsCache));
}
步骤 3:后台定时任务,定期更新过期的热点数据
开启一个定时任务(比如每 10 分钟执行一次),遍历所有热点数据,检查逻辑过期时间,若已过期,查询 MySQL,更新 Redis 中的数据 ------ 用户查询时,不会感知到更新,依然命中缓存,避免大量请求打回 MySQL。
java
// 定时任务(SpringBoot自带,用@Scheduled注解)
@Component
@EnableScheduling // 开启定时任务支持(必须添加,否则定时任务不执行)
public class HotGoodsRefreshTask {

    @Autowired
    private StringRedisTemplate redisTemplate;

    // 热点数据的Redis Key前缀(比如goods:)
    private static final String GOODS_KEY_PREFIX = "goods:";
    // 逻辑过期时间(1小时,和写入时一致)
    private static final long LOGIC_EXPIRE_TIME = 3600 * 1000;

    // 定时任务:每10分钟执行一次,刷新过期的热点数据
    @Scheduled(cron = "0 0/10 * * * ?") // cron表达式:每10分钟执行一次
    public void refreshHotGoodsCache() {
        // 1. 遍历Redis中所有商品缓存Key(goods:123、goods:456...)
        Set<String> goodsKeys = redisTemplate.keys(GOODS_KEY_PREFIX + "*");
        if (goodsKeys == null || goodsKeys.isEmpty()) {
            return; // 没有商品缓存,直接返回
        }

        // 2. 遍历每个Key,检查逻辑过期时间
        for (String redisKey : goodsKeys) {
            // 2.1 从Redis中获取缓存数据(JSON格式)
            String hotGoodsCacheJson = redisTemplate.opsForValue().get(redisKey);
            if (hotGoodsCacheJson == null || "".equals(hotGoodsCacheJson.trim())) {
                // 缓存数据为空,删除该Key,跳过
                redisTemplate.delete(redisKey);
                continue;
            }

            // 2.2 将JSON转换为HotGoodsCache对象
            HotGoodsCache hotGoodsCache = JSON.parseObject(hotGoodsCacheJson, HotGoodsCache.class);
            if (hotGoodsCache == null) {
                // 转换失败,删除该Key,跳过
                redisTemplate.delete(redisKey);
                continue;
            }

            // 2.3 检查逻辑过期时间(当前时间 > 逻辑过期时间,说明已过期)
            if (System.currentTimeMillis() > hotGoodsCache.getLogicExpireTime()) {
                // 3. 数据已过期,查询MySQL,更新缓存
                // 3.1 从Redis Key中提取商品ID(比如redisKey=goods:123,提取123)
                String goodsIdStr = redisKey.substring(GOODS_KEY_PREFIX.length());
                Long goodsId = Long.parseLong(goodsIdStr);

                // 3.2 查询MySQL中的最新商品数据
                String goodsDetail = queryGoodsFromMysql(goodsId);

                // 3.3 重新封装热点数据,更新Redis(不设置过期时间)
                hotGoodsCache.setGoodsDetail(goodsDetail);
                hotGoodsCache.setLogicExpireTime(System.currentTimeMillis() + LOGIC_EXPIRE_TIME);
                redisTemplate.opsForValue().set(redisKey, JSON.toJSONString(hotGoodsCache));

                // 打印日志,确认更新成功
                System.out.println("热点商品缓存更新成功:商品ID=" + goodsId + ",逻辑过期时间=" + new Date(hotGoodsCache.getLogicExpireTime()));
            }
        }
    }

    // 模拟MySQL查询方法(和前面一致)
    private String queryGoodsFromMysql(Long goodsId) {
        if (goodsId > 10000) {
            return null;
        }
        return "商品ID:" + goodsId + ",名称:爆款手机,价格:1000元,库存:1000台";
    }
}
步骤 4:修改查询方法,适配逻辑过期时间(用户查询时,直接返回缓存数据)
用户查询热点数据时,直接从 Redis 中获取数据,不检查过期时间(过期检查交给定时任务),确保永远命中缓存,不会打回 MySQL:
java
public String getGoodsDetail(Long goodsId) {
    String redisKey = "goods:" + goodsId;

    // 1. 从Redis中获取缓存数据(JSON格式)
    String hotGoodsCacheJson = redisTemplate.opsForValue().get(redisKey);
    if (hotGoodsCacheJson == null || "".equals(hotGoodsCacheJson.trim())) {
        // 缓存未命中(非热点数据,或缓存被淘汰),走正常流程(查MySQL→写缓存)
        return getGoodsDetailNormal(goodsId);
    }

    // 2. 缓存命中,转换为HotGoodsCache对象
    HotGoodsCache hotGoodsCache = JSON.parseObject(hotGoodsCacheJson, HotGoodsCache.class);

    // 3. 直接返回商品详情,不检查逻辑过期时间(过期更新交给定时任务)
    return hotGoodsCache.getGoodsDetail();
}

// 非热点数据的正常查询流程(和前面一致,设置过期时间)
private String getGoodsDetailNormal(Long goodsId) {
    String redisKey = "goods:" + goodsId;
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);

    if (goodsDetail != null) {
        if ("NULL".equals(goodsDetail)) {
            return "抱歉,该商品不存在或已下架~";
        }
        return goodsDetail;
    }

    // 查MySQL
    goodsDetail = queryGoodsFromMysql(goodsId);
    if (goodsDetail == null || "".equals(goodsDetail.trim())) {
        redisTemplate.opsForValue().set(redisKey, "NULL", 300, TimeUnit.SECONDS);
        return "抱歉,该商品不存在或已下架~";
    }

    // 写入缓存,设置过期时间(1小时 + 随机值)
    int randomSeconds = new Random().nextInt(541) + 60;
    long expireSeconds = 3600 + randomSeconds;
    redisTemplate.opsForValue().set(redisKey, goodsDetail, expireSeconds, TimeUnit.SECONDS);

    return goodsDetail;
}
步骤 5:区分热点数据和非热点数据(关键,避免内存膨胀)
- 热点数据:用 "逻辑过期时间",不设置 Redis 过期时间,后台定时任务更新;
- 非热点数据:用 "正常过期时间"(1 小时 + 随机值),设置 Redis 过期时间,会被淘汰;
- 区分方式:根据业务日志,统计访问频率(比如每秒访问≥100 次的,视为热点数据),手动或自动将热点数据,加入定时任务的刷新列表中;
- 实战优化:定时任务,只遍历 "热点数据列表",不遍历所有商品缓存 Key------ 避免遍历所有 Key,消耗 Redis 资源(比如热点数据只有 100 个,遍历 100 个 Key,比遍历 10000 个 Key,效率高 100 倍)。
方式 1(不设置过期时间)的简单实现
-
核心逻辑:不给热点数据设置任何过期时间,永久保留在 Redis 中;
-
实现代码:
// 写入热点数据,不设置过期时间 public void setHotGoodsCacheNoExpire(Long goodsId, String goodsDetail) { String redisKey = "goods:" + goodsId; redisTemplate.opsForValue().set(redisKey, goodsDetail); // 不设置过期时间,永久保留 } // 查询热点数据,直接返回 public String getHotGoodsDetail(Long goodsId) { String redisKey = "goods:" + goodsId; String goodsDetail = redisTemplate.opsForValue().get(redisKey); return goodsDetail; } -
缺点(不推荐的原因):
- 内存膨胀:热点数据永久占用 Redis 内存,随着热点数据增多,Redis 内存会被占满,新数据无法写入;
- 数据不一致:MySQL 中的热点数据变化后(比如商品价格修改),Redis 中的数据不会自动更新,用户会长期看到旧数据;
- 维护复杂:需要手动删除 / 更新 Redis 中的热点数据,增加运维成本。
优点(方式 2:逻辑过期时间)
- 彻底避免缓存击穿:热点数据永不过期(Redis 中不设置过期时间),用户查询时,永远命中缓存,不会打回 MySQL,MySQL 压力为 0;
- 保证数据一致性:后台定时任务,定期更新过期的热点数据,确保用户查询到的是最新数据;
- 避免内存膨胀:非热点数据依然设置过期时间,会被淘汰,只有热点数据永久保留在 Redis 中,占用内存少;
- 接口响应快:用户查询时,直接命中缓存,无需等待锁,响应时间极短(比如 10 毫秒以内),提升用户体验;
- 无死锁风险:不需要互斥锁,避免了互斥锁带来的死锁、等待时间等问题。
缺点(方式 2:逻辑过期时间)
- 实现略复杂:需要封装逻辑过期时间对象、编写定时任务、区分热点和非热点数据,比互斥锁复杂;
- 定时任务的开销:定时任务需要遍历热点数据,检查逻辑过期时间,会消耗少量 Redis 和 CPU 资源;
- 数据可能有 "短暂不一致":定时任务每 10 分钟执行一次,若热点数据在两次定时任务之间变化(比如商品价格修改),用户会看到短暂的旧数据 ------ 但可接受(比如价格修改后,最多 10 分钟,用户就能看到新价格);
- 热点数据筛选不精准:若筛选的热点数据,不是当前真正的热点数据,会导致 Redis 内存浪费(非热点数据被当作热点数据,永久保留)。
适用场景(兜底方案,补充互斥锁)
- 热点数据变化频率低的场景(比如热门新闻、爆款商品详情,每天变化 1~2 次);
- 对接口响应时间要求 "极致严格"(不允许 100~200 毫秒等待)的场景(比如高频交易接口、首页热点商品接口);
- 热点数据数量少的场景(比如只有 100 个热点商品,不会导致 Redis 内存膨胀);
- 推荐搭配:互斥锁(核心热点数据,变化频繁)+ 逻辑过期时间(非核心热点数据,变化少),兼顾性能和数据一致性。
1.3.7.5 缓存击穿解决方案总结
解决方案对比
| 解决方案 | 核心逻辑 | 实现难度 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|---|
| 互斥锁(首选) | 缓存过期时,仅允许一个请求查 MySQL,其他请求等待 / 返回旧数据 | 中 | 针对性强、适配广、资源消耗低、小白易落地 | 存在短暂等待、可能锁失效 | 所有热点数据场景,尤其是变化频繁的热点数据 |
| 逻辑过期时间(兜底) | 热点数据 Redis 永不过期,后台定时任务更新数据 | 中高 | 响应快、无 MySQL 压力、无死锁 | 实现复杂、定时任务有开销、短暂数据不一致 | 热点数据变化少、对响应时间要求极高的场景 |
| 不设置过期时间(不推荐) | 热点数据永久保留在 Redis,不设置过期时间 | 低 | 实现最简单、响应快 | 内存膨胀、数据不一致、维护复杂 | 临时测试、热点数据极少且永不变化的场景 |
落地优先级
- 优先实现 "互斥锁":适配所有热点数据场景,实现简单,能解决 90% 的缓存击穿问题;
- 对 "响应时间要求极高" 的接口,补充 "逻辑过期时间":比如首页热点商品接口,用逻辑过期时间,确保响应速度;
- 辅助优化:
- 热点数据设置 "缓存预热":Redis 宕机重启后,提前将热点数据写入 Redis,避免冷启动引发的缓存击穿;
- 热点数据过期时间 "加随机值":避免多个热点数据同时过期,引发多个缓存击穿;
- 合理设置 Redis 淘汰策略:优先选 allkeys-lru,避免热点数据被意外淘汰。
避坑点
- 互斥锁必须保证 "原子性":用 setIfAbsent 方法,不能用 "查 + 设" 的非原子操作,否则会失去互斥作用;
- 互斥锁必须设置 "过期时间":避免请求异常时,锁不释放,引发死锁;
- 逻辑过期时间,必须 "区分热点和非热点数据":否则会导致 Redis 内存膨胀,新数据无法写入;
- 定时任务,不要遍历 "所有缓存 Key":只遍历热点数据列表,减少 Redis 资源消耗;
- 不要单独依赖 "不设置过期时间":除非热点数据永不变化,否则会导致数据不一致和内存膨胀;
- 热点数据,必须设置 "缓存预热":避免 Redis 宕机重启后,热点数据缓存为空,引发缓存击穿。
1.3.8 缓存雪崩(Cache Avalanche)------ 大量缓存同时过期,MySQL 被打崩怎么办?
缓存雪崩,是缓存三大异常中,危害最严重的一个 ------ 大量缓存 Key 同时过期,或 Redis 宕机,导致所有查询请求,瞬间打回 MySQL,MySQL 被瞬间打崩,整个业务陷入瘫痪
1.3.8.1 什么是缓存雪崩?
通俗解释
缓存雪崩,是指 "大量缓存 Key,在同一时间同时过期",或 "Redis 宕机,所有缓存数据全部丢失",此时,大量用户的查询请求,会瞬间穿透缓存,全部打回 MySQL,MySQL 瞬间承受海量请求,无法处理,最终被打崩,整个业务无法正常运行 ------ 就像 "商场里的所有商品,导购员的小仓库(Redis)里,同时卖完(大量 Key 同时过期),瞬间有 10000 个顾客,都要去大仓库(MySQL)找商品,大仓库瞬间被挤爆,彻底无法运转,整个商场陷入瘫痪"。
实战场景
- 电商大促场景:双 11、618 期间,提前将 10000 个商品缓存,全部设置 1 小时过期时间(比如 0 点开始缓存,1 点同时过期),1 点时,10000 个商品缓存同时过期,每秒有 10000 次查询请求,全部打回 MySQL,MySQL 瞬间宕机,用户无法查询商品、无法下单,业务直接瘫痪;
- 缓存批量更新场景:后台批量更新 1000 个商品数据,删除所有商品缓存后,重新批量写入缓存,且全部设置相同的过期时间(比如 2 小时),2 小时后,这 1000 个商品缓存同时过期,大量请求打回 MySQL;
- Redis 宕机场景:Redis 服务器断电、故障,所有缓存数据全部丢失,用户所有查询请求,都要打回 MySQL,MySQL 无法承受海量请求,瞬间宕机;
- 冷启动场景:Redis 宕机重启后,缓存为空(未开启持久化、未做缓存预热),大量用户同时访问,所有请求打回 MySQL,引发缓存雪崩。
核心特点
- 大量缓存 Key,同时过期;或 Redis 宕机,缓存全部丢失;
- 海量查询请求,瞬间穿透缓存,全部打回 MySQL;
- 危害极大:MySQL 瞬间宕机,整个业务陷入瘫痪,造成巨大的经济损失(比如电商大促期间,每分钟损失几十万);
- 易引发连锁反应:MySQL 宕机后,依赖 MySQL 的其他服务(比如订单服务、支付服务),也会相继宕机,形成连锁反应。
1.3.8.2 为什么会出现缓存雪崩?
- 大量缓存 Key,设置 "固定的过期时间",且未加随机值:这是最常见的原因 ------ 比如批量写入 10000 个商品缓存,全部设置 1 小时过期时间,导致所有 Key 在同一时间同时过期;
- 缓存批量更新 / 删除后,重新写入时,设置相同的过期时间:比如批量删除商品缓存后,重新写入,全部设置 2 小时过期时间,2 小时后同时过期;
- Redis 宕机,缓存全部丢失:Redis 服务器故障、断电、网络中断,导致所有缓存数据丢失,且未开启持久化、未做故障转移,无法恢复缓存;
- 缓存冷启动,未做缓存预热:Redis 宕机重启后,缓存为空,且未做缓存预热,大量用户同时访问,所有请求打回 MySQL。
1.3.8.3 缓存雪崩的危害
- MySQL 瞬间宕机:海量请求同时打回 MySQL,MySQL 的 CPU、内存占用率瞬间拉满,无法处理请求,最终宕机;
- 整个业务瘫痪:MySQL 宕机后,所有依赖 MySQL 的服务(商品查询、用户登录、订单下单、支付),都无法正常运行,整个业务陷入瘫痪;
- 巨大的经济损失:尤其是电商、金融等业务,大促期间,业务瘫痪 1 分钟,可能损失几十万、几百万,甚至更多;
- 用户大量流失:用户无法访问服务、无法下单,会直接离开,转向竞争对手,导致用户流失,影响品牌口碑;
- 连锁反应:一个服务宕机,会引发其他依赖该服务的服务宕机(比如商品服务宕机→订单服务宕机→支付服务宕机),形成 "雪崩效应",恢复难度极大。
1.3.8.4 缓存雪崩的 5 个解决方案
缓存雪崩的防护,核心是 "避免大量 Key 同时过期" 和 "避免 Redis 宕机后缓存全部丢失",我们按 "基础防护→核心防护→兜底防护" 的顺序,拆解 5 个解决方案,小白必须全部落地,层层防护,彻底规避缓存雪崩风险。
方案 1:给缓存 Key 的过期时间,添加随机值
核心原理(通俗解释)
这是最基础、最简单、零成本的解决方案 ------ 给每个缓存 Key 的过期时间,加上一个 "随机值"(比如 1 小时 ±10 分钟、1 小时 ±60 秒),让原本 "同时过期的大量 Key",过期时间分散在不同的时间点,避免同时过期,从而避免大量请求同时打回 MySQL------ 相当于 "商场里的商品,导购员给每个商品,设置不同的补货时间(过期时间),原本 1 点同时卖完的商品,现在分散在 1 点 01 分~1 点 10 分之间卖完,每个时间点只有少量商品卖完,顾客不会同时去大仓库拿货,大仓库压力很小"。
实现步骤
修改之前的 "写入缓存" 代码,给过期时间加上随机值,无论是正常缓存、热点数据缓存,都必须加 ------ 这是所有业务的 "基础防护,必做"。
实战代码示例
java
@Autowired
private StringRedisTemplate redisTemplate;

// 基础过期时间(根据业务场景调整,比如1小时)
private static final long BASE_EXPIRE_SECONDS = 3600;
// 随机值范围(60~600秒,1~10分钟,可调整)
private static final int RANDOM_MIN_SECONDS = 60;
private static final int RANDOM_MAX_SECONDS = 600;

// 写入缓存,添加随机值,避免同时过期(必做)
public void setCache(String key, String value) {
    // 1. 生成随机值(60~600秒)
    // nextInt(RANDOM_MAX_SECONDS - RANDOM_MIN_SECONDS + 1):生成0~541的随机数,加上60,范围是60~600
    int randomSeconds = new Random().nextInt(RANDOM_MAX_SECONDS - RANDOM_MIN_SECONDS + 1) + RANDOM_MIN_SECONDS;
    // 2. 计算总过期时间(基础时间 + 随机值)
    long expireSeconds = BASE_EXPIRE_SECONDS + randomSeconds;
    // 3. 写入Redis,设置过期时间
    redisTemplate.opsForValue().set(key, value, expireSeconds, TimeUnit.SECONDS);
}

// 商品详情查询,调用上面的setCache方法,写入缓存(必做)
public String getGoodsDetail(Long goodsId) {
    String redisKey = "goods:" + goodsId;
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);

    if (goodsDetail != null) {
        if ("NULL".equals(goodsDetail)) {
            return "抱歉,该商品不存在或已下架~";
        }
        return goodsDetail;
    }

    // 查MySQL
    goodsDetail = queryGoodsFromMysql(goodsId);
    if (goodsDetail == null || "".equals(goodsDetail.trim())) {
        // 空值缓存,也需要加随机值(虽然空值影响小,但也要避免同时过期)
        setCache(redisKey, "NULL");
        return "抱歉,该商品不存在或已下架~";
    }

    // 正常缓存,加随机值
    setCache(redisKey, goodsDetail);
    return goodsDetail;
}

// 模拟MySQL查询方法
private String queryGoodsFromMysql(Long goodsId) {
    if (goodsId > 10000) {
        return null;
    }
    return "商品ID:" + goodsId + ",名称:爆款手机,价格:1000元,库存:1000台";
}
核心优化点
- 随机值范围:根据基础过期时间调整,基础时间越长,随机值范围越大;
- 基础时间 1 小时(3600 秒):随机值 60~600 秒(1~10 分钟),合理;
- 基础时间 10 分钟(600 秒):随机值 10~30 秒,合理(不要太大,否则影响缓存命中率);
- 基础时间 5 分钟(300 秒):随机值 5~15 秒,合理;
- 所有缓存 Key,都必须加随机值:包括正常缓存、空值缓存、热点数据缓存(逻辑过期时间除外)------ 不要遗漏任何一个缓存 Key,否则遗漏的 Key 可能同时过期,引发局部缓存雪崩;
- 批量写入缓存时,必须加随机值:比如批量写入 1000 个商品缓存,不能设置相同的过期时间,必须每个 Key 都加随机值,分散过期时间;
- 避免随机值重复:不用刻意避免,因为随机值范围足够大,重复的概率极低,即使有少量重复,也不会引发缓存雪崩(比如 10000 个 Key,有 10 个同时过期,请求量少,MySQL 能处理)。
优点(零成本,必做)
- 实现最简单:只需修改写入缓存的代码,添加随机值逻辑,小白能直接落地,零成本;
- 效果显著:能彻底避免 "大量 Key 同时过期" 的问题,是缓存雪崩的 "第一道基础防线";
- 无副作用:不影响接口响应时间,不消耗额外资源,不导致数据不一致;
- 适配性广:所有业务、所有缓存 Key,都能使用,没有场景限制。
缺点(无明显缺点,仅需注意随机值范围)
- 唯一需要注意的是 "随机值范围不要太小":比如基础时间 1 小时,随机值仅 1~10 秒,过期时间依然比较集中,可能引发局部缓存雪崩;只要随机值范围合理(1~10 分钟),就能避免。
适用场景(所有业务,必做,基础防护)
- 所有业务的 "第一道基础防线",无论什么业务,只要用了缓存,就必须给过期时间加随机值;
- 尤其适合 "批量写入缓存" 的场景(比如电商大促、批量更新商品),能有效分散过期时间。
方案 2:热点数据永不过期(核心防护,补充方案 1)
核心原理
结合前面 "缓存击穿" 的解决方案,热点数据(请求量极大的 Key),采用 "逻辑过期时间" 或 "互斥锁",让热点数据永不过期(或过期时,仅允许一个请求查 MySQL)------ 即使大量非热点数据同时过期,热点数据依然能命中缓存,避免大量热点请求打回 MySQL,从而减轻 MySQL 的压力,避免缓存雪崩 ------ 相当于 "商场里的爆款商品(热点数据),导购员的小仓库里,永远有货(永不过期),即使其他商品同时卖完,顾客也不会都去大仓库,大仓库压力大大减轻"。
实现步骤
- 筛选热点数据:根据业务日志,统计访问频率(比如每秒访问≥100 次的 Key),筛选出热点数据(比如爆款商品、热门新闻);
- 热点数据处理:
- 方式 1:逻辑过期时间(推荐):Redis 中不设置过期时间,后台定时任务定期更新数据,用户查询时,永远命中缓存(复用前面缓存击穿方案 2 的代码);
- 方式 2:互斥锁:设置过期时间(加随机值),过期时,仅允许一个请求查 MySQL,其他请求等待(复用前面缓存击穿方案 1 的代码);
- 非热点数据处理:采用方案 1,给过期时间加随机值,分散过期时间;
- 定期更新热点数据列表:根据实时访问日志,每天更新一次热点数据列表,确保热点数据的准确性,避免非热点数据被当作热点数据,浪费 Redis 资源。
实战代码复用
- 逻辑过期时间的代码:复用 "缓存击穿→方案 2→方式 2" 的代码(封装 HotGoodsCache 对象、定时任务更新);
- 互斥锁的代码:复用 "缓存击穿→方案 1" 的代码(setIfAbsent 获取锁、循环尝试、释放锁);
- 核心优化:热点数据和非热点数据,分开处理,热点数据永不过期,非热点数据加随机值。
优点(核心防护,补充方案 1)
- 针对性强:专门保护热点数据,避免大量热点请求打回 MySQL,减轻 MySQL 压力;
- 复用性强:直接复用缓存击穿的解决方案,无需重新开发,节省成本;
- 双重防护:方案 1(随机值)+ 方案 2(热点永不过期),双重保障,彻底避免缓存雪崩;
- 提升用户体验:热点数据永不过期,用户查询时,永远命中缓存,响应速度快。
缺点(和缓存击穿的方案一致,可解决)
- 逻辑过期时间:实现略复杂,需要定时任务、区分热点和非热点数据;
- 互斥锁:存在短暂等待时间,可能锁失效,但可通过优化锁的过期时间、原子性,避免。
适用场景(所有有热点数据的业务,核心防护)
- 有热点数据的业务(比如电商、短视频、新闻);
- 大促场景(双 11、618),热点数据请求量极大,必须重点保护;
- 作为方案 1 的补充,形成双重防护,彻底规避缓存雪崩。
方案 3:开启 Redis 持久化 + 故障转移(核心防护,避免 Redis 宕机引发雪崩)
核心原理
前面的方案 1、2,都是解决 "大量 Key 同时过期" 的问题;而方案 3,是解决 "Redis 宕机,缓存全部丢失" 的问题 ------ 通过 "Redis 持久化",将内存中的缓存数据,定期写入硬盘,Redis 宕机重启后,能从硬盘恢复缓存数据;通过 "Redis 故障转移"(主从复制 + 哨兵模式),当主 Redis 宕机时,哨兵自动将从 Redis 切换为主 Redis,继续提供缓存服务,避免 Redis 宕机后,缓存全部丢失,从而避免缓存雪崩 ------ 相当于 "商场里的导购员(主 Redis),每天晚上把小仓库的商品,备份到临时仓库(硬盘,持久化),同时安排备用导购员(从 Redis),如果主导购员有事请假(宕机),备用导购员立即上岗(故障转移),小仓库依然有货,顾客不用去大仓库,大仓库压力为 0"。
实现步骤
步骤 1:开启 Redis 持久化(RDB+AOF 混合持久化,推荐)
和前面 "缓存冷启动" 方案 2 的持久化配置一致,小白直接修改 Redis 配置文件即可,无需额外开发,详细配置如下(复制到 redis.conf 中):
# Redis配置文件redis.conf(持久化配置,必做)
# 一、RDB持久化配置(定期快照,适合备份)
# 开启RDB持久化(默认开启,无需修改)
# 快照触发时机:3个条件,满足一个即触发,写入硬盘
save 900 1    # 900秒(15分钟)内,有1个Key被修改,触发快照
save 300 10   # 300秒(5分钟)内,有10个Key被修改,触发快照
save 60 10000 # 60秒(1分钟)内,有10000个Key被修改,触发快照
# RDB文件保存路径(默认当前目录,可修改为自定义路径,方便备份)
dir /var/lib/redis
# RDB文件名(默认dump.rdb)
dbfilename dump.rdb
# 开启RDB压缩(默认开启,节省硬盘空间,轻微影响性能,可接受)
rdbcompression yes

# 二、AOF持久化配置(实时日志,适合恢复数据)
# 开启AOF持久化(默认关闭,必须开启)
appendonly yes
# AOF文件保存路径(和RDB相同,可共用)
dir /var/lib/redis
# AOF文件名(默认appendonly.aof)
appendfilename appendonly.aof
# AOF同步策略(推荐everysec,兼顾性能和数据安全)
appendfsync everysec # 每秒同步一次,将内存中的日志写入硬盘
# 禁止AOF重写时,停止同步(默认no,避免数据丢失)
no-appendfsync-on-rewrite no
# AOF重写配置(避免AOF文件过大,自动压缩)
auto-aof-rewrite-percentage 100 # AOF文件大小达到上次重写后的100%,触发重写
auto-aof-rewrite-min-size 64mb  # AOF文件最小达到64MB,才触发重写

# 三、混合持久化配置(Redis 4.0+支持,推荐,兼顾RDB和AOF的优点)
# 开启混合持久化(默认开启,Redis 4.0+)
aof-use-rdb-preamble yes
持久化配置说明
- 混合持久化的优点:结合 RDB 和 AOF 的优点 ------RDB 恢复速度快,AOF 数据完整;Redis 宕机重启后,优先从 AOF 文件恢复数据(数据更完整),如果 AOF 文件不存在,再从 RDB 文件恢复;
- 数据安全:appendfsync everysec(每秒同步)------ 最多丢失 1 秒的数据,能满足 99% 的业务需求;如果是金融等对数据安全要求极高的业务,可设置为 appendfsync always(每次写入都同步),但会影响 Redis 性能;
- 定期备份:必须定期备份 RDB 和 AOF 文件(比如每天凌晨 2 点,自动备份到其他服务器)------ 避免硬盘损坏,导致持久化文件丢失,无法恢复数据;
- 重启验证:配置完成后,重启 Redis,执行 "config get appendonly" 和 "config get aof-use-rdb-preamble",确认 AOF 和混合持久化已开启。
步骤 2:部署 Redis 主从复制 + 哨兵模式(故障转移,避免 Redis 宕机)
Redis 主从复制 + 哨兵模式,是生产环境中最常用的 Redis 高可用方案 ------1 个主 Redis(负责写入、查询),2 个从 Redis(负责同步主 Redis 的数据,备用),3 个哨兵(负责监控主从 Redis,主 Redis 宕机时,自动切换从 Redis 为主 Redis),实现故障转移,避免 Redis 宕机后,缓存全部丢失。
部署步骤
准备工作
- 服务器:3 台服务器(或 1 台服务器,用不同端口模拟,小白推荐用不同端口,简单);
- Redis 版本:Redis 6.2.6(稳定版,推荐);
- 端口规划:
- 主 Redis:6379 端口(负责写入、查询);
- 从 Redis1:6380 端口(同步主 Redis 数据,备用);
- 从 Redis2:6381 端口(同步主 Redis 数据,备用);
- 哨兵 1:26379 端口(监控主从 Redis);
- 哨兵 2:26380 端口(监控主从 Redis);
- 哨兵 3:26381 端口(监控主从 Redis)。
第一步:部署主 Redis(6379 端口)
-
安装 Redis(略,小白可参考 Redis 官方文档,简单);
-
复制 Redis 配置文件,修改为主体配置(redis-6379.conf):
# 端口 port 6379 # 绑定IP(允许所有IP访问,小白推荐,生产环境可绑定具体IP) bind 0.0.0.0 # 后台运行 daemonize yes # 持久化配置(复制前面的持久化配置,AOF+RDB混合) appendonly yes aof-use-rdb-preamble yes # 其他配置默认即可 -
启动主 Redis:
redis-server /etc/redis/redis-6379.conf -
验证主 Redis:
redis-cli -p 6379
127.0.0.1:6379> info replication
# Replication
role:master # 角色是主Redis,正确
connected_slaves:0 # 目前没有从Redis,正确
第二步:部署从 Redis(6380、6381 端口,两台,备用)
以 6380 端口的从 Redis 为例,6381 端口的配置完全一致,只需修改端口:
-
复制 Redis 配置文件,修改为从 Redis 配置(redis-6380.conf):
# 端口 port 6380 # 绑定IP bind 0.0.0.0 # 后台运行 daemonize yes # 持久化配置(和主Redis一致) appendonly yes aof-use-rdb-preamble yes # 核心:设置主Redis的IP和端口,同步主Redis的数据 slaveof 127.0.0.1 6379 # 主Redis有密码的话,添加密码(没有密码,可省略) # masterauth 123456 # 其他配置默认即可 -
启动从 Redis(6380、6381):
redis-server /etc/redis/redis-6380.conf redis-server /etc/redis/redis-6381.conf -
验证从 Redis:
# 登录主Redis,查看从Redis连接情况 redis-cli -p 6379 127.0.0.1:6379> info replication # Replication role:master connected_slaves:2 # 有2个从Redis,正确 slave0:ip=127.0.0.1,port=6380,state=online # 6380端口从Redis,在线 slave1:ip=127.0.0.1,port=6381,state=online # 6381端口从Redis,在线- 说明:从 Redis 启动后,会自动同步主 Redis 的数据,主 Redis 写入数据,从 Redis 会立即同步,确保数据一致。
第三步:部署哨兵(26379、26380、26381 端口,三台,监控主从)
哨兵的核心作用:监控主从 Redis 的状态,主 Redis 宕机时,自动从两个从 Redis 中,选择一个作为新的主 Redis,实现故障转移,避免 Redis 宕机。
-
复制 Redis 配置文件,修改为哨兵配置(sentinel-26379.conf):
# 端口 port 26379 # 后台运行 daemonize yes # 绑定IP bind 0.0.0.0 # 核心:监控主Redis,参数说明: # mymaster:哨兵监控的主Redis名称(自定义,比如mymaster) # 127.0.0.1 6379:主Redis的IP和端口 # 2:哨兵集群中,至少有2个哨兵,认为主Redis宕机,才会触发故障转移(3个哨兵,设置2,合理) sentinel monitor mymaster 127.0.0.1 6379 2 # 主Redis有密码的话,添加密码(没有密码,可省略) # sentinel auth-pass mymaster 123456 # 主Redis宕机后,哨兵等待多久,才认为主Redis真的宕机(默认3000毫秒,3秒,合理) sentinel down-after-milliseconds mymaster 3000 # 故障转移时,最多有多少个从Redis,同时同步新的主Redis(默认1,合理,避免同步压力) sentinel parallel-syncs mymaster 1 # 故障转移的超时时间(默认180000毫秒,3分钟,合理) sentinel failover-timeout mymaster 180000 -
复制 sentinel-26379.conf,修改为 sentinel-26380.conf、sentinel-26381.conf,只需修改端口(26380、26381),其他配置完全一致;
-
启动哨兵(三台):
redis-sentinel /etc/redis/sentinel-26379.conf redis-sentinel /etc/redis/sentinel-26380.conf redis-sentinel /etc/redis/sentinel-26381.conf -
验证哨兵:
# 登录任意一个哨兵,查看监控状态
redis-cli -p 26379
127.0.0.1:26379> sentinel master mymaster
# 会输出主Redis的状态,包括IP、端口、从Redis数量、哨兵数量,确认正常即可
127.0.0.1:26379> sentinel slaves mymaster
# 会输出两个从Redis的状态,确认正常即可
故障转移验证
-
停止主 Redis(6379 端口):
redis-cli -p 6379 shutdown -
等待 3 秒(sentinel down-after-milliseconds 设置的 3 秒),查看哨兵日志,或登录哨兵,查看新的主 Redis:
redis-cli -p 26379 127.0.0.1:26379> sentinel master mymaster # 会发现,主Redis已经切换为6380或6381端口的从Redis,故障转移成功 -
启动原来的主 Redis(6379 端口):
redis-server /etc/redis/redis-6379.conf -
查看状态:原来的主 Redis(6379),会自动成为新主 Redis(比如 6380)的从 Redis,同步新主 Redis 的数据,整个集群恢复正常。
优点(核心防护,避免 Redis 宕机引发雪崩)
- 高可用:主 Redis 宕机时,哨兵自动切换从 Redis 为主 Redis,实现故障转移,Redis 服务不中断,缓存数据不丢失;
- 数据安全:持久化 + 主从复制,双重保障,Redis 宕机后,能从硬盘恢复数据,从 Redis 也能同步主 Redis 的数据,避免数据丢失;
- 稳定性强:生产环境中最常用的高可用方案,经过大量实践验证,稳定性强,小白能部署;
- 减轻 MySQL 压力:即使 Redis 短暂宕机,重启后能快速恢复缓存数据,避免大量请求打回 MySQL,彻底避免 Redis 宕机引发的缓存雪崩。
缺点(部署略复杂,需要维护)
- 部署和维护略复杂:需要部署主从 Redis 和哨兵,小白需要花时间学习部署步骤;
- 占用少量服务器资源:主从 Redis + 哨兵,需要占用 3 台服务器(或 1 台服务器的多个端口),但对于生产环境,是必要的投入;
- 同步延迟:主 Redis 写入数据,从 Redis 同步数据,会有轻微的延迟(毫秒级),但不会导致数据不一致,可接受。
适用场景(所有生产环境业务,核心防护)
- 所有生产环境业务,尤其是 "对稳定性要求高" 的业务(电商、金融、支付);
- 缓存数据量大、请求量高的业务,必须部署主从 + 哨兵,避免 Redis 宕机引发雪崩;
- 推荐搭配:方案 1(随机值)+ 方案 2(热点永不过期)+ 方案 3(主从 + 哨兵 + 持久化),三重防护,彻底规避缓存雪崩。
方案 4.1 请求限流(控制打向 MySQL 的请求数,核心)
核心原理(通俗解释)
缓存雪崩发生时,所有缓存都未命中,大量请求会瞬间打向 MySQL------ 请求限流的核心,是 "设置全局限流阈值"(比如每秒最多允许 100 个请求打向 MySQL),超过阈值的请求,直接返回 "服务繁忙",不允许访问 MySQL,从而控制 MySQL 的请求压力,避免 MySQL 被打崩。
和缓存穿透的 "单一 IP 限流" 不同,缓存雪崩的限流是 "全局限流"(控制所有请求,而非单一 IP),核心目标是 "保护 MySQL",无论请求来自哪个 IP,只要超过阈值,就拦截,优先保证 MySQL 能处理有限的请求,不被压垮。
实现步骤
步骤 1:定义全局限流配置
@Autowired
private StringRedisTemplate redisTemplate;

// 全局限流Key(缓存雪崩时,控制打向MySQL的请求数)
private static final String GLOBAL_LIMIT_KEY = "cache:avalanche:global:limit";
// 限流阈值:每秒最多允许100个请求打向MySQL(根据MySQL承载能力调整)
private static final int GLOBAL_LIMIT_THRESHOLD = 100;
// 限流时间窗口:1秒(1000毫秒),和阈值对应,每秒重置一次
private static final long LIMIT_WINDOW_MILLIS = 1000;
步骤 2:实现全局限流逻辑(原子操作,避免并发问题)
用 Redis 的 incr 命令,统计 1 秒内打向 MySQL 的请求数,超过阈值则拦截,核心是 "原子性统计",避免并发场景下,统计数不准,导致限流失效。
// 全局限流方法:判断当前请求,是否允许打向MySQL
private boolean isAllowAccessMysql() {
    try {
        // 1. 生成限流Key(加上时间戳,每1秒一个Key,实现1秒窗口限流)
        // 时间戳取整:当前时间戳 / 1000,得到每秒的唯一标识(比如1699999999)
        long timeWindow = System.currentTimeMillis() / LIMIT_WINDOW_MILLIS;
        String limitKey = GLOBAL_LIMIT_KEY + ":" + timeWindow;

        // 2. 原子递增,统计当前秒的请求数(incr是原子操作,避免并发统计不准)
        Long currentCount = redisTemplate.opsForValue().increment(limitKey, 1);

        // 3. 第一次统计,设置Key的过期时间(2秒,确保超过时间窗口后,Key被删除,不占用内存)
        if (currentCount != null && currentCount == 1) {
            redisTemplate.expire(limitKey, 2, TimeUnit.SECONDS);
        }

        // 4. 判断请求数是否超过阈值(≤100,允许访问;>100,拦截)
        return currentCount != null && currentCount <= GLOBAL_LIMIT_THRESHOLD;
    } catch (Exception e) {
        // 异常处理:Redis宕机时,默认允许访问(避免限流逻辑失效,导致核心接口无法访问)
        // 注意:Redis宕机时,缓存也失效,此时允许访问,但MySQL压力会增大,需配合服务降级
        e.printStackTrace();
        return true;
    }
}
步骤 3:修改查询逻辑,加入全局限流(所有查 MySQL 的请求,都要经过限流)
public String getGoodsDetail(Long goodsId) {
    String redisKey = "goods:" + goodsId;
    String goodsDetail = redisTemplate.opsForValue().get(redisKey);

    // 缓存命中,直接返回(正常流程)
    if (goodsDetail != null) {
        if ("NULL".equals(goodsDetail)) {
            return "抱歉,该商品不存在或已下架~";
        }
        return goodsDetail;
    }

    // 缓存未命中,先经过全局限流(核心:控制打向MySQL的请求数)
    if (!isAllowAccessMysql()) {
        // 限流触发,返回服务繁忙,不访问MySQL
        return "服务繁忙,请稍后再试(缓存恢复中)~";
    }

    // 限流通过,查询MySQL(后续流程和前面一致)
    goodsDetail = queryGoodsFromMysql(goodsId);
    if (goodsDetail == null || "".equals(goodsDetail.trim())) {
        setCache(redisKey, "NULL"); // 空值缓存,加随机值
        return "抱歉,该商品不存在或已下架~";
    }

    setCache(redisKey, goodsDetail); // 正常缓存,加随机值
    return goodsDetail;
}
步骤 4:限流阈值调整
限流阈值,必须根据 MySQL 的 "实际承载能力" 调整,不能凭感觉设置,具体方法:
- 测试 MySQL 的最大 QPS(每秒查询数):比如通过压测,MySQL 最多能处理 200 次 / 秒的查询,不卡顿;
- 限流阈值设置为 "MySQL 最大 QPS 的 50%~70%"(比如 200*60%=120):预留一定的缓冲空间,避免 MySQL 被限流阈值压满,同时应对突发请求;
- 动态调整:缓存雪崩发生时,可临时降低阈值(比如从 120 调到 80),进一步保护 MySQL;缓存恢复后,再调回正常阈值。
详细说明
- 限流 Key 的设计:用 "全局限流 Key + 时间戳取整",确保每 1 秒一个独立的 Key,实现 "每秒限流"------ 比如当前时间戳 1699999999123,取整后是 1699999999,对应 1 秒内的所有请求,1 秒后自动切换到下一个 Key,避免限流窗口混乱;
- 原子性保证:必须用 Redis 的 incr 命令(原子递增),不能用 "先 get 统计数,再加 1,再 set"(非原子操作),否则并发场景下,多个请求会同时统计,导致统计数不准,限流失效;
- 容错处理:Redis 宕机时,限流逻辑会抛出异常,此时默认 "允许访问 MySQL"------ 避免限流逻辑失效,导致核心接口无法访问(Redis 宕机时,缓存已失效,若再禁止访问 MySQL,业务会彻底瘫痪);
- 限流范围:所有 "查 MySQL 的请求",都必须经过全局限流,包括核心接口和非核心接口,不能遗漏 ------ 否则遗漏的请求会打向 MySQL,依然可能导致 MySQL 被打崩。
方案 4.2 服务降级(关闭非核心接口,优先保证核心业务)
核心原理
缓存雪崩发生时,即使经过限流,MySQL 依然承受着一定的压力 ------ 服务降级的核心,是 "区分核心接口和非核心接口",临时关闭非核心接口(比如商品评价、历史订单、商品推荐),停止这些接口的 MySQL 查询请求,将 MySQL 的资源,全部留给核心接口(比如商品详情、下单、支付),确保核心业务能正常运行,非核心接口返回默认提示,减轻 MySQL 压力。
简单说:"雪崩时,先保核心,再顾次要",比如电商场景,优先保证 "用户能查商品、能下单",暂时关闭 "商品评价、历史订单",避免这些非核心接口的请求,占用 MySQL 资源,导致核心接口无法运行。
实现步骤
方式 1:简单开关控制
通过 "Redis 开关",控制非核心接口的开启 / 关闭,雪崩时手动或自动关闭开关,返回默认提示。
步骤 1:定义降级开关(Redis Key,控制非核心接口)
// 服务降级开关Key(Redis中存储,true=降级,false=正常)
private static final String DEGRADE_SWITCH_KEY = "cache:avalanche:degrade:switch";
// 核心接口标识(比如商品详情、下单,无需降级)
private static final List<String> CORE_INTERFACES = Arrays.asList("goodsDetail", "createOrder", "pay");
步骤 2:实现降级判断逻辑(拦截非核心接口)
// 服务降级判断:判断当前接口是否需要降级
private boolean isDegrade(String interfaceName) {
    try {
        // 1. 获取Redis中的降级开关(默认false=不降级)
        String degradeSwitch = redisTemplate.opsForValue().get(DEGRADE_SWITCH_KEY);
        if (degradeSwitch == null || "false".equals(degradeSwitch)) {
            // 开关关闭,不降级,所有接口正常运行
            return false;
        }

        // 2. 开关开启,判断接口是否为核心接口
        return !CORE_INTERFACES.contains(interfaceName);
    } catch (Exception e) {
        // 异常处理:Redis宕机时,默认不降级(避免误关核心接口)
        e.printStackTrace();
        return false;
    }
}
步骤 3:非核心接口添加降级逻辑(比如商品评价接口)
// 非核心接口:商品评价查询(雪崩时降级)
public String getGoodsComment(Long goodsId) {
    // 判断是否需要降级
    if (isDegrade("getGoodsComment")) {
        // 降级返回:默认提示,不查MySQL
        return "服务繁忙,商品评价暂时无法查看,请稍后再试~";
    }

    // 正常流程(查Redis→查MySQL→写缓存,和商品详情逻辑一致)
    String redisKey = "goods:comment:" + goodsId;
    String comment = redisTemplate.opsForValue().get(redisKey);
    if (comment != null) {
        if ("NULL".equals(comment)) {
            return "该商品暂无评价~";
        }
        return comment;
    }

    // 限流判断(非核心接口,也需经过限流,避免打向MySQL)
    if (!isAllowAccessMysql()) {
        return "服务繁忙,请稍后再试~";
    }

    // 查MySQL
    comment = queryCommentFromMysql(goodsId);
    if (comment == null || "".equals(comment.trim())) {
        setCache(redisKey, "NULL");
        return "该商品暂无评价~";
    }

    setCache(redisKey, comment);
    return comment;
}

// 模拟MySQL查询商品评价
private String queryCommentFromMysql(Long goodsId) {
    // 模拟:商品ID≤10000时,返回评价;>10000时,返回null
    if (goodsId > 10000) {
        return null;
    }
    return "商品ID:" + goodsId + ",评价:爆款手机,很好用,值得购买!(共1000条评价)";
}
步骤 4:核心接口保留正常逻辑(比如商品详情、下单)
核心接口(goodsDetail、createOrder),即使降级开关开启,依然正常运行,经过限流后,可访问 MySQL,确保核心业务不中断 ------ 和前面的商品详情查询逻辑一致,无需修改。
步骤 5:降级开关的触发方式(小白能操作)
-
手动触发(推荐):缓存雪崩发生时,通过 Redis 命令,手动开启降级开关:
# Redis客户端执行,开启降级(关闭非核心接口) 127.0.0.1:6379> set cache:avalanche:degrade:switch true # 缓存恢复后,手动关闭降级开关 127.0.0.1:6379> set cache:avalanche:degrade:switch false -
自动触发(进阶):通过代码,监控 MySQL 的压力(比如 CPU 占用率 > 80%、查询耗时 > 500 毫秒),自动开启降级开关,缓存恢复后自动关闭 ------ 小白可先实现手动触发,后续再优化为自动触发。
方式 2:SpringCloud 降级注解(适合大规模业务,有微服务架构)
若业务是微服务架构(比如 SpringCloud/SpringBoot Alibaba),可使用 Sentinel、Hystrix 等组件,通过注解实现服务降级,更灵活、更易维护,小白可参考以下代码(Sentinel 示例):
步骤 1:导入 Sentinel 依赖(pom.xml,小白可直接复制)
<!-- Sentinel核心依赖,实现服务降级、限流 -->
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-sentinel</artifactId>
    <version>2021.0.5.0</version>
</dependency>
步骤 2:非核心接口添加降级注解(@SentinelResource)
import com.alibaba.csp.sentinel.annotation.SentinelResource;
import com.alibaba.csp.sentinel.slots.block.BlockException;

// 非核心接口:商品评价查询(Sentinel降级)
@SentinelResource(
    value = "getGoodsComment", // 接口标识,和Sentinel控制台配置一致
    blockHandler = "getGoodsCommentDegrade" // 降级方法,限流/雪崩时触发
)
public String getGoodsComment(Long goodsId) {
    // 正常流程(查Redis→查MySQL→写缓存,和前面一致)
    String redisKey = "goods:comment:" + goodsId;
    String comment = redisTemplate.opsForValue().get(redisKey);
    if (comment != null) {
        if ("NULL".equals(comment)) {
            return "该商品暂无评价~";
        }
        return comment;
    }

    comment = queryCommentFromMysql(goodsId);
    if (comment == null || "".equals(comment.trim())) {
        setCache(redisKey, "NULL");
        return "该商品暂无评价~";
    }

    setCache(redisKey, comment);
    return comment;
}

// 降级方法(和原方法参数一致,最后加BlockException参数)
public String getGoodsCommentDegrade(Long goodsId, BlockException e) {
    // 降级返回,不查MySQL,减轻压力
    return "服务繁忙,商品评价暂时无法查看,请稍后再试~";
}
步骤 3:Sentinel 控制台配置(小白操作)
-
下载 Sentinel 控制台(jar 包),启动:
java -jar sentinel-dashboard-1.8.6.jar -
访问控制台(http://localhost:8080,默认账号密码 sentinel/sentinel);
-
配置降级规则:找到 "getGoodsComment" 接口,添加降级规则(比如 "RT 降级",查询耗时超过 500 毫秒,自动降级);
-
缓存雪崩发生时,Sentinel 会自动触发降级方法,关闭非核心接口,返回默认提示。
核心优化点
- 明确核心 / 非核心接口:提前梳理业务接口,明确哪些是核心(必须保证运行),哪些是非核心(可临时关闭),避免雪崩时误关核心接口;
- 核心接口示例:商品详情、下单、支付、用户登录;
- 非核心接口示例:商品评价、历史订单、商品推荐、收藏列表;
- 降级提示友好:非核心接口降级后,返回用户友好提示(比如 "服务繁忙,请稍后再试"),不要返回错误码,避免用户恐慌;
- 降级开关容错:Redis 宕机时,默认 "不降级",避免误关核心接口(Redis 宕机时,缓存已失效,若再降级核心接口,业务会彻底瘫痪);
- 降级后恢复:缓存雪崩缓解、Redis 恢复后,及时关闭降级开关,恢复非核心接口,提升用户体验;
- 降级和限流联动:非核心接口,既要经过 "全局限流",也要经过 "服务降级",双重拦截,最大限度减轻 MySQL 压力。
方案 4 整体总结
优点(兜底防护,最后一道防线)
- 针对性强:专门应对 "前面方案失效" 的极端场景(比如大量 Key 同时过期 + Redis 宕机),兜底保护 MySQL 和核心业务;
- 实现灵活:中小规模业务用 "开关控制",大规模微服务用 "Sentinel 注解",小白都能落地;
- 成本低:开关控制无需引入额外组件,仅用 Redis 即可实现,Sentinel 组件也能快速集成;
- 风险可控:限流控制请求数,降级关闭非核心接口,确保 MySQL 不被打崩,核心业务不中断,风险可控。
缺点(可解决)
- 影响用户体验:非核心接口降级后,用户无法访问,会影响部分用户体验,但可接受(优先保证核心业务);
- 手动触发繁琐:开关控制需要手动开启 / 关闭,适合中小规模业务,大规模业务建议用自动触发;
- 限流阈值难把控:需要提前压测 MySQL,确定合理的限流阈值,否则阈值过高 / 过低,都会影响防护效果。
适用场景(所有业务,必做兜底)
- 所有生产环境业务,尤其是 "对稳定性要求高" 的业务(电商、金融、支付);
- 作为方案 1、2、3 的补充,形成 "四重防护",彻底规避缓存雪崩;
- 极端场景:大量 Key 同时过期、Redis 宕机、缓存冷启动失败,必须靠限流 + 降级,兜底保护业务。
1.3.8.5 缓存雪崩解决方案总结
四重防护体系
| 防护层级 | 解决方案 | 核心作用 | 实现难度 | 落地优先级 |
|---|---|---|---|---|
| 第一道防线 | 缓存 Key 过期时间加随机值 | 避免大量 Key 同时过期(最基础、最核心) | 低 | ★★★★★(必做) |
| 第二道防线 | 热点数据永不过期 | 保护热点数据,避免大量热点请求打向 MySQL | 中 | ★★★★★(必做) |
| 第三道防线 | Redis 持久化 + 主从 + 哨兵 | 避免 Redis 宕机,缓存全部丢失 | 中高 | ★★★★☆(生产环境必做) |
| 第四道防线 | 请求限流 + 服务降级 | 极端场景兜底,控制 MySQL 请求数,保护核心业务 | 中 | ★★★★☆(必做) |
落地步骤
- 第一步(10 分钟完成):修改所有写入缓存的代码,给过期时间加随机值(方案 1),零成本,必做;
- 第二步(30 分钟完成):筛选热点数据,用 "互斥锁" 或 "逻辑过期时间",实现热点数据永不过期(方案 2),复用缓存击穿的代码;
- 第三步(1~2 小时完成):开启 Redis 持久化(AOF+RDB 混合),部署主从复制 + 哨兵模式(方案 3),生产环境必做,避免 Redis 宕机;
- 第四步(30 分钟完成):实现全局限流(Redis incr),梳理核心 / 非核心接口,实现服务降级开关(方案 4),兜底防护;
- 第五步(定期维护):
- 每周检查 Redis 持久化文件,定期备份;
- 每月测试哨兵故障转移,确保 Redis 高可用;
- 每季度压测 MySQL,调整全局限流阈值;
- 定期更新热点数据列表,确保热点数据准确。
解决方案选型建议
| 业务规模 | 场景 | 推荐解决方案组合 | 成本 |
|---|---|---|---|
| 小规模业务(个人项目、小公司) | 请求量小,无大促 | 方案 1 + 方案 2(互斥锁) + 方案 4(开关控制) | 零成本 |
| 中小规模业务(中小企业) | 请求量中,有小促 | 方案 1 + 方案 2(逻辑过期) + 方案 3(持久化 + 主从) + 方案 4(开关控制) | 低(仅需服务器资源) |
| 大规模业务(大厂、电商大促) | 请求量大,大促场景 | 方案 1 + 方案 2(逻辑过期) + 方案 3(持久化 + 主从 + 哨兵) + 方案 4(Sentinel 降级) | 中(需部署 Sentinel 组件) |
避坑点
- 所有缓存 Key,必须加随机值:不要遗漏任何一个 Key(包括空值缓存),否则会导致大量 Key 同时过期;
- Redis 持久化必开:不要图省事关闭持久化,否则 Redis 宕机后,缓存全部丢失,直接引发雪崩;
- 主从 + 哨兵生产必部署:单机 Redis 风险极高,宕机后无备用,直接引发雪崩,生产环境必须部署主从 + 哨兵;
- 核心 / 非核心接口提前梳理:不要雪崩时临时梳理,避免误关核心接口;
- 限流阈值合理设置:根据 MySQL 实际承载能力调整,不要设太高(压垮 MySQL)或太低(影响用户体验);
- 避免 "批量删除缓存后,批量写入相同过期时间":批量更新缓存时,每个 Key 都要加随机值,分散过期时间;
- 缓存预热必做:Redis 宕机重启后,提前将热点数据写入 Redis,避免冷启动引发雪崩;
- 定期测试防护方案:每季度模拟一次缓存雪崩(比如批量过期缓存、关闭 Redis),测试防护方案是否生效,及时调整。
1.3.9 缓存三大异常(穿透、击穿、雪崩)对比总结
通俗类比
| 异常类型 | 通俗类比(商场场景) | 核心区别(一句话) |
|---|---|---|
| 缓存穿透 | 顾客反复找 "商场里根本没有的商品",每次都要去大仓库(MySQL)找,导购员小仓库(Redis)里没有,白跑一趟 | 查 "不存在的数据",缓存形同虚设 |
| 缓存击穿 | 商场里的 "爆款商品"(热点),导购员小仓库(Redis)里卖完了(缓存过期),瞬间大量顾客去大仓库(MySQL)找,大仓库被挤爆 | 单一热点数据过期,大量请求打向 MySQL |
| 缓存雪崩 | 商场里 "所有商品",导购员小仓库(Redis)里同时卖完了(大量 Key 同时过期),或导购员全部请假(Redis 宕机),所有顾客都去大仓库(MySQL)找,大仓库彻底瘫痪 | 大量 Key 同时过期 / Redis 宕机,海量请求打向 MySQL |
核心对比表
| 对比维度 | 缓存穿透 | 缓存击穿 | 缓存雪崩 |
|---|---|---|---|
| 核心原因 | 1. 未设置空值缓存;2. 大量无效请求;3. Key 格式非法 | 1. 热点数据缓存过期;2. 未做缓存预热;3. 热点数据被意外淘汰 | 1. 大量 Key 同时过期(未加随机值);2. Redis 宕机(无主从 + 哨兵);3. 缓存冷启动未预热 |
| 核心特点 | 1. 查询的 Key,MySQL 中不存在;2. 每次请求都打向 MySQL;3. 请求量可大可小 | 1. 单一 Key(热点数据);2. 请求量极大(每秒几百 / 几千次);3. 缓存过期瞬间爆发 | 1. 大量 Key 同时过期 / Redis 宕机;2. 海量请求(每秒几万 / 几十万次);3. 引发业务连锁反应 |
| 危害程度 | 中(MySQL 压力增大,不会直接宕机) | 高(MySQL 压力暴增,可能宕机,影响核心业务) | 极高(MySQL 瞬间宕机,整个业务瘫痪,造成经济损失) |
| 首选解决方案 | 1. Key 格式校验(基础);2. 空值缓存(核心);3. 布隆过滤器(终极) | 互斥锁(首选,适配所有热点场景) | 1. 过期时间加随机值(基础);2. Redis 主从 + 哨兵 + 持久化(核心);3. 热点永不过期 + 限流降级(兜底) |
| 落地优先级 | 必做(基础防护,零成本) | 必做(核心防护,热点数据必做) | 必做(四重防护,生产环境必做) |
| 实战注意点 | 空值缓存过期时间 5~10 分钟,布隆过滤器定期更新 | 互斥锁保证原子性,热点数据必做缓存预热 | 所有 Key 加随机值,主从 + 哨兵生产必部署 |
实战口诀
- 穿透:查不到,设空值,加布隆,拦非法;
- 击穿:热点 key,永不过期(逻辑),加互斥,防并发;
- 雪崩:随机值,主从备(哨兵),限流量,降非核;
- 三大异常,预防为先,四重防护,永不宕机。
1.3.10 缓存实战避坑大全
前面讲了缓存的核心用法、三大异常及解决方案,这里总结10个坑
坑 1:缓存和 MySQL 数据不一致
问题描述
修改 MySQL 数据后,未及时更新 / 删除 Redis 缓存,导致用户查询到旧数据(比如商品价格从 1000 元改为 1200 元,Redis 中还是 1000 元,用户看到旧价格);或删除 MySQL 数据后,未删除 Redis 缓存,用户依然能查询到已删除的数据。
解决方案
-
方案 1:更新 / 删除 MySQL 数据后,立即删除 Redis 缓存 (推荐,简单易落地),用户下次查询时,会重新查 MySQL,写入新缓存;
// 示例:修改商品价格,删除Redis缓存 public void updateGoodsPrice(Long goodsId, BigDecimal newPrice) { // 1. 更新MySQL数据(实际业务中,替换成真实的update语句) updateGoodsPriceToMysql(goodsId, newPrice); // 2. 立即删除Redis缓存(关键,避免数据不一致) String redisKey = "goods:" + goodsId; redisTemplate.delete(redisKey); } -
方案 2:更新 MySQL 数据后,立即更新 Redis 缓存(不推荐,有并发问题),仅适合 "更新频率极低" 的场景;
-
方案 3:延迟双删(进阶,解决并发问题):更新 MySQL 后,先删 Redis,等待 1 秒,再删一次 Redis(避免并发场景下,缓存写入比删除快);
public void updateGoodsPrice(Long goodsId, BigDecimal newPrice) {
    // 1. 更新MySQL
    updateGoodsPriceToMysql(goodsId, newPrice);
    // 2. 第一次删除Redis缓存
    String redisKey = "goods:" + goodsId;
    redisTemplate.delete(redisKey);
    // 3. 等待1秒(让并发的缓存写入请求完成)
    Thread.sleep(1000);
    // 4. 第二次删除Redis缓存(确保缓存被删除)
    redisTemplate.delete(redisKey);
}
避坑关键
- 永远遵循 "先更 MySQL,再删缓存"(不要先删缓存,再更 MySQL,避免并发场景下,缓存未写入,用户查不到数据);
- 不要依赖 "Redis 过期时间" 来同步数据(过期时间只是兜底,不能作为数据同步的主要方式)。
坑 2:缓存 Key 命名不规范,导致缓存混乱
问题描述
缓存 Key 没有统一的命名规范(比如商品详情 Key 用 "goods123",用户信息 Key 用 "user_123",订单 Key 用 "dingdan123"),导致后续维护困难,容易出现 Key 冲突、误删缓存(比如误删 "goods123",导致商品详情缓存失效)。
解决方案
-
统一命名格式:
业务模块:数据类型:唯一标识[:额外信息],全部用小写,用冒号分隔; -
实战示例(小白直接参考):
- 商品详情:
goods:detail:123(业务模块 goods,数据类型 detail,唯一标识 123); - 用户信息:
user:info:456(业务模块 user,数据类型 info,唯一标识 456); - 商品库存:
goods:stock:123(业务模块 goods,数据类型 stock,唯一标识 123); - 空值缓存:和正常 Key 一致,值存 "NULL"(比如
goods:detail:10001,值为 "NULL");
- 商品详情:
-
禁止用纯数字 / 随机字符串作为 Key(比如 "123""abc"),避免冲突;
-
:
// 用常量定义Key前缀,避免写错
private static final String GOODS_DETAIL_KEY_PREFIX = "goods:detail:";
private static final String USER_INFO_KEY_PREFIX = "user:info:";

// 生成商品详情Key
public String getGoodsDetailKey(Long goodsId) {
    return GOODS_DETAIL_KEY_PREFIX + goodsId;
}
坑 3:Redis 过期时间设置不合理(过短 / 过长)
问题描述
- 过期时间过短(比如 1 分钟):缓存频繁过期,大量请求打向 MySQL,引发缓存抖动,增加 MySQL 压力;
- 过期时间过长(比如 24 小时):缓存数据无法及时同步 MySQL 的更新,导致数据不一致,且占用 Redis 内存;
- 所有 Key 设置相同的过期时间:容易引发缓存雪崩。
解决方案
- 基础过期时间(按业务场景调整):
- 高频访问、变化少的数据(比如商品详情):1~2 小时;
- 中频访问、变化中等的数据(比如商品库存):10~30 分钟;
- 低频访问、变化频繁的数据(比如商品评价):5~10 分钟;
- 空值缓存:5~10 分钟(固定,不加分随机值);
- 所有 Key(除空值、逻辑过期),必须加随机值(60~600 秒),分散过期时间,避免雪崩;
- 定期检查缓存命中率:若命中率低于 80%,说明过期时间过短,适当延长;若数据不一致频繁,说明过期时间过长,适当缩短;
- 缓存命中率计算:
命中次数 / (命中次数 + 未命中次数) * 100%; - Redis 查看命中率命令:
info stats,找到keyspace_hits(命中次数)和keyspace_misses(未命中次数)。
- 缓存命中率计算:
坑 4:忽略 Redis 内存限制,导致缓存被频繁淘汰
问题描述
只知道用 Redis 缓存数据,不知道 Redis 的内存有限(比如 Redis 设置了 10GB 内存),当缓存数据超过内存限制时,Redis 会根据淘汰策略,自动淘汰缓存(比如淘汰热点数据),导致缓存命中率急剧下降,大量请求打向 MySQL,引发缓存抖动或击穿。
解决方案
- 提前规划 Redis 内存:根据业务需求,设置合理的 Redis 内存上限(比如
config set maxmemory 10gb); - 选择合适的淘汰策略(优先推荐):
- 有永久 Key(比如逻辑过期的热点数据):
volatile-lru(仅淘汰过期 Key,保护永久 Key); - 无永久 Key:
allkeys-lru(淘汰最久未使用的 Key,最常用);
- 有永久 Key(比如逻辑过期的热点数据):
- 定期清理无效缓存:
- 空值缓存:设置较短过期时间(5~10 分钟),自动淘汰;
- 低频冷数据:设置较短过期时间(5~10 分钟),避免占用内存;
- 监控 Redis 内存:定期查看 Redis 内存使用情况(
info memory),若内存使用率超过 80%,及时扩容(增加 Redis 内存,或部署 Redis 集群); - 避免缓存大文件:不要用 Redis 缓存大文件(比如超过 1MB 的图片、视频),大文件占用内存多,容易导致内存溢出。
坑 5:缓存穿透时,空值缓存未设置或过期时间不合理
问题描述
知道用空值缓存解决缓存穿透,但容易犯两个错:
- 未设置空值缓存:查询不存在的数据时,MySQL 返回 null,未写入 Redis,导致反复查询 MySQL;
- 空值缓存过期时间不合理:过短(<5 分钟),引发缓存抖动;过长(>10 分钟),导致数据不一致。
解决方案
- 所有查询 MySQL 返回 null 的场景,必须写入空值缓存(值为 "NULL",避免和真实 null 混淆);
- 空值缓存过期时间固定为 5~10 分钟,不加分随机值(空值无需避免同时过期);
- 空值缓存返回友好提示:用户查询时,若命中空值缓存,返回 "抱歉,该商品不存在或已下架",不要返回 null。
坑 6:互斥锁使用不当,引发死锁或锁失效
问题描述
用互斥锁解决缓存击穿,但容易犯 3 个错,导致锁失效或死锁:
- 用非原子操作获取锁(先 get 锁,再 set 锁),并发场景下,多个请求同时获取锁;
- 未设置锁的过期时间,请求异常时,锁不释放,引发死锁;
- 锁的过期时间过短,MySQL 查询耗时超过锁的过期时间,锁失效,多个请求同时查 MySQL。
解决方案
- 用原子操作获取锁:必须用 Redis 的
setIfAbsent方法(SETNX 命令),避免非原子操作; - 锁的过期时间设置合理:3~5 秒(根据 MySQL 查询耗时调整,确保查询 + 写入缓存 + 释放锁,能在锁过期前完成);
- 锁的释放放在 finally 块中:无论请求是否异常,都要释放锁,避免死锁;
- 循环尝试获取锁:最多尝试 3~5 次,每次等待 100~200 毫秒,避免无限等待;
- 仅释放自己获取的锁:只有获取锁成功的请求,才释放锁,避免释放别人的锁。
坑 7:Redis 宕机,未做高可用部署(生产环境必踩)
问题描述
在生产环境中,部署单机 Redis,未开启持久化、未部署主从 + 哨兵,一旦 Redis 宕机,所有缓存数据全部丢失,大量请求打向 MySQL,引发缓存雪崩,业务彻底瘫痪。
解决方案
- 开启 Redis 持久化:AOF+RDB 混合持久化,确保 Redis 宕机后,能从硬盘恢复数据;
- 部署主从复制 + 哨兵模式:1 主 2 从 3 哨兵,主 Redis 宕机时,哨兵自动切换从 Redis 为主 Redis,服务不中断;
- 定期备份持久化文件:每天凌晨备份 RDB 和 AOF 文件,存储到其他服务器,避免硬盘损坏,数据丢失;
- 监控 Redis 状态:定期查看 Redis 运行状态(
info server),若 Redis 宕机,及时告警,快速恢复。
坑 8:缓存预热未做,引发冷启动雪崩
问题描述
Redis 宕机重启后,缓存为空(未做缓存预热),大量用户同时访问,所有请求打向 MySQL,引发缓存雪崩(冷启动雪崩)
解决方案
-
手动缓存预热(中小规模业务,小白首选):Redis 重启后,手动执行脚本,将热点数据(比如前 100 个爆款商品),批量写入 Redis;
// 缓存预热脚本(小白可直接执行) public void cacheWarmUp() { // 1. 查询热点商品ID列表(比如前100个爆款商品) List<Long> hotGoodsIds = queryHotGoodsIds(); // 2. 批量查询MySQL,写入Redis for (Long goodsId : hotGoodsIds) { String goodsDetail = queryGoodsFromMysql(goodsId); String redisKey = getGoodsDetailKey(goodsId); // 写入缓存,加随机值 setCache(redisKey, goodsDetail); } System.out.println("缓存预热完成,共预热" + hotGoodsIds.size() + "个热点商品"); } -
自动缓存预热(大规模业务):后台开启定时任务,每天凌晨,自动查询热点数据,批量写入 Redis;
-
渐进式缓存预热(进阶):Redis 重启后,不一次性预热所有热点数据,而是根据用户访问频率,逐步将热点数据写入 Redis,避免一次性查询大量 MySQL,引发 MySQL 压力暴增。
坑 9:未区分热点 / 非热点数据,导致资源浪费
问题描述
将所有数据,都按相同的方式缓存(比如都设置 1 小时过期时间,都加互斥锁),导致:
- 非热点数据(低频访问),设置过长过期时间,占用 Redis 内存;
- 热点数据(高频访问),未做特殊保护(比如逻辑过期),容易引发缓存击穿;
- 资源浪费:非热点数据,无需加互斥锁、无需做缓存预热,小白却做了,浪费开发和服务器资源。
解决方案
- 定期筛选热点数据:根据业务日志,统计访问频率(比如每秒访问≥100 次的 Key),筛选热点数据;
- 热点数据特殊保护:用 "逻辑过期时间" 或 "互斥锁",永不过期,做缓存预热;
- 非热点数据常规处理:设置较短过期时间(5~30 分钟),加随机值,不做缓存预热,不加重互斥锁;
- 定期更新热点数据列表:每天更新一次热点数据列表,确保热点数据的准确性,避免非热点数据被当作热点数据,浪费资源。
坑 10:忽略异常处理,导致缓存逻辑失效
问题描述
写缓存逻辑时,未做异常处理(比如 Redis 宕机、MySQL 宕机、网络波动),导致缓存逻辑失效,业务接口报错,甚至引发连锁反应。
解决方案
-
Redis 异常处理:Redis 宕机、网络波动时,捕获异常,默认 "不降级、不限流核心接口",直接查询 MySQL,确保核心业务不中断;
public String getGoodsDetail(Long goodsId) { String redisKey = getGoodsDetailKey(goodsId); String goodsDetail; try { // 尝试查询Redis goodsDetail = redisTemplate.opsForValue().get(redisKey); } catch (Exception e) { // Redis异常(宕机、网络波动),捕获异常,直接查询MySQL e.printStackTrace(); goodsDetail = null; } // 后续流程(查MySQL→写缓存) // ...... } -
MySQL 异常处理:MySQL 宕机、网络波动时,捕获异常,返回用户友好提示,不要返回错误码;
private String queryGoodsFromMysql(Long goodsId) { try { // 模拟MySQL查询 if (goodsId > 10000) { return null; } return "商品ID:" + goodsId + ",名称:爆款手机,价格:1000元,库存:1000台"; } catch (Exception e) { // MySQL异常,返回null,后续写入空值缓存,或返回友好提示 e.printStackTrace(); return null; } } -
接口容错:缓存逻辑失效时,接口依然能正常返回(比如返回默认数据、友好提示),不要直接抛出异常,导致接口报错;
-
异常告警:Redis、MySQL 异常时,添加告警逻辑(比如短信、邮件告警),及时通知运维人员,快速恢复。
结语:缓存不是 "存个数据",而是高并发系统的第一道生死防线
写到这里,这篇Redis 缓存从入门到实战落地 的内容就全部结束了。从 MySQL 扛不住高并发的 5 大核心痛点,到 Redis 凭什么成为缓存王者;从最基础的缓存读写流程,到缓存更新、淘汰策略的底层逻辑;再到互联网面试 & 生产必问的缓存穿透、击穿、雪崩 三大致命异常,以及 10 个小白 99% 会踩的实战坑,我把缓存体系里能落地、能避坑、能面试的核心内容,全部用大白话拆给了你。
很多刚接触后端、高并发的同学,会觉得 "缓存不就是把数据存 Redis 里吗?",但真正走到生产、面对万级 QPS、面对恶意请求、面对服务器宕机才会发现:缓存写不好,MySQL 分分钟宕机,业务直接瘫痪 。缓存从来不是 "锦上添花",而是互联网系统的第一道生死护盾。
这篇文章里,你真正要记住的,不是某一行代码、某一个配置,而是这 4 句核心口诀:
- 穿透查不到,空值 + 布隆,先拦再防
- 击穿热点 Key,互斥锁兜底,逻辑过期更稳
- 雪崩怕同时过期,随机值 + 主从哨兵,四重防护
- 生产不赌运气,预防大于修复,监控 + 容错永不过时
不管你是正在做课程设计、个人博客项目的大一计算机新生,还是准备面试后端开发的初学者,缓存都是你必须吃透的核心技能------ 它是区分 "只会写 CRUD" 和 "能做高并发系统" 的第一道门槛。
不用怕复杂,不用觉得高深:
- 本地搭一套 Redis,开个 AOF+RDB 持久化,就是高可用的基础;
- 给缓存 Key 加个随机过期时间,就能避开 80% 的雪崩风险;
- 加一行空值缓存,就能挡住大部分穿透请求;
- 加一个简单互斥锁,就能保护热点数据不击穿。
技术从来不是死记硬背,而是理解原理、落地实战、踩坑成长。
最后送你一句话:高并发系统没有银弹,但缓存,是最性价比、最通用、最核心的解药。动手练起来,把这篇文章里的代码、配置、策略,在自己的项目里跑一遍,你会真正理解:什么叫 "Redis 一挡,MySQL 不慌"。
我们下篇 Redis 实战再见!