Expert Parallel 深入解析:专家分得均匀,负载为什么仍不均
TL;DR
- 场景:四张 GPU、每张两个专家,权重占用接近。配置表均衡,执行时可能只有一张卡接下超过一半的专家任务,其他卡先算完,整层仍要等结果回来。
- 结论 :部署表记录专家放在哪里,Router 的输出记录这批 Token 实际选了谁。EP 把这两张表连起来,但"专家个数相同"只约束部署布局,不约束每一轮的工作量。
1100/700不是性能预测,只能证明这组假设下最忙卡的有效任务计数下降;真正缩短的是关键路径还是设计底盘,要靠对齐时间线的对照实验回答。 - 产出:一份 1000 Token × Top-2 = 2000 任务的"放置 vs 重排"手算对照(最忙卡 1100 → 700,最大/平均从 2.2 降到 1.4)、7 张机制图与官方原文节选(vLLM Layer Behavior、EPLB、Memory Footprint;DeepEP Performance 与 V2 ElasticBuffer)、20 行错误速查卡,覆盖 vLLM stable 与 DeepEP V2 两个核查锚点。
平台版本:vLLM
docs.vllm.ai/en/stable页眉v0.28.0;DeepEPgithub.com/deepseek-ai/DeepEPREADME V2 节。资料检查日期 2026-09-08。所有任务计数(600/500/200...、1100/400/300/200、700/600/350/350)与"3.3.3 万人已读"等下游结论均为作者假设,未执行部署、性能或质量实验。
版本矩阵
| 功能 | 状态 | 说明 |
|---|---|---|
| vLLM stable Expert Parallel Deployment 文档(页眉 v0.28.0) | ✅ 已验证 | vLLM EP Deployment HEAD 200 / GET 受 CDN 限流,正文确认含 EP 内容 |
vLLM EP Layer Behavior 表格 + TP×DP = EP 组大小 |
✅ 已验证 | Layer Behavior with EP enabled HEAD 200 / GET 受 CDN 限流,同文档节 |
| vLLM EPLB(运行时重新分配专家映射) | ✅ 已验证 | EPLB HTTP 200 |
| vLLM EPLB 显存开销(冗余专家占用 GPU 显存) | ⚠️ 需对照验证 | Memory Footprint Overhead HTTP 200,但本页未单独核查 |
| DeepEP README 主页面 | ✅ 已验证 | deepseek-ai/DeepEP HTTP 200 |
| DeepEP Performance(logical bandwidth 口径 + 含本地 rank 流量) | ✅ 已验证 | DeepEP Performance HTTP 200 |
| DeepEP Interfaces and examples(V2 统一 ElasticBuffer) | ✅ 已验证 | DeepEP Interfaces HTTP 200 |
| 图1:一个 Token,选中两个专家(Router Top-2 → dispatch → 专家计算 → combine) | ✅ 已解读 | /tmp/blog-imgs14/01-9c1a5f2b4e1c93435ada29e70001242e.png,机制示意,非实测 |
| 图2:同一组 GPU,不同层采用不同并行方式(贴 vLLM Layer Behavior 表格 + TP=2/DP=4 示例) | ✅ 已解读 | /tmp/blog-imgs14/02-c3fa63cf732da2683bfeb297d826e681.png,页眉 v0.28.0,2026-09-08 核验 |
| 图3:热度不变,换位置也能打散热点(原放置 1100 vs 重排 700,最大/平均 2.2→1.4) | ⚠️ 作者假设 | /tmp/blog-imgs14/03-18a8cbeacd6f42c8fcf37df2b6f7a76c.png,任务数下降不是加速比 |
| 图4:读通信数字,先确认口径与版本(贴 DeepEP Performance + V2 ElasticBuffer 原文) | ✅ 已解读 | /tmp/blog-imgs14/04-a9aa96d95ef028936104bd5c655ca733.png,2026-09-08 核验 |
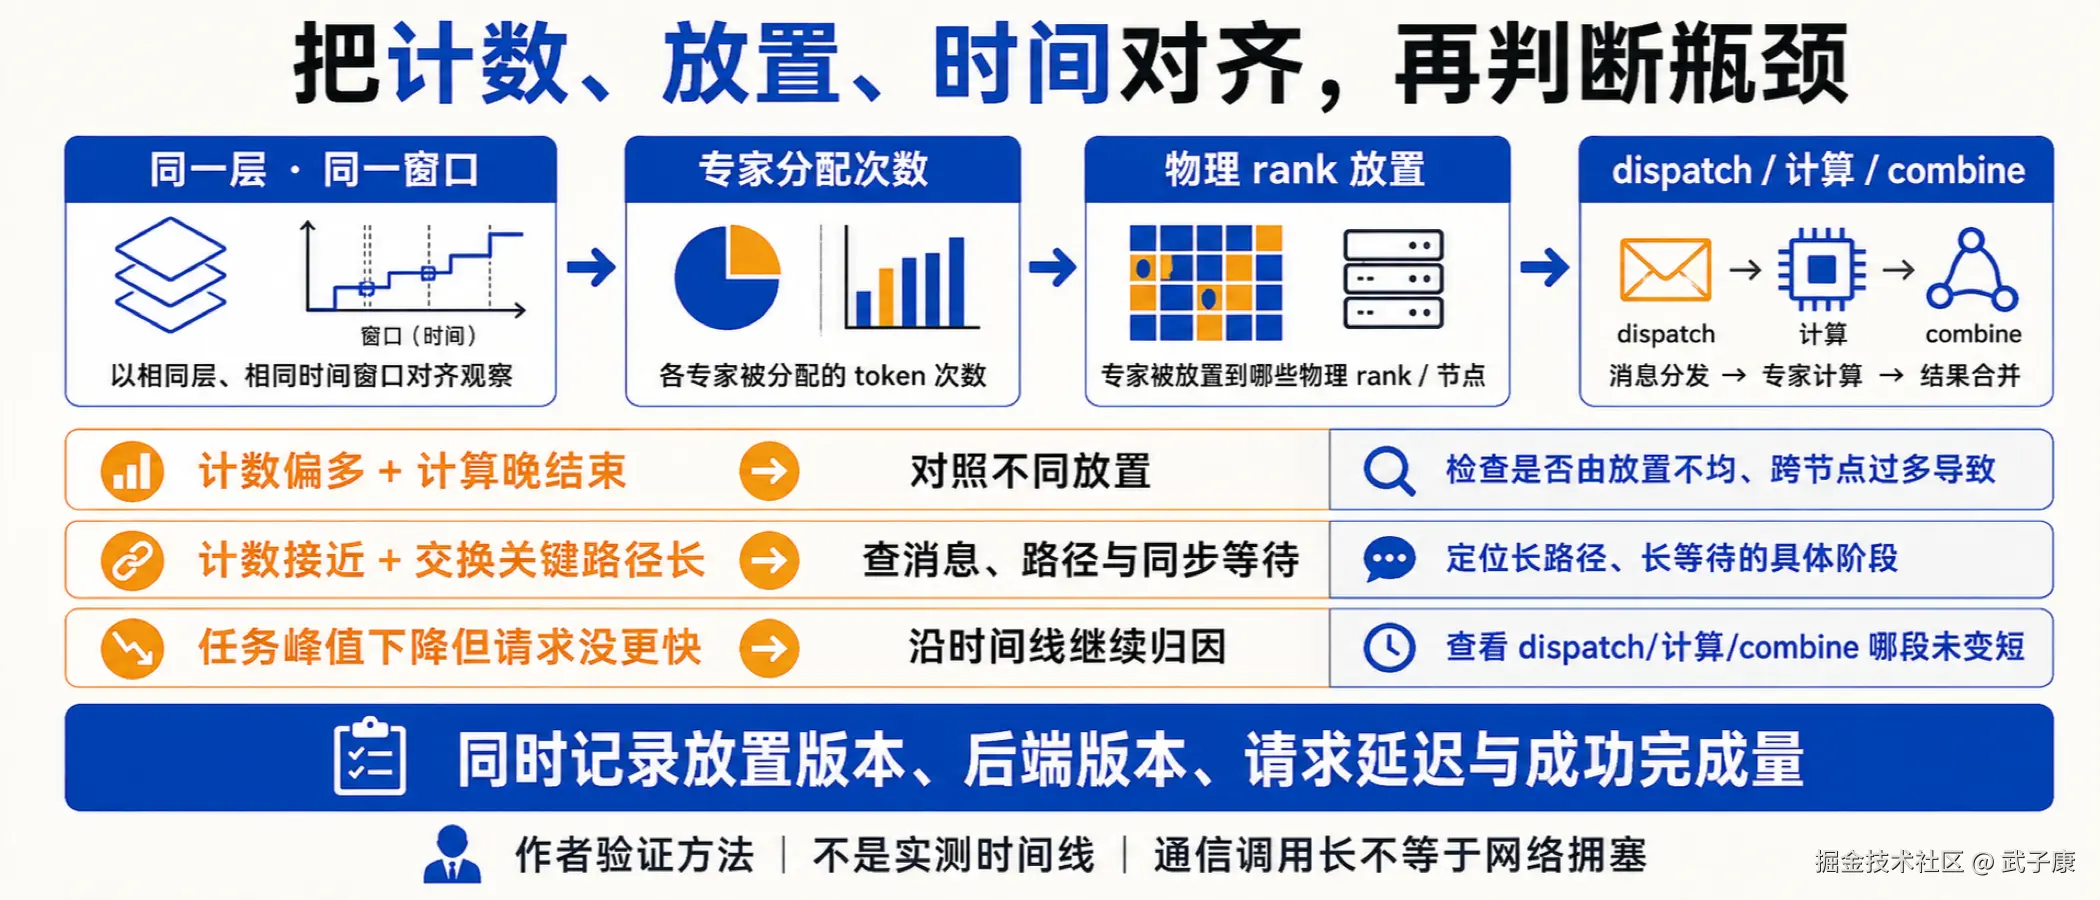
| 图5:把计数、放置、时间对齐,再判断瓶颈(4 步流程 + 3 个诊断分支) | ⚠️ 作者验证方法 | /tmp/blog-imgs14/05-376d95d77a5494f35592d83c85f2445f.png,不是实测时间线 |
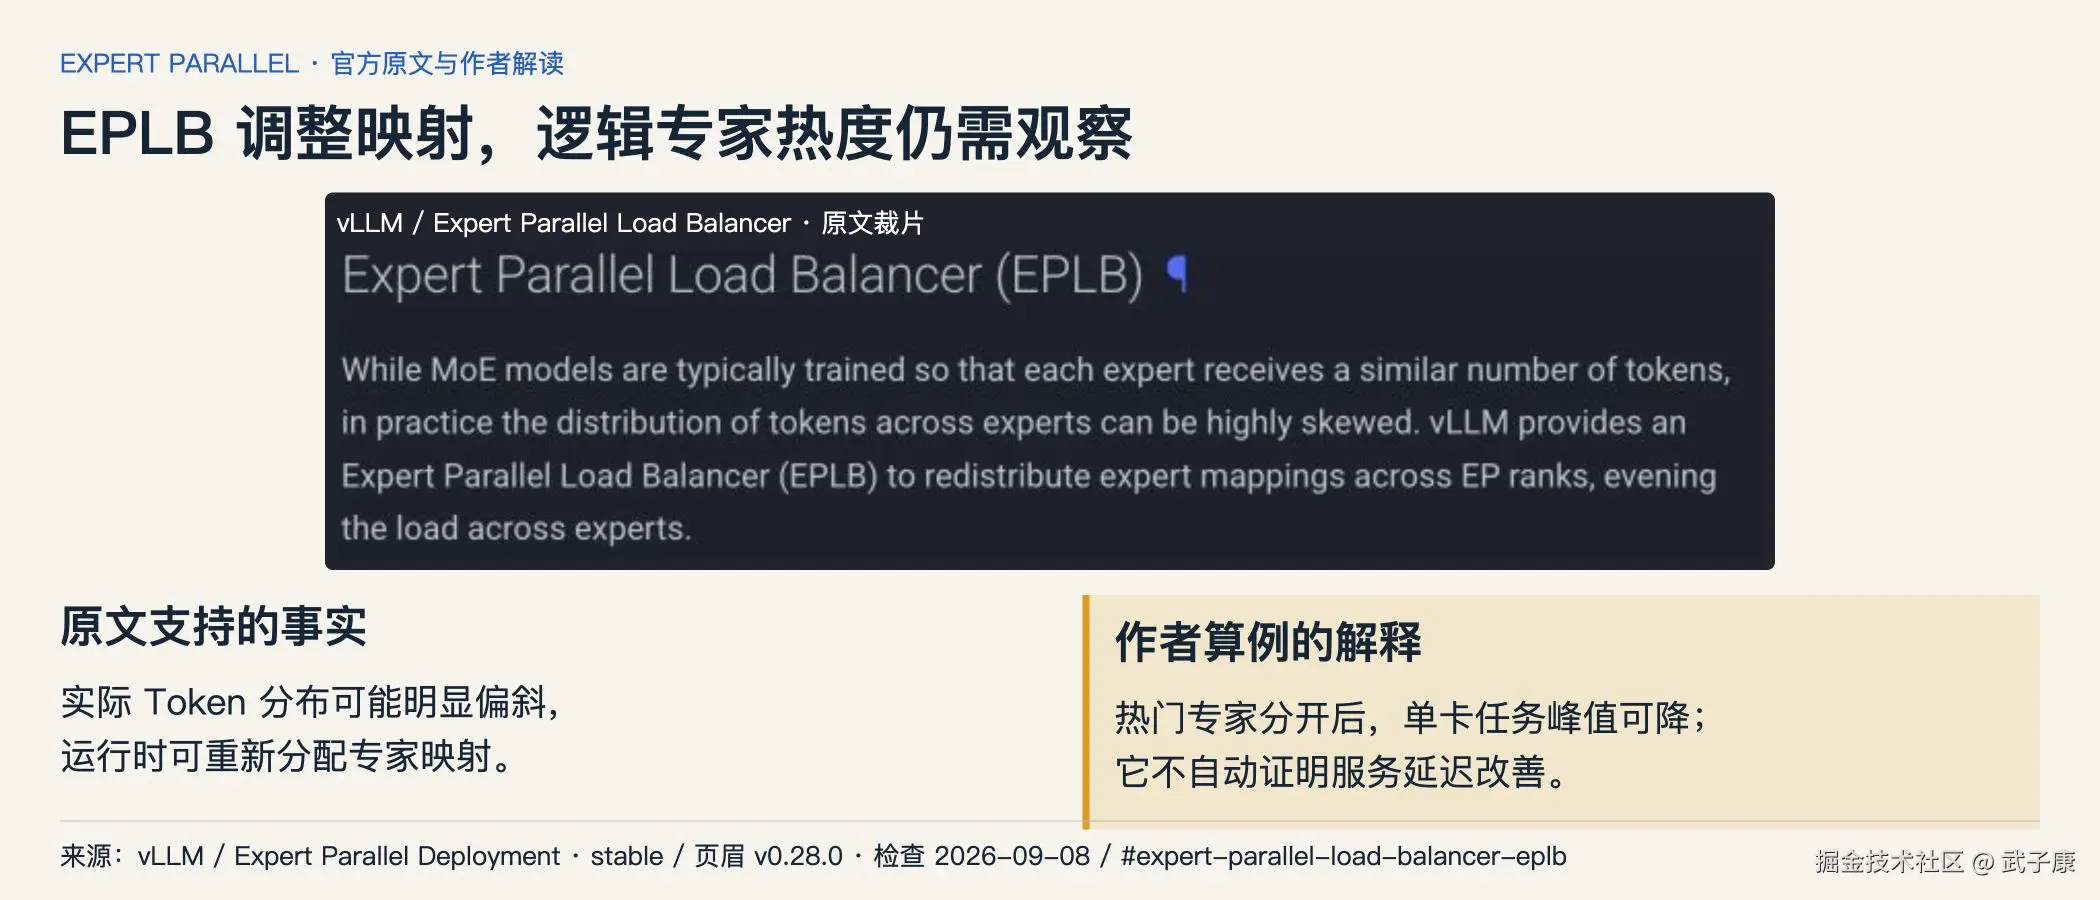
| 图6:EPLB 调整映射,逻辑专家热度仍需观察(贴 vLLM EPLB 原文) | ✅ 已解读 | /tmp/blog-imgs14/06-f2c03e4603ad5e373746f4d42fee88c0.png,页眉 v0.28.0,2026-09-08 核验 |
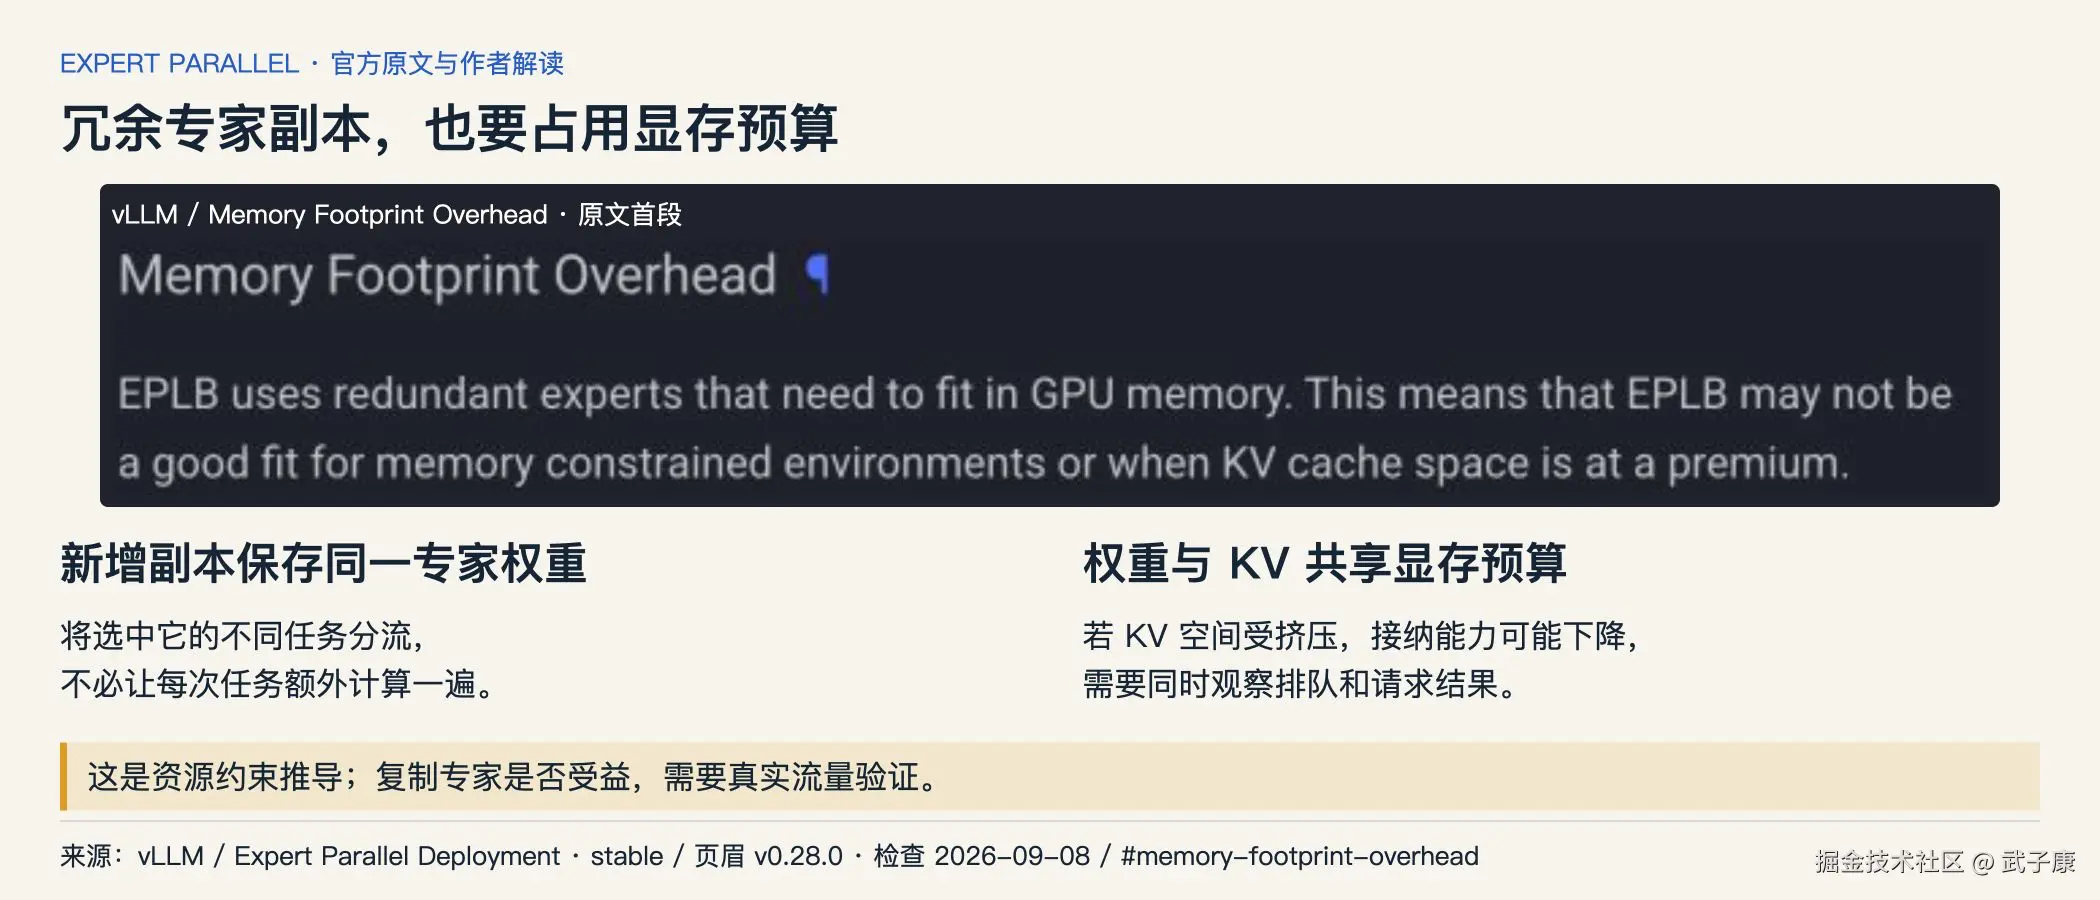
| 图7:冗余专家副本,也要占用显存预算(贴 vLLM Memory Footprint 原文) | ✅ 已解读 | /tmp/blog-imgs14/07-dc61ee216c595b7f18f574a21d86124d.png,页眉 v0.28.0,2026-09-08 核验 |
| 1000 Token × Top-2 = 2000 专家分配算例 | ⚠️ 作者假设 | 同 Token 被两专家各选一次,不能写作 2000 个 Token |
| 1100/400/300/200 → 700/600/350/350 放置对照 | ⚠️ 作者假设 | 不修改 Router 选择,只改变物理放置 |
| 2.2× / 1.4× 最大-平均比 | ⚠️ 算术结果 | 仅证明"这组假设下"最忙卡的有效任务计数下降 |
四张 GPU,每张放两个专家,权重占用也接近。配置表看起来很均衡,执行时却可能只有一张卡接下超过一半的专家任务,其他卡先算完,整层仍要等结果回来。
这个落差来自两张不同的表:部署表记录专家放在哪里,Router 的输出记录这批 Token 实际选了谁。Expert Parallel(EP,专家并行)把两张表连接起来。专家个数相同,只约束了部署布局,没有约束每一轮的工作量。
用一个可以手算的例子追踪这条链:先看逻辑专家的热度,再看物理卡的任务,最后看通信与计算各自花了多少时间。例子全部是假设,没有 GPU 跑分。它要回答的是该查哪一层、什么情况下值得调整专家放置。
从一个 Token 看见专家并行的边界
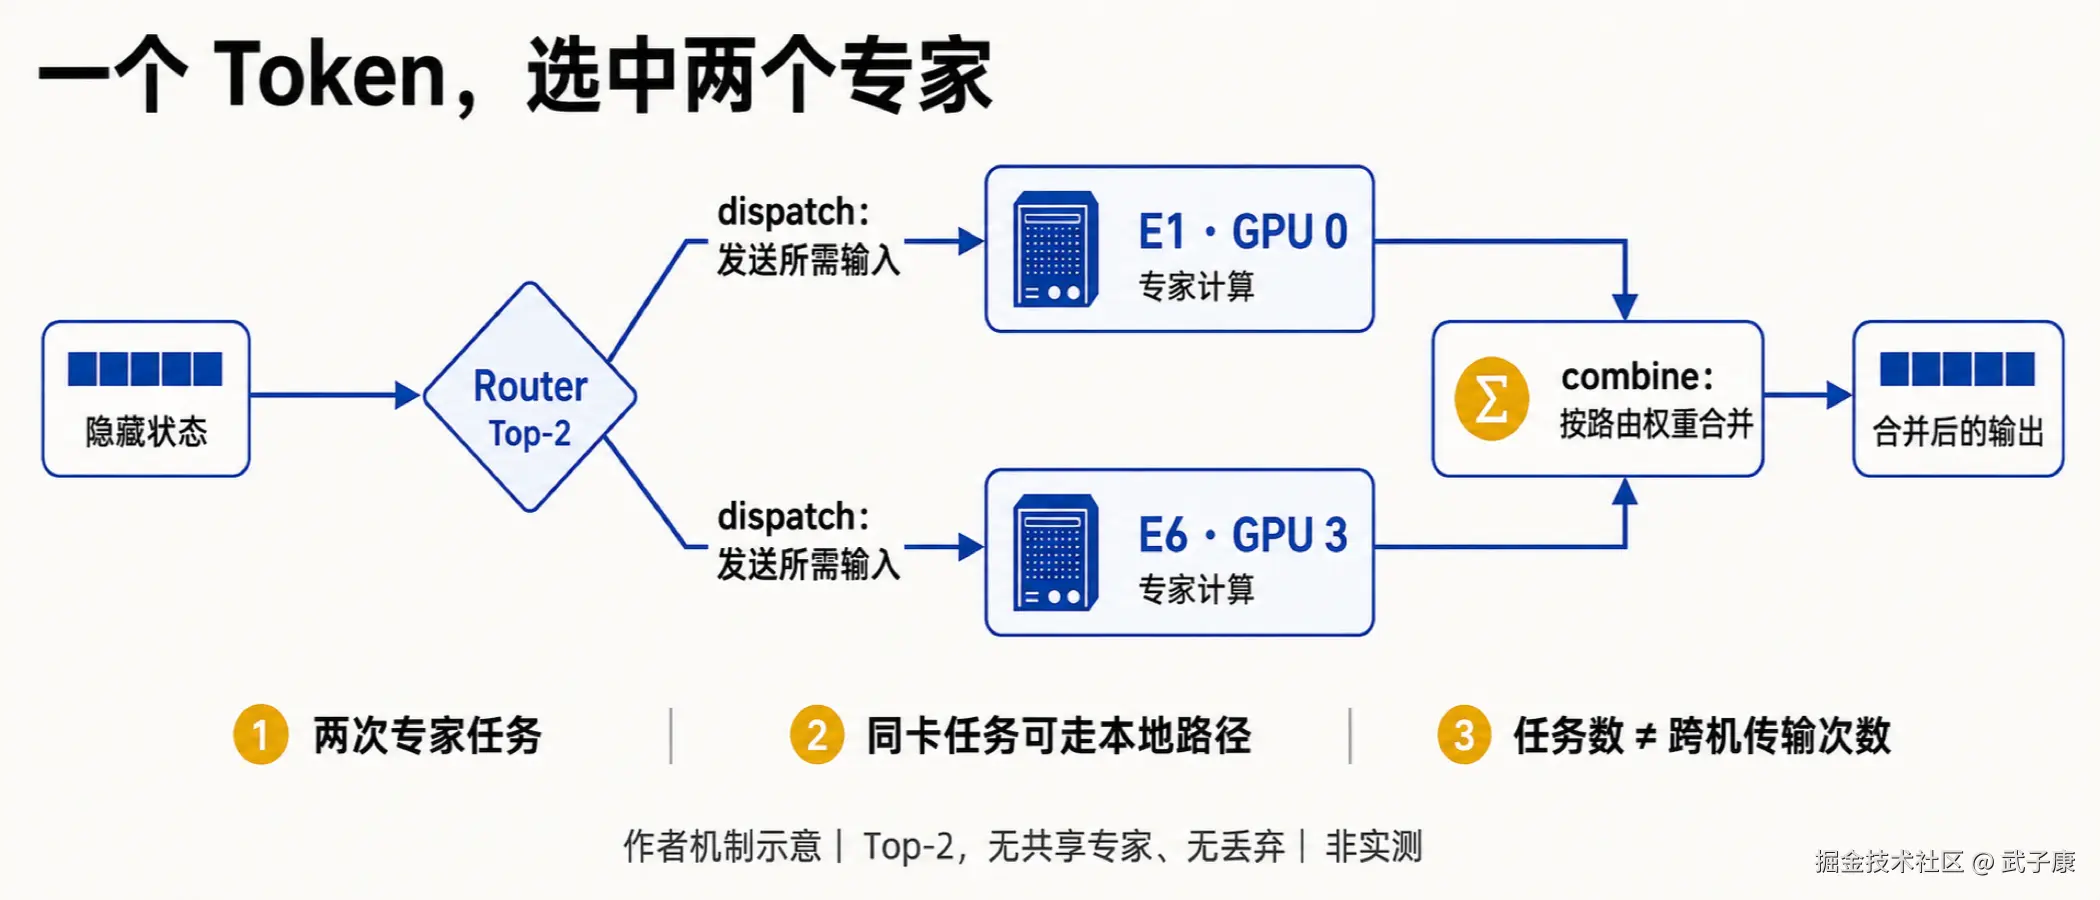
在常见稀疏 MoE 层里,Router 根据当前 Token 的隐藏状态选择若干专家。这里限定 Top-2、没有共享专家、没有丢弃或补发任务的简化模型:一个 Token 选中 E1 和 E6,就产生两次专家计算任务。
假设 E1 在 GPU 0,E6 在 GPU 3。执行系统要把所需隐藏状态送到专家所在位置,这一步叫 dispatch。两个专家分别计算后,把结果送回并按路由权重合并,这一步包含 combine。若某次任务的输入本来就在专家所在卡上,对应数据路径可以是本地的。图中的"去两个专家"不等于"两次跨机传输"。
这与API请求路由处于不同层次。API 路由决定一条请求交给哪个服务入口。MoE Router 在模型内部决定某一层的 Token 使用哪些专家。一条请求可以生成很多 Token,一个 Token 又会经过多个 MoE 层,不能拿入口请求数直接代表专家工作量。
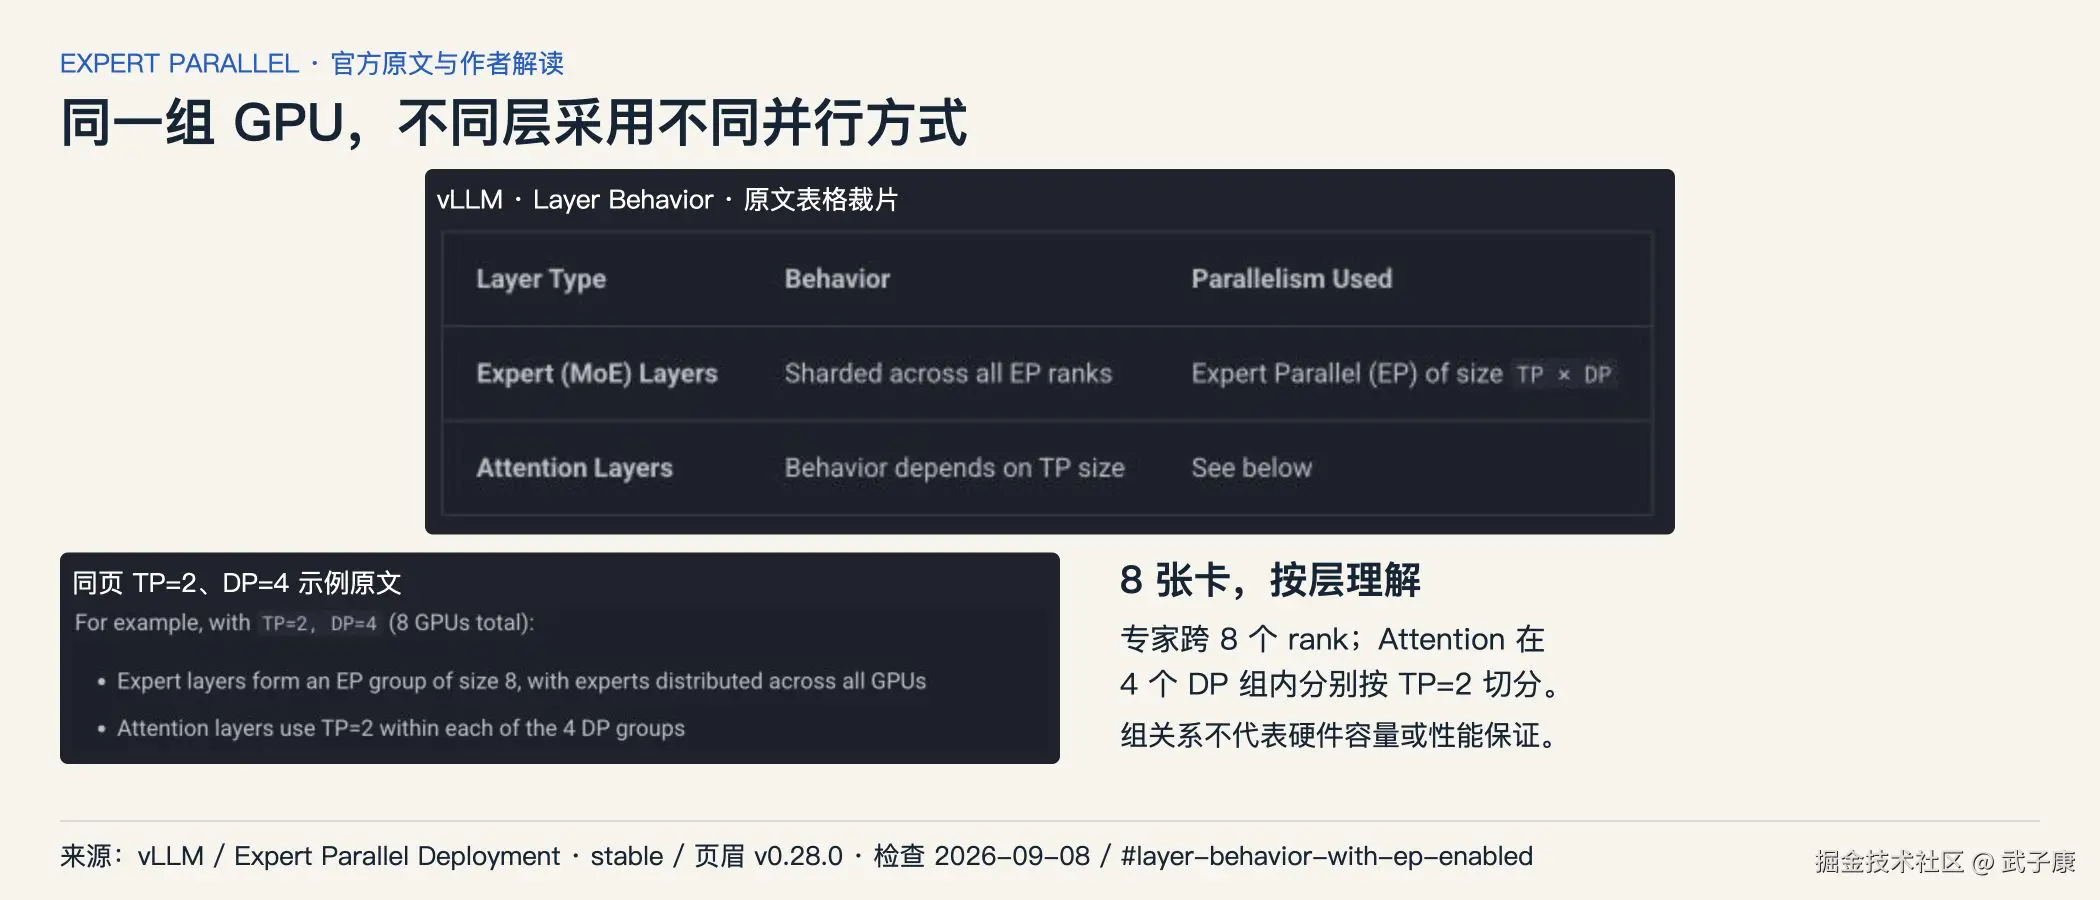
EP 与其他并行方式的组合也要按层理解。当前 vLLM 文档给出的 EP 组大小是 TP×DP。例如 TP=2、DP=4 时,专家跨八个 rank 分布,Attention 则在各 DP 组内按 TP=2 切分。不能把八张卡读成八套完整、互不协作的 MoE 服务。这个配置例子用于解释组关系,不是本文给出的硬件容量建议。vLLM EP 层行为说明
激活少量专家减少的是当前 Token 参与的专家计算。部署仍需让可能被选中的专家权重可用。在本例的常驻 GPU 权重方案中,八个专家都要有位置。权重卸载是另一种部署选择,它会增加取用路径,不能把"Top-2"直接代入总权重显存预算。
同样每卡两个专家,任务能差到多少
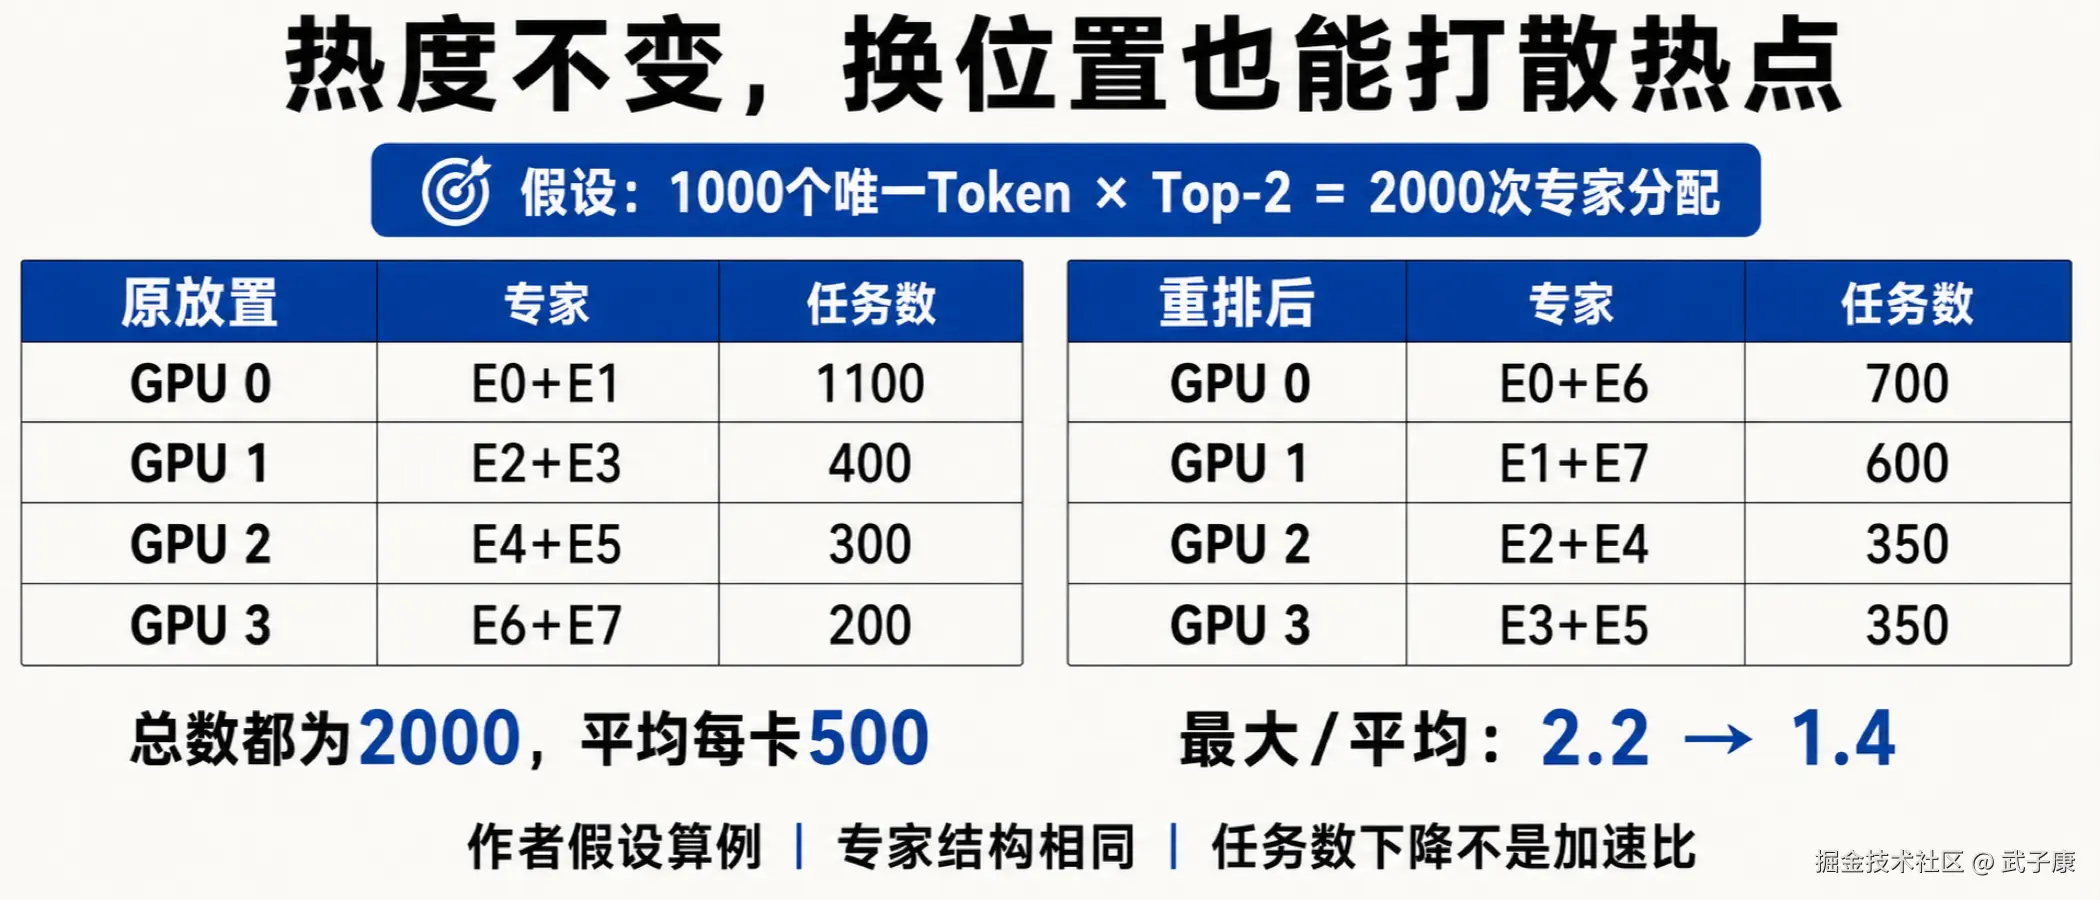
固定一层、同一次前向的统计窗口:有 1000 个唯一输入 Token,每个选两个不同专家,因此总共有 2000 次专家分配。再假设专家结构相同,只统计有效分配,暂不计填充和内核效率差异。
| 逻辑专家 | E0 | E1 | E2 | E3 | E4 | E5 | E6 | E7 |
|---|---|---|---|---|---|---|---|---|
| 专家分配次数 | 600 | 500 | 200 | 200 | 150 | 150 | 100 | 100 |
这里的 2000 不能写成"输入了 2000 个 Token"。同一个 Token 被两个专家选用,计了两次。1000 才是这个窗口的唯一 Token 数。讨论 Top-k、专家热度和通信量之前,先写清计数单位,否则后面的负载比例从起点就错了。
先按编号相邻放置,每卡两个专家:
| EP rank(本例一张 GPU) | 持有专家 | 分配次数 |
|---|---|---|
| 0 | E0、E1 | 1100 |
| 1 | E2、E3 | 400 |
| 2 | E4、E5 | 300 |
| 3 | E6、E7 | 200 |
平均每卡 500 次,最忙卡是平均值的 2.2 倍。问题不是卡 0 比别人多装了专家,而是两个热门专家碰巧落在同一张卡上。
只改变放置,不改变 Router 的选择,也不增加专家副本:把 E0 与 E6 放一起,E1 与 E7 放一起,其余分别组合成 E2/E4 和 E3/E5。
| EP rank | 调整后的专家 | 分配次数 |
|---|---|---|
| 0 | E0、E6 | 700 |
| 1 | E1、E7 | 600 |
| 2 | E2、E4 | 350 |
| 3 | E3、E5 | 350 |
总数仍是 2000,平均仍是 500,最大值变成平均的 1.4 倍。E0 依旧收到 600 次任务,E1 依旧收到 500 次。改变的是这些任务在物理卡上的相遇方式。
这说明"逻辑专家热度均匀"和"物理 rank 工作较均匀"是两个目标。运行时可以在不修改模型专家选择的前提下改善后者。反过来,若只看每卡的专家数量,就完全看不到这次调整为何可能有用。
700 也不是一个性能预测。1100/700 不能作为吞吐提升倍数:分组矩阵计算的效率、填充量、输入来自哪里以及通信重叠都没进入这张表。它只证明这组假设下最忙卡的有效任务计数下降了。
把热门专家搬开,仍可能在链路上等待
新的放置打散了计算热点,却也改变了数据目的地。假设原来一部分 Token 与 E1 位于同一个节点,把 E1 搬到另一节点后,这些任务可能需要跨节点传输。要不要搬,不能只由 1100→700 这一列决定。
MoE 的 dispatch/combine 常被概括为 All-to-All,但这描述的是多 rank 交换关系,不意味着每对 GPU 每轮都发送相同字节数,更不要求底层只能调用一个名为 AllToAll 的集合通信接口。实际路径会受到布局、数据格式和后端实现影响。
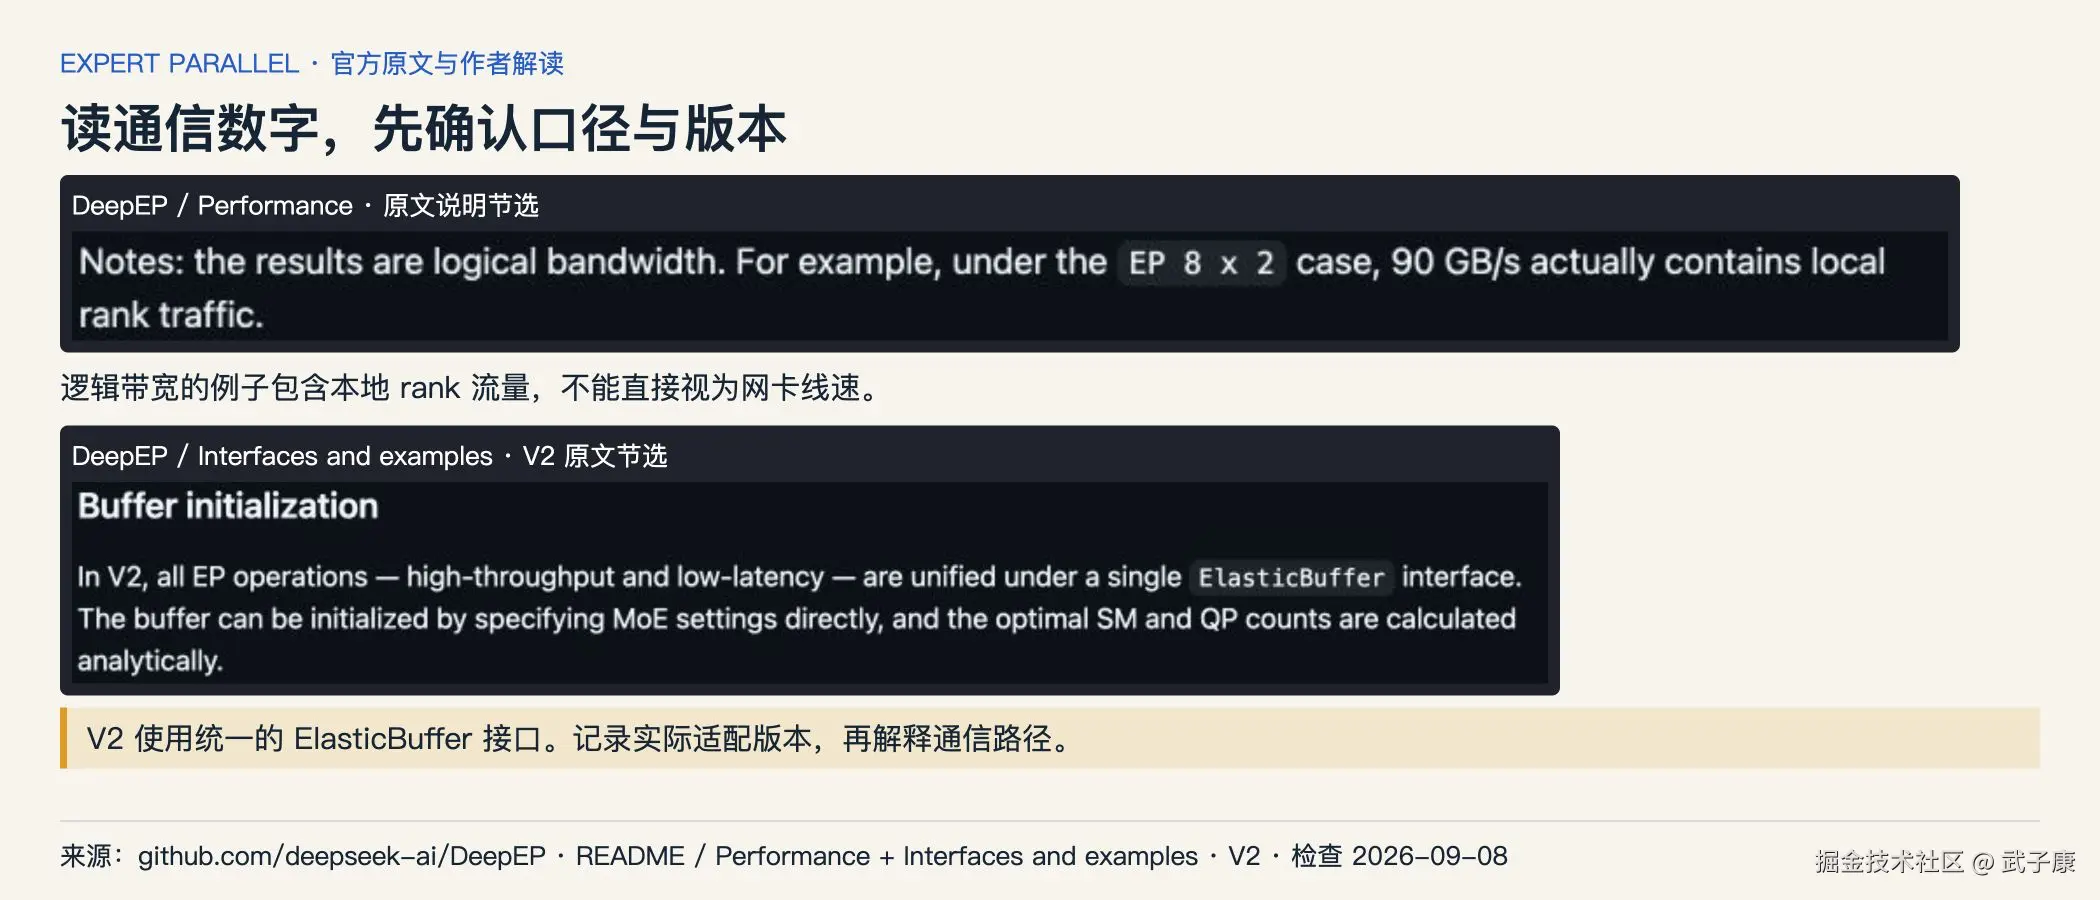
DeepEP 官方仓库把 dispatch 与 combine 分开报告,并明确其性能表中的带宽是逻辑带宽,部分口径包含本地 rank 流量。因此不能把表里的数值直接当成网卡实测线速,更不能拿专家分配次数乘一个固定系数,就宣称测出了跨机流量。DeepEP 性能口径
要判断等待来自哪里,可以围绕同一 MoE 层、同一前向窗口对齐三份记录:专家各自收到多少有效任务,映射到哪些物理 rank,以及这些 rank 的 dispatch、专家计算和 combine 时间线。记录应带上层号、窗口、放置版本与通信后端版本。把不同层或不同时段的峰值拼在一起,容易制造不存在的因果关系。
如果某卡有效任务持续偏多,专家计算也晚结束,放置调整值得进入对照实验。如果任务计数已经接近,但 dispatch/combine 的关键路径仍长,就应继续核查通信路径、消息规模、同步等待和内核开销。一次通信调用持续时间长,并不自动证明网络拥塞:它也可能在等待晚到的其他 rank。
还有一种更隐蔽的情况:按整天平均看很均衡,连续几次前向却总有不同专家突然变热。全天均值会把短时偏斜抹平,而在线延迟恰好由这些窗口决定。Prefill 与 Decode 的窗口也应分开观察。两者消息规模不同,用同一平均值挑后端会丢掉工作负载形状。
版本记录在这里尤其有用。当前 DeepEP V2 已将高吞吐与低延迟操作统一到 ElasticBuffer 接口,不能照搬旧版的接口划分。本文不把某个后端名字当作通用性能结论。实际服务框架适配了哪个版本,需要与该部署一起核对。DeepEP 当前接口
增加热门专家副本,代价会落在哪里
如果 E0 单独就收到 600 次任务,在不复制、不切分这个专家的前提下,仅靠搬位置,任何布局的最大卡负载都不可能低于 600。这是本例的任务计数下界,不是 GPU 延迟下界。继续把冷专家挪来挪去,无法让 E0 自己的工作消失。
一种进一步的手段,是为热门逻辑专家提供多个物理副本,让原本选中它的不同 Token 任务分给不同副本。这里复制的是同一个专家的权重。不是让 Router 改选另一个冷专家,也不是把每次任务额外算一遍。改变专家选择或丢弃任务会触及模型语义和质量,不能混进"只调整部署"的对照里。
vLLM 的 EPLB 会收集前向负载并周期性调整专家映射,也支持冗余专家。官方特别提醒冗余权重会占用显存,KV Cache 空间紧张时需要谨慎。这个机制提供了调节手段,并不保证所有请求分布都受益。vLLM EPLB 与显存边界
从资源预算推导,新增常驻副本除了占用权重空间,还要给通信缓冲和运行峰值留余量。如果复制专家挤压了原有 KV 预算,服务可能需要降低接纳能力。专家计算更均衡,整体排队却可能变长。这是要检查的条件后果,不是本文观察到的实测现象。
负载统计也有时效。历史窗口里最热的专家,未必在下一段业务输入里继续最热。重平衡还涉及映射切换及可能的权重移动。窗口太长会反应迟缓,调整太频繁又可能反复付出搬运成本。选择调整周期需要真实流量,而不是从本文的静态表里读出一个通用参数。
因此,对上面的四卡例子,第一轮实验可以只比较两种放置,保持模型、精度、输入回放、并发与后端一致。稳定预热后记录专家计数和分阶段时间,同时看请求延迟分布、成功完成量和输出校验。第二轮若加入冗余副本,则额外记录权重与 KV 预算变化,并分别查看稳定运行段和重平衡段,避免把迁移尖峰藏进平均值。
若任务最大值从 1100 降到 700,延迟却没有改善,先沿对齐的时间线解释差异。这时最有价值的结果可能是:计算热点已经缓解,关键路径转到了数据交换,或者减少的有效任务没有转化为更短的内核执行。确认这一点,才知道下一轮该改专家放置、通信实现,还是停下来保留更简单的配置。
本文为公开资料与架构推导,来源核查日期:2026-09-08。八专家、四卡、Top-2 及所有任务计数均为作者假设,未执行部署、性能或质量实验。文中的观测与对照方法是建议的验证方式,不是已完成的测试记录。
核查依据
- vLLM
docs.vllm.ai/en/stable/serving/expert_parallel_deployment/:HEAD 200(GET 受 CDN 限流,正文确认含 EP 内容);3 个锚点(#layer-behavior-with-ep-enabledHEAD 200、#expert-parallel-load-balancer-eplbHTTP 200、#memory-footprint-overheadHTTP 200)。 - DeepEP
github.com/deepseek-ai/DeepEP:主仓库 README HTTP 200;#performanceHTTP 200;#interfaces-and-examplesHTTP 200(V2 ElasticBuffer 节)。 - 7 张图均
curl -fsSL下载到/tmp/blog-imgs14/01-07并已read工具解读。 - 资料检查日期 2026-09-08;八专家、四卡、Top-2、所有任务计数(600/500/200...、1100/400/300/200、700/600/350/350)与最大-平均比(2.2 / 1.4)均为作者假设,未执行部署、性能或质量实验。