写在前面
这篇文章是 SeaPack 项目技术系列的第一篇。在写代码之前,我想先聊聊这个项目本身------它是什么、为什么要做、以及我在搭建过程中踩过哪些坑。
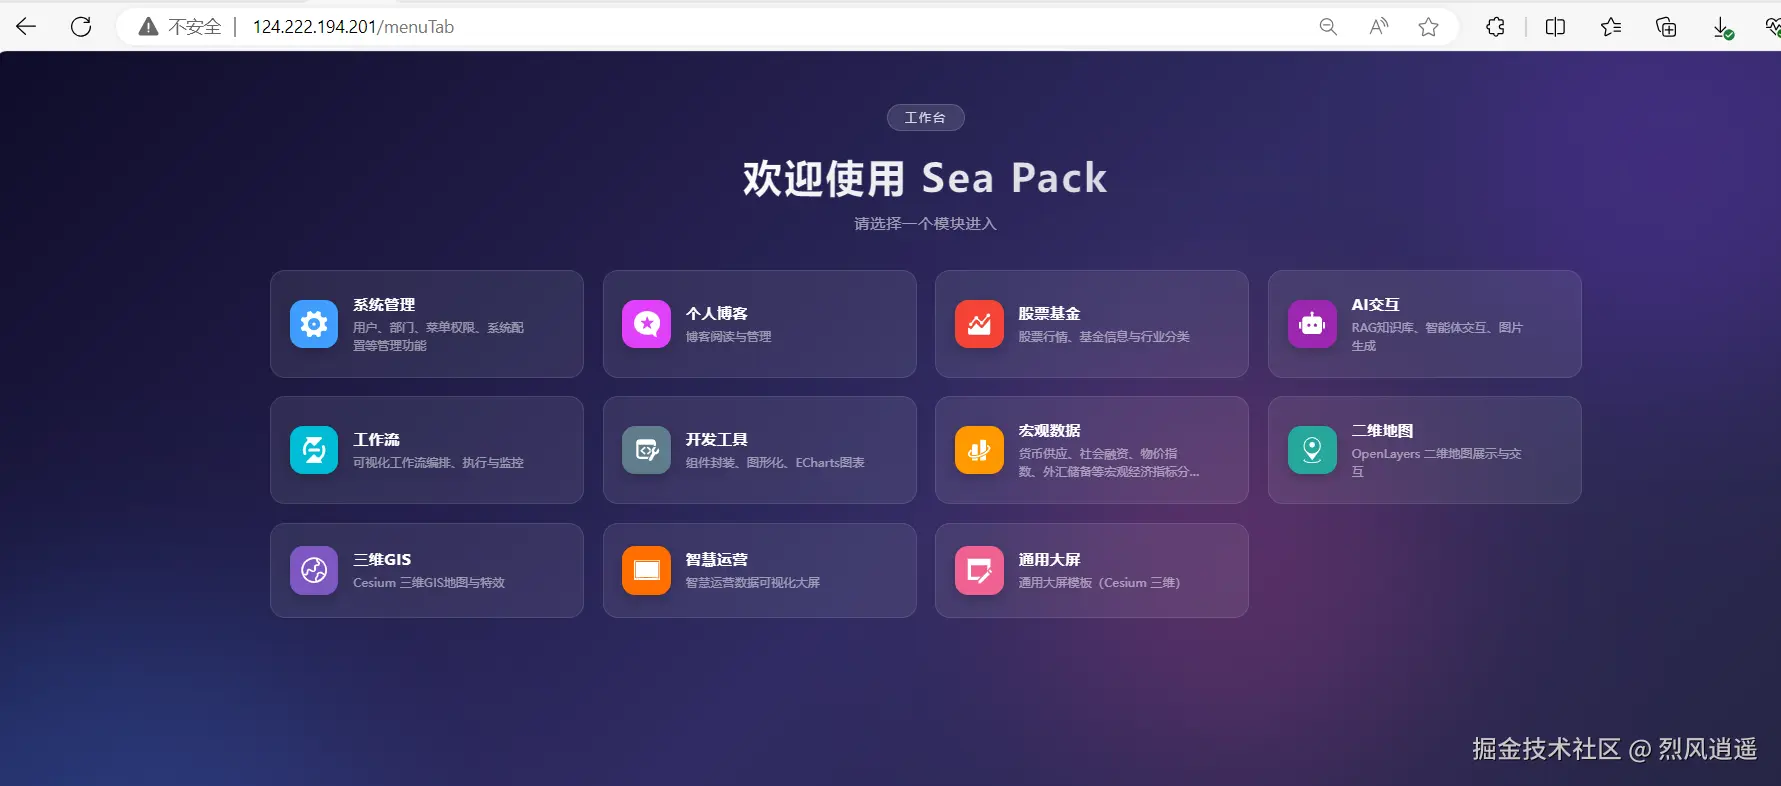
SeaPack 是什么? 简单来说,它是我独立开发的一个全栈 Web 应用。前端基于 Vue 3 + TypeScript,后端基于 Spring Boot 3 + Java 17,涵盖了 AI 智能体交互、GIS 地图可视化、宏观经济数据看板、可视化工作流、博客系统等多个模块。
为什么要做这个项目? 原因很朴素:我最初是想做点什么,想搞点自己的东西,把工作中用到的东西在自己的项目中积累下来。在工作中接触了点GIS三维地图,就在项目中做了一个GIS的基础模块。写博客总是发到别人的平台,想搞一个自己的博客。接触投资后将做一个股票系统方便信息搜集。AI火了后又想把AI集成在里面。
这篇文章主要分享系统的工具链配置、目录设计,编码约定以及整体设计。
访问地址 :http://124.222.194.201/
前端代码 :github.com/seapack-hub...
后端代码 :github.com/seapack-hub...
一、技术选型
选SeaPack 的完整技术栈:
| 层级 | 技术栈 | 版本 | 选择理由 |
|---|---|---|---|
| 前端框架 | Vue 3 + TypeScript | Vue 3.5 / TS 5.2 | 熟悉 Vue 生态,TypeScript 提供类型安全 |
| 构建工具 | Vite | 5.4 | 冷启动快,开发体验好 |
| UI 组件库 | Element Plus | 2.6 | 后台管理系统标配,生态成熟 |
| 样式方案 | UnoCSS | 0.65 | 原子化 CSS,写样式快,包体积小 |
| 状态管理 | Pinia | 2.1 | Vue 官方推荐,TypeScript 友好 |
| HTTP | Axios | 1.7 | 统一封装,拦截器处理错误 |
| 后端框架 | Spring Boot 3 + Java 17 | 3.2.5 | LTS 版本,长期维护 |
| ORM | MyBatis-Plus + PageHelper | 3.5.5 | 快速 CRUD + 分页 |
| AI 框架 | LangChain4j + ChromaDB | 0.35.0 | Java 生态的 AI 框架,支持 RAG |
| 数据库 | MySQL + Redis + Caffeine | --- | 三级缓存:本地 + 分布式 + 数据库 |
二、Vite + Vue 3 + TypeScript:搭建开发环境
2.1 为什么不用 Webpack
我之前做过的项目都用 Webpack,但每次 npm run dev 要等 30 秒以上,改个样式文件热更新也要等好几秒。Vite 的出现解决了这个问题:
- 冷启动:基于 ESM 的按需编译,启动时间从 30s+ 降到 2s 以内
- HMR:修改任意 Vue 组件后毫秒级热更新,改完立刻看到效果
- 原生 TS 支持:不需要额外的 loader 配置,开箱即用
2.2 Vite 核心配置
typescript
export default defineConfig(({ mode }: ConfigEnv) => {
  const viteEnv = loadEnv(mode, process.cwd());
  const isDev = mode === 'development'
  const isProd = mode === 'production'

  return {
    server: {
      host: true,          // 允许局域网 IP 访问(方便手机调试)
      port: 4444,
      proxy: {
        "/api": {
          target: viteEnv.VITE_APP_API_URL,  // 从 .env 读取
          ws: true,         // 支持 WebSocket(AI 流式对话用)
          changeOrigin: true,
          rewrite: (path) => path.replace(/^\/api/, ''),
        },
      }
    },
    build: {
      target: 'es2020',
      rollupOptions: {
        output: {
          manualChunks(id) {
            // Cesium 35MB+、ECharts、Element Plus 拆成独立 chunk
            if (id.includes('cesium')) return 'cesium'
            if (id.includes('echarts')) return 'echarts'
            if (id.includes('element-plus')) return 'element-plus'
            // ...
          }
        }
      }
    },
    esbuild: isProd ? { drop: ['console', 'debugger'] } : undefined,
  }
})
几个我觉得值得说的点:
host: true:不是为了给别人用,是为了自己调试。有时候在手机上看看页面效果,或者用另一台电脑访问局域网地址,这个配置很方便manualChunks:Cesium 一个包就有 35MB,如果不拆包,首屏加载会非常慢。拆开之后,用户第一次打开要加载,但后续访问会走缓存esbuild.drop:开发时console.log随便写,生产构建自动删掉,不用自己清理
2.3 自动导入
项目通过 unplugin-auto-import 和 unplugin-vue-components 实现了 Vue API 和 Element Plus 组件的自动导入:
typescript
AutoImport({
  resolvers: [ElementPlusResolver()],
  imports: ['vue', 'vue-router', '@vueuse/core'],
  dts: './auto-imports.d.ts',  // 自动生成类型声明文件
}),
Components({
  resolvers: [ElementPlusResolver()],
  dirs: ['src/components'],     // 自动注册全局组件
}),
效果是:在任意 .vue 文件中直接用 ref、computed、useRouter 等 API,不用写 import { ref, computed } from 'vue'。Element Plus 的组件也不用逐个注册。
2.4 多环境变量
bash
# .env.development ------ 本地开发
VITE_APP_API_URL=http://localhost:8090/
VITE_MOCK_DEV_SERVER=false

# .env.preview ------ 测试环境
VITE_APP_API_URL=http://你的测试服务器:8090/

# .env.production ------ 生产环境
VITE_BASE_API=/
VITE_MOCK_DEV_SERVER=false
启动时只需要切换 mode:vite --mode development 或 vite --mode production,环境变量自动切换。所有变量统一以 VITE_ 前缀命名,这样前端代码可以安全访问,而后端的数据库密码等敏感配置不会泄露到浏览器端。
三、ESLint + Prettier + Husky:代码规范
3.1 ESLint 9 Flat Config:配置清晰,规则明确
项目采用了 ESLint 9 的最新 Flat Config 格式,相比传统的 .eslintrc,配置更直观:
javascript
export default [
  // 忽略路径:构建产物、自动生成的类型文件
  { ignores: ['dist/**', 'components.d.ts', 'auto-imports.d.ts'] },

  // Vue 3 推荐规则
  ...pluginVue.configs['flat/recommended'],

  // Vue 专项:允许单单词组件名、不限制每行属性数
  {
    files: ['**/*.vue'],
    rules: {
      'vue/html-indent': ['error', 2],
      'vue/multi-word-component-names': 'off',
      'vue/max-attributes-per-line': 'off',
    },
  },

  // TypeScript:允许 any(项目中有些地方确实需要)
  {
    rules: {
      '@typescript-eslint/no-explicit-any': 'off',
      '@typescript-eslint/no-unused-vars': ['warn', { argsIgnorePattern: '^_' }],
    },
  },

  // 全局:console 和 debugger 给警告,不报错
  { rules: { 'no-console': 'warn', 'no-debugger': 'warn' } },
]
为什么不把 no-explicit-any 设成 error? 因为实际开发中,有些场景(比如第三方库的类型缺失、临时调试)确实需要 any。
3.2 Prettier:格式化
javascript
// .prettierrc.cjs
module.exports = {
  semi: true,            // 强制分号
  singleQuote: true,     // 单引号
  trailingComma: 'none', // 结尾无逗号
  printWidth: 120,       // 行宽 120(宽屏显示器友好)
  tabWidth: 2,           // 2 空格缩进
  endOfLine: 'auto'      // 自动识别换行符(Windows/Mac 不冲突)
}
endOfLine: 'auto' 是我在 Windows 上踩过坑之后加的。之前项目里 CRLF 和 LF 混在一起,每次 Git 提交都有一堆换行符变更,看着很烦。加了这个配置之后,Prettier 不会强制转换换行符,问题彻底解决。
3.3 Husky + lint-staged:提交时自动检查
bash
# .husky/pre-commit
npx lint-staged
json
"lint-staged": {
  "*.{vue,js,ts,tsx,jsx}": ["eslint --fix"],
  "*.{scss,css}": ["prettier --write"]
}
这套组合的工作流程是:每次 git commit 时,Husky 会触发 pre-commit 钩子,lint-staged 只对暂存区的文件执行 lint 和格式化。不是全量扫描,所以速度很快(1-2 秒),而且只处理你这次提交改的文件。
四、目录结构
4.1 整体结构
plain
seapack-template/
├── mock/                    # Mock 数据(后端没就绪时用)
├── src/
│   ├── api/                 # 接口层:按业务域拆分
│   ├── assets/              # 静态资源
│   ├── components/          # 通用组件
│   ├── config/              # 全局配置
│   ├── constants/           # 常量
│   ├── directives/          # 自定义指令
│   ├── hooks/               # 组合式函数
│   ├── layout/              # 布局系统
│   ├── locales/             # 国际化
│   ├── router/              # 路由
│   ├── store/               # Pinia 状态管理
│   ├── styles/              # 全局样式
│   ├── utils/               # 工具函数
│   ├── views/               # 页面视图
│   ├── main.ts              # 入口文件
│   └── App.vue              # 根组件
├── .env / .env.development / .env.production / .env.preview
├── eslint.config.js
├── .prettierrc.cjs
├── uno.config.ts
└── vite.config.ts
4.2 路由按业务域拆分
刚开始写项目时,我把所有路由都写在 router/index.ts 里,结果文件越来越长,找一个页面的路由要翻半天。后来拆成了按业务域独立文件:
plain
src/router/
├── index.ts                 # 路由主入口
├── modules/                 # 按业务域拆分
│   ├── systemManagement.ts  # 系统管理
│   ├── aiModule.ts          # AI 交互
│   ├── stockFund.ts         # 股票基金
│   ├── macroData.ts         # 宏观数据
│   ├── workflow.ts          # 工作流
│   ├── gis2d.ts             # 二维地图
│   ├── gis3d.ts             # 三维 GIS
│   ├── blogsManagement.ts   # 博客管理
│   ├── devTools.ts          # 开发工具
│   └── bigData.ts           # 大屏
└── plugins/                 # 路由插件系统
注册方式用了 import.meta.glob,自动扫描 router/modules/ 下的所有文件:
typescript
export function initAllRoutes() {
  const modules = import.meta.glob('@/router/modules/*.ts', { eager: true })
  Object.values(modules).forEach((mod: any) => {
    mod.default?.forEach((route: RouteRecordRaw) => {
      if (!router.hasRoute(route.name as string)) {
        router.addRoute(route)
      }
    })
  })
}
好处 :新增一个业务模块,只需要在 router/modules/ 下新建一个文件,不用改 index.ts。路由自动注册,侧边栏自动生成。
4.3 路由插件系统
Vue Router 的 beforeEach 守卫,如果写在一个文件里,很容易变成几百行的"大杂烩"------权限检查、进度条、日志记录全混在一起。所以我设计了一个轻量级的插件管理器:
typescript
// routerPluginManager.ts
class RouterPluginManager {
  private plugins: RouterPlugin[] = []

  register(plugin: RouterPlugin) {
    this.plugins.push(plugin)
    this.plugins.sort((a, b) => (a.priority ?? 99) - (b.priority ?? 99))
  }

  async runBeforeEach(context: RouterPluginContext) {
    for (const plugin of this.plugins) {
      const result = await plugin.beforeEach?.(context)
      if (result !== undefined) return result  // 有插件拦截就停止
    }
  }
}
使用时只需要注册插件:
typescript
routerPluginManager.register(permissionPlugin)  // 优先级 1,最先执行
routerPluginManager.register(progressPlugin)    // 优先级 99,默认
将来如果要加"路由访问日志"、"页面埋点"之类的功能,只需要实现一个 RouterPlugin 接口然后注册就行了,不用改已有的守卫代码。这是对个人开发者的长期投资------三个月后加新功能时,不用理解一堆耦合的逻辑。
4.4 接口层:按业务域 + 类型定义
plain
src/api/
├── ai/                    # AI 模块(14 个文件)
│   ├── agent.ts
│   ├── chatExecute.ts     # 统一 SSE 流式执行
│   ├── knowledgeBase.ts
│   ├── skill.ts
│   └── types/             # 独立的类型定义
│       ├── agent.ts
│       ├── knowledgeBase.ts
│       └── ...
├── blogs/
├── macroData/
│   ├── monetary/          # 货币供应
│   ├── financing/         # 社会融资
│   └── reserves/          # 外汇储备
├── stockFund/
├── system/
└── workflow/
每个 API 模块配套独立的 types/ 目录。接口的参数和返回值全部 TypeScript 类型化。
4.5 通用组件:封装一次,到处用
plain
src/components/
├── baseComponents/        # 基础业务组件(Sp 前缀 = SeaPack)
│   ├── SpTable/           # 增强表格
│   ├── SpDetailEditable/  # 详情/编辑双态组件
│   ├── SpDetailForm/      # 详情表单
│   ├── SpAction/          # 操作按钮组
│   ├── SpButtonPermission/# 带权限的按钮
│   ├── SpEmpty/           # 空状态占位
│   └── ...
├── AiAssistant/           # AI 助手浮窗
├── FilePreview/           # 文件预览
├── JsonEditor/            # JSON 编辑器
└── MarkdownRenderer/      # Markdown 渲染
通用组件统一用 Sp 前缀命名(Sp 是SeaPack 的简称)。这不是什么高深的设计,但它解决了一个很实际的问题:在代码里看到 <SpTable> 就知道是项目封装的表格组件,看到 <el-table> 就知道是 Element Plus 的原生组件。
五、前端其他设计
5.1 一键启动:克隆即跑
bash
git clone xxx
cd seapack-template
pnpm install    # 安装依赖
pnpm dev        # 启动开发服务器(端口 4444)
两行命令就能跑起来。背后的支撑是:
- pnpm workspace 配置了
allowBuilds白名单,避免某些包的 postinstall 脚本报错 - Vite 代理 自动转发
/api到后端,前端不用管跨域 - Mock 模式可以通过环境变量一键开启,后端没写好时也能独立开发前端
- 类型声明文件 (
auto-imports.d.ts、components.d.ts)提交到 Git,IDE 打开就有完整提示
5.2 模块化注册
当我想新加一个功能模块时,流程是这样的:
第一步 :在 config/modules.ts 填个表
typescript
{
  key: 'newModule',
  path: '/newModule/dashboard',
  title: '新模块',
  icon: 'new-icon',
  color: '#409EFF',
  description: '模块描述',
  permKey: 'newModule',
  entryRoutes: ['newModuleDashboard', 'newModuleList']
}
第二步 :在 router/modules/ 新建路由文件
typescript
export default [{
  path: '/newModule',
  name: 'newModule',
  component: () => import('@/layout/main/index.vue'),
  children: [
    { path: 'dashboard', name: 'newModuleDashboard', component: () => import('@/views/newModule/dashboard/index.vue') }
  ]
}]
第三步 :在 views/ 新建页面文件
完成。不用改 index.ts,不用改 main.ts,路由自动注册,侧边栏自动出现。
这种设计的核心思想是约定优于配置------只要遵守"文件放哪里"的约定,框架帮你搞定剩下的事。
5.3 按钮权限 v-permission
权限控制通过自定义指令 v-permission 实现,后续会详细介绍权限的实现过程:
vue
<!-- 拥有 'sys:user:add' 才显示 -->
<el-button v-permission="'sys:user:add'">新增用户</el-button>
<!-- 多个权限,任一匹配即可 -->
<el-button v-permission="['sys:user:add', 'sys:user:edit']">批量操作</el-button>
<!-- 无参数:始终显示 -->
<el-button>公开功能</el-button>
实现原理很简单:元素挂载时检查用户权限,无权限则直接从 DOM 移除(不是隐藏,是移除)。这个设计让我不用在每个页面写一堆 v-if="hasPermission('xxx')" 的判断代码。
5.4 缓存键隔离
typescript
const SYSTEM_NAME = 'SeaPack';

class CacheKey {
  static readonly TOKEN = `${SYSTEM_NAME}-token-key`;
  static readonly AUTH_CACHE = `${SYSTEM_NAME}-auth-cache`;
  // ...
}
所有 localStorage/sessionStorage 的键名统一加 SeaPack- 前缀。这解决了一个很实际的问题:我本地同时跑着开发环境和测试环境的前端,两个页面的 localStorage 不会互相覆盖。之前没做这个隔离时,经常遇到"明明登录了,刷新一下又跳回登录页"的问题,查了半天才发现是 localStorage 被另一个环境覆盖了。
5.5 Axios 封装
typescript
// utils/axios.ts
const Axios = axios.create({
  baseURL: import.meta.env.VITE_BASE_API,
  timeout: 30000,
});

// 请求拦截器:自动注入 Token
// 响应拦截器:
//   - 200 → 自动剥离 { code, message, data } 外层,直接返回 data
//   - 401 → 清除登录状态 + 跳转登录页
//   - 其他 → 弹出错误提示 + reject
写接口调用时,代码极其简洁:
typescript
const users = await UserAPI.getList(params)
// 直接拿到 data,不用管 status code,不用 catch 错误提示
六、后端:Spring Boot 3 的工程化实践
前端聊完了,来说说后端。后端的思路其实和前端一样------按业务域拆分、统一封装、约定优于配置 。但后端有一些前端没有的课题:认证鉴权、全局异常处理、缓存策略、AI 流式通信,这些都需要在项目初期就设计好。
6.1 项目结构
后端基于 Spring Boot 3 + Java 17,目录结构和前端保持了高度一致的对称性:
plain
src/main/java/org/seaPack/
├── config/              # 全局配置(安全、缓存、AI、异常处理)
├── controller/          # 按业务域拆分(59 个文件)
│   ├── ai/              # AI 相关(13 个)
│   ├── auth/            # 认证鉴权
│   ├── blog/            # 博客
│   ├── finance/         # 金融数据
│   ├── macro/           # 宏观经济
│   ├── market/          # 行情数据
│   ├── system/          # 系统管理
│   └── workflow/        # 工作流
├── service/             # 业务逻辑层(82 个文件)
├── mapper/              # MyBatis 映射层
├── model/               # 实体类(62 个文件)
├── dto/                 # 数据传输对象(48 个文件)
└── components/          # 工具组件
注意到后端的 controller、service、model、dto 也是按业务域拆分的------和前端的 api/ai/、views/aiModule/ 对应。
6.2 统一响应体
后端所有接口统一返回 Result<T> 格式:
java
public class Result<T> {
    private int code;   // 状态码:200 成功,500 错误
    private String msg;  // 提示信息
    private T data;      // 业务数据

    public static <T> Result<T> success(T data) {
        return new Result<>(200, "成功", data);
    }

    public static <T> Result<T> error(String msg) {
        return new Result<>(500, msg, null);
    }
}
更关键的是 GlobalResponseHandler------一个 @RestControllerAdvice,自动把 Controller 的返回值包装成 Result:
java
@RestControllerAdvice
public class GlobalResponseHandler implements ResponseBodyAdvice<Object> {
    @Override
    public Object beforeBodyWrite(Object body, ...) {
        if (body instanceof String) {
            return JSON.toJSONString(Result.success(body));
        }
        return Result.success(body);
    }
}
效果 :Controller 里直接返回业务对象就行,不用每个方法都包一层 Result.success():
java
// 不用写 return Result.success(userService.getById(id));
// 直接返回对象,GlobalResponseHandler 自动包装
@GetMapping("/user/{id}")
public User getUser(@PathVariable Long id) {
    return userService.getById(id);
}
这个设计和前端 Axios 拦截器是配套的------后端统一包装 **<font style="color:#DF2A3F;">{ code, msg, data }</font>**,前端拦截器自动剥离****。
6.3 全局异常处理:错误不会泄露堆栈
GlobalExceptionHandler 捕获所有异常,返回标准化错误响应:
java
@ControllerAdvice
public class GlobalExceptionHandler {

    // 业务异常:返回自定义错误码和消息
    @ExceptionHandler(BusinessException.class)
    public Result<Void> handleBusinessException(BusinessException e) {
        return Result.error(e.getCode(), e.getMessage());
    }

    // 第三方接口调用失败:返回友好提示,不暴露内部地址
    @ExceptionHandler(RestClientException.class)
    public Result<Void> handleRestClientException(RestClientException e) {
        return Result.error(502, "股票数据服务暂时不可用,请稍后重试");
    }

    // 参数校验失败:返回具体哪个字段有问题
    @ExceptionHandler(MethodArgumentNotValidException.class)
    public Result<Void> handleValidationException(MethodArgumentNotValidException e) {
        String errorMsg = e.getBindingResult().getFieldError().getDefaultMessage();
        return Result.error(400, errorMsg);
    }

    // 兜底:所有未处理的异常都走这里
    @ExceptionHandler(Exception.class)
    public Result<Void> handleException(Exception e) {
        log.error("系统内部异常:", e);  // 只记录日志,不暴露给前端
        return Result.error(500, "服务繁忙,请稍后重试");
    }
}
为什么这个很重要? 之前做项目时遇到过一个问题:后端报了 500 错误,但前端只显示"服务器内部错误",查了半天才发现是空指针异常。GlobalExceptionHandler 的设计让每种异常都有对应的处理策略,既不让前端看到堆栈信息(安全问题),又能给出有用的提示信息。
6.4 Spring Security + JWT:认证鉴权全链路
认证是后端最复杂的部分之一,我设计了完整的链路:
登录流程:
- 前端用 RSA 公钥加密密码(传输安全)
- 后端用 RSA 私钥解密,BCrypt 校验密码
- 校验通过后签发 JWT Token(24 小时有效期)
- 前端存储 Token,后续请求携带
Authorization: Bearer xxx
JWT 过滤器:在请求到达 Controller 之前完成 Token 校验
java
@Component
public class JwtAuthenticationFilter extends OncePerRequestFilter {
    @Override
    protected void doFilterInternal(HttpServletRequest request, ...) {
        String token = resolveToken(request);  // 从 Header 提取 Token
        if (token != null && !jwtUtil.isTokenExpired(token)) {
            Claims claims = jwtUtil.parseToken(token);
            Long userId = claims.get("userId", Long.class);
            // 将用户信息写入 SecurityContext,后续 Controller 可直接获取
            SecurityContextHolder.getContext().setAuthentication(authentication);
        }
        filterChain.doFilter(request, response);
    }
}
Security 配置:公开接口放行,其他接口必须携带有效 Token
java
http.authorizeHttpRequests(auth -> auth
    .requestMatchers("/auth/login", "/auth/captcha/**", "/auth/rsa/**").permitAll()
    .anyRequest().authenticated()  // 其他接口都要认证
)
.addFilterBefore(jwtAuthenticationFilter, UsernamePasswordAuthenticationFilter.class);
为什么不用 Session? 因为前后端分离架构下,前端是静态文件部署,后端是 API 服务,两边不共享 Session。JWT 无状态认证天然适合这种场景------Token 存在前端,后端只负责校验,不需要维护会话状态。
6.5 AI 架构:多 Provider 切换 + SSE 流式通信
AI 模块是项目最有技术深度的部分,后端用 LangChain4j 框架实现,支持多个 AI Provider 动态切换:
java
// AIProperties.java ------ 从配置文件读取 AI Provider 信息
@ConfigurationProperties(prefix = "ai")
public class AIProperties {
    private String activeProvider;           // 当前激活的 Provider(如 mimo、deepseek)
    private String embeddingProvider;        // 向量化 Provider(可能和聊天 Provider 不同)
    private Map<String, ProviderConfig> providers;  // 所有 Provider 的配置
}
配置文件中声明了三个 Provider:
properties
# 当前使用哪个 Provider,改一行就能切换
ai.active-provider=mimo
ai.embedding-provider=aliyun

# 每个 Provider 的配置
ai.providers.deepseek.api-key=xxx
ai.providers.deepseek.base-url=https://api.deepseek.com/v1
ai.providers.deepseek.chat-model=deepseek-v4-flash

ai.providers.aliyun.base-url=https://dashscope.aliyuncs.com/compatible-mode/v1
ai.providers.aliyun.chat-model=qwen-plus

ai.providers.mimo.base-url=https://api.xiaomimimo.com/v1
ai.providers.mimo.chat-model=mimo-v2.5
切换 Provider 只需要改一行配置 ,不用改任何 Java 代码。这在实际开发中非常有用------DeepSeek 的 API 偶尔会限流,我切到阿里云或 MiMo 只需要改 ai.active-provider 的值。
SSE 流式通信是 AI 对话的核心体验。后端通过 SSE(Server-Sent Events)逐字推送 AI 的回复,前端即时渲染,用户看到的是"打字机效果"而不是等几秒后一次性返回。为了不阻塞 Servlet 容器线程,专门配置了异步线程池:
java
@Bean("sseExecutor")
public Executor sseExecutor() {
    ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
    int cores = Runtime.getRuntime().availableProcessors();
    executor.setCorePoolSize(cores);
    executor.setMaxPoolSize(Math.max(cores * 2, 16));
    executor.setQueueCapacity(100);
    executor.setThreadNamePrefix("sse-");
    return executor;
}
6.6 缓存策略:Caffeine 本地缓存
后端用 Caffeine 做本地缓存,按业务场景配置不同的过期策略:
java
@Bean
public CacheManager cacheManager() {
    CaffeineCacheManager cacheManager = new CaffeineCacheManager();

    // 行业树缓存:最大 100 条,1 小时过期
    cacheManager.registerCustomCache("industryTree",
        Caffeine.newBuilder().maximumSize(100)
                .expireAfterWrite(1, TimeUnit.HOURS).build());

    // 股票历史 K 线缓存:最大 10000 条,1 小时过期
    cacheManager.registerCustomCache("stockHistory",
        Caffeine.newBuilder().maximumSize(10000)
                .expireAfterWrite(1, TimeUnit.HOURS).build());

    return cacheManager;
}
为什么用 Caffeine 而不是 Redis? 行业树、K 线这些数据更新频率低、查询频率高,放在本地缓存里访问速度是微秒级的,比 Redis 的毫秒级快两个数量级。而且这些数据每个用户看到的都一样,不需要跨实例共享。
6.7 数据库层:MyBatis-Plus + PageHelper
数据库层用了 MyBatis-Plus 做 ORM,PageHelper 做分页:
properties
mybatis.mapper-locations=classpath:mapper/**/*.xml
mybatis.configuration.map-underscore-to-camel-case=true  # 下划线自动转驼峰
pagehelper.helper-dialect=mysql
pagehelper.reasonable=true  # 页码超出范围自动修正
SQL 写在 XML 文件里(resources/mapper/),共 62 个 Mapper XML,按业务域拆分。为什么不用 MyBatis-Plus 的注解写 SQL?因为复杂的查询(多表 JOIN、动态条件)用 XML 写更清晰,调试也更方便。
6.8 后端工程规范小结
| 机制 | 解决的问题 | 优势 |
|---|---|---|
| 统一 Result 响应体 | 前后端格式不一致 | 前端 Axios 拦截器直接剥离,业务代码无感知 |
| GlobalExceptionHandler | 错误堆栈泄露 | 每种异常有对应处理,前端只看到友好提示 |
| JWT 无状态认证 | 前后端分离的会话管理 | 不用维护 Session,天然支持多实例部署 |
| AI Provider 动态切换 | 服务商限流 / 成本优化 | 改一行配置就能切换,不用改代码 |
| Caffeine 本地缓存 | 热点数据查询性能 | 微秒级访问,比 Redis 快两个数量级 |
| 异步线程池 | SSE 流式通信阻塞 | AI 对话不阻塞主线程,多用户并发不卡顿 |
| Mapper XML | 复杂 SQL 可读性 | 多表 JOIN 写在 XML 里比注解清晰得多 |
七、总结
| 配置 | 解决的问题 | 我的体会 |
|---|---|---|
| Vite + ESM | 启动慢、热更新卡 | 写代码的流畅度直接拉满 |
| 自动导入 | 重复 import | 代码更干净,少了很多无用 import |
| ESLint Flat Config | 规则混乱 | 配置一目了然,不用翻文档 |
| Husky + lint-staged | 格式不统一 | 提交时自动修复,省心 |
| 模块化路由 | 加页面要改多个文件 | 新建一个文件就行,零配置 |
| 路由插件系统 | 守卫逻辑一坨 | 每个职责独立,好维护 |
| 缓存键隔离 | 多环境数据冲突 | 再也不用排查"为什么又跳登录页了" |
| v-permission | 权限代码散落 | 一行搞定,模板里不用写 v-if |
| Axios 封装 | 错误处理重复写 | 业务代码只管拿数据 |
| 统一 Result 响应体 | 前后端格式不一致 | 前端拦截器自动剥离,业务无感知 |
| GlobalExceptionHandler | 错误堆栈泄露 | 每种异常有对应处理,前端只看友好提示 |
| JWT 无状态认证 | 前后端分离的会话管理 | 不用维护 Session,天然支持多实例 |
| AI Provider 动态切换 | 服务商限流/成本优化 | 改一行配置就能切换,不用改代码 |
| Caffeine 本地缓存 | 热点数据查询性能 | 微秒级访问,比 Redis 快两个数量级 |
工程规范不是给团队看的,是给未来的自己看的。 当你三个月后回来改代码时,规范的目录结构、清晰的命名约定、自动化的工具链,会让你的维护成本低很多。
一个人开发最怕的不是代码量大,而是代码量大了之后自己都看不懂。这些工程化实践,本质上是在帮"未来的自己"降低理解成本。
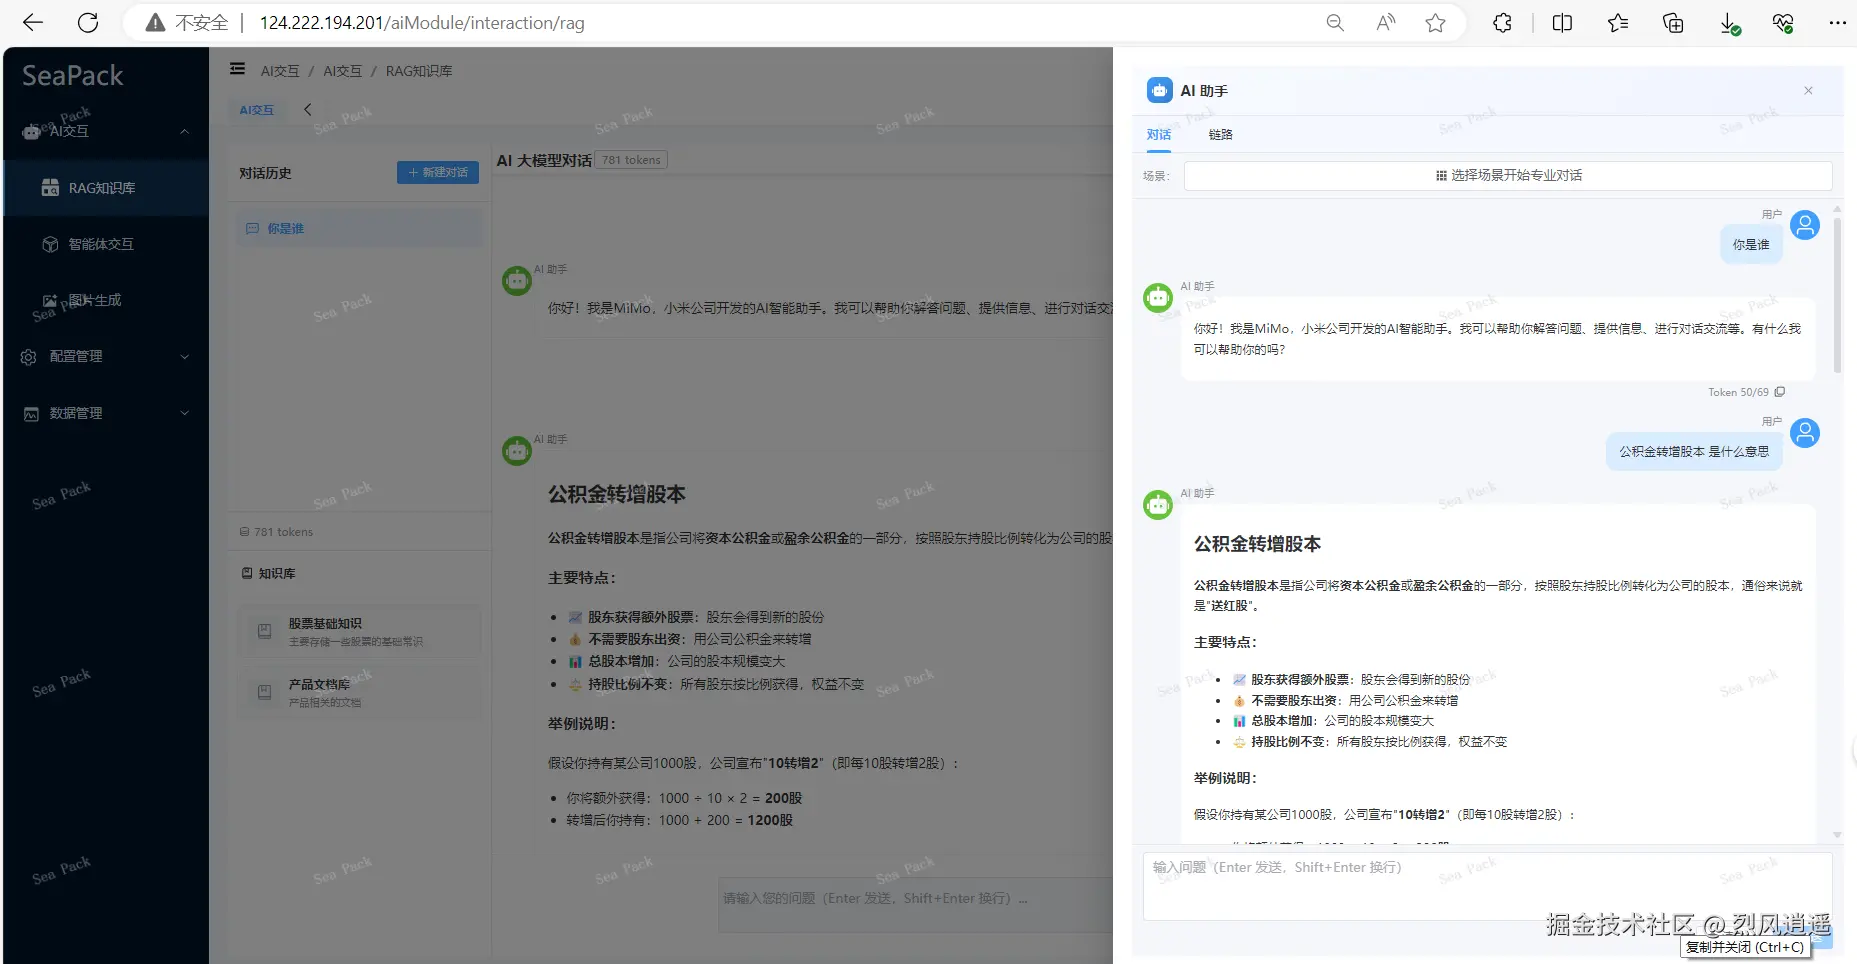
八、界面展示
主界面
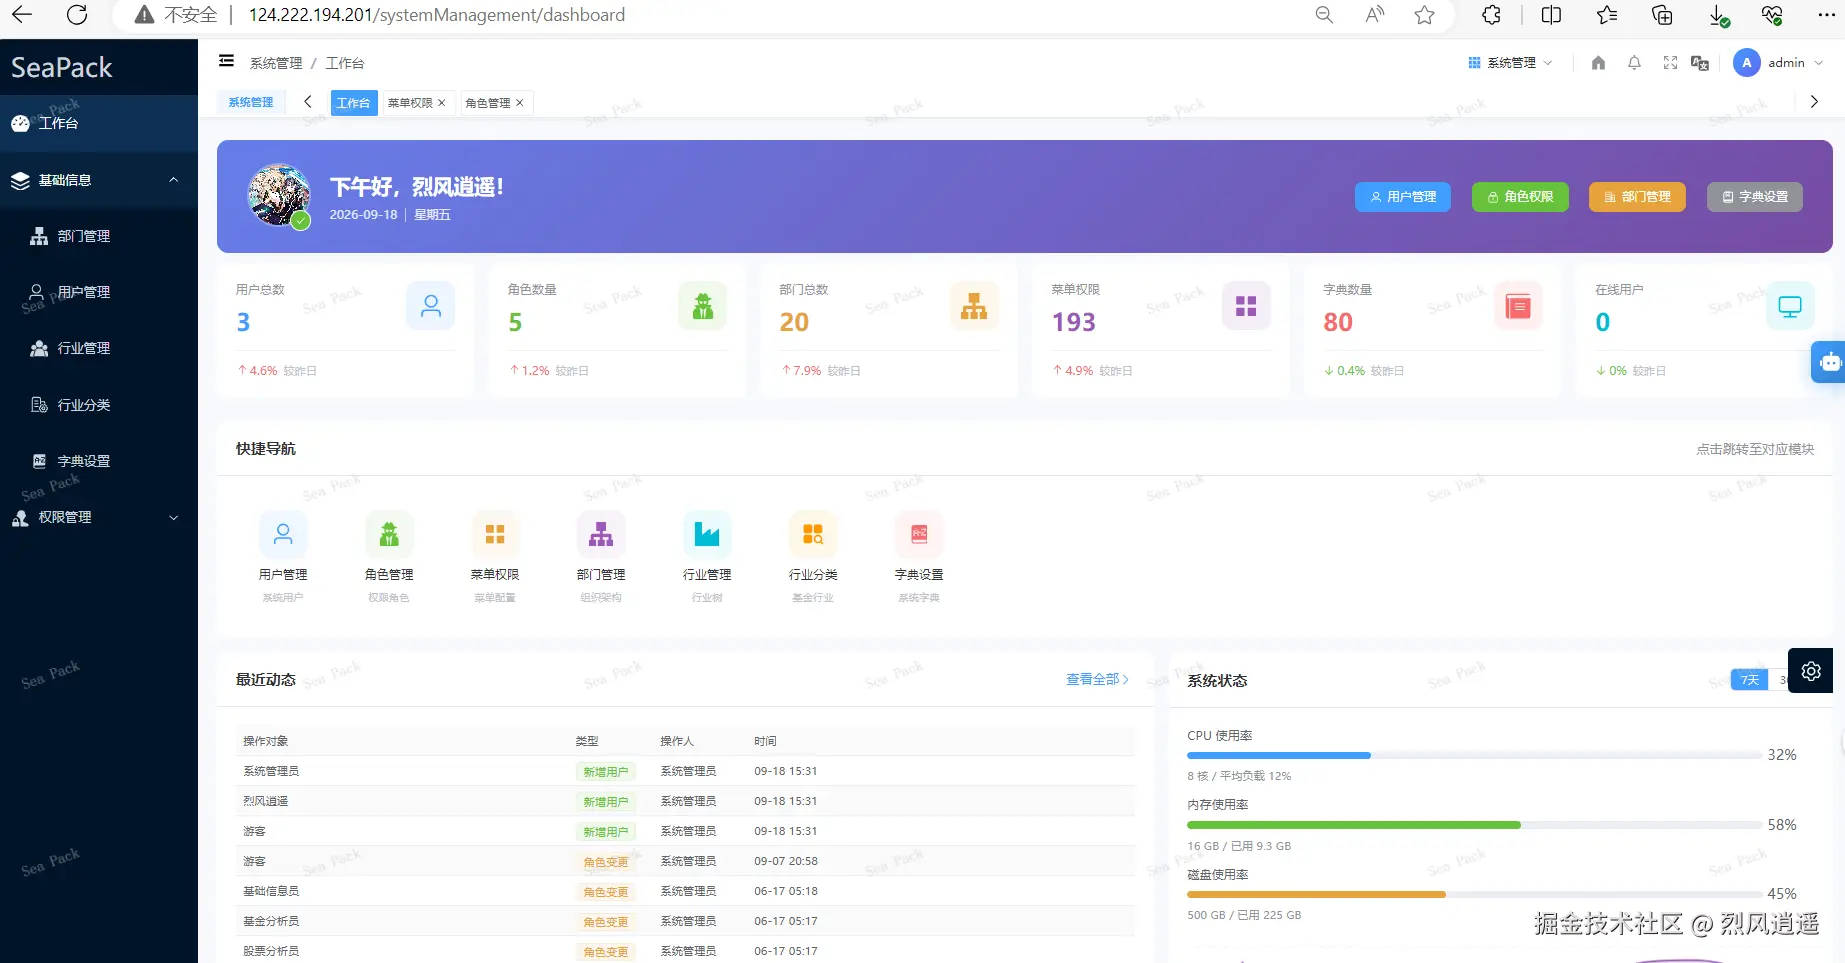
系统管理
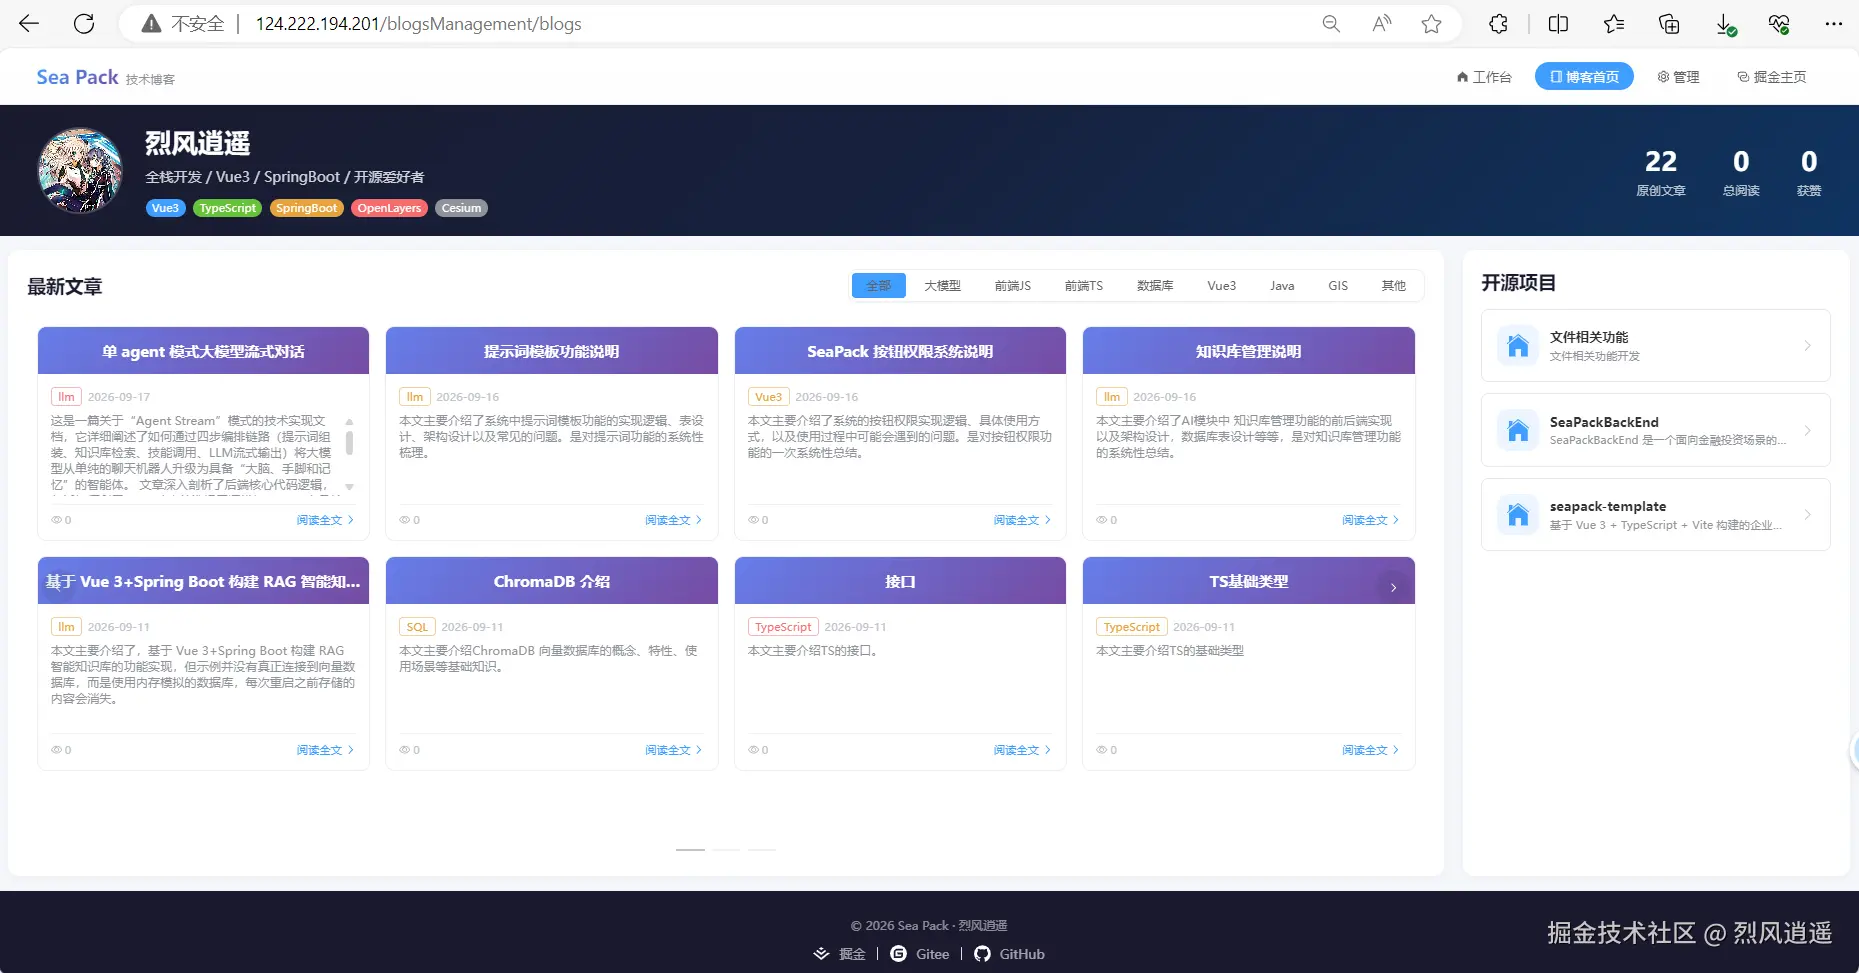
个人博客
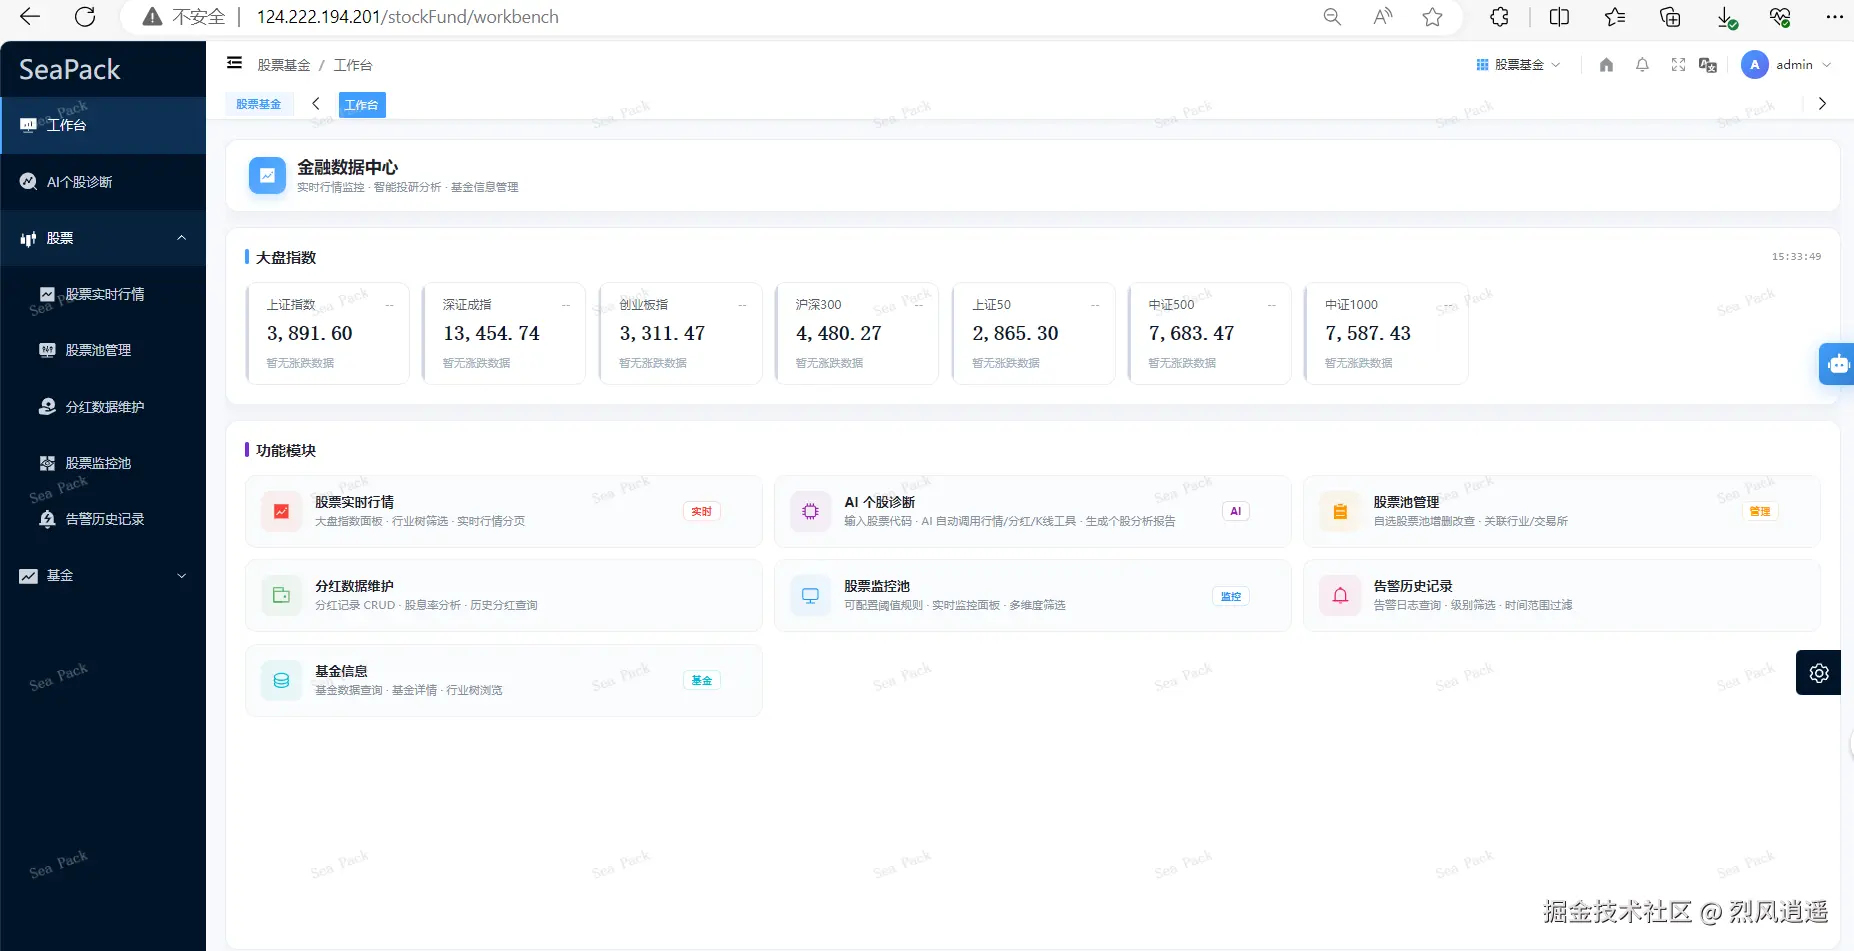
股票模块
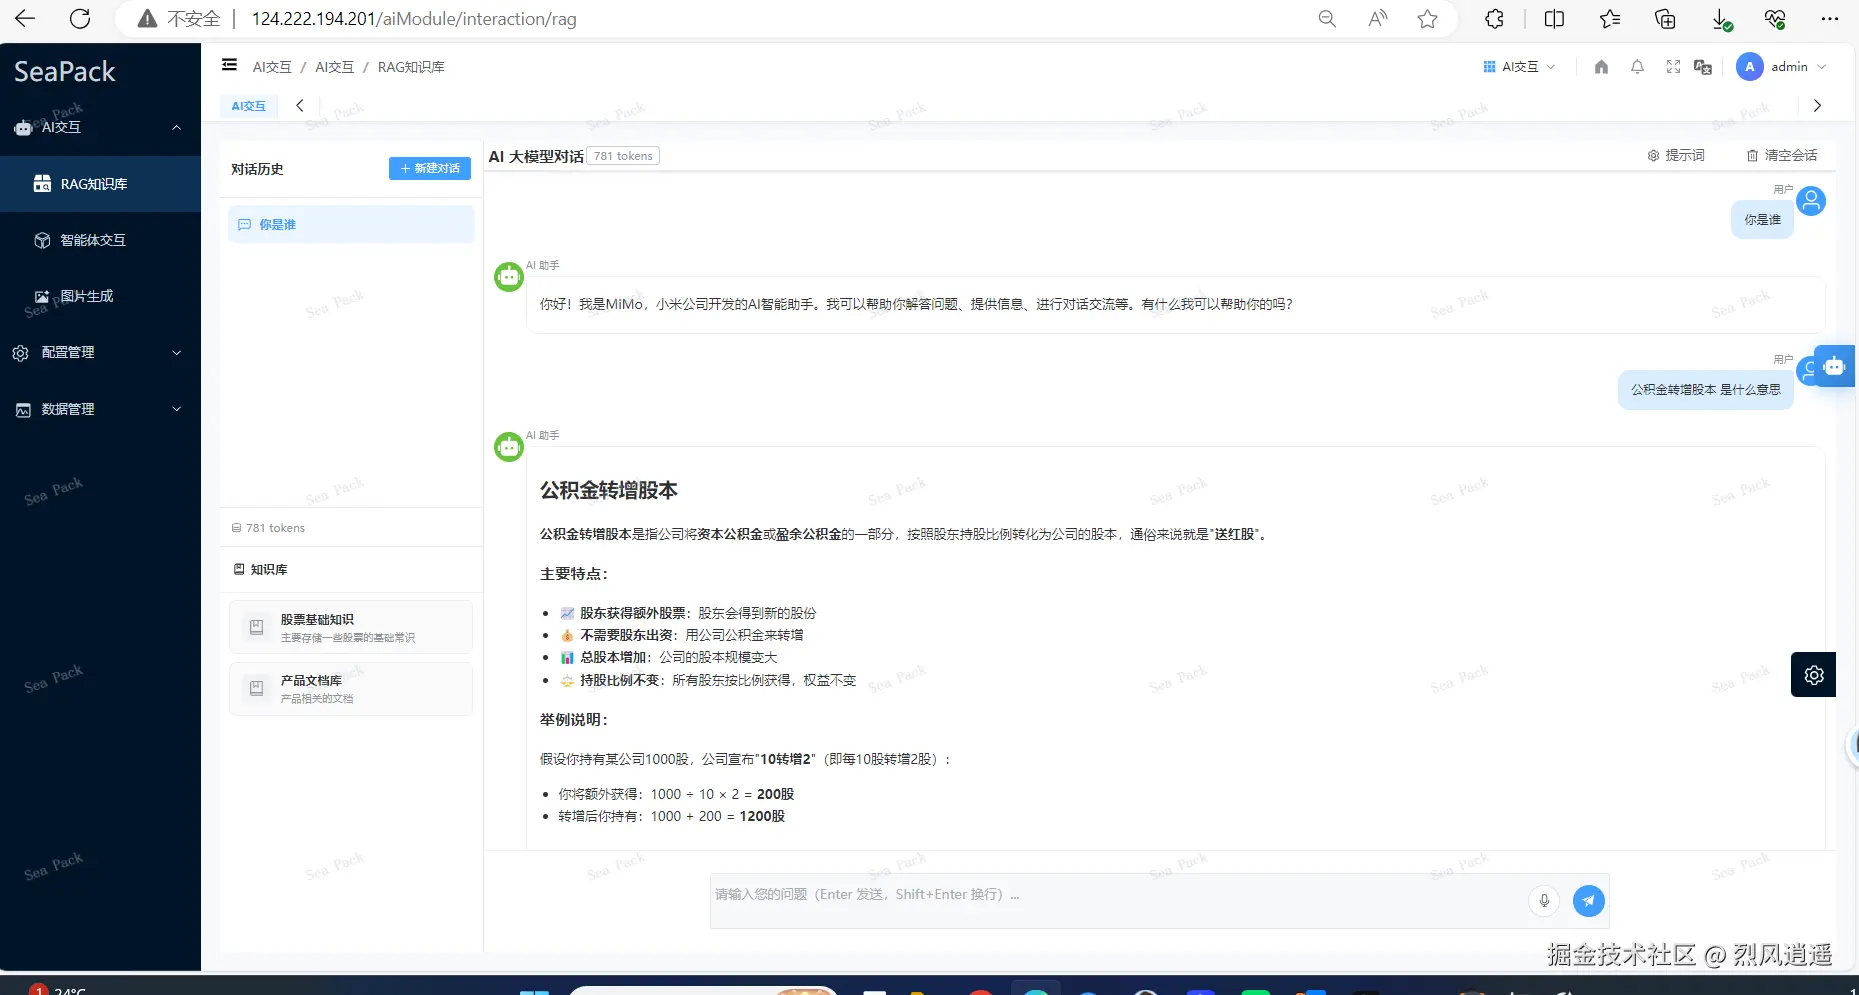
AI模块
全局AI助手