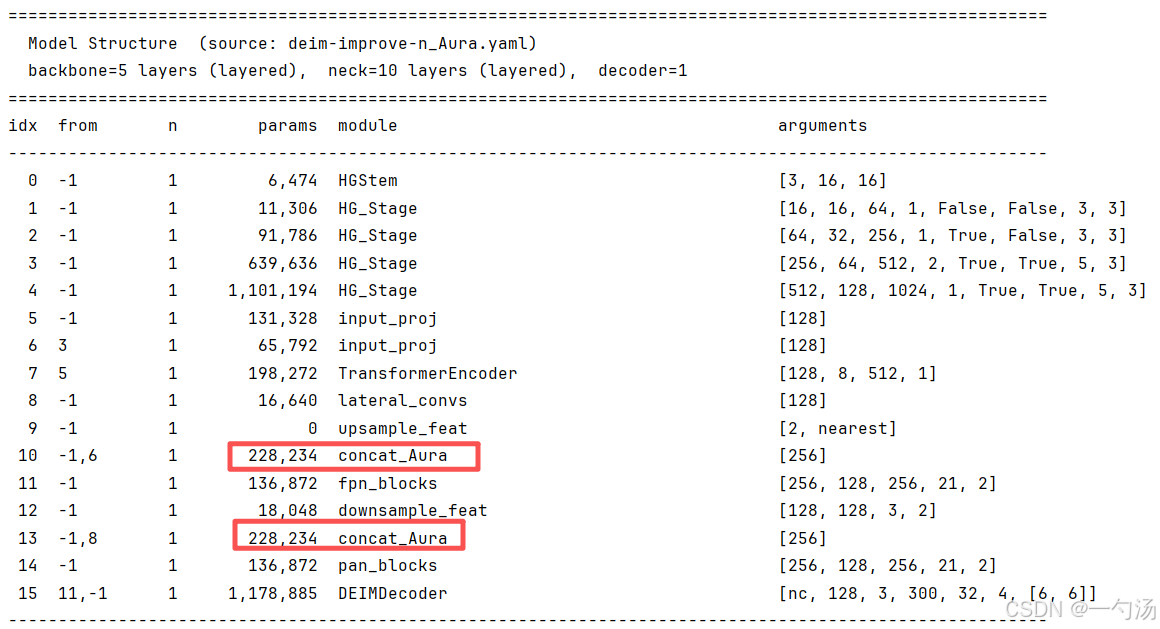
DEIM 的 FPN 用 concat 把上采样后的深层特征与浅层特征拼在一起,原始实现只是 torch.cat(xs, 1)------两路特征零交互,深层语义与浅层细节"各说各话",融合权重固定 50/50。针对这个被每级融合共用的节点,我们做了可即插即用的 Fuse_* 替换变体,覆盖"交叉注意力、自适应加权、注意力重标定、频域/结构相似增强"四类思路,全部保持输出通道与 concat 一致、一行 yaml 切换。本文给出完整变体清单与分组逻辑,重点拆解自研的 Aura(气息感知交叉注意力)。
0. 开场:concat是谁,它在哪
接上篇。特征是这么流动的:lateral_convs 投影 → upsample_feat 放大 → concat 拼接 → fpn_blocks 融合。前面几篇把"源头、咽喉、上采样"都修过了,现在轮到真正的融合动作本身 。在 DEIM 里,concat 是 FPN 每一级的核心节点:Y4 = fpn_blocks(concat(X4', upsample(Y5)))。它的输入永远是两路------一路是浅层细节(lateral 投影后),一路是深层语义(上采样后),输出通道 = 两路之和。原始实现朴素到极致:torch.cat(xs, dim=1),把两路特征沿通道方向堆叠,没有任何参数、没有任何交互。
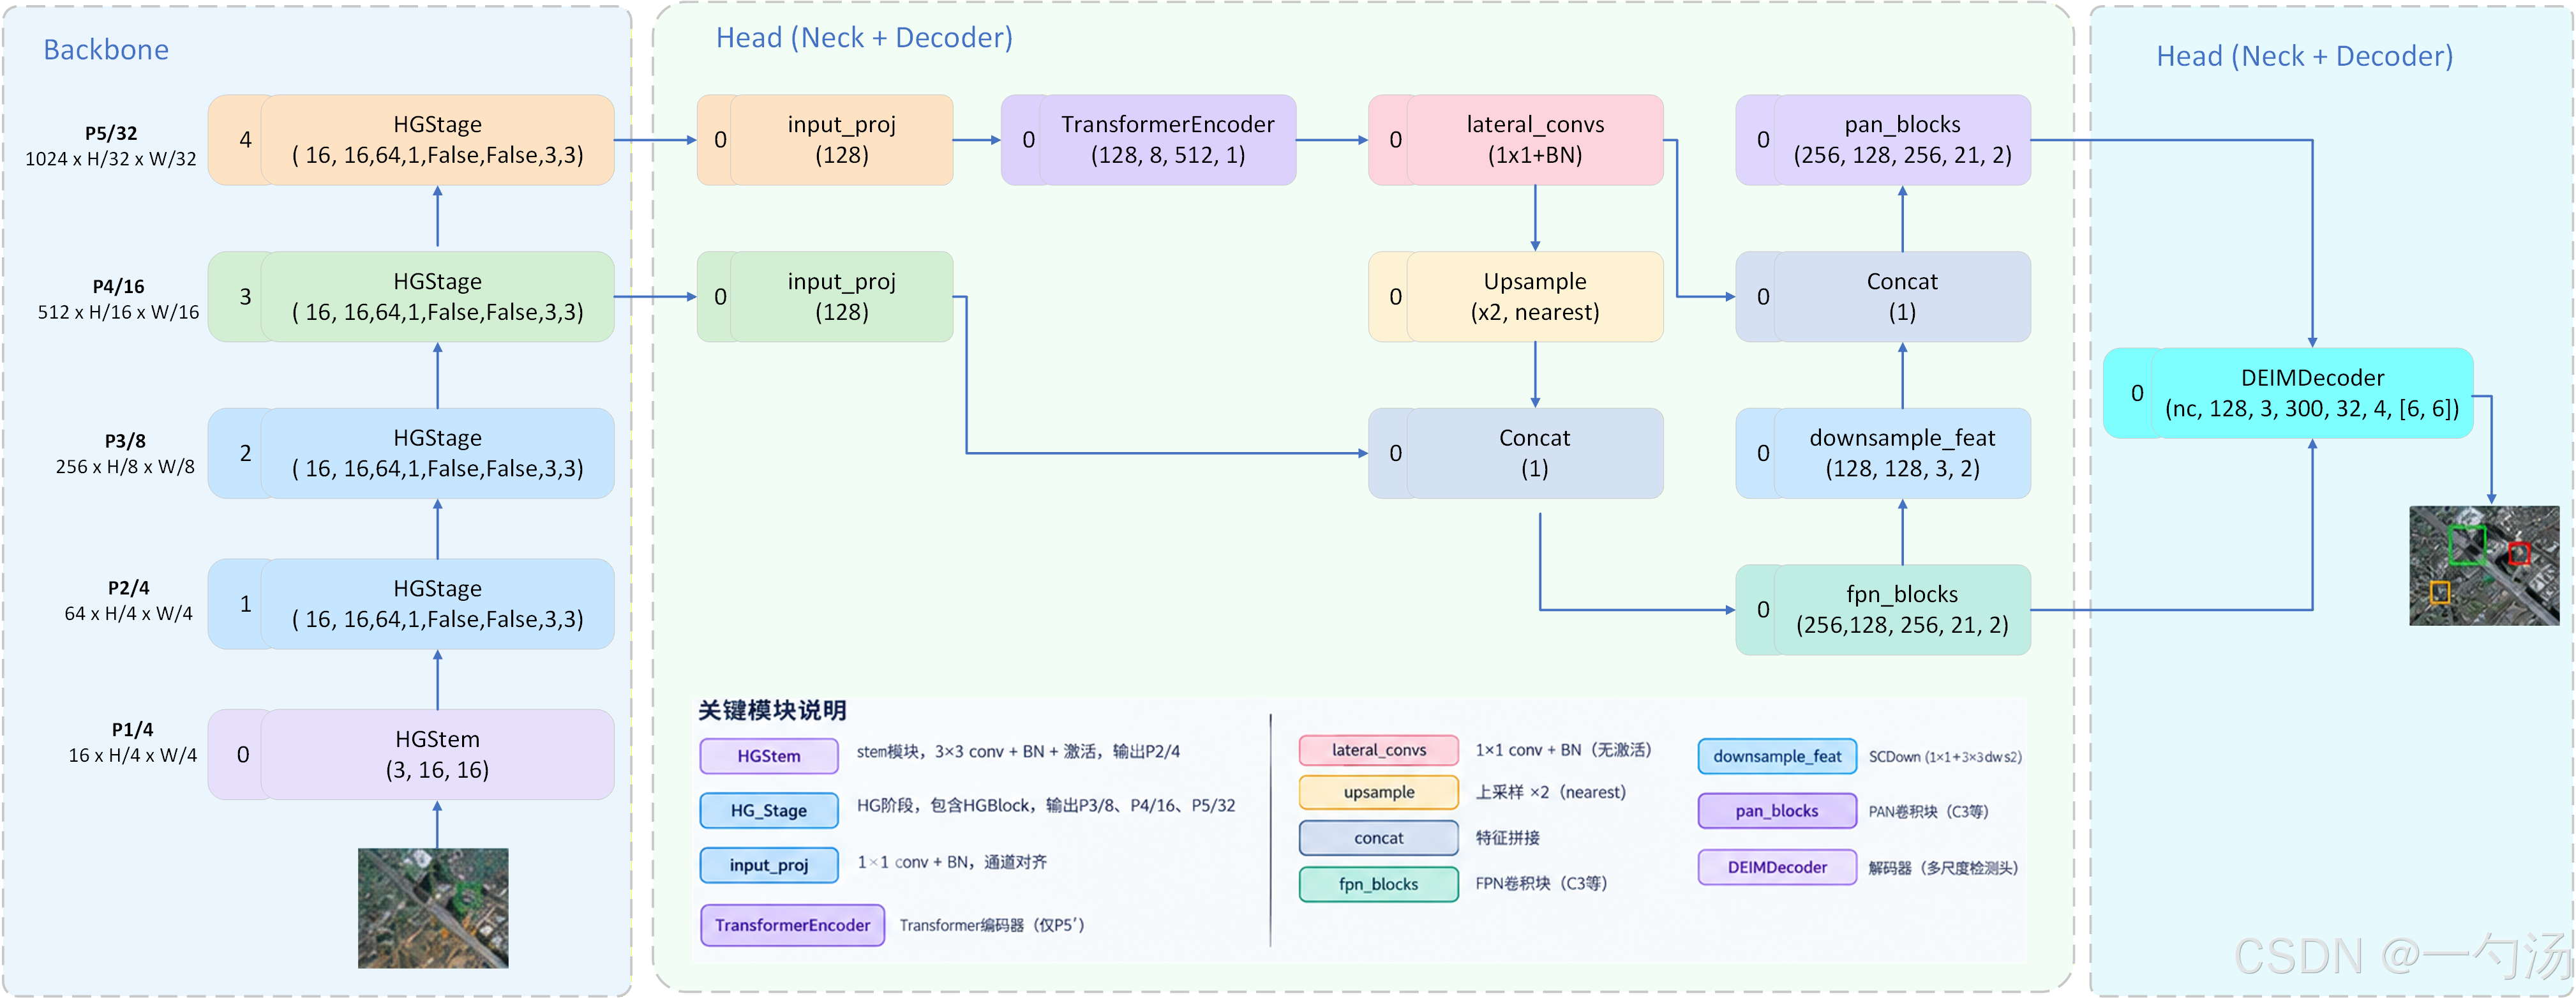
1. 现有的concat有什么问题
先看它做的事:两路各 c//2 通道拼成 c 通道。问题在于"它只是堆叠":
| 问题 | 机制原因 | 可观测后果 |
|---|---|---|
| 两路零交互 | cat 沿通道堆叠,深层特征与浅层特征之间不发生任何信息交换 | 语义信号与细节信号"各说各话",互补性没有被利用 |
| 融合权重固定 | 两路重要性是硬编码的 50/50,与内容无关 | 某些位置浅层细节更关键、某些位置深层语义更关键,concat 无法区分 |
| 通道冗余 | 拼接后通道翻倍,大量通道信息重叠,冗余留给下游融合块去消除 | 融合块需要更多容量消化冗余,收敛变慢 |
| 分布冲突 | 上采样后的深层特征与浅层特征数值分布不一致,直接拼接引入冲突 | 融合时强信号通道主导,弱信号(【细分场景】)被淹没 |
一句话总结:concat 是所有融合路径共用的节点,却只有"堆叠"这一个动作------它把"怎么融合"这个最重要的决策,完全甩给了下游 fpn_blocks。
2. concat可以往哪些方向改进
"拼接"这件事可以从四个层面升级,这也是我们最终落地的四个分组:
| 方向 | 思路 | 代表变体 | 优点 | 代价 |
|---|---|---|---|---|
| 交叉注意力 | 让两路特征互相"看"对方,再决定融合 | Aura、DAAFM、CMA、CVIM、MCA | 信息交互最充分,直击"零交互" | 参数与计算量最大 |
| 自适应加权/门控 | 用可学习权重决定两路怎么混合 | DPCF、DPCF_v2、MFM、mdfm、DFF、MEEM | 参数适中、机理直观 | 交互深度有限 |
| 注意力重标定 | 先对两路做通道/空间调制,再融合 | CSDF、HFFE、HDCAF、CAFR、CSFblock、HAFB、MASAG | 复用成熟注意力,稳定 | 偏"调制"而非"交互" |
| 频域/结构相似增强 | 从频带/局部结构相似度角度融合 | EFC、ResonanceFusion、FEFM、FFAFusion、SAFG | 角度独特,补充前两类盲区 | 实现复杂度高 |
四路共同点:都保持输出通道与 concat 完全一致(c),输入两路各 c//2,drop-in 替换 yaml 里的 concat 一行。
3. concat是如何改进的
concat 的替换变体共 23 个 ,全部通过 concat_<X> 通用前缀自动装配(输入 [x_lateral, y_upsampled],输出 c):
3.1 交叉注意力组------两路互相"看"
| 变体 | 核心机制 |
|---|---|
| Aura(自研) | 链式锚点交叉注意力:先聚合两路成"气息"锚点,再经两级注意力把气息反哺回特征(详见第 4 节) |
| DAAFM | 双模态注意力块:LN → 交叉注意力 → FFN 的完整 Transformer 式融合 |
| CMA | 通道对齐后交叉注意力,γ 可学习缩放融合结果 |
| CVIM | 左右适配器对齐 + 交叉注意力(scale 按输出维归一化) |
| MCA | 温度可学习的交叉注意力,深度可分离 QKV 控制开销 |
3.2 自适应加权/门控组------权重可学
| 变体 | 核心机制 |
|---|---|
| DPCF | AdaptiveCombiner:可学习 d 生成 sigmoid 边注意,两路加权后再分 4 块分别组合 |
| DPCF_v2 | 深度可分离卷积版的 DPCF |
| MFM | 通道对齐 + 通道注意力(MLP 门控)决定两路权重 |
| mdfm | 多尺度特征融合(MSFF 多尺度分支 + 对齐融合) |
| DFF | 对齐后全局池化 → 注意力门控 → 加权融合 |
| MEEM | 多头通道激励:sigmoid 激励 × 多分支 mid_conv |
3.3 注意力重标定组------先调制再融合
| 变体 | 核心机制 |
|---|---|
| CSDF | 空间注意力 + 深度可分离卷积 + DenseASPP(3/5/7 多空洞率)+ 通道注意力 |
| HFFE | 坐标注意力 + 空间注意力 + 高低频门控 |
| HDCAF | 高低频双通道注意力(下采样 + 全局池化 + fc_low/fc_high) |
| CAFR | 通道注意力重标定(下采样 + 双路 fc) |
| CSFblock | 全局池化 + 分层通道选择 |
| HAFB | 分层注意力融合块(PatchAttention 局部/全局 × 深浅两路 + SE + RepConv) |
| MASAG | 多尺度门控注意力(全局提取 + 局部上下文提取 + 门控选择) |
3.4 频域/结构相似增强组------换个角度看融合
| 变体 | 核心机制 |
|---|---|
| EFC | 高效频带融合(1×1/3×3/5×5 多频带卷积 + BN) |
| ResonanceFusion | 双场共振聚合 + 梯度感知纹理细化 + 交叉互惠门控 |
| FEFM | 频率增强融合(point+depth QKV + α/λ 可学习系数) |
| FFAFusion | 频率自适应注意力(低秩投影 + 窗口相似度 + layer_scale) |
| SAFG | 自适应光谱细化(patch 欧氏/余弦相似度权重 + 条带卷积 + 边缘增强) |
设计逻辑:四个分组对应融合的四个本质问题 ------交叉注意力回答"两路之间该交换什么",自适应加权回答"两路该按什么比例混合",重标定回答"混合前该强调什么",频域增强回答"从什么表征角度看相似性"。23 个变体不是堆数量,而是把'融合'这个动作的每个可设计维度都覆盖了一遍;Aura 则是我们在交叉注意力维度上的原创尝试。
4. 代码获取
https://github.com/tgf123/YOLOv8_improve
DEIM:超越 YOLO,快准双绝!DEIM:让 DETR 告别慢收敛,开启实时检测新纪元_哔哩哔哩_bilibili
5.以 Aura(气息感知交叉注意力) 为例
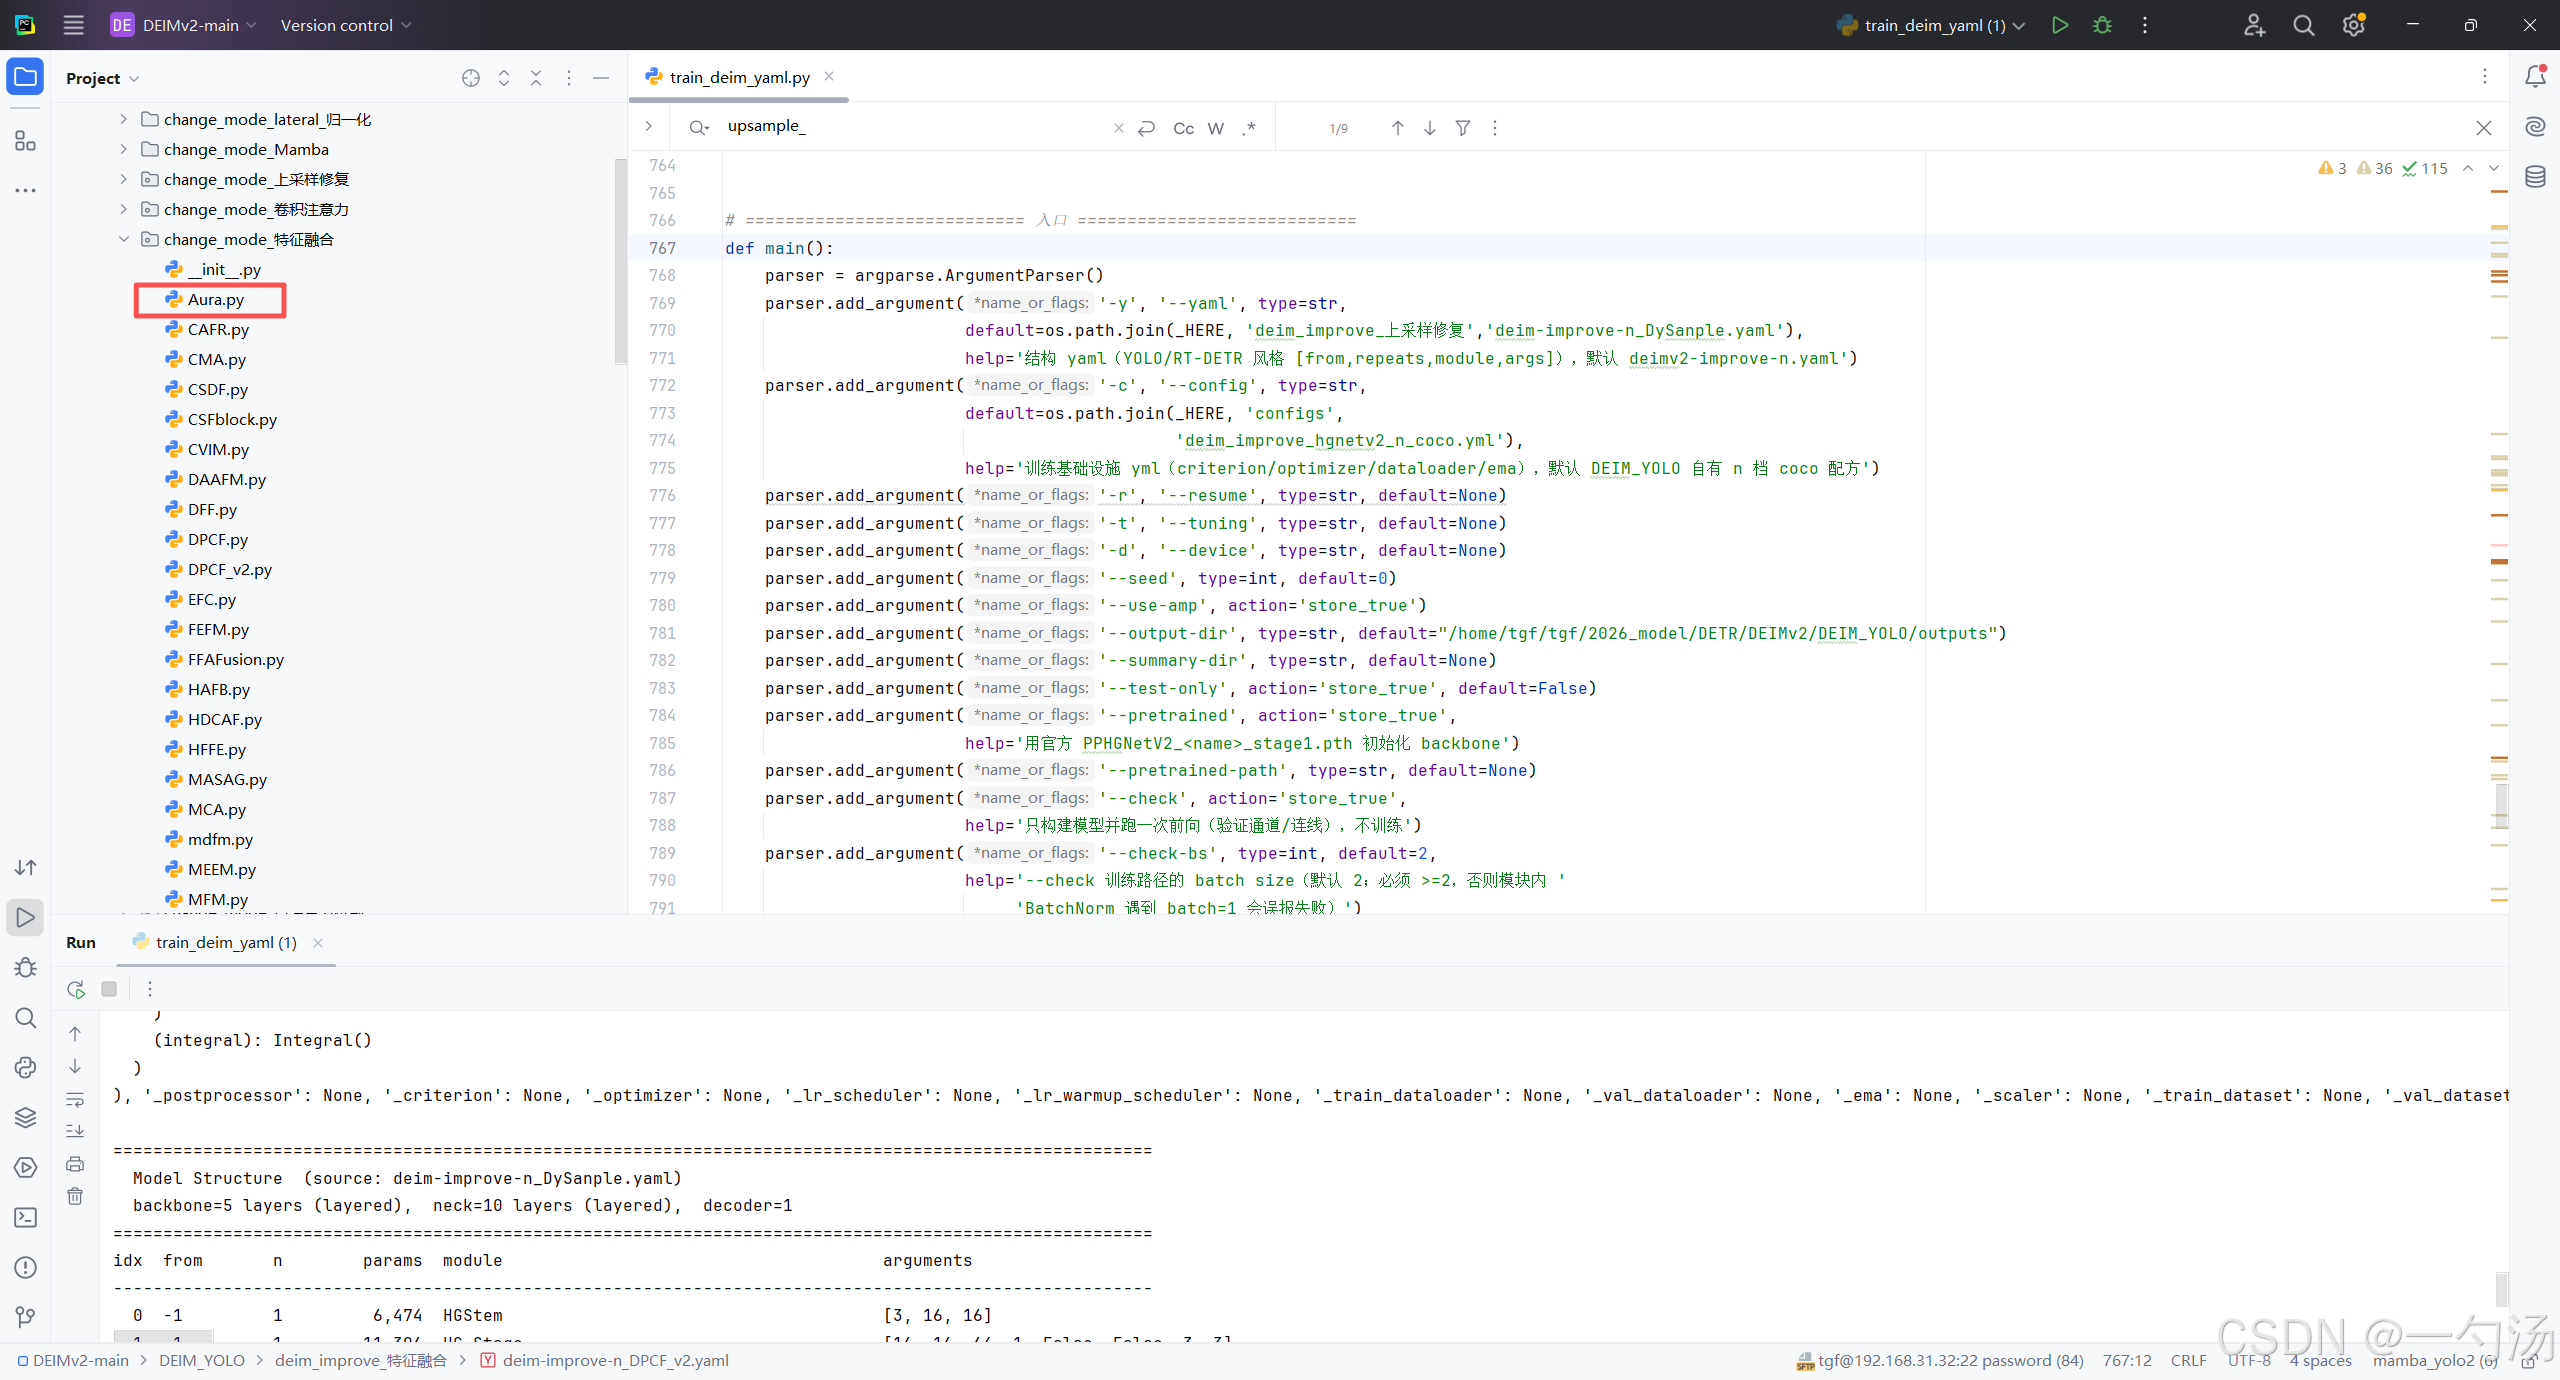
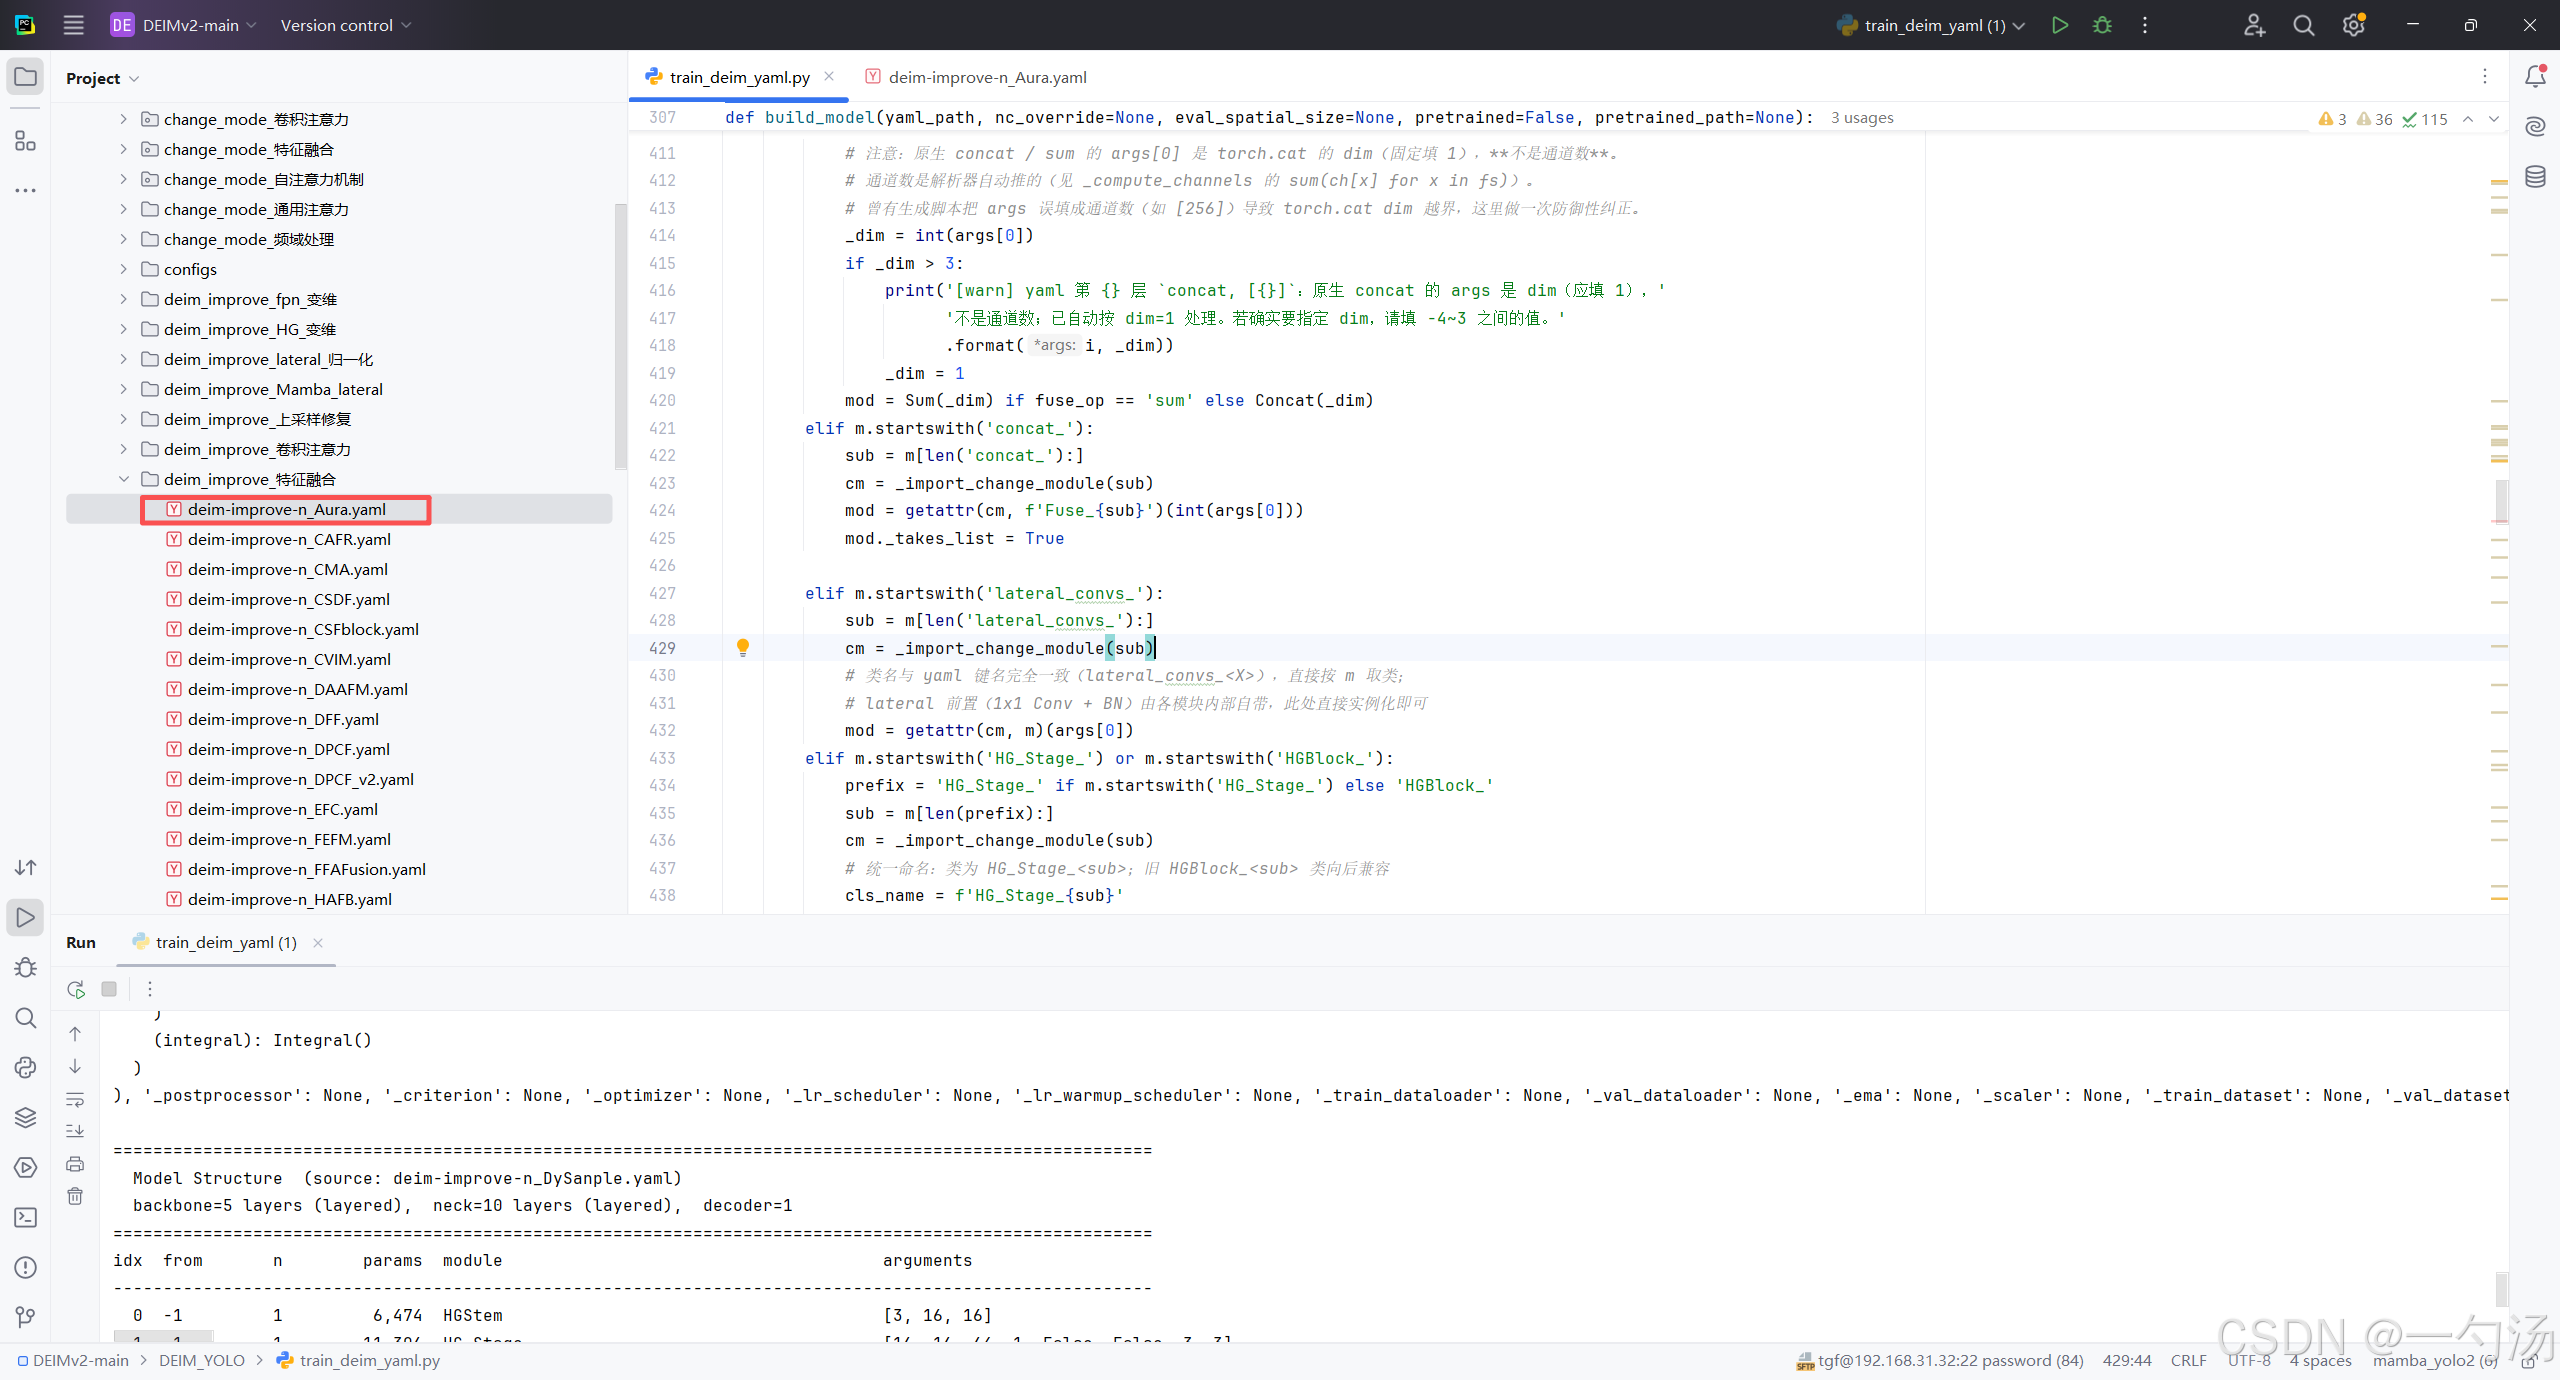
第一: 将下面的核心代码复制到DEIMv2-main\DEIM_YOLO\change_mode_上采样修复
路径下,如下图所示。
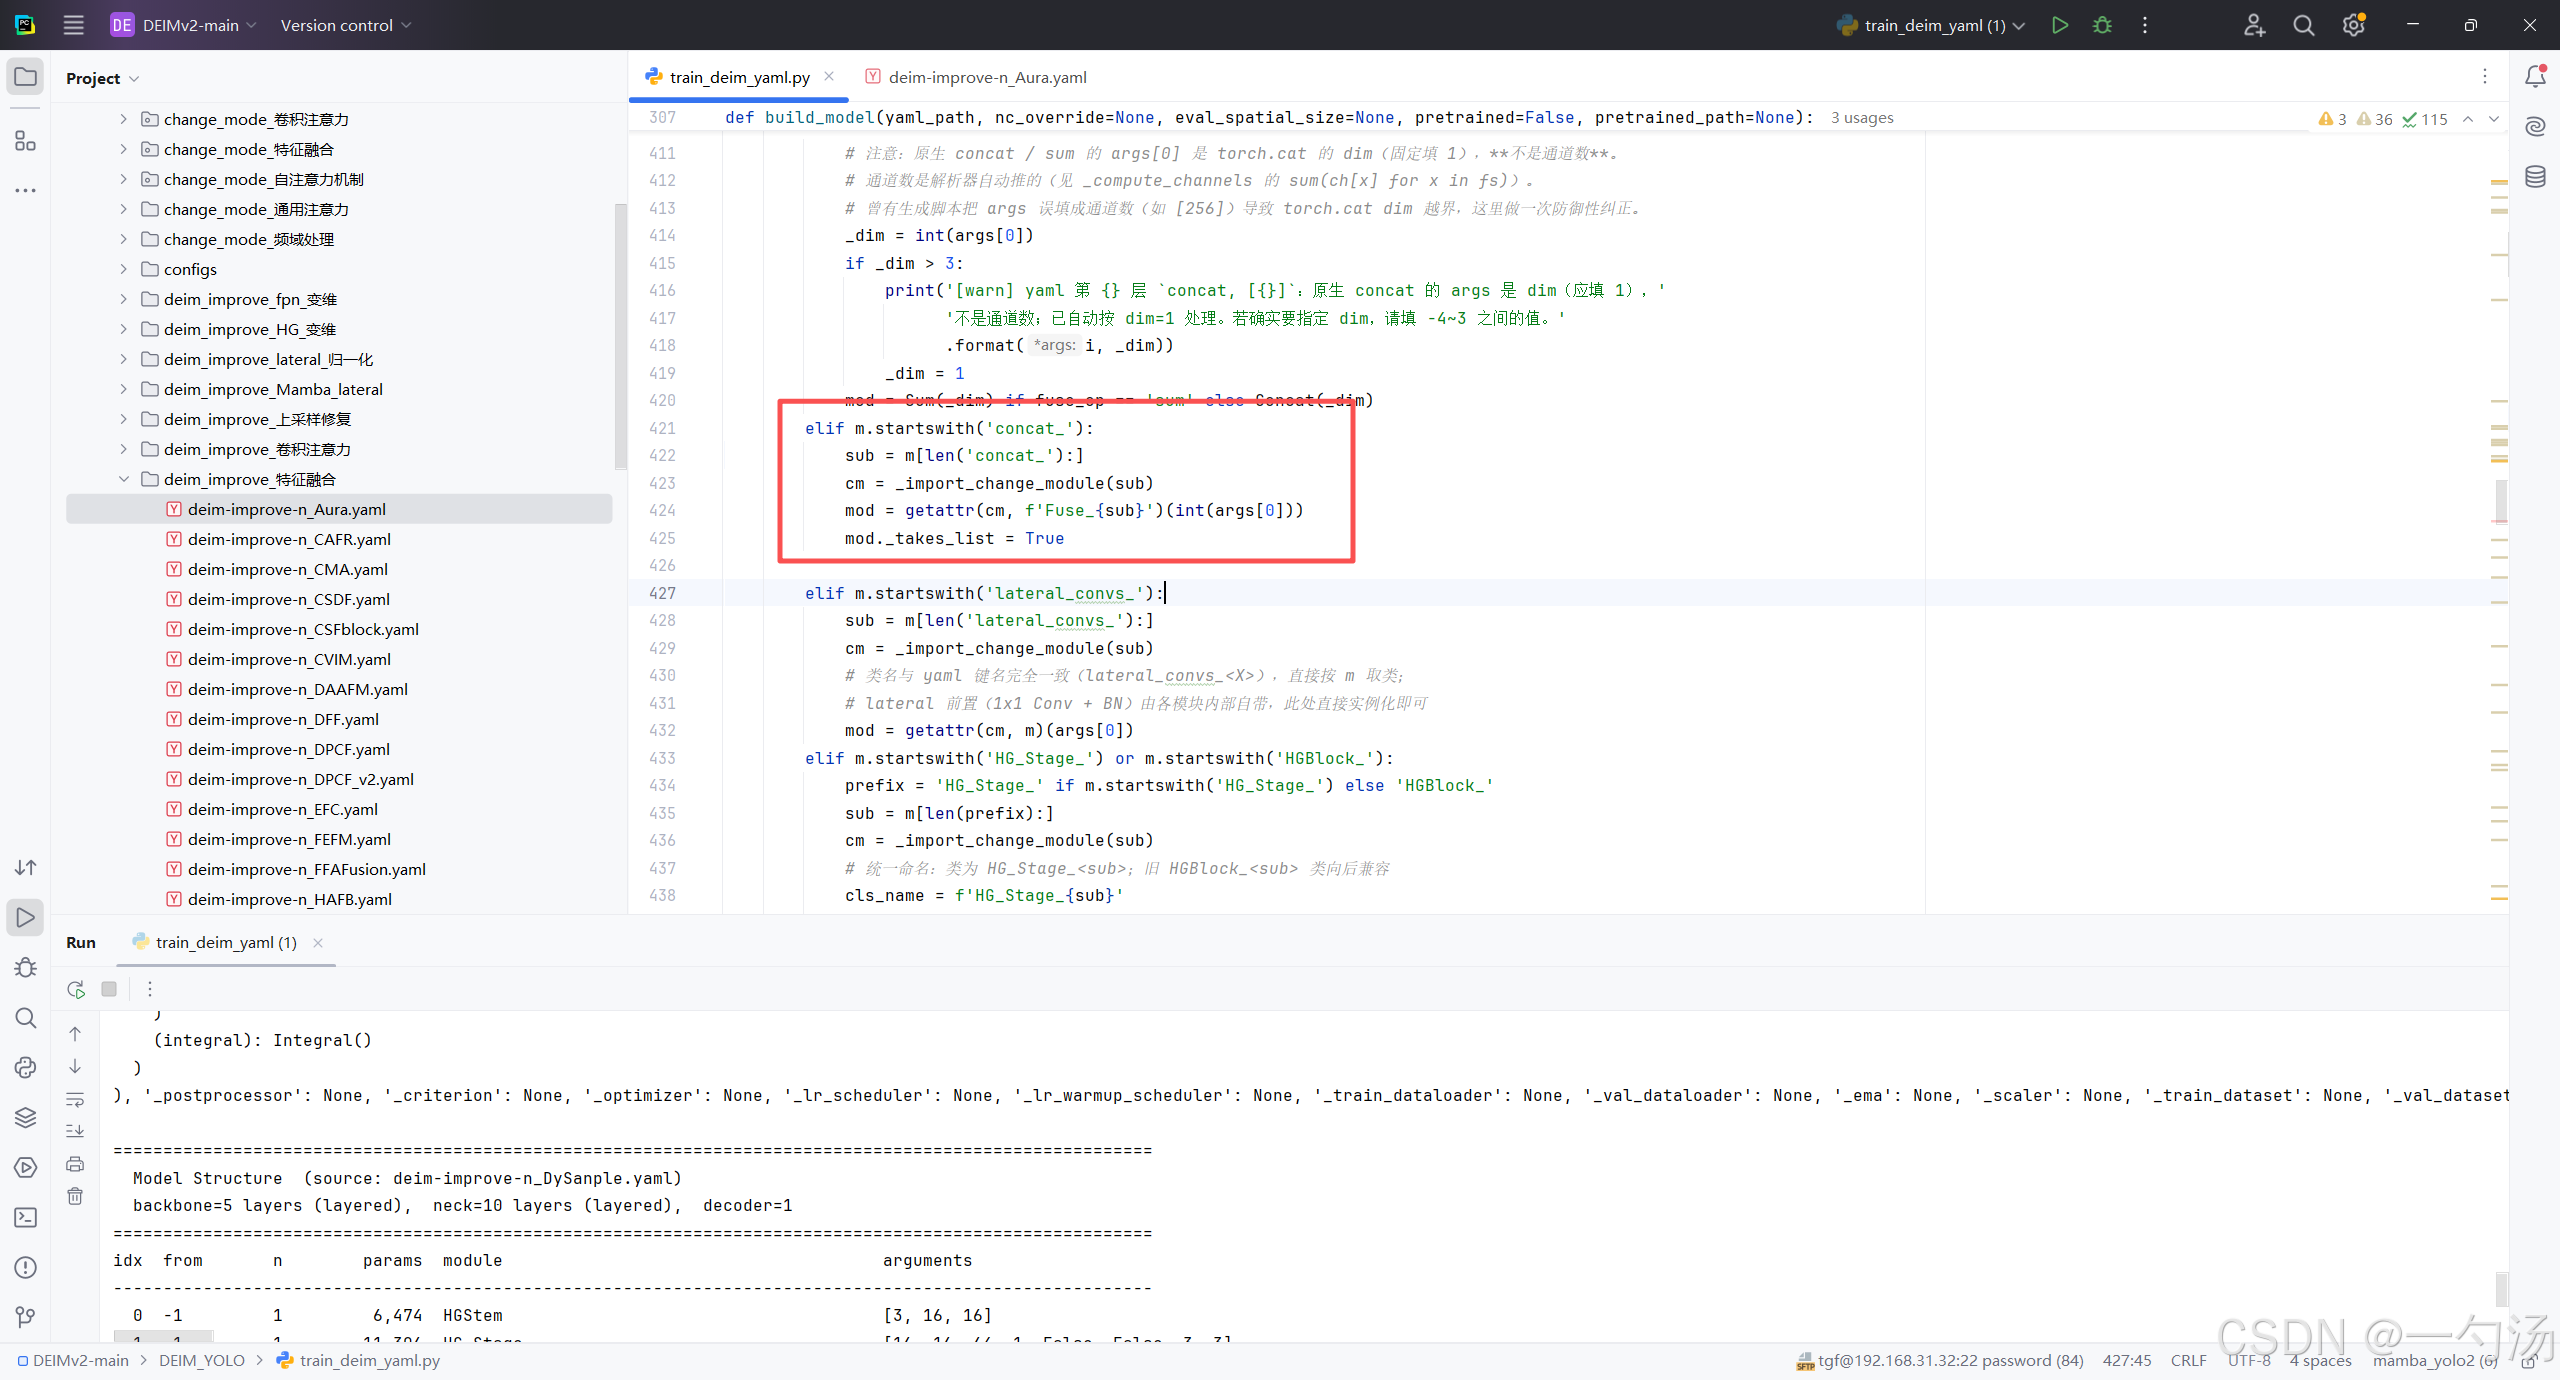
第二:自适应导 包与模型搭建
第三:将模型配置文件复制到DEIM.YAMY文件中
第四:模型跑出的结果