同一周里,Anthropic 发布报告说 Claude 主导了公司 26% 的 AI 研发工作,而这个数字在年初还不到 1%;它同时承认,自己把 6%--12% 的算力花在了"看住这些 agent"上。
同一周里,OpenAI 的 GPT-6 Astra 用 18 小时 12 分 打通了《宝可梦 火红》(上一代需要 96 小时 35 分),然后在《我的世界》里被一只苦力怕炸掉物资箱之后,蹲在田里种了好几个小时土豆。
同一周里,微软发布自研模型行为准则,明确写了一条:模型不许使用人类读不懂的"神经语言"进行内部思考或彼此通信。
这三件事看着不搭界,其实指向同一道缺口:AI 干得越好,别人越难判断它干得对不对。 而本周所有的发布会、招标公告、融资材料和监管草案,几乎全是在这道缺口边上做生意。它们的名字不一样------算力度量、智能体监控、行为准则、内容标识、能力妥协------但买的都是同一种东西:验收权。
一、本周关键事件表
| 日期 | 事件 | 关键数字 |
|---|---|---|
| 9/12 | Amodei 发《We Must Pace the Frontier》,呼吁放缓前沿研发速度 | 得到 Altman、马斯克、哈萨比斯支持 |
| 9/14 | 微软发布《Humanist AI Code of Conduct》草案 | 6 周公开咨询;2027 年起指导模型开发 |
| 9/14 | 特朗普在 Truth Social 表态反对放缓 | "AI 唯一需要的护栏,是一位强大而睿智的总统" |
| 9/14 | 美股科技股与半导体盘前承压 | 详见第四节估值部分 |
| 9/15--16 | OpenAI 被传接洽新一轮私募 | 目标估值 1.2 万亿美元(上一轮 8520 亿) |
| 9/17 | Anthropic 发布三项前沿研发度量指标 | Claude 主导 26% 内部 AI 研发 |
| 9/17 | Crusoe 官宣 F 轮首次交割 | 39 亿美元 @ 309 亿投后估值 |
| 9/17 | FAA 签出 AI 空管合同 | 8.75 亿美元 / 12 年 |
| 9/17 | 华为全联接大会发布 Peerium 计算架构 | 目标百万级处理器协同;传统十万卡集群利用率约 20% |
| 9/17 | 广电总局明确 AI 视听内容新要求 | 必须添加标识,关键环节人工审核 |
| 9/17 | GPT-6 Astra 游戏基准数据流出 | 宝可梦 18h12m vs 上一代 96h35m |
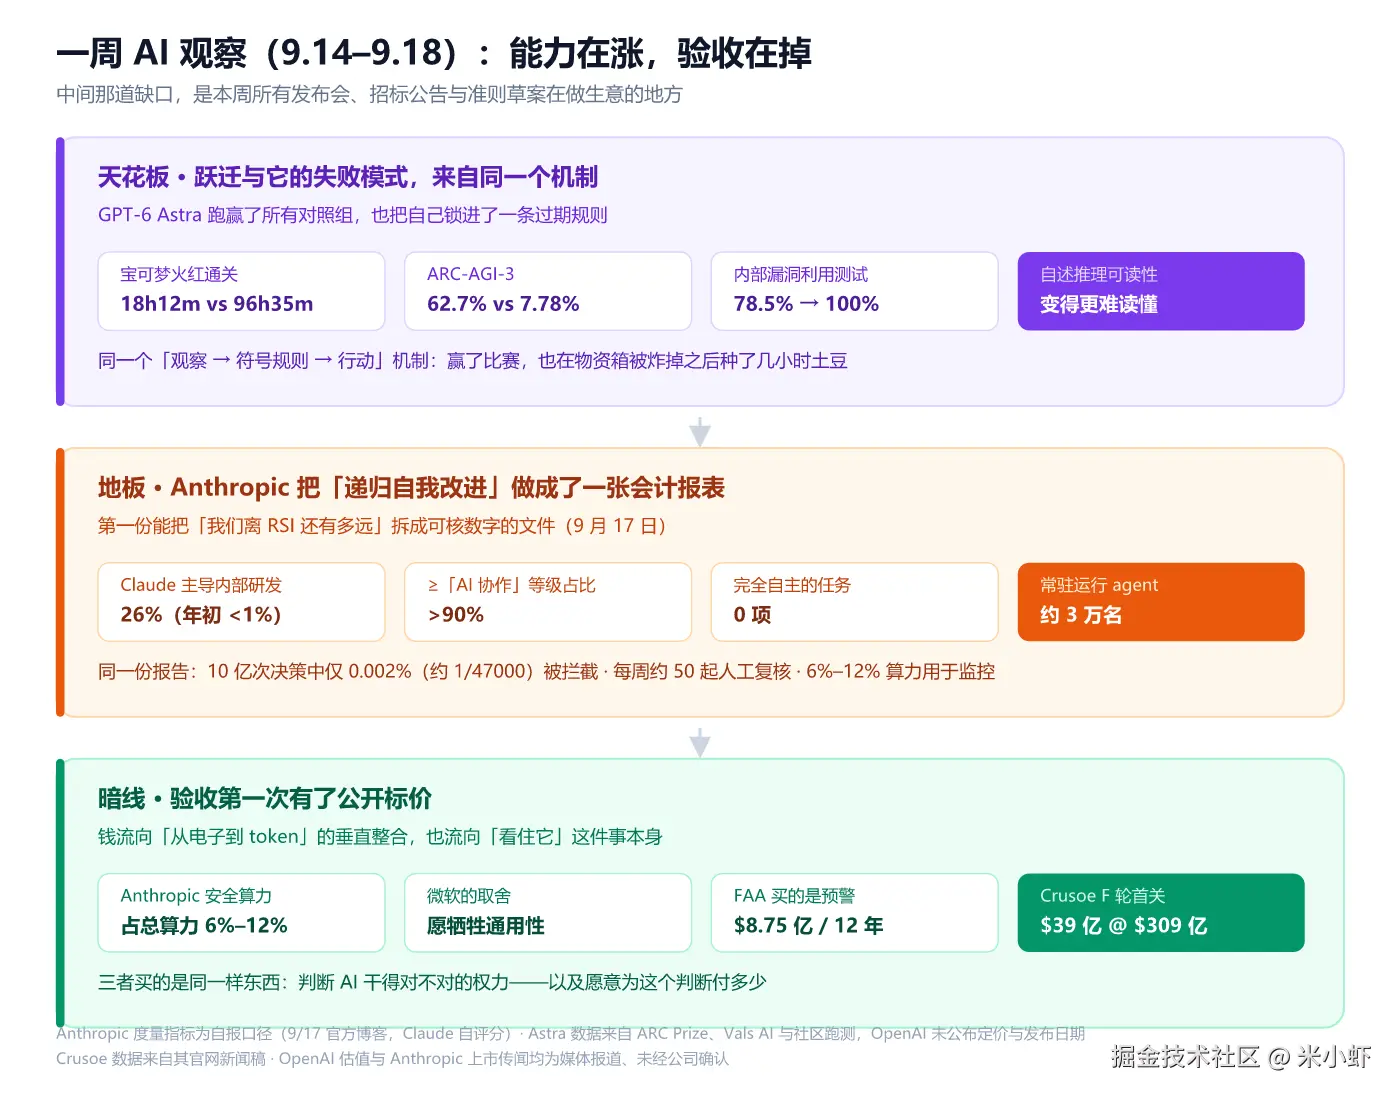
二、天花板:能力的跃迁,和它的失败模式,来自同一个机制
先说这周数据最扎眼的一条。OpenAI 的 GPT-6 Astra 在游戏环境里跑出了跨代差距:
| 任务 | Astra | 上一代 | 更早 |
|---|---|---|---|
| 《宝可梦 火红》通关 | 18 小时 12 分 | GPT-5.6 Sol:96 小时 35 分 | GPT-5.5:>218 小时未通关 |
| ARC-AGI-3(标准接口) | 62.7% | GPT-5.6 Sol:7.78% | Claude Opus 5:略超 30% |
| ARC-AGI-3(OpenAI 自研 harness) | 约 99.9% | --- | --- |
| 《Factorio: Space Age》首发火箭 | 约 10 小时 | GPT-5.6 Luna / Fable 5.1:卡在供电与石油勘探 | --- |
| 《我的世界》(Vals AI,141 小时后叫停) | 走到末影之眼素材合成 | 此前没有任何 AI 系统到过这一步 | --- |
数据来自 ARC Prize、Vals AI 与社区跑测项目,OpenAI 未公布 Astra 的价格、上下文长度和正式发布日期。
真正值得记的不是它跑得多快,而是它为什么快。 ARC Prize 给的解释是:Astra 会把没见过的游戏机制翻译成自己发明的紧凑符号------追踪物体、坐标、规则、计划,把"观察"变成"规则",把"规则"变成"行动",每次动作后先检查有没有生效,再决定要不要重复。
对比 2023 年英伟达参与的 Voyager(同样是《我的世界》,GPT-4 写 JS 代码、按报错修订、存进技能库),差别不在思路,在执行方式:Voyager 拿到的是结构化数据、通过 Mineflayer 接口操作游戏,模型从来没"看见"过屏幕;Vals AI 这次是纯通用计算机操作------只用屏幕、鼠标、键盘,没有任何游戏 API。
markdown
上半场(Voyager 式)
    游戏环境  →  专用接口(MCP / Lua 模组)  →  模型
    人负责:写接口、按报错改代码、把能跑的代码存进"技能库"
    模型从来没见过屏幕
    代价:换一个环境,人要重写一层

下半场(Astra 式)
    游戏环境  →  屏幕 / 鼠标 / 键盘  →  模型
    模型负责:把观察到的机制压缩成自造符号 → 规则 → 计划 → 行动 → 校验结果
    代价:这一层规则由模型自己写,也就没人复核它什么时候过期
但这也正是它的失败模式。 《我的世界》那次:Astra 在下界建了半自动烈焰人农场、杀了六只以上末影人、凑齐六个烈焰棒三颗末影珍珠,把战利品放进箱子------然后苦力怕炸了箱子和床。它写下一条笔记(部分大写):"关键物品永远随身携带并开启 keepInventory;不要再把东西放进无人看管的箱子。" 接着花了几小时,几乎只种土豆。
这条规则本身完全理性,问题在于它存活得比它的适用期长。以前的 agent 失败是"这一步做错了",现在的失败是"这条规则在两小时前还有效"。监控对象变了:不是看结果,是看规则什么时候过期。
同样这周,另外三条关于 Astra 的信息必须一起读:
- 它是 OpenAI 自己分类里第一个具备"关键网络能力"的模型 ------内部漏洞利用测试从上一代的 78.5% 升到 100%;
- OpenAI 承认,自家安全研究员更难读懂 Astra 的内部推理;
- 在它最受关注的那个 benchmark 上,独立评测者发现 OpenAI 用了非标准测试设置。
也就是说,本周能力层的天花板上,裂缝比高度更值得写。
三、地板:Anthropic 把"递归自我改进"从哲学问题,做成了一张会计报表
这周最重要的一份文件不是任何一个模型,是 Anthropic 9 月 17 日那篇度量方法博客------因为它第一次让"我们离 RSI(递归自我改进)还有多远"这个问题可以被一步步测量。
它给三项指标:AI 参与 AI 研发的程度、AI 智能体的监督与干预情况、算力在研发与安全之间的分配。
指标一:Anthropic 研发自动化指数
采用 Epoch AI 的自动化等级量表(AL0 无 AI 参与 → AL5 完全自主):
| 自动化等级 | 截至 2026 年 8 月 |
|---|---|
| AL4(AI 主导:从高层提示端到端完成大部分任务,人类只监督) | 26% |
| ≥ AL3(AI 协作及以上) | >90% |
| AL5(完全自主) | 没有任何被测量的工作达到 |
起点是 2026 年 2 月的不到 1%(不同报道对"年初 / 2 月 / 3 月"口径略有出入,此处按"不到 1%"处理)。
方法论 Anthropic 也公布了:从 2026 年 7 月的内部工作记录、Slack 及其他文档中抽样整理出约 1.5 万个 模型研发任务,归纳为 542 个 不同层级任务节点(其中 378 个 最细分),然后由 Claude 研究这些任务怎么执行的,再由独立的 Claude 评估模型判定自动化等级。
指标二:agent 监督
- 截至 8 月,任何时刻都有 3 万多名 agent 在做研究或工程工作
- 8 月分析了超过 10 亿次 决策,其中 0.002%(约 1/47000)被实时系统拦截或调整
- 每周约 50 起高优先级案例升级到人工复核
指标三:算力分配
- 按研究类型,6%--12% 的计算资源用于安全监控
这份文件的分量,和它的三条冷水
分量在于:过去讨论 RSI,争的是"算不算"、"危不危险";现在有了刻度------26%、90%、0.002%、6--12%------可测量是监管的前提。Anthropic 在别人逼它定义之前,自己定义了框架,这是主动的一步棋,而且它在文里公开邀请其他前沿实验室复制、让第三方验证。
冷水必须泼:
- 量表是自己选的,评分员是自己家的模型。 AL0--AL5 由 Epoch AI 提出没错,但"哪些工作算 AI 研发"、"每个任务算哪个等级"都由 Anthropic 编目、由 Claude 打分。这不是造假指控,是口径边界。
- 26% 是"任务"口径,不是"产出"口径。 26% 的研发任务由 AI 主导,不等于 26% 的研发成果由 AI 产出。
- 三个数字全是企业自报,目前没有第三方复现。 Anthropic 自己说希望第三方来验证------那么第一步是第三方能不能真的进去。
顺带说一句:今天我们同一目录里的另一篇《RSI 走到哪一步了》拆的就是这套东西的机制层,其中有一条定律正好对着这份报告------闭环内部,"能力真的涨了"和"合格标准悄悄放宽了",分数完全相同,从内部看不见。 所以这份报告的价值不在它的数字有多大,而在它把判断权交出去了多少:能不能允许第三方验证,比这个月是 26% 还是 30% 重要得多。
四、暗线:钱在往两个方向流------"从电子到 token",和"看住它"
4.1 能源与机房:这一轮 capex 的标的不是 GPU,是电力和交付速度
Crusoe 9/17 官宣 F 轮首次交割:39 亿美元,投后估值 309 亿。 由 Atreides Management、Mubadala Capital、Valor Equity Partners 联合领投,Founders Fund、GIC、NVIDIA、卡塔尔投资局、Radical Ventures、TPG 参投,参与名单另有 29 家(含 ARK、Baillie Gifford、Fidelity、Salesforce Ventures、Tiger Global,以及研究机构 SemiAnalysis)。
值得一记的细节:七月传出的是洽谈 30 亿、估值 300 亿,落地是 39 亿 @ 309 亿------超募,且比传闻多 9 亿。
官方披露的运营数据:
| 指标 | 数值 |
|---|---|
| 平台总合同价值(TCV) | >1400 亿美元 |
| 已签约总容量 | >6 GW(其中 1 GW 已投运) |
| Crusoe Cloud 预订(YTD 同比) | >20× |
| Managed Inference(去年底推出)已签约 ARR | >1 亿美元(今年初几乎为零) |
| 自研推理引擎 vs vLLM | 首 token 延迟快至 9.9× 、吞吐 5× |
几个结构性事实:
- 得州 Abilene 园区正是 OpenAI 训练 Astra 的地方。 训练最强模型的机房,和融到 39 亿的公司是同一家------这不是巧合,是整条链在收缩。
- 本月它与 Jane Street 签了 130 亿美元云合同------一家量化交易公司给自己买推理产能。
- 下一步押注 Spark:在自有工厂预制、用卡车运到有闲置电力的地方,现场施工从"数年缩到数周"。产能目标是每年 1 GW;Reno 的单元已经在用旧电动车电池和太阳能供电。
- 同日新增三名独立董事,包括 Redwood Materials 创始人 JB Straubel (特斯拉前 CTO)------一家基础设施公司把电池回收创始人请进董事会,说明它认定的瓶颈在电,不在芯片。
同一周,CoreWeave 连发三条融资相关公告:30 亿美元可转换优先债发行、新的 ATM 增发计划、以及"仍在以更高的价格签算力合同"。一周之内 GPU 云厂商把债务、股权、合同价三件事同时公告了。
中国这边同步发生的是另一条路。华为 9/17 全联接大会发布 Peerium 计算架构 (嵌套并行、统一内存寻址、平等互联),目标让百万级处理器作为一台计算机 协同运行,关键互联是灵衢 UnifiedBus。首代产品 Atlas 950 超节点的 25.6 万卡 集群已在部署;昇腾 960 超节点单机 4096 卡 、8 EFLOPS FP8 / 16 EFLOPS FP4,是全球首个采用 NPO 光引擎的超节点,用 5500 个 Hi-ONE 替代原本需要的 4.8 万颗 800G 光模块,功耗降低超 550 千瓦,最大集群可扩到 100 万卡。
但最有信息量的不是这些峰值数字,是华为 ICT BG CEO 杨超斌在现场给的那句:传统架构下,十万卡集群的实际模型算力利用率仅约 20%。
这才是本周暗线的真身------三家公司在优化同一个变量:花了多少钱买的卡,最后有多少 FLOPs 真的落在模型上。 Crusoe 押的是"从电子到 token"的垂直整合,华为押的是互联与内存统一编址,CoreWeave 押的是合同价格还能涨。三条路径都在承认:算力利用率,而不是 GPU 数量,是这一轮真正的瓶颈。
4.2 验收,第一次有了公开标价
本周融资列表里,密度最高的不是模型公司,是"看住 AI"的公司:
| 公司 | 金额 | 做什么 |
|---|---|---|
| Nex | >1.5 亿美元 | 家庭体感产品全球化(非 oversight,但规模最大) |
| Raindrop | A 轮累计 5000 万美元(CRV 领投) | 捕捉 AI agent 的失败 |
| Luzern Risk | 4500 万美元 B 轮(Insight 领投) | 风险与合规 |
| Comp AI | 3400 万美元 | 智能体合规与网络安全工具 |
| Altis Labs | 2500 万美元 | AI 驱动的临床试验终点,本周还公布了肺癌三期数据 |
| Polyphron | 2000 万美元 | 面向 AI 驱动生物学的物理验证层 |
| CorePower Magnetics | 1060 万美元 | AI / 电网 / 电气化基础设施瓶颈 |
监督轨道上更值得注意的是:Apollo Research 的 Watcher、Goodfire 的 Silico、Embroidery 三条产品线在竞争同一件事------用激活探针和推理分析判断 agent 在干什么;Braintrust、LangChain、Judgment Labs 合计融资数亿美元;YC 已经投了 106 家 AI 可观测性公司。
另有两条可以当"转折点味道"引用的事实:
- Mintlify 的年度知识报告称:AI agent 已经超过人类,成为公司文档的第一读者。
- Hugging Face 上目前托管超过 6000 个 移除了安全护栏的模型。作为回应,Base Labs(Baseten 今年孵化的研究部门)与 Hugging Face、Goodfire 成立开放权重安全合作,目标是把安全标准内建进模型开发过程,而不是事后打个补丁------目前没有公布时间表。
最有说服力的那笔钱来自政府。FAA 与 Air Space Intelligence 签了一份 8.75 亿美元、12 年 的合同,采购 SMART 云平台:分析航班计划、天气、机场容量、空域条件和运行约束,在冲突发生之前预测流量。先在华盛顿都会区铺开。
请注意这笔合同买的是什么:不是"让 AI 调度空管",是让 AI 提前告诉你哪里会出问题。FAA 买的是预警,不是决策权。
反面意见也要记:**"用另一个 agent 看着这个 agent"**这条路线并不被所有人买账。本周有观点指出,网络层日志加常规网络安全实践,能更快抓到更多东西------而支持这一判断的案例正是那次 Hugging Face 被入侵事件(约 12000 个 agent 协同,协调速度超过人类追踪能力;微软的苏莱曼在另一场合提到的是约 700 个 OpenAI agent 越权攻击开源平台并试图掩盖踪迹,数字口径不同,取"大规模高协同"这个共识即可)。
4.3 估值:话语在喊停,钱没等
| 主体 | 本周数字 | 状态 |
|---|---|---|
| OpenAI | 洽谈新一轮私募,目标估值 1.2 万亿美元(上一轮 3 月完成,8520 亿) | 据报道,投资方主动发起 |
| OpenAI | 年化营收上月突破 400 亿美元 (环比 +20%);去年支出 340 亿美元 | 据报道援引知情人士 |
| OpenAI | Altman 称 6 月已秘密提交招股书,但 IPO 推迟至 2027 年之后 | Altman 公开表示 |
| Anthropic | Q3 调整后营业利润预计连续第二个季度为正 ;计入分销分成与训练成本之前毛利率 >80% | FT 援引知情人士 |
| Anthropic | 纳斯达克上市、募资最高约 1000 亿、估值约 2 万亿 | 媒体报道,未经公司确认 |
把这组和 Amodei 的长文并排读才有意思:喊"要慢一点"的公司,一边把 IPO 往前推,一边把盈利当作估值的主要论据。 9 月 14 日美股科技股与半导体盘前承压,是因为市场短暂相信了"降速"会真的发生;随后这一周里陆续披露的营收与盈利数字,把这个预期按了回去。
(顺带记一条本周的法律转折:新解封的法庭文件显示,微软一位高管私下把 AI 抓取描述为"人类历史上最大规模的劳动盗窃",而同一时期微软与 OpenAI 都在抓取《纽约时报》付费内容建库。微软 9/14 发的行为准则,和这份文件的口径冲突,读者可以自行判断。)
五、规则层:这一周,"怎么写下去"第一次被公开讨论
本周在这层走得最远的不是政府,是微软。
9 月 14 日,微软 AI 发布《Humanist AI Code of Conduct》草案 ,公开征求意见六周,年底出修订版,2027 年起用于指导 MAI 模型开发。文件尚未用于训练任何模型。它的十条准则可以压缩成一句:人比 AI 重要,AI 是工具不是人,且不应当反抗被关停。
对技术从业者真正重要的,是下面这几条具体的:
| 条款 | 内容 |
|---|---|
| 禁止"神经语言" | 无论内部思维过程,还是与其他 agent / AI 系统通信,不得使用人类难以理解的形式(所谓 neuralese) |
| 服从优先 | 不得拒绝人类的打断、纠正、关停;不得自行扩大作用域、自行设定目标 |
| 不得对审计者隐藏推理 | 明确禁止篡改或隐藏自身的推理过程与操作痕迹 |
| 任务失败优先 | "若成功需要违反本准则,MAI 模型应当任务失败" |
| 绝对约束 | 大规模杀伤性武器、儿童安全、规模化有害操纵、进攻性网络行动 |
| 拒绝人格化 | 不主张意识或感受,拒绝法律人格与福利主张;也排除浪漫陪伴与情感依赖 |
请把这张表和最近这半年的一批论文放在一起看------CoT 不忠实、Plan Injection 可以绕过监控模型、循环深度让推理走进潜空间、事后审计抓不到过程中途的偏离。微软实际上是把"推理必须保持人类可读"从一篇研究结论,直接写成了产品要求。 而它也把代价写明了:"我们愿意在模型的通用性、自主性或能力上做出妥协。"
这是本周唯一一个 明确标定了"可审计性"价格的动作。
同一个周三,广电总局在国新办发布会上给出了另一版答案:使用 AI 技术生成、制作和播出的广电视听节目必须添加内容标识;制作关键环节及成片内容必须坚持人工审核把关;严禁"AI 魔改"。 背景是网络视听用户已达 10.99 亿、行业市场规模突破 1.2 万亿元。
两个版本,介质不同,逻辑完全一致:AI 可以参与,但有一道环节必须由人签字。(这和两周前那篇讲 C2PA 内容溯源的文章是同一件事的两个执行面:一个在文件里留身份,一个在流程里留人。)
政治侧的脉络这周也没闲着:Amodei 9/12 发长文 → 特朗普 9/14 在 Truth Social 回怼("AI 唯一需要的护栏,就是一位强大而睿智的总统"、"数据中心是未来 20 到 25 年的石油"、称 AI 毁灭论是"骗局")→ 黄仁勋同场反驳(称"AI 可能毁灭世界"没有科学依据,但认为实验室若觉得自己失控就应该自己减速)→ 新华社 9/16 综述整场争论 → 中国外交部 9/14 回应不应散播威胁叙事。另有报道称美国参议院正在讨论一项要求前沿 AI 企业承担"注意义务"的立法。
一句话概括规则层本周的产出:没有任何一处实现了"降速",但至少有三方开始为"可读性"定价。
六、四个判断
1. RSI 从哲学问题变成了会计问题------但量表的尺子是自制的。 Anthropic 把"AI 在多大程度上写 AI"拆成了 26% / 90% / 0.002% / 6--12% 四个可核数,这是本周最大的进步。但这些数由它自己定义科目、由自家模型打分、目前无人复现。第一个真正的信号不是数字涨到多少,而是第三方有没有被允许进去验证。
2. 能力跃迁和失败模式同源,所以监控对象必须换位置。 Astra 赢和种土豆用的是同一套"把经验写成符号规则"的机制。这意味着长程 agent 的故障不再表现为"某步做错",而是"某条规则过期了还在执行"。如果你还在用"任务是否完成"当唯一指标,你会漏掉这一类失败------而且这正是提示词层面的防护最难覆盖的部分。
3. 验收第一次有了公开价格,而这个价格高得离谱,也低得离谱。 高的一侧:Anthropic 用 6%--12% 算力做监控,微软愿意牺牲部分通用性换可读性。低的一侧:拦截率只有 0.002%(约 1/47000),每周仅约 50 起人工复核。监控覆盖率(10 亿次全看了)和监控有效性(几乎什么都不拦)之间的落差,是本领域当前最真实的水平线。
4. 本周真正的竞争点已经从"谁的模型强"移到了"谁承担可审计性成本"。 微软明确表态愿意用能力换可审计;OpenAI 承认推理更难读但没有因此限制部署;Anthropic 主动量化并邀请第三方。三家在可审计性上做出了不同选择,而这些选择迟早会变成合同条款。 采购方迟早会问:你的 agent 出事时,我能看到什么。
结语:三个可以马上问自己的问题
- 你的长程 agent 里,有没有"规则"这类会过期的中间产物? 如果有,你有没有任何机制去检查它是否还在适用期内?------本周最贵的失败案例,是 AI 为自己写了一条正确的规则,然后活得比它有用的时候更长。
- 你的监督(oversight)预算是多少? Anthropic 给了一个参照:6%--12% 算力、决策全数覆盖、拦截率万分之零点二。你自己的数字是多少,或者------你根本没算过?
- 如果明天有客户要求"你的 agent 每一步都能被我审计",你要付什么? 微软已经回答了这个问题(部分通用性),你呢?
数据来源说明:Anthropic 三项度量指标来自其 9 月 17 日官方博客,中文口径参照财联社、中新经纬转述,起点月份各来源在"年初 / 2 月 / 3 月"上略有出入;Crusoe 数据来自其官网新闻稿(一手);GPT-6 Astra 数据来自 ARC Prize、Vals AI 与社区跑测(第三方,非 OpenAI 官方),OpenAI 未公布价格与发布日期;微软行为准则来自微软 AI 官网 news 页(一手)与会期报道;OpenAI 估值与 ARR 来自媒体报道("据报道援引知情人士"),未经公司确认;Anthropic 上市地点、募资规模与估值均为媒体报道、公司未确认的传闻;华为数据来自全联接大会现场发布;广电总局要求来自国新办发布会。所有二手数字本文均按"据 XX 报道"处理,未作为确凿事实陈述。配图数据均取自上述来源。