小智断网后还能做什么?沿一次唤醒看清设备与服务端的分工
TL;DR
- 场景:把一台小智放在桌上,说唤醒词、屏幕变化、听见回答。如果外网断了,设备还能不能用?仅凭"支持离线唤醒"无法回答:可能还认得唤醒词却接不通语音服务;可能通过局域网找到自己的服务器,但服务器仍在等待外部模型接口;甚至扬声器还在出声,也可能只是播放断开前已经收到的音频。
- 结论:本地前处理解决的是声音怎样被采集和送出;完整问答能否离线,取决于这次请求所需的全部计算和服务是否仍然可达。"声音触发了本地事件"与"远端会话可以收音"是两个时刻;"本地有唤醒模型"不等于"具备任意语音转文字或开放式推理";"服务器在局域网里"不等于"模型计算在局域网里"。这三条边界决定了一份离线能力的真实范围。
- 产出 :一份"3 轮只断开一处"分段断开教学记录(设备到网络 / 自有服务器到外部模型 / 自有公网出口)、6 张机制图与官方原文节选(官方 application.cc / audio_service.cc / afe_audio_engine.cc / README;第三方 config.yaml / openai provider / edge TTS / config_loader.py)、20 行错误速查卡,覆盖官方固件
cf2024ff与第三方服务端6afc54a两个固定 commit。
把一台小智放在桌上,说出唤醒词,屏幕发生变化,随后听见回答。对使用者来说,这是一件事;对系统来说,识别唤醒词、接通会话、理解问题、生成语音和驱动扬声器,可能发生在不同位置。
这会带来一个很实际的疑问:如果外网断了,设备还能不能用?仅凭"支持离线唤醒"无法回答。它可能还认得唤醒词,却接不通语音服务;也可能通过局域网找到自己的服务器,但服务器仍在等待外部模型接口。甚至扬声器还在出声,也可能只是播放断开前已经收到的音频。
要判断小智的离线能力,先确定你切断了哪条连接,再沿一次新请求追踪剩下的动作。本地前处理解决的是声音怎样被采集和送出;完整问答能否离线,取决于这次请求所需的全部计算和服务是否仍然可达。
本文核对官方固件 cf2024ff 和第三方 xiaozhi-esp32-server 的 6afc54a 固定源码,分别解释客户端与一种开源服务端实现。二者未经本文配对联调,以下没有设备实测、恢复耗时或识别率结果,也不以第三方实现推断官方在线服务的内部架构。
唤醒词已经命中,为什么还要打开音频通道
最有用的入口不是一张"端、边、云"示意图,而是固件收到唤醒事件后继续做了什么。
在 Application::HandleWakeWordDetectedEvent() 中,程序先检查 protocol_ 是否存在;处于空闲状态时,才进入 BeginWakeWordInvoke()。后者编码唤醒相关音频,尝试切到 connecting 状态,并在音频通道尚未打开时安排后续连接动作。这说明"声音触发了本地事件"与"远端会话可以收音"是两个时刻,前者不能替后者作证。1
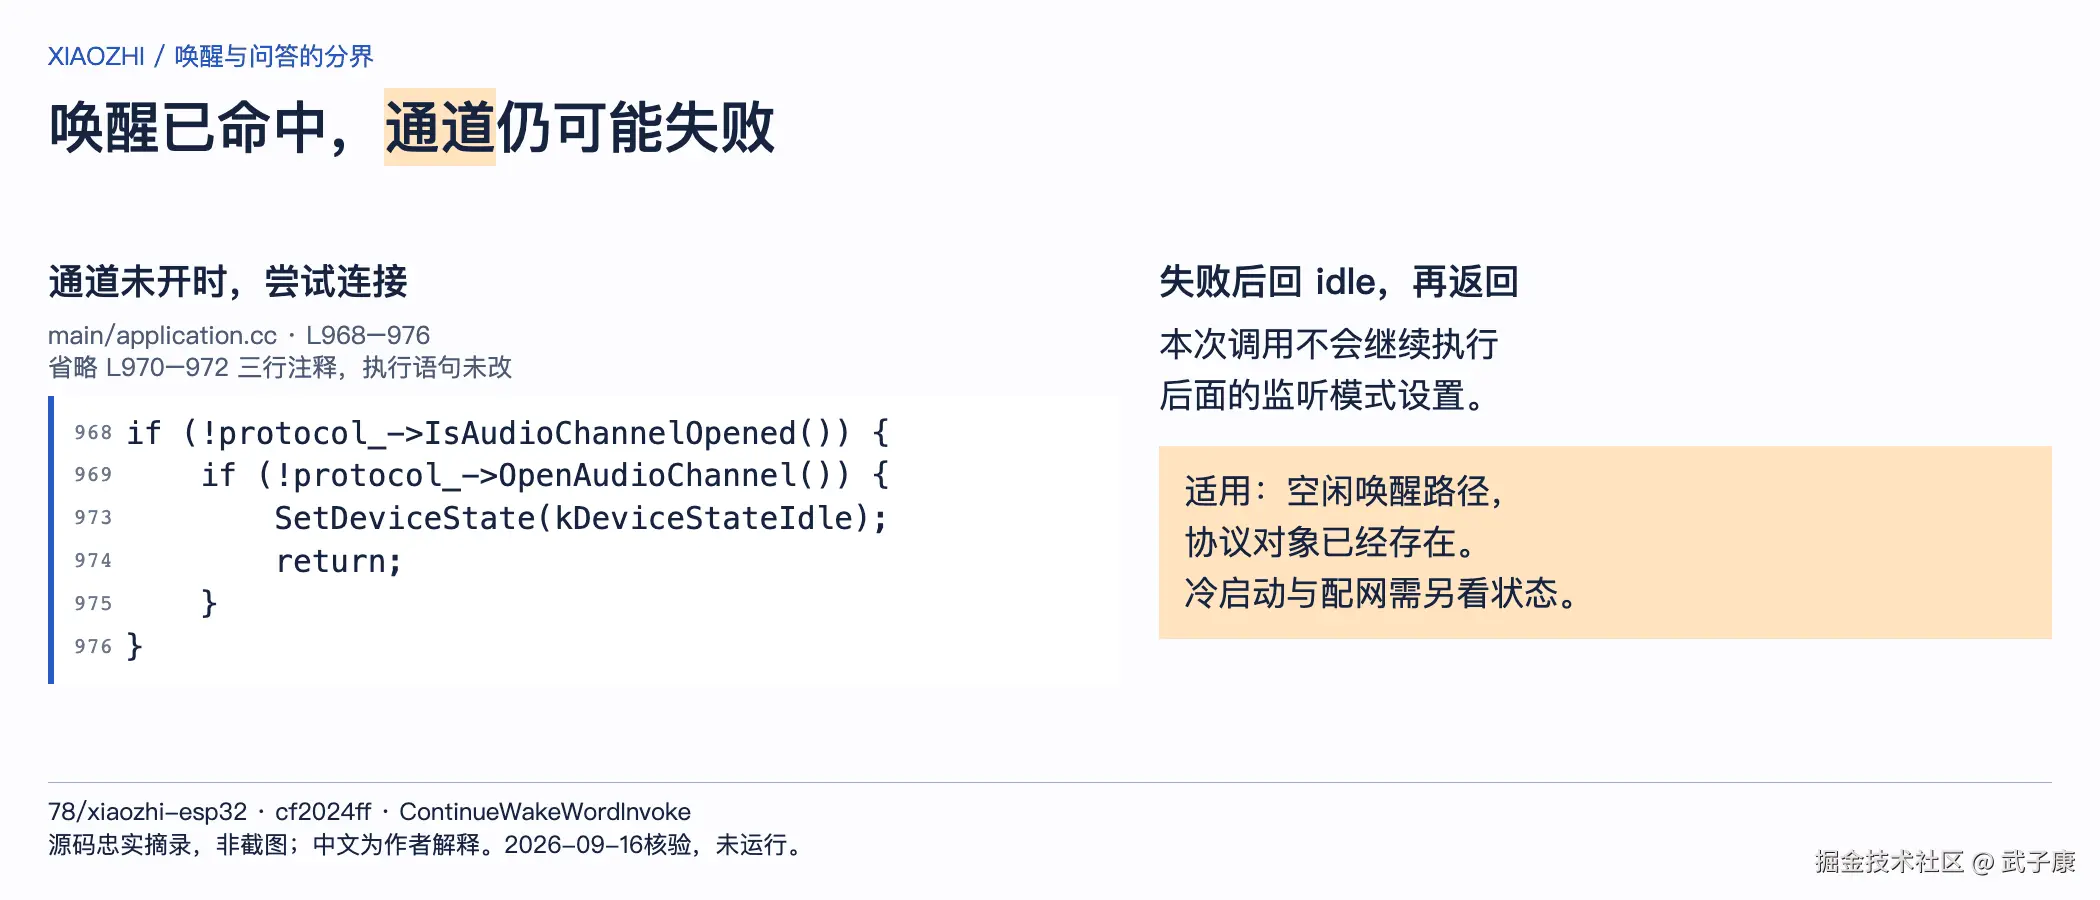
接下来,ContinueWakeWordInvoke() 有一个直接决定能否继续的分支。下面是其中连续的核心条件,省略了源码里的注释,未改动执行语句:
cpp
if (!protocol_->IsAudioChannelOpened()) {
    if (!protocol_->OpenAudioChannel()) {
        SetDeviceState(kDeviceStateIdle);
        return;
    }
}
这个分支位于唤醒数据发送和 SetListeningMode() 之前。打开通道失败,程序返回空闲,当前调用不会继续走后面的监听模式设置;源码注释还说明,回到空闲会由状态处理重新启用唤醒检测。设备因此可能再次响应唤醒,却仍然没有条件完成问答。1
这里也有几个容易忽略的限定。音频通道已经打开时,不会再次调用打开函数;唤醒发生在 speaking 或 listening 状态时,会走另外的处理分支;如果还没有协议对象,唤醒事件处理会直接返回;进入 Wi-Fi 配网状态时,状态处理还会明确关闭声音处理和唤醒检测。因此,已完成初始化后断网、冷启动时未联网、正在配网,不能作为同一种实验条件。因此不能把某个分支改写成"任何设备一断网都会发出相同提示音",更不能拿一次亮屏或提示音估算识别成功率。
真正需要记录的是:本地检测事件出现了吗,设备当时处于什么状态,是否尝试打开音频通道,打开结果如何。屏幕反馈有观察价值,但它只是这条时间线上的一个点。把它当作"设备已经听懂问题",排查就会从一开始走错方向。
这个区别也影响产品承诺。如果希望断网后仍能用一句固定口令控制灯光,就需要一条经过验证的本地命令执行路径。已有唤醒词检测,只能提供"有人开始叫我"的触发;从任意一句话解析目标、参数并执行动作,是另一个能力,不能通过把按钮事件换成唤醒事件自动获得。
本地确实在处理音频,但处理结果仍然是音频
承认问答依赖远端,不代表设备只是一个没有计算的麦克风。固件的音频任务有明确职责,只是这些职责与开放式语音理解不同。
AudioService::Initialize() 初始化音频编解码器、Opus 编码与解码,以及有需要时的采样率转换。它按芯片配置选择音频引擎:源码中的 ESP32-S3、P4、S31 分支创建 AfeAudioEngine,其他分支创建 LiteAudioEngine。选择分支本身不保证某个唤醒模型、麦克风配置或回声处理在实际板子上已经可用。2
有一段接口把前处理与问答的区别写得很清楚:
cpp
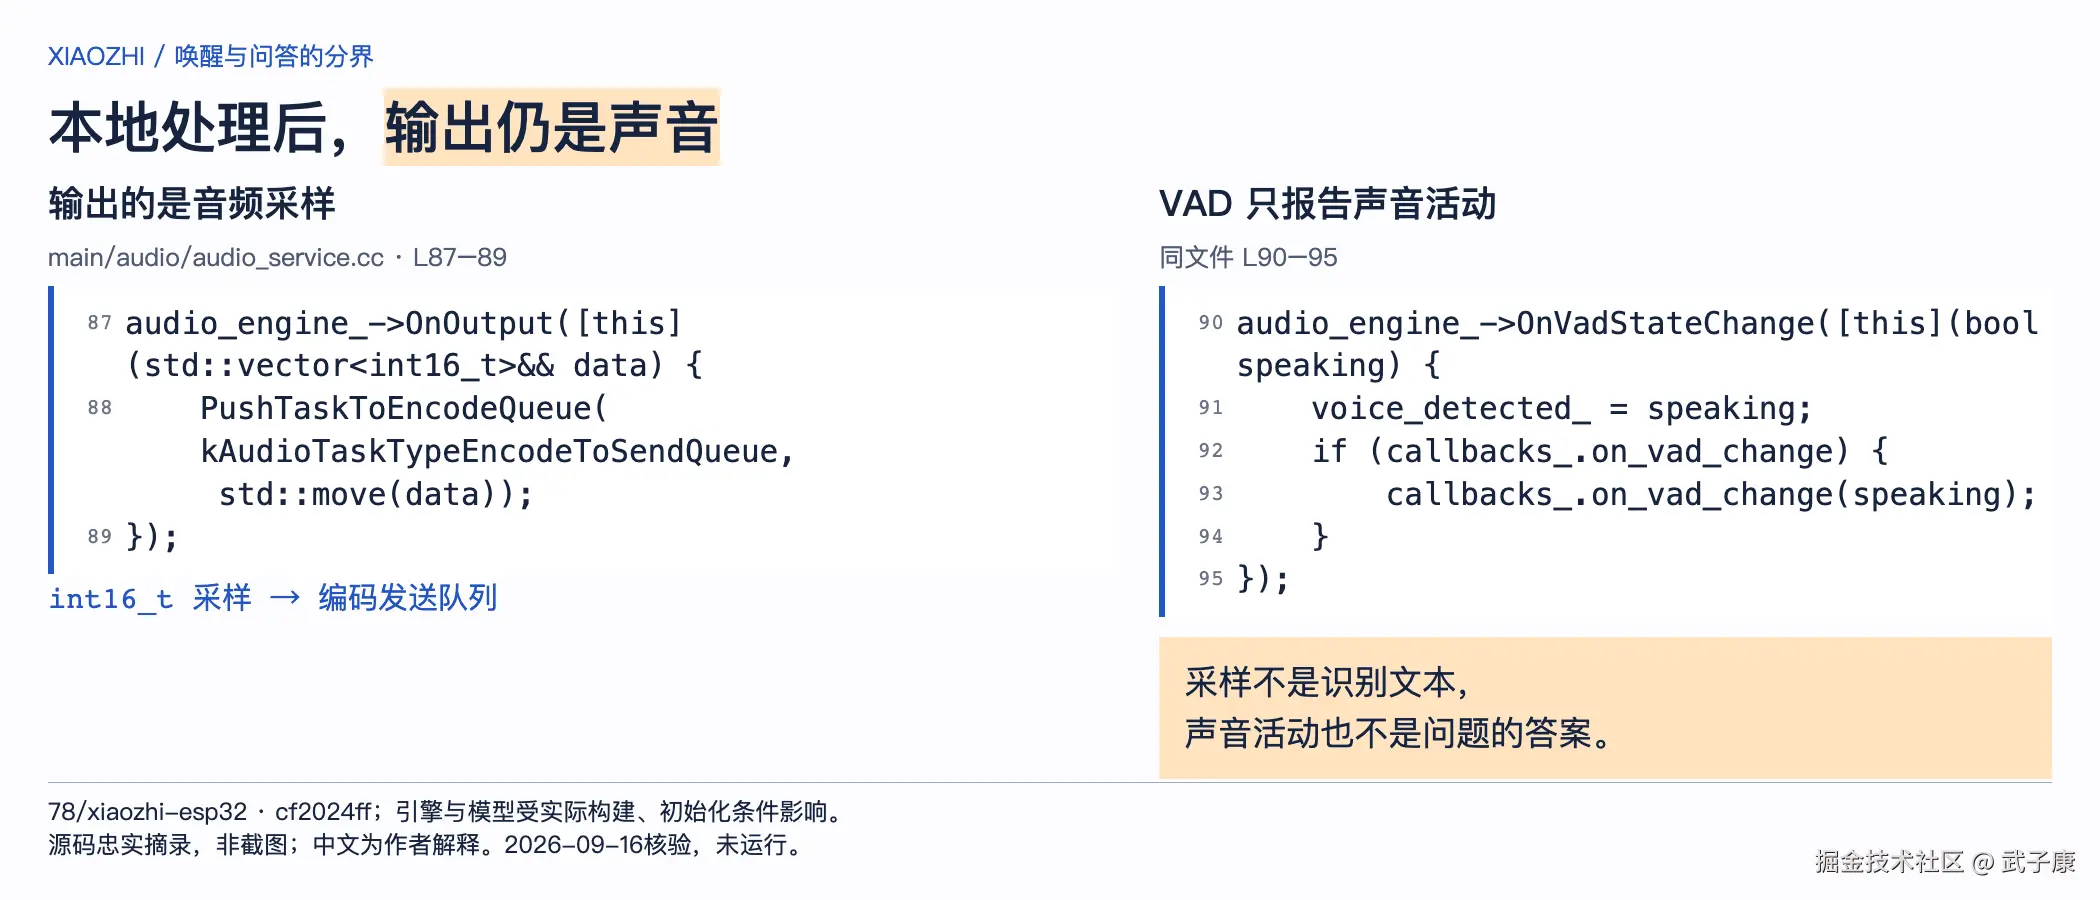
audio_engine_->OnOutput([this](std::vector<int16_t>&& data) {
    PushTaskToEncodeQueue(kAudioTaskTypeEncodeToSendQueue, std::move(data));
});
回调交出的 int16_t 序列是音频采样,下一站是待编码发送队列,并不是一句识别文本,更不是大模型答案。相邻的 VAD 回调传递 bool speaking,用来表示声音活动状态;唤醒回调传递命中的唤醒词。三个接口的输出类型就说明了它们分别解决什么问题。2
以 AFE 引擎为例,源码根据模型和编译条件选择 WakeNet、MultiNet 或没有唤醒检测器的情况。命中 WakeNet 后,程序取出对应唤醒词并调用回调;声音处理结果则进入输出缓冲,再交给上述音频回调。它们可以使用本地模型,但这里的"有模型"不等于"具备任意语音转文字或开放式推理"。3
于是,一台设备在某次实验中能识别固定唤醒词,却无法回答"今天晚饭吃什么",并不矛盾。两项任务的输入都来自麦克风,计算目的和输出却不同。也不能反过来推断:问答失败,就一定是本地唤醒、采样或扬声器坏了。
本地播放同样需要区分内容来源。AudioService::PlaySound() 可以处理传入的 Ogg 声音资源,正常下行则由解码任务把收到的音频转成 PCM,再交给 codec_->OutputData()。播放已经准备好的提示音,是设备自己的工作;根据新问题生成一段从未存在的回答,是另一条链路。断开后还听到几秒声音,既可能来自本地资源,也可能来自断开前的缓冲,必须结合请求时间判断。2
这里没有"所有本地能力断网后都一定可用"的保证。引擎是否初始化、当前状态是否允许采集、资源是否加载、板卡是否提供对应输入输出,都会影响实际结果。源码给出的是可定位的执行路径;一块具体设备离线时还能跑到哪一步,需要在它自己的构建和状态下观察。
屏幕上的识别文字与扬声器里的回答,从哪里进入设备
如果只看设备屏幕,很容易把"文字在这里显示"误认为"文字在这里生成"。固件的接收入口提供了反证。
InitializeProtocol() 注册的 OnIncomingJson() 按消息 type 分支处理。收到 stt 时,它从消息中取得 text,再安排界面显示为用户发言;收到 tts 的 sentence_start 时,它取出文本显示为助手发言。tts 的 start、stop 则驱动 speaking、listening 或 idle 等状态变化。这些分支是在消费接收到的协议内容。1
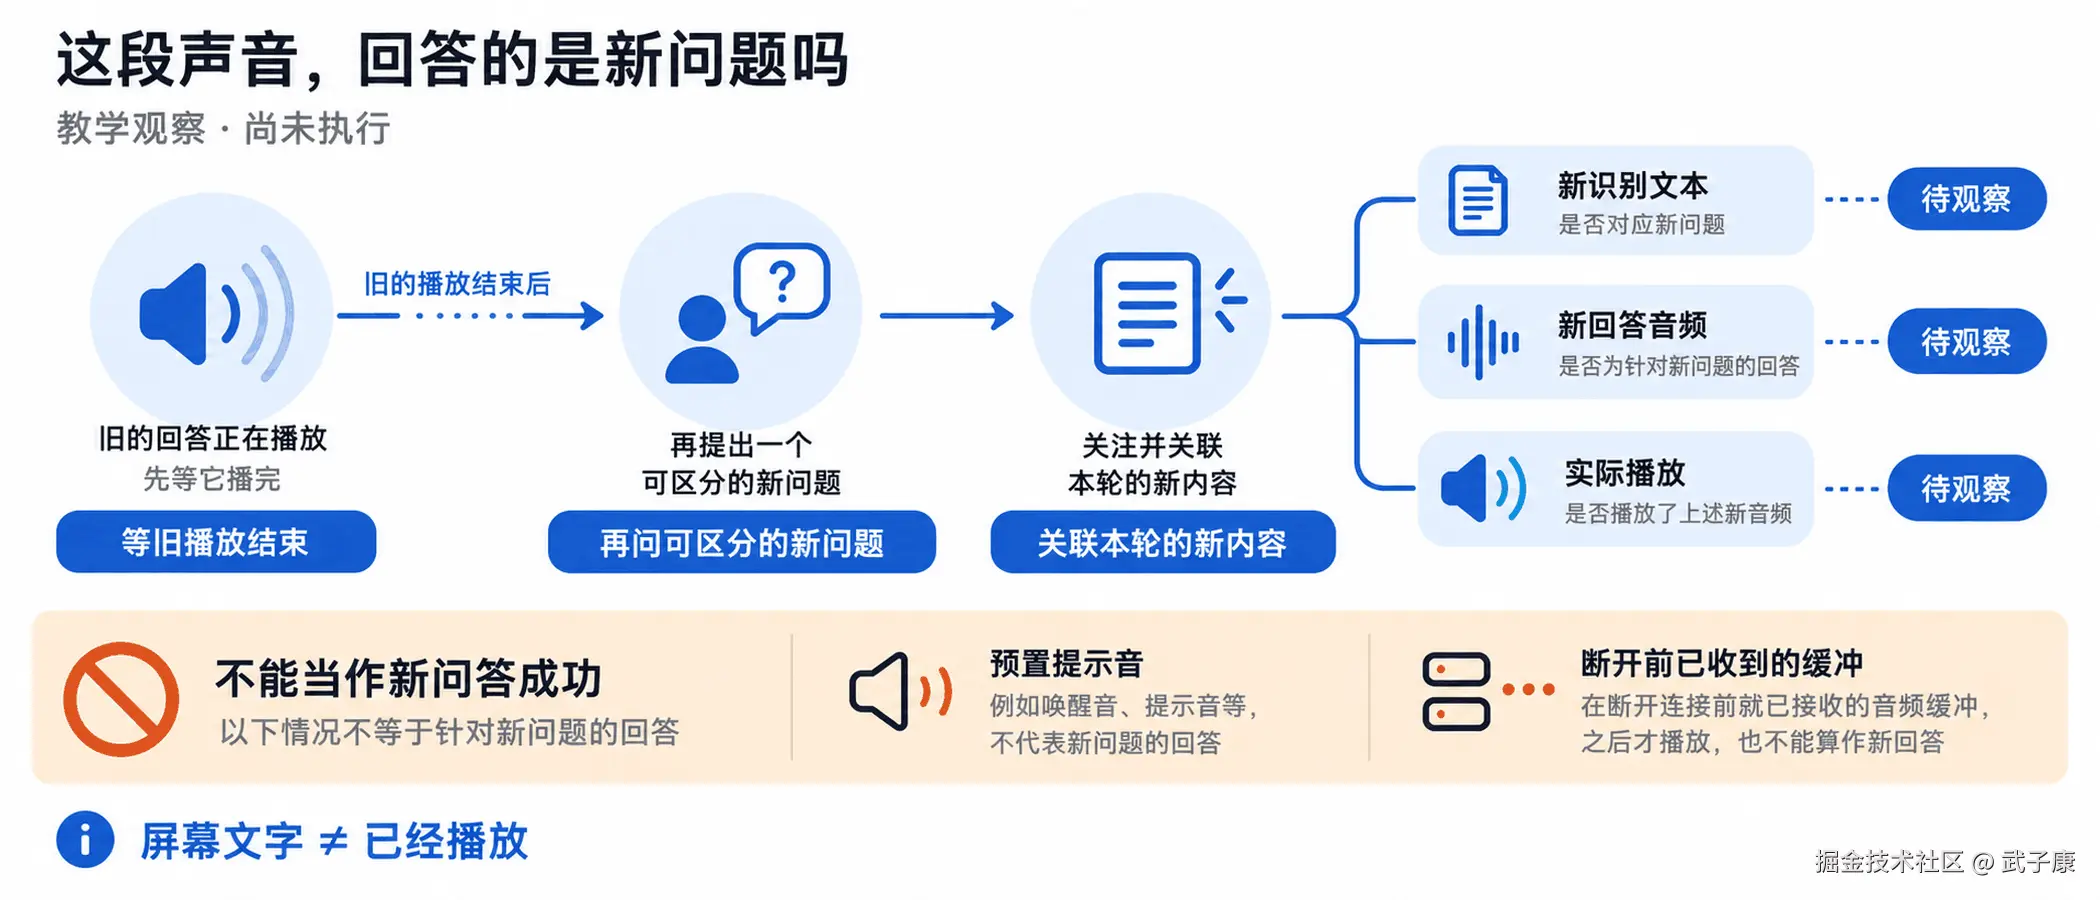
实际声音又走另一条入口:OnIncomingAudio() 收到音频包,在设备处于 speaking 状态时把它送进解码队列。可以看到,显示文字和播放声音虽然围绕同一次回答,却不是同一份载荷,也不是只要有一项就能证明另一项已完成。
如果实验中屏幕已经出现问题文本,却迟迟没有新回答,至少不能继续把问题全部归给麦克风。你已经得到一个更靠后的观察点,但还需要检查识别消息属于哪次请求,后续回答是否生成、音频是否下发、设备是否接收播放。反过来,听到"网络错误"之类预置提示也不说明识别链路成功;它可能恰好是在报告连接失败。
本文追踪的是这些可见协议路径,并不要求所有兼容服务都严格采用三个独立进程执行 ASR、LLM、TTS。官方 README 同时描述传统流水线与 Realtime 端到端语音模型支持,服务端完全可能以不同方式组织内部计算。客户端收到文本和音频,只能说明接口上发生了什么,不能凭这点复原官方服务用了哪些内部组件。4
这个边界反而让架构判断更简单:不必先猜服务端内部用了什么模型,先问本轮答案所需的新文本或新音频,是设备本地产生,还是从协议对端接收。对本篇核对的常规问答路径,后者是关键依赖。网络隔离实验应该围绕这个依赖设计,而不是围绕屏幕是否亮起来设计。
服务器放在家里,仍可能离不开公网
"本地部署"还有第二种含义:把服务端放到家里的电脑、NAS 或局域网服务器。这让计算位置靠近设备,但并没有自动把所有模型计算搬进这台机器。
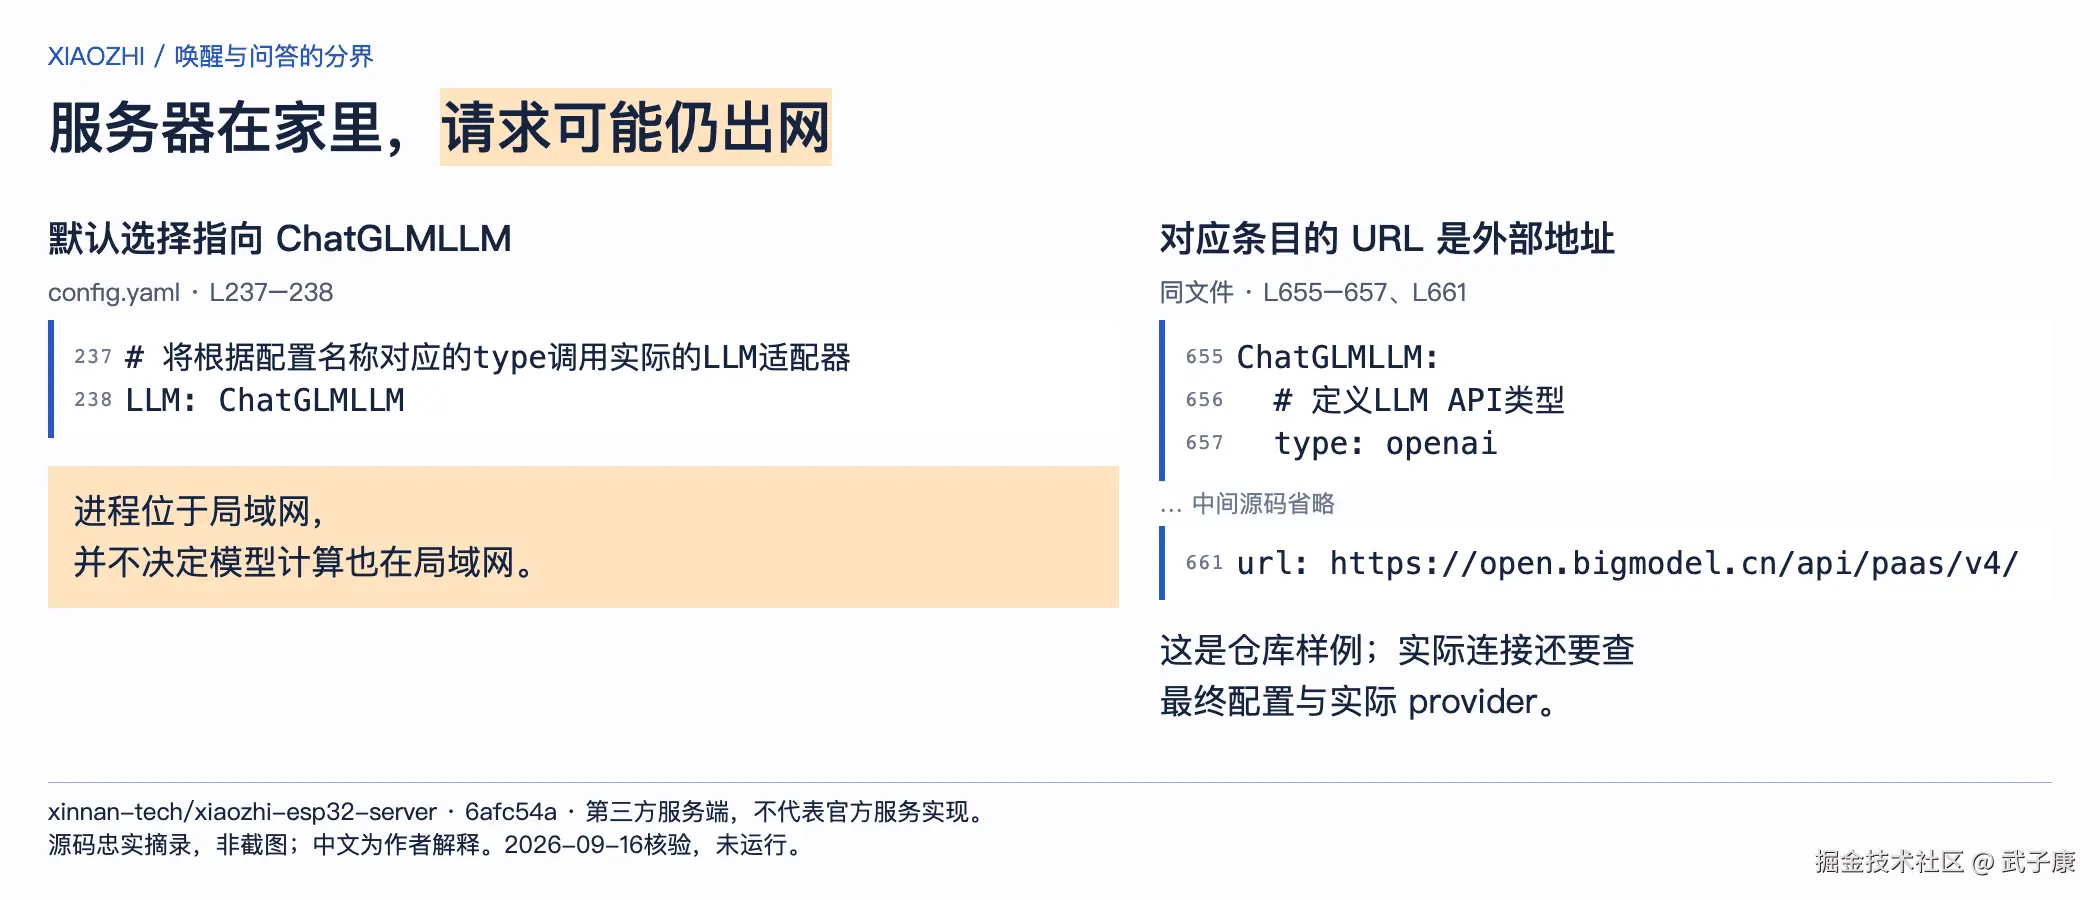
第三方服务端固定版本的 config.yaml 中,默认选择片段是:
yaml
selected_module:
  VAD: SileroVAD
  ASR: FunASR
  LLM: ChatGLMLLM
  VLLM: ChatGLMVLLM
  TTS: EdgeTTS
这段仅摘出相关连续选择项,删除了注释,未展示后续 Memory、Intent 等配置。继续查 ChatGLMLLM,其 type 为 openai,url 指向 https://open.bigmodel.cn/api/paas/v4/。对应 provider 会从配置读取 base_url 或 url,再创建客户端。也就是说,即使服务端进程运行在局域网机器里,这份配置所指向的语言模型请求仍要到外部地址。56
同一配置文件也列出 OllamaLLM,地址是 http://localhost:11434。这说明存在把该部分请求交给服务端本机服务的配置方式,不说明当前连接已经选择它。这里的 localhost 指调用它的服务器运行环境;如果进程在容器内,地址含义还要按容器网络核对,绝不是 ESP32 自己。5
更不能只改 LLM 就宣布离线化完成。当前选择的 TTS 适配器还会把文字交给 edge_tts.Communicate() 并读取音频流;需要继续核查实际 TTS 服务的网络依赖。其他场景还可能调用知识检索、天气、工具、身份管理或远程配置。只要这次业务必需的一项仍在隔离边界之外,完整业务就还没有成为离线业务。7
这里展示的是仓库默认样例,不是运行态诊断。配置加载器还存在本地覆盖和从 API 获取配置的路径。要判断自己的部署,应记录本次连接真正使用的 provider、它最终解析到的服务地址,以及这些服务是否实际可达;不应拿仓库文件中看见一个本地模型名字代替执行证据。8
如果需求只是"公网中断时仍能在家里聊天",保留局域网并在其中运行所需服务,是可以研究的一条路线。它与"设备完全脱网仍能聊天"是两个不同目标。后者失去到局域网服务器的路径,要求所需能力真正落在设备侧,或者把需求缩小到明确的固定口令和本地动作。两条路线的硬件、模型与验收范围都不同。
用一份分段断开记录,验证自己真正需要的离线能力
下面是一份尚未执行的教学安排。它只用于自己控制的设备、网络与服务器,不操作公共在线服务。目标是确定某项能力跨越了哪条连接,不是测试并发容量,也不评定故障后的扩量资格。
先在完整联网条件下做一次基线:记录固件构建、板卡、服务端版本、实际模型选择和目的地址,发起一个新的普通问答。保存本地唤醒事件、通道建立、识别消息、回答音频接收和扬声器输出的对应关系。没有基线,就无法区分离线造成的失败和原本就未配置好的能力。
然后每轮只改变一个条件,恢复后重新确认基线。不要用断开前正在播放的回答作为样本,等旧播放结束,再发起可区分的新问题;对录音与日志只保留必要信息,隐藏凭证。
| 断开位置 | 必须保留什么 | 本轮要观察的分界 | 结果填写 |
|---|---|---|---|
| 设备到网络的路径 | 设备供电与当前构建 | 本地唤醒事件是否出现;新音频通道在哪里失败;预置声音是否仍可触发 | 待实测 |
| 自有服务器到某个外部模型服务 | 设备到服务器连接,其他服务不变 | 请求是否到达服务器;停在识别、回答生成还是合成音频;错误是否能对应到所断地址 | 待实测 |
| 自有环境的公网出口 | 局域网、所需本地模型服务、已具备的本地资源 | 新问答能否完整完成;是否还有配置、工具或模型请求试图出网 | 待实测 |
最后一行应单独记录"已启动后的问答"和"冷启动后的新问答"。应用启动路径在网络连接后进入激活相关处理;一套已经建立连接的系统能维持运行,不能直接证明从关机状态开始也不需要外部配置或初始化。不要为了得到离线成功的结论,把冷启动失败从结果里删掉。1
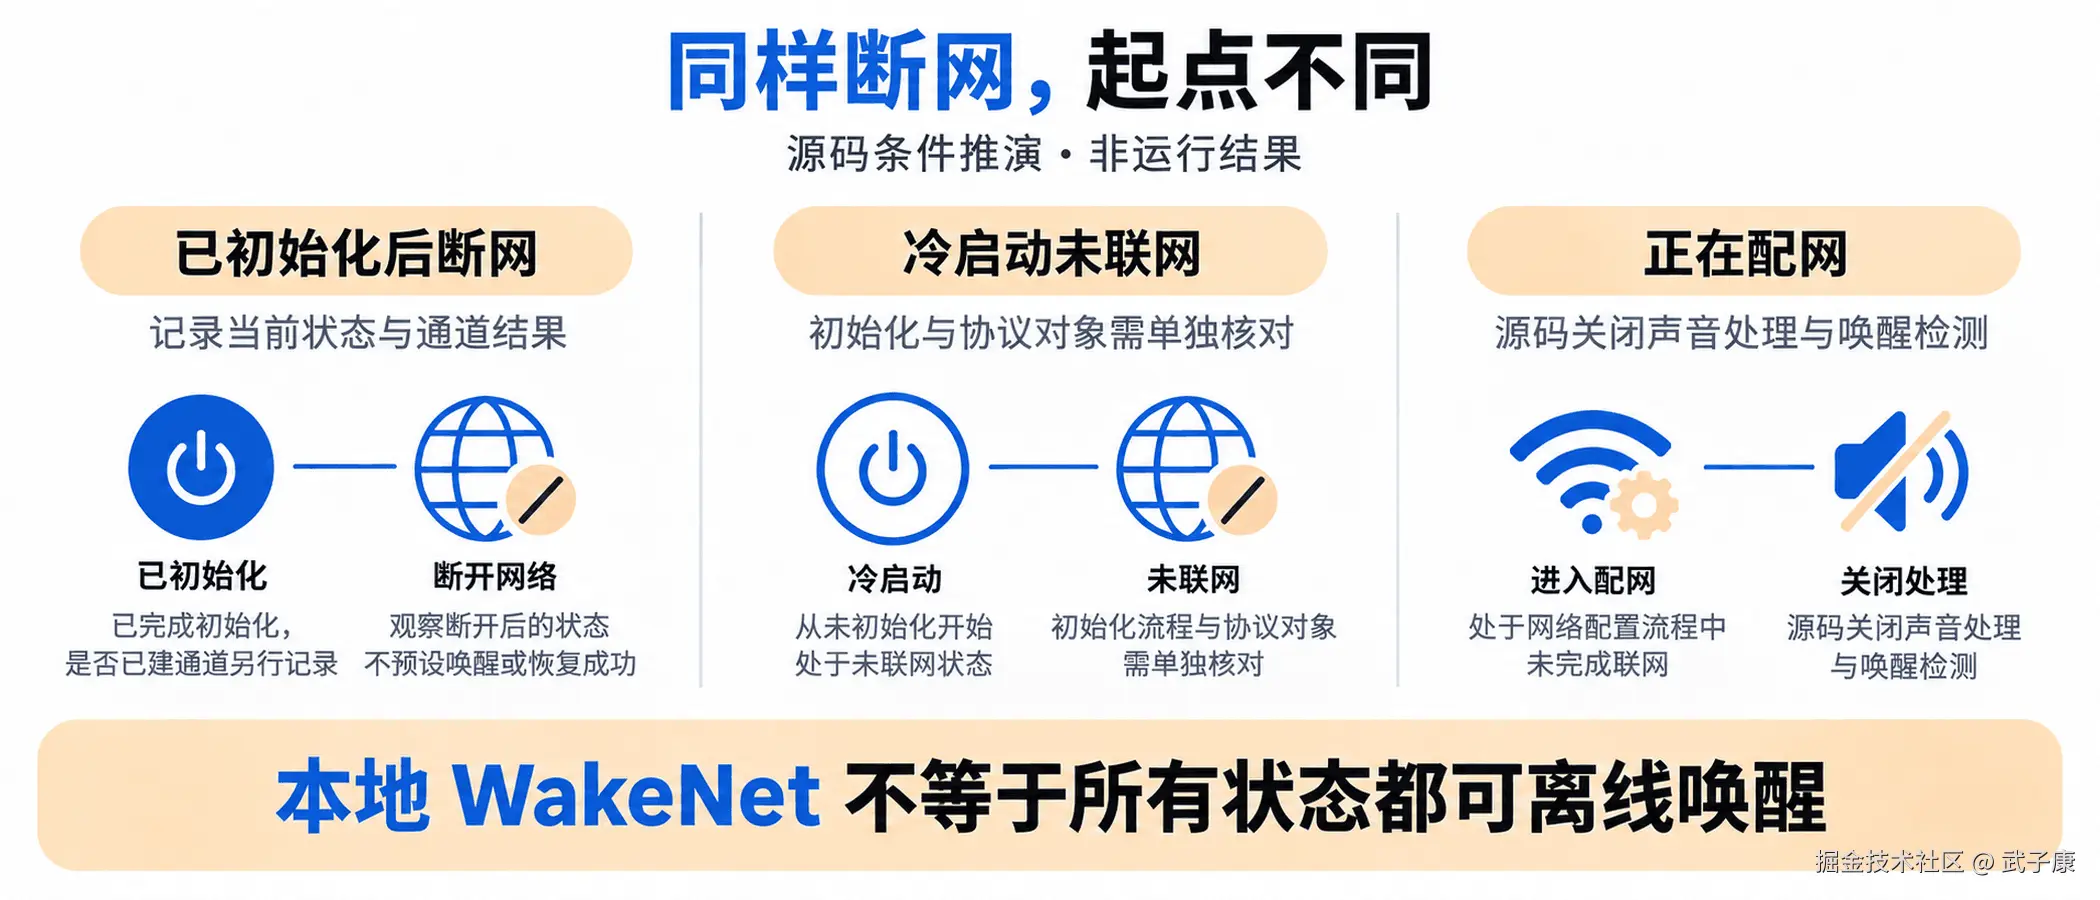
结果应该写成范围明确的句子。例如,"保留局域网并使用已启动的自有服务时,本次新问答完成;设备自身脱网时仅观察到唤醒事件",比"支持离线 AI"更有用。这里只是在示范写法,不是报告本文的测试结果。如果实际只听到提示音,就只记录提示音;没有新问题的识别与回答证据,不能填入问答成功。
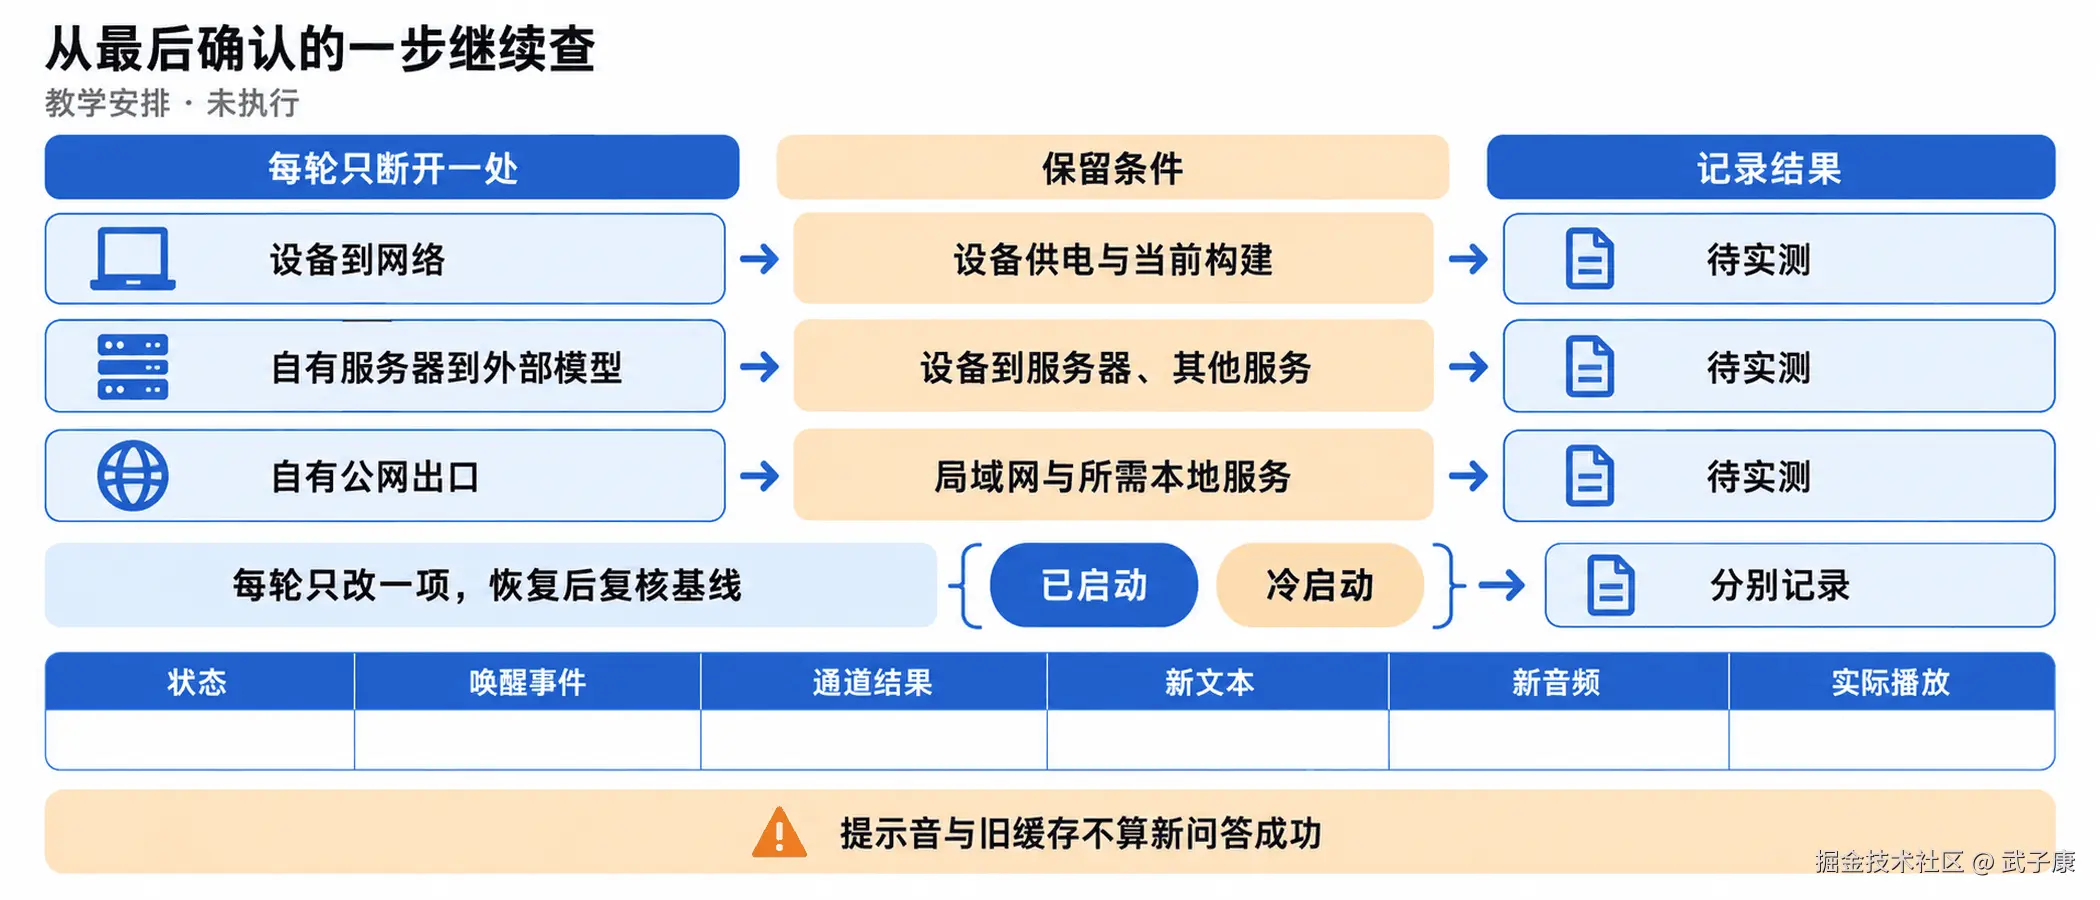
这份记录也能帮助选择下一步工作。若设备侧唤醒事件根本没有出现,先核对该构建的模型、音频输入和状态;若唤醒出现而通道未建立,先查设备到服务入口;若本地服务器收到请求但外部模型不可达,处理的是服务端依赖;若文本与音频已经到设备却未播放,才继续查接收状态和音频输出。每次沿已证实的最后一步前进,避免因为"没有回答"就同时换模型、刷固件和调整麦克风。
最终要承诺的不是一个模糊的"离线"标签,而是某个清楚的可用范围:什么网络仍在、哪些服务仍在、设备从什么状态开始,以及用户还能完成什么动作。小智的本地音频处理与远端问答可以很好地协作;把分界写清楚,才知道为了自己的场景,需要保留哪段连接、搬动哪项计算,或者缩小哪项功能。
错误速查卡
| 症状 | 根因 | 定位 | 修复 |
|---|---|---|---|
| 把"支持离线唤醒"当离线问答保证 | 本地唤醒事件与远端音频通道是两个时刻 | application.cc L897-992 | 区分"声音触发本地事件"与"远端会话可以收音",分别记录 |
| 唤醒命中就以为问答通道可用 | ContinueWakeWordInvoke 中 OpenAudioChannel 失败会 SetDeviceState(kDeviceStateIdle) 并 return |
application.cc L968-976 | 把"打开通道结果"单独记录,不能用一次唤醒命中代替通道建立 |
| 设备再次响应唤醒,就宣称问答恢复 | 回到空闲会重新启用唤醒检测,不等于问答链路恢复 | 同上 | 沿已证实的最后一步前进,不复用同一窗口观察 |
| 把"亮屏/提示音"当"设备已经听懂问题" | 屏幕反馈只是这条时间线上的一个点 | 同上 | 记录:本地检测事件、当时状态、是否尝试打开通道、打开结果 |
| 把"已初始化后断网""冷启动未联网""正在配网"当作同种实验条件 | 三种起点在源码里走不同分支 | 同上 | 分别核对;冷启动与配网需另看状态 |
| 把本地唤醒失败归给麦克风或扬声器 | 音频引擎分支(AFE / Lite)受实际构建与初始化影响 | audio_service.cc L49-101 | 先核对该构建的引擎、模型与初始化状态 |
| 把"有本地模型"当"具备任意语音转文字" | 本地引擎可以跑 WakeNet / MultiNet,不等于开放式 STT 或 LLM | afe_audio_engine.cc L444-502 | 把"唤醒"与"识别"分开,能力分别核验 |
| 把音频采样当作识别文本 | OnOutput 回调交出的是 int16_t 采样,下一站是编码发送队列 |
audio_service.cc L87-89 | 区分采样 / VAD speaking / 唤醒词三类回调的输出类型 |
把 VAD 的 bool speaking 当作问题答案 |
VAD 只报告声音活动状态 | audio_service.cc L90-95 | 把声音活动与文本生成分开记录 |
| 断开后听到几秒声音,就推断问答仍可用 | 播放可来自本地提示音资源或断开前的缓冲 | audio_service.cc | 结合请求时间判断;不预填"问答成功" |
| 把"屏幕出现识别文字"当"模型生成完成" | OnIncomingJson 与 OnIncomingAudio 是两个独立协议入口 |
application.cc | 同时记录识别文本、回答音频、实际播放,对应到同一次请求 |
| 听到"网络错误"提示音就推断识别链路成功 | 预置提示音可能恰好在报告连接失败 | 同上 | 区分"听到声音"与"针对新问题生成回答" |
| 用第三方实现推断官方在线服务的内部架构 | 第三方服务端是开源实现,不代表官方服务组件组织 | README.md | 把"客户端可见协议"与"服务端内部组件"分开讨论 |
| 把"服务器在家里"当"模型计算也在家里" | ChatGLMLLM 配置 url: https://open.bigmodel.cn/api/paas/v4/ |
config.yaml L232-242 | 记录本次连接实际 provider 与最终解析到的服务地址 |
| 把"看到 OllamaLLM 配置"当"当前已用本地模型" | 配置存在不说明当前连接已选择它;localhost 指服务端进程运行环境 | openai.py L23-80 | 核对实际 provider、base_url / url 与可达性,不凭仓库样例代替执行证据 |
| 只改 LLM 就宣布离线化完成 | TTS 适配器会调 edge_tts.Communicate 并读音频流 |
edge.py L46-81 | 检查所有用到的 provider(ASR / LLM / TTS / 工具 / 检索 / 远程配置)的网络依赖 |
| 用仓库样例代替运行态诊断 | 配置加载存在本地覆盖与 API 配置路径 | config_loader.py | 记录本次连接真正使用的 provider 与解析到的服务地址 |
| 把"公网中断时仍能在家里聊天"和"设备完全脱网仍能聊天"混作一个目标 | 两条路线失去的网络不同,前者保留到局域网路径,后者要求能力在设备侧 | 本文"服务器在家里"段落 | 把范围写成"什么网络仍在 / 哪些服务仍在 / 设备从什么状态开始 / 用户还能完成什么" |
| 用"已启动后维持运行"证明"冷启动也不需要外部配置" | 应用启动路径在网络连接后进入激活相关处理 | application.cc | 已启动与冷启动分别记录,不为了得到"离线成功"而删掉冷启动失败 |
| "没有回答"就同时换模型、刷固件、调麦克风 | 多变量同改无法定位 | 本文分段断开教学记录 | 沿已证实的最后一步前进:唤醒事件 / 通道 / 服务端依赖 / 接收播放 |
核查依据
- 官方固件
78/xiaozhi-esp32commitcf2024ff36b3af1d651a68ee582cbb91986ec4d4:4 个 GitHub blob 链接全部 HTTP 200(application.cc / audio_service.cc / afe_audio_engine.cc / README.md)。 - 第三方服务端
xinnan-tech/xiaozhi-esp32-servercommit6afc54a17def47578a4b3efc4680873689d3168b:4 个 GitHub blob 链接全部 HTTP 200(config.yaml / openai.py / edge.py / config_loader.py)。 - 6 张图均
curl -fsSL下载到/tmp/blog-imgs15/01-06并已read工具解读(页眉 XIAOZHI / 唤醒与问答的分界,2026-09-16 核验)。 - 资料检查日期 2026-09-16;二者未经本文配对联调;以下没有设备实测、恢复耗时或识别率结果,也不以第三方实现推断官方在线服务的内部架构。