介绍:认识 RF-DETR
-
- [0.1 它是什么](#0.1 它是什么)
- [0.2 YOLO 用户为什么要多看它一眼](#0.2 YOLO 用户为什么要多看它一眼)
- [0.3 环境与素材(本机实测口径)](#0.3 环境与素材(本机实测口径))
- [第一章 关键点推理:从检测框到人体骨骼](#第一章 关键点推理:从检测框到人体骨骼)
-
- [1.1 Keypoint Preview:一个模型,17 个关节](#1.1 Keypoint Preview:一个模型,17 个关节)
- [1.2 单图推理与 KeyPoints 输出结构](#1.2 单图推理与 KeyPoints 输出结构)
- [1.3 四个骨骼标注器(两个是新的)](#1.3 四个骨骼标注器(两个是新的))
- [1.4 视频 / 摄像头 / RTSP 帧循环](#1.4 视频 / 摄像头 / RTSP 帧循环)
- [1.5 与姊妹篇 yolo11n-pose 的路线对照](#1.5 与姊妹篇 yolo11n-pose 的路线对照)
- [1.6 实测:RTX 5060 上的关键点推理](#1.6 实测:RTX 5060 上的关键点推理)
- [1.7 本章方法速查](#1.7 本章方法速查)
- [第二章 微调:训练自己的模型](#第二章 微调:训练自己的模型)
-
- [2.1 训练前置:extra 与数据格式](#2.1 训练前置:extra 与数据格式)
- [2.2 `model.train()`:一行微调](#2.2
model.train():一行微调) - [2.3 训练产物:五种 checkpoint 的分工](#2.3 训练产物:五种 checkpoint 的分工)
- [2.4 `model.evaluate()`:一次评测,三种返回](#2.4
model.evaluate():一次评测,三种返回) - [2.5 实验一:迷你数据集烟测(全程离线)](#2.5 实验一:迷你数据集烟测(全程离线))
- [2.6 实验二:关键点微调烟测(伪标注骨骼)](#2.6 实验二:关键点微调烟测(伪标注骨骼))
- [2.7 本章方法速查](#2.7 本章方法速查)
- [2.8 导出部署速览](#2.8 导出部署速览)
本教程是《OpenCV 之外的另一半工具箱:Supervision 视觉工程实战》的姊妹篇。讲"检测结果从哪来"------认识并驾驭一个比 YOLO 更适合微调的检测器:RF-DETR。
0.1 它是什么
RF-DETR 是 Roboflow 2025 年开源的实时目标检测器,名字里的 RF 是 Roboflow,DETR 是 Detection Transformer------也就是检测领域的 Transformer 架构家族。它用 DINOv2 预训练骨干网络 + DETR 式解码器的设计,主打一个卖点:微调之后的精度-速度平衡。官方在 COCO 预训练模型的对比图里,它坐在"精度-延迟"帕累托曲线的前沿;而真正拉开差距的是微调场景------用自有数据集微调后,同量级模型的精度对比里 RF-DETR 常年领先 YOLO 系一个身位,这也是它敢在文档标题里写 "state-of-the-art fine-tuning" 的底气。
模型规格分档清晰:Nano / Small / Medium / Large 四档为主力(另有 Seg 分割、Keypoint 关键点变体),从边缘设备到服务器都能找到对应的档位;预训练权重基于 COCO 80 类,加载即用。几个常被引用的官方基准数字:检测档 COCO AP50:95 从 Nano 48.4 到 2XLarge 60.1(作为对照,YOLOv11-X 只有 50.9,而 RF-DETR-L 的 56.5 还比它快三分之一);本教程用到的两个数------关键点 Preview 71.8 AP、Nano 2.3 ms------分别见第一章与 2.8。
读官方基准数字前先看口径 ,三条值得学走的规矩(官方 benchmarks 页自己交代的方法论,比数字本身更值钱):① 延迟全部测自 T4 + TensorRT 10.4 + FP16 + batch 1 ,且两次前向间垫 200 ms 防降频------换硬件、换精度、换批量,数字都不能直接套;② 精度和延迟用同一份权重、同一精度测 ------拿 FP32 的精度配 FP16 的延迟对比竞品是行业惯用障眼法,朴素 FP16 转换可能明显掉精度;③ 全部模型(含竞品)用 pycocotools 在同一协议下重测 而非照抄厂商报告,官方页上与厂商数字有出入属正常。另外检测表里还有一组 RF100-VL 列(100 个跨领域数据集的平均精度):RF-DETR 全档位领先 YOLO 系 2--5 个点,衡量的是换域泛化------预训练模型直接拿到陌生领域还有多少底子,对工业场景选型很有参考价值。
协议是 Apache-2.0,免费商用------这一点与 ultralytics 的 AGPL-3.0 形成直接对照,也是很多团队认真评估它的第一原因。
0.2 YOLO 用户为什么要多看它一眼
如果你已经用过 YOLO,RF-DETR 值得纳入武器库的理由有四个:
- 协议干净。Apache-2.0 没有强Copyleft约束,商用、闭源、二次分发都不需要像使用 AGPL 的 ultralytics 那样反复确认边界。整套教程的合规组合(supervision MIT + RF-DETR Apache-2.0)在姊妹篇里论证过,这里直接继承。
- 微调是它的主场。DETR 系架构 + DINOv2 大规模预训练骨干,让它在小数据集微调时收敛快、上限高------"只有几百张标注图也要训自己的检测器"正是工业落地的常态,这个场景下它的优势最明显。
- 端到端的另一种范式。YOLO 是"锚框/无锚框 + NMS 后处理"的 CNN 路线,DETR 系是"集合预测"的 Transformer 路线。两条路线的踩坑点完全不同(后者没有 NMS 调参的烦恼,但对数据量、学习率更敏感),多会一种,选型时才不会被单一路线绑架。
- 与 supervision 原生一体 。
predict()直接返回sv.Detections,姊妹篇的全部下游技能(标注、切片、追踪、评测)零成本复用。
0.3 环境与素材(本机实测口径)
与姊妹篇同一台机器、同一套环境,实测数字均可复现:
| 项目 | 配置 |
|---|---|
| 显卡 | RTX 5060 Laptop(Blackwell 架构,sm_120) |
| 关键依赖 | torch 2.11.0+cu128(Blackwell 必须 CUDA ≥ 12.8)、supervision 0.30 |
| 检测库 | rfdetr 1.10.1(pip install rfdetr)、ultralytics(对照实验用) |
| 素材原则 | 公开素材(街景图、公开行人视频) |
全文代码基于 rfdetr 1.10+ 口径编写:网上旧教程大量使用的 RFDETRBase、optimize_for_inference() 等写法已在新版弃用或移除,抄旧代码报错时先对版本;1.4→1.10 的完整升级对照见官方 Migration 指南。
第一章 关键点推理:从检测框到人体骨骼
1.1 Keypoint Preview:一个模型,17 个关节
RF-DETR 关键点模型目前只有一个预览版 :RFDETRKeypointPreview------在 COCO person 关键点上预训练,每个人输出 17 个骨骼关节(K=17,COCO 标准关键点定义)。
| 规格 | 数值 |
|---|---|
| COCO AP50:95(person 关键点,OKS sigmas) | 71.8 |
| 延迟(T4 / TensorRT FP16 / batch 1) | 9.7 ms |
| 参数量 | 40.7 M |
| 输入分辨率 | 576×576 |
| 协议 | Apache-2.0 |
官方口径:同延迟下超过 YOLO26-pose X 与 YOLO11-pose X。两点使用前提要知道:
- 仅 rfdetr 包提供(inference 包暂不支持);
- Preview = 早期访问:API 与权重在正式版前可能变动,且官方明说"微调自定义关键点数据集才是主要用途"------预训练模型是起点,不是终点。姿态分析类需求(跌倒检测、作业姿势评估)微调自有数据时走的就是它。
1.2 单图推理与 KeyPoints 输出结构
python
import cv2
import supervision as sv
from rfdetr import RFDETRKeypointPreview

model = RFDETRKeypointPreview()

image_bgr = cv2.imread("dog.jpeg")
image_rgb = cv2.cvtColor(image_bgr, cv2.COLOR_BGR2RGB)   # ⚠️ 必须 RGB(第一章铁律)
kp = model.predict(image_rgb, threshold=0.5)

annotated = sv.EdgeAnnotator().annotate(image_rgb, kp)
predict() 返回的是 sv.KeyPoints (不是 sv.Detections)------姊妹篇第五章用 ultralytics 姿态模型时经 KeyPoints.from_ultralytics 转过一次,这里 rfdetr 是原生直出。逐字段拆解(N=检出人数,K=17):
| 字段 | 形状 | 说明 |
|---|---|---|
kp.xy |
(N, 17, 2) | 每人每个关节的像素坐标 |
kp.keypoint_confidence |
(N, 17) | 关节级可找到度得分------过滤低置信关节就靠它 |
kp.detection_confidence |
(N,) | 实例级 检测分,threshold 过滤的就是它;注意它包含默认的不确定性融合项,归一到 [0, 1) |
kp.data["xyxy"] |
(N, 4) | 每人对应的检测框------关键点模型也自带框,下游想接框类标注器/追踪器不用自己拼 |
kp.data["class_name"] |
(N,) | 类名解析 |
kp.data["source_image"] |
list | 源图存一份,N 个条目指向同一数组,取 [0] |
⚠️ 本章最大的坑在 class_id :COCO 预训练权重用的是稀疏类别 ID(1--90 的 COCO 原始编号) ,而且关键点模型存在"背景槽位"的历史版本差异(新版 one-class 是 0=前景、1=__background__;旧版背景优先则是 0 号槽位给背景)。实测直接踩中 :本机加载 Preview 权重推理,输出的 class_id=[1]、class_name=['person']------前景 person 落在 1 号槽位 (背景优先的老式编号),按"0=前景"的直觉去索引就会拿错。结论:永远用 data["class_name"] 解析类名,不要拿 class_id 去索引自己的类别表。
另一个语义差异要留意:ultralytics 的 conf 是单一检测分,rfdetr 关键点模型的置信度分关节级和实例级两层 ,过滤时机不同------实例级过滤靠 threshold 参数(推理时),关节级过滤靠 keypoint_confidence(推理后,见 1.3)。
顺带一个实用特性:批量推理 。predict() 除了单图还接受图片列表 ,多图打包进一次前向传播,返回对应长度的结果列表------检测模型返回 Detections 列表,关键点模型返回 KeyPoints 列表(本机实测确认两者都支持)。离线批量处理图片集时,这一条比逐帧循环省不少吞吐;官方 Pretrained Models 页专门给了示例代码。
1.3 四个骨骼标注器(两个是新的)
supervision 提供四个关键点标注器,均自动跳过 visible=False 的关节:
| 标注器 | 画什么 | 备注 |
|---|---|---|
sv.EdgeAnnotator |
骨架连线(关节间连接线) | 姊妹篇第五章已实测 |
sv.VertexAnnotator |
每个关节一个圆点 | 姊妹篇第五章已实测 |
sv.VertexEllipseAnnotator |
每个关节一个协方差椭圆(来自 data["covariance"]) |
新增:把逐关节不确定度画成"椭圆脚印" |
sv.VertexEllipseHaloAnnotator |
同上 + 柔光晕 | 新增:复杂背景上对比度更好 |
椭圆两个标注器是官方文档新出现的玩法------不是把关节画出来,而是把模型对每个关节位置的不确定程度可视化,做低置信关节诊断时比纯圆点直观。四个标注器在本机 supervision 0.30 均已就位(hasattr 逐一验证通过)。
一个实测发现要先泼盆冷水 :协方差椭圆的大小直接反映不确定度------当人物被严重遮挡(关节基本靠猜)时,椭圆会被撑得巨大、互相叠满整个画面(1.6 的实测图就是活例)。所以椭圆标注器适合人物基本完整可见的画面做不确定度诊断,光晕版在复杂背景上更醒目,但救不了遮挡场景。
手动隐藏低置信关节的官方写法:对 keypoint_confidence 做阈值,把低于阈值的关节在 kp.visible 里写成 False------标注器会自动跳过,无需自己改坐标。
1.4 视频 / 摄像头 / RTSP 帧循环
官方三段循环(视频文件 / 摄像头 / RTSP)骨架完全一致,只有 VideoCapture 的源不同:
python
video_capture = cv2.VideoCapture("video.mp4")     # 摄像头传 0,RTSP 传流地址
edge = sv.EdgeAnnotator()
vertex = sv.VertexAnnotator()

while True:
    ok, frame_bgr = video_capture.read()
    if not ok:
        break

    frame_rgb = cv2.cvtColor(frame_bgr, cv2.COLOR_BGR2RGB)   # ⚠️ 全章唯一的硬坑
    kp = model.predict(frame_rgb, threshold=0.5)

    annotated = edge.annotate(frame_rgb, kp)
    annotated = vertex.annotate(annotated, kp)
    cv2.imshow("RF-DETR Keypoint", annotated)
    if cv2.waitKey(1) & 0xFF == ord("q"):
        break
三点说明:
- BGR→RGB 是静默坑:不转不报错,但检出率悄悄下降(第一章检测实验实测过同一现象),多路接入时建议在取流层统一转好。
- 姊妹篇的
sv.process_video同样可用;裸循环的好处是摄像头 / RTSP 只换源不换逻辑,适合快速验证。 - 标注在 RGB 图上做、展示存盘前转回 BGR------官方示例里两个通道混着用没出问题(绘制不挑通道),但要保证推理输入的通道顺序正确。
1.5 与姊妹篇 yolo11n-pose 的路线对照
| 环节 | ultralytics(姊妹篇第五章) | rfdetr(本章) |
|---|---|---|
| 加载 | YOLO("yolo11n-pose.pt") |
RFDETRKeypointPreview() |
| 推理输出 | Results → sv.KeyPoints.from_ultralytics() 转换 |
原生直出 sv.KeyPoints |
| 检测框 | 需另取 results.boxes |
kp.data["xyxy"] 直接带 |
| 关节过滤 | 手动按 conf 掩码 | visible 布尔,标注器原生支持 |
| 不确定度可视化 | 无 | 协方差椭圆两个标注器 |
| 协议 | AGPL-3.0 | Apache-2.0 |
技能完全迁移:姊妹篇第五章的 as_detections、DetectionsSmoother 平滑、Edge/Vertex 标注在 rfdetr 输出上原样可用。
1.6 实测:RTX 5060 上的关键点推理
以下全部数字来自本机的实测输出(RTX 5060 Laptop / cu128 / rfdetr 1.10.1 / supervision 0.30)。
加载与权重 :权重文件 rf-detr-keypoint-preview-xlarge.pth(约百 MB 级,首次自动下载,MD5 校验),进程内就绪 1.3 秒。加载日志里两条警告值得读:checkpoint 按 1 类 配置(模型骨架按 90 类构建,加载时用 checkpoint 的 1 类)、keypoint schema 从 [17] 临时调整为 checkpoint 的 [0, 17]------0 是背景槽位 + 17 个关节,正好印证 1.2 的 class_id 坑不是文档危言。
单图推理(dog.jpeg,人被狗遮挡大半的街景):
| threshold | 检出人数 | detection_confidence |
|---|---|---|
| 0.25 | 2 | 0.666 / 0.253 |
| 0.50 | 1 | 0.666 |
| 0.75 | 0 | --- |
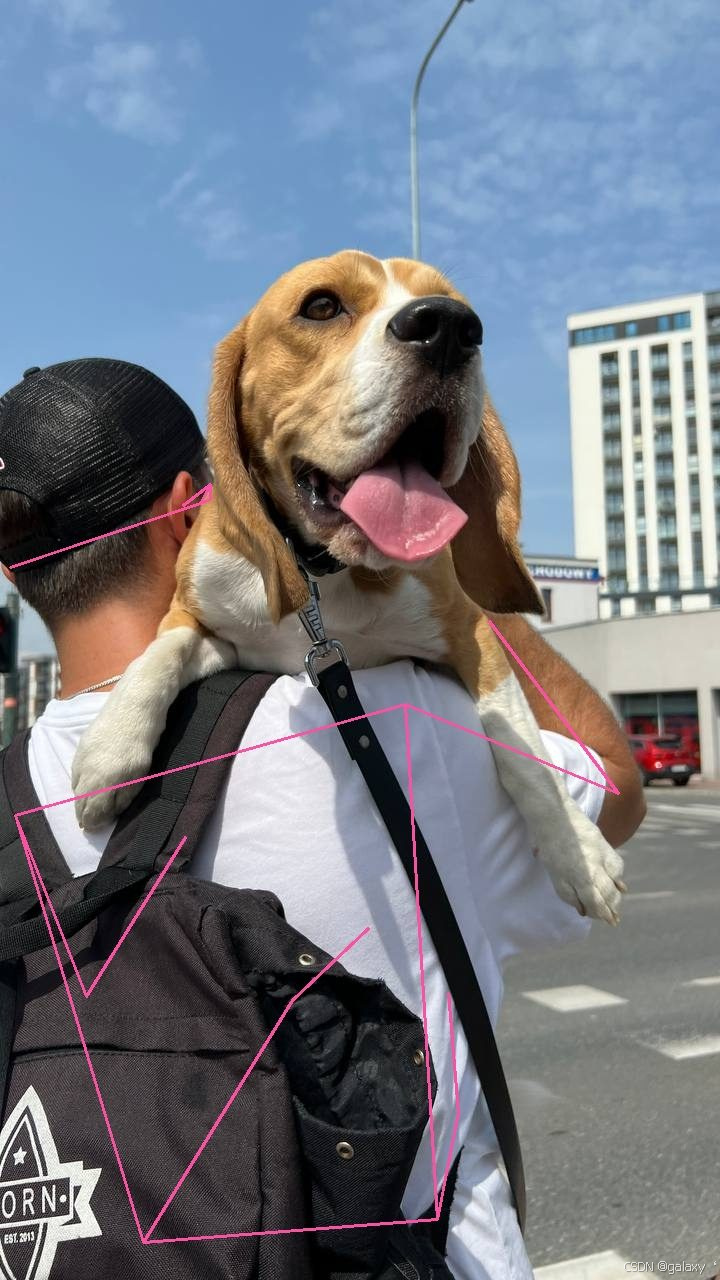
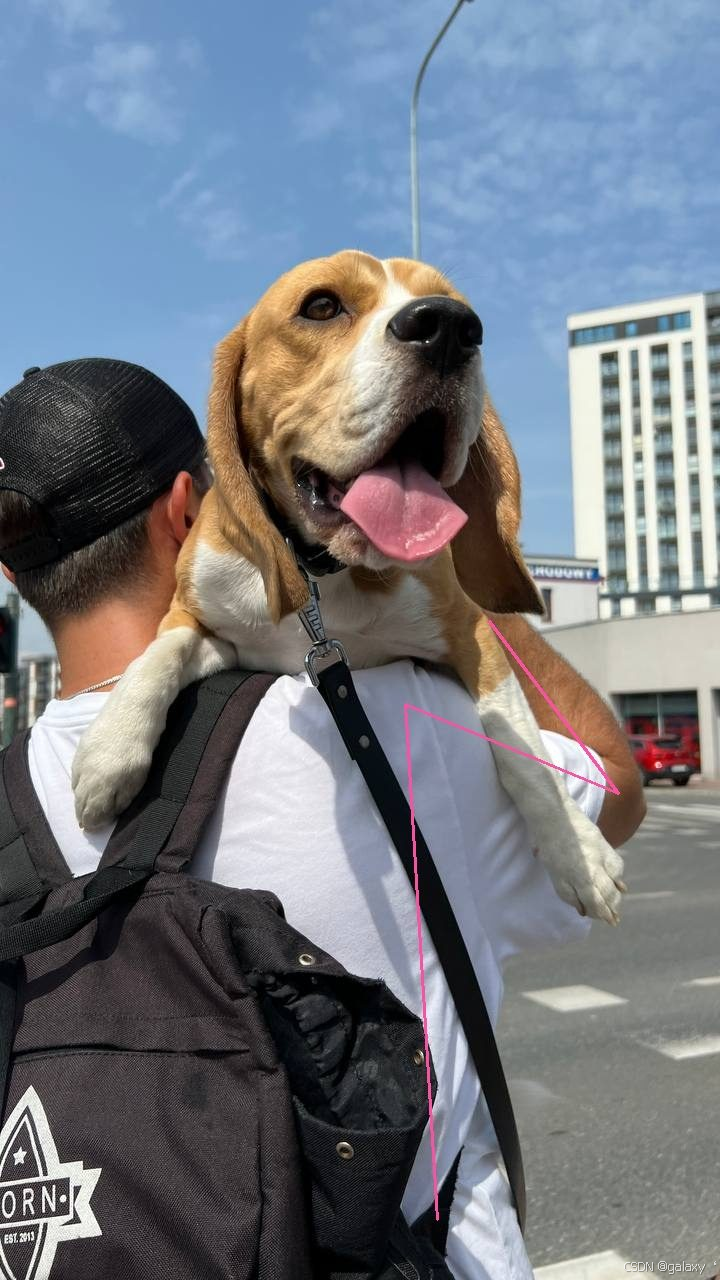
阈值 0.5 检出的那 1 个人,17 个关节里 12 个置信度低于 0.5 (被遮挡的下半身基本靠猜),而右肩 / 右耳 / 右肘 / 右腕高达 0.96--1.00------"实例检出了,但一半关节不可信",正是 visible 过滤的用武之地(1.3)。不过滤直接画骨架就是下面这样------猜测关节的连线画成离谱锯齿:
开了 visible 过滤之后,猜测关节连同锯齿线一起消失,只剩可信的上半身------同一个模型、同一张图,正反两版对照:
另注意 0.75 阈值下全军覆没:关键点模型的实例分普遍比检测模型低(含不确定性融合项),阈值不宜照搬检测习惯的 0.5+。
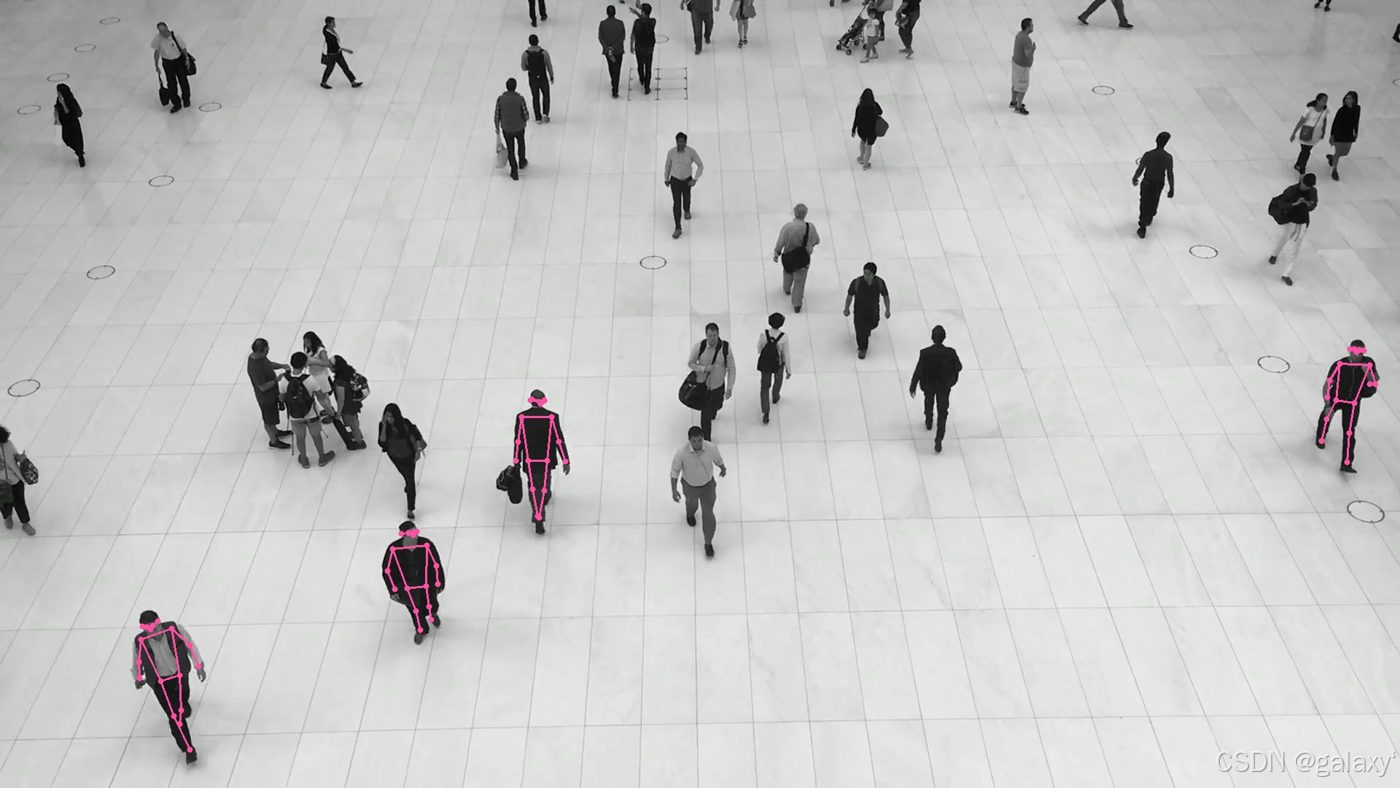
视频循环(people-walking.mp4,341 帧广场俯拍):
- 未做推理优化(日志提示
Model is not optimized for inference):单帧延迟均值 77.5 ms / 中位 76.7 ms / P95 93.5 ms,等效 12.9 FPS 。对比官方 T4 + TensorRT FP16 的 9.7ms------差距大头在 fp16 与 TensorRT(官方称优化后 T4 可再快约 8 倍),model.inference(dtype=float16)的优化实验留给部署章。 - 逐帧人数:均值 7.29 / 最大 12 / 最小 4,100% 的帧都有人------全程无追踪断链。
- 画面里行人远多于骨骼数(见上方样帧):远处小目标要么实例分过不了 0.5,要么关节置信度低被隐藏。姿态模型"只管抓得住的人"------远景人群分析要么降阈值、要么换更高分辨率输入,这组数字就是选型依据。
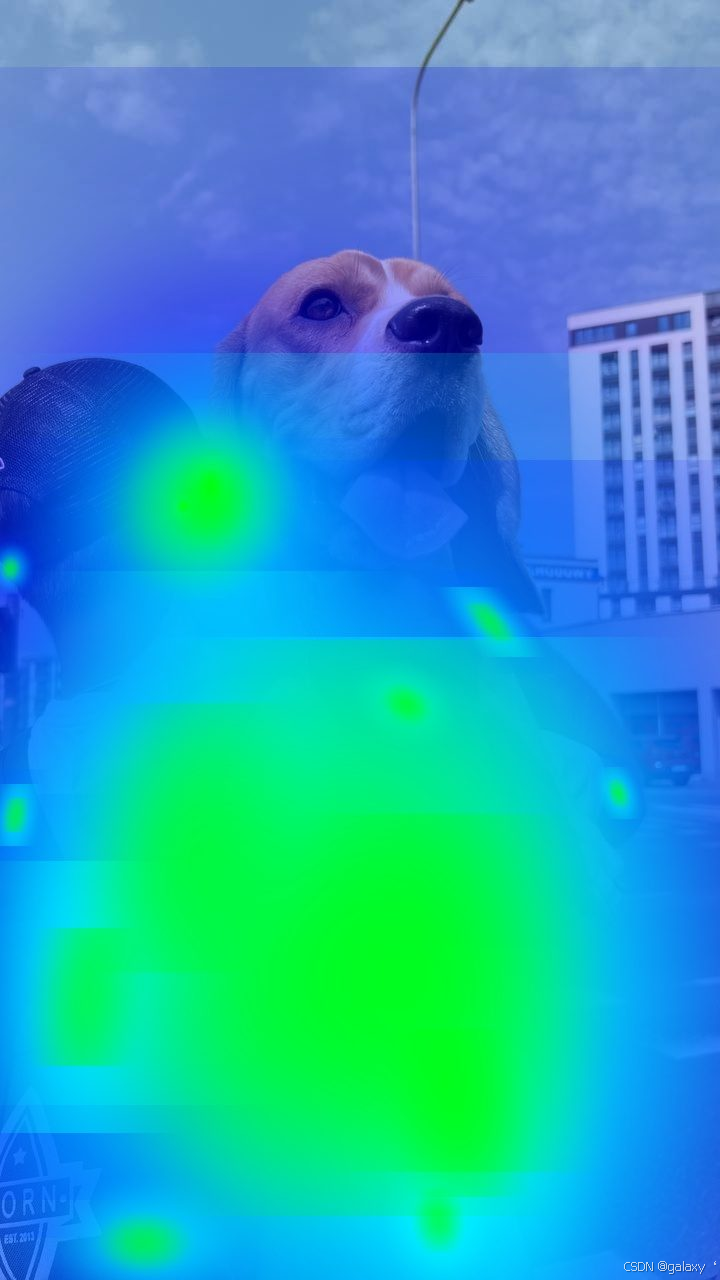
椭圆光晕的实测教训 :dog.jpeg 那个被遮挡人物的 VertexEllipseHaloAnnotator 输出里,巨大光斑铺满画面------不确定度可视化诚实地暴露了"这半个人是猜的",再次印证 1.3 的提醒:椭圆标注器只适合人物完整可见的画面。
1.7 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
RFDETRKeypointPreview() |
加载关键点模型(COCO person 17 关节) | 无必填参 | 首次运行自动下载权重;Preview 版 API/权重可能变动;仅 rfdetr 包提供 |
model.predict(image, threshold=0.5) |
关键点推理 | 必须喂 RGB ;threshold 过滤的是实例级 detection_confidence(含不确定性融合项,归一 [0,1)) |
返回 sv.KeyPoints,不是 sv.Detections |
kp.xy / kp.keypoint_confidence |
关节坐标 / 关节级置信度 | 形状 (N,17,2) / (N,17) | 关节级过滤:阈值后写 kp.visible,标注器自动跳过 False |
kp.data["xyxy"] |
每人对应检测框 | --- | (N,4) 数组;接框类标注器/追踪器不必自己拼框 |
kp.data["class_name"] |
类名解析 | --- | ⚠️ class_id 是稀疏 COCO 编号(1--90)且有背景槽位差异,不要拿它索引类别表 |
sv.EdgeAnnotator / VertexAnnotator |
骨架连线 / 关节圆点 | annotate(image, key_points) |
姊妹篇第五章已实测;visible=False 的关节自动跳过 |
sv.VertexEllipseAnnotator / VertexEllipseHaloAnnotator |
协方差椭圆 / 椭圆+光晕 | 依赖 data["covariance"] |
官方新增:逐关节不确定度可视化,supervision 0.30 已就位 |
cv2.VideoCapture(...) |
视频源接入 | 文件路径 / 摄像头索引 0 / RTSP 地址 | 官方三段循环只差源;cvtColor(BGR2RGB) 是唯一硬坑 |
第二章 微调:训练自己的模型
2.1 训练前置:extra 与数据格式
训练依赖不在基础包里,先装:
bash
pip install "rfdetr[train]"            # 训练栈(PyTorch Lightning 等)
pip install "rfdetr[train,loggers]" # 可选:TensorBoard / W&B / MLflow 实验追踪数据格式自动检测 ,不用手动指定------train() 按目录结构认格式:
| 格式 | 检测依据 | 说明 |
|---|---|---|
| COCO | train/_annotations.coco.json |
Roboflow 导出(dataset_file="roboflow")开箱即用 |
| YOLO | data.yaml + train/images/ |
YOLO 姿态数据集须在 data.yaml 声明 kpt_shape |
两种格式的口径速览:
COCO                                  YOLO
dataset/                              dataset/
├── train/                            ├── data.yaml          # names / nc / train / val / test
│   ├── _annotations.coco.json        ├── train/
│   └── *.jpg                         │   ├── images/
├── valid/(同 train 布局)           │   └── labels/        # 每图一个同名 .txt
└── test/(同 train 布局)            ├── valid/ ...  └── test/ ...
标注口径的四个差异点:
- 框的表示 :COCO
bbox=[x, y, w, h]------左上角原点、像素值;YOLO 每行class_id x_center y_center w h------中心点表示且全部归一化到 0--1。 - 类别 ID :COCO 的
category_id必须与categories数组对得上(可以从 1 起,实验 A 建库时重映射成连续 ID 就是这个原因);YOLO 的class_id是data.yaml里names的 0 起下标。 - 分割 :COCO 在标注里加
segmentation键(多边形坐标的扁平列表);YOLO 在行尾直接接多边形顶点(同样归一化)。 - 关键点 :COCO 走
keypoints=[x,y,v]*K,category 里声明关节名单与 skeleton(实验 B 建库用的就是这套);YOLO pose 在 data.yaml 声明kpt_shape: [17, 3],flip_idx(左右翻转置换)会被自动换算成keypoint_flip_pairs------2.6 说的"schema 能推断出来就带上"就是这条链路;kpt_shape: [K, 2]时可见性由库合成(非零点记 2,(0,0)记 0)。
空标注图(负样本图,"这张图没框"也要能表达):
| 格式 | 做法 |
|---|---|
| COCO | 图片照常进 images 数组,annotations 里不加它的标注 |
| YOLO | 建一个 0 字节的空 .txt,或干脆不放标签文件 |
格式互转不用重标------supervision(姊妹篇主角)四个方法包办:
python
import supervision as sv

# YOLO → COCO
ds = sv.DetectionDataset.from_yolo(
    images_directory_path="yolo/images", annotations_directory_path="yolo/labels",
    data_yaml_path="yolo/data.yaml")
ds.as_coco(images_directory_path="coco/images",
           annotations_path="coco/annotations.json")

# COCO → YOLO
ds = sv.DetectionDataset.from_coco(
    images_directory_path="coco/images", annotations_path="coco/annotations.json")
ds.as_yolo(images_directory_path="out/images",
           annotations_directory_path="out/labels", data_yaml_path="out/data.yaml")
选型口径(官方原话):两种格式 RF-DETR 处理得一模一样,手头是哪种就用哪种,不为模型迁就格式。
版本口径提醒:rfdetr 1.10 起 grad_accum_steps 默认为 1(1.4 时代默认 4)------网上旧教程的"有效批大小"算法和现在不同,照抄会得到不一样的优化行为。
2.2 model.train():一行微调
python
from rfdetr import RFDETRNano

model = RFDETRNano()   # 实例化即自动下载 COCO 预训练权重,微调从这里起步

model.train(
    dataset_dir="dataset/",   # COCO 或 YOLO 格式,自动检测
    epochs=10,
    batch_size="auto",        # 官方推荐的移植起点
    lr=1e-4,
    output_dir="output/run1",
)| 参数 | 默认 | 说明 |
|---|---|---|
dataset_dir |
必填 | 数据集根目录(含 train/valid 划分) |
epochs |
--- | 轮数;微调场景 10--50 常见 |
batch_size |
"auto" |
探测当前 GPU 显存 → 定物理 batch,并给出梯度累积建议值;CPU / MPS 必须传整数 |
grad_accum_steps |
1 | 梯度累积;1.10 默认 1,设大可放大有效批大小 |
lr |
1e-4(检测/分割) | 关键点 Preview 官方示例用 2e-5;另有 lr_encoder 单独控骨干学习率 |
output_dir |
--- | 训练产物目录(2.3 详解) |
train() 的完整参数有 40 多个,微调最常碰的可选项挑这些:
| 参数 | 默认 | 说明 |
|---|---|---|
lr_encoder |
1.5e-4 | 骨干编码器专属学习率,想"管住骨干慢慢调"就压低它 |
resolution |
模型相关 | 输入分辨率(须满足模型整除规则);实验 B 自动升到 576、检测 384,就是各模型的这个默认值 |
warmup_epochs |
0.0 | 线性学习率预热轮数,长周期训练建议开 |
seed |
None |
全局随机种子,复现实验时定死 |
early_stopping 三件套 |
False / patience=10 / min_delta=0.001 |
早停默认关 (2.3 有实锤);开了记得配 best_model_metric("map" / "mar") |
skip_best_epochs |
0 | 微调预训练权重时建议设几轮,防止最初波动把"最佳"记录与早停计数带偏 |
checkpoint_interval |
10 | 周期 checkpoint 间隔(实验 B 的 checkpoint_9.ckpt 就是它落盘的) |
resume |
None |
断点续训:.ckpt 恢复优化器/调度器全状态,轻量 .pth 则重启优化器 |
wandb / mlflow / project / run |
False / None |
W&B / MLflow 实验追踪,可同时开(配 project 分组、run 命名单次训练,不指定自动随机名;需 rfdetr[train,loggers])。⚠️ clearml=True 尚未实装,传了直接 NotImplementedError------要用 ClearML 得在训练前手动 Task.init() 借 SDK 自动绑定 |
eval_interval |
1 | 每 N 轮跑一次完整验证,长训练省时间 |
compute_val_loss |
"auto" |
验证 loss 计算(2.5 日志速读里有条目) |
还有两类参数容易踩混:
- 构造器参数 :
gradient_checkpointing=True(8GB 卡救星 :省 30--40% 显存,代价是慢约 20%,RFDETRNano(gradient_checkpointing=True)这样传)、num_keypoints_per_class、keypoint_flip_pairs都在模型构造函数 里传,不进train(); - 已废弃参数 :网上旧代码里的
eval_ema_only、lr_drop、lr_min_factor已被移除或改道(分别换eval_base_model和lr_scheduler+lr_scheduler_kwargs------后者接受"step"/"cosine"预设或任意 PyTorch 调度器导入路径),照抄会被忽略或报错。优化器同理可换:TrainConfig.optimizer接受"adamw"/"sgd"短名、导入路径或可调用对象,但换了之后fused_optimizer和"auto"显存估算都不再生效。
batch_size="auto" 的机制值得知道:它先探测硬件能塞下的物理 batch,再对照配置的有效批目标给出累积建议------官方明说这不保证优化等价(物理 batch 变大本身就会改变吞吐与行为),但在换卡、换分辨率时是省心的默认值。
⚠️ 实测坑(8GB 级笔记本 GPU) :"auto" 的探测从大候选起跳,逐级回退到能塞下的尺寸------但探测的前提是显存基本空闲 。两个叠加因素会让探测阶段直接 CUDA out of memory(连 torch.cuda.empty_cache() 都失败):① 同一进程里上一步加载的模型没释放(比如先用 Medium 伪标注、再训 Nano------del model + torch.cuda.empty_cache() 必须做);② 探测本身首跳过大,8GB 卡没有回退余地。结论:显存 ≤8GB 的卡不要用 "auto",直接给整数 (如 batch_size=4, grad_accum_steps=1,还不够就 2),稳定且行为可预期。补充:探测行为受几个 auto_batch_* 参数控制(目标有效批 auto_batch_target_effective=16、探测时的每图合成目标上限、EMA 显存预留比例 0.7)------显存紧张的卡也可以保留 auto 但把目标有效批调小,让探测从更小的候选起跳。
官方也给了显存档位参考配置 (按默认 Medium 模型口径;Nano 更小可以更宽------我们 8GB 卡 batch_size=4 跑 Nano 毫无压力,比官方 8GB 档还激进):
| 显存 | 配置 |
|---|---|
| 8GB | batch_size=1, grad_accum_steps=16, gradient_checkpointing=True, resolution=576 |
| 12GB | batch_size=2, grad_accum_steps=8, gradient_checkpointing=True |
| 16GB | batch_size=4, grad_accum_steps=4 |
| 24GB | batch_size=8, grad_accum_steps=2 |
| 40GB+ | batch_size=16, grad_accum_steps=1, resolution=768 |
⚠️ 实测坑(Windows + 多进程 DataLoader) :训练时 DataLoader 会启动 worker 子进程加载增强后的批次,Windows 上走的是 spawn 模式------子进程会重新执行你的脚本顶层代码 。如果整个流程(伪标注 → 建库 → 训练)平铺在脚本顶层而没有 if __name__ == "__main__": 守卫,子进程会把脚本从头再跑一遍、再跑一遍(日志里第 1 步、第 2 步反复刷屏就是症状),最终抛 RuntimeError: DataLoader worker exited unexpectedly。Linux 默认 fork,这个问题完全隐形,所以官方示例从不提------Windows 用户务必把逻辑包进 main() 函数再加守卫。
四个进阶口径,真实项目迟早用上:
- 断点续训 :
resume="output/last.ckpt"加载的是全状态 ------模型权重、优化器、学习率调度器、训练轮数全部续上;而checkpoint_best_total.pth这类轻量.pth是故意省掉优化器/调度器 的小体积存档,拿它续训优化器从零开始,且 best 分数追踪还要求output_dir与当初完全一致 。口径一句话:接着上次练用resume,拿旧权重开新训练用pretrain_weights。 - 多 GPU :训练脚本照写,
model.train(..., devices="auto"),然后用torchrun --nproc_per_node=4 train.py启动。最大的坑:devices必须显式传 ------默认devices=1,就算 torchrun 拉起多进程也依然静默单卡。有效批 =batch_size × grad_accum_steps × GPU 数,换卡数时等比换算;关键点模型多卡建议grad_accum_steps=1(手动优化下每个 microbatch 都会同步一次梯度,累积只多付通信费),且不支持 FSDP/DeepSpeed 分片策略。 - 自定义增强 :默认 torchvision 增强(缩放抖动 + 50% 水平翻转)零配置;传非空
aug_config字典即切到 Albumentations 栈(需装rfdetr[train,augment])------框会随几何变换自动旋转平移、像素级变换(模糊/噪声/色彩)不动坐标,联动完全自动不用管;augmentation_backend可强制管线:"torchvision"钉死默认行为、"kornia"走 GPU 批处理、"auto"有 CUDA 时优先 Kornia。官方内置四档预设按数据规模选:AUG_CONSERVATIVE(<500 图,翻转+轻度亮度对比)、AUG_AGGRESSIVE(2000+ 图,旋转/仿射/色彩抖动)、AUG_AERIAL(遥感俯拍)、AUG_INDUSTRIAL(制造/检测场景直接抄);预设是普通字典,可展开改({**AUG_AGGRESSIVE, "VerticalFlip": {"p": 0.1}})。aug_config={}传空字典只是关掉可选项 (水平翻转),必备的缩放归一化仍在;要连随机裁剪分支也关,另有独立的scale_jitter=False------贴边目标的标注就不会被裁掉。两条官方经验:几何变换别上太猛,旋转角度过大会把框推出画面(增强后框消失就是它);强增强下训练 mAP 低于验证 mAP 是正常现象 不是 bug------训练吃的是增强后的难图,验证用的是原图。2.5 日志速读里那条"增强后端 Albumentations → torchvision"的警告,装上这个 extra 并传aug_config就能复刻旧行为。 - 拆开训练栈 :
model.train()内部其实只有三步------RFDETRModelModule+RFDETRDataModule+build_trainer,然后trainer.fit(),全是公开的标准 PyTorch Lightning 类。要加自定义回调/日志器、接管多卡策略、深度定制训练循环时,把这三步拆出来自己组装就是官方推荐路径。顺带解释了 2.5 日志里那些 Lightning 消息从哪来;产物metrics.csv的列名也走 Lightning 指标口径(val/mAP_50_95、关键点val/keypoint_map_50_95、test/loss恒记),翻 CSV 时按这个找列。
2.3 训练产物:五种 checkpoint 的分工
训练结束,output_dir 里躺着一堆文件,该拿哪个去推理是新手最容易懵的点:
| 文件 | 里面有什么 | 用途 |
|---|---|---|
last.ckpt |
模型权重 + 优化器 + 调度器 + 元数据(最大) | 断点续训(Resume) |
checkpoint_<epoch>.ckpt |
同上,每 10 epoch 存一次 | 周期性续训点 |
checkpoint_best_ema.pth |
EMA 权重(验证分最优),轻量 | --- |
checkpoint_best_regular.pth |
原始权重(验证分最优),轻量 | --- |
checkpoint_best_total.pth |
EMA 与非 EMA 中验证分更高者,轻量 | 推理 / 评测的最终选择 |
- EMA(指数滑动平均)是训练过程中参数的平滑版本,通常泛化更好------所以默认最优选择逻辑是"EMA 和原始谁验证分高用谁"。
- 轻量 best 系列有意不带优化器/调度器状态 (文件小一个量级),只用于推理和评测;要续训回
last.ckpt。 - 关键点 Preview 模型的最优选择按 COCO 关键点 AP(
val/keypoint_map_50_95)判定,且 checkpoint 持久化了关键点 schema------RFDETR.from_checkpoint()能原样重建类别/关节槽位。 - 训练默认带 EMA 权重 (
use_ema=True)与最优 checkpoint 追踪,不用手动开;早停默认是关的 (early_stopping=False,实验 A/B 都跑满了max_epochs收场)------要开就配early_stopping_patience(默认 10)和best_model_metric(mAP/mAR 二选一);微调预训练权重建议设skip_best_epochs,防止最初几轮的指标波动把"最佳"记录和早停计数带偏。
2.4 model.evaluate():一次评测,三种返回
python
metrics = model.evaluate(dataset_dir="dataset/", split="test")
print(metrics["test/mAP_50_95"])
一次跑完数据集划分,返回并打印 mAP、mAR、macro-F1 扫描 全套 COCO 指标。内存里已有的权重直接被评测(训练完当场调不重载文件),也不往 output_dir 写任何东西。
⚠️ split 参数的行为矩阵------本教程实测挖出的坑:
| 数据格式 | split="test" 遇到没有 test 划分时 |
后果 |
|---|---|---|
| Roboflow 导出 COCO | 直接 FileNotFoundError |
好事,明确报错 |
| YOLO 格式 | 静默回退到 valid/ ,返回键仍叫 test/* |
坏事:你以为在测 test,实际测的是 valid |
| COCO / Objects365 原生 | 无 test 概念,静默测 valid/ |
同上 |
结论:看数字之前先看日志 ------回退发生时会有 warning,但返回键名不会变。想稳妥就用 split="val"(永远直取 valid/)。另外 evaluate() 虽然接受与 train() 相同的关键字参数,epochs/lr/ema 等训练字段全是摆设------评测走的是 eval-only 流程。
2.5 实验一:迷你数据集烟测(全程离线)
实验设计(诚实声明) :用预训练 Medium 模型给公开素材(dog.jpeg + people-walking 视频抽帧共十余张)伪标注 出 COCO 迷你数据集,三划分后微调 Nano。这是机制烟测 ------验证"伪标注 → 建库 → 训练 → checkpoint → 评测 → 回载推理"全链路走得通,mAP 数字本身没有业务含义;把这套流程换成你的真实数据集,就是真实微调------结构完全不变,变的只是数据和轮数。
配套脚本,五步:
- 伪标注建库:预训练模型打标 → 类别重映射为连续 ID → 按 Roboflow COCO 布局写出 train(8)/valid(2)/test(2)
model.train():Nano × 10 epochs(迷你数据集,分钟级)- 列出 output_dir 实际产物,对照 2.3 的表
- 加载
checkpoint_best_total.pth推理两张图------dog.jpeg 和标注框最多的一张行人帧;注意标签已从 COCO 80 类变成数据集自己的类别表 evaluate(split="test")正常出数 → 把 test 文件夹拿掉再跑一次,实测 COCO 格式的FileNotFoundError(2.4 坑的活体演示)
实测结果(RTX 5060 Laptop 8GB):
- 建库:12 张素材伪标注出 5 类(dog、car、person、backpack、handbag)共 102 框 → train 8 图 65 框 / valid 2 图 15 框 / test 2 图 22 框,类别表重映射为连续 ID。
- 训练 :10 epochs 共 62.1 秒 (batch_size=4,2.2 那两条 Windows 实测坑就是这实验第一次跑出来的)。验证 mAP(50:95) 逐轮 0.3284 → 0.4164 → 0.4041 → 0.4268 → 0.3816 → 0.4203 → 0.4563 → 0.4931 → 0.4699 → 0.5905 :前六轮在 0.38--0.46 震荡,第 7 轮起 mAR 冲上 0.93、第 10 轮收在全程最高------曲线后段发力,和 5 epochs 版(终值 0.3765)对比,多训几轮的效果一目了然。最优 checkpoint 仍由 EMA 判定(
Best total checkpoint saved from EMA (regular=0.0000, ema=0.5905))。 - 产物清单 (对照 2.3 的表):
checkpoint_best_ema.pth/checkpoint_best_total.pth/last_ema.pth各 120.9 MB,last.ckpt与checkpoint_9.ckpt各 483.4 MB,外加metrics.csv与training_config.json。两点与表有出入的实测细节:checkpoint_<epoch>.ckpt周期存档点按每 10 epoch 落盘,恰好撞上最后一轮才出现一个;checkpoint_best_regular.pth始终没有------regular 权重没算验证分,best_total 由 EMA 承担。表是官方口径,实际产物以日志为准。 - 双图回载推理 (本轮最大看点):加载
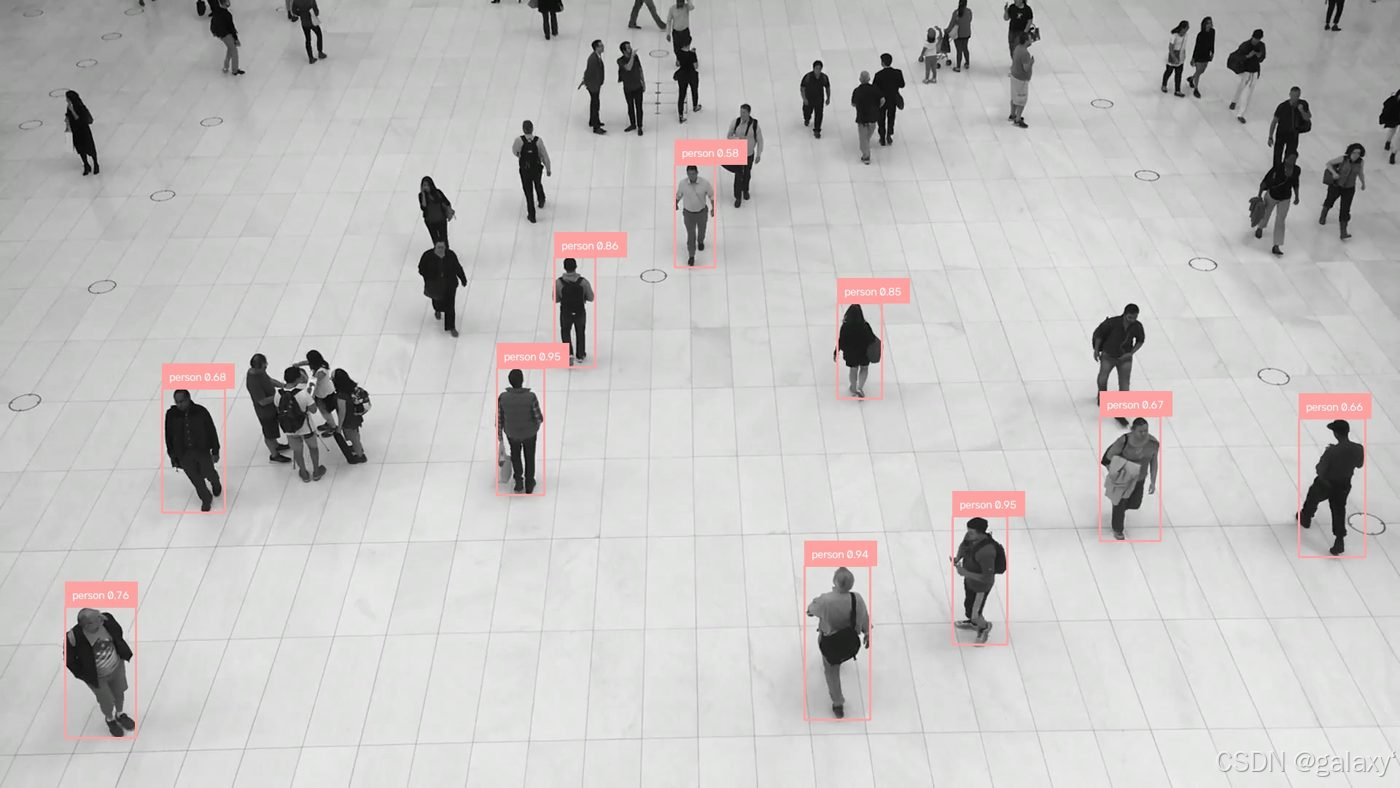
checkpoint_best_total.pth(自动以 checkpoint 的 5 类为准,反向警告一条)后------- 行人帧 (12 个伪标注框):检出 10 个 person,置信度 0.58--0.95------样本最多的类,学得又快又稳;
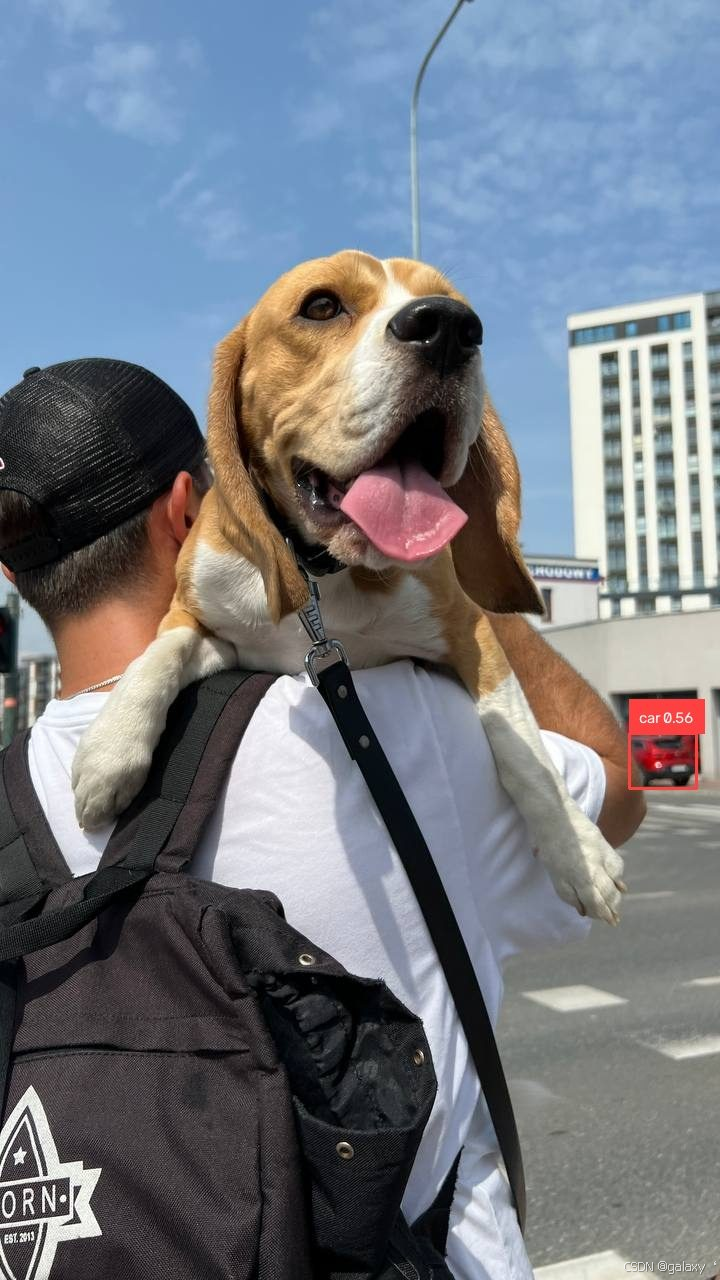
- dog.jpeg (在训练集里!):只检出 1 个------car 0.56 。看了输出图会发现更妙:这个框框住的是画面右侧背景里一辆真车,不是认错;画面主体的狗反而没检出。单样本的 dog 类在新头里还没学会,模型只敢报样本充足、学得动的 car------"训练时见过"不等于"认得出",检测头随机重初始化后,类别学习速度和样本量直接挂钩。真实项目里稀有类别要么补样本、要么调采样策略,而不是指望多训几轮自己开窍。
- evaluate(split="test") :mAP 50:95 0.8939 、mAP 50 0.9941 、precision 1.0000 、F1 0.9767,比 5 epochs 版(0.8677)更高。数字高得可疑?------是必然的:test 集的标注也是伪标注模型自己打的,学生做老师的考卷,评测基准与模型输出同分布。换成真实人工标注数据集,这个虚高会立刻消失;用伪标注建库时,务必清楚自己看的是什么口径的数字。
- FileNotFoundError 坑复现 :把 test/ 划分拿掉再跑,COCO 格式如 2.4 所述直接
FileNotFoundError: ...test\_annotations.coco.json------本教程实测口径确认。
附:一次训练日志速读------首次跑微调会被十几行日志糊脸,逐条翻译(按出现顺序):
| 日志原文(节选) | 人话 |
|---|---|
not loading DINOv2 backbone weights(两条 WARNING) |
本机推理 patch 16 与 DINOv2 原生 patch 14 不同,骨干不吃 DINOv2 原始权重------RF-DETR 自己的 COCO 预训练权重正常加载,微调不受影响,官方原话"this is not a problem" |
already exists with correct MD5 hash |
权重文件已在本地且校验通过,跳过下载 |
Model is not optimized for inference... |
没切 FP16 推理模式,延迟偏高;跑速度基准前先 model.inference(dtype=torch.float16)(第一章实测时切过) |
detection head will be re-initialized to 5 classes |
90 类旧头丢弃、5 类新头随机初始化------微调的真实起点,也是 4 里"背景车捞出来了、主体的狗没认出"的根源 |
TensorBoard logging disabled |
没装 tensorboard 包。TensorBoard 本来是默认开启 的(要关得显式传 tensorboard=False),没装包就静默关闭并出这条警告------装 rfdetr[loggers] 后跑 tensorboard --logdir output 浏览器开 6006 端口看曲线。不想装也没损失:metrics.csv 由 CSV 日志器永远在写,每次验证步追加一行全部指标 |
| augmentation backend ... Albumentations → torchvision | 新版默认训练增强后端换了(旧版 cv2 插值 → 新版 torchvision 抗锯齿),像素级行为略有差异;要复刻旧行为装 rfdetr[augment] 并传 aug_config |
square resize at resolution 384 / scales: [544] |
训练分辨率 384 方图,多尺度增强上探 544 |
uniform sampler because dataset is too small: 8 < 20 |
训练图少于 20 张,放弃类别均衡采样,改均匀抽样 |
training batches (5) smaller than log_every_n_steps=50 |
日志默认每 50 步记一次,但整个 epoch 才 5 步------无害提示 |
Triton linear-assignment ... using SciPy on CPU |
标签分配的 Triton 加速核在该 CUDA 环境不可用,退回 SciPy CPU 实现,训练略慢,Windows 上常见 |
Skipping validation-loss computation |
默认验证只算 mAP 不算 loss;想记 loss 曲线传 compute_val_loss=True |
Best total checkpoint saved from EMA (regular=0.0000, ema=0.5905) |
checkpoint_best_total.pth 由 EMA 权重当选;regular 没参与评选(本轮未出分) |
Checkpoint has 5 classes but model is configured for 90 |
回载微调权重时的反向 警告:库自动以 checkpoint 的 5 类为准,想消掉就传 num_classes=5 |
至此"伪标注 → 建库 → 训练 → checkpoint → 评测 → 回载"全链路实测打通;换上你的真实数据集,把第 1 步换成人工标注,其余结构原样不动。
2.6 实验二:关键点微调烟测(伪标注骨骼)
第一章的 Keypoint Preview 模型同样走 model.train(),且关节数不再限 17 ------由你数据集的关键点标注(COCO keypoints 或 YOLO pose 的 kpt_shape)决定,schema 自动推断。
实验设计 :和实验 A 同一套伪标注思路------手头没有标注好的自定义关键点数据集,就用第一章的 KeypointPreview 给同一批素材(dog.jpeg + 视频抽帧)伪标注 person + 17 关节,导出成 COCO 关键点格式(categories 带 keypoints 关节名单与 skeleton 骨架,annotations 带 keypoints=[x,y,v]*17 与 num_keypoints),三划分后微调。官方口径里关键点微调的特有配置全部落地:
python
from rfdetr import RFDETRKeypointPreview
from rfdetr.datasets._keypoint_schema import infer_coco_keypoint_schema

schema = infer_coco_keypoint_schema(DATASET / "train" / "_annotations.coco.json")

model = RFDETRKeypointPreview(
    num_classes=len(schema.class_names),
    num_keypoints_per_class=schema.num_keypoints_per_class,
    pretrain_weights=str(KP_WEIGHTS),
)
model.train(
    dataset_file="roboflow",
    dataset_dir=str(DATASET),
    class_names=schema.class_names,
    keypoint_oks_sigmas=schema.keypoint_oks_sigmas,
    epochs=10, batch_size=2, grad_accum_steps=2,   # 40.7M 模型,8GB 卡从 2 起步
    lr=1e-4,                                       # 烟测口径;官方 2e-5 属长周期保守学习率
    output_dir=str(run_dir),
)
要点:官方关键点示例的学习率 2e-5 比检测的 1e-4 小一个量级,且默认配 50+ epochs 的长周期------烟测的时间预算内跑不动(第一轮实测见下),所以脚本改用检测级 1e-4;真实项目请恢复 2e-5 。左右对称关节要配 keypoint_flip_pairs(水平翻转增强时交换左右标签,schema 能推断出来就带上);YOLO pose 数据集用 infer_yolo_keypoint_schema(data.yaml)。2.2 那两条 Windows 实测坑(显存释放、main 守卫)在本实验同样适用。
配套脚本,五步:
- 伪标注建库:KeypointPreview 打标 person + 17 关节(关节置信度 ≥0.5 记
v=2可见、否则v=1)→ 按 COCO 关键点布局写出 train(8)/valid(2)/test(2) - 关键点微调:10 epochs,schema 自动推断 →
lr=1e-4(烟测口径) - 列出 output_dir 实际产物
- 阈值扫描(0.05--0.5 各档人数与最高检测分)→ 加载
checkpoint_best_total.pth骨骼推理两张图(dog.jpeg + 行人帧),Edge + Vertex 标注器出图,出图阈值 0.2 evaluate(split="test")出关键点指标
第一轮实测(官方 2e-5 口径) :建库 85 人 × 17 关节 (train 8 图 53 人 / valid 2 图 18 人 / test 2 图 14 人);训练 10 epochs 共 175.6 秒,分辨率自动升到 576 方图(检测是 384------关键点模型吃更高分辨率);验证曲线前 7 轮全程 0.0000 ,第 8--10 轮才爬到 0.1188 → 0.3366 → 0.3926;checkpoint 逻辑还现出一个新变体------最优记录从未被触发时,日志 EMA metric never improved 之后库把最后一轮 EMA 权重 直接当 best_ema 存档。最要命的是:predict(threshold=0.5) 两张图都检出 0 人 (行人帧也是),而 evaluate 却给出 keypoint_map_50_95 0.3665 / box mAP 0.4486------评测管线不吃 predict 的阈值截断,低分预测照样参与 OKS 匹配,这是继"学生做老师考卷"之后第二个评测口径坑。诊断:链路全通,但 2e-5 在烟测时间预算内学不出可用的置信度,所有检测分都压在 0.5 以下。
第二轮实测(lr=1e-4 重训,其余不动):
- 训练 :10 epochs 共 178.4 秒 ,曲线彻底换相:第 1 轮 0.0000 → 第 2 轮 0.2158 → 第 3 轮 0.5682 → 一路爬到第 8 轮 0.9309、第 10 轮收 0.8986。与第一轮"7 轮全零"对照,学习率提一个量级的差距一目了然。
- checkpoint 怪癖复现 :
EMA metric never improved在两轮里都出现(检测实验没有)------看起来是关键点 Preview 的结构性怪癖,best_ema / best_total 都落在最后一轮 EMA 权重上。用它之前先知道这一点。 - 阈值扫描(行人帧) :0.05 → 70 人 / 0.10 → 36 人 / 0.20 → 12 人 / 0.30 → 9 人 / 0.50 → 0 人 ,最高检测分 0.475 ------重训后置信度天花板仍差 0.025 才够 0.5。这坐实了本节的核心经验:微调后别拍脑袋用 0.5,先扫描、让工作阈值跟着模型的实际分数带走。
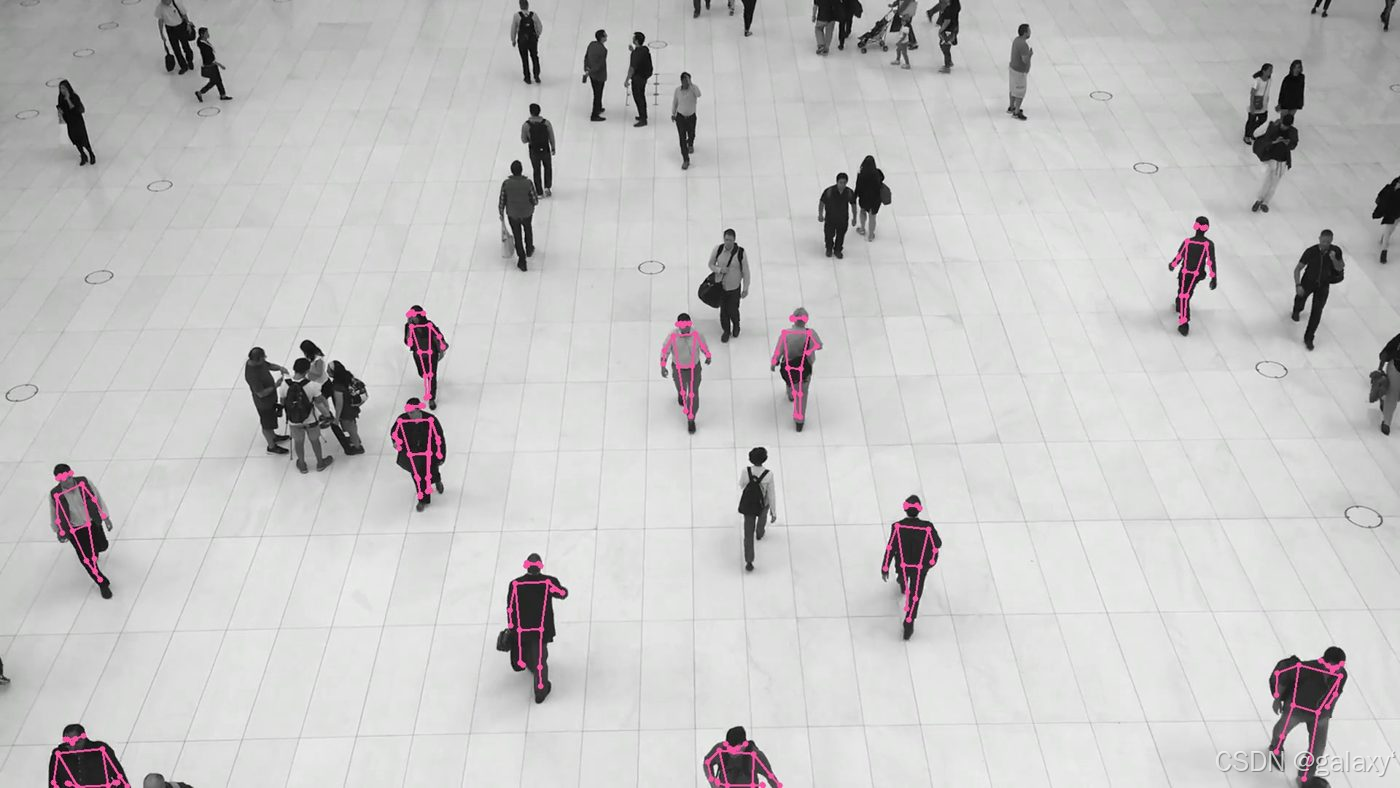
- 骨骼出图(阈值 0.2) :行人帧 12 人骨骼齐全 (10 个伪标注人 + 2 个低分多检),关节置信度均值 0.938 ;dog.jpeg 2 人(与第一章"dog.jpeg 画面含 2 人"口径一致),关节置信度均值 0.495。两张图都"看得到骨骼",烟测闭环。
- evaluate(split="test") :keypoint_map_50_95 0.8654、keypoint_map_50 0.9436、keypoint_mAR 0.9429,box mAP 50:95 0.9381------比第一轮的 0.3665 翻了一倍还多(口径提醒同实验 A:test 标注出自伪标注模型,数字按"学生做老师考卷"口径看)。
- 两轮对比就是一节现场课:官方 2e-5 没有错,但它默认长周期;短周期烟测要按时间预算调学习率(第二轮 1e-4),并让阈值跟着模型实际分数带走(0.2 而非 0.5)。真实项目恢复 2e-5 + 50+ epochs,阈值照扫不误。
2.7 本章方法速查
| 方法 | 干什么 | 关键参数(默认值) | 返回值 / 要点 |
|---|---|---|---|
pip install "rfdetr[train]" |
装训练栈 | loggers extra 可选 |
Lightning 等依赖,基础包不含 |
model.train(dataset_dir=..., ...) |
一行微调 | batch_size="auto"(探测物理 batch + 累积建议)、lr=1e-4(关键点 2e-5)、grad_accum_steps=1(1.10 起默认,旧版 4)、epochs、output_dir |
COCO/YOLO 格式自动检测;默认带 EMA + 早停 + 最优 checkpoint |
output_dir 产物 |
五种 checkpoint | last.ckpt / checkpoint_<epoch>(含优化器,续训用);best_ema / best_regular / best_total(轻量) |
推理评测拿 checkpoint_best_total.pth(EMA 与非 EMA 验证分择优) |
RFDETR.from_checkpoint(path) |
从 checkpoint 重建模型 | --- | 关键点 schema 已持久化,槽位原样恢复 |
model.evaluate(dataset_dir, split="test") |
一次评测出 mAP / mAR / macro-F1 | split="test" / "val" |
内存权重直接评;关键点模型额外返回 keypoint_map_50_95 / keypoint_map_50 / keypoint_mAR;⚠️ YOLO 格式无 test 时静默回退 valid 但键仍叫 test/* ,COCO 无 test 则 FileNotFoundError;训练字段传了也不生效;评测不吃 predict 的阈值截断 |
infer_coco_keypoint_schema(json路径) |
关键点 schema 自动推断 | 对应 infer_yolo_keypoint_schema(data.yaml) |
返回 class_names / num_keypoints_per_class / oks_sigmas;keypoint_flip_pairs 记得配对称关节 |
model.export() |
导出部署模型 | format="onnx"(默认,opset 17、batch_size=1)、fp16=True(TRT 默认半精度) |
训练产物直接可导;ONNX 输出是原始张量需自解码------详见 2.8 |
2.8 导出部署速览
训练好的模型不必困在 Python 训练环境里------model.export() 一行默认导出 ONNX(opset 17、batch_size=1):
python
model = RFDETRNano(pretrain_weights="output/run/checkpoint_best_total.pth")
model.export()                    # → output/ 下的 .onnx
model.export(format="tensorrt")   # NVIDIA GPU 上延迟最低(官方口径 Nano 2.3 ms)
格式按部署目标选(导出前各自装 extra:rfdetr[onnx] / [tflite] / [executorch] / [coreml],CoreML 仅 macOS):
| 目标 | 格式 | 要点 |
|---|---|---|
| 跨平台通用 | format="onnx"(默认) |
ONNX Runtime / OpenVINO 直接吃;自定义分辨率须被 patch_size × num_windows 整除 |
| NVIDIA GPU | format="tensorrt" |
先出 ONNX 再转 .trt;引擎绑定构建机的 GPU 架构与版本,换卡要重导 |
| 移动端 / 边缘 | format="tflite" |
FP32/FP16/INT8 三档,INT8 必须喂真实图片 做校准(calibration_data,随机噪声校准等于精度崩);实验性格式,锁版本 |
| 端侧 PyTorch / Apple | format="executorch" / "coreml" |
均不支持动态批;ExecuTorch 按后端选 xnnpack/coreml/qnn,QNN 需源码编译 |
最重要的一个坑:ONNX 输出是原始张量,不是现成的检测结果 ------dets 是 cxcywh 格式、labels 是没过 sigmoid 的 logits,要自己加 sigmoid、剔除背景槽位、转 xyxy;且必须按输出名匹配 取结果,不能按形状猜(类别数少时两个输出的末维可能一样大,猜形状必乱)。背景槽位下标还和训练时的类别映射挂钩:连续 ID 映射是 -1,官方 COCO 稀疏 ID 是 None。想省掉手写解码,可用官方推荐的 inference-models 库(PyTorch / ONNX / TensorRT 统一 API,TensorRT 引擎由它内部管理------这时别再传 format="tensorrt",会白构建一遍引擎)。
配套脚本,五步:加载实验一 best_total → export() 导出 → onnxruntime 会话体检(输入/输出名与形状)→ PyTorch 后端同图基线对照 → 手写解码出图 + CPU 延迟测量。
实测结果(RTX 5060 Laptop 8GB,ONNX Runtime CPU 路径):
- 导出 :
export()共 3.4 秒 ,产物rfdetr-nano.onnx113.0 MB (Nano 权重 120.9 MB 的 .pth 转纯图后略小)。注意export()默认verbose=True会把整张 ONNX 计算图逐节点刷屏(几百行onnx::MatMul/onnx::GridSample)------不是报错,嫌吵传verbose=False。 - 会话体检 :输入名
input,形状[1,3,384,384](Nano 默认分辨率);输出名dets(末维 4)+labels(末维 6 = 5 类 + 1 背景槽)------"背景槽挂在末维最后"实测吻合,300 个 query 也与官方口径一致。按名匹配的两条输出判定一次通过。 - 两后端对照 (dog.jpeg,微调烟测权重):PyTorch top-5 为 car 0.5568 / car 0.3433 / backpack 0.3121 / car 0.2804 / car 0.2043;ONNX 解码 top-5 为 car 0.5566 / car 0.3385 / car 0.2502 / car 0.2109 / car 0.1625。top-1 对到千分位(0.5568 vs 0.5566),证明 ImageNet 归一化输入口径和 cxcywh→xyxy 解码链路写对了;中低分段两边有交换(PyTorch 的 backpack 0.31 在 ONNX 里掉出前五)------浮点后端差异在低置信候选上会重排名,属正常现象,判读时以 top 结果为准。阈值 0.25 检出 3 个框全是 car(背景那辆红车),与实验一"car 类学得动、dog 单样本没学会"的结论延续一致。
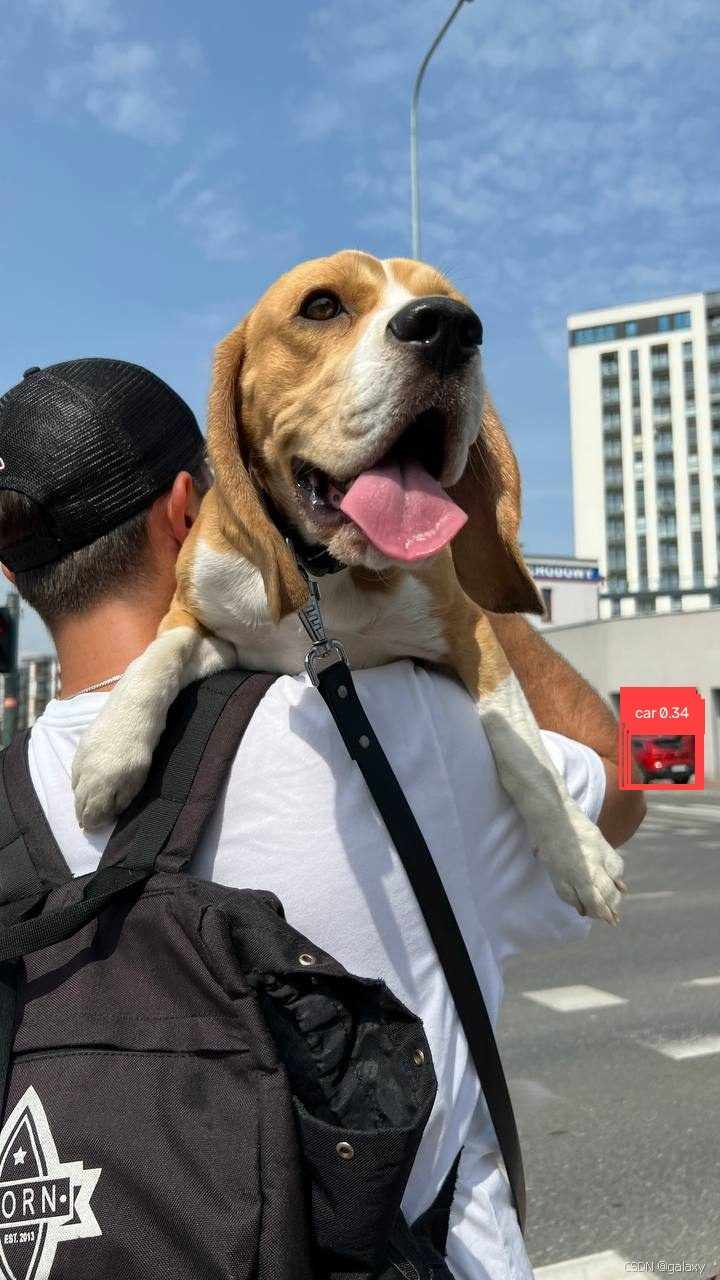
- 延迟 :ONNX Runtime CPU 路径 69.2 ms/帧,与 PyTorch CUDA 路径的 77.5 ms 基本打平------乍看反常,其实合理:
predict()默认走 FP32、且日志明确警告"未做推理优化";ONNX Runtime 的图优化把算子融合做得很足。工程结论:部署阶段换 ONNX Runtime,不依赖 GPU 也能拿到接近 GPU 的延迟,这是导出的真正价值。