这两年 Java 开发者做 AI 应用,已经不只是调一个大模型接口这么简单了。企业数据怎么接入?工具怎么调用?RAG 怎么拆模块?Agent 工作流怎么控制?
如果项目本身就是 Spring Boot,那么 Spring AI 值得重点关注。它不是训练模型的框架,而是把企业数据、业务 API 和 AI 模型连接起来的应用框架。
Spring AI 2.0 的变化尤其大:升级到 Spring Boot 4 基线,同时重构了 Model、Advisor、Tool Calling、MCP 与 RAG。
这篇文章从工程落地角度梳理 Spring AI 2.0:它解决什么问题、核心架构怎么变,以及 Java 开发者应该怎么选。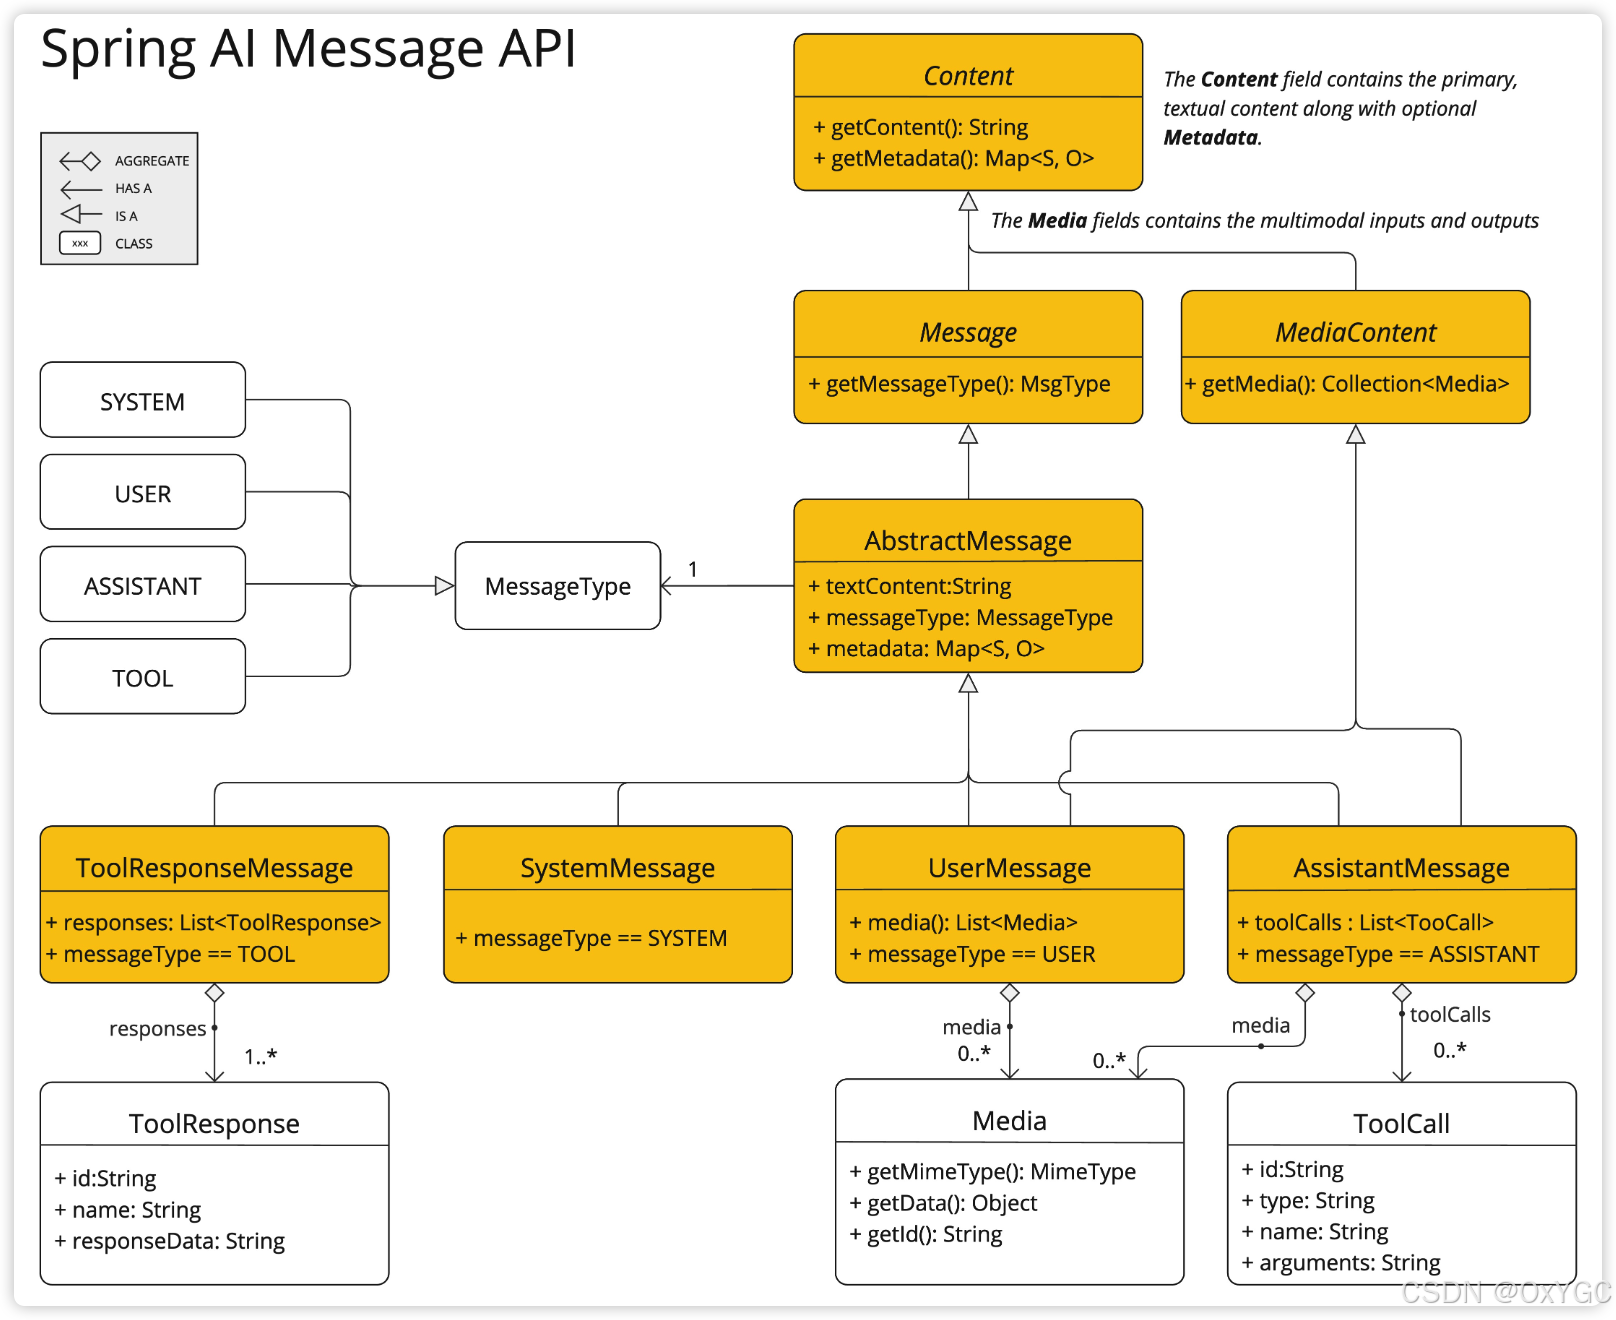
1. Spring AI 2.0:不只是一次版本升级
Spring AI 的定位很明确:让 Spring 开发者用熟悉的方式接入 Chat Model、Embedding、向量数据库、Tool Calling、RAG 和 MCP。
简单理解:
text
企业数据 / 业务 API / MCP 工具
              |
              v
        Spring AI 编排层
              |
              v
OpenAI / Qwen / DeepSeek / Claude / 本地模型
Spring AI 2.0 已全面面向 Spring Boot 4.0.x / 4.1.x;截至本文发布时,官方稳定版本为 2.0.1。官方入门文档
| 维度 | 1.x | 2.0 |
|---|---|---|
| Spring Boot | 3.x | 4.0.x / 4.1.x |
| JDK 基线 | 17 | 17+,生产更建议 21+ |
| 模型抽象 | 各模型 API 为主 | 统一的 Model API |
| Advisor | 基础增强链 | CallAdvisor / StreamAdvisor |
| Tool Calling | 模型侧内部循环 | ToolCallingAdvisor 统一编排 |
| MCP | 基础集成 | 注解驱动、客户端与服务端能力完善 |
| RAG | 传统问答增强 | Naive RAG + Modular RAG |
| 可观测性 | 基础指标 | 深度接入 Micrometer Observation |
我的理解是:
Spring AI 2.0 的重点不是"多支持几个模型",而是让 AI 能力真正进入 Spring 工程体系:可组合、可测试、可观测、可维护。
2. PromptTemplate 与 Advisor:把提示词和对话增强做成工程能力
提示词是大模型应用最基础的一层。业务方经常把它理解成一段字符串,但真实项目里,提示词通常需要模板化、版本化、变量注入和测试。Spring AI 2.0 的 PromptTemplate 默认采用 {} 作为变量分隔符,也支持自定义渲染器。
java
PromptTemplate promptTemplate = PromptTemplate.builder()
    .renderer(StTemplateRenderer.builder()
        .startDelimiterToken('<')
        .endDelimiterToken('>')
        .build())
    .template("推荐 5 部 <director> 的代表电影。")
    .build();

String prompt = promptTemplate.render(
    Map.of("director", "周星驰")
);
如果说 PromptTemplate 解决的是"怎么组织输入",那么 Advisor 解决的就是"如何在一次模型调用前后统一增强行为"。
text
用户请求
  --> Memory Advisor
  --> RAG Advisor
  --> Tool Calling Advisor
  --> Chat Model
  --> 响应增强 / 监控 / 审计
Spring AI 2.0 将 Advisor 分为两类:
| 类型 | 场景 | 核心方法 |
|---|---|---|
CallAdvisor |
普通同步调用 | adviseCall() |
StreamAdvisor |
流式响应 | adviseStream() |
Advisor 按 getOrder() 升序执行。工具调用也不再是某个模型实现内部的一段 while 循环,而是变成可组合的递归 Advisor 链。官方文档对 Advisor API 有完整说明。
Q:Advisor 适合放什么能力?
常见的横切逻辑都适合:
- 对话记忆
- RAG 上下文注入
- 内容安全
- 工具调用
- 请求审计
- Token 与耗时统计
- 重试、降级与模型路由
这里需要注意:自定义 Advisor 修改了请求后,必须将修改后的 request传递给下一个节点;只拼接一个字符串、却继续传原始 request,是不会生效的。
3. Memory、Tools、RAG:让模型连接真实业务
Q:对话记忆怎么做?
Spring AI 的 ChatMemory 提供了对话记忆抽象,常见实现是 MessageWindowChatMemory:只保留最近若干轮消息,避免上下文无限增长。
持久化则可以根据项目已有基础设施选择 JDBC、Redis、MongoDB、Cassandra、Neo4j 等实现。对于历史很长、但只需要召回相关片段的场景,可以使用 VectorStoreChatMemoryAdvisor。
短期记忆解决"刚才聊了什么";向量记忆解决"历史上哪些信息和当前问题有关"。
Q:Tool Calling 和 MCP 是一回事吗?
不是。
| 能力 | Tool Calling | MCP |
|---|---|---|
| 本质 | 模型请求应用调用某个函数 | 工具、资源、Prompt 的标准化协议 |
| 范围 | 当前应用内部 | 跨应用、跨进程、跨团队共享 |
| 典型用法 | 查订单、发消息、调用业务服务 | 连接 GitHub、数据库、内部工具平台 |
| Spring AI 入口 | @Tool |
@McpTool、@McpResource 等 |
普通工具可以直接写成:
java
@Component
class DateTimeTools {

    @Tool(description = "获取用户时区下的当前日期和时间")
    String getCurrentDateTime() {
        return LocalDateTime.now()
            .atZone(LocaleContextHolder.getTimeZone().toZoneId())
            .toString();
    }
}
Spring AI 2.0 会自动注册 ToolCallingAdvisor,由它驱动"模型请求调用工具 → 应用执行工具 → 结果回传模型"的循环。模型只能提出工具调用请求,真正执行权限仍然在应用侧,这一点对企业安全很重要。Tool Calling 官方文档
MCP 则把工具进一步外部化。Spring AI 2.0 支持 STDIO、SSE、Streamable HTTP 和无状态 Streamable HTTP;也支持用 @McpTool、@McpResource、@McpPrompt、@McpComplete 快速暴露 MCP 能力。MCP 注解文档
4. RAG:别只会"文档切块 + 向量检索"
RAG 本质上是把模型不知道的企业知识,在调用前检索出来,作为上下文注入 Prompt。
text
文件 / Wiki / 数据库
  --> 文档解析与切分
  --> Embedding 向量化
  --> Vector Store
  --> 检索相关内容
  --> 注入 Prompt
  --> LLM 生成答案
Spring AI 2.0 中可以把 RAG 分成两类:
| 模式 | 组件 | 适合场景 |
|---|---|---|
| Naive RAG | QuestionAnswerAdvisor |
FAQ、简单知识库问答 |
| Modular RAG | RetrievalAugmentationAdvisor |
复杂检索、多知识库、生产级问答 |
Modular RAG 的价值在于可组合:
text
用户问题
  --> QueryTransformer:改写 / 翻译 / 多查询扩展
  --> DocumentRetriever:多路检索
  --> DocumentJoiner:合并去重
  --> QueryAugmenter:注入上下文
  --> LLM
这比"拿问题直接搜一遍向量库"更适合真实企业知识库。比如用户问法模糊、文档多语言、多个数据源并存,或者需要结合权限过滤时,都需要把 RAG 拆成可替换模块。
5. Agent 与模型选型:先确定边界,再选框架和模型
Spring AI 官方给出了几种非常典型的 Agent 工作流模式:
| 模式 | 适合场景 |
|---|---|
| Evaluator-Optimizer | 模型自评估、多轮优化输出 |
| Routing | 按问题类型路由至专门处理器 |
| Orchestrator-Workers | 动态拆解复杂任务 |
| Chaining | 串行处理多步骤任务 |
| Parallelization | 并行调用后聚合结果 |
对大部分企业项目,我更建议从受控工作流开始,而不是一上来做全自治 Agent。
text
固定业务流程
  --> 在关键节点调用 LLM
  --> 调用受控 Tools
  --> 结构化输出
  --> 人工审核或规则校验
模型选型也一样,不要先问"哪个模型最强",而要先明确任务:
| 你的约束 | 优先考虑 |
|---|---|
| 追求最快上线、能力完整 | 云端商业模型 API |
| 数据不能离开内网 | 私有化部署的开放权重模型 |
| Token 成本敏感 | 小参数模型、路由策略、缓存与批处理 |
| 有垂直领域要求 | 自建评测集后,对候选模型实测 |
| 训练专属模型 | 算法、数据与 MLOps 能力,而非单纯应用开发 |
模型参数量不是选型结论。真正要看的是你的业务数据、任务类型、延迟、成本、合规要求和评测结果。
Q:LangChain4j 和 Spring AI 怎么选?
两者都能做 Java AI 应用,也都支持模型接入、RAG、Tool Calling 与 MCP 相关能力;不要简单写成"无脑选哪个"。
| 维度 | LangChain4j | Spring AI |
|---|---|---|
| 框架依赖 | 可独立使用,也可集成 Spring | 深度融入 Spring Boot |
| 编程风格 | AI Services 抽象较鲜明 | 更贴近 Spring 生态习惯 |
| MCP | 支持客户端;服务端能力有社区模块 | 客户端、服务端与注解模型更一体化 |
| 适合人群 | 非 Spring 项目、希望保持框架中立 | Spring Boot 企业应用 |
| JDK | 当前基线为 17+ | 17+,生产推荐 21+ |
如果你的主项目已经是 Spring Boot,Spring AI 2.0 的自动配置、可观测性、MCP Starter、Advisor 与企业基础设施整合会更省心;如果项目并不依赖 Spring,或希望保持框架独立,LangChain4j 也完全值得考虑。
6. 最后总结
如果你只是想快速接入一个模型: 从 ChatClient、PromptTemplate 和结构化输出开始。
如果你需要让模型理解企业知识: 加入 Vector Store、QuestionAnswerAdvisor,再逐步演进到 Modular RAG。
如果你需要让模型调用业务能力: 用 @Tool,并把鉴权、审计、超时和幂等性放在应用侧。
如果你准备做跨系统工具生态:使用 MCP,但不要把 MCP Server 当作天然可信的组件。
Spring AI 2.0 最值得关注的地方,不是它让 Java 也能"调用大模型",而是它开始把 AI 应用纳入了 Spring 擅长的工程体系:配置、测试、观测、安全和模块化。