一、背景知识
首先,算法的优化与解决来源于现实问题,多目标优化在现实世界中无处不在,因为几乎任何有意义的决策都涉及多个相互冲突的目标。比如:
汽车车身设计: 最小化重量、最大化刚度、最小化制造成本、最大化碰撞安全性(轻量化会降低刚度与安全性;高强度材料成本更高)
投资组合优化: 最大化预期收益、最小化风险(方差)、最大化流动性(高收益伴随高风险;流动性好的资产收益通常较低)
**车辆路径规划:**最小化行驶距离、最小化配送时间、最小化车辆数、最大化客户满意度(距离短不一定时间短(堵车);车辆少可能导致延迟)
将现实问题数学化、抽象化,就变成了一个研究问题,将现实世界抽象到"数学空间"中去解决,再指导现实世界,也就有了一个领域的问题。那么在这个多目标优化问题的领域,该如何寻找 Pareto 前沿呢?
基础知识和概念可以看,微信公众号【多目标优化从入门到精通-算法仓库】
Goldberg在 1989 年的著作《Genetic Algorithms in Search, Optimization, and Machine Learning》提出了一种全新的思路------使用基于非支配排序(Non-dominated Sorting)的选择机制,并配合小生境(Niching)技术( 【小生境共享"(Niche Sharing)】-CSDN博客**),来同时寻找多个 Pareto 最优解。**这个想法解决了一个核心难题:如何让种群在向 Pareto 前沿收敛的同时,还能保持多样性,避免所有个体挤在同一个点上。
有了理论想法的指导,接下来就到了代码的实现啦,1994年,N. Siinivas 和 Kalyanmoy Deb 发表论文 《Multiobjective Optimization Using Nondominated Sorting in Genetic Algorithms》提出NSGA,首次将 Goldberg 的**"非支配排序"** 与**"共享函数"**结合,用种群同时捕获多个 Pareto 最优解。
【ps:论文原文有说明传统方法(权重法、距离函数法、极大极小法)的局限性,以及遗传算法(GA)的优势和 Schaffer 最早尝试 的 VEGA 的不足(存在偏向某些区域的偏差)(可以去看论文原文的分析)】
总而言之,论文做了两件事情:
非支配排序 → 负责"收敛 "(把种群拉到 Pareto 前沿附近)。
表型共享 → 负责"多样性"(把种群铺开在前沿的不同位置,避免全挤在一起)。
那作者又是如何具体实现的呢?
二、NSGA算法的核心思想
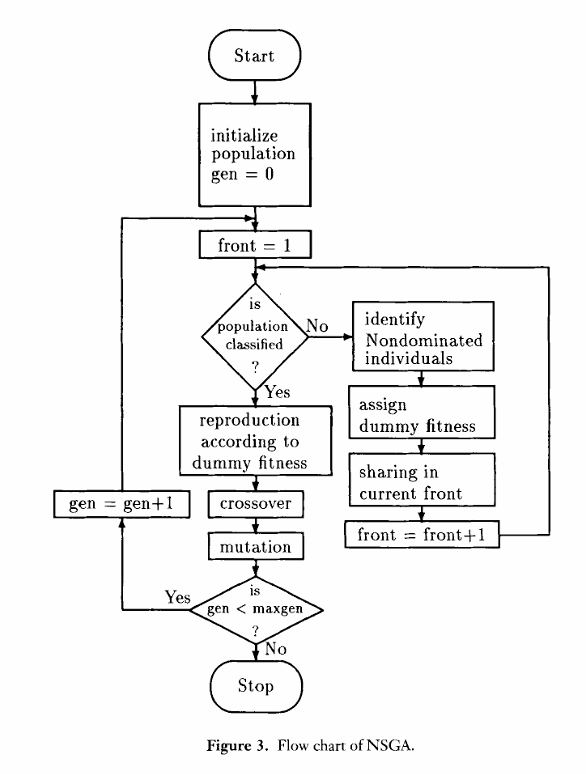
NSGA 其实就是在遗传算法的框架下,"初始化 → 评价 → 选择 → 交叉 → 变异 → 循环 ",改进了适应度评价和选择 这两个环节,采用非支配排序 的方式个体之间互相比较------如果 A 在所有目标上都不比 B 差,且至少有一个目标更好,就说 A 支配 B。不被任何人支配的个体构成第一梯队,去掉它们后剩下的个体中再找非支配的,构成第二梯队,依此类推。
比如,一个班级有多个评价维度(成绩、体育、文艺、组织能力),每个学生表现不同。第一梯队就是那些不被任何同学全面压制的学生------他们之间是平等的权衡关系,没有绝对优劣。机会会优先给到第一梯队,因为它们代表了当前种群中不被支配的解;第二梯队次之,依此类推。这样,整个种群会逐渐向 Pareto 前沿收敛。
但如果只按层级选择,同一层内的个体适应度相同,缺乏"分散"的驱动力,最终可能集中到 Pareto 前沿的局部区域。为了维持多样性,NSGA 引入了共享机制,让稀疏区域的个体获得更多繁殖机会。这样,优秀的解既能接近 Pareto 前沿,又能保持分布均匀。
如何根据实际问题设计合适的共享函数或多样性指标,也是一个很有意思的研究方向,需要对函数特性有深入理解。
2.1 非支配排序
-
根据个体之间的支配关系将种群分层:
-
第一层:所有非支配个体。
-
第二层:去除第一层后,剩余个体中的非支配个体。
-
依此类推,直到所有个体被分层。
-
2.2 虚拟适应度分配
-
第一层个体赋予最大虚拟适应度。
-
后续层的个体适应度依次减小。
-
保证非支配个体有更高的繁殖机会。
2.3 共享机制(Niche & Speciation)
- 为了维持种群多样性,使用表型共享函数:
- 计算个体的niche count,并用其调整适应度,避免种群过度集中。
2.4 选择与繁殖
-
使用随机余数比例选择。
-
交叉和变异操作与普通GA相同。
三、NSGA-II
一个算法肯定会有不足的地方,那么NSGA 的问题是什么?作者又做了什么改进呢?
NSGA的问题:
(1)复杂度高 O(MN3) : 旧版采用"普通非支配排序",每次分层都要遍历所有个体,计算极慢。
(2)非精英保留 (nonelitism): 父代产生的优秀个体可能在下一代中丢失,收敛性无法保证。(3)**需要指定共享参数 (sharing parameter):**旧版依赖"小生境共享"来维持多样性,但共享半径 σshare 极难预先设定,对问题敏感。
Kalyanmoy Deb 等人在 2002 年提出**NSGA-II(Non-dominated Sorting Genetic Algorithm II,带精英策略的非支配排序遗传算法),**主要有三大核心机制,分别对应上面提出的三大问题:
-
快速非支配排序(Fast Non-dominated Sorting)
-
精英保留策略(Elitism)
-
拥挤度距离(Crowding Distance)------ 替代了小生境共享
四、NSGA-III
那 NSGA-II 又有什么样的局限性呢?
NSGA-II 在高维目标空间失效的根本原因在于支配关系变得无效,拥挤度距离失去区分度。
随着目标数量增加,一个随机解支配另一个随机解的概率呈指数级下降。结果是,几乎整个种群都变成了"非支配解",全部挤在第一层。此时,非支配排序无法提供选择压力,算法只能依赖拥挤度距离来决定谁去谁留。
但拥挤度距离在高维空间同样失灵:所有解之间的距离都很大且相似,导致拥挤度值缺乏信息量位于"边界"(至少一个目标上取极值)的解数量爆炸式增长,它们都被赋予无穷大距离,算法无法区分。拥挤度距离可能被"冗余目标"欺骗------如果两个目标高度相关,它会重复计算同一维度的多样性,反而扭曲搜索方向。
NSGA-III 保留了 NSGA-II 的非支配排序作为收敛性引擎 ,但用一套结构化参考点系统 取代了拥挤度距离,作为多样性引擎。
| 场景 | 推荐 |
|---|---|
| 2~3 个目标 | NSGA-II。拥挤度距离简单有效,计算开销更低。在双目标车间调度问题上,两者性能无显著差异。 |
| 4 个及以上目标 | NSGA-III。NSGA-II 的拥挤度机制失效,必须换用参考点方法。 |