用 Python + FastAPI + Ollama,从零搭一个完全跑在自己电脑上的 AI 对话助手:数据不出本机、不需要任何 API Key、不花一分钱。
全文包含项目介绍、环境前提、三步运行、功能清单、核心原理拆解与优势对比,所有用到的开源项目均附官方网址。
开源地址 :GitHub - yangran-coder/ai-chatbot: AI聊天助手 · GitHub (MIT 许可)
一、这个项目是什么?
先说结论:这是一个只有 4 个依赖、1 个 Python 文件、1 个 HTML 文件的本地 AI 聊天助手。
它长得跟 ChatGPT 网页版差不多------有对话气泡、打字机式逐字输出、多轮上下文记忆、代码块渲染、连接状态指示灯。但本质区别在于:模型跑在你自己的电脑上,请求不出内网,不需要注册任何账号,也不需要付一分钱。
三层架构如下(启动后访问 http://localhost:8000 即可看到真实界面):
┌─────────────────────────────────────────┐
│  浏览器 · static/index.html(306 行)     │   展示界面 / 发请求 / 流式渲染
│  零构建,无需 npm                         │
└──────────────────┬──────────────────────┘
                   │  POST /api/chat  {messages}
                   │  ← SSE: data:{"content":"你"} ...
                   ▼
┌─────────────────────────────────────────┐
│  FastAPI 后端 · main.py(约 100 行)      │   历史整理 / 转发 / 错误处理
│  Uvicorn 承载,默认 8000 端口             │
└──────────────────┬──────────────────────┘
                   │  POST http://localhost:11434/api/chat
                   ▼
┌─────────────────────────────────────────┐
│  Ollama 本地大模型 · qwen2.5:3b          │   推理,数据不出本机
└─────────────────────────────────────────┘
项目名叫「小K AI」,技术栈如下:
| 层次 | 技术 | 作用 |
|---|---|---|
| 前端 | 原生 HTML + CSS + JS(单文件,306 行) | 渲染界面、发送消息、流式接收 |
| 后端 | FastAPI + Uvicorn | 对话历史整理、请求转发、SSE 流式输出 |
| 模型层 | Ollama + Qwen2.5 | 本地大模型推理,默认 qwen2.5:3b |
整个项目零前端构建------没有 npm、没有 webpack、没有 node_modules,双击 HTML 的结构直接由后端托管。这是我刻意的设计:对于一个"想搞懂全栈链路"的学习型项目,构建工具的复杂度会掩盖真正的核心逻辑。
二、运行前需要准备什么?
2.1 硬件前提
| 项目 | 最低要求 | 推荐配置 | 说明 |
|---|---|---|---|
| 内存 | 8 GB | 16 GB 及以上 | qwen2.5:3b 加载后约占用 2~3 GB |
| 硬盘 | 5 GB 可用 | 10 GB 可用 | 仅为模型文件预留,代码本身不到 20 KB |
| 显卡 | 无要求 | NVIDIA 6 GB 显存以上 | 没有独显也能跑(纯 CPU 推理,只是慢) |
2.2 软件前提
① Python 3.9 及以上(推荐 3.10 / 3.11)
官网下载:Download Python | Python.org
Windows 用户注意:安装时务必勾选 "Add Python to PATH" ,否则后续命令行里敲
python会提示找不到命令。
验证:
bash
python --version
# 或
python3 --version
② Ollama(本地大模型运行时)
这是整个方案的核心,它把"下载模型、加载模型、提供 HTTP 接口"这几件事封装成了一条命令。
-
模型库(可搜索全部可用模型):Ollama
Windows 上双击安装包一路下一步即可;macOS / Linux 也可一行命令安装:
bash
# macOS / Linux
curl -fsSL https://ollama.com/install.sh | sh
安装验证:
bash
ollama --version③ 一个模型
安装完 Ollama 后它会自动在后台常驻,监听 http://localhost:11434。首次使用需要拉一个模型下来:
bash
ollama pull qwen2.5:3b模型名必须与 ollama list 显示的一致,写错会导致后端报 404------这是本项目专门处理过的一个坑,见第六节。
几款常用模型对比(体积与定位):
| 模型 | 体积 | 特点 | 模型页 |
|---|---|---|---|
qwen2.5:3b |
~2 GB | 中文友好、轻量,本项目默认 | qwen2.5 |
qwen2.5:latest |
~4.7 GB | 7B 版本,效果明显更好 | qwen2.5 |
qwen2.5-coder |
~4.7 GB | 代码能力增强 | qwen2.5-coder |
llama3.2:latest |
~2 GB | 英文更顺 | llama3.2 |
三、快速运行项目
第 1 步:拉模型
bash
ollama pull qwen2.5:3b(上一节已做过的可跳过。约 2 GB,视网速等待几分钟。)
第 2 步:装依赖并启动
bash
# 进入项目目录
cd ai-chatbot
# 创建虚拟环境(推荐,避免污染全局环境)
python -m venv .venv
# 激活虚拟环境
# Windows:
.venv\Scripts\activate
# macOS / Linux:
source .venv/bin/activate
# 安装依赖(国内可加清华源加速)
pip install -r requirements.txt
# pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
# 复制配置模板(可选,不改也能跑)
cp .env.example .env # Windows 用: copy .env.example .env
# 启动
uvicorn main:app --reload --port 8000看到 Uvicorn running on http://127.0.0.1:8000 即启动成功。
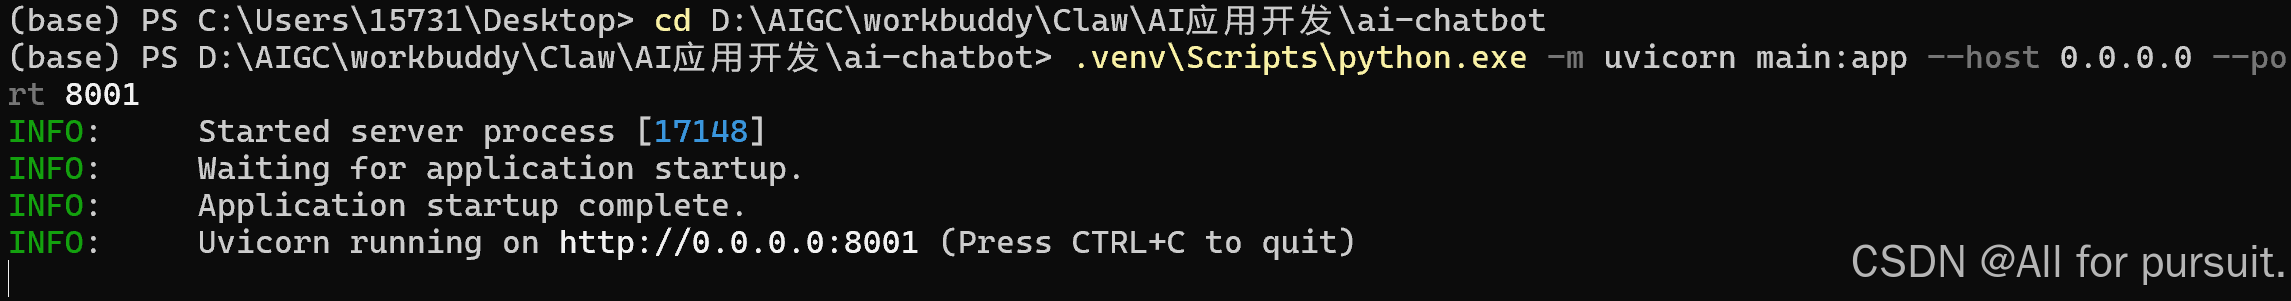
第 3 步:打开浏览器
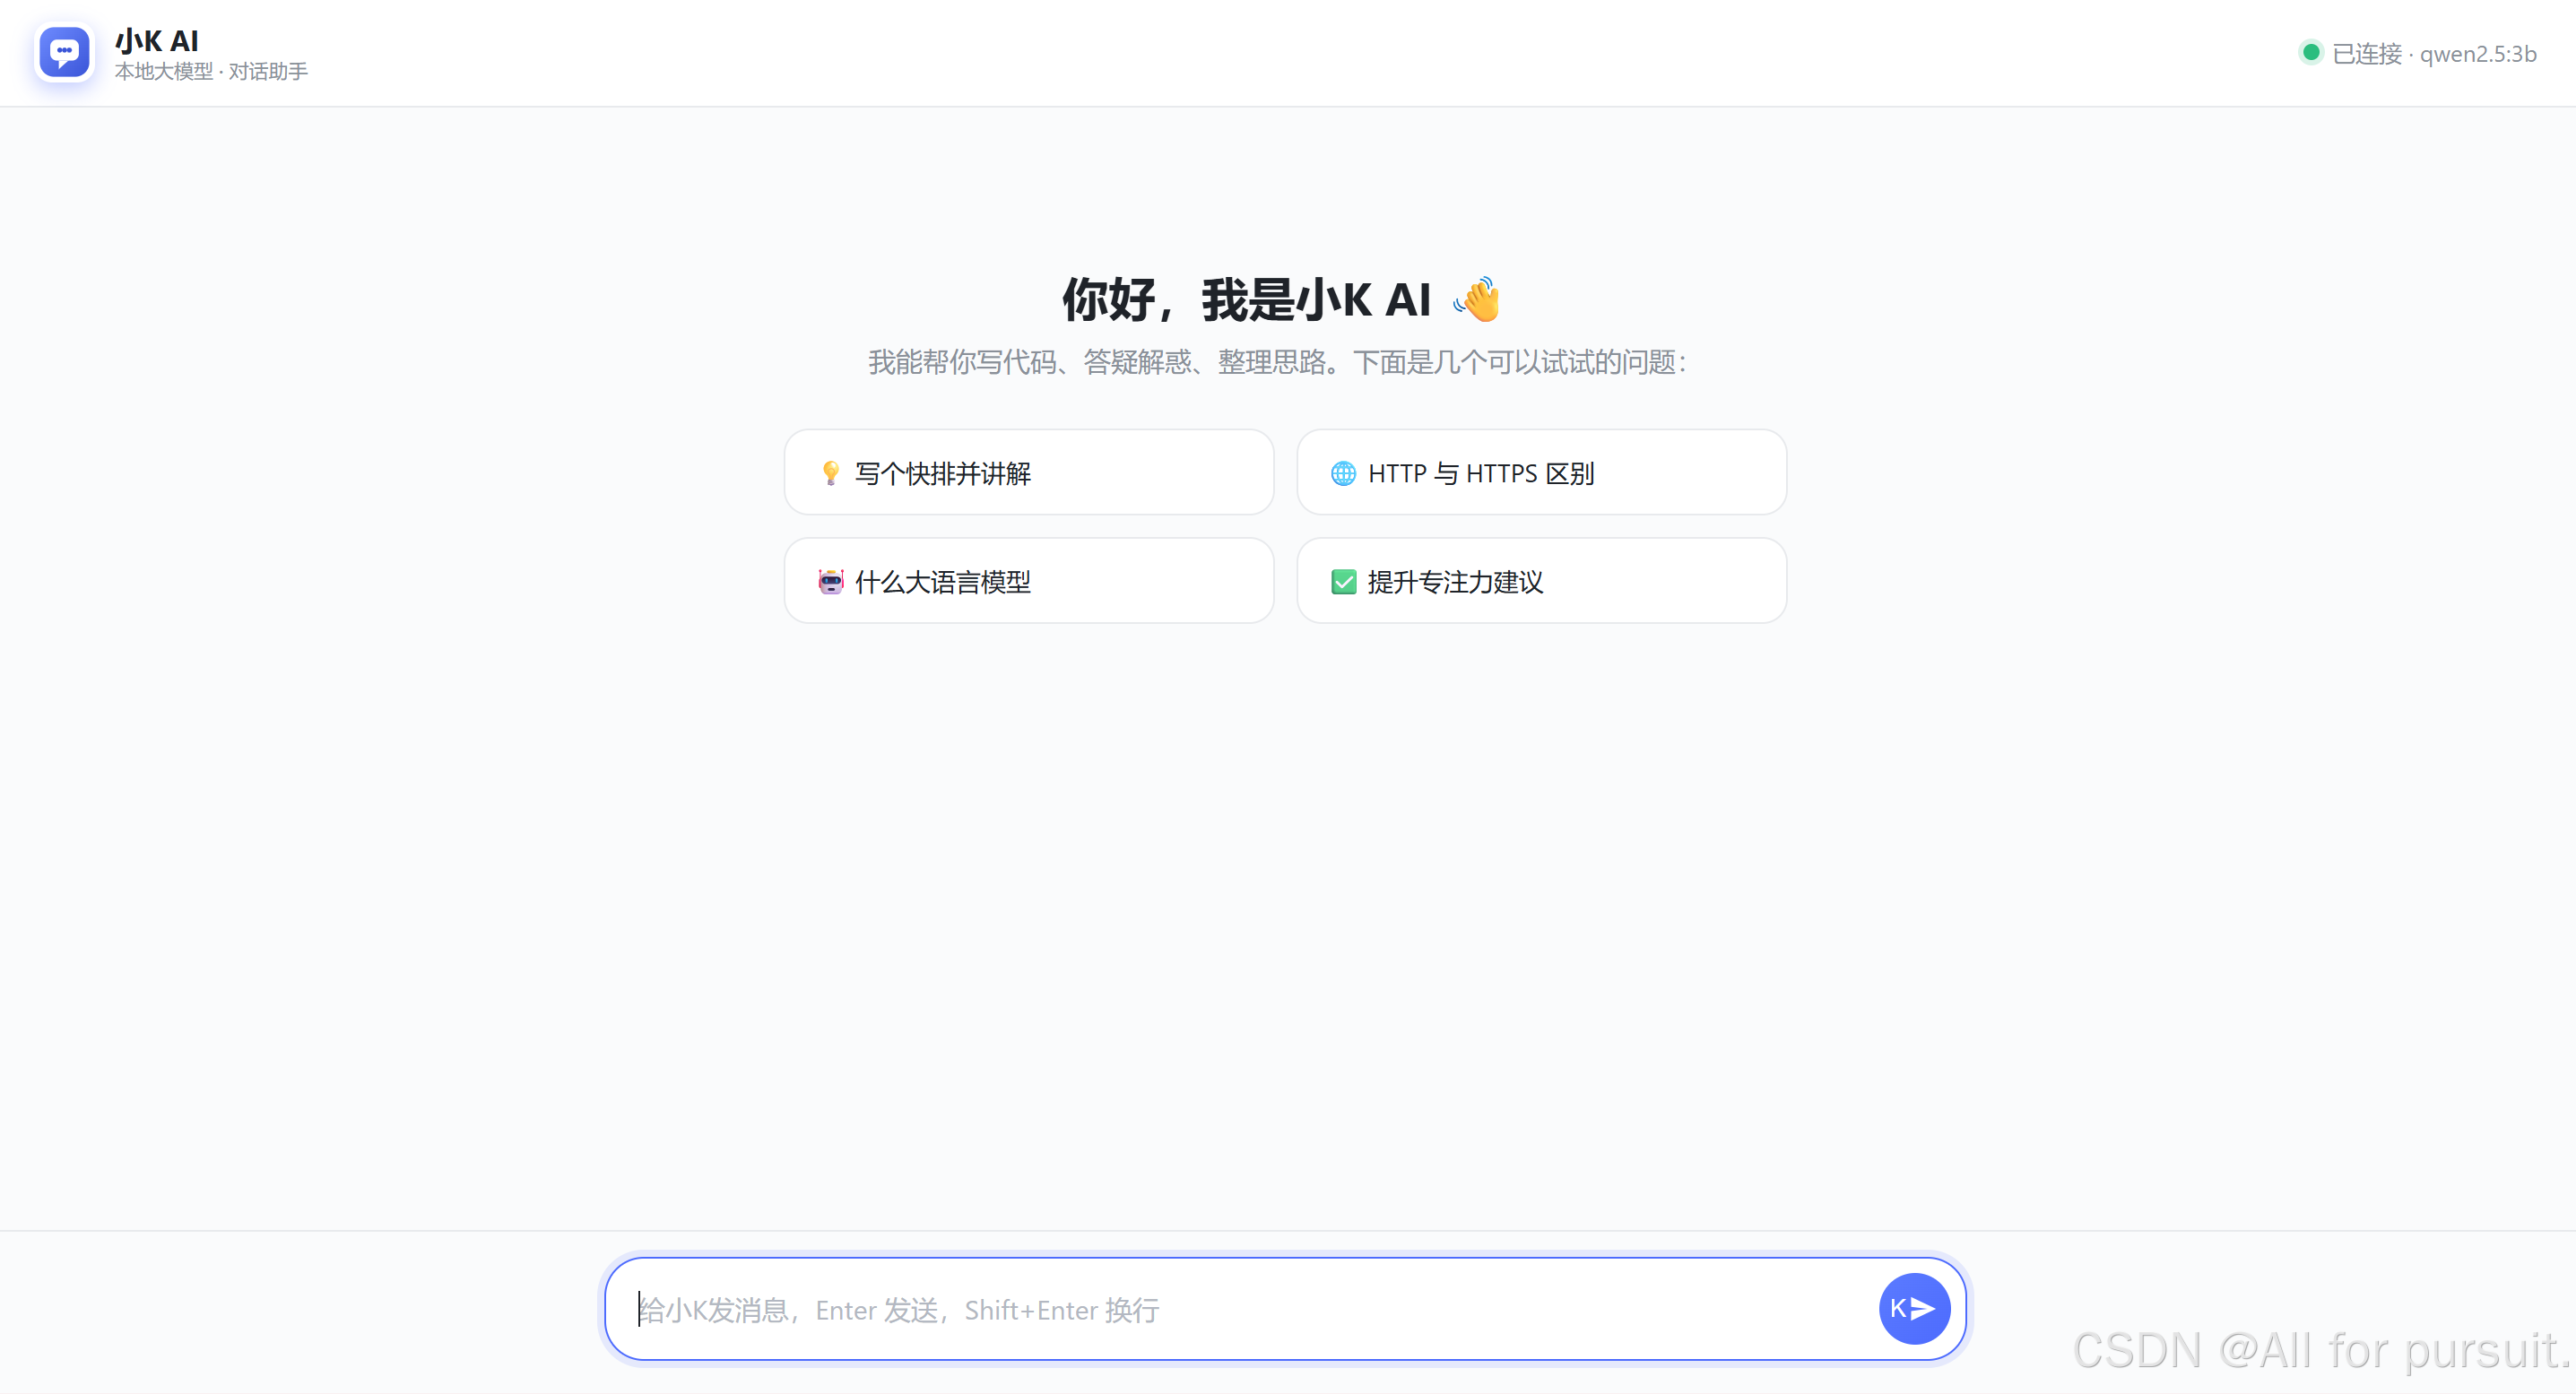
右上角状态灯显示绿色「已连接 · qwen2.5:3b」就说明三层链路全通,可以开始对话了。
浏览器打开的网页显示如下:
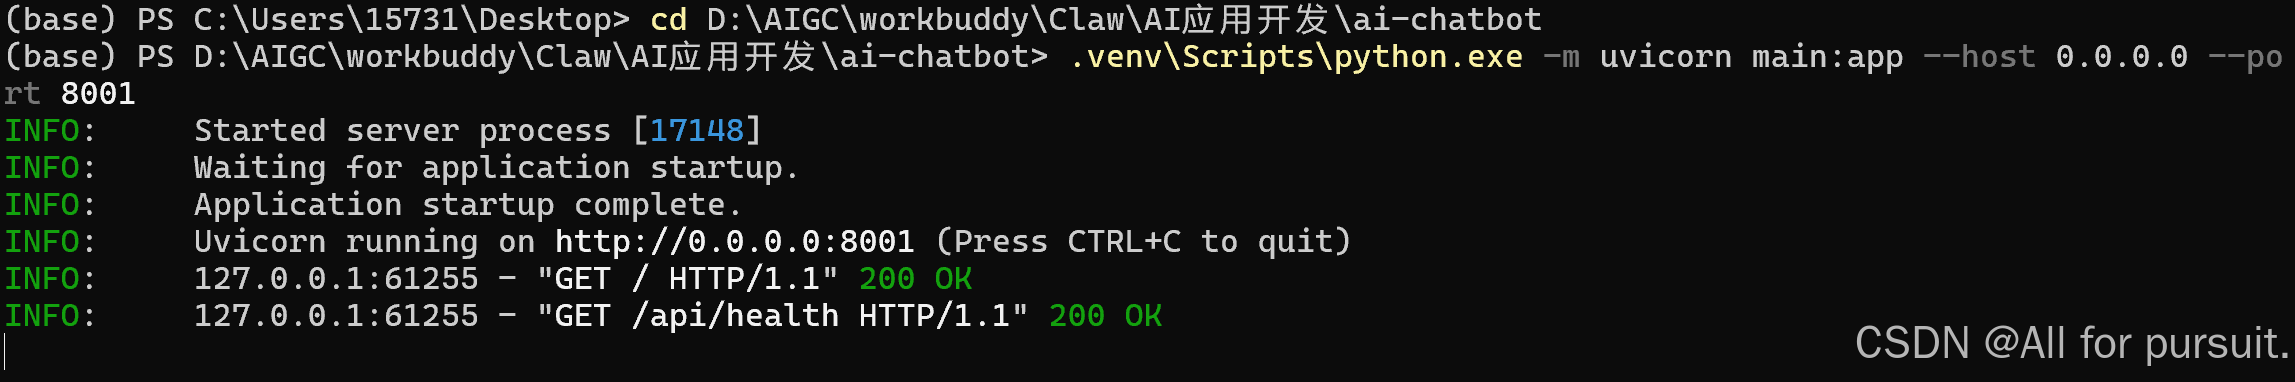
在浏览器打开网页后,终端显示如下:
测试一下能否使用:点击页面上给出的问题,回答如下:
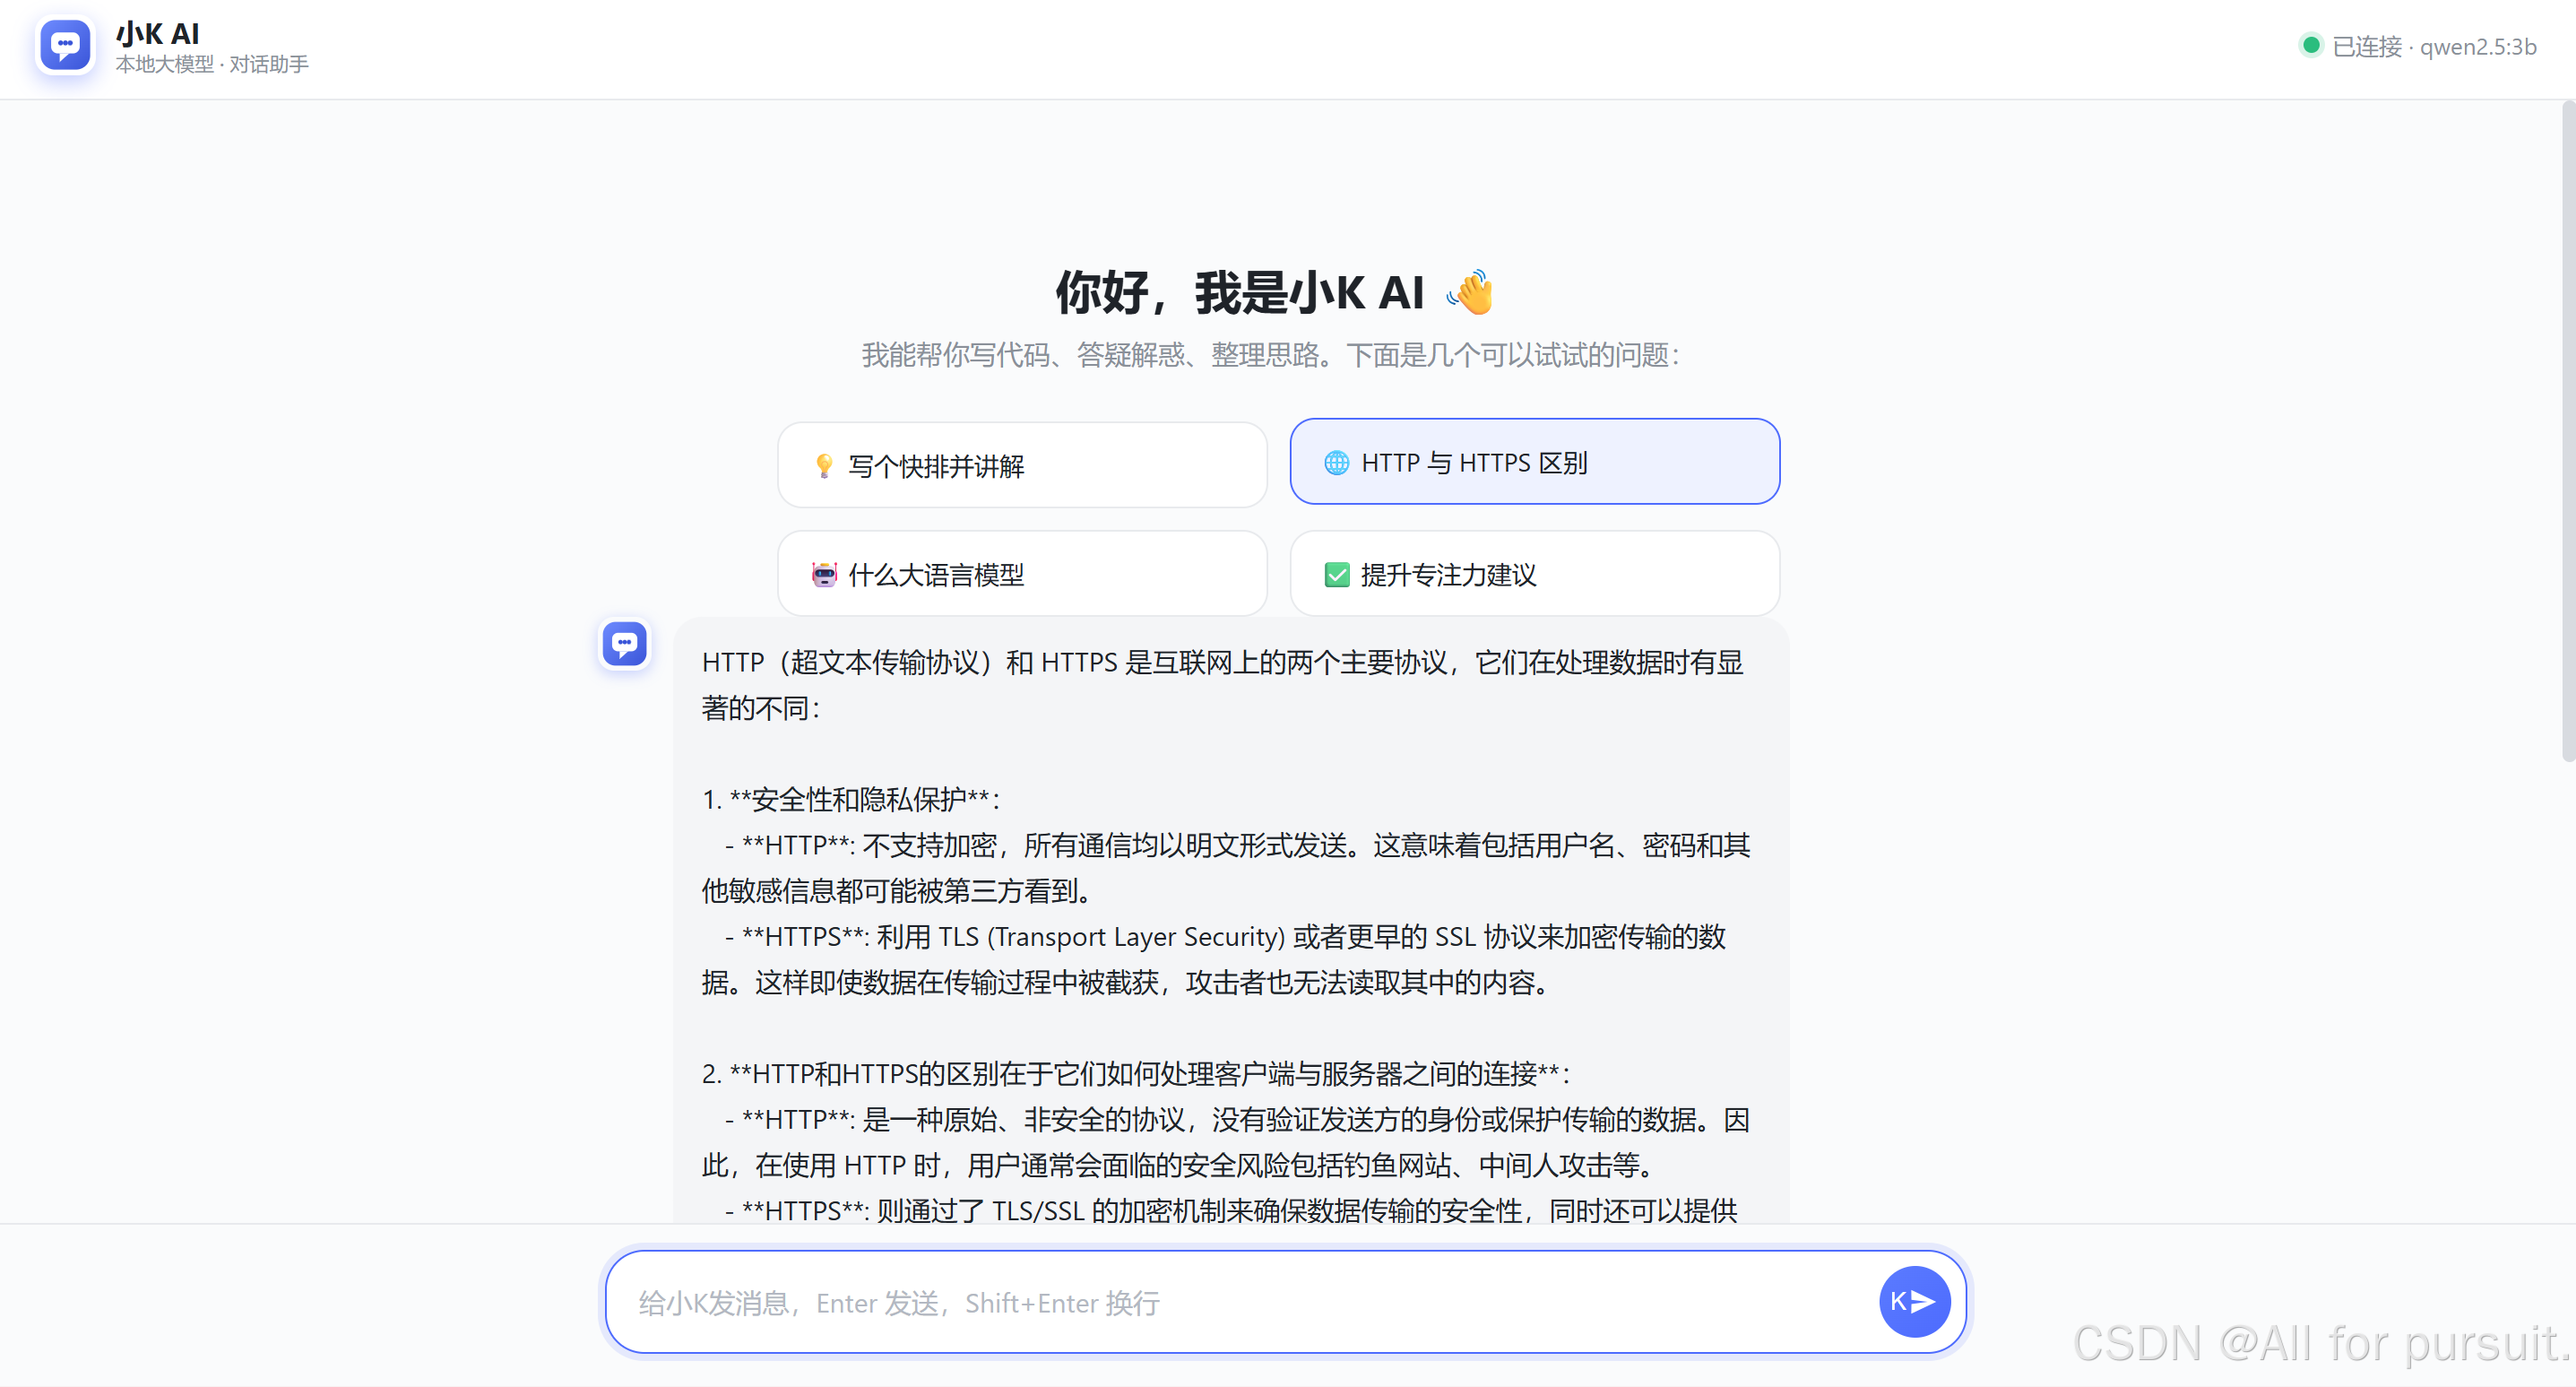
说明此AI对话助手可以正常使用啦!
四、它有哪些功能?
| 功能 | 说明 | 实现要点 |
|---|---|---|
| 流式打字机输出 | 答案逐字蹦出,不用干等 | 后端 SSE + 前端 ReadableStream |
| 多轮上下文记忆 | 能接着上一句话聊 | 前端维护 messages 数组全量回传 |
| 连接状态指示灯 | 顶部实时显示「已连接 / Ollama 未就绪 / 无法连接后端」 | 页面加载调用 /api/health |
| 空状态引导卡片 | 首屏 4 个示例问题,点一下直接问 | data-q 属性 + 事件委托 |
| 键盘操作 | Enter 发送、Shift+Enter 换行 | keydown 判断 e.shiftKey |
| 输入框自适应高度 | 最多撑到 160px 后滚动 | scrollHeight 动态回写 |
| 代码块渲染 | ``包裹的内容渲染为 <pre> |
按`` 切分奇偶段 |
| 错误可见化 | 模型名写错等问题直接在气泡里显示原因 | 后端显式捕获非 200 与流内 error |
| 移动端适配 | 600px 断点,气泡宽度 90% | CSS @media |
| XSS 防护 | 全部用 textContent 写入,不用 innerHTML |
富文本渲染函数 |
几个值得单独说的细节:
1)代码块渲染为什么"手写"而不用 markdown 库?
很多教程会引入 marked.js + highlight.js 来渲染 Markdown。本项目没有这么做,原因是:引入意味着要么加 CDN(离线环境失效)、要么加 npm(违背零构建)。而聊天场景 90% 的富文本需求就是"代码要有个灰底块",所以只需按 ``````````` 切分、奇数段包进 <pre> 即可,20 行代码解决问题,且天然免疫 XSS (全程 textContent)。
2)为什么状态灯很重要?
本地部署最常见的困惑是"我到底哪一层没起来"。状态灯把三态明确区分开:已连接 · 模型名(全通)、Ollama 未就绪(后端活着但模型层挂了)、无法连接后端(后端本身没起)。故障定位时间从"翻日志十分钟"降到"看一眼"。
五、核心原理拆解
理解这张图,就理解了整个全栈链路:
浏览器 (static/index.html)
    │  POST /api/chat   { messages: [...] }
    │  ← SSE 流式返回:data: {"content":"你"} ...
    ▼
FastAPI 后端 (main.py)
    │  POST http://localhost:11434/api/chat   { model, messages, stream:true }
    ▼
Ollama 本地大模型
为什么要中间夹一层后端,前端直接调 Ollama 不行吗?
技术上可以,但有三个实际问题:
① 浏览器直连 11434 端口会触发**跨域(CORS)**限制;
② 任何 API Key 或模型配置写在前端等于公开泄露;
③ 缺少统一入口后,后续加鉴权、限流、日志、多模型路由都无从下手。后端这一层是"中枢",不是为了凑架构。
5.1 流式输出是怎么做到的
后端:用 httpx 的流式请求把 Ollama 的输出边收边转成 SSE。
python
# main.py ------ 核心转发逻辑(节选)
async with client.stream(
    "POST",
    f"{OLLAMA_BASE_URL}/api/chat",
    json={"model": MODEL_NAME, "messages": messages, "stream": True},
) as resp:
    async for line in resp.aiter_lines():
        if not line:
            continue
        chunk = json.loads(line)
        if "message" in chunk and chunk["message"].get("content"):
            text = chunk["message"]["content"]
            # SSE 格式:以 "data: " 开头,两个换行结尾
            yield f"data: {json.dumps({'content': text}, ensure_ascii=False)}\n\n"
        if chunk.get("done"):
            yield "data: [DONE]\n\n"
前端:用 fetch + ReadableStream 逐块读取,拼进气泡。
html
// static/index.html ------ 前端接收(节选)
const resp = await fetch("/api/chat", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ messages }),
});
const reader = resp.body.getReader();          // 拿到流读取器
const decoder = new TextDecoder();
let buf = "";
while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buf += decoder.decode(value, { stream: true });
  const parts = buf.split("\n\n"); buf = parts.pop();   // 按 SSE 帧边界切分
  for (const part of parts) {
    if (!part.startsWith("data: ")) continue;
    const data = part.slice(6).trim();
    if (data === "[DONE]") continue;
    const json = JSON.parse(data);
    acc += json.content;
    bubble.textContent = acc;                  // 逐字刷新,形成打字机效果
  }
}
SSE 协议规范可参考 MDN:使用服务器发送事件 - Web API | MDN
为什么用 SSE 而不是 WebSocket? 对话是单向流 :请求一次,服务端持续吐字,客户端不需要再发数据。SSE 基于普通 HTTP,天然穿透代理、自动重连、浏览器原生
EventSource支持,而 WebSocket 需要额外握手与双向通道管理。用 SSE 是更轻的正确解------WebSocket 在这里属于过度设计。
5.2 AI 为什么能"记住"前面聊了什么
大语言模型本身是无状态 的:每次请求对它而言都是全新的。所谓"记忆",靠的是每次都把完整对话历史一起发过去。
python
let messages = []; // 前端保存完整对话历史
messages.push({ role: "user", content: text }); // 用户发言入列
// ... 请求时整列发给后端
// 收到完整回答后:
messages.push({ role: "assistant", content: acc }); // AI 回答也入列后端原样透传给 Ollama 的 /api/chat,模型看到完整上下文,于是能接着聊。
由此可推出两个实践结论:
-
上下文越长,单次推理越慢、占用显存越高------这是所有长对话变慢的根本原因;
-
刷新页面 = 清空
messages= 模型"失忆"。想持久化就得把历史存进数据库或localStorage(见第八节扩展方向)。
5.3 一个真实的坑:Ollama 的静默 404
这是开发中实际踩到的问题,值得单独记录:当模型名不存在时,Ollama 会返回 404,且这个响应不是流式的 。如果只写 async for line in resp.aiter_lines(),循环会直接结束,前端收到一个空响应------界面上表现为"AI 没有反应",控制台没有任何报错,极难排查。
解决办法是显式检查状态码:
python
if resp.status_code != 200:
    body = await resp.aread()
    err = json.loads(body).get("error", body.decode("utf-8", "ignore"))
    yield f"data: {json.dumps({'error': f'Ollama 返回 {resp.status_code}:{err}'}, ensure_ascii=False)}\n\n"
    yield "data: [DONE]\n\n"
    return
加上这段后,模型名写错会在气泡里直接显示 Ollama 返回 404:model "xxx" not found,一句话定位问题。
六、相比其他方案,优势在哪?
6.1 对比云端 API 方案(如直接调 OpenAI / 文心 / 通义 API)
| 维度 | 本项目(本地 Ollama) | 云端 API |
|---|---|---|
| 数据隐私 | 完全不出本机,可断网运行 | 需上传对话内容至服务商 |
| 费用 | 0 元(电费除外) | 按 token 计费,长期有成本 |
| 网络依赖 | 首次拉模型后无需联网 | 强依赖网络与服务商可用性 |
| 注册门槛 | 无,不需要 API Key | 需注册、实名、额度申请 |
| 模型能力 | 3B~7B 量级,够用但不顶尖 | 顶尖大模型,复杂推理更强 |
| 响应速度 | 取决于本机硬件 | 稳定较快 |
| 合规风险 | 内网场景可放心使用 | 涉敏数据需评估 |
客观结论 :如果追求最强推理能力或生产级稳定性,云端 API 仍是更优解;但如果诉求是隐私敏感场景(内部文档、代码、医疗/法务文本)、离线环境、学习研究、零成本原型验证,本地方案的性价比是压倒性的。
6.2 工程层面的其他优势
-
配置与代码分离 :
OLLAMA_BASE_URL、MODEL_NAME通过.env注入(python-dotenv),换模型不用改代码。 -
自带健康检查 :
/api/health返回{"ok": true, "models": [...], "model": "qwen2.5:3b"},便于接入监控或容器探针。 -
自动接口文档 :FastAPI 原生生成
/docs,无需手写 Swagger。 -
静态路由挂载顺序正确 :
app.mount("/", ...)放在所有/api路由之后,避免静态托管覆盖 API------新手常踩的顺序陷阱。 -
MIT 许可:可自由商用、二次开发,无授权负担。
七、常见问题速查
| 现象 | 原因 | 解决办法 |
|---|---|---|
| 状态灯红色「Ollama 未就绪」 | Ollama 未启动 | 启动 Ollama 应用,或执行 ollama serve |
| 对话无反应、无报错 | 模型名与 ollama list 不一致 |
ollama list 核对后改 .env 的 MODEL_NAME |
提示 model not found |
模型没拉下来 | ollama pull qwen2.5:3b |
| 首次回答特别慢 | 模型首次加载需载入显存/内存 | 正常现象,第二次起明显变快 |
Address already in use |
8000 端口被占用 | uvicorn main:app --port 8001 |
ModuleNotFoundError: No module named 'dotenv' |
依赖未装全 | pip install -r requirements.txt(含 python-dotenv) |
| 响应逐字输出但很卡 | CPU 推理 + 模型偏大 | 换 qwen2.5:3b,或改用带 GPU 的机器 |
| 页面 404 / 样式丢失 | 未在项目根目录启动 | cd 到含 main.py 的目录再执行 |
八、相关官方资源汇总
核心依赖