引言
你公司的知识资产真的只有Word文档吗?
翻一翻各部门的文件服务器:销售部的客户跟进Excel表、市场部的项目汇报PPT、技术部的设备说明书PDF、行政部的会议纪要录音、财务部的台账报表......这些文件里藏着大量有价值的信息,但传统知识库只能处理纯文本搜索------图表看不懂,表格数据查不了,录音听不着。
据CSDN 2026年9月报道,企业80%的核心知识蕴藏在图片、报表、PDF混合文档等非纯文本载体中。传统知识库只覆盖了冰山一角,剩下的大量知识资产处于"存了但用不了"的状态。
ISC团体标准《基于大模型的企业级AI知识库能力要求》(T/ISC0101---2026,2026年3月发布)明确要求:在多模态场景下应利用多模态大模型、OCR、声轨识别等技术对图像、音频等不同类型数据进行解析。这不是学术倡议,是行业标准的硬性要求。
Gartner 2026年9月调研显示,85%的职能负责人计划年内增加AI支出,但仅22%的组织成功扩展到多个业务单元。差距很大一部分卡在"知识进不来"------非文本格式的知识没有被有效转化。
本文给出一套将音频、表格数据、PDF混合文档转化为可检索、可问答知识资产的系统方案。三种模态,四条技术链路,一套落地路径。不讲概念,只讲怎么干。
第一章 认知校准:企业知识的"冰山模型"
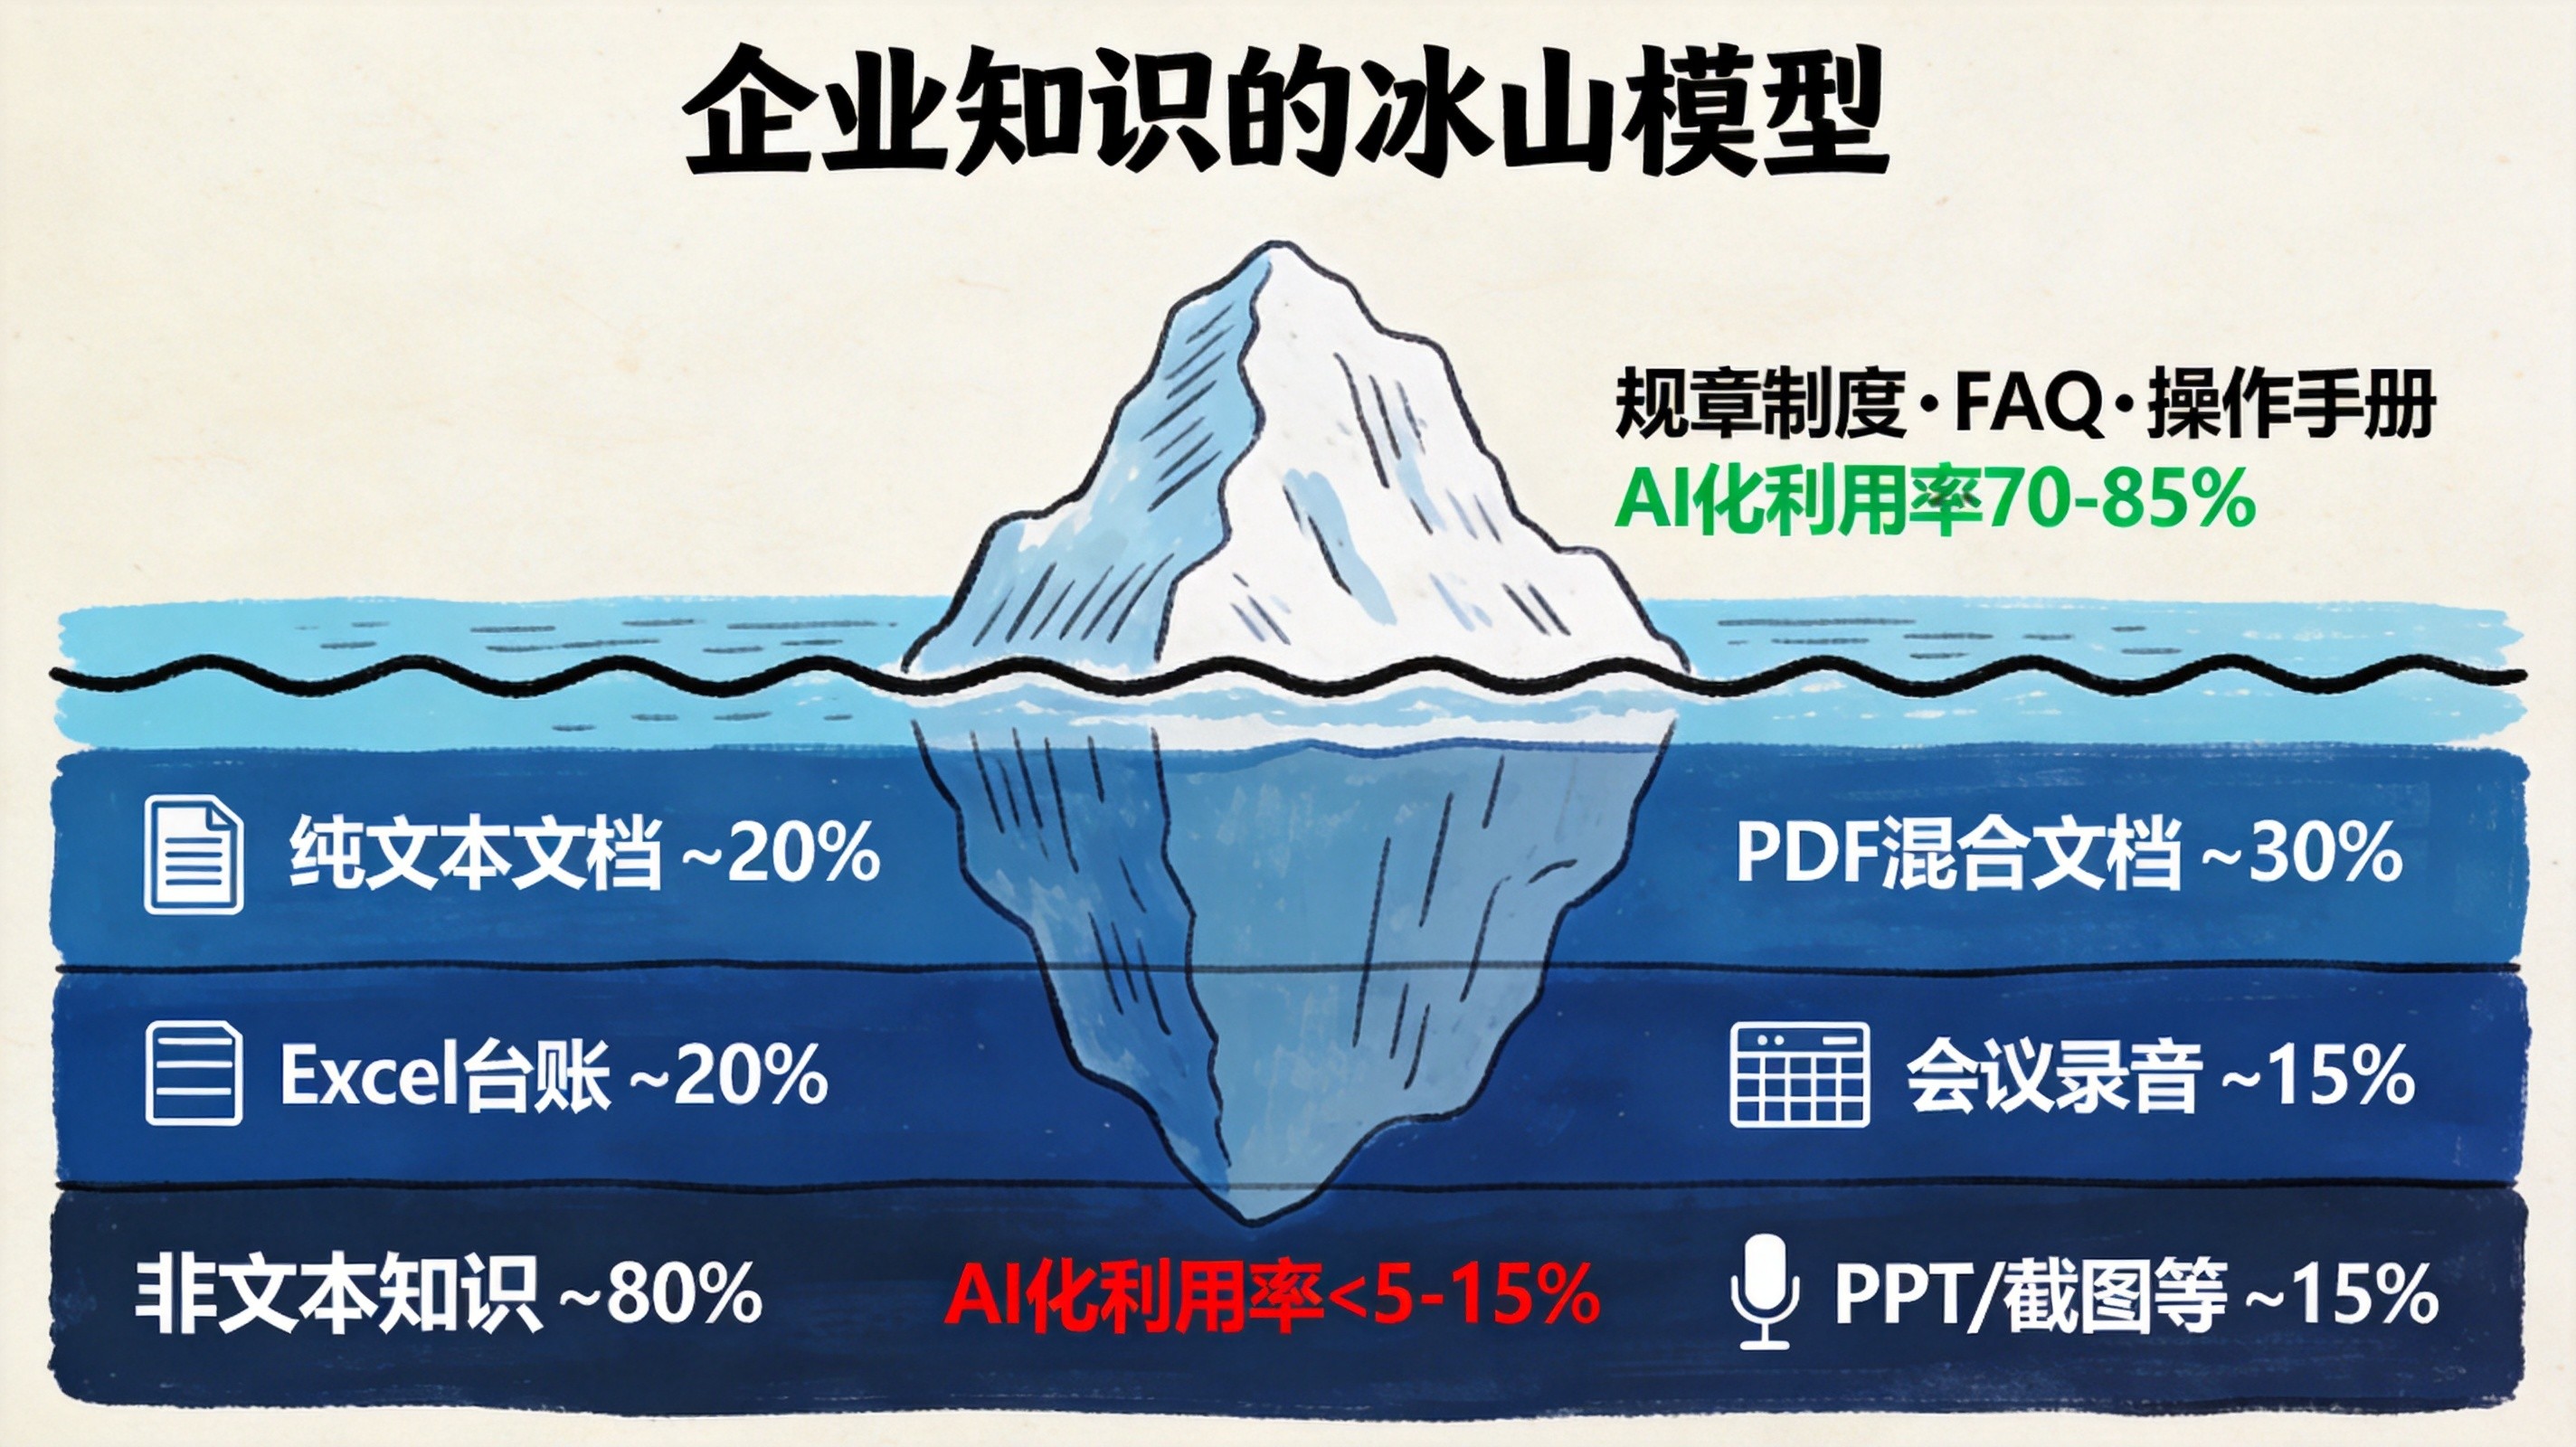
大多数企业做知识库的第一步,是把Word文档灌进去。这没错,但只做了20%的工作。
1.1 冰山之上与冰山之下
企业知识资产可以分成两层。
冰山之上(约20%) :纯文本文档------规章制度、FAQ、通知、操作手册的文字部分。这些内容传统知识库已经能处理,也是大多数企业知识库目前的覆盖范围。
冰山之下(约80%) :会议录音、Excel台账报表、PDF中的图表和流程图、产品截图、设计稿、PPT里的SmartArt结构、扫描件、设备说明书里的技术参数表格。这些内容占企业核心知识的大头,但绝大多数企业还没碰过。
|--------------------|---------------|--------------|---------------|-----------------------|
| 知识类型 | 占企业知识总量比例 | 当前AI化利用率 | AI化后可检索比例 | 典型场景 |
| 纯文本文档(制度/FAQ/通知) | ~20% | 较高(70-85%) | 90%+ | 行政制度、产品FAQ、操作手册文字部分 |
| PDF混合文档(图文/表格/流程图) | ~30% | 极低(<15%) | 85%+ | 设备说明书、技术报告、产品手册 |
| Excel/CSV台账报表 | ~20% | 低(<10%) | 90%+ | 客户跟进表、维保记录、销售数据、HR花名册 |
| 音频(会议/访谈/培训) | ~15% | 极低(<5%) | 80%+ | 客户访谈录音、项目复盘会、培训录音 |
| 其他(PPT/截图/设计稿) | ~15% | 极低(<5%) | 60-70% | 项目汇报PPT、产品截图、流程设计稿 |
这张表说明一件事:大多数企业的知识库只开发了不到20%的知识资产。剩下的80%,不是没有价值,而是不知道怎么让它"能被搜到、能被问到"。
1.2 多模态知识库不是"文件格式多"
很多人把多模态知识库理解为"能存更多格式文件的知识库"------能存PDF、能存Excel、能存音频,就是多模态了。
这个理解不对。
多模态知识库的核心不是"存",而是"理解"。具体来说:不同模态的内容都能被语义理解和跨模态检索。用户提一个问题,系统能同时从文档文字、表格数据、音频转写内容中找到相关信息并给出回答------这才是多模态知识库。
举个例子。用户问"XX型号设备上次维保是什么时候":
• 纯文本知识库:搜不到,因为维保记录在Excel台账里
• 多模态知识库:从Excel台账中检索到维保记录,返回"2026年3月15日,维保工程师张某"
再比如用户问"上次客户访谈中提到的核心诉求是什么":
• 纯文本知识库:搜不到,因为访谈内容在录音里
• 多模态知识库:从音频转写后的文本中检索到访谈内容,返回客户提到的三个核心诉求
1.3 三种核心形态
根据53AI在160+项目中的经验,企业级多模态知识库主要覆盖三种形态:
形态一:文本+音频。 最常见的入门场景。咨询公司、服务机构每周有大量客户访谈录音、内部会议录音、培训录音。通过ASR转写后变成可检索的文本。
形态二:文本+PDF混合文档。 最普遍的场景。制造企业的设备说明书、技术手册、检测报告,大量内容是图文混排的------一页里同时有文字段落、数据表格、产品截图、流程图。传统OCR只提取文字,图表信息全部丢失。
形态三:文本+表格/结构化数据。 最实用的场景。每个企业都有几十甚至上百份Excel台账------客户跟进表、设备维保记录、项目进度表、销售数据汇总。把这些数据知识化后,业务人员可以直接用自然语言查询。
→ 第1篇《企业知识库冷启动》中语料来源分类的第3-5类(录音、台账、经验文档)正是这80%的非文本知识
一句话总结:企业80%的知识资产在非文本载体中,多模态知识库要做的是让这些知识"能被理解、能被搜到、能被问到",而不仅仅是"能存进去"。
第二章 PDF混合文档知识化:让图文混排的内容"看得懂、搜得到"
翻开你们技术部的设备说明书PDF------一页里面同时有文字段落、参数表格、产品截图、电路流程图、数学公式。传统OCR做完之后,只剩下文字,表格结构被打散,流程图变成一堆乱码,截图里的信息直接消失。
这是企业知识库最普遍也最棘手的问题。不是缺文档,而是文档里的信息"看得见但提取不出来"。
2.1 问题本质:一页PDF里藏着五种信息
一份典型的图文混排PDF页面可能同时包含:
-
文字段落 :说明性文字、操作步骤
-
数据表格 :技术参数、规格指标
-
流程图/结构图 :工作流程、电路结构、装配关系
-
产品截图/照片 :实物照片、UI界面截图
-
数学公式 :计算公式、参数推导
传统OCR只处理第一种------文字。剩下四种信息要么丢失,要么被当成乱码文字强行提取,既不准确也没有结构。掘金社区2026年5月的一篇技术总结明确指出:表格、跨页表格、图片、流程图等特殊格式处理,是企业RAG落地最常见的"坑"。
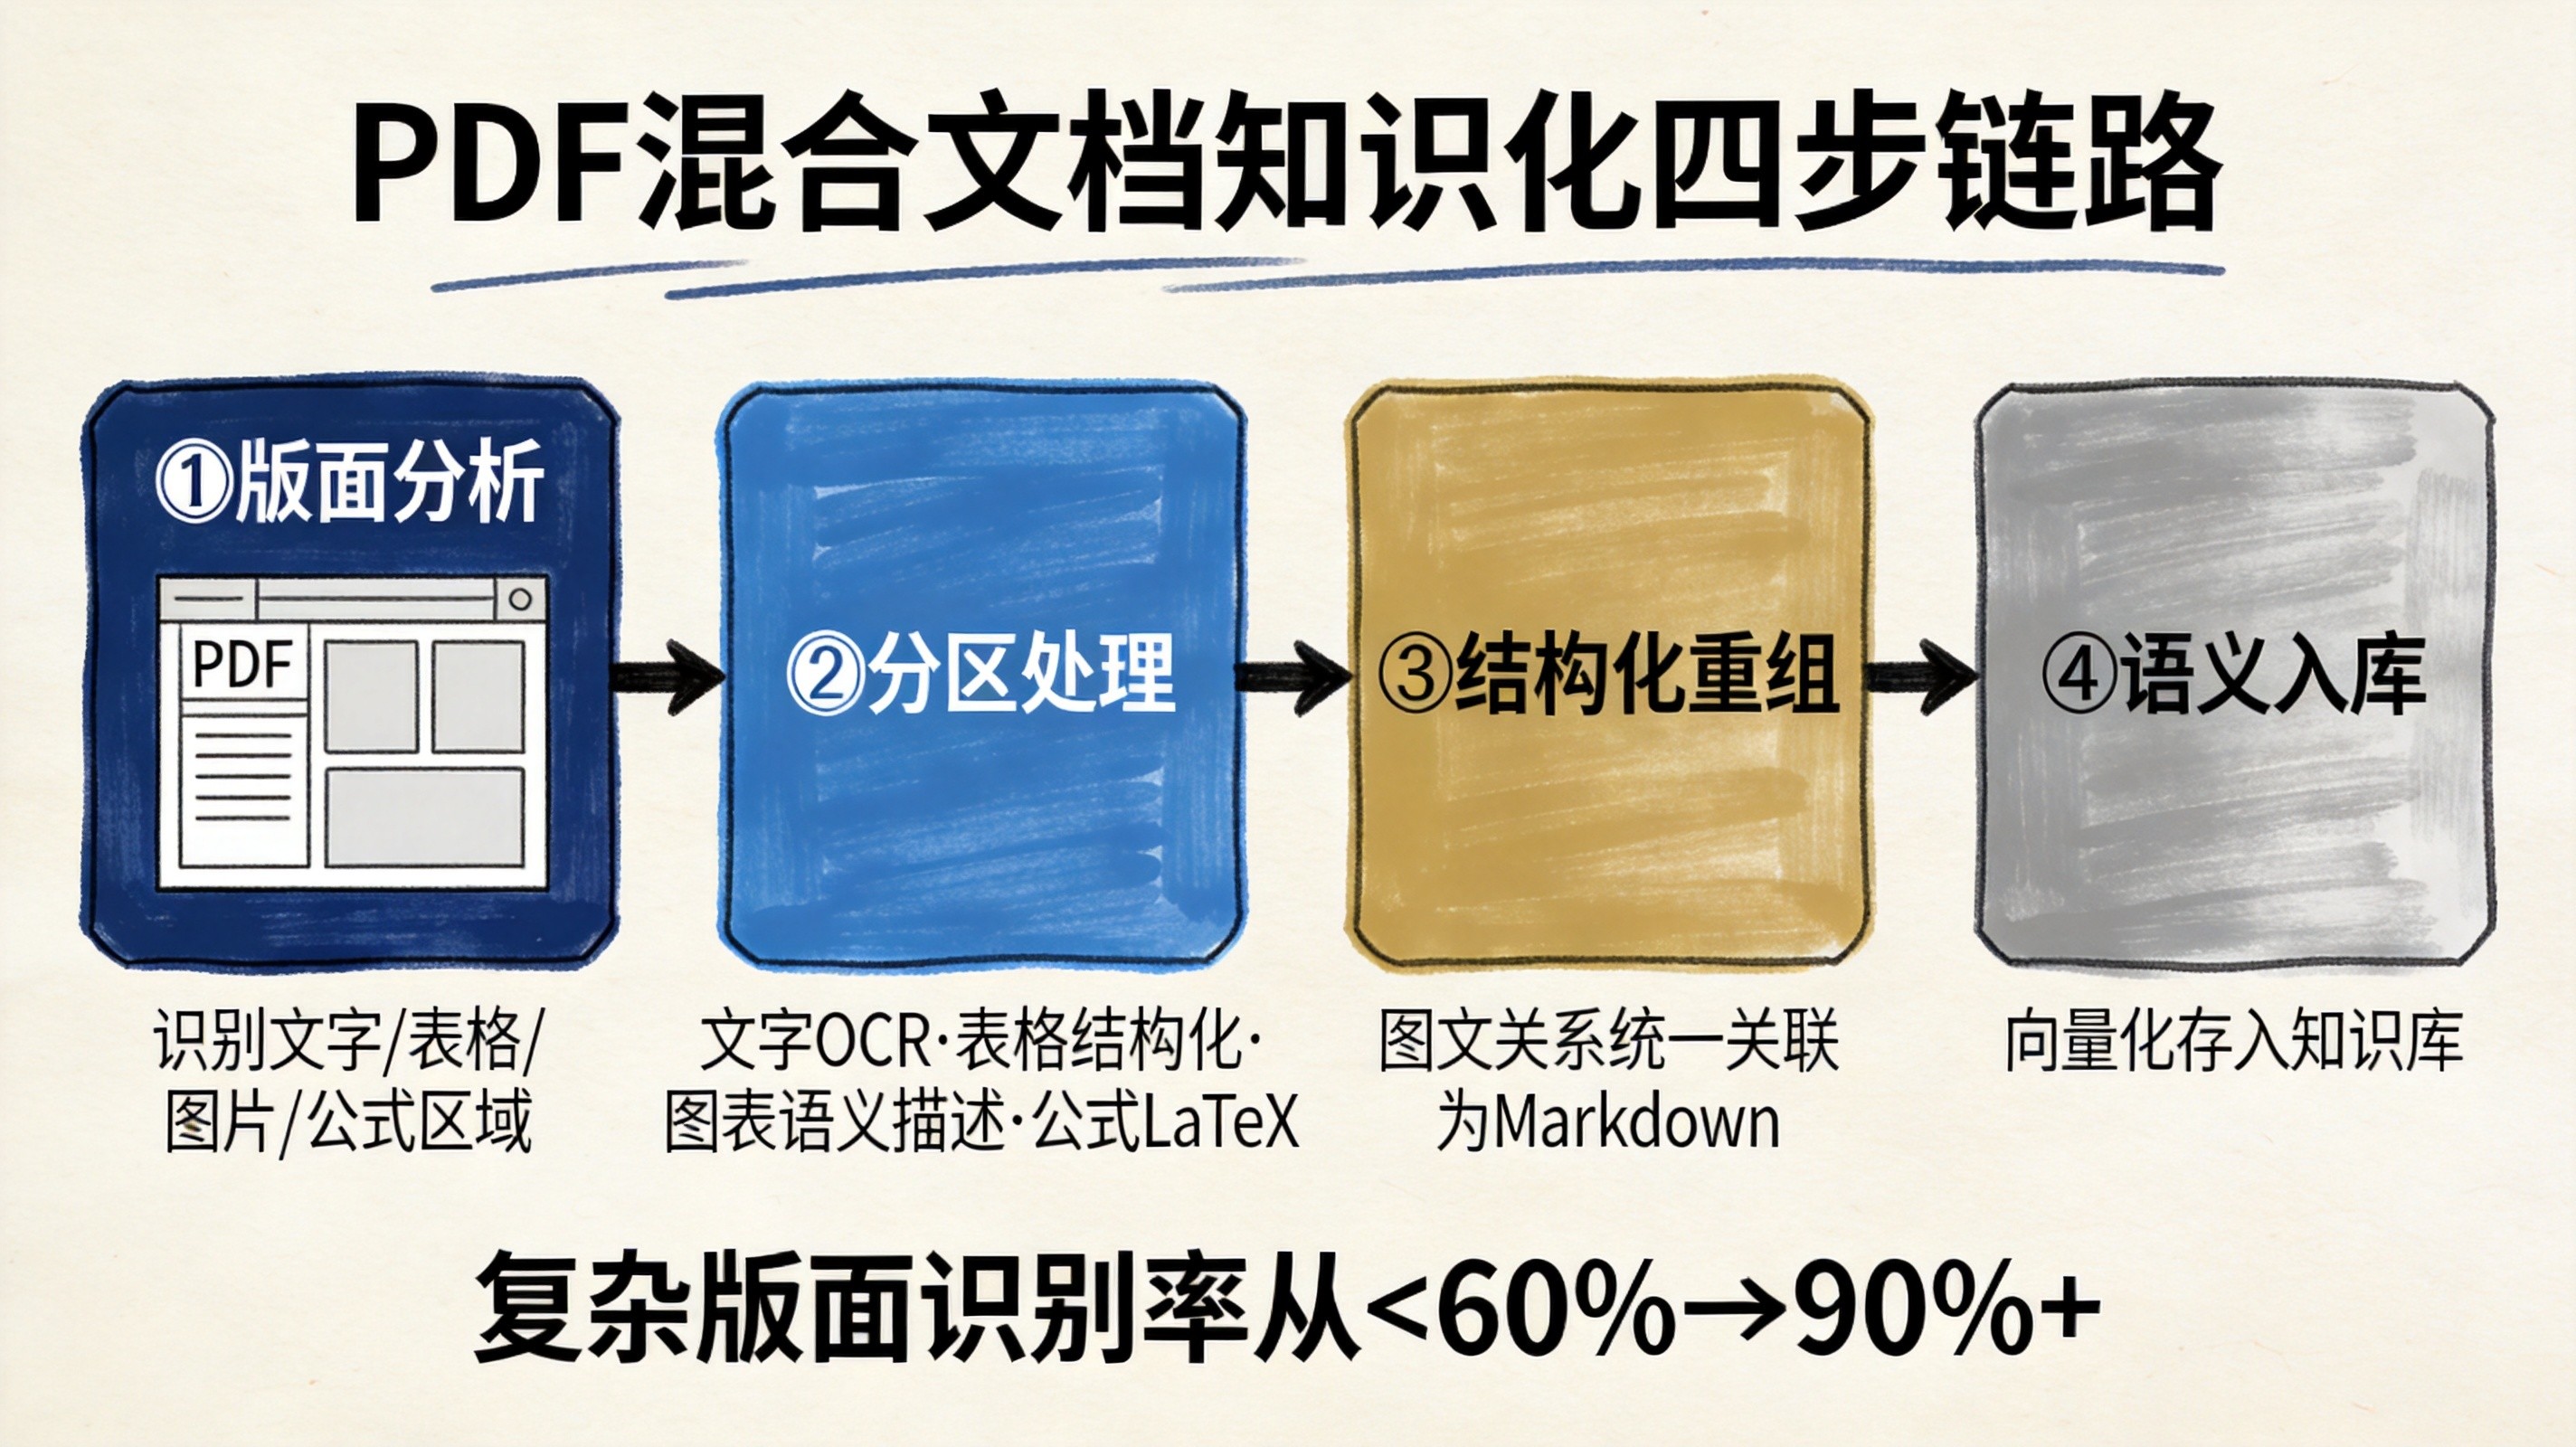
2.2 技术链路:四步把PDF变成结构化知识
第一步:文档解析+版面分析。 识别页面中每个区域的类型------文字、表格、图片、公式各在什么位置。这一步是所有后续处理的基础,版面分析做不好,后面全白搭。
第二步:分区域处理。 文字区域→OCR提取;表格区域→结构化解析保留表头和数据行关系;流程图/截图→多模态大模型生成语义描述;公式区域→LaTeX识别。
第三步:结构化重组。 把各区域解析结果按原始版面关系重组为统一Markdown格式。图表标题要和图表内容关联,流程图步骤说明要和图中的框对应------图文关系必须在重组阶段处理,不能等到切片时再补。
第四步:语义切片+向量化入库。 重组后的结构化内容按语义切片,向量化后存入知识库。
2.3 两条技术路线:成本、效果天差地别
|----------|--------------------|-----------------------|
| 对比维度 | 路线A:传统OCR+规则引擎 | 路线B:多模态文档解析引擎 |
| 文字提取 | 基本可用,识别率95%+ | 可用,识别率95%+ |
| 表格处理 | 结构丢失,变成纯文本 | 保留表头+数据行关系,结构化输出 |
| 流程图/截图 | 直接丢弃或变成乱码 | 多模态模型生成语义描述 |
| 公式 | 全部乱码 | LaTeX格式识别 |
| 复杂版面识别率 | <60% | 90%+ |
| 单页处理成本 | 低(约0.01-0.05元/页) | 中(约0.05-0.2元/页) |
| 适用场景 | 纯文字PDF、简单排版 | 图文混排、多列排版、含表格/图表的技术文档 |
| 典型工具 | Tesseract、ABBYY基础版 | TextIn、MinerU |
结论很清楚:如果企业里的PDF是纯文字文档(比如扫描的合同),传统OCR够用。但如果是设备说明书、技术手册、检测报告这种图文混排的内容,传统OCR会丢失大量关键信息。
53AI Brain的文档清洗流水线除了支持自研的解析引擎,还支持TextIn和MinerU两种文档解析引擎,对PDF和扫描件有较好的图文混排识别效果,可自动区分文字区域、表格区域和图片区域分别处理。在制造业客户项目中,这两种引擎在技术参数表格和结构示意图的解析上表现稳定,是目前企业级场景下性价比较高的方案。
2.4 关键挑战:图文关系不能断
PDF解析后最容易出问题的环节是"图文关系保持"。三个常见坑:
坑一:图表标题和内容分离。 一个表格上方有标题"表3-2 XX设备技术参数",切片时如果标题和内容被分到两个切片,用户搜索"XX设备技术参数"时可能只找到标题,找不到具体数据。
坑二:流程图步骤说明错位。 流程图的步骤说明文字通常写在图的旁边或下方,版面分析如果没做好位置关联,说明文字和图的对应关系就断了。
坑三:跨页表格断裂。 一个表格从第5页延续到第6页,解析时如果没有跨页合并逻辑,表格会被切成两个不完整的半表,数据行丢失表头。
这些问题的解决需要在解析阶段就做好版面关系的记录和保持,而不是等到切片时才补救。
2.5 落地案例
案例一:某晶圆代工龙头企业。 需要解析的文档类型覆盖PDF/Word/PPT/Excel,其中PDF文档大量包含表格、流程图、图表、SmartArt结构和内嵌图片。项目要求对每种元素分别处理并保留结构信息,同时支持来源追溯------AI回答时必须标注"来自XX文档第X页"。最终方案采用多模态文档解析引擎做版面分析,对文字、表格、图表分别处理后统一重组为Markdown格式,原图作为兜底保留。
案例二:上海勘察设计研究院。 核心需求是勘察报告、扫描件、跨页表格的版面语义保留。勘察报告的特殊之处在于大量扫描件质量参差不齐(倾斜、模糊、印章遮挡),同时工程类文档对来源证据可追溯要求很高------工程师需要看到AI引用的原文位置和页码。
案例三:石化企业SOP操作规册。 操作步骤旁配有设备实拍照片,参数表格和流程说明交替出现。多模态OCR+版面分析精准区分不同区域,将文字步骤和配图操作保持关联。
说到底,PDF混合文档知识化的核心不是"把文字提取出来",而是"把文字、表格、图表、流程图各自解析后按原始版面关系统一关联"。传统OCR只做了第一步,多模态文档解析引擎才能做完整。
第三章 音频知识化:会议录音、访谈记录的AI化管理
每周20多个小时的客户访谈录音,堆在共享文件夹里。项目经理想找某客户上次提到的核心诉求,得从头听到尾翻一遍录音。这种事情在咨询公司、服务机构、ToB企业里天天发生。
音频知识化的核心问题不是"怎么把录音存进知识库",而是"怎么让录音里的信息能被搜索、能被引用、能回答具体问题"。
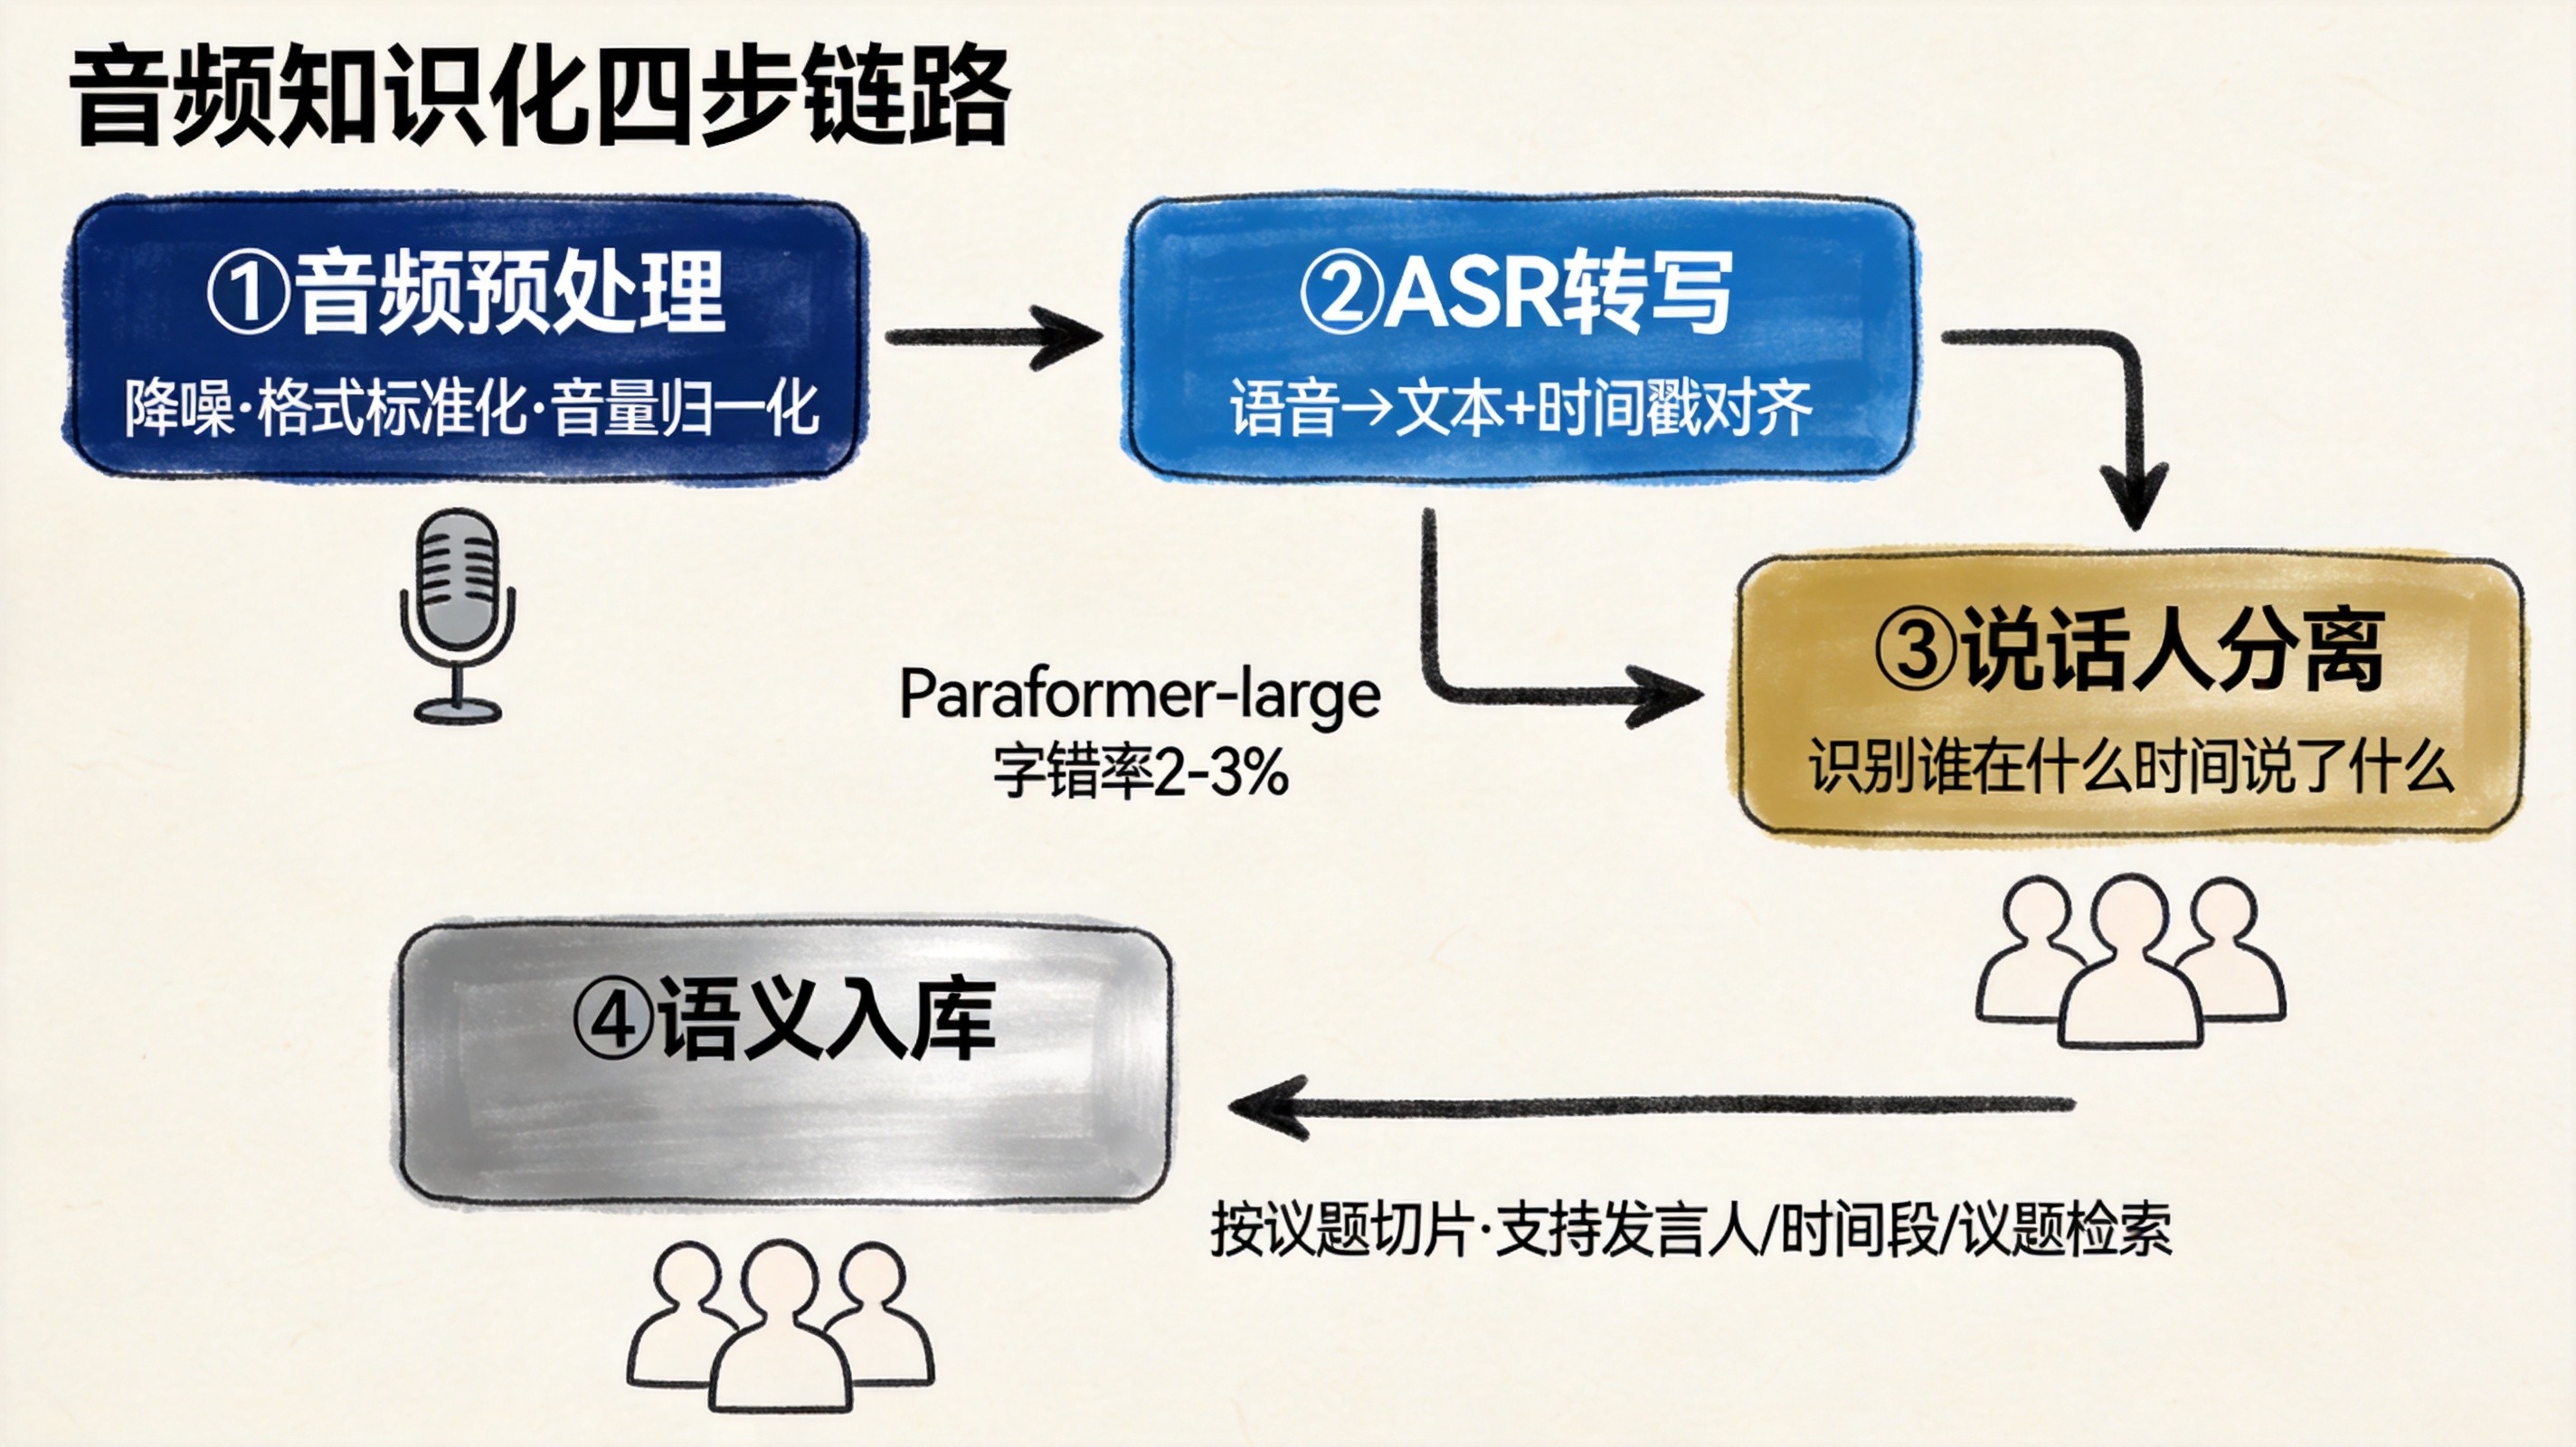
3.1 技术链路:四步把声音变成可检索的知识
第一步:音频上传与预处理。 降噪、格式标准化(统一16kHz采样率单声道WAV)、音量归一化。这一步对转写准确率影响很大------带背景噪音的会议录音,预处理前后ASR准确率可以差5-10个百分点。
第二步:ASR语音转写+时间戳对齐。 将语音转化为文本,每个字都带有时间戳标记。中文场景下,Paraformer-large在标准普通话上的字错率可低至2%左右,带口音或背景噪音的场景也能控制在5-6%以内。Whisper-large-v3在中文普通话上表现也不错,字错率约5%,但在带口音和噪音场景下与Paraformer有明显差距。
|------------|----------------------|----------------------|
| 对比维度 | Paraformer-large | Whisper-large-v3 |
| 中文标准普通话字错率 | ~2-3% | ~5% |
| 带口音/方言场景 | ~5-6% | ~8-12% |
| 噪音环境表现 | 较好 | 一般 |
| 专业术语识别 | 支持热词增强 | 依赖Prompt引导 |
| 识别速度 | 1.8x实时 | 1.2x实时 |
| 多语言支持 | 中文专精 | 99种语言 |
| 适用场景 | 中文为主的会议/访谈/培训 | 多语言混合场景 |
数据来源:CSDN 2026年1月实测对比,6段真实业务音频样本。
第三步:说话人分离(Speaker Diarization)。 识别"谁在什么时间说了什么"。会议录音中多人交替发言是常态,如果不做说话人分离,转写出来的文本就是一大段分不清谁说的文字,后续检索和引用的价值大打折扣。目前开源方案如pyannote-audio已经能做到比较准确的说话人分离,配合ASR时间戳,可以生成"张三(00:15:23-00:17:45):客户的核心诉求是降低库存成本"这样的结构化记录。
第四步:语义切片+知识入库。 将转写后的文本按议题或时间段切片,存入知识库。切片时保留说话人信息和时间戳作为元数据,支持按发言人、按时间段、按议题检索。
3.2 核心能力:三种检索维度
音频知识化之后,用户可以做到三件事:
按发言人检索。 "张总在上次项目复盘会上说了什么?"------通过说话人标签过滤,直接定位到特定发言人的内容。
按议题定位。 "客户上次反馈的核心问题有哪些?"------通过语义检索匹配转写文本中与"客户反馈"相关的内容,定位到对应的音频时间段。
按时间范围筛选。 "上周的项目例会讨论了什么?"------通过时间戳元数据过滤特定时间段的会议内容。
3.3 长音频处理策略
企业会议录音动辄1-2小时,不能一次性全部送入ASR。53AI在项目中总结的长音频处理策略:
分段处理。 超过30分钟的音频按5-10分钟切段处理,每段独立转写后拼接。原因有二:一是避免内存溢出,二是超长音频的ASR准确率会随长度增加而下降。
VAD预切分。 利用语音活动检测(VAD)识别静音段,在静音处自然切分。这比按固定时间切分效果好得多------不会把一个完整的句子从中间切断。
中文场景关键参数。 采样率16kHz、单声道、16bit PCM编码,这是大多数ASR模型的标准输入格式。如果原始录音是MP3,建议先用ffmpeg转为WAV再处理,MP3压缩会损失高频信息,影响辅音识别准确率。
3.4 案例:咨询公司客户访谈录音知识化
某咨询公司每周产生20+小时的客户访谈录音,过去全靠项目组成员手动整理访谈纪要。引入音频知识化方案后,录音经过ASR转写+说话人分离+语义切片,自动形成可检索的客户洞察库。顾问需要回顾某个客户的访谈内容时,直接提问即可定位到具体的发言段落,不用从头听录音。
53AI Brain支持音频文件上传与智能语音转写,将非结构化声音内容转化为可检索的文本,并保留时间戳和发言人信息作为元数据,支持按发言人、按时间段、按议题进行检索。在咨询、法律、教育等依赖大量语音沟通的行业,这是投入产出比最高的多模态知识化场景之一。
录音从"存了听不了"变成"随时搜得到",核心就三件事:中文场景选Paraformer、长音频做分段处理、保留说话人和时间戳元数据。链路不复杂,但每步都不能省。
第四章 表格与数据知识化:Excel台账报表变成可问答的知识
每家企业都有几十甚至上百份Excel台账------客户跟进表、设备维保记录、项目进度表、销售数据汇总、HR花名册。这些数据躺在共享文件夹里,业务人员想找一条记录要翻好几个表。能不能直接问AI"上个月华东区销售额最高的前5个客户是谁"?
表格数据知识化是多模态知识库中最容易被低估、但也最实用的部分。
4.1 表格为什么难处理
表格看起来结构简单,但对知识库来说处理难度比纯文本高得多。腾讯乐享的实践案例显示,表格是"多模态RAG中最容易被低估的部分"------需要保留字段名、字段值、行列关系、业务上下文四个维度的信息,任何一个维度丢失都会导致后续检索和回答出错。
具体挑战:
• 表头语义理解 :"GMV"是什么?"DAU"对应哪个字段?业务缩写和行业术语需要准确映射
• 多Sheet/跨表关联 :一个查询可能需要关联"客户表"+"订单表"+"回款表"
• 数值精度 :金额、百分比、日期格式的识别和转换不能出错
• 空值和异常值 :台账中经常有空单元格、"N/A"、"待确认"等非标准内容
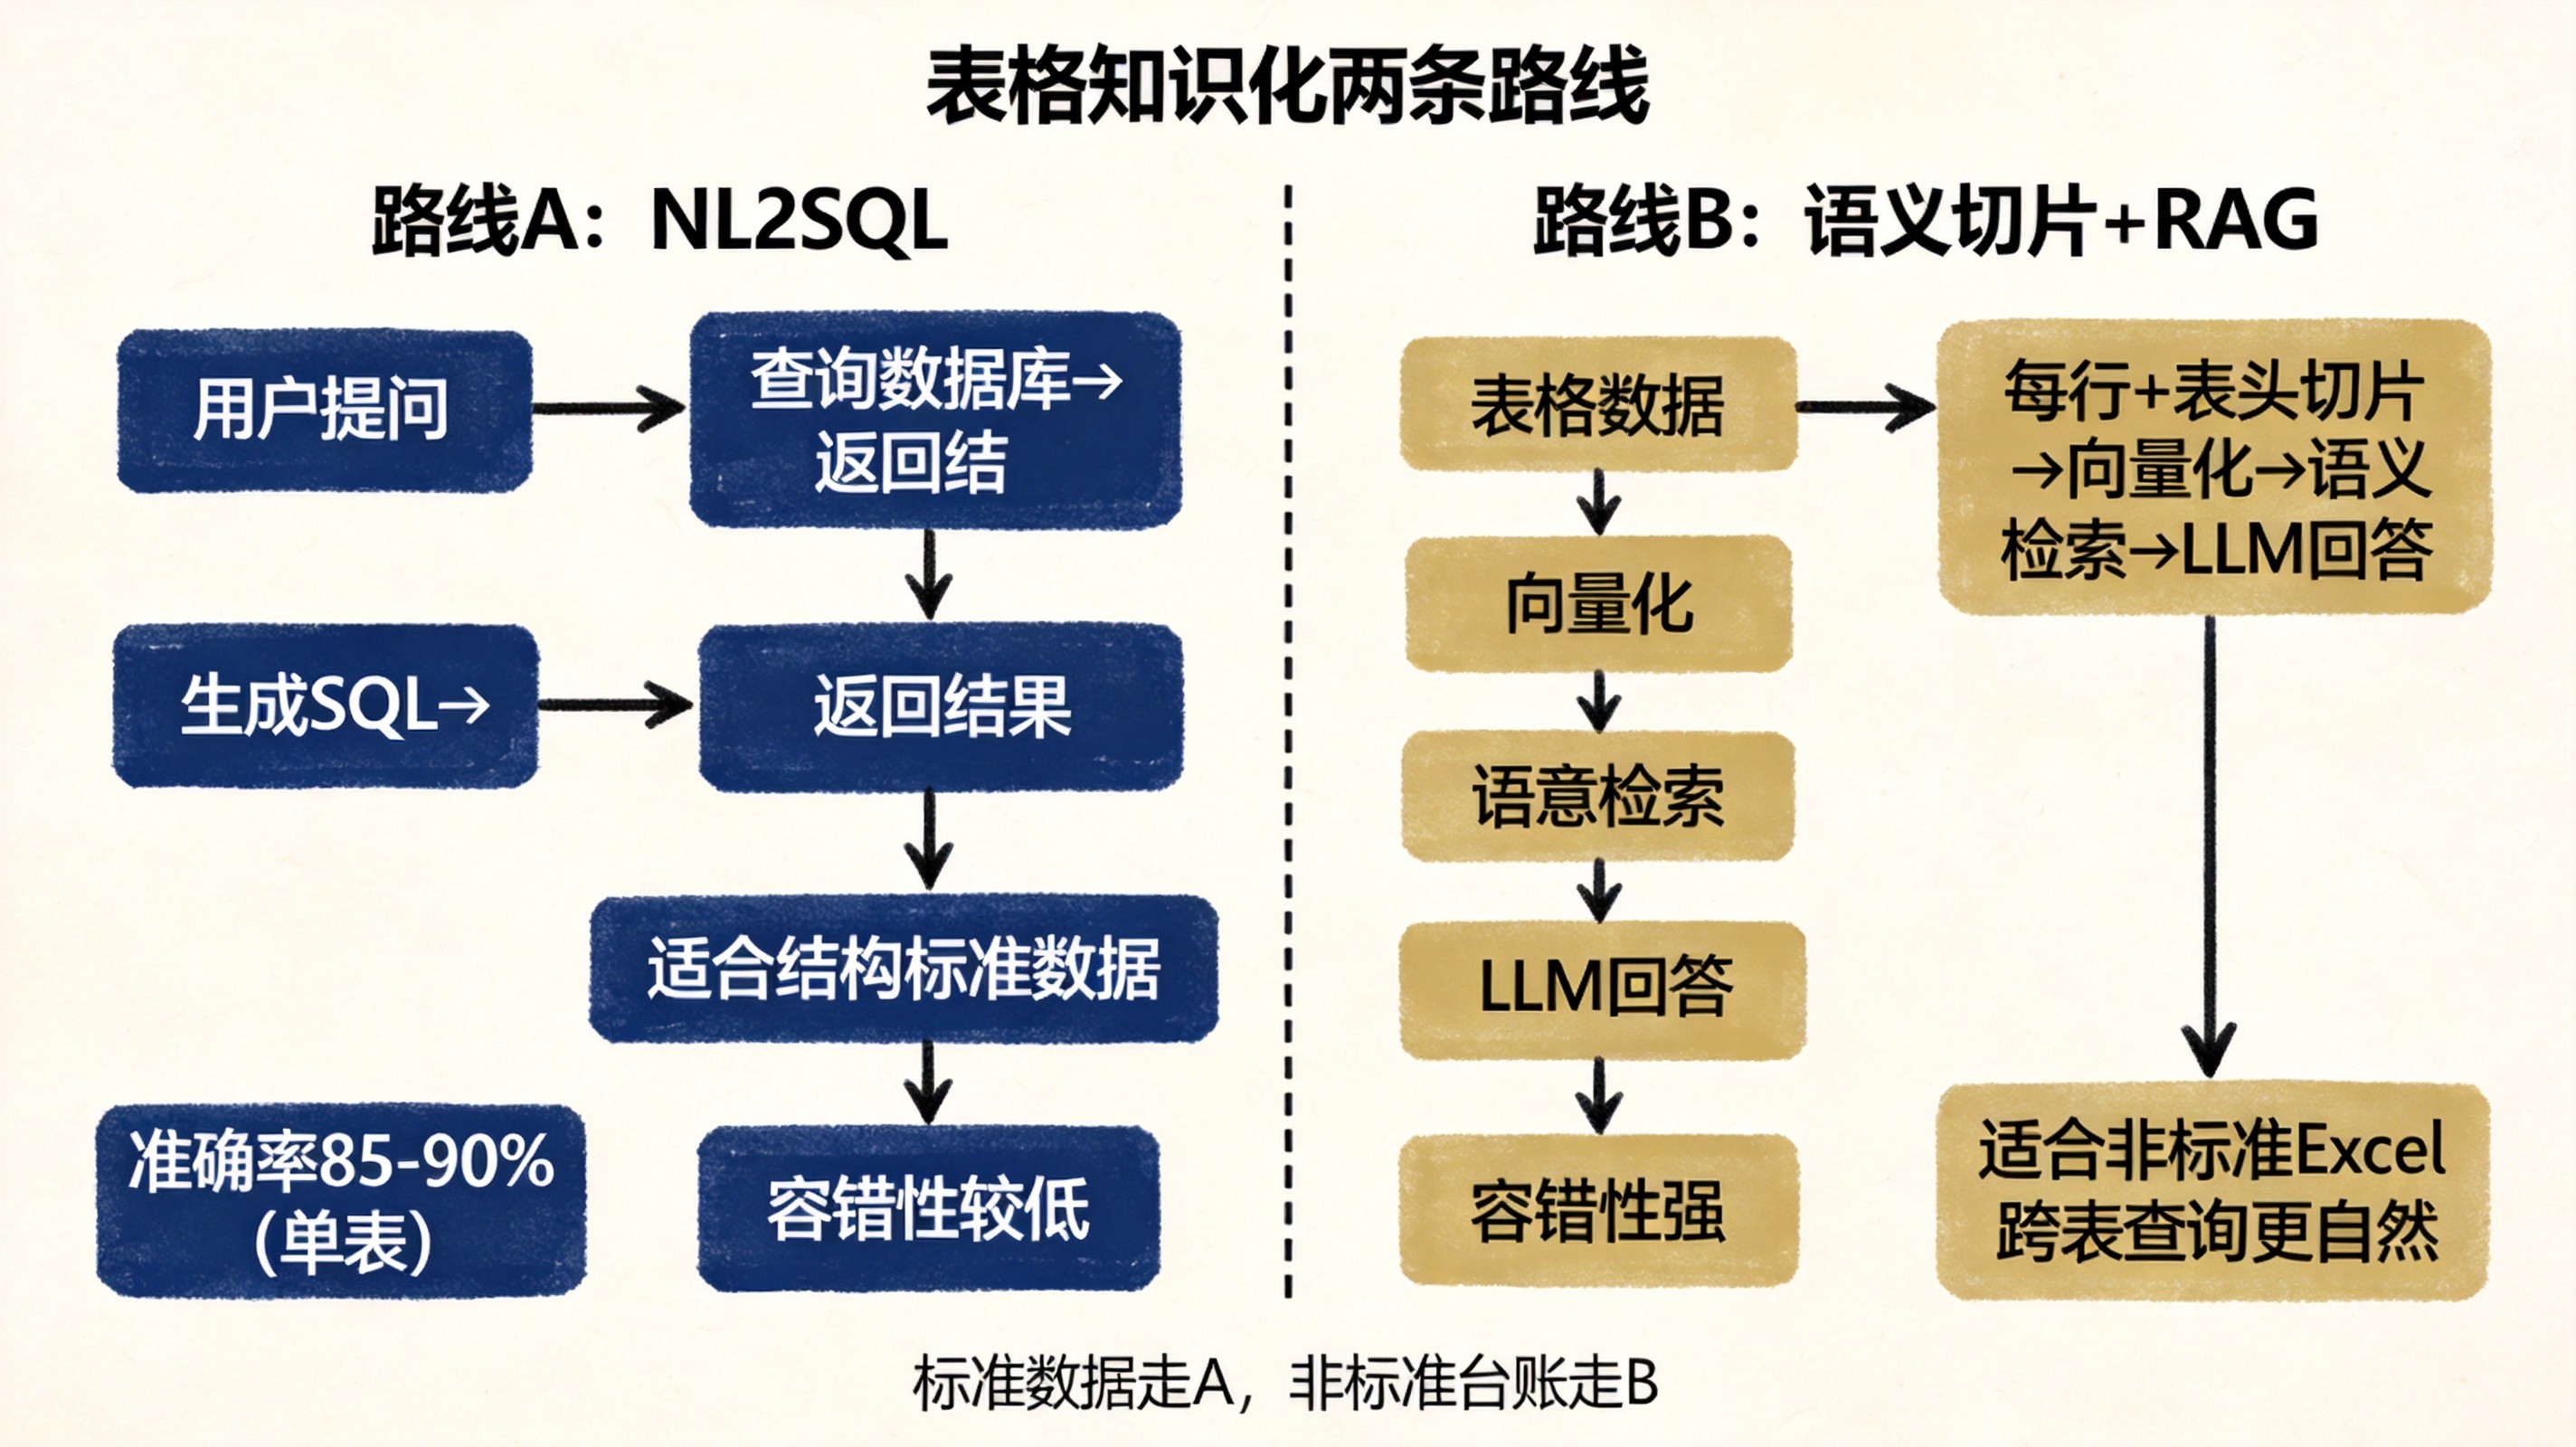
4.2 两条技术路线
|---------------|---------------------------|----------------------------|
| 对比维度 | 路线A:NL2SQL | 路线B:表格语义切片+RAG |
| 核心原理 | 自然语言→生成SQL→查询数据库→返回结果 | 表格数据切片向量化→语义检索→LLM基于检索结果回答 |
| 适合场景 | 结构化程度高、Schema稳定的数据 | 复杂表格、多Sheet、非标准格式 |
| 准确率(单表简单查询) | 85-90% | 80-85% |
| 准确率(多表JOIN查询) | 60-70%(纯NL2SQL) | 75-85% |
| 容错性 | 较低------SQL语法错误则完全失败 | 较高------检索结果不完整也能部分回答 |
| 可解释性 | 可追溯(SQL可见) | 可追溯(检索到的原文可见) |
| 部署复杂度 | 较高(需Schema映射、SQL校验) | 中等(需合理切片策略) |
| 典型案例 | 帆软FineBI Next、极昆仑iInsight | 53AI Brain语义检索+LLM问答 |
路线A详解:NL2SQL。 用户问"上月华东区销售额前5的客户",系统生成SQL查询执行后返回结果。学术基准上表现不错------Spider 1.0上o1模型达91.2%。但学术基准和企业真实场景之间有一条巨大的鸿沟。帆软FineBI Next给出的坦诚数据:纯NL2SQL在企业真实场景下准确率仅60%-70%。行业共识已经形成------在LLM和数据库之间需要加一个"约束层"。
路线B详解:表格语义切片+RAG。 把表格的每一行数据连同表头信息一起切片向量化。比如一行数据"张三 | 华东区 | 2026年8月 | 158万"会被切片为"客户张三,华东区,2026年8月,销售额158万元",向量化后存入知识库。用户提问时通过语义检索找到最相关的几行数据,再由LLM基于检索结果组织回答。
这条路线的优势在于容错性强------即使检索结果不完整,LLM也能基于已有信息给出部分答案,而NL2SQL一旦SQL生成错误就直接返回错误结果。53AI在制造业客户项目中大量使用路线B,尤其是设备维保台账、项目进度表这类结构不完全标准的表格数据。
4.3 核心挑战与解法
挑战一:表头语义理解。 业务缩写是最常见的问题。"GMV"="成交总额","DAU"="日活用户数","MRR"="月经常性收入"------这些映射关系需要在数据导入时建立好。解法:在表格导入时建立字段名-业务含义的映射表,作为Schema元数据存入知识库。
挑战二:多Sheet/跨表关联。 用户的查询可能需要关联多个Sheet甚至多个Excel文件。路线B天然支持这种场景------不同Sheet的数据切片后都在同一个向量空间里,语义检索可以跨Sheet找到相关信息。路线A则需要显式定义表间关联关系。
挑战三:数值精度。 金额单位(元/万元/亿元)、日期格式(2026-08-01/2026年8月/202608)、百分比(15%/0.15)需要统一。解法:数据导入时做标准化清洗,统一数值格式。
挑战四:权限管控。 不同角色只能查询授权范围的数据------普通员工不能查全公司薪资表,区域经理只能查本区域数据。解法:在检索层做权限过滤,根据用户角色限制可检索的数据范围。
4.4 落地案例
案例 一 :某制造企业设备维保台账。 5000+条Excel维保记录导入知识库后,业务人员用自然语言查询"XX设备上次维保时间""哪些设备下个月到期保养""今年维保费用最高的前10台设备"。原来需要打开Excel手动筛选、排序的工作,现在一句话搞定。
案例 二 :某咨询公司项目工时表。 200+个项目的工时、人员、客户数据知识化后,AI自动统计和对比分析------"张三上个月在哪些项目上投入了最多工时""A客户的总投入工时和B客户差多少"。
53AI Brain支持Excel/CSV等结构化数据的直接导入,通过文档解析引擎自动识别表头和数据类型,结合知识库的语义检索能力,让业务人员可以直接用自然语言查询表格数据。对于结构不完全标准、字段命名不规范的表格,53AI在项目中会先做一轮Schema梳理和字段映射,确保数据知识化后的查询准确率。
选哪条路线取决于数据状态。结构标准、Schema稳定的走NL2SQL,查询精准且可追溯;企业里大量存在的非标准Excel台账走语义切片+RAG更稳------容错性强,部署灵活,跨表查询也更自然。
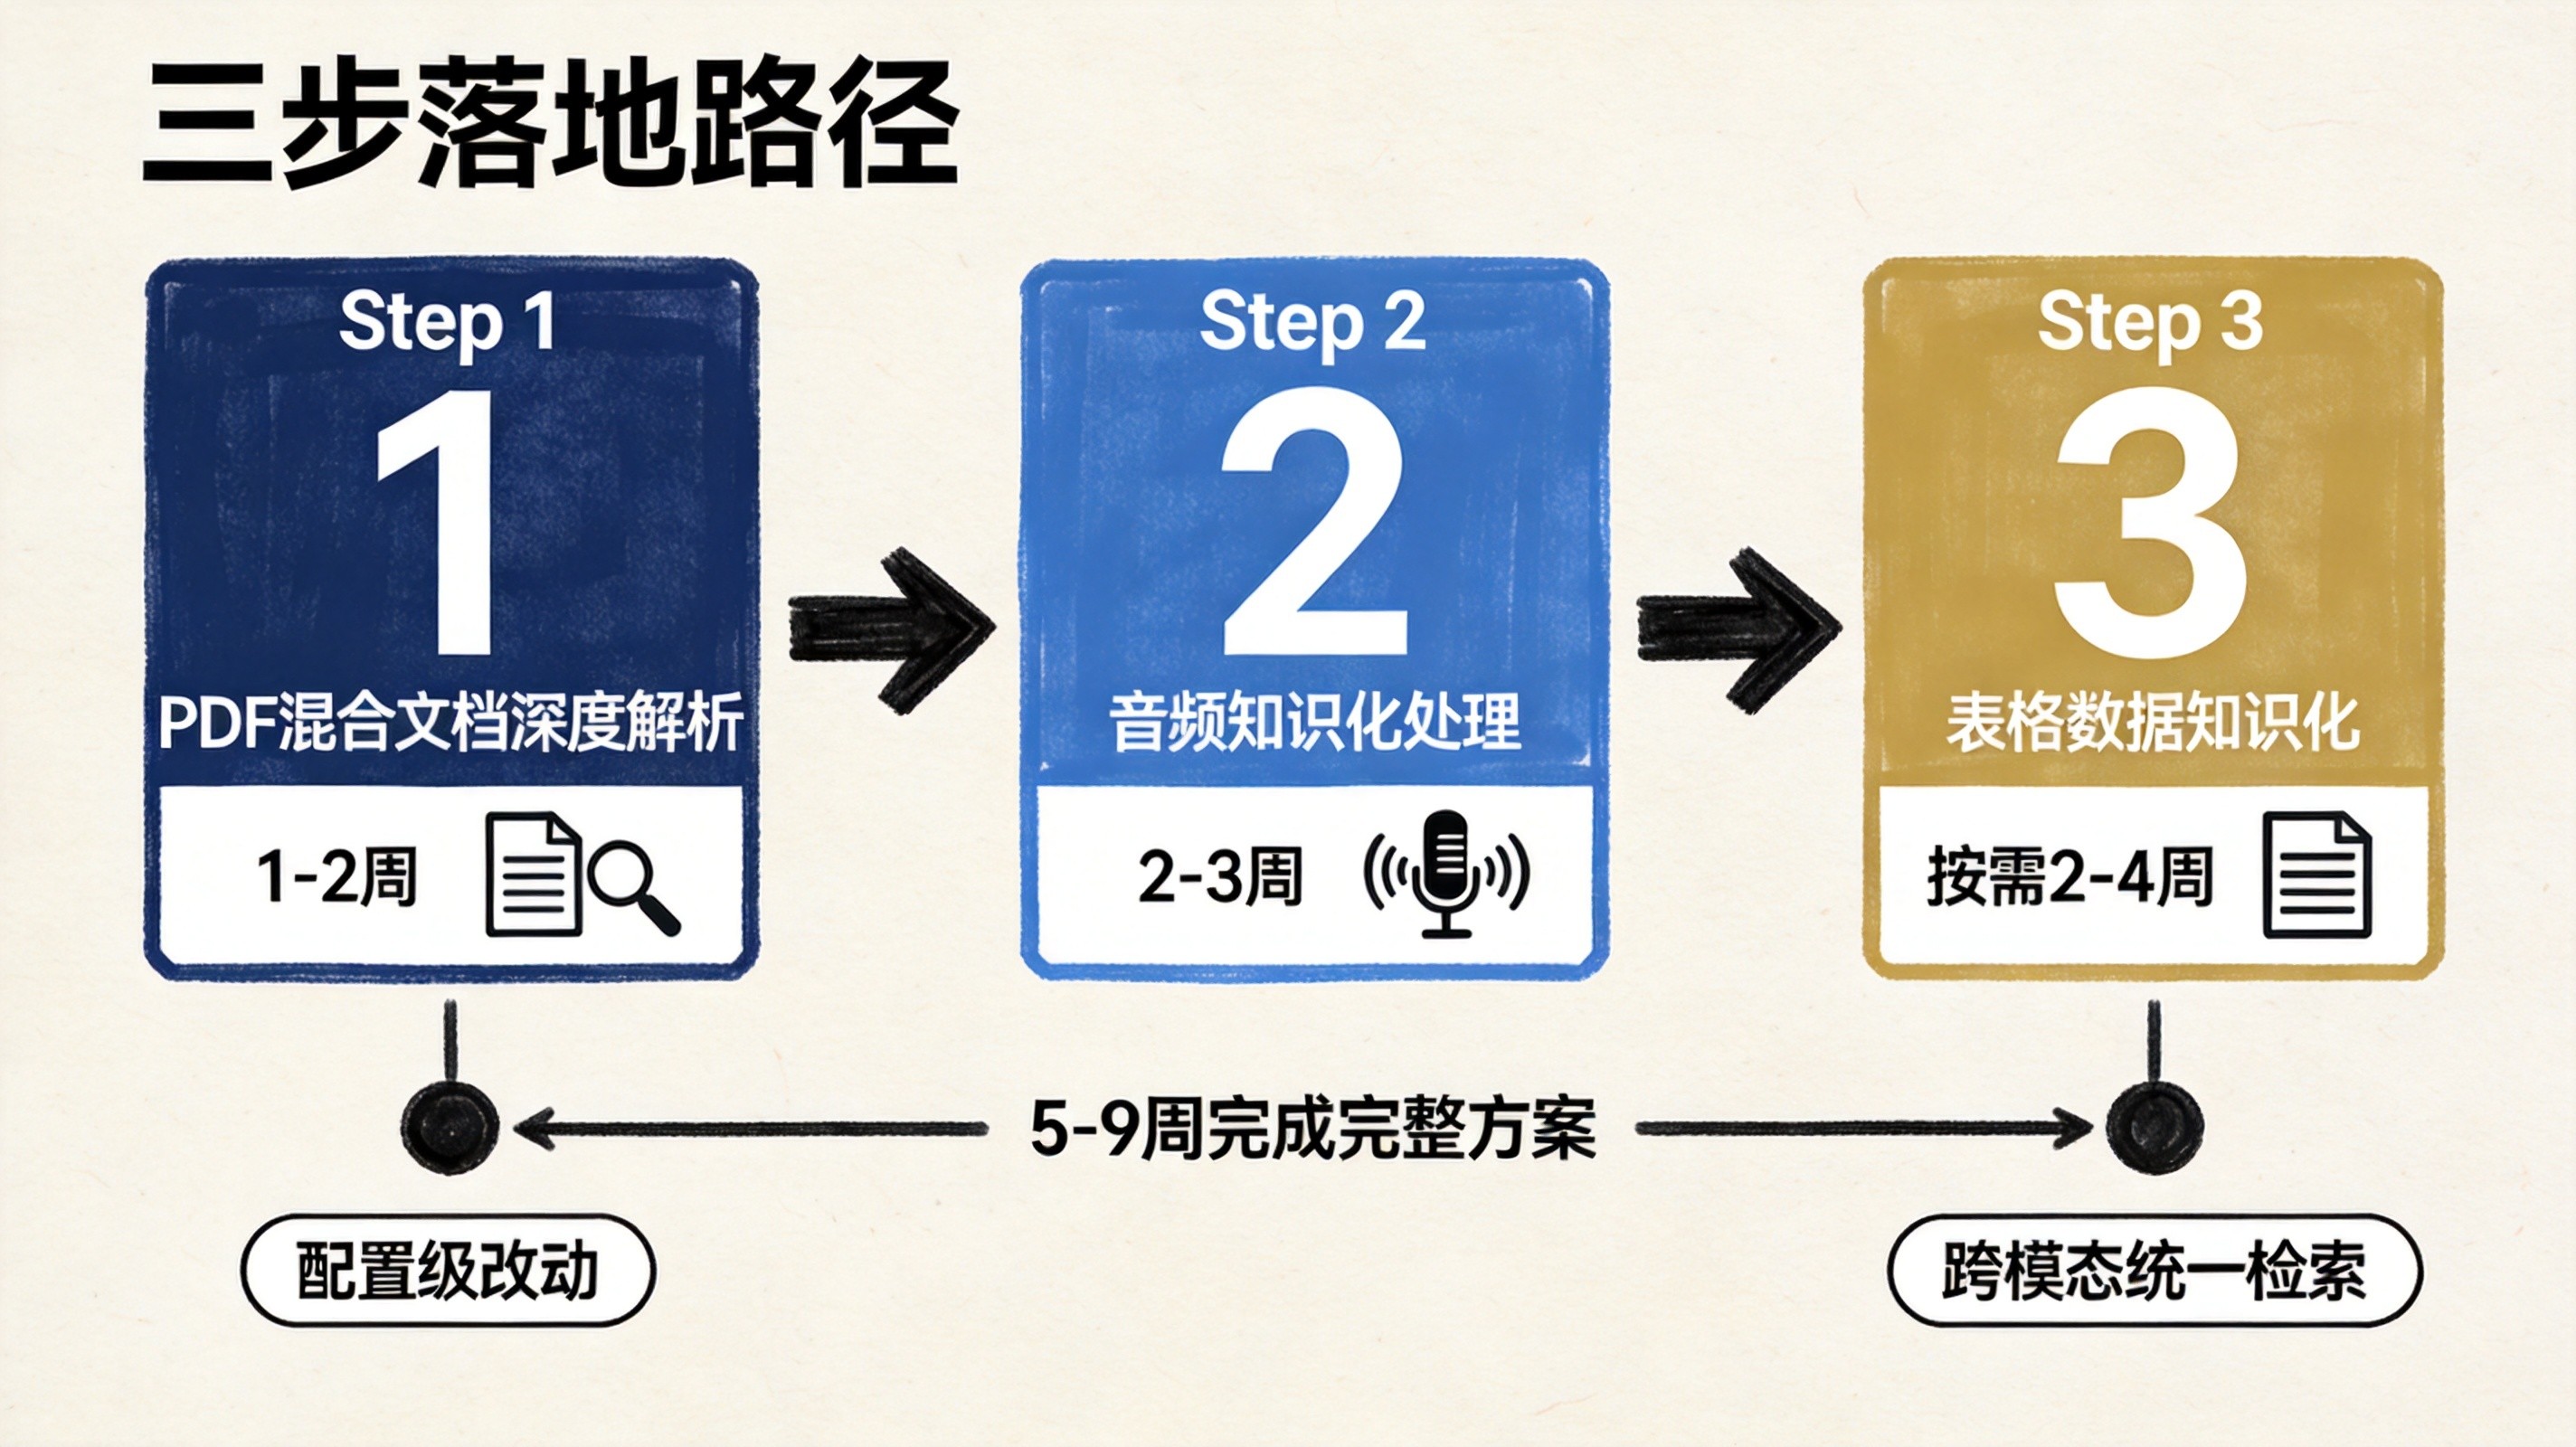
第五章 落地路径:从0到1构建多模态知识库
知道了PDF、音频、表格分别怎么处理,下一个问题是:先做哪个?全上还是分步?需要多少投入?
Gartner 2026年的数据显示,85%的组织计划增加AI支出,但仅22%成功扩展到多个业务单元。原因很多,但有一个很实际的因素------想一步到位做完整方案,结果哪个都没做好。
5.1 三步走路径
第一步(1-2周):先做PDF混合文档的深度解析。
这是企业存量最大的非文本知识。绝大多数企业的技术文档、操作手册、检测报告都是PDF格式,升级文档解析引擎就能释放大量此前不可检索的知识。成本最低、见效最快------本质上是把现有的文档解析从"传统OCR"升级为"多模态文档解析引擎",配置级改动,不需要重建整个系统。
→ 第4篇《语料质量管控》中的清洗流水线6个环节同样适用于多模态数据的预处理
第二步(2-3周):加入音频处理。
ASR转写边际成本很低,会议/访谈场景见效快。咨询公司、服务机构每周产生大量录音,知识化后ROI很明显。音频预处理+ASR转写+说话人分离+语义切片,整套流程2-3周可以跑通。
第三步(按需):接入表格/数据。
Excel台账报表知识化。复杂度取决于数据的结构化程度------标准格式导入很快,非标准格式需要先做Schema梳理和数据清洗。建议优先处理查询频次最高的台账(销售数据、设备维保记录等),不要试图一次把所有Excel都灌进去。
|-------------|--------|--------------------|-----------------|-------------|--------------|
| 阶段 | 周期 | 核心投入 | 核心能力 | 预期效果 | 适用企业规模 |
| 第一步:PDF深度解析 | 1-2周 | 文档解析引擎升级(配置级) | 图文混排PDF结构化提取 | 释放30%沉睡知识 | 所有规模 |
| 第二步:音频处理 | 2-3周 | ASR服务接入+转写配置 | 录音转写+说话人分离+语义检索 | 录音内容可搜索、可引用 | 有定期会议/访谈的企业 |
| 第三步:表格数据知识化 | 2-4周 | Schema梳理+数据导入+权限配置 | 自然语言查询表格数据 | 业务数据直接问答 | 台账报表>20份的企业 |
| 完整方案 | 5-9周 | 三阶段叠加 | 三种模态协同检索 | 跨模态统一问答 | 中大型企业 |
53AI在160+客户项目中总结的经验是:不要试图一步到位。先从PDF深度解析开始(投入最小、覆盖面最广),验证效果后再加音频和表格。渐进式接入的好处是每一步都能看到明确的ROI,也容易获得管理层的持续投入支持。
5.2 跨模态协同的真正价值
三步做完之后,最强大的能力是跨模态协同检索。一个查询同时检索文档中的文字、图表描述、音频转写内容和表格数据。
举个例子。用户问"XX客户上个月的项目进展怎么样",多模态知识库可以同时返回:
• 从项目周报PDF中提取的文字进展和甘特图描述
• 从项目例会录音转写中提取的讨论要点
• 从项目进度Excel中提取的里程碑完成情况
这种跨模态联动是纯文本知识库做不到的,也是多模态知识库最大的价值所在。
5.3 常见误区
误区一:PDF里的文字提取出来就够了。
不够。图表、流程图、截图里的信息才是关键------设备说明书里的技术参数表、操作流程图、产品实拍照片,传统OCR全部丢失。53AI在某制造业客户项目中发现,设备说明书中约40%的有价值信息在表格和流程图中,而不是纯文字段落里。
误区二:多模态知识库=很贵很复杂。
不是。渐进式接入的话,第一步只是升级文档解析引擎------配置级改动,几乎没有额外硬件成本。53AI Brain的文档清洗流水线在现有架构上支持TextIn和MinerU两种解析引擎的切换,企业可以根据实际需要逐步扩展多模态处理能力,不需要重建系统。
误区三:Excel数据用BI工具就够了,不需要进知识库。
BI只能做预定义的图表分析和固定报表。知识库能做的是自然语言问答+跨数据源关联+与文档/音频知识联动。比如用户问"XX客户的项目进展有什么问题",BI只能展示预设的仪表盘数据,知识库可以同时从项目进度表、会议纪要、周报PDF中提取相关信息给出综合回答。
→ 第6篇《知识库更新机制设计》中的版本管理策略同样适用于多模态知识------台账数据更新了、新录音入库了、PDF文档改版了,都需要有对应的更新机制
路径很明确:先PDF(1-2周),再音频(2-3周),最后表格数据(按需)。每一步都有明确ROI,不要试图一步到位。
FAQ
Q1:PDF里的图表和流程图,知识库根本识别不了怎么办?
需要多模态文档解析引擎,而不是传统OCR。传统OCR只提取文字,图表信息直接丢失。多模态文档解析引擎(如53AI Brain、TextIn、MinerU)对PDF做版面分析后分区域处理------文字OCR提取、表格结构化解析、图表用多模态模型生成语义描述、公式做LaTeX识别------最后统一重组为Markdown入库。实测复杂版面识别率从不到60%提升到90%以上。关键是在解析阶段就做好版面关系记录,否则图表标题和内容分离、跨页表格断裂这些问题会直接影响检索效果。
Q2:会议录音怎么导入知识库让AI能搜索和总结?
四步走:音频预处理(降噪、格式标准化)→ASR转写生成带时间戳文本→说话人分离识别"谁在什么时间说了什么"→语义切片入库。中文场景推荐Paraformer-large,标准普通话字错率2-3%,带口音控制在5-6%以内。长音频按5-10分钟分段处理,用VAD在静音处切分。入库后支持按发言人、议题、时间段检索。53AI Brain支持音频上传与智能语音转写,处理流程可在平台内完成。
Q3:Excel表格数据怎么接入AI知识库做自然语言问答?
两条路线。路线A是NL2SQL:自然语言→SQL→执行返回结果,适合结构标准的数据,单表准确率85-90%,多表JOIN降到60-70%。路线B是表格语义切片+RAG:每行数据连同表头切片向量化,语义检索后LLM回答,适合非标准Excel台账,容错性更强。关键是先做好Schema识别(字段名-业务含义映射)和数据清洗。53AI Brain支持Excel/CSV结构化数据导入,自动识别表头和数据类型,结合语义检索实现自然语言查询。
Q4:多模态知识库和普通文本知识库有什么本质区别?
普通知识库只能搜文字,多模态知识库能理解图表、听懂音频、查询表格数据,还能跨模态检索。举个例子------用户问"XX设备上次维保是什么时候",纯文本知识库搜不到(维保记录在Excel里),多模态知识库能从Excel台账中直接返回结果。问"上次客户访谈提到了哪些核心诉求",纯文本知识库搜不到(内容在录音里),多模态知识库从音频转写内容中检索返回。本质区别不在于"能存更多格式",而在于"不同模态的内容都能被语义理解和跨模态检索"。
Q5:搭建多模态知识库大概需要多少投入?
最小可行方案:先升级文档解析引擎处理PDF(1-2周,配置级改动,几乎零硬件成本),再加入音频转写(2-3周,ASR按调用量计费)。两步加起来3-5周,覆盖最常见的两种非文本知识场景。完整方案加上表格数据知识化(2-4周),总计5-9周。建议渐进式接入,先验证效果再扩展。53AI在160+项目中的经验是,第一步投入产出比最高,大多数企业PDF深度解析上线后会主动推进后续阶段。
Q6:制造企业的设备说明书里有大量图文混排,怎么处理?
这是PDF混合文档知识化的典型场景。关键是版面分析------把一页中的文字段落、参数表格、产品截图、流程图分别识别,用不同方式处理:文字OCR提取,表格结构化解析保留行列关系,流程图和截图用多模态模型生成语义描述。处理完按原始版面关系重组为Markdown入库。注意三个坑:图表标题和内容不能分开切片、跨页表格需合并、流程图步骤说明要和图中的框对应。53AI在某晶圆代工龙头的项目中处理过类似场景,表格、流程图、图表、SmartArt都做了分别处理并保留来源追溯。
Q7:不同模态的知识(文档/音频/表格)怎么统一管理?
核心是统一向量化。不同模态经过各自解析链路后,都转化为向量存储在同一个向量空间:PDF经版面分析+分区处理后重组为文本向量化入库;音频经ASR转写后文本入库;表格数据切片后向量化入库。三者在同一向量空间里,支持跨模态检索------一个问题同时从文档、录音和数据表中检索信息。另一个关键是元数据标准化------每份知识标注来源文档、模态类型、创建时间、所属部门,方便权限过滤和时效性筛选。
Q8:PDF文档解析用传统OCR和用多模态文档解析引擎有什么区别?
区别很大。传统OCR只提取文字------表格结构打散变纯文本,流程图和截图直接丢弃或输出乱码,公式全部变不可读字符。多模态文档解析引擎做"版面分析+分区域处理"------先识别页面中哪些区域是文字、表格、图片、公式,然后分别用最合适的方式处理。实测对比:传统OCR对复杂版面PDF识别率不到60%,多模态引擎可以到90%以上。成本上多模态解析单页约0.05-0.2元,贵几倍,但保留的信息量是传统OCR的3-5倍,性价比反而更高。
结语
企业知识的真正大头,不在Word文档里,在那些"看得见但用不了"的PDF图表中、在Excel台账里、在会议录音中。
多模态知识库要做的,就是把这些沉睡的知识唤醒------让图文混排的文档"看得懂",让会议录音"听得见",让Excel台账"问得到"。
三步走路径已经很清晰了:先升级文档解析引擎处理PDF(1-2周),再加入音频转写(2-3周),最后按需接入表格数据(2-4周)。不需要一步到位,每一步都有明确ROI。
ISC团标已经给出了能力要求,行业数据已经证明了可行性,53AI在160+项目中验证了落地路径。剩下的问题只有一个:你打算什么时候开始?