一.开发环境的准备
我们要使用conda来作为我们的开发环境也就是做一个隔离然后直接命名为RAG
conda create -n RAG python=3.12
conda activate RAG
变成这样就代表环境隔离成功了 这样我们可以在这里面使用llama-index了,后续我们要学习langchain就可以继续学习了,就是为了做一个环境隔离可以使用不同的框架
二.LlamaIndex的介绍:
官⽅⽹址: https://docs.llamaindex.org.cn/en/stable/
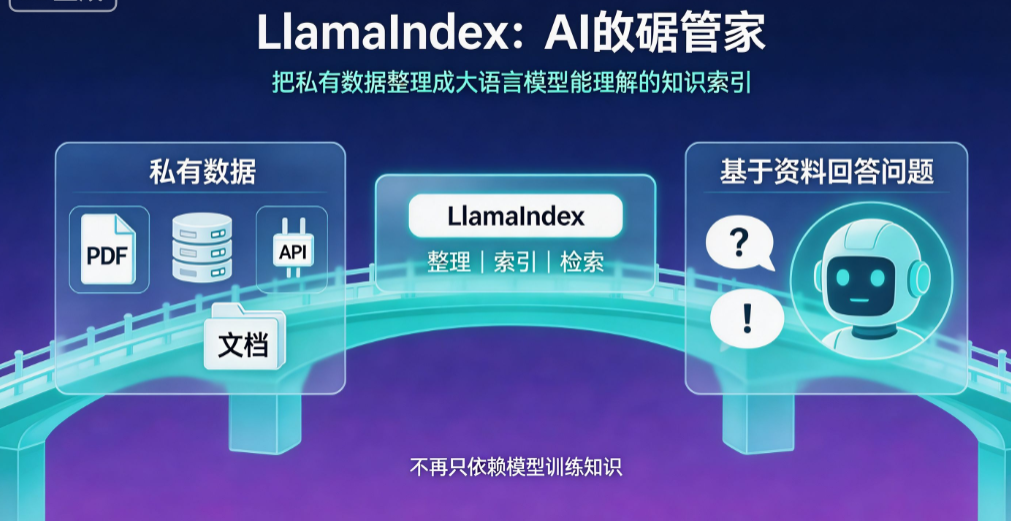
LlamaIndex是⼀个专⻔为你的私有数据与⼤语⾔模型(LLM)搭建桥梁的开源框架。它就像⼀个
"AI的数据管家" 。它能帮你把散落在各种⽂件(如PDF、数据库、API)⾥的私⼈数据,整理、索引成
LLM能懂的语⾔,然后让模型基于这些信息回答你的问题,⽽不是只依靠它⾃⼰训练时的知识
LlamaIndex 的安装:
# 安装 LlamaIndex
pip install llama-index -i https://mirrors.aliyun.com/pypi/simple/
# 查看 LlamaIndex 版本
pip show llama-index
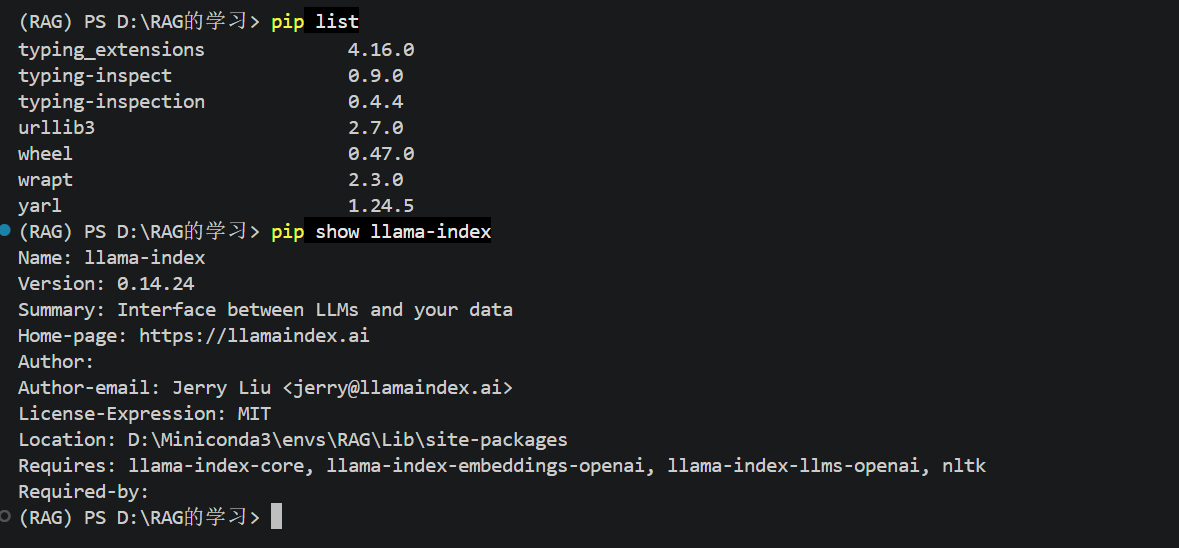
这样也就代表安装完毕了
| 框架 | 核心擅长 | 重心 |
|---|---|---|
| LlamaIndex | 数据全链路:加载、解析、分块、索引、精准检索 | RAG、知识库、文档问答、混合检索优化 |
| LangChain | 流程编排:Chain、Agent 多步骤逻辑、工具调用、复杂工作流 | 智能体、多工具串联、复杂任务调度 |
两者可以互相嵌套混⽤:⽤ LlamaIndex 做数据检索底座,LangChain 编排上层业务逻辑。
三.知识库的构建:
3.1 数据加载:
3.1.1 数据解析:
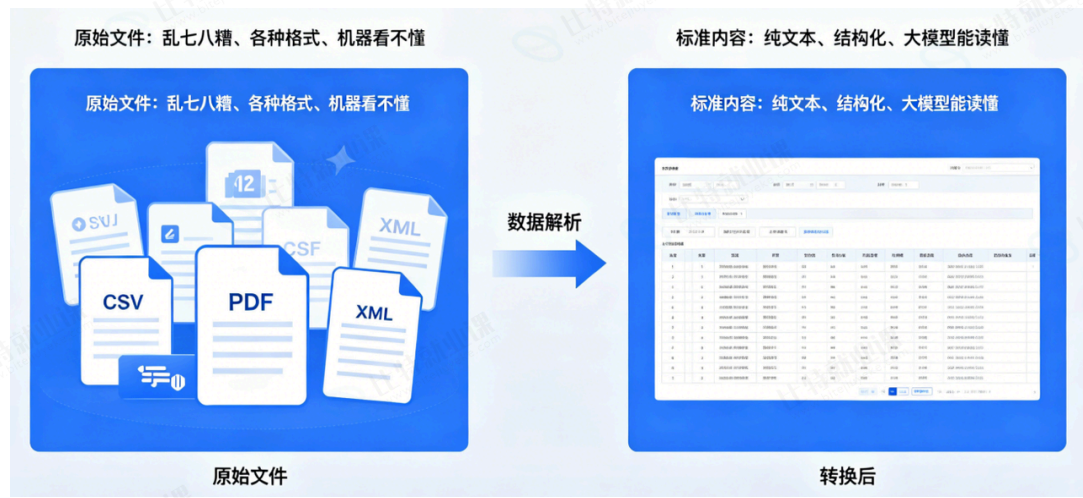
数据解析就是把「乱七⼋糟、各种格式、机器看不懂」的原始⽂件,转换成「纯⽂本、结构化、
⼤模型能读懂」的标准内容。
这里我们通过写代码的方式来进行数据解析,解析的数据是提前准备好的数据
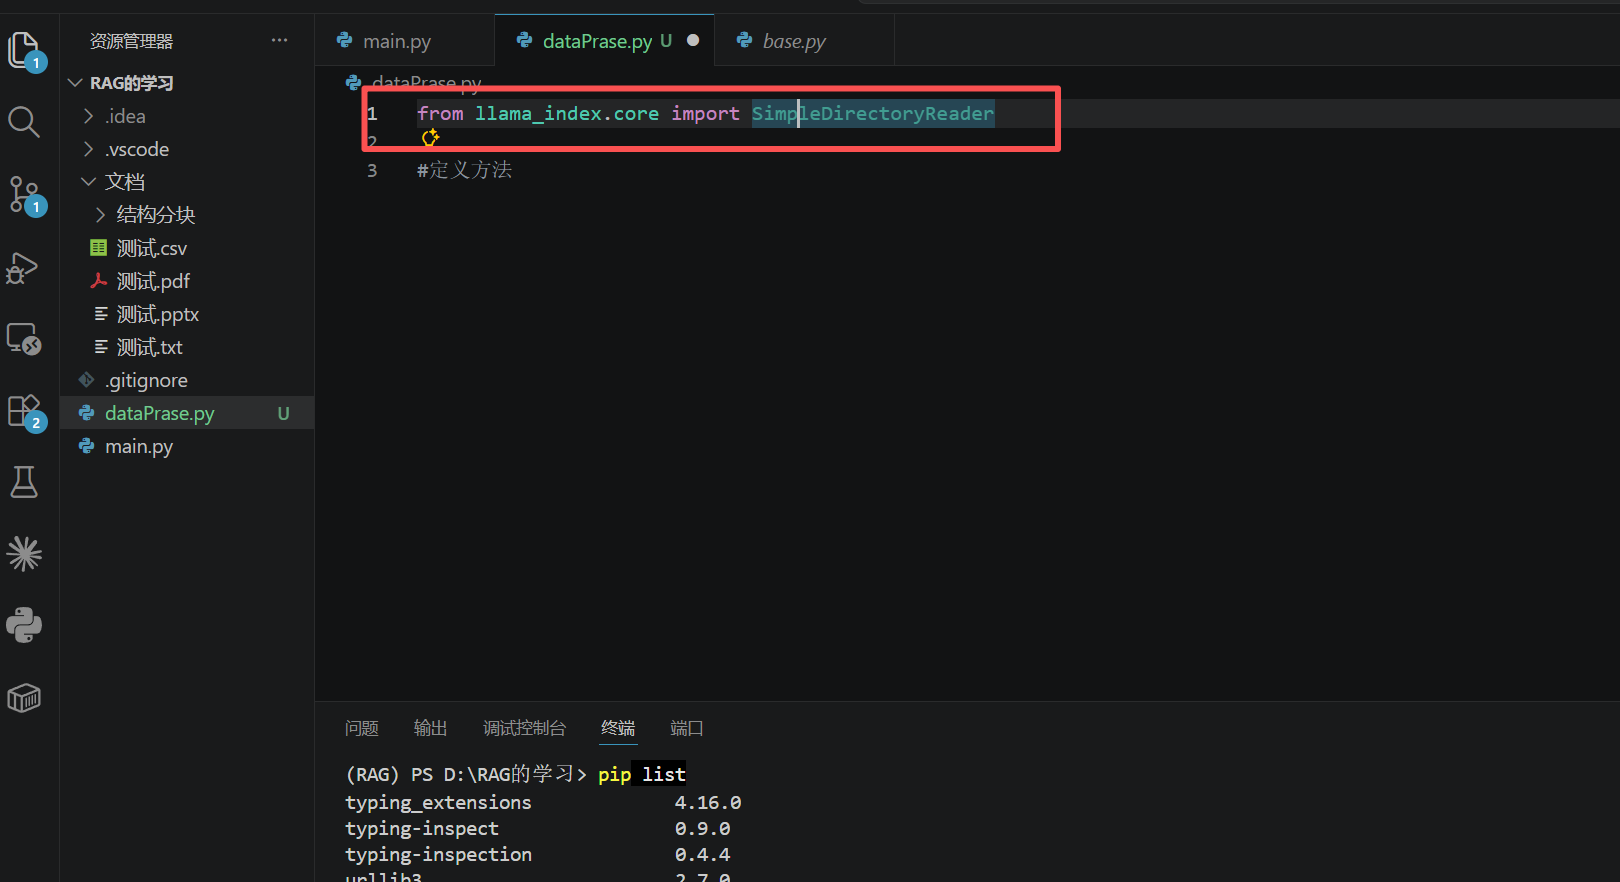
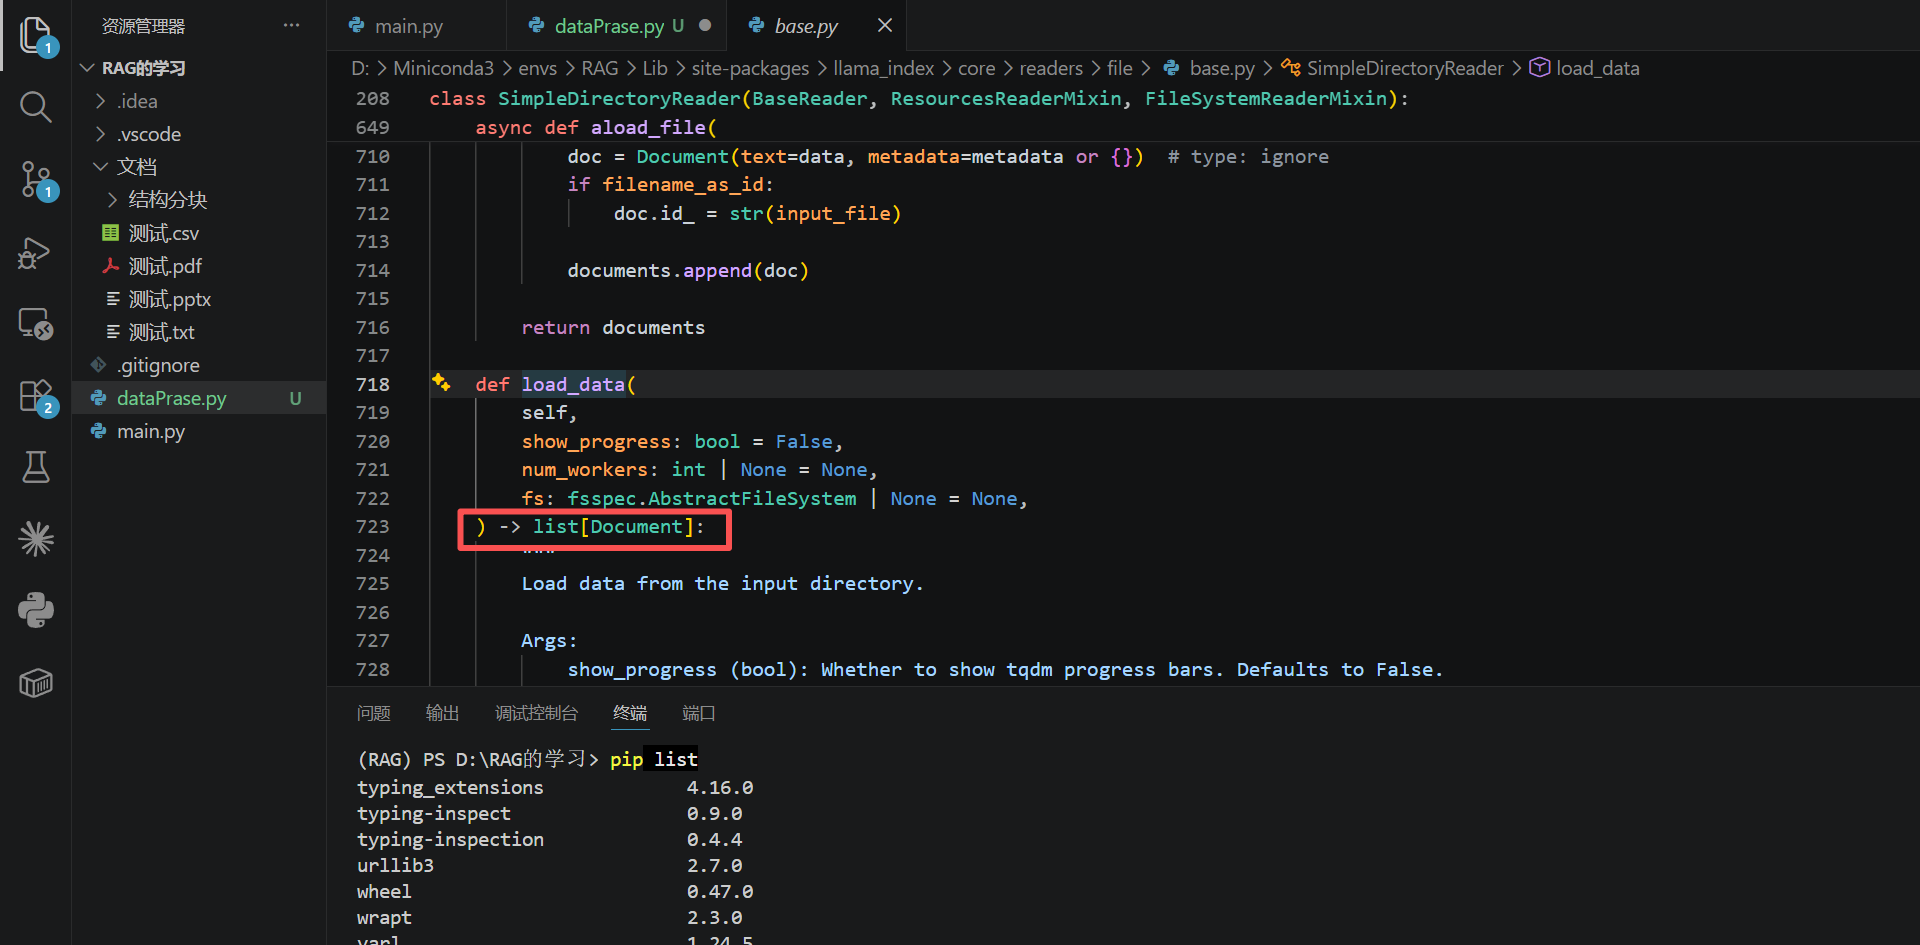
我们首先要导入这个库 用来解析数据
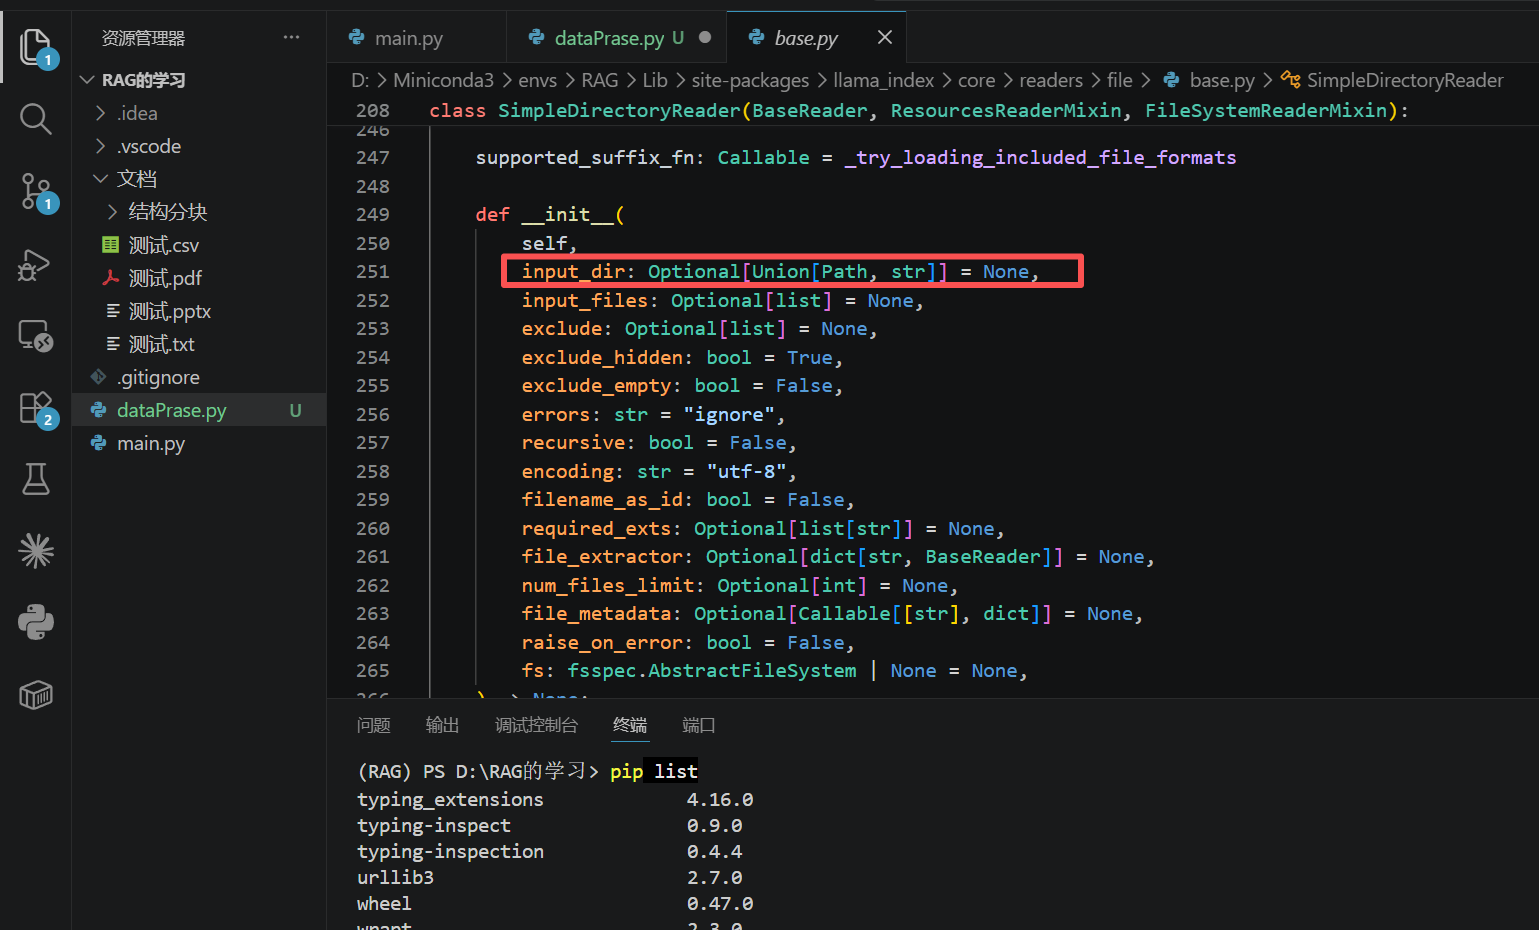
这个库里面我们比较关心的就是input_dir这个参数 因为我们后面要传递这个参数就是代表传递哪
个文件他就解析哪一个文件
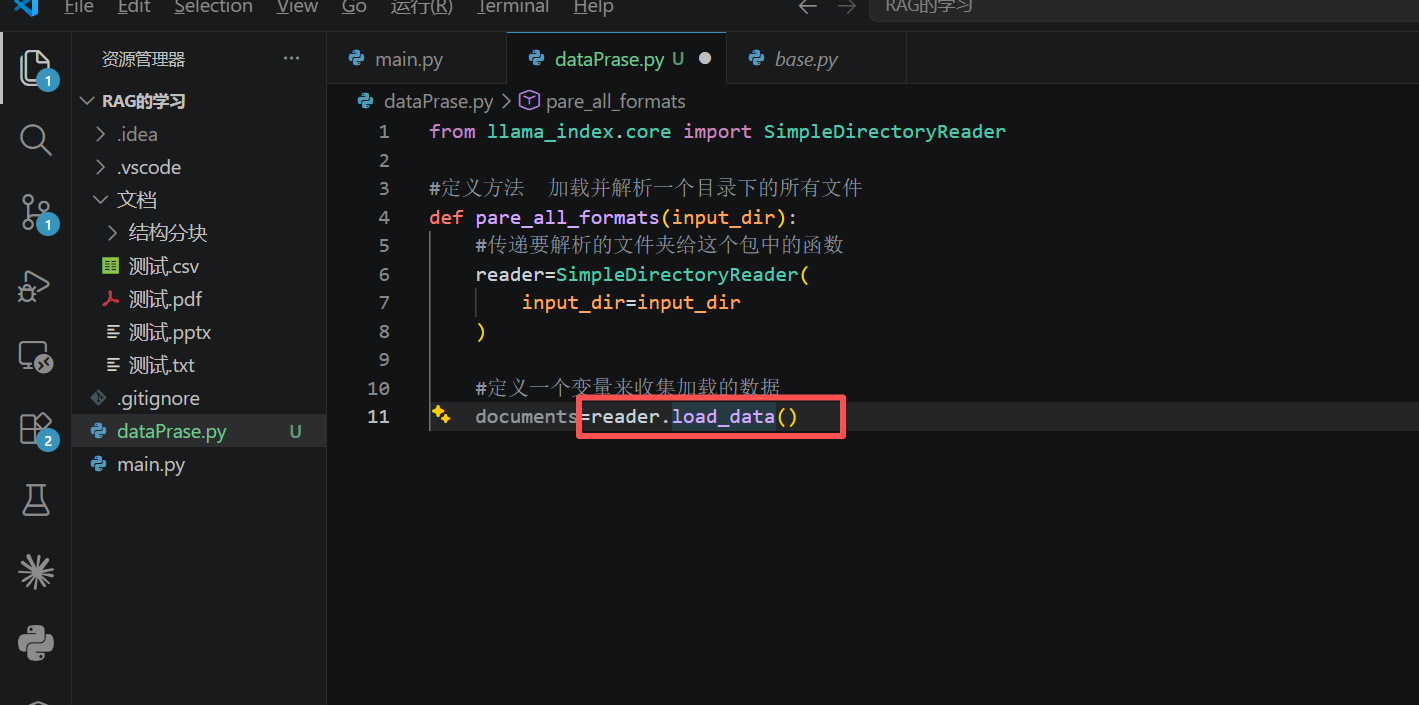
调用的方法这里其实返回的是一个数字或者叫列表
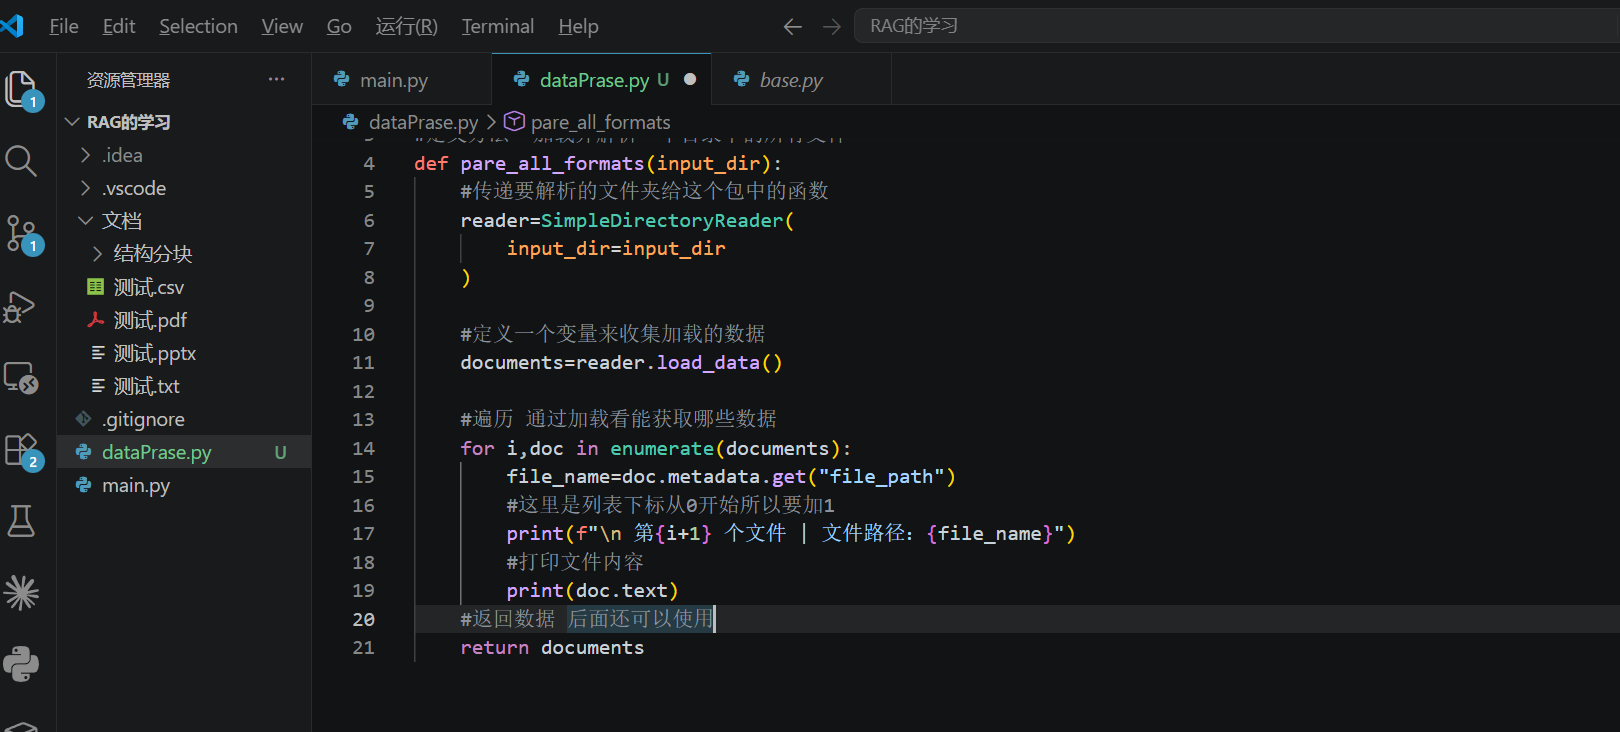
for i,doc in enumerate(documents):enumerate()会同时拿到索引 i 和 列表里面的元素 doc
i:当前文档在列表中的序号,从 0 开始(第 1 个文件 i=0,第 2 个 i=1)doc:文档对象,里面包含两个核心东西doc.metadata:文件元数据(文件路径、文件名等信息)doc.text:读取出来的文件文本内容
file_name=doc.metadata.get("file_path")从文档的元数据里取出file_path,也就是这个文件在电脑上的完整路径。.get()写法更安全,如果找不到file_path这个字段不会直接报错。print(f"\n 第{i+1} 个文件 | 文件路径: {file_name}")
- 因为
i从 0 开始,所以i+1,输出给人看的时候从第 1 个开始计数,更符合人的阅读习惯。 \n是换行,方便控制台打印的时候每个文件之间空一行,区分开。
print(doc.text)打印当前这个文件读取出来的文本内容。
整体作用
遍历读取到的所有文件,逐个打印:文件编号、文件路径、文件里面的文字 ,用来测试验证SimpleDirectoryReader有没有成功把文件夹里 pdf/txt/csv/pptx 都读出来。
假设 documents 列表里面有 3 个文件:
- i=0,doc = 测试.pdf → 打印:
第1个文件 | 文件路径: xxx/测试.pdf,然后打印 pdf 里文字 - i=1,doc = 测试.txt → 打印:
第2个文件 | 文件路径: xxx/测试.txt,打印 txt 内容 - i=2,doc = 测试.csv →打印:
第3个文件 | 文件路径: xxx/测试.csv,打印 csv 文本
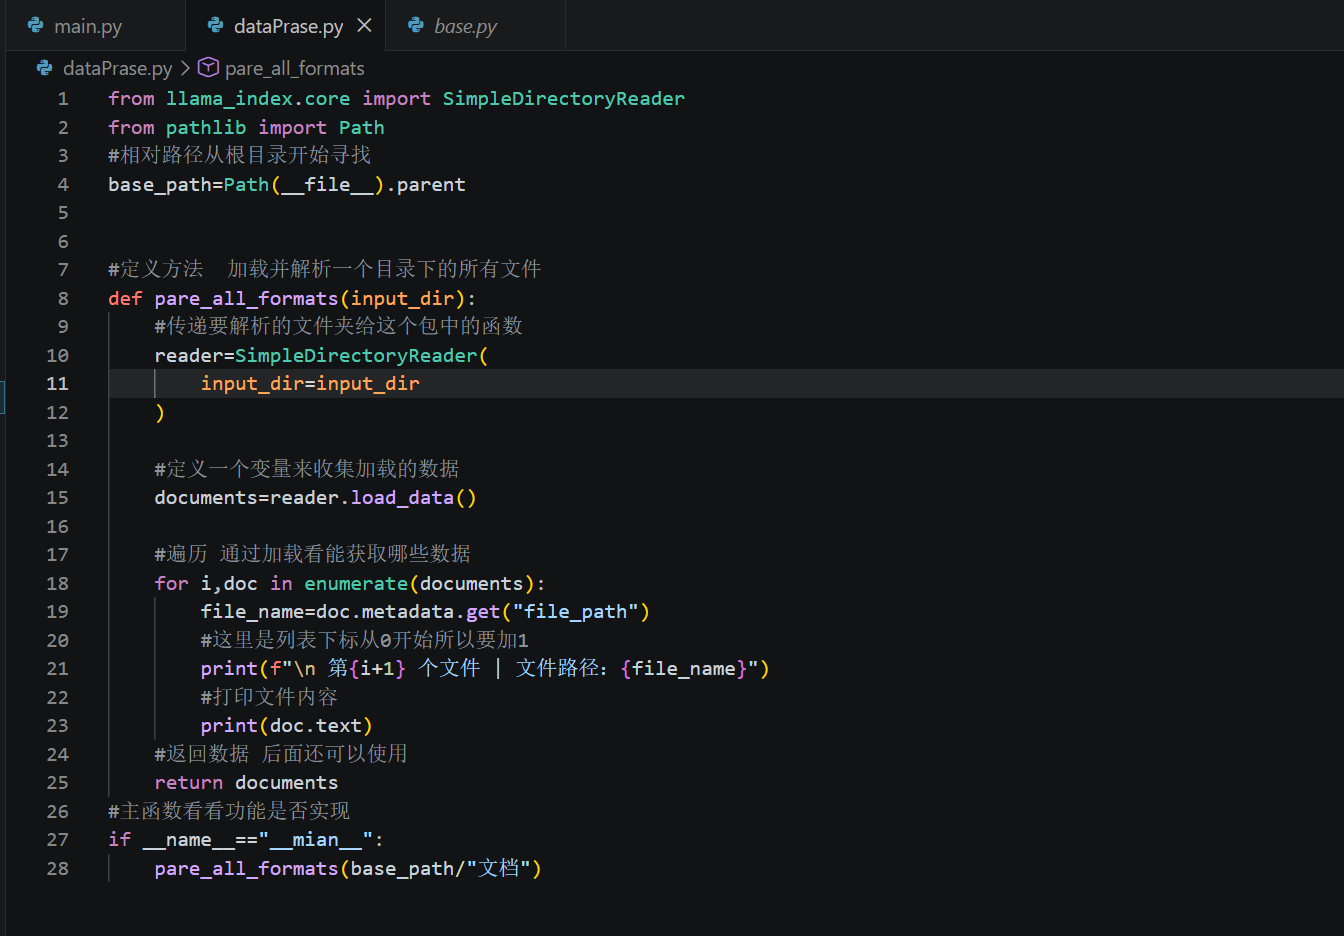
这就是我们整个解析数据的代码
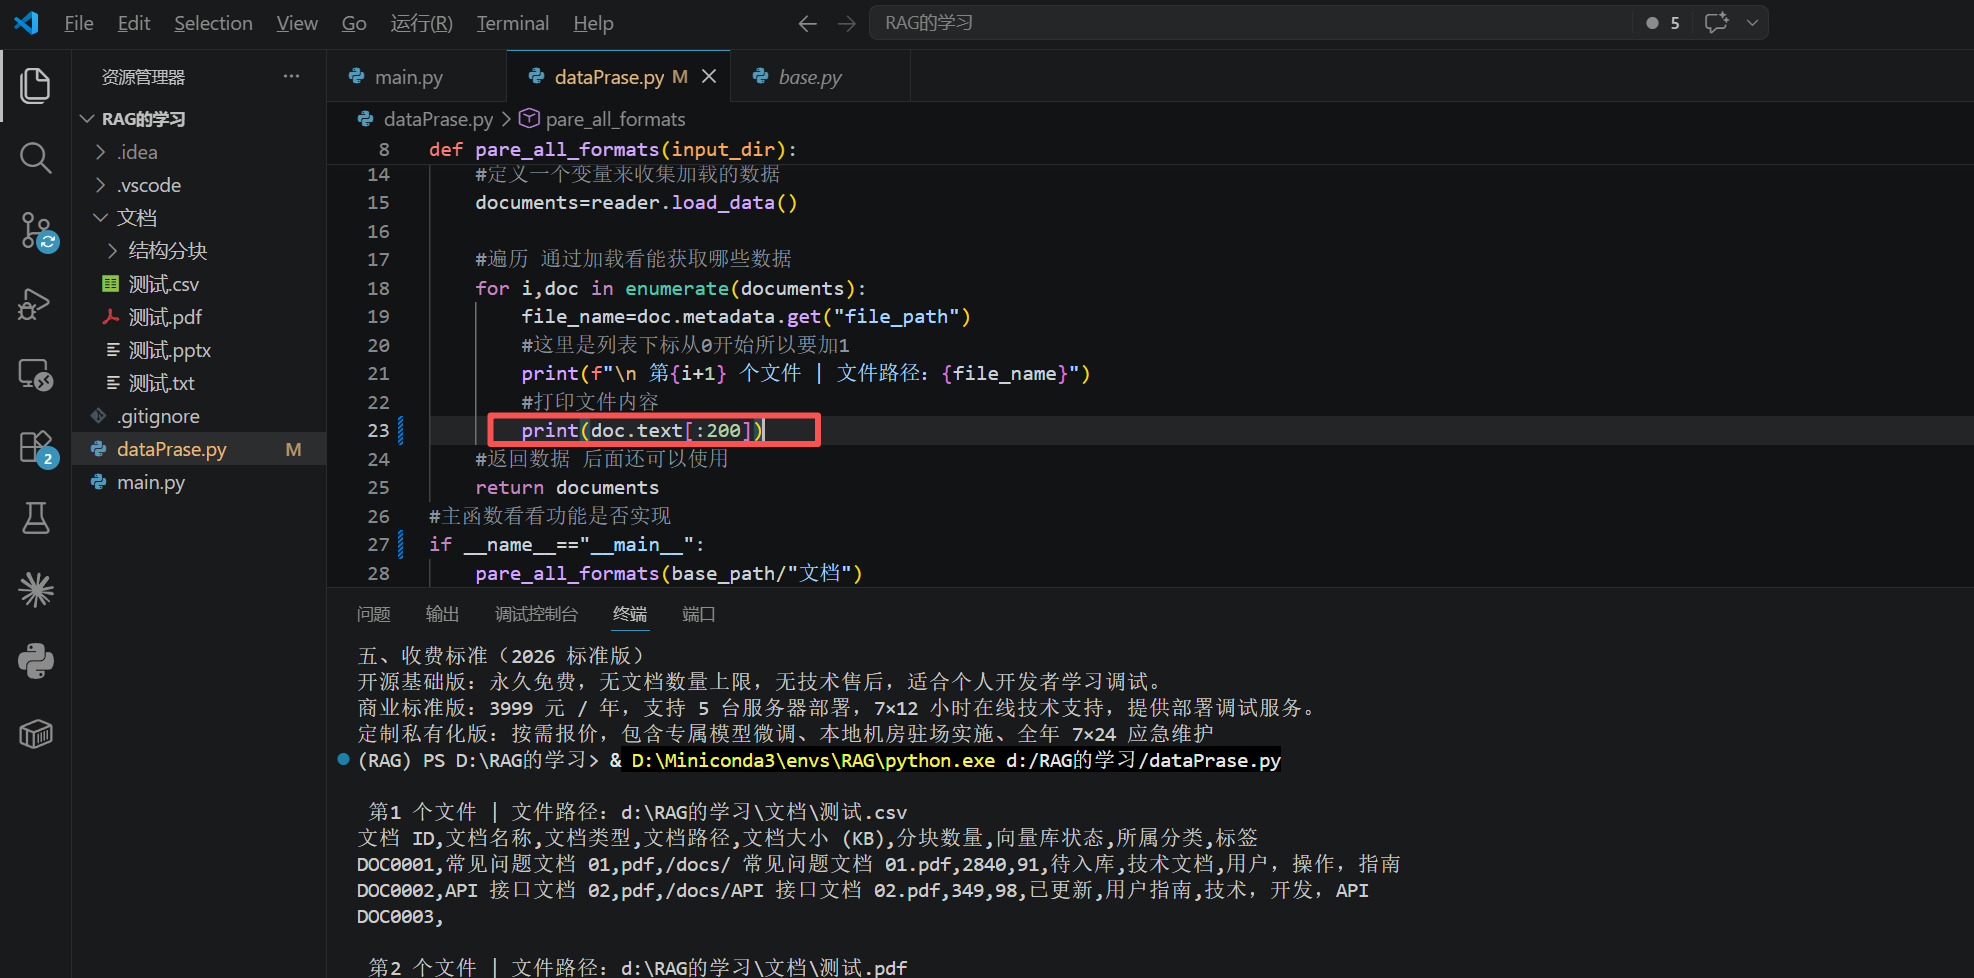
我们这里做了下修改只打印解析到的前两百个字符 不然由于解析的内容过长导致终端放不下
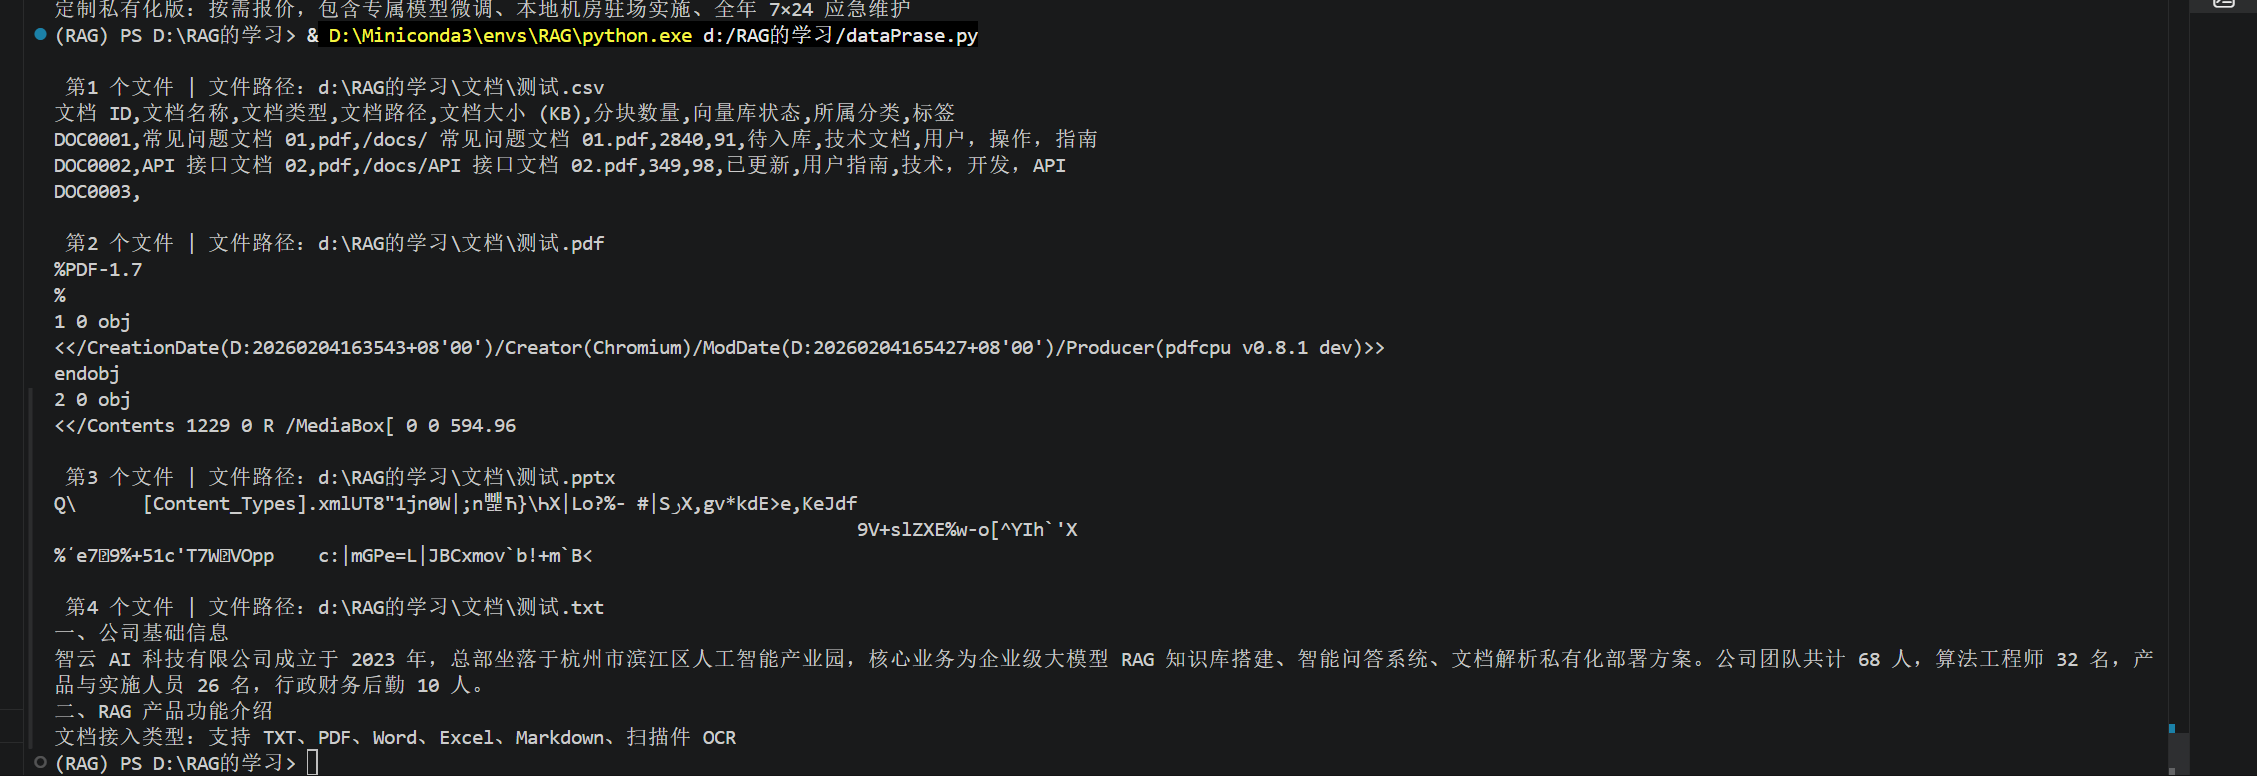
1.乱码问题:
看到效果也是成功解析了,但是有两个文件解析的内容有点问题:
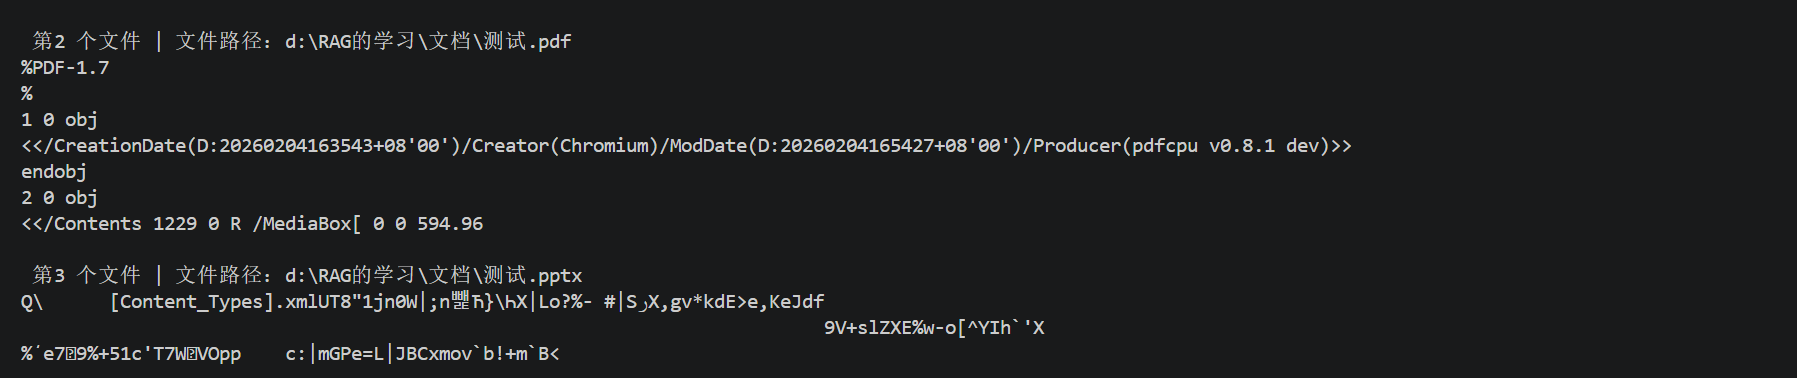
这两个解析出来全是乱码,乱码的内容解析出来发给大模型 大模型肯定是看不懂的,产生代码的原因就是没有办法把解析出来的东西更好的展示 这个主要原因就是缺包了,补上几个包应该就可以正确展示了
# 安装读取⽂件的依赖
pip install llama-index-readers-file python-pptx python-docx openpyxl -i
https://mirrors.aliyun.com/pypi/simple/
这些包就可以很好的解析这些文件了
当我们引入第三方依赖就可以解决文件解析乱码展示的问题
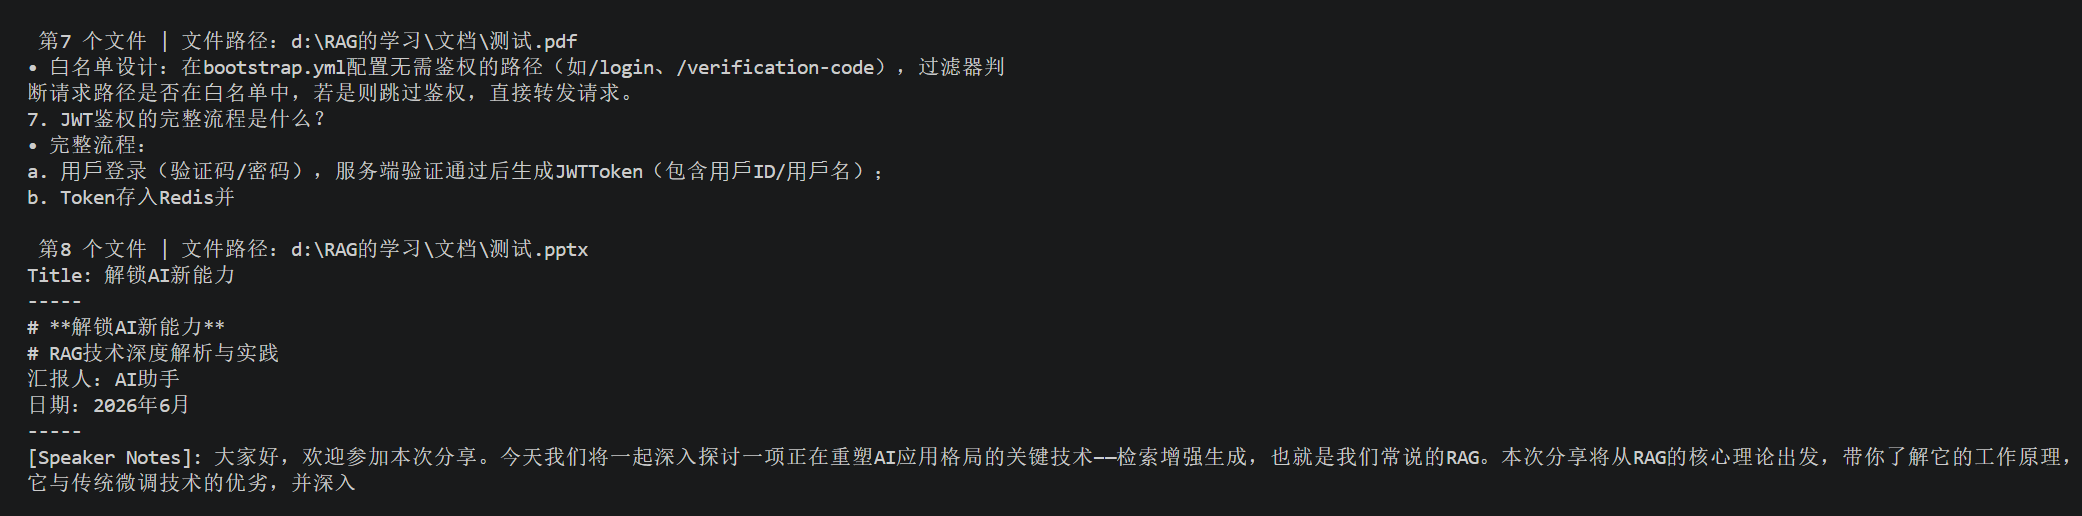
2.文件解析过多问题:
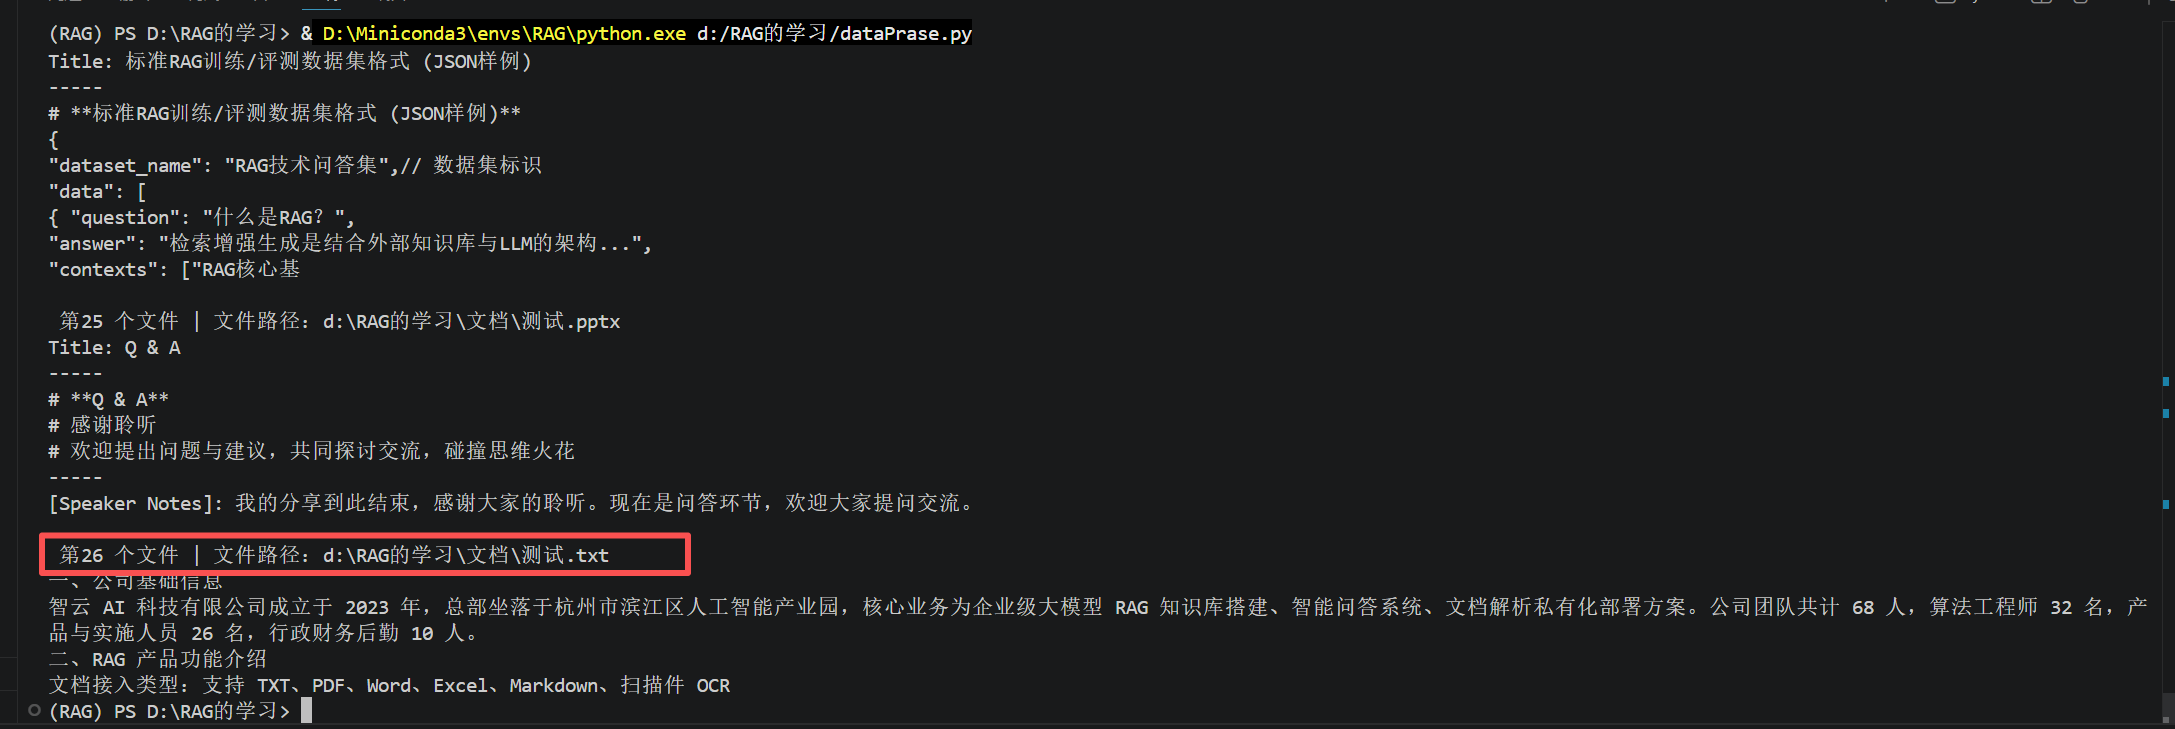
乱码问题解决后还有文件解析过多的问题 这里是因为我们代码里的document其实是一个对象不是一个物理文件 这里像我们解析pdf时 他是按页解析 那么他一页就相当一个对象也就是一个文件了,所以这里导致解析的文件变多 其实我们只有四个文件而已 这里的原因也很简单 当用户上传一个比如很多页的pdf 不可能把所有解析到的东西放入一个对象中
3.1.2 数据的清洗:
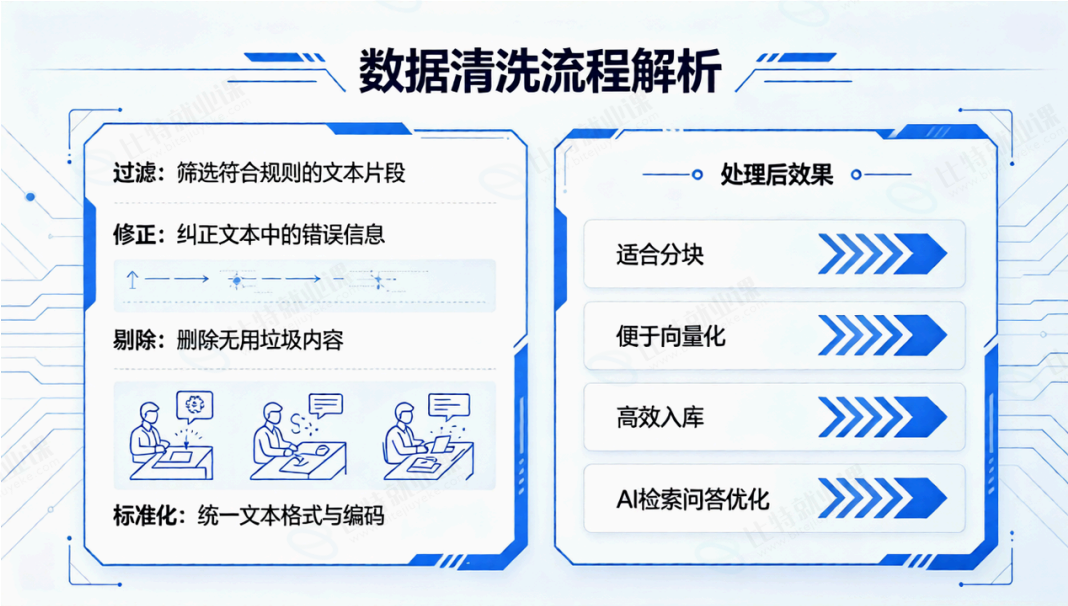
数据清洗就是:对解析后的⽂本做过滤、修正、剔除、标准化,删掉⽆⽤垃圾,保留有效信息,
让⽂本更适合分块、向量化、⼊库、AI 检索问答。这样就方便后续喂给大模型,去掉一些无用信息才能做出更好的判断
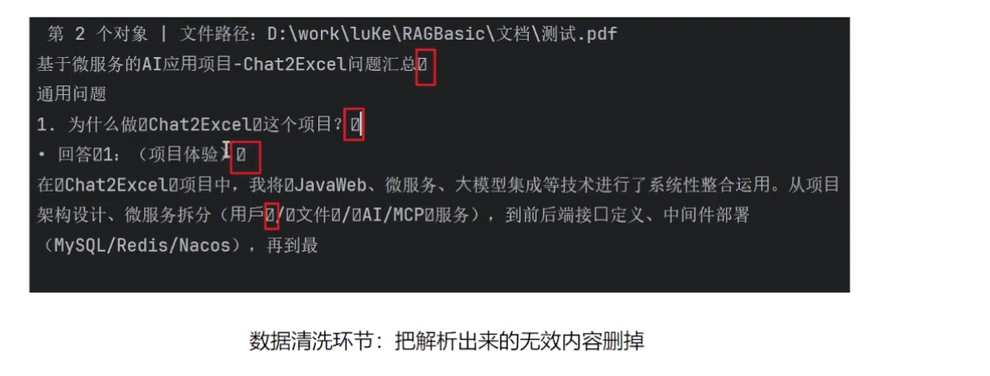
像我们的pdf文件中有格式他会带出来所有这里会导致引入乱码
1.通用方法和配置的构造:
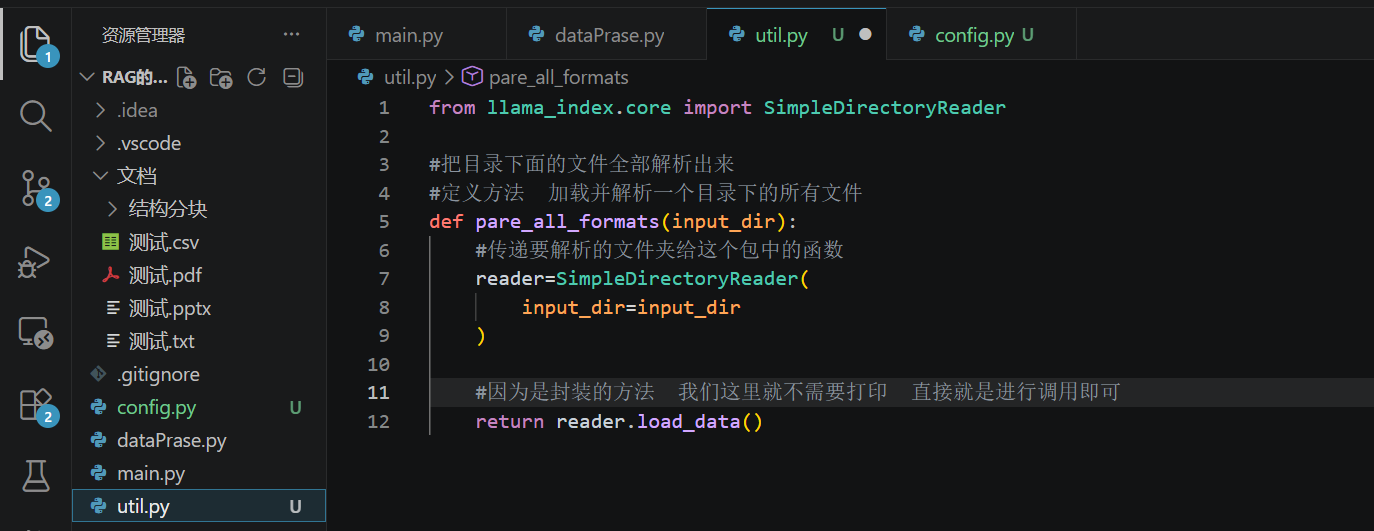
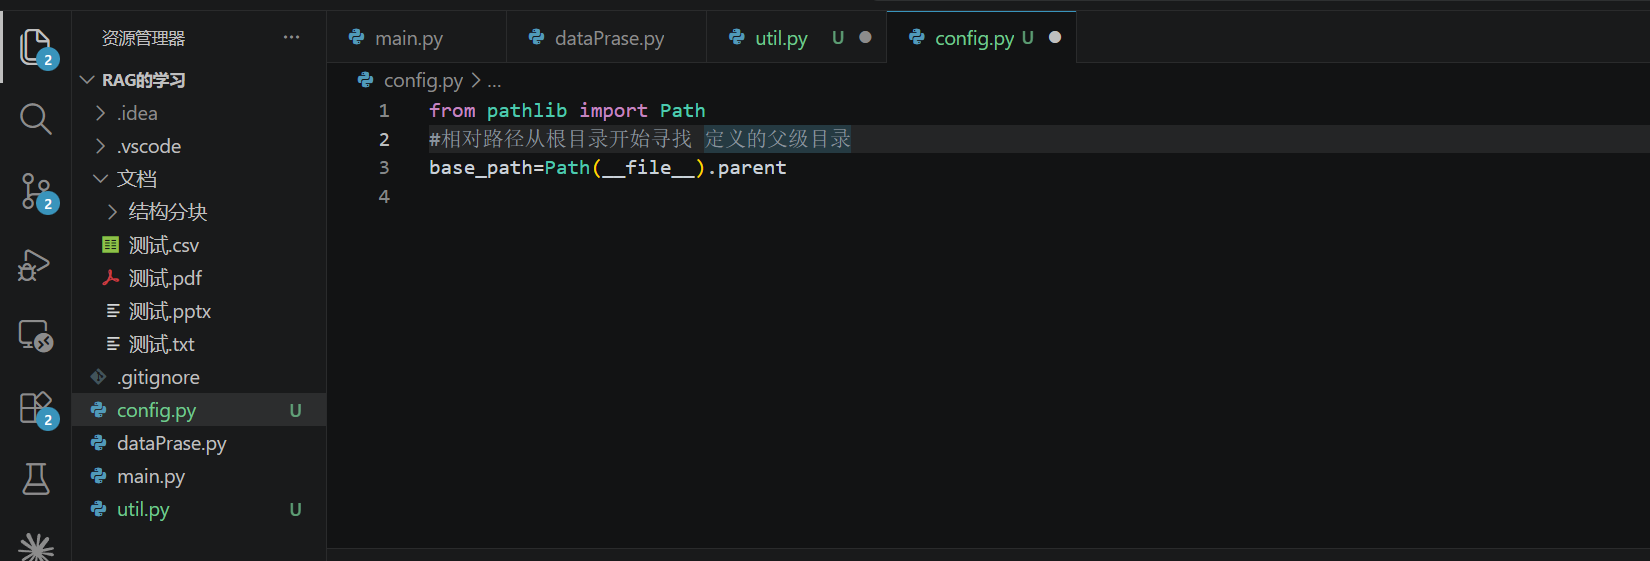
我们如果要继续数据清洗的话首先就要调用我们刚才的数据解析的函数,那么我们封装数据清晰的时候还要再写一遍数据解析吗,肯定是不想的 所有我们这里封装一个公共的方法 用来调用公共的一些功能。然后我们还需要一些配置也就是路径的一些配置和声明
解析文件的公共方法:
配置:
数据清洗的代码逻辑:
python
#引入正则表达式让其规范提取字符
import re
#引入unicode的标准库
import unicodedata
#因为清洗后的数据 我们要生成到新对象 那么要加入路径创建新对象
from pathlib import Path

from llama_index.core import Document
from config import base_path
from util import pare_all_formats

# ---------------------- 预编译正则:PPT解析产⽣的结构噪声匹配规则 -----------------

# 匹配PPT解析⽣成的标题⾏:Title: xxx
_PPTX_TITLE_LINE = re.compile(r"^Title:\s*.+\s*$", re.MULTILINE)
# 匹配PPT内容分割线:连续三个及以上短横线
_PPTX_SEPARATOR = re.compile(r"^-{3,}\s*$", re.MULTILINE)
# 匹配PPT备注前缀:[Speaker Notes]:
_PPTX_SPEAKER_NOTES = re.compile(r"^\[Speaker Notes\]:\s*", re.MULTILINE)
# ---------------------- 预编译正则:Markdown标记清理规则 ----------------------
# 匹配加粗⼀级标题 # **标题**
_MD_HEADING_BOLD = re.compile(r"^#\s*\*\*(.+?)\*\*\s*$", re.MULTILINE)
# 匹配⾏内加粗标记 **内容**
_MD_BOLD = re.compile(r"\*\*(.+?)\*\*")
# 匹配⾏⾸标题符号 #
_LEADING_HASH = re.compile(r"^#\s+", re.MULTILINE)
# 匹配⾸尾包裹#的⽂本 # 内容 #
_INLINE_HASH_WRAP = re.compile(r"#\s*(.+?)\s*#")
# 匹配⾏尾多余#符号
_TRAILING_HASH = re.compile(r"#\s*$")
# ---------------------- 预编译正则:通⽤脏字符匹配规则 ----------------------
# 匹配不可⻅ASCII控制字符(换⾏、制表符除外)
_CONTROL_CHARS = re.compile(r"[\x00-\x08\x0b\x0c\x0e-\x1f\x7f]")
# 匹配零宽空⽩、字节序标记等⾁眼不可⻅隐形字符
_ZERO_WIDTH = re.compile(r"[\ufeff\u200b\u200c\u200d\ufeff]")
# 匹配连续3⾏及以上空⾏,统⼀压缩为两段换⾏
_MULTI_BLANK_LINES = re.compile(r"\n{3,}")
# 对单端⽂本执⾏清洗逻辑
def clean_text(text, source_suffix):
    #这些都是将匹配成功的字符来做一个替换
    text = _ZERO_WIDTH.sub("", text)
    text = text.replace("\ufeff", "")
    text = unicodedata.normalize("NFKC", text)
    text = _CONTROL_CHARS.sub("", text)
    text = text.replace("\r\n", "\n").replace("\r", "\n")
    #通过文件后缀判断是哪个文件  来对不同的文件单独清晰
    if source_suffix.lower() in {".pptx", "ppt", "pptm"}:
        text = clean_ppt(text)
    lines = [line.strip() for line in text.split("\n") if line.strip()]
    text = _MULTI_BLANK_LINES.sub("\n\n", "\n".join(lines))
    return text.strip();
# 单独处理ppt⽂件
def clean_ppt(text):
    text = _PPTX_TITLE_LINE.sub("", text)
    text = _PPTX_SEPARATOR.sub("", text)
    text = _PPTX_SPEAKER_NOTES.sub("", text)
    text = _MD_HEADING_BOLD.sub(r"\1", text)
    text = _MD_BOLD.sub(r"\1", text)
    #拿到PPT所以格式进行替换
    while True:
        cleand = _INLINE_HASH_WRAP.sub(r"\1", text)
        if cleand == text:
            break;
    text = cleand
    text = _LEADING_HASH.sub("", text)
    text = _TRAILING_HASH.sub("", text)
    text = re.sub(r"\s+#\s+", "", text)
    return text.replace("#", "")
# 构建清洗后新的Document对象
def clean_doc(doc):
    #提取后面的文件后缀 来根据后缀调用对应的清洗方法
    suffix = Path(doc.metadata.get("file_path", "")).suffix
    return Document(text=clean_text(doc.text, suffix), metadata=doc.metadata)
# 构建清洗后的Document对象
def clean_all_formats(input_dir):
# 原始解析出来的对象
    docs = pare_all_formats(input_dir)
# 清洗之后的对象数组
    cleaned_docs = []
    #遍历解析后的对象然后清洗 然后把清洗后的数据放入新的document对象
    for i, doc in enumerate(docs):
        cleand_doc = clean_doc(doc)
        cleaned_docs.append(cleand_doc)
        file_path = cleand_doc.metadata.get("file_path")
        print(f"\n第{i+1} 个对象|⽂件路径:{file_path}")
        print(cleand_doc.text)
    return cleaned_docs
if __name__ == "__main__":
    clean_all_formats(base_path/"⽂档")
3.2 文本分块:
不分块,RAG 基本没法⽤;分块越好,AI 回答越准、越不胡说。
⽂本分块的作⽤如下:
- 解决⼤模型「上下⽂⻓度有限」的硬限制
⼤模型有最⼤上下⽂窗⼝(⽐如 4k、8k、32k token)。
你的本地⽂档、⼿册、资料可能⼏万、⼏⼗万字
全⽂直接塞给模型,装不下、直接报错 / 截断分块:把⻓⽂档切成⼩⽚段,只有相关的⼩块才发给⼤ 模型。 - 让向量检索「精准匹配」
向量数据库只能存短⽂本向量:
整篇⽂档转向量:内容太杂,⼀句话问题,匹配到整篇⽆关内容
分块之后:每⼀块只讲⼀个⼩知识点⽤⼾问啥,只召回最相关的那⼀⼩段,匹配精度暴增。 - 防⽌语义割裂、回答错乱
如果不分块 / 乱硬切:⼀句话劈成两半、上下⽂拆开,AI 只看碎⽚⽂字合理分块(句⼦ / 段落分
块):保证每⼀块语义完整、逻辑独⽴,AI 看得懂、不乱编。 - 降低成本 + 提升速度
发给⼤模型的⽂本越短,token 消耗越少、花钱越少
⼩块向量检索、计算、对⽐速度远快于超⻓⽂本省钱、响应更快。
3.2.1 固定大下分块:
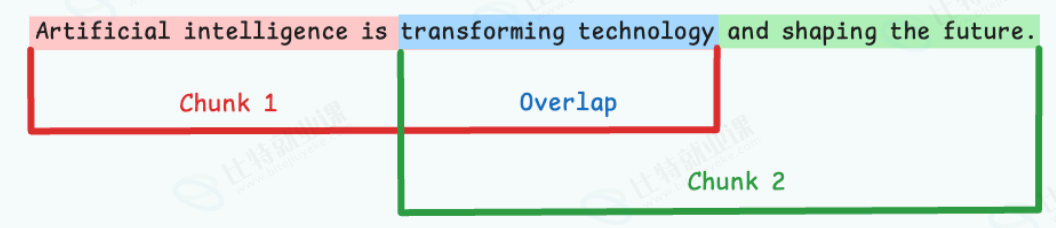
固定⼤⼩分块 ( Fixed-size Chunking ), 将⽂本按固定⻓度(如字符数或token数)切分,每个
块⼤⼩⼀致,可能通过重叠保留上下⽂连贯性。例如,将⽂档每256个字符切分为⼀个块,重叠20个字符以减少边界信息丢失。
我们做固定大小分块的时候是默认进行了数据加载和数据的清洗,所以我们还需要把数据清洗也放入util中 这样作为公共的方法来进行调用
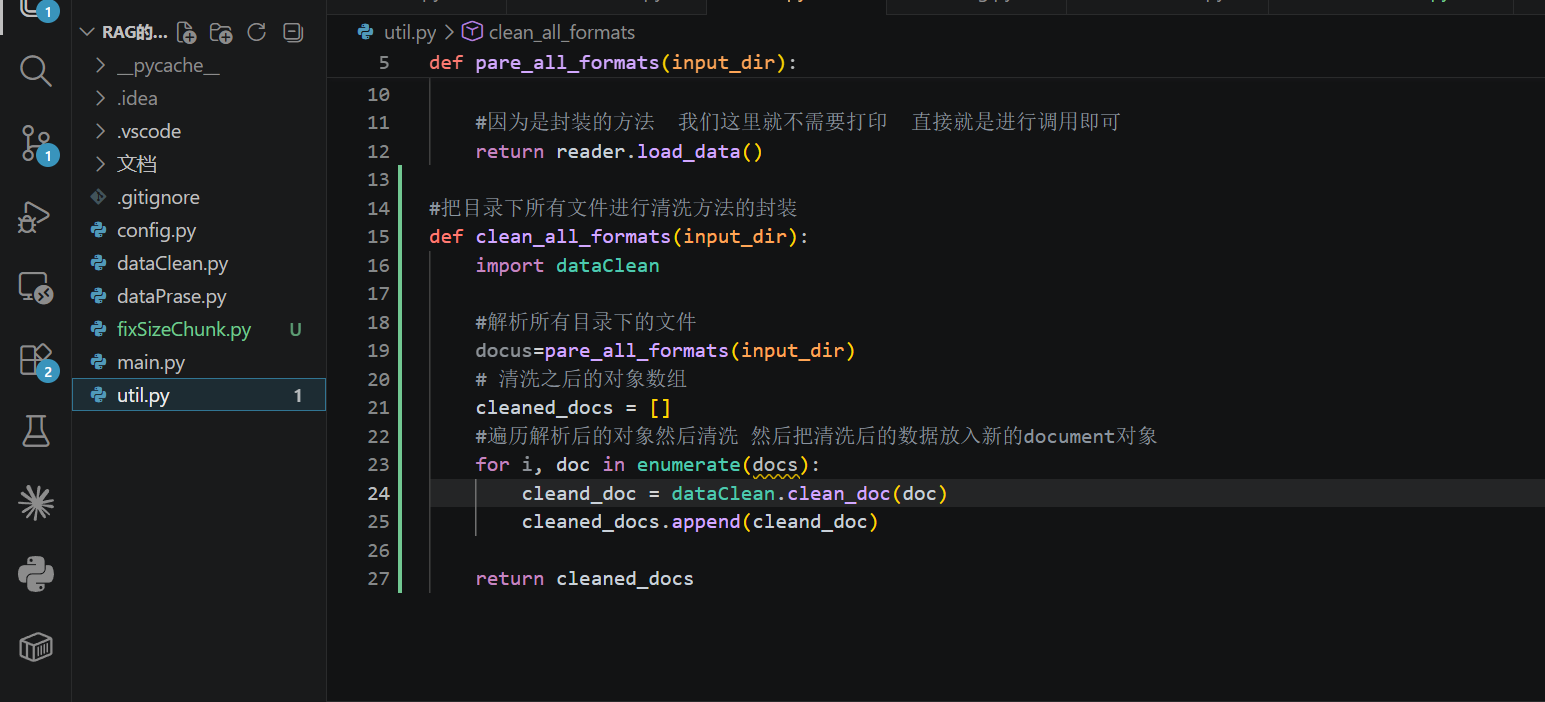
也就是去调用封装好的dataclean这样就可以完成对不同格式的清洗 也就是一层套了一层
初始的分块的代码
python
#引入数组
from typing import List
#引入文本
from llama_index.core.schema import Document
import config
import util

#按照固定大小分块 括号里面都是参数    然后返回List的文档类型
def fixed_size_chunked_documents(
        #让他直接操作文件
        input_dir : str,
        #按照固定大小长度
        chunk_size: int=500,
        #重叠区的长度大小
        chunk_overlap: int=50
)->List[Document]:
    chunks=[] #用空数组接这个返回值
    #他每一次有一个滑动的长度 是固定大小长度-重叠区的长度
    step=chunk_size-chunk_overlap
    #获取清洗后的文档
    documents=util.clean_all_formats(input_dir)

    for d in documents:
        text=d.text
        path=d.metadata.get("file_path")
        start=0 #分块在原文中的起始位置
        idx=0 #当前文档的分块序号

        #开始分块迁移
        while start<len(text):
            #是在你起始位置加上固定长度大小和文本的长度取最小值 不能越界
            end=min(start+chunk_size,len(text))
            #复制原始文档
            m=dict(d.metadata)
            #更新一下文档
            m.update({
                "source_file_path":path,
                "chunk_index":idx,
                "chunk_start": start,
                "chunk_end": end,
            })
            chunks.append(Document(text=text[start:end],metadata=m))
            if end >= len(text):
                break
            start = start + step
            idx = idx + 1
    for i, d in enumerate(chunks):
        print(f"第{i+1}个分块")
        print(d.metadata)
        print(d.text)
    return chunks
if __name__ == "__main__":
    fixed_size_chunked_documents(config.base_path/"文档")
我这里执行的时候遇到了一直卡住的问题 也不报错让AI介入看看发生了什么导致一直卡住吧
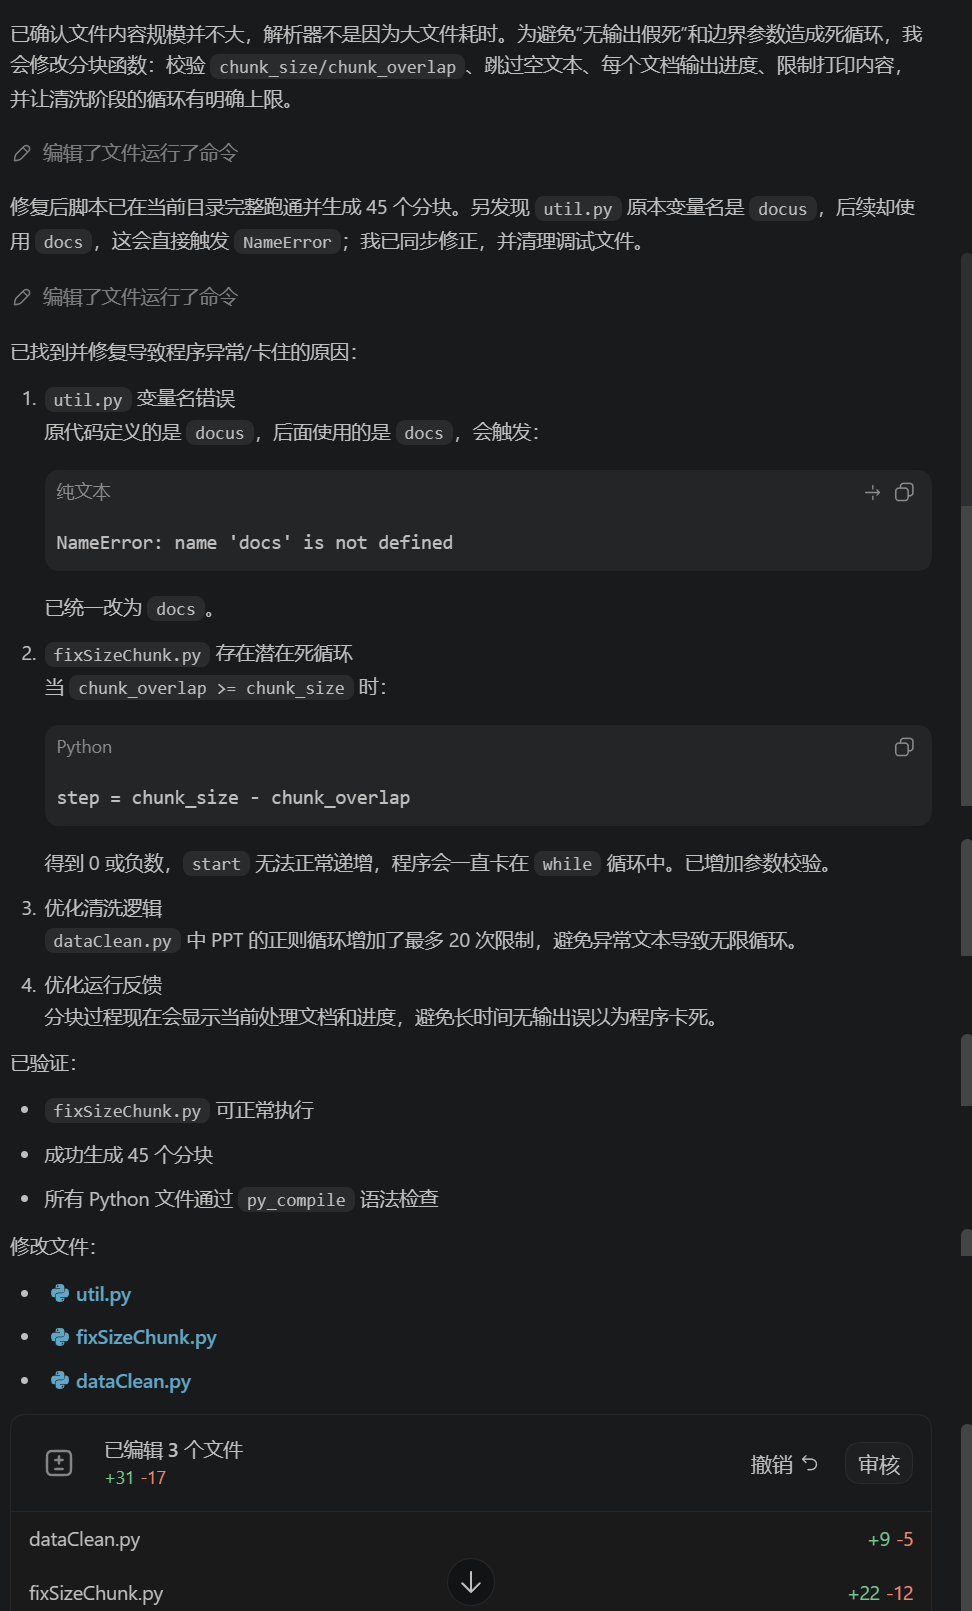
这部分代码的理解:
可以把它理解成一个"文本切片器"。
-
导入依赖
from typing import List
用于类型提示,表示函数返回的是一个列表。
from llama_index.core.schema import DocumentDocument 是 LlamaIndex 中的文档对象,通常包含:
-
text:文本内容 -
metadata:元数据,例如文件路径、页码等import config
import util -
config:获取项目路径 -
util:调用文档读取和清洗函数
-
定义函数
def fixed_size_chunked_documents(
input_dir: str,
chunk_size: int = 500,
chunk_overlap: int = 50
) -> List[Document]:
这个函数有三个参数。
input_dir
输入目录,例如:
"文档"或者:
config.base_path / "文档"目录中可以包含:
- PPTX
- TXT
- CSV
- 其他 LlamaIndex 支持的格式
chunk_size
每个文本块的最大字符数。
默认:
chunk_size = 500注意:这里计算的是 Python 字符串长度,不是 token 数量。
chunk_overlap
相邻两个文本块之间的重叠字符数。
默认:
chunk_overlap = 50重叠的意义是避免一句话刚好被切断后,后一个文本块缺少上下文。
返回值
-> List[Document]表示返回一个列表,列表中的每一项都是一个 Document。
-
参数校验
if not isinstance(chunk_size, int) or chunk_size <= 0:
raise ValueError("chunk_size 必须是大于 0 的整数")
检查 chunk_size 是否为正整数。
例如下面的参数不允许:
chunk_size = 0
chunk_size = -10
chunk_size = "500"
否则可能出现无意义的分块,甚至死循环。
if not isinstance(chunk_overlap, int) or chunk_overlap < 0:
    raise ValueError("chunk_overlap 必须是大于等于 0 的整数")
重叠长度不能是负数。
if chunk_overlap >= chunk_size:
    raise ValueError("chunk_overlap 必须小于 chunk_size")
这是非常重要的检查。
程序后面会计算:
step = chunk_size - chunk_overlapstep 表示下一次向前移动多少字符。
如果:
chunk_size = 500
chunk_overlap = 500
那么:
step = 0start 永远不会增加,while 循环就会永久运行。
如果:
chunk_overlap > chunk_size那么 step 会变成负数,也会导致死循环。
-
创建结果列表
chunks = []
这个列表用来保存最终生成的所有文本块。
例如最终可能是:
[
    Document(...),
    Document(...),
    Document(...)
]-
计算滑动步长
step = chunk_size - chunk_overlap
默认情况下:
step = 500 - 50
     = 450
意思是:
- 每个块最多 500 个字符
- 下一块从前一块起始位置往后移动 450 个字符
- 因此两块之间有 50 个字符重叠
公式可以写成:
下一块起点 = 当前块起点 + chunk_size - chunk_overlap-
读取并清洗文档
documents = util.clean_all_formats(str(input_dir))
这一行做了两件事:
第一步:读取目录中的文件
util.clean_all_formats() 内部会调用:
SimpleDirectoryReader(input_dir=input_dir).load_data()它会解析目录中的 PDF、PPTX、TXT、CSV 等文件。
第二步:清洗文本
清洗内容包括:
- 删除不可见字符
- 统一换行符
- 清理 PPT 标题格式
- 删除 Markdown 加粗符号
- 清理多余的
# - 去除空行和首尾空格
因此,documents 中的文本已经不是原始文本,而是清洗后的文本。
需要注意:PDF 通常会按页生成多个 Document。所以你的一个 PDF 可能对应多个 Document。
-
遍历每个原始文档
for doc_index, d in enumerate(documents, start=1):
这表示逐个处理清洗后的文档。
例如:
第 1 个文档:测试.csv
第 2 个文档:测试.pdf 第 1 页
第 3 个文档:测试.pdf 第 2 页
第 4 个文档:测试.pptx 第 1 页
变量 d 就是当前正在处理的原始 Document。
-
获取文本和文件路径
text = d.text
取出当前文档的文本内容。
path = d.metadata.get("file_path")从元数据中获取文件路径。
例如:
D:\RAG的学习\文档\测试.pdf-
跳过空文档
if not text:
print(f"跳过空文档: {path}", flush=True)
continue
如果当前文档没有内容,就跳过,不进行分块。
continue 的意思是:
结束本次循环,直接处理下一个文档。
-
初始化分块位置
start = 0
表示当前分块从文本的第 0 个字符开始。
idx = 0表示当前分块的序号从 0 开始。
例如:
第一个块:chunk_index = 0
第二个块:chunk_index = 1
第三个块:chunk_index = 2-
分块循环
while start < len(text):
只要当前起点还没有到达文本末尾,就继续切块。
假设:
len(text) = 1200
chunk_size = 500
那么循环会处理:
start = 0
start = 450
start = 900-
计算当前分块的结束位置
end = min(start + chunk_size, len(text))
假设:
start = 0
chunk_size = 500
len(text) = 1200
那么:
end = min(0 + 500, 1200)
    = 500
如果到了最后:
start = 900
end = min(900 + 500, 1200)
    = 1200
这样可以保证不会超过文本长度。
-
复制原始元数据
m = dict(d.metadata)
把原始文档的元数据复制一份。
例如原文档原本有:
{
    "file_path": "测试.pdf",
    "page_label": "1",
    "file_type": "application/pdf"
}
这里复制后,新的 m 还是包含这些信息。
之所以复制,是为了给每个分块单独添加信息,而不直接修改原始文档。
-
添加分块元数据
m.update({
"source_file_path": path,
"chunk_index": idx,
"chunk_start": start,
"chunk_end": end,
})
这里增加了四个字段。
source_file_path
表示这个分块来自哪个文件。
chunk_index
表示这个分块在当前文档中的序号。
chunk_start
表示这个分块在原文中的起始字符位置。
chunk_end
表示这个分块在原文中的结束字符位置。
例如:
{
    "source_file_path": "测试.txt",
    "chunk_index": 1,
    "chunk_start": 450,
    "chunk_end": 950
}
表示:
这是当前文档的第 2 个分块,对应原文第 450 到 950 个字符。
-
创建新的 Document
chunks.append(
Document(
text=text[start:end],
metadata=m
)
)text[start:end]
是 Python 的切片操作,表示:
从 start 开始,截取到 end 之前然后把这段文本和元数据封装成一个新的 Document,放入 chunks 列表。
-
判断是否已经到达末尾
if end >= len(text):
break
如果当前分块已经到达文本末尾,就退出 while 循环。
这一步很重要,可以避免最后重复生成一个分块。
-
移动到下一个分块
start = start + step
默认 step=450,所以:
第一次:start = 0
第二次:start = 450
第三次:start = 900

idx = idx + 1
分块序号加一。
一个完整例子
假设原文是 26 个字符:
ABCDEFGHIJKLMNOPQRSTUVWXYZ设置:
chunk_size = 10
chunk_overlap = 2
那么:
step = 10 - 2 = 8分块过程如下:
| 分块 | start | end | 内容 |
|---|---|---|---|
| 0 | 0 | 10 | ABCDEFGHIJ |
| 1 | 8 | 18 | IJKLMNOPQR |
| 2 | 16 | 26 | QRSTUVWXYZ |
| 3 | 不再生成 |
可以看到:
第 0 块:ABCDEFGH I J
第 1 块:        I J KLMNOPQR
第 2 块:                QR STUVWXYZ
相邻文本块之间:
- 第 0 块和第 1 块重叠:
IJ - 第 1 块和第 2 块重叠:
QR
这就是"滑动窗口分块"。
-
打印所有分块
for i, d in enumerate(chunks):
print(f"第{i+1}个分块")
print(d.metadata)
print(d.text)
这部分只是为了调试和观察结果。
它会打印:
- 第几个分块
- 该分块的元数据
- 该分块的完整文本
如果文档很多,或者文本很长,控制台会输出大量内容,看起来可能像程序很慢。它不会影响分块逻辑,只是输出比较多。
-
返回结果
return chunks
函数最终返回所有分块:
List[Document]之后你可以把它传给:
- 向量数据库
- Embedding 模型
- LlamaIndex 索引
- RAG 检索器
-
主程序入口
if name == "main":
fixed_size_chunked_documents(config.base_path / "文档")
这句的意思是:
只有直接运行
fixSizeChunk.py时,才执行分块;如果这个文件被其他代码导入,则不会自动执行。
例如直接运行:
python fixSizeChunk.py就会处理:
项目目录/文档如果在其他文件中:
from fixSizeChunk import fixed_size_chunked_documents则只会导入函数,不会自动处理文档。
整体流程可以简化成:
读取目录
   ↓
解析 PDF、PPTX、TXT、CSV
   ↓
清洗文本
   ↓
逐个文档处理
   ↓
按固定字符数切片
   ↓
加入重叠内容
   ↓
记录文件来源和字符位置
   ↓
返回所有 Document 分块
最关键的三行是:
step = chunk_size - chunk_overlap

end = min(start + chunk_size, len(text))

chunks.append(Document(text=text[start:end], metadata=m))
它们分别负责:
- 决定窗口每次移动多少
- 决定当前块截取到哪里
- 创建并保存新的文本块。
3.2.2 句子分块:
句⼦分割是将⼀段连续的⽂本按照句⼦边界(如句号、问号、感叹号、换⾏等)切分成独⽴的句
⼦。
常见的标点符合:。!?用这些去做一个句子的拆分,不是让一个句子一个块,句子分好之后,可能会有语意的不清晰,所以要多个句子组成一个块来使用,多个句子拼装成一个块,这里通过标点符号就要引入正则表达式来表示了
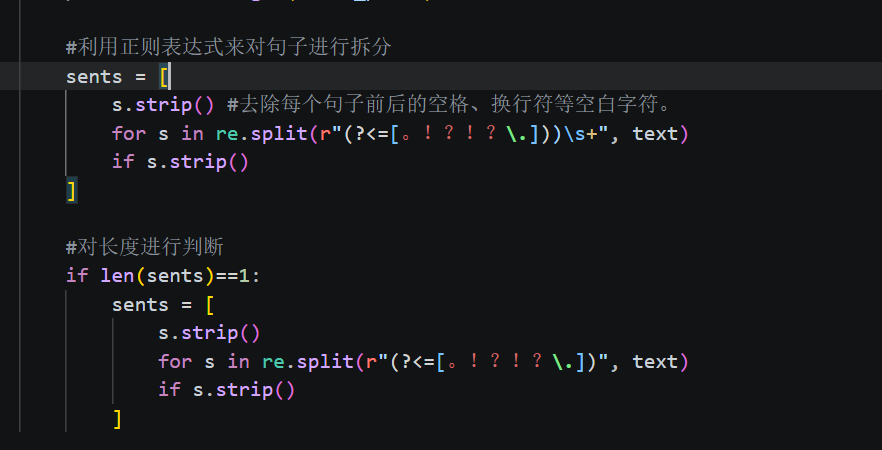
第一个正则表达式是用来匹配后面有多个空格或者换行符号的 如果第一次没有分块成功,那么块就=1,那么就进行第二次的分块 这样就不匹配空格和换行符了就直接进行匹配分割
这两块代码是在用两种方式拆分句子:第一块优先按照"句末标点 + 空白字符"拆分;如果拆不出来,再用第二块直接在句末标点后拆分。
第一块:标点后有空格或换行时拆分
sents = [
    s.strip()
    for s in re.split(r"(?<=[。!?\.])\s+", text)
    if s.strip()
]
正则表达式:
(?<=[。!?\.])\s+分为两部分:
(?<=[。!?\.]):要求当前位置前面是句号、问号或感叹号。\s+:匹配一个或多个空白字符,包括空格、换行、制表符等。
例如:
text = "你好。 今天天气很好!\n要出去玩吗?"结果:
["你好。", "今天天气很好!", "要出去玩吗?"]这里真正被 re.split() 删除的是标点后面的空格或换行,标点本身会保留。
第二块:第一种方式拆不出来时直接拆
if len(sents) == 1:
    sents = [
        s.strip()
        for s in re.split(r"(?<=[。!?\.])", text)
        if s.strip()
    ]

if len(sents) == 1:
表示第一块执行完后只有一个元素,说明没有找到"标点 + 空白字符"这样的分割位置。
于是第二块不再要求标点后必须有空格,直接在标点后面拆分。
例如:
text = "你好。今天天气很好!要出去玩吗?"第一块无法拆分,因为标点后面没有空格或换行,所以结果是:
["你好。今天天气很好!要出去玩吗?"]长度为 1,于是进入第二块,最终得到:
["你好。", "今天天气很好!", "要出去玩吗?"]两块的区别可以简单理解为:
| 代码块 | 拆分条件 |
|---|---|
| 第一块 | 标点后面必须有空格或换行 |
| 第二块 | 只要遇到标点就拆分 |
Python strip()作用:删除字符串「开头和结尾」的指定字符(默认删空白符),中间字符不动。
句子分块的代码:
python
#导入正则表达式
import re
from typing import List
from llama_index.core.schema import Document
import util
import config

#实现按照句子去分块功能
def sentence_chunk_documents(
        input_dir:str,
        #多个句子拼成一个块 这里随便设置了 要根据数据集
        max_sentences:int=5
#提前告知返回类型是对象数组  也就是数组里面装的是一个对象
)->List[Document]:
    chunk=[]
    #用来承接清洗后的数据
    documents=util.clean_all_formats(input_dir)

    for d in documents:
        text=d.text
        if not text:
            #这个没有数据就终止这一次的循环而不是整个循环
            continue

        path=d.metadata.get("file_path")

        #利用正则表达式来对句子进行拆分
        sents = [
            s.strip() #去除每个句子前后的空格、换行符等空白字符。
            for s in re.split(r"(?<=[。!?.!?])\s+", text)
            if s.strip()
        ]

        #对长度进行判断
        if len(sents)==1:
            sents = [
                s.strip()
                for s in re.split(r"(?<=[。!?.!?])", text)
                if s.strip()
            ]
        #每次遍历上面设置的长度 然后设置成一个块
        #`range(start, end, step)`,步长是`max_sentences=5`
        for i in range(0,len(sents),max_sentences):
            #加上通过正则表达式筛选后的块
            part="".join(sents[i:i+max_sentences]).strip()
            if not part:
                continue
            m = dict(d.metadata)
            m.update({
                "source_file_path": path,
                "chunk_index": i // max_sentences,
                "chunk_start": i,
                "chunk_end": min(i+max_sentences, len(sents)),

            })
            chunk.append(Document(text=part, metadata=m))
    for i, chunk in enumerate(chunk):
        print(f"第{i+1}个分块")
        print(chunk.metadata)
        print(chunk.text)
if __name__ == "__main__":
    sentence_chunk_documents(config.base_path/"文档")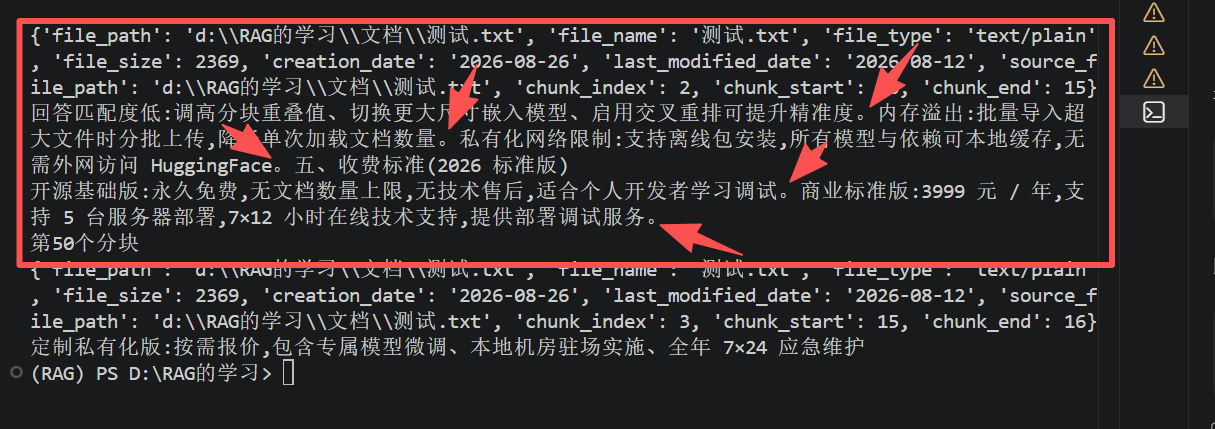
可以看到这里就被分为五句话了
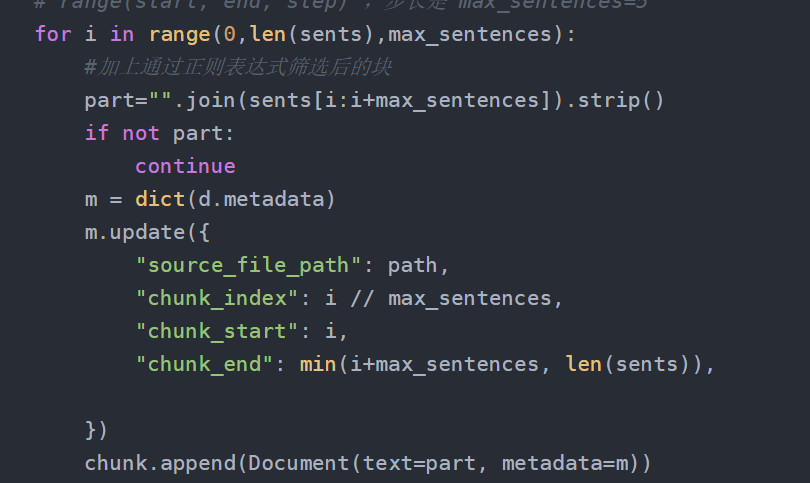
这部分循环代码当时我有点没弄懂其实这段代码的作用是:把已经拆好的句子列表 sents,每 max_sentences 个句子合并成一个文本块,并给每个文本块附加来源和位置信息。
假设:
sents = [
    "第一句话。",
    "第二句话。",
    "第三句话。",
    "第四句话。",
    "第五句话。",
    "第六句话。",
    "第七句话。",
]

max_sentences = 3-
按固定数量遍历句子
for i in range(0, len(sents), max_sentences):
range(start, stop, step) 的含义是:
- 从
0开始 - 到
len(sents)之前结束 - 每次增加
max_sentences
上面的例子中:
len(sents) = 7
max_sentences = 3
所以:
range(0, 7, 3)得到的 i 依次是:
0、3、6也就是:
第 0 个位置开始取一块
第 3 个位置开始取一块
第 6 个位置开始取一块
这里的 i 是当前分块在句子列表中的起始下标。
-
取出当前分块的句子
sents[i:i+max_sentences]
这是 Python 的列表切片,表示从下标 i 开始,取最多 max_sentences 个句子。
当 i = 0 时:
sents[0:3]得到:
["第一句话。", "第二句话。", "第三句话。"]当 i = 3 时:
sents[3:6]得到:
["第四句话。", "第五句话。", "第六句话。"]当 i = 6 时:
sents[6:9]虽然结束下标是 9,但列表实际只有 7 个元素,因此 Python 会自动取到末尾:
["第七句话。"]不会越界报错。
-
把句子合并成一个文本块
part = "".join(sents[i:i+max_sentences]).strip()
"".join(...) 会把列表中的字符串连接起来,连接符是空字符串。
例如:
"".join(["第一句话。", "第二句话。", "第三句话。"])结果是:
第一句话。第二句话。第三句话。最后的 .strip() 用于去除整个文本块前后的空格和换行。
如果希望句子之间保留换行,也可以写成:
part = "\n".join(sents[i:i+max_sentences]).strip()-
跳过空文本块
if not part:
continue
如果 part 是空字符串,就跳过本次循环,不创建空的 Document。
continue 的意思是:直接结束当前这次循环,进入下一次循环。
-
复制原文档的元数据
m = dict(d.metadata)
d 是前面清洗后得到的原始文档对象,d.metadata 是它的元数据,例如:
{
    "file_path": "文档/test.txt",
    "file_name": "test.txt"
}
dict(d.metadata) 会复制一份新的字典,避免直接修改原文档的元数据。
-
更新当前文本块的元数据
m.update({
"source_file_path": path,
"chunk_index": i // max_sentences,
"chunk_start": i,
"chunk_end": min(i+max_sentences, len(sents)),
})
各字段含义如下:
"source_file_path": path表示这个文本块来自哪个文件。
"chunk_index": i // max_sentences表示当前是第几个文本块。
// 是整除:
0 // 3 = 0
3 // 3 = 1
6 // 3 = 2
因此分块编号是:
0、1、2

"chunk_start": i
表示当前文本块从句子列表的哪个下标开始。
"chunk_end": min(i+max_sentences, len(sents))表示当前文本块结束的位置。
这里的结束下标通常是"左闭右开"的,也就是:
sents[chunk_start:chunk_end]例如:
chunk_start = 3
chunk_end = 6
表示使用:
sents[3:6]也就是第 3、4、5 号句子,不包含下标 6 的句子。
min() 是为了防止结束位置超过句子总数。
-
创建新的 Document 对象
chunk.append(Document(text=part, metadata=m))
这里创建了一个新的 Document:
text=part:文本内容metadata=m:该文本块的元数据
然后使用:
chunk.append(...)把它添加到 chunk 列表中。
最终,chunk 大概会是:
[
    Document(
        text="第一句话。第二句话。第三句话。",
        metadata={
            "source_file_path": "test.txt",
            "chunk_index": 0,
            "chunk_start": 0,
            "chunk_end": 3
        }
    ),
    Document(
        text="第四句话。第五句话。第六句话。",
        metadata={
            "source_file_path": "test.txt",
            "chunk_index": 1,
            "chunk_start": 3,
            "chunk_end": 6
        }
    ),
    Document(
        text="第七句话。",
        metadata={
            "source_file_path": "test.txt",
            "chunk_index": 2,
            "chunk_start": 6,
            "chunk_end": 7
        }
    )
]
整体流程可以概括为:
原始文档
  ↓
拆分成句子 sents
  ↓
每 max_sentences 个句子取一组
  ↓
合并成 part
  ↓
复制并更新元数据
  ↓
创建 Document
  ↓
加入 chunk 列表
元数据的含义:
元数据就是"描述数据的数据"。
在这段代码中,真正的正文是:
Document(text=part, metadata=m)其中:
text=part是文本块的实际内容,例如:
第一句话。第二句话。第三句话。而:
metadata=m是描述这个文本块的信息,例如:
{
    "source_file_path": "D:/RAG的学习/文档/test.txt",
    "chunk_index": 0,
    "chunk_start": 0,
    "chunk_end": 3
}
这些字段的含义是:
source_file_path:文本块来自哪个文件chunk_index:这是第几个文本块chunk_start:从第几个句子开始chunk_end:到第几个句子结束
可以类比为一本书:
正文内容:这是书中的一段文字。

元数据:
书名:《人工智能入门》
作者:张三
页码:第 10 页
章节:第一章
正文是实际要阅读的内容,元数据是帮助我们识别、管理和定位正文的信息。
在 RAG 中,元数据非常重要。例如用户问:
这段内容来自哪个文件?
系统就可以通过:
document.metadata["source_file_path"]找到来源文件。
也可以通过元数据实现:
- 按文件筛选内容
- 显示答案引用来源
- 定位原文位置
- 区分不同文档的文本块
- 删除或更新某个文件产生的所有文本块
所以,这段代码给每个文本块添加元数据,是为了让文本块不仅有内容,还能知道"自己来自哪里、处于什么位置"。
3.2.3 语义分块:
语义分块(Semantic Chunking),基于⽂本语义相似度⾃动切分,把语义连贯、主题统⼀的内
容划为⼀块,语义发⽣明显跳转时再分割。
第一步引入一个专门为语言分块的模型,下载嵌入模型:
BAAI/bge-m3 是北京智源研究院发布的第三代通⽤⽂本嵌⼊(Embedding)模型,专⻔给 RAG
知识库、语义搜索做⽂本向量化,是⽬前⼯业界综合能⼒最强的开源向量模型之⼀,经它处理产⽣的 向量是1024维的。
https://www.modelscope.cn/models/BAAI/bge-m3
这种嵌入模型就是本地可以使用的模型,来进行操作,一串文本经过嵌入模型的操作会得到一个向量数组,也就是把非数字化的数据转为数字化数据,这样就可以量化和比较
这里对于模型的下载推荐的是SDK下载 直接下载对应的依赖包然后起一行python命令就可以嵌入模型了
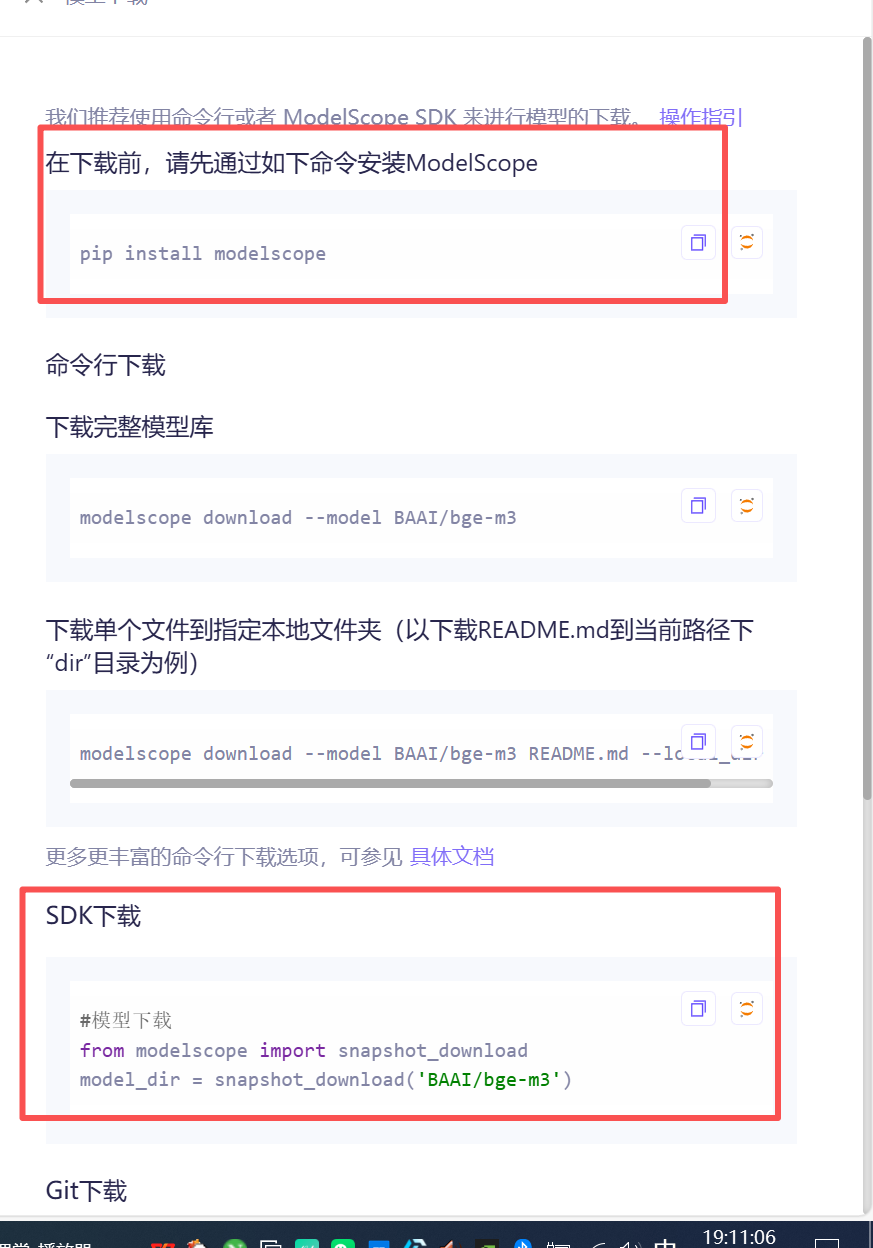
我们还可以指定下载路径不然就指定下载到电脑的C盘了,这个模型还是非常大的4个G,所以还是推荐指定路径下载
1.模型的下载:
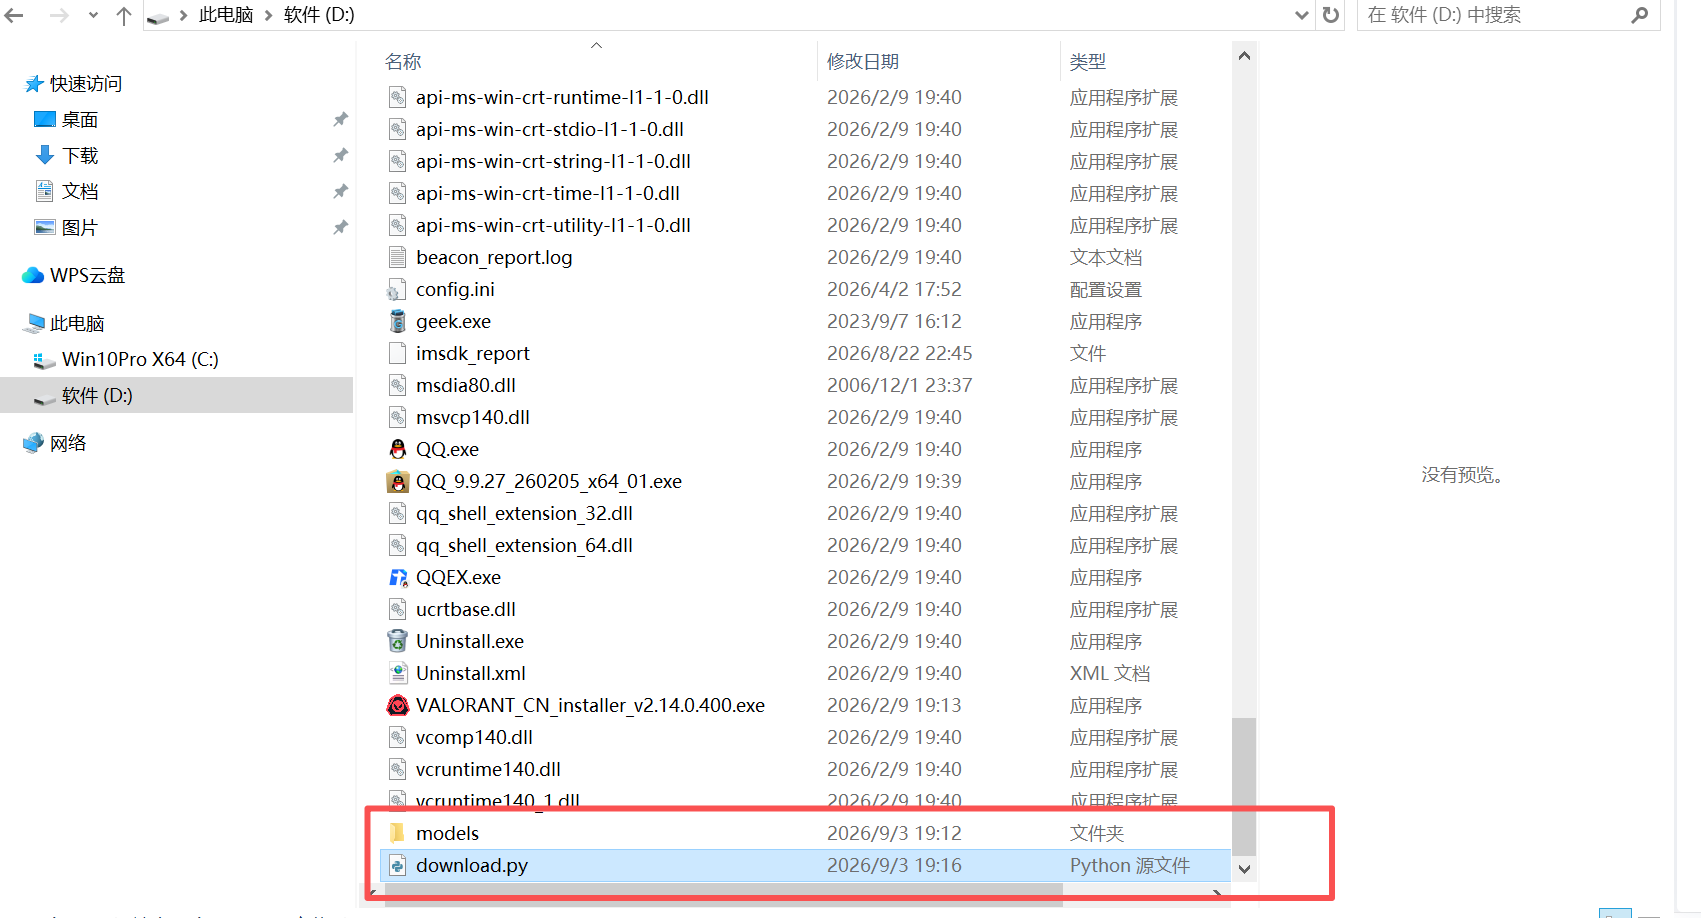
首先在D盘创建这两个文件即可,在这个脚本文件中的代码是:
python
#模型下载
# 模型下载(指定保存到 D:\models ⽬录)
from modelscope import snapshot_download
# 下载模型并指定保存路径
model_dir = snapshot_download(
'BAAI/bge-m3',
cache_dir='D:\\models' # 关键:指定下载⽬录
)
# 打印最终保存路径,⽅便你查看
print("模型已下载到:", model_dir)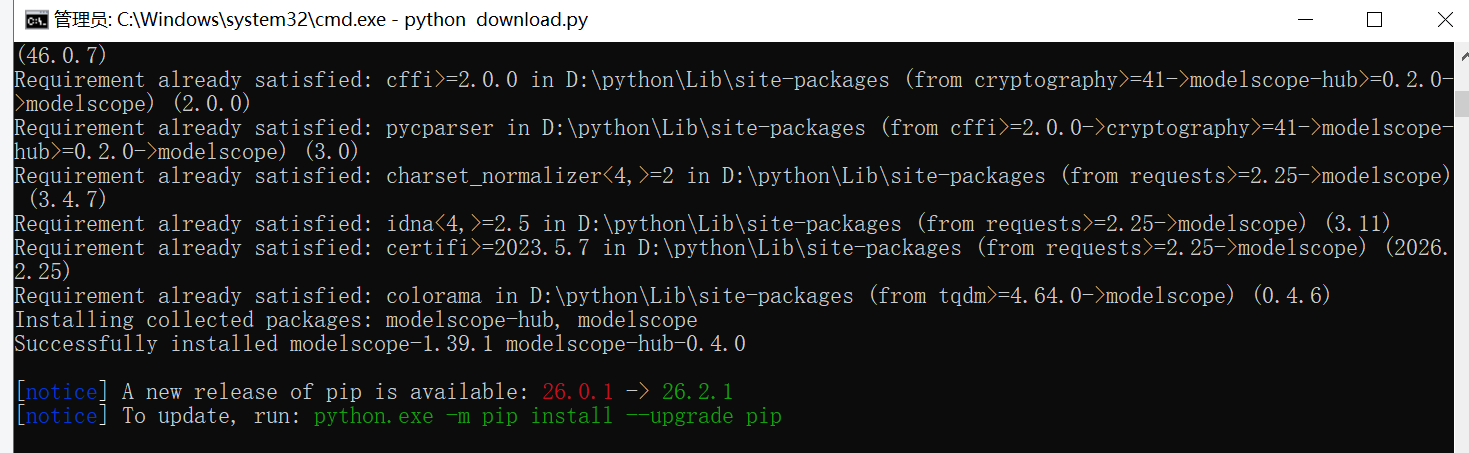
安装完这两个依赖之后 就要进入到D盘然后下载这个模型就行了,这样模型就下载到我们存在的D盘的了
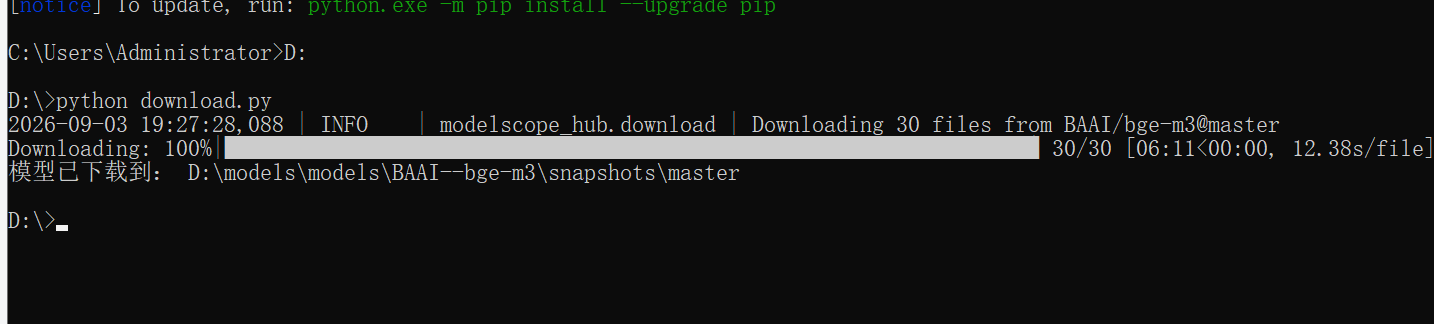
这样文件就下载好了
像.huggingface是用来专门处理向量模型的,第一步就是模型的嵌入 第二步就是计算向量(文本->模型转换->向量),第三步就是计算相似度 得到一个阈值比这个数大就得到这个数
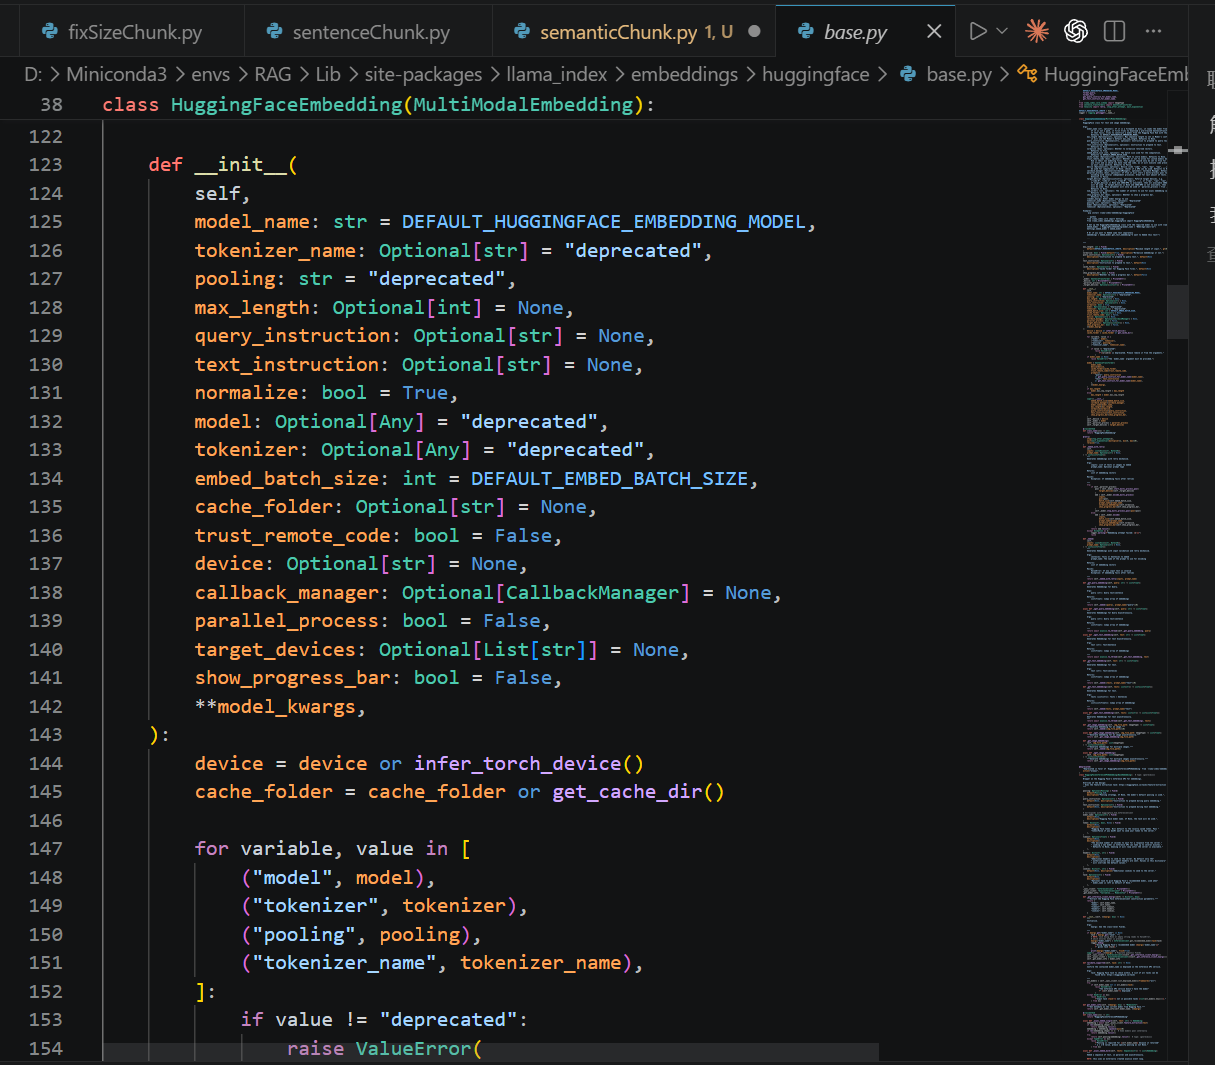
这块的源码modelname相当于我们刚才下载的嵌入模型的路径
我们现在把这个路径地址写入公共的文件配置中去
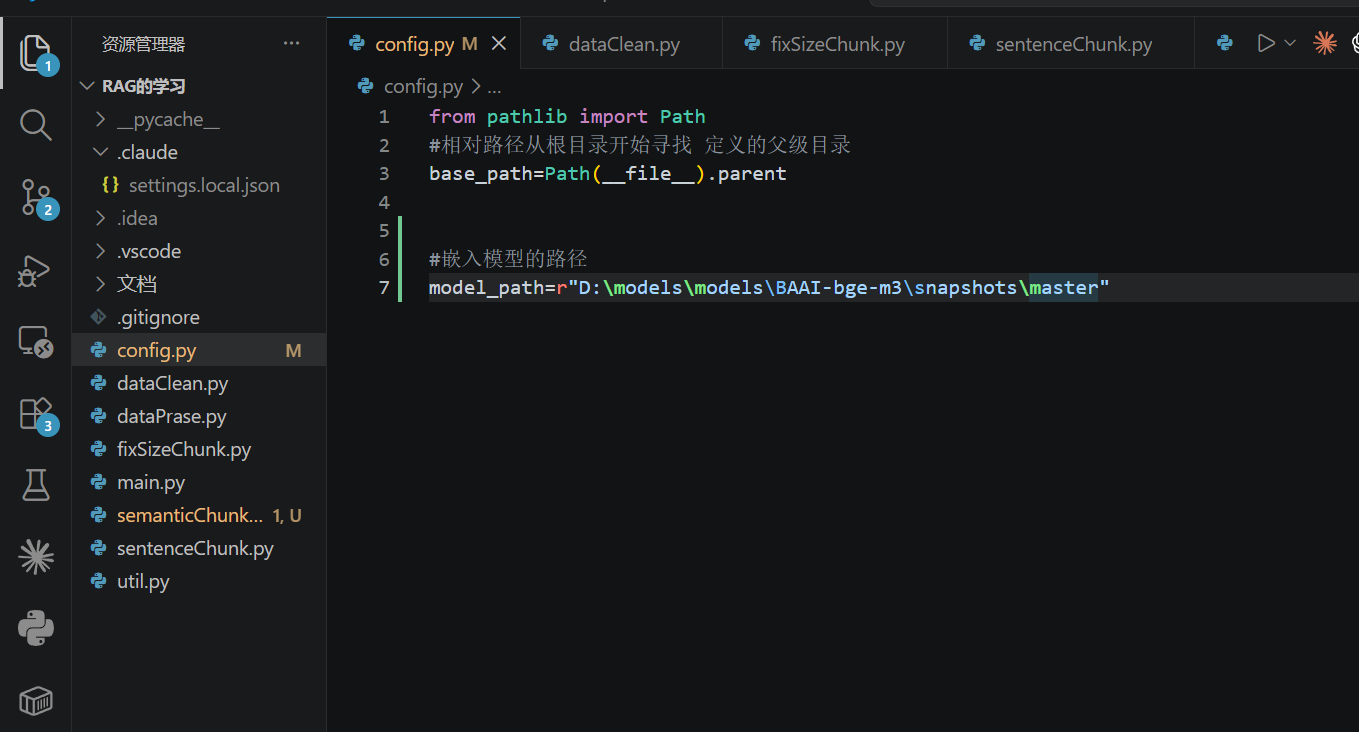
测试嵌入模型脚本的代码如下:
python
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
import config

#测试嵌入模型
def test_models(
        sentence1:str,
        sentence2:str,
)->float:
    #嵌入模型
    embed_model=HuggingFaceEmbedding(model_name=config.model_path)

    #计算文本向量
    vec1=embed_model.get_text_embedding(sentence1)
    vec2=embed_model.get_text_embedding(sentence2)

    #根据向量求相似度
    similarity=embed_model.similarity(vec1,vec2)

    #打印
    print(f"\n句子1: {sentence1}")
    print(f"向量1: (维度 {len(vec1)}) : {vec1}")
    print(f"\n句子2: {sentence2}")
    print(f"向量2: (维度 {len(vec2)}) : {vec2}")
    print(f"\n句子相似度:{similarity:.4f}")

    return similarity

if __name__ =="__main__":
    test_models("小明长得很帅!!!", "小明长得很丑!!!")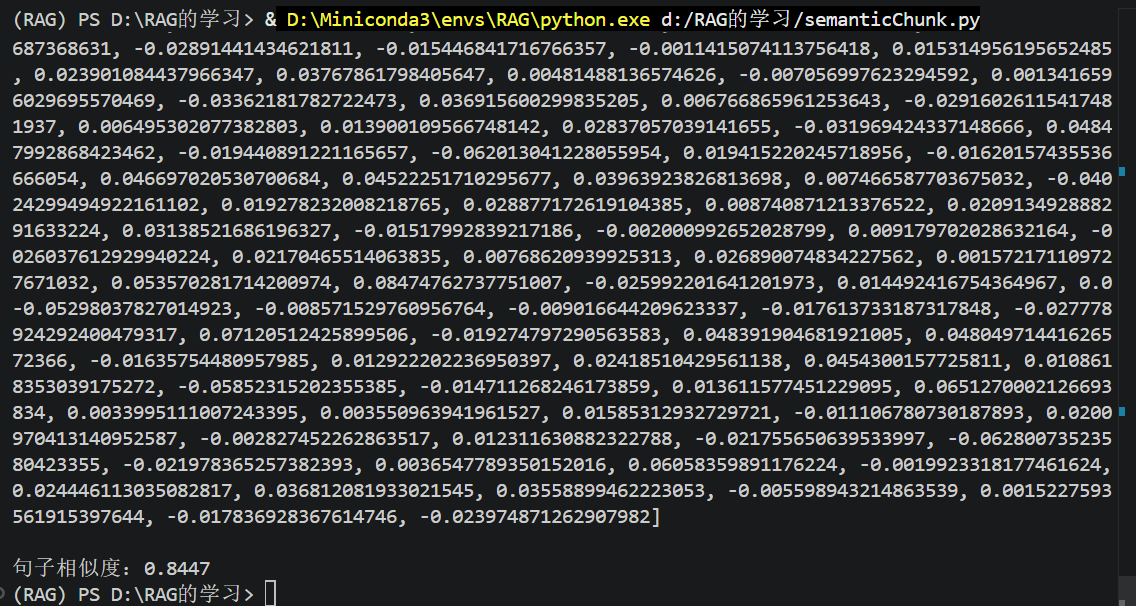
可以看到句子相似度在0.8847,他进入我们计算机中就是变成了向量,后面计算相似度的时候就是靠向量来计算了,就不需要靠纯文本了
测试完毕后,我们现在就要实现使用嵌入模型来对语义进行分块了
2.语义分块的实现:
语义分块的代码实现如下:
python
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
import config
from typing import List
from llama_index.core.schema import Document
import util
from llama_index.core.node_parser import SemanticDoubleMergingSplitterNodeParser #引入语义分块器
#测试嵌入模型
def test_models(
        sentence1:str,
        sentence2:str,
)->float:
    #嵌入模型
    embed_model=HuggingFaceEmbedding(model_name=config.model_path)

    #计算文本向量
    vec1=embed_model.get_text_embedding(sentence1)
    vec2=embed_model.get_text_embedding(sentence2)

    #根据向量求相似度
    similarity=embed_model.similarity(vec1,vec2)

    #打印
    print(f"\n句子1: {sentence1}")
    print(f"向量1: (维度 {len(vec1)}) : {vec1}")
    print(f"\n句子2: {sentence2}")
    print(f"向量2: (维度 {len(vec2)}) : {vec2}")
    print(f"\n句子相似度:{similarity:.4f}")

    return similarity


# 通过嵌⼊模型实现语义分块
def semantic_chunk_documents(
    input_str :str,
) -> List[Document]:
    #获取清洗后的目录下的所有文档
    documents=util.clean_all_formats(input_str)

    #加载嵌入的模型
    embed_model=HuggingFaceEmbedding(model_name=config.model_path)

    #进行语义分块 需要引入语义分块器
    splitter=SemanticDoubleMergingSplitterNodeParser(
        embed_model=embed_model
    )

    #执行语义分块操作
    #先创建一个分块来承接
    chunks=[]
    for d in documents:
        text=d.text
        if not text:
            continue
        #获取路径的元数据
        path=d.metadata.get("file_path")
        #进行语义的操作的切分
        nodes=splitter.get_nodes_from_documents(
            [
                Document(text=text,metadata=d.metadata)
            ]
        )
        #拼装合成语义分块
        for idx,n in enumerate(nodes):
            m=dict(n.metadata)
            m.update(
                {
                    "source_file_path":path,
                    "chunk_index":idx,# ⼀个Document可能会语义分块成多个node 想要直到你在语义分块中是第几个
                }
            )
            #进行语义分块后的拼接
            chunks.append(Document(text=n.text, metadata=m))
    for i, chunk in enumerate(chunks):
        print(f"第{i+1}个分块")
        print(chunk.metadata)
        print(chunk.text)
    return chunks


if __name__ =="__main__":
#     test_models("小明长得很帅!!!", "小明长得很丑!!!")
    semantic_chunk_documents(config.document_path)
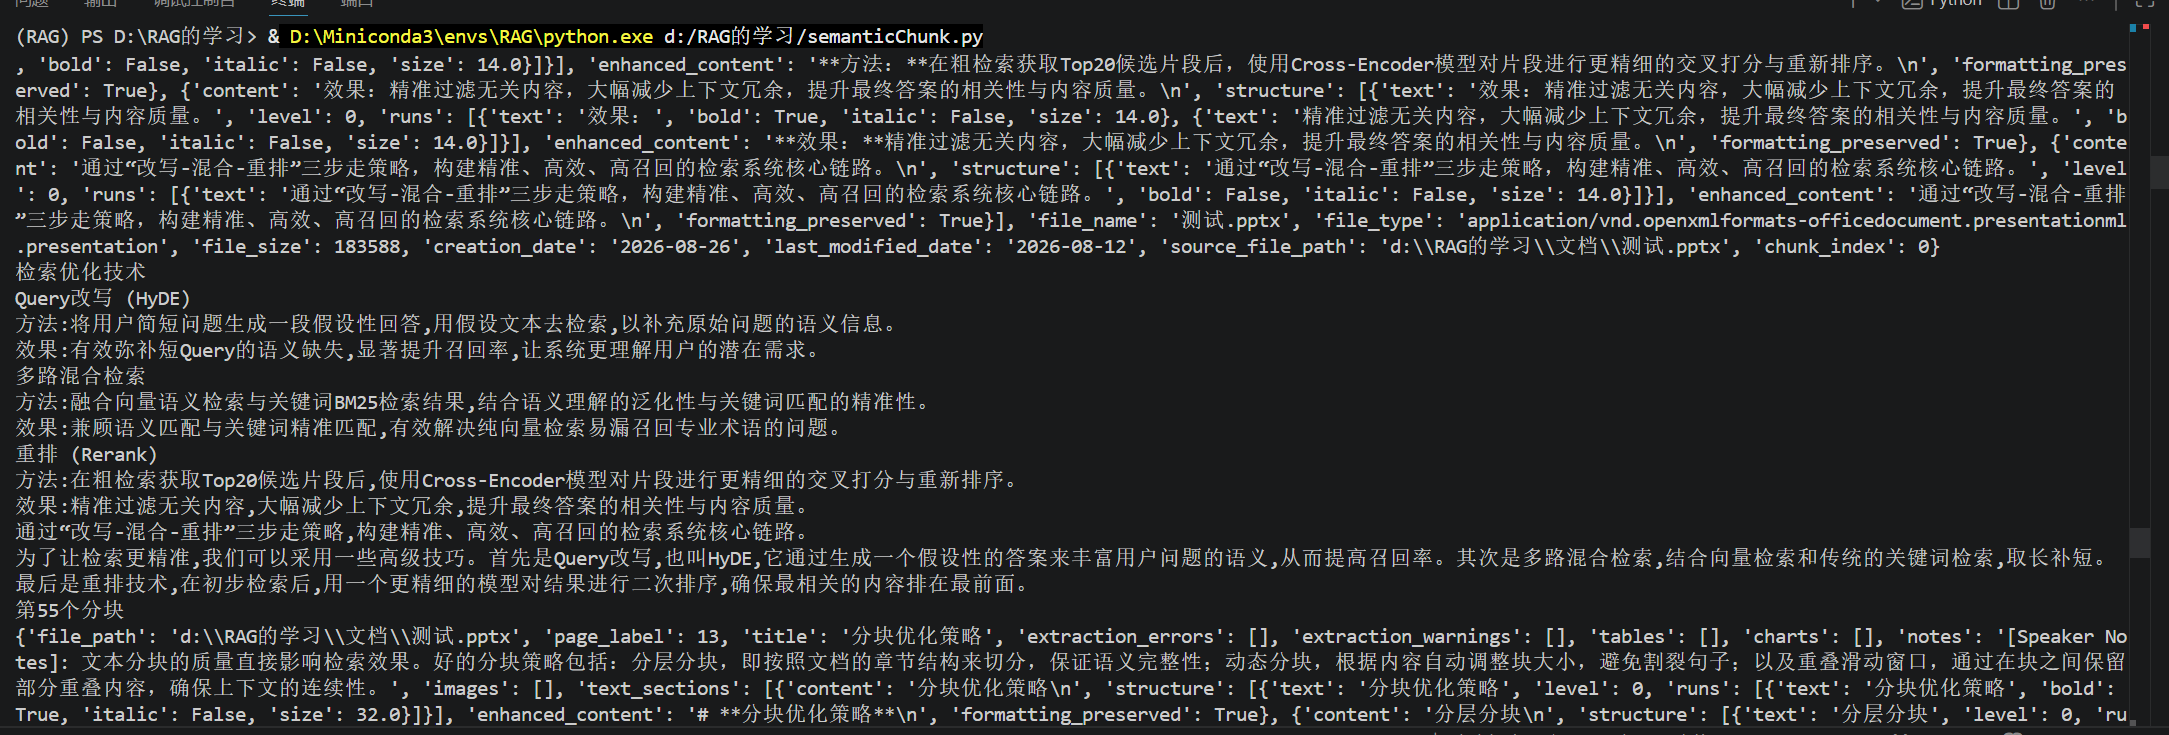
语义分块测试完毕
3.2.4 递归分块:
递归分块(Recursive Chunking),先按主题或段落初步划分,再对超⻓块递归细分,直⾄满⾜
⼤⼩限制。递归分块融合了结构化与⾮结构化处理逻辑,与固定⼤⼩的分块不同,这种⽅法保持了语 ⾔的⾃然流畅性并保留了完整的内容语义。
这里还要通过标点符号来进行就是按照主题和段落来进行划分
递归分块的实现如下,其实只是多了用一些标点符号来进行分块
python
from typing import List
from llama_index.core.schema import Document
from llama_index.core.node_parser import TokenTextSplitter
import util
import config

#递归分块
def recursive_chunk_documents(
        input_str:str
)->List[Document]:
    #获取清晰后的数据
    documents=util.clean_all_formats(input_str)

    #根据符号去划分文本
    # 分隔符优先级列表:从前到后依次尝试,越靠前越优先(语义边界越完整)
    # 段落 -> 换⾏ -> 中英⽂句末 -> 分号 -> 逗号 -> 空格 -> 单字符
    separators = [
        "\n\n", "\n",
        "。", "!", "?",
        ". ", "! ", "? ",
        ";", ";",
        ",", ",",
         " ", "",
    ]

    #创建分块器(元组)
    spliter= TokenTextSplitter(
        separator=separators[0], #首选段落进行分块
        # backup_separators 必须是列表,不能只传入 separators[1] 这个字符串
        backup_separators=separators[1:],#备用分隔符(按顺序逐级尝试)
    )

    #使用分块器来处理清洗好的文档
    chunks=[]
    for d in documents:
        text=d.text
        if not text:
            continue
        path=d.metadata.get("file_path")

        nodes=spliter.get_nodes_from_documents(
            [Document(text=text,metadata={"file_path":path})]
        )
         #拼装合成语义分块
        for idx,n in enumerate(nodes):
            m=dict(n.metadata)
            m.update(
                {
                    "source_file_path":path,
                    "chunk_index":idx,# ⼀个Document可能会语义分块成多个node 想要直到你在语义分块中是第几个
                }
            )
            #进行语义分块后的拼接
            chunks.append(Document(text=n.text, metadata=m))
    for i, chunk in enumerate(chunks):
            print(f"第{i+1}个分块")
            print(chunk.metadata)
            print(chunk.text)
    return chunks
if __name__ == "__main__":
    recursive_chunk_documents(config.document_path)
你别看这里使用递归分块的时候打印出来跟清洗后的分块都是26个分块你就觉得是一样的,其实不然
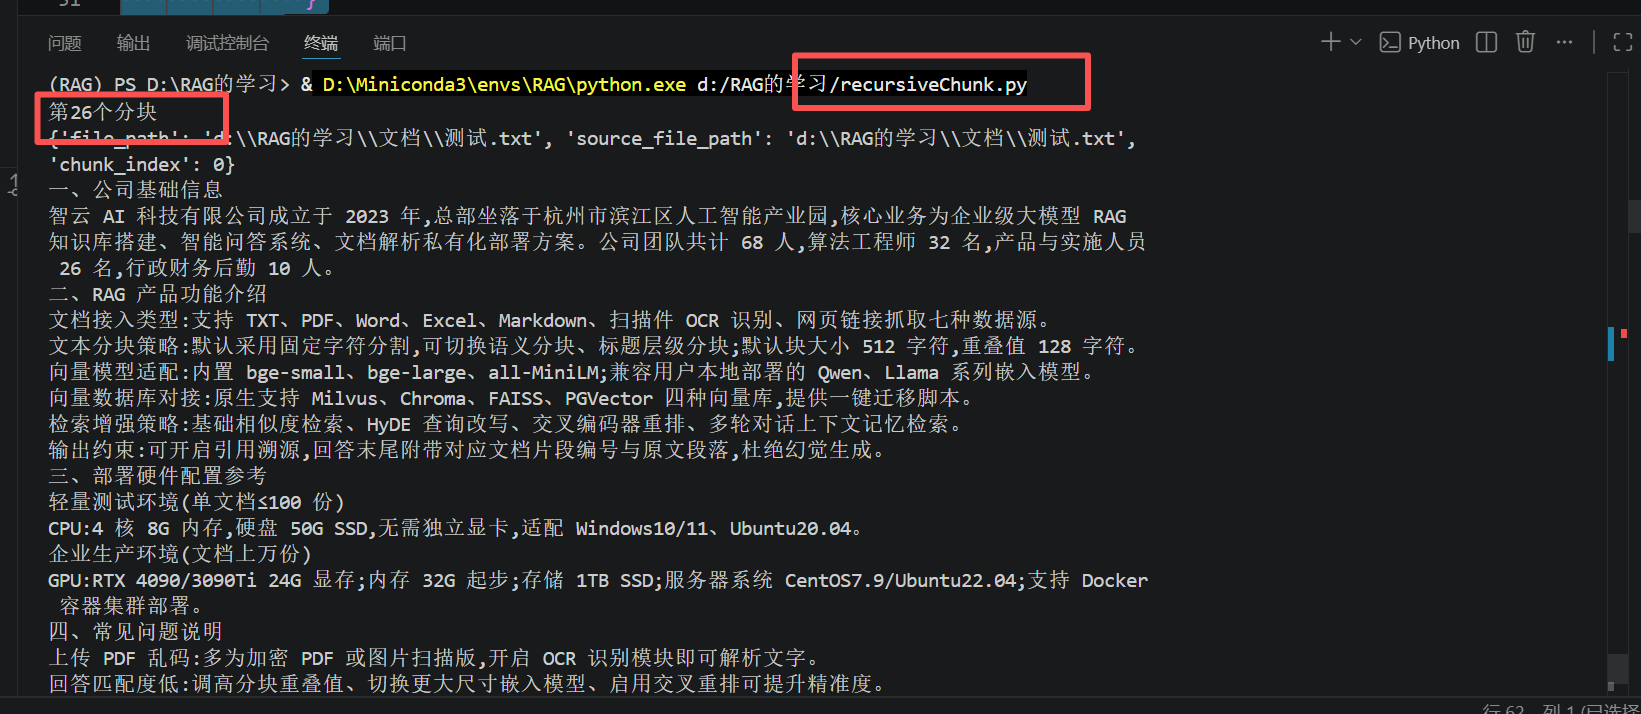
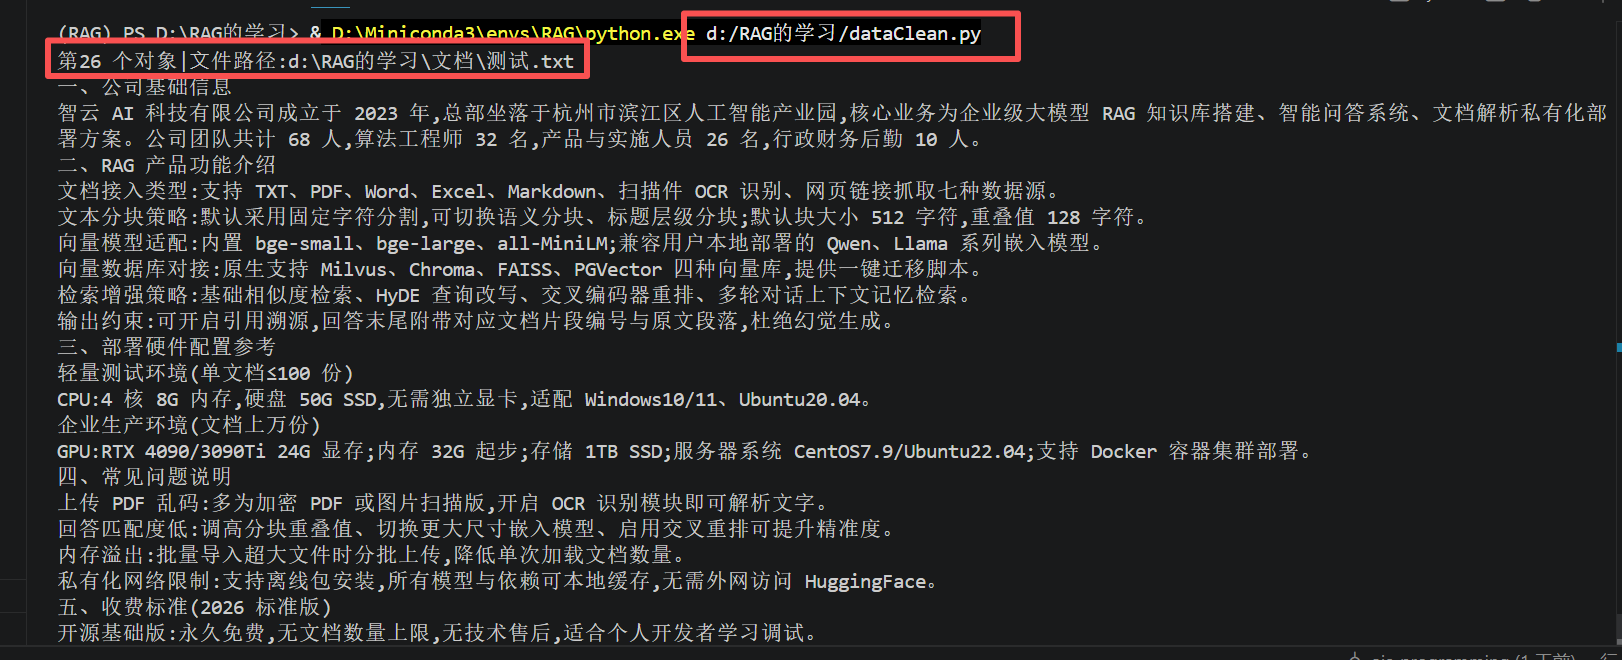
你清洗的物理文件不管你在比如.txt文件后面加了多少段落 他清理出来其实都是26个 但是递归分块不同 当年在文本后面加了内容 递归分块的话他就会增加分块了,物理文件,清洗后的文档,分块后的文档 这三个还是不一样的
在 RAG 流程中,这三个概念分别处于不同阶段:
物理文件 → 清洗后的文档 → 分块后的文档1. 物理文件
指磁盘上原始存在的文件,例如:
D:\RAG的学习\文档\产品说明书.pdf
D:\RAG的学习\文档\FAQ.docx
D:\RAG的学习\文档\data.txt
它可能包含:
- PDF、Word、Excel、Markdown 等格式
- 页眉、页脚
- 多余空格和换行
- HTML 标签
- 扫描乱码
- 重复内容
- 图片或表格
物理文件是数据的原始载体。
2. 清洗后的文档
程序读取物理文件后,将内容统一转换成 Document 对象,并清除无用内容。
例如原始文本:
    产品名称:智能音箱


页码:1


产品名称:智能音箱
清洗后可能变成:
产品名称:智能音箱清洗通常包括:
- 去除多余空格
- 合并空行
- 去除页眉页脚
- 清除 HTML 标签
- 统一换行符
- 删除空文档
- 保留文件路径等元数据
示例:
Document(
    text="产品名称:智能音箱",
    metadata={
        "file_path": "产品说明书.pdf"
    }
)
清洗后的文档仍然可能很长,通常还没有进行切分。
3. 分块后的文档
将一篇较长的清洗后文档切成多个较短的文本块,以便:
- 生成向量
- 存入向量数据库
- 进行相似度搜索
- 作为上下文提交给大语言模型
例如清洗后的文档:
产品名称:智能音箱。
智能音箱支持语音控制。
它可以播放音乐、查询天气和设置闹钟。
设备支持 Wi-Fi 和蓝牙连接。
分块后可能变成:
第 1 块:
产品名称:智能音箱。智能音箱支持语音控制。

第 2 块:
它可以播放音乐、查询天气和设置闹钟。

第 3 块:
设备支持 Wi-Fi 和蓝牙连接。
每个分块通常都有元数据:
Document(
    text="产品名称:智能音箱。智能音箱支持语音控制。",
    metadata={
        "source_file_path": "产品说明书.pdf",
        "chunk_index": 0
    }
)
4.三者的关系
| 阶段 | 内容 | 数量 |
|---|---|---|
| 物理文件 | 磁盘上的原始 PDF、Word、TXT 等 | 少 |
| 清洗后的文档 | 读取并整理后的 Document 对象 |
通常与文件数接近 |
| 分块后的文档 | 切分后的多个短 Document 或 Node |
通常比文件数多很多 |
例如:
3 个 PDF 文件
    ↓
3 个清洗后的 Document
    ↓
45 个分块后的 Document
在代码中:
documents = util.clean_all_formats(input_dir)这里得到的是清洗后的文档。
nodes = spliter.get_nodes_from_documents(documents)这里得到的是分块后的节点。
需要注意:分块不会修改原始物理文件,通常也不会修改清洗前的文档,只是根据原文生成多个较小的文本单元。
3.2.5 大模型分块:
这里我们直接使用deepseek的chat模型进行一个语义的分块,这里直接让deepseek实现了
python
#引入JSON 大模型的返回结果是JSON字符串 要解析成Python对象
import json
#引入正则 用来切分片段、以及从模型返回里抠出JSON
import re
from typing import List

from llama_index.core.schema import Document
#DeepSeek的接口兼容OpenAI 所以直接用openai这个库调 只要把base_url换掉
from openai import OpenAI

import config
import util

# ---------------------- LLM分块和前面几种分块的区别 ----------------------
# 固定大小分块:纯数字符 不管内容
# 递归分块:按标点优先级一层层退让
# 结构分块:认标题、认页码、认幻灯片
# 语义分块:看嵌入向量的相似度在哪突变
# LLM分块:把文本直接交给大模型读 由它来判断"这段话题讲到哪算完"
# 前面几种靠的都是表面特征 只有LLM是真的"读懂"了内容再决定切在哪

# ---------------------- 参数 ----------------------
# 候选片段的目标长度:片段是"交给模型判断该不该合并"的最小单位
# 片段太大 模型不好挪动边界;片段太小 编号一多模型容易数错
_MAX_PIECE_LEN = 300

# 一批最多送多少字:一次送太多模型会看漏 送太少请求次数和费用都上去了
_BATCH_CHAR_LIMIT = 2500

# 每批额外带上上一批末尾的几片当"上文" 让模型知道这批内容是接着前面的
# 这几片只给模型看 不参与分组 所以不会重复成块
_CONTEXT_PIECES = 2

# 一批最多重试几次:模型偶尔会漏片段或者编号写乱 校验不过就重来一次
_MAX_RETRY = 2

# 兜底合并时的目标块长:模型彻底罢工时自己按长度凑 尽量凑成正常大小的块
_TARGET_CHUNK_LEN = 500

# 句末标点:按这些标点切句子(用后顾断言切 标点会留在前一句结尾)
_SENTENCE_END = re.compile(r"(?<=[。!?!?;;])")

# ---------------------- 提示词 ----------------------
_SYSTEM_PROMPT = """你是一个专业的文档切分助手,负责把长文档切成一个个适合做检索的知识块。

我会把文档按顺序切成带编号的片段交给你,你要判断哪些相邻的片段讲的是同一件事,把它们合并成一个知识块。

规则:
1. 只能合并相邻的片段:不能打乱顺序、不能跳过、不能重复、也不能把单个片段拆开。
2. 每个知识块要自成一个完整的语义单元(一个知识点、一个小节、一段完整的论述),单独拿出来看也讲得通。
3. 宁可块大一点也不要切碎:讲同一主题的连续片段就该合在一起,话题明显换了才断开。
4. 必须覆盖全部片段编号,从第一个到最后一个,一个都不能落下。
5. 只输出 JSON,不要输出任何解释文字。"""

_USER_TEMPLATE = """{context}需要切分的文档片段如下(编号从 {start} 到 {end}):

{pieces}

请输出分组结果,格式为 JSON:
{{"groups": [[1, 3], [4, 4], [5, 8]]}}
每个 [起始编号, 结束编号] 表示一个知识块包含的片段范围,按顺序排好,覆盖全部编号。"""


# ---------------------- 一、准备客户端 ----------------------
# 客户端统一找util.get_llm_client()要:那里有全进程共用的缓存 密钥校验也在那儿
# 这里不自己建 免得同样的密钥检查写两份 以后改提示语漏掉一处


# ---------------------- 二、把正文切成候选片段 ----------------------
# 长段落按句末标点切开 再把小句贪心合并成不超过_MAX_PIECE_LEN的片段
def _merge_sentences(para: str) -> List[str]:
    #按句末标点切句 切完的小句标点还在结尾
    #切完再逐句strip:段落里的单个换行会被切到下一句开头 留着头尾空白只是噪声
    sentences = [s for s in (s.strip() for s in _SENTENCE_END.split(para)) if s]
    pieces = []
    buf = ""
    for s in sentences:
        #装上这一句就超长了 而且buffer里已经有内容 就先把手里的收掉
        #(buffer为空说明是单句本身就超长 只能让它自己撑成一片 免得空转)
        if buf and len(buf) + len(s) > _MAX_PIECE_LEN:
            pieces.append(buf)
            buf = ""
        buf += s
    if buf.strip():
        pieces.append(buf)
    return pieces


# 把整篇正文切成候选片段
def _split_pieces(text: str) -> List[str]:
    pieces = []
    #先按空行分段:空行是作者自己划的语义边界 比标点可靠
    for para in re.split(r"\n\s*\n", text):
        para = para.strip()
        if not para:
            continue
        #短段落整段当一片 不动它
        if len(para) <= _MAX_PIECE_LEN:
            pieces.append(para)
            continue
        #长段落内部再按句子切 不然一片太大模型没法挪边界
        pieces.extend(_merge_sentences(para))
    return pieces


# 把片段按字数分批 返回的是下标分组(每批一个下标列表)
def _make_batches(pieces: List[str]) -> List[List[int]]:
    batches = []
    cur = []
    cur_len = 0
    for i, piece in enumerate(pieces):
        #加上这一片会超出一批的上限 就另起一批
        #(cur非空才判断 保证单片超长时也能塞进某一批 不会死循环)
        if cur and cur_len + len(piece) > _BATCH_CHAR_LIMIT:
            batches.append(cur)
            cur = []
            cur_len = 0
        cur.append(i)
        cur_len += len(piece)
    if cur:
        batches.append(cur)
    return batches


# ---------------------- 三、调模型 ----------------------
# 从模型返回的文本里抠出分组结果 不合法就返回None
def _parse_groups(raw: str, n: int) -> List[List[int]] | None:
    if not raw:
        return None
    text = raw.strip()
    #模型有时候会把JSON包在```json```里 先剥掉这层壳
    m = re.search(r"```(?:json)?\s*(.+?)```", text, re.S)
    if m:
        text = m.group(1).strip()
    try:
        data = json.loads(text)
    except json.JSONDecodeError:
        return None
    #兼容两种写法:{"groups": [...]} 或者干脆直接给一个数组
    groups = data.get("groups") if isinstance(data, dict) else data
    if not isinstance(groups, list):
        return None

    #逐个检查分组 必须严格按顺序把 1..n 一个不落、不重不漏地覆盖完
    expected = 1  #下一个该被覆盖的编号
    result = []
    for g in groups:
        #兼容 [3] 这种只写一个编号的写法
        if isinstance(g, int):
            start = end = g
        elif isinstance(g, (list, tuple)) and len(g) == 2:
            start, end = g
        else:
            return None
        #编号必须是整数 顺序要接得上 范围要在1..n之内
        if not (isinstance(start, int) and isinstance(end, int)):
            return None
        if start != expected or end < start or end > n:
            return None
        result.append([start, end])
        expected = end + 1

    #必须刚好覆盖到第n片 少一片都算不合格(宁可重试 也不放半个分组进去)
    if expected != n + 1:
        return None
    return result


# 兜底分组:模型没给出合法结果时 不靠模型 按目标长度把这几片贪心合并
def _fallback_groups(pieces: List[str], batch: List[int]) -> List[List[int]]:
    groups = []
    start = 1  #分组里用的是批内编号(从1开始) 不是整体下标
    cur_len = 0
    for k, i in enumerate(batch, start=1):
        #手里有内容 再加一片就超长了 就把手里的先收成一个块
        #(cur_len为0说明是这一批的第一片 再长也得先装着)
        if cur_len and cur_len + len(pieces[i]) > _TARGET_CHUNK_LEN:
            groups.append([start, k - 1])
            start = k
            cur_len = 0
        cur_len += len(pieces[i])
    groups.append([start, len(batch)])
    return groups


# 把一批片段交给模型分组 返回批内的分组结果(编号从1开始) 失败返回None
def _ask_llm(
        client: OpenAI,
        pieces: List[str],
        batch: List[int],
        prev: List[int],
) -> List[List[int]] | None:
    #上一批末尾的几片当上文 让模型知道这批是接着前面写的
    #标成[上文]是提醒模型:这是背景 不用你处理、也别给它编号
    context = ""
    if prev:
        context = "上文(这批片段接着下面的内容往下,只作参考,不用你处理):\n" + "\n".join(
            f"[上文] {pieces[i]}" for i in prev
        ) + "\n\n"

    #给这一批的片段编上号 编号从1开始 模型返回的就是这套编号
    body = "\n\n".join(f"[{k}] {pieces[i]}" for k, i in enumerate(batch, start=1))
    user = _USER_TEMPLATE.format(
        context=context, start=1, end=len(batch), pieces=body
    )

    resp = client.chat.completions.create(
        model=config.deepseek_model,
        messages=[
            {"role": "system", "content": _SYSTEM_PROMPT},
            {"role": "user", "content": user},
        ],
        #温度取自config:分块是个判断题 不需要模型发挥
        temperature=config.deepseek_temperature,
        #强制接口返回合法JSON 省得去解析模型自由发挥的文本
        response_format={"type": "json_object"},
    )
    return _parse_groups(resp.choices[0].message.content, len(batch))


# ---------------------- 四、对外接口 ----------------------
# 用LLM把文档切成一个个语义完整的分块
def llm_chunk_documents(
        input_str: str,
) -> List[Document]:
    #先把密钥和客户端准备好 免得文档都解析完了才发现密钥没填
    client = util.get_llm_client()

    #获取清洗后的目录下的所有文档
    documents = util.clean_all_formats(input_str)

    chunks = []
    for doc_index, d in enumerate(documents, start=1):
        text = (d.text or "").strip()
        #获取路径的元数据
        path = d.metadata.get("file_path")
        if not text:
            print(f"跳过空文档: {path}", flush=True)
            continue

        #第一步:把正文切成候选片段 再按字数分批
        pieces = _split_pieces(text)
        if not pieces:
            continue
        batches = _make_batches(pieces)
        print(
            f"正在LLM分块 ({doc_index}/{len(documents)}): {path} "
            f"共{len(pieces)}个片段 分{len(batches)}批",
            flush=True,
        )

        #当前文档的分块序号
        idx = 0
        for b, batch in enumerate(batches, start=1):
            #上一批末尾的几片当上文(第一批没有上文 就是空列表)
            prev = list(range(max(0, batch[0] - _CONTEXT_PIECES), batch[0]))

            #调模型拿分组结果 失败或者结果不合法就重试 重试用完就兜底
            groups = None
            for attempt in range(_MAX_RETRY + 1):
                try:
                    groups = _ask_llm(client, pieces, batch, prev)
                except Exception as e:
                    #接口报错(网络、限流、余额)也当这一批失败 走重试
                    print(
                        f"  第{b}批调用失败(第{attempt + 1}次): "
                        f"{type(e).__name__}: {e}",
                        flush=True,
                    )
                    groups = None
                if groups:
                    break
            if not groups:
                #重试也没拿到合法分组 就自己按长度贪心合并兜底
                #(宁可块切得糙一点 也不能因为接口抽风就把这批内容整个丢掉)
                print(f"  第{b}批没拿到合法分组 改用贪心合并兜底", flush=True)
                groups = _fallback_groups(pieces, batch)

            #第二步:按分组把片段拼成一个个分块
            for start, end in groups:
                #分组里是批内编号 换成整体下标要减1(结束编号转下标后要加回来 因为是闭区间)
                first = batch[start - 1]
                last = batch[end - 1]
                #片段之间用空行隔开 保住原来的段落感
                content = "\n\n".join(pieces[first:last + 1]).strip()
                if not content:
                    continue

                m = dict(d.metadata)
                m.update({
                    "source_file_path": path,
                    "chunk_index": idx,
                    #这个块覆盖了全文的第几片到第几片(从1开始) 方便回原文核对
                    "piece_start": first + 1,
                    "piece_end": last + 1,
                })
                chunks.append(Document(text=content, metadata=m))
                idx += 1

    for i, chunk in enumerate(chunks):
        print(f"第{i+1}个分块")
        print(chunk.metadata)
        print(chunk.text)
    return chunks


if __name__ == "__main__":
    llm_chunk_documents(config.document_path)
python
from llama_index.core import SimpleDirectoryReader
from typing import Iterator, List
from llama_index.core.schema import Document

import config
#把目录下面的文件全部解析出来
#定义方法  加载并解析一个目录下的所有文件
def pare_all_formats(input_dir):
    #传递要解析的文件夹给这个包中的函数
    reader=SimpleDirectoryReader(
        input_dir=input_dir
    )

    #因为是封装的方法  我们这里就不需要打印  直接就是进行调用即可
    return reader.load_data()

#把目录下所有文件进行清洗方法的封装
def clean_all_formats(input_dir)->List[Document]:
    import dataClean

    #解析所有目录下的文件
    docs=pare_all_formats(input_dir)
    # 清洗之后的对象数组
    cleaned_docs = []
    #遍历解析后的对象然后清洗 然后把清洗后的数据放入新的document对象
    for i, doc in enumerate(docs):
        cleand_doc = dataClean.clean_doc(doc)
        cleaned_docs.append(cleand_doc)

    return cleaned_docs


# ==================== LLM 对话封装(DeepSeek) ====================
# 前面那些函数是"把文档读进来" 这里开始是"把话发给模型"
# 几个函数返回的都是生成器(yield)而不是拼好的整段字符串:
# 流式的重点就是模型吐一个字你就显示一个字 不用等整段生成完才看到东西
# 调用方拿到生成器自己决定怎么用 ------ 打到终端、推到前端、边收边处理都行

# 整个进程共用一个客户端 不用每次对话都重建
# 客户端内部带连接池 复用同一个对象才能复用连接 流式请求尤其吃这个
_llm_client = None


# 取(或第一次创建)DeepSeek 客户端
def get_llm_client():
    global _llm_client
    #已经建过就直接返回 后面再调用不会重复建
    if _llm_client is not None:
        return _llm_client

    #放在函数里导入 这样用不到LLM的模块(固定大小分块、结构分块)不会被动拖上这个依赖
    from openai import OpenAI

    api_key = config.deepseek_api_key
    #占位符还没换掉 或者压根没填 都当没配置
    if not api_key or "在这里填写" in api_key or not api_key.startswith("sk-"):
        raise RuntimeError(
            "还没配置 DeepSeek 密钥。请在项目根目录的 .env 文件里填一行:\n"
            "  DEEPSEEK_API_KEY=sk-你的密钥\n"
            "(没有 .env 就照着 .env.example 复制一份。该文件已被 .gitignore 忽略 不会提交)\n"
            "密钥申请地址:https://platform.deepseek.com/api_keys"
        )

    # DeepSeek的接口是OpenAI兼容的 所以换个base_url就能用同一个SDK
    _llm_client = OpenAI(api_key=api_key, base_url=config.deepseek_base_url)
    return _llm_client


# 流式对话的底层实现:把messages发出去 模型吐一段就yield一段
# 外面两个函数最后都落到这里 区别只是messages怎么攒出来的
def _stream_chat(messages: List[dict], temperature: float = None) -> Iterator[str]:
    client = get_llm_client()
    resp = client.chat.completions.create(
        model=config.deepseek_model,
        messages=messages,
        #不传温度就用配置里的对话温度(比分块的0高 聊天要有点发挥)
        temperature=config.deepseek_chat_temperature if temperature is None else temperature,
        #打开流式 接口会把回复拆成一小段一小段陆续返回
        stream=True,
    )
    for chunk in resp:
        #流式返回的最后几个chunk可能只有用量统计 没有内容 这种跳过
        if not chunk.choices:
            continue
        piece = chunk.choices[0].delta.content
        #有些chunk的增量是空的(比如第一个chunk只告诉你角色是assistant) 空的就别往外yield
        if piece:
            yield piece


# 单轮对话 流式输出
def chat_stream(
        user_prompt: str,
        #系统提示词:规定模型扮演什么角色、用什么口气说话 不用就传None
        system_prompt: str = None,
        #不传就用config里的对话温度
        temperature: float = None,
) -> Iterator[str]:
    messages = []
    #系统提示词放在最前面 它管的是整场对话的基调
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": user_prompt})
    yield from _stream_chat(messages, temperature)


# 多轮对话 流式输出:messages列表就是对话历史 函数负责把这一轮的问和答记进去
# 用法:自己建一个messages=[] 每轮把它传进来 上下文就自动接上了
def multi_turn_chat_stream(
        messages: List[dict],
        user_prompt: str,
        system_prompt: str = None,
        temperature: float = None,
) -> Iterator[str]:
    #系统提示词只在第一轮插一次 后面几轮就算又传进来也不会重复插
    if system_prompt and not (messages and messages[0].get("role") == "system"):
        messages.insert(0, {"role": "system", "content": system_prompt})

    #先把用户这一问记进历史 模型才能看到前面聊过什么
    messages.append({"role": "user", "content": user_prompt})

    #一边往外吐一边把完整回答攒起来 攒完了要作为模型的回答记回历史
    answer = ""
    for piece in _stream_chat(messages, temperature):
        answer += piece
        yield piece

    #能走到这行说明流读完了 把模型的回答记进历史 下一轮才接得上
    #(调用方要是中途break了就到不了这行 这轮不完整的回答不会进历史)
    messages.append({"role": "assistant", "content": answer})


if __name__ == "__main__":
    #演示:下面会真的调DeepSeek接口 跑之前确认.env里的密钥是好的
    print("=== 1. 单轮对话(流式输出)===")
    for piece in chat_stream(
        "用一句话说明什么是RAG",
        system_prompt="你是一个简洁的技术助手 回答不要超过50字",
    ):
        # end=""表示不换行 flush=True表示立刻打出来 不然会攒在缓冲区里看不出"流"的效果
        print(piece, end="", flush=True)
    print()

    print("\n=== 2. 多轮对话(流式输出)===")
    #整场对话就共用这一个列表 它既是入参也是出参 上下文都记在里面
    history = []
    for question in ("我叫小明", "我叫什么名字?"):
        print(f"\n我: {question}")
        print("AI: ", end="", flush=True)
        for piece in multi_turn_chat_stream(
            history, question,
            system_prompt="你是一个简洁的助手",
        ):
            print(piece, end="", flush=True)
        print()

    #跑完看看历史里攒了什么:system、user、assistant 一问一答地排着
    print("\n=== 对话历史 ===")
    for msg in history:
        print(f"[{msg['role']}] {msg['content']}")
这个是util文件里面还封装了调用大模型的一些方法,比如单轮对话流式输出,多轮对话流式输出
3.3 向量嵌入:
3.3.1 余弦相似度:
余弦相似度是计算两个向量之间夹⻆的余弦值。余弦距离(Cosine distance)就是⽤1减去这个获得
的余弦相似度。取值范围 −1,1
• 计算公式:
cos(θ)=∣∣a∣∣×∣∣b∣∣a ⋅ b
• 逻辑:只看向量⽅向夹⻆,忽略向量⻓度(模⻓)。
• 适⽤场景:
◦ 绝⼤多数⽂本 Embedding(OpenAI、BGE、Sentence-BERT 等);
◦ ⽂本语义匹配,只关⼼语义⽅向,不关⼼向量⻓度;
• 取值范围: -1, 1 ,越接近 1 代表语义越相似,数值越⼤越相似。
• LlamaIndex 默认⽤它,是⼯业界 RAG 标准⽅案。
我们这里使用的是封装好的一个余弦相似度的计算
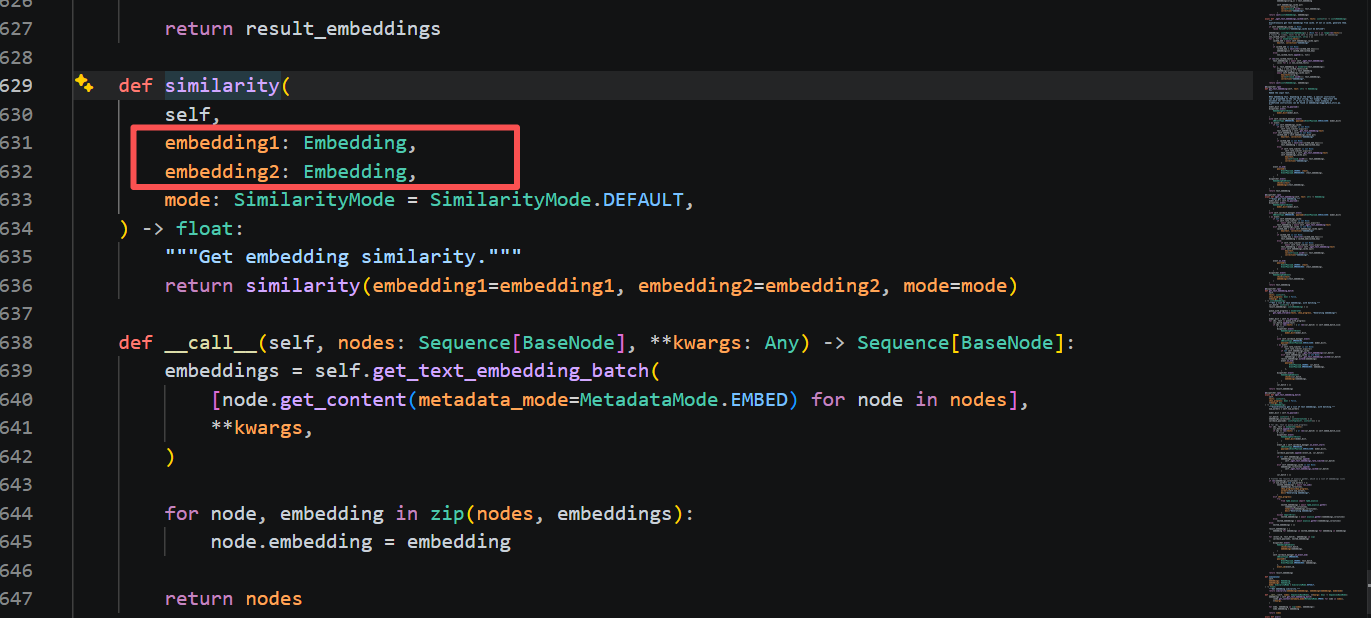
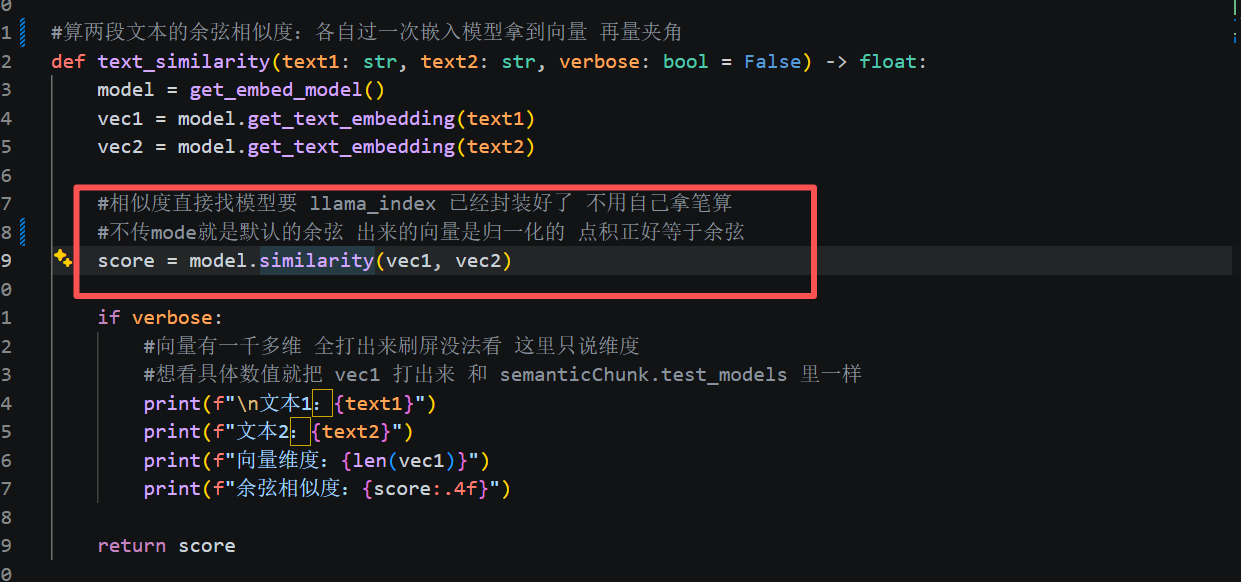
这里只需要传入两个语义文本即可,不去穿第三个参数就是去计算的余弦相似度
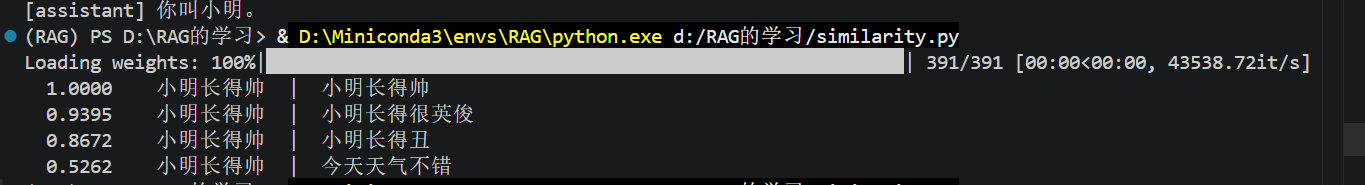
测试一下相似度 越接近1相似度越高
3.3.2 欧氏距离:
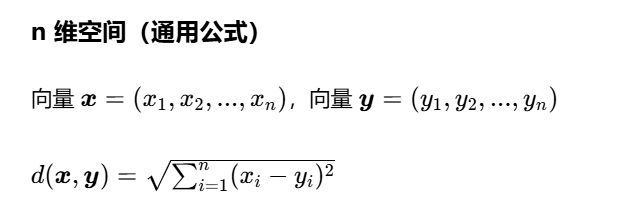
欧式距离,就是把 "⽂档向量" 和 "查询向量" 当成⾼维空间⾥的两个点,算它们之间的直线
距离;距离越⼩,说明⽂本越相似。取值范围 [0,+ ∞ )
•
计算公式:
•
逻辑:计算向量空间两点的直线距离,数值越⼩越相似(和余弦 / 点积相反)。
• 适⽤场景:
◦ 图像、数值特征向量;
◦ 很少⽤于⽂本 Embedding,⽂本向量⾼维下欧⽒距离区分度很差;
• 向量库内部会⾃动转换距离为相似度打分,业务层不⽤⼿动换算。
这里我们需要注意的是如果你传了第三个参数那么说明你要去计算欧式距离了
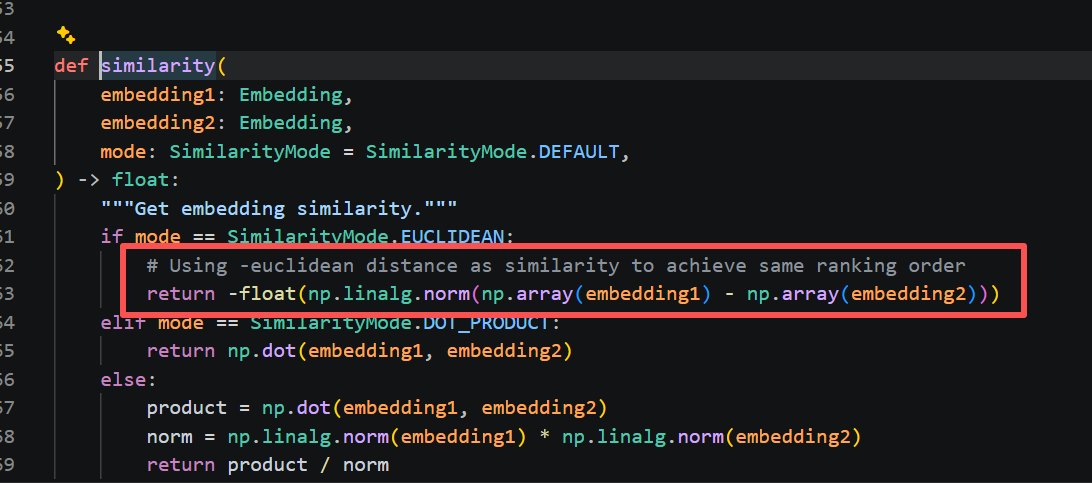
这里需要注意的是他的返回值是负数 就是为了适应值越大越相似,这里是故意这样设计的,只有欧式距离是相反的,也就是数值越小相似度越高 所以这里加上了负号代表数字越大这里相似度越高 就是为了一个统一的排序逻辑
3.3.3点积距离:
点积距离(Dot Product Distance)其实就是:⽤两个向量的点积来衡量相似度,值越⼤越相似。
• 计算公式:
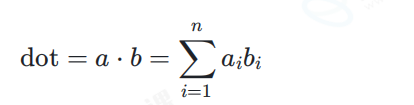
• 逻辑:同时兼顾向量⽅向 + 向量⻓度。
• 适⽤场景:
◦ 做过归⼀化(L2 Norm) 的向量:归⼀化后点积 = 余弦相似度;
◦ 模型输出向量⾃带⻓度表征重要性的场景(部分⾃研 Embedding);
• 注意:未归⼀化向量不能随便⽤,⻓向量会天然得分更⾼,⼲扰语义匹配。
点击距离越大越相似
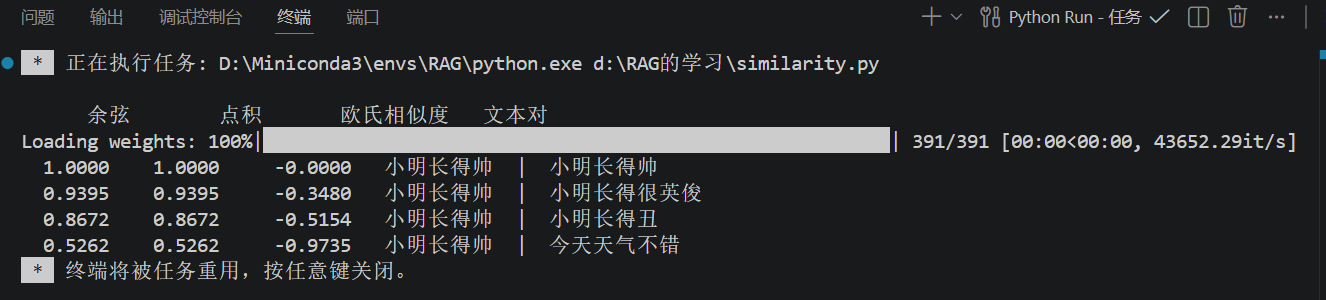
整个的向量嵌入也就搞定了,主要还是基于封装好的llmaindex中的similary函数的进行一个调用
python
# ==================== 两段文本的相似度:余弦 / 欧氏 / 点积 ====================
# 思路:嵌入模型把一段文本压成一个向量(一串数) 这个向量的方向就代表这段话的意思
# 于是"两段话像不像"就变成了"两个向量像不像" 用下面三把尺子去量
#
# 尺子一:余弦相似度 ------ 量两个向量的夹角
#    1  方向完全一致 ------ 讲的是同一件事
#    0  方向垂直     ------ 两段话毫无关系
#   -1  方向完全相反 ------ 意思正好相反(实际用嵌入模型很少见负值 大多落在 0~1 之间)
#   只看方向不看长短:同一句话写长一点写短一点 只要讲的还是那件事 分数依然高
#
# 尺子二:欧氏相似度 ------ 量两个向量端点之间的直线距离 再取负当相似度
#    0      两个向量完全重合 ------ 意思最接近(距离为0 取负还是0 所以它是最大的)
#    越小   离得越远         ------ 意思差得越多(带了负号 距离越大这个值反而越小)
#   取负是框架特意做的 为的是跟余弦统一口径:所有模式都是"越大越像"
#   口径统一了 调用方换模式时不用改排序逻辑 同一句"从大到小取前N条"到哪都成立
#
# 尺子三:点积相似度 ------ 两个向量对应位置相乘 再把结果全部加起来
#    越大越像:方向越一致、向量越长 点积就越大
#   注意它方向管 长短也管 两样都算进去 所以严格讲它不是个纯粹的"像不像"
#   (余弦把长短约掉了 距离把长短算进分母 点积是长短直接乘在上面)
#
# ==================== 三把尺子在本项目里的实际关系 ====================
# 本项目的 HuggingFaceEmbedding 默认 normalize=True 出来的向量长度都是 1
# 长度是1的时候有两条换算关系:
#   点积 = 1 × 1 × 余弦 = 余弦            ------ 点积和余弦是同一个数
#   距离 = √(2 - 2×余弦)                  ------ 欧氏相似度就是它取负
# 拿实测数对一下:余弦0.9395 → 欧氏相似度 -√(2-1.879) = -0.3480 跟跑出来的一致
#
# 所以此刻三把尺子量出来的"远近顺序"完全一样 只是刻度不同
# 也正因如此 向量库普遍爱用点积:既然归一化之后跟余弦等价
#   那就犯不着再去求两次模长、做一次除法 直接乘加一遍最省事
# 反过来说 哪天把归一化关了(normalize=False) 点积立刻和余弦分家
#   长向量会因为"长"而拿到更高的点积 这时候再用点积排序就不公平了

import config
from llama_index.core.base.embeddings.base import SimilarityMode
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

#嵌入模型整个进程只加载一次
#加载要读几百M到几个G的权重文件 每算一次相似度就重新加载一次 慢得没法用
_embed_model = None


#取(或第一次创建)嵌入模型
def get_embed_model() -> HuggingFaceEmbedding:
    global _embed_model
    if _embed_model is None:
        #模型路径来自config:config.model_path 里填的是哪个模型 这里用的就是哪个模型
        #要换模型(比如换成Qwen的嵌入模型)只改config那一行 这个文件不用动
        _embed_model = HuggingFaceEmbedding(model_name=config.model_path)
    return _embed_model


#算两段文本的余弦相似度:各自过一次嵌入模型拿到向量 再量夹角
def text_similarity(text1: str, text2: str, verbose: bool = False) -> float:
    model = get_embed_model()
    vec1 = model.get_text_embedding(text1)
    vec2 = model.get_text_embedding(text2)

    #相似度直接找模型要 llama_index 已经封装好了 不用自己拿笔算
    #不传mode就是默认的余弦 出来的向量是归一化的 点积正好等于余弦
    score = model.similarity(vec1, vec2)

    if verbose:
        #向量有一千多维 全打出来刷屏没法看 这里只说维度
        #想看具体数值就把 vec1 打出来 和 semanticChunk.test_models 里一样
        print(f"\n文本1:{text1}")
        print(f"文本2:{text2}")
        print(f"向量维度:{len(vec1)}")
        print(f"余弦相似度:{score:.4f}")

    return score


#算两段文本的欧氏相似度:各自过一次嵌入模型拿到向量 再量端点之间的直线距离
def text_euclidean_similarity(text1: str, text2: str, verbose: bool = False) -> float:
    model = get_embed_model()
    vec1 = model.get_text_embedding(text1)
    vec2 = model.get_text_embedding(text2)

    #EUCLIDEAN模式返回的是"负的距离" 看着别扭 但这是框架故意的 别去翻它
    #它要让所有模式统一成"越大越像":余弦本来就是越大越像 而距离是越小越近
    #统一口径之后 用的人换模式时不用改排序逻辑 "从大到小取前N条"这句到哪都成立
    score = model.similarity(vec1, vec2, mode=SimilarityMode.EUCLIDEAN)

    if verbose:
        print(f"\n文本1:{text1}")
        print(f"文本2:{text2}")
        print(f"向量维度:{len(vec1)}")
        print(f"欧氏相似度(负的距离):{score:.4f}")

    return score


#算两段文本的点积相似度:各自过一次嵌入模型拿到向量 再逐位相乘求和
def text_dot_product_similarity(text1: str, text2: str, verbose: bool = False) -> float:
    model = get_embed_model()
    vec1 = model.get_text_embedding(text1)
    vec2 = model.get_text_embedding(text2)

    #DOT_PRODUCT模式返回的就是点积本身 框架一点没加工
    #(不像EUCLIDEAN那样还替你翻个符号)拿到什么就是什么 不用换算
    score = model.similarity(vec1, vec2, mode=SimilarityMode.DOT_PRODUCT)

    if verbose:
        print(f"\n文本1:{text1}")
        print(f"文本2:{text2}")
        print(f"向量维度:{len(vec1)}")
        print(f"点积相似度:{score:.4f}")

    return score


if __name__ == "__main__":
    #几组对照:一样、相近、相反、无关 看三把尺子是不是同步走
    pairs = [
        ("小明长得帅", "小明长得帅"),
        ("小明长得帅", "小明长得很英俊"),
        ("小明长得帅", "小明长得丑"),
        ("小明长得帅", "今天天气不错"),
    ]
    print(f"{'余弦':>8}  {'点积':>8}  {'欧氏相似度':>10}   文本对")
    for a, b in pairs:
        cos = text_similarity(a, b)
        dot = text_dot_product_similarity(a, b)
        euclid = text_euclidean_similarity(a, b)
        print(f"{cos:8.4f}  {dot:8.4f}  {euclid:10.4f}   {a}  |  {b}")
3.3.4 向量数据库:
1.什么是向量数据库:
向量数据库是专⻔存储、索引、检索⾼维 Embedding 向量的专⽤数据库,核⼼作⽤是快速做相似
度匹配,弥补传统关系型数据库不擅⻓⾼维浮点数组⽐对的短板。
我们之前学习的MySQL,redis,sqlite 这些都是关系型数据库,这个的话他是可以存储向量数据的,但是效率不高,因为归一之后数据后面的小数点特别长,引入向量数据库的话可以计算向量相似度:
- 0.03807787224650383 , - 0.002669620094820857 , 3 - 0.00038058828795328736 , 0.031184565275907516 , - 0.02876528911292553 , ...................., 0.030514752492308617 , 0.03327701613306999 , - 0.01747242547571659 , - 0.029959438368678093 , - 0.00964059866964817
常⻅的向量数据库有如下种类:
HNSW:⼯业最主流,速度、精度均衡(Milvus、Chroma、Pinecone)
FAISS IVF:Facebook 开源,适合批量⼤规模数据
Annoy、DiskANN:适合磁盘⼤容量存储
我们使⽤Milvus : 快速入门 | Milvus 文档
2.Milvus与MySQL核⼼概念对⽐和区别:
| Milvus | MySQL |
|---|---|
| Collection 集合 | Table 数据表 |
| Entity 实体 | Row 行记录 |
| Field 字段 | Column 列 |
| Partition 分区 | 分表 / 分区表 |
| Segment | 磁盘数据文件 |
| Shard 分片 | 分库分表 |
| Proxy | MySQL Proxy 网关 |
| QueryNode | 查询执行器 |
| etcd 元数据 | 系统库 information_schema |
| 对象存储 | 磁盘数据目录 |
| 对比项 | 传统关系型数据库 | 向量数据库 |
|---|---|---|
| 存储对象 | 字符串、数字、表格 | 高维浮点向量 |
| 查询方式 | 精确匹配、模糊关键词 | 近似相似度匹配 |
| 适用场景 | 订单、用户、业务台账 | RAG 知识库、图文检索、推荐 |
| 高维性能 | 上万维检索极慢,全量遍历 | 内置索引算法,亿级向量秒查 |
3.下载Milvus-Lite:
pip install milvus-lite pymilvus -i https://pypi.tuna.tsinghua.edu.cn/simple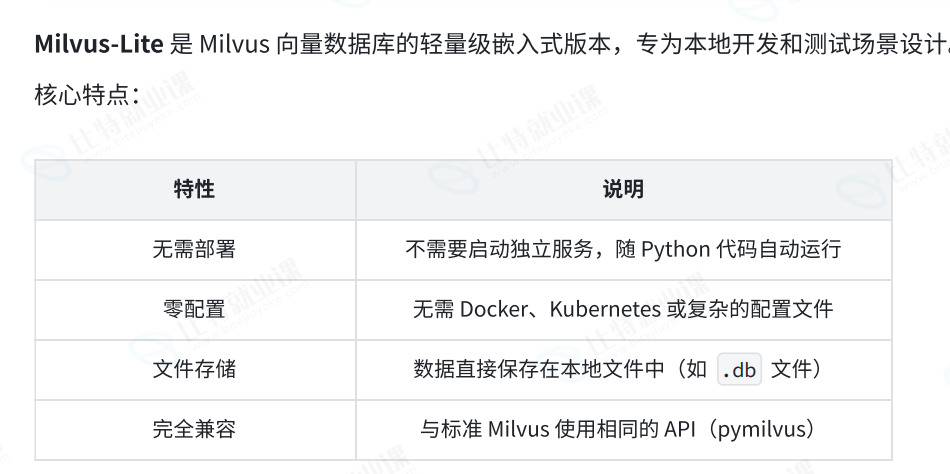
注释:pymilvus 是 python 调用 milvus 的 SDK
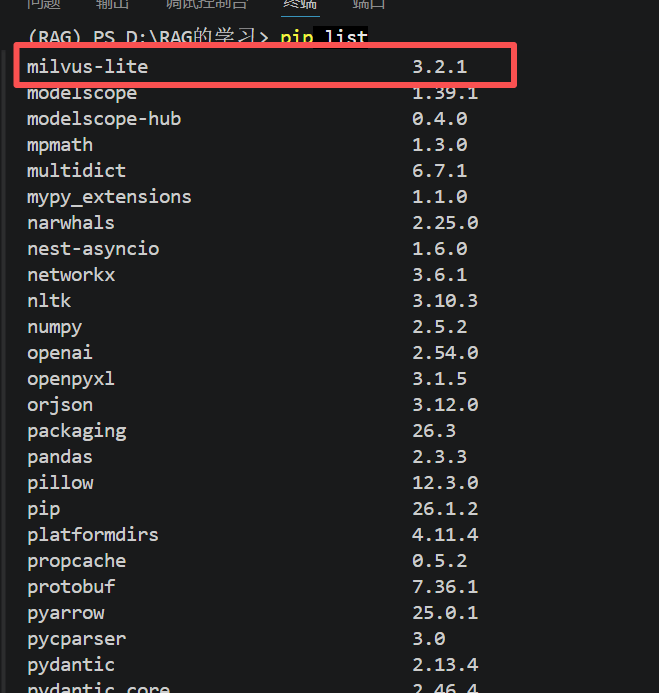
这里也就安装完毕了
4.封装常见向量数据库的操作
这里需要注意的是同一个collection中需要保障向量的维度一致 跟我们MySQL建表的时候先去声明字段是一样的,而且我们封装向量数据库的操作的时候不仅只封装像关系数据库那种增删改查 还要去封装像向量数据库那种可以向量查询的那种,引入向量数据库,可以省去计算文本向量的环节
python
from pymilvus import MilvusClient, DataType
#LoadState不在pymilvus顶层 得从子模块拿(顶层只有MilvusClient、DataType这些常用的)
from pymilvus.client.types import LoadState
import config
from typing import List
from typing import Any
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

client:MilvusClient=None

# ==================== 嵌入模型 ====================
# 向量库只认数字不认字:存进去的得是向量 查的时候也得先把问题变成向量
# 所以这一层要配一个嵌入模型 有两个地方要用:
#   第6步建collection时------靠它知道"向量该是多少维"
#   第10步向量查询时------把查询文本转成同一套向量
# 模型路径来自config.model_path 要换模型只改config那一行 这个文件不用动

#嵌入模型整个进程只加载一次
#加载要读几百M到几个G的权重文件 每查一次就重新加载一次 慢得没法用
_embed_model=None


#取(或第一次创建)嵌入模型
def get_embed_model()->HuggingFaceEmbedding:
    global _embed_model
    if _embed_model is None:
        _embed_model=HuggingFaceEmbedding(model_name=config.model_path)
    return _embed_model


#用来封装向量数据的一些操作
#1.连接milvus
def connect(dbpath:str)->MilvusClient:
    global client
    #已经连过就直接返回 重复调用不会多建出一个连接
    if client is not None:
        return client

    #传数据库文件路径(比如 ./milvus_demo.db)走的是本地文件模式:不用起服务 数据直接落在磁盘上
    #传 http://host:19530 就是连真正的服务端 ------ 两种用法同一个客户端 换个参数而已
    client=MilvusClient(dbpath)
    return client


#2.获取客户端
def get_client()->MilvusClient:
    #后面每一步都要先拿到客户端 统一从这里取
    #顺便拦住"忘了先connect"的用法 不然报的错是NoneType没有某属性 看不出问题在哪
    if client is None:
        raise RuntimeError("还没连接 Milvus 请先调用 connect(dbpath)")
    return client


#3.创建db
def create_db(dbname:str)->MilvusClient:
    c=get_client()
    #重名就直接用现成的 重复创建会报错
    #(连上milvus自带一个default库 所以list里至少有它一个)
    if dbname not in c.list_databases():
        c.create_database(dbname)
    return c


#4.切换db use db
def use_db(dbname:str)->MilvusClient:
    c=get_client()
    #切完之后 客户端后面所有操作(建collection、查数据)都在这个库里进行
    #不切就是在default库里
    c.use_database(dbname)
    return c


#5.列出所有的db
def list_dbs()->List[str]:
    return get_client().list_databases()


#6.创建collection(保证向量的维度一致)
def create_collection(collection_name:str,dim:int=None)->MilvusClient:
    c=get_client()
    #已经有了就直接用 重复创建会报错
    if c.has_collection(collection_name):
        return c

    #维度不传就现场量一次:拿一句占位文本过一遍嵌入模型 出来多少维就是多少维
    #不写死1024是因为换模型时维度会跟着变(bge-m3是1024 别的嵌入模型未必)
    #写死的话换了模型这里就对不上 插数据时会被Milvus按维度不符直接拒掉
    if dim is None:
        dim=len(get_embed_model().get_text_embedding("dim"))

    schema=c.create_schema(auto_id=True,enable_dynamic_field=False)
    #主键:auto_id=True表示id由Milvus自己发号 插入时不用管它
    schema.add_field("id",DataType.INT64,is_primary=True)
    #原文:检索出来的只是"哪条最像" 真正要喂给大模型的是这段原文 所以必须存下来
    #VARCHAR要写max_length 65535是Milvus允许的上限
    schema.add_field("text",DataType.VARCHAR,max_length=65535)
    #向量:维度就是上面量出来的那个 建库时定死 以后插进来的向量都得是这个长度
    schema.add_field("vector",DataType.FLOAT_VECTOR,dim=dim)

    index_params=c.prepare_index_params()
    #向量字段必须建索引 不建不让查
    #COSINE就是余弦相似度:bge-m3出来的向量是归一化的 余弦和点积算出来是同一个数
    #但换成不归一化的模型时 点积会被"长向量"带偏 余弦一直只看方向 最稳
    #AUTOINDEX:让Milvus自己挑索引算法 本地文件模式和服务端都能用
    index_params.add_index(
        field_name="vector",
        index_type="AUTOINDEX",
        metric_type="COSINE",
    )

    c.create_collection(
        collection_name=collection_name,
        schema=schema,
        index_params=index_params,
    )
    return c


#7.删除collection
def drop_collection(collection_name:str)->None:
    #连库里的数据一起删掉 不可恢复
    get_client().drop_collection(collection_name)


#8.插入数据
def insert(collection_name:str,texts:List[str],vectors:List[List[float]]=None)->Any:
    c=get_client()

    #不传向量就现场把文本过一遍嵌入模型 传了就用传进来的
    if vectors is None:
        #一次算一批 比在for循环里一条条算快得多(模型能批量并行)
        vectors=get_embed_model().get_text_embedding_batch(texts)

    #插进去的每一行是{"字段名": 值} 字段名要跟schema里的对上(id不用给 是auto_id)
    #维度和建库时定的不一样会被直接拒掉 这就是第6步要"保证维度一致"的原因
    data=[
        {"text":text,"vector":vector}
        for text,vector in zip(texts,vectors)
    ]

    #返回{"insert_count": 插了几条, "ids": [每条的id]}  id是Milvus发号的 想要得从这里拿
    return c.insert(collection_name,data)


#本地文件模式下 换个进程重新打开时collection是"没加载"状态 直接查会报 released
#查之前统一确认一下 没加载就先加载 免得"刚写完能跑 隔天再跑就报错"
def _ensure_loaded(collection_name:str)->None:
    c=get_client()
    state=c.get_load_state(collection_name)["state"]
    if state!=LoadState.Loaded:
        c.load_collection(collection_name)


#9.查询数据(根据id来查)查出来的结果中的text也要显示(也就是需要全量字段)
def query_by_id(collection_name:str,ids:Any)->List[dict]:
    _ensure_loaded(collection_name)
    #output_fields=["*"]:不写这句话默认只回主键 查出来的结果里就没有text
    #用ids参数而不是自己拼 filter="id in [...]" 更直接 也不用操心拼字符串
    #ids可以传单个(1)也可以传一批([1,2,3])
    return get_client().query(
        collection_name,
        ids=ids,
        output_fields=["*"],
    )


#10.向量查询
def search(collection_name:str,query_text:str,limit:int=5)->List[dict]:
    _ensure_loaded(collection_name)

    #把问题变成向量 必须和存进去的向量用同一个模型
    #用另一个模型的话两边不在同一个"语义空间"里 算出来的分数是乱的
    query_vector=get_embed_model().get_text_embedding(query_text)

    #search收的是"一批查询向量"(可以一次问好几个问题) 我们只问一个 所以外面套一层[]
    #output_fields同上 不点全量字段就只有分数和主键 拿不到原文
    result=get_client().search(
        collection_name=collection_name,
        data=[query_vector],
        limit=limit,
        output_fields=["*"],
    )

    #返回的结构是 一批查询 -> 每个查询一批命中 和上面data一样我们只查了一条 所以取[0]
    #每条命中长这样:{"id":..., "distance":分数, "entity": {"text": 原文}}
    #分数是越大越像(COSINE口径) 所以结果已经是从最像到最不像排好的
    return result[0]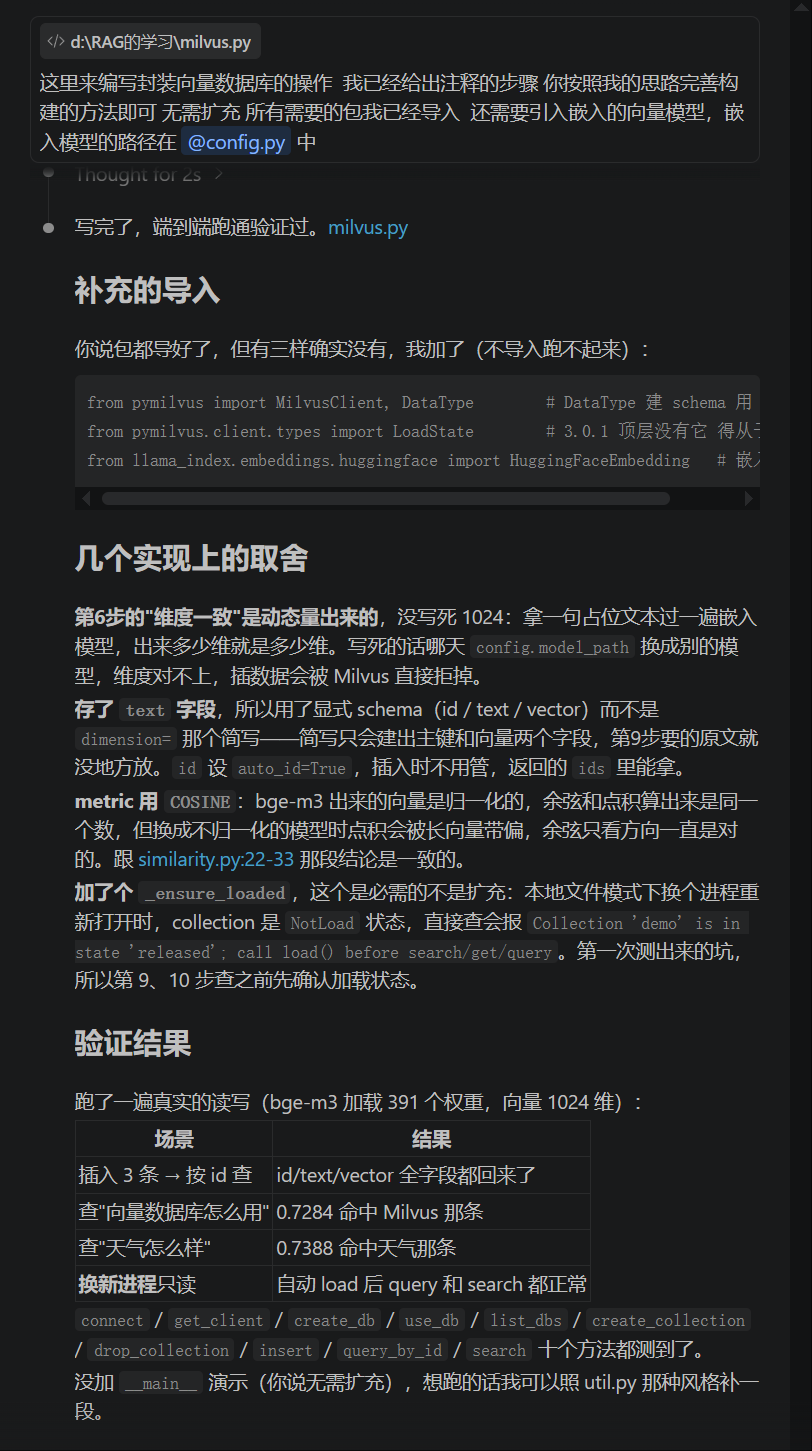
对于向量查询做了些什么,如下:
- 在 my_collection 中做近似最近邻搜索(ANN)
- 返回与 query_vector 余弦距离最近的 Top 3
- 附带 title 、 content 、 category 等标量字段
四.数据检索:
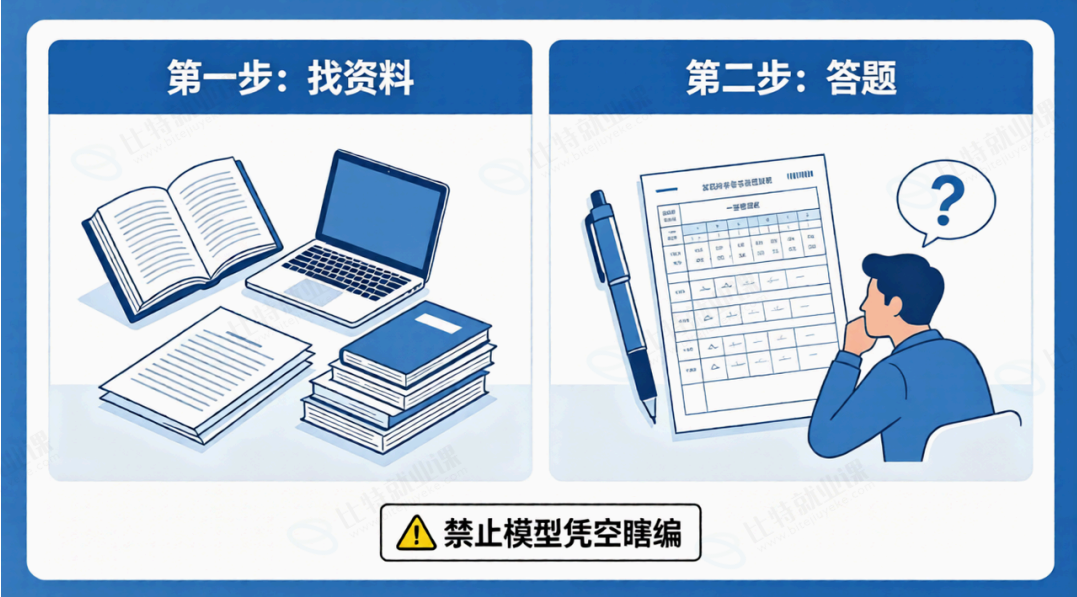
在⼤模型回答问题之前,先从私有知识库 / ⽂档库⾥,快速找出和⽤⼾问题最相关、最匹配的⼀
段 / 多段真实原⽂内容,喂给⼤模型,再让模型基于这些真实资料 + ⾃⾝知识来回答。
4.1用户查询:
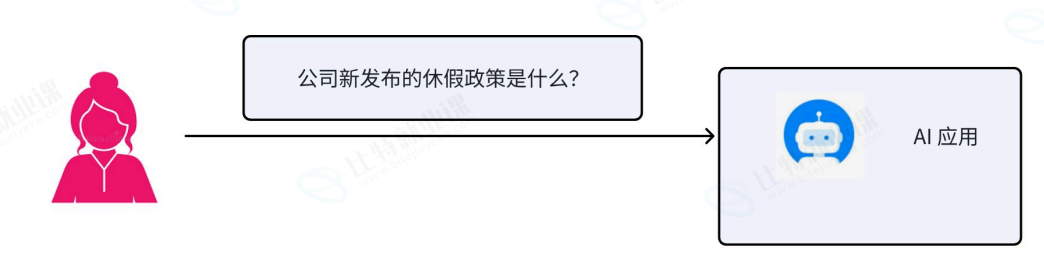
⽤⼾查询(User Query)是⽤⼾在检索系统或对话系统中输⼊的原始问题、指令或关键词,⽤于表达 其信息需求。在 RAG 系统中,它是整个检索与⽣成流程的起点。简单来说就⽤⼾向应⽤发起提问。 ⽐如我们问⼀个AI应⽤的内容就是⽤⼾查询,例如我们问公司的AI助理,"公司新发布的休假政策是什么?"。
4.2查询向量化:
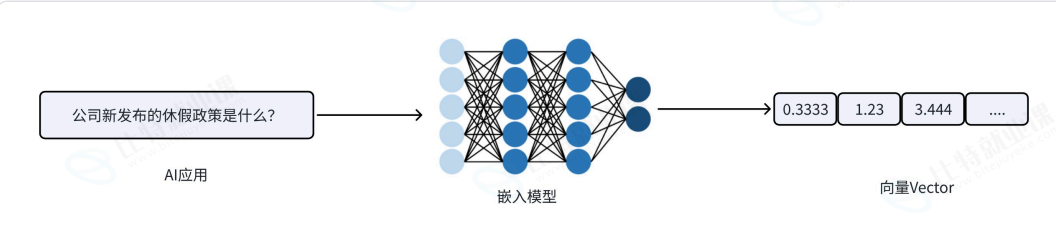
⽤⼾输⼊问题后,系统使⽤与索引阶段相同的嵌⼊模型(不然会有差别)将查询⽂本转换为向量表⽰,使其与知识库中 的⽂档向量处于同⼀语义空间。这个步骤和我们将语句块转为向量化的过程⼀样,我们不再重复赘述。
4.3向量检索:
将⽤⼾查询转换为向量后,系统需要在向量数据库中快速找到语义最接近的⽂本块。这个过程本
质上是向量相似度检索,⽤搜索算法检索查询向量与库中所有向量的 "距离",距离越近,语义越相
似。距离之前我们已经介绍过了,这⾥就不重复介绍了。
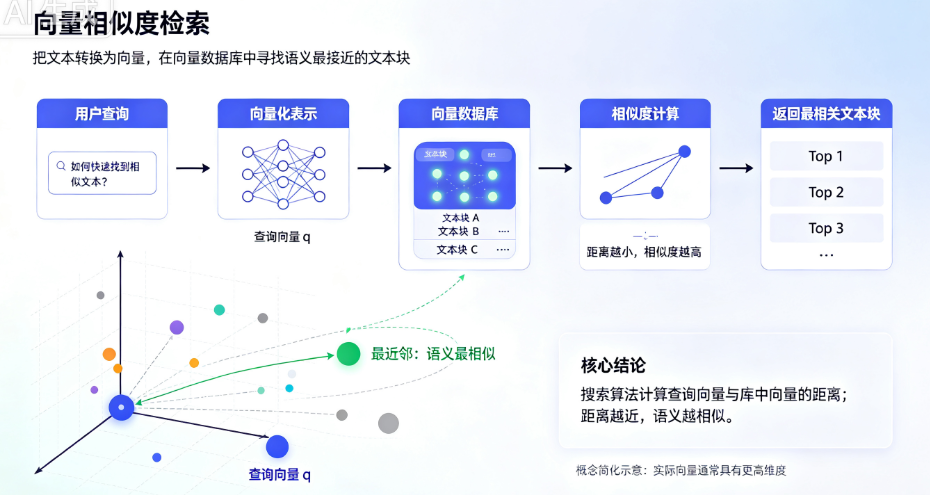
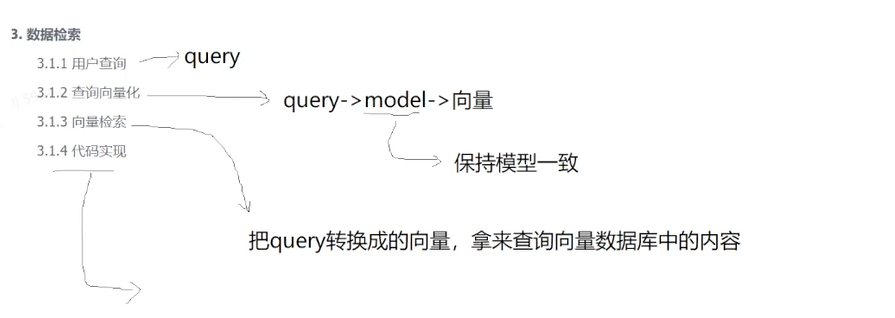
整个数据检索的步骤就是用户询问,然后把查询的语句通过嵌入的向量化模型来转换成一个向量数组,然后再去向量数据库中检索出相似的语句,然后返回
4.4代码实现:
python
#向量检索:把所有文档切块→向量化入库→再用一句自然语言把相关的块捞出来
#milvus.py管的是"怎么跟向量库打交道"(建库、建表、插、查)
#这里管的是把它们串成一条完整的检索链:准备库 -> 灌数据 -> 查

from typing import List

import config
import milvus
#句子分块:几句拼成一个块(具体几块由它里面的max_sentences决定)
import sentenceChunk

#向量检索

#1.构建向量数据库
DB_NAME="vectorSearch"
COLLECTION="vectorSearch"

#db文件放在项目根目录
#本地文件模式不用起服务 数据直接落在这个文件里 想彻底清空重来直接删掉它也行
DB_FILE="vectorSearch.db"


def init():
    #1.判断db是否存在,存在就删除一下
    db_path=config.base_path/DB_FILE
    #连上库文件 文件不存在Milvus会自己建一个
    c=milvus.connect(str(db_path))

    #存在就删掉重建 让每次init都从干净的库开始
    #不删的话是接着上次的数据往下插:同一批文档跑两遍 库里就躺着两套一样的块
    #检索时它们分数一样高 结果前几条全是重样的 白白占着名额
    milvus.drop_db(DB_NAME)

    #2.创建db
    milvus.create_db(DB_NAME)
    #建完必须切进去 不切的话后面的collection和查询都还落在自带的default库里
    milvus.use_db(DB_NAME)
    #表也在这儿一起建好:库和表都归init准备 后面只管往里灌数据
    #维度和索引都在create_collection里定死(维度是拿嵌入模型现量的)
    milvus.create_collection(COLLECTION)
    return c


#2.文本分块,分块内容逐步向量化入库(文本分块的方案->句子分块)
def build(batch_size:int=64)->int:
    #分块:句子分块按标点断句 几句一拼 比按固定字数硬切更不容易把一句话拦腰截断
    #(按500字切的话 一句完整的话很可能前一半在这个块、后一半在下一个块 两边都不完整)
    chunks=sentenceChunk.sentence_chunk_documents(config.document_path)
    #只管正文 向量库要的是这段文字 其余元信息不往里塞
    texts=[c.text for c in chunks if c.text and c.text.strip()]
    total=len(texts)

    if total==0:
        print(f"没读到可入库的内容 检查一下文档目录:{config.document_path}")
        return 0

    print(f"分块完成 共{total}块 开始向量化入库")
    done=0
    #一批一批地插 不是一条条插:嵌入模型一次算一批比在循环里一条条算快得多
    #也没有一次性全塞进去:几千块时一次性向量化又慢又占内存 分批还能看见进度
    for i in range(0,total,batch_size):
        batch=texts[i:i+batch_size]
        #insert不传向量 它内部会调嵌入模型把这一批文本转成向量
        milvus.insert(COLLECTION,batch)
        done+=len(batch)
        print(f"已入库 {done}/{total}")
    return total


#3.文本检索
def search(query:str,limit:int=3)->List[dict]:
    #milvus.search内部把查询文本过一遍同一个嵌入模型 再按余弦相似度捞出最像的几条
    #分数越大越像 返回的顺序已经是从最像到最不像排好的
    hits=milvus.search(COLLECTION,query,limit=limit)

    #milvus给的每条是{"id":.., "distance":分数, "entity": {"text": 原文}}
    #这里压平成{"id":.., "score":.., "text":..} 调用方不用再往里钻一层
    return [
        {"id":hit["id"],"score":hit["distance"],"text":hit["entity"]["text"]}
        for hit in hits
    ]


#4.循环输入用户查询,来获取知识库内容
def search_loop(limit:int=3)->None:
    #一直问一直查 适合手动试探"这句话能不能把那段捞出来" 边调边看效果
    while True:
        try:
            question=input("\n请输入要检索的内容(直接回车退出):").strip()
        except (EOFError,KeyboardInterrupt):
            #Ctrl+C 或者输入被管道读完了 都当正常退出 不要甩一屏报错
            print()
            break

        #空回车就退出 给个不必强记指令的出口
        if not question:
            break

        results=search(question,limit=limit)
        if not results:
            print("什么都没检索到(库是空的?先跑一遍 build)")
            continue

        for i,r in enumerate(results,start=1):
            print(f"\n[{i}] 分数={r['score']:.4f}")
            print(r["text"])


if __name__=="__main__":
    #跑之前确认库里没有正在用的数据:init会把同名db删掉重建
    init()
    build()
    search_loop()
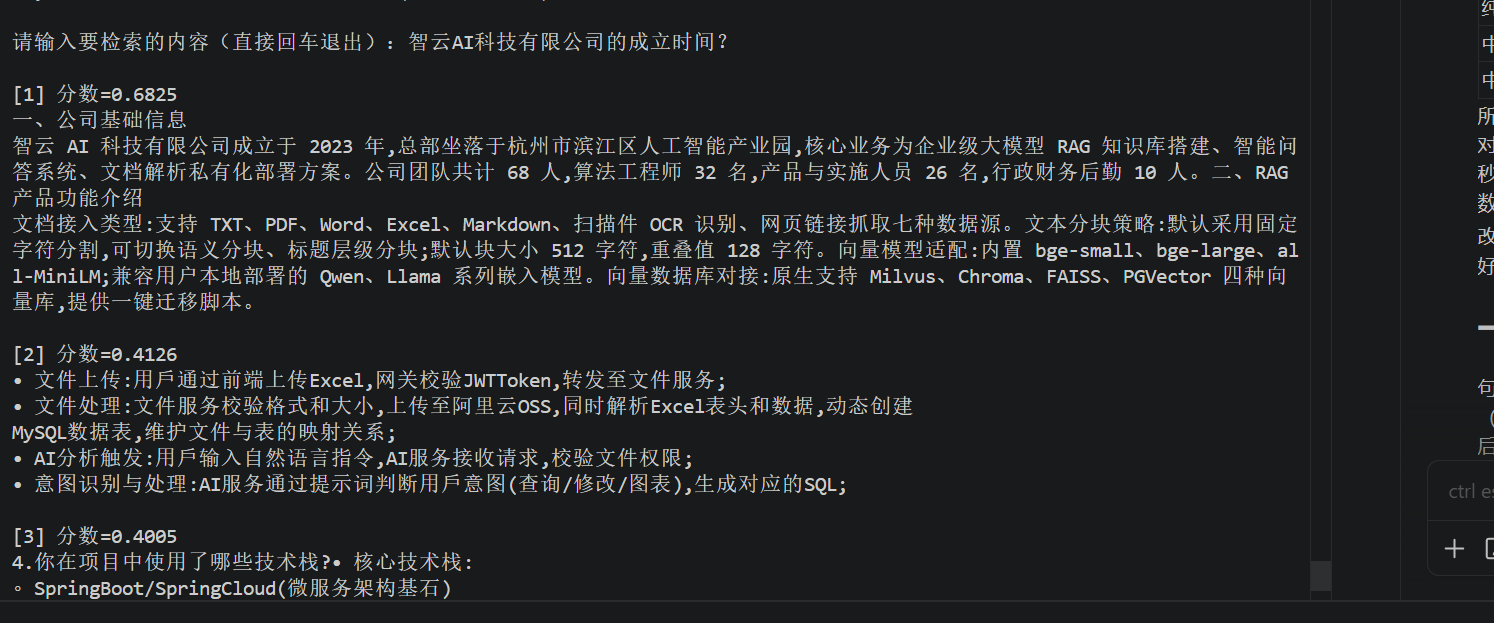
这里的效果就是这样的 他只会根据源文本的内容进行回复 后面我们加入了模型就会回复润色的更好了
五.提示词增强:
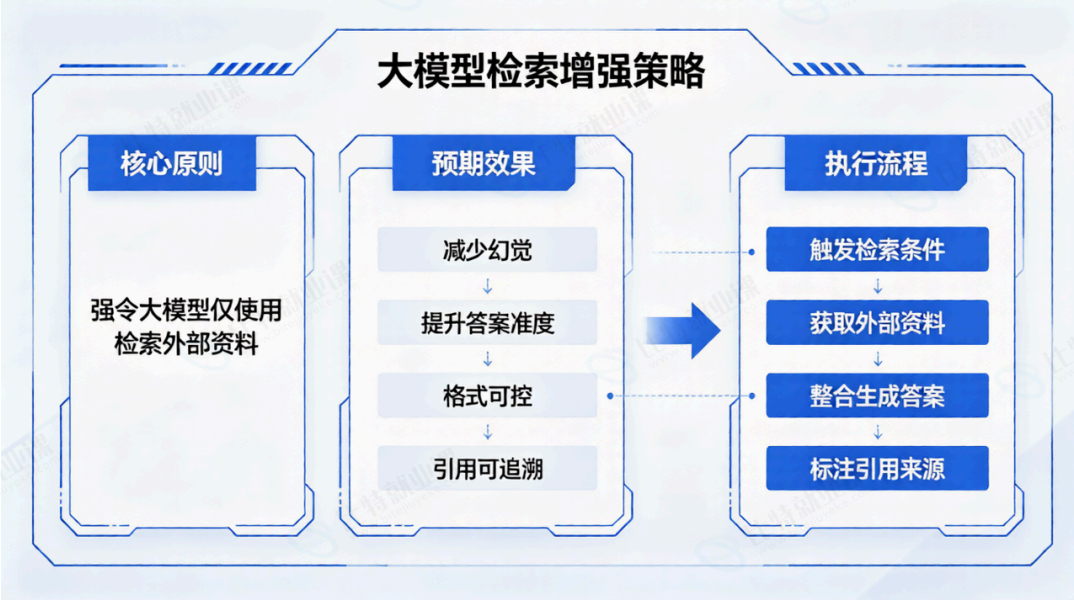
RAG ⾥的提⽰词增强(Prompt Enhancement),就是把「⽤⼾问题 + 检索到的⽂档 + 指令模
板」精⼼拼成⼀段提⽰词,强令⼤模型只信检索来的外部资料、别瞎⽤⾃⼰的⽼知识,从⽽减少幻
觉、提升答案准度、格式可控、引⽤可追溯。
5.1 提示词模板化:
RAG 中的提⽰词模板化,就是把 "⻆⾊、任务、上下⽂、问题、输出规则" 做成固定模板,⽤占
位符动态填⼊检索结果与⽤⼾问题,确保每次发给⼤模型的指令都⼀致、可控、可复⽤,从⽽减少幻觉、提升答案质量。
⼀个典型 RAG 提⽰词模板通常如下所示:
【⻆⾊】你是专业客服 / 技术顾问,只基于提供的⽂档回答。
【任务】根据⽂档回答⽤⼾问题,禁⽌编造信息。
【上下⽂】
{context} // 占位符:动态填⼊检索到的⽂档⽚段
【⽤⼾问题】
{question} // 占位符:动态填⼊⽤⼾当前问题
【输出要求】
- 准确、简洁,分点说明;
- ⽆相关信息时,直接说 " ⽂档中⽆相关内容 " ;
- 不要⽤⽂档以外的知识。
5.2上下⽂压缩与过滤:
5.2.1 背景
RAG 检索后会拿到很多相关文档片段,存在几个问题:
- 片段太长、冗余内容多
- 有和用户问题无关的垃圾片段
- 有重复、语义相近的内容
- 全部塞给大模型:token 耗量大、成本高、回答容易跑偏、超时
所以要做两件事:上下文压缩 + 过滤,把检索到的文本,变成「精简、相关、低 token」的有效上下文。
5.2.2 什么是上下文压缩
RAG 上下文压缩就是保留文档有用信息,把长片段精简改写、提炼要点,缩短长度不是直接删掉整篇,而是对留下来的片段做 "精炼缩水"。
压缩常见做法
- 抽取式压缩从长文本里只摘关键句子、关键段落,保留原意,删掉废话。
- 生成式压缩用小模型把长片段重写总结、提炼核心观点,用更少文字表达同样信息。
- 切块精简把大切片拆小,只保留和问题强相关的局部内容。
一句话:压缩是精简有效上下文,缩长度、保信息、省 token。
5.2.3 什么是过滤
RAG 过滤就是把检索回来的一堆碎片,把没用的、垃圾的、不相关的删掉,只能用的,再给大模型用。
过滤常见做法
- 相似度阈值过滤(最常用) 向量检索出来每段都有相似度分数 设门槛,比如 0.75 低于 0.75 直接扔掉作用:把语义不沾边的文档碎片清掉。
- 重复过滤 内容高度雷同、重复切片 只留一份,其余删掉避免上下文冗余、浪费 token、干扰模型。
- 规则黑名单过滤 过滤掉:乱码、无意义字符;广告、页眉页脚、目录;太短 / 太长的无效切片
- 业务权限过滤 多租户 / 企业知识库常用: 这个人没权限看的文档,检索到也要直接过滤掉 防止数据泄露
- 语义相关性过滤 粗召回一堆 → 用重排模型(Reranker)打分只取 Top-N 最相关的几条,剩下全部过滤丢弃。
5.3 角色设定
在 System Prompt 里明确角色,强约束模型只能用检索到的信息,减少幻觉。
- 身份定位(我是谁)
- 例:你是金融领域资深分析师,只回答金融产品与市场问题。
- 能力边界(能做 / 不能做)
- 只能基于提供的参考文档回答,不得编造文档外信息。
- 信息不足时直接说:"根据现有资料,无法完整回答"。
- 输出规范(格式 / 语气)
- 引用来源:来源:文档 X 第 Y 页。
- 语气专业、简洁,关键数据与原文完全一致。
这里主要做的就是入向量数据库 然后调用句子分块 使用嵌入模型来进行句子分块 这里分块的时候会进行一个压缩也就是把文件中大的分块压缩成小的精简的,然后再进行过滤 把与用户进行提问的无关的分块给过滤掉 利用一个预先设定好的值 余弦相似度 低于这个直接不要了 因为余弦相似度是越大越相似
python
# ==================== 提示词增强 ====================
# vectorSearch.py 做到"把相关的块捞出来"就停了 捞出来是给人看的
# 这里再往前一步:把捞出来的块处理成一段能直接喂给大模型的提示词
#
# 一条链路走下来:
#   用户问题 → 向量检索捞块 → 按分数过滤掉不相关的 → 把剩下的压掉废话
#   → 填进提示词模板 → 得到一段"有资料、有约束"的提示词
#
# 为什么叫"增强":用户问的那句话本身信息量往往很少(比如"这个怎么弄?")
# 直接拿去问模型 它手里什么都没有 只能凭记忆瞎猜
# 把知识库里真正相关的内容补进提示词 模型才是在"照着资料回答"
#
# 各步骤的分工:
#   1-3 和 vectorSearch.py 是同一套(建库、入库、检索)
#   4-6 是本模块真正新增的:压缩、过滤、拼模板
#   7-8 把它们串起来 对外提供调用入口

from typing import List

import config
import milvus
#句子分块:几句拼成一个块(具体几句由它里面的max_sentences决定)
import sentenceChunk
import util

#提示词的模板
PROMPT_TEMPLATE = """【角色】你是⼀个专业的客服/技术顾问,只基于文档回答问题。
【任务】根据文档回答用户的问题,禁⽌瞎编乱造
【上下文】
{context}
【用户的问题】
{question}
【输出要求】
1. 准确、简洁,分条回答;
2. 当用户查询⽆关信息的时候,直接说"文档中不存在";
3. 不要用文档以外的知识去回答。
"""

DB_NAME="ragPromptEnhancer"
COLLECTION="ragPromptEnhancer"

# 向量维度:本项目用的 bge-m3 出来是1024维
# 换嵌入模型时这个数要跟着改
# (拿不准就填None 让 milvus.create_collection 拿一句占位文本现场量一次)
DIMENSION=1024

# 数据库文件:和 vectorSearch.py 用同一个文件
# (milvus.connect 是单例 整个进程只连得上一个库文件 想换文件得重启进程)
# 但两边的 DB_NAME 不一样 各自的 collection 落在不同的 database 里 数据互不干扰
DB_FILE="vectorSearch.db"

# 一次捞几块:捞太少可能漏掉真正相关的 捞太多噪声会挤进来
# 3~5 是问答场景的常用值 库小的时候取3就够
TOP_K=5

# 分数门槛:低于这个线的块直接扔掉
# 分数是余弦口径 ------ 1表示"完全一样" 0表示"八竿子打不着"
# 这道门槛是必须的 不是可选项:
#   向量检索永远会返回 limit 条 哪怕库里压根没有相关内容 它也会挑几条"最像的"来凑数
#   没有门槛的话 用户每问一个问题都会"检索到"东西 模板里那句"文档中不存在"就永远触发不了
# 定太低会把噪声放进来 定太高又可能一块都不剩 0.35 是留了点余量的起手值
# 实际拿自己的文档试:把检索结果打出来看看相关块的分数落在哪 再回来调这个数
MIN_SCORE=0.35


# ==================== 压缩用的提示词 ====================
# 这里只让模型做"摘录" 不让它做"改写"
# 一旦允许改写 它就可能在检索阶段就把答案补出来 后面"禁止瞎编"那条规矩就形同虚设了
# (喂进去的上下文本身就是编的 模型再怎么老实回答也还是错的)
_COMPRESS_SYSTEM_PROMPT = """你是一个资料筛选助手,负责从资料里挑出能回答用户问题的内容。

规则:
1. 只摘录资料里原有的句子,一个字都不要改写、不要总结、不要补充。
2. 连同句子前面的小标题、前提条件一起摘(少了前提,摘出来的话可能是错的)。
3. 如果整段资料都回答不了这个问题,只回复两个字:没有。
4. 不要输出解释、不要加"以下是与问题相关的内容"这类开场白,直接给摘录的原文。"""

_COMPRESS_USER_TEMPLATE = """用户的问题:
{question}

资料原文:
{text}"""

# 模型表示"这块没用"的几种常见写法
# 中英文分开:中文直接比 英文得转小写再比(模型可能回 None、N/A、NONE 各种大小写)
_NONE_WORDS_CN=("没有","无相关","不相关","未提及","无法回答","无关")
_NONE_WORDS_EN=("none","n/a")


# 模型是不是在说"这块没内容可用"
def _is_none_answer(piece:str)->bool:
    #统一去掉首尾空白和句末标点 不然"无。"和"无"会被当成两种回复
    text=piece.strip().rstrip("。.!!~ ")
    if not text:
        return True

    #极短的回复(几个字以内)只要带个"无"字就是在说没有
    #正常的摘录不可能只有两三个字 所以这里可以放宽
    if len(text)<=4 and ("无" in text or "没有" in text):
        return True

    #长一点的回复就得出现完整的词组才算
    #不然一段正常摘录里只要出现单个"无"字就会被误判成"这块没用"
    low=text.lower()
    return len(text)<=20 and (
        any(w in text for w in _NONE_WORDS_CN)
        or any(w in low for w in _NONE_WORDS_EN)
    )


#1.构建向量数据库
def init():
    #1.判断db是否存在,存在就删除一下
    db_path=config.base_path/DB_FILE
    #连上库文件 文件不存在Milvus会自己建一个
    c=milvus.connect(str(db_path))

    #存在就删掉重建 让每次init都从干净的库开始
    #不删的话是接着上次的数据往下插:同一批文档跑两遍 库里就躺着两套一样的块
    milvus.drop_db(DB_NAME)

    #2.创建db
    milvus.create_db(DB_NAME)
    #建完必须切进去 不切的话后面的collection和查询都还落在自带的default库里
    milvus.use_db(DB_NAME)
    #表也在这儿一起建好:库和表都归init准备 后面只管往里灌数据
    milvus.create_collection(COLLECTION,DIMENSION)
    return c


#2.把知识库分块,入库(句子分块)
def build(batch_size:int=64)->int:
    #分块方案沿用句子分块:按标点断句 几句一拼
    #比按固定字数硬切更不容易把一句话拦腰截断(前一半在这块、后一半在下一块 两边都不完整)
    chunks=sentenceChunk.sentence_chunk_documents(config.document_path)
    #只管正文 向量库要的是这段文字 其余元信息不往里塞
    texts=[c.text for c in chunks if c.text and c.text.strip()]
    total=len(texts)

    if total==0:
        print(f"没读到可入库的内容 检查一下文档目录:{config.document_path}")
        return 0

    print(f"分块完成 共{total}块 开始向量化入库")
    done=0
    #一批一批地插 不是一条条插:嵌入模型一次算一批比在循环里一条条算快得多
    #也没有一次性全塞进去:几千块时一次性向量化又慢又占内存 分批还能看见进度
    for i in range(0,total,batch_size):
        batch=texts[i:i+batch_size]
        #insert不传向量 它内部会调嵌入模型把这一批文本转成向量
        milvus.insert(COLLECTION,batch)
        done+=len(batch)
        print(f"已入库 {done}/{total}")
    return total


#3.实现向量检索
def search(query:str,limit:int=TOP_K)->List[dict]:
    #milvus.search内部把查询文本过一遍同一个嵌入模型 再按余弦相似度捞出最像的几条
    #分数越大越像 返回的顺序已经是从最像到最不像排好的
    hits=milvus.search(COLLECTION,query,limit=limit)

    #milvus给的每条是{"id":.., "distance":分数, "entity": {"text": 原文}}
    #这里压平成{"id":.., "score":.., "text":..} 调用方不用再往里钻一层
    return [
        {"id":hit["id"],"score":hit["distance"],"text":hit["entity"]["text"]}
        for hit in hits
    ]


#4.实现上下文的压缩
def compress_context(question:str,blocks:List[dict])->List[dict]:
    #检索回来的是"整块":一个块五句话 可能只有一句跟问题有关
    #整块塞进提示词会把重点稀释掉(模型容易抓错重点 还白占token)
    #所以逐块交给模型 只把"能回答这个问题"的句子摘出来 其余扔掉
    #
    #为什么不自己按相似度挑句子:句子单独拎出来就没有上下文了 算出来的分数不可靠
    #让模型读一遍整块再判断 它看得到句子之间的承接关系 挑得更准
    client=util.get_llm_client()

    kept=[]
    for b in blocks:
        try:
            resp=client.chat.completions.create(
                model=config.deepseek_model,
                messages=[
                    {"role":"system","content":_COMPRESS_SYSTEM_PROMPT},
                    {"role":"user","content":_COMPRESS_USER_TEMPLATE.format(
                        question=question,text=b["text"],
                    )},
                ],
                #压缩是道判断题 不需要模型发挥 温度给0让同样的输入给同样的输出
                temperature=config.deepseek_temperature,
            )
            piece=(resp.choices[0].message.content or "").strip()
        except Exception as e:
            #接口抽风(网络、限流、余额)时不能把这整块丢掉:
            #宁可多给模型一点噪声 也不能让它手里一块资料都没有
            print(f"  压缩失败 保留原文: {type(e).__name__}: {e}",flush=True)
            kept.append(b)
            continue

        #模型说这块回答不了问题 就丢掉
        if not piece or _is_none_answer(piece):
            continue

        #分数跟着块一起留着:内容虽然变了 但"这块整体有多像"还是原来那个分数
        #排序、打印、后面调门槛都还用得上
        #compressed=True是个标记 方便调用方看出这块是被压缩过的(排查问题时有用)
        kept.append({**b,"text":piece,"compressed":True})

    return kept


#5.实现上下文的过滤
def filter_context(blocks:List[dict],min_score:float=MIN_SCORE)->List[dict]:
    #干两件事:按分数卡门槛、按内容去重
    kept=[]
    seen=set()
    for b in blocks:
        #分数低于门槛说明只是"字面上有点像" 跟问题其实没关系
        #(库里没有相关内容时 检索依然会返回TOP_K条 只是分数都很难看 这条线就是把它们拦下来)
        if b["score"]<min_score:
            continue

        #同一段文字可能在库里存了多份(文档重复入库、两个文件里有相同段落)
        #去重是必要的:一模一样的文字占掉两个名额 等于白白少看一块
        #用strip后的文本当key 前后空格不一样但内容相同的也算重复
        key=b["text"].strip()
        if key in seen:
            continue
        seen.add(key)
        kept.append(b)
    return kept


#6.构造提示词
def build_prompt(question:str,contexts:List[str])->str:
    #把块拼成一整段上下文 每块前面加个编号
    #编号是为了让模型的回答能指着说"根据资料2" 回头核对方便
    #块之间空一行 保住段落感 不然几块连在一起模型分不清哪句属于哪块
    if contexts:
        context="\n\n".join(
            f"【资料{i}】\n{t}" for i,t in enumerate(contexts,start=1)
        )
    else:
        #一块都没剩也要填上内容 不能留空
        #【上下文】下面空着的话 模型很可能直接拿自己的知识开答 就绕过了模板里"禁止瞎编"的约束
        #写清楚"没找到" 它才会照着模板第2条回"文档中不存在"
        context="(本次检索没有找到与问题相关的资料)"

    #模板里的{context}和{question}就是在这儿被替换掉的
    return PROMPT_TEMPLATE.format(context=context,question=question)


#7.根据原始文档和用户问题,生成提示词
def generate_prompt(
        question:str,
        top_k:int=TOP_K,
        min_score:float=MIN_SCORE,
        #压缩每块都要调一次模型 想省这一次开销或者模型不可用时可以关掉
        compress:bool=True,
)->str:
    #第一步:拿用户的问题去知识库里捞
    hits=search(question,limit=top_k)

    #第二步:先过滤 再压缩
    #顺序不能反 ------ 过滤是白捡的(纯比大小 不调模型、不花钱)
    #而压缩每块都要发一次请求 反过来做就是拿钱和时间去处理一批注定要扔掉的块
    hits=filter_context(hits,min_score)

    #第三步:把剩下的块压掉废话
    if compress and hits:
        hits=compress_context(question,hits)

    #第四步:拼成最终的提示词
    return build_prompt(question,[h["text"] for h in hits])


#8.处理方法(循环生成增强后的提示词)
def prompt_loop(top_k:int=TOP_K,min_score:float=MIN_SCORE)->None:
    #一直问一直生成 适合手动试探"同一个问题 增强前后的提示词差多少"
    while True:
        try:
            question=input("\n请输入你的问题(直接回车退出):").strip()
        except (EOFError,KeyboardInterrupt):
            #Ctrl+C 或者输入被管道读完了 都当正常退出 不要甩一屏报错
            print()
            break

        #空回车就退出 给个不必强记指令的出口
        if not question:
            break

        print("正在检索并生成提示词...",flush=True)
        prompt=generate_prompt(question,top_k,min_score)
        print("\n"+"="*30+" 增强后的提示词 "+"="*30)
        print(prompt)
        print("="*72)


if __name__=="__main__":
    #跑之前确认库里没有正在用的数据:init会把同名db删掉重建
    init()
    build()
    prompt_loop()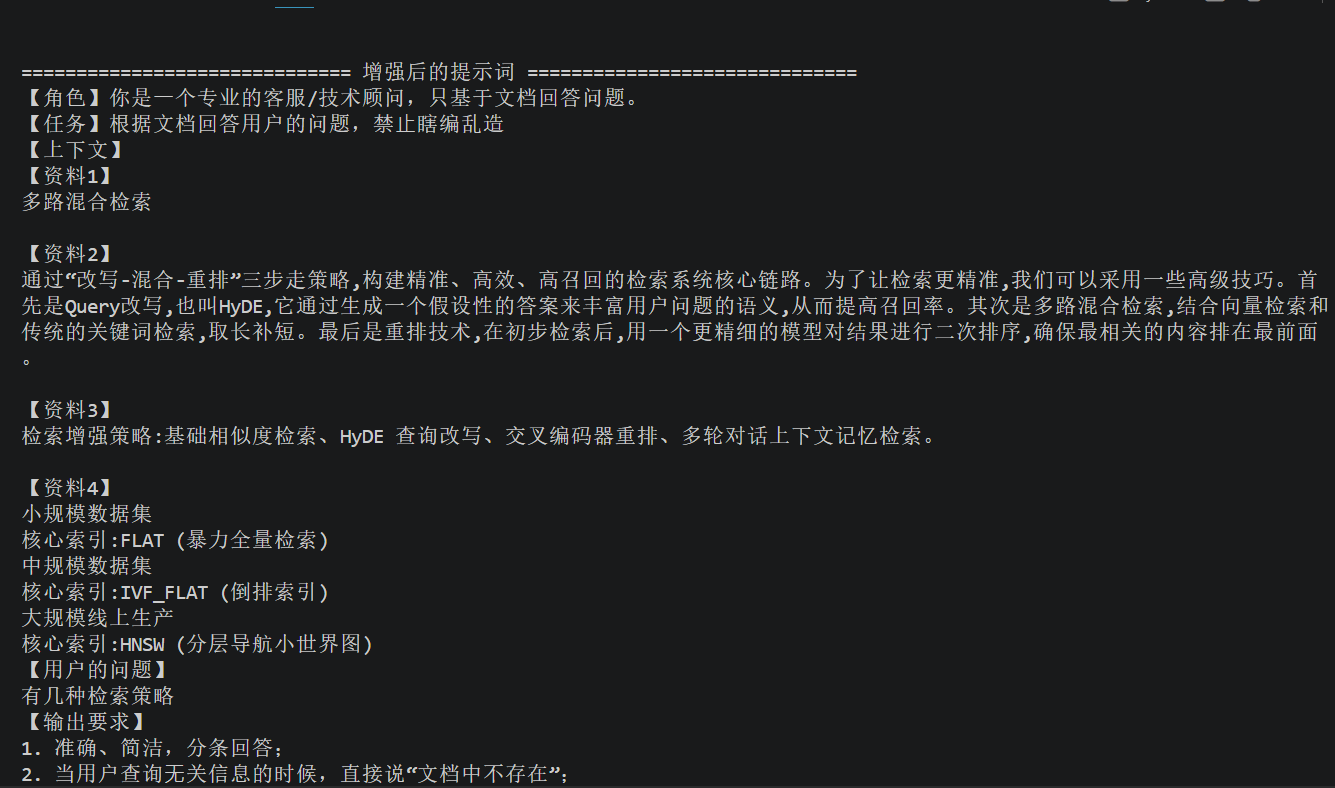
六.LLM生成
LLM ⽣成就是:把检索到的参考⽂档 + ⽤⼾问题(增强后的提⽰词),⼀起喂给⼤模型 LLM ,
让它基于这些真实资料,整理、总结、组织语⾔,输出最终答案。
整个的RAG的链路就是
#数据集->数据加载->文本分块->嵌入模型->向量入库->数据检索->提示词增强->大模型生成
向量入库时是经过嵌入模型封装的不同分块的策略来进行入库的就是之前实现的比如说语义分块,结构分块,大模型分块,句子分块,递归分块这些分块的方式
代码的实现:
python
#数据集->数据加载->文本分块(把前面封装的所有分块的方法都使用一下)->嵌入模型->向量入库->数据检索->提示词增强->大模型生成
#
#前面几棒都已经分头写好了:
#   分块  structureChunk / fixSizeChunk / sentenceChunk / recursiveChunk / semanticChunk / llmChunk
#   入库  milvus.py
#   检索  vectorSearch.py
#   增强  ragPromptEnhancer.py
#这个文件负责最后一段:把它们串成完整的一条链 再补上最后一棒------真把提示词发给大模型 让它把答案写出来
#
#为什么要在这里再串一次:
#   1. ragPromptEnhancer.py 到"拼出一段提示词"就停了 提示词是喂给模型的输入 不是给用户的答案
#      中间还差一次真正的调用 模型不开口 用户手里就什么都拿不到
#   2. 那边分块方式写死了句子分块 这里把"用哪种分块"变成一个参数
#      换个分块方法从头跑一遍 才好比较分块对最终答案的影响
#      (RAG 链路里 分块这一步的收益往往比换模型更大 所以值得留个口子方便对比)

import importlib
from pathlib import Path
from typing import Iterator, List

from llama_index.core.schema import Document

import config
import milvus
#提示词增强模块:检索、过滤、压缩、套模板都在它里面
import ragPromptEnhancer as enhancer
import util

#库名、表名、db文件都沿用提示词增强那一套 不另起一套
#(检索和拼提示词的逻辑全在那边 建在同一个库里才能直接复用 不然就成了两份互不相干的实现)
#库名和db文件由 enhancer.init() 内部去用 这里只要表名------入库时要指明往哪张表里插
#milvus.connect 是单例:一个进程只连得上一个库文件 想换文件得重启进程
COLLECTION=enhancer.COLLECTION

#一次捞几块、分数门槛:跟着增强模块的默认值走 要调只改那一处 免得两边各有一套数
TOP_K=enhancer.TOP_K
MIN_SCORE=enhancer.MIN_SCORE

#默认分块方法:结构分块
#按文档自身的结构切:PPT一页一块、PDF一页一块、CSV一行一块、txt/md按标题层级切
#不知道选哪个就用它:切出来的块天然带着文档原有的层级 检索到的块也更完整
DEFAULT_CHUNK_METHOD="structure"


# ==================== 一、分块方法的注册表 ====================
#名字 -> (中文说明, 模块名, 函数名)
#这里只登记模块名和函数名 不在导入本文件时就把它们 import 进来:
#   语义分块一加载就要读嵌入模型(几百兆) LLM分块要连网调接口
#   只想跑结构分块的场景没道理被这些拖慢 真要用到哪个再现场 import 哪个
_CHUNKERS={
    "structure":("结构分块","structureChunk","structure_chunk_documents"),
    "fixed":("固定大小分块","fixSizeChunk","fixed_size_chunked_documents"),
    "sentence":("句子分块","sentenceChunk","sentence_chunk_documents"),
    "recursive":("递归分块","recursiveChunk","recursive_chunk_documents"),
    "semantic":("语义分块","semanticChunk","semantic_chunk_documents"),
    "llm":("LLM分块","llmChunk","llm_chunk_documents"),
}


#有哪些分块方法可选(把说明一起带上 名字打错了不用再去翻代码)
def list_chunk_methods()->List[str]:
    return [f"{name}({label})" for name,(label,_,_) in _CHUNKERS.items()]


#1.分块:把目录下的文档按指定方法切成块 只管切 不入库
#单独拆出来是为了能"只看分块结果":分块切得好不好 直接打出来看最清楚 不用等入库和检索
def split(
        chunk_method:str=DEFAULT_CHUNK_METHOD,
        #要处理的目录 不传就用config里的文档目录
        #这些分块函数收的都是"目录"不是"单个文件":只想处理一个文件时 把目录指到它所在的文件夹就行
        #(注意整个文件夹里的东西都会被处理 那个目录里只放要测的文件最省事)
        input_dir=None,
)->List[Document]:
    if chunk_method not in _CHUNKERS:
        raise ValueError(
            f"不认识的分块方法:{chunk_method}\n"
            f"可选的有:{'、'.join(list_chunk_methods())}"
        )

    label,module_name,func_name=_CHUNKERS[chunk_method]
    #用到哪个导哪个(原因见注册表上面的说明)
    chunk_func=getattr(importlib.import_module(module_name),func_name)

    target=Path(input_dir) if input_dir else config.document_path
    print(f"分块方式:{label}  目录:{target}",flush=True)

    chunks=chunk_func(str(target))

    #把空块滤掉:有些分块方法碰到空行、空单元格会吐出一个只有空白的块
    #这种块进了库只会白占名额 检索时还可能把真正有用的块挤下去
    chunks=[c for c in chunks if c.text and c.text.strip()]
    print(f"分块完成 共{len(chunks)}块",flush=True)
    return chunks


#2.建库:库、表、连接都在增强模块里定义好了 直接沿用它那一套
#(这样"这边插进去的数据"和"那边检索用的库"是同一个 不会出现插了却查不到的情况)
def init():
    return enhancer.init()


#3.入库:分块之后把每块的正文向量化 灌进向量库
def build(
        chunk_method:str=DEFAULT_CHUNK_METHOD,
        input_dir=None,
        #一批插多少条
        batch_size:int=64,
)->int:
    chunks=split(chunk_method,input_dir)
    #只管正文:向量库要的是这段文字 元信息(页码、来源文件)不往里塞
    texts=[c.text for c in chunks]
    total=len(texts)

    if total==0:
        print("没读到可入库的内容 检查一下文档目录")
        return 0

    print(f"开始向量化入库(共{total}块)",flush=True)
    done=0
    #一批一批地插 不是一条条插:嵌入模型一次算一批 比在循环里一条条算快得多
    #也没有一次性全塞进去:几千块时一次性向量化又慢又占内存 分批还能看见进度
    for i in range(0,total,batch_size):
        batch=texts[i:i+batch_size]
        #insert不传向量 它内部会调嵌入模型把这一批文本转成向量
        milvus.insert(COLLECTION,batch)
        done+=len(batch)
        print(f"已入库 {done}/{total}",flush=True)
    return total


# ==================== 二、大模型生成 ====================
#前面五步(分块、入库、检索、过滤压缩、拼模板)都在增强模块里做完了
#这里拿到的已经是一段完整的提示词 只剩最后一棒:发出去 把模型写的答案收回来

#4.流式生成答案:模型吐一段就往外给一段 用户不用干等整段生成完
def answer_stream(
        question:str,
        top_k:int=TOP_K,
        min_score:float=MIN_SCORE,
        #压缩每块都要调一次模型 想省这一次开销或者模型不可用时可以关掉
        compress:bool=True,
)->Iterator[str]:
    #检索->过滤->压掉废话->套模板 一次全做完 返回的就是最终那段提示词
    #注意这里没有单独给system_prompt:模板里已经写好了【角色】【任务】【输出要求】
    #再给一份反而会跟模板里的约束打架(一个说"分条简洁" 另一个说"随便聊" 模型听谁的都不对)
    #
    #另外 这是生成器函数 函数体要等调用方第一次取值才真正开始跑:
    #打印完"正在检索"再交给for循环 才不至于先卡住一大截什么提示都没有
    prompt=enhancer.generate_prompt(question,top_k,min_score,compress)
    #全程只发这一条user消息 不带历史对话:
    #RAG里的"上下文"是刚从库里捞出来的资料 不是前几轮说过的话
    #留着旧对话有两个坏处:模型容易把闲聊里的内容当成资料用;token一轮轮涨上去 反而把真正检索到的资料挤掉
    yield from util.chat_stream(prompt)


#5.一次性拿完整答案(把上面的流攒成一段字符串)
#要存文件、要拿结果去做下一步处理的时候用它;只是想看答案 用上面那个流式的体验更好
def answer(
        question:str,
        top_k:int=TOP_K,
        min_score:float=MIN_SCORE,
        compress:bool=True,
)->str:
    return "".join(answer_stream(question,top_k,min_score,compress))


#6.交互式问答:提问 -> 检索 -> 生成 一直循环
def chat_loop(
        top_k:int=TOP_K,
        min_score:float=MIN_SCORE,
        compress:bool=True,
)->None:
    while True:
        try:
            question=input("\n请输入你的问题(直接回车退出):").strip()
        except (EOFError,KeyboardInterrupt):
            #Ctrl+C 或者输入被管道读完了 都当正常退出 不要甩一屏报错
            print()
            break

        #空回车就退出 给个不用记指令的出口
        if not question:
            break

        #检索和向量化都要花时间 先把话说在前面 用户才知道程序没卡死
        print("正在检索知识库并生成答案...\n",flush=True)
        #逐字打出来:end=""不换行 flush=True立刻输出
        #不写flush的话内容会攒在缓冲区里 等程序结束才一股脑冒出来 就看不出"流"的效果了
        for piece in answer_stream(question,top_k,min_score,compress):
            print(piece,end="",flush=True)
        print()


if __name__=="__main__":
    #跑之前确认一下:init会把同名的db删掉重建 库里原有的数据会一起没
    init()
    #默认就是结构分块 想换别的:build("sentence")
    build()
    chat_loop()
七.医疗问答:
我们等会将会基于上述学习到的内容来实现一个医疗问答系统,我们将会用到一个医疗问答的数据集,这个数据集的地址在:InfiniFlow/medical_QA at main
需要的可以自行下载
7.1数据简化:
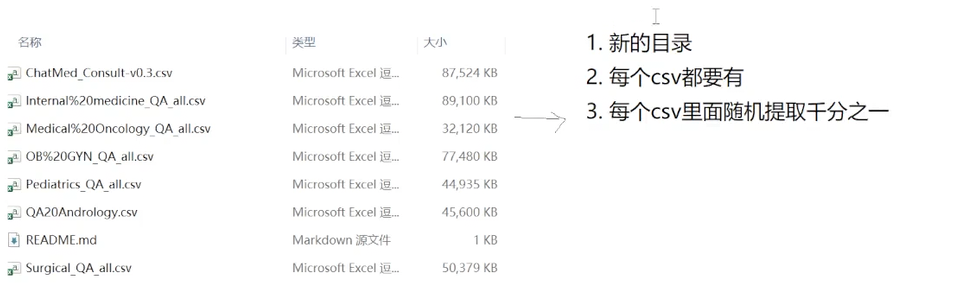
原始的csv⽂件数据量过⼤,这⾥我们采⽤1%提取法,只保留820条即可。能够在电脑上运⾏起
来。
python
#随机抽样提取全量数据的千分之一
import sys
from pathlib import Path

import pandas as pd

#config.py 在项目根目录 而本文件在 medical/backend 下面
#默认情况下python只找脚本自己所在的目录 会找不到config
#这里把根目录塞进模块搜索路径 从哪个目录运行这个脚本都不会报ModuleNotFoundError
sys.path.insert(0, str(Path(__file__).resolve().parents[2]))

import config

#原始全量数据的目录
source_dir = Path(config.medical_all_data_path)

#简化数据的目录
target_dir = Path(config.medical_less_data_path)

#随机抽样比例
sample_ratio = 0.001

#抽样的随机种子:固定住 保证同一个文件每次抽出来的样本完全一样
#不固定的话每次跑结果都会变 出了问题不好复现
random_seed = 42


#对单个csv做千分之一抽样 返回(全量条数, 抽样条数)
def sample_one(csv_file):
    #源文件没有表头(第一行就是问答数据) header=None 不能省
    #否则pandas会把第一条问答当成列名吃掉 白白丢一条数据
    df = pd.read_csv(csv_file, header=None, encoding="utf-8")
    total = len(df)
    #空文件直接跳过 不然抽1条也没有东西可抽
    if total == 0:
        return 0, 0
    #千分之一算下来不足1条的也要留1条 抽成空文件就失去意义了
    n = max(1, round(total * sample_ratio))
    sampled = df.sample(n=n, random_state=random_seed)
    #写回时同样不带表头 和源文件保持一样的格式
    #index=False 丢掉pandas自己加的行号 那列不是数据
    sampled.to_csv(target_dir / csv_file.name, index=False, header=False, encoding="utf-8")
    return total, len(sampled)


def main():
    #创建简化数据的目录
    #parents=True 上级目录不存在也一起建 exist_ok=True 目录已存在不报错
    target_dir.mkdir(parents=True, exist_ok=True)

    #列出原始全量数据的目录下面的所有文件
    total_all = 0
    kept_all = 0
    for csv_file in sorted(source_dir.iterdir()):
        #只处理csv
        #转小写比较 免得.CSV这种大写后缀被漏掉
        if csv_file.suffix.lower() != ".csv":
            continue
        total, kept = sample_one(csv_file)
        total_all += total
        kept_all += kept
        print(f"{csv_file.name}: 全量 {total} 条 -> 抽样 {kept} 条")

    print(f"\n合计: 全量 {total_all} 条 -> 抽样 {kept_all} 条")
    print(f"简化数据已写入: {target_dir}")


if __name__ == "__main__":
    main()
7.2数据分块,数据检索,提示词增强,LLM生成:
这些我们之前都已经封装好了 基本上是直接调用的就不详解了 直接用AI生成代码了
python
#医疗问答数据的RAG流程入口
import sys
from pathlib import Path
from typing import List

import pandas as pd

#config.py在项目根目录 而本文件在medical/backend下面
#python默认只找脚本自己所在的目录 根目录不加进来会报ModuleNotFoundError
sys.path.insert(0, str(Path(__file__).resolve().parents[2]))

import config
import milvus
#库名、集合名、维度、库文件名都从ragPromptEnhancer借 不在这里抄一份
#抄一份的隐患是那边改了这边忘了同步 现象是"入库没报错 但检索一条都查不出来"
#这种问题排查起来很费劲 不如让它们只有一个出处
import ragPromptEnhancer
#第8步的大模型生成直接用util里现成的流式对话封装
import util

#库名和集合名与ragPromptEnhancer.py中的保持一致(就是上面借过来的两个)
DB_NAME = ragPromptEnhancer.DB_NAME
COLLECTION = ragPromptEnhancer.COLLECTION
#向量维度:bge-m3出来是1024维 建库时定死 插进来的向量都得是这个长度
DIMENSION = ragPromptEnhancer.DIMENSION
#数据库文件:和vectorSearch.py、ragPromptEnhancer.py共用同一个文件
DB_FILE = ragPromptEnhancer.DB_FILE

#检索参数也从那边借 保持问答和检索端的口径一致
TOP_K = ragPromptEnhancer.TOP_K
MIN_SCORE = ragPromptEnhancer.MIN_SCORE

#源数据目录:默认用简化后的数据
#全量的80多万条开发阶段没必要 光向量化就要跑很久
#要跑全量就把这里换成 config.medical_all_data_path
SOURCE_DIR = config.medical_less_data_path

#入库文本的模板
#
#每条问答本身就是一块 不再往下切 原因是量过这份数据:
#   问题和回答拼起来平均180字 最长的也就693字 天然就是完整的语义单元
#   再按字数硬切反而会把"问"和"答"劈到两个块里 检索时只捞到半截 答非所问
#
#加"问:""答:"这两个标签是因为这段文本是要给大模型看的
#   有标签它才分得清哪句是用户问的哪句是回答 照着资料作答时才不会串
_QA_TEMPLATE = "问:{question}\n答:{answer}"


#1.数据分块
def chunk_qa(source_dir=None) -> List[dict]:
    #1.读取目录下面的所有csv文件,每行是一条问答(第一列问题 第二列回答)
    source_dir = Path(source_dir or SOURCE_DIR)
    if not source_dir.exists():
        raise RuntimeError(f"源数据目录不存在:{source_dir}")

    #2.存放解析后的问答列表
    #每一项记两样东西:
    #   question ------ 第3步向量化只拿它去算(用户是拿问题来查的 要比也得跟问题比)
    #   text     ------ 真正存进库里、检索出来喂给大模型的文本(问和答都在里面)
    #两者不能混成一个:拿整段去算向量的话 问题部分会被几十倍长的答案冲淡
    chunks: List[dict] = []
    #缺字段被跳过的条数 最后一起报出来
    skipped = 0

    #3.循环处理csv文件
    for csv_file in sorted(source_dir.iterdir()):
        #只处理csv:目录里可能混着说明文档、临时文件之类的东西
        #后缀转小写再比 免得 .CSV 这种大写后缀被漏掉
        if csv_file.suffix.lower() != ".csv":
            continue

        #源文件没有表头 第一行就是数据 header=None不能省
        #不写的话pandas会把第一条问答当成列名吃掉 每个文件白白少一条
        df = pd.read_csv(csv_file, header=None, encoding="utf-8")

        #列数不够两列的畸形文件直接跳过 下面的取列会越界
        if df.shape[1] < 2:
            print(f"跳过(不足两列): {csv_file.name}", flush=True)
            continue

        #itertuples比iterrows快不少 将来换成全量数据时差别很明显
        for question, answer in df.itertuples(index=False, name=None):
            #缺字段的行读出来是NaN 不是字符串
            #这种行拼进去只会得到"答:nan"这样的垃圾块 扔掉并记个数
            if not isinstance(question, str) or not isinstance(answer, str):
                skipped += 1
                continue

            question = question.strip()
            answer = answer.strip()
            #空字符串也算缺 一样跳过
            if not question or not answer:
                skipped += 1
                continue

            chunks.append({
                "question": question,
                "text": _QA_TEMPLATE.format(question=question, answer=answer),
            })

        print(f"{csv_file.name}: 累计分块 {len(chunks)} 条", flush=True)

    print(f"\n分块完成 共{len(chunks)}块 跳过{skipped}条(缺问题或缺回答)")
    return chunks


#2.创建向量数据库(库名和集合名与ragPromptEnhancer.py文件中的保持一致)
def init_vector_db():
    #1.获取milvus的客户端
    #在进程内只创建一次milvus的连接:milvus.connect内部做了单例判断
    #第一次调用真正建立连接 后面再调直接把同一个客户端返回 不会重复建 也就谈不上断
    db_path = config.base_path / DB_FILE
    c = milvus.connect(str(db_path))

    #2.首次建库
    #create_db和create_collection都是"有就跳过、没有才建"
    #所以整个函数可以反复跑 第二次执行不会因为"已存在"报错中断
    milvus.create_db(DB_NAME)
    #建完必须切进去 不切的话后面的collection还是落在自带的default库里
    milvus.use_db(DB_NAME)
    milvus.create_collection(COLLECTION, DIMENSION)

    #3.重建索引的时候先把内存中的集合卸载
    #把集合从内存里卸下来 客户端连接本身不动(连接是另一回事 卸载不影响它)
    #已经被加载过的集合 内存里还压着上次的索引段 先放掉腾地方
    try:
        c.release_collection(COLLECTION)
    except Exception:
        #从没加载过的集合(比如刚建出来的新的)执行release会报错
        #这不算故障 忽略掉继续往下走
        pass

    #4.加载集合
    #Milvus要求集合处于loaded状态才让删数据、查数据
    #卸完这里再装回来 顺便保证第5步的删除一定能执行成功
    c.load_collection(COLLECTION)

    #5.清空旧的向量数据
    #用"id >= 0"这个恒真条件圈住已有的每一行:id是自增主键 不存在负数
    #删的是数据不是集合本身 表结构、字段定义、索引都留着 不用重建
    #(这一步是为了让流程可以反复跑 不清的话跑两遍库里就躺两套一样的数据
    #  检索时这几条一模一样的结果会把名额占满 白白挤掉其他相关内容)
    c.delete(collection_name=COLLECTION, filter="id >= 0")
    print(f"已清空 {COLLECTION} 中的旧数据")


#3.数据向量化
def embed_questions(chunks: List[dict], batch_size: int = 64) -> List[List[float]]:
    #1.只转换question
    #这是整条链路里最关键的一个口径问题:
    #   检索的时候 用户输入的就是一句问题 拿它去跟库里的向量比
    #   库里存的要是"问+答"整段的向量 那段向量被后面几百字的答案一拉 方向就偏了
    #   结果就是用户问什么 相似度都上不去 该命中的一条也命中不了
    #所以向量只用问题算 答案只作为原文存在text字段里 不参与相似度计算
    model = milvus.get_embed_model()
    total = len(chunks)
    if total == 0:
        return []

    #2.记录所有的向量数组
    vectors: List[List[float]] = []

    #3.按照批处理来向量化
    #   看向量化的进度
    #一批一批地算 不是一条条算:嵌入模型一次算一批能把算力吃满 比循环里单条算快得多
    #也没有一次性全塞进去:几千条一起算内存吃不住 分批还能看见进度 卡住了也知道卡在哪
    for i in range(0, total, batch_size):
        batch = chunks[i:i + batch_size]
        questions = [c["question"] for c in batch]
        #get_text_embedding_batch返回的是和入参一一对应的向量列表
        vectors.extend(model.get_text_embedding_batch(questions))
        print(f"已向量化 {min(i + batch_size, total)}/{total}", flush=True)

    return vectors


#4.处理向量化的结果
#5.构建待插入的数据
def insert_vectors(chunks: List[dict], vectors: List[List[float]]) -> int:
    #4.处理向量化的结果
    #数量和维度都先核对一遍 对不上就别往里插了
    #数量对不上说明中间丢过数据 硬插进去文本和向量会错位
    #   (错位的现象特别迷惑:检索能查到东西 但返回的答案跟问题八竿子打不着)
    if len(chunks) != len(vectors):
        raise RuntimeError(
            f"文本数和向量数对不上:{len(chunks)} vs {len(vectors)}"
        )
    if not chunks:
        print("没有可入库的数据")
        return 0

    #维度也要对得上:集合建的时候维度就定死了 长度不一样的向量会被Milvus直接拒掉
    #提前检查是为了让报错看得懂 不然等Milvus抛出来的是串grpc错误
    if len(vectors[0]) != DIMENSION:
        raise RuntimeError(
            f"向量维度对不上:嵌入模型给出{len(vectors[0])}维 "
            f"集合是按{DIMENSION}维建的。换过嵌入模型的话 "
            f"DIMENSION(来自ragPromptEnhancer.py)要跟着改"
        )

    #5.构建待插入的数据
    #milvus.insert要的是两个平行列表:texts是原文 vectors是对应的向量
    #下标必须一一对应 ------ texts[0]配的就是vectors[0] 顺序乱了这个块就废了
    texts = [c["text"] for c in chunks]

    #向量必须显式传进去 不能让insert自己去算:
    #它默认会拿texts过一遍嵌入模型 那算出来的就是"问+答"整段的向量
    #口径和检索时用的"问题向量"不是一回事 传进去等于白算了
    result = milvus.insert(COLLECTION, texts, vectors)

    #insert返回{"insert_count":插了几条, "ids":[...]}
    #不同版本的返回结构不太一样 拿不到就按传进去的条数算
    try:
        return int(result["insert_count"])
    except (TypeError, KeyError, IndexError):
        return len(texts)


#检索之前统一确认一下连接和库
#和milvus.py里_ensure_loaded是一个思路:把"忘了先做某一步"这类坑堵在入口
#不这样做的话 单独调search/answer(没跑过前面那两步建库)会报"还没连接Milvus"
#或者更糟------连上了但停在default库上 查出来永远是空 还看不出哪里错了
def _ensure_connected():
    #没连过就连上:milvus.connect内部有单例判断 连过的话直接把现成的客户端返回
    milvus.connect(str(config.base_path / DB_FILE))
    if DB_NAME not in milvus.list_dbs():
        raise RuntimeError(
            f"库 {DB_NAME} 还不存在 说明数据还没入过库。"
            f"先完整跑一遍:python medical/backend/main.py"
        )
    #切到本模块用的库 不切的话collection和查询都还落在自带的default库里
    milvus.use_db(DB_NAME)


#6.数据检索
def search(question: str, limit: int = TOP_K) -> List[dict]:
    #单独拎出来是为了能"只跑检索":调门槛、看分数分布、确认库里到底有没有相关内容时用得上
    #(什么都不改就跑整条链的话 看到的只有最终回答 分不清是检索没捞到还是模型答坏了)
    _ensure_connected()
    #ragPromptEnhancer.search内部已经把milvus的返回压成{"id","score","text"}了 直接用
    return ragPromptEnhancer.search(question, limit)


#7.提示词增强(可以复用之前实现的方法)
def build_prompt(question: str,
                 top_k: int = TOP_K,
                 min_score: float = MIN_SCORE) -> str:
    #ragPromptEnhancer.generate_prompt已经把这条链路整个串好了:
    #   检索 → 按分数过滤掉不相关的 → 逐块压缩掉废话 → 填进提示词模板
    #这里直接复用 不再自己实现一遍(重复实现的话两边口径迟早会走偏)
    #
    #想省掉压缩那一步(每块都要调一次模型 又慢又花钱)就传compress=False
    #
    #连接要在这里自己确保一次:generate_prompt走的是ragPromptEnhancer自己的检索
    #它不经过下面那个search() 光在那儿加保护管不到这条路径
    _ensure_connected()
    return ragPromptEnhancer.generate_prompt(question, top_k, min_score)


#8.LLM生成(可以调用util中实现的方法)
def answer(question: str,
           top_k: int = TOP_K,
           min_score: float = MIN_SCORE) -> str:
    #先拿到增强后的提示词(第7步)
    prompt = build_prompt(question, top_k, min_score)

    #再把它交给大模型
    #util.chat_stream是现成的流式封装:模型吐一段这里就出一段 不用等整段生成完
    #   (整段生成完再打印的话 长回答要干等好几秒 用户会以为卡死了)
    #
    #提示词里已经带了【角色】【任务】【上下文】【输出要求】 本身就规定了模型该怎么答
    #所以这里不再另传system_prompt 传了反而可能跟模板里的要求打架
    print("回答:", end="", flush=True)
    pieces = []
    for piece in util.chat_stream(prompt):
        pieces.append(piece)
        print(piece, end="", flush=True)
    print()

    return "".join(pieces)


def main():
    #1.数据分块
    chunks = chunk_qa()
    if not chunks:
        print("没读到数据 后面的步骤没法进行")
        return
    #挑一条打出来看看长什么样 有问题一眼能看出来
    print(f"\n分块示例:\n{chunks[0]['text']}\n")

    #2.创建向量数据库
    init_vector_db()

    #3.数据向量化(只算问题的向量)
    vectors = embed_questions(chunks)

    #4.处理向量化的结果 → 5.构建待插入的数据 → 入库
    inserted = insert_vectors(chunks, vectors)
    print(f"\n入库完成 共{inserted}条")

    #6.检索 → 7.提示词增强 → 8.LLM生成
    #一条链路跑完了 最后留个口子手动问几句 验证整条路是通的
    print("\n" + "=" * 28 + " 可以开始提问了 " + "=" * 28)
    while True:
        try:
            question = input("\n请输入你的问题(直接回车退出):").strip()
        except (EOFError, KeyboardInterrupt):
            #Ctrl+C 或者输入被管道读完了 都当正常退出 不要甩一屏报错
            print()
            break

        #空回车就退出 给个不用记指令的出口
        if not question:
            break

        print("正在检索并生成回答...", flush=True)
        answer(question)


if __name__ == "__main__":
    main()
7.3 Web框架:
7.3.1 FastAPI:
专⻔⽤来快速编写⾼性能 HTTP API 接⼝的 Python 现代 Web 框架。
核⼼功能:
- 定义接⼝路由( @app.get("/xxx") )
- 请求参数⾃动校验(路径、查询、请求体、⽂件、表单)
- ⾃动⽣成交互式接⼝⽂档 /docs 、 /redoc
- 原⽣⽀持异步 async/await ,性能极⾼
- ⾃动类型提示、数据解析、错误返回格式化
- 依赖注入、权限校验、Cookie/Header 解析
简单理解:负责写业务接⼝逻辑。
下载FastAPI框架:
pip install fastapi -i https://pypi.tuna.tsinghua.edu.cn/simple
7.3.2 Uvicorn
Python ASGI 异步 Web 服务器,专⻔⽤来运⾏ FastAPI / Starlette 写好的应⽤。
核⼼功能
- 监听端⼝,接收浏览器 / 客⼾端的 HTTP 请求
- 把请求转发给 FastAPI 框架处理
- 将 FastAPI 返回的结果返回给客⼾端
- ⽀持异步并发、热重载、多进程部署
简单理解:负责启动、托管、对外提供服务。
类似于java中的tomcat,用来运行写好的应用的
安装指令:
pip install uvicorn -i https://pypi.tuna.tsinghua.edu.cn/simple
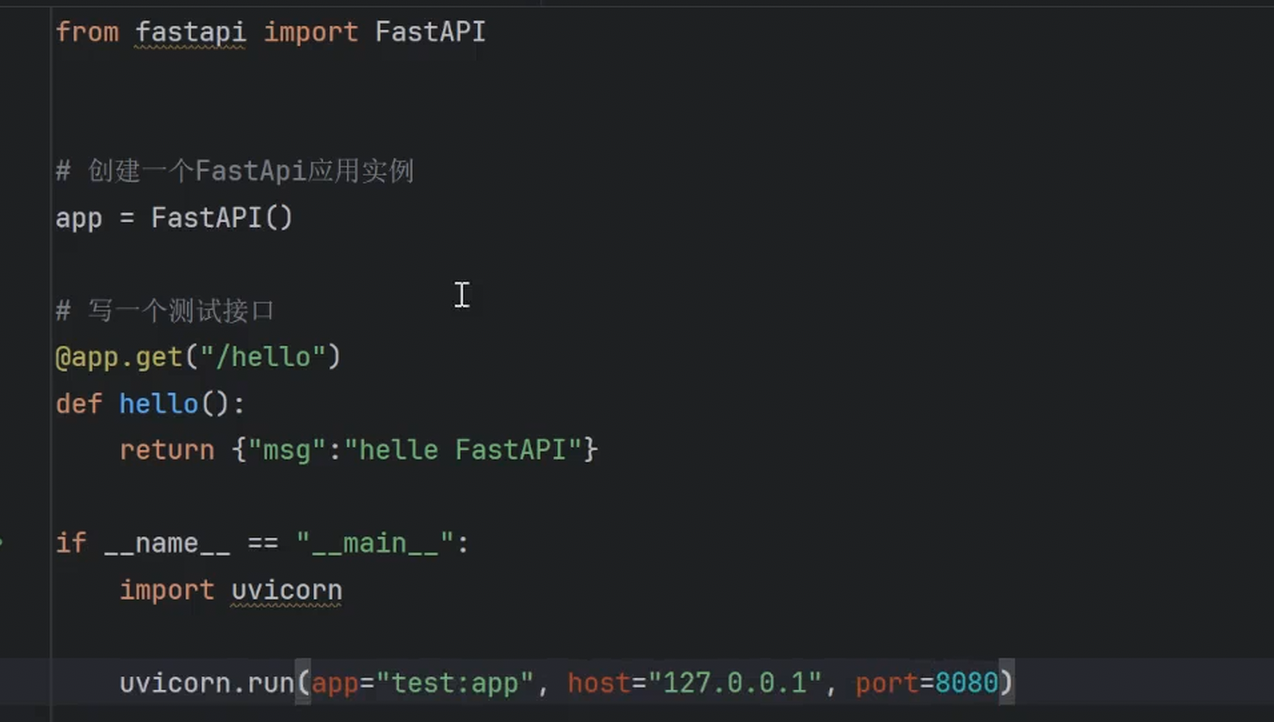
这里加上这个Uvicorn之后就可以启动服务了:
这里看到服务已经正常启动起来了并且返回值也是正确的
7.3.3 接口的定义与实现:
我们这里需要两个接口,一个是重建索引的接口用来读取 CSV 医疗问答数据,清空并重建 Milvus 向量库(只要数据集发生改变,对应的向量数据库就需要改变)。还需要一个接口医疗问答是接收⽤⼾问题,通过向量检索相关问答⽚段,并调⽤⼤模型⽣成回答。
重建向量索引接口文档:
| 项目 | 说明 |
|---|---|
| 路径 | /api/rebuild-index |
| 方法 | POST |
| 请求体 | 无 |
请求示例
POST /api/rebuild-index HTTP/1.1
Host: 127.0.0.1:8080
Content-Type: application/json
响应
{
  "ok": true,
  "message": "索引构建完成,写入 Milvus 123 条"
}| 字段 | 类型 | 说明 |
|---|---|---|
| ok | boolean | 是否成功,成功时为 true |
| message | string | 结果描述,包含写入 Milvus 的条数 |
医疗问答的接口文档:
接收用户问题,通过向量检索相关问答片段,并调用大模型生成回答。
| 项目 | 说明 |
|---|---|
| 路径 | /api/ask |
| 方法 | POST |
| 请求体 | JSON |
请求体
表格
| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
| question | string | 是 | 用户提出的问题,不能为空或纯空白 |
请求示例
POST /api/ask HTTP/1.1
Host: 127.0.0.1:8080
Content-Type: application/json

{
  "question": "高血压的常见症状有哪些?"
}
响应 成功
{
  "answer": "高血压常见症状包括......",
  "sources": [
    {
      "rank": 1,
      "score": 0.8523,
      "text": "检索命中的问答片段全文",
      "metadata": {
        "question": "来源问题",
        "id": "来源记录 ID"
      }
    }
  ]
}| 字段 | 类型 | 说明 |
|---|---|---|
| answer | string | 大模型生成的回答 |
| sources | array | string | 引用来源列表;无相关文档时为 empty string "" |
sources 数组元素:
| 字段 | 类型 | 说明 |
|---|---|---|
| rank | integer | 来源排序序号 |
| score | number | 相似度分数(0~1,越高越相关) |
| text | string | 检索命中的文本片段 |
| metadata.question | string | 来源问答中的问题 |
| metadata.id | string | 来源记录 ID |
整个后端代码的实现:
python
#医疗问答 RAG 的 HTTP 服务入口
#
#职责:把 main.py 里那条建库链路(分块 → 建库 → 向量化 → 入库)包成接口给前端调
#不做任何业务逻辑的实现:分块、向量化、入库全在 main.py 里 这里只是把它串起来
#重复实现一遍的隐患是两边口径会慢慢走偏(比如这边忘了只拿问题算向量)
#现象是"接口跑通了 但检索答非所问" 排查起来很费劲 不如让它们只有一个出处
import sys
import threading
import traceback
from importlib.util import module_from_spec, spec_from_file_location
from pathlib import Path
from typing import List

from fastapi import FastAPI, Request
from fastapi.exceptions import RequestValidationError
from fastapi.middleware.cors import CORSMiddleware
from fastapi.responses import JSONResponse
from pydantic import BaseModel, Field

#config.py 在项目根目录 而本文件在 medical/backend 下面
#python默认只找脚本自己所在的目录 根目录不加进来下面那些 import 会报 ModuleNotFoundError
sys.path.insert(0, str(Path(__file__).resolve().parents[2]))

#检索、过滤、压缩、拼提示词这几件事在 ragPromptEnhancer 里已经实现好了
#生成回答用 util 的流式对话封装
#这两个跟 main.py 用的是同一份 接口里不再各写一套
import ragPromptEnhancer
import util

#加载同目录下的 main.py
#
#这里不用 "import main" 是因为项目根目录下也有一个 main.py 两个文件同名
#根目录刚被插到了搜索路径的最前面 谁先被找到取决于插入顺序 一旦拿到根目录那个
#跑起来是数据清洗的演示代码 跟建库没有半点关系 而且不会报错 很难看出哪里不对
#按文件路径加载就绕开了这个歧义:要哪个文件写得清清楚楚
_MAIN_FILE = Path(__file__).resolve().parent / "main.py"
_spec = spec_from_file_location("medical_backend_main", _MAIN_FILE)
pipeline = module_from_spec(_spec)
#先登记再执行:模块自己(或它导入的东西)回头按名字取它时能取到
sys.modules[_spec.name] = pipeline
_spec.loader.exec_module(pipeline)

#导入 main.py 本身没有副作用:它内部那些重活(读数据、加载嵌入模型、连 Milvus)
#都写在函数里 模块级只有常量和函数定义 所以服务启动时不会又跑一遍建库
#(真正加载 bge-m3 要读几百M权重 是第一次请求时才发生的 那一次会明显慢一些)

#索引上的读写锁
#
#重建索引是"先清空再重灌" 清空和重灌之间库里是空的(全量数据下能空好几个小时)
#所以"写"(重建)不光要跟别的写互斥 还得跟"读"(问答)互斥:
#   光挡住两个重建同时跑是不够的 ------ 重建跑到一半有提问进来
#   检索捞到的是个空库 会一本正经地回"文档中不存在" 用户只会以为系统坏了
#   (更糟的是重建里的 release/load 撞上检索里的加载检查 直接抛异常)
#
#读读并行(两个提问之间互不干扰)写独占(重建期间谁也别碰)
#
#全部是非阻塞获取:抢不到就立刻回绝 不排队等
#等是没意义的 ------ 提问排队等重建跑完 等到的那份数据早就不是它想查的了
#不如当场告诉调用方"正忙 稍后再试" 前端还能给个提示
class _ReadWriteLock:
    def __init__(self):
        #只保护下面两个计数/标志 拿到手看一眼就放
        #不是把整个检索过程压在这把锁上(那又退化成一把普通的互斥锁了)
        self._guard = threading.Lock()
        self._readers = 0      #这会儿有几个人在读
        self._writing = False  #这会儿有没有人在写

    #申请读:已经有写者在跑就不放行
    def acquire_read(self) -> bool:
        with self._guard:
            if self._writing:
                return False
            self._readers += 1
            return True

    def release_read(self) -> None:
        with self._guard:
            self._readers -= 1

    #申请写:有读的(哪怕只有一个)或者已经有人在写 都不放行
    #一个读者都不能放进去 ------ 重建中途进来的检索只能读到半库数据
    def acquire_write(self) -> bool:
        with self._guard:
            if self._writing or self._readers:
                return False
            self._writing = True
            return True

    def release_write(self) -> None:
        with self._guard:
            self._writing = False


_index_lock = _ReadWriteLock()

app = FastAPI(title="医疗问答 RAG 服务", version="0.1.0")

#跨域放行:这个服务是给前端调的 前端多半跑在另一个端口上
#不加的话浏览器会直接把请求拦在预检那一步 表现是"接口自己测是通的 页面上就是调不动"
#本地开发图省事全放开 真要对外部署再把 allow_origins 收紧成具体的域名
app.add_middleware(
    CORSMiddleware,
    allow_origins=["*"],
    allow_methods=["*"],
    allow_headers=["*"],
)


#统一响应体:成功失败都长 {"ok":..., "message":...} 这个样子
#接口文档里成功时是这么定的 失败也照着来
#这样前端判一个 ok 字段就够了 不用一会儿看状态码一会儿看响应体 两套口径容易漏判
def _result(ok: bool, message: str, status_code: int = 200) -> JSONResponse:
    return JSONResponse(
        status_code=status_code,
        content={"ok": ok, "message": message},
    )


#从入库文本里把"问题"那段抠出来
#
#库里没有单独的问题字段(schema 就 id/text/vector 三个)问题只作为"问:xxx"这行
#跟答案一起混在正文里 而返回给前端的来源要单独给出"来源问题" 只能从文本里反解
#
#反解用的是 main.py 里那个入库模板本身 不是在这儿重写一遍"问:""答:"这两个字面量
#模板哪天改了(比如前面加上科室) 这里跟着一起变 不会悄悄失效
#现象要是真失效了很隐蔽:接口照样返回 只是来源问题里多带一段"问:"或者带出答案
_TPL_HEAD, _, _TPL_REST = pipeline._QA_TEMPLATE.partition("{question}")
_TPL_SEP = _TPL_REST.partition("{answer}")[0]


#从"问:xxx\n答:yyy"里取回 xxx
def _parse_question(text: str) -> str:
    #先切掉答案那一段:用 partition 只切第一刀 答案里万一还有"答:"也不会被误切
    body = text.partition(_TPL_SEP)[0]
    #再摘掉开头的"问:"(模板变了这行也只是白跑一次 不会切坏内容)
    if body.startswith(_TPL_HEAD):
        body = body[len(_TPL_HEAD):]
    return body.strip()


#把检索结果整理成接口文档里 sources 那个结构
def _to_sources(blocks: List[dict]) -> List[dict]:
    return [
        {
            #排名从1开始 跟提示词里"【资料1】"的编号对得上 用户能按着序号回头核对
            "rank": rank,
            #分数截到4位小数:原始分数是一长串浮点 对用户没意义 还占地方
            "score": round(float(b["score"]), 4),
            "text": b["text"],
            "metadata": {
                "question": _parse_question(b["text"]),
                #Milvus 的 id 是64位整数 原样给出前端(JS)接不住这么大的数 转成字符串
                "id": str(b["id"]),
            },
        }
        for rank, b in enumerate(blocks, start=1)
    ]


#提问接口的请求体
class AskRequest(BaseModel):
    #这里只声明类型 不在这儿用 pydantic 的约束去卡"不能为空"
    #因为那种报错回的是 FastAPI 自带的那套 {"detail":[...]} 跟本服务的 {"ok":...} 对不上
    #前端就得为这一类错单独写一套解析 不如放到函数里判 走同一个出口
    question: str = Field(..., description="用户提出的问题")


#请求体本身不合法(少了字段、类型不对)时 把 FastAPI 默认的 {"detail":[...]} 也掰成统一格式
#不然同一个服务里失败响应有两种长相 前端要么漏判要么得写两套
@app.exception_handler(RequestValidationError)
def _on_bad_request(request: Request, exc: RequestValidationError) -> JSONResponse:
    #errors() 里的 msg 是给人看的 取第一条就够(字段少的时候也只有一条)
    errors = exc.errors()
    detail = errors[0].get("msg", "参数不合法") if errors else "参数不合法"
    return _result(False, f"请求参数不合法:{detail}", status_code=422)


#重建向量索引
#
#注意这里是 def 不是 async def
#整条链路从头到尾都是同步阻塞的(读csv、跑嵌入模型算向量、等Milvus落盘)
#写成 async def 会把这些阻塞操作按在事件循环上 一个请求就能把整个服务卡死
#连别的接口都别想进来 直到它跑完为止
#FastAPI 见到普通的 def 会自动丢到线程池里执行 不占事件循环
#上面那把 threading.Lock 也是配着这个用法来的
@app.post("/api/rebuild-index")
def rebuild_index():
    #申请写锁 抢不到立刻回绝
    #抢不到有两种可能:另一个重建在跑 或者有提问正在检索
    #(后一种情况下等它跑完再重建也没问题 只是得让调用方自己重试
    #  一次问答也就几秒 提示他"稍后再试"比在这儿挂着连接强)
    if not _index_lock.acquire_write():
        return _result(
            False,
            "索引正忙(有重建任务或问答请求在执行中),请稍后再试",
            status_code=409,
        )

    try:
        #1.数据分块:读源数据目录下的csv 每条问答当成一块
        chunks = pipeline.chunk_qa()
        if not chunks:
            return _result(
                False,
                "源数据目录里没读到可用的问答数据,请检查数据目录",
                status_code=500,
            )

        #2.建库:保证库和集合在 并把集合里的旧数据清空
        #这一步是"重建"和"增量入库"的区别所在:老数据在这儿被删掉 后面灌进去的才是唯一一份
        pipeline.init_vector_db()

        #3.向量化:只算问题的向量(答只作为原文存着 不参与相似度计算)
        vectors = pipeline.embed_questions(chunks)

        #4.处理向量化的结果 → 5.构建待插入的数据 → 入库
        inserted = pipeline.insert_vectors(chunks, vectors)

        return _result(True, f"索引构建完成,写入 Milvus {inserted} 条")

    except Exception as exc:
        #任何一步炸了都在这儿兜住:源数据目录不存在、向量维度和集合对不上、
        #Milvus 被占用打不开、嵌入模型加载失败......都可能发生
        #不兜的话客户端拿到的是一个没有 body 的 500 看不出到底哪一步坏了
        #所以把异常原文带回去 同时把完整堆栈打到控制台(接口只回一行 排查还得看堆栈)
        traceback.print_exc()
        return _result(False, f"索引构建失败:{exc}", status_code=500)

    finally:
        #不管成功失败都要放锁 漏了这个 finally
        #一次失败之后这个接口就永远回"正在执行中"了 只能重启服务才恢复
        #(清理旧数据那步尤其容易失败:库被别的进程占着、磁盘没空间......
        #  而失败时锁要是没放掉 后面连查都查不了 好好的服务就这么废了)
        _index_lock.release_write()


#医疗问答
#
#跟生成索引那个接口一样是 def:检索要用嵌入模型算向量、压缩和生成要等大模型返回
#从头到尾都是同步阻塞的 写成 async def 会把这些等待全压在事件循环上 一个请求就能卡住整个服务
#
#整条链路(检索 → 过滤 → 压缩 → 拼提示词 → 生成)走的是 ragPromptEnhancer 里现成的函数
#没有直接调它的 generate_prompt 是因为那个函数把中间结果都吞在内部了
#而这个接口要额外吐出 sources 只能自己把这几步串起来
#串的时候一步没落 顺序也跟 generate_prompt 里一致(过滤在压缩前面)
@app.post("/api/ask")
def ask(payload: AskRequest):
    #首尾空白不算内容:"   " 这种问出去检索不到东西 大模型也只能瞎答 不如在这儿拦下来
    #(用 pydantic 的 min_length 卡长度拦不住纯空白 它只看字符个数)
    question = payload.question.strip()
    if not question:
        return _result(False, "问题不能为空", status_code=400)

    #申请读锁:重建正在跑的话这趟直接回绝
    #不在这儿等 ------ 重建可能持续很久(全量数据按小时算)等不起 而且等到的那份结果也不是这会儿该看到的
    #多个提问之间不互斥 只是跟"重建"互斥 所以并发的几个问答不会被这里挡住
    #
    #空问题那段校验放在抢锁前面:它压根不碰库 没必要为它占一次锁
    if not _index_lock.acquire_read():
        return _result(
            False,
            "索引正在重建中,暂时无法检索,请稍后再试",
            status_code=503,
        )

    try:
        #1.检索:拿问题去库里捞最像的几条
        #检索内部已经处理过"连没连上库""库在不在" 不用在这儿再确认一遍
        hits = pipeline.search(question)

        #2.过滤:卡相似度门槛 + 去重
        #库里一堆无关内容时 检索照样会返回 TOP_K 条(只是分数都很难看)这步就是把它们拦下来
        filtered = ragPromptEnhancer.filter_context(hits)

        #3.压缩:把每块里跟问题无关的句子摘掉 剩下的块才进提示词
        #这一步会调模型 也可能把整块判成"答不了这个问题"直接丢掉
        #一块都没剩下就别去调了 省几次没意义的请求
        kept = ragPromptEnhancer.compress_context(question, filtered) if filtered else []

        #4.挑出要放到 sources 里的块
        #范围是"真正参与了生成的那几块"(也就是被压缩环节留下来的)
        #文本用的是压缩前的原文:sources 是给人回头核对资料的 摘录过的片段没法核对
        #压缩后的块只留了 id 和分数 正文被换成摘录了 所以按 id 回压缩前的列表里取
        kept_ids = {b["id"] for b in kept}
        cited = [b for b in filtered if b["id"] in kept_ids]

        #5.拼提示词:模板里的【角色】【任务】那套约束都在这儿填进去
        #传的是压缩后的文本(跟模型看到的完全一致 ------ sources 给原文 模型看摘录 两者分工不同)
        prompt = ragPromptEnhancer.build_prompt(question, [b["text"] for b in kept])

        #6.生成回答
        #流式接口照样能拿到完整回答:边上边攒 攒到最后就是整段
        #对前端来说这是一个普通的同步接口 等生成完一次性返回(要边生成边推给前端得换 SSE)
        pieces = []
        for piece in util.chat_stream(prompt):
            pieces.append(piece)
        answer_text = "".join(pieces).strip()

        print(f"提问:{question}\n"
              f"  命中{len(hits)}条 过滤后{len(filtered)}条 压缩后{len(kept)}条 "
              f"回答{len(answer_text)}字", flush=True)

        #一条都没留下就按接口文档的要求回空串 而不是空数组
        #(文档里写死了 sources 是 array|string 前端多半按 falsy 判"没查到资料")
        sources = _to_sources(cited)
        return {
            "answer": answer_text,
            "sources": sources if sources else "",
        }

    except Exception as exc:
        #检索失败、大模型超时、密钥没配......都在这儿兜住
        #完整堆栈打控制台(接口只回一行 排查还得看堆栈)
        traceback.print_exc()
        return _result(False, f"回答失败:{exc}", status_code=500)

    finally:
        #跟重建那边一样:成败都要放锁
        #漏掉的话一次异常就会让重建永久回"索引正忙" 只能重启服务
        _index_lock.release_read()


if __name__ == "__main__":
    import uvicorn

    #这里传 app 对象而不是 "api:app" 字符串:字符串那种写法要靠模块名反查
    #从哪个目录启动、模块名怎么算都会影响能不能找到 传对象没这些问题
    #
    #不开 reload:reload 会为每个请求起子进程 而嵌入模型和 Milvus 连接都是进程内单例
    #换进程就得重来一遍(模型要重新加载)本地调接口会慢到没法用
    uvicorn.run(app, host="127.0.0.1", port=8080)
7.7.4 前端:
我们前端就交给AI来生成即可了,这里就不过多赘述了,我们前端是用vue3来写的 然后现在我们要启动服务的话先把前端这些依赖和前端先部署了
首先先进入到对应的文件夹,也就是你先前端代码的那部分:
然后使用npm安装对应的依赖
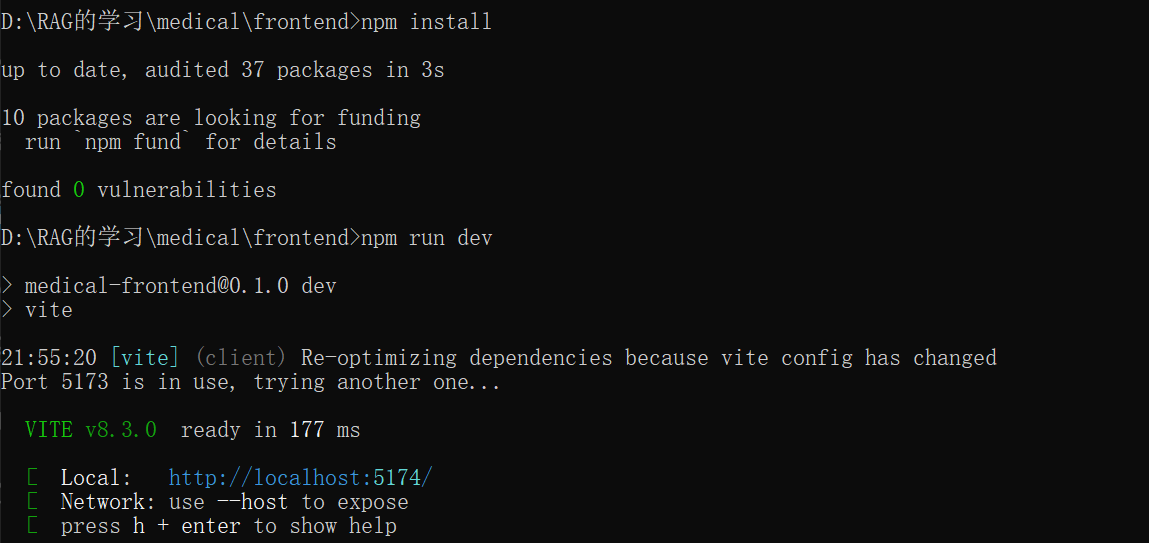
然后再npm run dev 服务就起来了,然后再运行后端代码即可
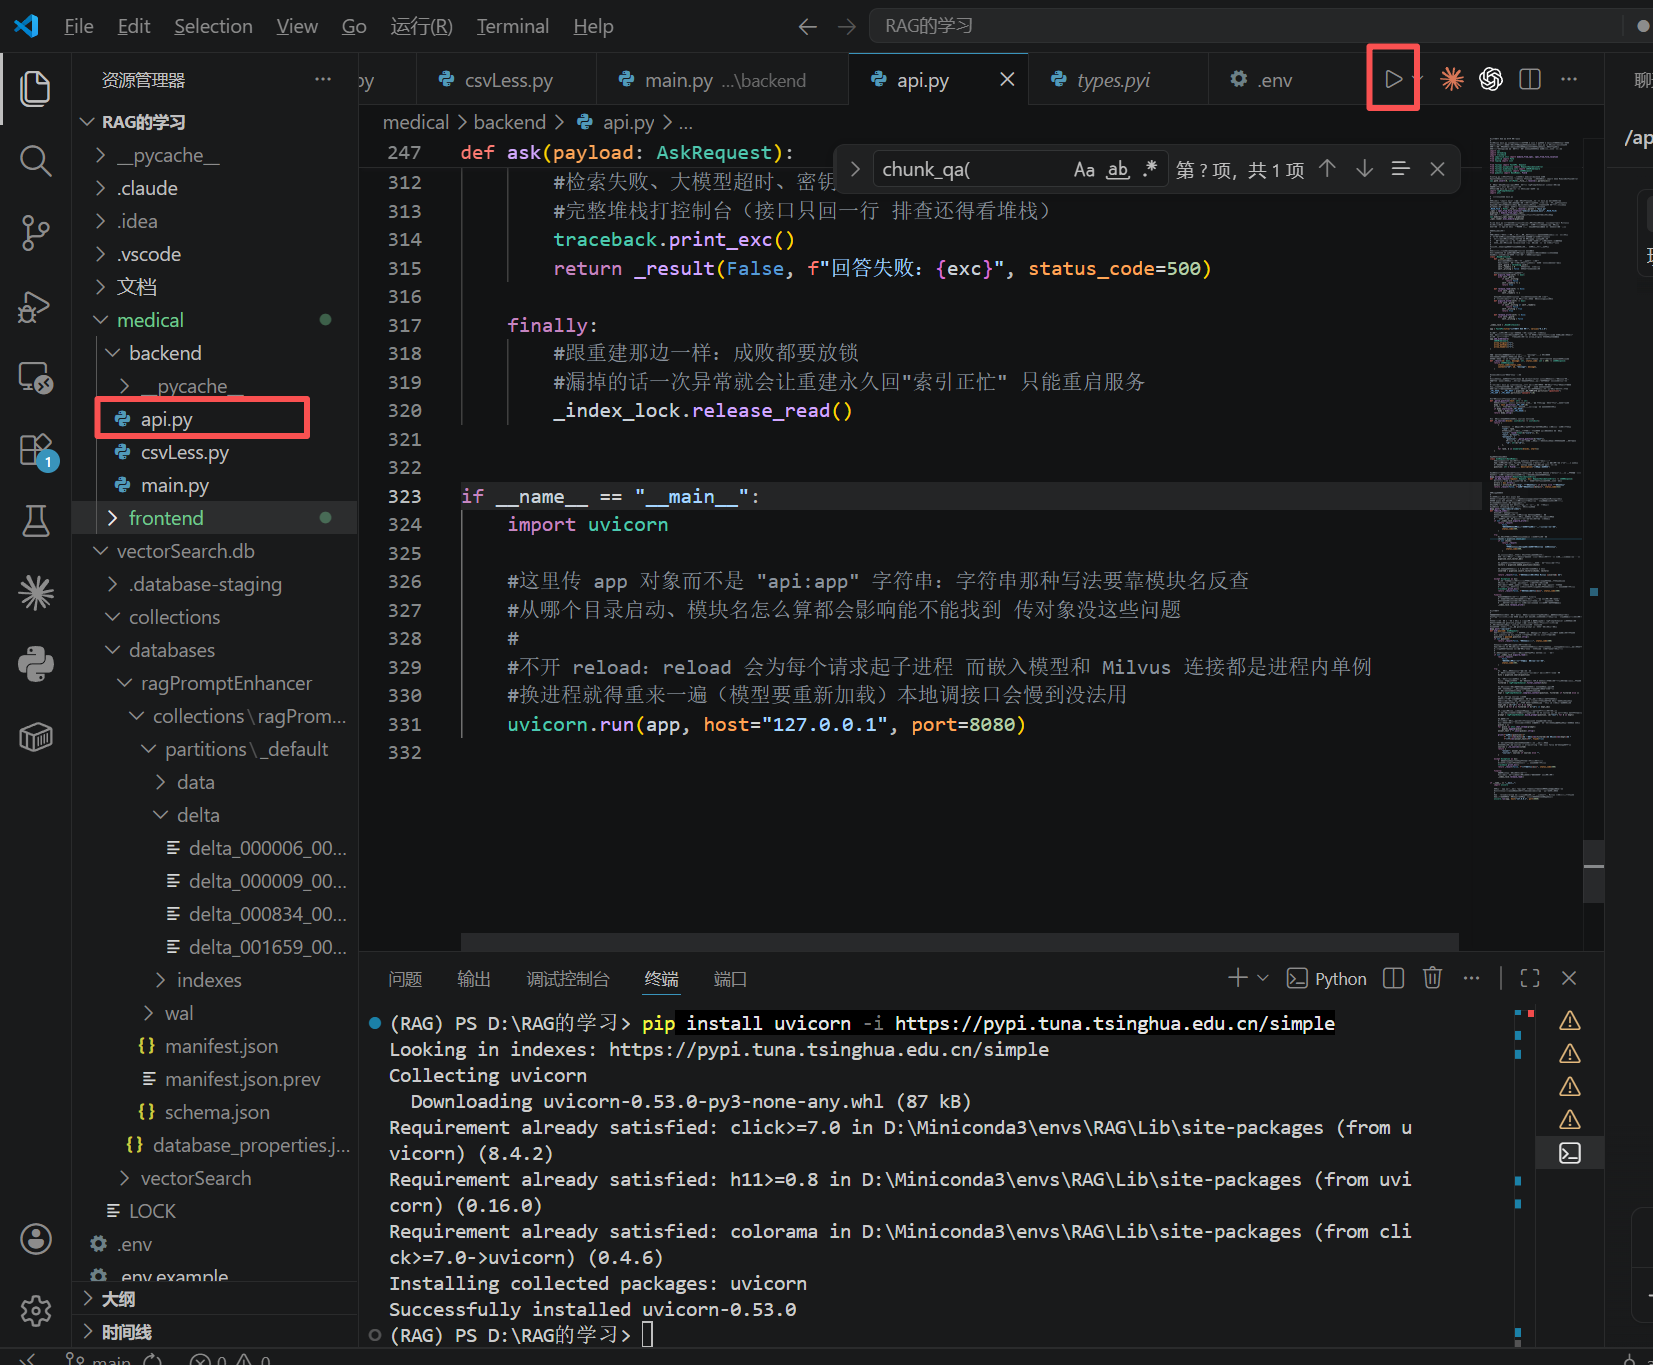
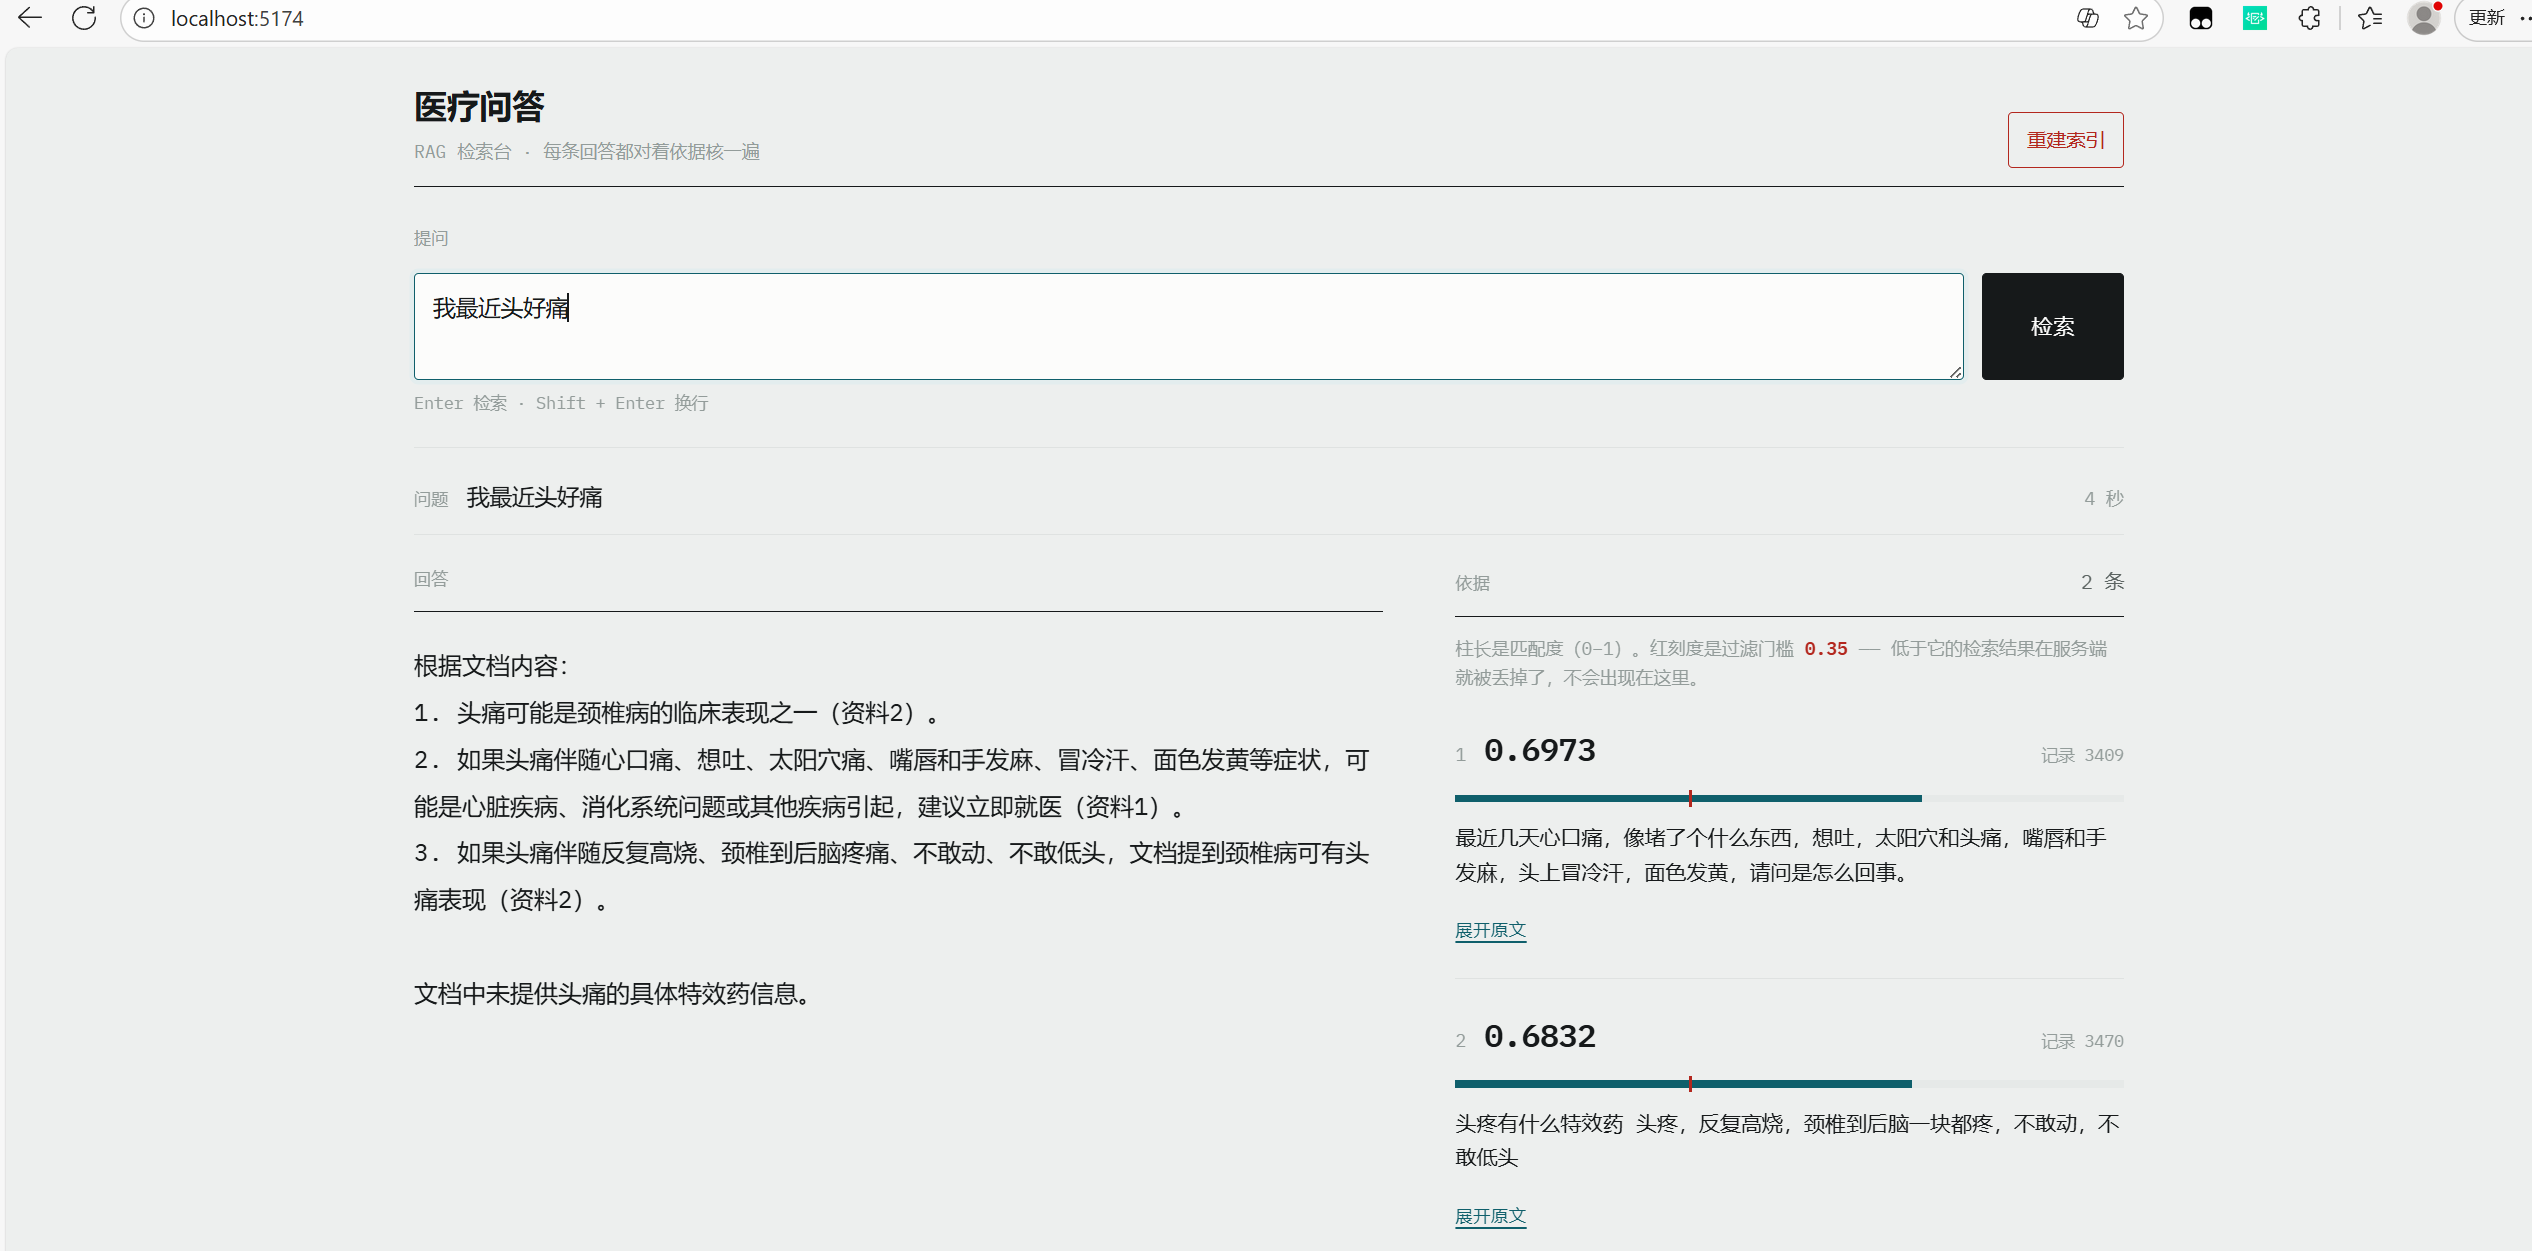
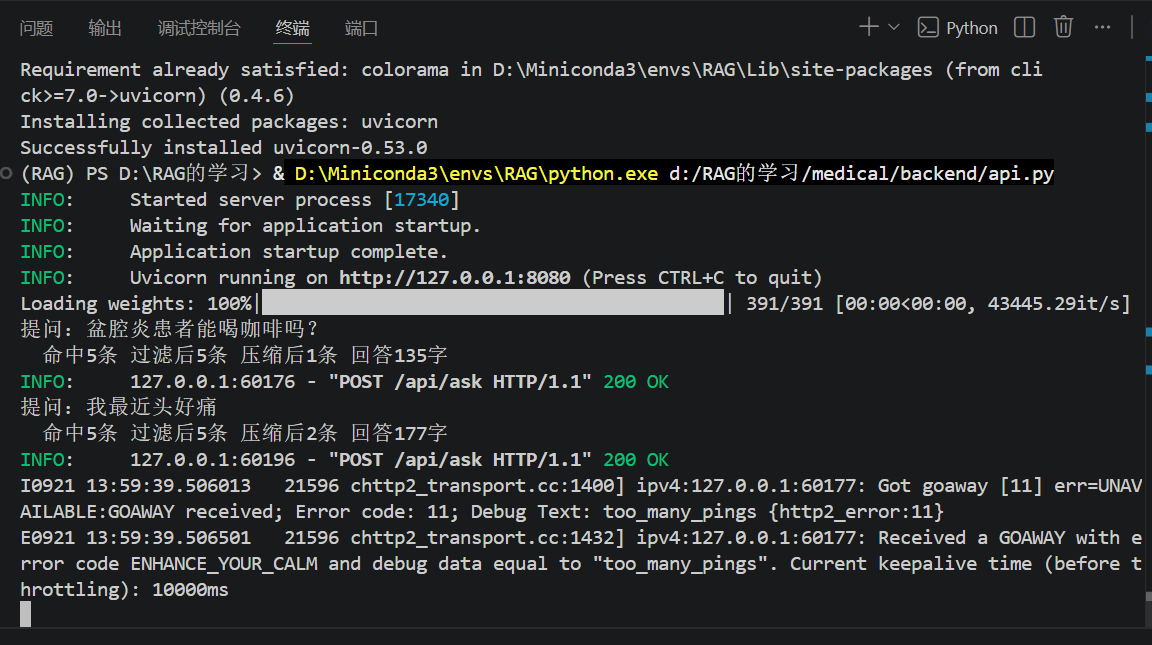
这样我们整个RAG的初阶学习就到这里了,谢谢大家的阅读!