原文链接:Dify 知识库 RAG 实战:把 100 页手册变成会回答的 AI
上一篇《30 分钟跑通 Dify:Docker 一键部署,5步上线首个AI应用》把环境搭起来之后,紧接着的问题很实际:公司那本一百来页的产品手册,怎么让它自己回答问题?
把整本手册塞进 Prompt 不现实------上下文装不下,装得下也贵。Dify 知识库的思路是不让模型死记,而是把文档切成小段,提问时只把最相关的几段递给它。
这篇是我在本地 Dify 上完整走一遍的记录:建库、传文档、分段、召回、问答,附上有无知识库的对比,以及关键词、向量、重排三套召回策略的实测数据。
一、RAG 到底改了哪一步
RAG 不是一步操作,是三件事串起来的流水线:索引 → 召回 → 生成。
索引把 PDF、Word、Markdown 切成段,建成可检索的库;召回按问题捞最相关的几段;生成则把这几段塞进 Prompt,让模型照着原文答。
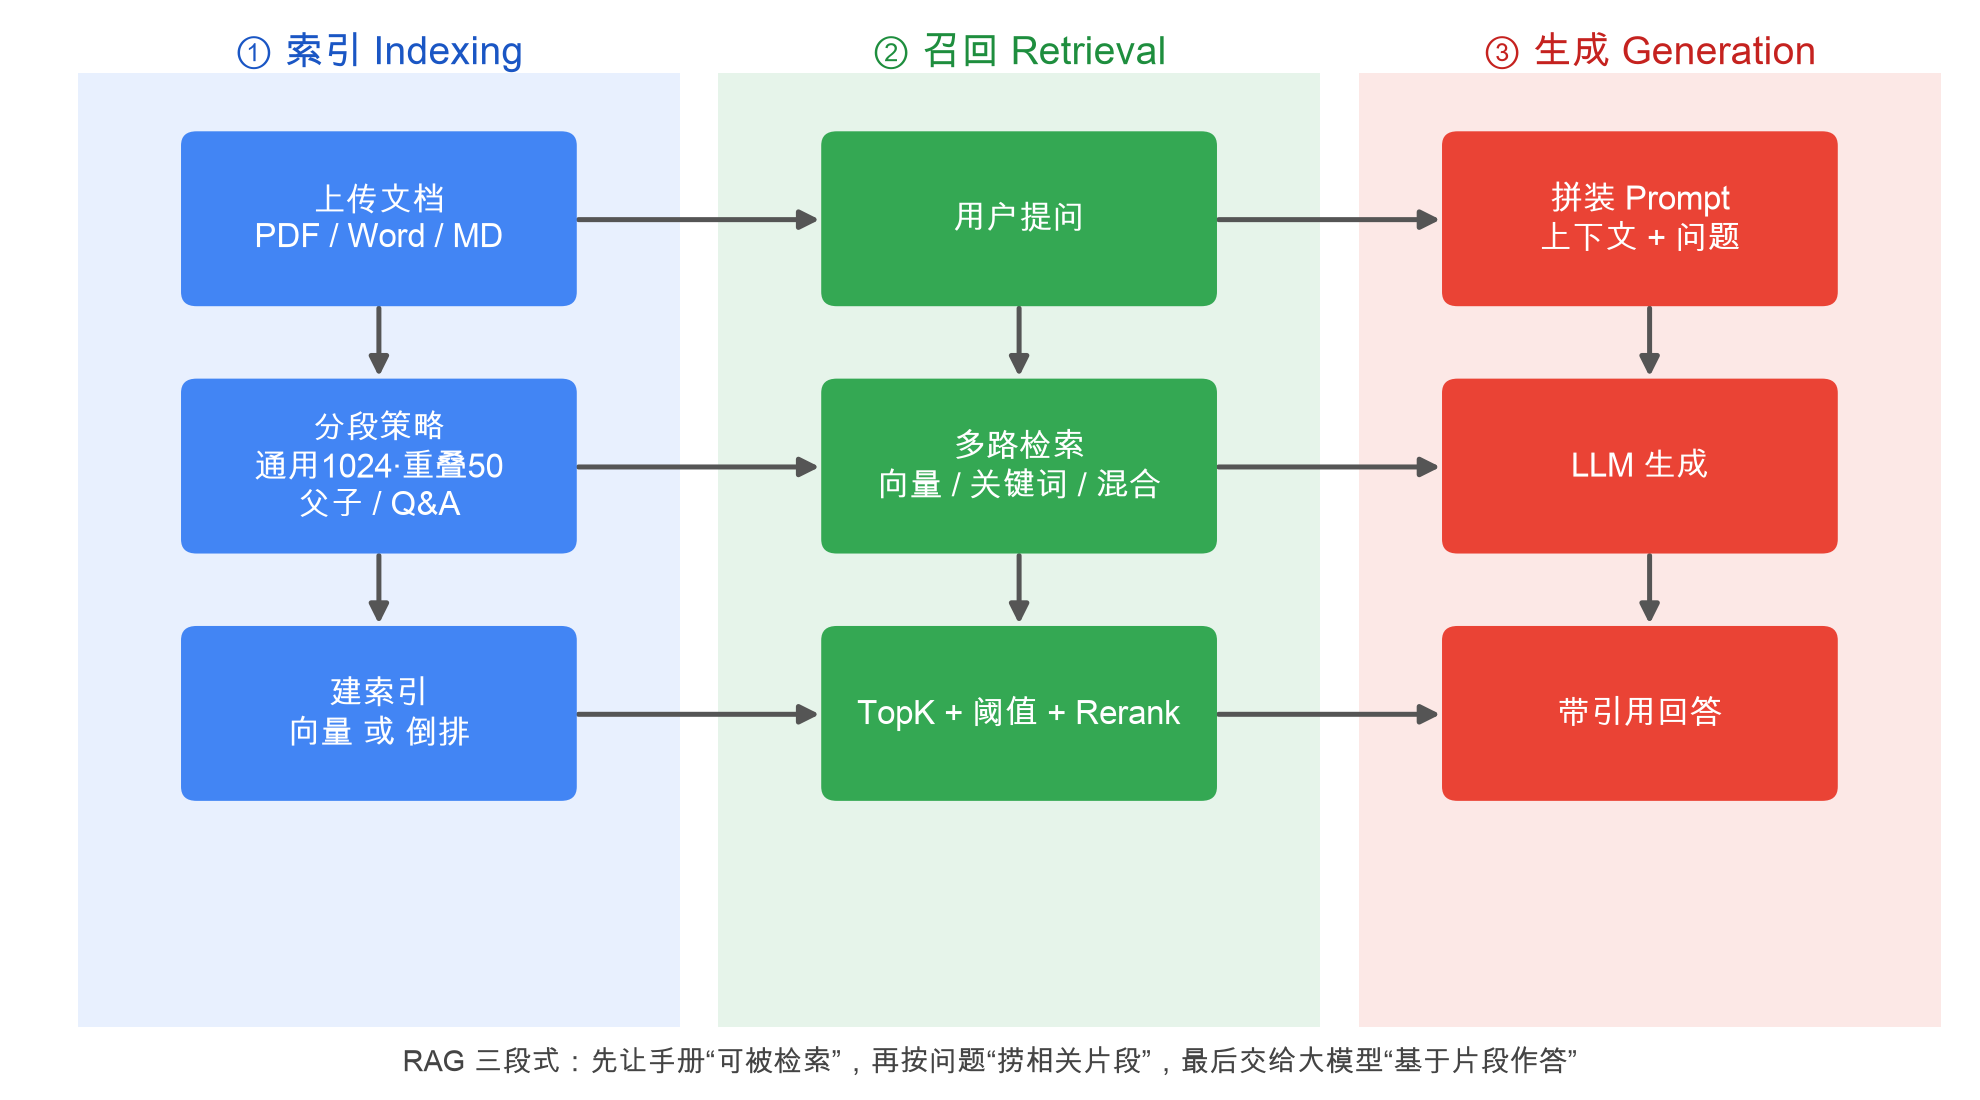
三段里最容易出问题的是召回。遇到"知识库答非所问",第一反应往往是模型不行,但多数时候那轮根本没把对的段落捞出来。
微软研究院在《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》里做过对照:同一个模型,喂对上下文之后准确率能提升 20% 以上。
所以排优先级,先确认"正确的那段话能不能被找到",再考虑换模型。
二、先建一个能被检验的知识库
测试文档我用的是《星火会议纪要系统》手册,五节:支持的音频格式、处理时长、方言支持、私有化显存、说话人区分。
它短,但事实点密集,每个问题都有唯一正确答案,方便判断召回对不对。
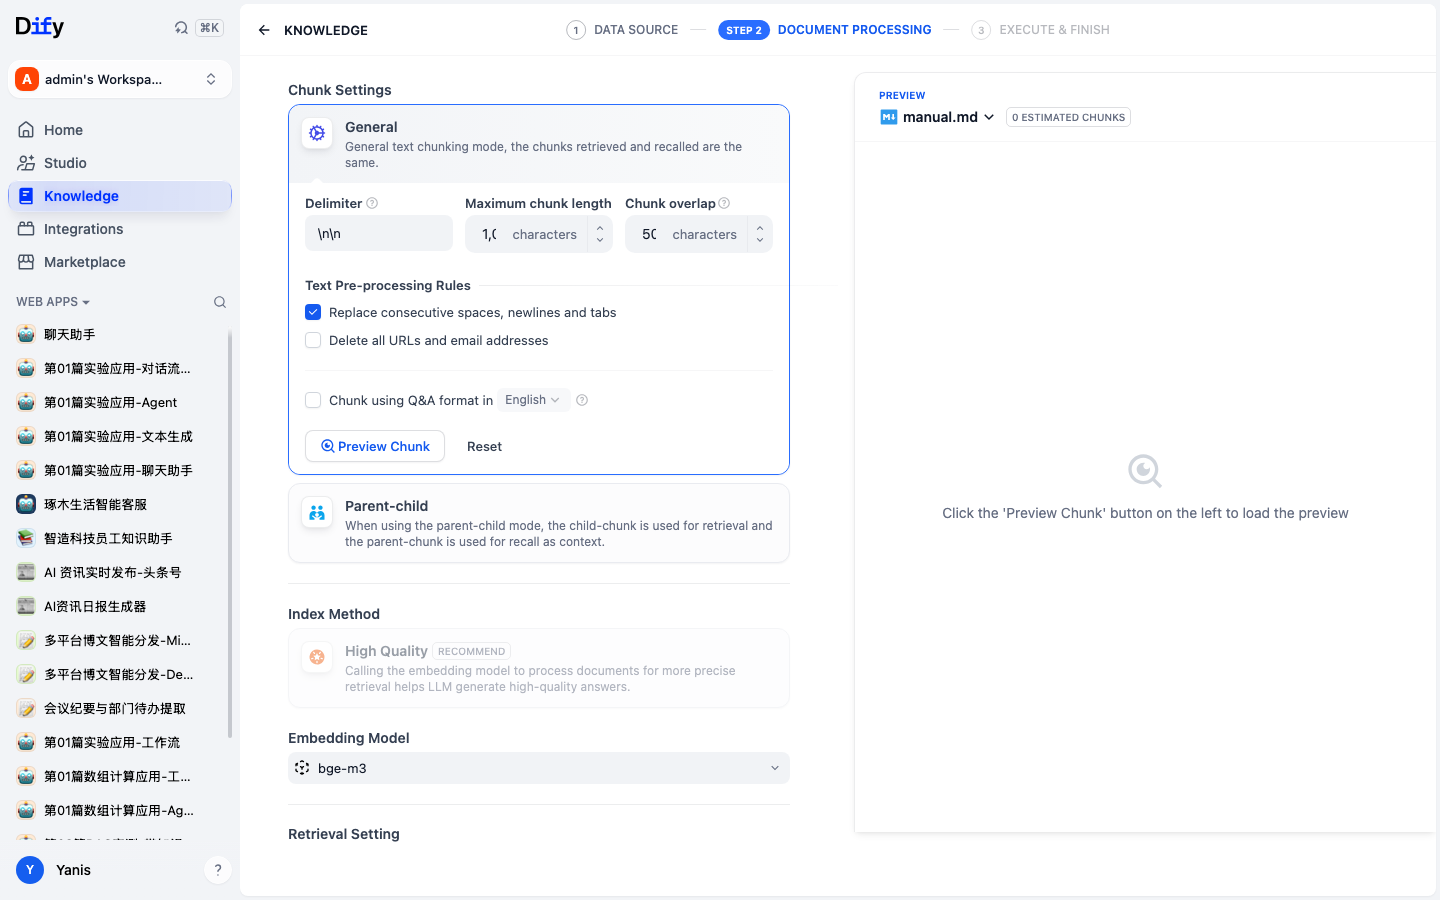
上传后 Dify 给出通用分块预览:分隔符 \n\n、最大长度 1024、重叠 50,切成 6 段。重叠 50 的作用是防止一句话刚好被切断,导致召回时丢上下文。
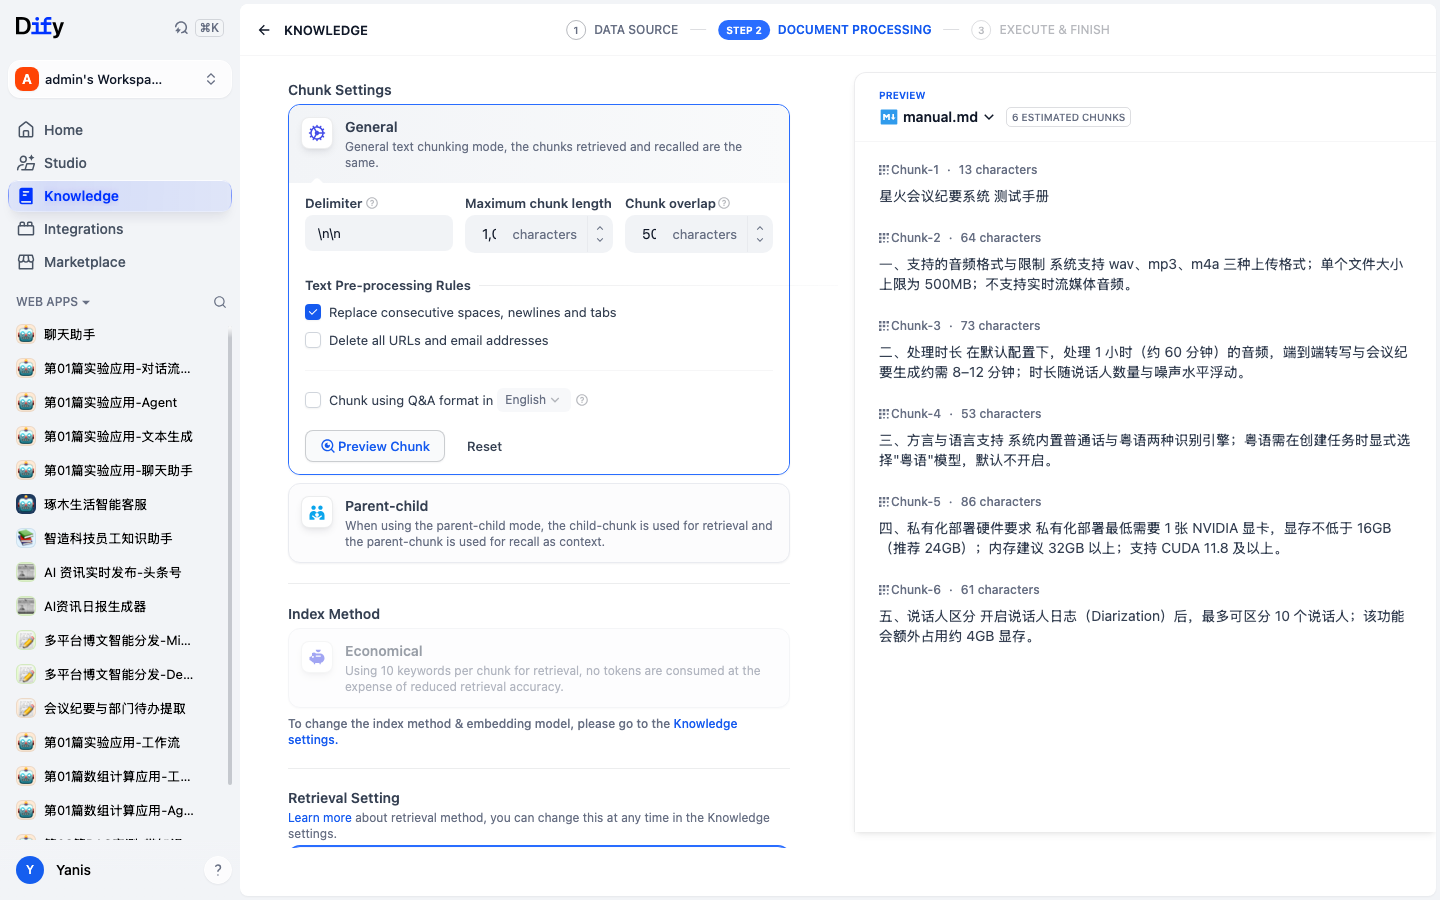
分段方式 Dify 提供三种:通用分块、父子分段(Parent-Child)、Q&A 分段。手册、制度这类连续叙述的文档用通用分块就够,只有原始材料本身就是问答对时,才值得切 Q&A。
本次操作只新增自己的测试文档、数据集和应用,没动别人已有的任何配置。
三、召回测试:先回答"找得到吗"
文档索引完成,先单独验检索,别急着开聊天窗口。
四个问题跑下来,命中的段落都对得上:
| 问题 | 命中间片 | 关键证据 |
|---|---|---|
| 星火系统支持哪些音频格式? | Chunk-02 | 支持 wav、mp3、m4a,单个文件上限 500MB |
| 处理 1 小时音频大约需要多久? | Chunk-03 | 端到端约需 8--12 分钟 |
| 这套系统支持粤语吗? | Chunk-04 | 内置普通话与粤语两种识别引擎 |
| 私有化部署最低需要多少显存? | Chunk-05 | 显存不低于 16GB(推荐 24GB) |
第一个问题命中 Chunk-02,wav、m4a、mp3、500MB 几个关键词被高亮标出:
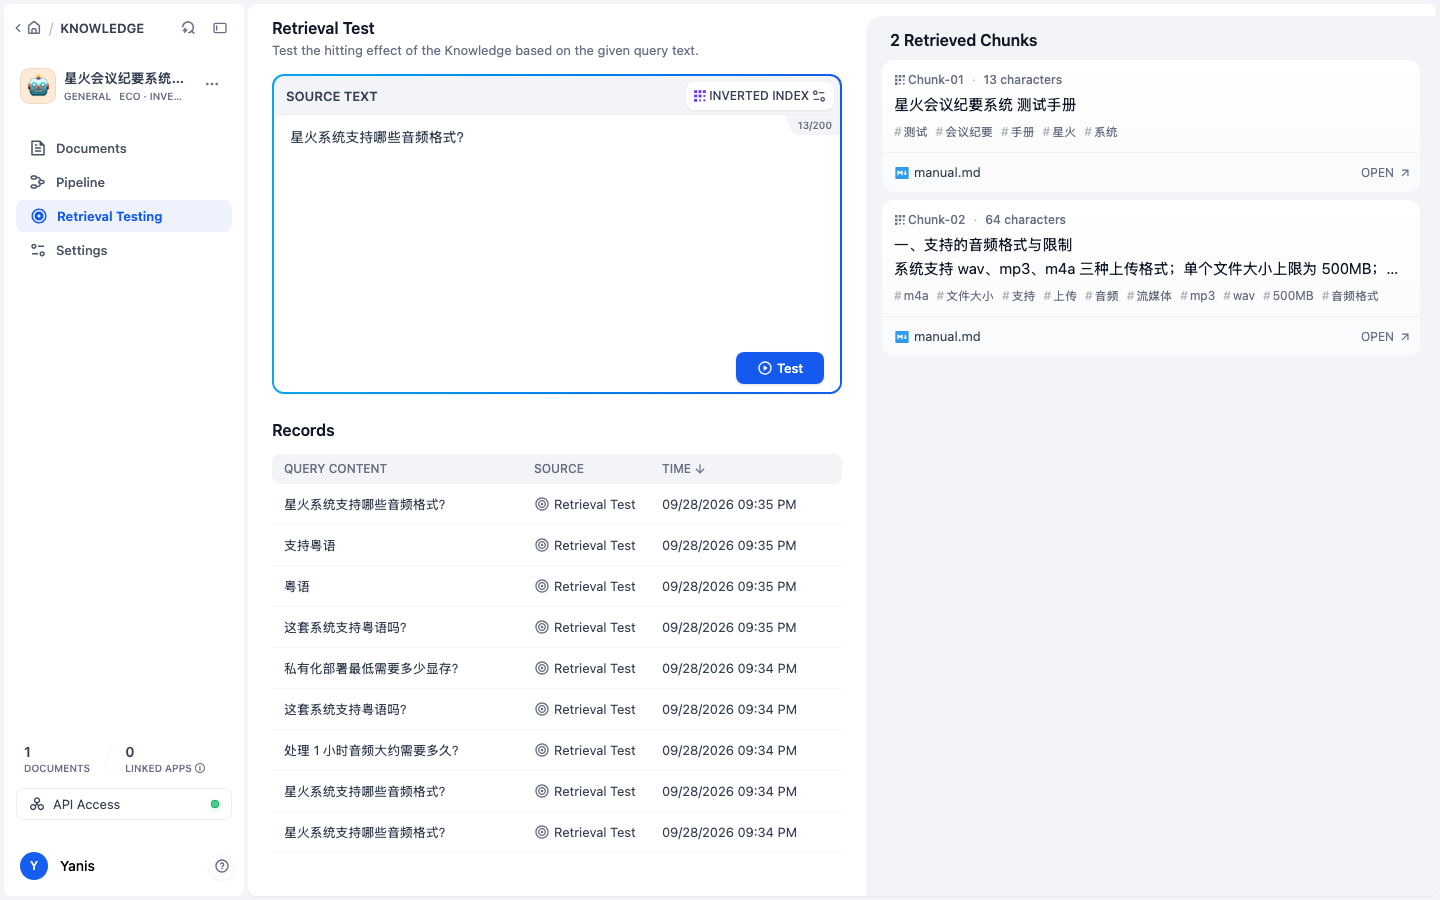
这一步只回答"找不找得到"。排得准不准,第五节用数据说。
四、有没有知识库,答案差多少
对照用的是两个配置完全一样的聊天助手,唯一区别是一个关联了上面那个知识库。
同样问:"星火系统支持哪些音频格式?"
关联知识库的那个,答 wav、mp3、m4a,末尾挂着引用,点开就是 manual.md 里的原文。
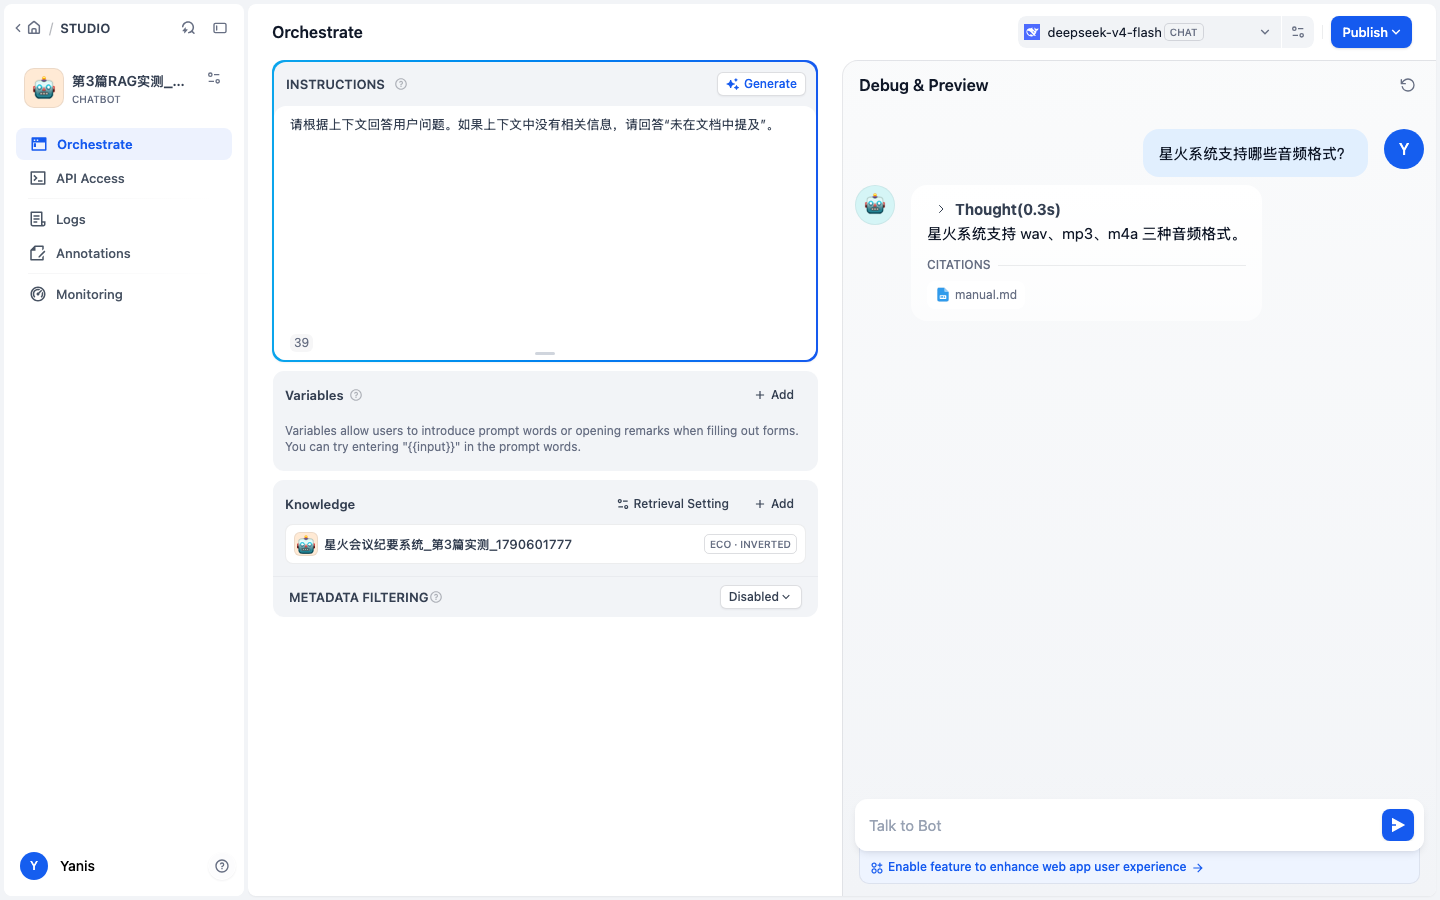
没关联的那个,直接把"星火系统"认成了科大讯飞星火,洋洋洒洒列了一堆 PCM、WAV、MP3、M4A、AMR、OPUS,甚至开始怀疑你说的是不是 Apache Spark。
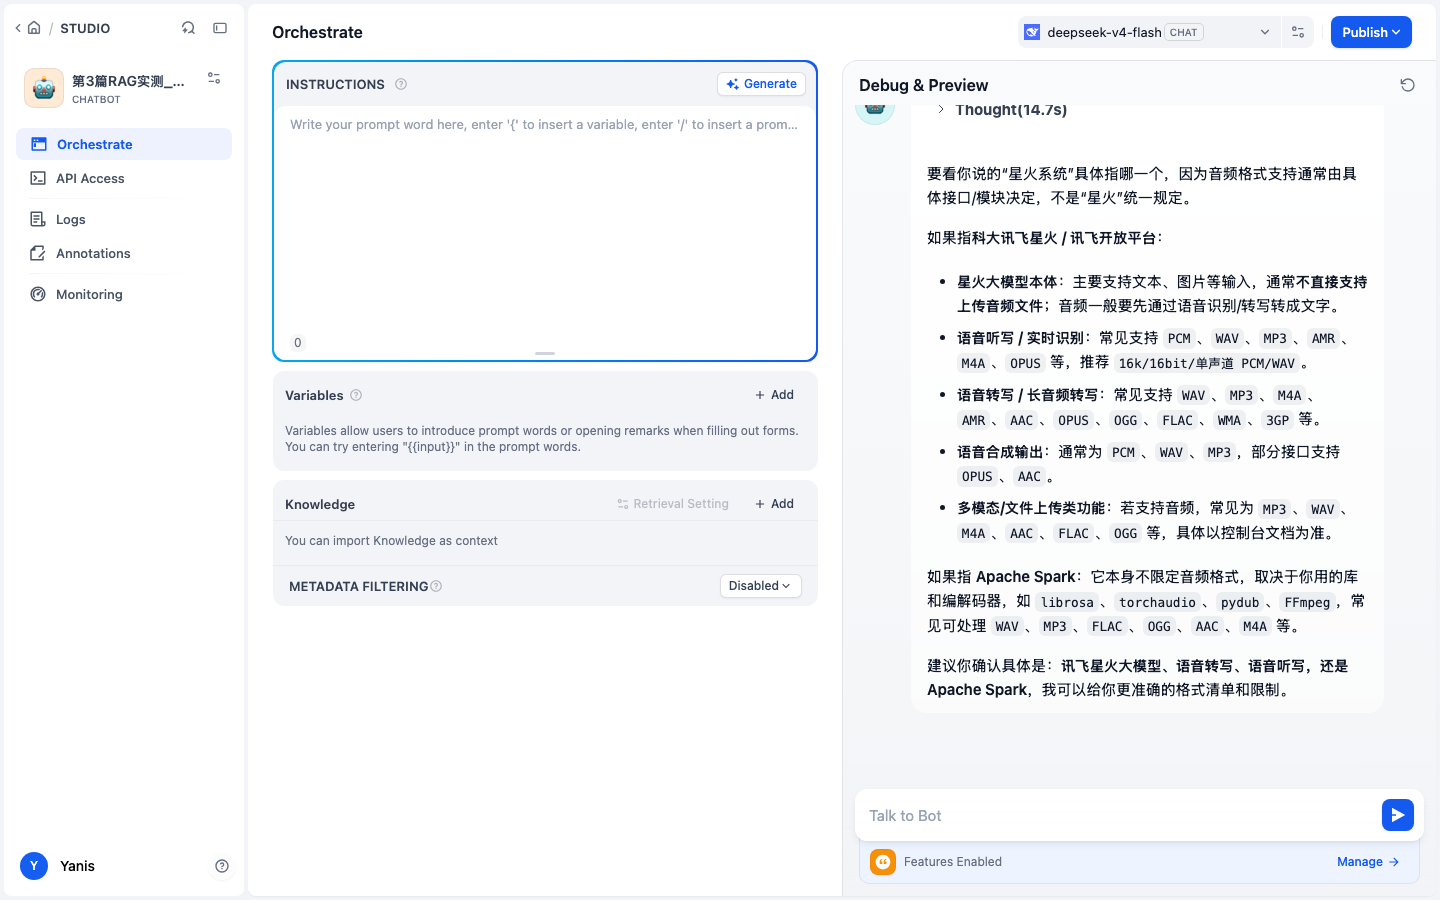
字数不少,但没有一个字跟这本手册有关。
四个问题放一起看:
| 问题 | 带知识库 | 不带知识库 |
|---|---|---|
| 音频格式 | wav / mp3 / m4a,带引用 | 误指科大讯飞星火,列出一堆通用格式 |
| 1 小时音频耗时 | 8--12 分钟,带引用 | 模型泛化,无稳定答案 |
| 粤语支持 | 支持,需选粤语模型,带引用 | 模型泛化,无稳定答案 |
| 私有化显存 | 最低 16GB,带引用 | 模型泛化,无稳定答案 |
显存那道也一样,带知识库时边界给得很干脆:
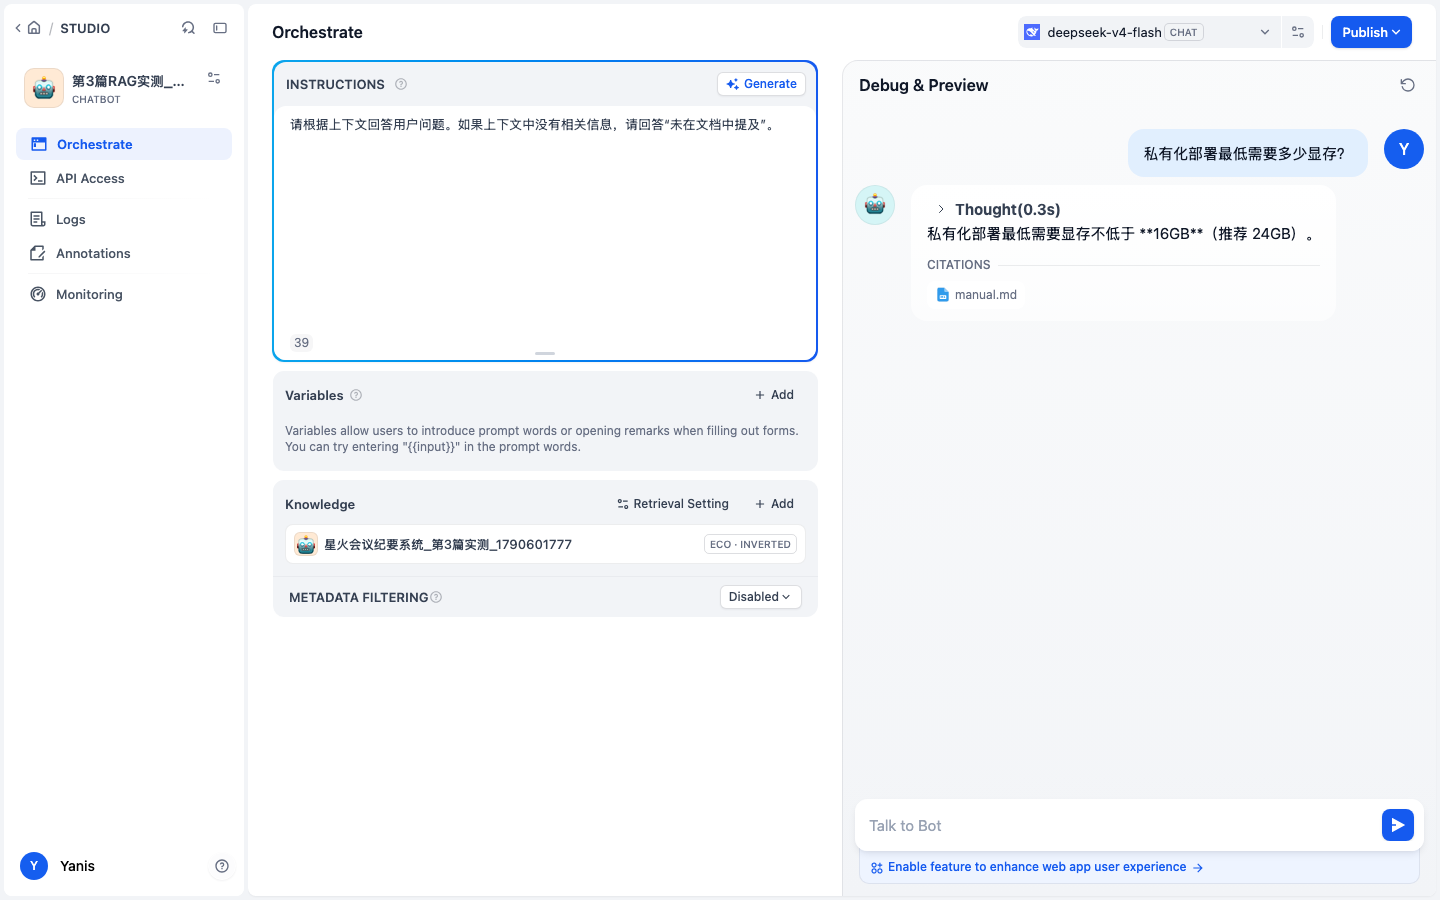
两组答案的差距,不在模型聪不聪明,而在它有没有被圈在那几段原文里。
五、关键词、向量、重排,三套召回差多少
到第四节为止,检索靠的是关键词倒排索引,一个模型都不用装。这条路能跑通,但它有个没被检验的前提:用户的问法得跟原文用词对得上。
于是换个做法重跑一遍:把 bge-m3 向量模型和 bge-reranker-v2-m3 重排模型接进 Dify。两个模型都跑在本机 127.0.0.1:8501,走 OpenAI 兼容端点。
同一份手册再建一个高质量知识库,索引方式选 High Quality,Embedding 指定 bge-m3:
还是那四个问题,三套召回策略的结果:
| 召回策略 | 依赖 | Top1 命中 | Top1 得分 |
|---|---|---|---|
| 经济(关键词倒排) | 无模型 | 1/4 | 无得分 |
| 高质量·向量(bge-m3) | Embedding | 4/4 | 余弦 0.61--0.82 |
| 混合检索+重排 | 向量+关键词+Rerank | 4/4 | 相关性 0.95--1.00 |
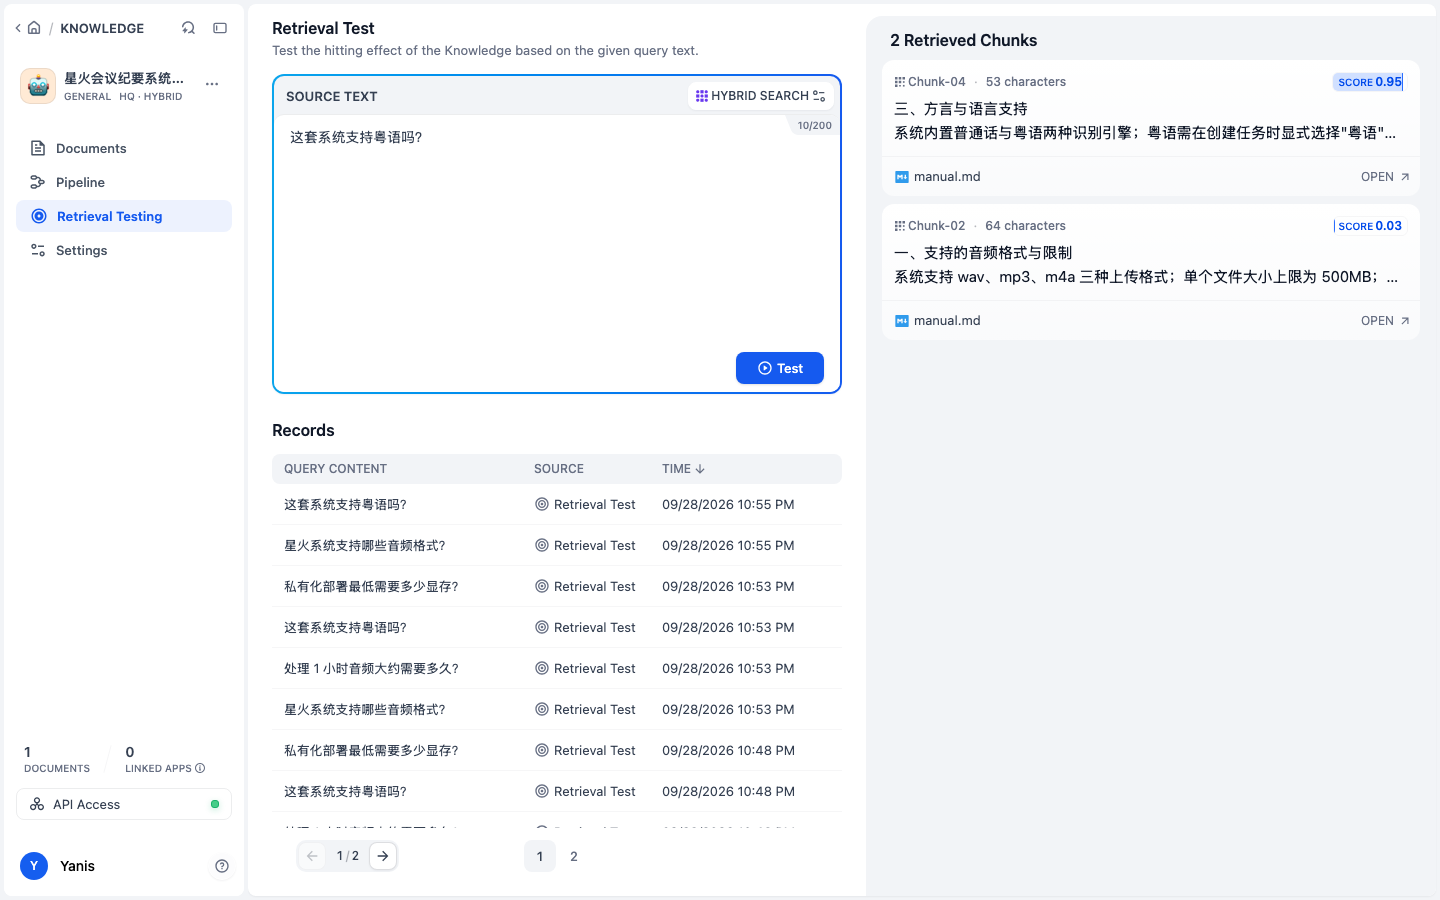
真正的差别在第三题。关键词模式下,正确段落被排在第 3 位,排第一的是标题段落------找得到,但排不对。
换成 bge-m3 向量检索,它以 0.71 的余弦相似度直接站到第一;再叠上 bge-reranker-v2-m3 重排,相关性 0.95,混进来的音频格式段落被压到 0.03:
把高质量知识库接进聊天助手,四个问题同样全对,且都带引用:
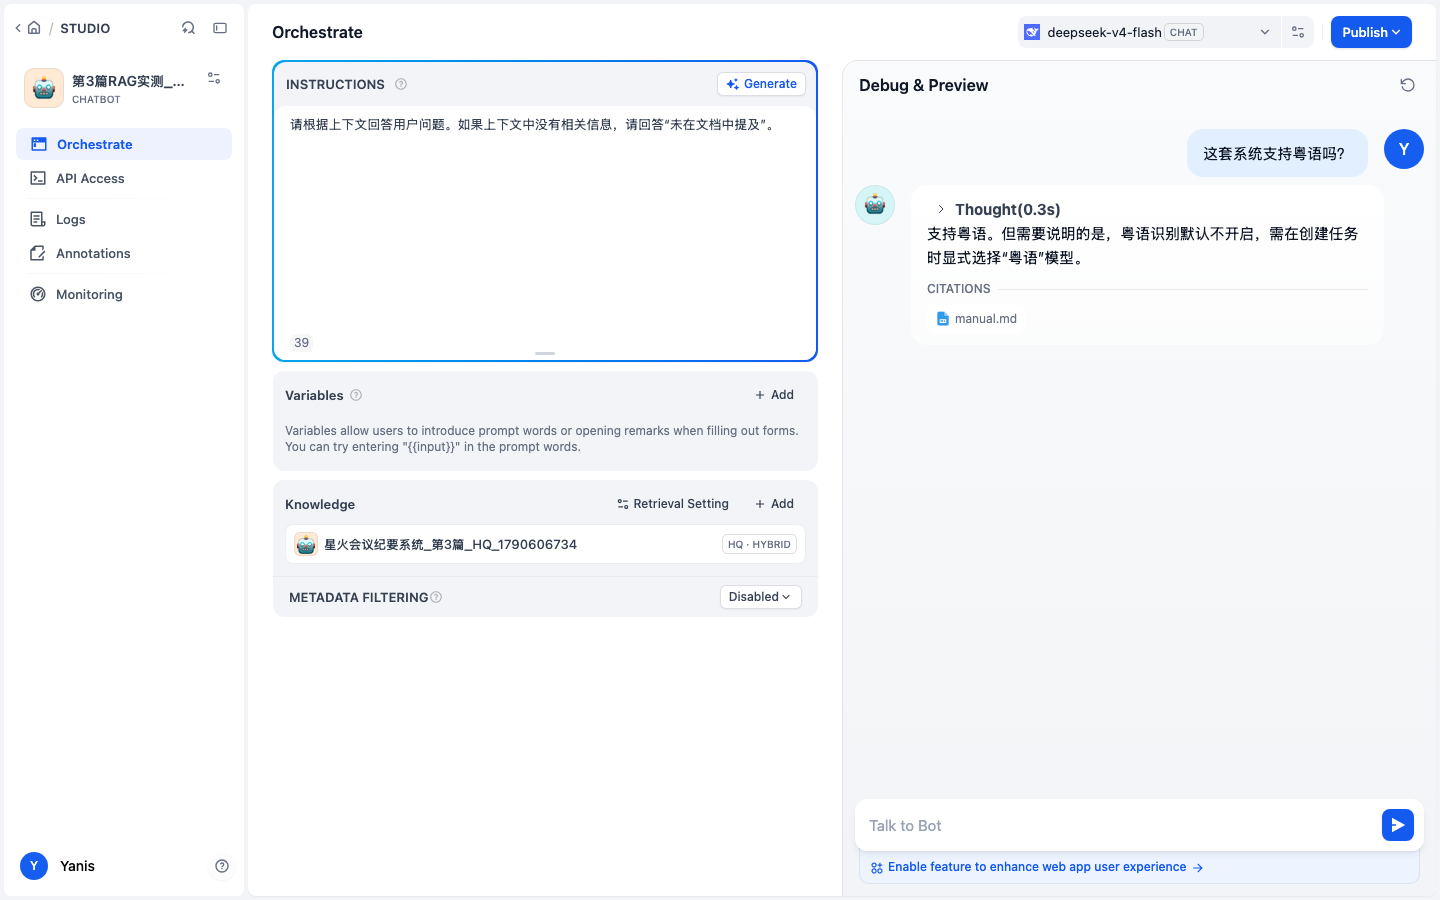
有个小插曲值得记:显存那道题,第一次答的是"未在文档中提及",重试一次就对了。召回层很稳,生成层仍有随机性,业务上要留兜底。
怎么选,看文档和问法:
| 场景 | 推荐模式 | 原因 |
|---|---|---|
| 问法多变、语义相近 | 高质量(向量) | Embedding 能理解同义改写 |
| 手册/制度、关键词明确 | 经济(倒排) | 零模型依赖、启动快 |
| 追求排序精度 | 混合检索+重排 | Rerank 把最相关片段顶到最前 |
六、能跑通,不等于能上生产
链路跑通之后,还有三件事值得补:
- 重排调参:本次用的是 bge-reranker-v2-m3,Top1 相关性从 0.61--0.82 提到 0.95 以上。TopK 和阈值得按自己的文档调,别照抄。
- 分段调优:最大长度、重叠、分隔符都跟着文档类型走,代码文档和制度文档的最优值不一样。
- 评估集:固定 20--50 条真实问题做回归,每次改分段、换模型都跑一遍,否则很容易"越改越差"自己还没察觉。
提示词这块我用的模板很短:
|------------------------------------------------------------------------------------------------------|
| 请根据以下上下文回答用户问题。如果上下文中没有相关信息,请回答"未在文档中提及"。 上下文: {{#context#}} 用户问题:{{#query#}} 回答时请保持简洁,并引用上下文中的关键信息。 |
它只做一件事:把模型限定在给定上下文里,上下文里没有就直说没有。要不要这么严取决于场景,制度问答、客服这类事实型场景越紧越好,开放创作就得留空间。
写在最后
一本手册能不能被问住,跟文档厚度关系不大,跟模型贵不贵关系也不大。
三段式跑通、每一层都拿数据验过,答案才有底:召回决定找不找得到,重排决定排得准不准,生成层还得留容错。
留个问题: 你手里的哪类文档,最先该被做成 RAG 知识库?欢迎在评论区写出来。
如果这篇对你有用,建议收藏 起来当实操手册,顺手点个「在看 」,转发给正在折腾 Dify 的同事。