测出来的值会抖:约束和目标带噪声时,「可行」和「更好」该怎么判
同一个配方,今天测出来吸收峰 0.98,明天测出来 1.03。同一个仿真,换个随机种子,峰值力差 3%。这种事在实验台上和昂贵仿真里都很常见,但算法里的两个判断却是按「测一次就是真值」写的:这个解可行吗 (约束值是否不超过零),这个解比那个解更好吗(目标值谁更小)。噪声一旦进来,这两个判断会同时被污染------有些解只是「这一次测出来可行」,有些解只是「这一次测出来更好」。
要讲清这件事,需要按顺序回答五个问题:噪声写进模型后长什么样;「可行吗」怎么改写成概率;「更好吗」怎么改写成概率、以及为什么这样改写可以不带阈值参数;单次测量下「看起来可行」的区域比真可行区域多出多少、判断被噪声翻过来的区间有多宽;重复测量能买到什么、代价是什么。为了让每一步都能验算,下面用一个人为设定的一维解析算例把关键量逐点算出,算式只用标准库里的 math.erf,读者可以改参数自行重算。
一、噪声写进哪里:两个位置,一套假设
把一次评价写成观测模型,需要明确三件事:真值、噪声、以及「我们手上拿到的是什么」。最常用的写法是
目标观测:y = f(x) + eps_f
约束观测:c = g(x) + eps_c
其中 f 与 g 是真值(永远看不到),eps_f 与 eps_c 是噪声。要往下算概率,还得再补两条假设:噪声的分布已知或可估 (通常是零均值正态、方差已知),以及噪声与决策变量无关(同方差)。这两条不是装饰------概率可行性、概率更优的每一个数值都直接由方差决定,方差估错多少,概率就错多少。
这套写法解释了为什么「把测量当真值」会同时污染两个判断:算法看到的是 y 和 c,而它想判的是 f 和 g。目标侧的噪声让「谁更好」变成一个随机事件;约束侧的噪声让「是否可行」也变成一个随机事件。两者用的是同一套噪声假设,所以要么一起处理,要么一起错。
这套「先建代理模型、再由采集函数决定下一个评价点」的循环,本身就是为昂贵黑箱函数设计的经典做法 6;带噪版本并不是另起一套框架,而是把这个循环里的两个判断改成概率形式。
批量化会让这件事更棘手。一次并行测多个点时,批内比较用的仍然是带噪观测,而不同点的噪声彼此独立,于是「这一批里最好的那个」很可能只是「这一批里噪声最正的那个」。这正是带噪超体积改进的期望这一类采集函数要处理的问题:它不去比某一次的具体取值,而是在后验分布下对「整批点能带来多少超体积改进」取期望。需要注意,这与「约束怎么进入采集函数」是两件事------在自驱动实验的闭环实现里 1,约束是通过给采集值乘一个由约束预测值决定的 S 形权重进入的,而不是先做一次硬性筛选。
另外,噪声还有一个容易被忽略的入口:测量本身的适用区间。在银纳米颗粒的案例里,第一个目标带一个门控函数------最终吸收峰幅度低于可测区间时该目标直接取零,理由是幅度过低会让相似度测量的噪声变大;幅度饱和时估计也不准,所以该目标还在相似度超过 0.999 处被截断。也就是说,同一个「测量」在不同取值区间里的可信度并不一样,而算法必须把这件事写进目标定义,否则会把「测不准」当成「真的差」。
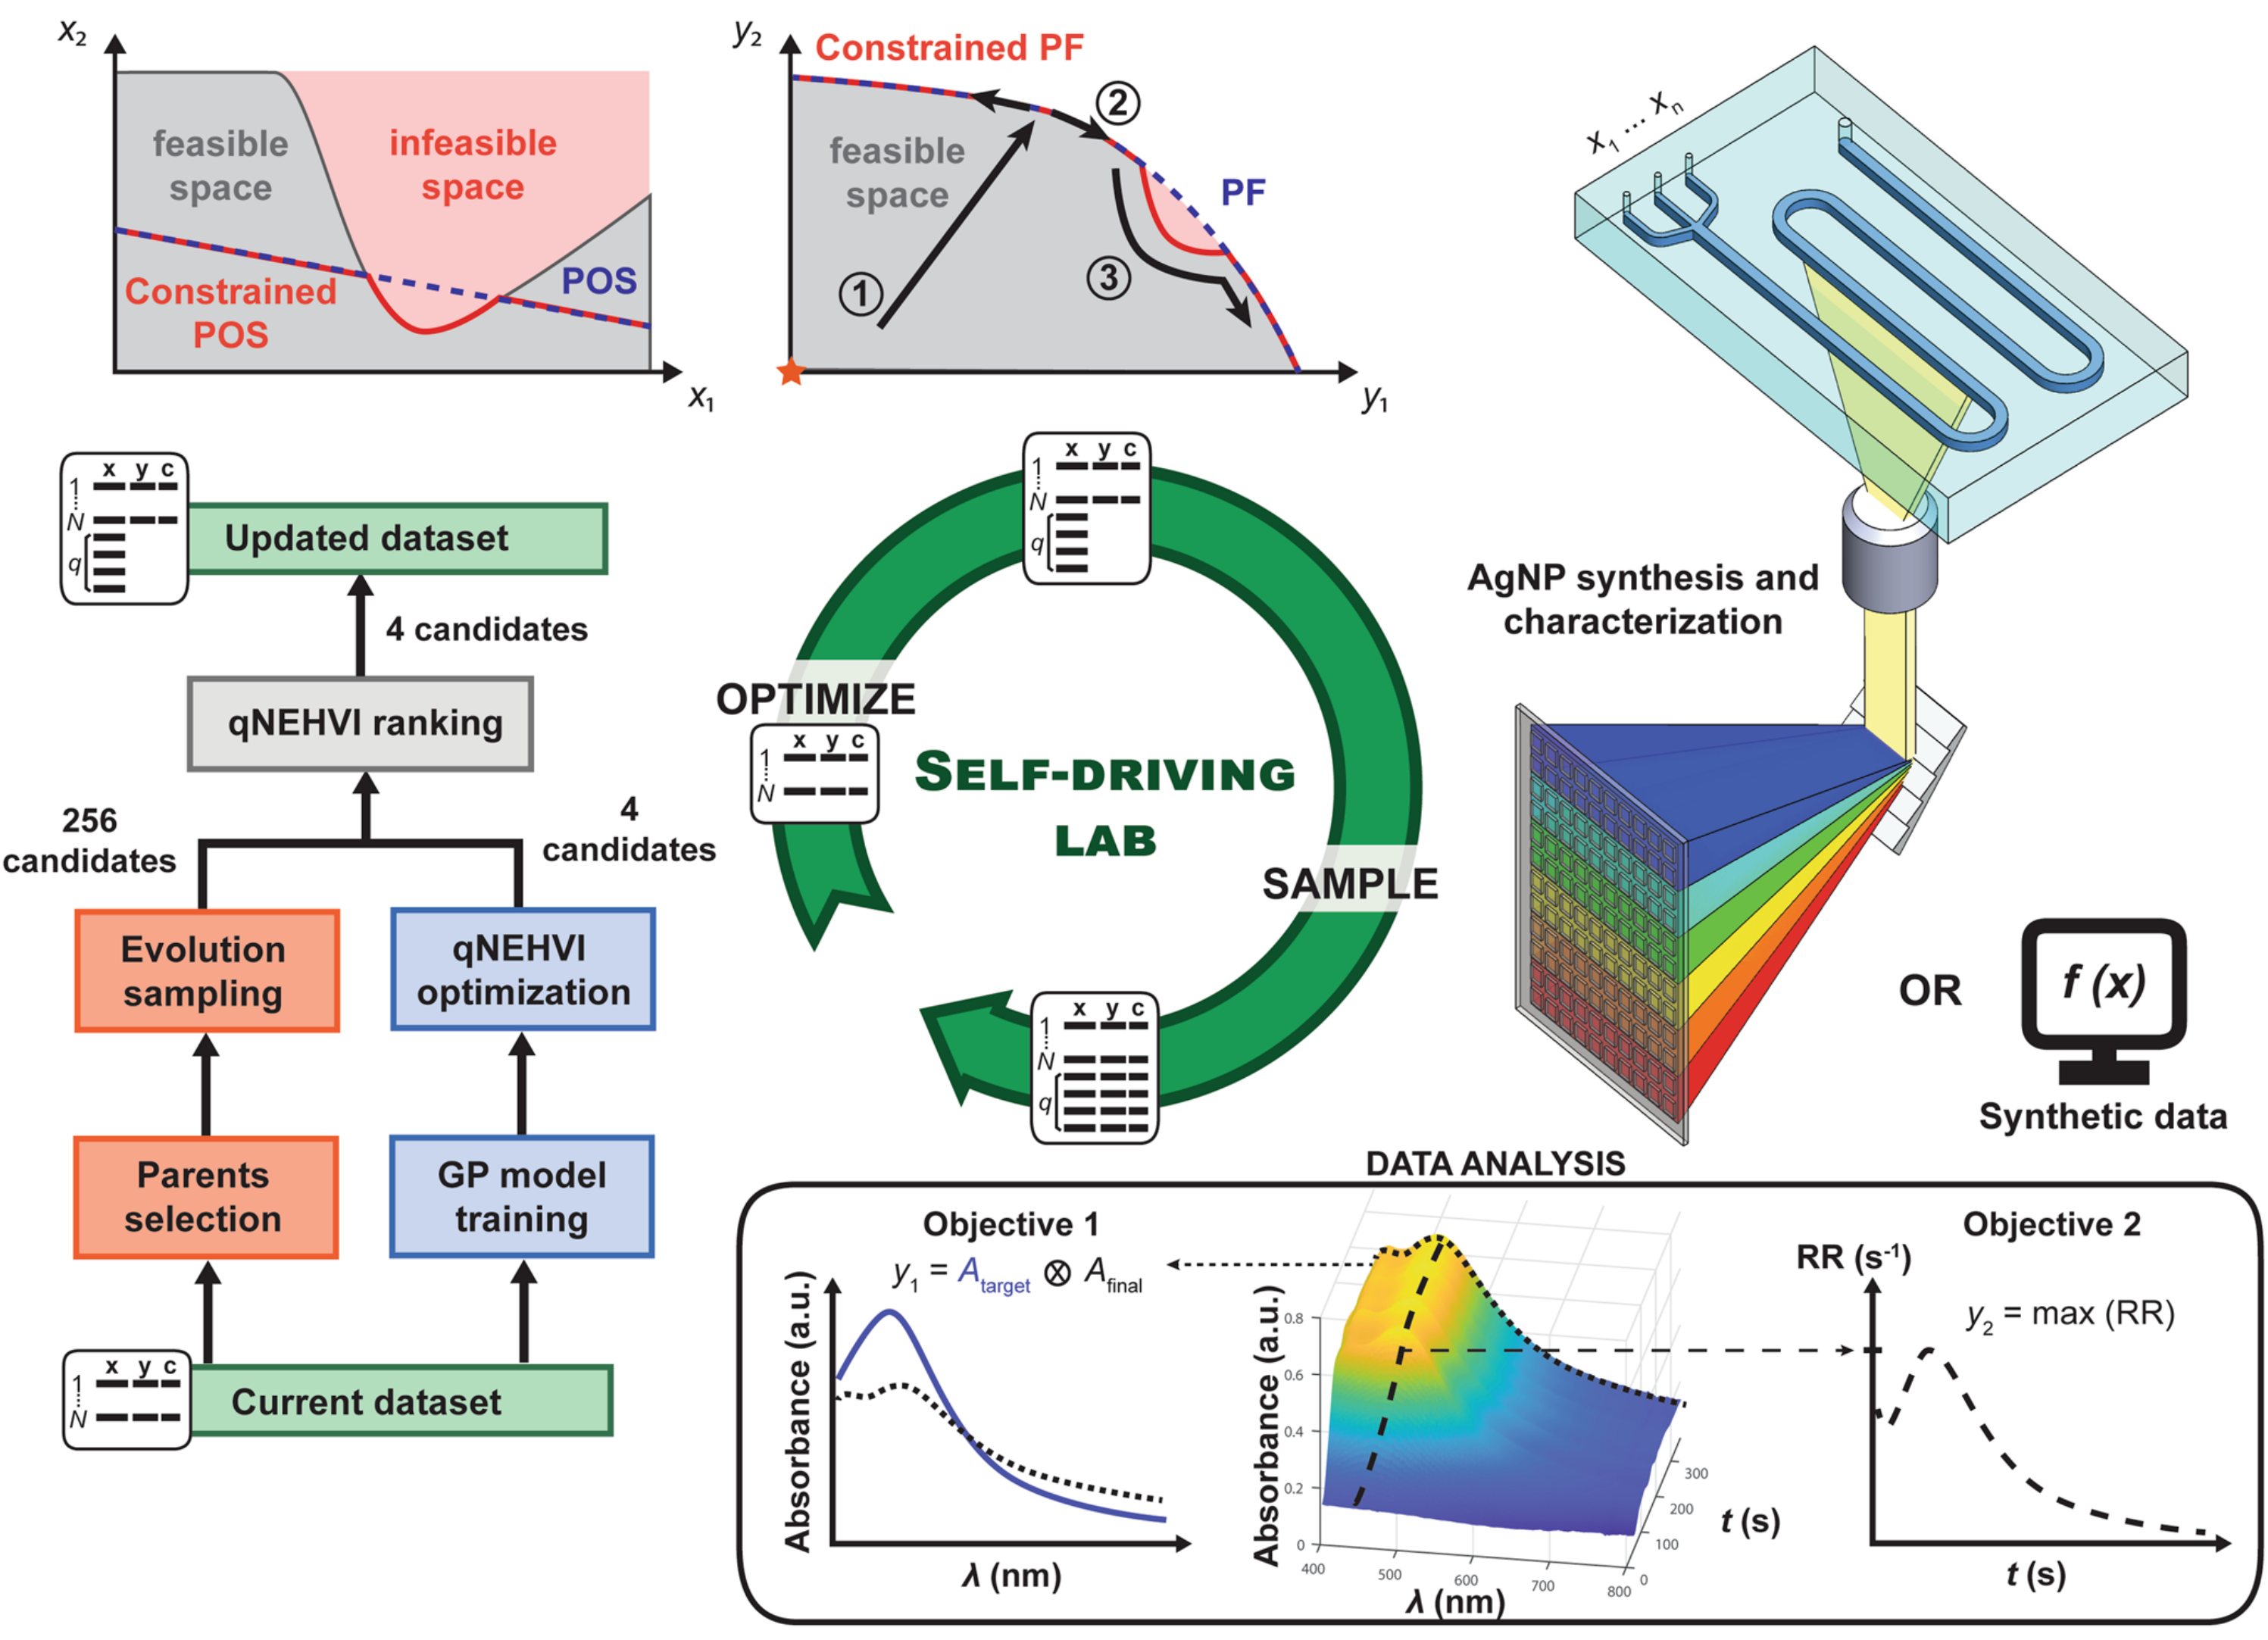
来源:1, Fig. 1:EGBO 引导的高通量实验闭环
图 1 左侧是并行给出候选的两条路线,右侧是采样与分析的闭环,底部是目标值从吸收光谱数据算出来的过程。对本文来说它有两个用处:一是看清噪声与有限预算从哪一环进入(每一次采样都要消耗真实的实验时间与试剂),二是看清「候选怎么被提出」与「值怎么被算出来」是两个独立的环节------判据的改写发生在后者身上。
二、「可行吗」改写成概率:概率可行性
把「满足约束」写成一个概率,最直接的写法是:对所有约束同时成立的概率。若对每条约束各建一个模型,得到预测均值与预测不确定度,那么单条约束满足的概率就是预测值不超过零的概率;在正态假设下,它等于「负的预测均值除以预测标准差」处的标准正态累积分布函数值。
概念的写法是各条约束满足概率的乘积 。但概率支配那篇论文指出,约束条数一多,即使是可行解,这个乘积也会变得很小------于是它改用取最小值:整体概率可行性等于各条约束满足概率里最小的那一个。这个改动看起来只是换了个算法,实际上是把「所有约束同时满足」这句话,重新解释成「最险的那条约束有多大概率满足」。
这个定义有一个非常好用的判读口径:当某条约束的预测均值恰好等于零(也就是解正好落在边界上)时,该条的概率可行性等于 0.5。因此,当解被预测为满足全部约束时,概率可行性不小于 0.5;小于 0.5 说明它被预测为违反至少一条约束。这句话把抽象的「概率」锚到了一个可检查的数上:边界上永远是五五开。
有了概率可行性,算法就不再问「这个解可行不可行」,而是问「这个解有多可行」。这一步的后果在第四节量化:在真不可行的一侧,概率可行性仍然可能很高,只是随距离衰减------于是可行与不可行之间那条硬边界,被换成了一条概率带。
顺便说清一个容易混淆的地方:把可行性判断交给学习模型的做法,在噪声被显式处理之前就已经存在。例如分类器代理那一类做法,直接用支配关系与拥挤程度作标签训练分类器,把「是否值得评价」做成分类输出,再把未评价解分档,只把最好的一档交给真实评价 5。它改变的是「谁来判」,概率可行性改变的是「判的是什么量」------前者仍然给出一个是/否,后者给出一个 0 到 1 之间的数,以及这个数是从哪个方差算出来的。
三、「更好吗」改写成概率:概率更优与概率支配
两个解在某个目标上谁更好,同样可以写成一个概率。若两个解各自有一个带不确定度的预测分布,那么「甲不劣于乙」的概率,就是把两个分布之差看成一个新的正态分布之后,这个差不超过零的概率;它的解析形式是「乙的预测均值减甲的预测均值」除以「两者预测标准差平方和的开方」之后的标准正态累积分布函数值。两个解的概率更优之和恰好等于 1。
这里有一条很值得记住的性质:两个解的概率更优谁大谁小,只由它们的预测均值决定,与预测不确定度无关。不确定度改变的是这个概率离 0.5 有多近(越不确定越靠近 0.5),但不改变两者的大小关系。这解释了为什么概率更优不能被直接当成比较量------它本身仍然只反映均值的高低,只是被不确定度「压扁」了。
真正的构造发生在下一步:为每个解在每条原目标上造一个新目标 ,取「概率可行性 × 概率更优」的负值,然后在这组新目标上执行帕累托支配。这个新目标的含义很直白:它同时装着「这个解有多可行」与「这个解在这条目标上有多好」。当两个解的概率可行性相等时,新目标改用概率更优的负值------这一条是为了保证两者概率可行性都为零(都被预测为严重不可行)时仍然可比。
为什么这个构造不需要额外的阈值参数?因为它没有把两个量合成一个带权重的分数,而是保留了维度:可行性一个维度、每条目标一个维度,然后在多维空间里做支配判断。参数化的做法(罚函数、ε 约束法)都需要选一个参数来决定「违反多少算可以接受」,而这个参数是问题相关的、需要调的;概率支配把「有多可行」直接放进目标向量里,让支配关系自己去处理取舍,因此没有可调参数。论文给出的直接理由是:通用约束处理技术要么偏好可行解、容易让种群困在局部可行域,要么依赖需要精细调节的问题相关参数;而既有的概率类做法又要求初始数据库里已经有可行解来提供参考值------概率支配两边都不依赖。
它带来的行为可以用论文给出的四条性质概括,其中两条最关键:
- 早期待在不可行区域时:若一个解在预测均值上支配另一个,且它的概率可行性不低于对方,那么它在新目标上也支配对方。于是预测均值更好、同时离可行域更近的解被保留,种群被牵引着穿越不可行区域。
- 进入可行区域之后 :与可行解在目标空间相邻的不可行解会被可行解支配(此时判定主要由概率可行性决定),而距离很远的不可行解与可行解互不支配,因此被保留下来。这些远端的不可行解不是噪声,而是「还没被探索过的可行部分的线索」。
论文把这件事总结成两种用途:与可行解竞争的可行解用于开发 已找到的可行部分,距离较远但有前途的不可行解用于探索新的可行部分。这也是「参数无关」之外,概率支配最实质的收益。
还有一处细节值得区分:概率支配负责「怎么比」,而「同层里删谁」是另一个问题。论文在这一步用的是到最近邻的欧氏距离:环境选择先按概率支配做非支配排序、依次填入前沿,超出规模时按密度逐个删除;候选选择只从第一前沿里取,规模超过上限时同样按密度删。密度估计这一类策略原本只看目标空间的距离 3,因此它和可行性是两套信息------这也是为什么该论文后来把违反度当作第 m+1 个目标并入密度估计,用于高维目标数的情形。
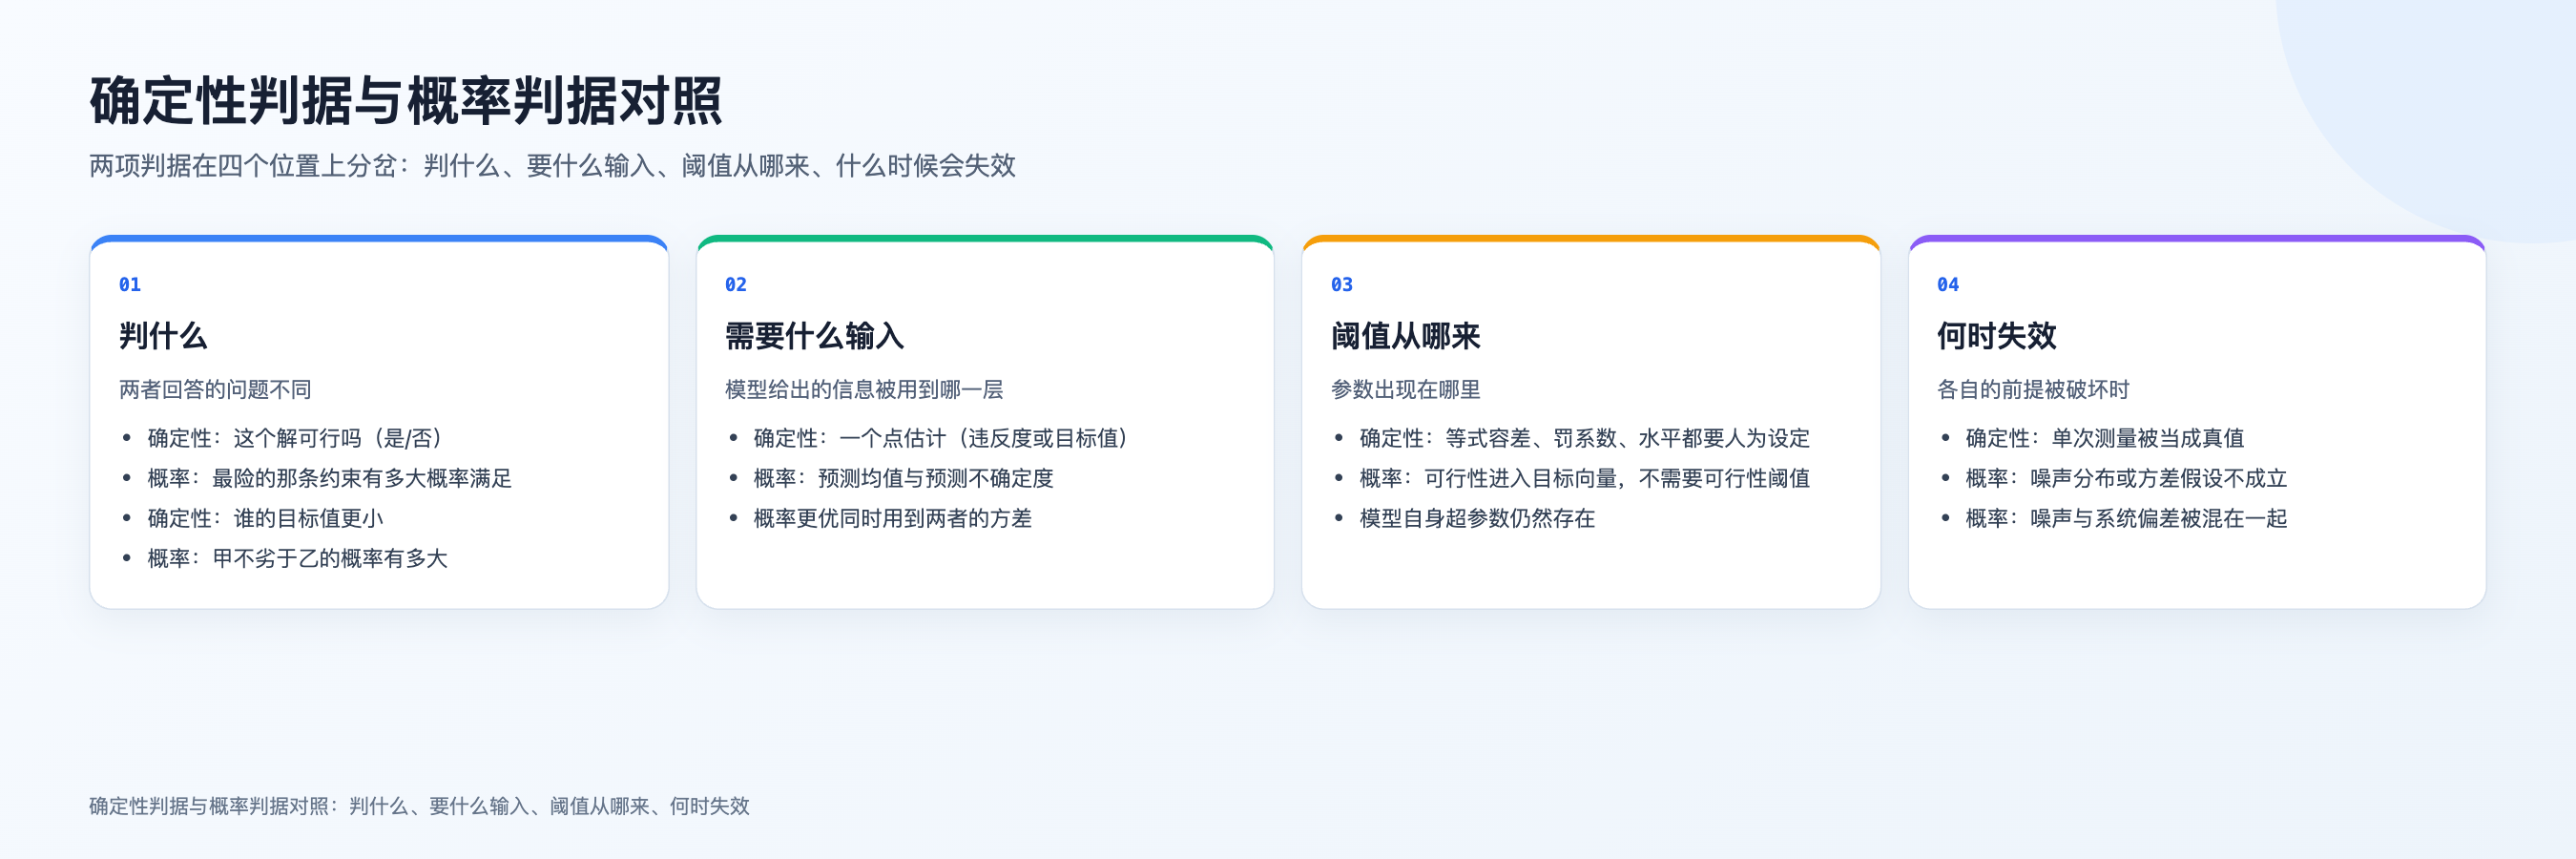
确定性判据与概率判据对照:判什么、要什么输入、阈值从哪来、何时失效
四、量化:放大的可行域与被翻过来的排序
下面用一个一维解析算例把这些量算出来。设定很简单:约束真值取 g(x) = 1 - 2x,x 在 [0, 1] 上取值,于是真可行域是 x < 0.5、名义边界在 x = 0.5;测量噪声取零均值正态,标准差 0.05。
先看「看起来可行」有多容易。 在 x 处,单次测量被判为可行的概率是 P(g(x) + eps <= 0) = Phi((2x - 1) / 0.05),其中 Phi 是标准正态累积分布函数,可以用 math.erf 精确算出。几个位置的值是:
| 位置 x | 与边界的距离 | 单次测量判为可行的概率 |
|---|---|---|
| 0.48 | 真可行,离边界 0.02 | 0.211855(它被判不可行) |
| 0.50 | 恰在边界上 | 0.500000 |
| 0.52 | 真不可行,越界 0.02 | 0.788145 |
| 0.55 | 真不可行,越界 0.05 | 0.977250 |
这张表最值得看的是第一行与最后一行:一个真可行的点有约 21% 的机会被判成不可行;一个真不可行、且已经越界 0.05 的点,有约 98% 的机会被判成可行。边界上则是五五开------这不是巧合,而是概率可行性的判读口径在起作用:预测值落在边界上时,两侧对称,概率就是 0.5。
噪声带的宽度有闭式解。 把「判为可行的概率降到 0.10」作为误差带的边界,位置是 x = 0.5 + 1.2816 * sigma / 2。标准差 0.05 时半宽是 0.032039、全宽 0.064078。也就是说,在这条 0.064 宽的带子里,真不可行的点仍有超过 10% 的机会被判为可行;带子的右端越靠右,表观可行域就被放大得越多。
再看「谁更好」被翻过来的概率。 设两个解的真值差为 Delta(即乙比甲差多少),两者各有独立的同方差噪声。按单次测量比较这两个解时,判断与真值一致的概率是 Phi(Delta / (sigma * sqrt(2)))。几个值是:
| 真值差 Delta | 单次测量的判断一致概率 | 四次复测后 |
|---|---|---|
| 0 | 0.500000 | 0.500000 |
| 0.02 | 0.611351 | 0.714196 |
| 0.03 | 0.664313 | 0.801928 |
| 0.05 | 0.760250 | 0.921350 |
| 0.10 | 0.921350 | 0.997661 |
第一行是一个必须承认的事实:两个解真值一模一样时,按测量判断的胜率就是 50% 。噪声在这里不是「误差」,它就是全部信息。第二行更值得记住:真值差 0.02(正好等于噪声标准差的 40%)时,判断一致的概率只有约 61%------也就是说,近四成的比较会把顺序判反。要让判断一致的概率达到 0.70,真值差需要到 0.0370808 (此时该概率为 0.700000);要到 0.90,需要到 0.090619。
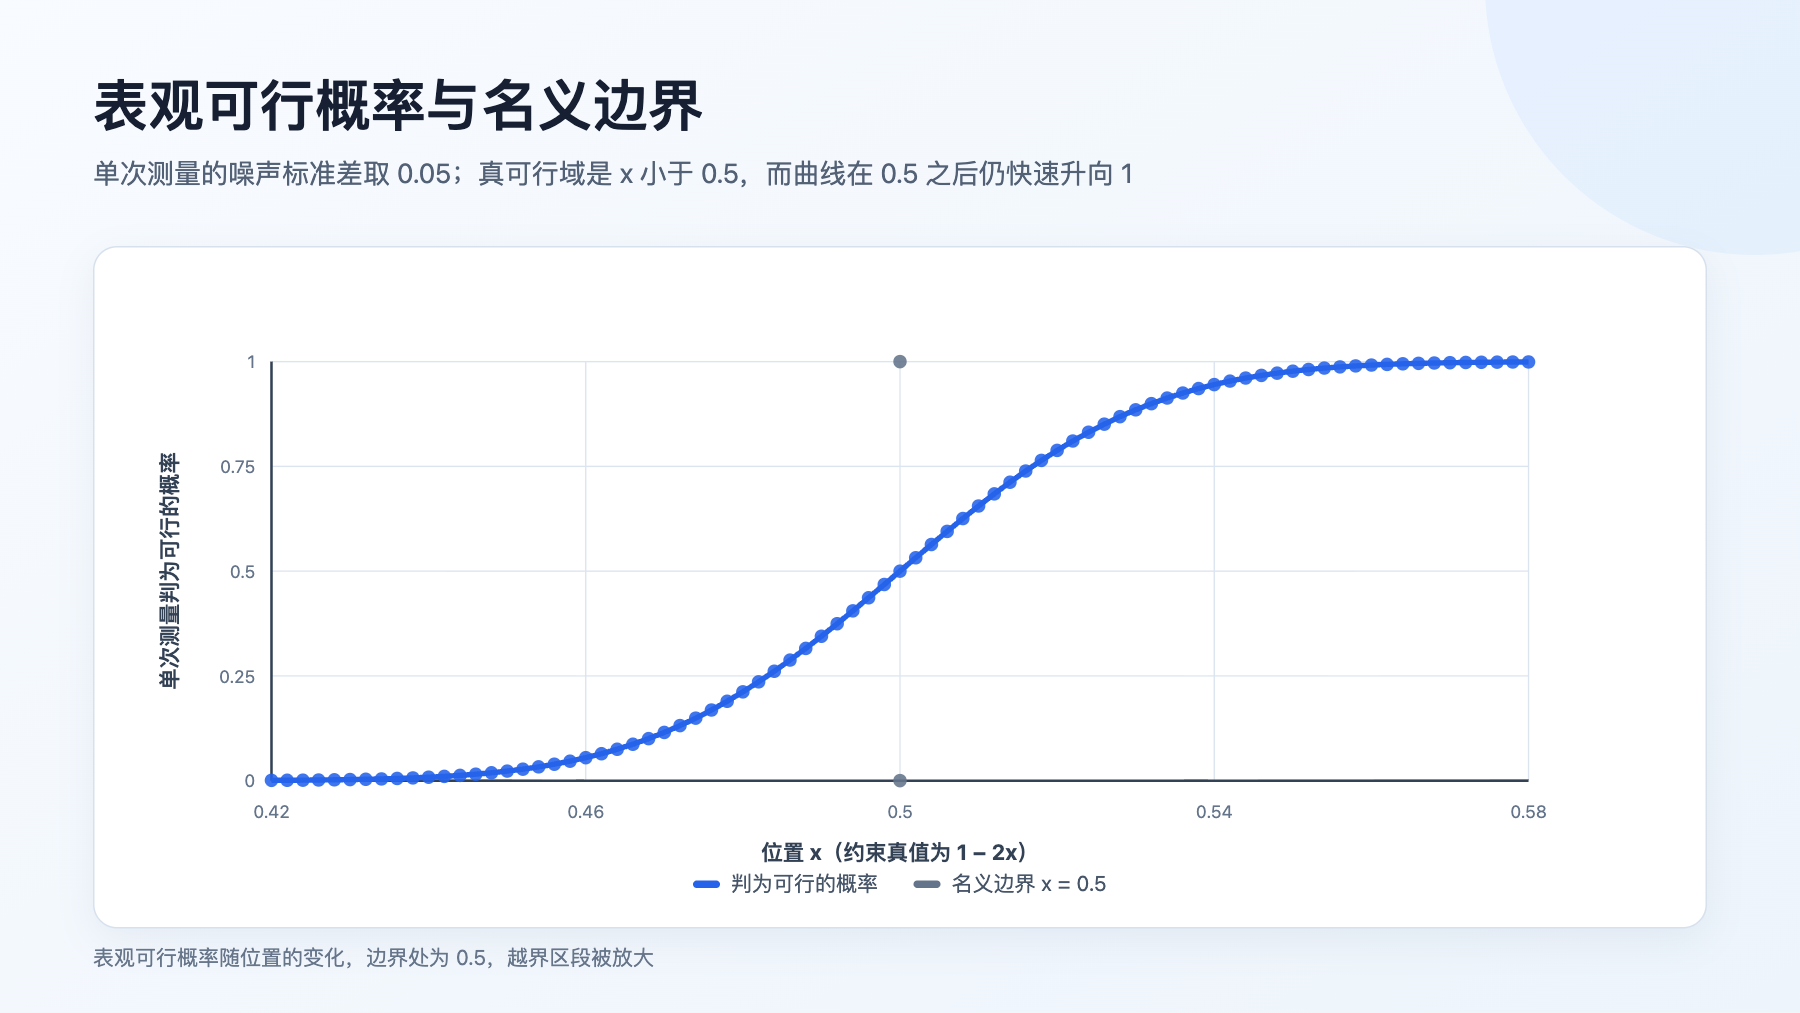
表观可行概率随位置的变化,边界处为 0.5,越界区段被放大
图 3 把这张表画成曲线:横轴是位置 x,纵轴是「单次测量判为可行」的概率,灰色虚线标出名义边界 x = 0.5。边界以左是真可行区段,判为可行的概率从 0 一路升到 0.5;边界以右是真不可行区段,而曲线并不掉到零,反而继续升向 1------这就是「表观可行域被放大」的直接形状。越界 0.02 处已经升到 0.788,越界 0.04 处是 0.945,越界 0.08 处是 0.999313。
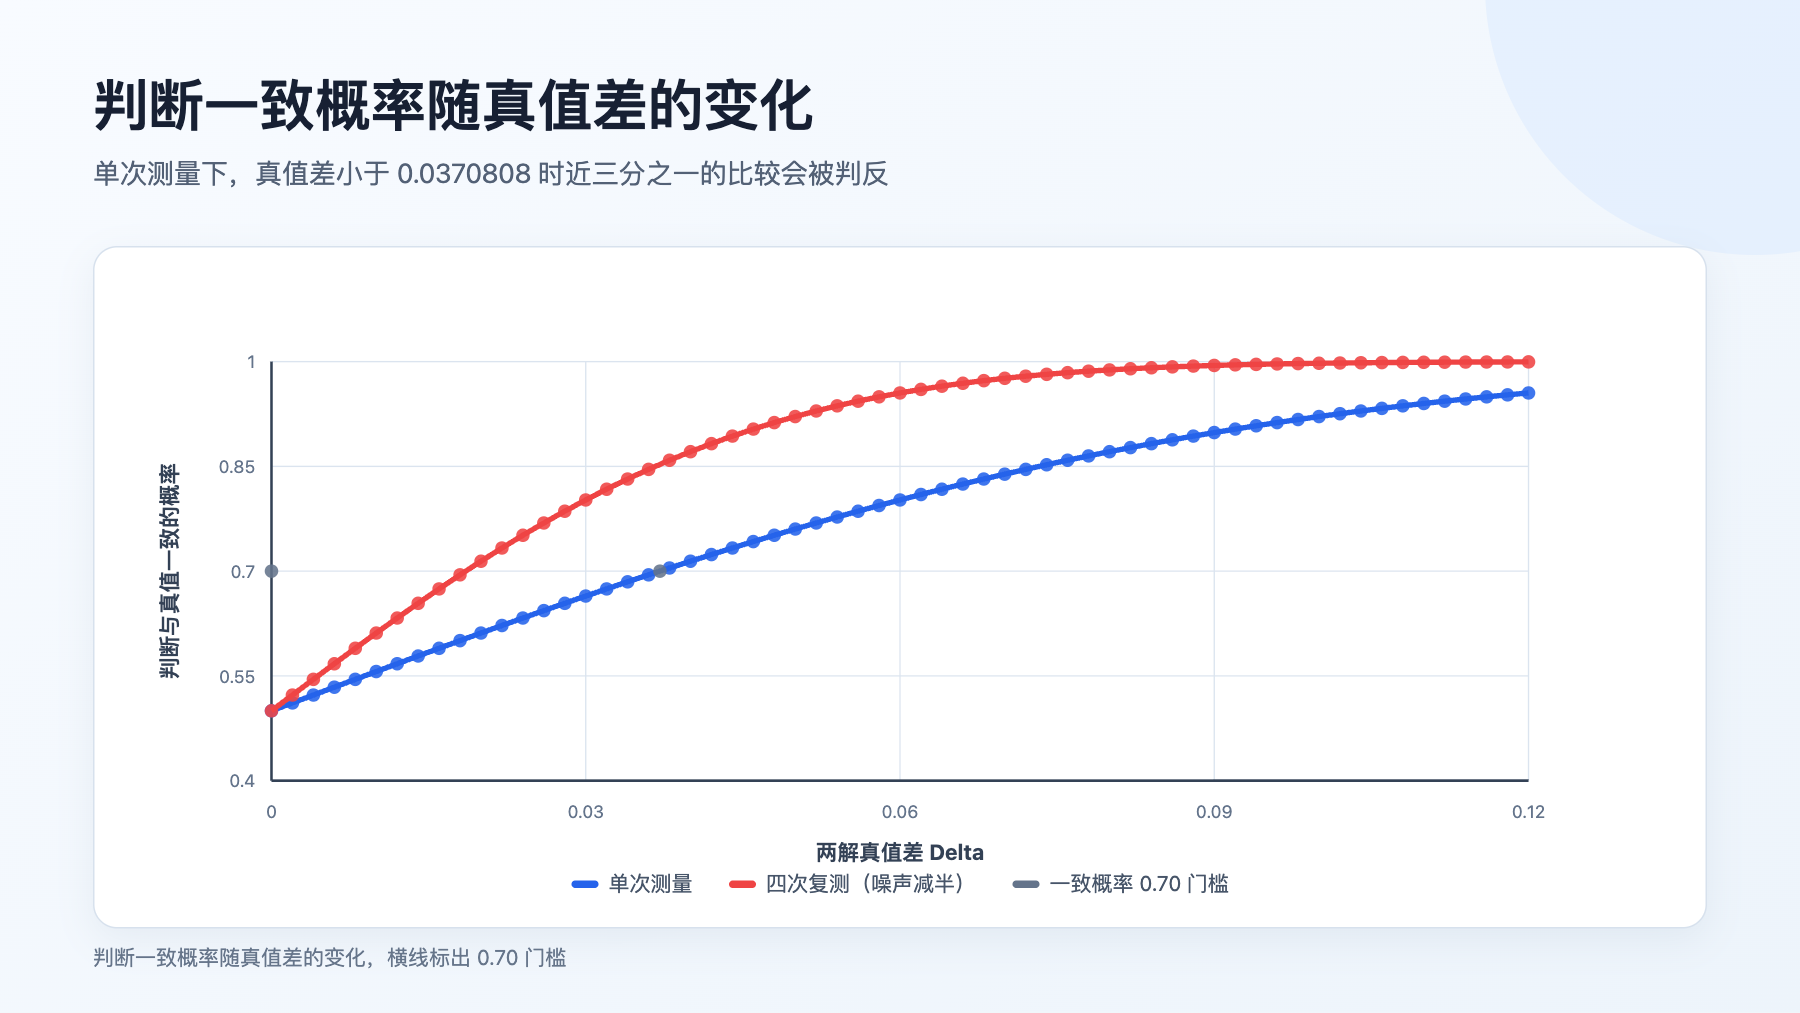
判断一致概率随真值差的变化,横线标出 0.70 门槛
图 4 把「判断一致的概率」画成随真值差变化的曲线,并用一条横线标出 0.70 这个参考门槛:真值差小于 0.0370808 时,单次测量给出的顺序有超过 30% 的机会是错的;同一门槛在四次复测下只需要真值差 0.0185404。这条曲线同时说明为什么「赢家诅咒」在这里不是算法缺陷------它是「用一次带噪测量当排序依据」的数学后果。任何按测量值排序的做法都会踩到它,除非它显式地用到不确定度。
五、重复测量:买到什么,花掉什么
同一个点测 k 次取平均,在独立同分布假设下方差降为 1/k、标准差降为 1/sqrt(k)。这条关系把上面的所有曲线都变成一族曲线:
| 复测次数 k | 预算倍数 | 平均后标准差 | 误差带半宽 | 边界外 0.02 处判为可行的概率 |
|---|---|---|---|---|
| 1 | 1 | 0.050000 | 0.032039 | 0.788145 |
| 2 | 2 | 0.035355 | 0.022655 | 0.871050 |
| 4 | 4 | 0.025000 | 0.016019 | 0.945201 |
| 8 | 8 | 0.017678 | 0.011327 | 0.988174 |
读这张表要注意三点。
第一,边界上的概率永远不变。 无论复测几次,恰好落在名义边界上的点被判为可行的概率始终是 0.500000;图 5 里四条曲线正是在这一点交于 0.5。复测买到的是「离边界稍远处的确定性」,买不到「边界在哪」------边界的位置必须靠对真值的估计来定,而不是靠把同一个点测得更准。
第二,收益递减得很整齐。 误差带半宽与 1/sqrt(k) 成正比:k 从 1 到 4,半宽从 0.032039 缩到 0.016019(正好减半);k 从 1 到 8 只缩到 0.011327(约三分之一)。标准差从 0.05 降到 0.017678,花了 8 倍预算。表里也能看出来:已经越界 0.05 的点,本来就有 98% 的机会被判成可行,复测把它推到 99.997%,这 2 个百分点的确定性用了 4 倍预算。
第三,复测与选点花的是同一笔预算。 预算固定时,把一个点测 4 次,就等于少测 3 个别的点。因此「要不要复测」不是判据问题,而是预算分配问题:如果当前最大的不确定性来自「边界在哪里」,那么把预算花在新的位置(哪怕是有噪声的新位置)可能比把同一个点测得更准更值。反过来,如果某个候选的解是否可行直接决定了下一步能不能继续,那么在那个点复测就是对的。
这也是本文不给「该复测几次」的普适建议的原因:它能给出的只是定量关系(标准差按 1/sqrt(k) 收缩、误差带按同一比例收窄)与代价口径(k 倍预算),至于这笔预算该花在复测还是花在探索,取决于当前最贵的不确定性是哪一项。
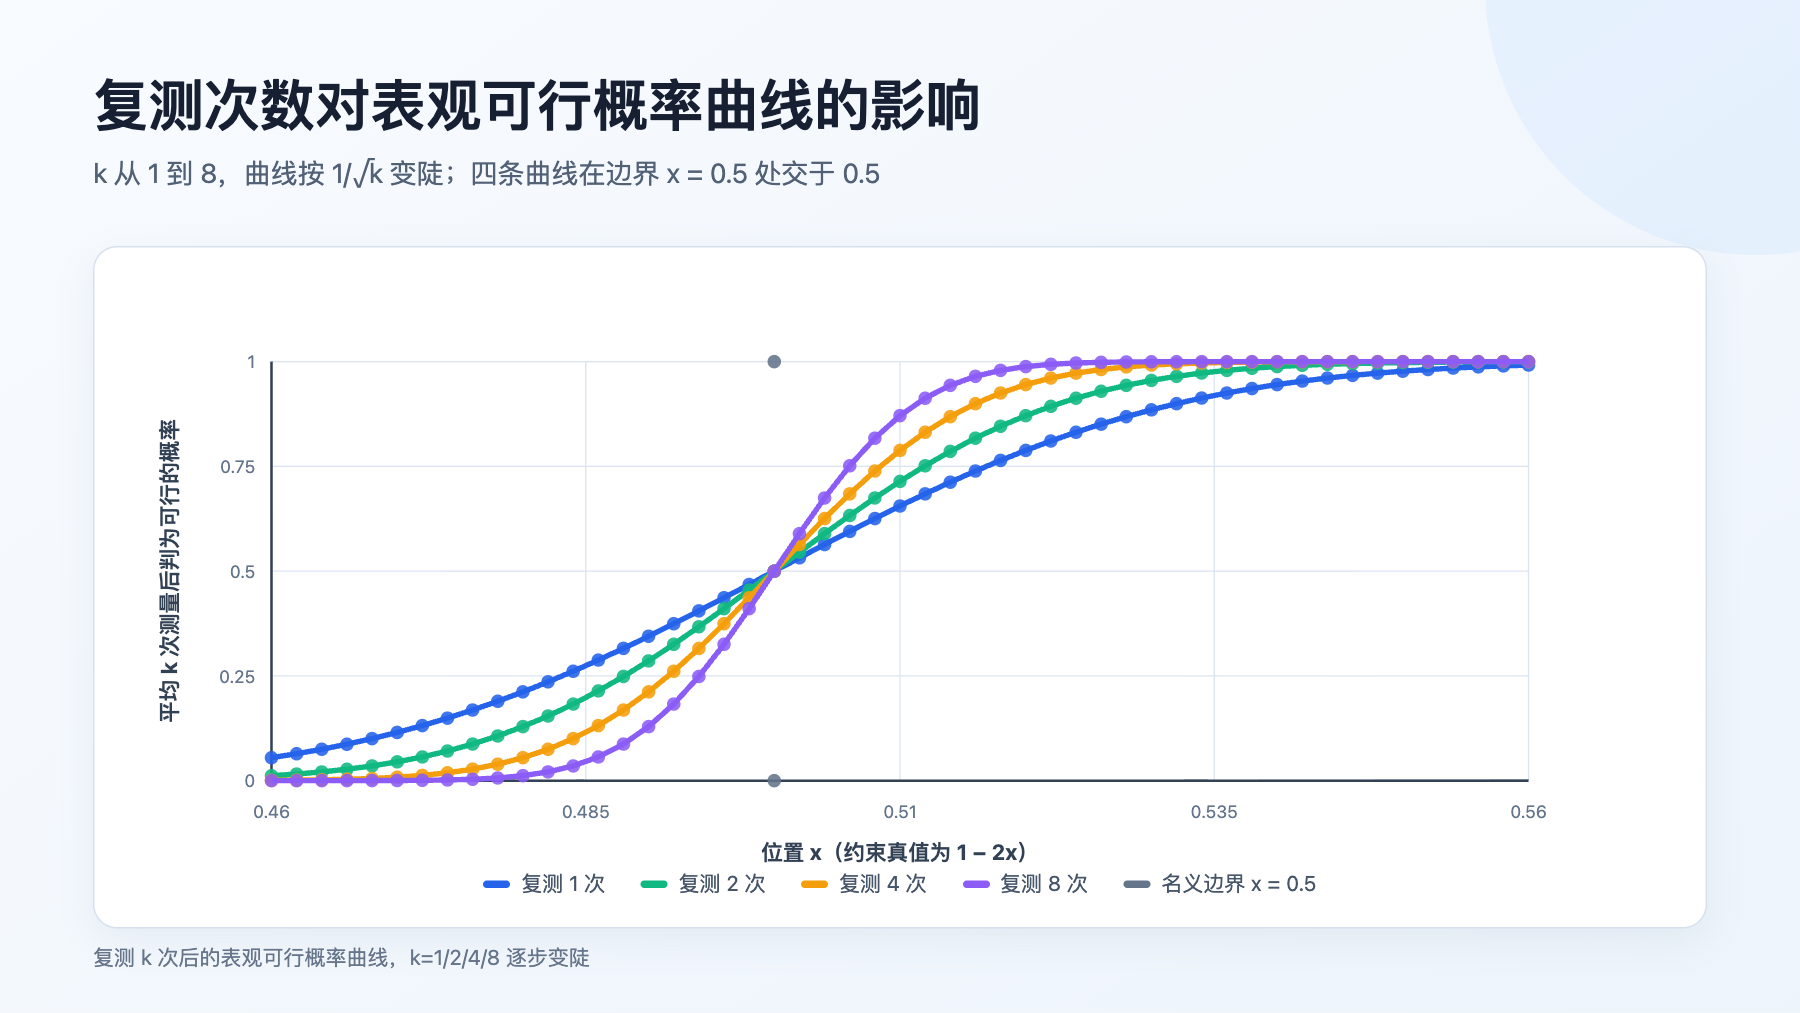
复测 k 次后的表观可行概率曲线,k=1/2/4/8 逐步变陡
六、两篇论文的实验口径:噪声与预算各自出现在哪里
本文的技术事实来自两篇一手论文,它们分别站在「真实带噪实验」与「昂贵代理模型」两侧。这一节只解释口径与论文自报结论,不复现、不搬运其数值表与图像。
自驱动实验室一侧(银纳米颗粒合成)。 研究对象是种子介导生长的银纳米颗粒:三条目标分别是与目标吸收光谱的接近程度、最大反应速率、银种子用量的相反数;决策变量是五种反应物的流速(5 维),水的流速用来把总水相流速固定住。另有两条约束防止二次成核堵塞微流控芯片。有意思的是,这两条约束只依赖流速输入(按论文自己的分类属于输入约束),但论文选择按输出约束处理,理由是当时预期帕累托前沿不会被约束强烈限制------也就是把「约束只在哪里出现」和「约束有多强」分开判断。
论文的闭环把每一步都写清楚了:微流控芯片生成液滴,液滴在 1.5 米长的反应管里边流动边反应,线扫描高光谱成像在线采集 UV/Vis 光谱,数据分析得到吸收光谱随停留时间的演化,再由这张演化图与流速算出目标值与约束值。评价预算的规模是可数的:每个优化器 15 次迭代、每次一批 4 个候选,因此每个优化器 72 个样本、整场实验 132 个样本,由作者因时间与资源主动停止。平台采用同步批量------技术上每次只出一个样,但把两个优化器各 4 个共 8 个样本当作一批顺序评价,理由是 8 个样本的总耗时落在一个可控且一致的时间窗内。
噪声在这篇论文里以三种方式出现,值得逐个记住:一是目标定义里的门控与截断(幅度过低或饱和时测量不可信,见第一节);二是每次迭代开始处测一个对照条件,用来确认相对此前各次迭代的实验可重复性;三是作者自己承认的局限------单次运行对初始候选与随机噪声都敏感,因此要证明性能提升需要多问题、多运行的统计分析。论文随后在 MW7 等合成问题上补了这项工作(8 维、10 次运行、每次 48 次迭代),两个优化器用的是同一套 Sobol 初始化(12 个起点)与同样的批量设置。
论文对约束处理还有一个与本文直接相关的发现:修复算子放在哪里会改变结果。事后修复先由采集函数选出候选、再把不可行候选投影回可行域;事前修复先把一个离散候选集整体修复、再按采集函数值排序取最好的几个。论文报告事前修复下两种算法的对数超体积差距都下降、非均匀性与纯随机采样相当,且除初始化之外不再提出不可行点;并据此认为事前修复适合处理平台上的输入约束。这条结论对本文的意义是:在带噪观测下,把「不可行」处理成什么,与把「值」判成什么,是两个都要显式决定的问题。
昂贵代理模型一侧(概率支配 2)。 论文的算法框架是:拉丁超立方采样建立初始种群与数据库并用真实目标与约束评价;随后循环做四件事------用数据库里全部解建立模型、在模型上做 20 代进化搜索、从结果里选出至多 5 个候选交给真实评价、用更新后的数据库刷新种群;直到真实评价次数达到上限。这里有一个容易被忽略的细节:算法内部两处用的比较规则并不相同------进化搜索与非支配排序用概率支配,而种群刷新这一步把概率支配换成约束支配原则。也就是说,概率判据是装在一套本来就有确定性判据的框架里的,替换的只是「怎么比」。
实验口径是:三个测试问题族(MW、C-DTLZ、DC-DTLZ)共 50 个问题,决策变量数取 8 与 10 两种情况,每个问题独立运行 30 次,真实评价上限 300,种群与初始数据库规模都是 50,每轮交给真实评价的候选数为 5(论文注明沿用既有推荐值),交叉与变异概率分别为 1 与 1/D、分布指数都取 20,统计检验用显著性水平 0.05 的秩和检验。三个评价指标是可行率(至少找到一个可行解的运行比例)、反世代距离(同时衡量可行非支配解的多样性与收敛性),以及先比可行率、再比反世代距离的比较原则------论文给出的理由是可行性最重要。
概率可行性这个概念本身不是这篇论文提出的------它把出处指向回填采样准则那一类工作 4,论文的贡献在于把可行性与优劣都写成概率之后,用它们构造出一个可以被支配关系直接使用的量。论文比较概率支配的方式很有参考价值:把同一框架里的这一判据替换成六种代表性的通用约束处理技术(约束支配原则、ε 约束法、随机排序、自适应罚函数、基于多目标优化的方法与自适应权衡模型),在 MW 问题族上比较;另与八种先进的代理辅助算法在三个问题族上比较。它还明确点出了既有概率类做法的适用边界:那些做法需要初始数据库里已经存在可行解来提供参考目标值,当可行比例极小而初始没有可行解时就不再适用------这正是概率支配不依赖初始可行解这一点的针对性。
真实工程案例是汽车梁系统的耐撞性结构优化:两个相互冲突的目标(能量吸收的相反数与峰值压溃力)、一条总质量不超过 3.08 千克的约束、五个取 1 到 3 之间的板厚变量,三个量都由有限元求解器算出、没有解析表达式,单次求解约 12 分钟。实验口径是五种独立运行、真实评价上限 100、种群与初始数据库规模 25,因此一次运行约需 20 小时;由于受约束帕累托前沿未知,改用超体积做比较。论文自报其方法比八种对比算法收敛更快、结果更好,并把一条原因归于概率支配让「探索新的可行部分」与「开发已找到的可行部分」可以同时被考虑。论文也明确列出适用范围:只考虑连续决策变量的问题,混合决策变量留作未来工作。
七、假设边界:什么时候这些概率不成立
概率判据的每一个数值都来自假设,所以必须把假设列清楚。
- 噪声分布已知或可估。 概率可行性与概率更优的解析形式都假定预测不确定度是已知的高斯标准差。若方差只能从很少的重复测量里估出来,那么算出来的概率本身也有不确定度;本文不给出「几次复测够用」的通用答案,只给出方差收缩的定量关系。
- 噪声与偏差必须可区分。 观测模型把误差写成零均值的随机项,但真实测量往往还带系统偏差(仪器标定漂移、模型系统误差)。偏差不会被重复测量平均掉,却会被当成噪声的一部分进入方差,从而把概率算错。两篇来源都没有处理偏差项,因此本文只能指出这是假设边界,不能给出定量结论。
- 同方差假设。 两篇来源的模型都按同方差处理。若噪声大小随决策变量位置变化,本文算例里的「误差带半宽与标准差成正比」这一关系就不再成立。
- 参数无关不等于无需调参。 概率支配本身没有可行性阈值参数,但它仍然依赖模型的预测均值与不确定度,而模型有自己的超参数;「不用调可行性阈值」与「整套算法不用调参」是两件事。
- 判据的可比性依赖同一套噪声假设。 比较两个解时假定两者的噪声同分布。若两个解的测量精度不同(例如一个来自高精度平台、一个来自快速筛选平台),等方差下的解析式会把精度差误当成真值差。
- 两篇来源没有做彼此的对照。 一篇在真实实验平台与合成问题上验证带噪贝叶斯优化,另一篇在合成问题族与有限元问题上验证概率判据。「概率判据在带噪实验平台上一定更好」不是它们的结论,本文也不这样写。
- 只考虑连续决策变量。 这一点是概率支配那篇自己列出的限制,本文的算例同样是一维连续变量。
八、把整件事写成一段流程
下面这段是概念性伪代码,用来说明「带噪测量下的判据改写」在流程里落在哪几步,不是任何一篇论文算法框的复现,也不含任何来源的数值。
text
概念性伪代码:带噪观测下的可行性判断与支配判断

输入:决策变量集合、每条目标与约束的带噪观测(含重复次数)、
      噪声方差的估计、每次迭代的真实评价预算

输出:按概率判据筛选的非支配解集合

1  对每条目标与每条约束各建立一个预测模型
2  由重复测量估计各观测的噪声方差,并登记为模型假设
3  循环直到真实评价预算用尽:
4      对每个候选解,用模型算出预测均值与预测标准差
5      对每条约束算出「该条被满足」的概率,取其中最小值作为该解的概率可行性
6      对每一对候选解、每条目标,算出「甲不劣于乙」的概率
7      把「概率可行性 × 概率更优」取负值,作为该解在该条目标上的新目标
8      在这组新目标上做非支配排序,保留前列解
9      从保留的解里选出下一批要真实评价的候选
10     若某个候选的可行性判断会决定下一步能否继续,则对它增加重复测量次数
11     用新的带噪观测回到第 1 步,并更新噪声方差的估计
第 5 步与第 7 步是全文的核心:前者把「可行吗」变成「最险的那条约束有多大概率满足」,后者把「更好吗」变成「可行性乘优劣」再取负,然后在多维空间里做支配。第 10 步是复测真正该出现的位置------不是无条件复测所有点,而是在「这个判断决定下一步」的地方复测。
九、最小可运行示例
下面这段是最小可运行示例 :只用标准库,两个不同版本的 Python 解释器都跑过,结果相同。它把本文用到的两个概率各算一次:apparent 算「真不可行的点被判为可行」的概率,correct 算「按测量排序与按真值排序一致」的概率。
python
import math

def Phi(z):
    """标准正态累积分布函数,用 math.erf 精确计算。"""
    return 0.5 * (1.0 + math.erf(z / math.sqrt(2.0)))

def apparent(x, sigma, const=1.0):
    """约束真值为 const - 2x 时,单次测量把它判为可行的概率。"""
    return Phi(-(const - 2.0 * x) / sigma)

def correct(delta, sigma):
    """两解真值差为 delta 时,按一次测量排序与按真值排序一致的概率。"""
    return Phi(delta / (sigma * math.sqrt(2.0)))

if __name__ == "__main__":
    sigma = 0.05
    print(round(apparent(0.50, sigma), 6))   # 边界上,恒为 0.5
    print(round(apparent(0.52, sigma), 6))   # 越界 0.02
    print(round(correct(0.0370808, sigma), 6))  # 判断一致概率 0.7 对应的真值差
示例只打印数字,正文引用的每一个数都来自前几节的表格与曲线,读者可以直接用这几行代码把任意参数下的值重算一遍。
十、一句话总结
带噪观测把算法里的两个判断都变成了概率问题:可行与不可行之间不再是硬边界,而是一条由噪声标准差决定的概率带;谁更好也不再是确定结论,真值差小于噪声量级时近一半的比较会被判反。概率可行性与概率更优把这两件事写成可以精确计算的数,概率支配再把它们装进一个不需要可行性阈值参数的比较规则里;而重复测量只能按 1/sqrt(k) 收窄随机噪声,因而它买到的是确定性、花掉的是探索预算。
参考文献
1 Low, A. K. Y., Mekki-Berrada, F., Gupta, A., Ostudin, A., Xie, J., Vissol-Gaudin, E., Lim, Y.-F., Li, Q., Ong, Y. S., Khan, S. A., Hippalgaonkar, K. Evolution-guided Bayesian optimization for constrained multi-objective optimization in self-driving labs. npj Computational Materials, 2024. DOI: 10.1038/s41524-024-01274-x
2 Zhang, Z., Wang, Y., Sun, G., Pang, T., Tang, K. Constrained Probabilistic Pareto Dominance for Expensive Constrained Multiobjective Optimization Problems. IEEE Transactions on Evolutionary Computation, 2025. DOI: 10.1109/TEVC.2024.3394005
3 Li, M., Yang, S., Liu, X. Shift-Based Density Estimation for Pareto-Based Algorithms in Many-Objective Optimization. IEEE Transactions on Evolutionary Computation, 2014. DOI: 10.1109/TEVC.2013.2262178
4 Parr, J. M., Keane, A. J., Forrester, A. I. J., Holden, C. M. E. Infill sampling criteria for surrogate-based optimization with constraint handling. Engineering Optimization, 2012. DOI: 10.1080/0305215X.2011.637556
5 Zhang, J., He, L., Ishibuchi, H. Dual-Fuzzy-Classifier-Based Evolutionary Algorithm for Expensive Multiobjective Optimization. IEEE Transactions on Evolutionary Computation, 2023. DOI: 10.1109/TEVC.2022.3195668
6 Jones, D. R., Schonlau, M., Welch, W. J. Efficient Global Optimization of Expensive Black-Box Functions. Journal of Global Optimization, 1998. DOI: 10.1023/A:1008306431147