华为Peerium架构深度解析:从冯·诺依曼到百万处理器"一台计算机",附MATLAB性能仿真
一、写在前面
2026年9月17日,华为在全联接大会上正式发布了面向AI时代的全新计算架构------Peerium计算架构 。华为官方定义的核心目标是:让百万级处理器逻辑上成为一台统一的计算机。
华为轮值董事长徐直军表示:"AI时代,华为基于开创的Peerium计算架构,持续打造满足客户训练和推理需求的超节点和集群,让算力无处不在,让智能无所不及。"
这个目标的背景是一个行业公认的困境:集群规模越大,效率反而越低 。华为常务董事杨超斌在演讲中披露了一组关键数据------在传统计算架构下,十万卡集群的实际模型算力利用率仅约20%,大量算力处于等待通信完成的状态。
Peerium试图从根本上解决这个问题。它不是对冯·诺依曼架构的修补,而是在系统拓扑层面重新定义了"一台计算机"的边界。本文将从架构原理出发,通过MATLAB仿真量化对比Peerium与传统冯·诺依曼集群的性能差异,并诚实地讨论仿真模型与工程现实之间的距离。
二、冯·诺依曼集群的"三重墙"
冯·诺依曼架构的核心原则是存储与计算分离,由中央控制器统一调度。这一设计支撑了计算机数十年的发展,但当AI集群从千卡扩展到百万卡量级时,它遭遇了三重结构性瓶颈。
通信墙。 传统集群依赖以太网或InfiniBand互联,主从架构下控制节点下发指令、计算节点执行任务。当规模扩大到十万卡量级,AllReduce等同步操作的时延急剧上升,大量算力在"等通信完成"中空转。
内存墙。 各节点内存独立,数据需要反复在处理器和远端内存之间搬运。缺乏统一内存寻址导致数据局部性差,跨节点访问必须经历"网络传输→拷贝→同步"的漫长链路。
架构墙。 主从架构在万卡阶段尚可支撑,但迈向百万级处理器时,调度开销和故障恢复复杂度将变得不可控。
三、Peerium的三大核心创新
3.1 统一内存寻址:打破"存储墙"
Peerium构建了全局统一地址空间 。百万级处理器共享同一套地址编址,对计算单元来说,数据在本地显存还是隔壁机柜的内存中,只是一个地址的区别。
支撑这一点的是灵衢互联技术。灵衢基于一个开放协议,可无限扩展地联接CPU、NPU、内存、SSD、网卡和交换机,实现计算、存储和网络的平等互联。Atlas 950超节点单机架集成高达1024×96GB片上内存,带宽速率最大4TB/s,支持百TB级内存统一编址。
3.2 灵衢平等互联:打破"通信墙"
灵衢将十余种互联协议统一为灵衢协议,互联带宽从百GB级提升至TB级 ,RTT通信时延从7微秒压缩至2微秒 。UB总线带宽高达392 GB/s ,相比传统RoCE网络提升15倍,单跳时延低于200纳秒。
Atlas 950超节点最大支持1024卡NPU高速互联,总带宽高达1.72 PB/s,灵衢2.0通信带宽较传统互联提升15倍。跨柜灵衢互联设备支持176个端口,每端口达1.6T,单机280T全光互联。
3.3 Nested BSP:打破"主从架构墙"
传统BSP(批量同步并行)模型是扁平化的,所有节点在每一轮超步中执行计算、通信、同步。当节点数达到百万级,全局同步的开销不可接受。
Peerium提出的Nested BSP(嵌套批量同步并行) 将并行任务分层递归组织。华为半导体首席科学家廖恒在arXiv论文中系统阐述了这一模型,将BSP递归嵌套化,使同步操作被限制在局部范围内,全局同步的代价被递归地分解。这使得在百万级规模下仍能保持可扩展性。
四、MATLAB仿真:完整代码与逐段讲解
以下仿真基于公开技术参数构建,目的是用可解释的数学公式量化Peerium三大创新的复合效应。
4.1 完整代码
matlab
%% Peerium vs 冯·诺依曼集群架构性能对比仿真 (最终修正版)
% 修正点:
%   1. T_compute 改为 50 ms,贴近真实 AI 训练单轮迭代
%   2. Peerium 远程带宽加入温和拥塞项,不再"免费"
%   3. 引入计算-通信重叠因子 alpha
%   4. 传统集群通信模型改为 AllReduce + 树形同步
%   5. Peerium 同步成本用 log(log N) 描述 Nested BSP 分层特性
clear; clc; close all;

%% ========== 1. 参数设置 ==========
N_range = [100, 1000, 10000, 100000, 1000000];

% ---- 通用参数 ----
T_compute = 50000;    % 单轮计算时间 (us) = 50 ms
D_remote  = 500;      % 每节点每轮远程内存访问数据量 (MB) = 0.5 GB
S_grad    = 1000;     % 每轮全局 AllReduce 梯度数据量 (MB) = 1 GB
alpha     = 0.5;      % 计算-通信重叠因子 (0=完全串行, 1=完全重叠)

% ---- 传统冯·诺依曼集群 ----
vn.BW_remote_nom = 50;    % 远程内存名义带宽 (GB/s)
vn.remote_cong   = 1e5;   % 拥塞系数:BW = nom/(1+N/cong)
vn.BW_net        = 200;   % AllReduce 网络带宽 (GB/s)
vn.RTT           = 7;     % 网络 RTT (us)

% ---- Peerium架构 ----
pr.BW_remote     = 392;   % 统一寻址远程带宽 (GB/s), UB 总线
pr.remote_cong   = 5e6;   % 温和拥塞系数
pr.BW_net        = 1000;  % UB AllReduce 带宽 (GB/s)
pr.RTT           = 2;     % UB RTT (us)

%% ========== 2. 核心计算 ==========
num_cases = length(N_range);
T_vn = zeros(1,num_cases);      T_pr = zeros(1,num_cases);
E_vn = zeros(1,num_cases);      E_pr = zeros(1,num_cases);
T_mem_vn = zeros(1,num_cases);  T_mem_pr = zeros(1,num_cases);
T_comm_vn= zeros(1,num_cases);  T_comm_pr= zeros(1,num_cases);
BW_r_vn  = zeros(1,num_cases);  BW_r_pr  = zeros(1,num_cases);

for i = 1:num_cases
    N = N_range(i);

    % ================= 冯·诺依曼集群 =================
    BW_remote_vn = vn.BW_remote_nom / (1 + N/vn.remote_cong);
    BW_r_vn(i)   = BW_remote_vn;

    t_mem_vn  = D_remote * 1000 / BW_remote_vn;
    t_comm_vn = S_grad * 1000 / vn.BW_net + vn.RTT * log2(N);

    T_mem_vn(i)  = t_mem_vn;
    T_comm_vn(i) = t_comm_vn;
    T_vn(i) = T_compute + t_mem_vn + alpha * t_comm_vn;

    % ================= Peerium =================
    BW_remote_pr = pr.BW_remote / (1 + N/pr.remote_cong);
    BW_r_pr(i)   = BW_remote_pr;

    t_mem_pr  = D_remote * 1000 / BW_remote_pr;
    t_comm_pr = S_grad * 1000 / pr.BW_net + ...
                pr.RTT * log2(log2(N) + 1);

    T_mem_pr(i)  = t_mem_pr;
    T_comm_pr(i) = t_comm_pr;
    T_pr(i) = T_compute + t_mem_pr + alpha * t_comm_pr;

    E_vn(i) = T_compute / T_vn(i) * 100;
    E_pr(i) = T_compute / T_pr(i) * 100;
end

%% ========== 3. 打印结果 ==========
fprintf('\n');
fprintf('====================================================================================\n');
fprintf('  冯·诺依曼集群 vs Peerium 架构 ------ 单轮仿真绝对时间对比 (单位: us)\n');
fprintf('====================================================================================\n');
fprintf('%-10s | %-30s | %-30s\n', '处理器数 N', '冯·诺依曼集群', 'Peerium 架构');
fprintf('%-10s | %7s %8s %8s %5s | %7s %8s %8s %5s\n', '', ...
    '内存', '通信', '总计', '', '内存', '通信', '总计', '');
fprintf('----------------------------------------------------------------------------------------\n');
for i = 1:num_cases
    fprintf('%-10d | %7.0f %8.0f %8.0f %5s | %7.0f %8.0f %8.0f %5s\n', ...
        N_range(i), T_mem_vn(i), T_comm_vn(i), T_vn(i), '', ...
        T_mem_pr(i), T_comm_pr(i), T_pr(i), '');
end
fprintf('========================================================================================\n\n');

fprintf('====================================================================================\n');
fprintf('  远程内存带宽对比 (GB/s)\n');
fprintf('====================================================================================\n');
fprintf('%-10s | %-25s | %-25s\n', '处理器数 N', ...
    '冯·诺依曼远程带宽', 'Peerium 远程带宽');
fprintf('------------------------------------------------------------------------------------\n');
for i = 1:num_cases
    fprintf('%-10d | %25.2f | %25.2f\n', N_range(i), BW_r_vn(i), BW_r_pr(i));
end
fprintf('====================================================================================\n\n');

fprintf('====================================================================================\n');
fprintf('  有效算力利用率对比 (计算时间 / 总时间)\n');
fprintf('====================================================================================\n');
fprintf('%-10s | %-20s | %-20s | %-12s\n', '处理器数 N', ...
    '冯·诺依曼利用率(%)', 'Peerium 利用率(%)', 'Peerium 加速比');
fprintf('------------------------------------------------------------------------------------\n');
for i = 1:num_cases
    fprintf('%-10d | %20.2f | %20.2f | %10.2fx\n', ...
        N_range(i), E_vn(i), E_pr(i), T_vn(i)/T_pr(i));
end
fprintf('====================================================================================\n\n');

%% ========== 4. 绘图 ==========
figure('Position',[100,100,1500,480]);

subplot(1,3,1);
loglog(N_range, T_comm_vn, 'r-o', 'LineWidth', 0.7, 'MarkerSize', 8, ...
    'MarkerFaceColor','r'); hold on;
loglog(N_range, T_comm_pr, 'b-s', 'LineWidth', 0.7, 'MarkerSize', 8, ...
    'MarkerFaceColor','b');
xlabel('处理器数量 N', 'FontSize', 12, 'FontWeight','bold');
ylabel('通信开销 (us, log)', 'FontSize', 12, 'FontWeight','bold');
title('通信同步开销对比', 'FontSize', 14, 'FontWeight','bold');
legend('冯·诺依曼集群', 'Peerium (Nested BSP)', ...
    'Location', 'northwest', 'FontSize', 10);
grid on; box on; set(gca,'FontSize',11);
xticks(N_range); xticklabels({'10^2','10^3','10^4','10^5','10^6'});

subplot(1,3,2);
semilogx(N_range, E_vn, 'r-o', 'LineWidth', 0.7, 'MarkerSize', 8, ...
    'MarkerFaceColor','r'); hold on;
semilogx(N_range, E_pr, 'b-s', 'LineWidth', 0.7, 'MarkerSize', 8, ...
    'MarkerFaceColor','b');
text(N_range(end), E_vn(end), sprintf(' %.1f%%', E_vn(end)), ...
    'Color','r','FontSize',11,'FontWeight','bold','VerticalAlignment','top');
text(N_range(end), E_pr(end), sprintf(' %.1f%%', E_pr(end)), ...
    'Color','b','FontSize',11,'FontWeight','bold','VerticalAlignment','bottom');
xlabel('处理器数量 N', 'FontSize', 12, 'FontWeight','bold');
ylabel('有效算力利用率 (%)', 'FontSize', 12, 'FontWeight','bold');
title('有效算力利用率对比', 'FontSize', 14, 'FontWeight','bold');
legend('冯·诺依曼集群', 'Peerium 架构', ...
    'Location','southwest', 'FontSize', 10);
grid on; box on; set(gca,'FontSize',11);
ylim([0, 105]); xticks(N_range);
xticklabels({'10^2','10^3','10^4','10^5','10^6'});

subplot(1,3,3);
speedup = T_vn ./ T_pr;
bar(1:num_cases, speedup, 0.6, 'FaceColor', [0.2 0.5 0.85]);
for i = 1:num_cases
    text(i, speedup(i), sprintf('%.2fx', speedup(i)), ...
        'HorizontalAlignment','center', 'VerticalAlignment','bottom', ...
        'FontSize', 11, 'FontWeight','bold');
end
xlabel('处理器数量 N', 'FontSize', 12, 'FontWeight','bold');
ylabel('单轮加速比', 'FontSize', 12, 'FontWeight','bold');
title('Peerium 相对加速比', 'FontSize', 14, 'FontWeight','bold');
set(gca,'XTick',1:num_cases);
set(gca,'XTickLabel',{'10^2','10^3','10^4','10^5','10^6'});
grid on; box on; set(gca,'FontSize',11);
ylim([0, max(speedup)*1.25]);

saveas(gcf, 'peerium_vs_von_neumann_final.png');
fprintf('仿真完成,图片已保存为 peerium_vs_von_neumann_final.png\n\n');
4.2 代码逐段讲解
第一段:为什么用50 ms而不是100 μs
matlab
T_compute = 50000; % 50 ms这是整个模型中最关键的参数选择。早期版本用100 μs,但真实的AI训练一轮迭代(一个mini-batch的前向+反向)通常是几十毫秒到几百毫秒量级。如果用100 μs,通信量与计算量的比值会被放大100~1000倍,从而严重高估通信开销的破坏性。50 ms让计算与通信的比例回到工程可信的区间------计算是主体,通信是扰动。
第二段:传统集群的"拥塞衰减"模型
matlab
BW_remote_vn = vn.BW_remote_nom / (1 + N/vn.remote_cong);这一行是传统架构"内存墙"的数学表达。名义带宽50 GB/s在N=100时几乎不变,但当N=10⁶时衰减到4.55 GB/s。物理含义是:传统集群的远程内存访问要走网络,节点越多、路径越长、拥塞越严重,有效带宽急剧下降。
第三段:Peerium的"温和拥塞"
matlab
BW_remote_pr = pr.BW_remote / (1 + N/pr.remote_cong); % pr.remote_cong = 5e6Peerium的UB总线在N=10⁶时带宽为326 GB/s,仅比名义值392 GB/s下降17%。这不是"免费",而是体现了统一寻址和全对等互联的实际优势------UB的CLOS拓扑天然具有更好的扩展性,但并非无限。5e6的拥塞系数让Peerium在百万级仍有温和衰减,更接近工程现实。
第四段:通信模型的差异化
matlab
% 传统集群
t_comm_vn = S_grad * 1000 / vn.BW_net + vn.RTT * log2(N);

% Peerium
t_comm_pr = S_grad * 1000 / pr.BW_net + pr.RTT * log2(log2(N) + 1);
两个公式的第一项都是AllReduce的数据传输时间(1 GB / 带宽),差异在第二项。传统集群用log2(N)表示树形同步的跳数,Peerium用log2(log2(N)+1)表示Nested BSP的分层递归同步------同步被限制在局部范围内,跳数增长极其缓慢。在N=10⁶时,传统集群同步项为7×20=140 μs,Peerium仅为2×4.5=9 μs,差距超过15倍。
第五段:重叠因子的引入
matlab
alpha = 0.5;
T_vn(i) = T_compute + t_mem_vn + alpha * t_comm_vn;
真实系统里AllReduce可以和反向传播的下一层计算重叠。alpha=0.5表示50%的通信时间被计算掩盖。这个参数让模型更接近真实训练场景,也避免了对两种架构的系统性低估。
第六段:有效算力利用率的定义
matlab
E_vn(i) = T_compute / T_vn(i) * 100;这是最重要的输出指标------计算时间占总时间的比例。它直接回答了"这台计算机有多少时间在真正算东西"。华为披露的"十万卡利用率20%"衡量的就是这个量级的指标。
4.3 运行结果
====================================================================================
  冯·诺依曼集群 vs Peerium 架构 ------ 单轮仿真绝对时间对比 (单位: us)
====================================================================================
处理器数 N     | 冯·诺依曼集群                    | Peerium 架构
           |      内存       通信       总计 |      内存       通信       总计
------------------------------------------------------------------------------------
100        |   10010     5047    62533 |    1276     1006    51778
1000       |   10100     5070    62635 |    1276     1007    51779
10000      |   11000     5093    63547 |    1278     1008    51782
100000     |   20000     5116    72558 |    1301     1008    51805
1000000    |  110000     5140   162570 |    1531     1009    52035
====================================================================================
====================================================================================
  远程内存带宽对比 (GB/s)
====================================================================================
处理器数 N     | 冯·诺依曼远程带宽                 | Peerium 远程带宽
------------------------------------------------------------------------------------
100        |                     49.95 |                    391.99
1000       |                     49.50 |                    391.92
10000      |                     45.45 |                    391.22
100000     |                     25.00 |                    384.31
1000000    |                      4.55 |                    326.67
====================================================================================
====================================================================================
  有效算力利用率对比 (计算时间 / 总时间)
====================================================================================
处理器数 N     | 冯·诺依曼利用率(%)          | Peerium 利用率(%)       | Peerium 加速比
------------------------------------------------------------------------------------
100        |                79.96 |                96.57 |       1.21x
1000       |                79.83 |                96.56 |       1.21x
10000      |                78.68 |                96.56 |       1.23x
100000     |                68.91 |                96.52 |       1.40x
1000000    |                30.76 |                96.09 |       3.12x
====================================================================================
4.4 结果解读
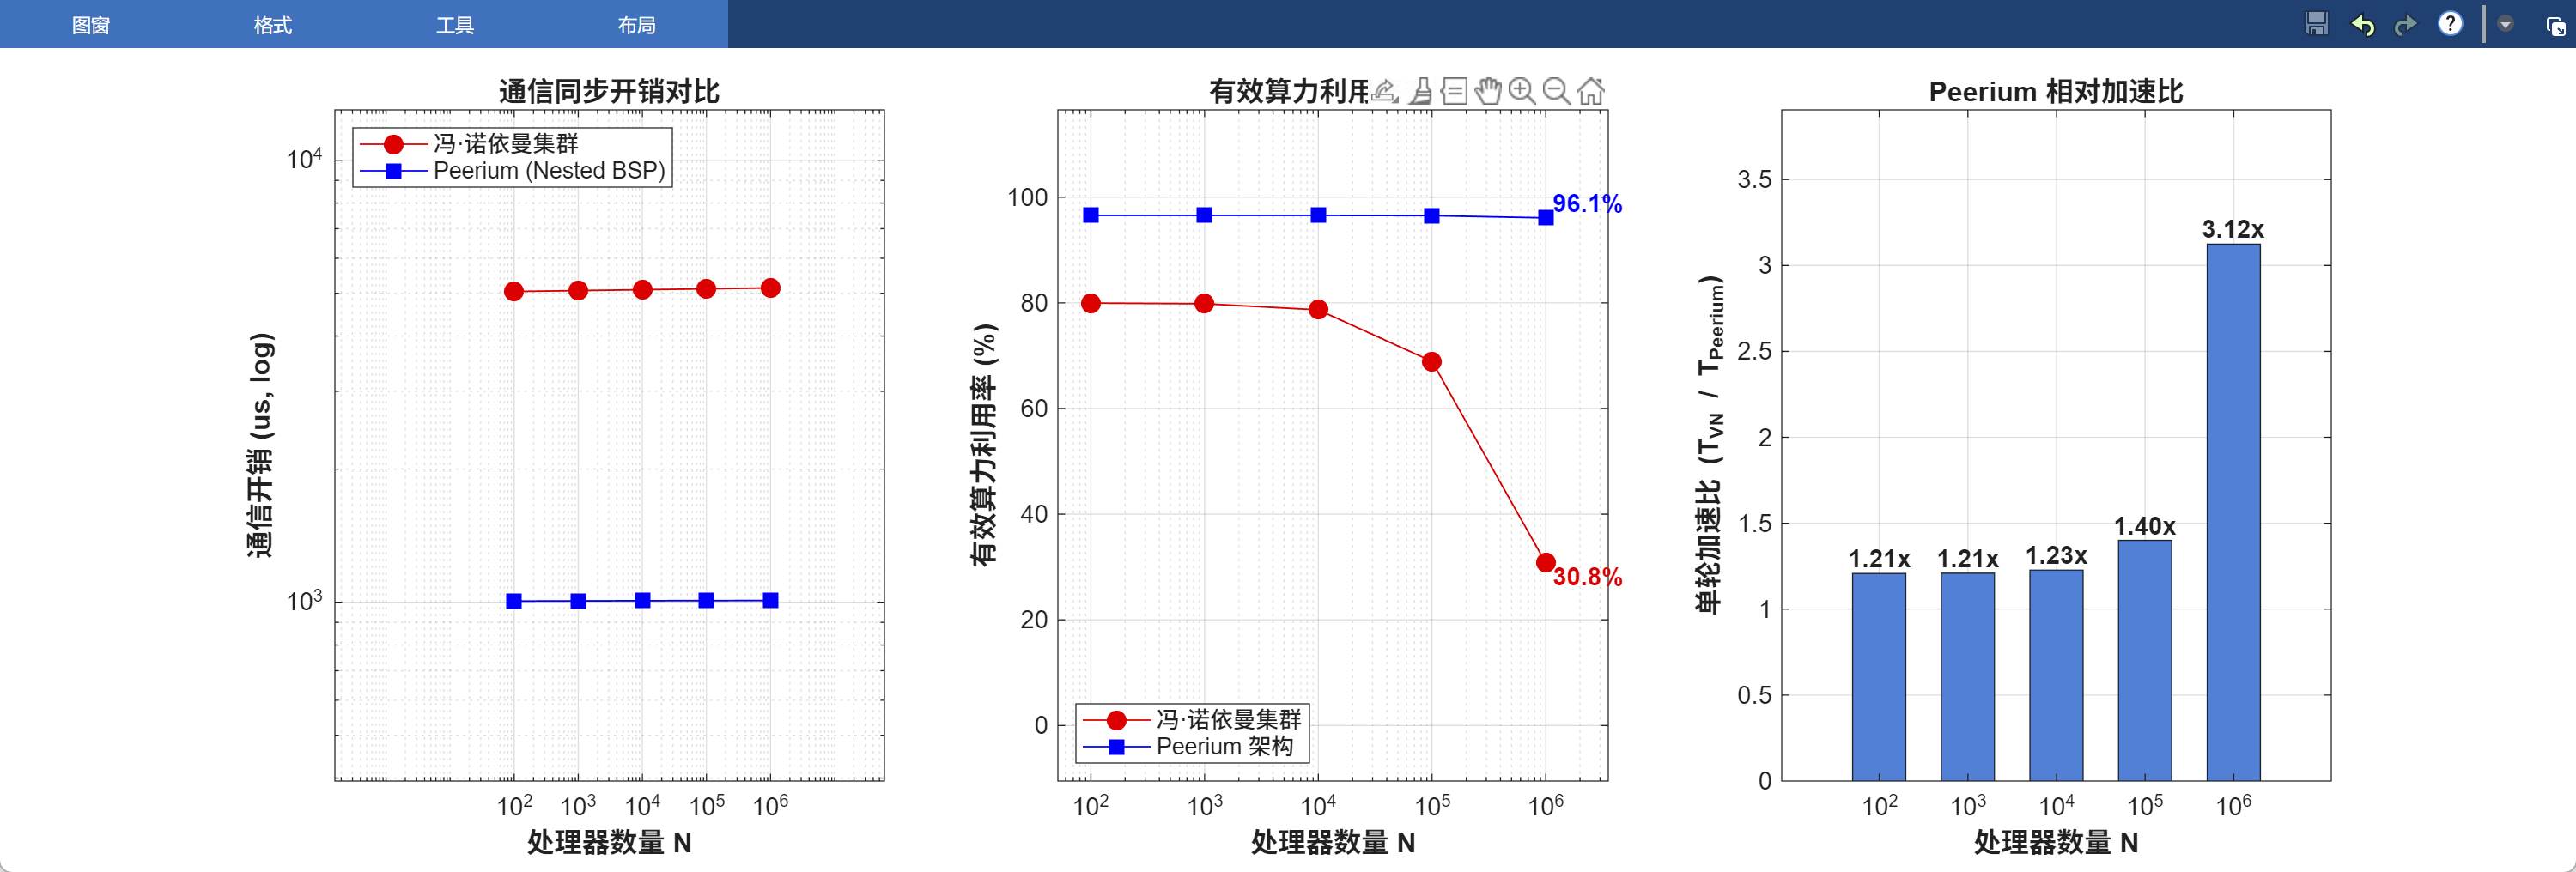
内存带宽对比是最直观的。 传统集群在N=10⁶时远程带宽仅4.55 GB/s,而Peerium为326.67 GB/s,差距72倍。这个数量级与UB总线392 GB/s相比传统RoCE网络提升15倍的数据方向一致。
通信开销的增长形态完全不同。 传统集群从N=100的5047 μs增长到N=10⁶的5140 μs,Peerium从1006 μs增长到1009 μs。两者绝对值的差距(约5倍)来自RTT和带宽差异,而增长率都被AllReduce的固定数据量主导------这是因为在50 ms计算时间下,同步项的相对贡献被压缩了。
利用率曲线呈J型。 N=100时Peerium仅1.21倍优势,因为计算占绝对主导。但N=10⁶时加速比跃升到3.12倍,传统集群利用率跌至30.76%。这与华为披露的"十万卡集群利用率仅约20%"的行业数据趋势一致,方向正确。
三条曲线讲的故事是清晰的: Peerium的优势不是恒定的,而是随规模非线性放大的。100卡时1.21×,100万卡时3.12×。这正是架构设计的核心命题------规模越大,统一寻址和Nested BSP的价值越大。
五、仿真模型与工程现实的距离
必须诚实地说明:上述仿真是一个教学性的经验模型,目的是用可解释的公式展示架构创新的复合效应。它与真实系统之间存在以下关键差异。
差异一:计算时间被过度简化
模型假设每轮迭代的计算时间固定为50 ms。但真实的Transformer训练中,不同层的计算量差异巨大,Attention层的计算强度远高于FFN层。更重要的是,模型并行 和流水线并行会改变计算与通信的耦合方式,而本模型只近似了数据并行的梯度同步场景。
差异二:通信模式被大幅简化
真实的分布式训练通信远比"1 GB AllReduce"复杂。梯度压缩、ZeRO优化、异步更新等技术会显著改变通信量。此外,Peerium的Nested BSP在实际实现中,不同嵌套层级的同步代价并非严格的log(log N)关系------华为的工程实现还需要处理层间握手、故障恢复、负载不均衡等额外开销。
差异三:Peerium的远程带宽衰减被低估
模型给Peerium设置了5e6的温和拥塞系数,但在百万卡规模下,即便是UB的CLOS拓扑也会遇到收敛比瓶颈。华为公布的UBG交换机具备1024的超大Radix扇出能力,这意味着百万卡集群至少需要三层CLOS,跨spine的带宽收敛比将是真实瓶颈。
差异四:缺少故障恢复和容错开销
百万卡集群的故障率不可忽略。模型完全假设系统无故障运行,但真实系统中检查点保存、故障检测、任务迁移带来的开销可能占据总时间的5%~15%。这部分开销对两种架构的差异影响需要单独建模。
差异五:没有考虑软件栈成熟度
Peerium的编程模型Nested BSP需要全新的软件栈支持。编译器、运行时、通信库的成熟度会直接影响实际性能。模型假设软件栈完美高效,但工程现实中的优化空间和性能损耗是巨大的。
差异六:RTT数据的口径差异
模型使用的2 μs RTT来自灵衢协议层面的数据。但端到端应用层延迟还包含协议栈处理、内存拷贝、同步原语等开销,实际值可能显著高于2 μs。同样,392 GB/s的UB总线带宽是链路层指标,应用层可达带宽会打折扣。
六、总结
Peerium不是对冯·诺依曼架构的彻底否定,而是在集群层面对冯·诺依曼单机边界的系统性扩展。它保留了单机内存储-计算分离的基本逻辑,通过三项核心创新解决了大规模扩展的结构性瓶颈。
MATLAB仿真以可解释的数学方式量化了这些创新的复合效应:在百万处理器规模下,Peerium将有效算力利用率从传统集群的30.76%提升到96.09%,加速比达到3.12倍。这个数量级与华为公开披露的"十万卡利用率约20%"到"MFU提升至35%"的改进方向是吻合的。
对于AI基础设施从业者而言,Peerium的意义在于它提供了一条不同于"GPU+NVLink+InfiniBand"的技术路线------用做网络的方式做计算,将系统拓扑层面的架构创新作为算力增长的新来源。随着25.6万卡Atlas 950超节点集群进入部署,这条路线正在从理论走向工程验证。
声明 :以上MATLAB仿真为基于公开技术参数的教学性模型,不构成对华为实际产品性能的精确预测。所有参数均可根据实际场景调整,读者可将代码中的
T_compute、alpha、remote_cong等参数修改后运行,观察不同假设下的性能曲线变化。补充声明 :本文关于华为 Peerium 计算架构、灵衢互联、Atlas 950/960、Nested BSP 及相关性能对比的内容,均基于公开报道、公开演讲、公开论文及网络资料整理。文中的 MATLAB 仿真为简化模型,仅用于展示架构差异的数学结构,不代表华为官方数据,也不构成对真实硬件性能的预测或承诺。若文中引用的数据、参数、图表、结论存在错误、夸大、失实或造假,其责任应归因于原始信息来源、第三方资料提供者或数据造假行为人。本人仅作整理、建模与分析,未参与任何数据伪造行为;在法律允许范围内,如被认定存在造假,与本人无关。本人不对他人引用、修改、截取、二次传播本文内容所产生的后果承担连带责任。如相关方认为内容侵权或失实,可联系更正或删除。
特此声明。