先说清楚这套方案解决什么问题
家里的摄像头大多是普通 IP 摄像头,能出 RTSP 流,但自带的人形检测基本靠 PIR 或者简单的画面变化判断,风一吹树叶、车灯扫过、猫走过去都会触发录像,手机一天能收到几十条推送。
我想要的其实不复杂:只在画面里出现人、车、猫狗这类目标时才记录事件,其余时间安静地存录像就行。Frigate 正好是干这个的------它把视频流拉进来,用目标检测模型逐帧推理,命中目标才生成事件,并且它自带一套基于 MQTT 和 Web UI 的事件管理,不需要自己再写一套后端。
之所以放在绿联 NAS 上,是因为它常年开机、有硬盘位、Docker 支持也齐全,比单独买一台 NVR 或者挂个树莓派省事。这篇就按我自己实际部署的顺序写一遍,中间哪些配置是必须的、哪些是坑,我会尽量说清楚。
硬件前提和版本说明
先说明一下我用的环境,因为 Frigate 对硬件比较敏感,不同平台配置差异不小:
- 设备:绿联 DXP 系列 NAS(x86 架构,Intel 核显)
- 系统:UGOS Pro,Docker 与 Docker Compose 可用
- Frigate 镜像:
ghcr.io/blakeblackshear/frigate:stable - 摄像头:两台支持 RTSP 的普通 IPC,主码流 1080p,副码流 640×360
【注意】Frigate 的镜像标签和配置项在版本之间改动比较频繁,我写这篇时用的是 stable 标签。你如果隔几个月再看,建议先去官方文档确认当前版本的配置字段,尤其是 detect、objects、record 这几块,字段名改过不止一次。我下面给的配置是以我本地能跑通的版本为准,不保证跨大版本完全兼容。
绿联 NAS 的 Docker 界面本质上是对标准 Docker 的封装,所以直接用 compose 文件最省事。我没有用它的图形化"容器"面板去逐个填参数,那样太容易漏环境变量。
为什么不用 CPU 直接跑检测
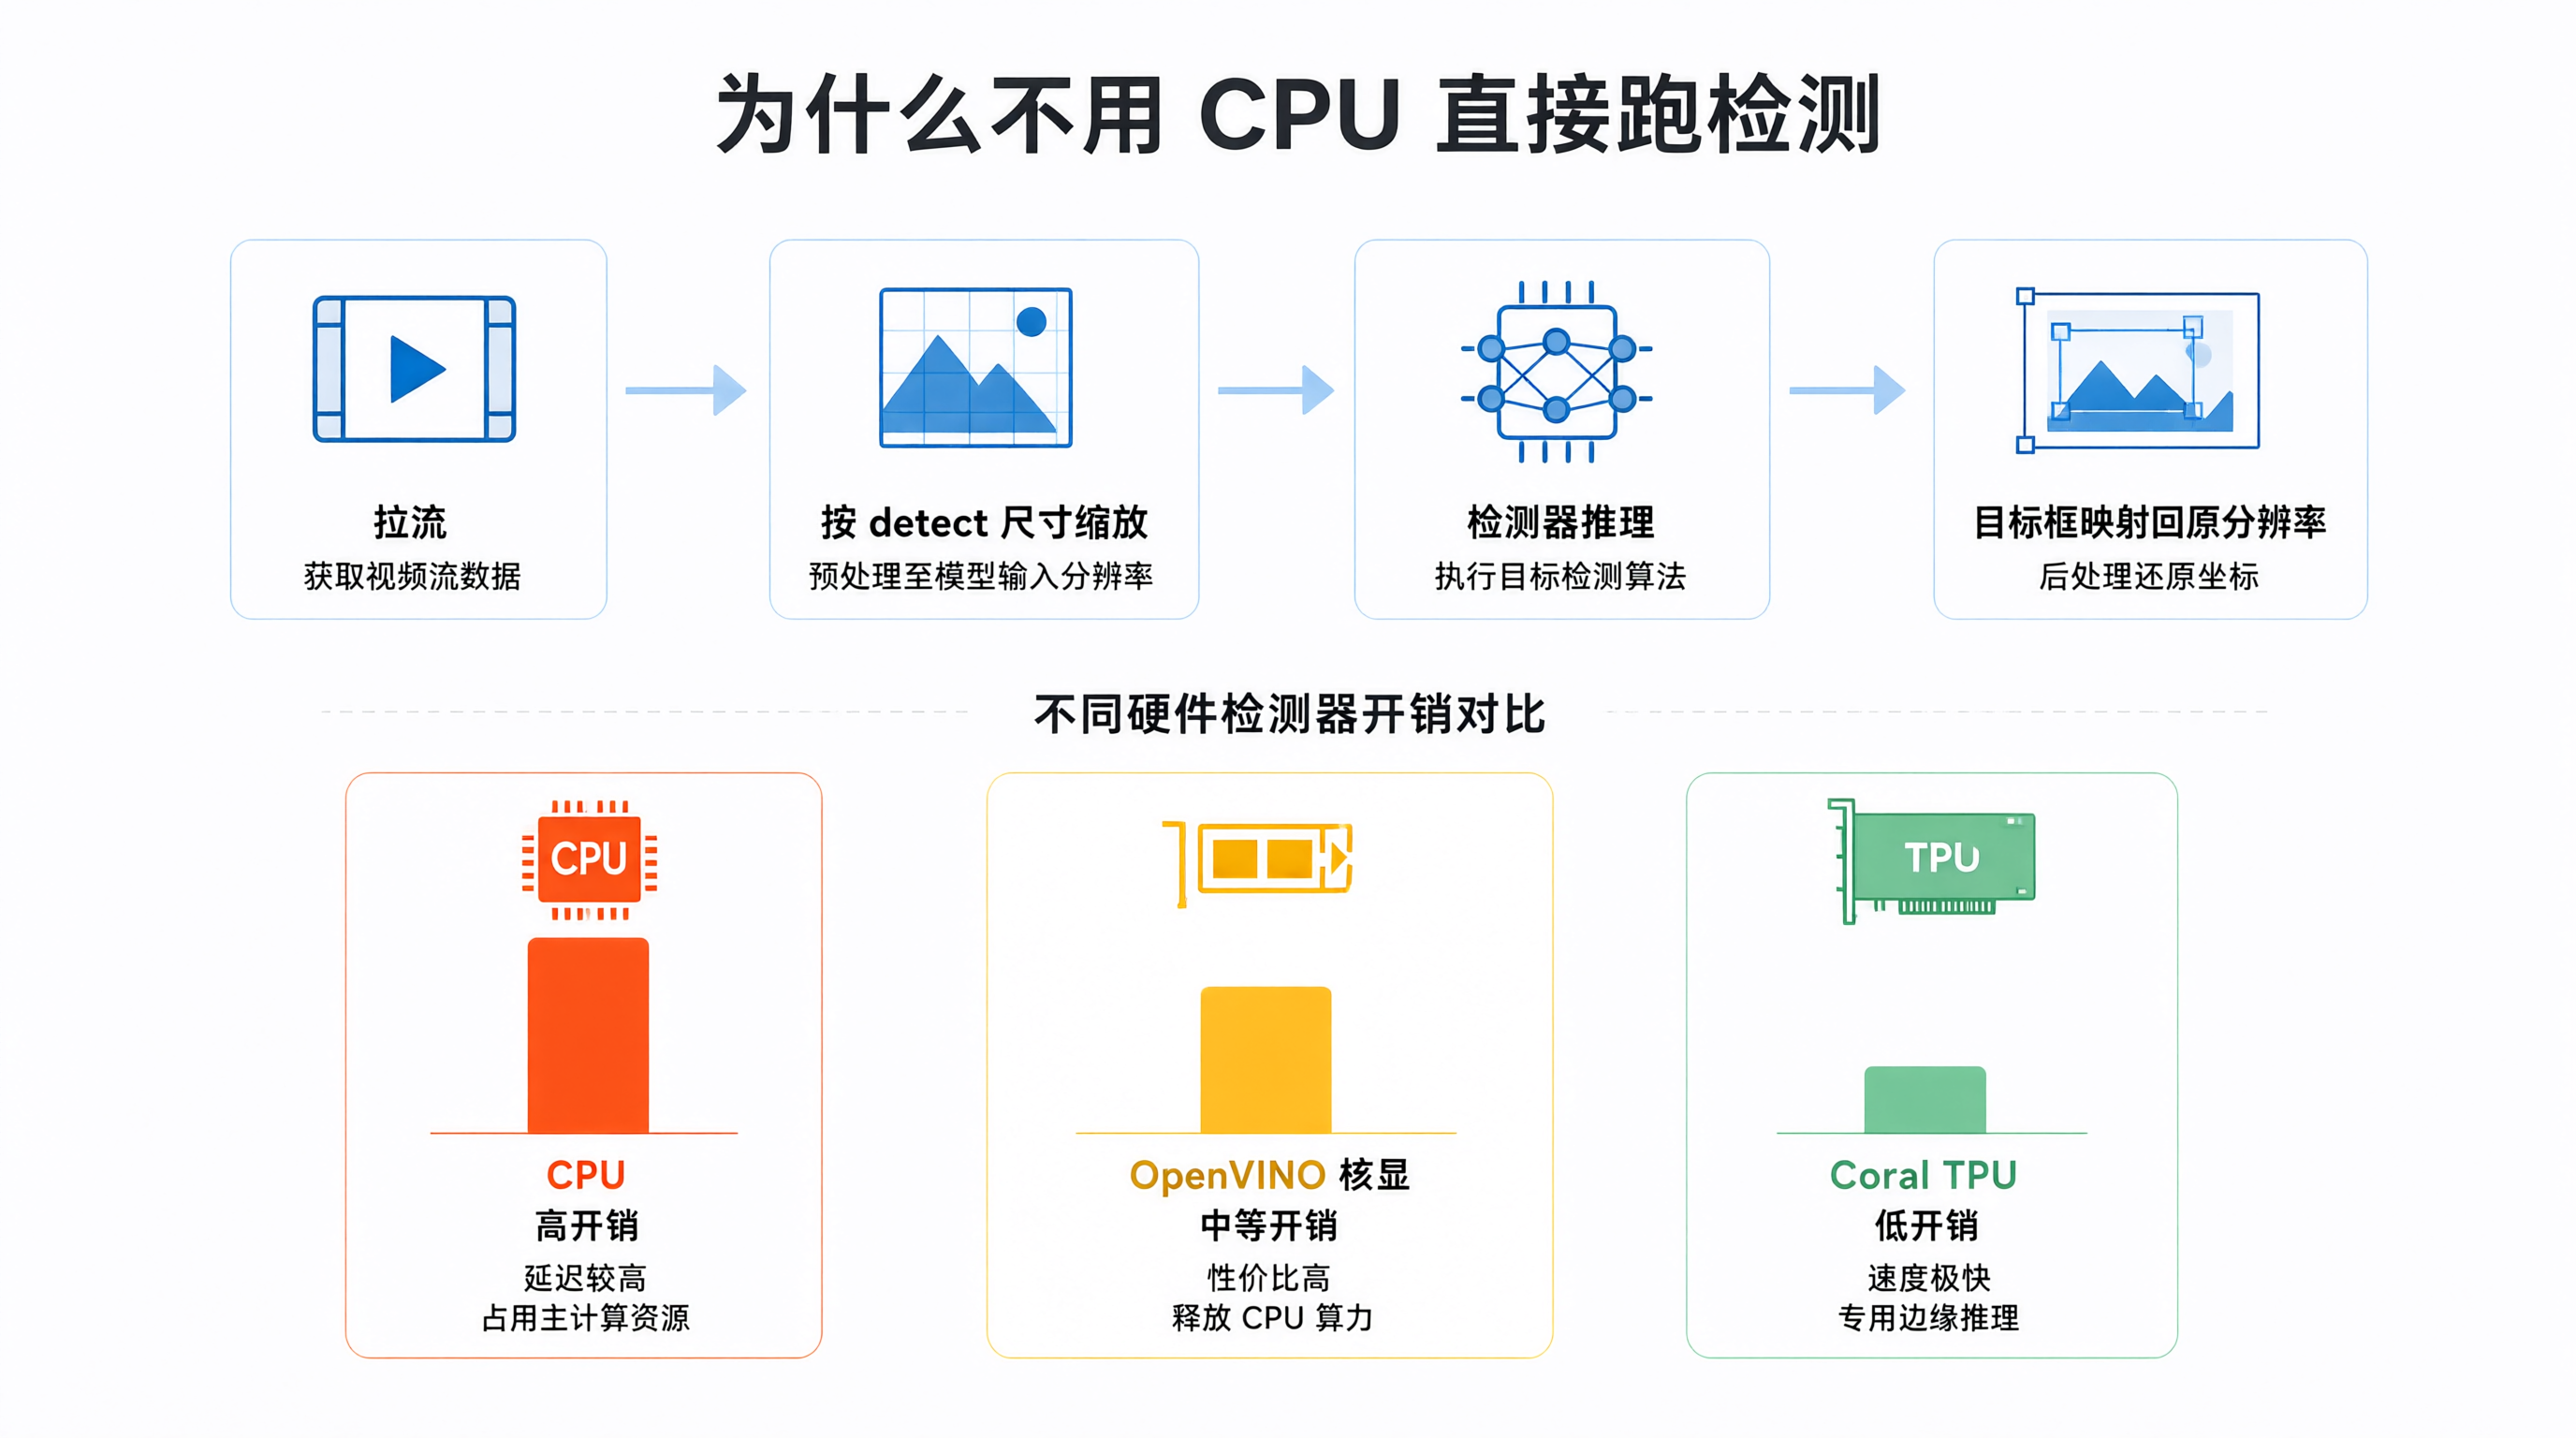
这是很多人第一步就会卡住的地方。Frigate 默认的检测器是 CPU(用 OpenVINO 或者直接跑 TFLite),1080p 一路流在纯 CPU 上推理,帧率会被压得很低,多路就基本跑不动。
Frigate 的检测流程大致是这样的:它从摄像头拉流,按 detect 里配置的宽高做缩放,然后把这个小图送进检测器推理,得到目标框之后再映射回原始分辨率。也就是说,真正影响推理开销的是缩放后的尺寸,不是你摄像头的原始分辨率。这一点理解清楚,后面调优会轻松很多。
检测器可选的路子:
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| CPU(默认) | 零配置,任何机器能跑 | 帧率低,多路吃力 | 单路、临时验证 |
| Intel 核显(OpenVINO) | 绿联 x86 机型可直接用,开销低 | 需要正确映射设备 | 有 Intel 核显的 NAS |
| Coral TPU(USB/PCIe) | 推理快、功耗低 | 需要额外买硬件 | 路数多、追求稳定 |
| NVIDIA GPU | 性能强 | NAS 基本没有 | 自建服务器 |
绿联的 x86 机型带 Intel 核显,所以走 OpenVINO 是最划算的。这里有个前提:容器里要能访问 /dev/dri,否则 OpenVINO 会退回 CPU,你会看到 CPU 占用飙高但检测帧率还是很低。
compose 配置
我最终的 docker-compose.yml 长这样,关键部分我加了注释:
yaml
services:
  frigate:
    container_name: frigate
    image: ghcr.io/blakeblackshear/frigate:stable
    restart: unless-stopped
    shm_size: "256mb"          # 多路摄像头时共享内存要够,否则会崩
    devices:
      - /dev/dri:/dev/dri      # Intel 核显直通,OpenVINO 靠它
    volumes:
      - /volume1/docker/frigate/config:/config
      - /volume1/docker/frigate/media:/media/frigate
      - /etc/localtime:/etc/localtime:ro
    ports:
      - "5000:5000"            # Web UI
      - "8554:8554"            # RTSP 回放(可选)
      - "8555:8555/tcp"        # WebRTC(可选)
    environment:
      - FRIGATE_RTSP_PASSWORD=你的摄像头密码
几个点解释一下。
shm_size 是共享内存。Frigate 用共享内存做帧缓冲,路数多、分辨率高的时候默认的 64MB 很容易不够,表现是容器莫名重启或者日志里报共享内存相关的错误。我给到 256MB,两路 1080p 是够的。你如果上四路以上,建议再往上加。
devices 那行是让容器能碰 /dev/dri。绿联的系统里这个设备节点是存在的,但默认容器拿不到,必须显式映射。这一步没做,OpenVINO 就用不了。
【踩坑提醒】绿联的存储路径和群晖不一样,它的主存储卷一般在 /volume1 这种路径下,但不同型号、不同存储池编号会变。配之前先在文件管理器里确认你的实际路径,别照抄我的。
config.yml:摄像头和检测器
Frigate 的主配置是 config/config.yml,compose 只是把它挂进去。核心内容:
yaml
mqtt:
  enabled: false        # 我没接 MQTT,先关掉

detect:
  enabled: true

detectors:
  ov:
    type: openvino
    device: AUTO

model:
  path: /openvino-model/ssdlite_mobilenet_v2.xml
  width: 300
  height: 300
  input_pixel_format: bgr
  input_tensor: nhwc
  labelmap_path: /openvino-model/coco_91cl_bkgr.txt

cameras:
  front_door:
    ffmpeg:
      inputs:
        - path: rtsp://admin:密码@192.168.1.10:554/Streaming/Channels/101
          roles:
            - detect
            - record
        - path: rtsp://admin:密码@192.168.1.10:554/Streaming/Channels/102
          roles:
            - detect
    detect:
      width: 640
      height: 360
      fps: 5
    objects:
      track:
        - person
        - car
        - dog
        - cat
    record:
      enabled: true
      retain:
        days: 3
        mode: active_objects
    snapshots:
      enabled: true
这里有几处值得展开。
主副码流分开用。 海康、大华这类摄像头一般有主码流和子码流。我把子码流(102 通道)拿来给检测用,主码流(101 通道)用来录像。原因很直接:检测只需要低分辨率,用子码流能大幅降低解码和缩放的开销;而录像要清晰,用主码流。这是很实用的一招,尤其是多路的时候。
detect 里的 width/height。 这两个值是送给检测器的输入尺寸。设成 640×360 而不是 1920×1080,推理开销能差好几倍,而人形识别在 640 宽度上其实已经够用了。这是整个配置里对性能影响最大的一个参数。
fps: 5。 检测帧率。人走动不是高速运动,5 帧足够捕捉到,没必要按摄像头原生 25 帧去跑。这个值直接决定推理频率,调低立竿见影。
model 部分用的是 OpenVINO 自带的 SSD MobileNet v2。 这是 Frigate 镜像里预置的模型,输入 300×300,识别 COCO 的常见类别。它不是最强的模型,但胜在轻、开箱即用。你如果追求精度,可以换 YOLO 系列的模型,但需要自己准备模型文件并改 model 配置,这一步我没在绿联上做,所以具体的路径和参数我这里就不写了,避免给错。
启动和验证
配好之后启动,然后看日志:
bash
docker logs -f frigate正常情况下你会看到它连接摄像头、初始化 ffmpeg、加载 OpenVINO 模型。如果 OpenVINO 加载成功,日志里会有类似 OpenVINO 和推理相关的输出。如果它退回 CPU,你会在日志里看到 CPU 检测器的提示,同时 Web UI 里检测帧率会明显偏低。
Web UI 默认在 5000 端口,浏览器打开 http://你的NAS_IP:5000。进去之后能看到实时画面、检测框、以及 Events 和 Recordings 两个页面。
判断是否真的走核显,我一般看两个地方:
- 日志里检测器类型;
- 检测帧率的实际值(在 UI 的 System 或者 debug 页面能看到 inference speed)。
如果 inference speed 是几十毫秒级别,基本就是 CPU 在跑;如果是几毫秒,说明核显生效了。具体数值因机器而异,我这里不给绝对值,你自己对比开不开 /dev/dri 的差别就能看出来。
事件和录像策略
Frigate 的录像有两套逻辑,容易搞混:
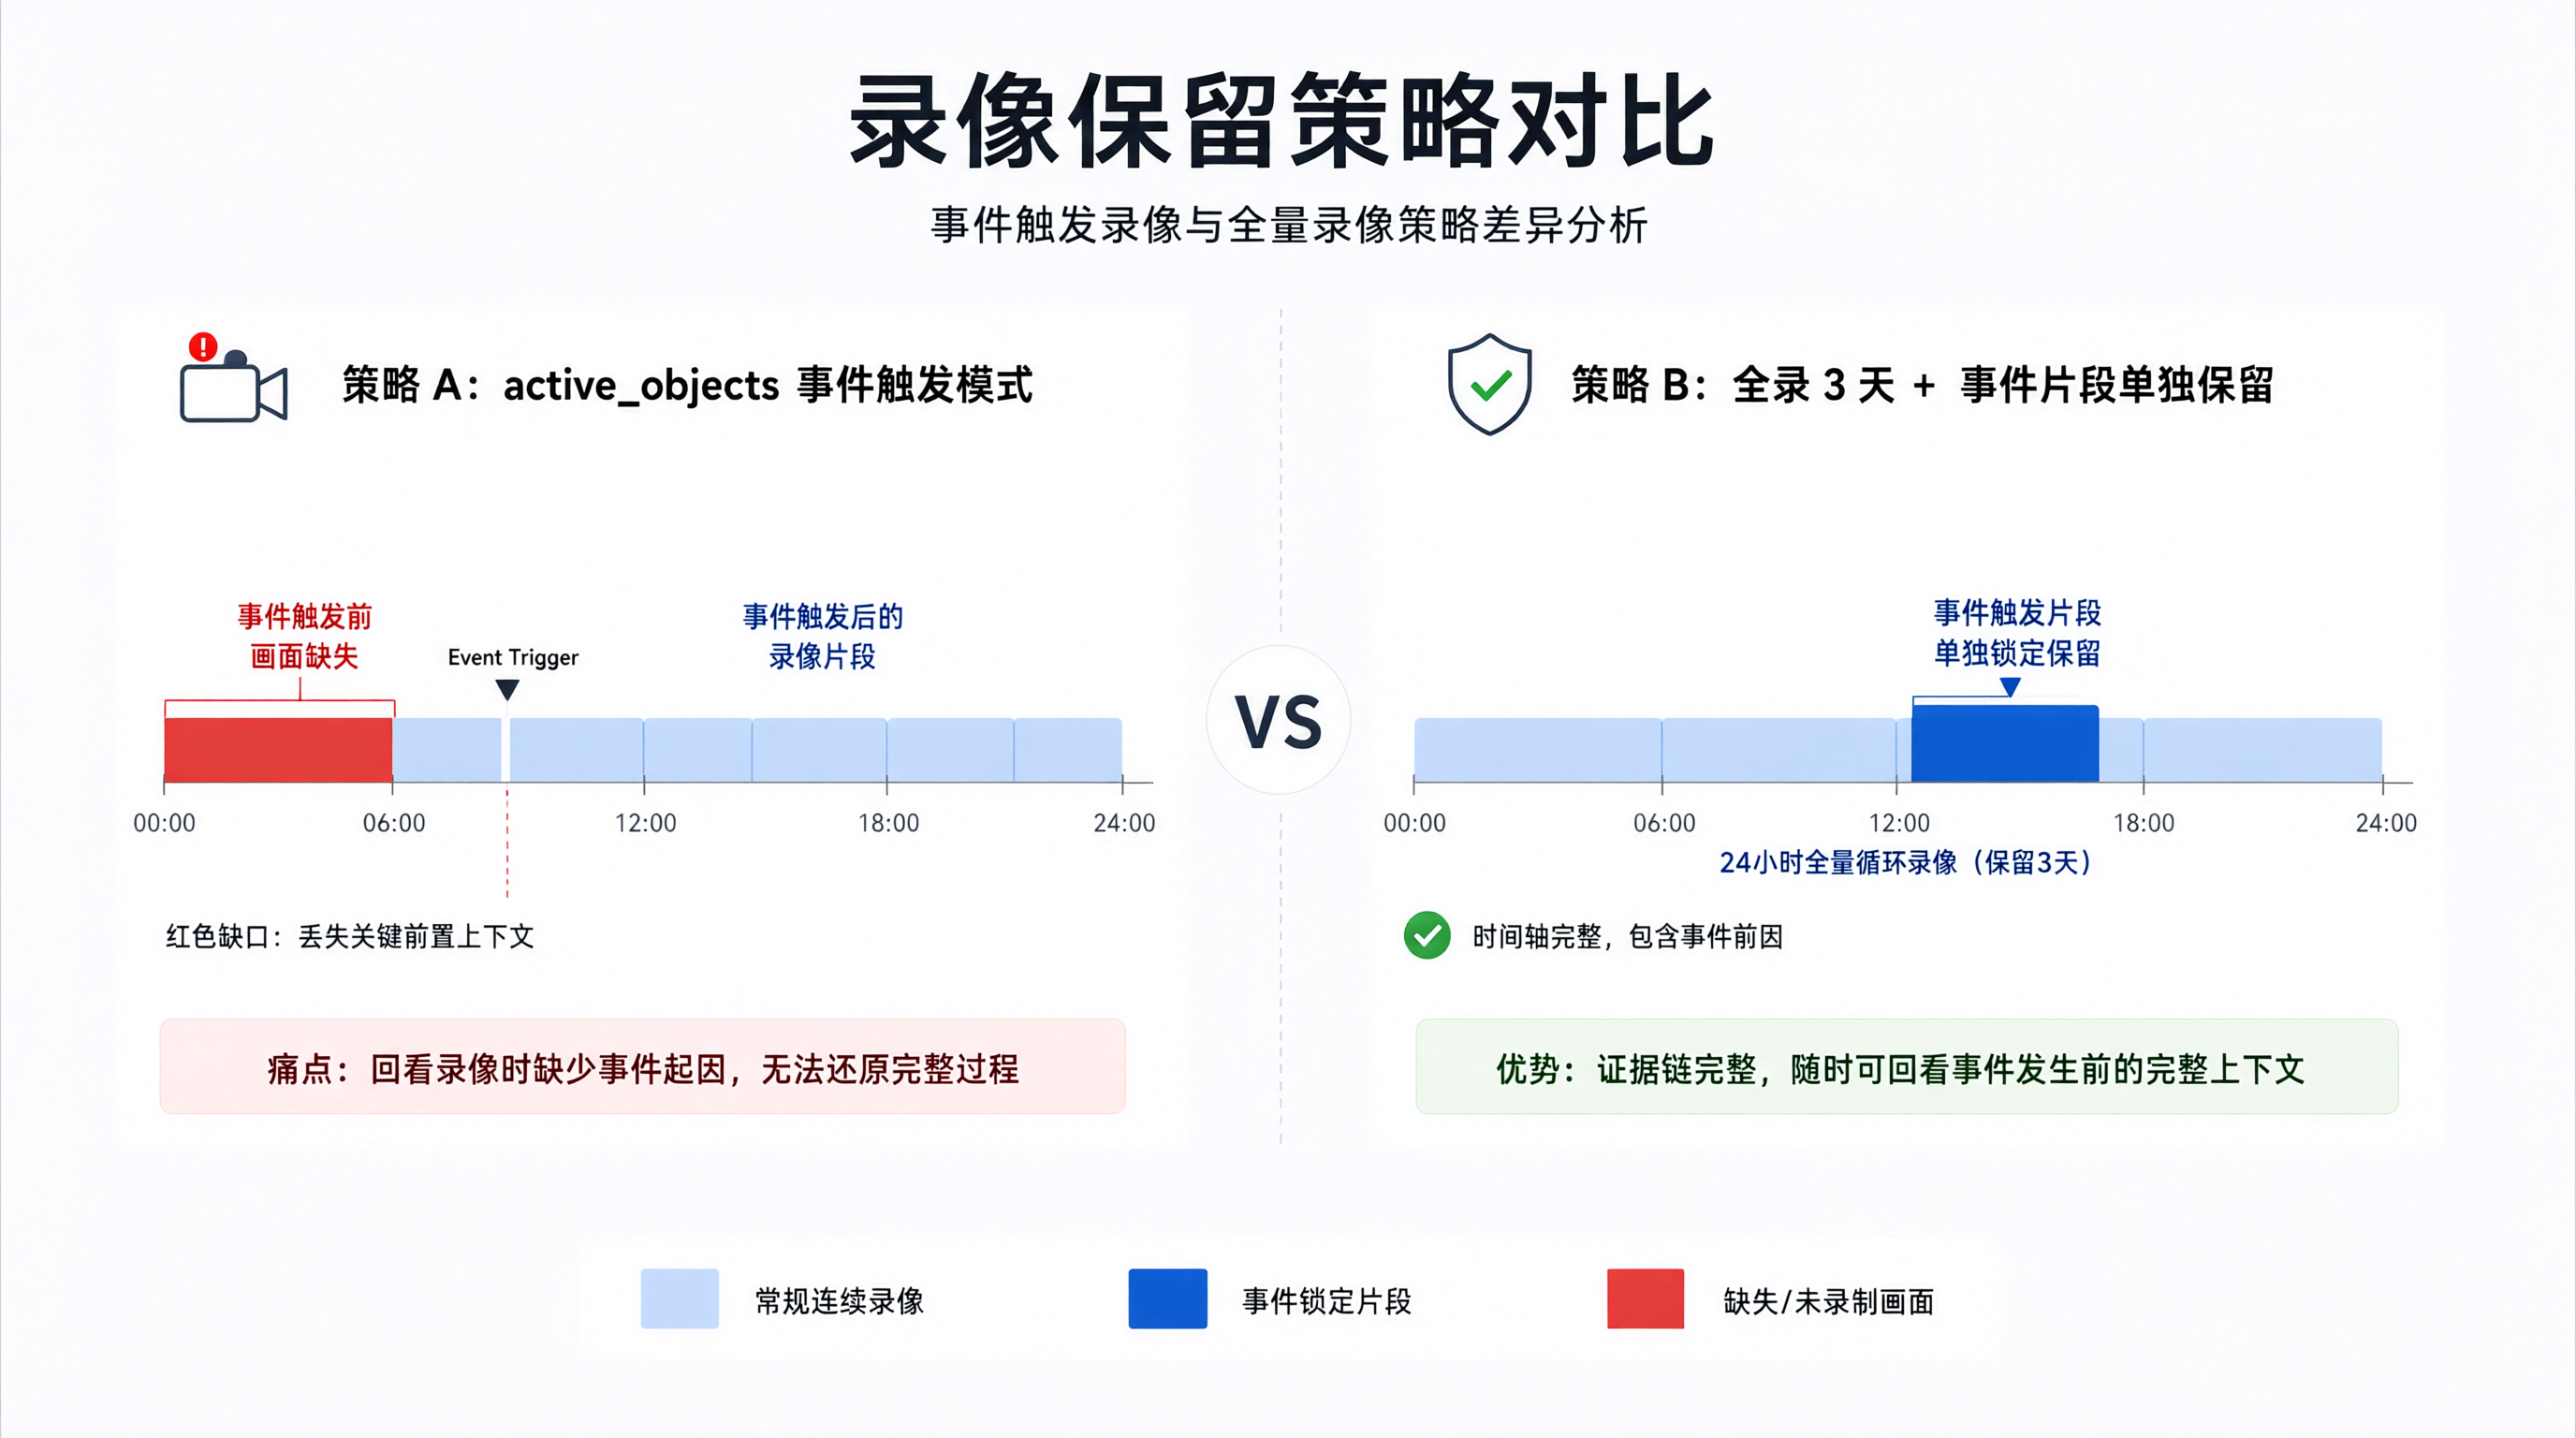
record.retain.days:整体保留多少天。record.retain.mode:保留模式。all是全录,active_objects是只保留有目标活动的时间段,motion是保留有运动的时间段。
我一开始想省空间,直接用了 active_objects,结果发现有些"人刚进入画面还没被判定为目标"的片段会被丢掉,回看时经常缺开头。后来我改成保留全录 3 天 + 事件片段单独保留更久,实际体验更稳。
对象过滤这块,objects.track 决定哪些类别会产生事件。默认可能只跟踪 person 之类,我显式加了 car、dog、cat。这里要注意:你加的类别必须是模型支持识别的类别,SSD MobileNet 用的是 COCO 数据集,包含常见的 80 类,像 person、car、dog、cat 都在里面。你如果想识别 COCO 里没有的类别,就得换模型。
另外 Frigate 有个 zone(区域)的概念,可以只在画面的某一块区域内检测,比如门口、车道,忽略马路这种干扰源。我刚开始没配 zone,结果马路上的车一直触发事件。加上 zone 之后噪音少了很多。zone 的坐标是在 UI 里画出来的,画完它会给你一组相对坐标,贴回 config 就行。
我实际遇到的几个问题
容器反复重启。 排查下来是 shm_size 太小,加了之后就稳定了。
检测不到目标。 有一次是 detect 的宽高比例和摄像头实际画面比例对不上,画面被拉伸得厉害,人形变形导致识别率下降。把宽高改成和子码流接近的比例后正常了。
CPU 一直很高。 检查发现 /dev/dri 没映射成功,OpenVINO 退回 CPU。补上 devices 映射解决。
录像找不到对应事件。 是录像和检测用了不同码流,时间轴对不齐。后来统一让录像走主码流、检测走子码流,事件片段用主码流回放,就对上了。
关于要不要上更强的东西
跑通之后我确实想过换 YOLO 模型、接 MQTT 做自动化、甚至加个本地 LLM 对事件做自然语言描述。但冷静下来看,对我这种家庭场景,SSD MobileNet + 区域过滤已经能过滤掉绝大部分误报,再往上堆的收益不明显。
如果你有更复杂的需求,比如要区分快递员和陌生人、要统计车流量,那确实值得研究更强的模型和 Frigate 的 zone + object 组合。但这属于另一条路了,本文就不铺开。我的建议是先把基础链路跑稳,确认误报率能接受,再决定要不要继续投入。
最后提醒一句:Frigate 的配置字段和镜像版本绑定很紧,升级镜像前先看 release notes,尤其注意 record、detect、model 这几块的变更。我吃过一次升级后配置报错、容器起不来的亏,后来养成习惯------升级前先把 config 目录备份一份。