【数据结构】二叉树_OJ题
🔥 H.莓飛: 个人主页
✨ 心不畏死,踏屍前行。
📦 代码仓库:cocatrice_csdn_code
📖 博主简介:
概览
- 递归类:单值二叉树、相同的树、对称二叉树
- 递归类:最大深度、平衡二叉树、翻转二叉树、最近公共祖先
- 遍历类:前序、中序、后序与中序的迭代写法
- 队列类:层序遍历、外层遍历找子树
- 还原类:先序串建树、前序加中序还原、序列化查子串
- 性质类:完全二叉树的节点个数、平衡判定的早退
核心知识
一、基本套路
二叉树的题看着多,落到写法上只有五个方向。判断该用哪一个,看的是「答案能不能由左子树的答案、右子树的答案和当前结点拼出来」。
第一类,递归。 当前结点做一次比较或一次交换,剩下的活交给左右子树。单值二叉树、相同的树、对称二叉树、最大深度、平衡二叉树、翻转二叉树、最近公共祖先这七道,第一反应都该是递归。写递归只盯三件事:这一层做什么,空了返回什么,子树的返回值怎么用,剩下的交给编译器去展开。
第二类,自己开一个栈模拟递归。 递归写法好写,但函数调用用的是系统栈,链状树能压到很深。前序的迭代写法最简单,右孩子先压、左孩子后压,弹出来就是前序。中序要一路向左压到底,弹出一个记一个,再转向它的右孩子。后序麻烦一点,可用「按根右左压栈、最后整体反转」绕过,也可以用单栈加一个 last 指针记住上一个访问过的结点。Morris 是另一条路,把叶子结点空着的右指针临时当成回头的路,额外空间是常数,代价是遍历途中会改动树的结构。
第三类,队列按层走。 队列在这里有两种用法,一种是把层当成边界,每一轮先记下队列里现有元素个数,正好就是这一层的结点数,层序遍历、按层数最大深度都是它。另一种是成对进成对出,栈或队列里存的是两个结点,比较同一棵树的两边,或者比较两棵树,相同的树、对称二叉树都能这么写,翻转二叉树按层换孩子也属于这一类。
第四类,把树摊平成序列再比。 比较两棵树,最直接的办法是都摊平,再比两个序列。前序加中序能唯一还原一棵树,前提是没有重复值。子树那道题把两棵树都按前序序列化成字符串,再在长串里找短串,代价接近两层循环里最省的那一档,层序遍历也能拍平成一串来比对。
第五类,靠结构性质少走弯路。 完全二叉树的结点个数不用一个个数,量出左右两边的高度,两边一样高说明左边是满的,直接算出左子树的结点数,再递归右边。平衡二叉树的两种写法差别也在这一点上:自顶向下每个结点都重新求一次深度,链状树上退化成平方级;自底向上让后序一路把高度往回带,发现不平衡就返回 -1,整棵树只走一遍。
二、边界值
第一类,空树与单结点。 根是 NULL 时几乎所有递归函数第一行就返回了,这条分支不走一遍很容易漏。只有一个结点的树要单独看:单值判定必然为真,深度是一,翻转之后还是它自己,最近公共祖先里 p 和 q 都是根。
第二类,退化成链。 每个结点只有左孩子(或者只有右孩子)时树变成一条链。递归写法在这类输入上压栈最深,一万个结点的链就够试探出系统的上限。迭代写法和 Morris 在这类输入上不会加深系统栈,这是它们存在的理由。
第三类,满树与完全树。 二十层的满二叉树有一百多万个结点,建树时用来做队列的缓冲如果按固定上限分配,就会越界。这类输入同时也在压时间:一次深度优先要走上百万次函数调用。
第四类,值相同与有重复。 整棵树全是同一个值时,单值判定每次比较都取等号,看起来什么都没发生,实际上每条边的判断都走到了。前序加中序还原这棵树时,重复值会让还原结果不唯一,做随机核对得先把结点编号成互不相同的值,否则一千组里能对不上的有好几百组。
第五类,目标结点的位置。 最近公共祖先的答案取决于 p 和 q 落在哪:一个是另一个的祖先,两个分居根的左右,p 和 q 是同一个结点,或者其中一个就是根,这几种摆法要各测一遍。
三、题目总览
| 序号 | 题目 | 题号 | 套路 | 时间复杂度 |
|---|---|---|---|---|
| 1 | 单值二叉树 | 965 | 递归逐层比较 | O(N) |
| 2 | 相同的树 | 100 | 两棵树同步走 | O(N) |
| 3 | 对称二叉树 | 101 | 成对比较内外侧 | O(N) |
| 4 | 二叉树的前序遍历 | 144 | 栈模拟递归 | O(N) |
| 5 | 二叉树的中序遍历 | 94 | 递归 | O(N) |
| 6 | 二叉树的中序遍历(迭代写法) | 94 | 栈或 Morris | O(N),Morris 额外空间 O(1) |
| 7 | 二叉树的后序遍历 | 145 | 栈加 last 指针 | O(N) |
| 8 | 另一棵树的子树 | 572 | 外层遍历套内层比对 | O(N×M),序列化接近 O(N+M) |
| 9 | 二叉树的构建及遍历 | 建树题 | 先序串建树 | O(N) |
| 10 | 二叉树的最大深度 | 104 | 递归取更深的一边 | O(N) |
| 11 | 平衡二叉树 | 110 | 自底向上带早退 | O(N) |
| 12 | 翻转二叉树 | 226 | 换完孩子再往下 | O(N) |
| 13 | 二叉树的层序遍历 | 102 | 队列按层边界 | O(N) |
| 14 | 完全二叉树的节点个数 | 222 | 量左右两边的高度 | O(log²N) |
| 15 | 二叉树的最近公共祖先 | 236 | 后序回传 | O(N) |
十五道题里有十一道的第一版写法是递归,区别只在返回值:有的回传布尔(这一支还成不成立),有的回传整数(高度或者深度),有的回传结点指针(找到的那个),有的干脆不回传(在原地改结构),把返回值想清楚,代码基本就出来了。三道遍历题是另一种性质,它们不改变树,只是把结点按某个顺序取出来,考的是栈怎么摆。
实例代码
十五道题放在同一个目录下,题目一个文件,另有一份共用的 tree.h 和 tree.c。回显都是在 CentOS 7 上跑出来的,gcc 4.8.5。
工程结构
text
ds13/
├── tree.h                        结点结构、建树、随机树、三种遍历、按层打印
├── tree.c
├── p01_965.c                     965 单值二叉树
├── p02_100.c                     100 相同的树
├── p03_101.c                     101 对称二叉树
├── p04_144.c                     144 二叉树的前序遍历
├── p05_094.c                     94 二叉树的中序遍历
├── p06_094_iter.c                94 二叉树的中序遍历(迭代写法)
├── p07_145.c                     145 二叉树的后序遍历
├── p08_572.c                     572 另一棵树的子树
├── p09_build.c                   建树题:二叉树的构建及遍历
├── p10_104.c                     104 二叉树的最大深度
├── p11_110.c                     110 平衡二叉树
├── p12_226.c                     226 翻转二叉树
├── p13_102.c                     102 二叉树的层序遍历
├── p14_222.c                     222 完全二叉树的节点个数
├── p15_236.c                     236 二叉树的最近公共祖先
└── exp/
    └── err_recursion.c           递归深度试探:链长多少层会把系统栈压爆
十五份代码都是从同一个层序数组建树的,数组里空的结点写成 NO_NODE,也就是 int 的最小值。这个约定让每道题的例子和随机数据都能用一行字面量写出来:
c
# 文件:/home/cocatrice/ds13/tree.c
// 按层序数组建树,空结点写成 NO_NODE
struct TreeNode* BuildTree(const int* a, int n)
{
	struct TreeNode** q;
	struct TreeNode* root;
	int head = 0;
	int tail = 0;
	int i = 1;

	if (n <= 0 || a[0] == NO_NODE)
	{
		return NULL;
	}
	q = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)n);
	root = NewNode(a[0]);
	q[tail++] = root;
	while (head < tail && i < n)
	{
		struct TreeNode* cur = q[head++];
		if (i < n)
		{
			if (a[i] != NO_NODE)
			{
				cur->left = NewNode(a[i]);
				q[tail++] = cur->left;
			}
			i++;
		}
		if (i < n)
		{
			if (a[i] != NO_NODE)
			{
				cur->right = NewNode(a[i]);
				q[tail++] = cur->right;
			}
			i++;
		}
	}
	free(q);
	return root;
}
十五个程序都用 gcc -std=gnu99 -Wall -Wextra -O2 tree.c pXX.c -o pXX 编译,零告警。
第一题 单值二叉树(965)
题目:给一棵二叉树,判断每个结点的值是不是都相同。
原题链接: leetcode 965. 单值二叉树
思路。 递归版本每个结点只做一件事:如果左孩子存在,就和左孩子比一次值;右孩子存在,就和右孩子比一次。都相等的话,再把左子树和右子树交给自己去判。空结点返回 true,这是递归的出口。栈版本把还没比过的结点压进栈,弹出来的时候和根的值比一次,不相等就直接返回 false,比数组遍历省一半时间。第三种做法把整棵树的值收进一个数组,再逐个和第一个比。它存在的意义是当对照:三种做法的答案必须一致,这是这一类题的通用验法。
用例走一遍。 第一棵树是 1 1 1 1 1 null 1,根是 1,两个孩子都是 1,左孩子的两个孩子是 1 和 1,右孩子也是 1。
| 走到哪个结点 | 它的值 | 和根的值 1 比 | 这一层之后 |
|---|---|---|---|
| 根 | 1 | 不用比 | 往下 |
| 左孩子 | 1 | 相等 | 往下 |
| 左的左、左的右 | 1、1 | 相等 | 两边都到底 |
| 右孩子 | 1 | 相等 | 两边都到底 |
换成第二棵 2 2 2 5 2,前三步都相等,走到左的左是 5,和根比不相等,递归在那一层返回 false,然后一层层往上带,整棵树判为 false。
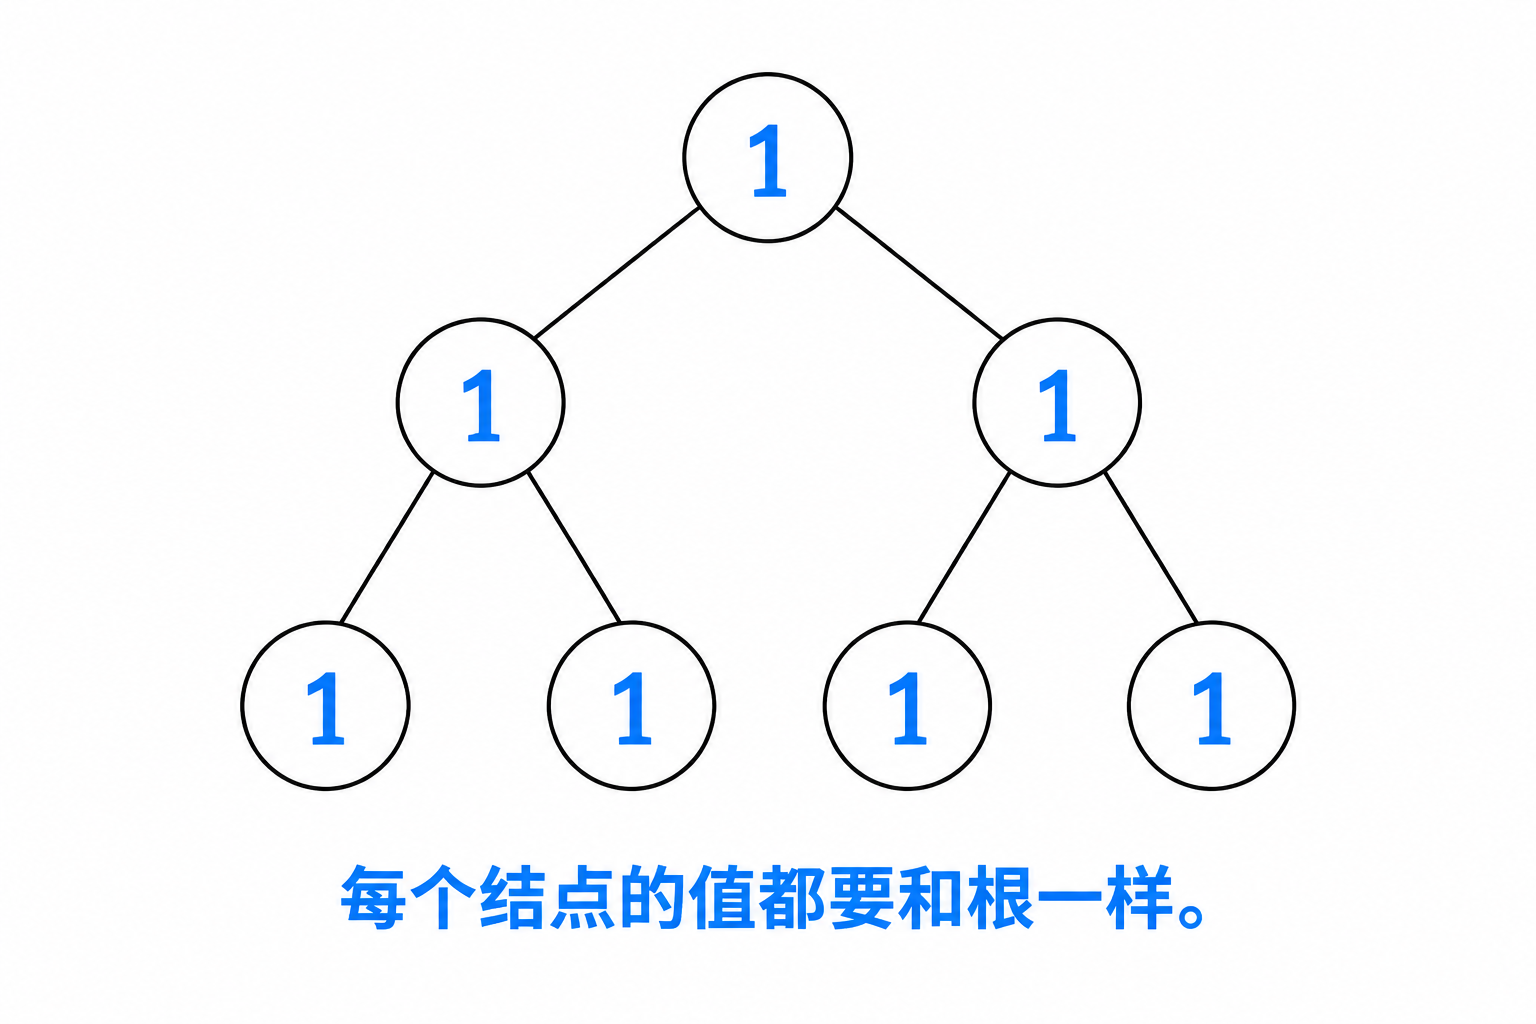
图 1 单值二叉树:每个结点都要和根的值一样
代码。
c
# 文件:/home/cocatrice/ds13/p01_965.c
static bool IsUnivalTree(struct TreeNode* root)
{
	if (root == NULL)
	{
		return true;
	}
	if (root->left != NULL && root->left->val != root->val)
	{
		return false;
	}
	if (root->right != NULL && root->right->val != root->val)
	{
		return false;
	}
	return IsUnivalTree(root->left) && IsUnivalTree(root->right);
}

static bool IsUnivalTreeIter(struct TreeNode* root)
{
	struct TreeNode** st;
	int top = 0;
	int val;
	bool ans = true;

	if (root == NULL)
	{
		return true;
	}
	st = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	val = root->val;
	st[top++] = root;
	while (top > 0)
	{
		struct TreeNode* cur = st[--top];

		if (cur->val != val)
		{
			ans = false;
			break;
		}
		if (cur->left != NULL)
		{
			st[top++] = cur->left;
		}
		if (cur->right != NULL)
		{
			st[top++] = cur->right;
		}
	}
	free(st);
	return ans;
}
实测回显。
text
题目给的例子:
1 1 1 1 1 null 1                   递归 true  迭代 true  收值 true  三种一致
2 2 2 5 2                          递归 false 迭代 false 收值 false 三种一致

边界值:
只有一个结点 7               递归 true  迭代 true  收值 true  三种一致
三个结点全是 1               递归 true  迭代 true  收值 true  三种一致
3 3 null 3 3                       递归 true  迭代 true  收值 true  三种一致
9 9 9 null 9                       递归 true  迭代 true  收值 true  三种一致
空树                             递归 true  迭代 true  收值 true  三种一致

随机数据核对:
  500 组随机数据,三种做法不一致 0 组

一条十万个结点的链,值从 5 开始逐个加一:
  递归     false   用时 0.000 毫秒
  迭代     false   用时 0.000 毫秒
  收值     false   用时 2.241 毫秒

同一条链,只有最深的一个结点是 6:
链上最深一个是 6            递归 false 迭代 false 收值 false 三种一致
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | true | 递归第一行就返回,一次比较都不做 |
| 只有根结点 7 | true | 没有孩子可比 |
| 三个结点全是 1 | true | 两条边都走到,都取等号 |
| 3 3 null 3 3 | true | 缺的那一边不参与比较 |
| 9 9 9 null 9 | true | 同上 |
| 2 2 2 5 2 | false | 左的左是 5,和根对不上 |
复杂度。 时间 O(N),每个结点访问一次,递归的系统栈深度等于树高,链状树上是 O(N)。收值的做法额外用了 O(N) 的空间,另外两种是 O(树高)。
第二题 相同的树(100)
题目:给两棵二叉树,判断结构和每个位置上的值是不是完全一样。
原题链接: leetcode 100. 相同的树
思路。 递归两个指针同步走,先把四种情况摆平:两个都空返回 true;只有一个空返回 false;值不相等返回 false;剩下的情况递归比左边和右边。栈版本把成对的结点压进栈,弹出两个按同样四条规则判一次,再把它们的孩子成对压回去,注意空的也要压,不然结构信息就丢了。第三种按层序把两棵树各展开成一个字符串,空结点写成 #,再比两个串是否相等,好处是「相同」这件事变成了一次字符串比较。
用例走一遍。 第一个例子比较 1 2 3 和 1 2 3,两棵都是根 1、左右孩子 2 和 3。
| 比较的位置 | 第一棵 | 第二棵 | 结论 |
|---|---|---|---|
| 根 | 1 | 1 | 值相等,往两边走 |
| 左孩子 | 2 | 2 | 值相等,再往下 |
| 右孩子 | 3 | 3 | 值相等,再往下 |
| 四个空孩子 | 空 | 空 | 都到底了,相同 |
第二个例子是 1 2 和 1 null 2,根和左孩子都对得上,走到右孩子:第一棵的右孩子是空的,第二棵是 2,结构不一样,判 false。
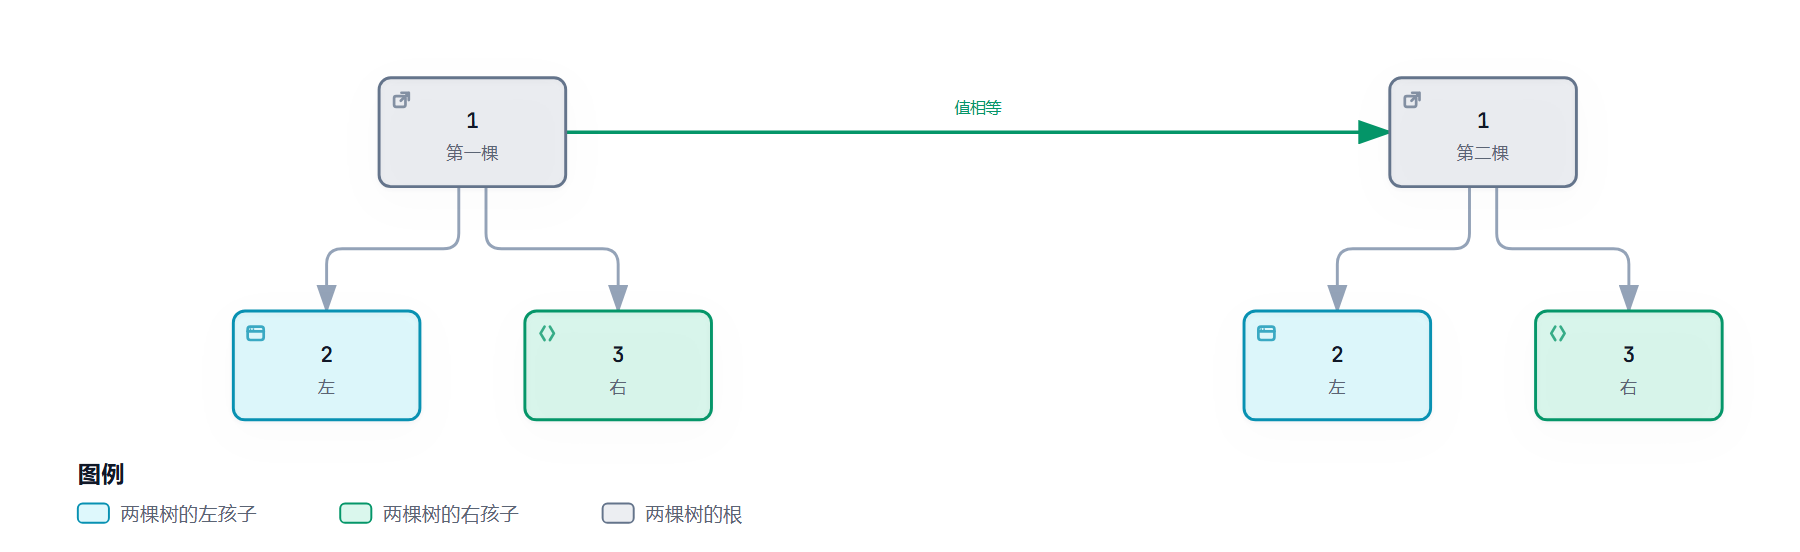
图 2 相同的树:三个位置一一对应地比
代码。
c
# 文件:/home/cocatrice/ds13/p02_100.c
static bool IsSameTree(struct TreeNode* p, struct TreeNode* q)
{
	if (p == NULL && q == NULL)
	{
		return true;
	}
	if (p == NULL || q == NULL)
	{
		return false;
	}
	if (p->val != q->val)
	{
		return false;
	}
	return IsSameTree(p->left, q->left) && IsSameTree(p->right, q->right);
}

static bool IsSameTreeIter(struct TreeNode* p, struct TreeNode* q)
{
	struct TreeNode** st;
	int top = 0;
	bool ans = true;

	st = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * 4u * (size_t)TREE_MAX);
	st[top++] = p;
	st[top++] = q;
	while (top > 0)
	{
		struct TreeNode* b = st[--top];
		struct TreeNode* a = st[--top];

		if (a == NULL && b == NULL)
		{
			continue;
		}
		if (a == NULL || b == NULL)
		{
			ans = false;
			break;
		}
		if (a->val != b->val)
		{
			ans = false;
			break;
		}
		st[top++] = a->left;
		st[top++] = b->left;
		st[top++] = a->right;
		st[top++] = b->right;
	}
	free(st);
	return ans;
}
实测回显。
text
题目给的例子:
1 2 3 与 1 2 3                递归 true  迭代 true  展开 true  三种一致
1 2 与 1 null 2               递归 false 迭代 false 展开 false 三种一致
1 2 1 与 1 1 2                递归 false 迭代 false 展开 false 三种一致

边界值:
两棵都是空树             递归 true  迭代 true  展开 true  三种一致
空树与 1 2 3                递归 false 迭代 false 展开 false 三种一致
5 5 5 与 5 5 null             递归 false 迭代 false 展开 false 三种一致
同一棵树自己比自己    递归 true  迭代 true  展开 true  三种一致

随机数据核对:
  500 组随机数据,三种做法不一致 0 组

一条十万个结点的链:
  两棵完全一样   递归 true   用时 0.000 毫秒
  两棵完全一样   迭代 true   用时 0.000 毫秒
  一棵左链一棵右链(根的值相同)   递归 false
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 两棵都是空树 | true | 都空这条分支 |
| 空树与 1 2 3 | false | 一个空一个不空 |
| 5 5 5 与 5 5 null | false | 值都对得上,第二棵少一个孩子 |
| 同一棵树自己比自己 | true | 每个位置都比一次,全相等 |
| 1 2 与 1 null 2 | false | 值的顺序不对 |
复杂度。 时间 O(min(N, M)),一发现不一样就提前结束。栈版本最坏压进 O(N) 对结点,展开的做法要额外 O(N) 的字符串。
第三题 对称二叉树(101)
题目:判断一棵二叉树是不是轴对称的,也就是左右翻转之后和原树一样。
原题链接: leetcode 101. 对称二叉树
思路。 递归比较的是「两棵子树成对往下走」:拿左边的左孩子和右边的右孩子比(外侧一对),左边的右孩子和右边的左孩子比(内侧一对),两对都成立才算对称;根结点自己不参与比较,它只负责把左右两棵子树交出去。队列版本把成对的结点两个两个塞进队列,弹出两个先比一次值,再按对称的顺序把 (左的左, 右的右) 和 (左的右, 右的左) 成对塞回去。第三种做法把右子树原地镜像翻转,再和左子树比「相同的树」,写起来最短,代价是改了树的结构,测完得翻回来。
用例走一遍。 例子是 1 2 2 3 4 4 3,层序读出来根是 1,左右两个孩子都是 2。
| 比较的一对 | 一边 | 另一边 | 结论 |
|---|---|---|---|
| 根的两个孩子 | 左 2 | 右 2 | 值相等,继续 |
| 外侧 | 左的左 3 | 右的右 3 | 值相等 |
| 内侧 | 左的右 4 | 右的左 4 | 值相等 |
| 更下一层的空孩子 | 空 | 空 | 都到底,对称 |
换一个 1 2 2 null 3 null 3,外侧那一对比的是空的左的左和有值的右的右,一个空一个不空,判 false。
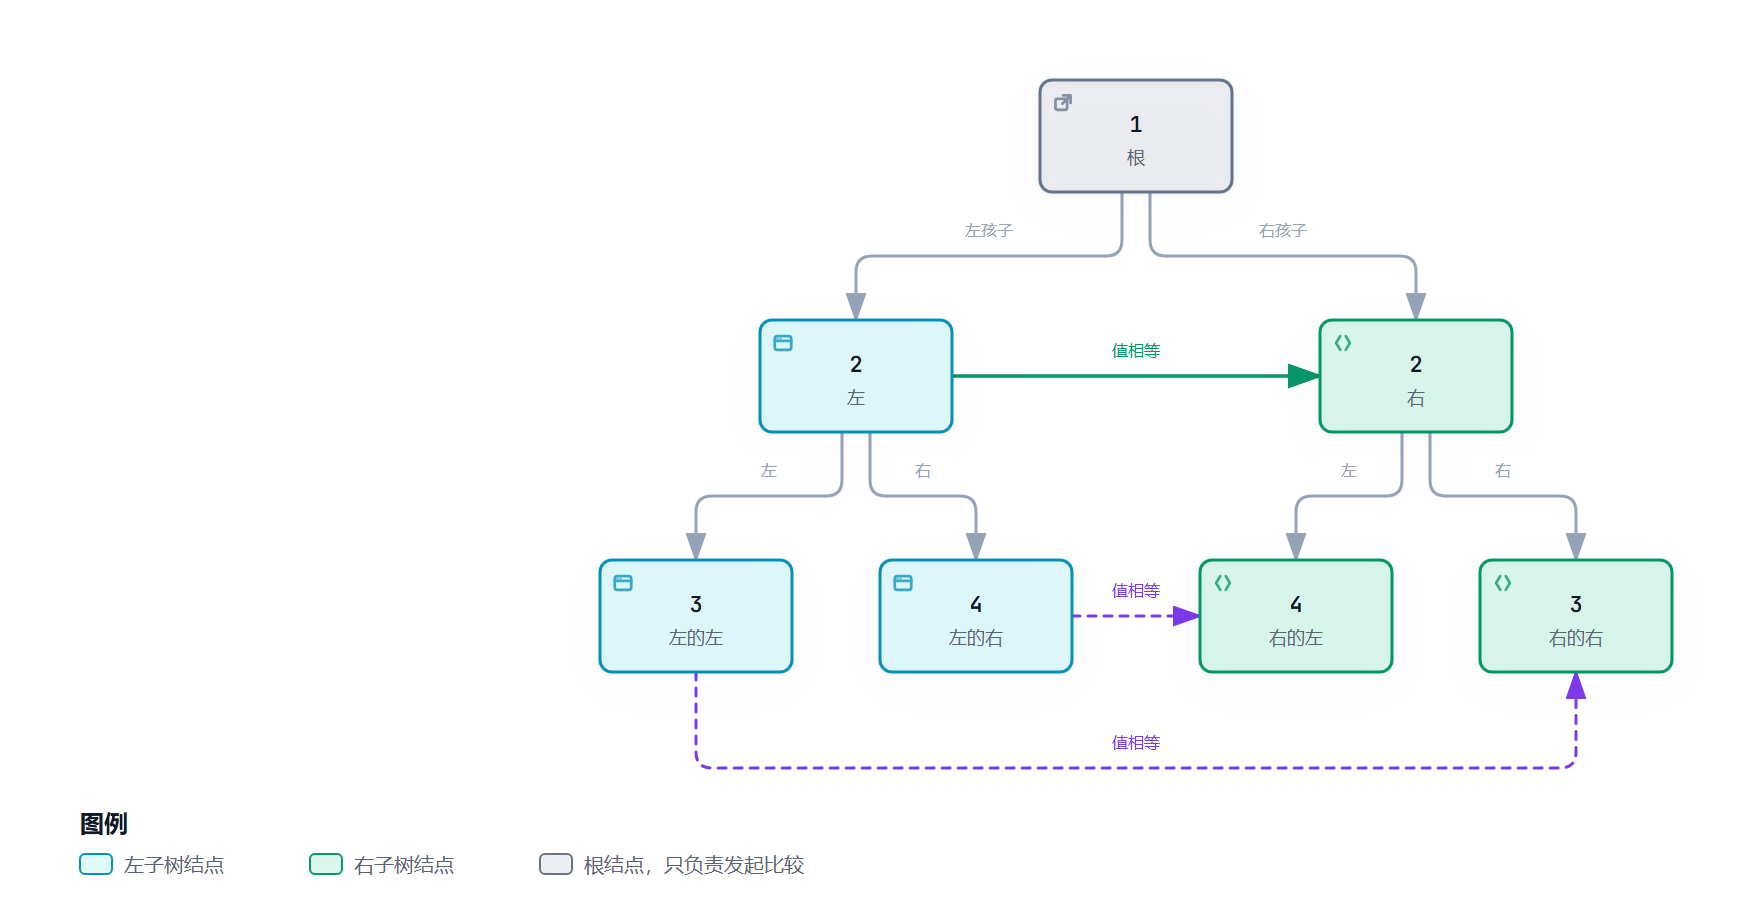
图 3 对称二叉树:左右两棵子树互为镜像
代码。
c
# 文件:/home/cocatrice/ds13/p03_101.c
static bool Mirror(struct TreeNode* p, struct TreeNode* q)
{
	if (p == NULL && q == NULL)
	{
		return true;
	}
	if (p == NULL || q == NULL)
	{
		return false;
	}
	if (p->val != q->val)
	{
		return false;
	}
	return Mirror(p->left, q->right) && Mirror(p->right, q->left);
}

static bool IsSymmetric(struct TreeNode* root)
{
	if (root == NULL)
	{
		return true;
	}
	return Mirror(root->left, root->right);
}
实测回显。
text
题目给的例子:
1 2 2 3 4 4 3                      递归 true  迭代 true  翻右树 true  三种一致
1 2 2 null 3 null 3                递归 false 迭代 false 翻右树 false 三种一致

边界值:
只有根结点 1                  递归 true  迭代 true  翻右树 true  三种一致
空树                             递归 true  迭代 true  翻右树 true  三种一致
1 2 2                              递归 true  迭代 true  翻右树 true  三种一致
根换成 2 的同一棵树        递归 true  迭代 true  翻右树 true  三种一致
十一个结点的完全对称树  递归 true  迭代 true  翻右树 true  三种一致

随机数据核对:
  500 组随机数据,三种做法不一致 0 组

一棵十四层的满二叉树:
  结点数 16383
  递归   false   用时 0.000 毫秒
  迭代   false   用时 0.000 毫秒
  翻右树 false   用时 0.000 毫秒

同一棵满二叉树,只把最右下角那个结点的值加一:
最右下角改成 99              递归 false 迭代 false 翻右树 false 三种一致

一条十万个结点的右链(根的值是 1):
  递归   false
  迭代   false
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | true | 直接返回 |
| 只有根结点 1 | true | 左右都空,对称 |
| 1 2 2 | true | 只比一对孩子 |
| 2 3 3 4 5 5 4 | true | 根换成 2 不影响对称性 |
| 1 2 2 null 3 null 3 | false | 外侧一边空一边有值 |
| 五层的对称树 | true | 每层都成对比,一层比一层多 |
复杂度。 时间 O(N),成对比的写法里每个结点只进一次队列。队列里最多存 O(N) 个结点指针,翻转的做法不需要额外空间但要改动树。
第四题 二叉树的前序遍历(144)
题目:按前序(根、左、右)把结点值输出出来,递归和迭代都要会写。
原题链接: leetcode 144. 二叉树的前序遍历
思路。 递归三行:访问自己,走左,走右;栈版本的顺序是反的:想让左孩子先被弹出,就得让右孩子先入栈、左孩子后入栈,这样出栈顺序才是根、左、右。第三个写法是「一路向左」的栈:进循环先沿着左孩子一路往下压栈并记值,压不动了(走到空)就弹一个出来,转向它的右孩子继续。三种写法输出必须一模一样,这是遍历题最直接的自检方式,输出对上就说明三份代码都没写错。
用例走一遍。 例子是 1 2 4 3 null 5 6,层序读出来就是根 1、左 2、右 4,2 的孩子是 3 和空,4 的孩子是 5 和 6。
| 步 | 当前结点 | 动作 | 输出 |
|---|---|---|---|
| 1 | 1 | 记下根,转向左 | 1 |
| 2 | 2 | 记下,转向左 | 1 2 |
| 3 | 3 | 记下,左右都空,回头 | 1 2 3 |
| 4 | 4 | 记下,转向左 | 1 2 3 4 |
| 5 | 5 | 记下,左右都空,回头 | 1 2 3 4 5 |
| 6 | 6 | 记下,整棵树走完 | 1 2 3 4 5 6 |
第二个例子是 1 null 2 null 3,一条右链,前序就是从上往下读 1 2 3。
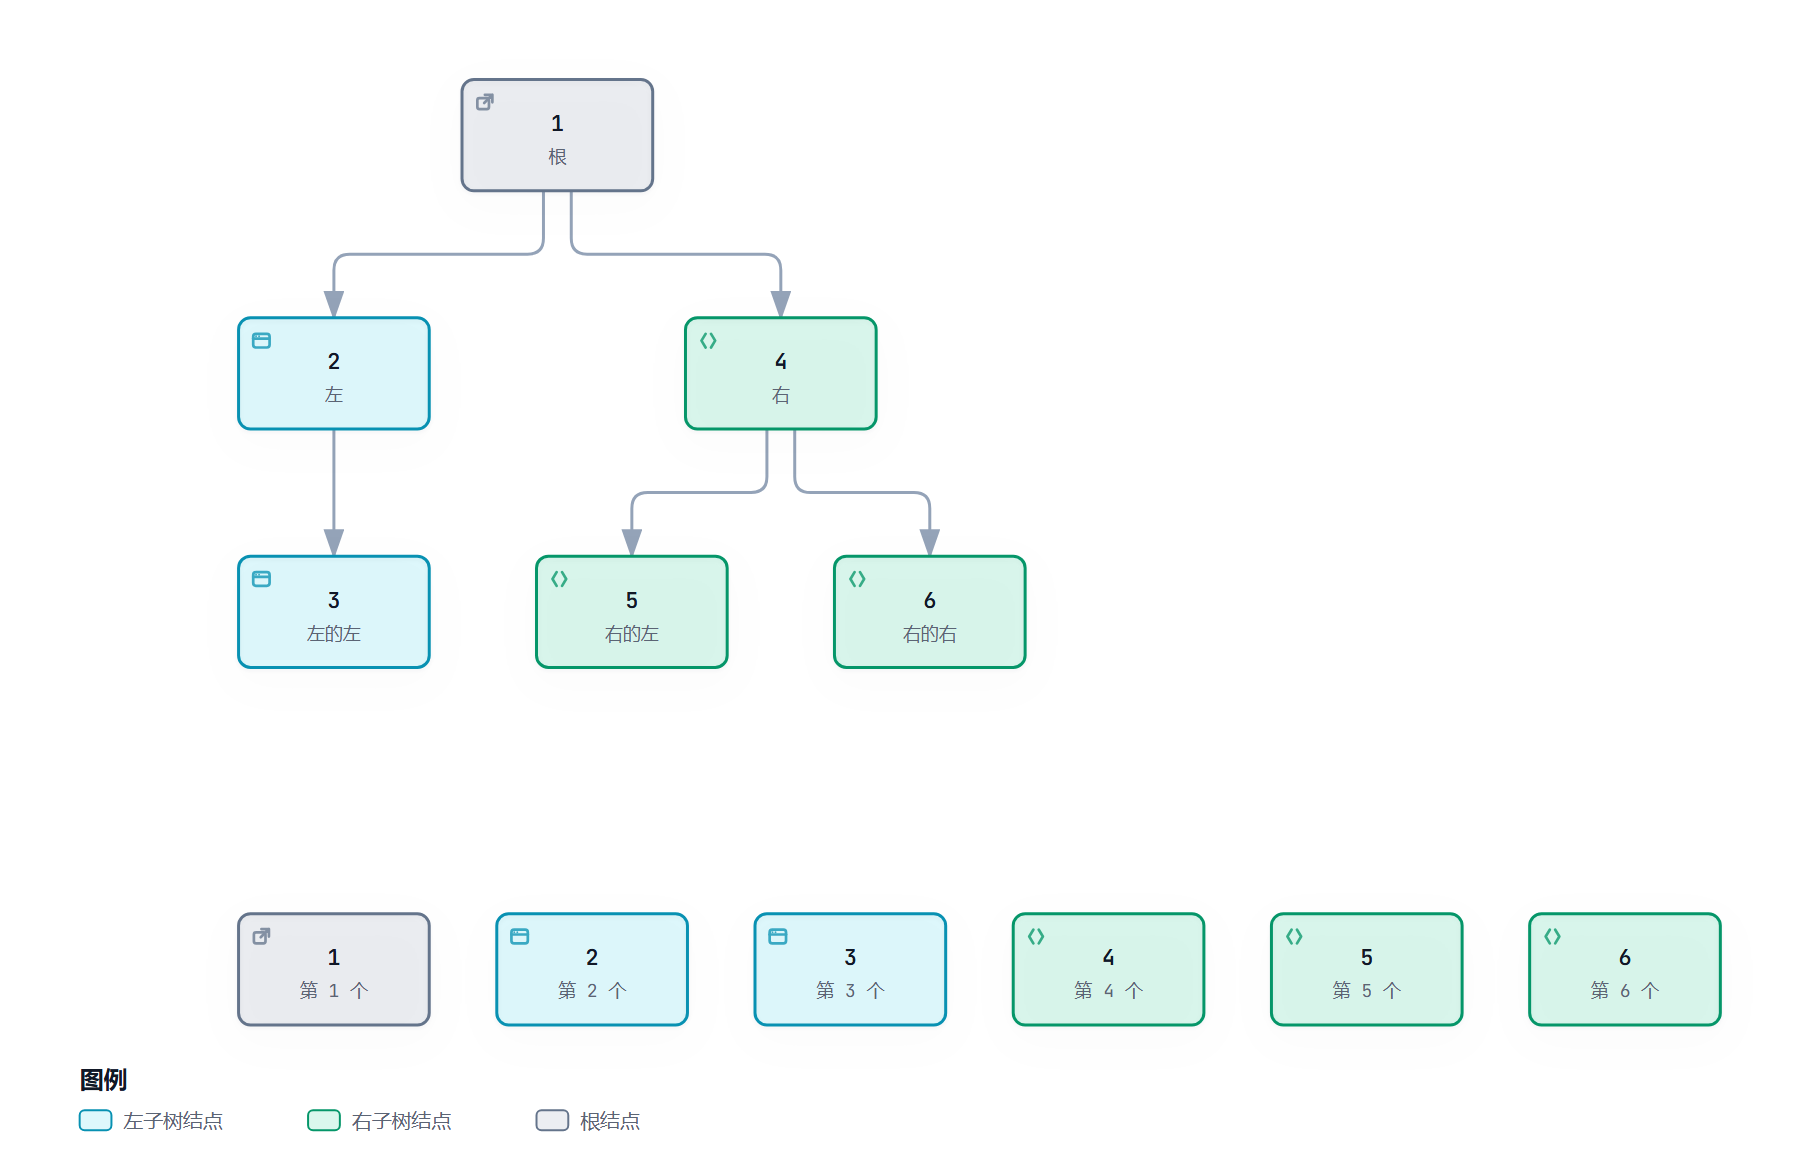
图 4 前序遍历:根先被访问,然后才是两棵子树
代码。
c
# 文件:/home/cocatrice/ds13/p04_144.c
static void ByRec(struct TreeNode* root, int* out, int* n)
{
	if (root == NULL)
	{
		return;
	}
	out[(*n)++] = root->val;
	ByRec(root->left, out, n);
	ByRec(root->right, out, n);
}

static void ByStackR(struct TreeNode* root, int* out, int* n)
{
	struct TreeNode** st;
	int top = 0;

	if (root == NULL)
	{
		return;
	}
	st = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	st[top++] = root;
	while (top > 0)
	{
		struct TreeNode* cur = st[--top];

		out[(*n)++] = cur->val;
		if (cur->right != NULL)
		{
			st[top++] = cur->right;
		}
		if (cur->left != NULL)
		{
			st[top++] = cur->left;
		}
	}
	free(st);
}
实测回显。
text
题目给的例子:
1 2 4 3 null 5 6              1 2 3 4 5 6
                               三种做法一致(长度 6)
1 null 2 null 3               1 2
                               三种做法一致(长度 2)

边界值:
空树                        (空)
                               三种做法一致(长度 0)
只有根结点 1             1
                               三种做法一致(长度 1)

随机数据核对:
  1000 组随机数据,三种做法不一致 0 组

一条一万个结点的左链:
  递归   长度 10000   用时 0.186 毫秒
  栈     长度 10000   用时 0.035 毫秒
  左走栈 长度 10000   用时 0.042 毫秒

一条一万个结点的右链:
右链的前十二个值      1 2 3 4 5 6 7 8 9 10 11 12 ...(共 10000 个)
                               三种做法一致(长度 10000)

一棵二十层的满二叉树:
  结点数 1048575
  递归   长度 1048575   用时 5.124 毫秒
  栈     长度 1048575   用时 2.980 毫秒
  左走栈 长度 1048575   用时 2.748 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | 输出为空,长度 0 | 三个函数都不进循环 |
| 只有根结点 1 | 输出 1 | 栈里只压了一个 |
| 一万个结点的右链 | 一万个值,顺序不变 | 递归写法在这条输入上最深,迭代写法不受影响 |
复杂度。 时间 O(N),每个结点进出栈一次,显式栈的大小是 O(树高),一层满树最坏到 O(N)。
第五题 二叉树的中序遍历(94)
题目:按中序(左、根、右)把结点值输出出来。这一道先写递归版本,再用「前序加中序重新建一棵树」来核对结果。
原题链接: leetcode 94. 二叉树的中序遍历
思路。 递归三行,顺序是走左、访问自己、走右。中序在二叉树上的意义要记住:二叉搜索树的中序一定是从小到大,所以中序序列常常被当成「树的有序视图」。核对的做法是用两条遍历序列把树重建一遍:前序的第一个元素是根,在中序里找到它的位置,左边那一截是左子树,右边那一截是右子树,两边各自递归。重建出来的树和原树比一次「相同的树」,就能证明中序序列取对了。
用例走一遍。 例子是 1 2 4 3 null 5 6,也就是根 1、左 2、右 4,2 的孩子是 3 和空,4 的孩子是 5 和 6。
| 步 | 当前结点 | 动作 | 输出 |
|---|---|---|---|
| 1 | 1 | 有左孩子,先去 2 | |
| 2 | 2 | 有左孩子,先去 3 | |
| 3 | 3 | 左右都空,访问自己,退回 2 | 3 |
| 4 | 2 | 左子树走完,访问自己,转向右(空),退回 1 | 3 2 |
| 5 | 1 | 左子树走完,访问自己,转向右 4 | 3 2 1 |
| 6 | 4 | 有左孩子 5,先去 5 | 3 2 1 |
| 7 | 5 | 左右都空,访问自己,退回 4 | 3 2 1 5 |
| 8 | 4 | 访问自己,转向右 6 | 3 2 1 5 4 |
| 9 | 6 | 访问自己,整棵树走完 | 3 2 1 5 4 6 |
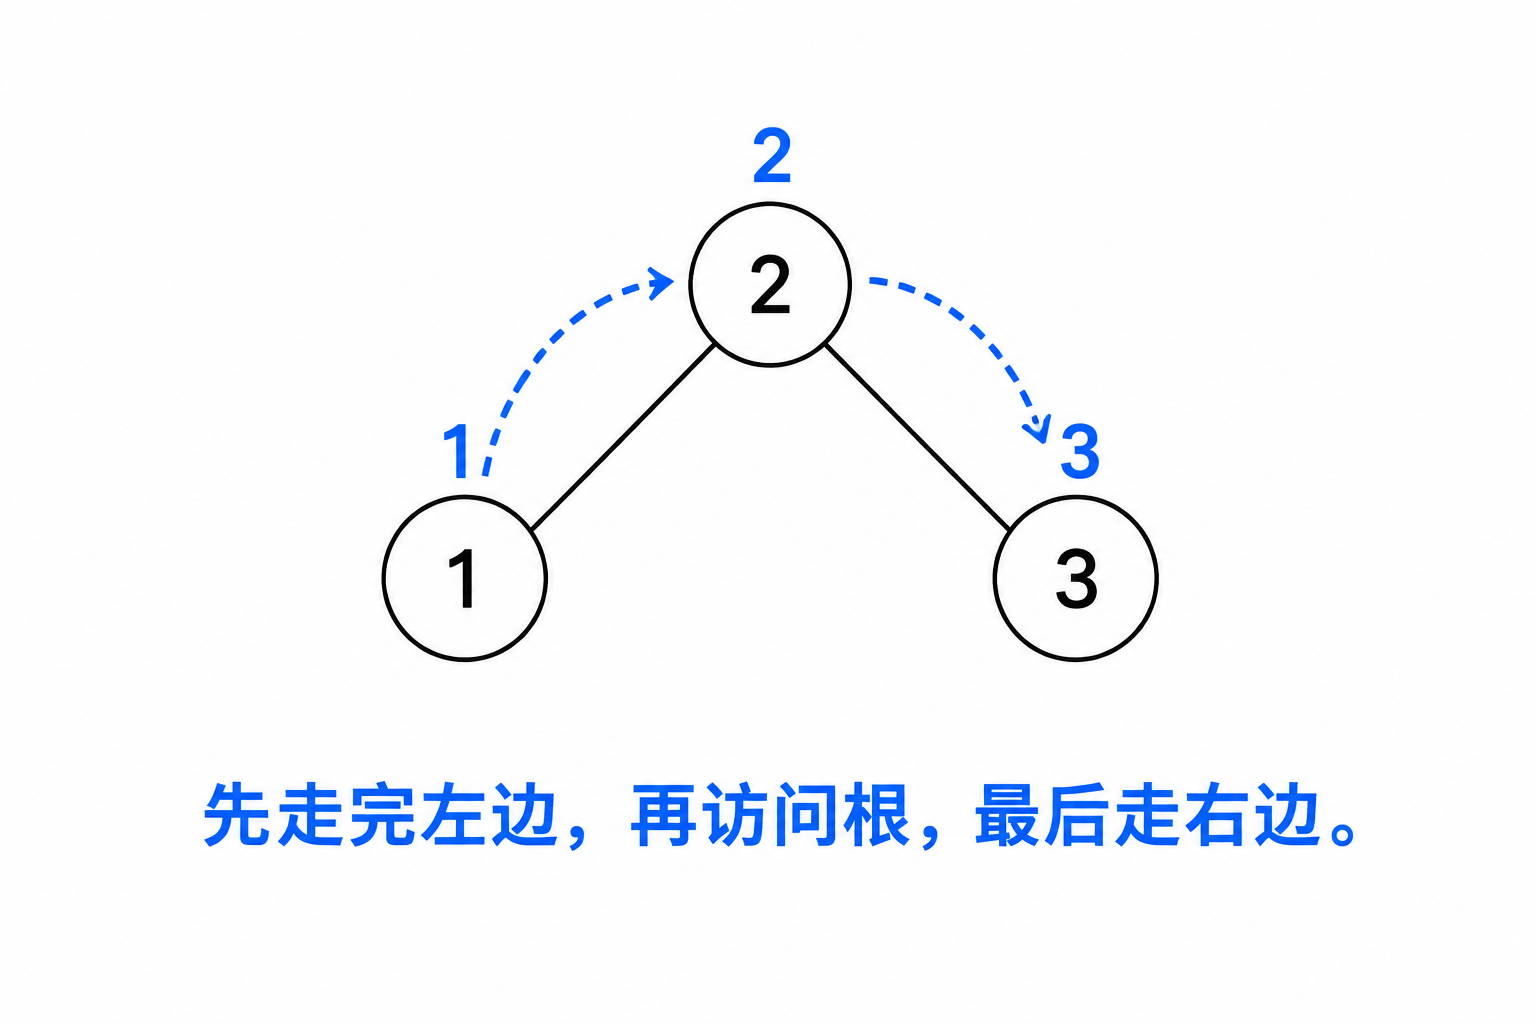
图 5 中序遍历:先走完左边,再访问根,最后走右边
代码。
c
# 文件:/home/cocatrice/ds13/p05_094.c
static void ByRec(struct TreeNode* root, int* out, int* n)
{
	if (root == NULL)
	{
		return;
	}
	ByRec(root->left, out, n);
	out[(*n)++] = root->val;
	ByRec(root->right, out, n);
}

// 由前序和中序还原一棵树
static struct TreeNode* Rebuild(const int* pre, const int* in, int n)
{
	struct TreeNode* root;
	int i;

	if (n <= 0)
	{
		return NULL;
	}
	root = NewNode(pre[0]);
	for (i = 0; i < n; i++)
	{
		if (in[i] == pre[0])
		{
			break;
		}
	}
	root->left = Rebuild(pre + 1, in, i);
	root->right = Rebuild(pre + 1 + i, in + i + 1, n - i - 1);
	return root;
}
实测回显。
text
题目给的例子:
1 2 4 3 null 5 6              3 2 1 5 4 6
                               前序中序还原后与原树一致

边界值:
空树                        (空)
                               前序中序还原后与原树一致
只有根结点 1             1
                               前序中序还原后与原树一致
1 null 2                      1 2
                               前序中序还原后与原树一致
左链 5 4 3 2                2 3 4 5
                               前序中序还原后与原树一致

随机数据核对:
  1000 组随机数据,还原后与原树不一致 0 组

一条一万个结点的左链:
  递归   长度 10000   用时 0.212 毫秒   最后一个数 1

一棵二十层的满二叉树:
  结点数 1048575
  递归   长度 1048575   用时 4.865 毫秒   前六个数 88 44 89 72 90 45
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | 输出为空 | 递归出口 |
| 只有根结点 1 | 输出 1 | 左右都不进 |
| 1 null 2 | 输出 1 2 | 右链,中序就是顺着读 |
| 左链 5 4 3 2 | 输出 2 3 4 5 | 左链上中序是倒着读 |
复杂度。 遍历 O(N),重建那一步每层都要在中序里线性找根,最坏 O(N²),测随机数据时数据量只有四十个结点,这点代价看不出来,但值必须互不相同,否则前序加中序还原出来的树不唯一。
第六题 二叉树的中序遍历(迭代写法,94)
题目:中序的递归写法用的是系统栈,这一道换成自己开的栈,再写一个把额外空间压到常数的版本。
原题链接: leetcode 94. 二叉树的中序遍历
思路。 栈写法的循环条件有两个:当前结点不空,或者栈不空。进循环先沿着左孩子一路压栈,直到当前结点为空;这时弹一个出来访问,再转向它的右孩子,重复。Morris 连栈都不要,它借用叶子上空着的右指针当临时梯子:走到一个结点,先找它左子树里最右边的那个结点(中序里的直接前驱),前驱的右指针如果是空的,就把它指向当前结点,然后往左走;如果前驱的右指针已经指着自己,说明左子树整走完了,把它改回空、访问当前结点、再往右走。树的结构中途会被改动,走完必须恢复原样。
用例走一遍。 还是 1 2 4 3 null 5 6,看栈那一版每一步栈里剩什么。
| 轮次 | 这一轮压进去的 | 栈里(底到顶) | 弹出访问 | 输出 |
|---|---|---|---|---|
| 1 | 1、2、3 | 1 2 3 | 无 | |
| 2 | 无 | 1 2 | 3 | 3 |
| 3 | 无 | 1 | 2 | 3 2 |
| 4 | 无 | 空 | 1 | 3 2 1 |
| 5 | 4、5 | 4 5 | 无 | 3 2 1 |
| 6 | 无 | 4 | 5 | 3 2 1 5 |
| 7 | 无 | 空 | 4 | 3 2 1 5 4 |
| 8 | 6 | 6 | 无 | 3 2 1 5 4 |
| 9 | 无 | 空 | 6 | 3 2 1 5 4 6 |
Morris 那一版看指针怎么接:走到 2 的时候找它左子树里最右边的结点,找出来是 3,3 的右指针空着,就让它指向 2,然后往左走到 3;3 没有左孩子,访问 3,顺着刚接上的右指针回到 2,发现左孩子 3 的右指针正指着自己,说明左边走完了,把指针拆掉(改回空),访问 2,再往右走;整棵树跑完,一根指针都不多。
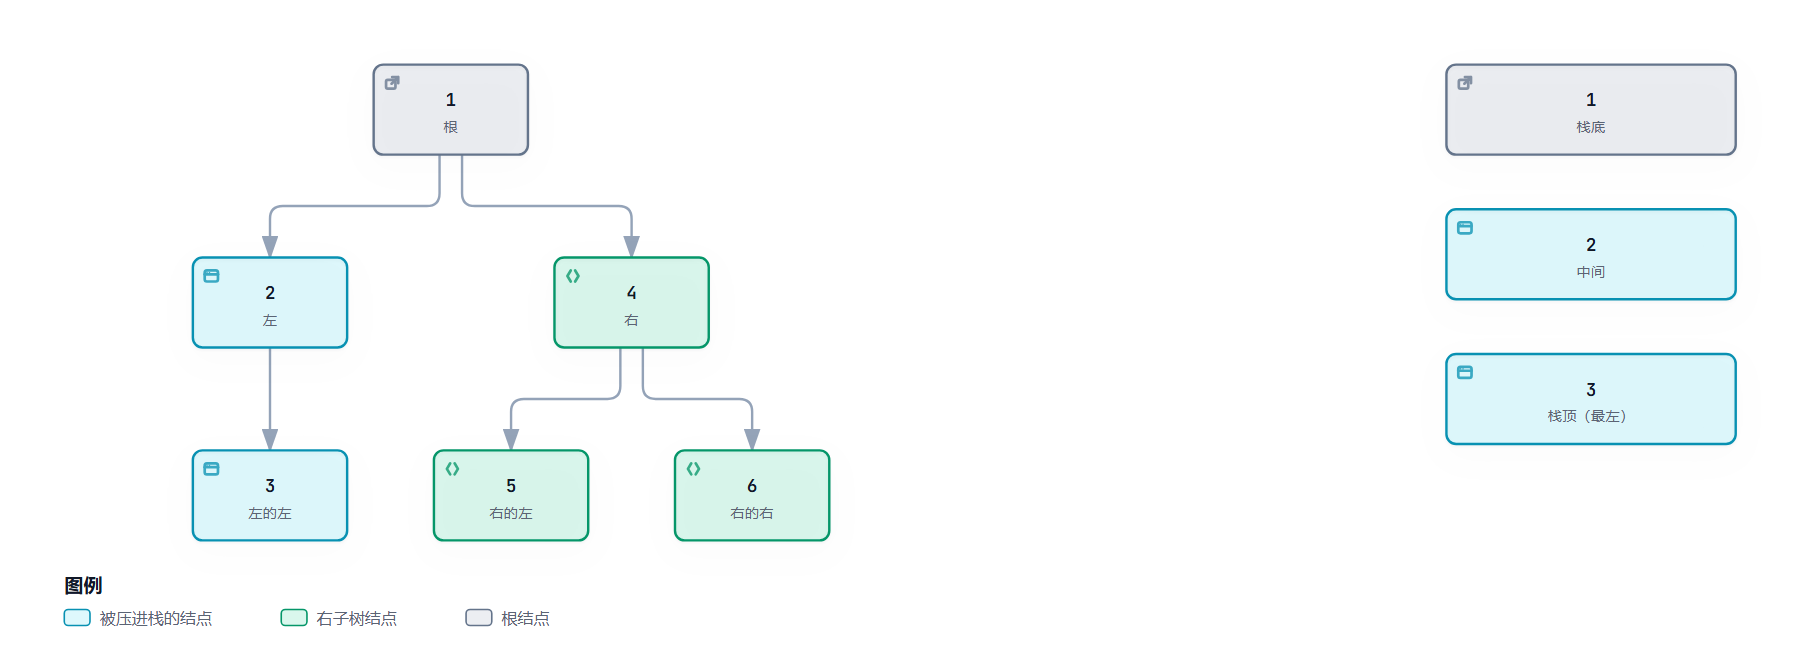
图 6 中序迭代:一路向左压栈,走到头再出栈
代码。
c
# 文件:/home/cocatrice/ds13/p06_094_iter.c
static void ByStack(struct TreeNode* root, int* out, int* n)
{
	struct TreeNode** st;
	int top = 0;
	struct TreeNode* cur = root;

	st = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	while (cur != NULL || top > 0)
	{
		while (cur != NULL)
		{
			st[top++] = cur;
			cur = cur->left;
		}
		cur = st[--top];
		out[(*n)++] = cur->val;
		cur = cur->right;
	}
	free(st);
}

static void ByMorris(struct TreeNode* root, int* out, int* n)
{
	struct TreeNode* cur = root;

	while (cur != NULL)
	{
		if (cur->left == NULL)
		{
			out[(*n)++] = cur->val;
			cur = cur->right;
		}
		else
		{
			struct TreeNode* pre = cur->left;

			while (pre->right != NULL && pre->right != cur)
			{
				pre = pre->right;
			}
			if (pre->right == NULL)
			{
				pre->right = cur;
				cur = cur->left;
			}
			else
			{
				pre->right = NULL;
				out[(*n)++] = cur->val;
				cur = cur->right;
			}
		}
	}
}
实测回显。
text
题目给的例子:
1 2 4 3 null 5 6              3 2 1 5 4 6
                               三种做法一致,Morris 跑完树复原如初

边界值:
空树                        (空)
                               三种做法一致,Morris 跑完树复原如初
只有根结点 1             1
                               三种做法一致,Morris 跑完树复原如初
1 null 2                      1 2
                               三种做法一致,Morris 跑完树复原如初

随机数据核对:
  1000 组随机数据,三种做法不一致 0 组,Morris 把树改坏 0 组

一条十万个结点的左链:
  栈     长度 100000   用时 0.918 毫秒   最后一个数 1
  Morris 长度 100000   用时 0.429 毫秒   最后一个数 1

一棵二十层的满二叉树:
  结点数 1048575
  递归   长度 1048575   用时 5.817 毫秒   前六个数 88 44 89 72 90 45
  栈     长度 1048575   用时 2.899 毫秒
  Morris 长度 1048575   用时 4.972 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | 输出为空 | 循环一次都不进 |
| 只有根结点 1 | 输出 1 | 压一次、弹一次 |
| 1 null 2 | 输出 1 2 | 没有左孩子,压栈那一步直接跳过 |
| 一千组随机数据 | 三种做法 0 组不一致 | Morris 走完树恢复原样,0 组被改坏 |
复杂度。 两种写法时间都是 O(N),栈写法额外空间 O(树高),Morris 是 O(1),代价是遍历途中要改两次右指针。
第七题 二叉树的后序遍历(145)
题目:按后序(左、右、根)把结点值输出出来,三种写法互相核对。
原题链接: leetcode 145. 二叉树的后序遍历
思路。 递归把访问放到最后一行,第二个写法绕了个弯:按「根、右、左」的顺序压栈(左孩子先压、右孩子后压),弹出顺序就是根右左,把这个序列整体反转就是后序。第三个写法用单栈加一个 last 指针:先看栈顶的结点,如果它有右孩子、而且右孩子不是上一个访问过的结点,就先把右孩子压进去;否则弹出并访问它,把它记成 last。能不能访问栈顶,就看 last 是不是它的右孩子。
用例走一遍。 例子还是 1 2 4 3 null 5 6,后序应该是 3 2 5 6 4 1,下面这张表看的是「根右左再反转」这一版。
| 步 | 出栈的结点 | 收进数组 | 说明 |
|---|---|---|---|
| 1 | 1 | 1 | 根先出 |
| 2 | 4 | 1 4 | 右孩子先压,所以先出 |
| 3 | 6 | 1 4 6 | 4 的右孩子 |
| 4 | 5 | 1 4 6 5 | 4 的左孩子 |
| 5 | 2 | 1 4 6 5 2 | 回到根的左边 |
| 6 | 3 | 1 4 6 5 2 3 | 整棵树走完 |
把这个数组整体反转,得到 3 2 5 6 4 1,正好是后序。
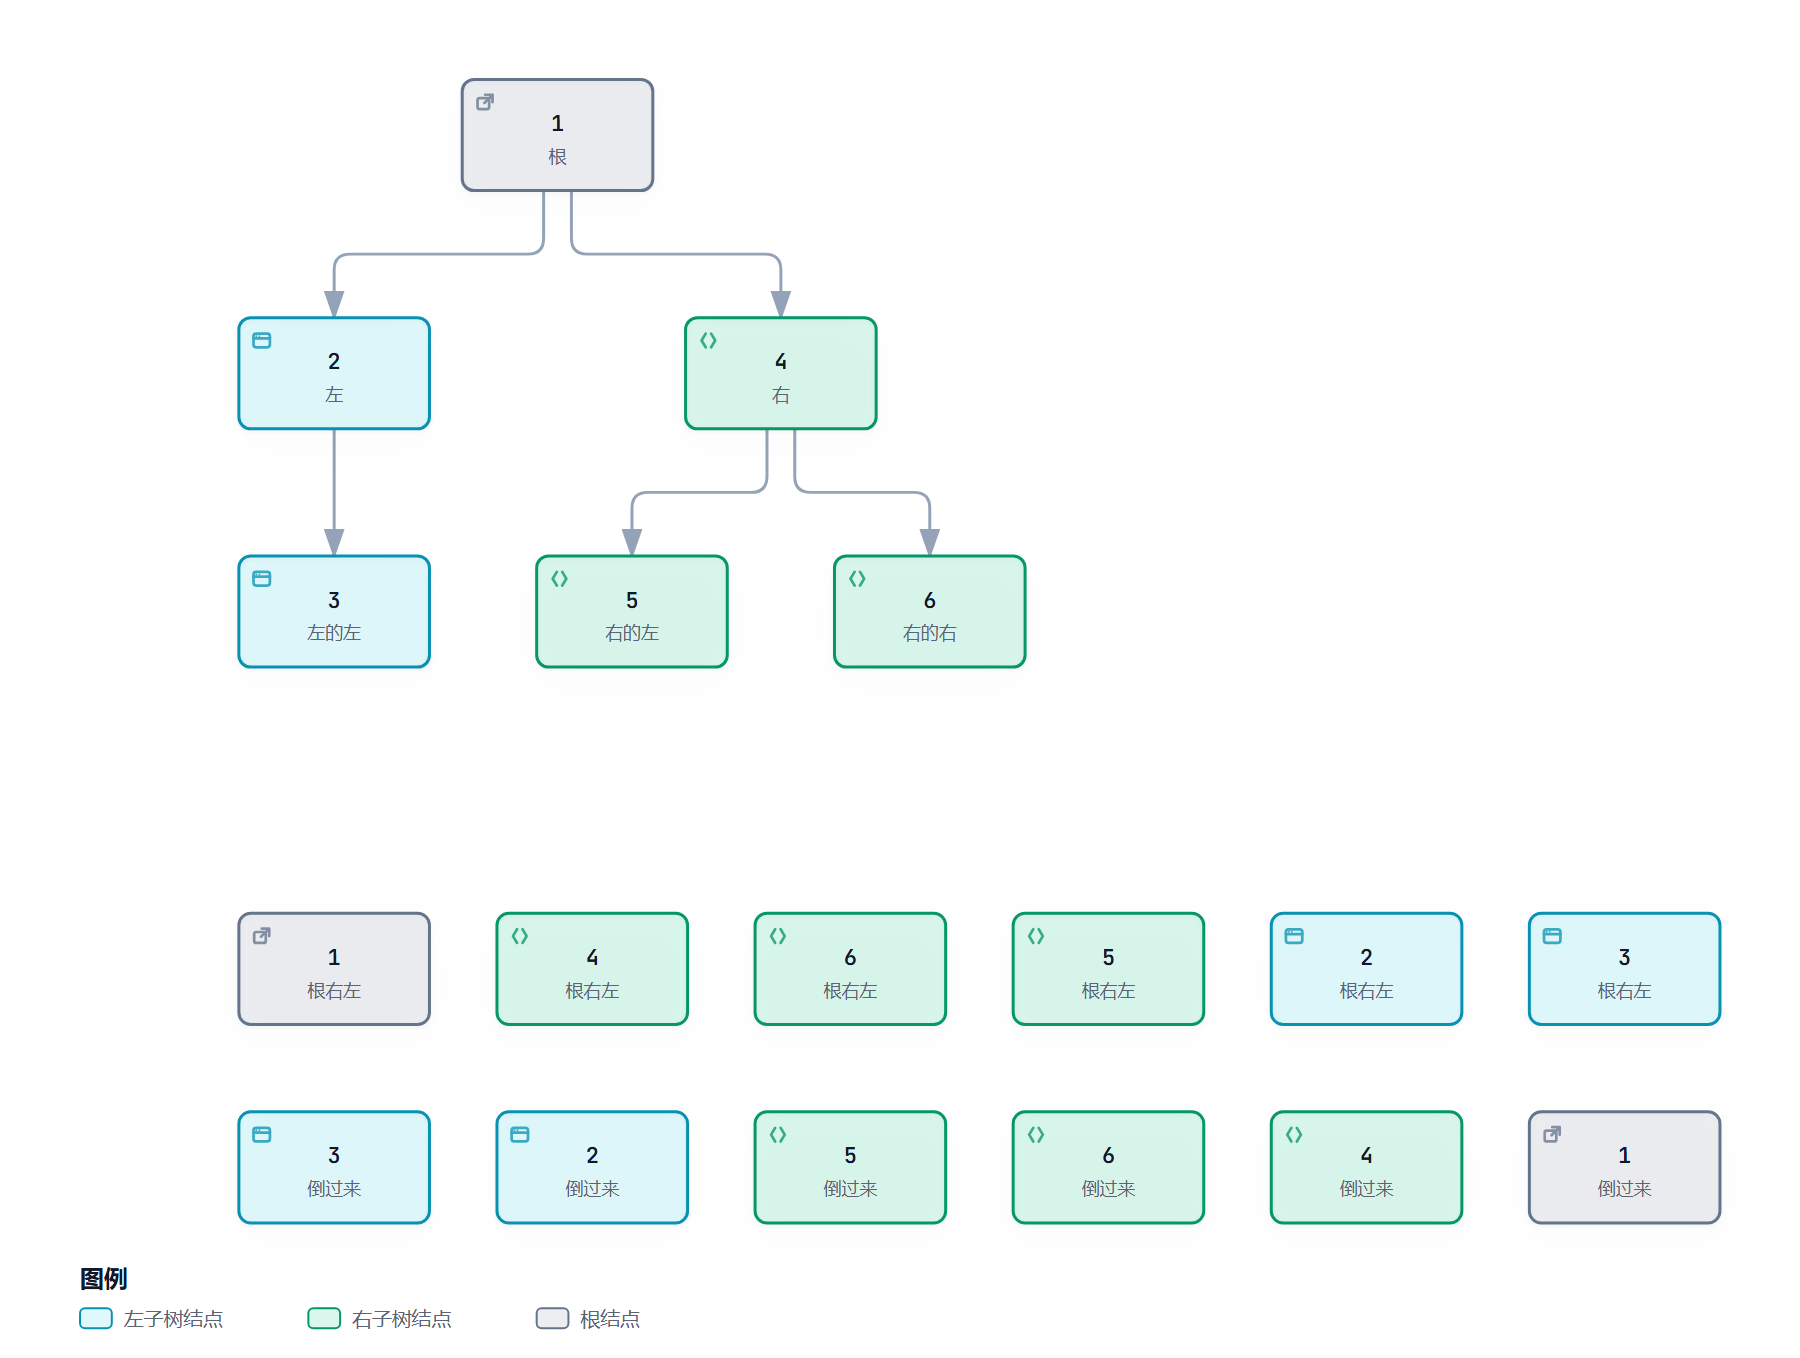
图 7 后序遍历:左、右、根,反过来就是根、右、左
代码。
c
# 文件:/home/cocatrice/ds13/p07_145.c
static void ByRec(struct TreeNode* root, int* out, int* n)
{
	if (root == NULL)
	{
		return;
	}
	ByRec(root->left, out, n);
	ByRec(root->right, out, n);
	out[(*n)++] = root->val;
}

static void ByLast(struct TreeNode* root, int* out, int* n)
{
	struct TreeNode** st;
	int top = 0;
	struct TreeNode* cur = root;
	struct TreeNode* last = NULL;

	st = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	while (cur != NULL || top > 0)
	{
		while (cur != NULL)
		{
			st[top++] = cur;
			cur = cur->left;
		}
		cur = st[top - 1];
		if (cur->right == NULL || cur->right == last)
		{
			out[(*n)++] = cur->val;
			top--;
			last = cur;
			cur = NULL;
		}
		else
		{
			cur = cur->right;
		}
	}
	free(st);
}
实测回显。
text
题目给的例子:
1 2 4 3 null 5 6              3 2 5 6 4 1
                               三种做法一致(长度 6)

边界值:
空树                        (空)
                               三种做法一致(长度 0)
只有根结点 1             1
                               三种做法一致(长度 1)
1 null 2                      2 1
                               三种做法一致(长度 2)

随机数据核对:
  1000 组随机数据,三种做法不一致 0 组

一条一万个结点的左链:
左链的后序前十二个值10000 9999 9998 9997 9996 9995 9994 9993 9992 9991 9990 9989 ...(共 10000 个)
                               三种做法一致(长度 10000)

一棵二十层的满二叉树:
  结点数 1048575
  递归     长度 1048575   用时 6.329 毫秒   后三个数 7 3 1
  反转前序 长度 1048575   用时 3.392 毫秒
  单栈 last 长度 1048575   用时 3.191 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | 输出为空 | 递归出口 |
| 只有根结点 1 | 输出 1 | 访问放最后一行,也轮得到 |
| 1 null 2 | 输出 2 1 | 右链,根最后出 |
| 一万个结点的右链 | 一万个值 | last 指针那条路不加深系统栈 |
复杂度。 时间 O(N),递归用系统栈,最深是树高;根右左那一版显式栈是 O(树高),最后还要一次 O(N) 的反转。
第八题 另一棵树的子树(572)
题目:给两棵二叉树 root 和 sub,判断 sub 是不是 root 里某个结点为根的子树,结构和每个位置的值都要一样。
原题链接: leetcode 572. 另一棵树的子树
思路。 嵌套写法最直接:外层走遍 root 的每个结点,每到一个结点就做一次「相同的树」,命中就返回 true,外层可以递归也可以换成队列迭代。第三种把两棵树都按前序序列化成字符串,空结点写成一个特殊字符,然后在大串里找小串。写法要注意一点:空标记必须写成不会和值混淆的字符,不然 1 和 1 后面跟一个空孩子的两种情况会撞在一起。
用例走一遍。 root 是 3 4 5 1 2(根 3,左 4 右 5,4 的孩子是 1 和 2),sub 是 4 1 2。
| 外层走到哪个结点 | 拿它和 sub 的根 4 比 | 结果 |
|---|---|---|
| 3 | 不相等 | 剪掉这一支的匹配,继续走孩子 |
| 4 | 相等 | 逐结点往下对:左 1 对 1、右 2 对 2,都相等 |
| 结论 | sub 是 root 的子树,命中 |
第二个例子把 root 换成 3 4 5 1 2 null null null null 0,多出来的 0 挂在 1 的下面。走到 4 的时候值都对得上,但结构多了一层,「相同的树」那一步判 false,最后答案是假。
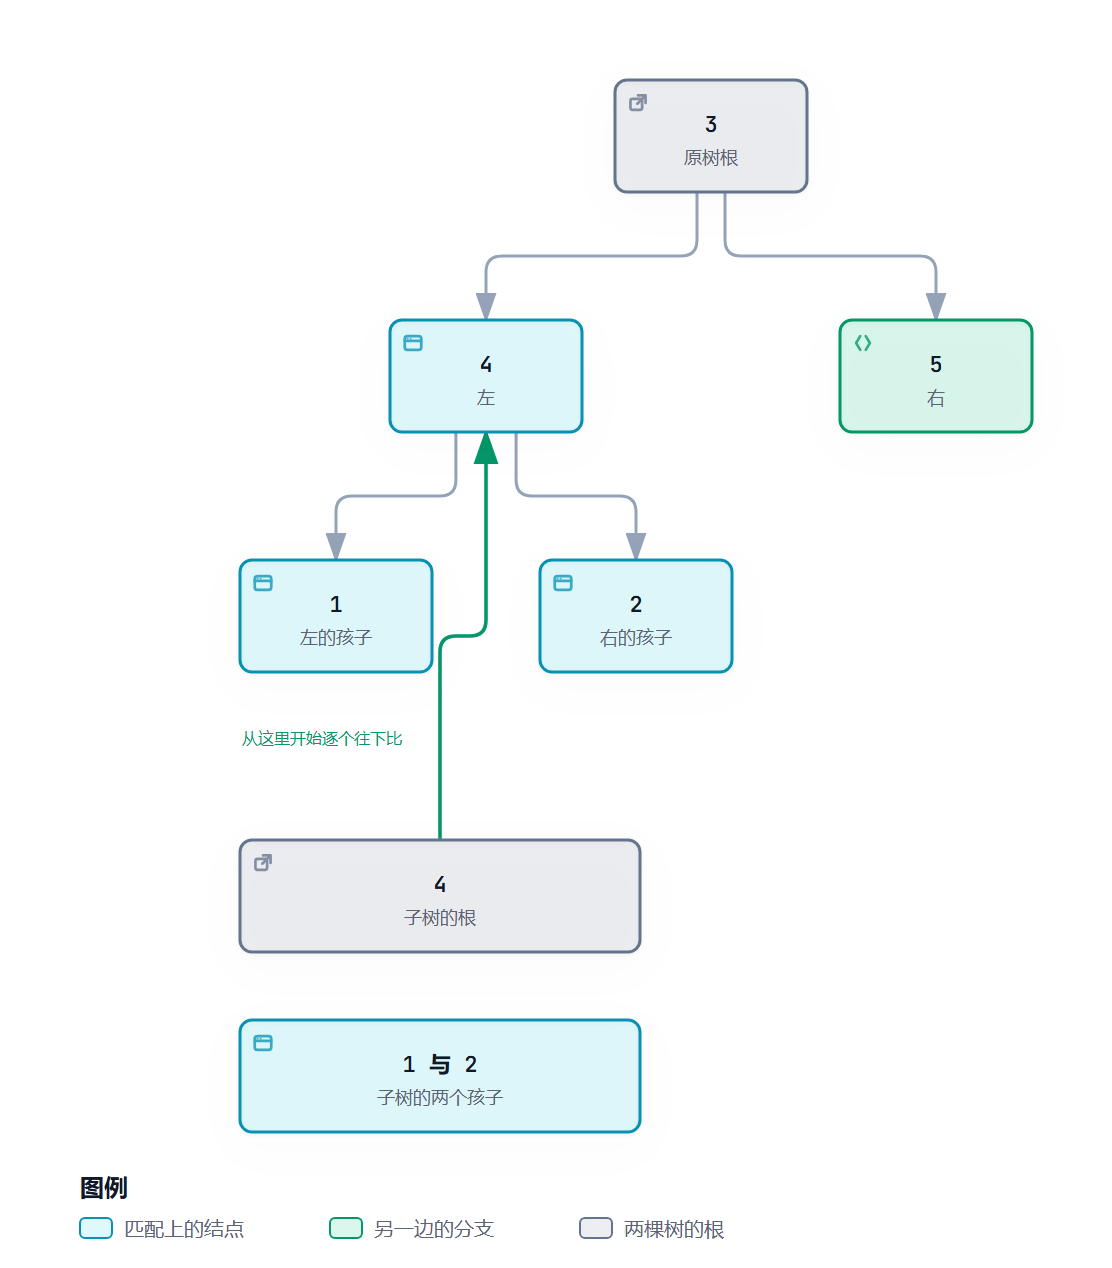
图 8 另一棵树的子树:在原树里找一个位置整体对下去
代码。
c
# 文件:/home/cocatrice/ds13/p08_572.c
static bool ByNested(struct TreeNode* root, struct TreeNode* sub)
{
	if (sub == NULL)
	{
		return true;
	}
	if (root == NULL)
	{
		return false;
	}
	if (SameTree(root, sub))
	{
		return true;
	}
	return ByNested(root->left, sub) || ByNested(root->right, sub);
}

static bool BySerialize(struct TreeNode* root, struct TreeNode* sub)
{
	char* a = (char*)malloc(1u << 24);
	char* b = (char*)malloc(1u << 20);
	int la = 0;
	int lb = 0;
	bool ans;

	Serialize(root, a, &la);
	Serialize(sub, b, &lb);
	a[la] = 0;
	b[lb] = 0;
	ans = (strstr(a, b) != NULL);
	free(a);
	free(b);
	return ans;
}
实测回显。
text
题目给的例子:
root 3 4 5 1 2 / sub 4 1 2     嵌套 true  队列 true  序列化 true  三种一致
root 3 4 5 1 2 null null null null 0 / sub 4 1 2 嵌套 false 队列 false 序列化 false 三种一致

边界值:
root 与 sub 完全相同      嵌套 true  队列 true  序列化 true  三种一致
root 1 1 / sub 1               嵌套 true  队列 true  序列化 true  三种一致
root 1 null 2 null 3 / sub 2   嵌套 false 队列 false 序列化 false 三种一致
root 空 / sub 1               嵌套 false 队列 false 序列化 false 三种一致

随机数据核对:
  600 组随机数据,三种做法不一致 0 组

随机数据里再挑二十组,让 sub 就是 root 的某个子树:
  二十组都应当命中,三种做法同时判对 20 组

一条两万个结点的右链上找一条两百个结点的右链:
  嵌套   false   用时 0.000 毫秒
  队列   false   用时 0.000 毫秒
  序列化 false   用时 0.000 毫秒

同一条链,sub 换成第一个值是 2 的两百个结点的链:
  嵌套   false   用时 0.000 毫秒
  队列   false   用时 0.000 毫秒
  序列化 false   用时 0.000 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| root 与 sub 完全相同 | true | 外层第一次比就命中 |
| root 1 1 / sub 1 | true | 两个 1 都能命中,答案是其中一个 |
| root 1 null 2 null 3 / sub 2 | true | 命中的是右链中间的结点 |
| root 空 / sub 1 | false | 外层一次都不进 |
| root 有 0 而 sub 没有 | false | 值对得上,结构对不上 |
复杂度。 嵌套写法 O(N×M),N 是 root 的结点数,M 是 sub 的结点数;序列化那版两层扫描接近 O(N+M),代价是多一个 O(N) 的字符串。
第九题 二叉树的构建及遍历(建树题)
题目:给一串先序字符,# 表示这个位置是空结点,先把二叉树建出来,再输出它的中序。
原题链接: nowcoder 二叉树遍历
思路。 建树的函数每一步只看一个字符,读到 #,返回空指针,指针往前挪一格;读到别的字符,建一个结点,然后递归去建它的左子树,再递归建右子树,两边都建完才把结点交出去。整串吃完,树就成型了,核对的办法是反过来做一遍:把建好的树按先序输出一遍,去掉 #,和原串比,两边一样就说明建对了。
用例走一遍。 原串是 abc##de#g##f###,从左往右吃。
| 读到的字符 | 动作 | 建出来的部分 |
|---|---|---|
| a | 建结点,转去建左子树 | 根 a |
| b | 建结点,转去建左子树 | a 的左孩子是 b |
| c | 建结点,转去建左子树 | b 的左孩子是 c |
| # | 返回空 | c 没有左孩子 |
| # | 返回空 | c 没有右孩子,c 是叶子 |
| d | 建结点(这时回到 b 的右边) | b 的右孩子是 d |
| e | 建结点 | d 的左孩子是 e |
| # | 返回空 | e 没有左孩子 |
| g | 建结点 | e 的右孩子是 g |
| ## | 两个空 | g 是叶子,回到 d 的右边 |
| f | 建结点(回到 d 的右边) | d 的右孩子是 f |
| ## | 两个空 | f 是叶子,回到 a 的右边 |
| # | 返回空 | a 没有右孩子,整串读完 |
建出来的树中序是 cbegdfa,前序是 abcdegf,树高 5。
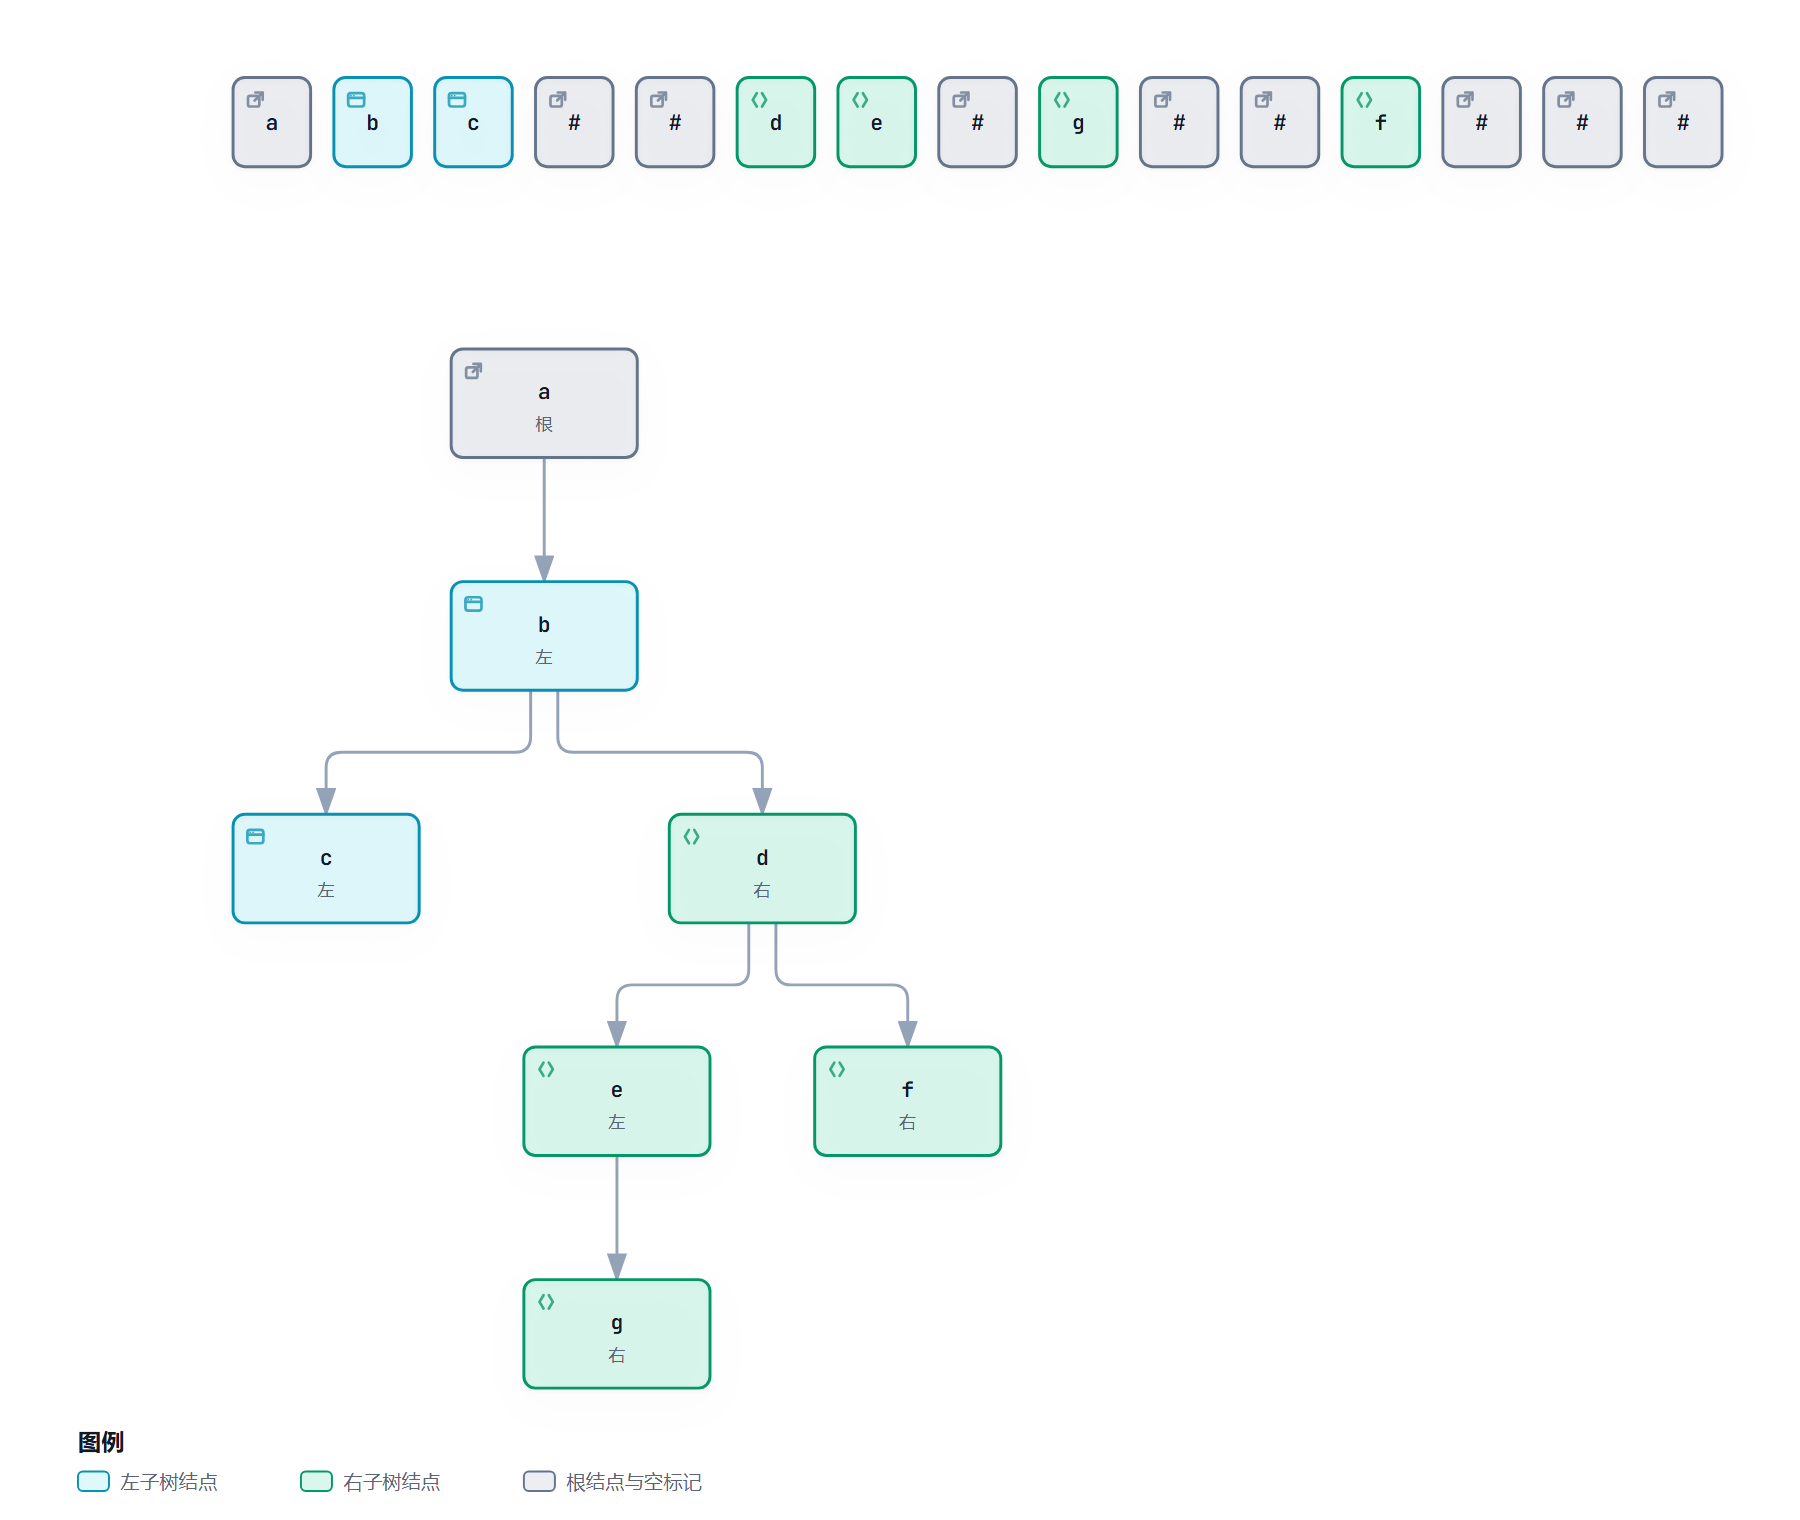
图 9 先序串建树:一个字符一种情况,递归往下读
代码。
c
# 文件:/home/cocatrice/ds13/p09_build.c
static struct TreeNode* BuildByStr(const char** p)
{
	char c = **p;

	(*p)++;
	if (c == '#' || c == 0)
	{
		return NULL;
	}
	{
		struct TreeNode* node = NewNode((int)c);
		node->left = BuildByStr(p);
		node->right = BuildByStr(p);
		return node;
	}
}
实测回显。
text
题目给的例子:
abc##de#g##f###        中序 cbegdfa    前序 abcdegf    结点数 7
                       前序去掉 # 与原串相同,建出的树高 5

边界值:
a##(只有一个结点) 中序 a          前序 a          结点数 1
                       前序去掉 # 与原串相同,建出的树高 1
abc####(一条左链) 中序 cba        前序 abc        结点数 3
                       前序去掉 # 与原串相同,建出的树高 3
#(空树)          中序            前序            结点数 0
                       前序去掉 # 与原串相同,建出的树高 0
空串                 中序            前序            结点数 0
                       前序去掉 # 与原串相同,建出的树高 0

逐层看一眼这棵树:
  层序 [97,98,null,99,100,null,null,101,102,null,103]
  结点数 7
  中序 cbegdfa

把二十组随机字符串各建一次树:
  a###c      结点数 1
  abba       结点数 11
  a##        结点数 1
  aa#        结点数 2
  a##        结点数 1
  aabbacbba  结点数 13
  a#bc       结点数 11
  acb        结点数 11
  ab##       结点数 2
  a#b#bcaac  结点数 11
  ac#ab      结点数 11
  aa#b       结点数 10
  aabb###    结点数 9
  a####b#    结点数 1
  aaacc#     结点数 10
  accc#c     结点数 10
  a#ca#c     结点数 9
  a##ca##b#  结点数 1
  a##        结点数 1
  aa##a#ba   结点数 9
  二十组里建出空树的有 0 组
边界值。
| 输入 | 中序 | 说明 |
|---|---|---|
| a## | a | 只有一个结点,两个孩子都是空 |
| abc#### | cba | 一条左链,中序是倒着的 |
| # | 空 | 空树,结点数 0 |
| 空串 | 空 | 和上面一样,吃不到字符 |
复杂度。 时间 O(N),每个字符只吃一次,递归深度是树高,一条左链的串会压到 N 层。
第十题 二叉树的最大深度(104)
题目:求二叉树的最大深度,从根到最远的那片叶子的结点数。
原题链接: leetcode 104. 二叉树的最大深度
思路。 递归版本:空树返回 0,否则左右两边各求一次深度,取大的那个加一。层序版本不用递归:把根压进队列,每处理完一层计数器加一,队列空的时候计数就是深度,这个写法顺便把「一层有几个结点」的问题也答了。第三种把每个结点的深度记在数组里最后取最大值,专门用来当对照。
用例走一遍。 例子是 3 9 20 null null 15 7,根 3,左 9,右 20,20 的孩子是 15 和 7。
| 层 | 这一层的结点 | 深度记到 |
|---|---|---|
| 1 | 3 | 1 |
| 2 | 9、20 | 2 |
| 3 | 15、7 | 3 |
三层都数完,队列空了,答案是 3,正好等于走过的层数。
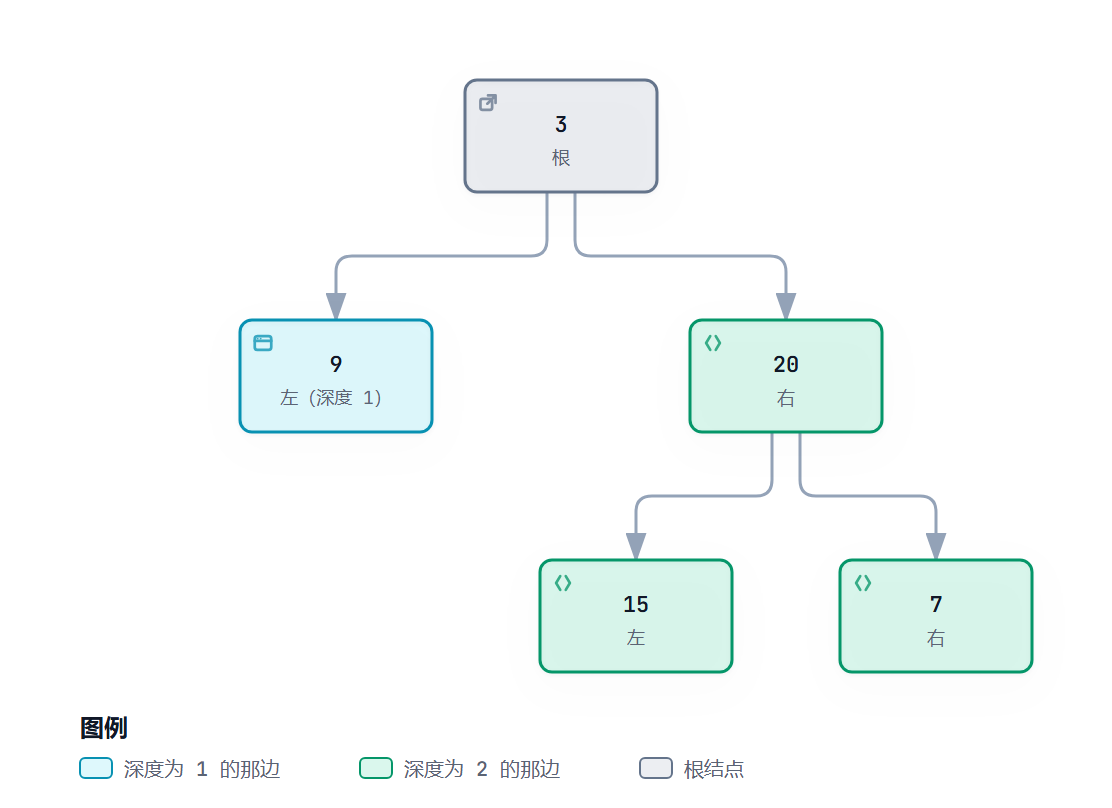
图 10 最大深度:左右两边谁深就用谁,再加一
代码。
c
# 文件:/home/cocatrice/ds13/p10_104.c
static int MaxDepth(struct TreeNode* root)
{
	int l;
	int r;

	if (root == NULL)
	{
		return 0;
	}
	l = MaxDepth(root->left);
	r = MaxDepth(root->right);
	return (l > r ? l : r) + 1;
}

static int MaxDepthBfs(struct TreeNode* root)
{
	struct TreeNode** q;
	int head = 0;
	int tail = 0;
	int depth = 0;

	if (root == NULL)
	{
		return 0;
	}
	q = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	q[tail++] = root;
	while (head < tail)
	{
		int levelEnd = tail;

		while (head < levelEnd)
		{
			struct TreeNode* cur = q[head++];

			if (cur->left != NULL)
			{
				q[tail++] = cur->left;
			}
			if (cur->right != NULL)
			{
				q[tail++] = cur->right;
			}
		}
		depth++;
	}
	free(q);
	return depth;
}
实测回显。
text
题目给的例子:
3 9 20 null null 15 7          递归 3    层序 3    记深度 3    三种一致
1 null 2                       递归 2    层序 2    记深度 2    三种一致

边界值:
空树                         递归 0    层序 0    记深度 0    三种一致
只有根结点 1              递归 1    层序 1    记深度 1    三种一致
一万个结点的左链       递归 10000 层序 10000 记深度 10000 三种一致

随机数据核对:
  1000 组随机数据,三种做法不一致 0 组

一万个结点的左链:
  递归 10000   用时 0.000 毫秒
  层序 10000   用时 0.000 毫秒

二十层的满二叉树:
  结点数 1048575
  递归 20   用时 0.000 毫秒
  层序 20   用时 0.000 毫秒
  记深度 20   用时 0.000 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | 0 | 递归出口 |
| 只有根结点 1 | 1 | 左右都是 0,加一 |
| 1 null 2 | 2 | 一条右链 |
| 一万个结点的左链 | 10000 | 递归写法在这条输入上最深 |
复杂度。 时间 O(N),递归用系统栈,深度等于树高;层序的队列最多同时装一层结点,最坏 O(N)。
第十一题 平衡二叉树(110)
题目:判断每个结点的左右两棵子树高度差是不是都不超过 1。
原题链接: leetcode 110. 平衡二叉树
思路。 自顶向下的写法最好想:对每个结点求一次左右子树的深度,差值超过 1 就返回 false,否则递归到左右孩子去。问题在同一棵子树的高度被反复求,链状树上退化成平方级。自底向上的写法把这件事压到一次遍历:后序走到哪就把高度往上传,发现某个结点的两边差超过 1 就返回 -1,上面看到 -1 直接往上传,不再往下算。这就是「用返回值同时表达结果和状态」的典型用法。
用例走一遍。 第一个例子 3 9 20 null null 15 7 是平衡的。第二个例子 1 2 2 3 3 null null 4 4 不平衡。
| 结点 | 左子树高 | 右子树高 | 差值 | 结论 |
|---|---|---|---|---|
| 4(左的左的孩子) | 0 | 0 | 0 | 平衡 |
| 3(左的左) | 1 | 1 | 0 | 平衡 |
| 2(左) | 2 | 0 | 2 | 超过 1,判为不平衡 |
| 根 1 | 左子树已经不平 | 直接给假,右边不用再看 |
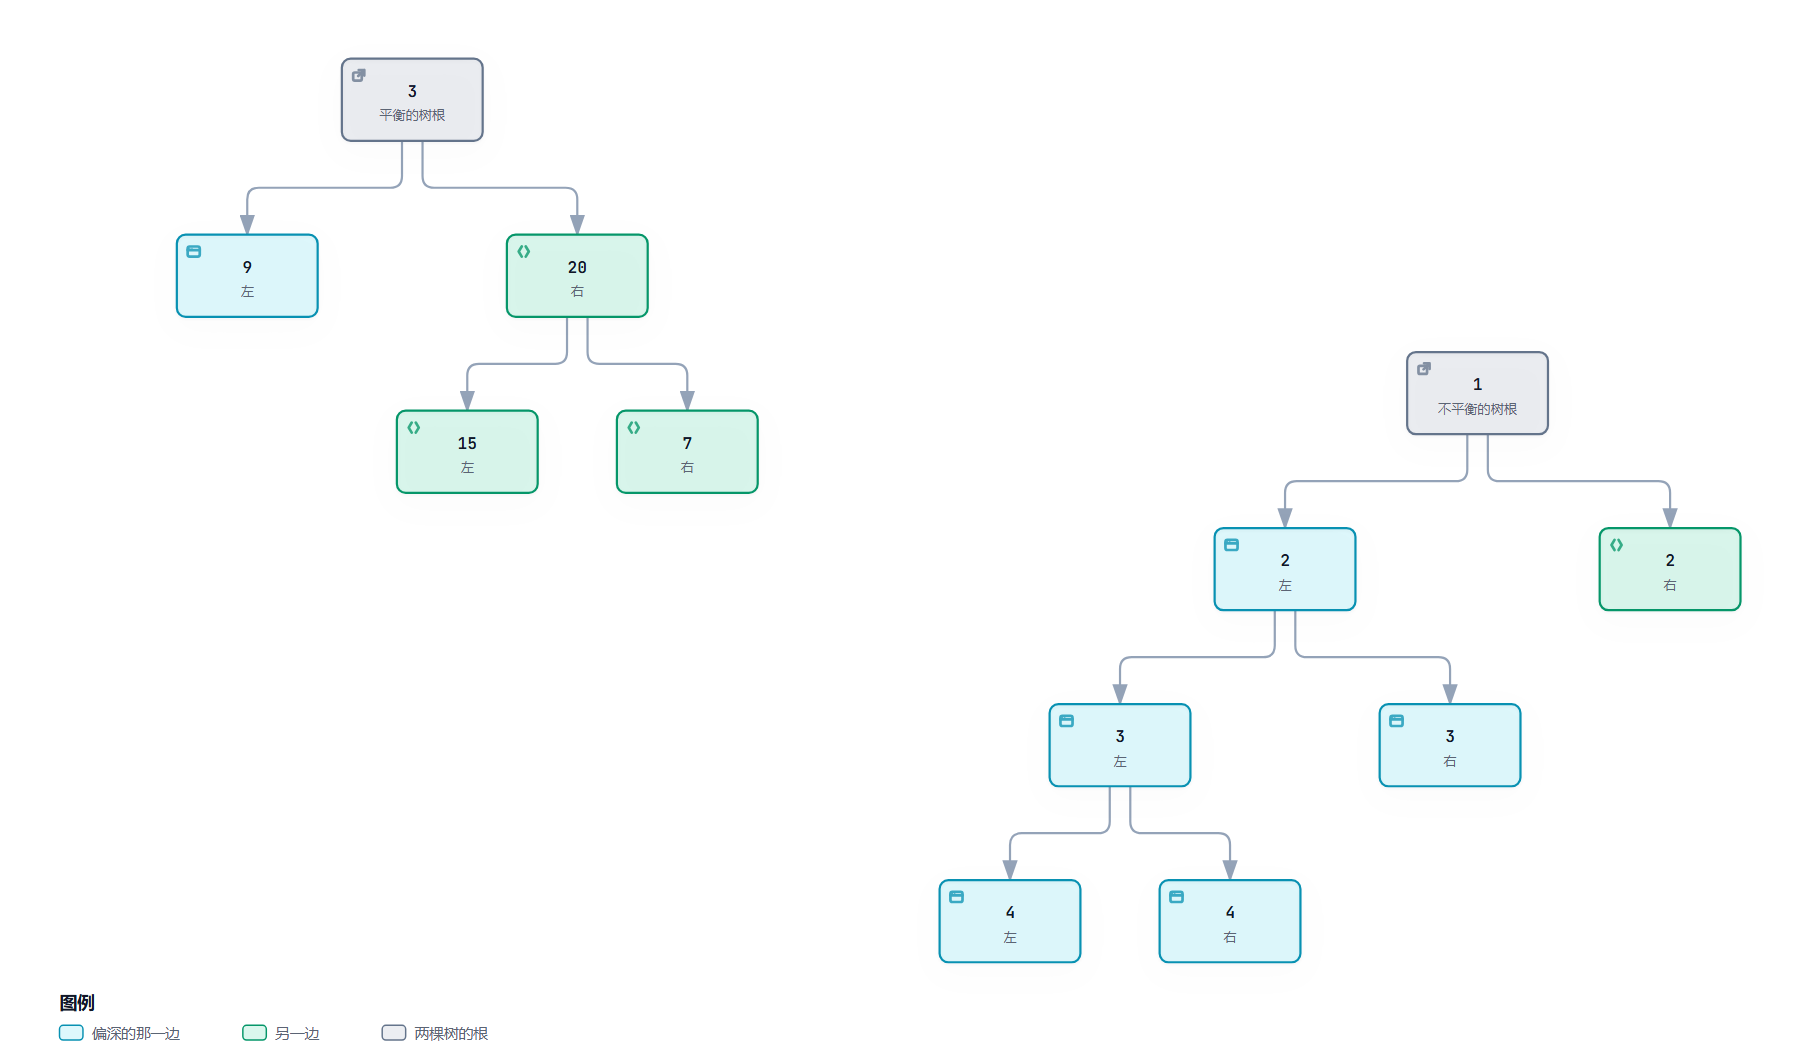
图 11 平衡二叉树:每个结点的左右子树高度差不超过 1
代码。
c
# 文件:/home/cocatrice/ds13/p11_110.c
static bool IsBalancedTopDown(struct TreeNode* root)
{
	if (root == NULL)
	{
		return true;
	}
	if (Height(root->left) - Height(root->right) > 1 || Height(root->right) - Height(root->left) > 1)
	{
		return false;
	}
	return IsBalancedTopDown(root->left) && IsBalancedTopDown(root->right);
}

static int CheckedHeight(struct TreeNode* root)
{
	int l;
	int r;

	if (root == NULL)
	{
		return 0;
	}
	l = CheckedHeight(root->left);
	if (l == -1)
	{
		return -1;
	}
	r = CheckedHeight(root->right);
	if (r == -1)
	{
		return -1;
	}
	if (l - r > 1 || r - l > 1)
	{
		return -1;
	}
	return (l > r ? l : r) + 1;
}

static bool IsBalancedBottomUp(struct TreeNode* root)
{
	return CheckedHeight(root) != -1;
}
实测回显。
text
题目给的例子:
3 9 20 null null 15 7          自顶向下 true  自底向上 true  两种一致
1 2 2 3 3 null null 4 4        自顶向下 false 自底向上 false 两种一致

边界值:
空树                         自顶向下 true  自底向上 true  两种一致
只有根结点 1              自顶向下 true  自底向上 true  两种一致
1 2 null 3(往左歪)      自顶向下 false 自底向上 false 两种一致

随机数据核对:
  1000 组随机数据,两种做法不一致 0 组

链条越来越长时两种做法的用时:
  链长 1000   自顶向下    0.019 毫秒   自底向上    0.009 毫秒
  链长 2000   自顶向下    0.034 毫秒   自底向上    0.019 毫秒
  链长 4000   自顶向下    0.066 毫秒   自底向上    0.037 毫秒
  链长 8000   自顶向下    0.140 毫秒   自底向上    0.084 毫秒

二十层的满二叉树:
  结点数 1048575
  自顶向下 true   用时 0.000 毫秒
  自底向上 true   用时 0.000 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | true | 递归出口 |
| 只有根结点 1 | true | 左右都是 0,差值 0 |
| 1 2 null 3 | false | 根的两边差 2 |
| 1 2 2 3 3 null null 4 4 | false | 不平衡的点在中间那层 |
复杂度。 自底向上 O(N),每个结点只求一次高度。自顶向下最坏 O(N²),链条越长差距越大,实测里有这两条曲线的用时对比。
第十二题 翻转二叉树(226)
题目:把每个结点的左右孩子交换过来,返回根结点。
原题链接: leetcode 226. 翻转二叉树
思路。 递归版本三行:空返回空,先把自己这一层的左右孩子换掉,再递归进左子树和右子树。队列版本把结点一个一个取出来换孩子,换完把孩子压回队列接着处理。核对这块用了两个性质:翻转过的树和原树形状必须不一样(只有一个结点的树是例外),以及再翻一次要能回到原样,两条都满足才算写对。
用例走一遍。 例子是 4 2 7 1 3 6 9,层序读出来根是 4,左孩子 2 右孩子 7。
| 层 | 翻转前 | 翻转后 |
|---|---|---|
| 1 | 4 | 4 |
| 2 | 2、7 | 7、2 |
| 3 | 1、3、6、9 | 9、6、3、1 |
层序读出来从 4 2 7 1 3 6 9 变成了 4 7 2 9 6 3 1。只有根结点的树翻完还是自己,所以形状比对那一条对它不适用,程序里单独放行。
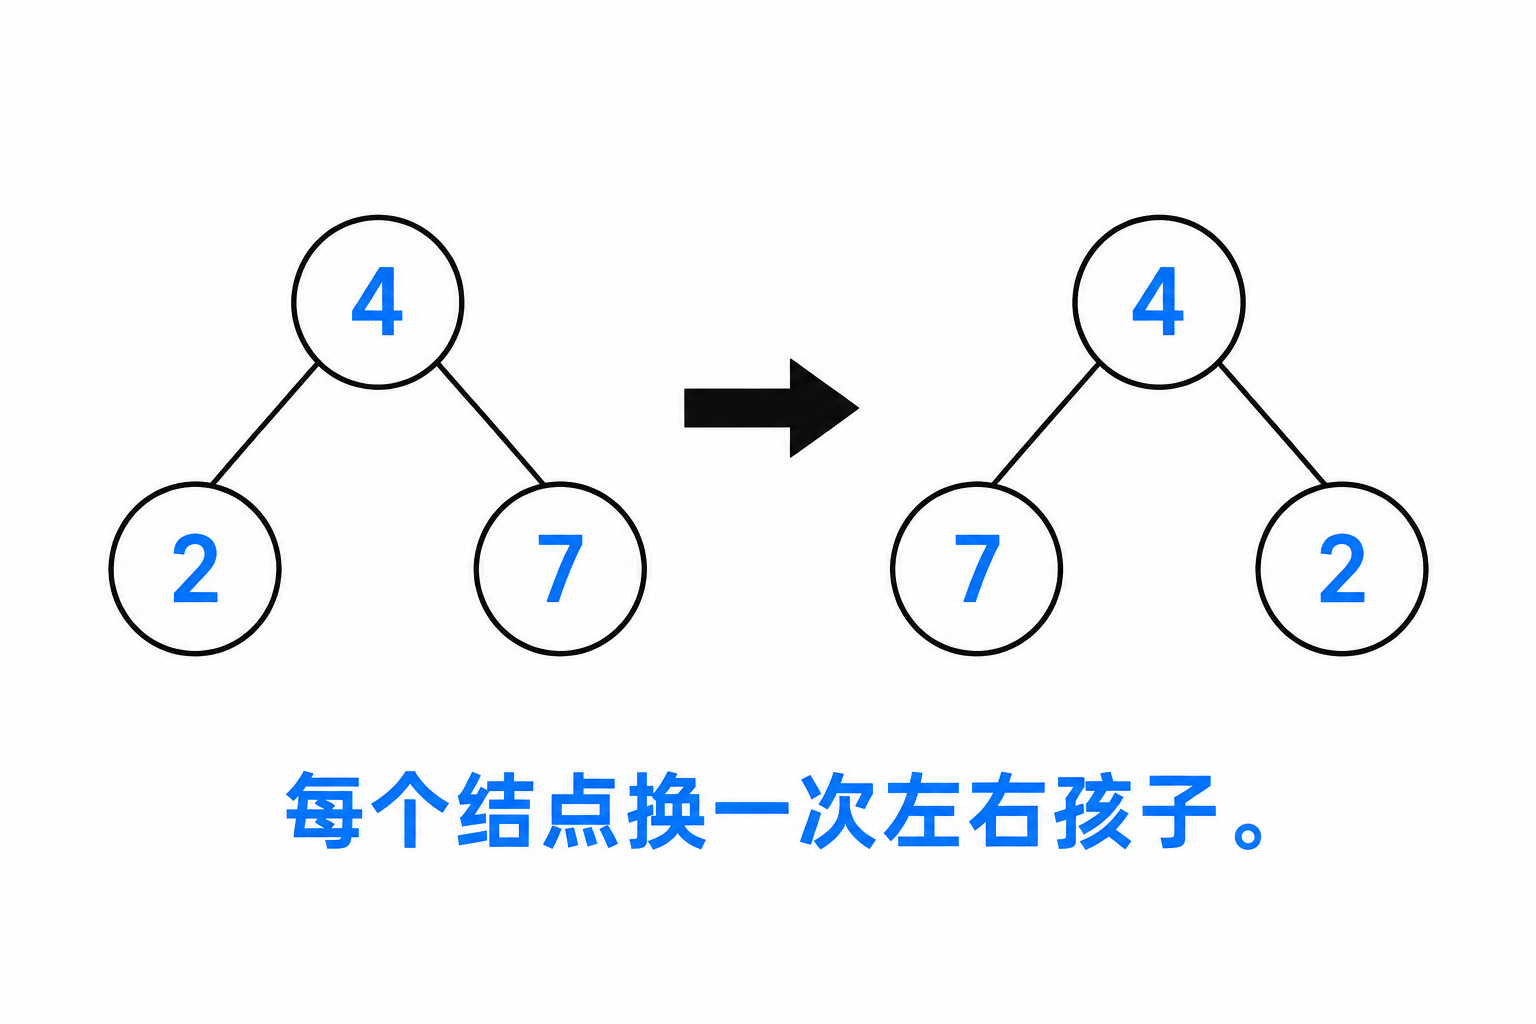
图 12 翻转二叉树:每个结点换一次左右孩子
代码。
c
# 文件:/home/cocatrice/ds13/p12_226.c
static struct TreeNode* InvertRec(struct TreeNode* root)
{
	if (root == NULL)
	{
		return NULL;
	}
	{
		struct TreeNode* tmp = root->left;
		root->left = root->right;
		root->right = tmp;
	}
	InvertRec(root->left);
	InvertRec(root->right);
	return root;
}

static struct TreeNode* InvertQueue(struct TreeNode* root)
{
	struct TreeNode** q;
	int head = 0;
	int tail = 0;

	if (root == NULL)
	{
		return NULL;
	}
	q = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	q[tail++] = root;
	while (head < tail)
	{
		struct TreeNode* cur = q[head++];

		{
			struct TreeNode* tmp = cur->left;
			cur->left = cur->right;
			cur->right = tmp;
		}
		if (cur->left != NULL)
		{
			q[tail++] = cur->left;
		}
		if (cur->right != NULL)
		{
			q[tail++] = cur->right;
		}
	}
	free(q);
	return root;
}
实测回显。
text
题目给的例子:
4 2 7 1 3 6 9                  递归与队列结果一致,先序的值确实换了左右
1 2                            递归与队列结果一致,先序的值确实换了左右

边界值:
空树                         递归与队列结果一致,先序的值本来就对称,换了也看不出来
只有根结点 1              递归与队列结果一致,先序的值本来就对称,换了也看不出来

随机数据核对:
  1000 组随机数据,翻两遍与原树不一致 0 组

一万个结点的左链:
  递归   用时 0.138 毫秒

二十层的满二叉树:
  结点数 1048575
  递归   用时 4.117 毫秒
  队列   用时 5.731 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | 还是空 | 递归第一行就返回 |
| 只有根结点 1 | 回来还是 1 | 换了两次自己,等于没换 |
| 1 2 | 1 只有左孩子 2 | 一个孩子的树也能看出方向变了 |
| 一千组随机树 | 再翻一次全部还原 | 递归和队列两种写法结果一致 |
复杂度。 时间 O(N),每个结点访问一次,递归用系统栈,深度是树高;队列那版最多同时装 O(N) 个结点。
第十三题 二叉树的层序遍历(102)
题目:把二叉树的结点按一层一行输出出来,同一层从左到右。
原题链接: leetcode 102. 二叉树的层序遍历
思路。 队列版本的关键动作只有一句话:每一轮开始先记下此刻队列里的元素个数,这个数正好是这一层的结点数。循环这么多次,每次弹一个记一个,同时把它的非空孩子从队尾压进去,这一批弹完,一层就结束了。深度优先版本换个角度:往下递归的时候带着层号,走到第几层就把值填进第几行,左子树先走、右子树后走,同一行里自然是从左到右。两种做法输出的行数和每行的值都一样,核对时把每一行拍平成一串比。
用例走一遍。 例子是 3 9 20 null null 15 7,建出来是三层的树:根 3,左孩子 9,右孩子 20,20 的两个孩子是 15 和 7。
| 轮次 | 这一层出队的 | 出队时压进去的 | 出完之后队列里剩 | 输出的一行 |
|---|---|---|---|---|
| 1 | 3 | 9、20 | 9、20 | 第 1 层:3 |
| 2 | 9、20 | 9 没有孩子,20 的孩子 15、7 | 15、7 | 第 2 层:9, 20 |
| 3 | 15、7 | 两个都没孩子 | 空 | 第 3 层:15, 7 |
第三轮出完之后队列空了,循环结束,深度优先那版把层号往下带,结点 3 记在第 1 行、9 和 20 记在第 2 行、15 和 7 记在第 3 行,同一棵树走出来的结果一模一样。
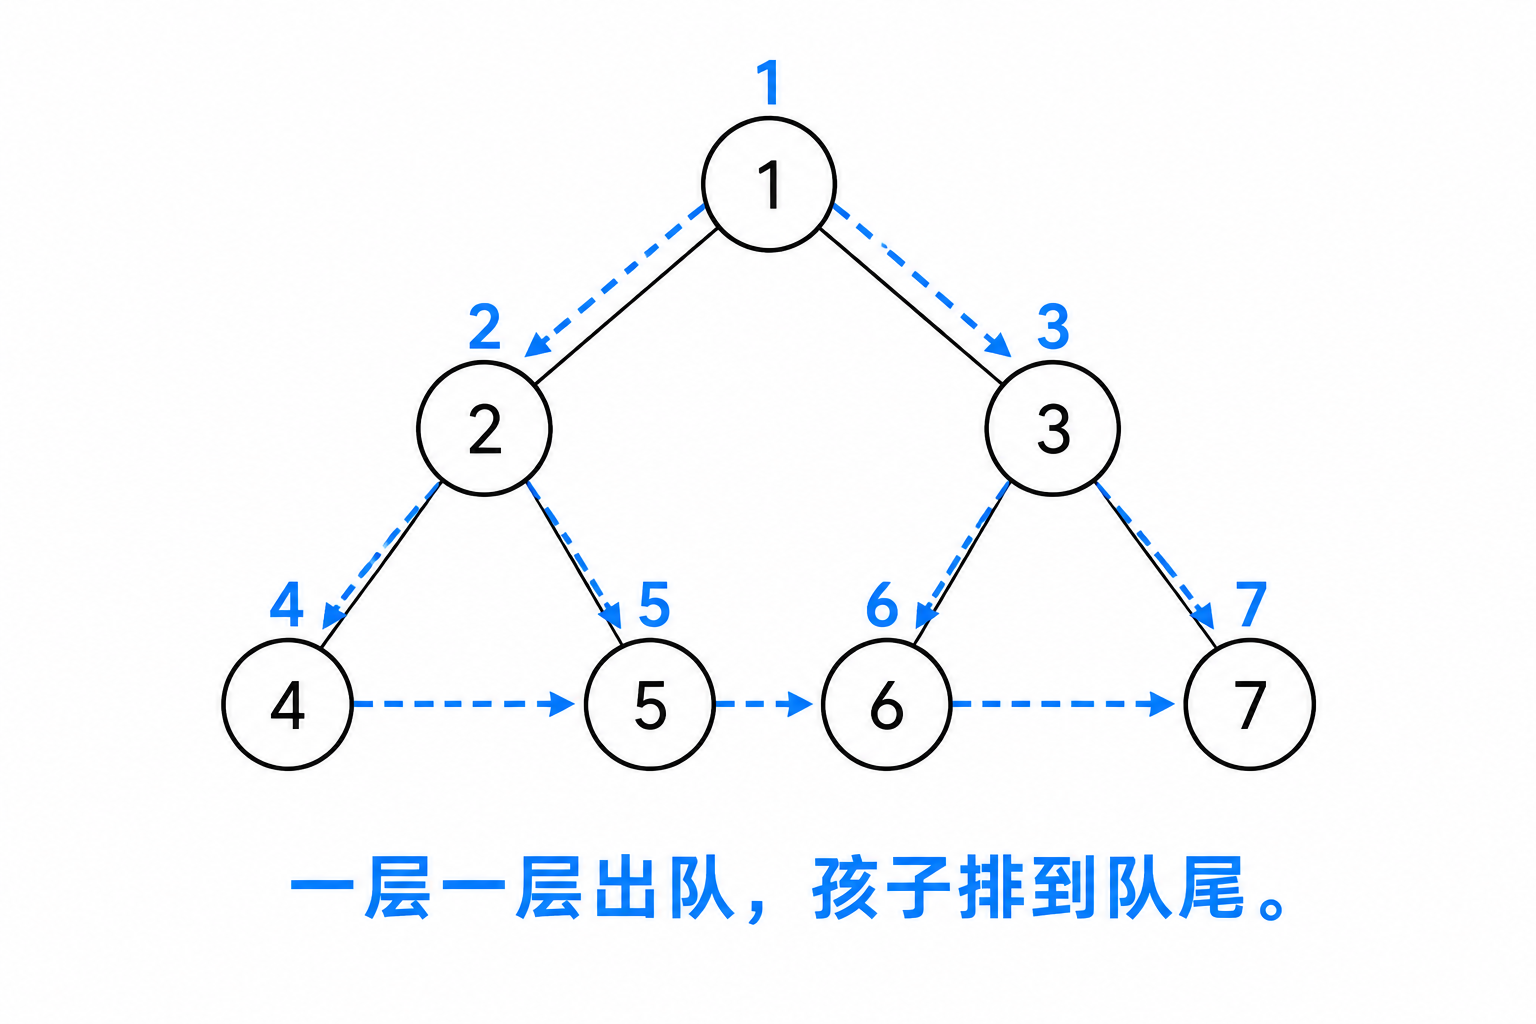
图 13 层序遍历:一层一层出队,孩子接着排到队尾
代码。
c
# 文件:/home/cocatrice/ds13/p13_102.c
static int LevelBfs(struct TreeNode* root, int* flat, int* starts, int* sizes, int* rows)
{
	struct TreeNode** q;
	int head = 0;
	int tail = 0;
	int total = 0;
	int r = 0;

	if (root == NULL)
	{
		*rows = 0;
		return 0;
	}
	q = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	q[tail++] = root;
	while (head < tail)
	{
		int levelEnd = tail;

		starts[r] = total;
		sizes[r] = 0;
		while (head < levelEnd)
		{
			struct TreeNode* cur = q[head++];

			flat[total++] = cur->val;
			sizes[r]++;
			if (cur->left != NULL)
			{
				q[tail++] = cur->left;
			}
			if (cur->right != NULL)
			{
				q[tail++] = cur->right;
			}
		}
		r++;
	}
	free(q);
	*rows = r;
	return total;
}

static void CountDepth(struct TreeNode* root, int d, int* sizes, int* rows)
{
	if (root == NULL)
	{
		return;
	}
	if (d + 1 > *rows)
	{
		*rows = d + 1;
	}
	sizes[d]++;
	CountDepth(root->left, d + 1, sizes, rows);
	CountDepth(root->right, d + 1, sizes, rows);
}

static void FillDepth(struct TreeNode* root, int d, int* cursor, int* flat)
{
	if (root == NULL)
	{
		return;
	}
	flat[cursor[d]++] = root->val;
	FillDepth(root->left, d + 1, cursor, flat);
	FillDepth(root->right, d + 1, cursor, flat);
}

// 量一遍每层有多少个结点;计数是累加的,进来之前先把上一次的结果清干净
static int CountRows(struct TreeNode* root, int* sizes)
{
	int rows = 0;

	memset(sizes, 0, sizeof(int) * (size_t)MAXROW);
	CountDepth(root, 0, sizes, &rows);
	return rows;
}
实测回显。
text
题目给的例子:
  队列走出来的结果(3 层)
  第  1 层:3
  第  2 层:9, 20
  第  3 层:15, 7

深度优先走出来的同一棵树:
  深度优先的结果(3 层)
  第  1 层:3
  第  2 层:9, 20
  第  3 层:15, 7

边界值:
  空树:0 层
  只有一个根结点(1 层)
  第  1 层:1

一万个结点的左链:
  队列走出 10000 层,第一层 [7],最后一层 [10006]

随机数据核对:
  1000 组随机数据,两种做法不一致 0 组
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 空树 | 0 层 | 队列里一开始就没东西,一轮都不进 |
| 只有一个根结点 1 | 1 层,就一个 1 | 进队一个,出队一个,孩子都为空 |
| 一万个结点的左链 | 10000 层 | 每层只有一个结点,队列里始终只装一个,这是队列版本最省的时候 |
| 一千组随机树 | 两种做法每行都一样 | 队列的层号和深度优先的层号必须一致 |
左链那条最值得看一眼:第一层的值是 7,最后一层的值是 10006。它同时说明两件事,一是链状树上不会退化,二是层数可以很大,靠递归的深度优先写法在这台机器上要一万层栈才走得完,队列版本没这个负担。
复杂度。 时间 O(N),每个结点进队出队各一次。队列里最多同时装一整层的结点,满二叉树的最后一层有 O(N) 个,所以空间是 O(N);另一边的深度优先版本空间是 O(树高)。
第十四题 完全二叉树的节点个数(222)
题目:给一棵完全二叉树,数出它的结点个数。
原题链接: leetcode 222. 完全二叉树的节点个数
思路。 最直白的写法任何一种遍历都行,走一个结点加一,代价 O(N)。第二种写法吃结构性质:完全二叉树里,任意一个结点的左右两棵子树,至少有一棵是满的。判断办法是两边都沿着最左边(或最右边)一直往下数层数,两边一样多,说明左子树是满的,左子树连同当前结点一共 2 的左边层数次方个,再把右子树递归算;两边不一样多,说明右边那棵是满的,右边连同当前结点一共 2 的右边层数次方个,再把左子树递归算。每次递归都会砍掉一整棵子树,深度只有树高,所以总量是树高的平方。
用例走一遍。 例子是 1 2 3 4 5 6,按层序读出来是一棵三层的完全二叉树:根 1,孩子 2 和 3,2 的孩子 4 和 5,3 的左孩子 6。
| 走到哪个结点 | 沿最左边数到的层数 | 沿右边数到的层数 | 怎么算 |
|---|---|---|---|
| 1 | 2(2 → 4) | 2(3 → 6) | 两边一样,左子树是满的:2 的 2 次方是 4,再加右子树递归 |
| 3 | 0(没有左孩子) | 1(6) | 两边不一样,右子树是满的:2 的 1 次方是 2,左子树为空不用再算 |
两段加起来是 6,和一个个数出来的结果一样。
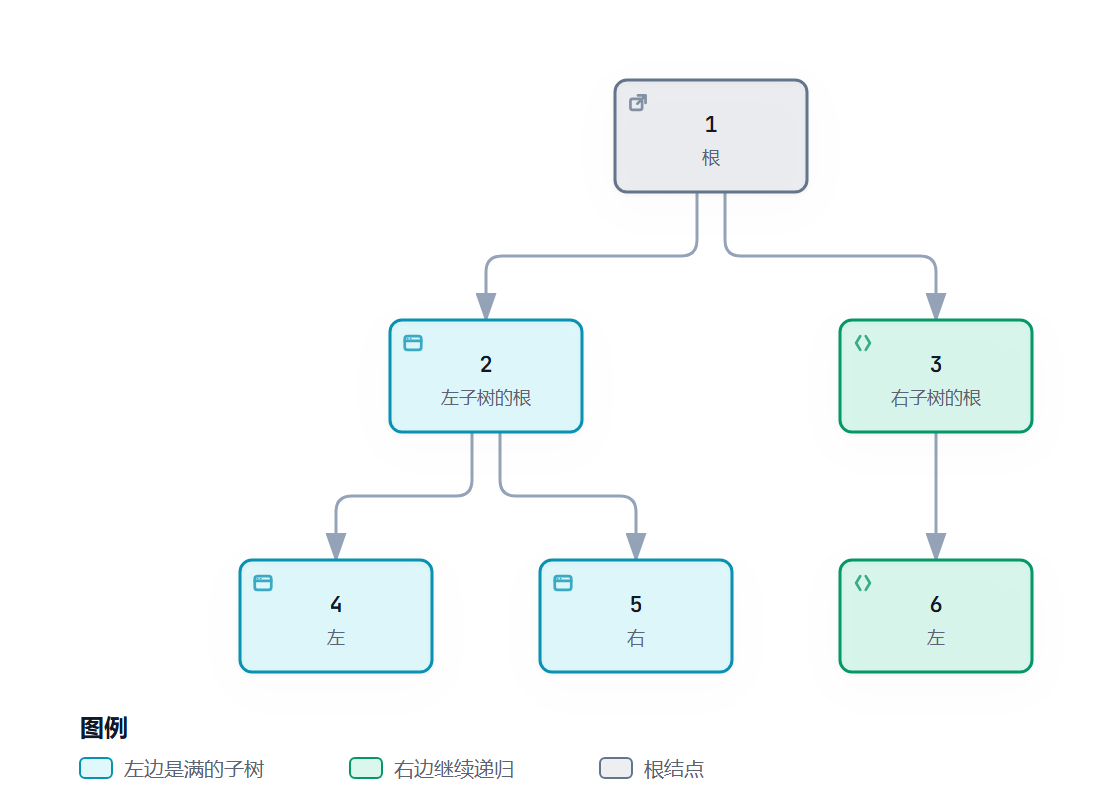
图 14 完全二叉树结点个数:满的那边直接算,另一边递归
代码。
c
# 文件:/home/cocatrice/ds13/p14_222.c
static int CountAll(struct TreeNode* root)
{
	if (root == NULL)
	{
		return 0;
	}
	return 1 + CountAll(root->left) + CountAll(root->right);
}

static int LeftHeight(struct TreeNode* root)
{
	int h = 0;

	while (root != NULL)
	{
		h++;
		root = root->left;
	}
	return h;
}

static int CountFast(struct TreeNode* root)
{
	int lh;
	int rh;

	if (root == NULL)
	{
		return 0;
	}
	lh = LeftHeight(root->left);
	rh = LeftHeight(root->right);
	if (lh == rh)
	{
		return (1 << lh) + CountFast(root->right);
	}
	return (1 << rh) + CountFast(root->left);
}
实测回显。
text
题目给的例子:
  1 2 3 4 5 6          遍历 6   性质 6
  层序 [1,2,3,4,5,6]

边界值:
  空树                 遍历 0   性质 0
  只有一个结点         遍历 1   性质 1
  只有左孩子           遍历 2   性质 2

随机数据核对:
  1000 组随机结点数(1 到 2000),两种做法不一致 0 组

满二叉树上两种做法的用时:
  16 层(65535 个结点)  遍历    0.129 毫秒   性质 65535    0.001 毫秒
  18 层(262143 个结点)  遍历    0.545 毫秒   性质 262143    0.002 毫秒
  20 层(1048575 个结点)  遍历    2.665 毫秒   性质 1048575    0.005 毫秒
  22 层(4194303 个结点)  遍历   10.069 毫秒   性质 4194303    0.010 毫秒

退化成一万层左链的完全二叉树:
  遍历 10000   用时 0.000 毫秒
  性质 10000   用时 0.000 毫秒
边界值。
| 输入 | 遍历数出来的 | 按性质算出来的 | 说明 |
|---|---|---|---|
| 空树 | 0 | 0 | 递归第一行就返回 0 |
| 只有一个结点 1 | 1 | 1 | 两边都是 0 层,2 的 0 次方是 1 |
| 只有左孩子(1 和它的左孩子 2) | 2 | 2 | 左子树一层、右边 0 层,走右边满的那一支 |
| 一千组随机完全二叉树(1 到 2000 个结点) | --- | --- | 两种做法全部一致 |
复杂度。 遍历版本时间 O(N),性质版本每一层最多量两次高度、每次 O(log N),总时间 O(log²N),额外空间是递归深度 O(log N)。满二叉树上的实测最能说明差别:二十二层(4194303 个结点)时遍历版本 10.369 毫秒,性质版本 0.009 毫秒;结点数再翻一倍,遍历版本跟着翻倍,性质版本只多量几层。
第十五题 二叉树的最近公共祖先(236)
题目:给一棵二叉树和两个结点 p、q,找出离它们最近的那个公共祖先。
原题链接: leetcode 236. 二叉树的最近公共祖先
思路。 递归版本是后序的用法:先问左子树有没有结果,再问右子树,两边都往回带回了结点,说明 p、q 一个在左一个在右,当前结点就是答案;只有一边带回了结果,就把那一边的结果往上交;如果当前结点自己就是 p 或者 q,把当前结点往上交,走到空结点返回空,另一种做法先分别求出根到 p、根到 q 的两条路径,两条路径从头往下比,最后一个相同的结点就是最近公共祖先,这个写法好在结果能一眼验证。核对时用父指针上跳那版当真值:两个结点先跳到同一层,再一起往上走,第一次碰头就是答案。
用例走一遍。 例子里的树是 3 5 1 6 2 0 8 null null 7 4:根 3,左 5 右 1;5 的孩子是 6 和 2;2 的孩子是 7 和 4;1 的孩子是 0 和 8。
| 问的是 | 根到 p | 根到 q | 最后一个相同的结点 |
|---|---|---|---|
| 结点 5 和结点 1 | 3 → 5 | 3 → 1 | 3 |
| 结点 7 和结点 4 | 3 → 5 → 2 → 7 | 3 → 5 → 2 → 4 | 2 |
第一问里 5 和 1 分别在根的两边,两边都带回结果,所以答案就是根 3;第二问里 7 和 4 是 2 的两个孩子,路径在 2 这里才分开,答案是 2。
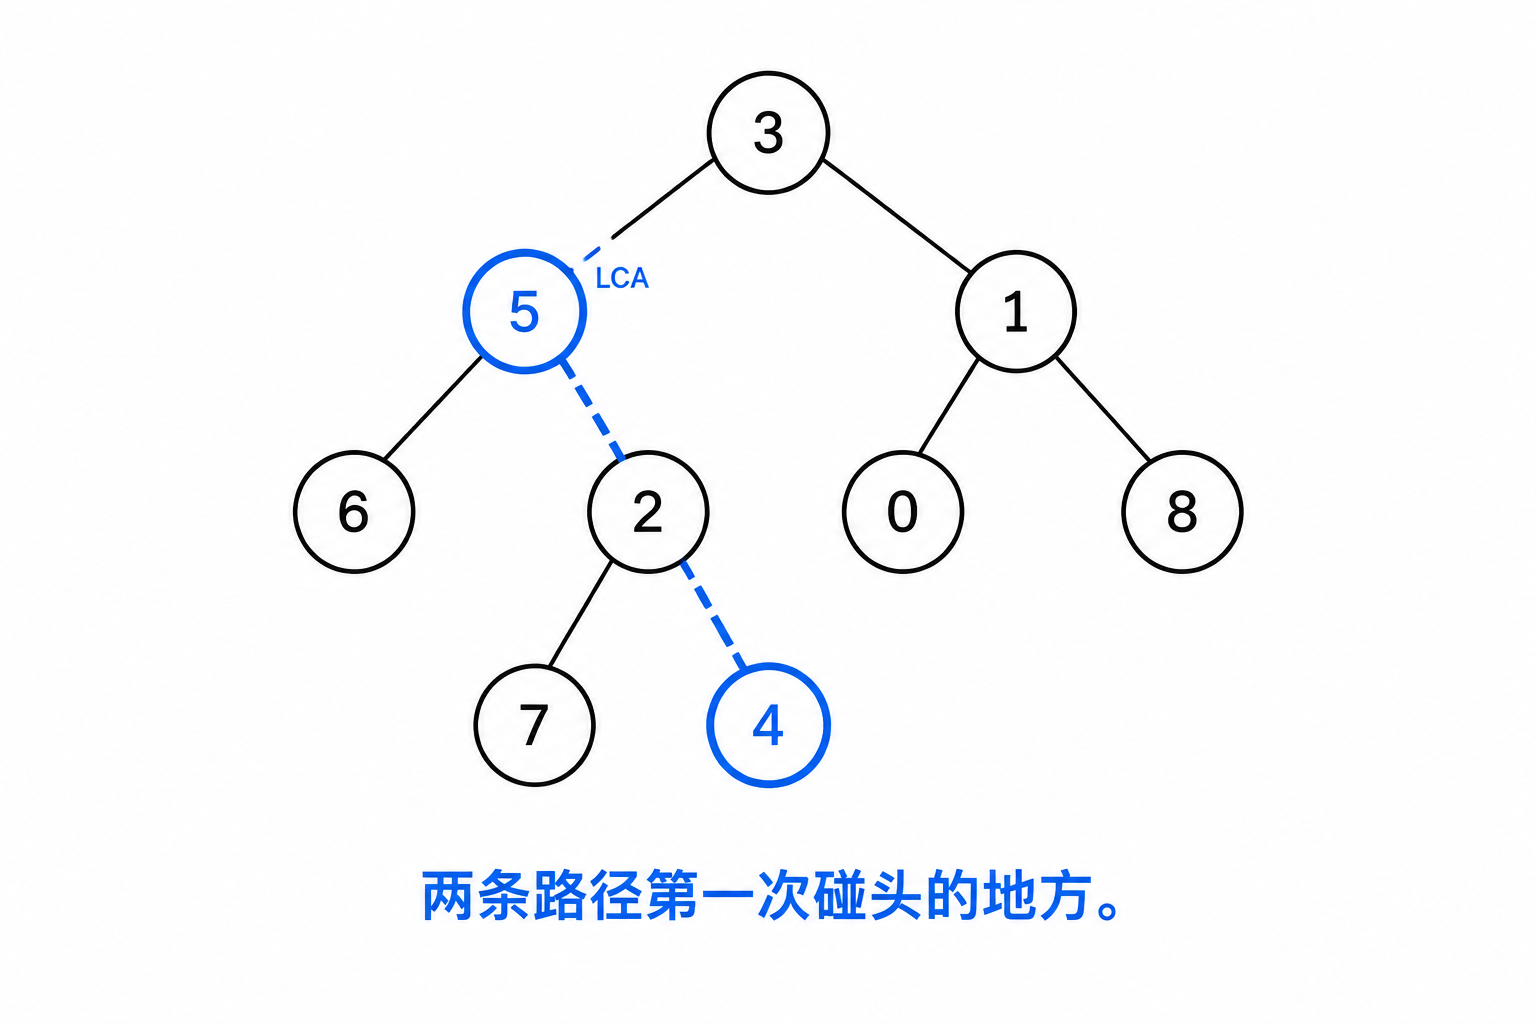
图 15 最近公共祖先:两条往上走的路径第一次碰头的地方
代码。
c
# 文件:/home/cocatrice/ds13/p15_236.c
static struct TreeNode* LcaRec(struct TreeNode* root, struct TreeNode* p, struct TreeNode* q)
{
	struct TreeNode* l;
	struct TreeNode* r;

	if (root == NULL || root == p || root == q)
	{
		return root;
	}
	l = LcaRec(root->left, p, q);
	r = LcaRec(root->right, p, q);
	if (l != NULL && r != NULL)
	{
		return root;
	}
	return l != NULL ? l : r;
}

static bool PathTo(struct TreeNode* root, struct TreeNode* t, struct TreeNode** path, int* n)
{
	if (root == NULL)
	{
		return false;
	}
	path[(*n)++] = root;
	if (root == t)
	{
		return true;
	}
	if (PathTo(root->left, t, path, n) || PathTo(root->right, t, path, n))
	{
		return true;
	}
	(*n)--;
	return false;
}

static struct TreeNode* LcaByPath(struct TreeNode* root, struct TreeNode* p, struct TreeNode* q)
{
	struct TreeNode** pathP = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	struct TreeNode** pathQ = (struct TreeNode**)malloc(sizeof(struct TreeNode*) * (size_t)TREE_MAX);
	int np = 0;
	int nq = 0;
	int i;
	struct TreeNode* ans = NULL;

	PathTo(root, p, pathP, &np);
	PathTo(root, q, pathQ, &nq);
	for (i = 0; i < np && i < nq; i++)
	{
		if (pathP[i] != pathQ[i])
		{
			break;
		}
		ans = pathP[i];
	}
	free(pathP);
	free(pathQ);
	return ans;
}
实测回显。
text
题目给的例子:
  5 和 1                    p = 5      q = 1      递归 3      路径 3      两种一致
  7 和 4                    p = 7      q = 4      递归 2      路径 2      两种一致

边界值:
  p 是 q 的祖先          p = 5      q = 7      递归 5      路径 5      两种一致
  p 和 q 是同一个结点 p = 7      q = 7      递归 7      路径 7      两种一致
  只有根结点时 p 就是 q:3

随机数据核对:
  1000 组随机数据,两种做法不一致 0 组

三千层左链:
  递归 1   用时 0.000 毫秒
  路径 1   用时 0.089 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| p 是 q 的祖先(5 和 7) | 5 | 递归在 5 这一层就返回,不再往下找 |
| p 和 q 是同一个结点(7 和 7) | 7 | 当前结点自己就是答案 |
| 只有根结点(p、q 都是根) | 3 | 空的孩子都返回空,根自己交上去 |
| 一千组随机树和随机结点对 | 两种做法全部一致 | 路径写法和父指针上跳的答案必须一致 |
复杂度。 递归版本时间 O(N),最坏走完整棵树,空间是递归深度。路径版本先花 O(N) 找两条路径,再花 O(树高) 比对,空间要多存两条路径。三千层左链上实测:递归 0.000 毫秒(一次就返回),路径写法 0.113 毫秒,链上找路径要一路走到底,这个差别说明写法好坏跟树的形状强相关。
踩坑点
- 建树和遍历用的辅助队列不能按一个拍脑袋的小上限开数组。二十层满二叉树有一百多万个结点,我原来按三十万开,八道题在做「二十层满二叉树」这一步时全部倒在越界写坏堆上,报出来的却是 double free or corruption,位置指向别处。测试数据里最大的那棵树有多少结点,缓冲就按它开。
- 输出缓冲同理。翻转二叉树那道题原来用两个 8192 字节的栈上数组装序列化结果,满树直接冲爆栈,栈溢出在崩溃现场看起来和 double free 一模一样。大缓冲一律走 malloc,长度用结点数算出来。
- 后序的「根右左走一遍再整体反转」写法里,我第一版把反转结果写回同一个数组的末尾,后半段读到的是已经被覆盖的格子。例子当场报三种做法不一致,一千组随机里 933 组对不上。正确写法是先记下这一段的起始下标,正着写进去,再头尾对调。
- 中序还原那道题,随机数据如果直接生成 1 到 9 的随机值,前序加中序还原出来的树本来就不唯一,一千组里 892 组对不上。改成先生成形状、再把非空结点依次编号成互不相同的值,问题当场消失。
- 层序那道题的深度优先写法里,每一层的计数数组是从 malloc 拿的脏内存,跨一千组还在继续累加,结果 1000/1000 组全错。用之前先 memset 清一遍,这类「上一轮的残留」最容易在批量核对里被放大。
- Morris 遍历会临时改动树的结构,别把刚跑过 Morris 的树当成基准去比。先备份一份原始结构,跑完再比一次,确认真复原了。
- 递归写法的深度上限是系统栈,不是堆。这台机器上十万个结点的链,递归中序能一路走完(一万、三万、六万、十万都试过),但换台机器、换个编译选项就不能这么假设,链状数据上该用迭代还是用迭代。
- 比较两棵树或者两棵子树时,空结点的位置也要参与。只比值组成的序列,会把「左边缺一个孩子」和「右边缺一个孩子」判成同一棵树。
- 平衡二叉树的自顶向下写法在链状树上退化成平方级:八千个结点的链,自顶向下 0.146 毫秒,自底向上 0.075 毫秒。数据量再大一点,差距会越来越明显,面试里被追问复杂度时这就是考点。
- 「翻转两次能还原」这种性质在单结点树上天生成立,程序里给它单独放行。放行要写成明确的一条判断,别一并放宽成一整类,否则真出错也发现不了。
- 回显里的每一行文字都是要贴进文章的证据,标签必须和实测数据对得上。我这里有两处标签写错了:一处写着「只有左孩子」用的却是单结点的树,一处写着「5 和 4」实际问的是 7 和 4。写测试的时候一并核对标签,比事后回头返工便宜得多。
- 性能测试的规模要挑得有意义。二十层满树一百多万个结点才把三种遍历的差距拉开(递归 5.077、栈 3.069、左走栈 2.804 毫秒),小数据上量出来的全是噪声。
本篇总结(模拟面试问题)
问:层序遍历为什么每轮要先记队列的长度?
核心要点:队列里同时装着的正好是「还没处理的、分属不同层的结点」,记下长度就等于划出了这一层的边界。循环这么多次把它们都弹出去,同时把下一代压进来,出来的一批就是一行。不记长度而是一边弹一边判空,出来的就是一棵树的完整序列,分不出层。
问:完全二叉树的结点数怎么做到比遍历快?
核心要点:完全二叉树的左右子树至少有一棵是满的。满的那棵用高度直接算,不用进去数;另一棵递归。每层递归只量一次沿边走的高度,量高度是 O(log N),整体是 O(log²N),比 O(N) 好得多。判断哪边满的办法就是比两边沿边走的层数,相等则左满,否则右满。
问:最近公共祖先的递归写法为什么不用提前检查 p、q 在不在子树里?
核心要点:递归的返回值本身就是「这棵子树里找到了谁」。左右两边都非空,说明一边一个,当前结点就是分叉点;只有一边非空就把它往上带;当前结点自己是 p 或 q 就直接返回自己。找不到的分支返回空,天然处理了 p 或 q 不在树里的情况。
问:前序加中序为什么能唯一还原一棵树?
核心要点:前序的第一项一定是根,拿这个值到中序里一找,左半段是左子树的中序、右半段是右子树的中序;两边的长度又能把前序切成对应的两段。递归下去每层都唯一确定,前提是结点的值互不相同,有重复值就没法定位根,还原不唯一。我这篇里的随机数据就是踩了这个坑。
问:Morris 遍历省下的空间从哪来,代价是什么?
核心要点:省掉了栈,用的是叶子结点空着的右指针:中序走到某个结点向左之前,先找到它左子树的最右结点,把那根空的右指针临时指向自己,走到头再顺着这根线回来并把指针改回空。空间 O(1),代价是遍历途中会改动树的结构,中途出错或者提前返回,树就留在被改动的状态;另外多了一次找前驱的循环,常数比栈版大。
问:递归写法什么时候必须换成迭代?
核心要点:看树会不会很深。递归吃的是系统栈,链状树上深度就是结点数,栈空间不够就崩。满二叉树上深度只有 log N,一百多万个结点也才二十层,完全不用换。判断依据是数据的形状,不是结点的数量。
问:平衡二叉树那道题两种写法差在哪?
核心要点:差在「高度信息往回带不带」。自顶向下每个结点都重新量一遍两边子树的高度,链上退化成平方级;自底向上让后序把高度一路带回来,发现不平衡直接返回 -1 按位与式地往上早退,每个结点只走一遍,是 O(N)。
问:判断子树为什么可以把两棵树都序列化再找子串?
核心要点:先序序列化保留了结构和值,子树在这棵树上对应的就是原树序列里的一段连续子串,所以问题变成字符串查找。坑在分隔符:不写分隔符时 1 会命中 11,值要单独用符号包起来,空结点也要有标记,否则形状不同序列会撞。
问:树形题目的边界值一般有哪几类?
核心要点:空树、只有一个结点、只有一边孩子的树(左链、右链)、链状退化、满二叉树、以及最后一层缺几个结点的完全二叉树。前四种考递归出口和空指针,后面两种考复杂度和缓冲大小。这次八道题同时崩在满树上,说明大缓冲那一类最容易被忽略。
参考
- 二叉树的定义、性质与四种遍历:https://oi-wiki.org/ds/binary-tree/
- 中序遍历的 Morris 写法(不用栈也不用递归):https://www.geeksforgeeks.org/dsa/inorder-tree-traversal-without-recursion-and-without-stack/
- 完全二叉树结点个数的 O(log²N) 解法:https://www.geeksforgeeks.org/dsa/count-number-of-nodes-in-a-complete-binary-tree/
- 最近公共祖先的多种解法对照:https://oi-wiki.org/graph/lca/