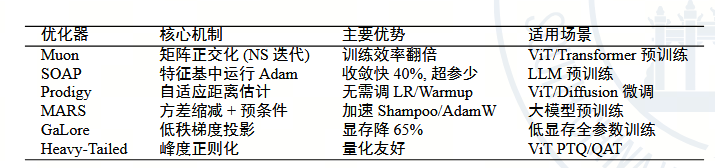
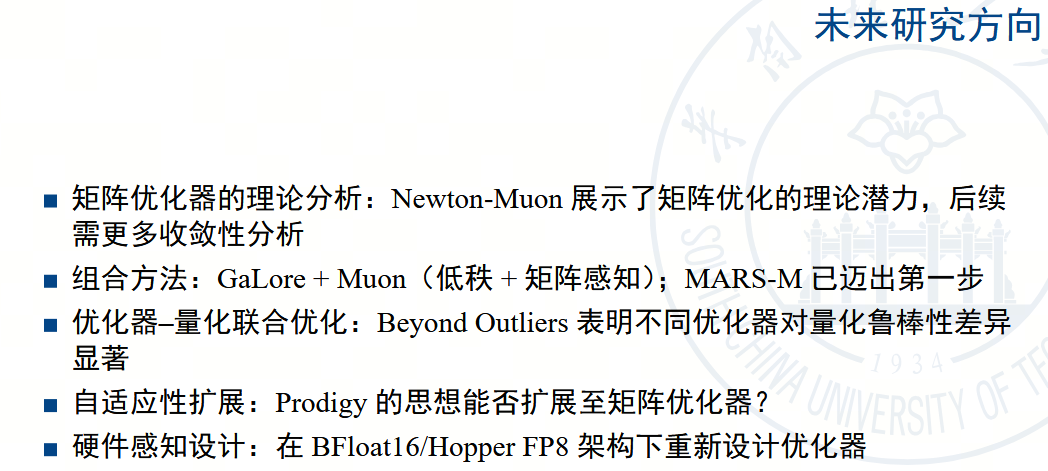
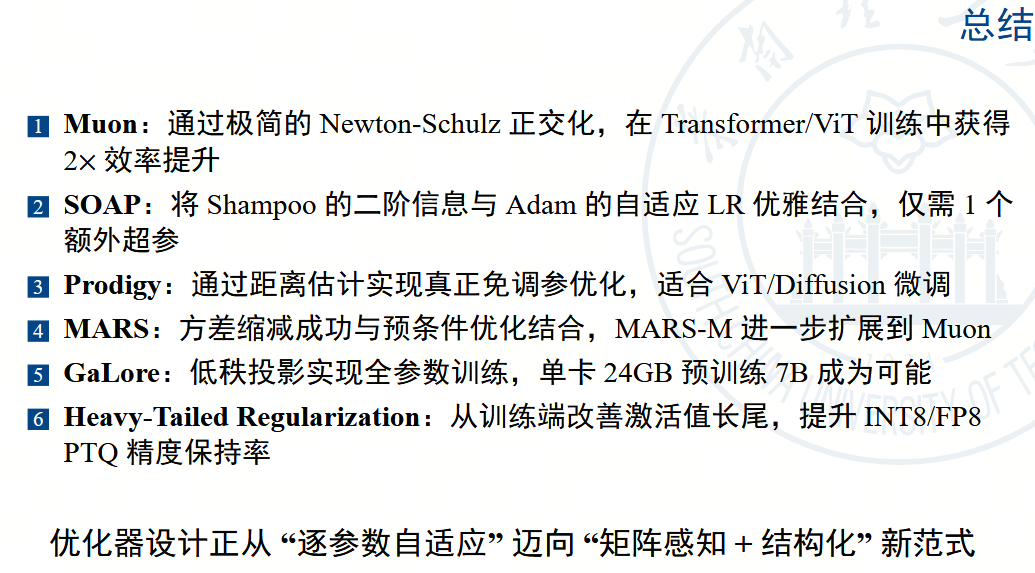
结合优化理论研究,"Heavy-Tailed"(重尾) 在 Adam 相关的研究中主要指代以下两大背景:
1. 梯度噪声的重尾分布与正则化(Heavy-Tailed Noise & Regularization)
在现代大语言模型(LLM)训练中,随机梯度的噪声经常表现出"重尾分布"(Heavy-Tailed Noise,即存在极少数概率极低但幅值巨大的极端离群梯度/Outliers)。
- 理论发现:标准 SGD 或未受约束的 Adam 在面对重尾噪声时,其收敛界和高概率收敛性会显著恶化(甚至不收敛)。
- 正则化/剪裁解法 :通过引入梯度剪裁(Gradient Clipping) 、自适应正则化项(Adaptive Regularization) 或限制步长域范围 等手段对 Adam 进行正则化约束(如 Clipped Adam 或 Regularized Adam ),能够在理论上恢复在重尾噪声下的收敛率(如达到 O(ϵ−7/2)\mathcal{O}(\epsilon^{-7/2})O(ϵ−7/2) 的平稳点收敛界)。
2. 论文《Heavy-Tailed Class Imbalance and Why Adam Outperforms Gradient Descent》
- 核心观点:该论文解释了为什么在自然语言处理任务(如 Transformer / GPT)中,Adam 会以数量级的优势碾压 SGD。
- 主要机制 :语言数据中的词频分布天然呈现 重尾长尾分布(Heavy-Tailed Class Imbalance)。传统 SGD 会导致低频词(长尾部分)对应的参数梯度极小、更新极慢;而 Adam 通过二阶动量归一化(本质上类似于 Sign-GD 的符号更新),使得更新步长脱离了类频率大小的束缚,让长尾稀有词也能获得足够的更新。
1. 重尾长尾分布(Heavy-Tailed Class Imbalance)理解与公式化表达
- 概念理解 :
重尾/长尾分布指的是在真实世界的数据集中(如 NLP 中的词频、CV 中的长尾类别分类或神经网络激活值/梯度分布中),少数高频类别(头类)占据了绝大部分数据点,而绝大多数类别(尾类)出现的频率极低,但在频次概率分布的尾部衰减速度远慢于指数衰减(即"重尾")。 - 数学表达(幂律分布/帕累托分布) :
重尾分布通常用幂律分布(Power-law Distribution)来建模。若设随机变量 XXX 为第 iii 个类别的出现频次或采样概率,其累积分布函数的尾部概率满足:
P(X>x)∼L(x)⋅x−α(x→∞)P(X > x) \sim L(x) \cdot x^{-\alpha} \quad (x \to \infty)P(X>x)∼L(x)⋅x−α(x→∞)
其中 α>0\alpha > 0α>0 为尾指数(Tail Index),L(x)L(x)L(x) 为慢变函数(如 lnx\ln xlnx)。当 α<2\alpha < 2α<2 时,该分布的方差趋于无穷大;当 α≤1\alpha \le 1α≤1 时,均值趋于无穷大。这导致传统的 SGD(依赖高斯分布或方差有限假设)在训练长尾数据时,低频类别的梯度更新被高频类别彻底淹没,收敛极慢;而 Adam 等自适应优化器通过二阶动量归一化,使得低频类也能获得足够步长的更新。
2. 结合 图片理解具体的正则化操作过程
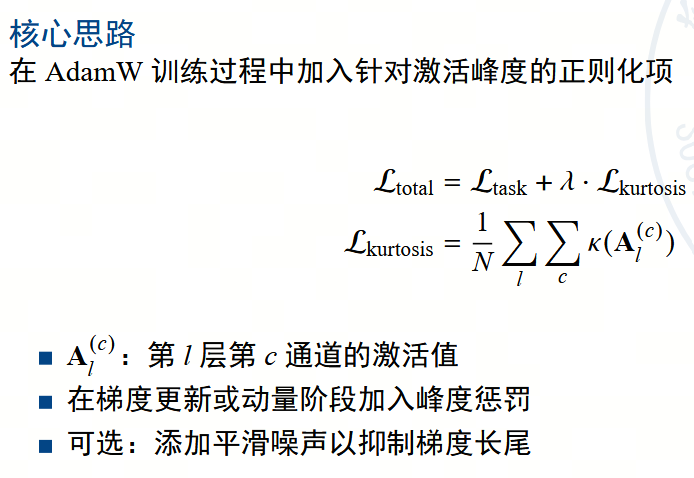
图中展示的方案是在训练损失中显式添加针对激活值峰度(Kurtosis)的正则化惩罚(Kurtosis Regularization),目的是消除神经网络内部激活或梯度的"极值离群点(Outliers)",从而平滑长尾重尾现象。
具体操作逻辑如下:
- 总损失函数构建:
Ltotal=Ltask+λ⋅Lkurtosis\mathcal{L}{\text{total}} = \mathcal{L}{\text{task}} + \lambda \cdot \mathcal{L}_{\text{kurtosis}}Ltotal=Ltask+λ⋅Lkurtosis
训练时在前向传播中算出任务损失 Ltask\mathcal{L}{\text{task}}Ltask,同时计算各层激活值的峰度惩罚项 Lkurtosis\mathcal{L}{\text{kurtosis}}Lkurtosis,用超参数 λ\lambdaλ 进行加权控制。
- 激活峰度项计算(Lkurtosis\mathcal{L}_{\text{kurtosis}}Lkurtosis):
Lkurtosis=1N∑l∑cκ(Al(c))\mathcal{L}{\text{kurtosis}} = \frac{1}{N} \sum{l} \sum_{c} \kappa(\mathbf{A}_l^{(c)})Lkurtosis=N1l∑c∑κ(Al(c))
对于第 lll 层、第 ccc 个通道的激活值向量/张量 Al(c)\mathbf{A}_l^{(c)}Al(c),计算其统计峰度(Kurtosis) κ(⋅)\kappa(\cdot)κ(⋅)。峰度定义为四阶标准矩:
κ(X)=E(X−μ)4(E(X−μ)2)2−3\kappa(\mathbf{X}) = \frac{\mathbb{E}(\\mathbf{X} - \\mu)\^4}{\left(\mathbb{E}(\\mathbf{X} - \\mu)\^2\right)^2} - 3κ(X)=(E(X−μ)2)2E(X−μ)4−3
峰度越大,说明数据分布的尾部越"重"(即存在极少数数值极大或极小的离群峰值)。通过将其作为 Loss 进行最小化,强制拉低激活值的峰度,使其分布更接近高斯分布(薄尾/轻尾)。
- 反向传播与 AdamW 更新:
-
梯度反向传播 :∇WLtotal\nabla_{\mathbf{W}} \mathcal{L}_{\text{total}}∇WLtotal 会同时包含任务梯度与"削平峰值"的正则化梯度。
-
动量更新:在 AdamW 的一阶与二阶动量维护阶段,加入峰度惩罚梯度,能够防止特定 Channel 产生暴增的二阶动量(避免二阶动量被大 Outliers 撑爆导致后续学习率衰减过快)。
-
可选平滑噪声 :在计算梯度或动量时加入微小的平滑高斯噪声 ϵ∼N(0,σ2)\epsilon \sim \mathcal{N}(0, \sigma^2)ϵ∼N(0,σ2),进一步打散极端离群值,抑制长尾效应。
峰度
峰度(Kurtosis)是统计学中用来衡量数据概率分布 "尾部厚度"以及"极端值(离群点/Outliers)出现概率"的指标。
简单来说,峰度反映了数据是倾向于集中在均值附近,还是更容易出现极高或极低的"陡峭离群峰值"。
数学定义与公式
对于随机变量 XXX,其均值为 μ\muμ,标准差为 σ\sigmaσ,峰度定义为数据的四阶标准矩:
KurtX=E(X−μσ)4=E(X−μ)4(E(X−μ)2)2\text{Kurt}X = \mathbb{E}\left\\left(\\frac{X - \\mu}{\\sigma}\\right)\^4\\right = \frac{\mathbb{E}(X - \\mu)\^4}{\left(\mathbb{E}(X - \\mu)\^2\right)^2}KurtX=E(σX−μ)4=(E(X−μ)2)2E(X−μ)4
在实际应用中,通常使用超额峰度(Excess Kurtosis),即在原始峰度的基础上减去 3(因为标准正态分布的原始峰度恰好为 3):
Excess Kurtosis=KurtX−3\text{Excess Kurtosis} = \text{Kurt}X - 3Excess Kurtosis=KurtX−3
峰度的三类形态
根据超额峰度(Excess Kurtosis)的值,概率分布可分为三类:
-
正态分布(Mesokurtic,中峰):
-
超额峰度 =0= 0=0(原始峰度 =3= 3=3)。
-
数据的尾部厚度和离群点出现的概率与标准正态分布一致。
-
厚尾/尖峰分布(Leptokurtic,超额峰度 >0> 0>0):
-
特点 :分布的中心更陡峭,且尾部更厚(Heavy-tailed)。
-
含义:出现极端异常值(Outliers)的概率显著高于正态分布(即容易产生"暴涨"或"暴跌"的极端极值)。
-
薄尾/平峰分布(Platykurtic,超额峰度 <0< 0<0):
-
特点:分布比较平缓,中心较平坦。
-
含义:数据分布相对均匀,极少出现严重的离群异常值。
在深度学习/大模型训练中的意义
结合你之前提到的正则化方案,神经网络激活值(Activations)或梯度(Gradients)的峰度过高通常意味着:
-
存在严重的异常激活值(Outliers):某些 Channel 或层在特定 Input 下会突然爆发出极大的数值。
-
训练不稳定/量化困难:极高的峰度(尖峰厚尾)会导致二阶动量被离群值撑爆,或者在模型量化(INT8/FP8 Quantization)时破坏动态范围(Dynamic Range)。
-
正则化的作用 :通过在 Loss 中添加峰度惩罚项 Lkurtosis\mathcal{L}_{\text{kurtosis}}Lkurtosis(即强制降低峰度),本质上是在压制这些极端异常峰值,让激活值的分布回归到平滑、薄尾的状态。
Heavy-Tailed Class Imbalance(重尾长尾类不平衡)不仅局限于 Loss 层面的优化,它是一个涵盖 Loss 设计、优化器更新机制(Optimizer)、数据采样策略(Data Sampling)以及特征表示(Representation)的全方位学术与工程课题。
在实践与理论研究中,针对重尾/长尾分布的解决方案主要分为以下几个核心维度:
1. 优化器层面的优化(Optimizer Design)
- 原理 :这是该领域最核心的发现之一(如经典论文 "Heavy-Tailed Class Imbalance and Why Adam Outperforms Gradient Descent" 所揭示)。传统 SGD 的更新步长与梯度幅值直接成正比,导致出现频率极低的"尾部类(Tail Classes)"因为累积梯度太小而被"头部类(Head Classes)"彻底淹没。
- 做法 :Adam 等自适应优化器通过除以二阶动量 vt\sqrt{v_t}vt (本质上类似 Sign-GD 符号更新),自动归一化了梯度的数量级,使得长尾低频类参数也能获得足够大的有效步长,从而在优化器层面天然缓解了重尾不平衡问题。
2. 损失函数层面的优化(Loss Formulation)
Loss 优化的确是最直观、最常用的手段,主要通过调整不同类别的梯度权重或决策边界:
- 重加权/重缩放(Re-weighting / Re-scaling):根据类频的倒数或有效样本数(Effective Number of Samples)给 Loss 加权(如 Class-Balanced Loss)。
- 边际/间隔优化(Margin-based Loss):如 LDAM Loss(Label-Distribution-Aware Margin),强制要求尾部类在特征空间中拥有更大的分类 Margin,补偿其较小的先验概率。
- 焦点损失(Focal Loss):通过降低易分类样本(头部类)的 Loss 权重,让模型聚焦在难分类样本(尾部类)上。
3. 数据与采样层面的优化(Data / Sampling Level)
- 重采样(Re-sampling):对头部类进行欠采样(Under-sampling)或对尾部类进行过采样(Over-sampling / Repeat-sampling)。
- 混合采样与增强(Decoupled Training & Augmentation):例如先用原始分布训练特征提取器,再用均衡采样微调分类头(Decoupled Representation and Classifier);或对尾部类实施更强的数据增强(如 CutMix/Mixup)。
4. 结构与正则化层面的优化(Architecture & Regularization)
- 激活/梯度正则化:正如前面 PPT 中提到的方案,通过对激活值或梯度的峰度/离群点进行正则化惩罚(Kurtosis Regularization),压制极端值产生,平滑长尾分布在模型内部的特征响应。