做香港职场自动化,绕不开法例------《雇佣条例》《最低工资条例》《职业安全及健康条例》这些决定了 HR 流程里每一条硬性规则。香港把全部现行法例做成了开放数据,整包 0.91 GB。
这就撞上一个很实际的问题:一个 0.91 GB 的下载任务,Agent 不可能靠上下文记进度。 上下文里放得下「我要下 4 个文件」,放不下「第 2 个文件已经下了 347,219,003 字节」。一旦中断,靠上下文回忆进度的 Agent 只能从头再来。
这篇文章把这件事做了一遍:从清单解析、三层验收、断点续传到 sha256 校验,全部实测。所有数字可复现。
文章目录
-
- [1. 官方的清单,本身就是验收标准](#1. 官方的清单,本身就是验收标准)
- [2. 三次把关,越早发现问题越便宜](#2. 三次把关,越早发现问题越便宜)
- [3. 断点续传:先确认对端答应](#3. 断点续传:先确认对端答应)
- [4. 完整跑一遍:49.4 MB,14.27 秒](#4. 完整跑一遍:49.4 MB,14.27 秒)
- [5. 校验:分块读,别把 0.91 GB 读进内存](#5. 校验:分块读,别把 0.91 GB 读进内存)
- [6. 进度账本:为什么不能放在上下文里](#6. 进度账本:为什么不能放在上下文里)
- [7. 踩坑清单与结论](#7. 踩坑清单与结论)
- [8. 参考链接](#8. 参考链接)
1. 官方的清单,本身就是验收标准
下载之前先拿清单。这份 XML 只有 2.8 MB,但它把整个任务的账目写清楚了:
python
import re, pathlib

def parse_plan(path):
    """清单里每个 <DataResource> 都自带 fileSize 和 sha256 ------ 直接当验收标准用。"""
    t = pathlib.Path(path).read_text(encoding="utf-8")
    head = dict(re.findall(r'(\w+)="([^"]*)"', t.split("<DataSet>")[0]))
    items = []
    for blk in re.findall(r"<DataResource\b(.*?)</DataResource>", t, flags=re.S):
        a = dict(re.findall(r'(\w+)="([^"]*)"', blk))
        a["label"] = re.sub(r"\s+", " ", re.sub(r"<[^>]+>", "", blk)).strip()
        items.append(a)
    return head, items
跑出来是 4 个条目:
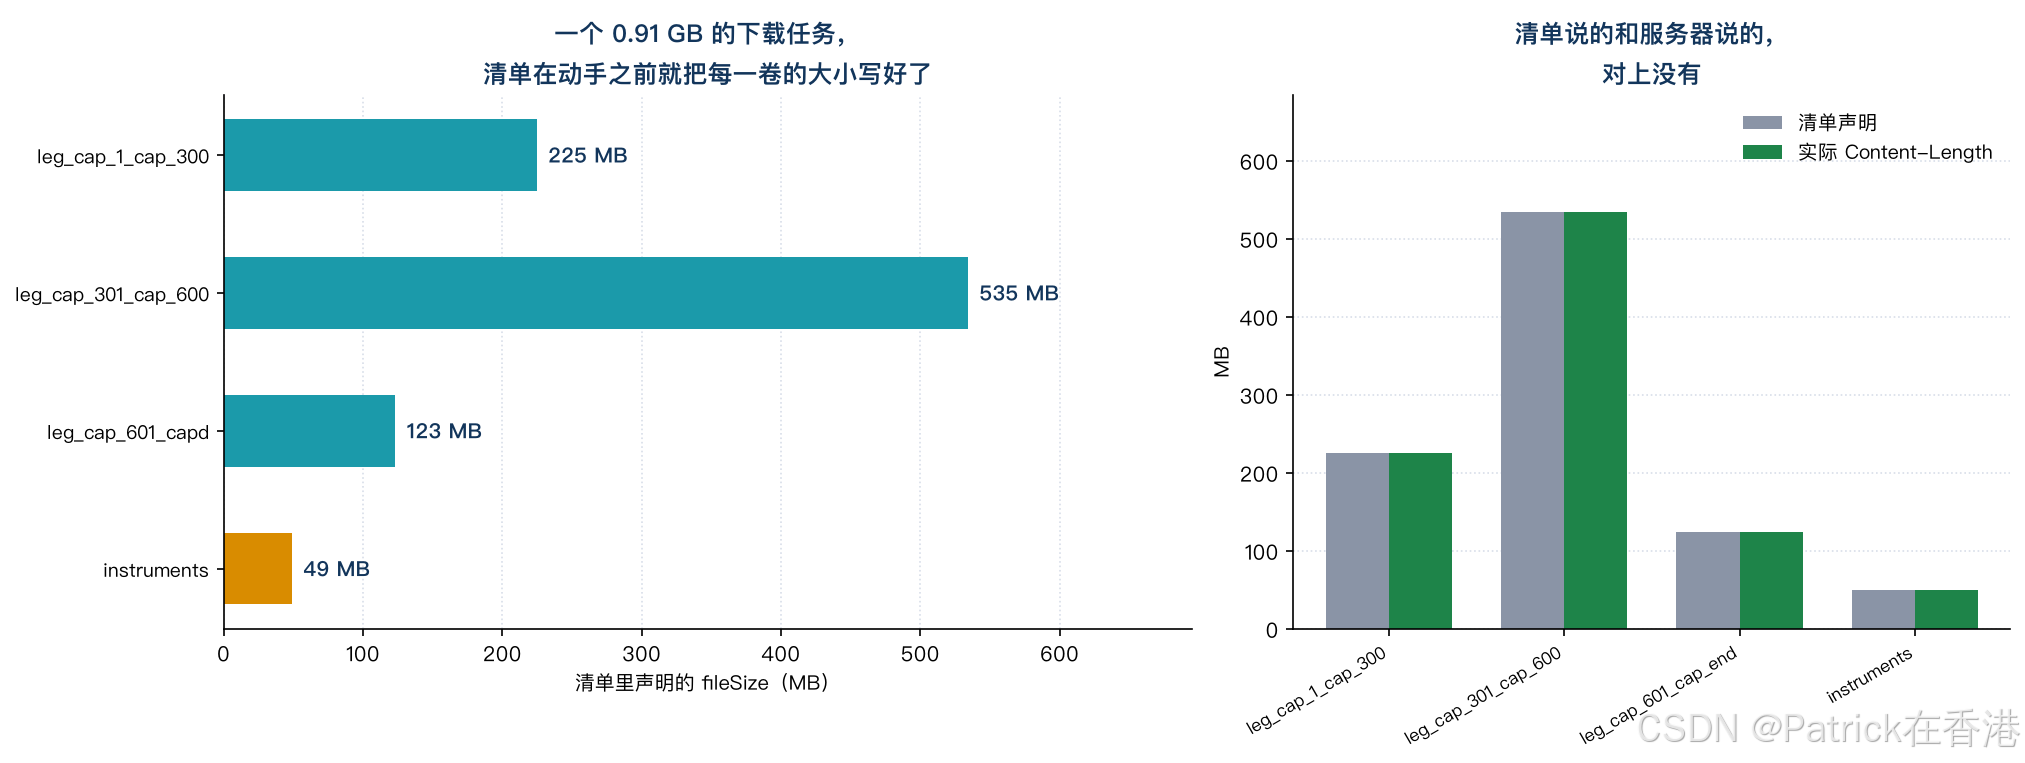
| 分卷 | 声明大小 | 类型 |
|---|---|---|
| Cap. 1 -- 300 | 225.0 MB | 法律 |
| Cap. 301 -- 600 | 534.5 MB | 法律 |
| Cap. 601 -- 末 | 123.3 MB | 法律 |
| 附例(Instruments) | 49.4 MB | 附例 |
| 合计 | 977,571,818 B = 0.91 GB |
清单里还有两个容易被忽略但很有用的字段:UpdatedDateTime(本次是 2026-09-14T21:25:47)和每条目的 fileDate。它们让你在下第一个字节之前就知道这批数据是不是你要的那一版。
这三个检查点值得收藏成一张检查表 ------ 任何大文件任务,动手前过一遍。
顺手做了一个交叉验证:把清单声明的 fileSize 和对端实际返回的 Content-Length 逐条比。4 个条目全部一致,一字不差------这说明这份清单是可信的,可以直接当基准。
2. 三次把关,越早发现问题越便宜
长任务最怕的不是失败,是跑到最后一秒才发现不对。这个下载任务里其实有三个天然的检查点:
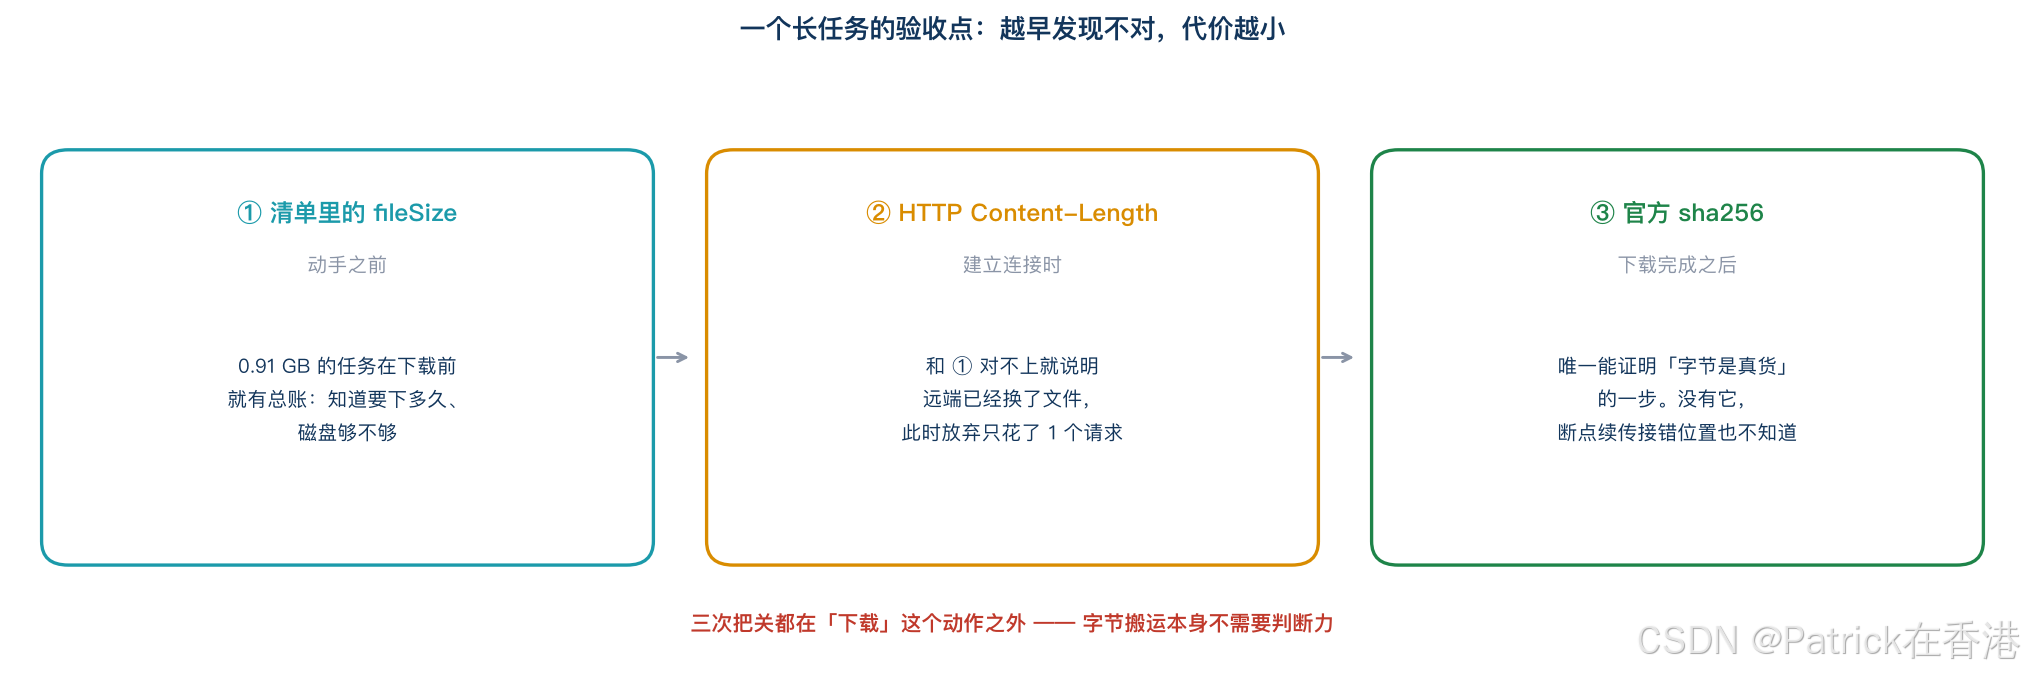
① 清单的 fileSize(动手之前)------0.91 GB 这个数让你能提前算:按实测的 3.9 MB/s,全量大概 4 分钟;磁盘够不够;要不要分期。
② Content-Length(建立连接时)------只需要一个 HEAD 请求。如果它和清单声明对不上,说明远端换过文件了,此时放弃的成本是「一个请求」。
③ sha256(下载完成之后)------唯一能证明「下下来的字节就是官方那份」的一步。
很多人只做第 ① 步(看一眼大小差不多就开始下),然后在最后发现校验不过,回头重下。把关点越靠后,返工代价越大。
3. 断点续传:先确认对端答应
-C - 这个参数不是魔法,它只是让 curl 在请求头里加一句 Range: bytes=N-。能不能续,取决于对端回不回 206 Partial Content。
所以动手前先探一次:
python
def range_probe(url, nbytes=1024):
    """断点续传的前提:对端要回 206 + Content-Range,否则 Range 会被忽略。"""
    r = subprocess.run(["curl", "-s", "-o", "/dev/null", "-D", "-",
                        "-r", f"0-{nbytes - 1}", "--max-time", "40", url],
                       capture_output=True, text=True)
    st = [l.split()[:2] for l in r.stdout.splitlines() if l.startswith("HTTP/")]
    cr = re.search(r"(?im)^content-range:\s*(.+)$", r.stdout)
    return {"status": st[-1][1] if st else "000",
            "content_range": cr.group(1).strip() if cr else None}
回到的是 206 加 content-range: bytes 0-1023/129326534。对端答应了。
然后做真实的「中断---续传」:
第 1 次:curl -sL --max-time 4 -o seg.zip "$URL"     → 4,728,174 字节(4.5 MB)
第 2 次:curl -sL --max-time 4 -C - -o seg.zip "$URL" → 8,932,884 字节(8.5 MB)
第二次的增量是 4,204,710 字节------它没有重新开始,而是从 4.5 MB 处接上的。
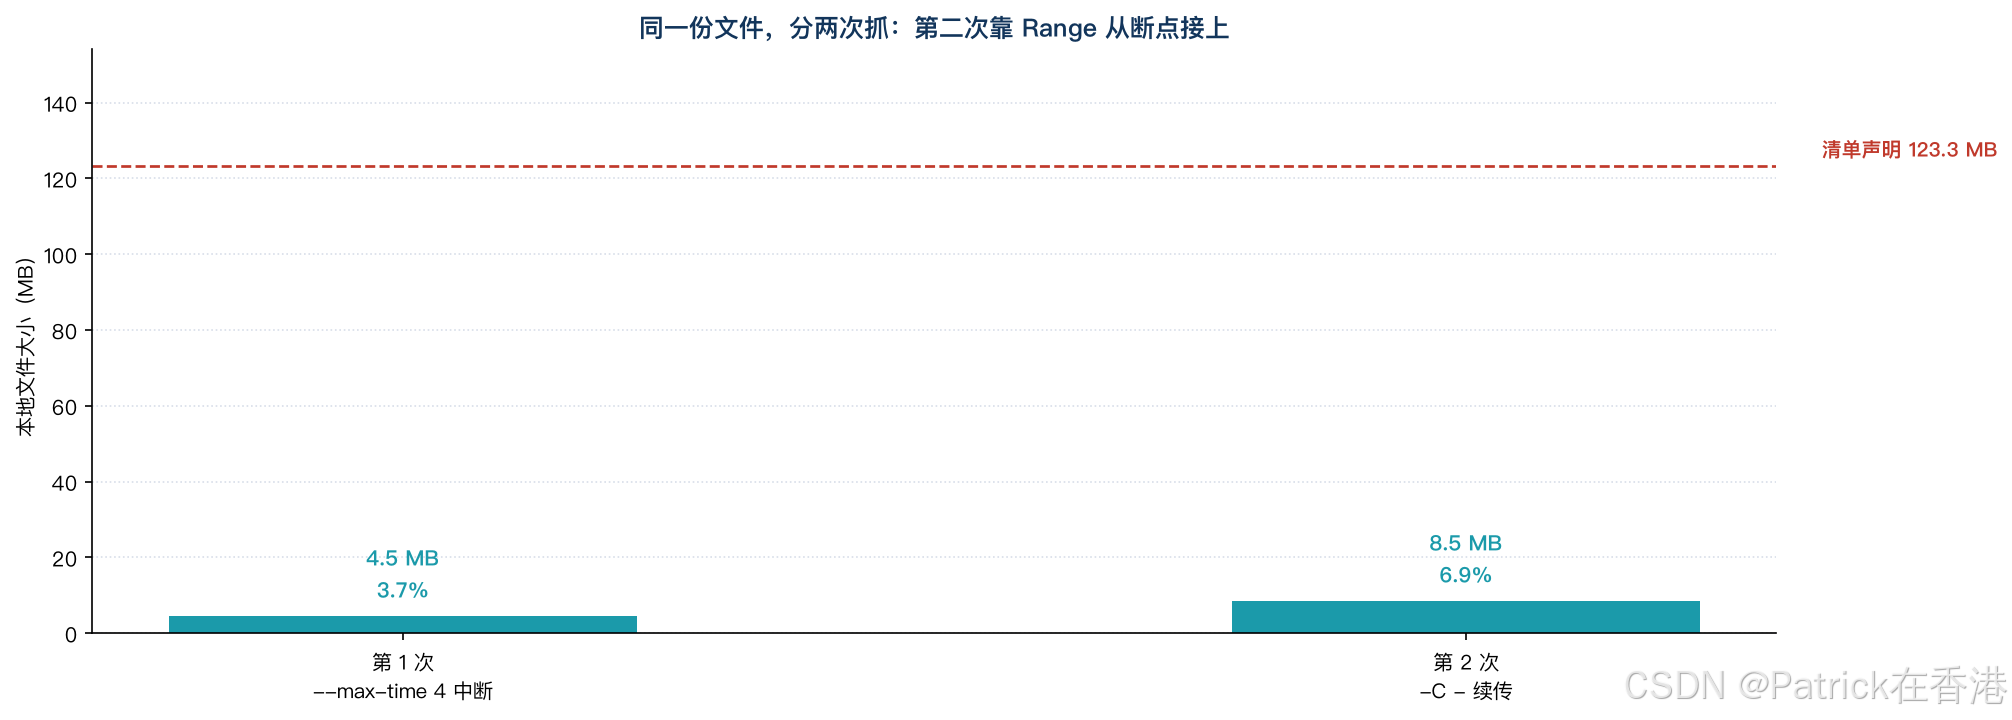
这里有个细节值得单独说:-C - 是让客户端 告诉对端「我从哪接」。如果本地文件被截断过、或者上次下载写坏了字节,-C - 会老老实实从一个错误的位置接上,并且不报错 。所以续传必须配一个事后校验------就是第 5 节的 sha256。
4. 完整跑一遍:49.4 MB,14.27 秒
为了真验一次,我下载了最小的那一卷(附例,49.4 MB):
目标 hkel_c_instruments_en.zip
清单声明 51,811,189 B | 本地已有 0 B (0.0%)
下载后 51,811,189 B | 完成 True | 状态已写入 download_state.json
real 0m14.274s
14.27 秒,49.4 MB,约 3.9 MB/s。 按这个速度,0.91 GB 全量大约 4 分钟------这是可以放进一次任务里的量级,不需要分段跨天。
速度数字的意义在于:它让「要不要下载全量」变成一个可以用算术回答的问题,而不是靠感觉。
5. 校验:分块读,别把 0.91 GB 读进内存
官方已经给了 sha256,所以校验逻辑不需要自己定义「什么算下载成功」:
python
def sha256_of(path, chunk=1 << 20):
    """按 1 MB 分块读 ------ 0.91 GB 的文件不要一次性读进内存。"""
    h = hashlib.sha256()
    with pathlib.Path(path).open("rb") as f:
        for blk in iter(lambda: f.read(chunk), b""):
            h.update(blk)
    return h.hexdigest().upper()
实测结果:
本地 51,811,189 B / 声明 51,811,189 B
sha256 本地 51A4D2F38E2D025DF4AE2E96... | 声明 51A4D2F38E2D025DF4AE2E96...
校验 通过这段校验代码可以直接收藏:换任何带官方校验和的官方数据源(很多政府/开源镜像都提供),改一行路径就能用。分块大小取 1 MB 是个平衡点------再小会增加系统调用次数,再大对内存不友好。
6. 进度账本:为什么不能放在上下文里
现在回到 Agent 的问题。假设让一个 Agent 去下这 0.91 GB:
放进上下文会怎样? 「已下载 4 个文件中的第 2 个」这种状态,上下文里存的是语义摘要 。中断后重启,Agent 只能看到「第 2 个还没下完」------但不知道是 5% 还是 95%。它唯一安全的选择是重新开始,这在 535 MB 那一卷上意味着白等两分钟。
放进磁盘会怎样? 状态变成可精确读取的数字:
python
def save_state(path, key, declared, local):
    """进度落盘:只存「能用来做判断」的字段。"""
    state = json.loads(pathlib.Path(path).read_text(encoding="utf-8")) \
        if pathlib.Path(path).exists() else {}
    state[key] = {"declared": declared, "local": local,
                  "complete": local == declared}
    pathlib.Path(path).write_text(
        json.dumps(state, ensure_ascii=False, indent=1), encoding="utf-8")
    return state
重启后第一件事不是问模型「我们进行到哪了」,而是 读磁盘 → 比对声明的 fileSize → 决定续传还是重下。这一步是纯算术,不需要判断力,也就不会出错。
这个「状态落盘」的写法可以收藏 ------ 换成批量调 API、批量转码这类长任务,账本字段换掉就能直接用。
分工线因此很清楚:字节搬运和状态记账交给磁盘和 curl,Agent 只负责决策------比如「这一卷校验不过,要不要重下一次」、「磁盘只剩 2 GB 了,剩下两卷先下哪个」。
7. 踩坑清单与结论
| 坑 | 现象 | 处理 |
|---|---|---|
| 只信大小不看校验 | 下完才发现内容不对 | 官方给了 sha256 就用它 |
-C - 接在错误位置 |
续传成功但文件是坏的,不报错 | 续传后必须校验 |
| 一次性读大文件算哈希 | 0.91 GB 进内存 | 按 1 MB 分块流式读 |
| 进度只存上下文 | 中断后不知道下了多少,只能重来 | 状态落盘,重启先读盘 |
不探 Range 就续传 |
对端不支持时静默从头下 | 先探 206 再决定策略 |
| 假设清单永远不变 | 远端换了文件,本地拼出混版 | 比对 fileSize + updatedDateTime |
三条:
- 下载任务的正确姿势是「先算账,再动手」。 清单把总量、单卷大小、校验和都给了,把这些读进来看一遍,比下载完之后再发现问题便宜得多。
- 断点续传解决的是「不要重复劳动」,不解决「数据对不对」。 这两件事要分开做,前者靠
Range,后者靠sha256。 - Agent 的长任务里,能落盘的都别放上下文。 判断力是稀缺资源,进度、字节数、校验结果这些纯数据,交给磁盘比交给模型可靠。
本文只做公开数据的接入与传输实测,不涉及任何法律意见或 HR 合规判断。 全部数字可按文中代码复现。
8. 参考链接
- https://resource.data.one.gov.hk/doj/data/hkel_list_c_all_en.xml
- https://resource.data.one.gov.hk/doj/data/hkel_c_leg_cap_1_cap_300_en.zip
- https://resource.data.one.gov.hk/doj/data/hkel_c_instruments_en.zip
原创声明:本文为原创内容,数据来自香港律政司 e-Legislation 开放数据,代码可直接运行验证,转载请注明出处。
关注不迷路:后续会继续用 Python 拆解香港的公开数据源,把「接口看着规整、跑起来全是坑」的部分一个个写清楚。