大模型很聪明,但它通常不知道企业内部文档,也不知道刚刚更新的业务规则。
如果直接问模型:
公司退款需要几天到账?
模型可能根据训练数据猜一个答案,也可能一本正经地编错。
RAG(Retrieval-Augmented Generation,检索增强生成)的作用,就是在模型回答之前,先从企业知识库里找到相关资料,再让模型基于这些资料作答。
可以把它理解成一次"开卷考试":
普通大模型依赖记忆答题;RAG 先帮模型翻书,再让模型根据找到的内容答题。
一句话理解 RAG
RAG 的核心流程是:
text
用户提问
  → 从知识库检索相关资料
  → 筛选出少量可靠原文
  → 将问题和原文一起交给大模型
  → 大模型生成答案
它不是重新训练模型,也不是把整个知识库发送给模型。
RAG 的完整工作流程
RAG 通常分为两个阶段:
- 离线阶段:构建知识库。
- 在线阶段:检索资料并生成答案。
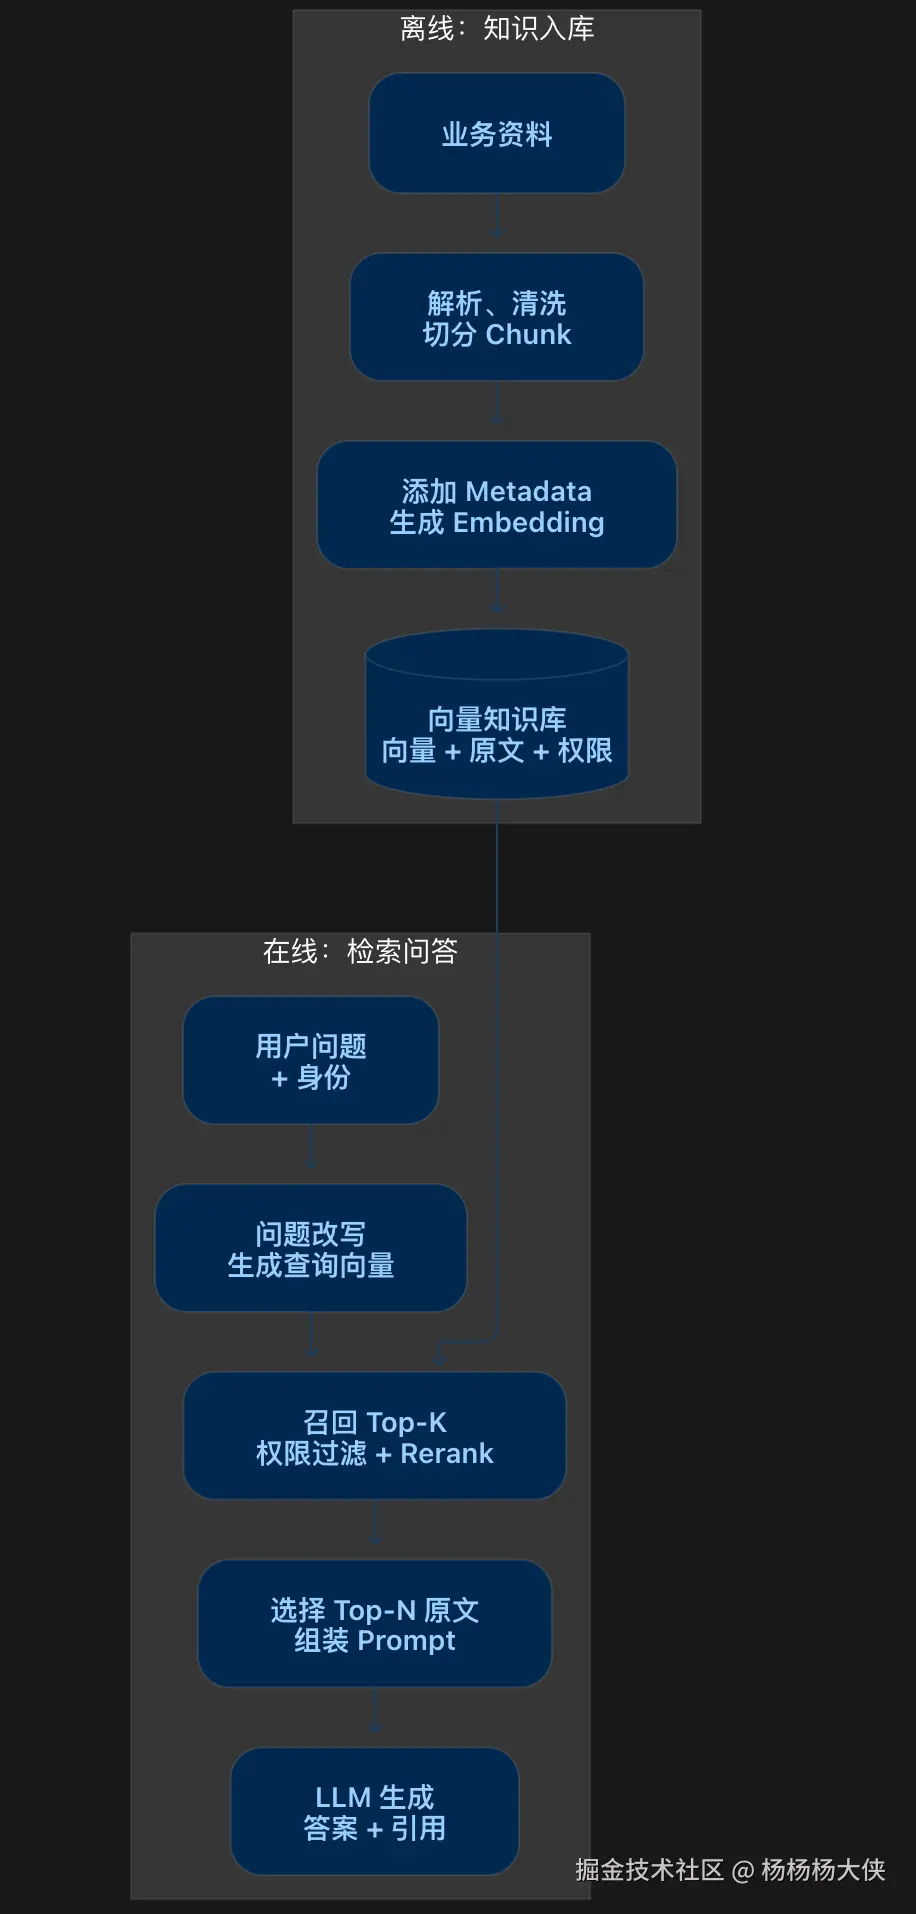
一、离线阶段:知识库是怎么建成的
1. 解析原始资料
企业数据可能来自很多地方:
- PDF、Word、Excel;
- 产品说明和操作手册;
- 内部 Wiki;
- 数据库记录;
- 客服 FAQ;
- 网页和接口。
系统首先需要提取正文、标题、表格和层级关系,同时清除页眉、页脚、导航栏和重复内容等噪声。
如果输入内容本身就是错的,后面的模型再强也没有用。
2. 将长文档切成 Chunk
一份几十页的文档一般不会整体存成一个检索单元,而是拆成多个文本片段,也就是 Chunk。
例如:
text
退款规则.md

Chunk 1:退款申请条件
Chunk 2:退款审核流程
Chunk 3:退款到账时间
Chunk 4:特殊情况处理
切分主要有两个原因:
- 一个问题通常只与文档中的一小部分有关;
- 整篇文档放进模型上下文既浪费 Token,也容易稀释重点。
Chunk 不是越小越好。
切得太小,语义可能不完整;切得太大,又会包含太多无关内容。因此,文档切分策略会直接影响 RAG 的最终效果。
3. 添加 Metadata
除了原文,每个 Chunk 通常还会附带一些元数据:
json
{
  "documentId": "refund-policy-2026",
  "title": "退款到账时间",
  "department": "finance",
  "tenantId": "1001",
  "securityLevel": 2,
  "updatedAt": "2026-09-01"
}
这些信息可以用于:
- 用户权限过滤;
- 租户隔离;
- 按部门检索;
- 排除过期文档;
- 展示答案引用来源。
生产环境中,权限过滤的重要性往往不低于检索准确率。
4. 使用 Embedding 模型生成向量
Embedding 模型会把文本转换成一组数字:
text
"退款一般在 3~5 个工作日到账"
                ↓
[0.018, -0.231, 0.764, ...]
这些数字表达文本的语义特征。
语义相近的内容,在向量空间中的距离通常也比较接近。因此:
text
退款多久到账
退款到账时间
退款几天能收到
虽然文字不同,但它们可能被检索到一起。
需要注意:
Embedding 向量不是答案,也不代表模型已经学会了这段内容。它主要用于查找语义相近的文本。
5. 写入向量数据库
最终保存的通常不只是向量,还包括:
text
向量
+ 原始文本或文本 ID
+ 文档来源
+ 权限信息
+ 其他 Metadata
至此,离线知识库准备完成。
二、在线阶段:用户提问后发生了什么
假设用户提出问题:
退款需要多久才能到账?
1. 客户端只负责提交问题
客户端一般只提交:
json
{
  "question": "退款需要多久才能到账?",
  "conversationId": "c-123"
}
同时携带用户登录凭证。
客户端不应该:
- 下载整个知识库;
- 自己过滤知识库内容;
- 保存模型或知识库密钥;
- 决定用户是否有权查看某份文档。
这些工作应当在服务端完成。
2. 服务端处理问题
RAG 后端收到问题后,可能先进行:
- 错别字修正;
- 指代消解;
- 多轮对话补全;
- 查询改写;
- 关键词提取;
- 租户和用户权限解析。
例如,用户追问:
那节假日呢?
系统可能结合上一轮对话,将它改写为:
退款在节假日期间需要多久才能到账?
3. 将问题转换成查询向量
系统使用 Embedding 模型,把问题转换成查询向量:
text
"退款需要多久才能到账?"
              ↓
Query Embedding
然后使用查询向量搜索知识库中距离较近的文档向量。
4. 召回候选资料
向量数据库可能返回:
text
0.92  退款一般在 3~5 个工作日到账
0.86  节假日期间退款可能顺延
0.78  退款申请提交后进入审核
0.61  发票通常在订单完成后开具
这个阶段通常会适当多取一些候选资料,例如 Top-K 取 20 条。
原因是初次向量检索强调"不要漏掉",后面还可以继续筛选。
有些系统还会同时执行关键词检索:
text
向量检索:擅长语义相近
关键词检索:擅长编号、名称和专业术语
两种结果合并后,就是混合检索。
三、相似度不会直接生成答案
这是 RAG 中最容易误解的地方。
相似度的作用是:
决定哪些资料更值得交给大模型阅读。
它并不直接决定最终答案怎么写。
text
相似度检索
  → 选择参考资料

大模型
  → 阅读参考资料并生成答案
例如相似度是 0.92,并不意味着模型按照 92% 的权重生成某句话。
这个分数主要用于候选资料的筛选和排序。最终答案仍然由大模型根据 Prompt,逐个预测 Token 生成。
四、为什么还需要过滤和 Rerank
向量检索速度快,但初次返回的内容不一定足够准确。
因此,候选资料通常还要经过几层处理。
权限过滤
系统需要根据当前用户身份过滤资料:
text
用户所属租户必须匹配
用户部门必须具备访问权限
文档安全等级不能超过用户等级
权限过滤必须在资料发送给模型之前完成。
否则,即使最终页面没有展示敏感引用,敏感内容也可能已经被发送给模型。
Metadata 过滤
系统还可以限定:
- 只检索当前产品;
- 只检索已经生效的规则;
- 排除过期文档;
- 只查询指定业务类型。
Rerank 重排
Rerank 模型会把用户问题和每个候选片段放在一起,重新判断相关性。
典型流程如下:
text
向量数据库快速召回 20 条
        ↓
Rerank 精确重新排序
        ↓
选择最终 3~5 条
可以把向量检索理解为初筛,把 Rerank 理解为复筛。
五、最终发送给大模型的是什么
系统不会把整个向量数据库发送给模型。
一般只会发送:
- 系统回答规则;
- 用户问题;
- 筛选出的少量原文;
- 必要的对话历史。
例如:
text
系统规则:
你只能根据参考资料回答。
如果参考资料不足,请明确回答无法确定。
回答时标注资料编号,不要自行补充业务规则。

用户问题:
退款需要多久才能到账?

参考资料:
[1] 退款审核通过后,一般在 3~5 个工作日到账。
[2] 如遇法定节假日,到账时间可能顺延。
模型最后生成:
退款审核通过后,一般会在 3~5 个工作日到账;如遇法定节假日,到账时间可能顺延。12
所以更准确的说法是:
服务端先筛选模型需要阅读的资料,模型再根据这些资料组织答案。
六、各个组件分别负责什么
| 组件 | 主要职责 |
|---|---|
| 客户端 | 提交问题、携带用户凭证、展示答案和引用 |
| 业务后端 | 鉴权、检索编排、Prompt 组装和异常处理 |
| Embedding 模型 | 将问题或文档转换为语义向量 |
| 向量数据库 | 快速召回相似的候选资料 |
| Rerank 模型 | 对候选资料进行更精确的重新排序 |
| 大模型 | 阅读最终原文并生成答案 |
简单概括:后端负责调度,向量数据库负责初筛,Rerank 负责精选,大模型负责生成。
如果使用托管 RAG 服务,这些组件可能由一个平台内部完成,但职责边界依然存在。
七、用伪代码看一次完整调用
不考虑具体框架,一次问答大致可以写成:
java
String question = request.question();

// 解析用户、租户和文档权限。
AccessScope scope = permissionService.resolve(request.userId());

// 从知识库中召回较多候选资料。
List<Document> candidates =
        knowledgeBase.search(question, scope, 20);

// 删除无权限、已过期或者分数过低的资料。
List<Document> filtered =
        documentFilter.filter(candidates, scope);

// 对候选资料重新排序,并取最终五条。
List<Document> context =
        reranker.rerank(question, filtered).stream()
                .limit(5)
                .toList();

// 没有可靠资料时停止回答,避免模型猜测。
if (context.isEmpty()) {
    return "现有资料不足,暂时无法确定。";
}

// 将规则、问题和原文组装成 Prompt。
Prompt prompt = promptBuilder.build(question, context);

// 调用大模型生成最终答案。
String answer = chatModel.generate(prompt);

// 返回答案以及对应的文档来源。
return responseBuilder.build(answer, context);
这段代码体现了 RAG 的本质:
text
Retrieve:检索资料
Augment:把资料加入上下文
Generate:模型生成答案
八、RAG 最容易出问题的地方
1. 文档切分不合理
如果标题和正文被拆开,或者一个业务规则被切成几个不完整片段,检索结果即使相似,也可能无法回答问题。
2. 只使用向量相似度
专有名词、错误码、订单号和精确编号通常更适合关键词检索。因此,生产系统经常使用混合检索。
3. 没有权限过滤
如果只追求召回率,没有把用户权限带入检索条件,就可能产生越权访问和数据泄露。
4. 检索多少内容都交给模型
内容太少可能漏掉答案,内容太多则会增加成本、延迟和干扰信息。
Top-K 和最终 Top-N 应通过测试集评估,而不是随便设置。
5. 没有拒答机制
资料不足时仍然强制模型回答,很容易产生幻觉。
一个可靠的 RAG 系统应该允许回答:
根据当前知识库资料无法确定。
6. 知识库没有及时更新
RAG 能读取新知识,不代表它会自动知道知识已经变化。
文档新增、修改或者删除后,需要同步更新索引。
7. 不记录检索过程
出现错误时,需要知道:
- 用户原始问题是什么;
- 改写后的查询是什么;
- 召回了哪些片段;
- 每条资料的分数是多少;
- 最终给模型发送了什么;
- 模型引用了哪些资料。
否则很难判断问题究竟出在检索阶段,还是生成阶段。
九、如何评价一个 RAG 系统
RAG 不能只看"回答听起来是否自然"。
至少需要分开评估三个方面。
检索质量
- 正确资料是否被召回;
- 无关资料是否过多;
- 正确资料的排名是否足够靠前;
- 权限过滤是否正确。
生成质量
- 答案是否得到参考资料支持;
- 是否添加了资料中不存在的内容;
- 引用是否准确;
- 资料不足时是否正确拒答。
工程指标
- 接口耗时;
- 模型 Token 消耗;
- 知识库和模型调用成功率;
- 超时、降级和重试情况。
检索错误和生成错误必须分开定位。模型答错了,不一定是模型能力不足,也可能是系统根本没有给它正确资料。
总结
RAG 并不是一个神秘的新模型,它是一套"检索、上下文组装、模型生成"的工程流程。
完整链路可以归纳为:
text
文档解析
  → 文本切分
  → Embedding
  → 向量入库
  → 用户提问
  → 相似度召回
  → 权限过滤
  → Rerank
  → 选择少量原文
  → 组装 Prompt
  → 大模型生成
  → 返回答案和引用
其中最重要的几个边界是:
- 客户端只提交问题,不负责过滤知识库;
- 相似度负责选择资料,不直接生成答案;
- 模型只接收筛选后的少量原文,不会读取整个向量数据库;
- RAG 后端负责鉴权、检索编排、上下文组装和异常处理;
- 资料不足时,可靠的系统应该拒绝猜测。
下一篇进入代码层面:
《知识库已经有了,Java 程序员还要做什么?Spring AI 实战》