Agentic 设计模式详解
作者:Elcker
项目地址:www.axxiu.cn/project/N6R...
版本:Ynuo v0.3.6
前言 Ynuo Agent 的快速上手
1.1 环境要求
- Node.js >= 22.13.0
- npm(或 pnpm / yarn)
- 操作系统:Windows / macOS / Linux
1.2 安装
bash
npm install -g @ynuo/ai安装成功后,全局会有一个 ynuo 命令。
1.3 启动
bash
# 前台模式(开发调试用,终端关闭服务即停)
ynuo

# 守护模式(推荐日常使用,后台常驻,崩溃自动重启)
ynuo daemon

# 停止守护进程
ynuo stop
首次启动会进入初始化引导,按提示创建管理员账号即可。
1.4 访问
打开浏览器访问 http://localhost:2609,进入 Web IDE。
写在前面
先交代一下我为什么写这篇东西,以及我打算怎么讲。
过去这段时间,我在 ynuo 里搭 Agent 运行时,从最朴素的一次 LLM 调用,一路做到带工具、带规划、带子智能体的完整循环。过程中我踩了不少坑,也反复琢磨一个问题:为什么同样的模型,有人搭出来稳,有人搭出来飘? 我慢慢意识到,差别不在"用了多强的模型",而在用什么样的结构去组织模型的思考和行动------这些结构,就是本文要讲的"Agentic 设计模式"。
我的写法约定如下,先说好,免得你读到一半觉得跳跃:
- 结合实际经验。凡是我给出建议、判断、或"踩坑提醒"的地方,那是我个人的实践结论,你尽可以结合自己的场景取舍;凡是引用论文或框架结论的地方,我会点明出处。
- 每个模式我都按同一套骨架讲:含义 → 介绍 → 解决的问题 → 交互图 → 场景实例。这样你可以横向对照,也可以直接跳读你关心的那一节。
- 我不会把模式吹成银弹 。每一种模式我都明确写了"什么时候值得用、什么时候是负资产"。我的核心立场是 Anthropic 那八个字:先用最简单的方案。
一句话总纲 :模式是正交的、可组合的。一个"协调者 + 子智能体"系统里,每个子智能体内部完全可以跑 ReAct + 工具使用 + 反思。你真正要做的,不是"选一个模式",而是按问题形状,把合适的几块拼起来。
一、整体目录
本文档采用"一个模式,五个固定小节"的局部结构,让每个模式都能横向对照。每个模式(第 2--8 章)内部都按下面这张表组织:
| 小节 | 我讲什么 |
|---|---|
| 含义 | 一句话把它定义清楚,再点出关键特征,划清它的边界 |
| 介绍 | 思想的来源、我认可的典型代表、它到底怎么工作 |
| 解决的问题 | 它针对哪些痛点、什么条件下才值得上 |
| 交互图 | 用 Mermaid 画出控制流 / 时序,让你"看"懂它 |
| 场景实例 | 给一个贴近生产的例子(含伪代码或对话轨迹),最后补一句"我什么时候会放弃它" |
1. 整体介绍
1.1 先对齐一下:什么是 Agentic 系统
我习惯把"Agentic"(智能体式)理解为一件事:由大语言模型驱动、能自主感知环境、制定计划、调用工具,并和外部世界交互来达成目标的系统。
它和"一问一答"的普通对话模型最大的区别,在于闭环。普通模型是"你说一句,它答一句",答完就停;Agentic 系统会自己决定"下一步该干嘛",干完看看结果,结果不好就调整,直到把事办成。
业界对"Agent"的界定其实不太统一,但有个拆解我特别认同,是 Lilian Weng 2023 年那篇博客里提的:
Agent = LLM + 规划(Planning)+ 记忆(Memory)+ 工具使用(Tool Use) 或者 Agent = LLM + Harness
我的理解是:LLM 是大脑,负责推理和拍板;规划负责把目标拆成步骤;记忆存上下文和过往经验;工具让模型真正能"动手"改世界。这四个件凑齐,一个 Agent 才算"立得住"。
1.2 一个我觉得最重要的区分:工作流 vs Agent
Anthropic 在工程实践里做了个区分,我认为是理解本文所有模式的"总纲",必须放在最前面:
- 工作流(Workflow) :LLM 和工具由写死的代码路径编排,控制流是开发者提前定好的。
- Agent :LLM 自己掌控流程和工具,控制流是模型运行时现做的。
为什么我要强调这个?因为它直接决定了成本和风险:每多一次 LLM 自主决策,就多一份延迟、成本,也多一份出错的可能。 工作流的失败能定位到具体某一步,Agent 的失败可能要翻一整条轨迹。所以我的习惯是:能用工作流解决的任务,绝不轻易上自主 Agent。
本文第 2--7 章讲的"基础能力模式",大多能在单个 Agent 内部 用;第 8 章讲的"多智能体拓扑",则是多个 Agent 之间怎么组织。
1.3 我把模式分成两层
为了讲得清楚,我把要讨论的模式分成两层。你可以把它理解成"个人能力"和"团队协作":
| 层 | 关注什么 | 本文对应模式 |
|---|---|---|
| 基础能力模式 | 一个 Agent 内部怎么想、怎么做、怎么纠错 | 反思、规划、工具使用、ReAct、人在回路 |
| 多智能体拓扑模式 | 多个 Agent 之间怎么分工、怎么交接控制权 | 单一、顺序、并行、循环与评审、协调者与子智能体 |
再提醒一次:这两层不是二选一。一个"协调者 - 子智能体"系统里的每个子智能体,内部完全可以跑 ReAct + 工具 + 反思。模式是正交的、可拼的------这正是 Agentic 设计最有趣、也最容易翻车的地方。
1.4 为什么要"模式化"?
有人可能会问:这些不就是提示词技巧吗,至于起这么多名字?我的回答是,命名本身就有价值:
- 省沟通成本。跟同事说"这里用 ReAct 循环",比说"让它边想边做边看结果"精确得多,也少扯皮。
- 给了选型锚点。每种模式都对应一组明确的适用条件和代价(延迟、成本、可预测性)。所谓选型,本质就是"选形状"。
- 沉淀可复用构件。这些模式在 LangGraph、OpenAI Agents SDK、CrewAI 这些框架里,基本都是能直接拖出来的原语。
1.5 一张全景对照表(阅读地图)
下面这张表是我给每个模式贴的"标签",先给你方向感。每个模式到底适用/不适用在哪,我会在各自的"解决的问题"小节里讲透:
| 模式 | 层 | 控制流来自谁 | 核心动作 | 我最常踩的代价 |
|---|---|---|---|---|
| 反思 Reflection | 基础 | 模型自评 | 批判 → 修正 | 多花一轮 LLM 调用 |
| 规划 Planning | 基础 | 模型先规划 | 分解 → 执行 | 计划与实际执行漂移 |
| 工具使用 Tool Use | 基础 | 模型调工具 | 调用 → 观察 | 参数校验、安全 |
| ReAct | 基础 | 模型循环 | 思考→行动→观察 | 多轮延迟/成本 |
| 多 Agent 协作 | 拓扑 | 多个模型分工 | 角色协同 | 通信 / 协调开销 |
| 人在回路 HITL | 横切 | 人 + 模型 | 审批 / 干预 | 人工响应延迟 |
| 单一 / 顺序 / 并行 / 循环评审 / 协调者 | 拓扑 | 见第 8 章 | 见第 8 章 | 见第 8 章 |
接下来我会一个模式一个模式地讲。建议你带着两个问题读:"这个问题我的场景里有吗?""代价我付得起吗?" 付不起就别上,这不是抠,是工程判断。
2. 反思 Reflection
2.1 含义
我先给一个我自己的理解:反思就是让 Agent 回头批判自己刚做的事,然后把"哪里错了、为什么错、下次怎么办"写成一段话,用来指导下一轮------而不是傻乎乎地原地重试。
它有三个我认为是本质的特征:
- 反馈被语言化。环境或评估器给的多半是个冷冰冰的信号------单测挂 2 条、打分 0.6、报个错。反思要做的,是把这堆信号翻译成人话:"边界条件 x=0 没处理,入口得加空值判断。"
- 经验能攒下来。这段反思文本我会存进一个缓冲区(论文里叫情景记忆),下一次尝试时塞回上下文。于是"试错 → 反思 → 改进"就成了一个螺旋,而不是一锤子买卖。
- 不动模型权重。改进发生在提示词层面,不是重新训练。这点很重要------它是反思区别于传统强化学习的关键,也是它能"少样本就见效"的原因。
2.2 介绍
反思的思想根源,我一直觉得就是人类的元认知:写完作文回读一遍、写完代码自己审一遍,这种"检查自己的检查"的习惯。把这套习惯显式地交给 LLM,反思就出来了。
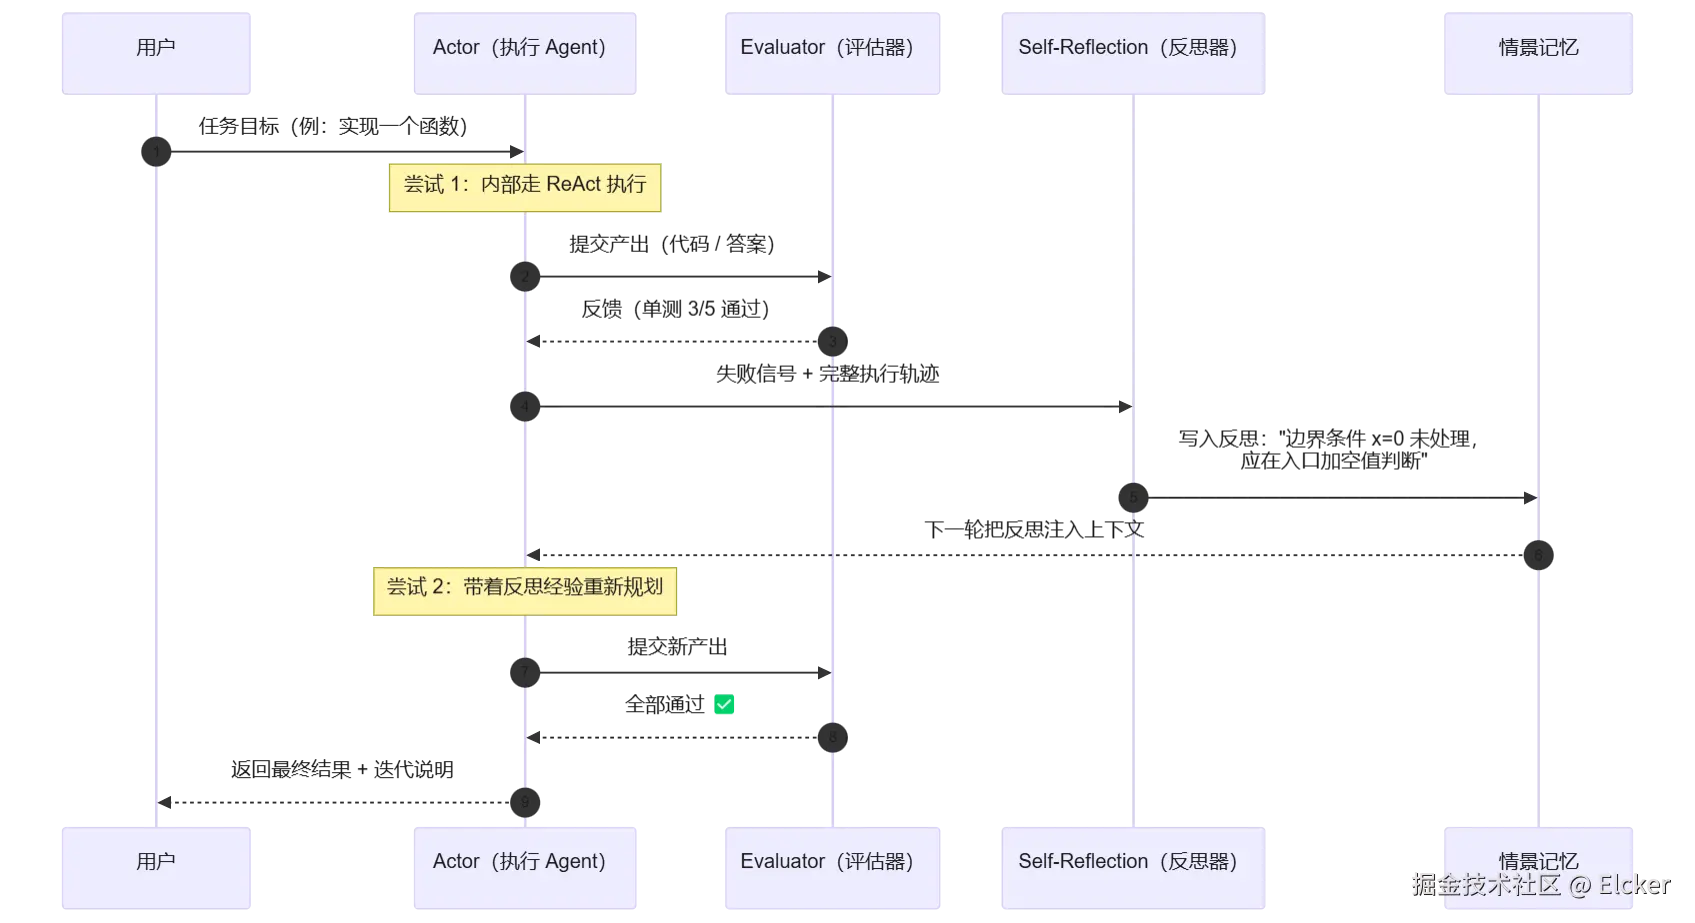
真正把它系统化的是 Reflexion (Shinn et al., 2023)。我读这篇论文时的印象很深,它干了一件反直觉的事:不更新权重,纯靠语言反思来"强化"------让 Agent 把任务反馈翻成语言,存进记忆,引导后续尝试。结果在 HumanEval 编程基准上跑到 91% pass@1,压过了当时 80% 的 GPT-4。它的三个组件我也基本照搬进自己的设计:
- Actor:干活的,产出一条执行轨迹(通常内部就是 ReAct 或 Plan-and-Execute);
- Evaluator:打分/判对错的,信号可以来自环境、自写单测,或另一个 LLM;
- Self-Reflection:把失败原因写成语言总结,写进记忆,供下一轮注入。
按"谁来评估",我把它分成三类,你对照着看:
| 类型 | 谁来评 | 信号从哪来 | 我见过的典型场景 |
|---|---|---|---|
| 自我反思 | 同一个模型 | 自审 + 环境反馈 | 代码自审("再读一遍刚才的输出") |
| 独立评估者 | 另一个 LLM(Critic) | 按 rubric 打分 | 文案质量评审、答案事实核验 |
| 外部信号 | 环境 / 程序 | 单测、编译器、搜索命中 | 单测失败驱动的代码修复 |
这里我得先把它和第 8.4 节的"循环与评审(Loop & Critic)"划清界限,免得你混。Loop & Critic 讲的是拓扑------生成器和评审者怎么转这个圈;反思讲的是学习------评审的结论怎么沉淀成下次能复用的语言经验。 一个管流程,一个管沉淀,别当成一回事。
2.3 解决的问题
我列几个我真实碰到过的痛点,以及反思是怎么帮我缓的:
| 痛点 | 我观察到的效果 |
|---|---|
| 单次生成不稳定。模型一口气给的方案可能是错的,但"错在哪"其实能从反馈里推出来 | 把反馈显式翻成改进方向,第二轮的起点肉眼可见地抬高 |
| 传统 RL 太贵。试错学习要海量样本 + 微调,LLM 场景玩不起 | 语言化反思在上下文层面就把"学习"做完了,few-shot 就生效 |
| 错误传播。长链条里早期一个小错,后面全被放大 | 在关键节点插反思检查点,早一点纠偏 |
| 模型爱"自信地犯错"。它经常给自己打满分 | 上一个独立 Critic 提供外部视角,打破"自己夸自己" |
什么条件才值得上 :任务得可评估------得有单测、有 rubric、有环境反馈,或者至少能被另一个模型判断。如果输出完全没法评估(比如纯审美的开放创作),纯反思收益有限,这时候我更倾向把它接进人在回路。
2.4 交互图
以 Reflexion 我常用的一轮循环为例(执行 → 评估 → 反思 → 带着记忆重试):
2.5 场景实例
举个我自己在编码 Agent 上跑过的例子。需求是实现 parse_ip_range(把 "10.0.0.0/24" 解析成地址列表)。
轨迹(两轮反思):
text
── 尝试 1 ──────────────────────────────────────────────
Thought: 把 /24 当前缀长度,用位运算算地址范围。
Code:    start = base; end = base + (1 << (32 - prefix)); ...
单测:    ✗ test_single_ip   (prefix=32 时 1<<0=1,多算了一个地址)
         ✗ test_invalid     (prefix=0 时没校验,返回了 42 亿条)

── 反思(Self-Reflection 生成的那段话)─────────────────
"两次失败都卡在边界:prefix=32 时范围应是 1 个地址而不是 2 个;
 prefix=0 属非法输入,应该直接抛错,别返回整个地址空间。
 下一轮:先做输入校验,再按 (2**(32-prefix)) 精确算,特判 prefix=32。"

── 尝试 2(把反思注入后)───────────────────────────────
Code:    if prefix > 32: raise ValueError(...)
         count = 1 << (32 - prefix)   # prefix=32 → 1
单测:    ✓ 全部通过
我的一点体会 :反思器并没有重新发明算法,它干的是信用分配(credit assignment)------指出错在哪一步、为什么错、下一步改什么。这段语言结论我存下来之后,同类任务下次执行能直接命中经验,不至于再摔一次同一个跟头。
我什么时候会放弃它:如果任务是"写一段品牌 slogan"这种没有客观对错的开放创作,Reflexion 那套"环境反馈"根本不存在。这时候我会改走第 8.4 节的 LLM-as-a-Judge 评审循环,或者干脆把"自评 + 修改"直接写进提示词("请自评并润色三遍"),没必要上记忆缓冲和多轮重放那套重家伙。
3. 规划 Planning
3.1 含义
我对规划的理解很朴素:先想清楚"要做哪几步、什么顺序、每步产出什么",再按计划动手,中途发现偏了就修计划------把复杂目标拆成可管理的步骤序列,而不是拿到目标就一头扎进去。
三个我认为是规划"成立"的特征:
- 先规划后执行(或者边规划边执行)。把"目标"翻译成一个可验证的子任务清单。
- 计划是一等公民。计划本身是数据结构(列表、树、图),能存、能传、能改、能回滚------不是脑子里一闪而过的念头。
- 动态可修订。执行中发现偏差,允许重新分解、插步骤、回退分支,而不是死板地执行旧计划。
3.2 介绍
规划其实是认知科学里最老的研究主题之一(Newell & Simon 那个"问题空间搜索"),在 LLM Agent 里它演化出好几种我常用到的形态:
| 形态 | 怎么工作 | 我认的代表 |
|---|---|---|
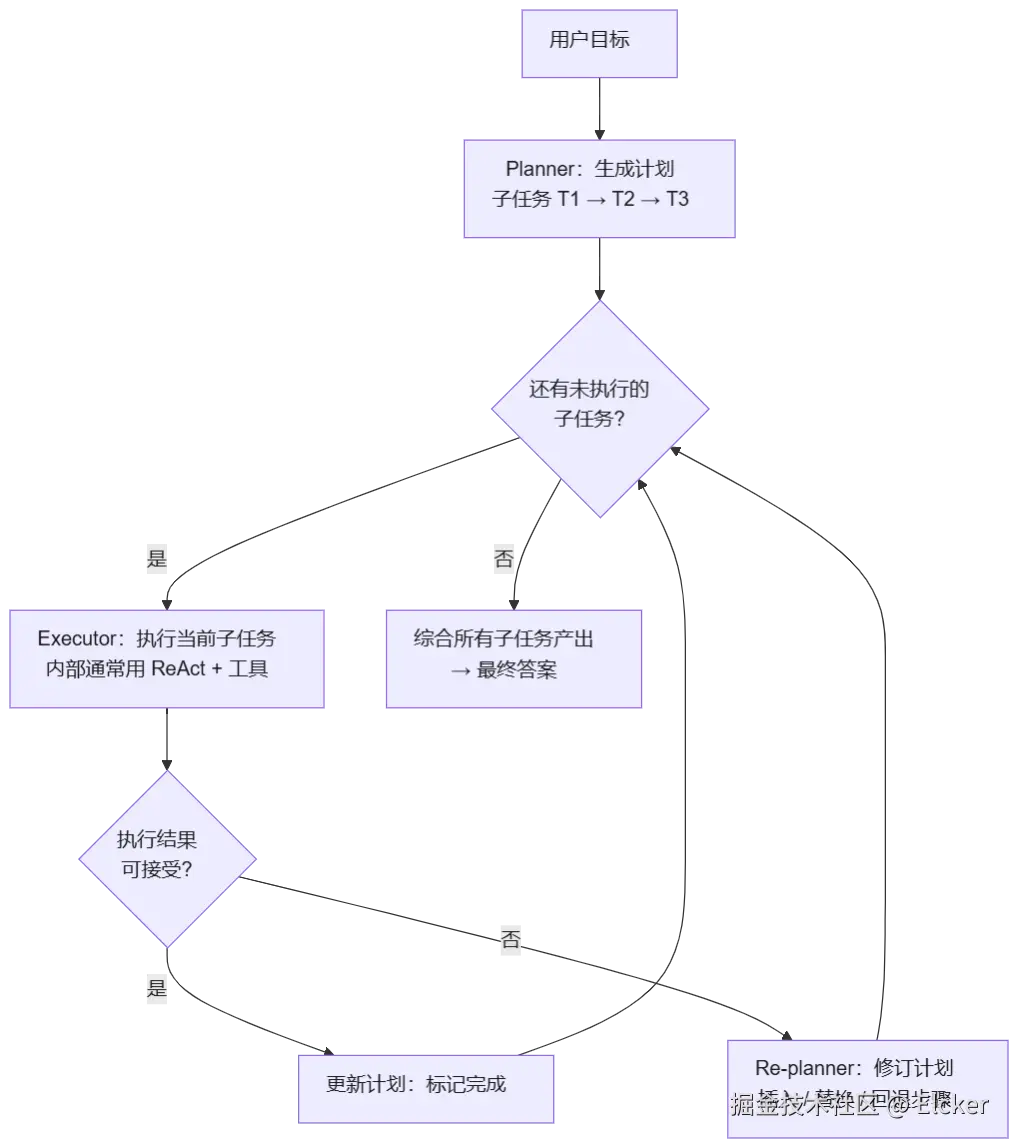
| Plan-and-Execute | 先让 LLM 出完整计划,执行器逐步跑完;失败可重规划 | LangChain Plan-and-Execute、HuggingGPT |
| 任务分解 | 把目标递归拆成子任务,子任务能并行能串行 | BabyAGI、TaskWeaver |
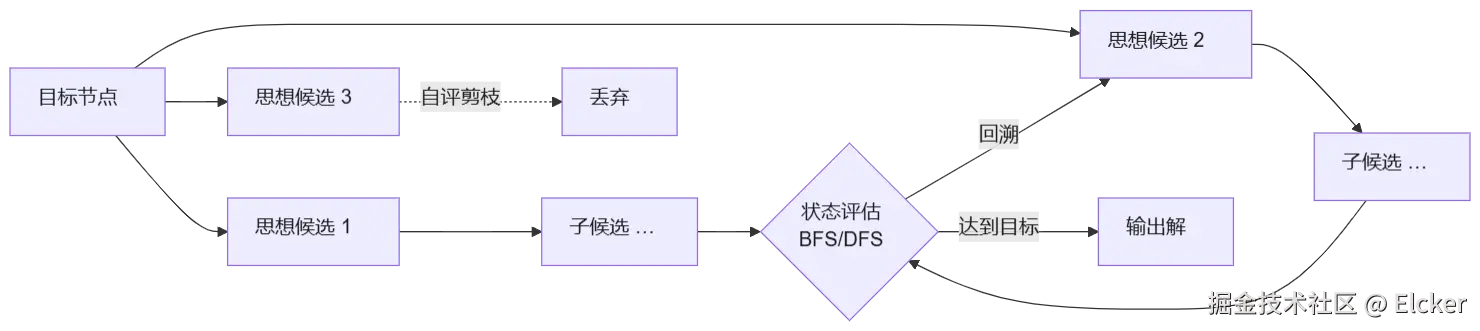
| 思维树 ToT | 把推理建模成树:每步生成多个候选"思想",LLM 自评打分,再 BFS/DFS 搜索 + 回溯 | ToT(Yao et al., 2023):Game of 24 从 CoT 的 4% 提到 74% |
| 分层规划 | 高层 Agent 定战略,低层 Agent 定战术,逐级细化 | 协调者-子智能体里的"规划职责下放" |
规划 vs ReAct,这是我见过最常被搞混的一对,我用一句话给你掰开:
- ReAct 是"微观"------每一步怎么想、怎么做,是步级循环;
- Planning 是"宏观"------整体要分几步、什么顺序,是全局结构。
实践里我几乎总是把它俩组合用:Plan 定骨架,ReAct 填肉。 规划给出步骤清单,执行每个步骤时内部跑 ReAct。
3.3 解决的问题
| 痛点 | 规划怎么救场 |
|---|---|
| 复杂目标撑爆单次上下文。一次性让模型做"调研+设计+编码+测试"必然顾此失彼 | 拆成子任务,每个子任务只盯局部上下文 |
| "走一步看一步"易偏航。即时反应式 Agent 在长任务里会丢目标感 | 显式计划当"锚",每步执行完对照计划校准 |
| 多步依赖管理。哪些必须串行、哪些能并行,模型自己容易搞乱 | 计划显式表达依赖(DAG),调度器据此并行化 |
| 失败难定位。长链条出错不知道错在哪一步 | 子任务粒度化后,失败能定位到具体步骤,局部重规划 |
| 需要前瞻和回溯。有些任务早期决策决定成败(解谜类) | ToT 的树搜索支持 lookahead 和 backtracking |
什么时候值得上 :任务步骤多、步骤之间有依赖,或者存在"早期决策影响全局"的结构。单步能干完的活,规划纯属浪费。我的经验法则是步骤 ≥ 3 且步骤间有依赖时,规划才开始回本。
3.4 交互图
Plan-and-Execute 的标准循环(规划 → 逐步执行 → 必要时重规划),这是我画得最多的一张:
再给一张 ToT 的树搜索视角(同一任务的"搜索过程"长这样):
3.5 场景实例
给个我设计过的例子。用户要"把这份 200 页 PDF 报告总结成 10 分钟演讲稿"。
Planner 的输出(计划就是数据结构,不是我脑子里的念头):
json
{
  "goal": "200 页 PDF → 10 分钟演讲稿",
  "steps": [
    { "id": 1, "task": "解析 PDF,抽取目录与章节摘要", "deps": [] },
    { "id": 2, "task": "识别 3-5 个核心论点", "deps": [1] },
    { "id": 3, "task": "按 10 分钟时长分配各节篇幅(≈150 字/分钟)", "deps": [2] },
    { "id": 4, "task": "撰写演讲稿初稿", "deps": [3] },
    { "id": 5, "task": "反思校对:时长是否超标、论点是否完整", "deps": [4] }
  ]
}执行轨迹(节选):
text
Step 1 完成:抽出 8 个章节摘要(耗时 40s,调了 6 次 PDF 工具)
Step 2 完成:核心论点 = [论点A, 论点B, 论点C]
Step 3 偏差:模型初稿 2400 字(超时了)
  → Re-plan:把论点B的展开砍掉,改一句带过;重新分配篇幅
Step 4 完成:新初稿 1500 字
Step 5 反思:✓ 时长 9.8 分钟,论点覆盖 3/3,交付
我为什么信这套 :规划把"做什么"和"怎么做"解耦了------Executor 只操心"当前这一步",Planner 只在偏差出现时才插手。这正是 Plan-and-Execute 能稳扎稳打处理长任务的结构原因:偏差被锁死在单个子任务里,不会污染全局。
我什么时候会放弃它 :用户问"北京今天气温多少"------单步就能干完,规划纯添乱、纯花钱。这种时候直接"单 Agent + 一次工具调用"就完事。记住我那条线:步骤 ≥ 3 且有依赖,规划才值得。
4. 工具使用 Tool Use
4.1 含义
我的一句话定义:工具使用就是让 Agent 借助外部工具(代码解释器、搜索、API、数据库、文件、浏览器......)去拿它拿不到的信息、干它干不了的事。 在我看来,这是 Agent 从"一个封闭的文本生成器"变成"一个能在开放世界里动手的行动者"的分水岭,没有它就没有真正的 Agentic。
三个我认为必须刻在脑子里的特征:
- 工具就是一个受控的副作用接口 。每个工具都是"输入 schema → 执行 → 输出"的契约化函数。模型只负责"选哪个、传什么参数",不负责"怎么执行"------执行那摊事是框架和工具实现的事。
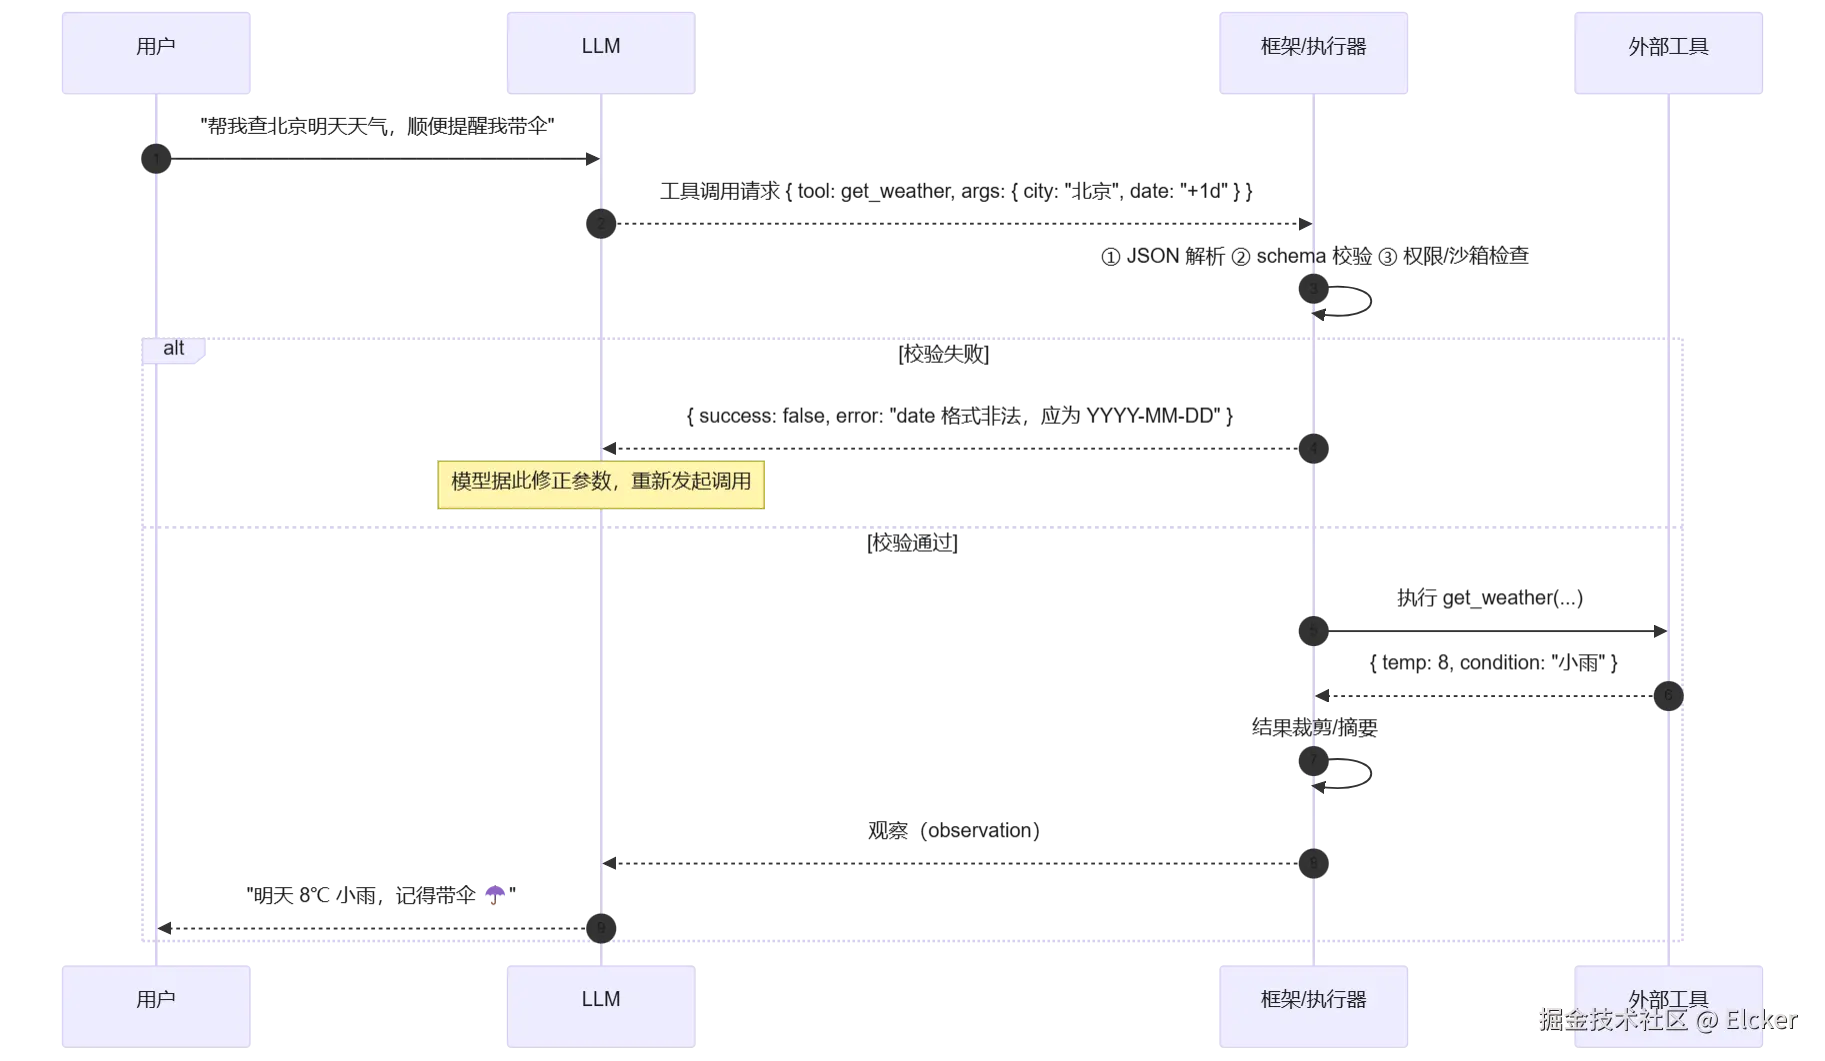
- 模型给的参数是不可信输入 。这是我从安全角度反复强调的一点:模型产出的工具参数,必须当成用户输入那样校验(先
JSON.parse,再按 schema 校验,最后才执行)。模型会被提示注入带偏,参数是它最容易被"污染"的地方。 - 可观测、可审计。每次调用(工具名、参数、结果、耗时)我都记下来,为的是调试和人在回路审批。一个查无实据的工具调用,等于没有。
4.2 介绍
技术底座就是各家模型厂商的 Function Calling / Tool Use API :我用 JSON Schema 把工具描述清楚(名字、描述、参数),模型在回复里嵌入一个结构化的"工具调用请求",框架执行完再把结果灌回上下文。Anthropic 把"带增强的 LLM(retrieval + tools + memory)"当成 Agentic 系统的基本积木------后面的 ReAct、规划、多 Agent,全建在它上面。
工具工程(Tool Engineering)上,我给自己定了几条硬约束,基本来自 OpenAI Agents 这类生产实践的教训:
| 约束 | 我的理解 |
|---|---|
| 描述要精确 | 描述决定模型"选得对不对"。写"获取数据"会招来误选;写"按 ISO 日期区间查订单,返回含状态和金额的列表"才稳 |
| 参数必须校验 | 模型输出是不可信输入:先 JSON.parse,再按 schema 校验,最后才执行 |
| 失败要结构化回传 | 工具报错时返回 { success: false, error: "..." },别崩掉------模型靠这个信息去重试、换路、或向用户解释 |
| 结果要裁剪 | 别把整张表、整个 API 响应塞回上下文;摘要或截断,否则上下文窗口直接淹死 |
| 循环要设上限 | 带步数上限的工具循环,是防"无限 API 调用 + 成本失控"的保险丝 |
| 沙箱隔离 | 涉及代码执行的工具必须在沙箱里跑,防止参数注入升级成代码执行(prompt injection → RCE) |
按用途,我一般把工具分成四类(最后一类尤其要小心,它是第 7 章人在回路的主战场):
| 类别 | 例子 | 我警惕的风险 |
|---|---|---|
| 信息检索 | 搜索、网页抓取、RAG | 结果不可信(可能含注入) |
| 计算与代码 | 代码解释器、Python 沙箱 | 任意代码执行 |
| 系统操作 | 文件读写、Shell、Git | 越权、破坏性命令 |
| 业务 API | 下单、转账、发消息 | 不可逆副作用 |
划个重点:工具使用管"能做什么",人在回路管"做之前要不要问人"。最后那类"不可逆副作用"工具,正是 HITL 的用武之地,两章是配套的。
4.3 解决的问题
| 痛点 | 工具怎么用 |
|---|---|
| 知识有保质期。LLM 训练有截止日,不知道"今天/此刻" | 搜索、API 工具接实时数据 |
| 算不准。LLM 做长算术、精确计算容易翻车 | 代码解释器给确定性结果 |
| 没手。纯文本模型没法"真的"发消息、改文件 | 工具把"说"变成"做" |
| 上下文装不下整个知识库 | 检索工具按需取回相关片段(RAG 本质就是"检索工具") |
| 不懂内部系统。模型不知道某内部系统怎么调 | 封装成工具后,模型只管按 schema 用 |
什么时候值得上 :任务需要模型能力边界之外 的信息或动作。如果纯靠对话 + 模型知识就能解决,引入工具只会多延迟、多成本、多攻击面。我的默认策略是**"能不调工具就不调"**(就是 tool_choice: auto 那个语义)。
4.4 交互图
一次工具调用的完整时序(含校验和失败恢复),这是我排查工具问题时最常对照的图:
4.5 场景实例
拿一个客服 Agent 里最典型的危险动作举例:"取消订单 #4521"。这是不可逆副作用,我的定义和防御长这样:
typescript
const cancelOrder = tool({
  name: "cancel_order",
  // 这段描述是给模型看的:必须精确,否则模型会选错工具/传错参数
  description: "取消一笔已支付的客户订单。不可逆。仅在用户明确确认后调用。",
  parameters: z.object({
    orderId: z.number().describe("订单号,如 4521"),
    reason:  z.enum(["user_requested", "out_of_stock", "fraud_suspect"])
  }),
  // 副作用工具:挂"需人工审批"标记(详见第 7 章)
  needsApproval: true,
  execute: async ({ orderId, reason }) => {
    // 执行器已经校验过参数;这里只关心业务逻辑
    await orders.markCancelled(orderId, reason)
    return { success: true, message: `订单 ${orderId} 已取消` }
  }
})一次带审批的完整轨迹:
text
用户: "我买错了,把订单 4521 退了吧"
模型 → 工具: { tool: cancel_order, args: { orderId: 4521, reason: "user_requested" } }
框架:   参数校验 ✓ → needsApproval → 生成审批中断,暂停执行
人工:   审批通过
框架:   执行 cancel_order → { success: true }
模型 → 用户: "已为您取消订单 4521,退款将在 3-5 个工作日到账。"
我的体会 :工具使用把"取消订单"这件危险的事,收敛进了一个有 schema、有审计、有审批钩子 的接口里。没有工具化之前,"模型说了一句'已取消'用户就信了";工具化之后,"说"必须跟着"做",而且每一步可回放。这是 Agentic 系统可信度的结构基础------我把这点看得比模型选型还重。
我什么时候会放弃它 :回答"什么是量子纠缠"这种纯知识问题,调工具纯属浪费。判断标准很简单:模型是缺信息(→ 检索类工具)还是缺动作能力(→ 操作类工具),两样都不缺就别调。
5. ReAct 推理-行动
5.1 含义
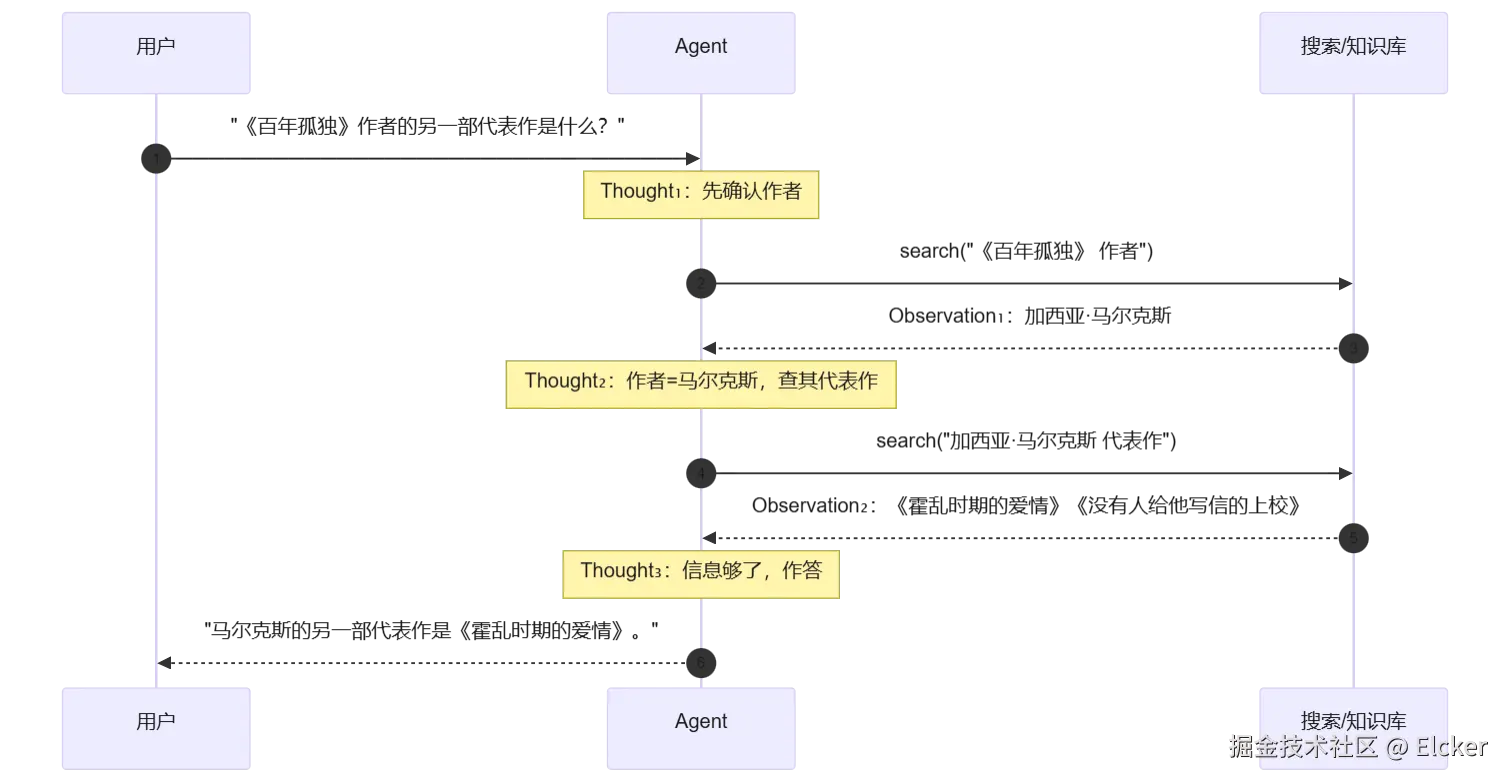
我给 ReAct 的定义:一个把"推理"和"行动"交织在一起的循环框架 ------Agent 反复走 思考(Thought)→ 行动(Action)→ 观察(Observation):先分析要干啥,再决定选哪个工具、传什么参数,然后拿到工具返回的结果,如此循环,直到攒够信息满足用户请求。
说白了,它就是把"模型会想"和"模型会做"这两件事交替编织在一条轨迹里。在我眼里,这是当代 Agent 运行时最底层的内循环------ynuo 的 Agent 循环内核,本质就是 ReAct。
5.2 介绍
ReAct 是 Yao et al.(2022)提的。它最戳中我的洞察是:推理(chain-of-thought)和行动(调工具)过去是分开的两条线,但它们其实是互补的------
- Reason to Act:推理轨迹帮模型归纳、追踪、更新行动计划,还能处理异常;
- Act to Reason:行动让模型从外部(知识库、环境)拿到新信息,反过来喂给推理。
论文里那个形式化我记到现在:ReAct 把动作空间扩展成 Â = A ∪ L(A 是工具动作,L 是语言空间)。L 里的"thought"不动外部环境、不产生观察,只更新内部上下文;A 里的动作会改环境、产生 observation。两者交错出现,就拼成一条人类看得懂的解题轨迹------这一点是我特别看重的,因为它直接对接了"可解释"和"人在回路"。
ReAct 相对两个"半吊子"基线的优势(论文实测,我也复现过类似的差距):
| 基线 | 毛病 | ReAct 怎么补 |
|---|---|---|
| 纯 CoT(只推理) | 拿不到外部信息 → 幻觉 + 错误传播 | 用工具取回真实信息支撑推理 |
| 纯 Act(只行动) | 没计划 → 容易原地打转、盲目尝试 | 推理轨迹给方向,动态改道 |
实测成绩:HotpotQA / Fever 上缓解幻觉;ALFWorld / WebShop 上比模仿学习/强化学习分别高出 34% / 10% 的绝对成功率。
ReAct vs Function Calling ,这俩我也常被问,我这样分:Function Calling 是执行机制,ReAct 是控制流描述。 现代框架里 ReAct 的"Action"往往直接落地成一次工具调用,"Thought"就是工具调用之间那段推理文本。
5.3 解决的问题
| 痛点 | ReAct 怎么解 |
|---|---|
| 长链条信息不够。单轮推理拿不到"下一步该查啥"的依据 | 每步观察结果喂给下一步推理,闭环 |
| 幻觉。模型编造不存在的事实 | 关键事实从工具取回,推理有据可依 |
| 计划僵化。预先写死的计划扛不住意外 | 每步重新思考,可动态改道 |
| 黑盒不可复盘。决策过程没留痕 | 思考轨迹全程可查,人能审查、能介入(接 HITL) |
| 跨多轮交互才能办成(订票、操作网页) | 循环到终止条件满足,天然支持长交互 |
什么时候值得上 :任务一步到不了位,需要"边查边做边调"。如果答案在模型知识里,或一次工具调用就够,ReAct 多轮的开销不划算------退化成"单 Agent + 单次工具调用"。
5.4 交互图
ReAct 内循环(思考→行动→观察,到终止为止):

再给一张"查事实并核验"的时序展开:
5.5 场景实例
给个我印象深的一个。用户问"对比 A 框架和 B 框架在 v2 之后的性能差异"(要实时资料 + 多步核验)。
典型轨迹(Thought/Action/Observation 交错):
text
Thought₁: 我得分别查 A 框架 v2 和 B 框架 v2 的官方 benchmark,<br/>再找一份第三方对比。
Action₁:  search("A framework v2 benchmark")
Observation₁: 官方页面给 throughput 提升 40%,但样本量没写。

Thought₂: 官方数据偏乐观,我得找第三方交叉验证。
Action₂:  search("A vs B v2 independent benchmark")
Observation₂: 第三方报告显示 A 在大 batch 下领先,小 batch 下 B 更优。

Thought₃: 两个来源不一致,得搞清楚条件差异。再查一次 A 的测试设置。
Action₃:  fetch("A v2 benchmark methodology")
Observation₃: 官方是单卡、batch=256;第三方是多卡、batch=8。

Thought₄: 信息够了。差异主要来自测试条件,不是绝对性能。
Final Answer: 综合来看......(给条件化结论 + 引用来源)
我为什么觉得它比"纯工具调用"强 :ReAct 的价值不在"每步都答对",而在每步都可审计、可纠偏------你看 Thought₂ 里那句"官方数据偏乐观,我得交叉验证",这是元判断,是纯 Function Calling(只有调用没有思考文本)和纯 CoT(没有外部信息)都给不出来的。
我什么时候会放弃它:用户问"1+1 等于几"------Thought/Action/Observation 走三轮纯属浪费。ReAct 的触发条件应该是**"信息或动作一步到不了位"**;单步能到的,直接答。实践里我会加一个"先判断要不要用工具"的轻路由(思路见第 8.2 节的顺序模式)来避免无谓循环。
6. 多 Agent 协作 Multi-Agent Collaboration
6.1 含义
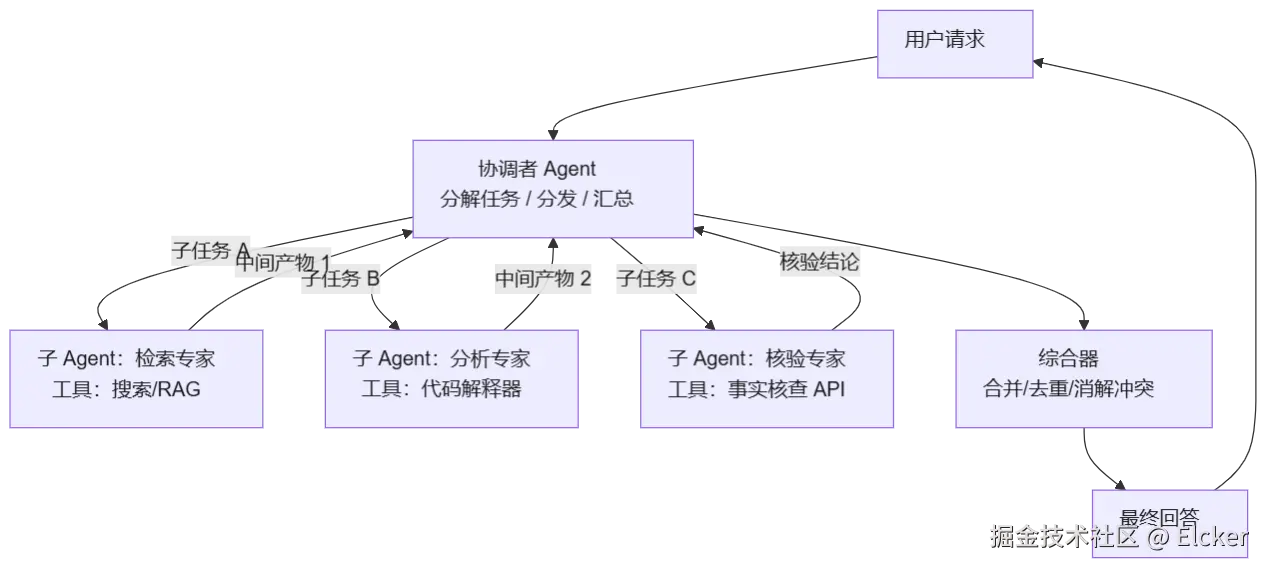
我的一句话定义:让多个专业化 Agent 一起把一个复杂问题干完------把大任务拆给各自有独立角色、独立提示词、独立工具集的子 Agent,它们之间靠消息、共享状态或控制权交接来通信,通常还有一个"领导者/协调者" Agent 负责分发和汇总。
三个我认为构成"多 Agent"的特征(缺一个我就觉得只是"多段提示词"而非真正的多 Agent):
- 角色专业化。每个子 Agent 的 System Prompt、工具、上下文互相隔离,只擅长一件事。我一直信奉"窄而精的提示词 > 大而全的提示词"。
- 通信有边界 。子 Agent 之间不共享完整上下文,只交换必要的中间产物。这既省 token,又降低串扰------一个子 Agent 跑偏不会带崩全局。
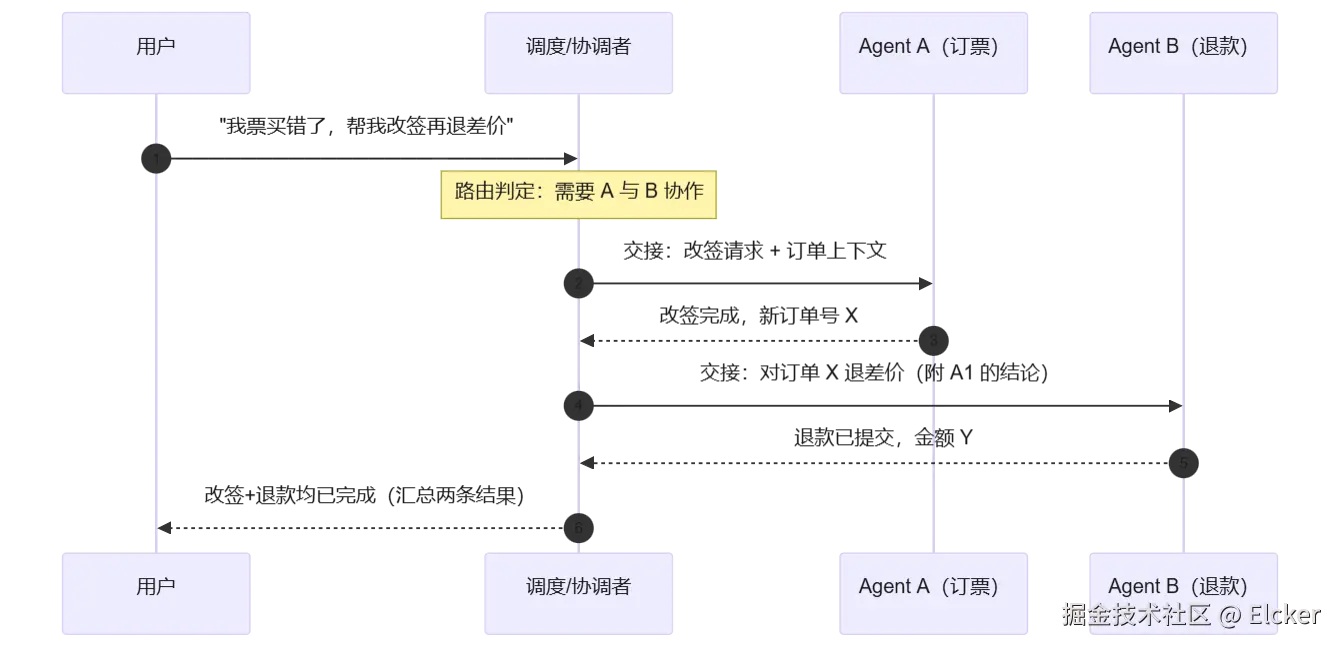
- 控制权显式流转。谁激活谁、何时交接、谁对最终结果负责,由拓扑(第 8 章)定义清楚,而不是模型自己瞎转。
6.2 介绍
多 Agent 的思想源头是经典多智能体系统(MAS),LLM 时代被"让模型扮角色 + 互相对话"这个玩法复活了。我比较看好的几个代表作:
| 工作 | 核心机制 | 给我的启发 |
|---|---|---|
| ChatDev(2023) | 模拟一家软件公司:CEO、产品经理、程序员、测试员等角色,按"瀑布式"阶段协作开发 | 角色分工 + 阶段化交接 |
| MetaGPT(2023) | 把 SOP 编码进提示词,"Code = SOP(Team)",各角色产出结构化产物(PRD→设计→代码→测试) | 用流程纪律约束 Agent 的自由发挥 |
| CAMEL(2023) | 两个 Agent(AI User + AI Assistant)角色扮演对话,自主推进任务 | "角色对"是最小协作单元 |
| Generative Agents(Stanford, 2023) | 25 个 Agent 在虚拟小镇生活,靠记忆+反思+规划支撑涌现行为 | 记忆和反思是长期协作的地基 |
Anthropic 和 LangChain 的生产实践给了我多 Agent 化的三个正当动机(少一个我就不建议拆):
- 上下文隔离:单 Agent 塞不下所有领域的指令和工具,拆开后每个 Agent 的上下文是"干净"且专注的。
- 工程模块化:独立 Agent 容易单独更新、评估、维护和并行------像微服务之于单体。
- 组织边界:不同团队各开发各的 Agent,天然就是多 Agent 架构。
但代价我必须摊开说(LangChain 在 τ-bench 上的实测,我认这个结论):
- 传话损耗(telephone game):协调者架构里子 Agent 不能直接回用户,所有信息经协调者"转述",每转一次就多一分失真 + 多一分 token。
- 成本和延迟上升:每个 Agent 都是一次独立的 LLM 调用,多 Agent 总成本 ≈ 子 Agent 数 × 单 Agent 成本。
- 协调复杂度:交接时机、失败重试、死锁检测都得显式设计。
所以我的立场和 Anthropic 那八个字一致:先用最简单的方案。 从单 Agent 起步,等它明显不够用了,再拆。拆多 Agent 不是"显得高级",是解决"上下文/质量/并行/组织边界"某个具体瓶颈的手段。
6.3 解决的问题
| 痛点 | 多 Agent 怎么解 |
|---|---|
| 单一上下文装不下。多领域指令 + 多工具 + 长历史互相污染 | 每个子 Agent 只装自己领域的指令和工具,上下文干净 |
| 单一提示词顾此失彼。一个 Prompt 既要会写又要会测还要会审 | 角色专业化,每个 Agent 的 System Prompt 窄而精 |
| 要并行提速。独立子任务串行太慢 | 并行 Agent 同时跑(见 8.3) |
| 要独立评估视角。自己查不出自己的错 | 评审 Agent / Critic Agent 提供外部视角(见 8.4) |
| 组织/团队边界。各团队各管各的能力 | 每个团队交付一个 Agent,用协作拓扑集成 |
什么时候值得上 :任务能干净地 沿角色/领域切开,并且单 Agent 的上下文或质量瓶颈已经被证实。如果任务本质是"一个角色的连续工作"(比如一个程序员连续编码),硬拆多 Agent 只会白付协调税。
6.4 交互图
以"协调者 + 专业化子 Agent"为骨架的通用协作图(具体拓扑第 8 章展开):
再给一张控制权交接(handoff)视角:
6.5 场景实例
拿一个企业知识助手的例子,我设计时拆成过这种结构。用户问:"我们 Q2 的海外营收为什么比预期低了 15%?"
这问题横跨三个领域(财务数据、市场动态、内部决策记录),单 Agent 的上下文会被三类工具和指令污染。我于是拆成三个专家 + 一个协调者:
| Agent | 角色 | 工具 | 上下文只装 |
|---|---|---|---|
| 协调者 | 分解问题、汇总答案 | 无(纯路由) | 用户问题 + 各子 Agent 结论 |
| 财务 Agent | 拉 Q2 分区域营收 | 数仓查询 API | 财务指标定义 + 查询模板 |
| 市场 Agent | 检索海外竞品/宏观动态 | 搜索 + 新闻 RAG | 市场分析报告模板 |
| 内部 Agent | 检索内部决策/会议纪要 | 内部知识库 RAG | 会议/决策检索模板 |
协作轨迹:
text
协调者: 分解为 ① 分区域营收对比 ② 海外市场环境变化 ③ 内部相关决策
财务 Agent → 协调者: 东南亚营收 -22%,北美持平;汇率贡献 -3pct
市场 Agent → 协调者: 东南亚竞品 4 月降价 10%;当地 5 月有政策收紧
内部 Agent → 协调者: Q1 决议"Q2 收缩东南亚投放"(会议纪要 #8821)
协调者 → 用户: 综合三方面:汇率(-3pct)+ 竞品降价 + 主动收缩投放,
               共同导致东南亚 -22% 拖累整体 -15%。建议复核投放策略......
我设计时的关键点 :三个专家 Agent 交给协调者的是结构化结论 (不是各自的全量原始数据),协调者只做"合并 + 消解冲突",不做重新分析------否则协调者会膨胀成"上帝 Agent",token 成本也压不住。
我什么时候会放弃它:任务只是"查一下某客户的订单状态",单 Agent + 一个订单工具就够。多 Agent 的引入门槛,必须是**"上下文/质量/并行/组织边界"四者之一被单 Agent 顶到天花板**,而且能用清晰的子任务边界表达。
7. 人在回路 Human-in-the-Loop
7.1 含义
我的一句话定义:在 Agent 的决策或执行链路里显式插入人类节点,让人能对 Agent 的行为进行反馈、修正与审批。 它不是一个"模式"而是一个横切机制------可以叠在 ReAct 循环上、叠在多 Agent 拓扑上、叠在任何有副作用的动作前面。
三个我认为定义 HITL 的特征:
- 暂停与恢复 。Agent 跑到需要人拍板的点时停下来 ,把"我打算做什么、为什么"呈给人;人做完决定后,Agent 从原地恢复,而不是从头再来。
- 人是决策者之一,不是旁观者。人不是"看看日志",而是真的能改变走向------批准、拒绝、修改参数、改目标。
- 有边界、有范围 。不是每一步都问人(那就退化成纯人工操作了),只在高风险、不可逆、低置信的节点介入。
7.2 介绍
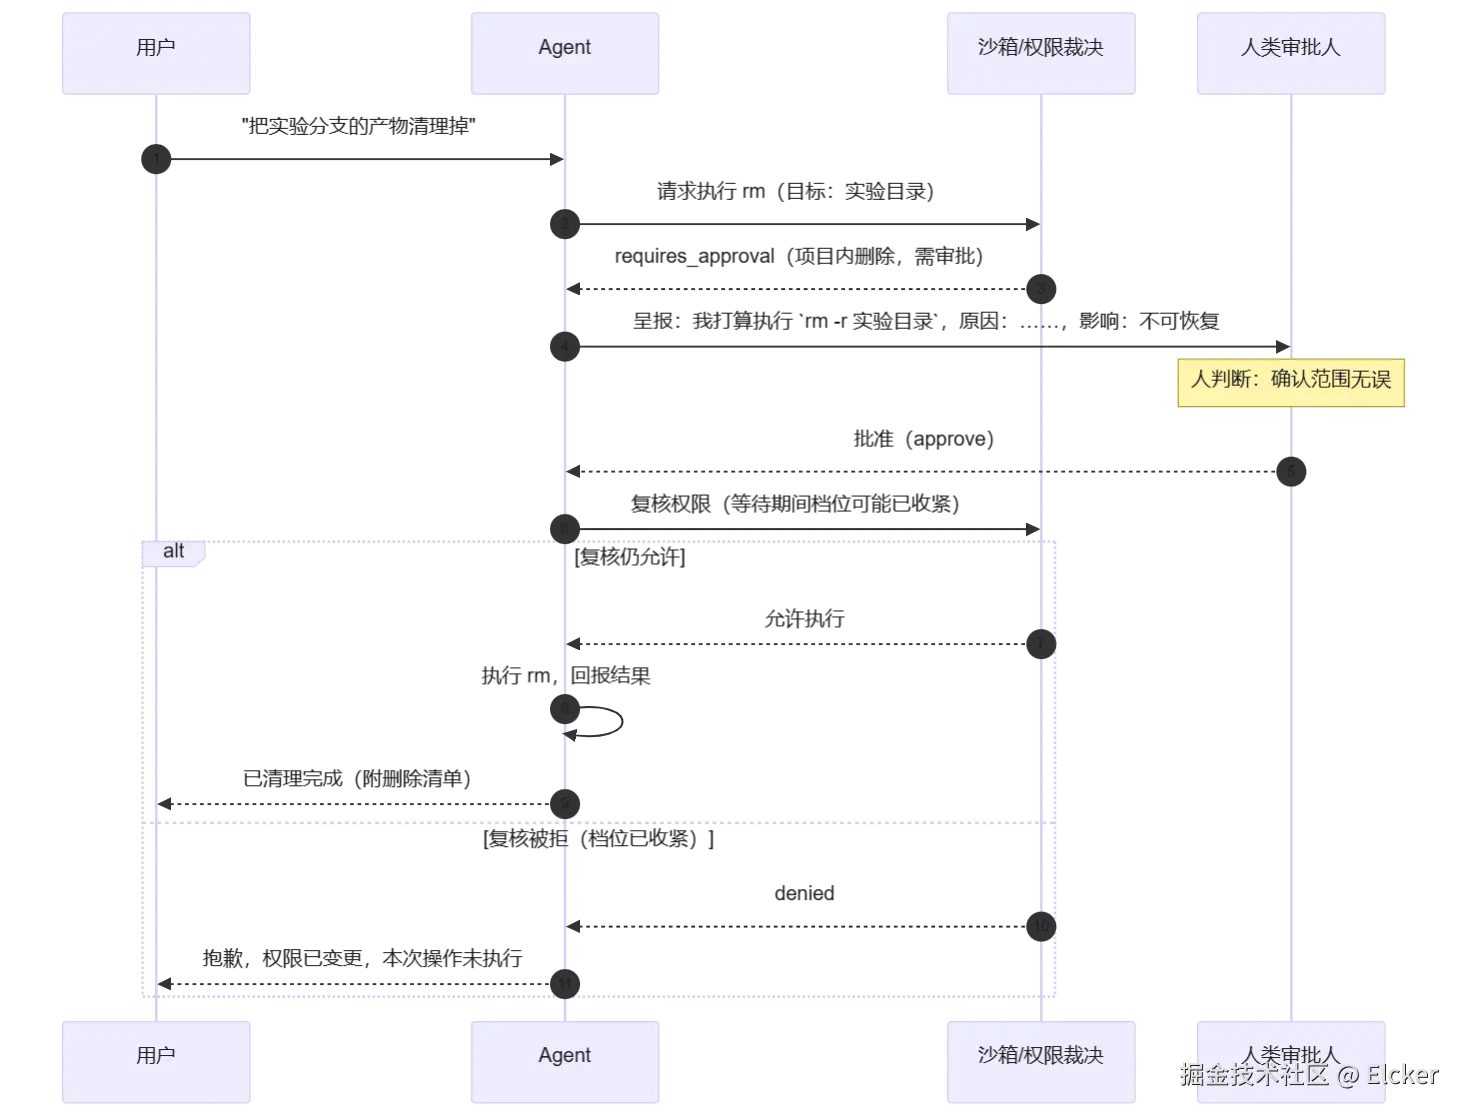
人在回路的思想最早来自控制论和自动驾驶(人在环上 on-the-loop、人在环内 in-the-loop 的区分)。在 Agentic 系统里,它的落地形态主要是审批中断(approval interruption)------OpenAI Agents SDK 把这套流程标准化成了四步,我基本照搬:
- Agent 跑到一个需要审批的工具调用时,不执行,而是记录一个"审批中断";
- 运行结果返回
interruptions列表 + 一个可恢复的 state; - 人(或策略引擎)对挂起项逐一审批:通过 / 拒绝 / 修改参数;
- 从
state恢复同一次运行,而不是开一轮新对话。
这里有个我特别强调的细节:审批通过之后,执行前还要复核一次权限。 因为从"人点通过"到"工具真正执行"之间有时间差,这期间权限档位可能已经被收紧(比如用户从"项目可写"切回了"只读")。不复核就执行,等于审批形同虚设。这也是 ynuo 沙箱里的硬规则。
HITL 的介入点,我一般分四个层次(风险从低到高):
| 层次 | 介入点 | 例子 |
|---|---|---|
| 目标层 | 开始前确认任务理解 | "我理解你要......对吗?" |
| 计划层 | 执行前审计划 | 展示计划,人可增删步骤 |
| 动作层 | 副作用前审批 | 取消订单、删文件、发外部消息 |
| 输出层 | 交付前审结果 | 对外文案、邮件发送前过目 |
一个反直觉的提醒 :HITL 不等于"更安全"。把每一步都抛给人审,人会陷入"审批疲劳"------开始认真看,三分钟后变成无脑点通过,看起来更安全,实际上更危险 。正确的做法是只审真正不可逆的动作,其余交给沙箱和护栏自动裁决,把人的注意力花在刀刃上。
7.3 解决的问题
| 痛点 | HITL 怎么解 |
|---|---|
| 不可逆副作用。Agent 一旦执行无法撤销(转账、删库、对外发布) | 动作层审批:执行前必须人点头 |
| 低置信决策。模型自己也拿不准(置信度低、多解并存) | 把候选方案摆给人,人拍板,而非模型硬猜 |
| 目标歧义。用户一句话可能有多重解读 | 目标层确认,避免"方向对了但理解错了" |
| 信任建立期。新系统/新 Agent 还没建立信任 | 初期多介入,随可靠度上升逐步放权(分级自治) |
| 合规与审计。某些操作按制度必须留人审记录 | 审批中断天然就是审计日志 |
什么时候值得上 :动作不可逆 、风险高 、或模型置信度低。反过来,高频、可逆、低风险的内部操作(读文件、查数据),引入 HITL 只会拖慢效率、引发审批疲劳------这类应该交给沙箱自动裁决。
7.4 交互图
以"动作层审批"为例(审批中断 + 恢复 + 复核):
7.5 场景实例
拿 ynuo 里最典型的一个场景:用户让 Agent 在项目里删一个目录。
完整轨迹:
text
用户: "把 tests/fixtures 里过期的样例清掉"
Agent 内部:
  1. 解析意图 → 调用 bash 工具执行 rm
  2. 沙箱裁决:目标在项目内、是删除操作、档位=project
     → requires_approval(项目内删除不给静默通过)
  3. 生成审批事件,暂停
人工审批界面:
  "Agent 请求执行:rm -r tests/fixtures/old
   影响:删除 12 个文件,不可恢复
   批准 / 拒绝 / 修改参数"
人工: 批准(并顺手把范围改成 tests/fixtures/old/*,保留 .keep)
Agent 内部:
  4. 复核权限(档位仍是 project)→ 允许
  5. 执行修改后的命令
  6. 回报
Agent → 用户: 已按修改后的范围清理 11 个文件(保留 .keep)。我设计这套时的取舍:
- 为什么必须复核:审批等待的几分钟里,用户可能刚把工作空间档位切回 readonly。不复核,"批准"就被架空了。
- 为什么删除不给"自动批准"通道:可逆操作(改文件)我可以容忍 Agent 自己干、事后 git 恢复;删除在版本库外就不可逆,风险不对称。
- 为什么允许人改参数:只给"批准/拒绝"两个按钮,人一旦觉得范围不对就只能全拒、重新描述,效率很低。允许直接改参数,把 HITL 从"闸门"升级成"协作"。
我什么时候会放弃它 :纯只读查询、内部可逆操作、高频低风险动作------这些一律交给沙箱自动裁决。HITL 是给不可逆和风险兜底的,不是给每个动作加一道工序。滥用 HITL 的系统,最终会得到一个"什么都要人点一下"的累赘。
8. 多智能体拓扑模式
这一章我换个角度讲。第 2--7 章讲的是"一个 Agent 内部的能力",这一章讲多个 Agent 摆成什么形状 。我参考了 LangChain 的 benchmark 实践和 Anthropic 的分类,把生产里最常见的五种拓扑整理出来:单一、顺序、并行、循环与评审、协调者与子智能体。
先说清一个前提:拓扑选型的本质是选控制流形状------线性、分叉、环形还是星形。形状决定了三件事:
- 控制流来源:控制权是代码写死的,还是模型现拍的?
- 传话次数:信息要经过几道"转述"?(每次转述都失真 + 花 token)
- 并行度:哪些环节能同时跑?
我还会沿用前面的五小节骨架(含义 / 介绍 / 解决的问题 / 交互图 / 场景实例),但因为是同一章内的对照项,"介绍"部分会和前面章节交叉引用,不重复展开。
8.1 单一智能体 Single Agent
含义
只有一个 Agent 承担全部职责:一个提示词、一套工具、一条上下文,从接收请求到产出结果都由它独立完成(内部可含 ReAct 循环、工具调用、反思)。
它不是"简陋版",而是我强烈主张的默认起点。
介绍
LangChain 在 τ-bench 基准里把单 Agent 当 baseline:一个工具调用 Agent、一个提示词、能访问所有领域的工具和指令。我的实践结论和他们的实验一致------当干扰领域 ≤ 1 时,单 Agent 表现最好且 token 消耗最低;只有当任务横跨多个"互不相关"的领域、上下文开始互相污染时,它才会明显掉链子。
单 Agent 的隐含假设是:任务能被一个"角色"从头干到尾,且全部相关指令装得进上下文。 这两条假设里任何一条破了,才轮到多 Agent 出场。
解决的问题
| 痛点 | 单 Agent 的表现 |
|---|---|
| 任务单一领域、步骤清晰 | 最优解:零协调开销、无传话损耗、易调试 |
| 需要快速迭代提示词 | 改一处提示词即全局生效,不用同步多个 Agent |
| 成本敏感 | 一份上下文、一轮对话,token 消耗最低 |
| 需要审计 | 一条轨迹看全程,失败定位直接 |
交互图
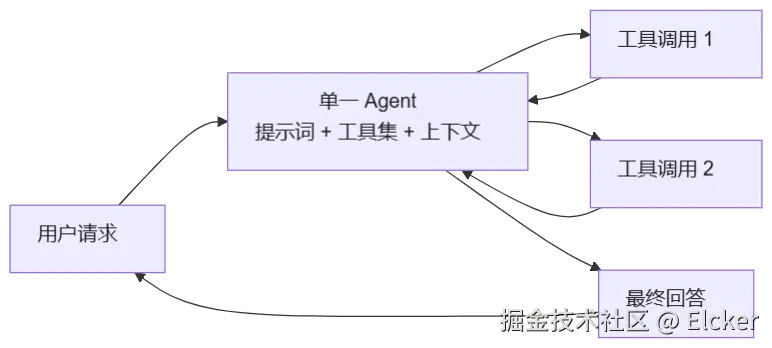
场景实例
场景:代码库问答助手------"这个项目的鉴权是怎么做的?"
text
单 Agent(工具:代码搜索 / 读文件 / grep)
  → 搜索 auth 相关文件 → 读关键实现 → 读中间件链 → 综合作答
我的判断 :这种"一个专家角色 + 一套工具就能贯穿"的任务,上多 Agent 是自我感动。我会先用单 Agent 把它做到"上下文开始打架"为止------表现为:提示词里塞了五个领域的规则、模型开始引用错领域的工具、或者长对话后答非所问。出现这些信号,才去拆。
8.2 顺序智能体 Sequential Agents
含义
多个 Agent 排成一条流水线:上一个 Agent 的产出是下一个 Agent 的输入,控制权沿固定顺序单向流动(A → B → C → 输出)。控制流由代码写死,不靠模型拍板。
这就是 Anthropic 说的 Prompt Chaining(提示词链) :把任务拆成固定子任务序列,每个 LLM 调用处理上一步的输出,中间还可以插程序化校验门(gate)。
介绍
顺序模式的精髓是**"每一步只做一件事,并且把难的任务拆成容易的任务"**------Anthropic 的原话是"用延迟换准确率"。它的两个工程要点:
- 每步之间有 gate:不是无脑传给下一步,而是程序化检查(格式对吗?长度对吗?必要字段有吗?),不达标就地打回,不带错进下游。
- 每步可以换一个"更合适的模型/提示词":抽取步骤用小模型便宜跑,综合步骤用大模型跑------单 Agent 做不到这种"分步配模"。
顺序模式和"规划"的区别要划清:顺序模式的步骤是开发者提前定死的(写死在代码里),规划模式的步骤是模型运行时现拆的。前者可预测、可测试,后者灵活、难保证。
解决的问题
| 痛点 | 顺序模式怎么解 |
|---|---|
| 任务可被干净地拆成固定阶段(翻译、审校、格式化......) | 每阶段一个 Agent,提示词窄而专 |
| 单步输出太长/太复杂,一次生成质量差 | 分步生成,每步只解决一个小问题 |
| 需要中间质量门 | gate 拦截不合格中间产物,防止错误放大 |
| 不同阶段对模型能力要求不同 | 分步配置模型,成本/质量可分别调 |
交互图
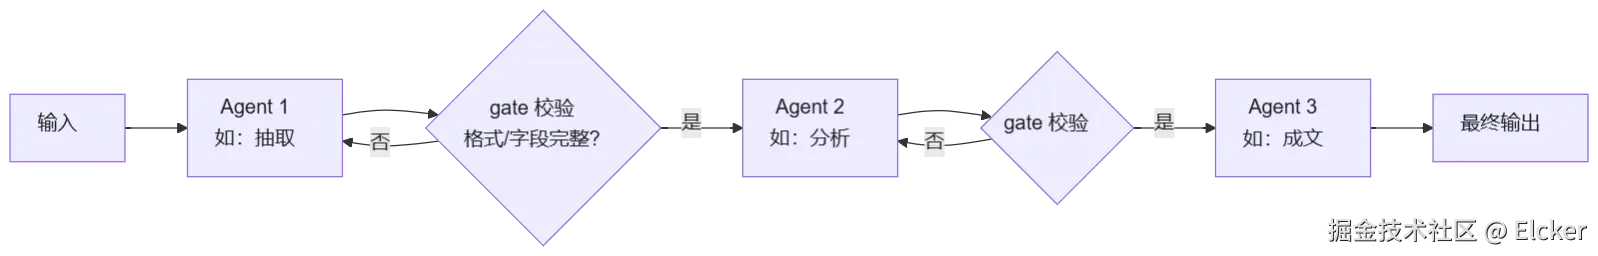
场景实例
场景:多语言技术文档发布流水线(我在 ynuo 的文档处理里用过这个形状):
text
输入:英文 PRD 原文
  Agent 1(翻译,小模型)   → 中文初稿
  gate:段落数一致?术语表命中?
  Agent 2(审校,大模型)   → 修正术语与语病,附修改说明
  gate:修改说明非空且引用了 gate 标记的问题?
  Agent 3(排版,规则为主) → 统一标题层级、代码块格式
输出:可发布中文文档
我的体会 :顺序模式最大的红利是可测试 ------每一步都有确定输入输出,可以单步回归、可以离线评测。它最大的风险是脆弱 :A1 抽错一个字段,后面全白跑,而且 gate 只能查"格式",查不了"语义对不对"。所以我会把语义校验尽量放在最后一步的独立 Agent(评审者),gate 只管结构。
我什么时候会放弃它 :步骤数量或顺序事先说不清的任务("帮我调研竞品"到底要查几家、查多深?)。这种任务用顺序模式要么 gate 全红、要么输出残缺------应该交给第 8.5 节的协调者让模型自己拆。
8.3 并行智能体 Parallel Agents
含义
多个 Agent 同时处理互不依赖的子任务,结果在汇聚点(barrier / synthesizer)合并。它是顺序模式的"分叉版":控制流从一条线变成"一分多、多合一"的扇出-扇入(fan-out / fan-in)。
Anthropic 把它归为 Parallelization,并细分两种变体,我实践里两种都用:
| 变体 | 机制 | 目的 |
|---|---|---|
| 分片并行(Sectioning) | 把任务切成 N 块,N 个 Agent 各干一块 | 提速 + 分治 |
| 投票并行(Voting) | 同一个任务给 N 个 Agent(或同 Agent N 次),取共识 | 提质(用冗余换可靠性) |
介绍
并行模式的工程核心不是"能同时跑",而是汇聚时的冲突处理 。我踩过最深的坑是共享状态:多个子 Agent 同时写同一份状态,如果 reducer 是简单覆盖(=),后写的把先写的踩掉,只留最后一份。LangGraph 里我用 merge_dicts 这类按 key 合并 的 reducer,每个子 Agent 写自己的 key(按子任务 id 命名空间),并行写才不会互相覆盖。这个坑我建议在文档里重点记一下:并行模式的状态设计,决定了它是"真并行"还是"假并行 + 数据丢失"。
第二个工程要点是汇聚点要做消解:N 份结果不是简单拼接,而是要去重、排序、消解矛盾(两个子 Agent 结论相反时怎么办?)。这一步经常是质量的决定性环节。
解决的问题
| 痛点 | 并行模式怎么解 |
|---|---|
| 独立子任务串行太慢 | 同时跑,墙钟时间 ≈ 最慢的一块 |
| 单次生成方差大、想要更稳的结论 | 投票并行:N 次采样取多数/取共识 |
| 任务天然可分片(按文档、按子问题、按地区) | 分片并行,各干各的 |
| 单上下文装不下全部分片 | 每片独立上下文,最后只汇聚"结论" |
适用条件(务必满足) :子任务之间真的无依赖。一旦 B 依赖 A 的产出,就不是并行问题,而是顺序问题------硬并行只会拿到半成品。
交互图
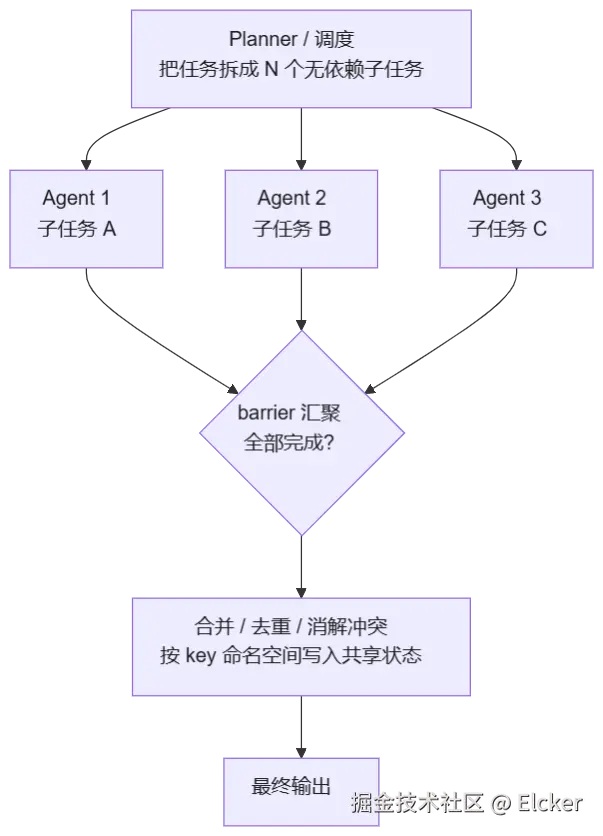
投票变体:
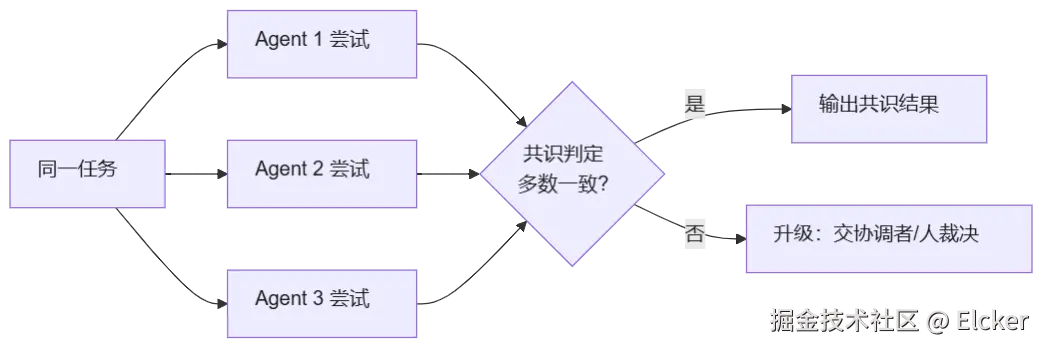
场景实例
场景:深度研究助手,用户问"2025 年主流向量数据库横评"。
text
Planner: 拆成 3 个无依赖子问题 → ① 性能基准 ② 功能特性 ③ 成本与运维
并行:
  Agent 1(性能): 检索并汇总各库 benchmark
  Agent 2(特性): 汇总过滤/稀疏向量/多租户等能力矩阵
  Agent 3(成本): 汇总定价、运维复杂度
汇聚:
  三份结果按子问题 id 写入共享状态(merge_dicts,不互相覆盖)
  综合器:拼成横评表 + 消解矛盾(如 A 库在性能上"第一"与成本"最贵"并存 → 标注为权衡而非矛盾)
输出: 横评报告我的两点经验:
- 投票并行最被低估 。同一个问题让 Agent 跑 3 次取一致结论,在事实类问题上比"换个更强的模型"便宜得多。但注意成本 ×3,只用在高价值 + 高不确定的结论上。
- 汇聚不是免费的。barrier 意味着"最慢的子任务决定整体延迟",而且汇聚逻辑(去重、消解)要单独设计、单独测试------别指望"自动合并"。
我什么时候会放弃它 :子任务之间有依赖、或子任务数量模型自己说不清(那就该用协调者动态拆)。另外,为了"看起来高级"而并行是最常见也最蠢的滥用------两个子任务明明 0.5 秒能串行跑完,硬开并行只多付协调成本。
8.4 循环与评审 Loop & Critic
含义
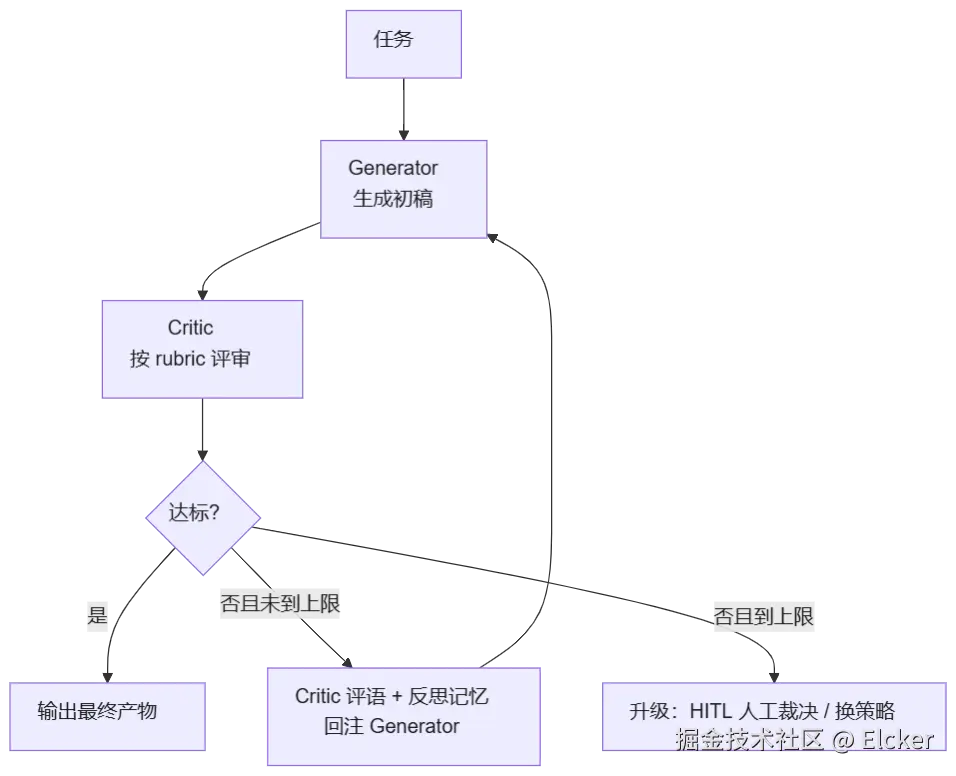
生成器和评审者反复拉锯 :一个 Agent(Generator)产出,另一个 Agent(Critic)按标准评审,不达标就打回重做,循环到质量阈值满足或达到迭代上限。它是"反思"(第 2 章)在拓扑层面的落地------两个独立 Agent 构成的闭环。
Anthropic 称之为 Evaluator-Optimizer:生成器产出,独立评估器批判,循环直到质量阈值通过。
介绍
这个模式的关键是评审标准(rubric)必须先于循环存在 。没有事先写好的评分标准,Critic 就是在"凭感觉挑刺",循环要么永远不收敛(Critic 总能找到新毛病),要么第一轮就放水(Critic 懒得挑)。我的习惯是把 rubric 写成可判定的清单("是否包含 X?引用是否可核验?长度是否在区间内?"),让 Critic 的输出是"通过/不通过 + 理由",而不是一个模糊分数。
两个必须设的刹车:
- 迭代上限:循环必须有 max_rounds,否则就是"无限互怼 + 烧 token"。
- 升级出口 :达到上限仍不达标时,不是死循环,而是升级------交给人(第 7 章 HITL)或交协调者换策略。
Loop & Critic 和第 2 章反思的关系再强调一次:反思管"结论怎么沉淀成经验",Loop & Critic 管"两个 Agent 怎么转这个圈"。生产里我几乎总是两者合用------循环里每轮 Critic 的评语,同时写入反思记忆,下一轮 Generator 带着经验重做。
解决的问题
| 痛点 | 循环评审怎么解 |
|---|---|
| 单次生成质量不稳定 | 评审打回重做,把"一次赌对"变成"迭代到对" |
| 自己查不出自己的错(自我评估偏乐观) | 独立 Critic 提供外部视角 |
| 有明确质量标准的交付物(文案、代码、报告) | rubric 驱动,收敛目标可量化 |
| 需要"交出去之前再把关" | 评审环节即质量门 |
适用条件 :有可判定的质量标准 + 产出值得多轮打磨。标准越模糊,这个循环越难收敛------审美类任务要么先把审美量化成 rubric,要么直接交 HITL。
交互图
场景实例
场景:对外发布的 API 文档生成(我在 ynuo 的文档流水线里用的就是它)。
text
Generator(大模型): 根据代码 + OpenAPI 规范生成接口文档
Critic(另一模型,rubric 驱动):
  - [x] 每个接口都有请求/响应示例?
  - [ ] 示例中的字段名与 schema 完全一致?→ 不通过
  - [x] 错误码覆盖完整?
  评语:"POST /orders 的响应示例里用了 camelCase,schema 是 snake_case,
        请统一;另外缺少 409 冲突场景的示例。"
Generator 第 2 轮: 修正字段命名,补 409 示例
Critic 第 2 轮: 全部通过 ✅ → 输出我的取舍:
- 为什么用两个 Agent 而不是"同一个模型自评":同一个模型自评有个通病------它倾向于认可自己刚写的东西。独立 Critic(哪怕同模型、不同提示词)也会显著更苛刻。这是我实测过的结论。
- 为什么 rubric 必须可判定:模糊的"写得要好一点"会让 Critic 每轮都能挑出新毛病(因为总能找到),循环永不收敛。可判定清单让"达标"成为布尔值。
我什么时候会放弃它:产出本身没有质量标准("随便写点")、或时效性要求极高(等不起两轮 LLM 调用)。这类直接一次生成 + 事后抽检,别上循环。
8.5 协调者与子智能体 Coordinator & Sub-agents
含义
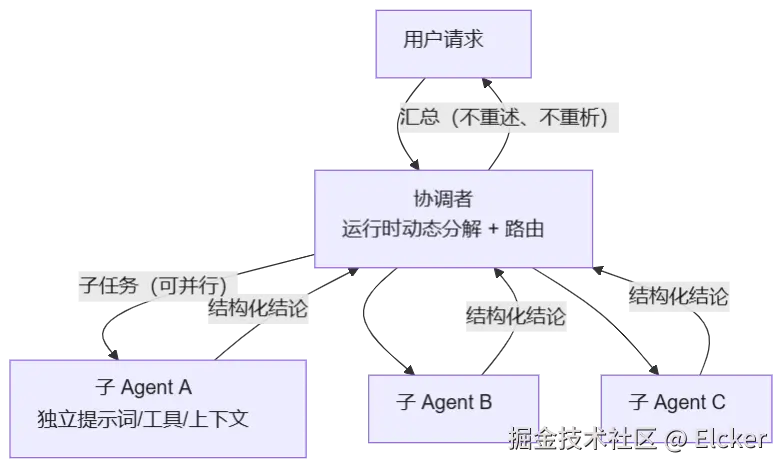
一个协调者 Agent 居中,按运行时需求把子任务动态分发给专业化子 Agent,再汇总结果 ------星形拓扑。它是多 Agent 协作里最常用 的形态,Anthropic 称之为 Orchestrator-Workers ,LangChain 用 langgraph-supervisor 实现。
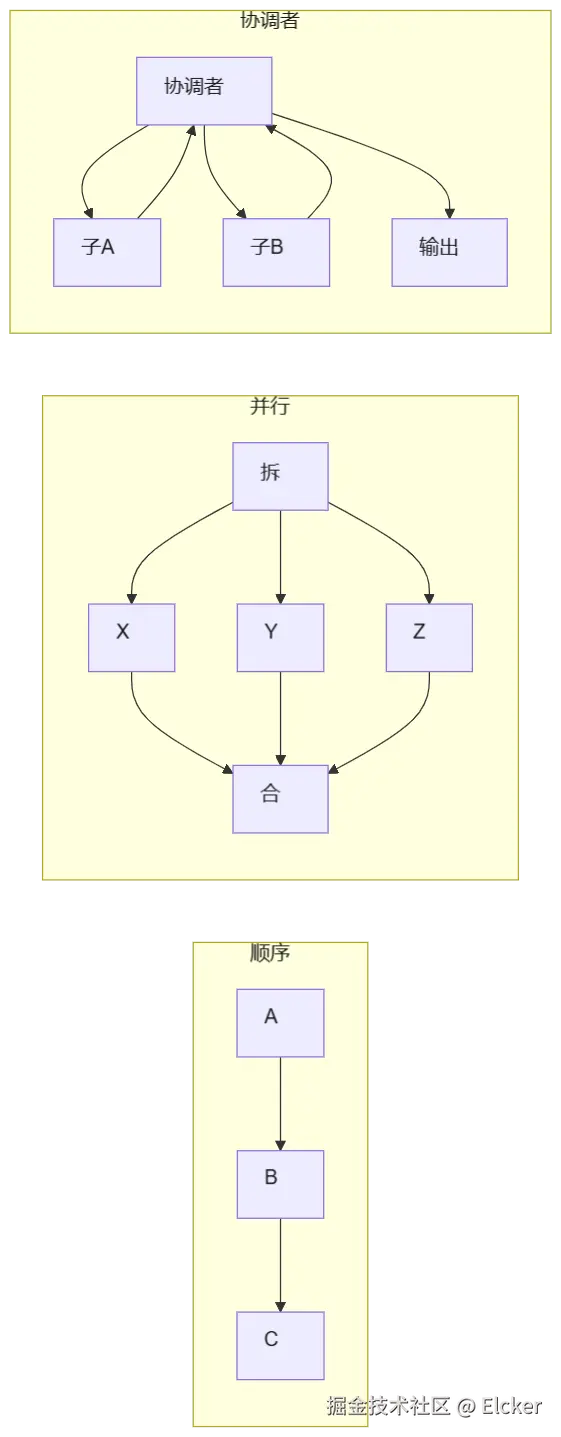
和前面几种拓扑的本质区别在于:子任务不是事先定死的,而是协调者在运行时根据任务动态拆的。 顺序/并行模式的"拆法"是代码写死的;协调者模式的"拆法"是模型现场拍的。
介绍
这是 LangChain 在 τ-bench 上重点 benchmark 的架构之一,他们的结论(我也认):
- 优势:对子 Agent 几乎无假设,适用面最广;子 Agent 的上下文互相干净;子任务可并行。
- 代价(他们称之为"传话问题"):子 Agent 不能直接回用户,所有信息经协调者转述------就像玩"传话游戏",每转一次失真一次、花一份 token。
- 他们的改进:减少协调者的"翻译"动作(让子 Agent 的产出更接近可直接交付的格式、让协调者做"路由 + 汇总"而非"重新理解 + 重述"),性能提升近 50%。
这条经验对我启发很大:协调者要"瘦" 。它应该只做三件事------分解任务、路由分发、汇总结果;不该做重新分析、重新推理、替子 Agent 重述。协调者越"胖",传话损耗越大。
协调者和"单 Agent 带工具"的边界在哪?我的判断标准是:子任务是否需要独立的上下文/工具集/提示词。如果"子 Agent"只是"单 Agent 调了个不同工具",那还是单 Agent;只有当子任务需要一套独立人设(独立的 System Prompt + 工具 + 上下文隔离)时,才配叫子 Agent。
解决的问题
| 痛点 | 协调者模式怎么解 |
|---|---|
| 任务拆法事先说不清(开放性任务) | 协调者运行时动态拆,不受预定义步骤限制 |
| 多领域、多工具,单上下文装不下 | 每个子 Agent 一套独立人设 + 工具 + 上下文 |
| 需要"一个大脑"对结果负总责 | 协调者统一汇总、统一对外,责任链清晰 |
| 子任务间可能并行 | 协调者分发后,子 Agent 可并行执行 |
适用条件 :任务开放性高、领域跨度大、且单 Agent 已被证实不够用。它是多 Agent 里的"重型武器"------能用顺序/并行解决的,别上协调者(协调者多一次 LLM 决策 + 传话损耗)。
交互图
与顺序/并行的对照(控制流形状差异):
场景实例
场景:企业级"全能助手",用户一句话可能跨多个领域------"帮我看看上周的告警,把重复的合并了,再给运维群发个周报"。
text
用户: "上周告警去重 + 发运维周报"
协调者(运行时分解):
  判定需要 3 个能力:告警查询 / 去重聚类 / 通知发送
  → 分发:
     告警 Agent(工具:监控 API): 拉上周告警 → 结构化清单
     分析 Agent(工具:无,纯推理): 对清单做聚类去重 → 合并建议
     通知 Agent(工具:消息 API,需审批): 按模板生成周报 → 待发送
协调者汇总:
  合并去重结果 + 周报草稿 → 呈给用户
  其中"发送周报"是副作用 → 触发 HITL 审批(见第 7 章)
用户批准 → 通知 Agent 执行发送我的核心经验(来自传话问题的教训):
- 子 Agent 的产出要"近交付"。让告警 Agent 直接输出"结构化告警清单",而不是"一段描述告警的话"------协调者就不必再"理解 + 重述",传话损耗骤降。
- 协调者提示词要克制。我只让协调者做"分解、路由、汇总",明确禁止它"替子 Agent 分析、重新推理"。协调者一越界,就从"路由器"变成"第二个上帝 Agent"。
- 副作用统一收口。所有不可逆动作(发送、删除)不管在哪个子 Agent,都汇到协调者这一层触发 HITL 审批------审批点集中,审计才清晰。
我什么时候会放弃它 :任务领域单一(单 Agent 够)、或拆法固定(顺序/并行更省)。协调者是最后的选项,不是首选------它是"单 Agent 不行、顺序/并行也不够灵活"时才请出来的重型架构。
9. 总结
这一章我把全文收个尾。我不想只把前面的东西再念一遍,而是想给你我自己做选型时真正在用的那套判断框架------以及我踩过的坑、形成的几条铁律。
9.1 一张图看懂全部模式
先把"能力模式"和"拓扑模式"摆到一起,你就能看到它们是怎么拼成一个完整 Agent 系统的:
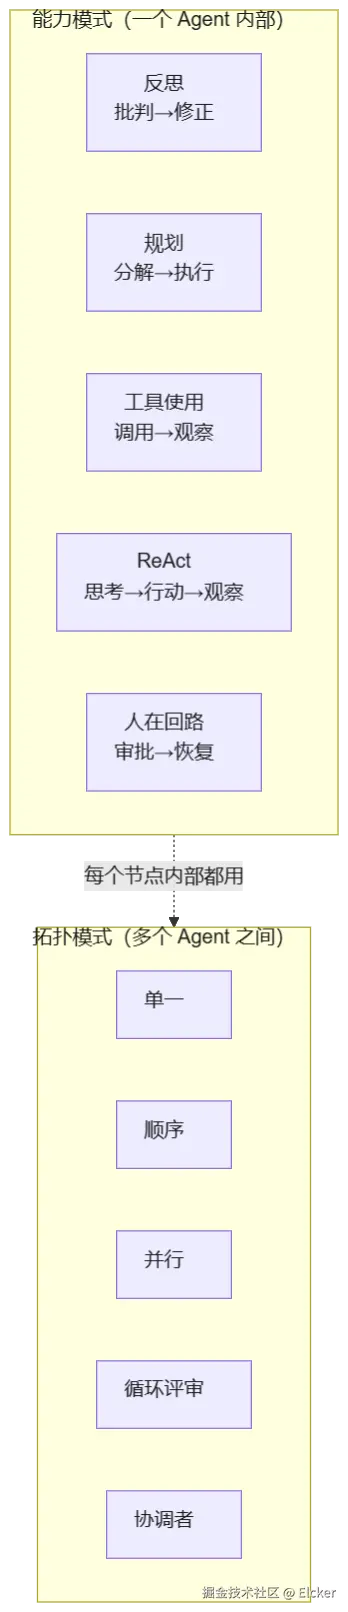
读法:横轴是"一个 Agent 怎么想怎么做",竖轴是"多个 Agent 怎么摆"。任意一个拓扑节点(哪怕只是"单一"那个),内部都可以是 ReAct + 工具 + 反思的组合;而"人在回路"是横切的,能插在任何一个有副作用的节点前面。
9.2 我的选型决策框架
如果让我给一个刚要动手的人一张"从哪开始"的清单,我会这么写:
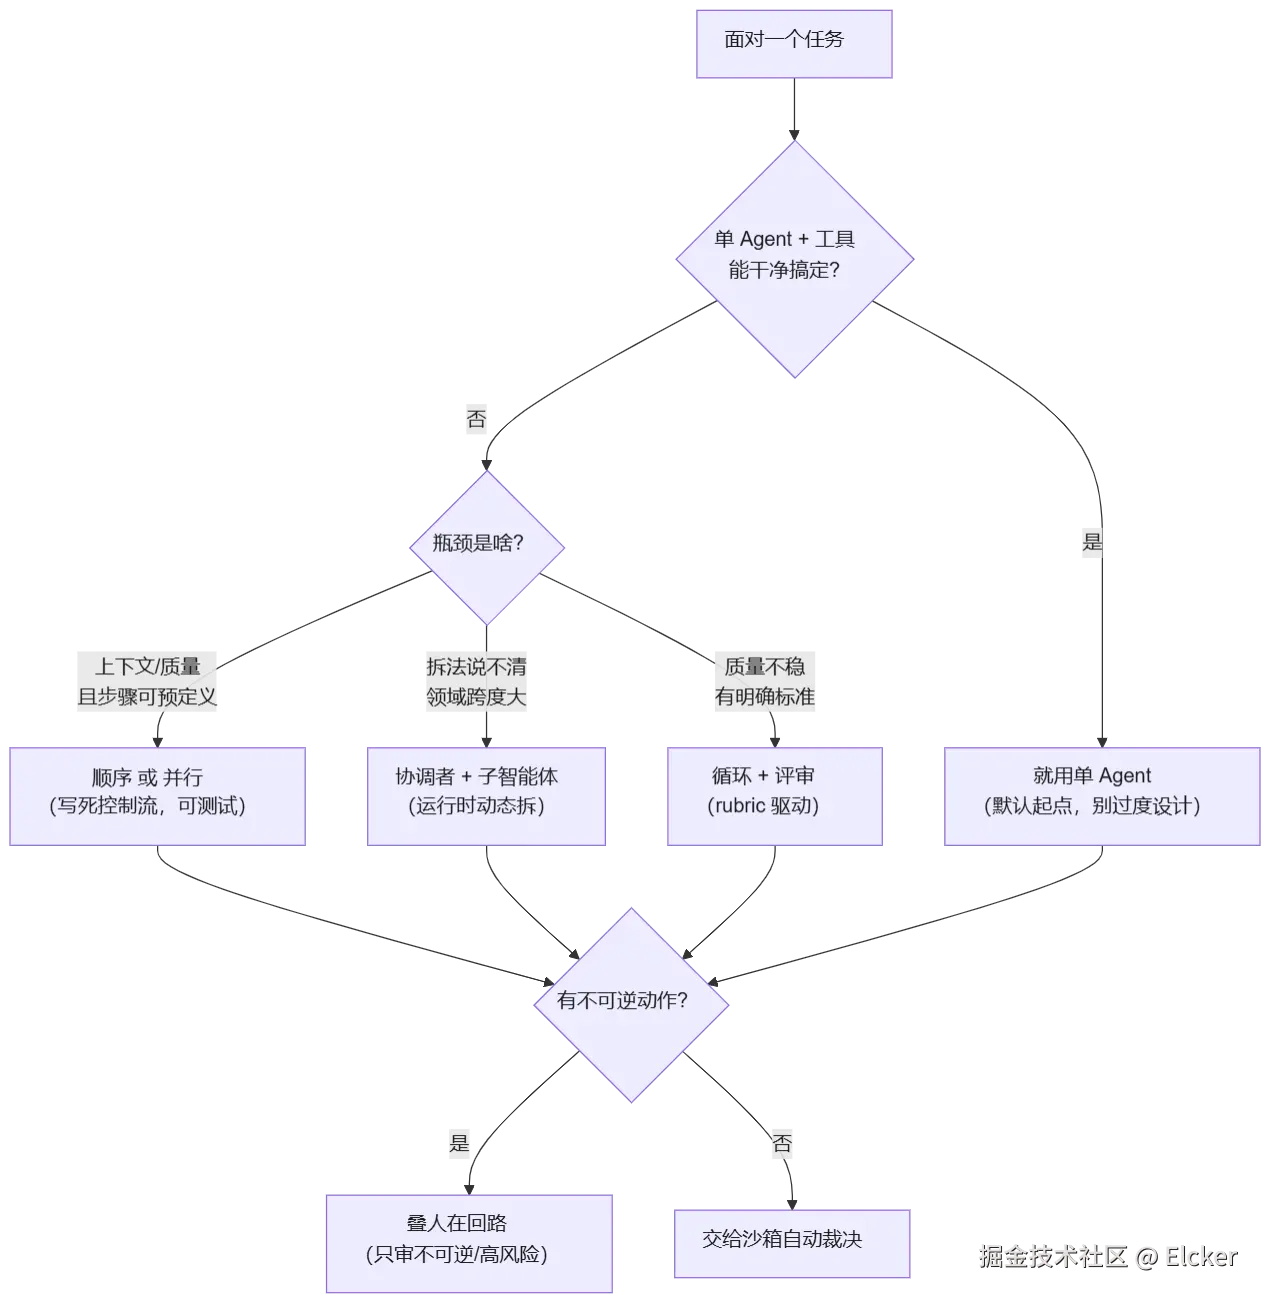
这张图浓缩了我反复强调的立场:从单 Agent 起步,按瓶颈逐步加码,每一步加码都要能说出"为什么单 Agent/更简单的形状不够"。
9.3 几条我认为是"铁律"的经验
这些是我用真金白银(token 和排查时间)换来的,放在最后单独拎出来:
- 先用最简单的方案。 每多一层复杂度(多一个 Agent、多一轮循环、多一个模型决策),都换来延迟、成本、出错面的上升。复杂度是"解出来的",不是"预设的"。
- 控制流形状要匹配任务形状。 任务步骤固定 → 顺序/并行(代码写死控制流,可预测可测);任务开放性高 → 协调者(模型现拆)。用错形状,再强的模型也救不回来。
- 传话次数是隐藏成本。 信息每经过一次"转述"(子 Agent → 协调者 → 用户)都失真一次、花一份 token。让子 Agent 的产出"近交付"、让协调者"瘦",是多 Agent 系统最重要的两个优化点。
- 并行不是免费的,状态设计决定成败。 共享状态的 reducer 用简单覆盖(
=)就会丢数据;并行写必须按 key 命名空间隔离。"真并行"和"假并行 + 数据丢失"的差别,全在这一处。 - 评审标准(rubric)必须先于循环存在,且必须可判定。 模糊的"写好点"会让 Critic 每轮都能挑出新毛病、循环永不收敛;可判定清单才让"达标"成为布尔值。
- HITL 只审不可逆,别让"审批疲劳"架空安全。 每一步都问人,人会从认真变成无脑点通过------看起来更安全,实际更危险。不可逆/高风险走审批,其余交给沙箱自动裁决。
- 审批通过 ≠ 可以执行,要复核一次。 从"人点通过"到"工具执行"之间有窗口期,权限档位可能已被收紧。不复核,审批形同虚设。
- 模型给的参数是不可信输入。 工具参数必须
JSON.parse+ schema 校验 + 沙箱检查后才执行。这是防提示注入升级成代码执行(prompt injection → RCE)的底线。
9.4 模式是拼出来的,不是选出来的
最后想说的一点,也是这篇文档我最想让你带走的:
没有"最好的模式",只有"最匹配任务形状的组合"。
我见过的成熟 Agent 系统,几乎都是这么拼的:单 Agent 内核跑 ReAct + 工具使用,外层按任务需要套上规划,关键动作挂人在回路,需要并行提速时局部用并行扇出,领域跨度大到单上下文装不下时才升级为协调者 + 子智能体。 每个模式各管各的、正交可组合,谁也不替代谁。
所以与其问"我该用哪个模式",不如问:
- 我的任务,一个角色 + 一套工具从头干到尾够不够?(不够才多 Agent)
- 它的步骤,事先说得清吗?(说得清 → 顺序/并行;说不清 → 协调者)
- 它有没有不可逆/高风险动作?(有 → 挂 HITL)
- 它的质量,有没有可判定的标准?(有 → 套循环 + 评审)
把这几个问题答完,你的架构基本就长出来了。剩下的,就是按本文每个模式的"交互图"去实现、按"场景实例"去验证、按"我什么时候会放弃它"去克制自己别过度设计。
共勉!
附录:参考与延伸阅读
本文结论综合了以下公开资料(我按"它贡献了哪个观点"标注,方便你回溯):
| 来源 | 贡献的核心观点 |
|---|---|
| ReAct(Yao et al., 2022, arXiv:2210.03629) | 思考-行动-观察循环;Reason to Act / Act to Reason;动作空间 Â = A ∪ L |
| Reflexion(Shinn et al., 2023, arXiv:2303.11366) | 语言化反思强化(不更新权重);Actor / Evaluator / Self-Reflection 三组件;HumanEval 91% pass@1 |
| Tree of Thoughts(Yao et al., 2023, arXiv:2305.10601) | 规划建模为树搜索(BFS/DFS + 回溯);Game of 24 从 CoT 4% 到 74% |
| Building Effective Agents(Anthropic, 2024-12) | 工作流 vs Agent 的区分;提示词链/路由/并行/编排/评审优化五个模式;"先用最简单的方案" |
| Benchmarking Multi-Agent Architectures(LangChain, 2025) | 单 Agent / 群组 / 协调者三架构的 τ-bench 实测;"传话问题"与协调者"瘦身"优化 |
| OpenAI Agents 指南(Guardrails & Approvals) | 审批中断四步流程(中断→可恢复 state→审批→恢复);护栏分层(输入/输出/工具);工具循环/参数校验硬约束 |
| ChatDev / MetaGPT / CAMEL / Generative Agents(2023) | 多角色协作、SOP 编码进提示词、角色对、记忆+反思+规划支撑长期协作 |