上一篇我们把湖仓的「读」讲完了------双路查询架构让业务平台各取所需。但所有查询的前提是:数据得先进到湖里。智驾数据闭环的入湖数据源五花八门:五个平台的 MySQL 业务库、四类实时事件流、还有体量最大的采集大文件------延迟要求从秒级到亚秒级不等,合规要求也完全不同。
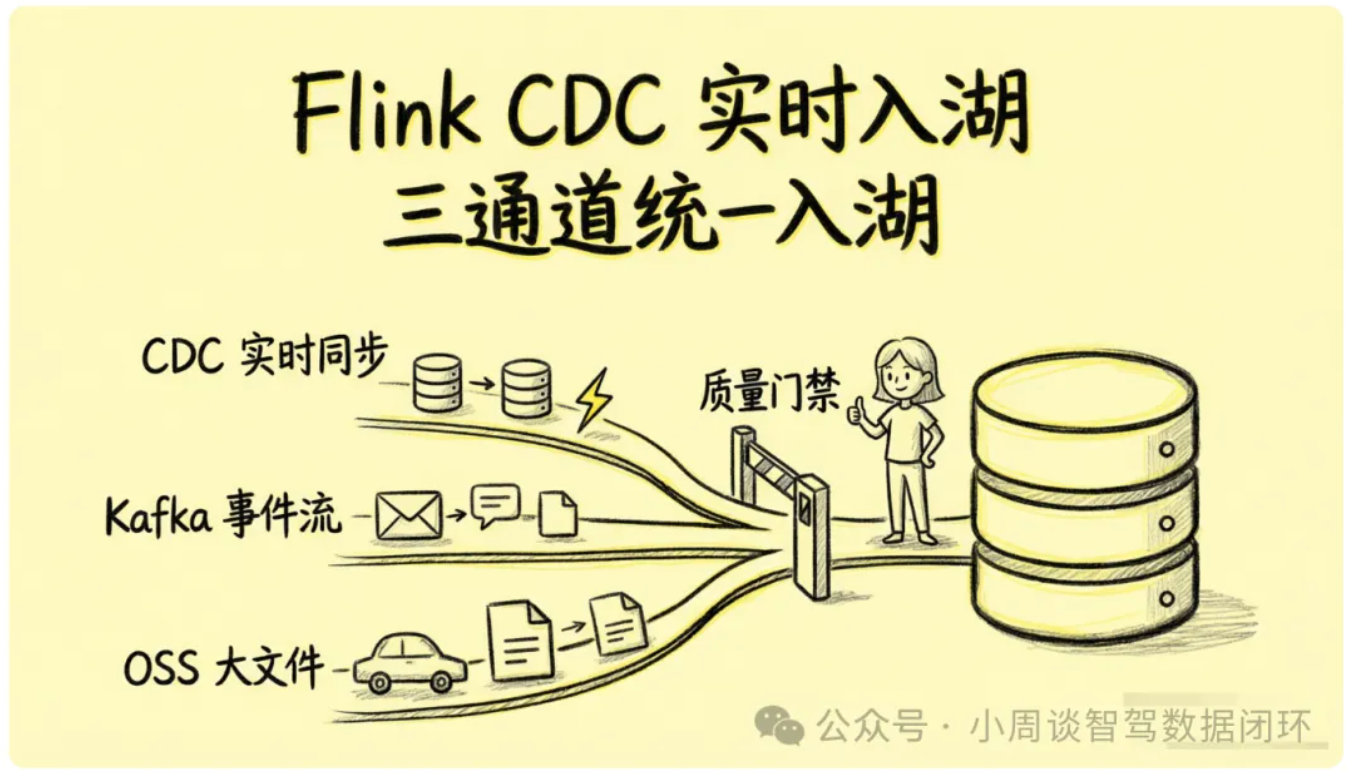
如果为每类数据源各建一套同步链路,结果必然是作业失控、口径不一、出了问题谁都查不动。我们的答案是------按数据形态分三条通道,统一经数据质量门禁写入 Paimon ODS 层:结构化业务库走 Flink CDC,事件流走 Kafka,采集大文件走 OSS 合规上传通道。
本文完整拆解三通道入湖架构的设计决策:CDC 断点续传与 Exactly-Once 怎么保证、Kafka 乱序数据怎么用 Watermark 处理、采集大文件为什么要经过「车端脱敏 → 合规室上传 → 合规云脱密 → 智驾云入湖」的五步链路。
一、入湖难题:一条同步链路喂不饱九类数据源
先看智驾数据闭环的全部入湖数据源画像------九个来源,数据形态、延迟要求、合规等级全都不一样:
|--------------------|----------------------|----------|------------|
| 数据源 | 接入方式 | 同步频率 | 延迟要求 |
| 产线 / 标注 / 质检 MySQL | Flink CDC | 实时 | < 5s |
| 训练 / 评测 MySQL | CDC + 定时批量 | 实时 + 小时级 | < 5s / 1h |
| 产线 / 训练 / 回传 Kafka | Flink Kafka Consumer | 实时 | < 1s |
| 采集大文件(图像/点云) | OSS 合规上传通道 | 实时(元信息) | < 5s |
三个最典型的矛盾:
- 产线任务状态变更频繁------批同步(每小时拉一次)会导致闭环大盘看到的永远是过期状态,必须实时感知;
- 车端触发事件要求亚秒级------触发器上传的事件是 Badcase 分析的起点,晚一秒入湖,下游分析就晚一秒启动;
- 采集大文件是合规敏感数据------图像 / 点云未经脱敏不能离开车端,根本不允许直接进业务通道。
二、三通道统一入湖架构全景
整体架构一句话概括:三条通道、一道门禁、一个湖------
- 通道一(Flink CDC):实时读取五个平台 MySQL 的 binlog,断点续传 + 数据清洗后直写 ODS 层;
- 通道二(Kafka):消费四类事件流(产线埋点 / 训练指标 / 车端回传 / 仿真事件),Exactly-Once + Watermark 乱序处理;
- 通道三(OSS 合规上传) :采集大文件经五步合规链路,文件本体存 OSS,元信息经 Kafka 实时写入
ods_data_file_meta。
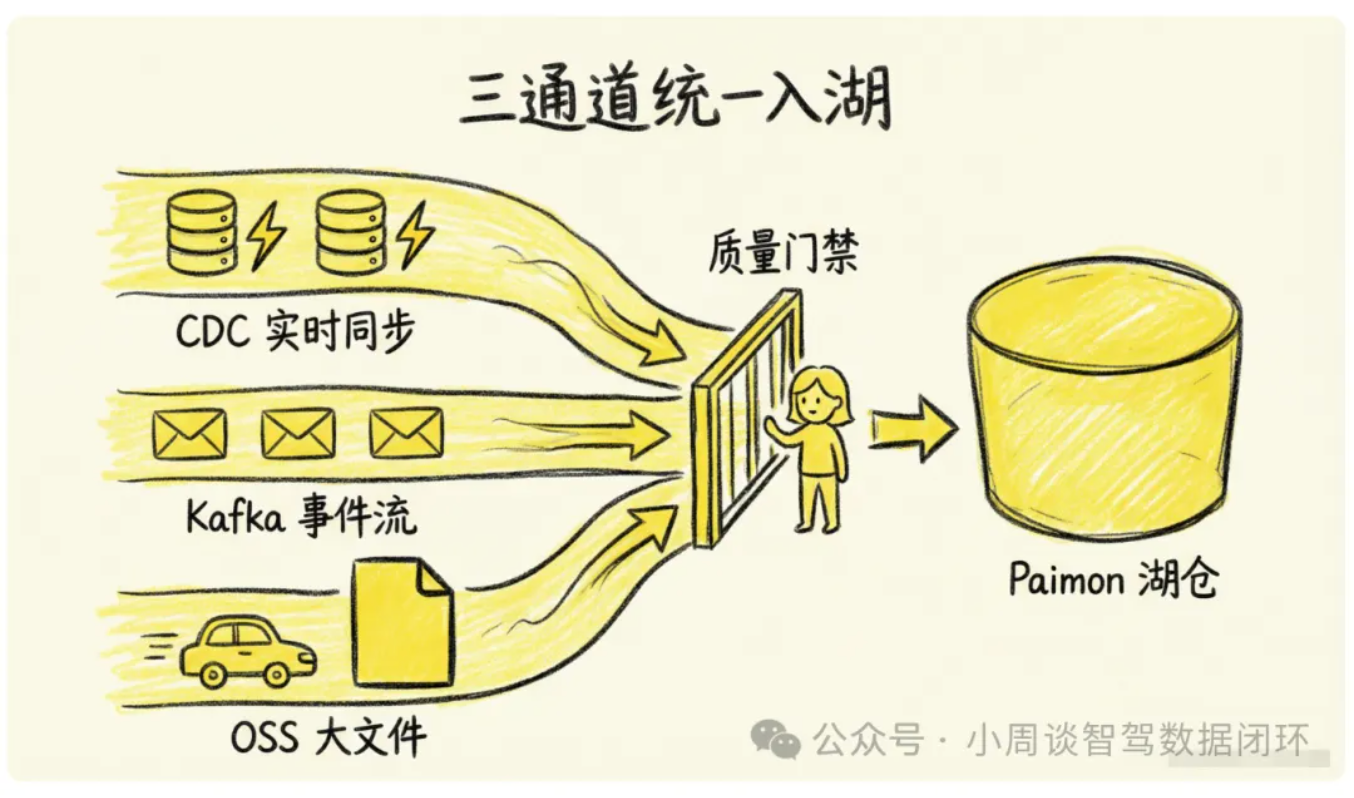
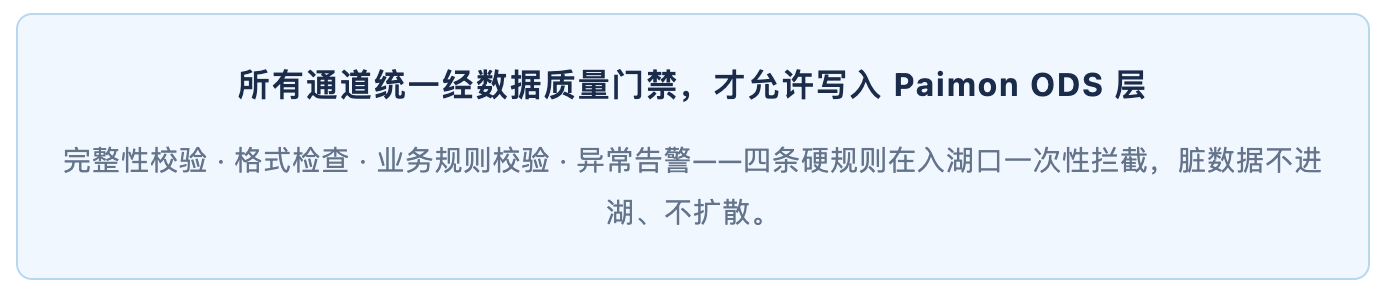
门禁只拦不修:命中「拒绝入湖」规则的数据进入异常隔离表 ods_quality_issue,走分级告警与人工处理,修复后可重新入湖(完整的五步校验链路会在系列二第 6 篇展开)。
三、通道一:Flink CDC 实时同步------断点续传与 Exactly-Once
3.1 CDC 作业:Source → Sink 一条龙
以产线任务表为例,一个 CDC 作业就是「声明 Source、声明 Sink、一条 INSERT」三段式。注意 Sink 端两个关键配置:changelog-producer='input' 直接透传 binlog 的变更类型,bucket=4 与上一篇讲的主键点查裁剪呼应:
sql
-- ① CDC Source:读产线 MySQL binlog(增量快照,免锁表)
CREATE TABLE mysql_source_production_line_task (
    task_id STRING, task_name STRING, status STRING,
    create_time TIMESTAMP(3), update_time TIMESTAMP(3),
PRIMARY KEY (task_id) NOT ENFORCED
) WITH (
'connector' = 'mysql-cdc',
'database-name' = 'production_db',
'table-name' = 'production_line_task',
'scan.startup.mode' = 'initial',                    -- 全量初始化 + 增量
'scan.incremental.snapshot.enabled' = 'true'-- 增量快照,无锁
);

-- ② Paimon Sink:ODS 层主键表
CREATE TABLE paimon_sink_production_line_task (
    task_id STRING, ..., status STRING,
    _ingest_time TIMESTAMP(3), _source_system STRING,
PRIMARY KEY (task_id) NOT ENFORCED
) WITH (
'connector' = 'paimon',
'bucket' = '4',
'changelog-producer' = 'input'
);

-- ③ 同步作业:补两个审计字段后直写
INSERT INTO paimon_sink_production_line_task
SELECT task_id, ..., status,
CURRENT_TIMESTAMPAS _ingest_time,
'production_mysql'AS _source_system
FROM mysql_source_production_line_task;
所有 CDC 作业的 Sink 表都强制补两个审计字段:_ingest_time(入湖时间)与 _source_system(来源系统)------后续数据质量追溯与血缘登记都靠它们定位数据出处。
3.2 断点续传:Checkpoint 是 CDC 的救命机制
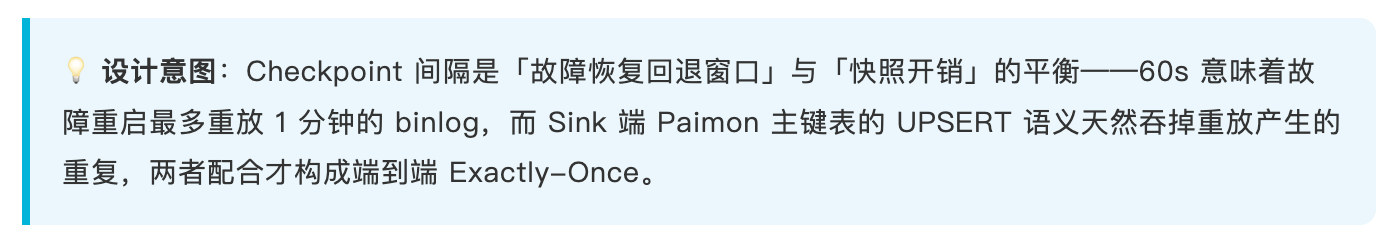
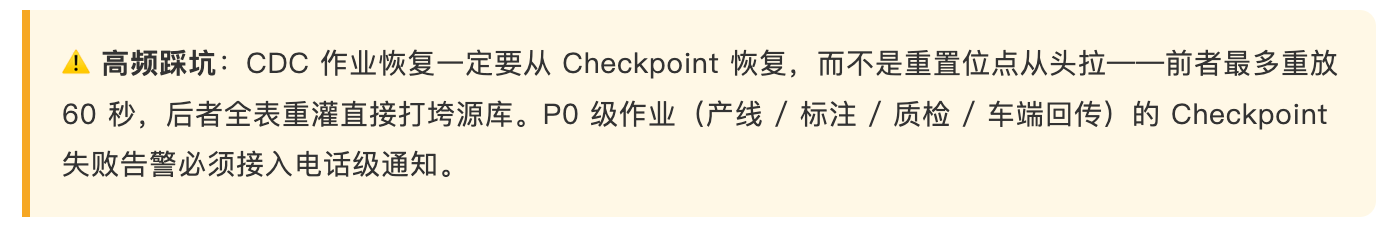
CDC 作业 7×24 常驻,最怕的是进程崩溃后「从哪继续读」答错------重读会产生重复,跳过会产生丢失。解法是把 binlog 位点存进 Checkpoint:
|---------------------|------------------------------|----------------------|
| 配置项 | 取值 | 作用 |
| checkpoint.interval | 60s | 位点快照频率,崩溃最多回退 60s 数据 |
| checkpoint.mode | EXACTLY_ONCE | 快照对齐,不重不漏 |
| checkpoint.storage | oss://flink-checkpoints/cdc/ | 位点持久化到 OSS,作业重建不丢位点 |
| high-availability | ZooKeeper 三节点 | JobManager 故障自动接管 |
3.3 表映射规则:新增字段与转换集中声明
源表和目标表不是简单抄字段------审计字段、字段转换统一在映射配置里声明,新增源表不改作业代码:
XML
mappings:
  - source: { database: production_db, table: production_line_task }
    target: { database: ods, table: ods_production_line_task }
    field_mappings:
# 1:1 映射字段无需配置,只声明新增字段
      - target: _ingest_time
        expression: CURRENT_TIMESTAMP
      - target: _source_system
        value: "production_mysql"
    transforms:
      - field: status            # 状态码统一大写,避免上下游口径不一致
        type: uppercase
      - field: config            # JSON 合法性预校验,脏配置不入湖
        type: json_validate
四、通道二:Kafka 事件流------乱序处理与 Watermark
4.1 Topic 规划:分区数与保留时间按流量定
|------------------------|-------------------|-----|------|
| Topic | 来源 | 分区数 | 保留时间 |
| production-line-events | 产线平台埋点 | 16 | 7 天 |
| training-metrics | 训练过程指标 | 8 | 3 天 |
| vehicle-trigger-events | 车端触发器(Badcase 起点) | 16 | 30 天 |
| simulation-events | 仿真任务事件 | 8 | 7 天 |
注意 vehicle-trigger-events 保留 30 天------车端触发事件是 Badcase 回溯的起点,保留时长直接决定问题能回溯多远。
4.2 典型作业:明细直写 + 实时聚合两种形态
Kafka 入湖作业分两种形态:事件明细类(产线埋点)按 event_id 主键直写 ODS;指标类(训练过程)在 Flink 内先做窗口聚合再写湖,降低湖仓写入压力:
sql
-- 训练指标:按任务 + epoch 实时聚合后写 DWD,原始明细不入湖
INSERT INTO paimon_training_metric_agg
SELECT training_task_id, epoch,
AVG(loss) AS avg_loss, MAX(loss) AS max_loss,
MIN(loss) AS min_loss, COUNT(*) AS metric_count
FROM kafka_source_training_metrics
GROUP BY training_task_id, epoch;
4.3 乱序处理:Watermark 划一条「迟到容忍线」
车端网络抖动、训练任务重试,都会让事件乱序到达。如果窗口见一条算一条,聚合结果就是错的。Watermark 的作用是声明「晚于这条线的数据视为迟到」:
sql
-- 训练指标:允许 5 秒乱序
WATERMARK FOR metric_time AS metric_time - INTERVAL'5'SECOND

-- 车端回传:网络抖动大,放宽到 10 秒
WATERMARK FOR event_time AS event_time - INTERVAL'10'SECOND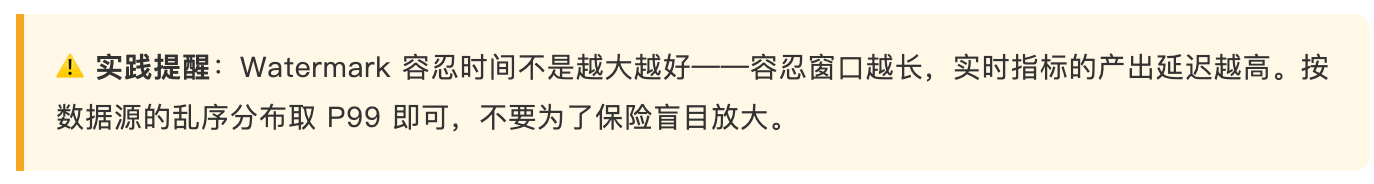
五、通道三:OSS 合规上传------大文件的五步入湖链路
采集数据(相机 / 激光雷达 / IMU / GNSS 的图像与点云)是入湖体量最大、敏感度最高的数据源,既塞不进 CDC,也塞不进 Kafka,必须走独立的合规通道。核心链路五步:
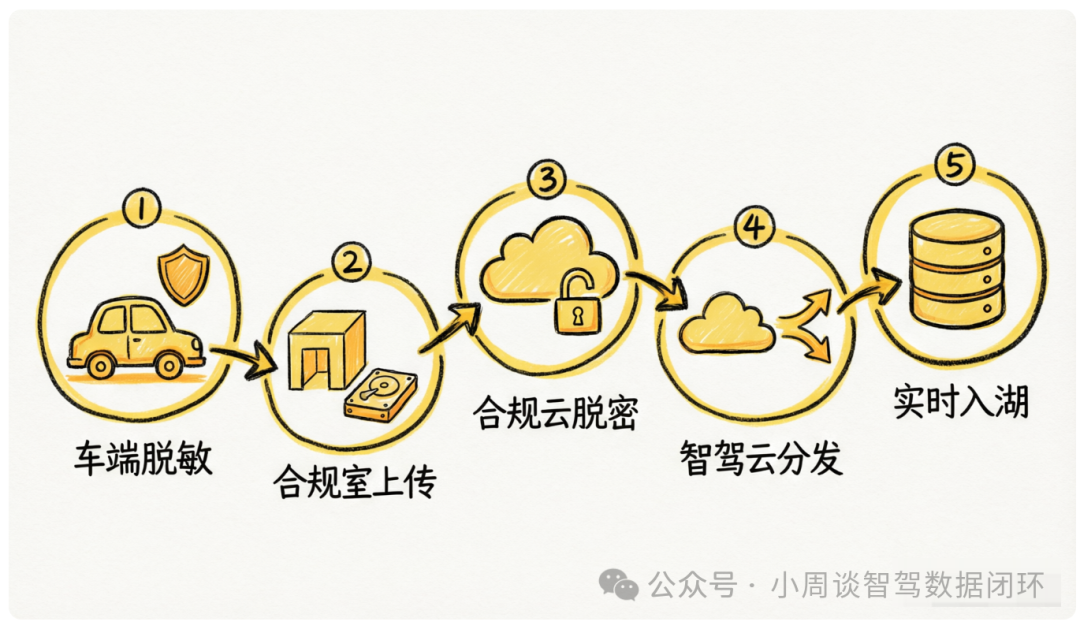
|---------|--------------------------------------------|------------|
| 步骤 | 动作 | 关键约束 |
| ① 车端脱敏 | 采集时实时执行人脸 / 车牌个性脱敏 + 地信脱敏,落盘车端 | 数据离车即合规 |
| ② 合规室上传 | 合规人员提取硬盘,带入合规室上传至合规云对象存储 | 物理隔离,不经公网 |
| ③ 合规云脱密 | 删除敏感 POI(军事设施等)、模糊桥梁限高数值 | 独立云,不对外暴露 |
| ④ 智驾云分发 | 合规数据副本复制至智驾云 OSS,元信息发往业务方 Kafka | 同一 VPC 内流转 |
| ⑤ 实时入湖 | 消费 Kafka 写入 ods_data_file_meta,文件本体留 OSS | 元信息即血缘追溯起点 |
5.1 双脱敏机制:两段缺一不可
-
车端简单脱敏
采集时实时执行,保证数据「离车即合规」;
-
合规云复杂脱敏
车端算力做不了的深度处理------删敏感 POI、模糊桥梁限高等具体数值;
-
两段脱敏分别守住「出车」与「出云」两道门,缺一环即合规风险。
5.2 入湖原则:文件外置、元信息进湖
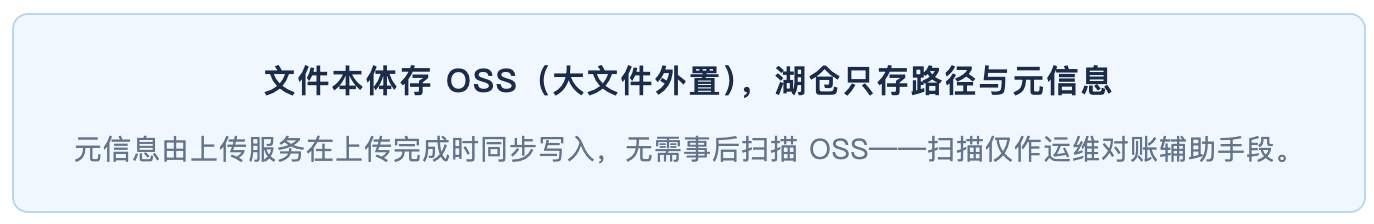 这条通道的门禁检查项也最严苛:脱敏标记缺失、data_id 格式非法直接 P0 拒绝入湖 ;文件不可解码、OSS 路径不一致 P1 拒绝入湖 ------因为这张
ods_data_file_meta 表是全链路血缘追溯的起点,脏一条就污染整条血缘。
六、接入运维:监控阈值、部署清单与故障预案
6.1 监控四组指标:延迟、速率、积压、资源
|------------------------|------------|----------|----------------------------|
| 指标 | 告警阈值 | 级别 | 说明 |
| cdc_lag_seconds | > 30s | WARNING | CDC 同步延迟 |
| cdc_checkpoint_failure | > 3 次 | CRITICAL | Checkpoint 连续失败 = 断点续传失效风险 |
| kafka_consumer_lag | > 10000 条 | WARNING | Kafka 消费积压 |
| rejected_records_count | > 100 条 | WARNING | 质量门禁拒绝量激增,源头可能异常 |
6.2 故障恢复预案:先定位,再按 SOP 执行
|-------------|---------------------------------------------|----------|
| 故障场景 | 恢复步骤 | RTO |
| CDC 作业失败 | 检查 Checkpoint → 从最近 Checkpoint 恢复 → 验证数据一致性 | < 30 分钟 |
| Kafka 消费积压 | 扩 Consumer 并行度 → 检查下游写入速度 → 必要时跳过过期数据 | < 15 分钟 |
| Paimon 写入失败 | 检查 OSS 连接 → 检查表结构 → 重启作业 | < 30 分钟 |
| 数据质量异常 | 查异常数据详情 → 检查源系统 → 修复后重新入湖 | < 1 小时 |
结语
用三句话带走本篇:按数据形态分通道 ------结构化行走 CDC、事件流走 Kafka、大文件走 OSS 合规通道,不搞一条链路硬扛所有;可靠性靠机制不靠运气 ------Checkpoint 断点续传 + Exactly-Once + Watermark 乱序容忍,重放与乱序都有确定性解法;合规与质量前置------大文件五步链路双脱敏保合规,统一质量门禁把脏数据拦在湖外,入湖口就是数据质量的最后防线。