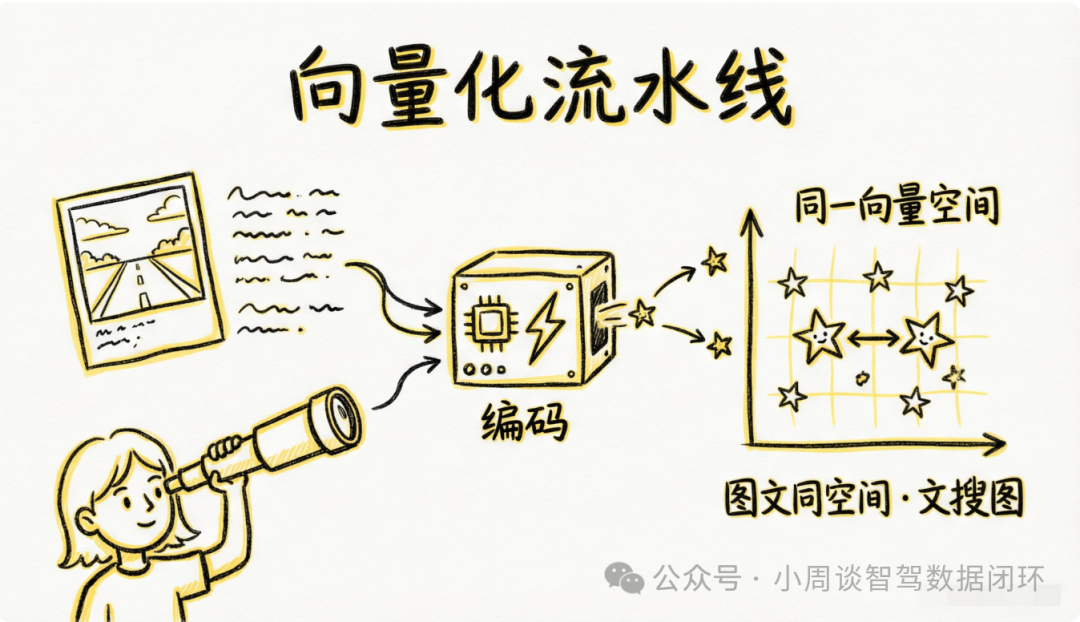
到上一篇为止,每张图片已经拥有了「结构化标签 + 自然语言说明」的双重表达。但要在千万张图片里回答「帮我找一批跟这张图相似的场景」,靠标签 LIKE 是做不到语义级匹配的------还需要把图片和文字编码成同一空间里的向量。这就是向量化流水线(Embedding 流水线)的职责。
本篇拆解三件事:流水线怎么跑(五步流程)、模型与版本怎么管(CLIP 双塔 + 版本化向量)、向量表为什么是湖仓里唯一带分区的表。
一、五步流水线:每日凌晨 6 点前完成
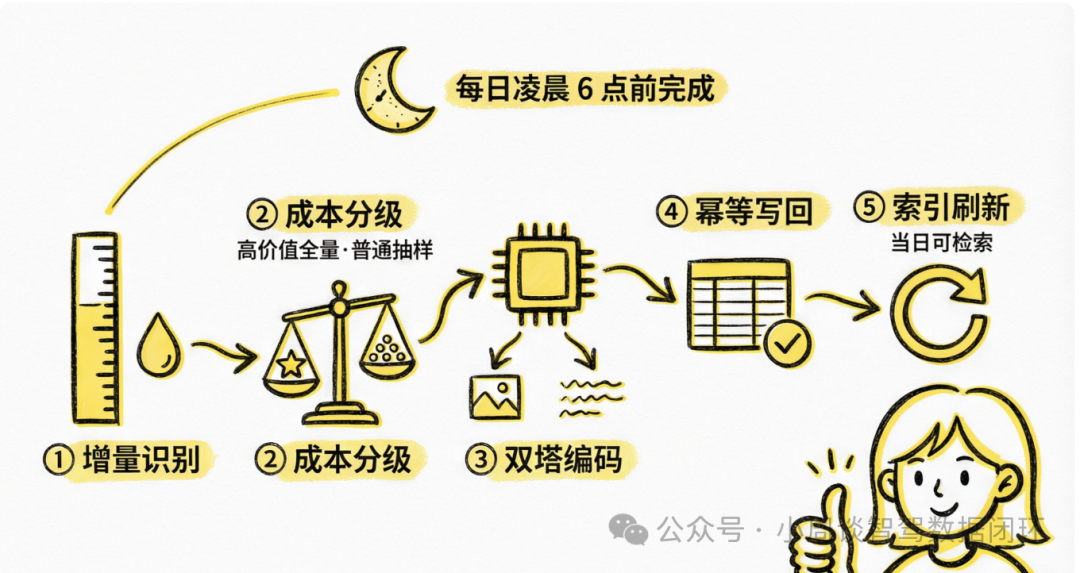
流水线 T+1 调度,每日凌晨 6 点前跑完,五步环环相扣:
-
① 增量识别
按 create_time / update_time 水位,只处理新增图片和标签变更的图片------不做全量重算,这是成本控制的前提;
-
② 成本分级
高价值数据(规则命中 / 事件抽帧)全量处理,普通数据按比例抽样------与抽帧、caption 一脉相承的分级思路;
-
③ 向量生成
图片走 image encoder、文字(caption)走 text encoder,双路经同一 CLIP 模型编码,保证图文向量落在同一空间------这是文搜图能成立的地基;
-
④ 幂等写回
按 (image_id, embedding_version, dt) 主键 Upsert 进向量表,重跑无副作用;标签变了图片没变就不重算图像向量;
-
⑤ 索引刷新
通知 StarRocks 做分区级增量索引刷新(SLA ≤ 1 小时)------新数据当日可检索。
实现选型上采用 Spark / Ray + GPU 算子,UDF 调用模型服务,批次失败可断点续跑------与 VLM 推理共享同一套弹性 GPU 资源池,凌晨窗口错峰使用。
二、模型与版本:CLIP 双塔与向量版本化
为什么是 CLIP 这类双塔模型?它用对比学习把图片和文本映射到同一向量空间:「雨天夜间高速行人横穿」这句话的向量,会天然靠近这类图片的向量------文搜图、图搜图本质上是同一个最近邻问题。业界沿这条路线持续演进(SigLIP 以 Sigmoid 损失提升判别力,中文场景可评估 Chinese-CLIP),模型选型不是一锤子买卖。
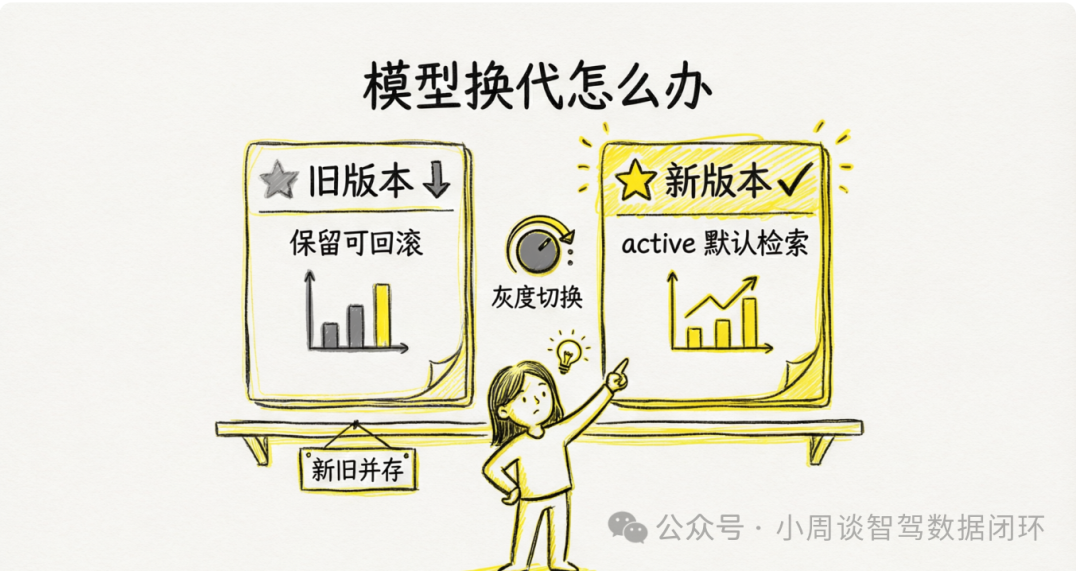
模型一定会换代,向量怎么办?答案是把 embedding_version 放进主键 :模型升级后新旧向量并存,用 vector_status 区分,检索默认 active 版本------灰度切换与回滚都不需要重刷全量数据。「增量向量化 + 版本化索引」是特斯拉、Wayve 等数据引擎迭代的通用做法,双写灰度是其中标配。
三、向量表:湖仓里唯一的分区表
流水线落地的 dwd_mining_image_vector_detail 是整个湖仓里一个特殊的存在:它是全湖体量最大的明细表(千万~亿级行 × 高维向量),也是湖仓内唯一带分区的表(其余表以 bucket + 主键 Upsert 管理)。联合主键为 (image_id, embedding_version, dt),dt 即分区键。
为什么唯独它要分区?两个理由都指向「大」:生命周期降冷 ------历史分区可以整体降冷到更便宜的存储,检索却只扫近期分区不受影响;向量索引增量刷新------按分区触发刷新,每天只建新分区的那部分索引,而不是全量重建。一个分区设计,同时解决了存储成本和索引成本两个最贵的问题。
📌 本篇要点回顾:① 五步流水线每日凌晨 6 点前完成:增量识别 → 成本分级 → 图文双路编码 → 幂等写回 → 索引刷新;② 同一 CLIP 模型双塔编码保证图文同空间,文搜图图搜图是同一个最近邻问题;③ embedding_version 入主键,模型换代新旧并存可灰度可回滚;④ 向量表是全湖最大的明细表、唯一分区表,分区同时解决降冷与索引增量刷新。
向量生产齐了,最后一环是检索本身:一句自然语言怎么变成一次毫秒级的最近邻查询?下篇讲多模态语义检索:统一检索 API 的五步处理、StarRocks 外部表双 HNSW 索引、P95 ≤ 2 秒的性能目标与内表冗余降级路径------挖掘系列在此收官。