上一篇我们把 79+ 张表的命名、分区、Bucket 设计讲完了,有读者问了一个非常实际的工程问题:「数据都在 Paimon 湖仓里,但闭环大盘要毫秒级响应、训练平台点查难例库要随机圈选------查询引擎到底怎么查湖?全部导进 StarRocks,还是直接查外部表?」
这其实是湖仓架构落地时绕不开的选型难题:全量导入内表 ,查询快但数据冗余、同步链路复杂、一致性难保证;全部外部表直查,零冗余零同步,但高频查询场景的性能撑不住业务平台的 SLA。
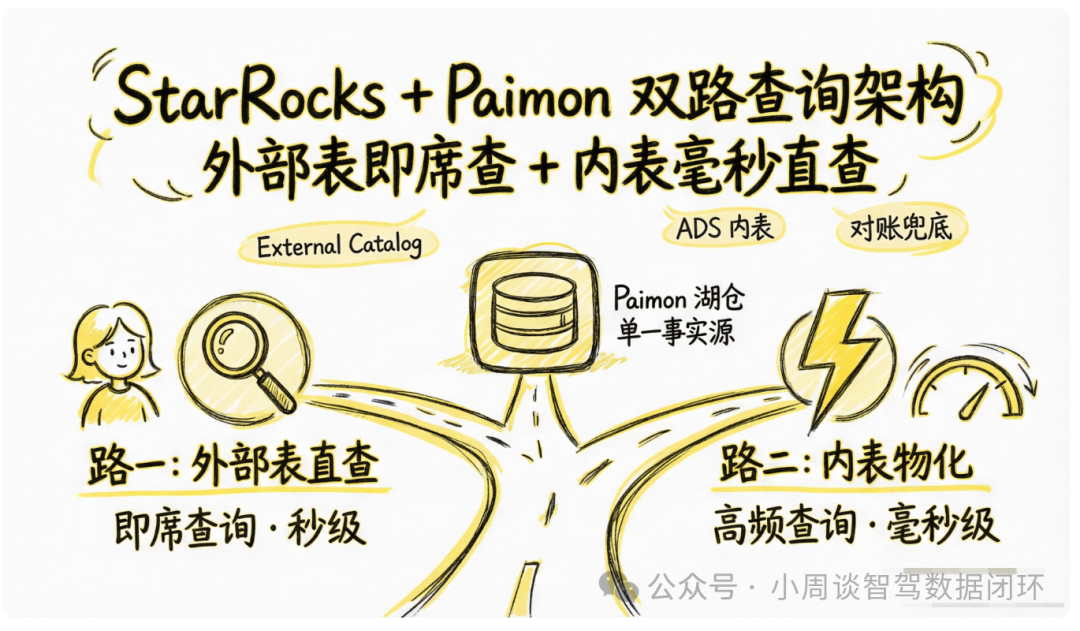
我们的答案是------不做二选一,按查询模式分层,走「External Catalog + ADS 内表物化」双路架构:即席查询、明细下钻、跨域 JOIN 走外部表直查;高频数据产品查询物化为 StarRocks 内表,毫秒级直查。本文完整拆解这套架构的设计决策、建表原则、物化作业与权限边界。
一、问题本质:湖仓存得下,但业务等不起
先看智驾数据闭环的查询场景画像------同一个湖仓,要同时服务五类平台,查询模式差异极大:
|--------|-------------------|--------------|-------|
| 平台 | 典型查询 | 查询模式 | 延迟要求 |
| 数据管理平台 | 单条数据全链路状态追溯 | 主键点查、低频 | 秒级可接受 |
| 训练平台 | 难例库圈选、数据集版本对比 | 高频点查 + 条件圈选 | 毫秒级 |
| 评测平台 | 模型版本对比、Badcase 明细 | 聚合分析、中频 | 秒级可接受 |
| 业务大屏 | 闭环大盘、热力图、成本看板 | 高频聚合查询 | 毫秒级 |
| 问题分析平台 | Badcase 回溯、触发事件下钻 | 即席查询、跨表 JOIN | 秒级可接受 |
如果只选一条路,必然顾此失彼:
|---------|-------------------|-------------------------|
| 方案 | 优点 | 致命缺点 |
| 全部外部表直查 | 零数据冗余、零同步链路、永远查最新 | 高频聚合查询性能撑不住大屏毫秒级 SLA |
| 全部导入内表 | 查询性能拉满、毫秒级响应 | 79+ 张表全量复制,冗余成本高、一致性难保证 |
💡 关键洞察 :选型的核心不是「湖快还是内表快」,而是按查询模式分层------低频、灵活、探索式的查询走外部表;高频、固定、面向产品的查询走内表。查询模式决定出口,而不是数据层级决定出口。
二、双路查询架构全景:统一查询 · 双路出口
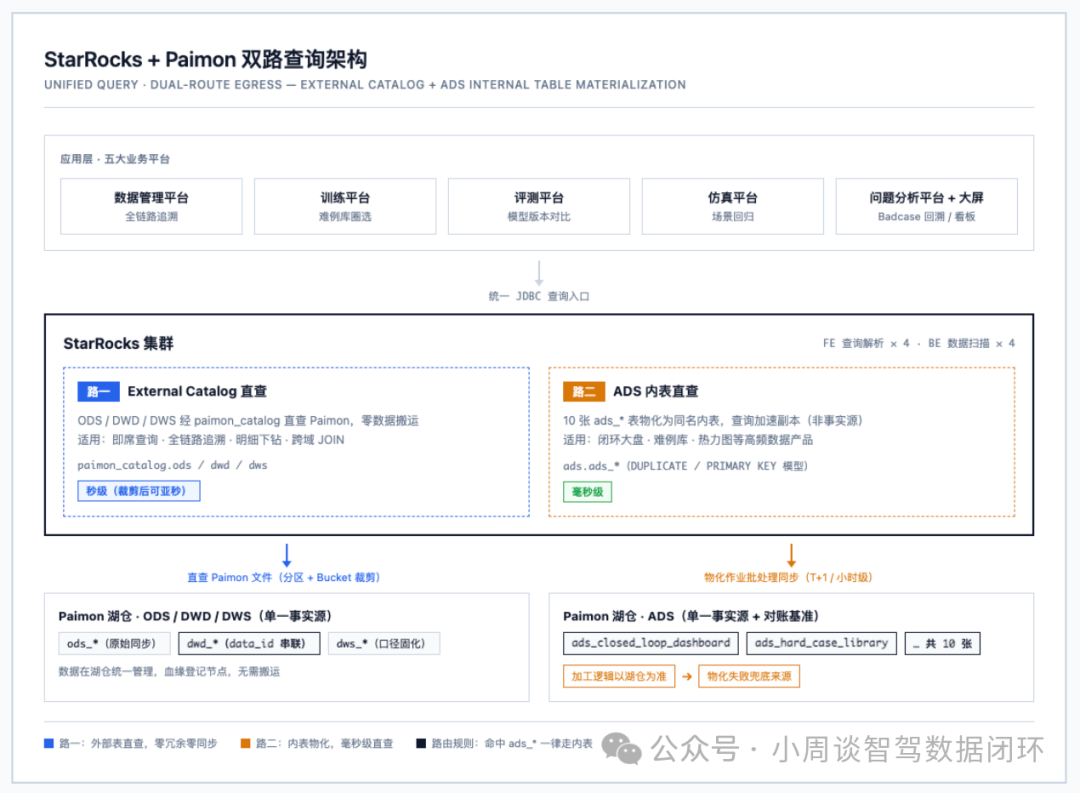
整体架构遵循一个原则:所有平台统一走 StarRocks 查询,由 StarRocks 在内部做双路分流------
-
路一(External Catalog 直查)
ODS/DWD/DWS 层经
paimon_catalog直查 Paimon,数据已在湖仓统一管理,无需搬运,适合即席查询与全链路追溯; -
路二(ADS 内表直查)
ADS 层 10 张
ads_*表由 StarRocks 离线加工并物化为内表,承载毫秒级快速直查,服务业务大屏与训练平台高频场景。
这里必须澄清一个最容易搞混的问题------Paimon 侧也有 ads_* 表,那它和 StarRocks 内表是什么关系?
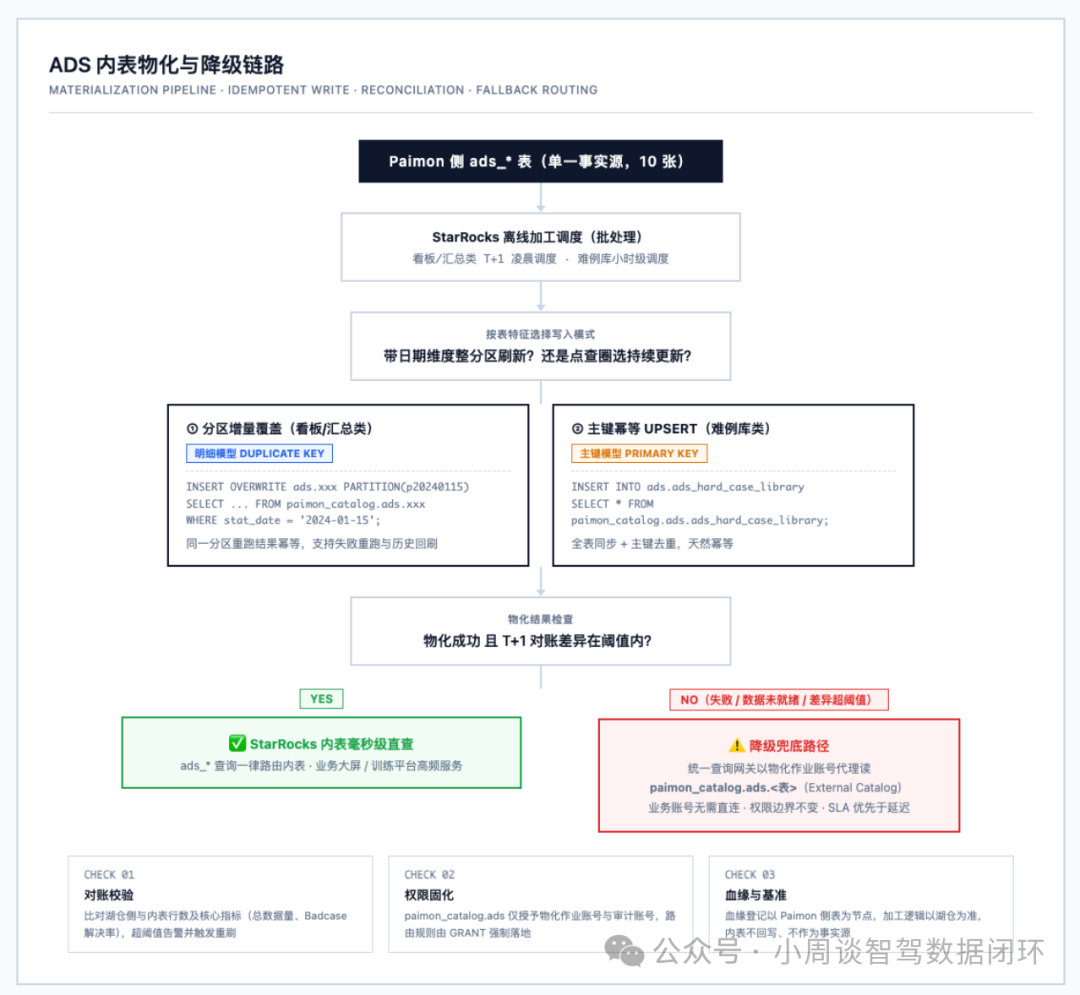
Paimon 侧 ads_* 表 = 单一事实源
StarRocks 内表 = 查询加速副本。一切加工逻辑以湖仓侧为准,内表只服务毫秒级查询,不回写、不作为事实源。
这个主从关系决定了三件事:血缘登记 以 Paimon 侧表为节点;对账校验 以湖仓侧数据为基准;物化失败兜底时,降级查询读的是 Paimon 侧的 ads 表而不是别的来源。
三、路一:External Catalog 直查------一条 DDL 打通湖仓
3.1 创建 Paimon Catalog
External Catalog 的本质是把 Paimon 的元数据(DLF)和数据文件(OSS)注册进 StarRocks,之后所有 Paimon 表都可以像本地表一样用 SQL 访问:
-- 创建 Paimon External Catalog(阿里云 DLF + OSS)
CREATE EXTERNAL CATALOG paimon_catalog
PROPERTIES (
'type' = 'paimon',
-- 元数据:DLF 目录
'metastore' = 'dlf',
'dlf.region' = 'cn-hangzhou',
-- 数据:OSS 湖仓目录
'paimon.catalog.warehouse' = 'oss://intelligent-driving-lakehouse/paimon/',
-- 本地缓存:100GB,TTL 1 小时
'cache.enabled' = 'true',
'cache.size' = '107374182400',
'cache.ttl' = '3600'
);配置完成后,SHOW TABLES FROM paimon_catalog.dwd 即可看到湖仓侧全部 79+ 张表,无需任何数据搬运。
3.2 典型查询:主键点查全链路状态
数据管理平台最高频的场景是「一条数据现在走到哪一步了」。得益于上一篇讲的 data_id 主键设计,这就是一次主键查询:
-- 单条数据全链路状态追溯(dwd 层 27 张表以 data_id 串联)
SELECT data_id, upload_status, preprocess_status,
       annotation_status, qc_status, delivery_status,
       total_production_hours
FROM paimon_catalog.dwd.dwd_data_production_chain
WHERE data_id = 'COLLECT_BP_20240115143022_a3f8';
3.3 让外部表查询跑得快:两级裁剪
外部表直查的性能密码,藏在上一篇讲的物理设计里------分区裁剪 + Bucket 裁剪:
|-----------|--------------------------|-----------------------|
| 裁剪手段 | 触发条件 | 效果 |
| 分区裁剪 | WHERE 条件命中分区键(dt / 业务字段) | 只扫目标分区的文件,扫描量降几个数量级 |
| Bucket 裁剪 | WHERE 条件命中分桶键(如 data_id) | 只扫单个 Bucket,点查从秒级降到亚秒 |
⚠️ 实践提醒:物理设计是为查询模式服务的------上一篇的分区策略三规则、Bucket 五档,本质都是在给这一章的两级裁剪铺路。设计阶段少想一步,查询阶段就多花十倍。
四、路二:ADS 内表物化------10 张表的毫秒级直查
4.1 物化范围:10 张 ads_* 表
Paimon 侧 ADS 层共 10 张表,逐表物化为同名 StarRocks 内表。注意物化频率不是拍脑袋------按业务依赖强度分两档:
|-------------------------------------|----------------|------|
| SR 内表 | 中文名 | 物化频率 |
| ads_closed_loop_dashboard | 闭环大盘指标表 | T+1 |
| ads_production_bottleneck_analysis | 产线瓶颈分析表 | T+1 |
| ads_badcase_root_cause_distribution | Badcase 根因分布表 | T+1 |
| ads_scene_library_summary | 场景库汇总表 | T+1 |
| ads_hard_case_library | 难例库表(训练平台高频依赖) | 小时级 |
| ads_data_asset_catalog | 数据资产目录表 | T+1 |
| ads_model_version_comparison | 模型版本对比表 | T+1 |
| ads_ota_deployment_summary | OTA 部署汇总表 | T+1 |
| ads_trigger_heatmap | 触发事件热力图表 | T+1 |
| ads_storage_cost_dashboard | 存储成本看板表 | T+1 |
4.2 建表原则:两种模型选对,物化才幂等
StarRocks 内表不是把 Paimon DDL 抄一遍就行,模型选择直接决定物化作业能不能重跑:
|------------------------|-------------------|--------------------------------------|
| 表特征 | 模型选择 | 物化方式 |
| 带日期统计维度、整分区刷新(看板/汇总类) | 明细模型(DUPLICATE) | 按 stat_date 分区 INSERT OVERWRITE,重跑幂等 |
| 点查/圈选为主、持续更新(难例库、资产目录) | 主键模型(PRIMARY KEY) | 全表同步 + 主键去重,幂等 UPSERT |
两个代表性建表示例(分区分桶参照 Paimon 侧 bucket,查询热点键参与分桶):
-- 示例1:明细模型(闭环大盘,按 stat_date 分区增量覆盖)
CREATE TABLE ads.ads_closed_loop_dashboard (
    stat_date DATENOT NULL,
    project_code VARCHAR(64) NOT NULL,
    total_data_count BIGINT,
    avg_loop_hours DOUBLE,
    badcase_resolve_rate DOUBLE,
    update_time DATETIME
) ENGINE = OLAP
DUPLICATE KEY(stat_date, project_code)
PARTITION BY RANGE(stat_date) ()
DISTRIBUTED BY HASH(project_code) BUCKETS 2
PROPERTIES (
"dynamic_partition.enable" = "true",   -- 动态分区,保留 365 天
"dynamic_partition.time_unit" = "DAY",
"dynamic_partition.start" = "-365"
);

-- 示例2:主键模型(难例库,训练平台高频点查/圈选,幂等 UPSERT)
CREATE TABLE ads.ads_hard_case_library (
    data_id VARCHAR(128) NOT NULL,
    hard_case_type VARCHAR(64),
    difficulty_score DOUBLE,
    scene_type VARCHAR(64),
    is_used_in_training BOOLEAN,
    update_time DATETIME
) ENGINE = OLAP
PRIMARY KEY(data_id)
DISTRIBUTED BY HASH(data_id) BUCKETS 8;
4.3 物化作业:两条 SQL 覆盖两种模式
物化作业由 StarRocks 离线加工调度(批处理),把 Paimon 侧 ads_* 表同步至内表,核心就两种写法:
-- ① 分区增量覆盖(幂等):看板类表按 stat_date 覆盖写入,重跑不产生重复
INSERT OVERWRITE ads.ads_closed_loop_dashboard PARTITION(p20240115)
SELECT stat_date, project_code, total_data_count, avg_loop_hours, ...
FROM paimon_catalog.ads.ads_closed_loop_dashboard
WHERE stat_date = '2024-01-15';

-- ② 主键模型幂等 UPSERT:难例库类表全表同步,主键去重
INSERT INTO ads.ads_hard_case_library
SELECT * FROM paimon_catalog.ads.ads_hard_case_library;
物化作业的四个工程要点,决定了双路架构靠不靠谱:
|--------|----------------------------------------------------------------------|
| 设计点 | 策略 |
| 刷新频率 | 看板/汇总类 T+1 凌晨调度;难例库等训练平台高频依赖表小时级调度 |
| 分区增量覆盖 | 按 stat_date 分区 INSERT OVERWRITE,同一分区重跑结果幂等,支持失败重跑与历史回刷 |
| 对账校验 | T+1 对账作业比对湖仓侧与内表行数及核心指标(总数据量、Badcase 解决率),差异超阈值告警并触发重刷 |
| 失败回退 | 物化失败或数据未就绪时,统一查询网关以物化作业账号代理读 External Catalog 兜底,业务账号无需直连(SLA 优先于延迟) |
五、查询路由与权限边界:规则越简单越不容易出错
5.1 路由规则:一条就够了
|-----------------|---------------------|-------------------------|------------|
| 数据层 | 查询出口 | 适用场景 | 延迟 |
| ADS 层 | StarRocks 内表(ads 库) | 闭环大盘、难例库、场景库等开箱即用数据产品 | 毫秒级 |
| ODS / DWD / DWS | External Catalog | 即席查询、全链路追溯、明细下钻、跨域 JOIN | 秒级(裁剪后可亚秒) |
凡命中 ads_* 表的查询,一律路由 StarRocks 内表
仅当物化作业失败降级或需回溯 ADS 加工逻辑时,才允许查 paimon_catalog.ads(兜底路径)。
5.2 权限设计:用授权把路由规则固化下来
路由规则不能只写在文档里------用 GRANT 语句把它固化,业务账号想违反都没有入口:
-- 业务账号:ODS/DWD/DWS 经 External Catalog 直查,ADS 走内表
GRANT SELECT ON paimon_catalog.ods TO'data_platform'@'%';
GRANT SELECT ON paimon_catalog.dwd TO'data_platform'@'%';
GRANT SELECT ON paimon_catalog.dws TO'data_platform'@'%';
GRANT SELECT ON DATABASE ads TO'data_platform'@'%';

-- paimon_catalog.ads 仅授予物化作业账号与审计账号
-- (降级兜底由查询网关以 ads_materialize_job 代理读取)
GRANT SELECT ON paimon_catalog.ads TO'ads_materialize_job'@'%';
GRANT SELECT ON paimon_catalog.ads TO'audit_account'@'%';
💡 设计意图 :业务账号直查 paimon_catalog.ads 会绕过物化加速、且权限边界失控。兜底查询由网关代理执行,既保住可用性(SLA 优先于延迟),又不破坏权限模型。
六、性能优化与运维四件套
双路架构上线后,日常运维主要抓四件事:
|-------|--------------------------------------------------------|----------------------|
| 运维项 | 配置要点 | 解决的问题 |
| 数据缓存 | scan_data_cache_size=10GB,TTL 3600s;另开 Page 缓存 4GB | 热点数据免重复拉取,重复查询加速 |
| 资源组隔离 | 按平台划分 Resource Group(数据管理 cpu=4/并发 20,训练 cpu=2/并发 10) | 防止单平台大查询拖垮全局,保障多租户公平 |
| 慢查询监控 | query_time > 10s 告警;开启 Profile 分析执行计划 | 及时发现缺分区条件、全表扫描类烂 SQL |
| 故障排查 | SHOW CATALOGS / SHOW TABLE STATUS / SHOW PARTITIONS 三连 | 连接失败、元数据不新、分区缺失快速定位 |
⚠️ 高频踩坑:「数据不一致」几乎全部是缓存未刷新导致的------先清缓存、再检查 Paimon 表 Compaction 状态,不要上来就怀疑同步链路。
结语
用三句话带走本篇:查询模式决定出口 ------即席查走外部表,高频产品查询走内表,不做全量导入也不做一刀切;单一事实源不动摇 ------Paimon 侧 ads_* 表是事实源与对账基准,StarRocks 内表只是加速副本,不回写;幂等 + 对账 + 兜底------分区覆盖物化可重跑、T+1 对账保一致、物化失败网关代理降级查湖仓,双路架构才算工程上真正可靠。
下篇预告
系列二第 4 篇将深入 Flink CDC 实时入湖------智驾多源数据接入架构设计,拆解 CDC / Kafka / OSS 三通道如何统一入湖、断点续传与 Exactly-Once 语义如何保证。敬请期待。