文章目录
-
- [一、cm_ctl 和 gs_om 查到的状态有什么区别?](#一、cm_ctl 和 gs_om 查到的状态有什么区别?)
- 二、先读懂一份输出,再逐个认识状态
-
- [一行 P Primary Normal,包含三项信息](#一行 P Primary Normal,包含三项信息)
- 三、集群整体:Normal、Degraded、Unavailable
- [四、实例角色:除了 Primary、Standby,还有什么?](#四、实例角色:除了 Primary、Standby,还有什么?)
-
- [1. 稳定角色:主、备、级联备](#1. 稳定角色:主、备、级联备)
- [2. 过渡和异常提示:不是新的业务分工](#2. 过渡和异常提示:不是新的业务分工)
- 五、运行状态:角色确定了,还可能正在启动或恢复
-
- [Need repair 后面的原因,比这个标签更具体](#Need repair 后面的原因,比这个标签更具体)
- 六、用一次主备切换,把这些名称串起来
查看数据库状态时,经常会遇到 Primary、Standby、Normal、Pending 等名称。它们看起来都在描述"状态",实际回答的却是不同问题。
Primary、Standby 说明实例承担什么角色;Normal、Starting 等说明实例运行得怎么样;cluster_state 则概括整个集群的情况。 一个备库完全可以同时是 Standby 和 Normal,两者并不矛盾。
因此,"集群状态共有几种"要先限定观察对象。对于本文介绍的常规主备,集群整体先认识 Normal、Degraded、Unavailable 三个核心取值;实例层面还要分别理解角色、运行状态和异常提示,不能把它们合并成一张没有层次的清单。
本文以 openGauss 6.0、已部署 CM 的集中式日志复制主备为基础,帮助理解磐维数据库的状态输出。
一、cm_ctl 和 gs_om 查到的状态有什么区别?
它们是两个管理入口,关注点有所不同,但所观察的数据库实例可以是同一批。
| 查看入口 | 主要用途 | 阅读时关注什么 |
|---|---|---|
cm_ctl query |
通过 CM 查看受管集群和组件状态 | 区分 CM Server、集群整体和 DN 等不同区块 |
gs_om -t status --detail |
通过 OM 运维工具查看详细状态 | 理解集群摘要和各 DN 的角色、运行情况;部署 CM 时也可能展示 CM Server 信息 |
| 管理平台页面 | 用图形界面展示采集到的信息 | 看清对象、字段说明和采集时间,页面名称可能经过转换 |
在部署了 CM 的环境中,可以用 cm_ctl query -Cvd 查看详细的主备状态。-v 表示详细显示,-C 用于按主备关系组织展示,-d 用于在输出中增加显示实例的数据目录路径(DATADIR)。
两个命令的输出不能简单理解成"一份是真实状态,另一份是假状态"。它们的展示范围、格式和查询时刻可能不同;尤其在启动、切换或故障期间,同一实例的状态会变化。如果结果不一致,应先对齐查询时间、实例标识和字段含义。
二、先读懂一份输出,再逐个认识状态
下面将状态输出简化为三个区块,省略 IP、端口、目录等信息,并调整排版便于阅读:
text
[ CMServer State ]
A    Standby
B    Primary
C    Standby

[ Cluster State ]
cluster_state : Normal

[ Datanode State ]
A    P Primary Normal
B    S Standby Normal
C    S Standby Normal
第一块表示 CM Server 的主备角色:B 上的 CM Server 当前为主。
最后一块表示 DN:A 上的 DN 当前为主。管理服务和数据库各有自己的主备关系,所以这份输出不存在冲突。
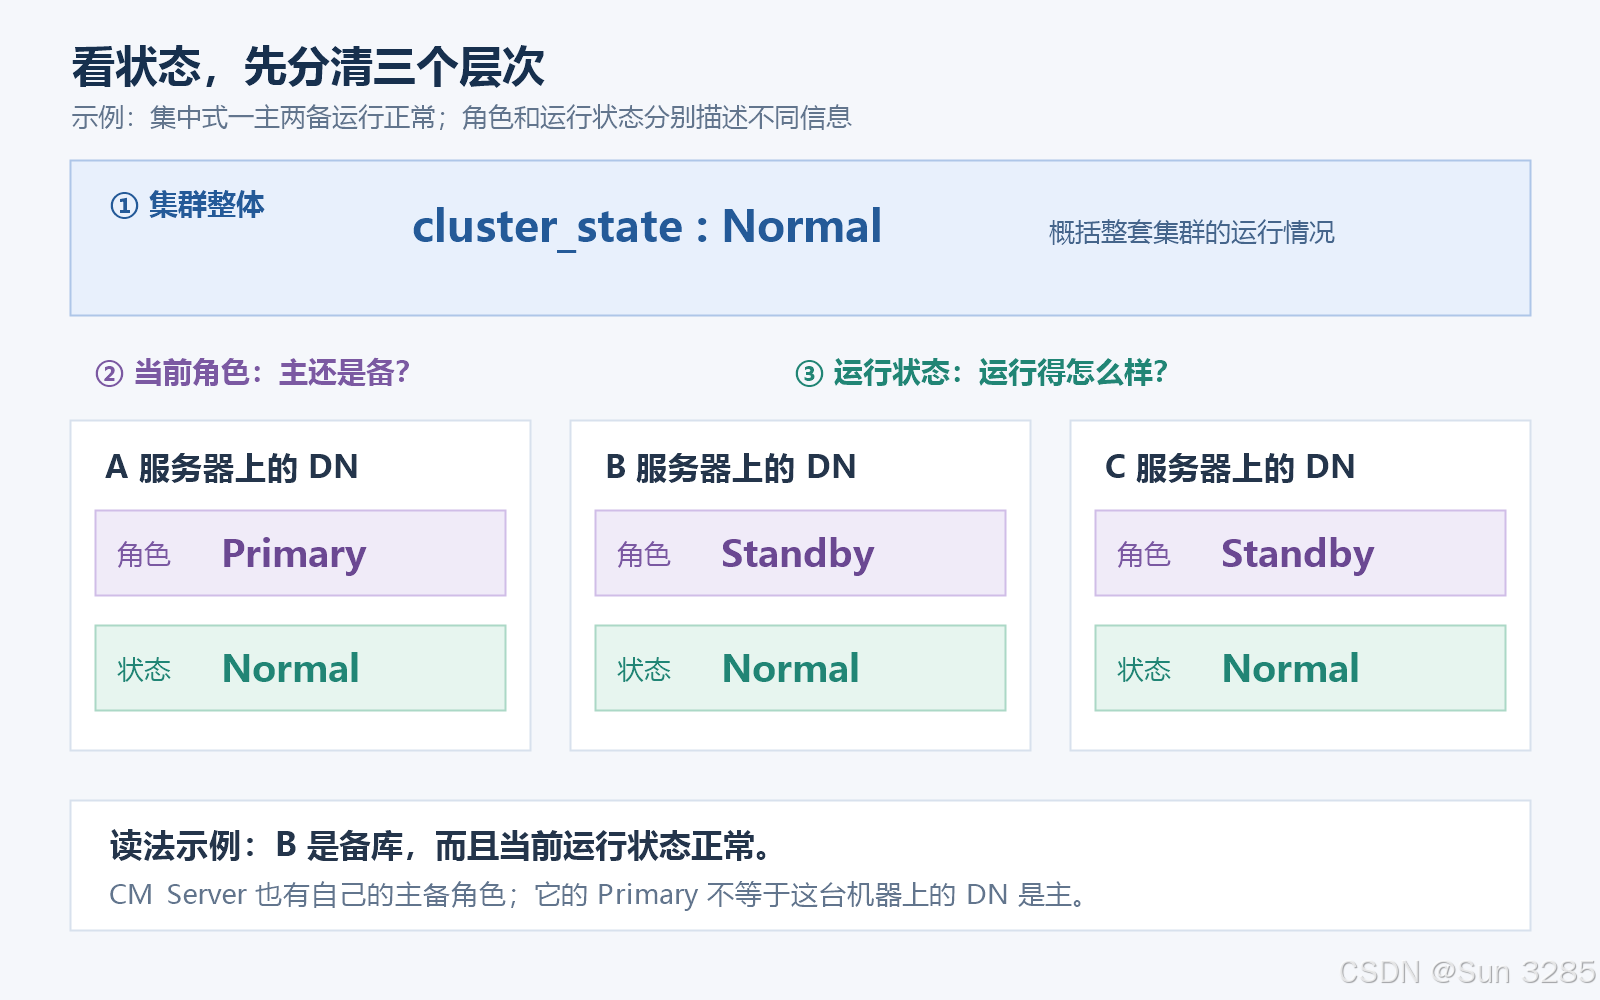
同一个 Normal 出现在不同位置,描述的对象不同;CM Server 的角色也要与 DN 的角色分开看。
一行 P Primary Normal,包含三项信息
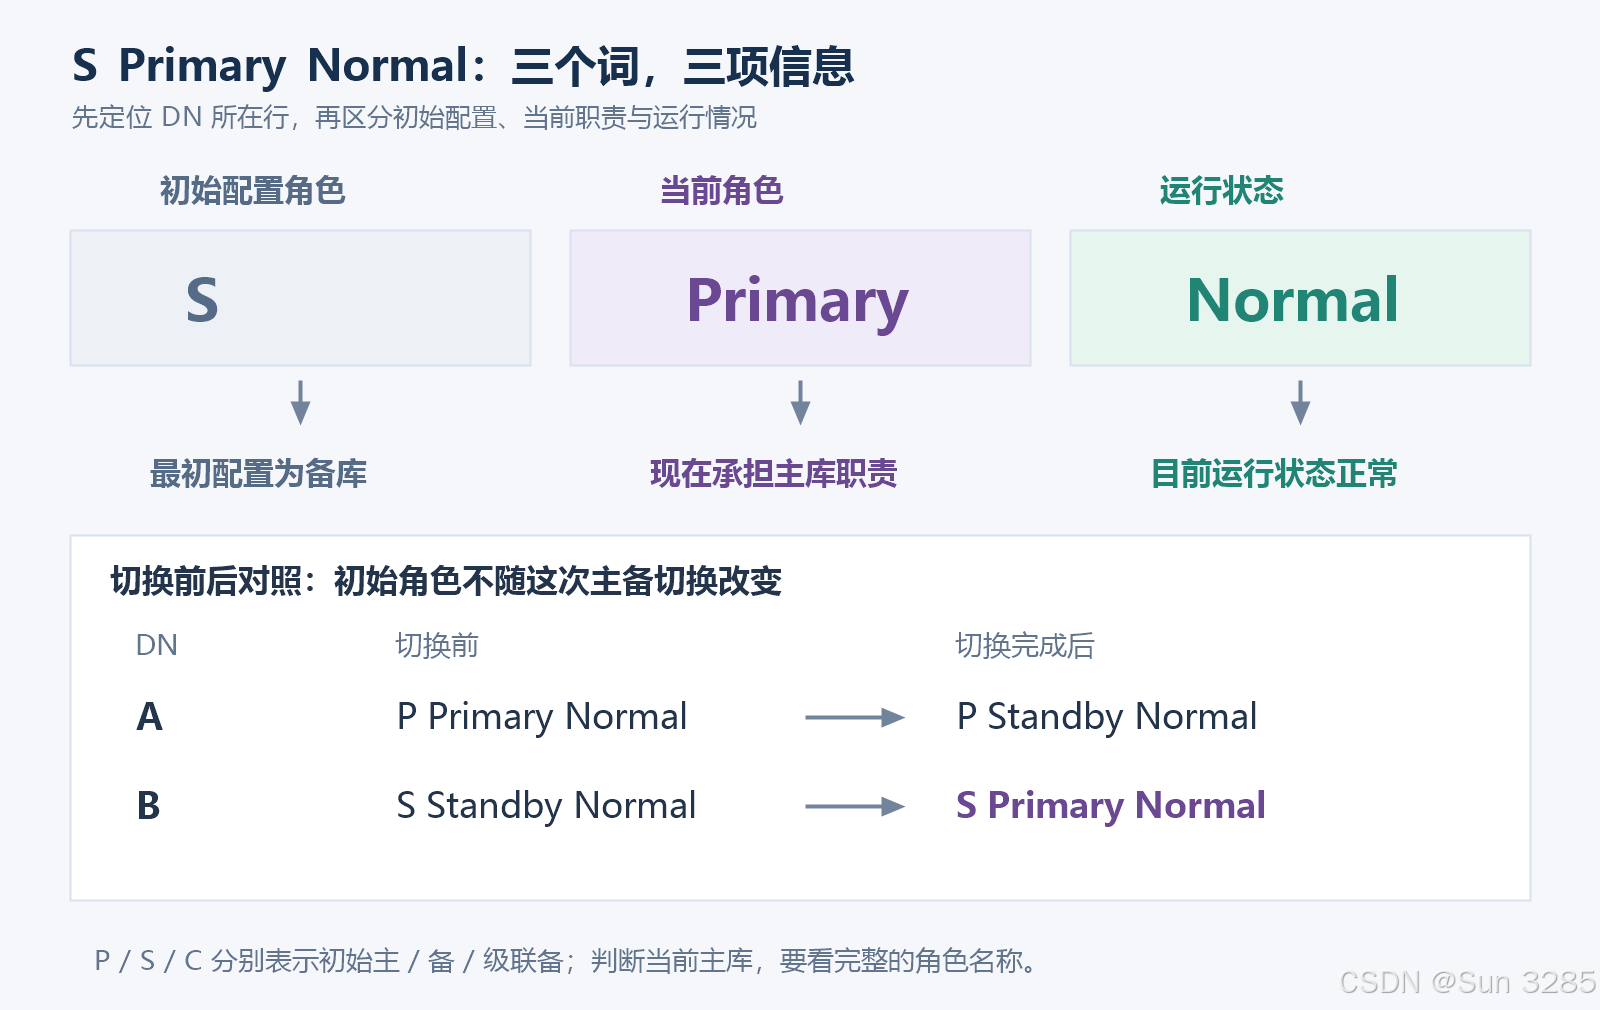
| 字段 | 含义 | 回答的问题 |
|---|---|---|
P |
静态配置中的初始角色是主 | 最初按什么角色配置? |
Primary |
当前角色是主 | 现在承担什么职责?(角色) |
Normal |
当前运行状态正常 | 现在运行得怎么样?(状态) |
对应地,S 表示初始备角色,C 表示初始级联备角色。主备切换会改变当前角色,不会仅因切换就把初始角色标记一起改掉。
所以,S Primary Normal 的意思是"最初配置为备、现在是主、目前运行正常" 。不能只看最前面的 S,就认定它仍然是备库。
三、集群整体:Normal、Degraded、Unavailable
这一层主要看 [ Cluster State ] 下的 cluster_state。
| 取值 | 中文理解 | 应当怎样阅读 |
|---|---|---|
Normal |
正常 | 集群达到正常运行条件,相关实例及主备关系正常 |
Degraded |
降级 | 集群仍被判断为可用,但存在故障或冗余能力受损,未达到完整健康状态 |
Unavailable |
不可用 | 集群被判断为无法正常提供服务,需要继续检查具体实例与管理状态 |
例如,主库还能够服务,但备库出现异常,集群可能处于降级状态。这与"所有组件健康"不同,也与"整个集群完全不可用"不同。
Unavailable 也不表示每个进程都已经退出,更不能直接据此判断数据丢失;它首先描述的是集群服务的可用性。
Degraded 不是剩余副本数量的精确说明。 在一主多备中,应继续查看每个备库,确认哪些仍健康、哪些已经失去正常复制能力,而不是直接推断"备库全没了"或"恰好坏了一个"。具体判定还与拓扑和版本实现有关。
下面对照一张实际操作窗口中的截图。执行的是 gs_om -t status --detail,输出同时包含 CM Server、集群整体和 DN 三个区块。
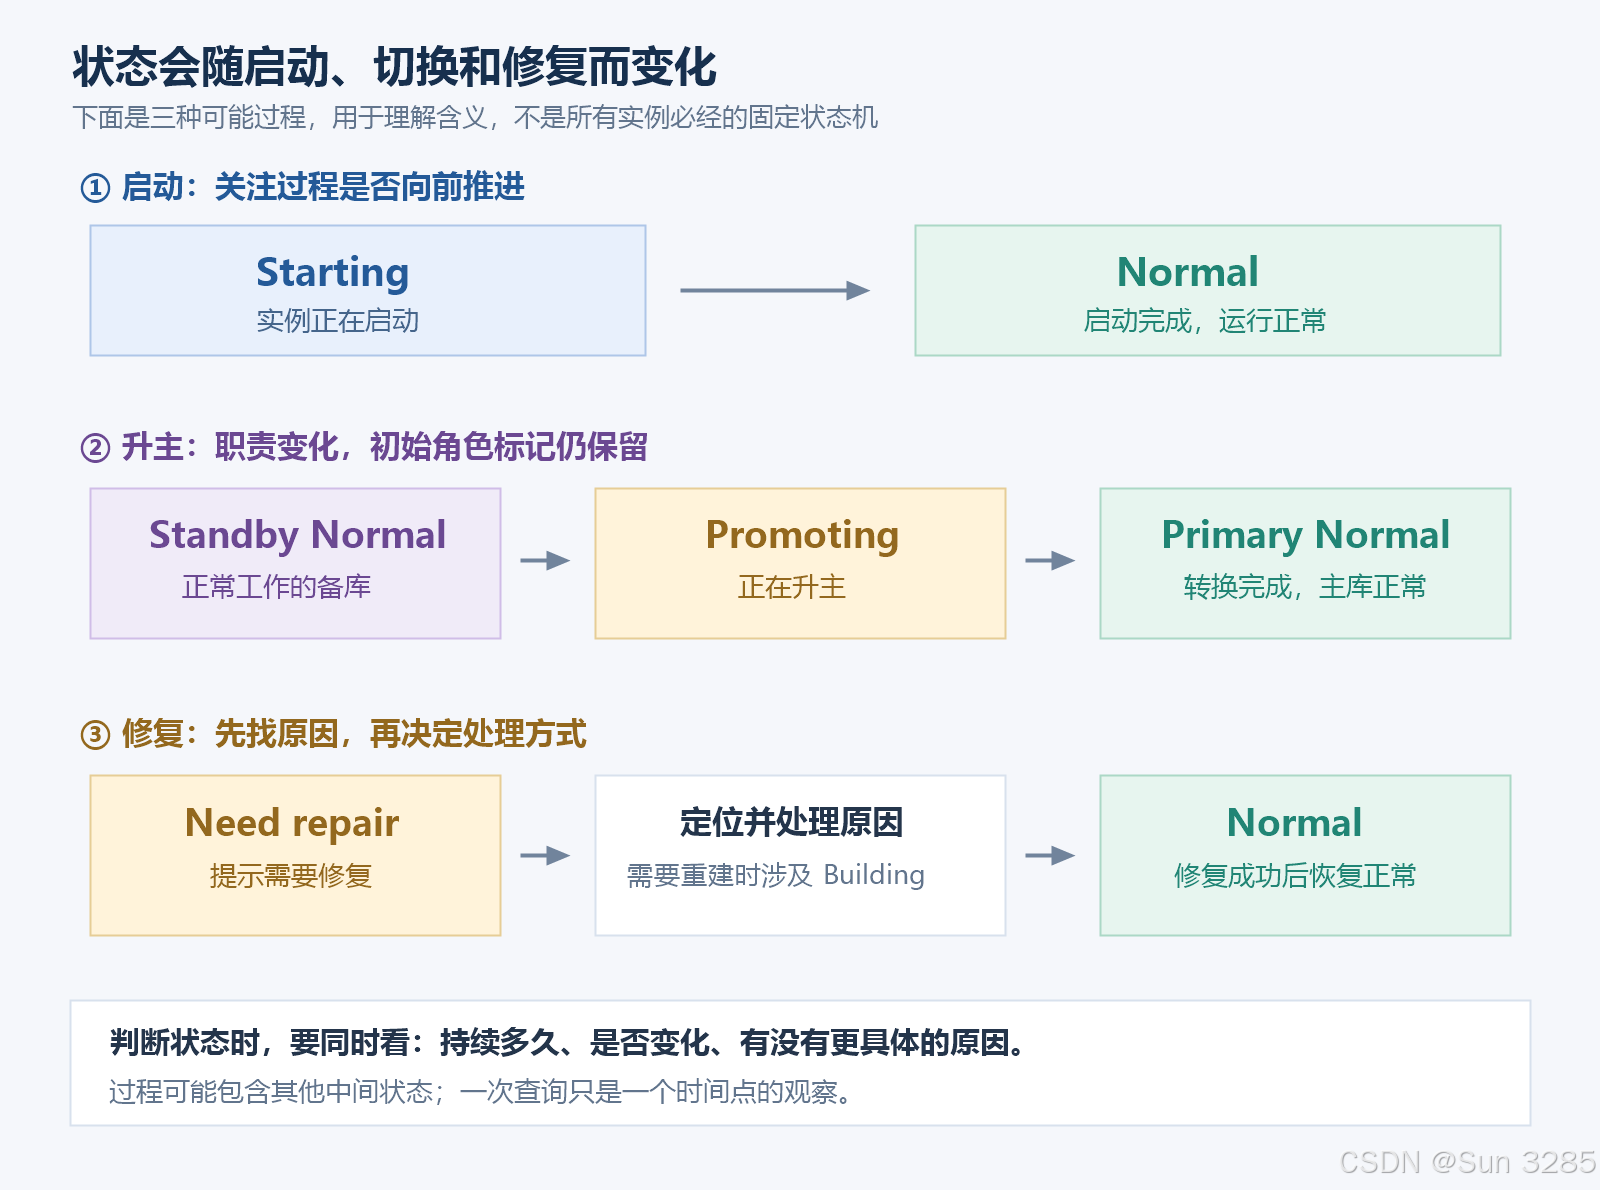
从上到下读,可以发现:
- CM Server 区块 :前三个分别为
Primary、Standby、Standby,第四个为Down。 - 集群区块 :整体为
Degraded,说明当前未达到完整健康状态。 - DN 区块 :前三个仍是
P Primary Normal、S Standby Normal、S Standby Normal,第四个显示S Down Unknown。
这张图直接说明:集群降级时,仍可能存在正常的主库和多个备库。第四个 DN 中的 S 记录初始备角色,Down 和 Unknown 则提示它当前存在停机及状态信息不完整的情况,应继续定位,不能只看前面的 S 就把它算作健康备库。
这里的冗余指主备副本提供的保护,并不表示已经完成独立备份。即使 cluster_state : Normal,也不能据此推断历史备份可用、业务没有误删,或者应用不存在慢 SQL。
另外,查询超时、连不上 CM 与明确返回 Unavailable 是不同现象。前者首先说明这次查询没有取得有效结果,仍需进一步判断数据库实际情况。
四、实例角色:除了 Primary、Standby,还有什么?
先认识稳定运行时的三种主备角色,再看角色栏里可能出现的过渡或异常信息。
1. 稳定角色:主、备、级联备
| 角色 | 含义 | 与业务和复制的关系 |
|---|---|---|
Primary |
主实例 | 在本文架构中承担业务写入,向备库发送日志 |
Standby |
备实例 | 从主库接收并回放日志;满足相应条件时可提供只读查询或接替主库 |
Cascade Standby |
级联备实例 | 从上游备库接收日志,形成"主 → 备 → 级联备"的复制关系 |
普通一主两备可以是"A 主库分别向 B、C 两个备库发送日志";级联结构则可以是"A 主库发给 B 备库,再由 B 发给 C 级联备"。"第二个备库"并不自动等于"级联备",区别在复制来源和配置角色。
级联复制能减轻主库直接向多个副本发送日志的压力,但增加了一个传递环节。在 openGauss 6.0 所述级联备模式下,备库到级联备采用异步复制,级联备也不能直接当作普通备库随意升主。本次只需认识其含义,不展开部署和转换操作。
此外,某些工具的角色说明中还会出现 Normal,用于表示单机实例;它与 Primary Normal 末尾表示运行正常的 Normal 含义不同。判断时仍要看字段位置和部署方式。
2. 过渡和异常提示:不是新的业务分工
状态输出的 state 区域有时会同时容纳角色和异常信息。因此,下面这些名称虽然可能出现在相近位置,却不能理解成与"主、备"并列的长期业务角色。
| 名称 | 含义 | 容易误解的地方 |
|---|---|---|
Pending |
处于仲裁阶段,等待角色确定 | 不代表正在排队执行 SQL |
Unknown |
当前无法确定角色或状态 | 信息不足,不等于已经确认宕机 |
Down |
实例被判断为未运行或宕机 | 指实例不可用,不能直接断定整台服务器断电 |
Abnormal |
实例或节点存在异常 | 是概括性提示,具体原因需结合详细信息 |
Manually stopped |
已通过管理操作手动停止 | 表达停止意图,应与意外退出区分 |
例如,管理链路异常时,工具可能暂时无法确定实例状态,但数据库进程仍在运行;这就是为什么 Unknown 和 Down 不能互相替换。
五、运行状态:角色确定了,还可能正在启动或恢复
知道一个实例是 Standby,并不能说明它已经健康地承担备库工作。还要看它当前处于哪个运行阶段。
| 运行状态 | 含义 | 阅读重点 |
|---|---|---|
Normal |
实例运行状态正常 | 不等于复制延迟绝对为零 |
Starting |
正在启动 | 短暂出现可以是正常过程,长期停留才需要进一步定位 |
Catchup |
备库正在追赶主库 | 关注日志追赶进度,不能只凭名称判断追赶时间 |
Need repair |
实例需要修复 | 先看原因,不能看到它就直接决定全量重建 |
Building |
与备库构建、重建相关的状态 | 尚不能作为正常就绪的备库看待,应结合构建进度与日志判断 |
Wait promoting |
等待升主流程推进 | 表示角色转换中的等待,不是数据库软件版本升级 |
Promoting |
正在升为主实例 | 角色转换尚在进行,不等于应用已经恢复访问 |
Demoting |
正在从主角色降为备角色 | 这里的"降级"指角色变化,与集群 Degraded 不同 |
Coredump |
程序崩溃相关状态 | 需要结合崩溃记录和日志定位原因 |
Unknown |
运行状态未知 | 与角色未知一样,都要先确认监测信息是否完整 |
这张表是常见名称的阅读指南,不是所有工具、所有模式都统一使用的完整枚举;某些状态持续很短,也未必会在一次查询中被捕捉到。
Need repair 后面的原因,比这个标签更具体
Need repair 告诉我们"需要处理",后面的原因则帮助说明"为什么不能正常工作"。例如:
Disconnect:备库无法连接主库,应先检查连接链路和主库状态。WAL segment removed:所需日志段缺失等日志衔接问题,需要判断是否还能补齐或恢复复制。Version not matched:主备二进制版本不匹配。System id not matched:主备数据库的系统标识不一致,不是改成相同数据库名就能解决。Timeline not matched:日志时间线不匹配。时间线用于区分恢复、切换后可能形成的日志历史分支,不是操作系统的时区。
可以把诊断层次理解为:"这个实例是备库"说明职责,"它需要修复"说明状态,"连接不上主库"进一步说明原因。三层信息应当连起来阅读。
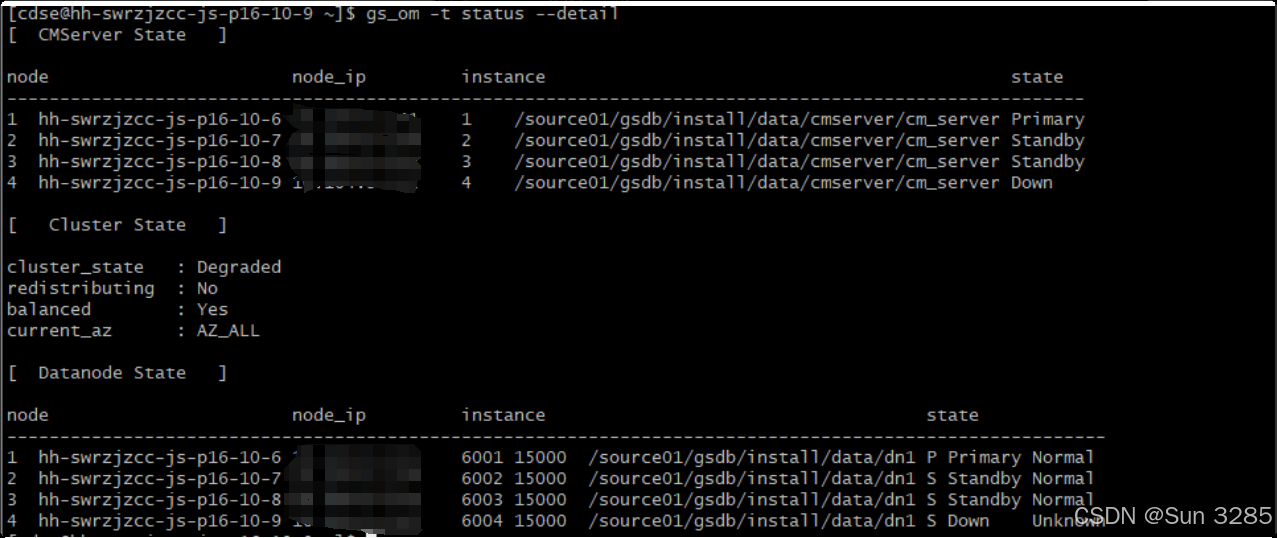
图中展示三种可能的过程。具体经过哪些中间状态、是否需要重建,取决于触发原因和处理方式;不是每次都按图中顺序完整出现。
六、用一次主备切换,把这些名称串起来
假设一主两备运行正常,DN 的简化输出如下:
text
A    P Primary Normal
B    S Standby Normal
C    S Standby Normal
现在进行一次满足条件的计划内主备切换:B 接替为主,A 转为备,C 继续作为备库。角色转换过程中,可能观察到 B 的 Promoting、A 的 Demoting;具体采样不保证能看到每一个中间状态。
切换完成并恢复正常复制后,输出可以变成:
text
A    P Standby Normal
B    S Primary Normal
C    S Standby Normal
这时有三个结论:A 前面的 P 仍记录初始主角色,但它当前是备;B 前面的 S 没有妨碍它成为当前主;当集群满足正常运行条件时,整体仍可为 Normal。主库位置发生变化,本身不等于集群异常。
如果随后 C 出现 Need repair,就需要分别判断:A、B 当前是否健康,C 的具体修复原因是什么,集群整体被判为哪种状态。不能把 C 的异常直接解释成 B 已不再是主,也不能仅凭 B 的 Primary 就认定集群整体健康。
实际阅读时,按以下顺序即可:
- 先看区块:这是 CM Server、DN,还是集群整体?
- 再看当前角色:谁现在是主,谁是备?不要把初始角色标记当成当前角色。
- 接着看运行状态和原因:是正常、过渡中,还是需要处理?
- 最后联系时间变化 :刚启动时的
Starting与长期卡住的Starting,需要作出的判断不同。
例如,读到 B S Primary Normal,可以直接翻译成一句话:"B 的 DN 最初配置为备,现在承担主角色,目前运行状态正常。"这比孤立记忆每个英文单词更容易理解,也更不容易误判。