1.KNN算法简介
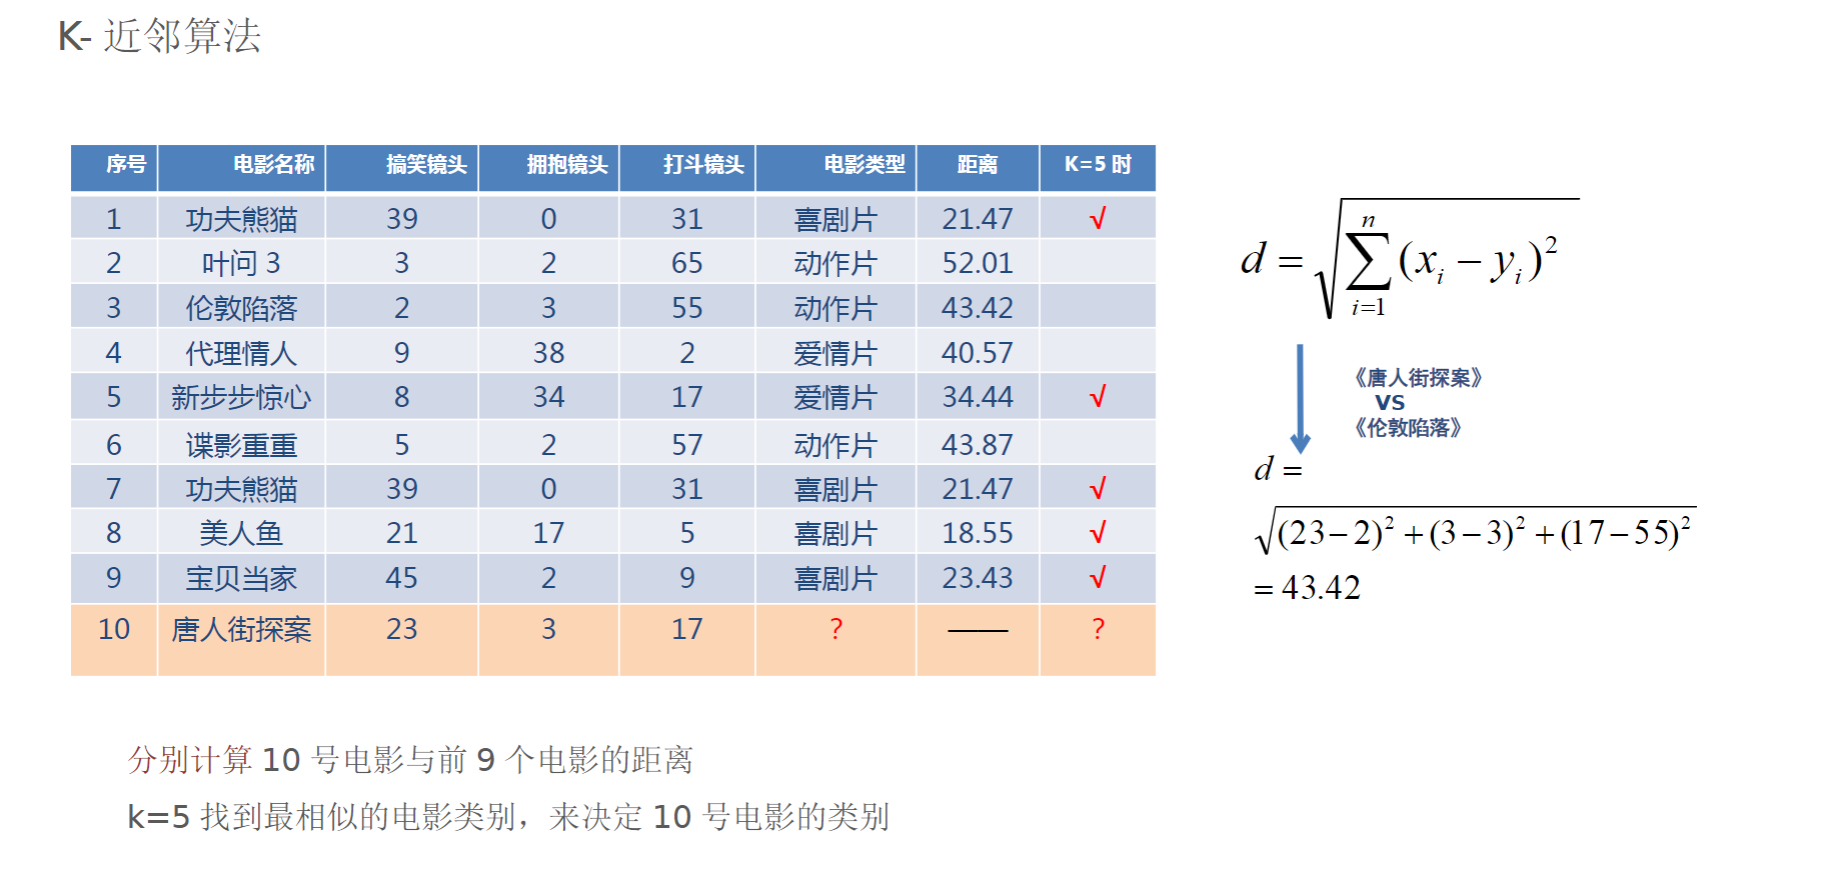
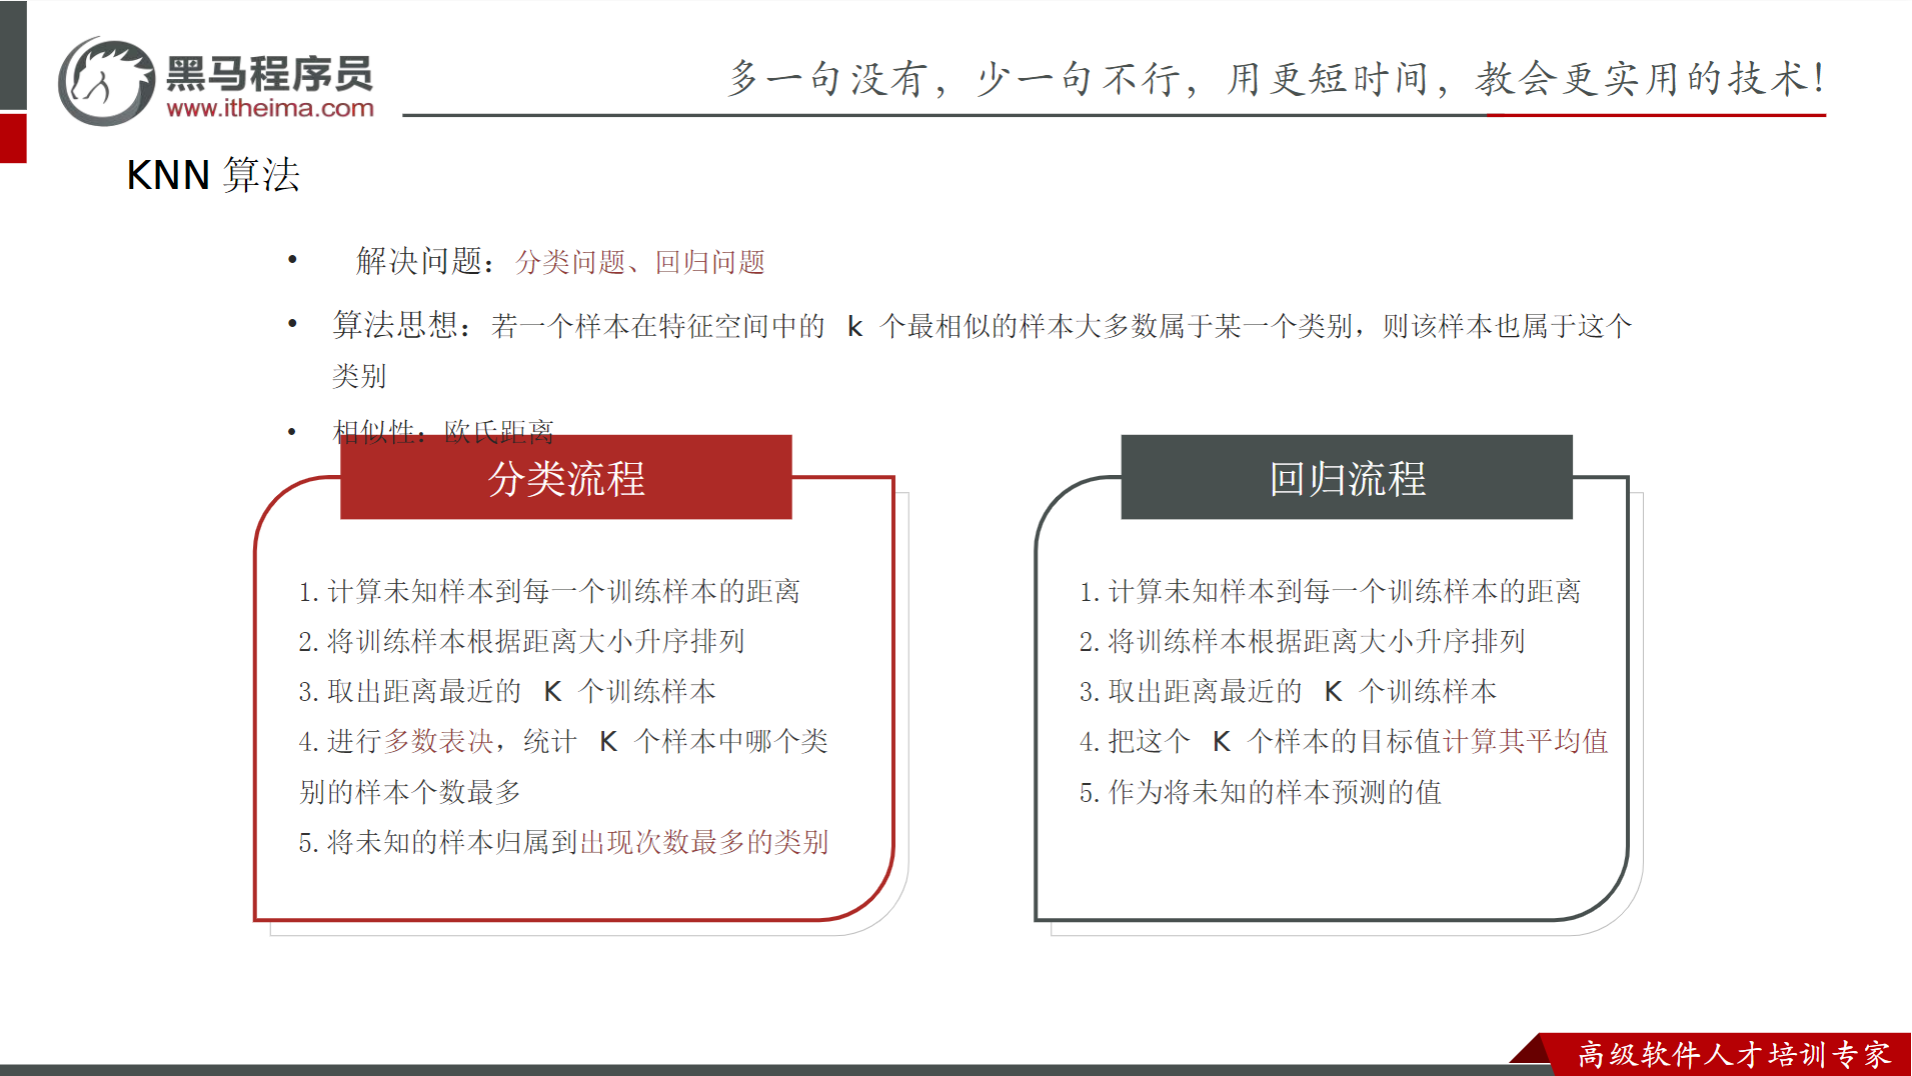
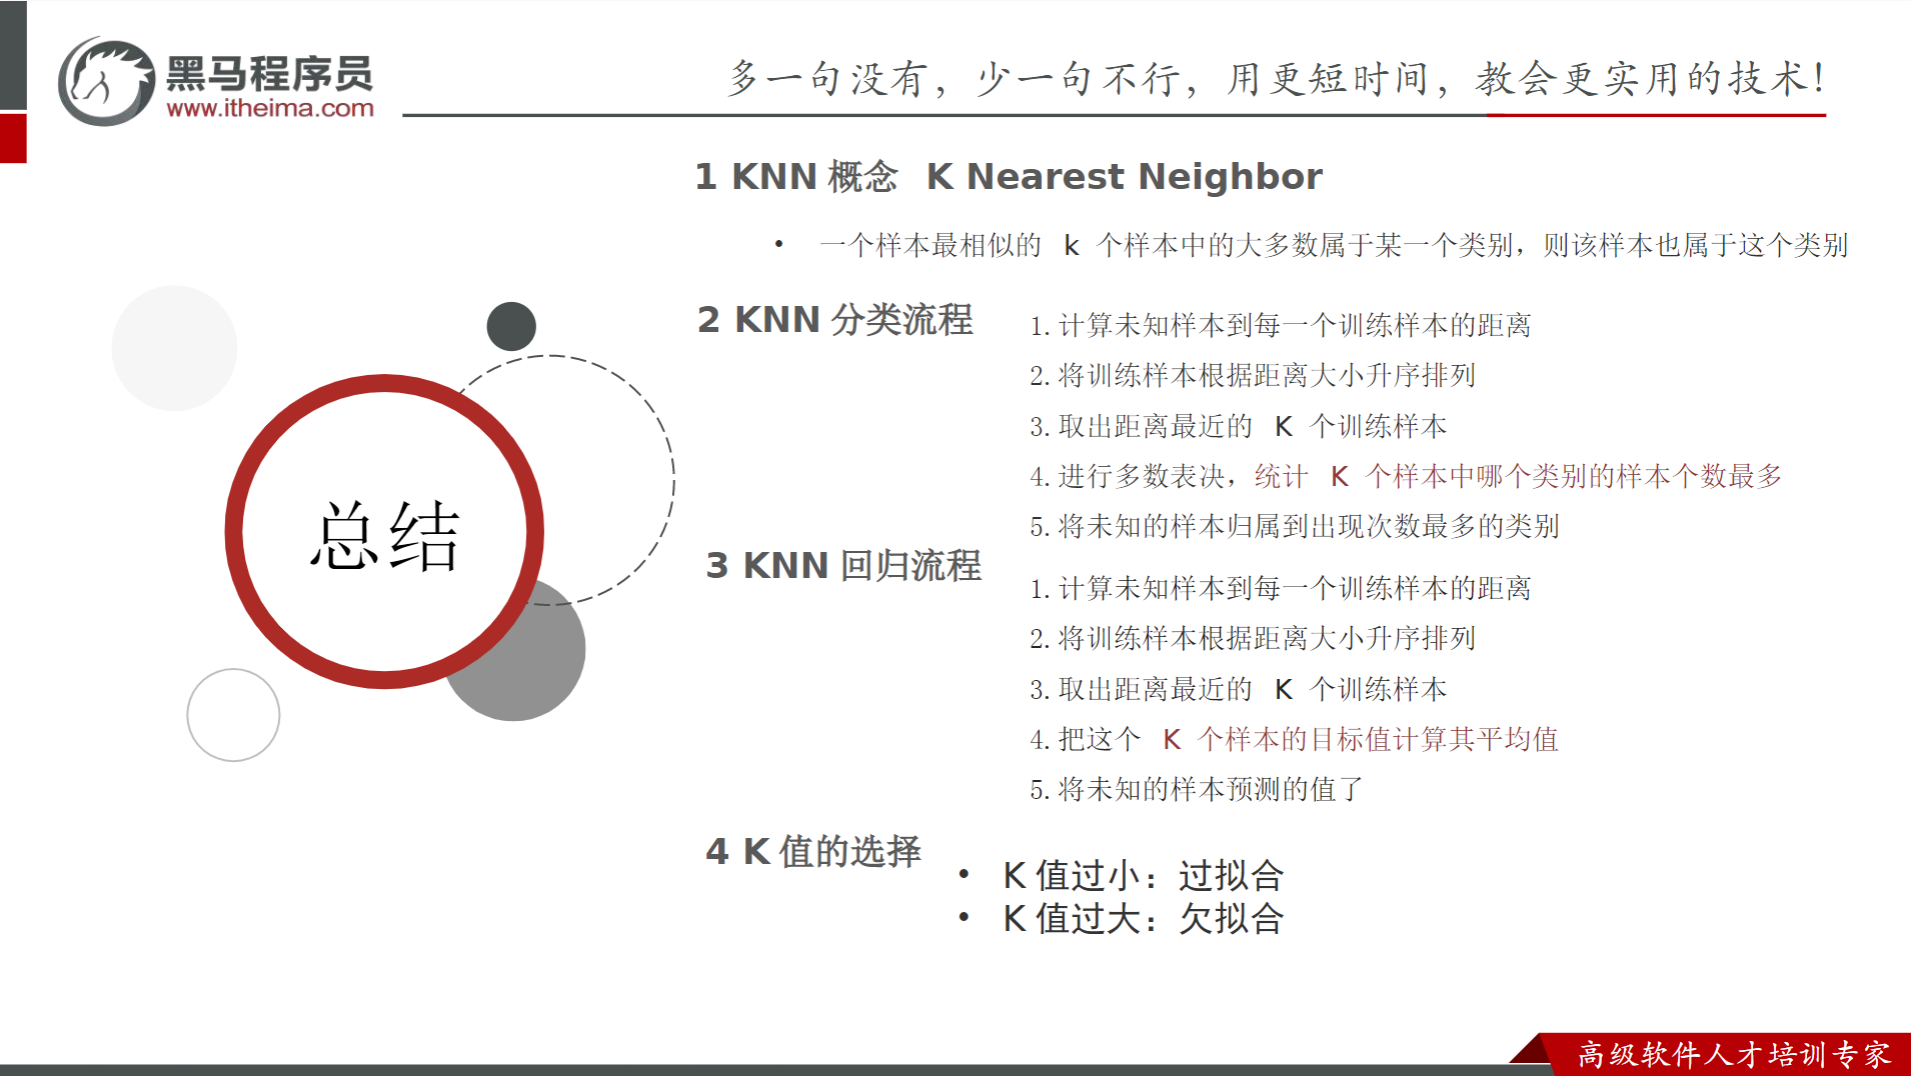
K近邻分类应用于投票;回归应用于均值
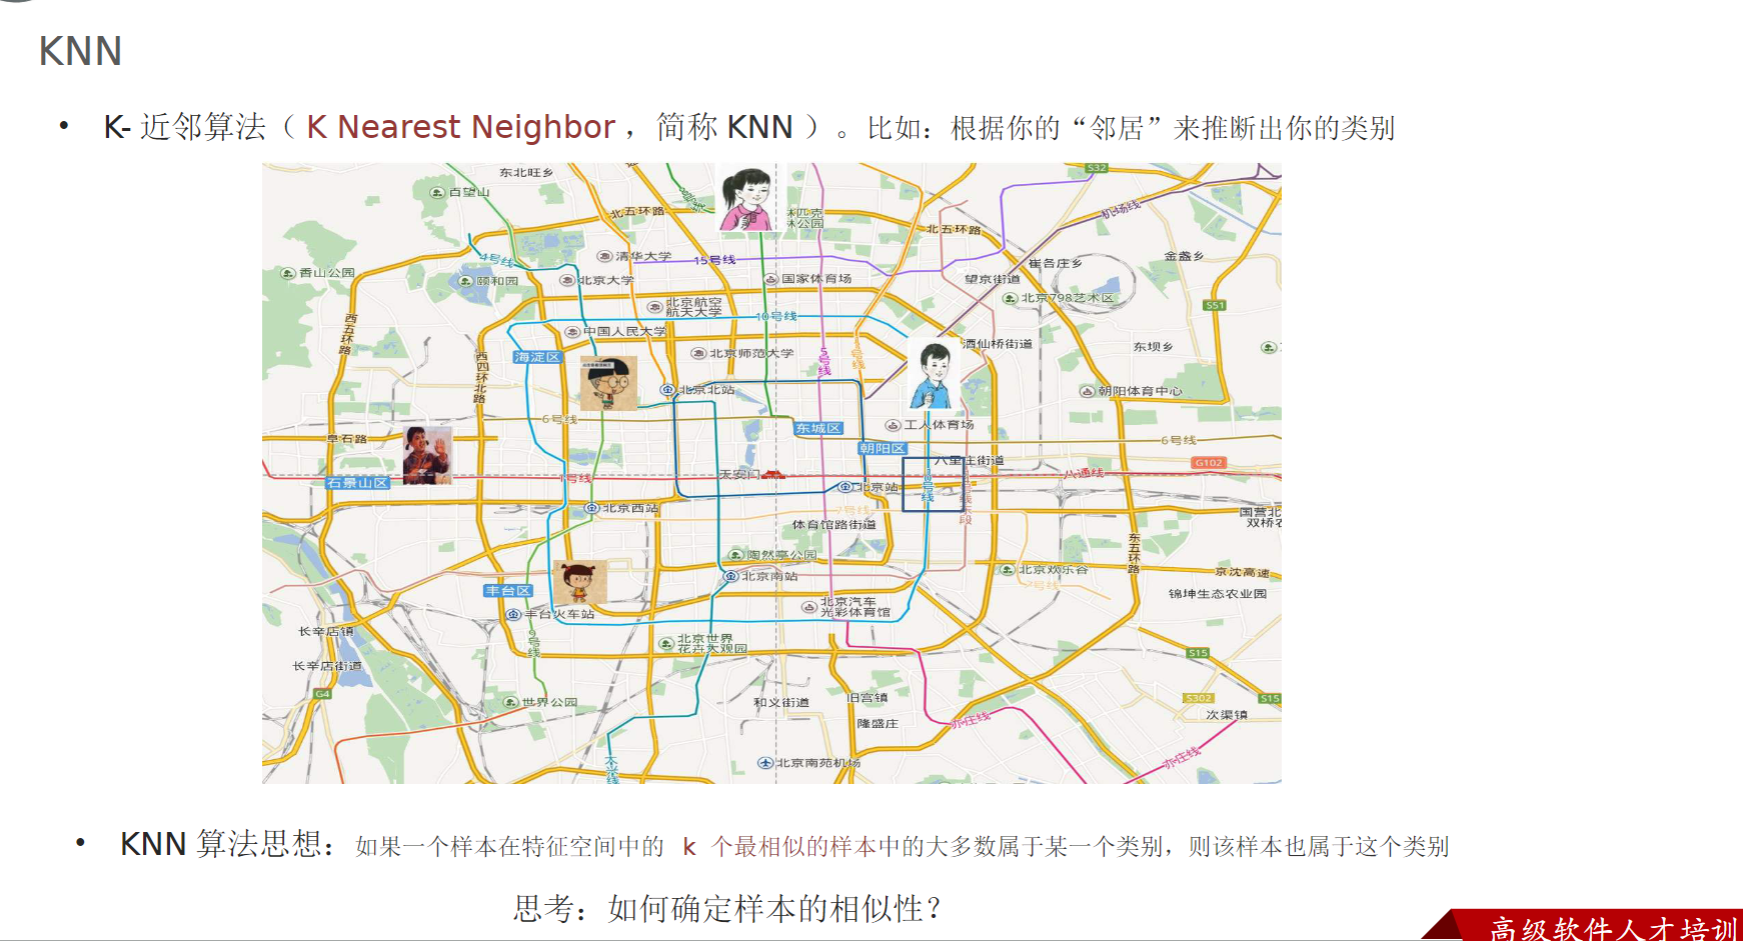
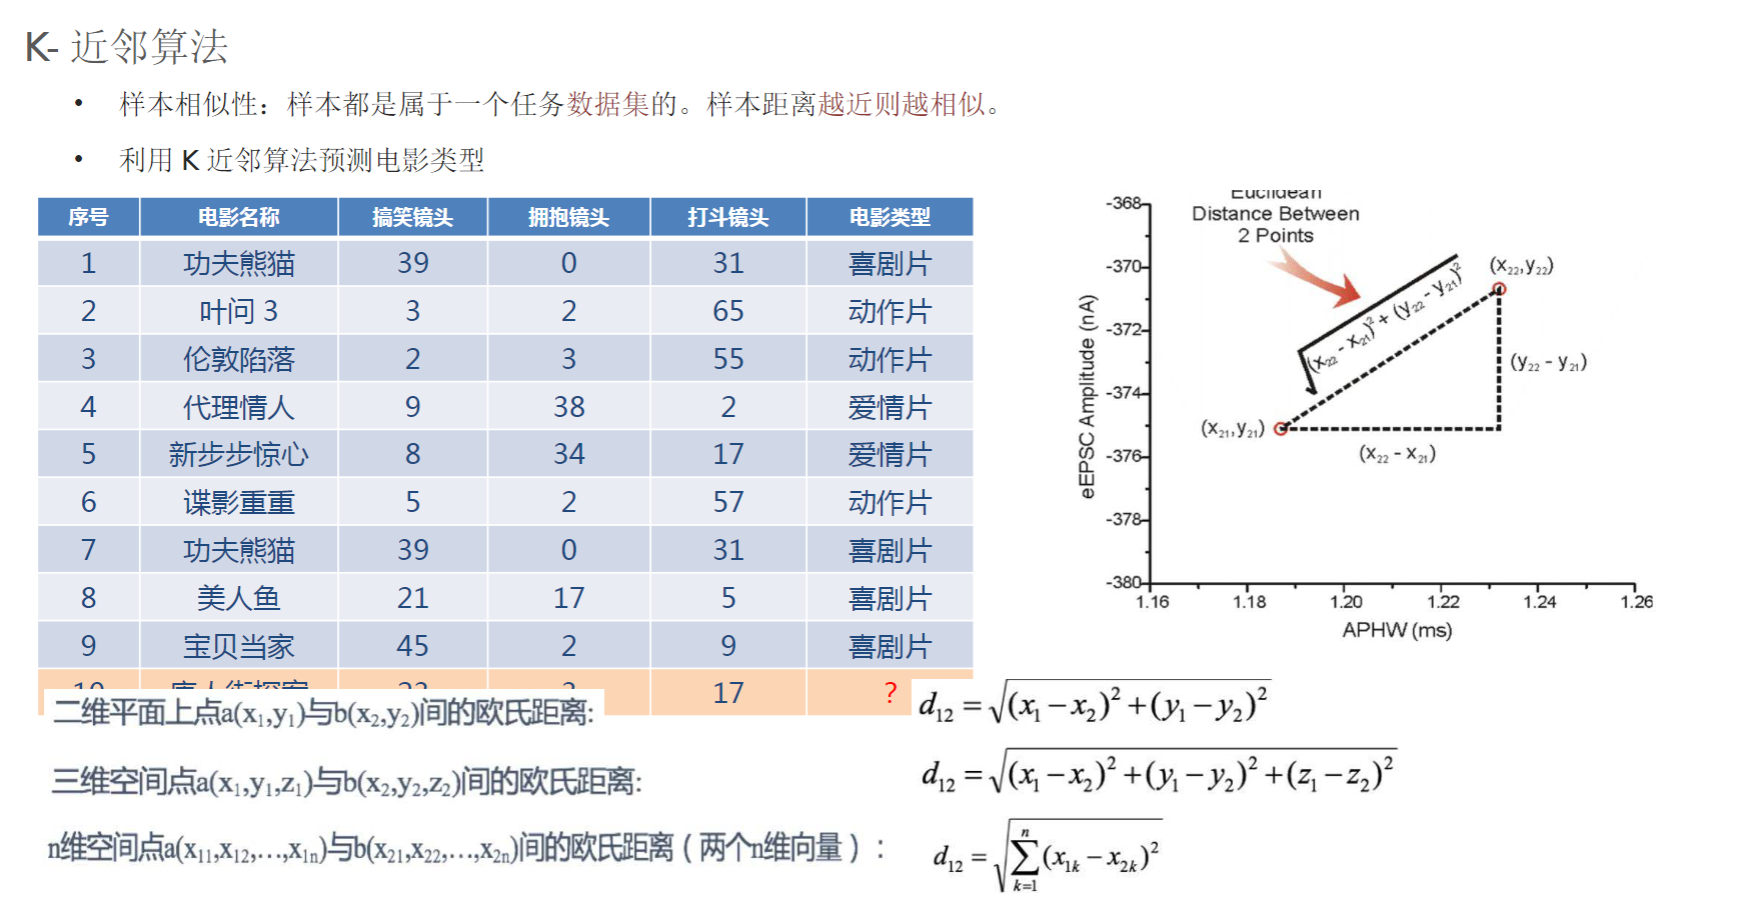
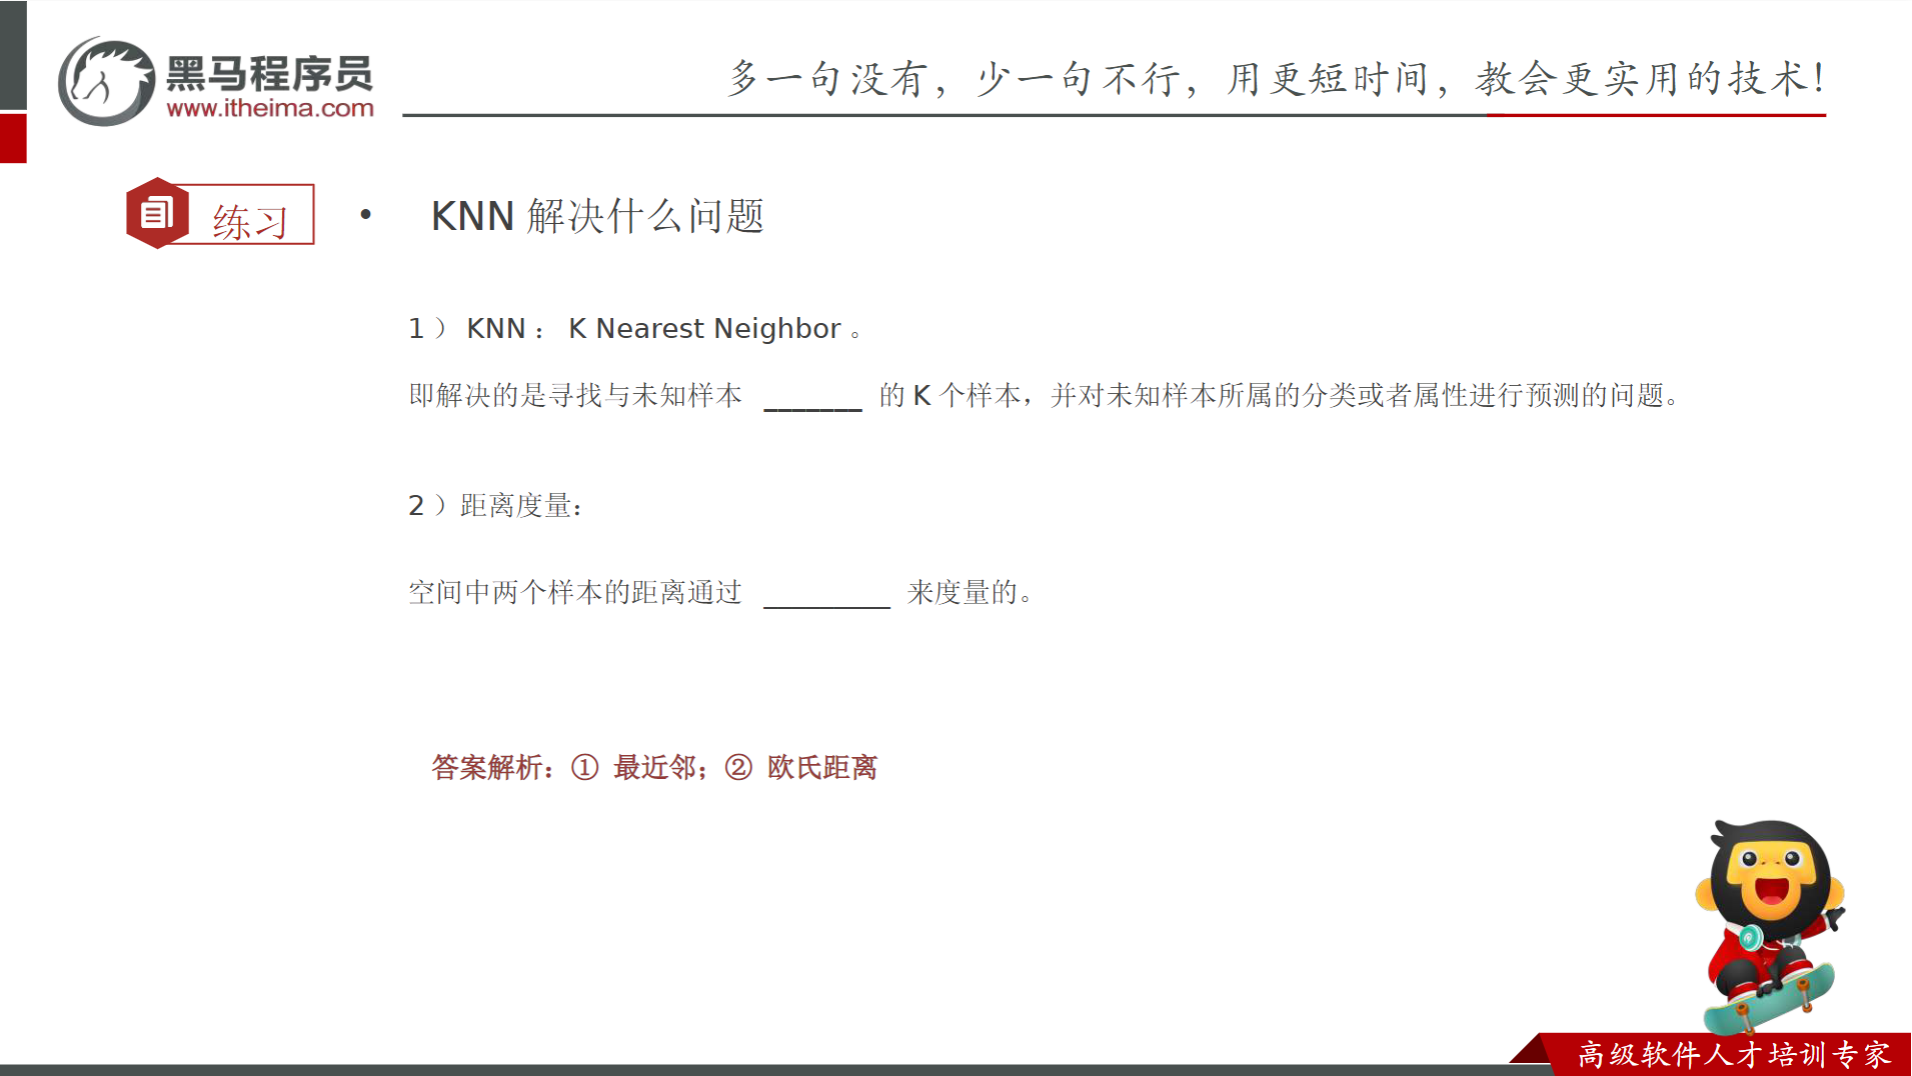
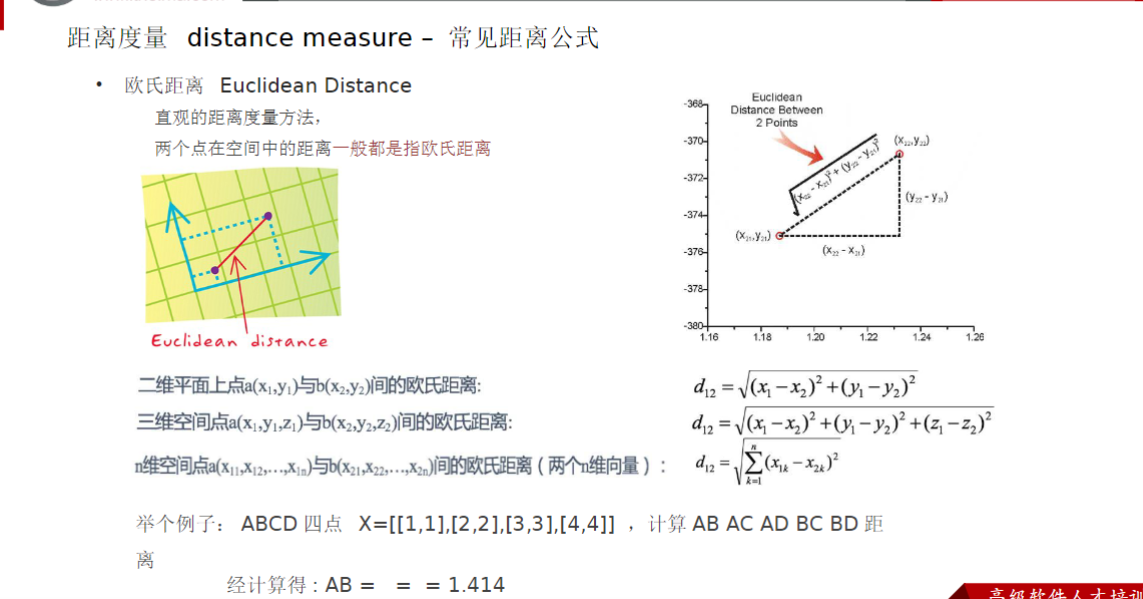
欧式距离=对应维度差值平方和,开平方根;也就是两点间距离公式
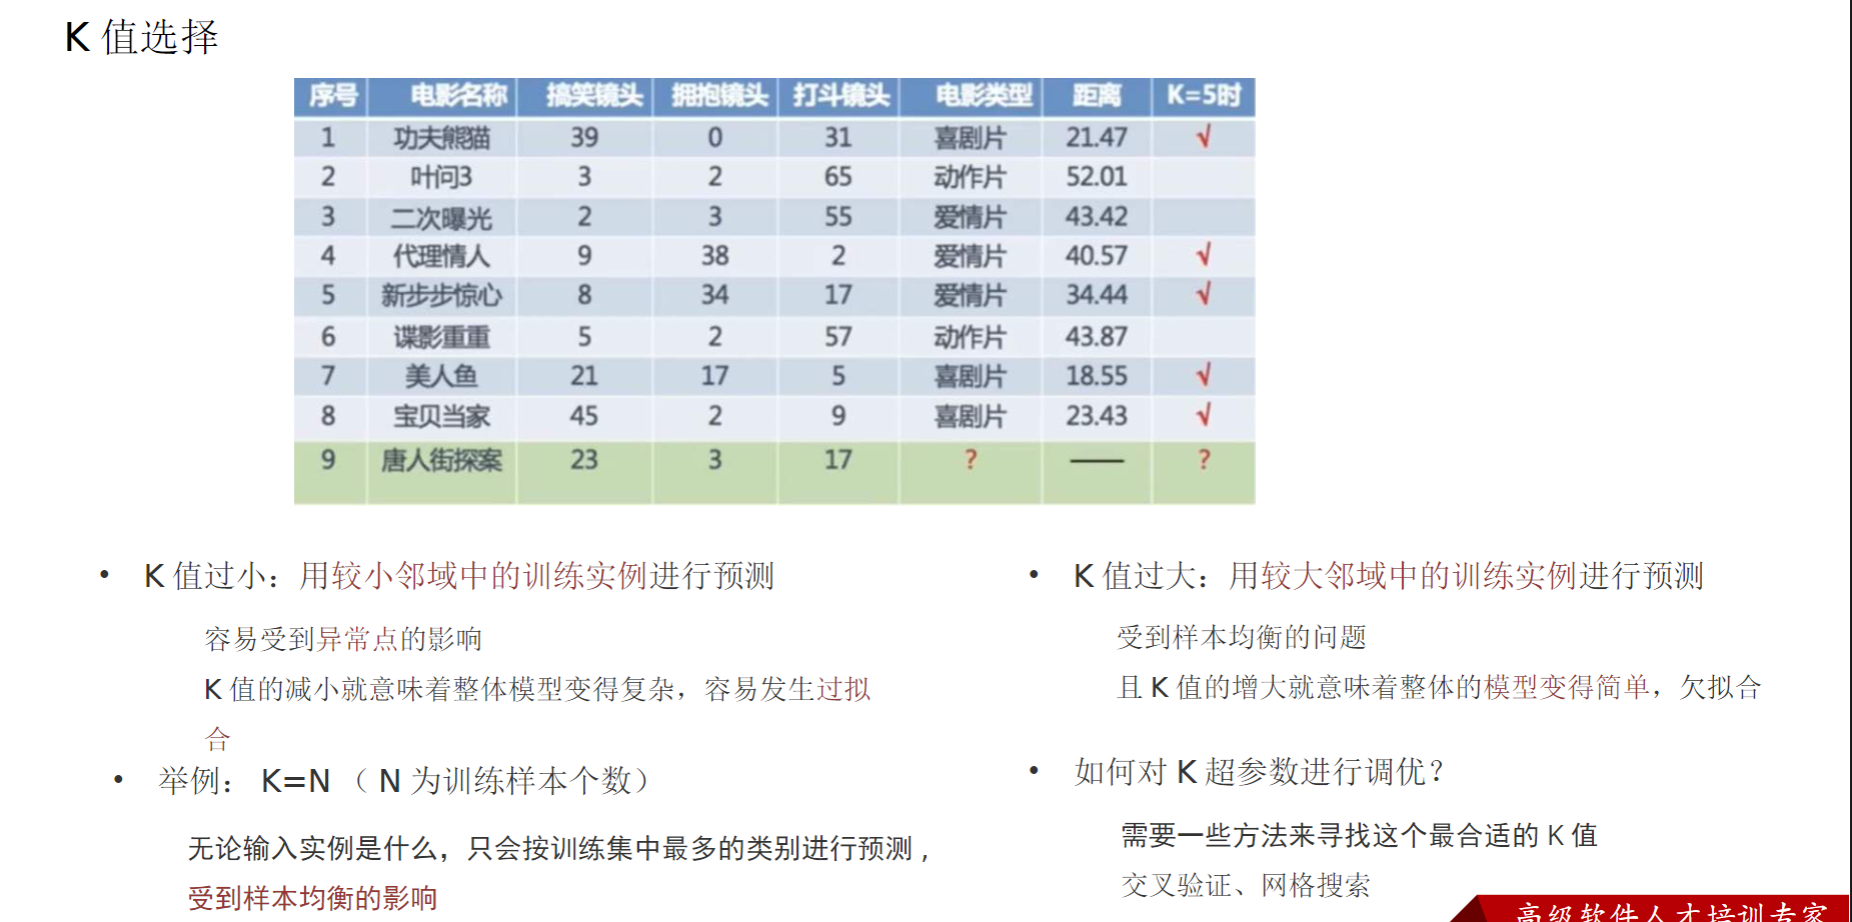
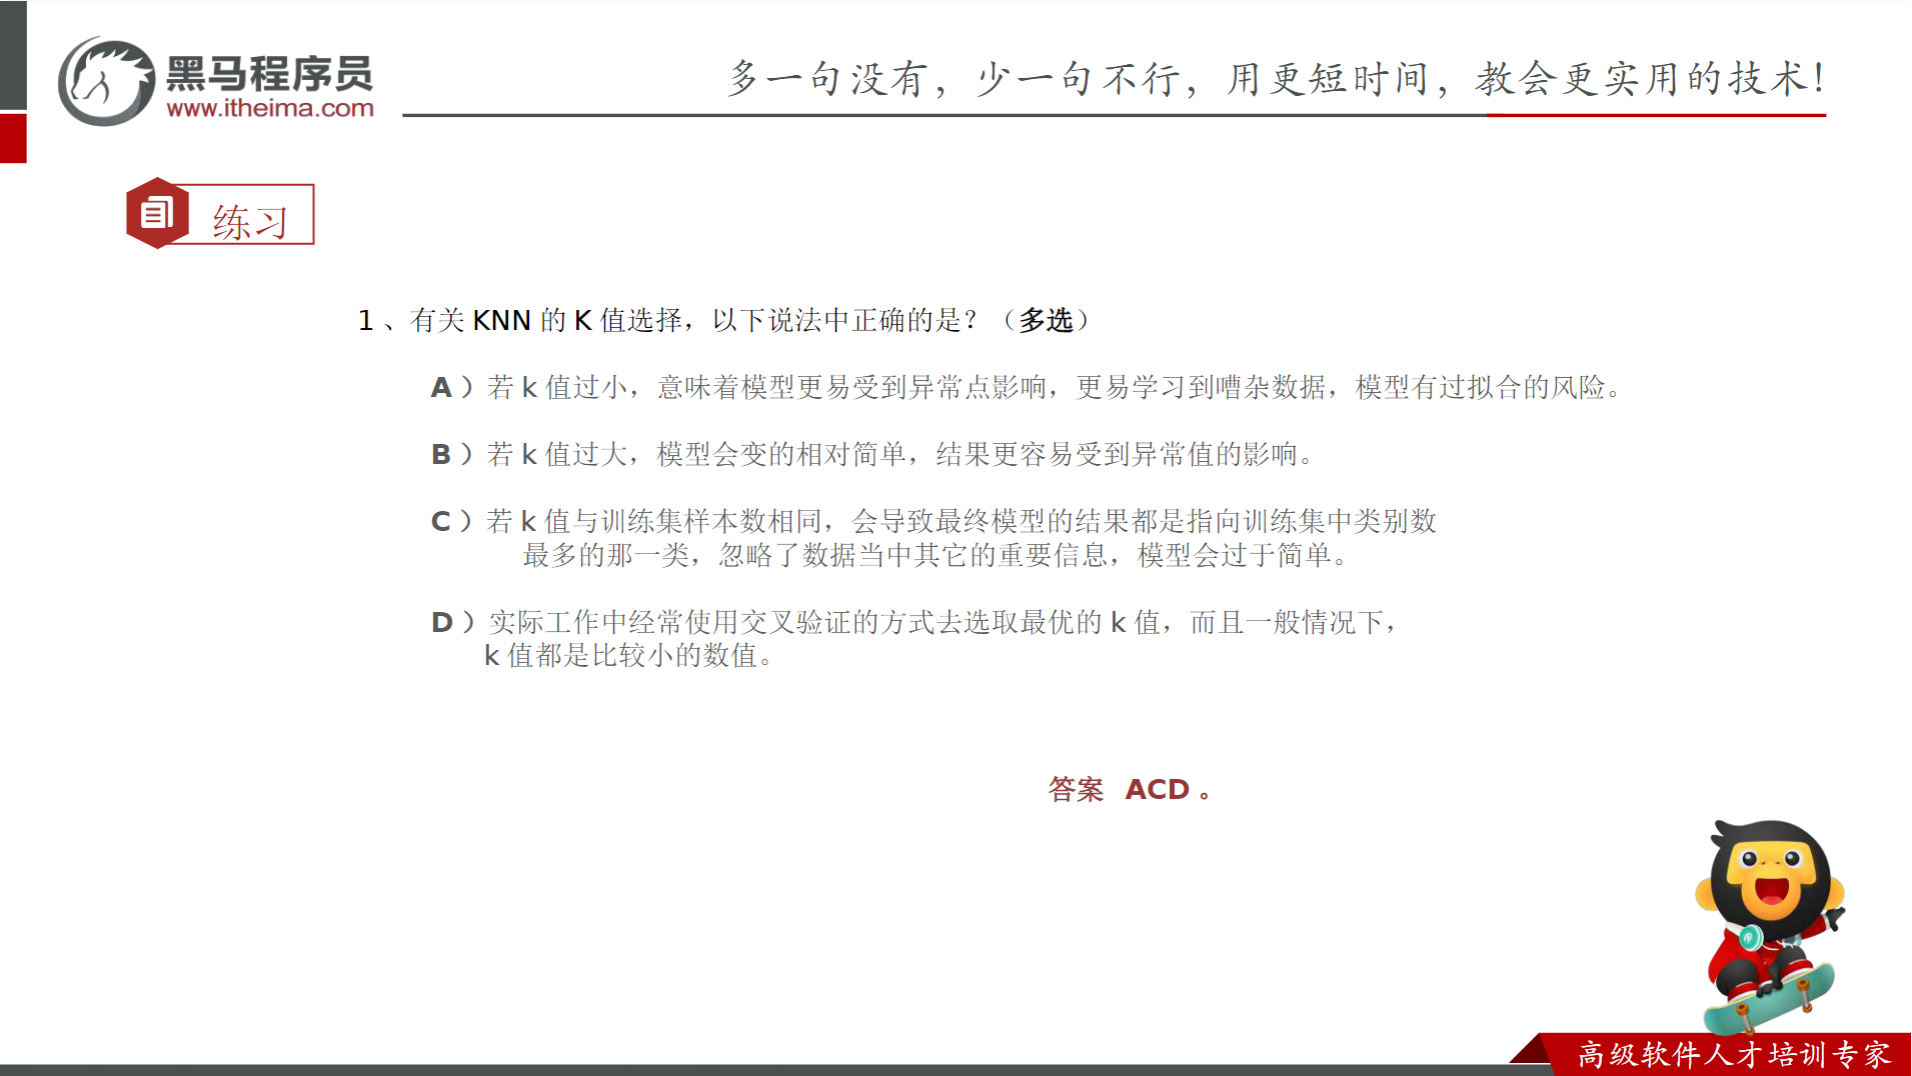
K值过大欠拟合,K值过小过拟合
2.KNN算法API介绍
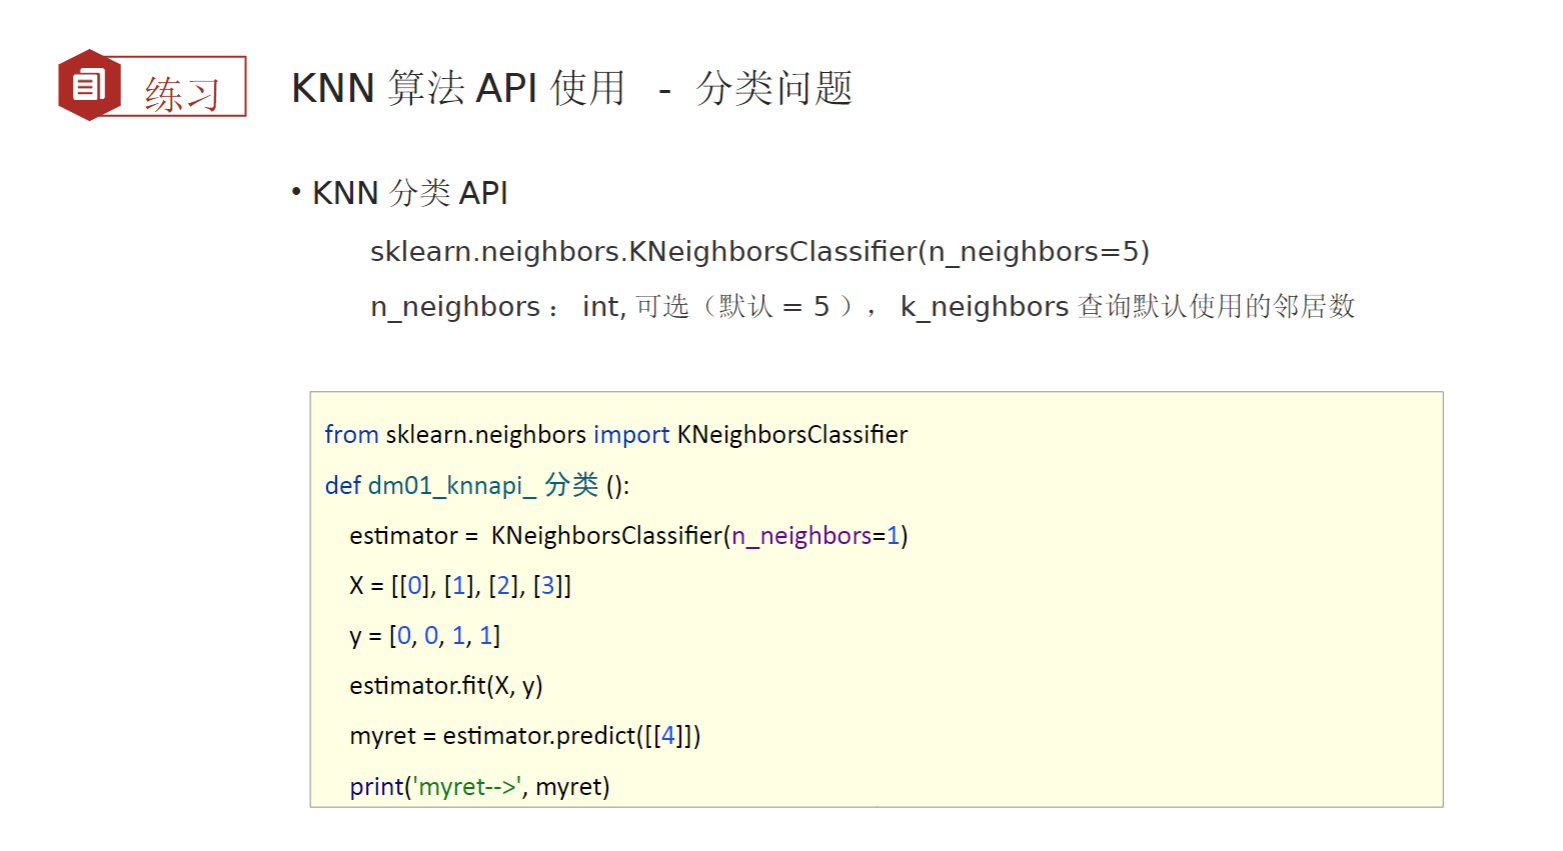
python
"""
KNN算法_分类思路
1.计算测试集与每个训练集的距离
2.基于距离进行升序排列
3.取前K个距离最小的样本
4.根据前K个样本的类别, 进行投票,
5.取票数最多的类别作为测试集的类别.
代码实现思路:
1.导包
2.准备数据集(训练集和测试集)
3.创建(KNN分类模型)模型对象
4.模型训练
5.模型预测
"""
#导包
from sklearn.neighbors import KNeighborsClassifier
#准备数据集(测试集和训练集)
x_train =[[0],[1],[2],[3]]  # 训练集的特征值 因为特征可以有多个,所以用二维
y_train =[0,0,1,1]  # 训练集的类别 因为标签是离散的,所以用一维
x_test=[[5]]  # 测试集的特征值 测试集和训练集要保持一致
#创建(KNN分类模型)模型对象
estimator = KNeighborsClassifier(n_neighbors=4)
#模型训练
estimator.fit(x_train, y_train)
#模型预测
y_pre=estimator.predict(x_test)
#打印预测结果
print(f'预测结果为: {y_pre}')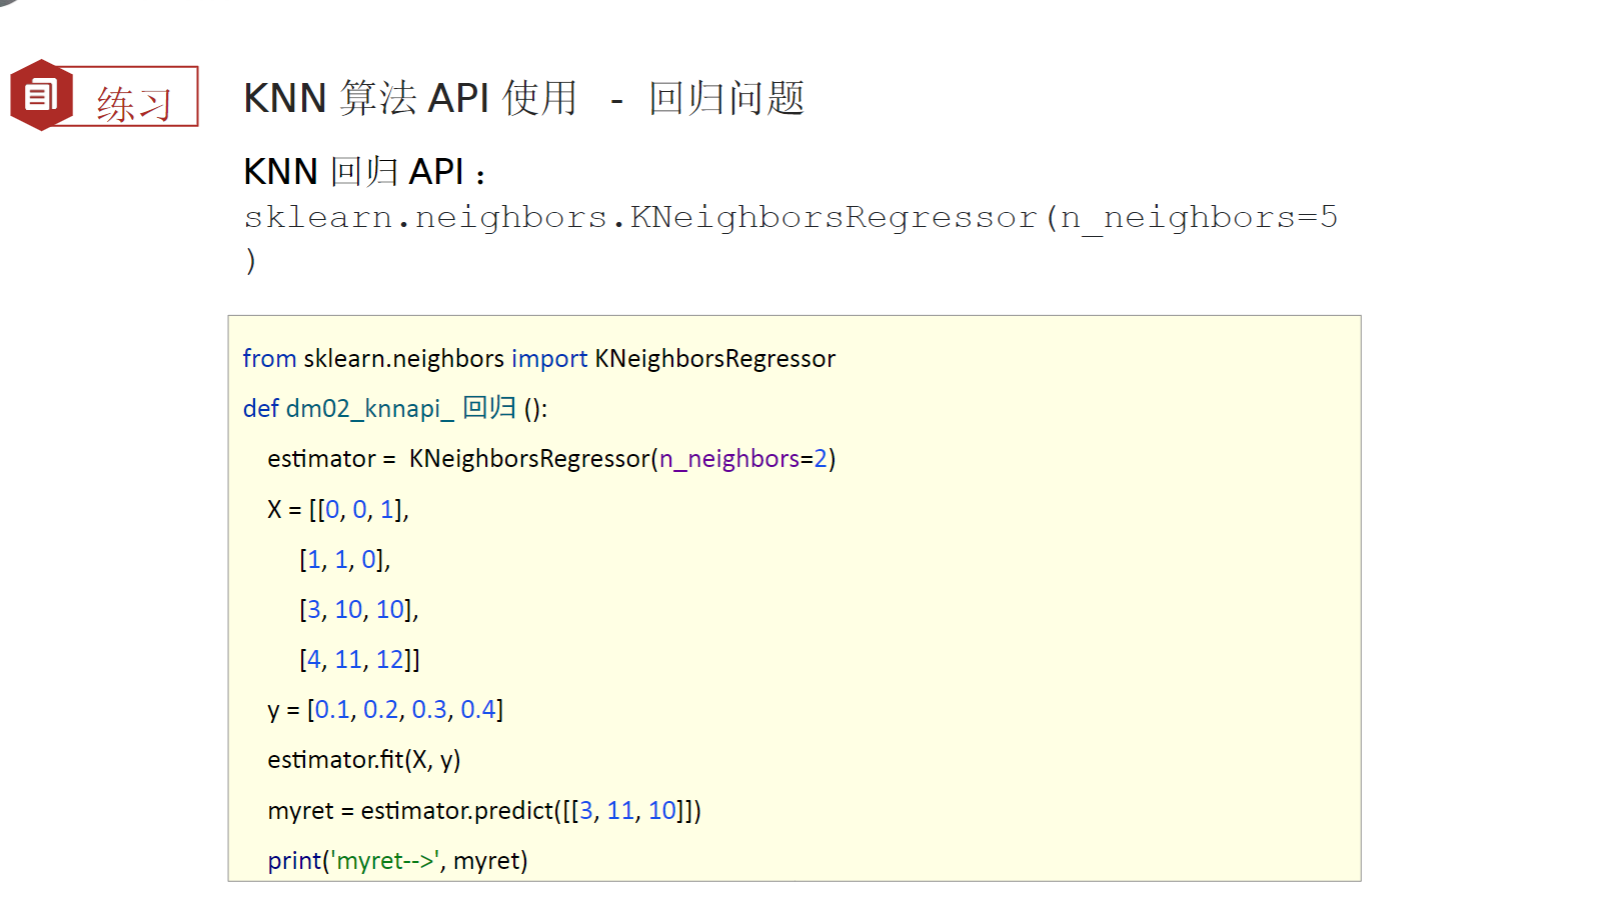
回归使用的是:欧氏距离(两点间距离公式)
python
"""
KNN算法_回归思路
1.计算测试集与每个训练集的距离
2.基于距离进行升序排列
3.取前K个距离最小的样本
4.基于前K个样本的标签值,计算平均值
5.将上述计算出来的平均值,作为测试集的结果.
代码实现思路:
1.导包
2.准备数据集(训练集和测试集)
3.创建(KNN回归模型)模型对象
4.模型训练
5.模型预测
总结:
K值过小,容易受到异常值的影响,且会导致模型学到大量的"脏的特征",导致出现过拟合现象。
K值过小,模型会变得简单,容易发生欠拟合现象。
"""
#导包
from sklearn.neighbors import KNeighborsRegressor
#准备数据集(测试集和训练集)
'''
开根号:14.53        14.29   1        2.24  从这里面找k个距离最小的样本
平方:   211         204     1         5
差值:   (3,11,9) (2,10,10)(0,1,0)  (1,0,2)也就是x_test和x_train的差值
'''
x_train=[[0,0,1],[1,1,0],[3,10,10],[4,11,12]]
y_train=[0.1,0.2,0.3,0.4]
x_test=[[3,11,10]]
#创建(KNN回归模型)模型对象
estimator = KNeighborsRegressor(n_neighbors=3)
#模型训练
estimator.fit(x_train, y_train)
#模型预测
y_pre=estimator.predict(x_test)
#打印预测结果
print(f'预测结果为: {y_pre}')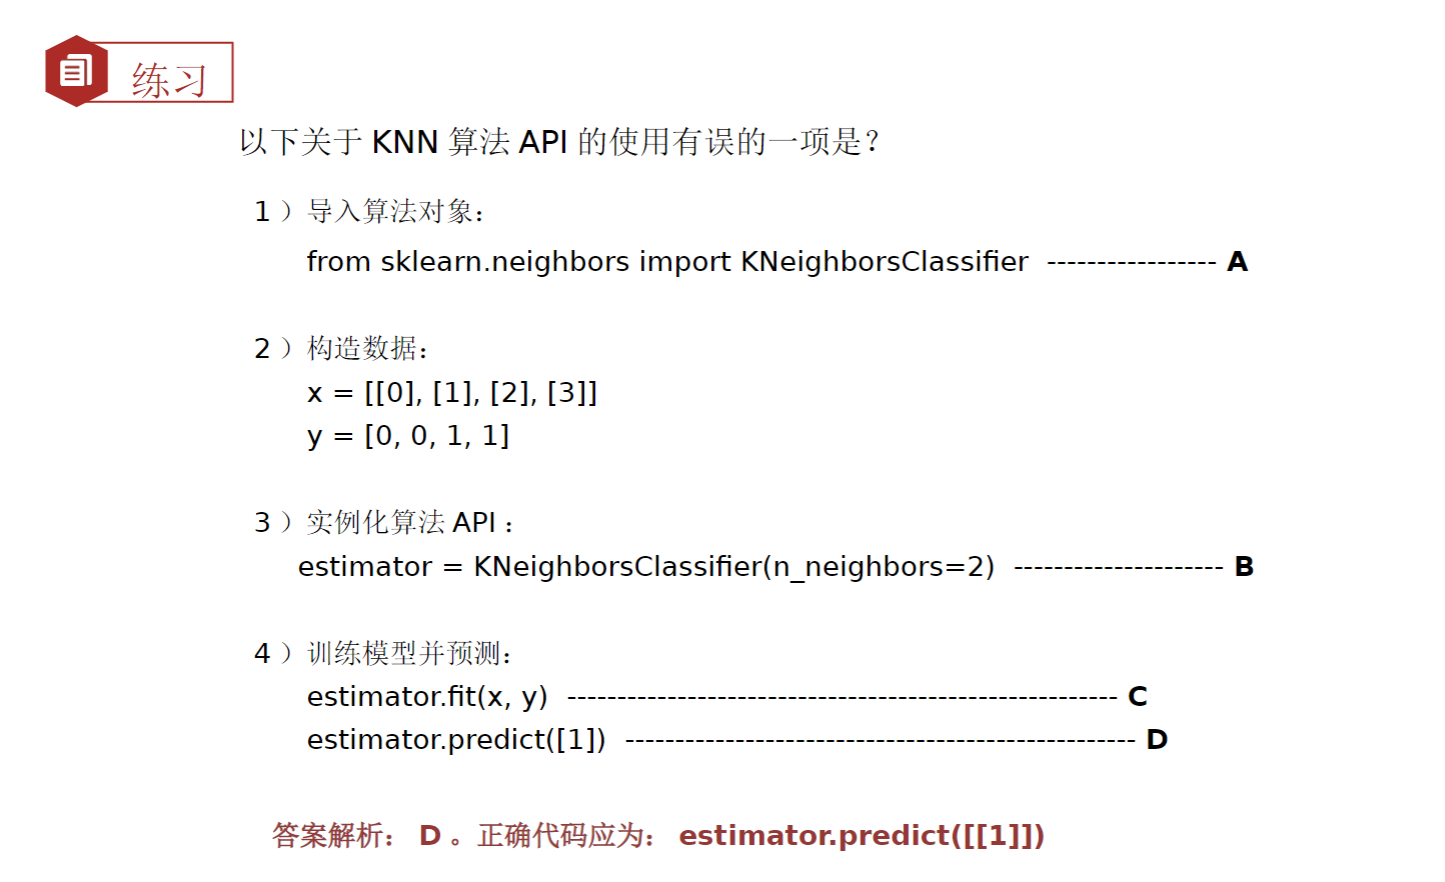
3.距离度量
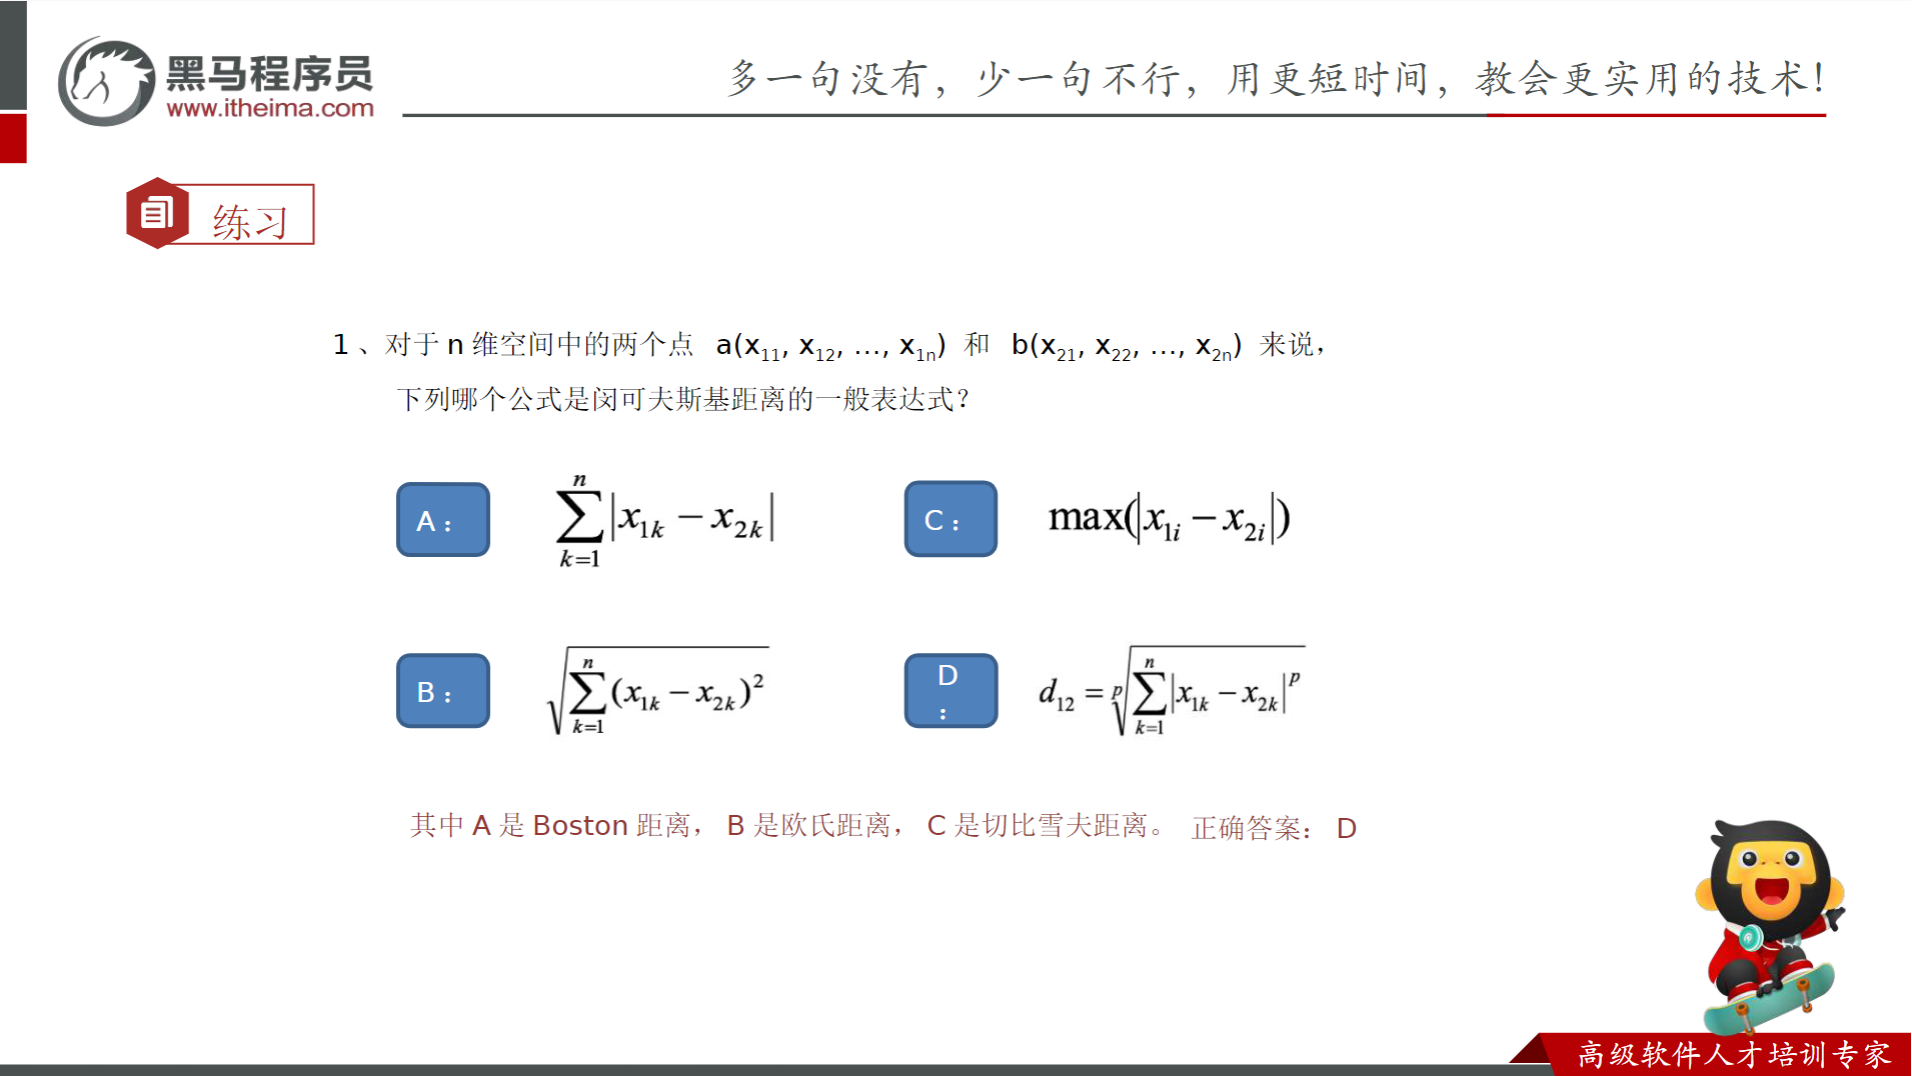
欧式距离
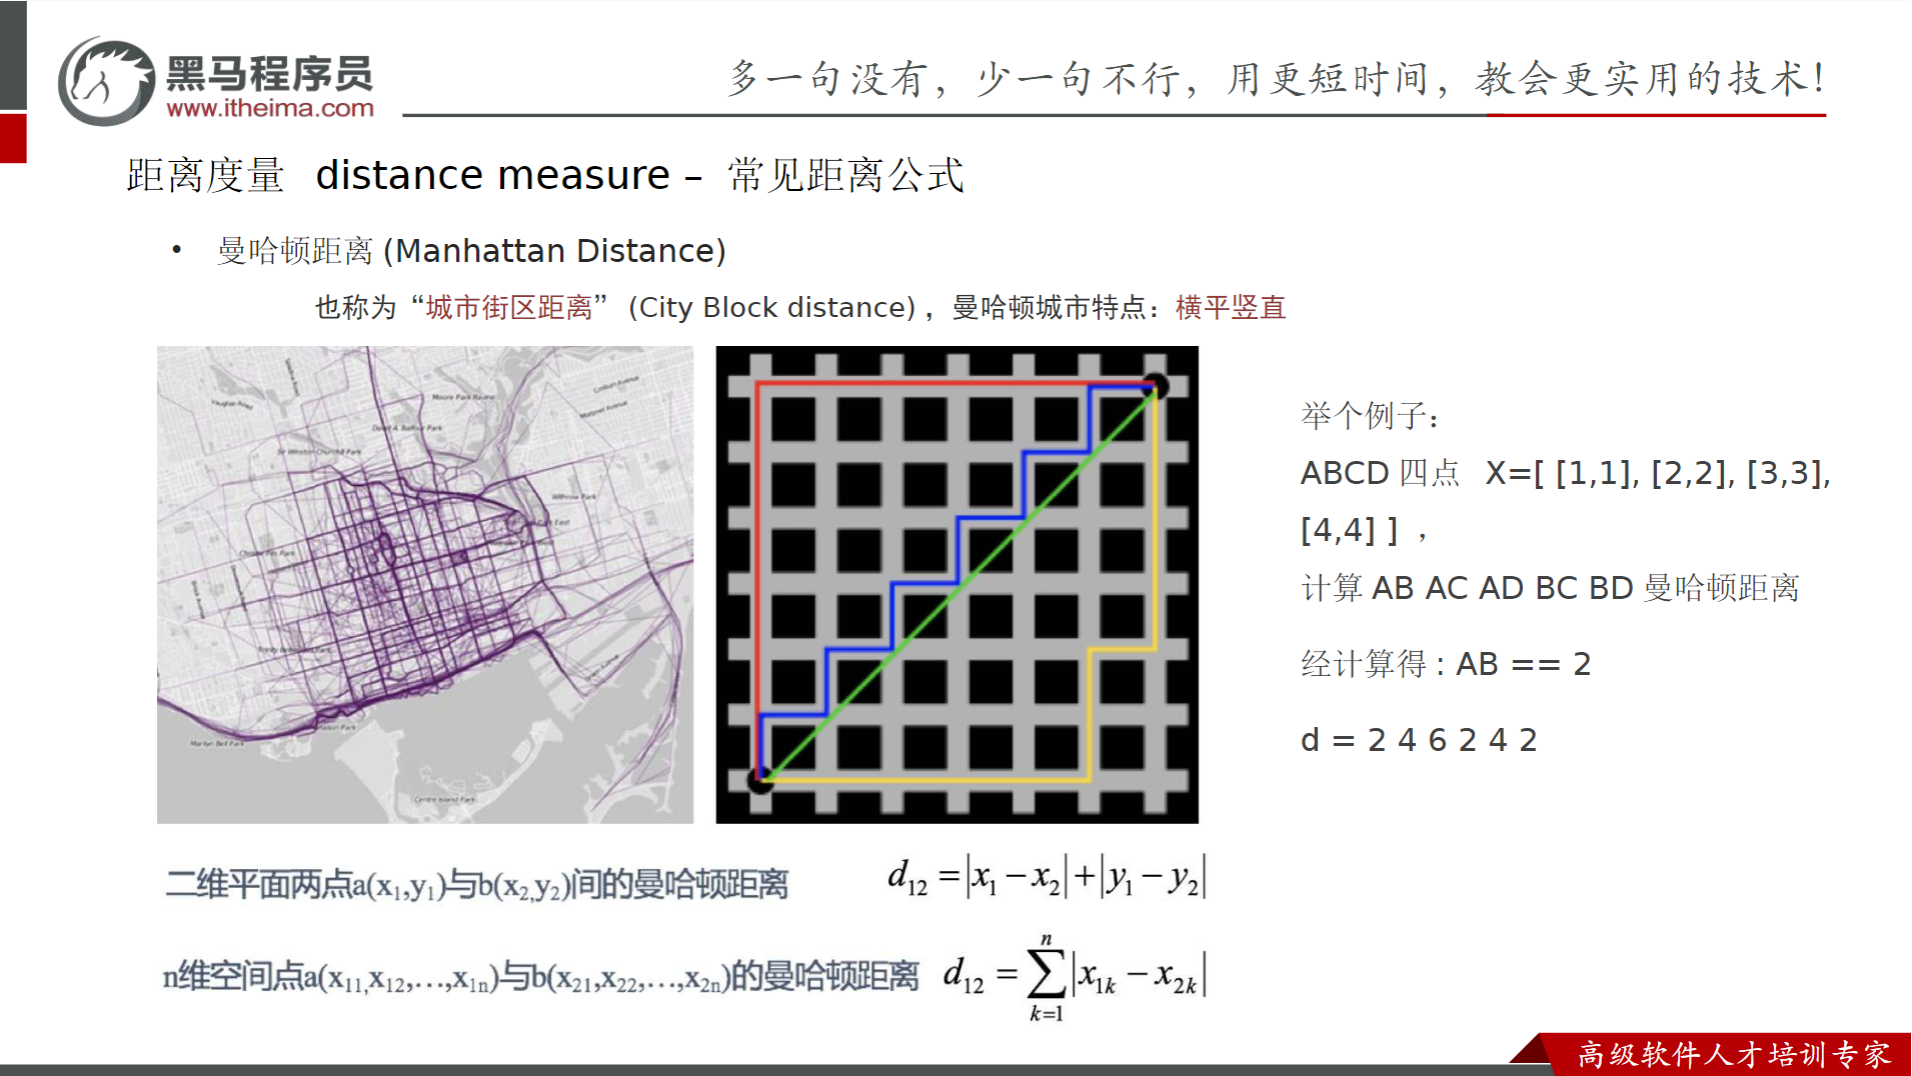
曼哈顿距离
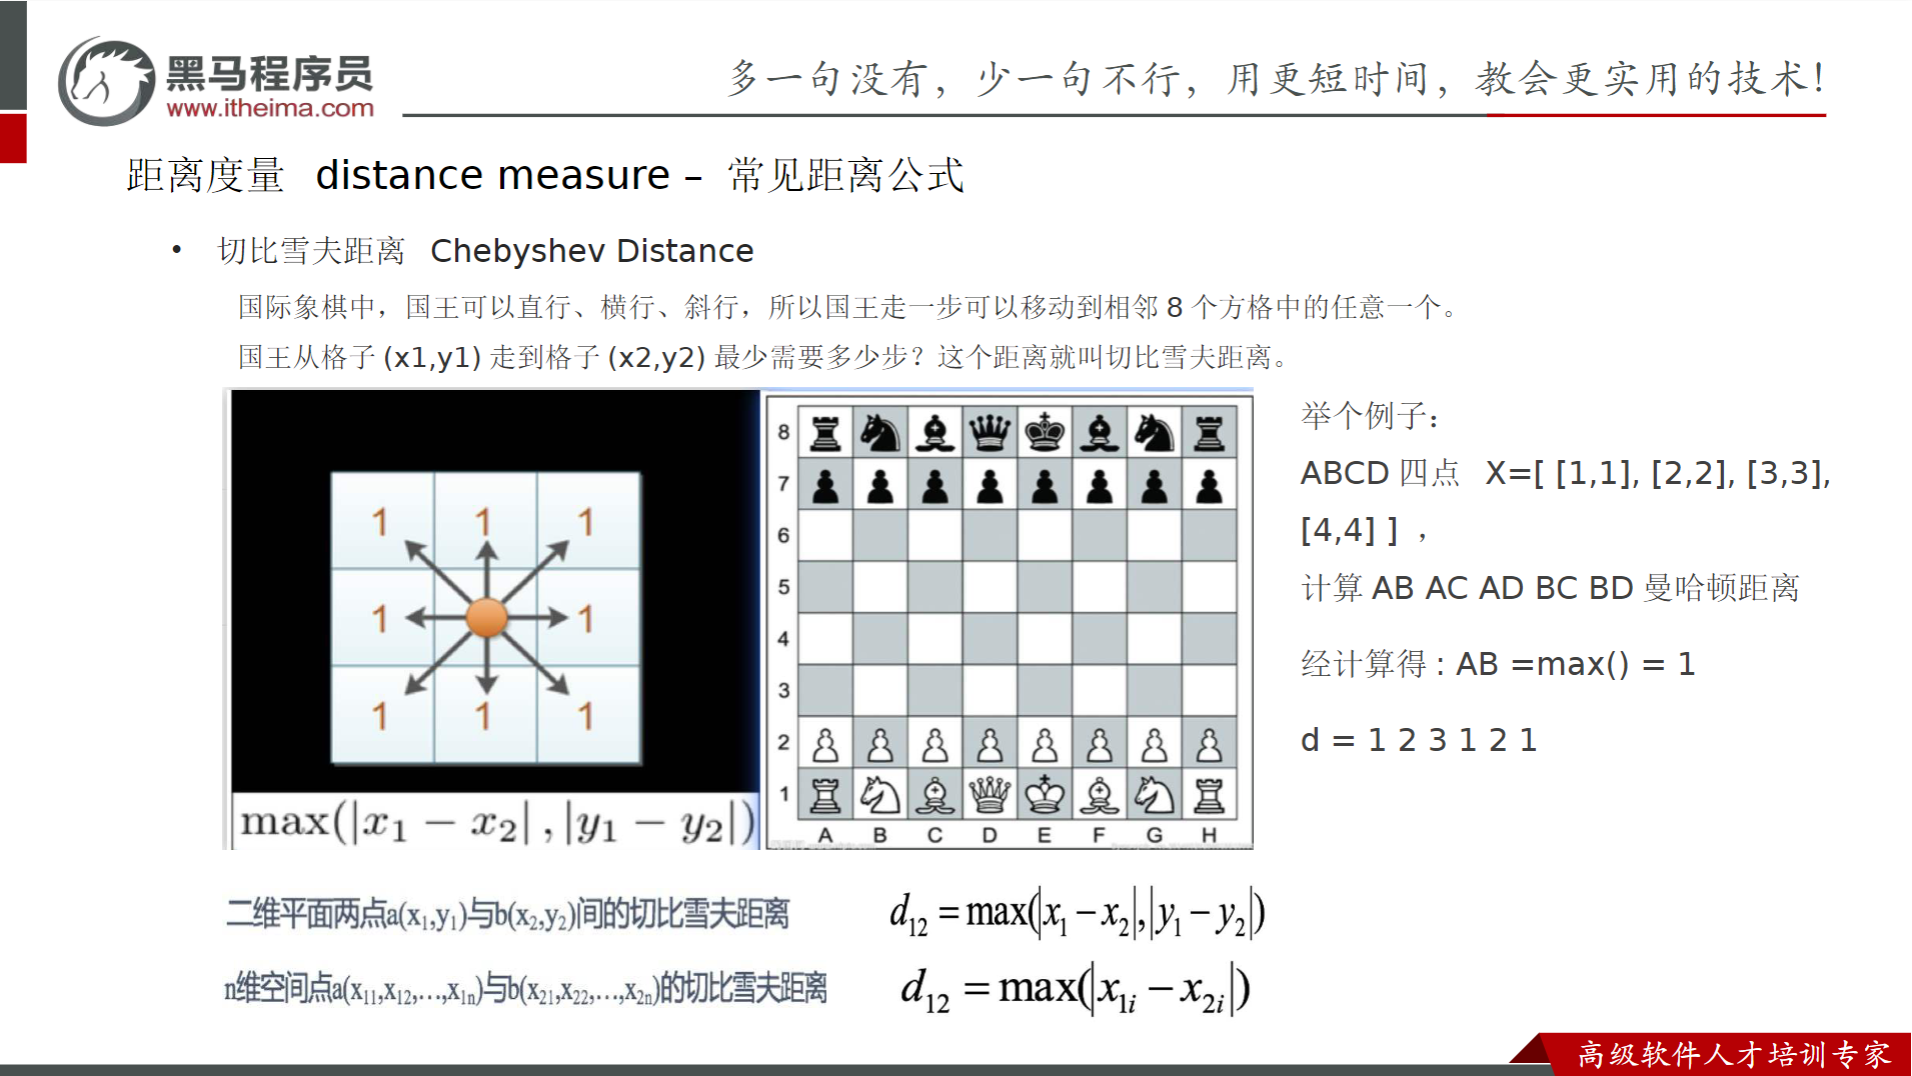
切比雪夫距离
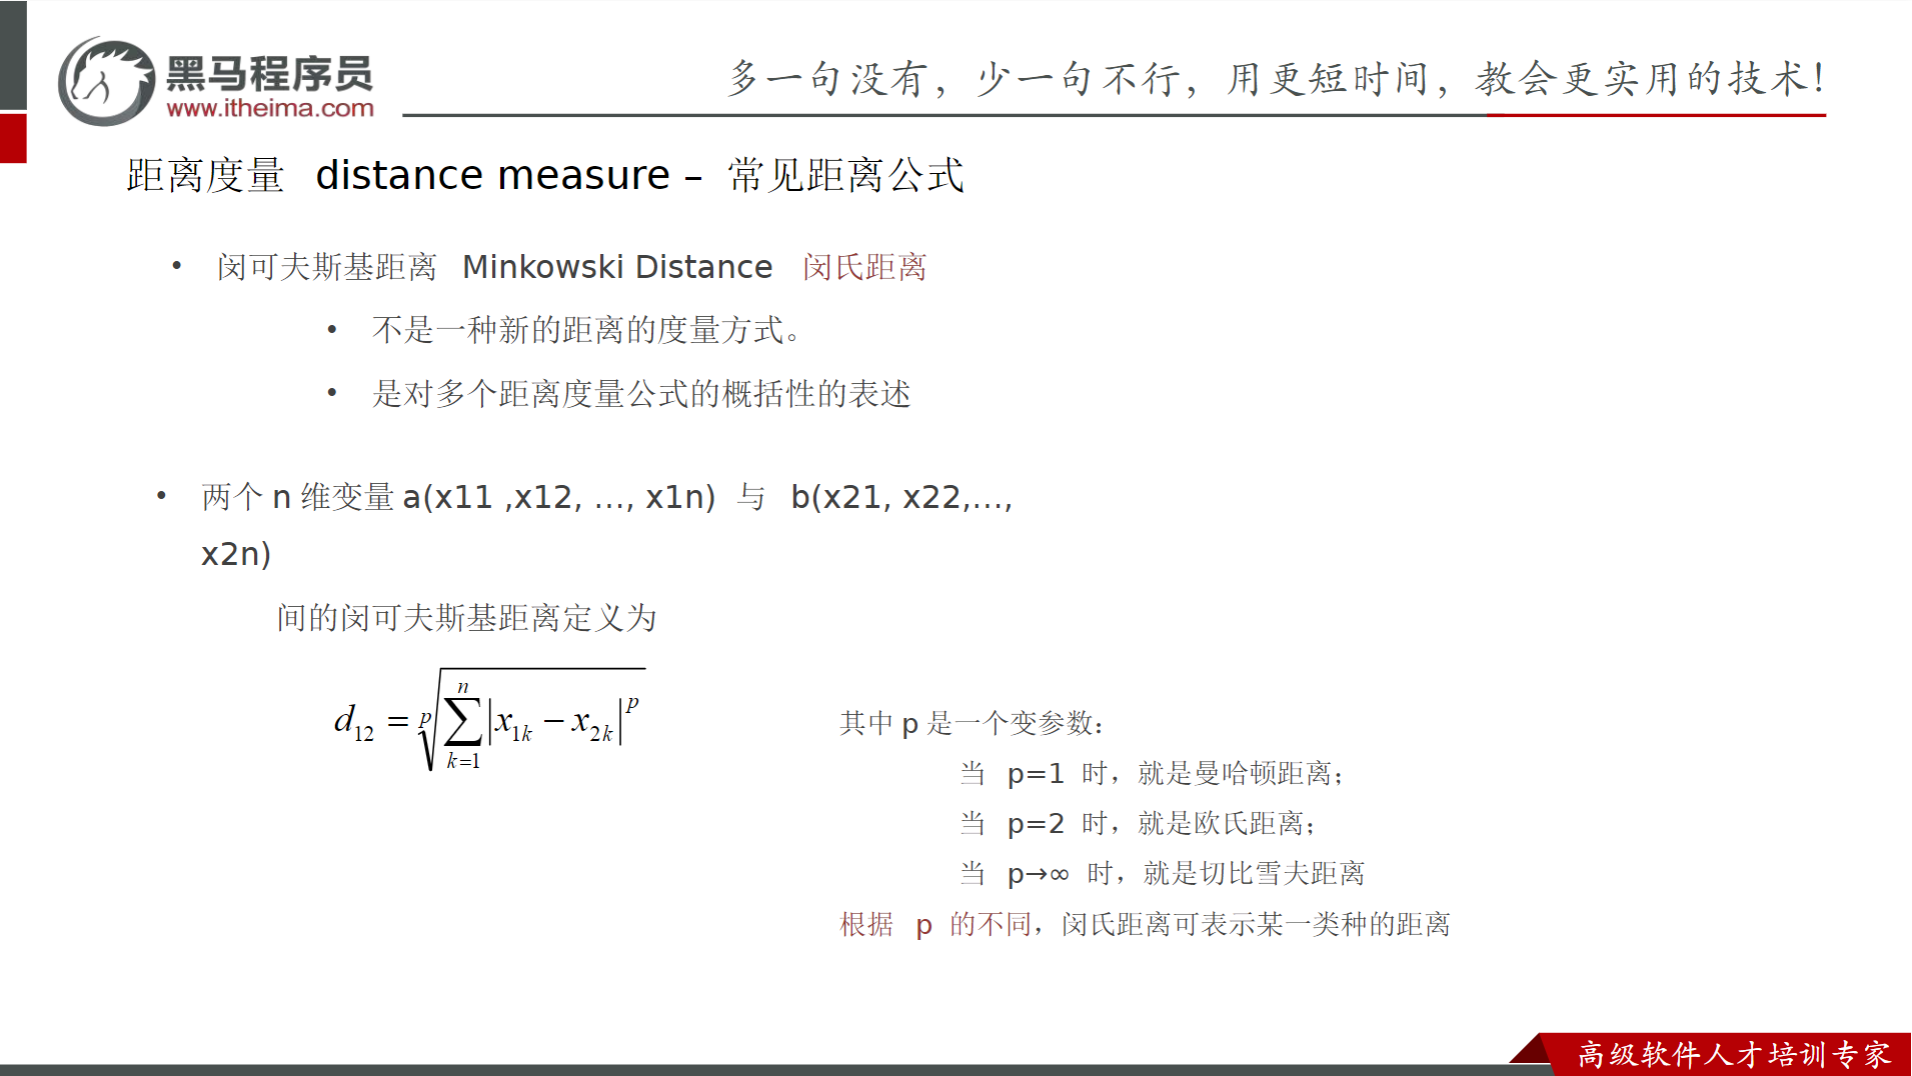
闵可夫斯基距离
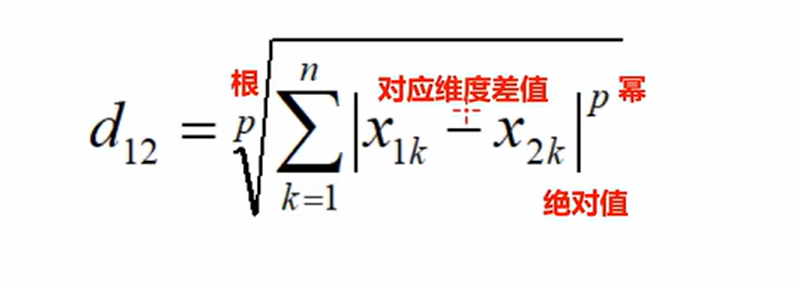
欧氏距离(两点间距离公式)=对应纬度差值平方和,开平方根
曼哈顿距离、城市街区距离=对应维度差值的绝对值,求和
切比雪夫距离=对应维度值差值的绝对值,求最大值
4.特征预处理
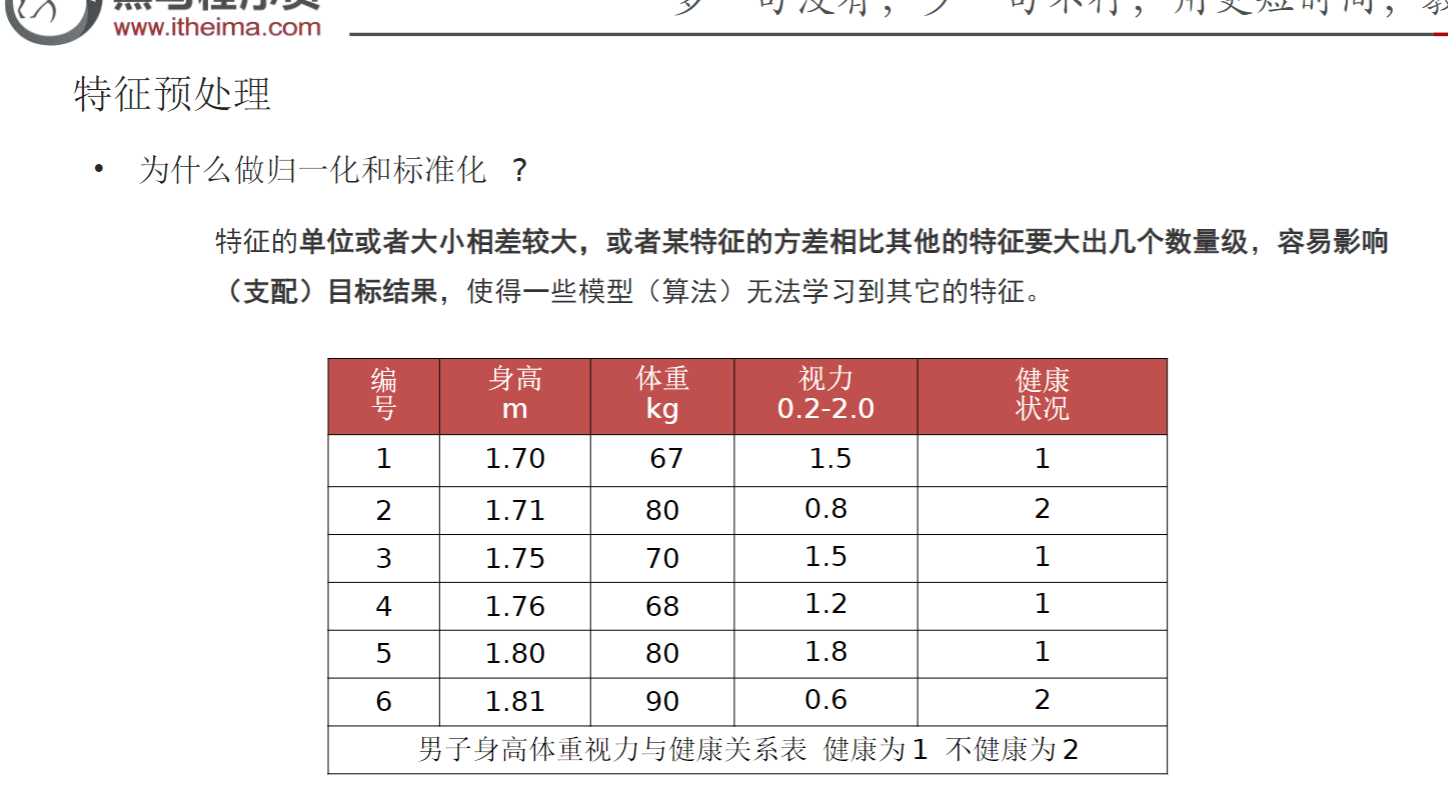
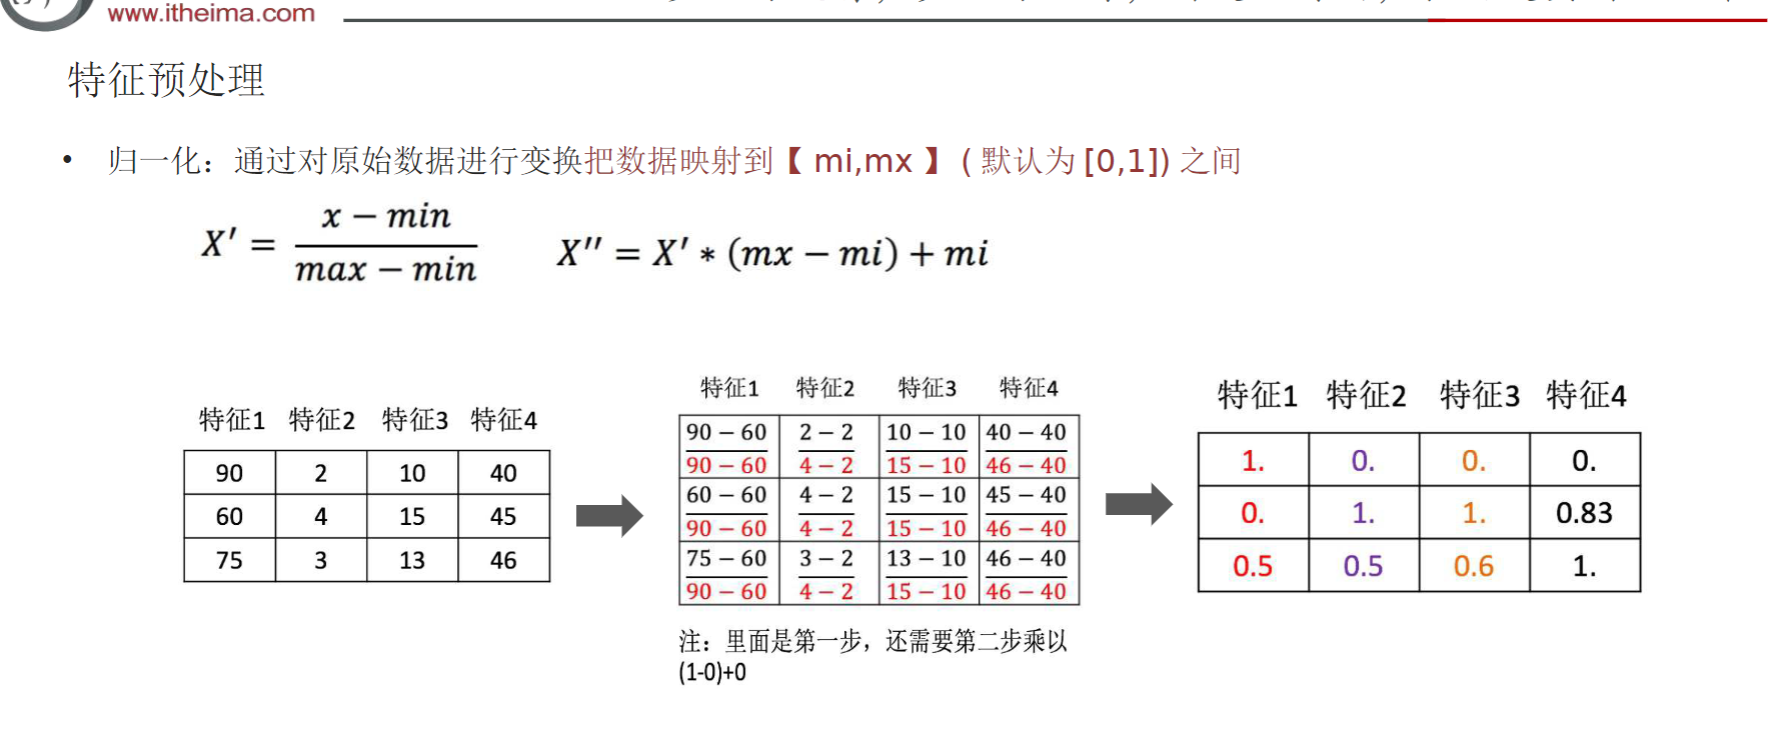
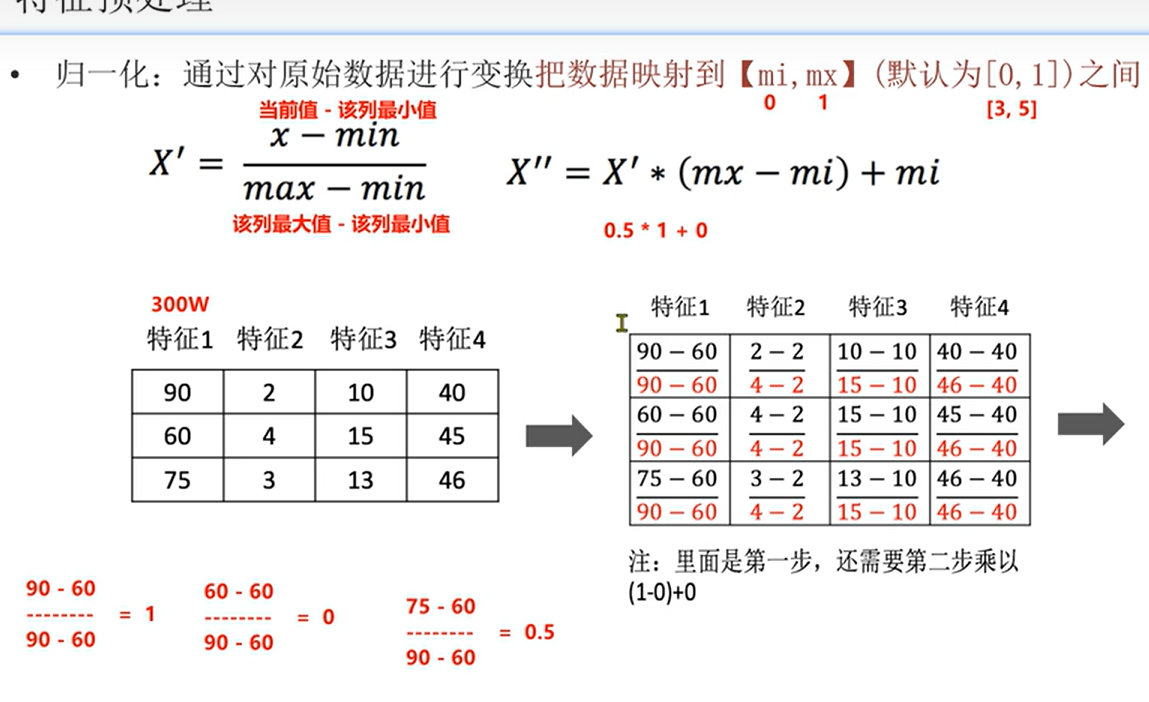
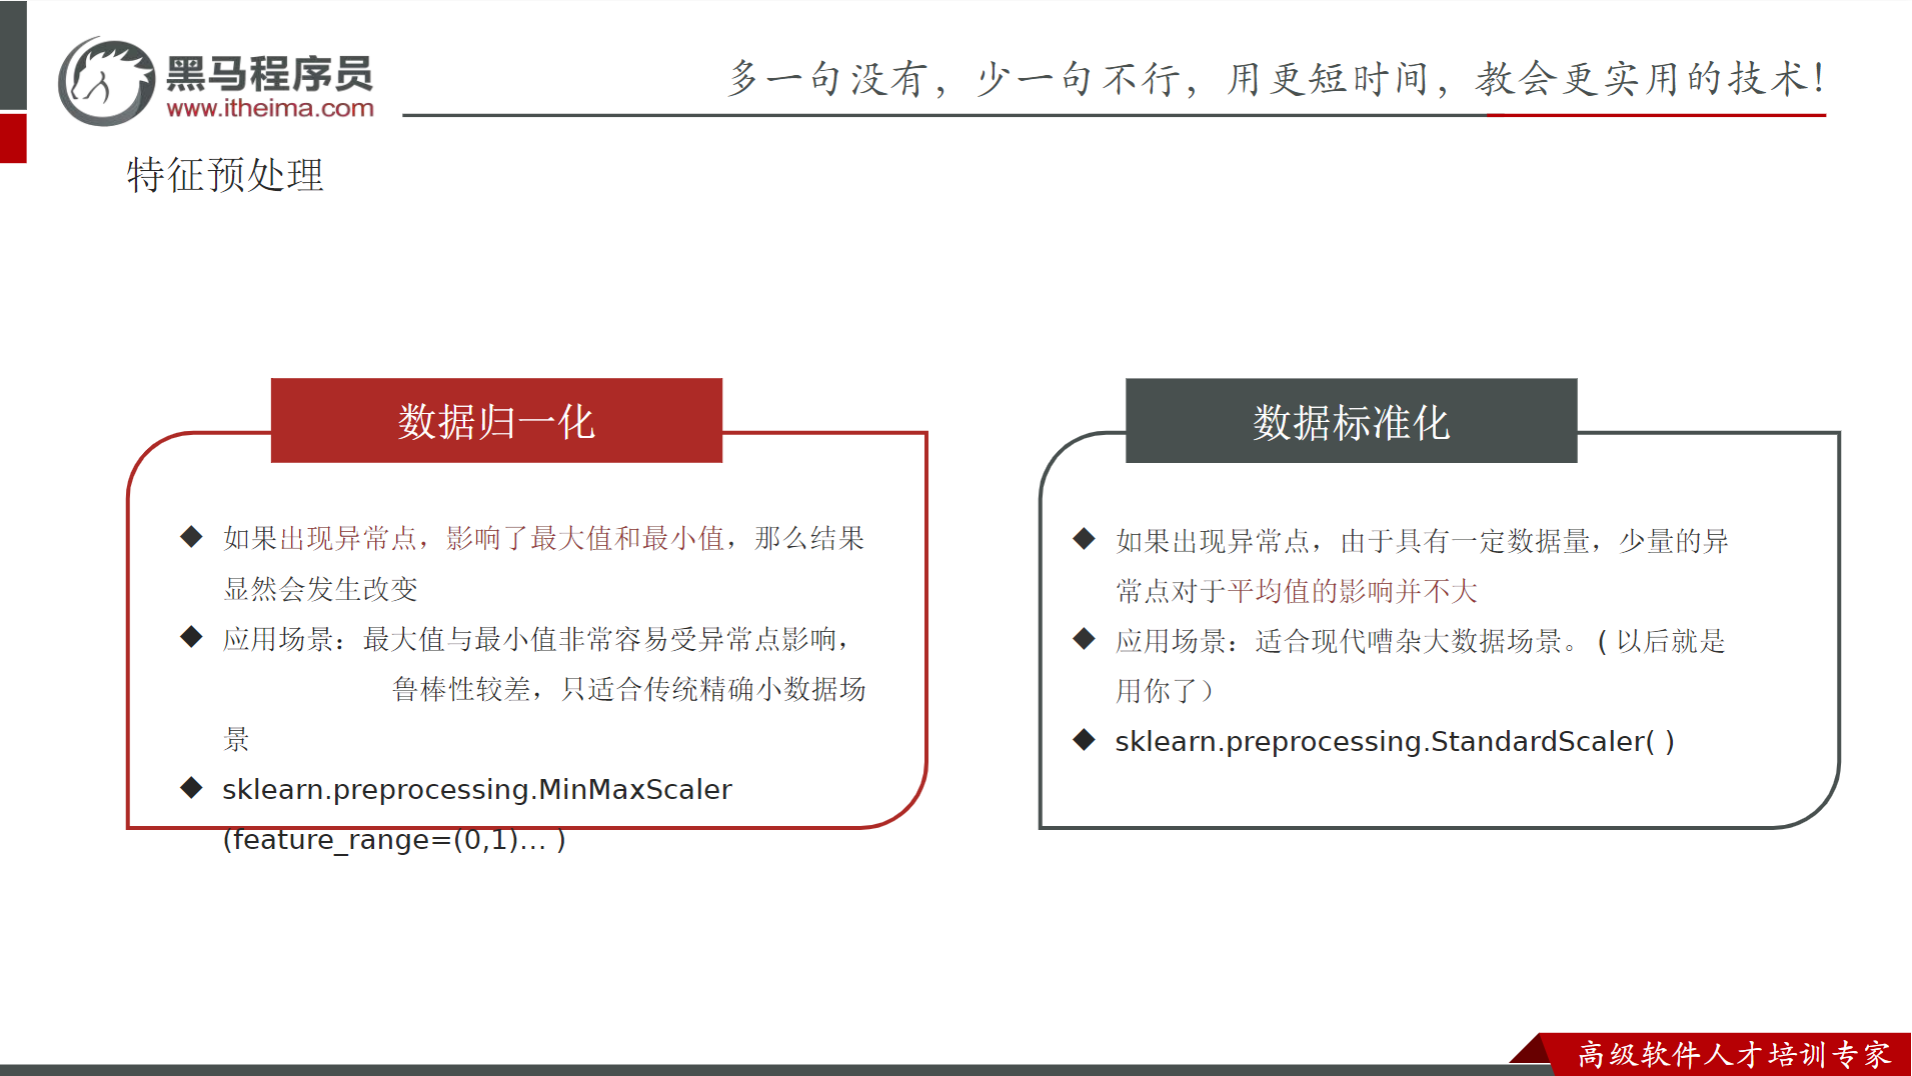
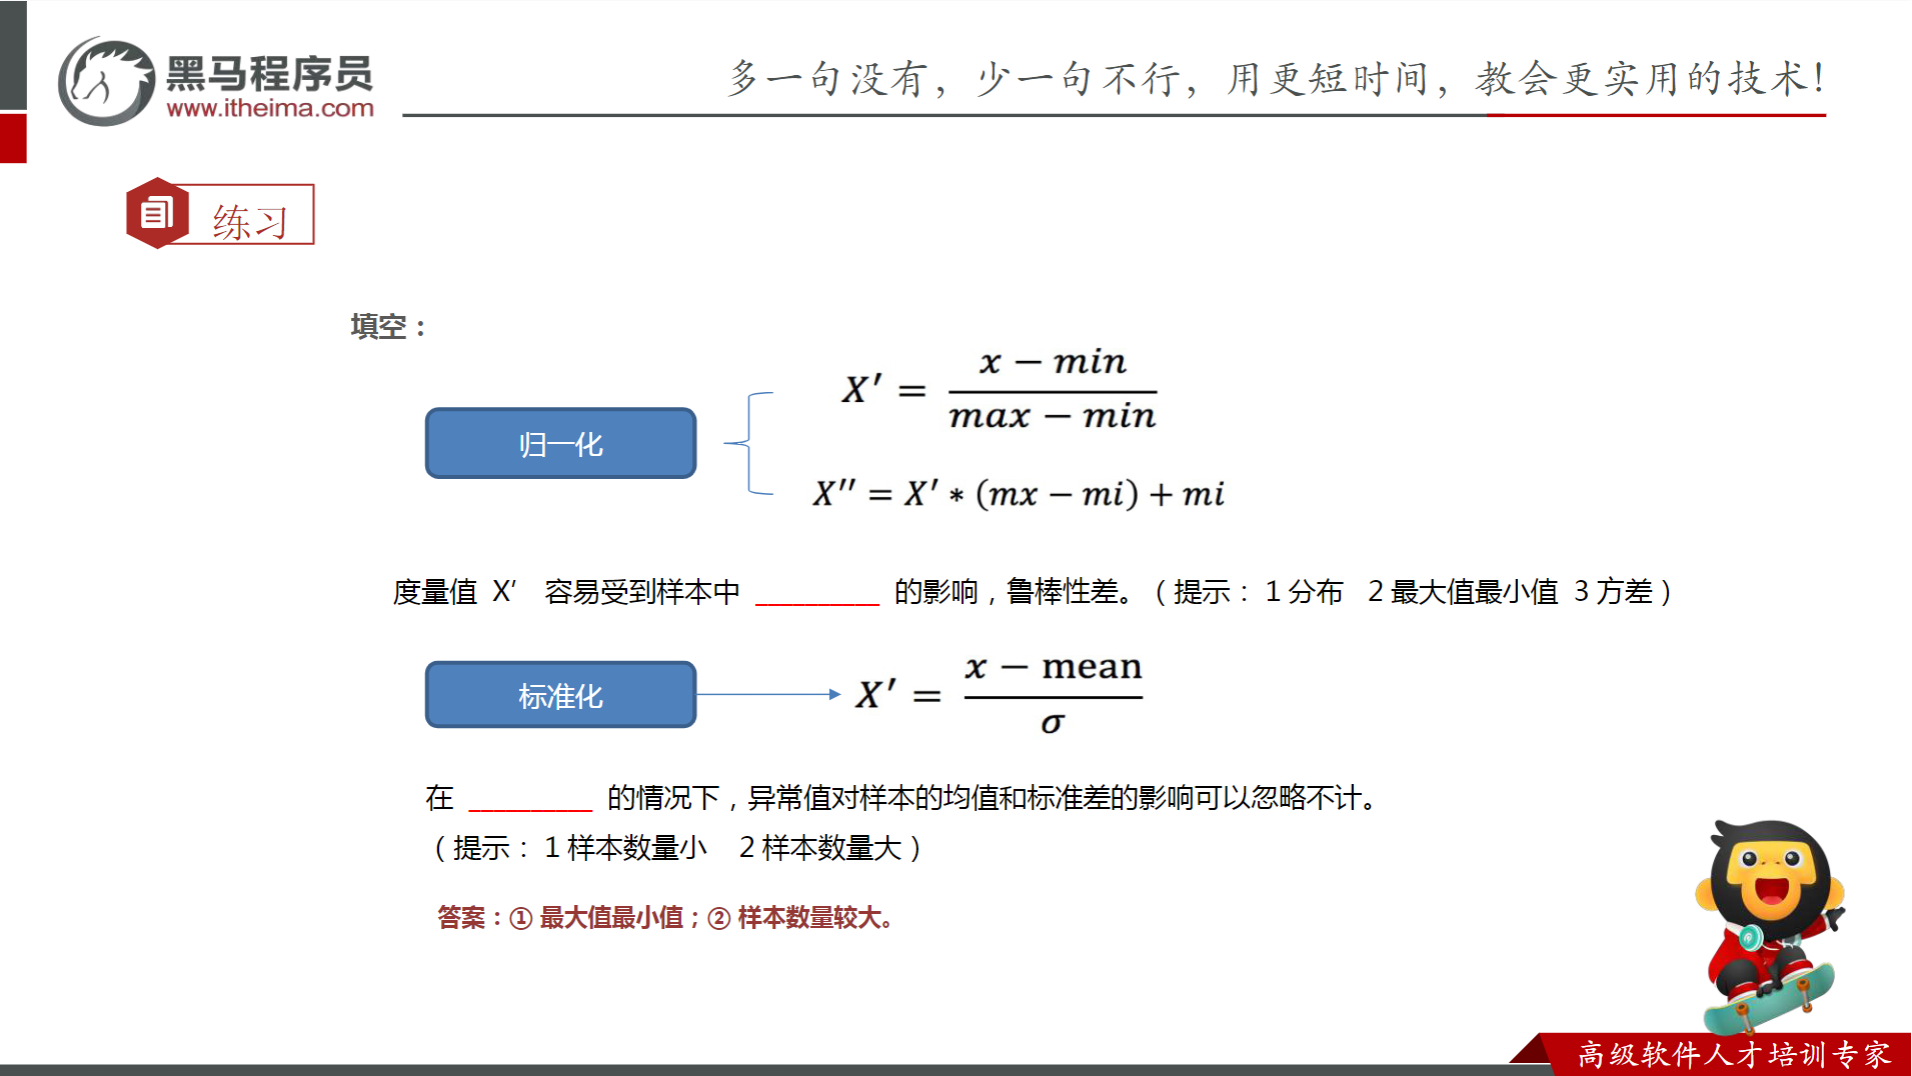
1.上面的方法计算太容易受到极值得影响;所以归一化适用于小数据集;
右边公式X''=X'*(mx-mi)+mi这一步的操作是;让取值控制在mi,mx之间,因为不一都是0,1
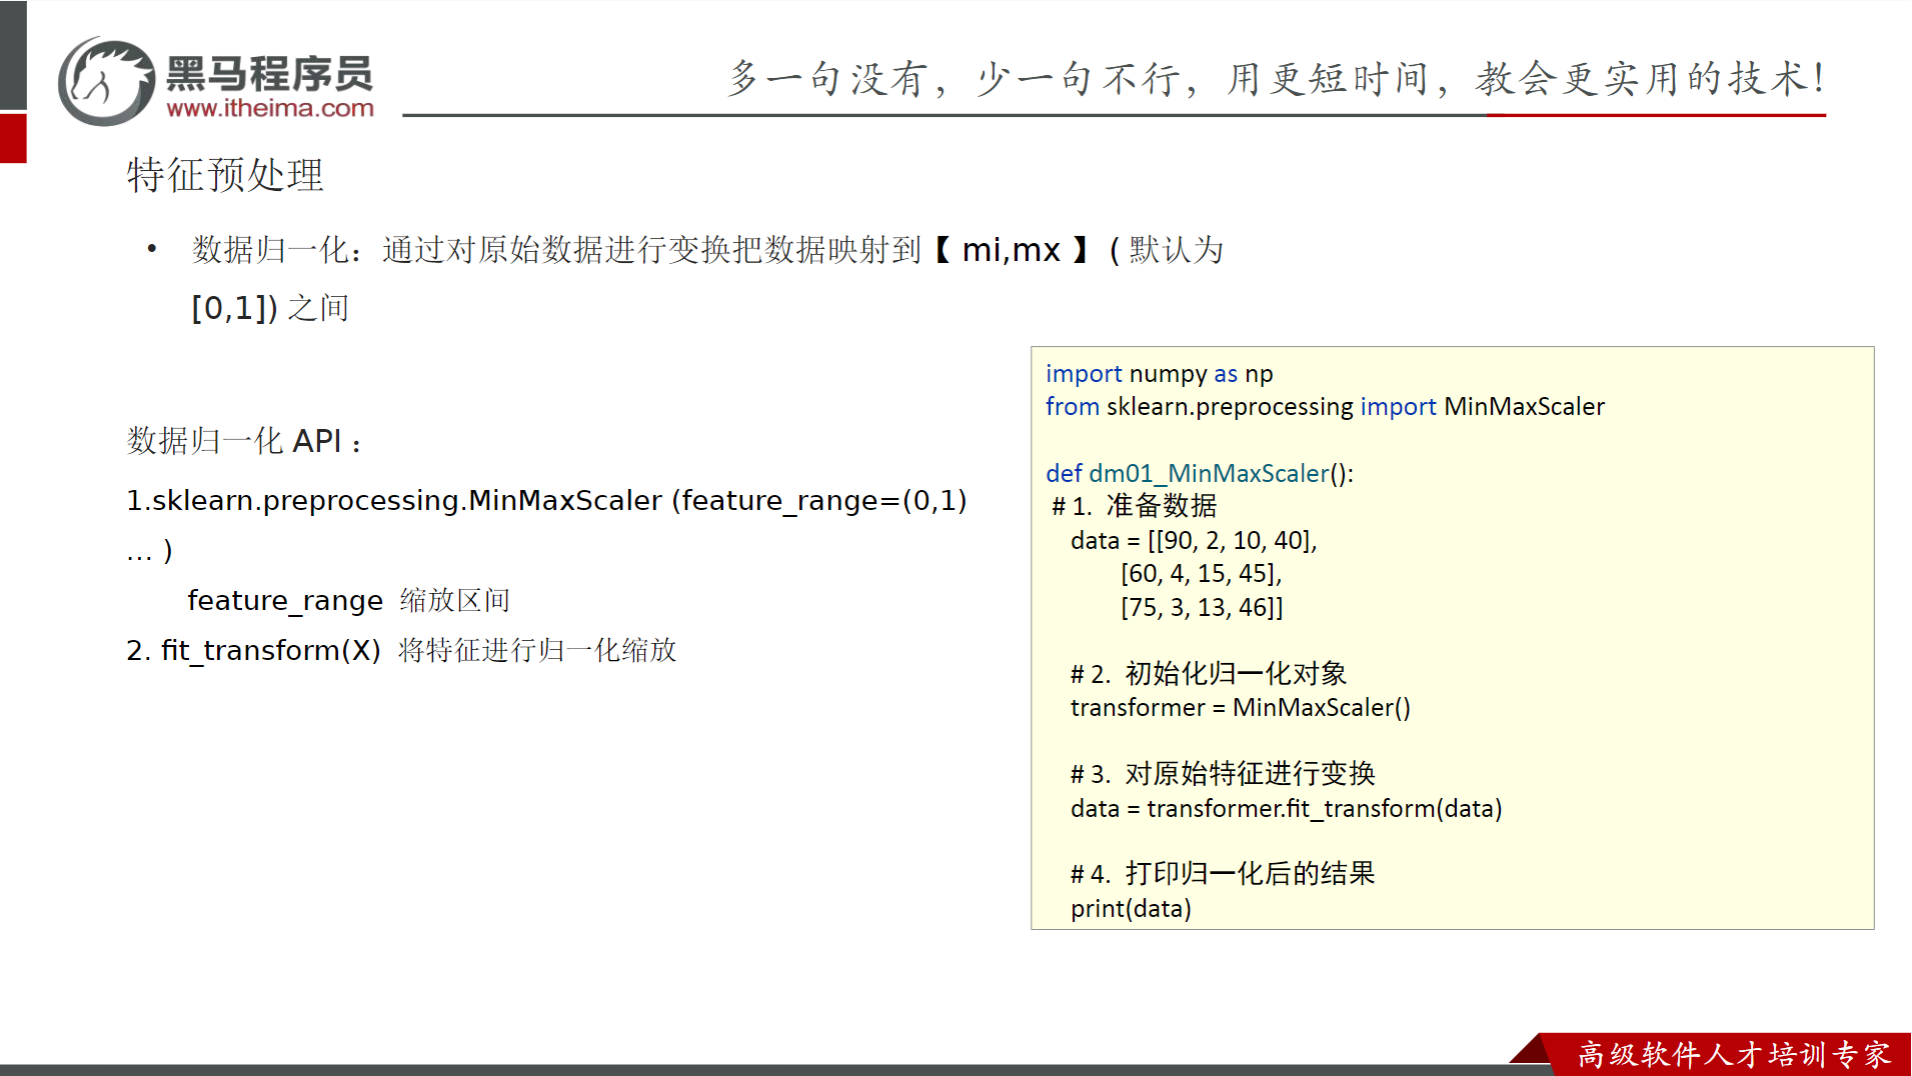
2.标准化适用于大数据集
python
'''
案例:演示特征预处理之归一化操作
问题:特征工程的目的和步骤
    目的:利用专业的背景知识和技巧处理数据,用于提升模型的性能
    步骤:
        1.特征提取
        2.特征预处理(归一化,标准化)
        3.特征降维
        4.特征选择
        5.特征组合
特征预处理之 归一化操作:
    目的:防止因为量纲(单位)问题,导致特征列的方差值相差较大,影响模型的最终结果
    公式:
    X'=(X-X_min)/(X_max-X_min)
    X''=X'(X_max-X_min)+X_min
    解释:
        1. X':基于公式算出来的结果
        2.X''最终的结果
    弊端:
        容易受到最大值和最小值的影响,所以它一般用于处理小数据集
'''
#导包
from sklearn.preprocessing import MinMaxScaler
#准备数据
x_train=[[90,2,10,40],[60,4,15,45],[75,3,13,46]]
#创建归一化对象
#参数feature_range表示生成范围,默认为:0,1,如果就是这个范围,就不需要指定
transfer=MinMaxScaler(feature_range=(0,1))
#对原数据进行归一化处理
x_train=transfer.fit_transform(x_train)
#打印处理后的数据
print('归一化后的数据:\n',x_train)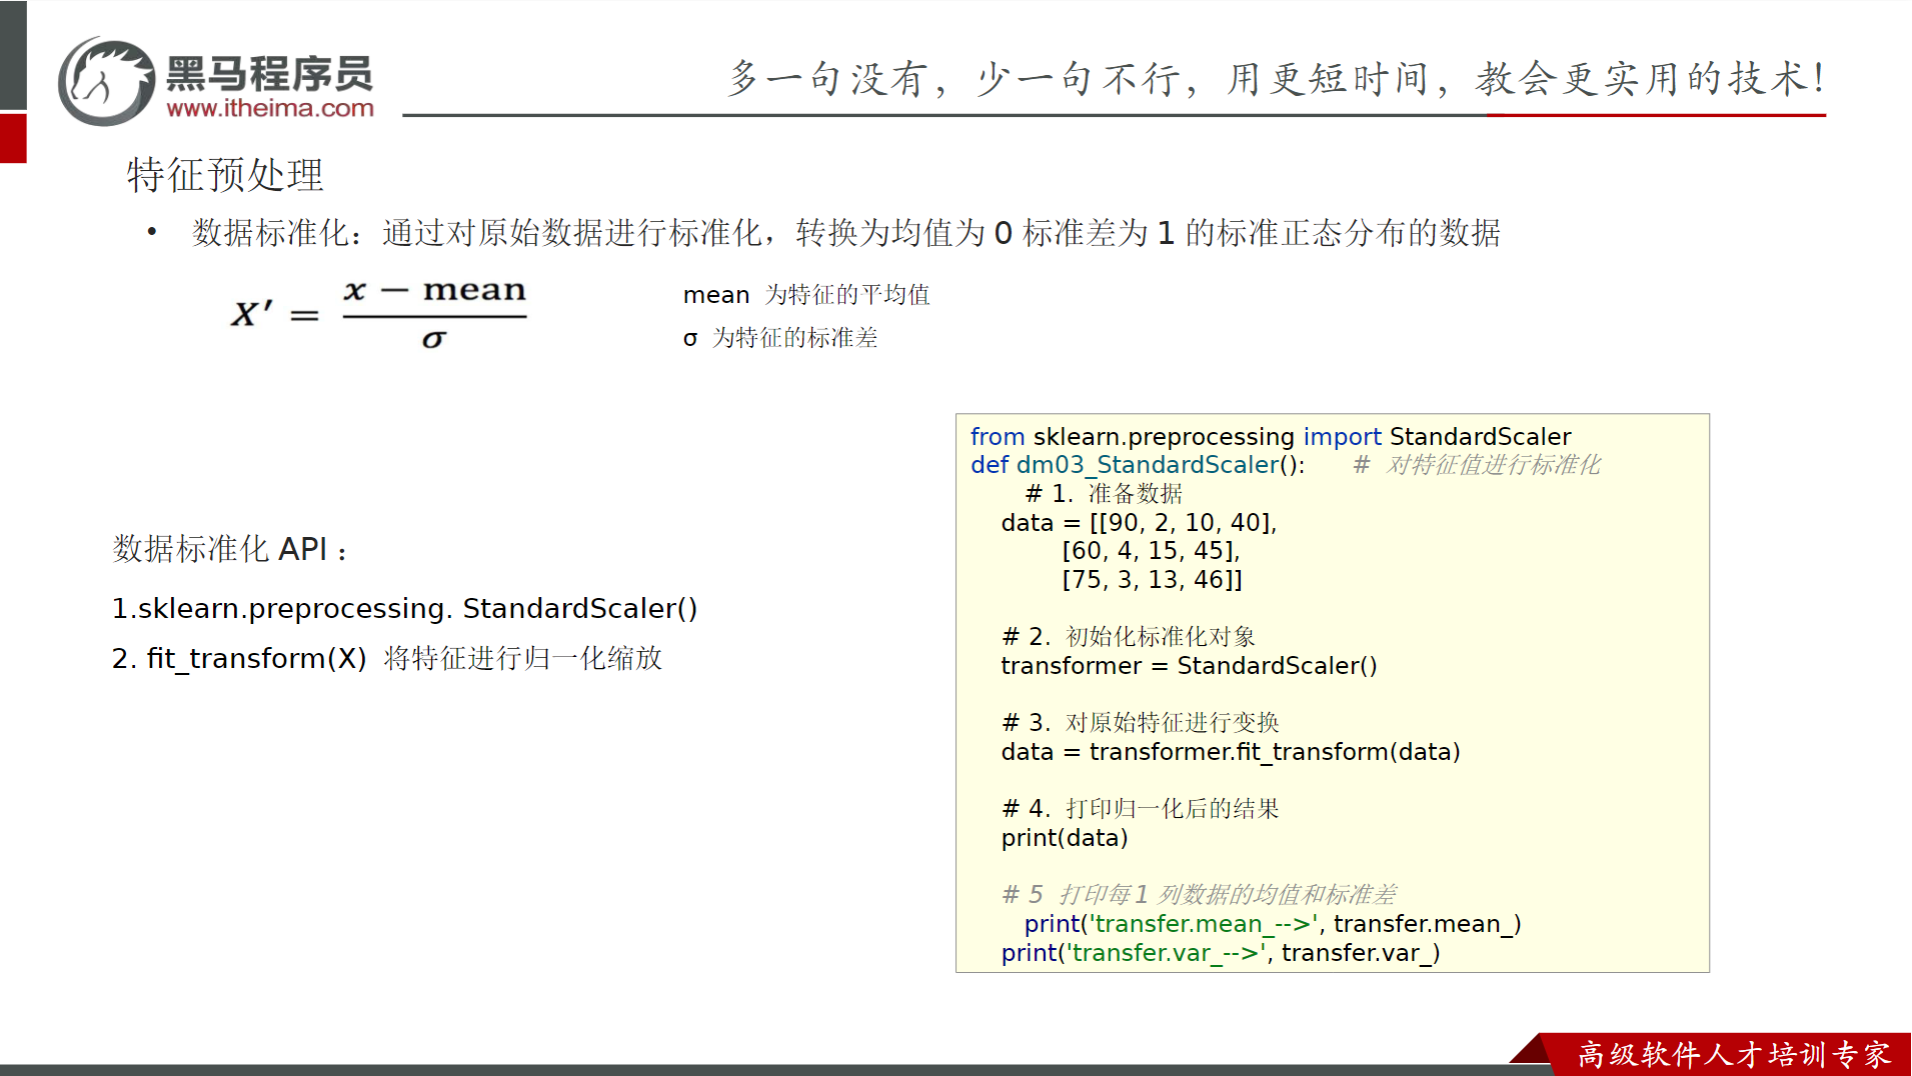
python
'''
案例:演示特征预处理之归一化操作
问题:特征工程的目的和步骤
    目的:利用专业的背景知识和技巧处理数据,用于提升模型的性能
    步骤:
        1.特征提取
        2.特征预处理(归一化,标准化)
        3.特征降维
        4.特征选择
        5.特征组合
特征预处理之 标准化操作:
    目的:防止因为量纲(单位)问题,导致特征列的方差值相差较大,影响模型的最终结果
    公式:
    X'=(X-该列平均值)/(该列的标准差)

    应用场景:
        适用于大数据集的处理
结论:
    无论是归一化,还是标准化,目的都是为了解决因为量纲(单位)问题,导致模型评估较低等问题
回顾:
    方差计算公式:该列每个值和该列均值的差的平方和的平均值
    标准差计算公式:方差的平方根
'''
#导包
from sklearn.preprocessing import StandardScaler
#准备数据
x_train=[[90,2,10,40],[60,4,15,45],[75,3,13,46]]
#创建标准化对象
transfer=StandardScaler()
#对原数据进行标准化处理
x_train=transfer.fit_transform(x_train)
#打印处理后的数据
print('标准化后的数据:\n',x_train)
print('标准化后的数据的均值:\n',transfer.mean_)
print('标准化后的数据的标准差:\n',transfer.scale_)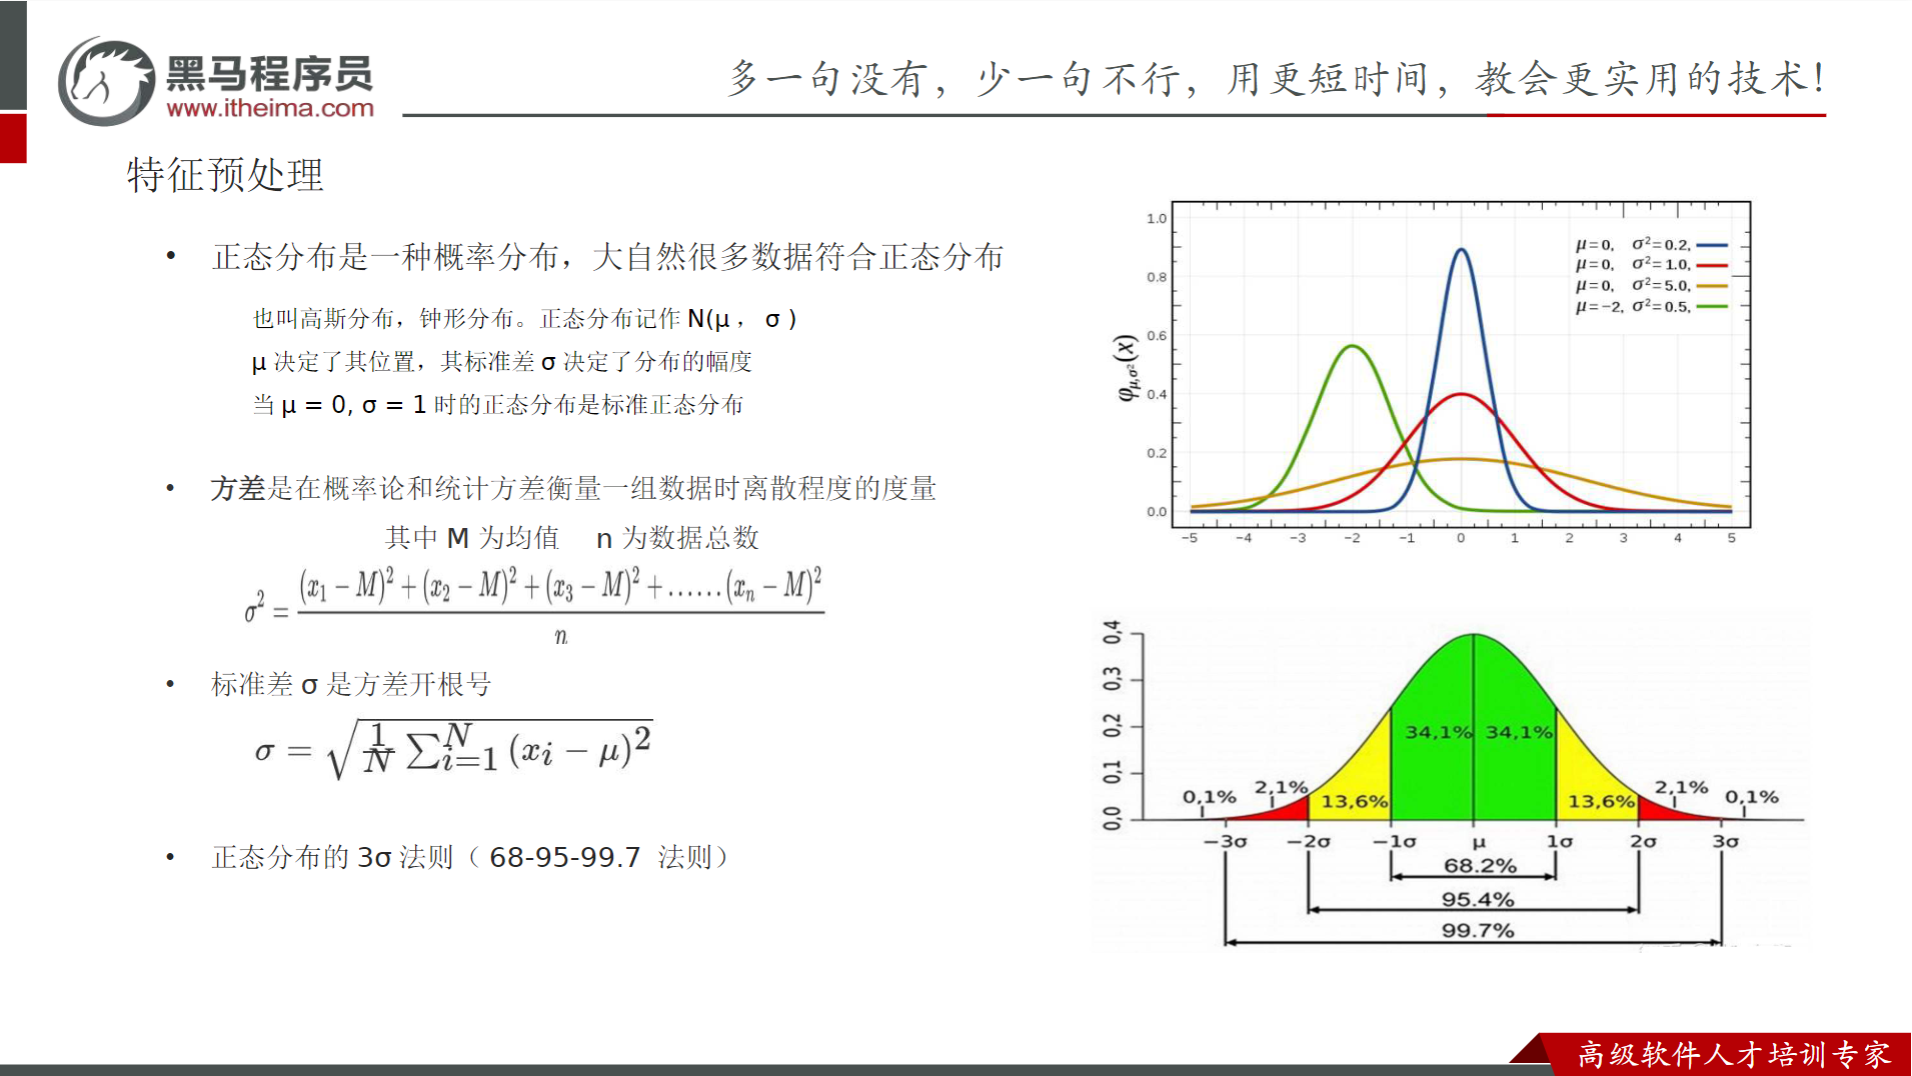
python
'''
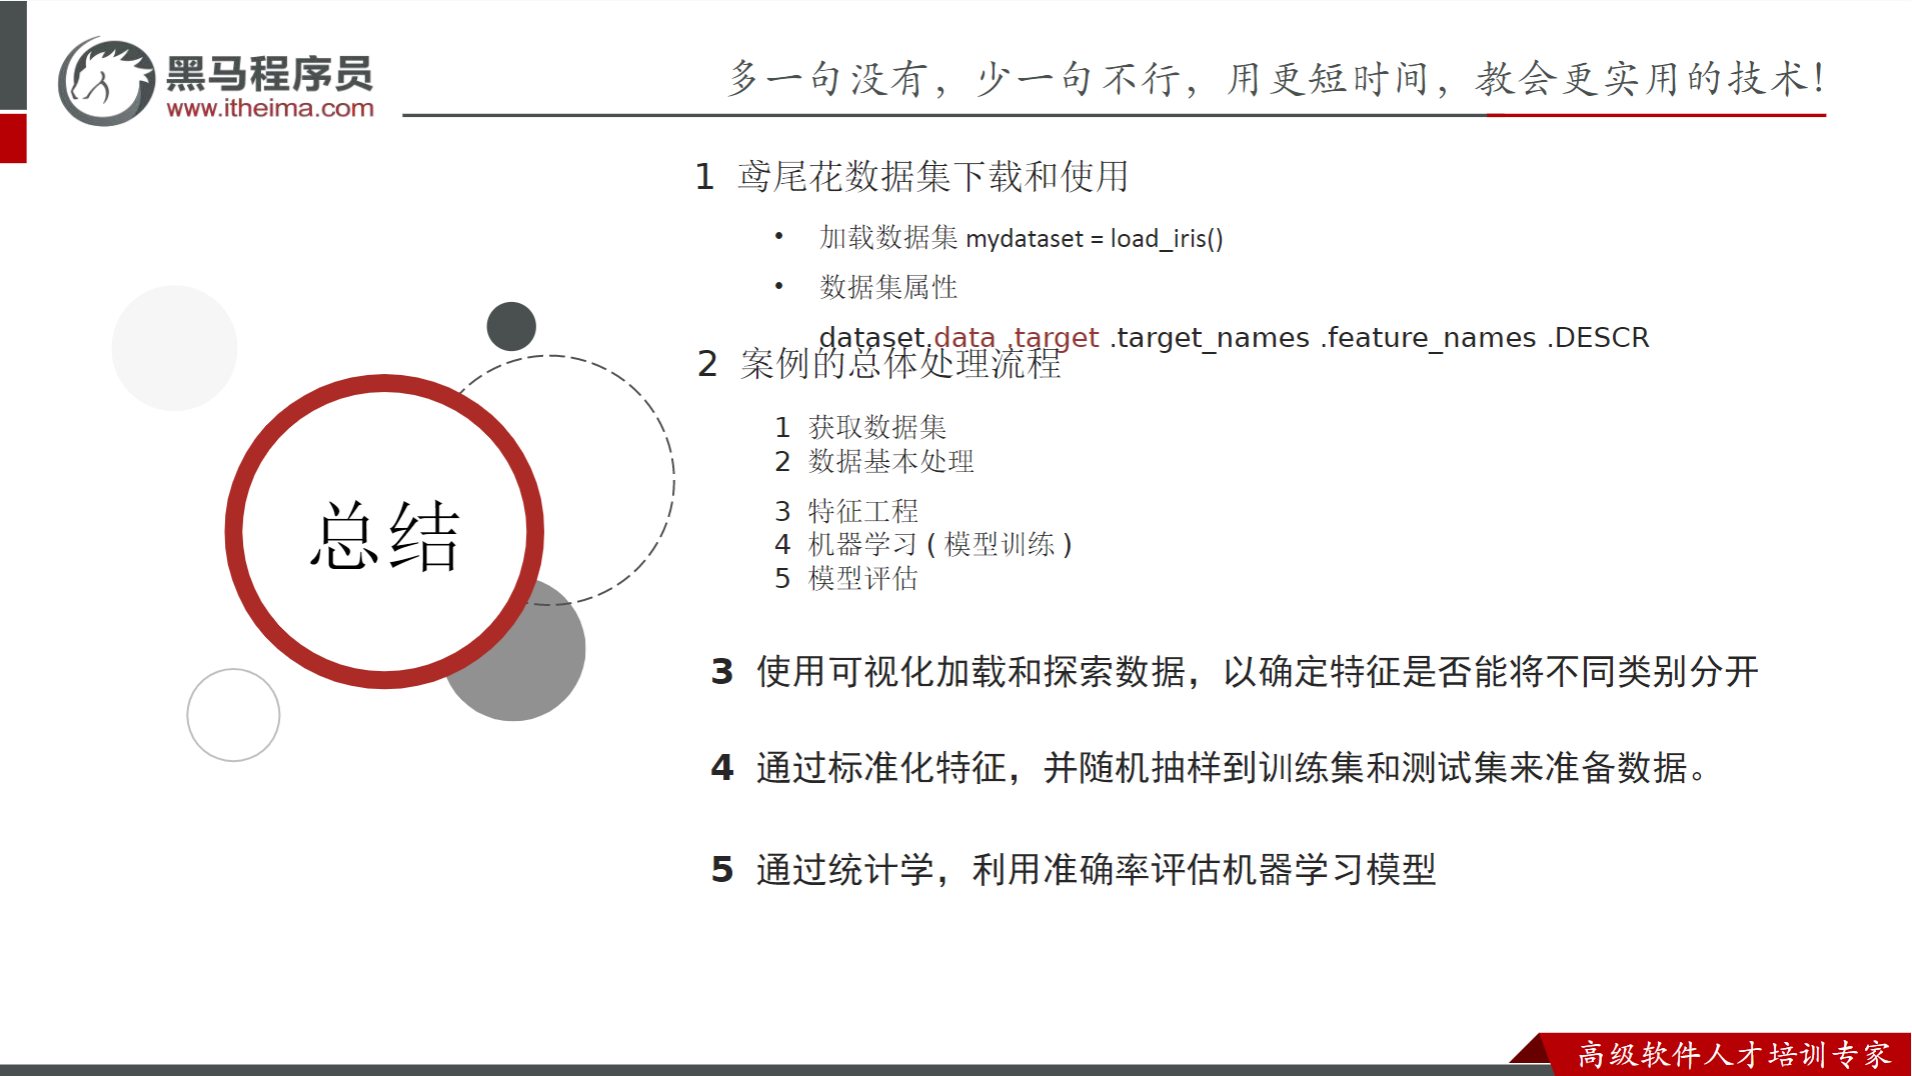
机器学习的步骤:
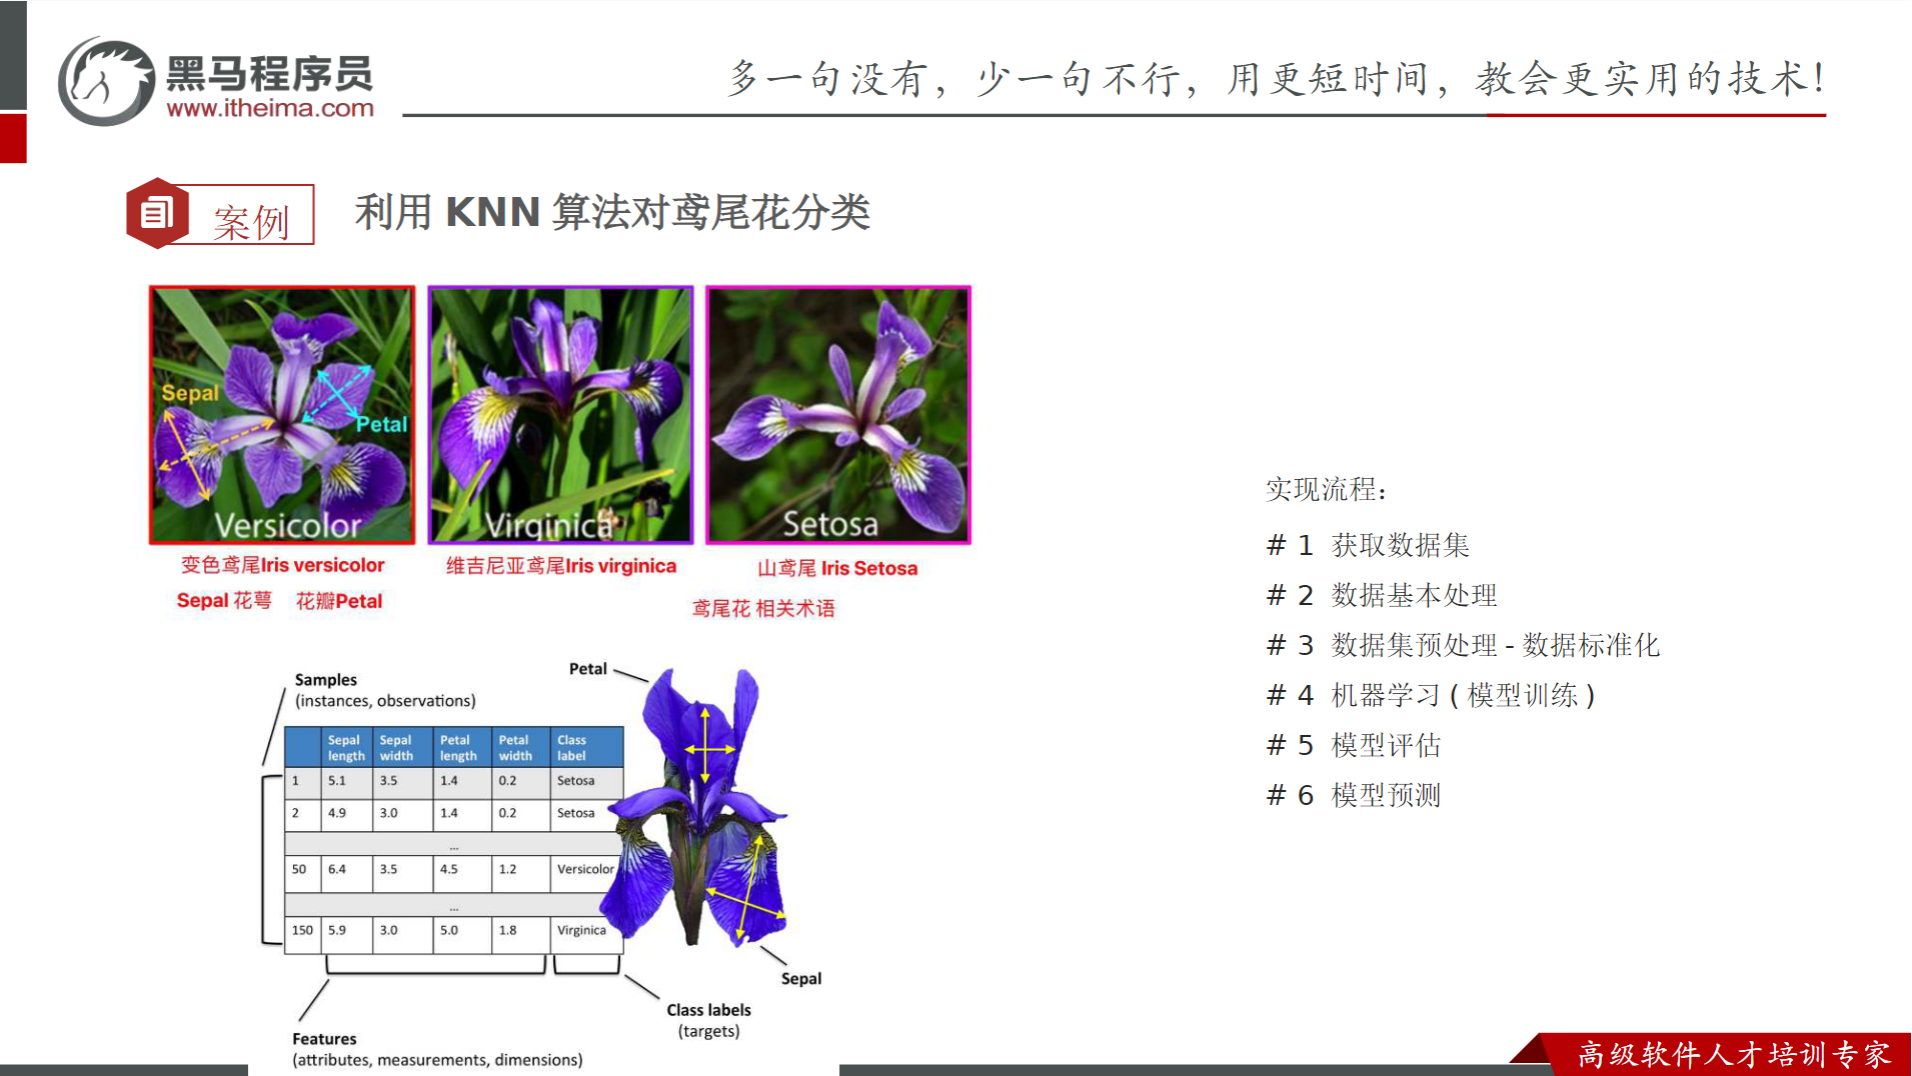
1.加载数据
2.数据预处理
3.特征工程(特征提取,特征预处理,特征降维,特征选择,特征组合)
4.模型选择
5.模型训练
6.模型评估
7.模型预测
'''
# 导入工具包
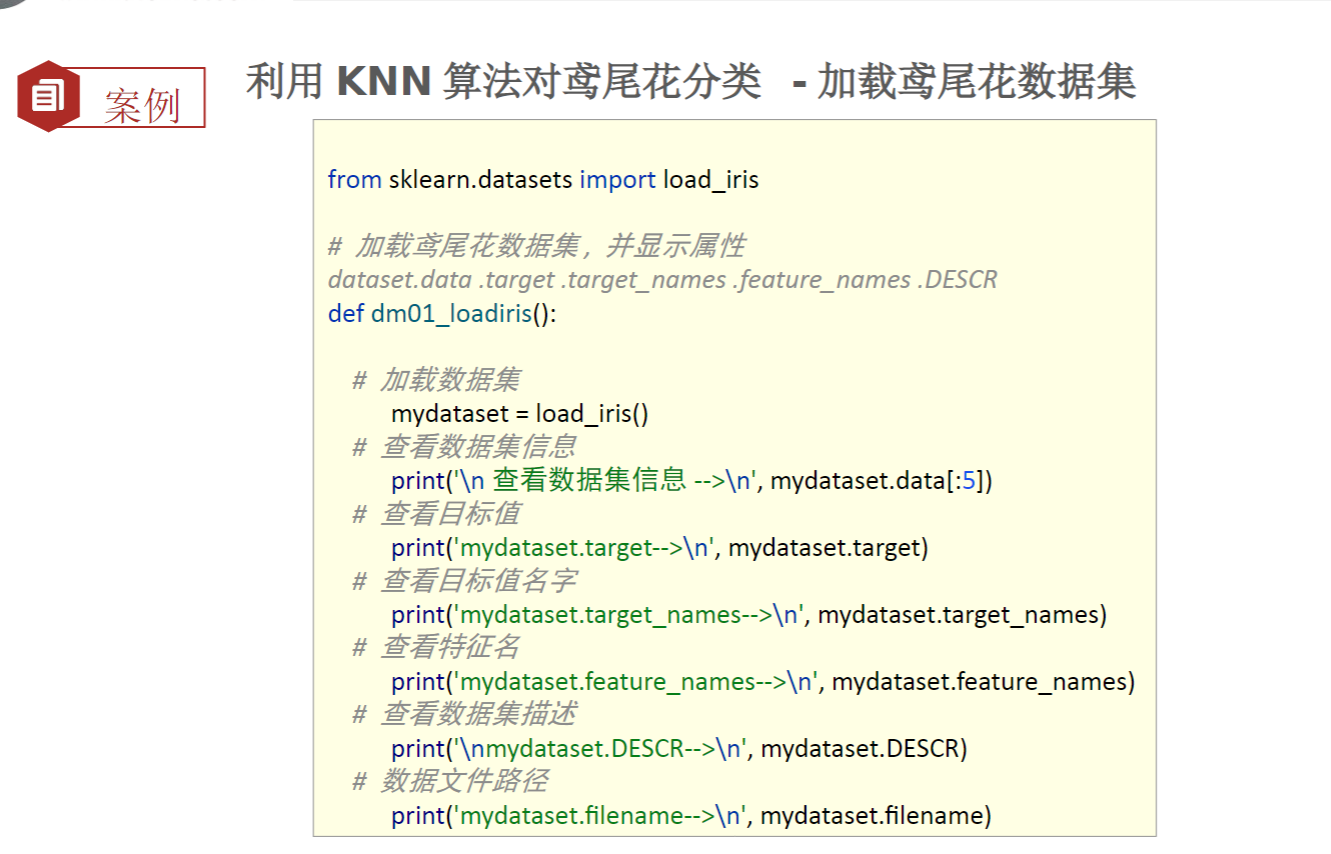
from sklearn.datasets import load_iris          # 加载鸢尾花测试集的.
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split    # 分割训练集和测试集的
from sklearn.preprocessing import StandardScaler        # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier      # KNN算法 分类对象
from sklearn.metrics import accuracy_score              # 模型评估的, 计算模型预测的准确率
#1.定义函数,加载鸢尾花数据集,并查看数据集
def dm01_load_iris():
    #1.加载鸢尾花数据集
    iris=load_iris()
    #2.查看数据集
    # print(f'数据集:{iris.data}')
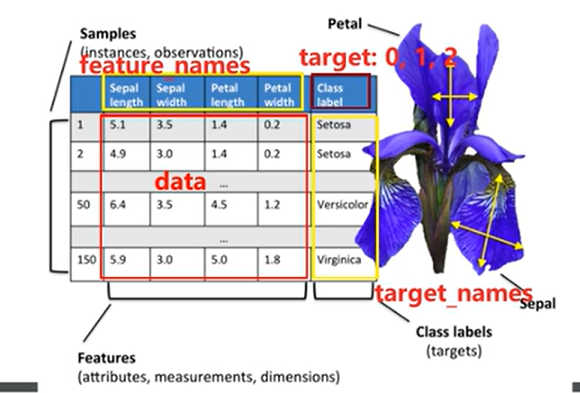
    print(f'具体的数据:{iris.data[:5]}')#有150条数据,每条数据有4个特征,我们只看前5条
    print(f'具体的标签{iris.target[:5]}')#具体的标签,有150条数据,每条数据有1个标签,我们只看前5条
    print(f'特征的名称:{iris.feature_names}')#特征的名称
    print(f'目标的名称:{iris.target_names}')#目标的名称
    print(f'数据集的文件名{iris.filename}')#数据集的文件名
#2.定义函数 绘制数据集的散点图
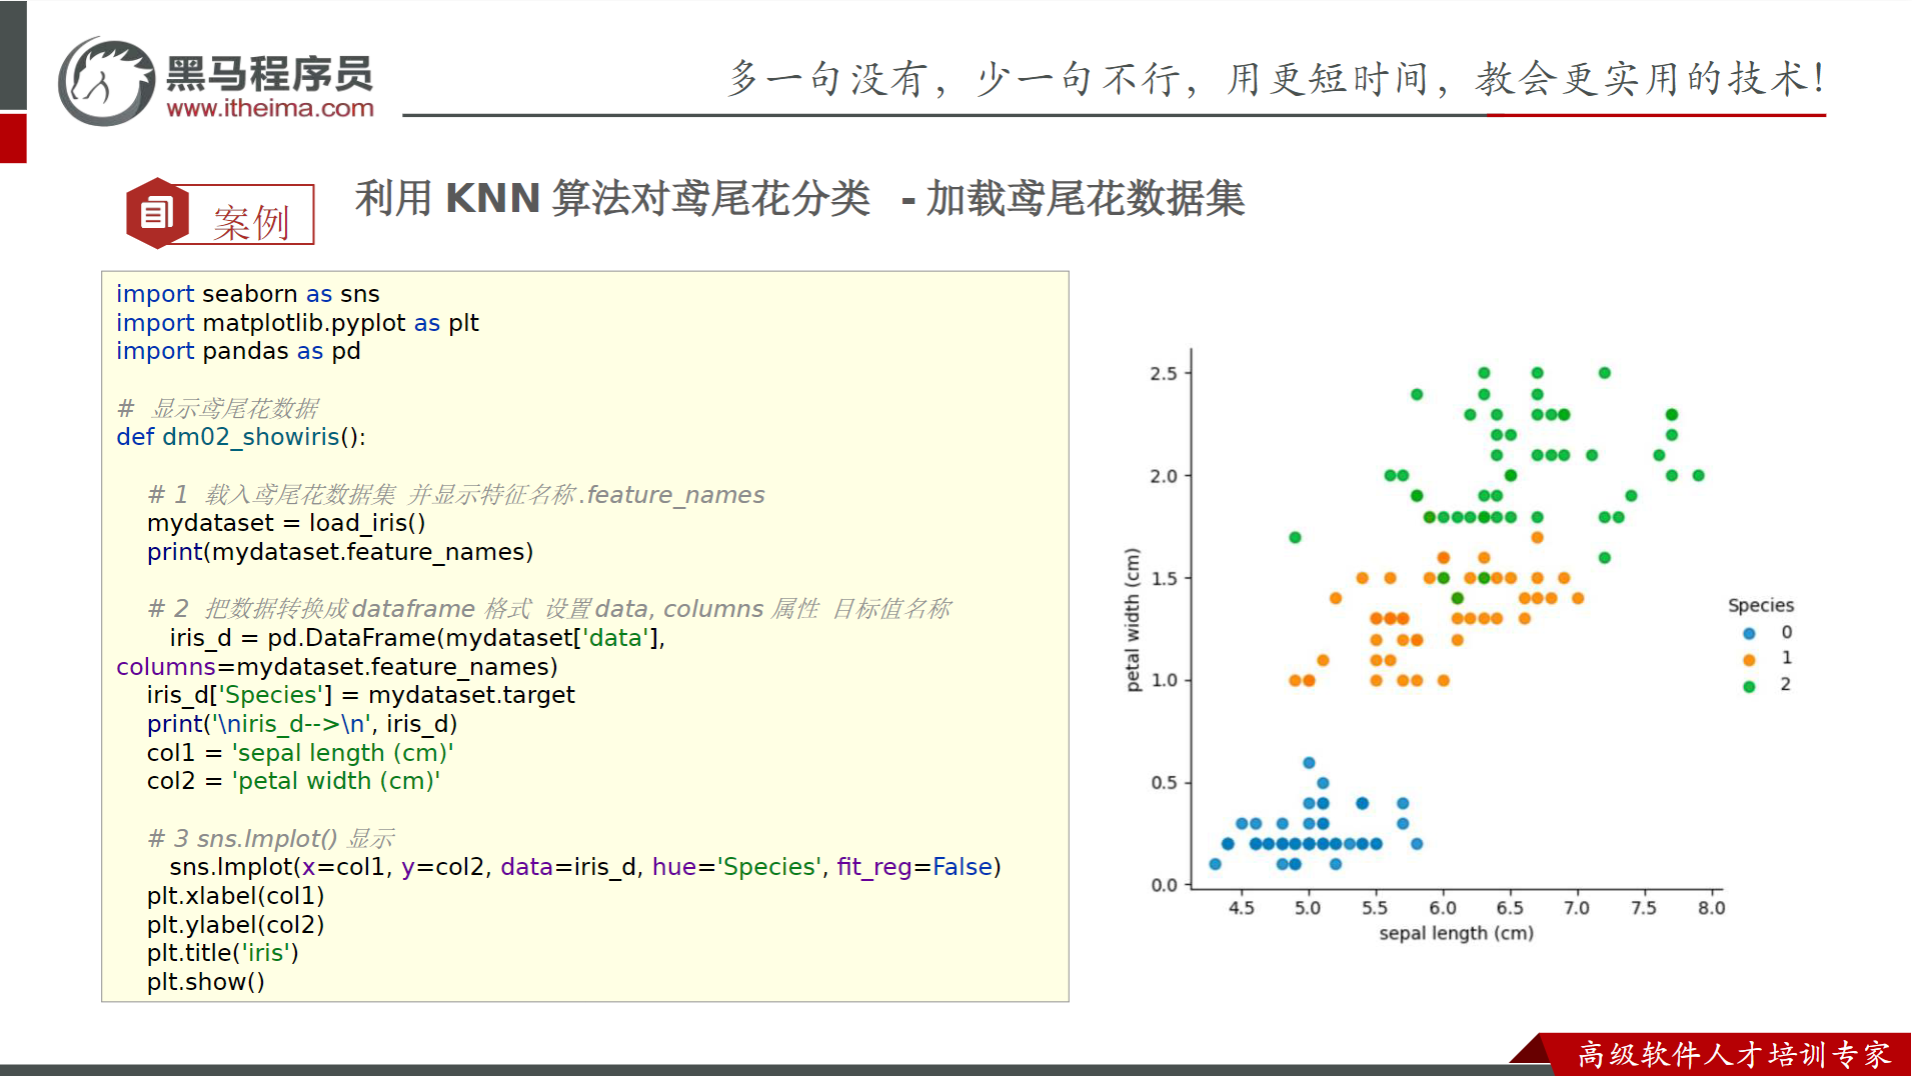
def dm02_show_iris():
    #1.加载数据集
    iris_data=load_iris()
    #2.把鸢尾花数据集封装成DataFrame对象
    iris_df=pd.DataFrame(iris_data.data,columns=iris_data.feature_names)
    #3.给df对象新增一列->标签列
    iris_df['target']=iris_data.target
    #4.通过seaborn绘制散点图
    #参1:数据集参2:x轴的特征参3:y轴的特征参4:hue->根据标签进行着色参
    sns.scatterplot(data=iris_df,x='sepal length (cm)',y='sepal width (cm)',hue='target')
    #5.设置标题,显式
    plt.title('iris_data')
    plt.tight_layout()#自动调整字体参数,以使整个图像的边界与子图匹配
    plt.show()
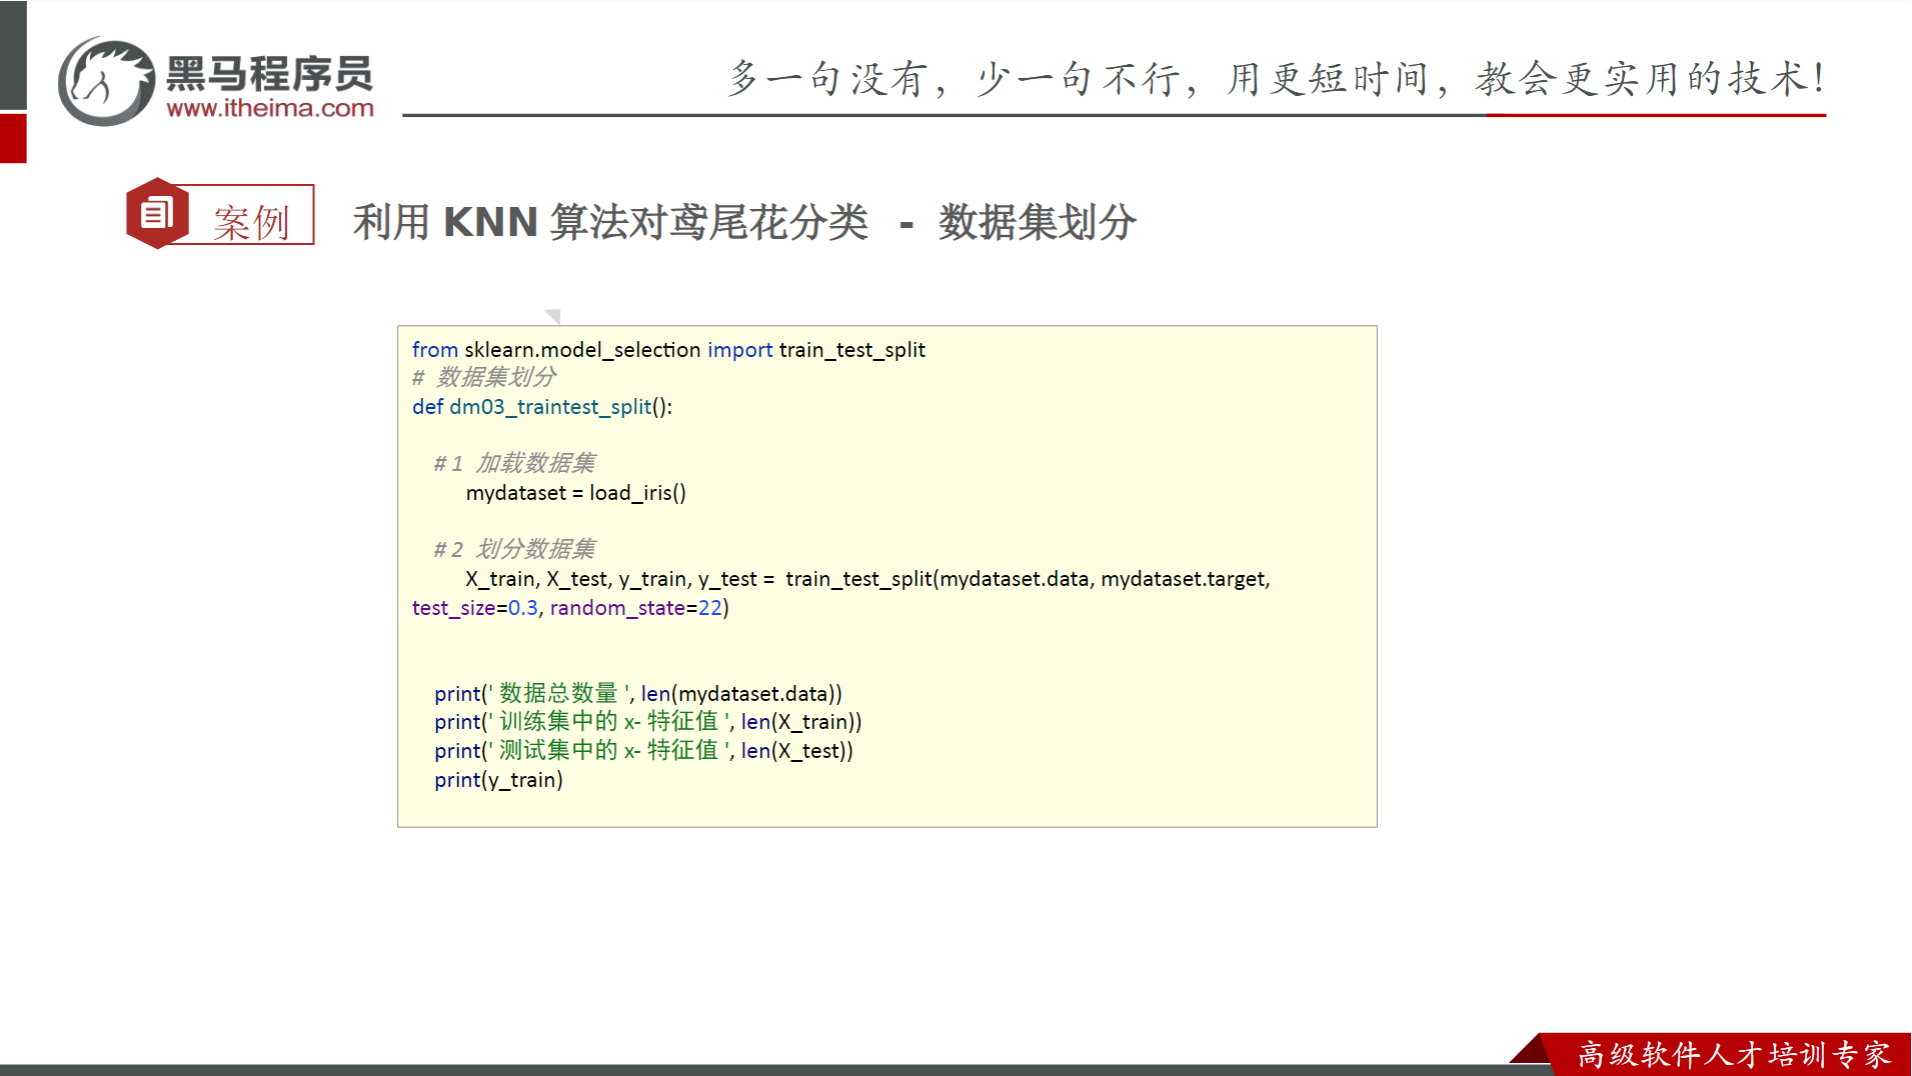
#3.定义函数,切分数据集为训练集和测试集
def dm03_split_train_test():
    #1.加载数据集
    iris_data=load_iris()
    #2.数据预处理:从150个特征和标签中,按照8:2的比例,切分训练集和测试集
    #参1:特征数据参2:标签数据 参3:测试集的比例 参4:随机种子(种子一致,每次生成的随机数据集都是固定的)
    #返回值:训练集的特征数据,测试集的特征数据,训练集的标签数据,测试集的标签数据
    x_train,x_test,y_train,y_test=train_test_split(iris_data.data,iris_data.target,test_size=0.2,random_state=23)
    #3.查看切分结果
    print(f'训练集的标签数据{x_train},个数{len(x_train)}')
    print(f'测试集的标签数据{x_test},个数{len(x_test)}')
    print(f'训练集的特征数据{y_train},个数{len(y_train)}')
    print(f'测试集的特征数据{y_test},个数{len(y_test)}')
#4.定义函数,实现鸢尾花完整案例->加载数据,数据预处理,特征工程,模型选择,模型训练,模型评估,模型预测
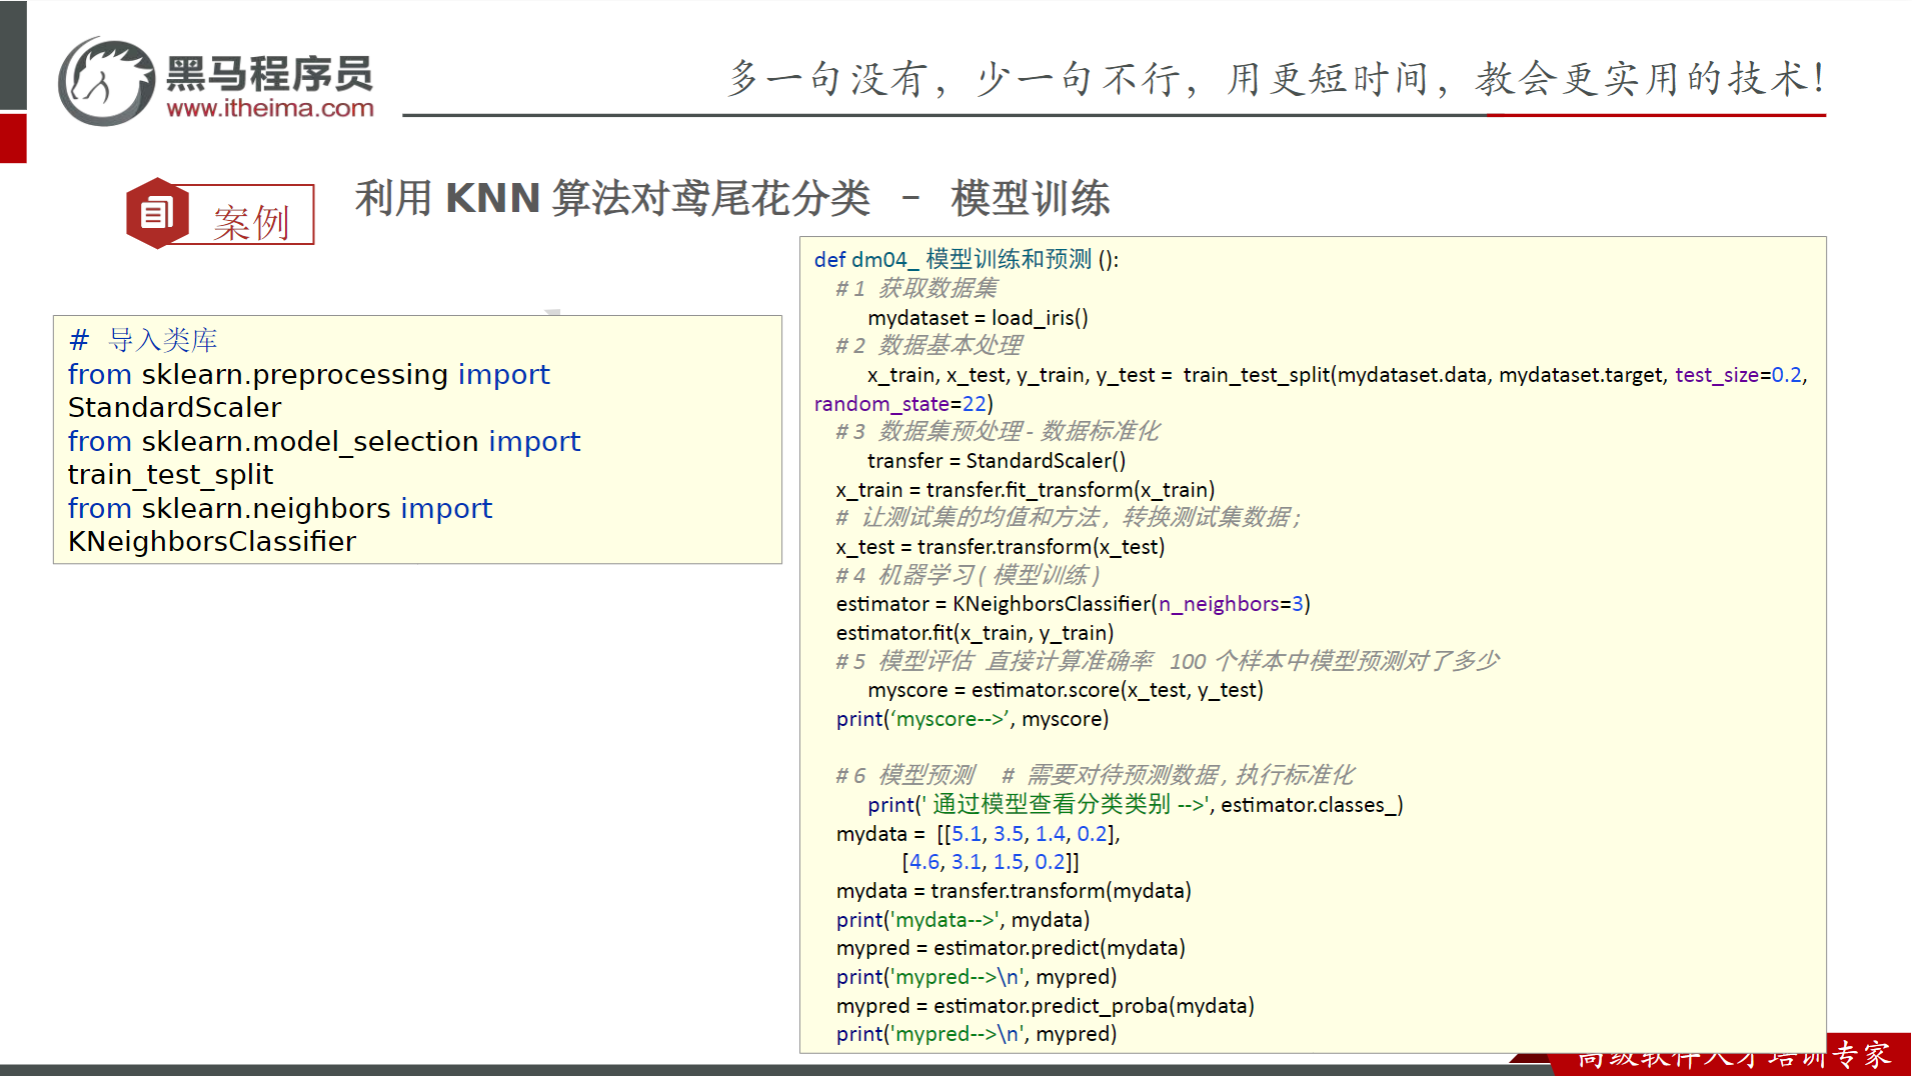
def dm04_iris_evaluate_test():
    #1.加载数据集
    iris_data=load_iris()
    #2.数据预处理:从150个特征和标签中,按照8:2的比例,切分训练集和测试集
    x_train,x_test,y_train,y_test=train_test_split(iris_data.data,iris_data.target,test_size=0.2,random_state=23)
    #3.特征工程:(提取、预处理...)
    #思考1:特征提取:因为原数据只有4个特征列,且都是我们要用的,所以这里无需特征提取
    #思考2:特征预处理:因为原数据的4列特征差值不大,所以我们无需做特征预处理,但是,加入特征预处理会让我们 的代码更完善,所以加入
    #3.1创建数据标准化对象
    transfer=StandardScaler()
    #3.2对特征列进行标准化,即,x_train训练集的特征数据,x_test测试集的特征数据
    #fit_transfer间距fit和transform的功能,即,训练,转换,该函数适用于:第一次进行标准化的时候使用,一般用于处理:训练集
    x_train=transfer.fit_transform(x_train)
    #transform只有转换,该函数适用于:重复进行标准化的时候使用,一般用于处理:测试集
    x_test=transfer.transform(x_test)
    #4.模型训练
    #4.1创建模型对象
    estimator=KNeighborsClassifier(n_neighbors=3)
    #4.2训练模型
    #参1:特征数据参2:标签数据
    #返回值:模型对象
    estimator.fit(x_train,y_train)
    #5.模型预测
    #场景1:对刚才切分的 测试集进行预测
    #5.1直接预测即可,获取到:预测结果
    y_pre=estimator.predict(x_test)
    print(f'预测值为:{y_pre}')
    #场景2,对新的数据集(150条之外的数据)进行预测
    #5.1自定义测试训练集
    my_data=[[7.8,2.1,5.0,1.2]]
    #5.2对自定义测试训练集进行预测
    y_pre_new=estimator.predict(my_data)
    print(f'预测值为:{y_pre_new}')
    #5.3查看上述数据集,每种分类的概率
    y_pre_proba=estimator.predict_proba(my_data)
    print(f'各分类预测概率为:{y_pre_proba}')
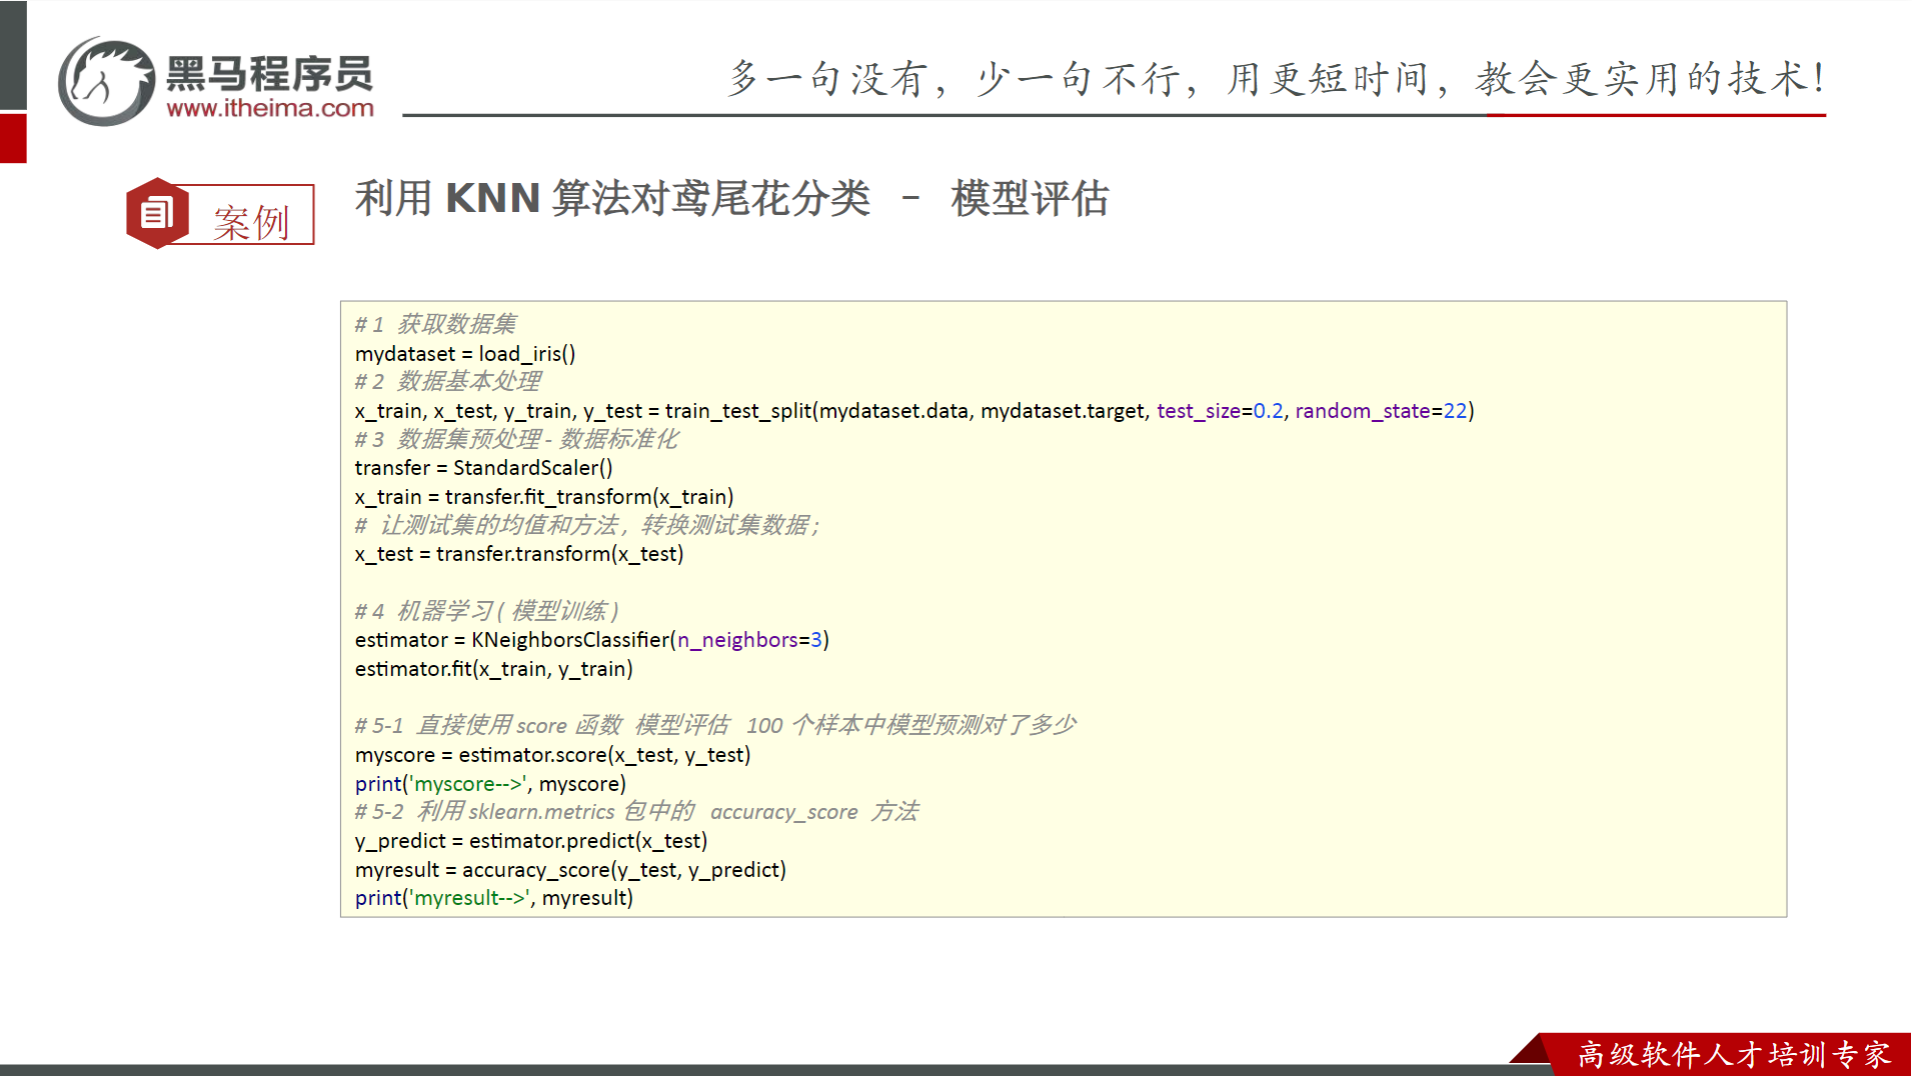
    #6.模型评估
    #方式1:直接评分,基于::测试集的特征和测试集的标签
    print(f'正确率:{estimator.score(x_test,y_test)}')
    #方式2:基于测试集的标签和预测结果进行评分
    print(f'正确率:{accuracy_score(y_test,y_pre)}')
if __name__ =='__main__':
    # dm01_load_iris()
    # dm02_show_iris()
    # dm03_split_train_test()
    dm04_iris_evaluate_test()
2
5.超参数选择方法
python
'''
网格搜索和交叉验证
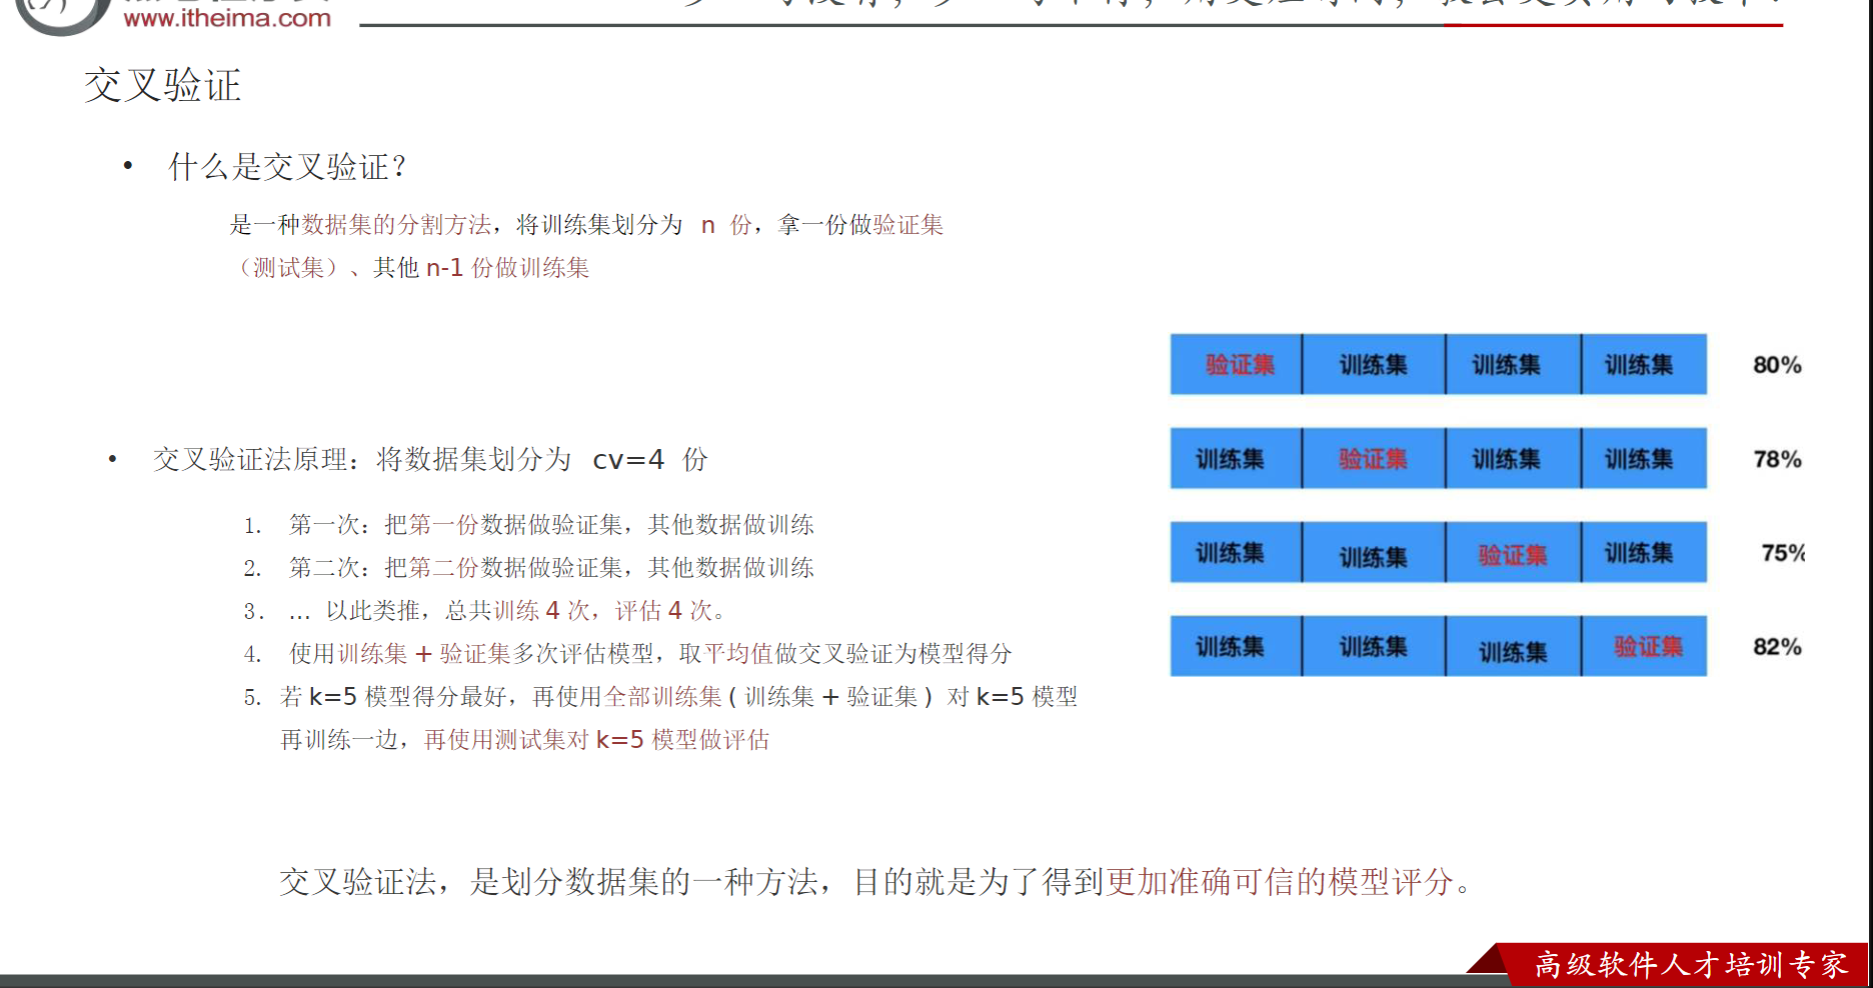
交叉验证解释:
    原理:
    把数据分为n份,例如分成4份->也叫4折交叉验证
    第1次:把第1份作为测试集,其他3份作为训练集,训练模型,模型预测,获取:准确率->准确率1
    第2次:把第2份作为测试集,其他3份作为训练集,训练模型,模型预测,获取:准确率->准确率2
    第3次:把第3份作为测试集,其他3份作为训练集,训练模型,模型预测,获取:准确率->准确率3
    第4次:把第4份作为测试集,其他3份作为训练集,训练模型,模型预测,获取:准确率->准确率4
    最后:把4个准确率取平均,作为最终的准确率

    假设第4次最好,则用全部数据(训练集+数据集)训练模型,再次用(第4次的)测试集度模型测试
    目的:
    为了让模型的最终验真结果更准确
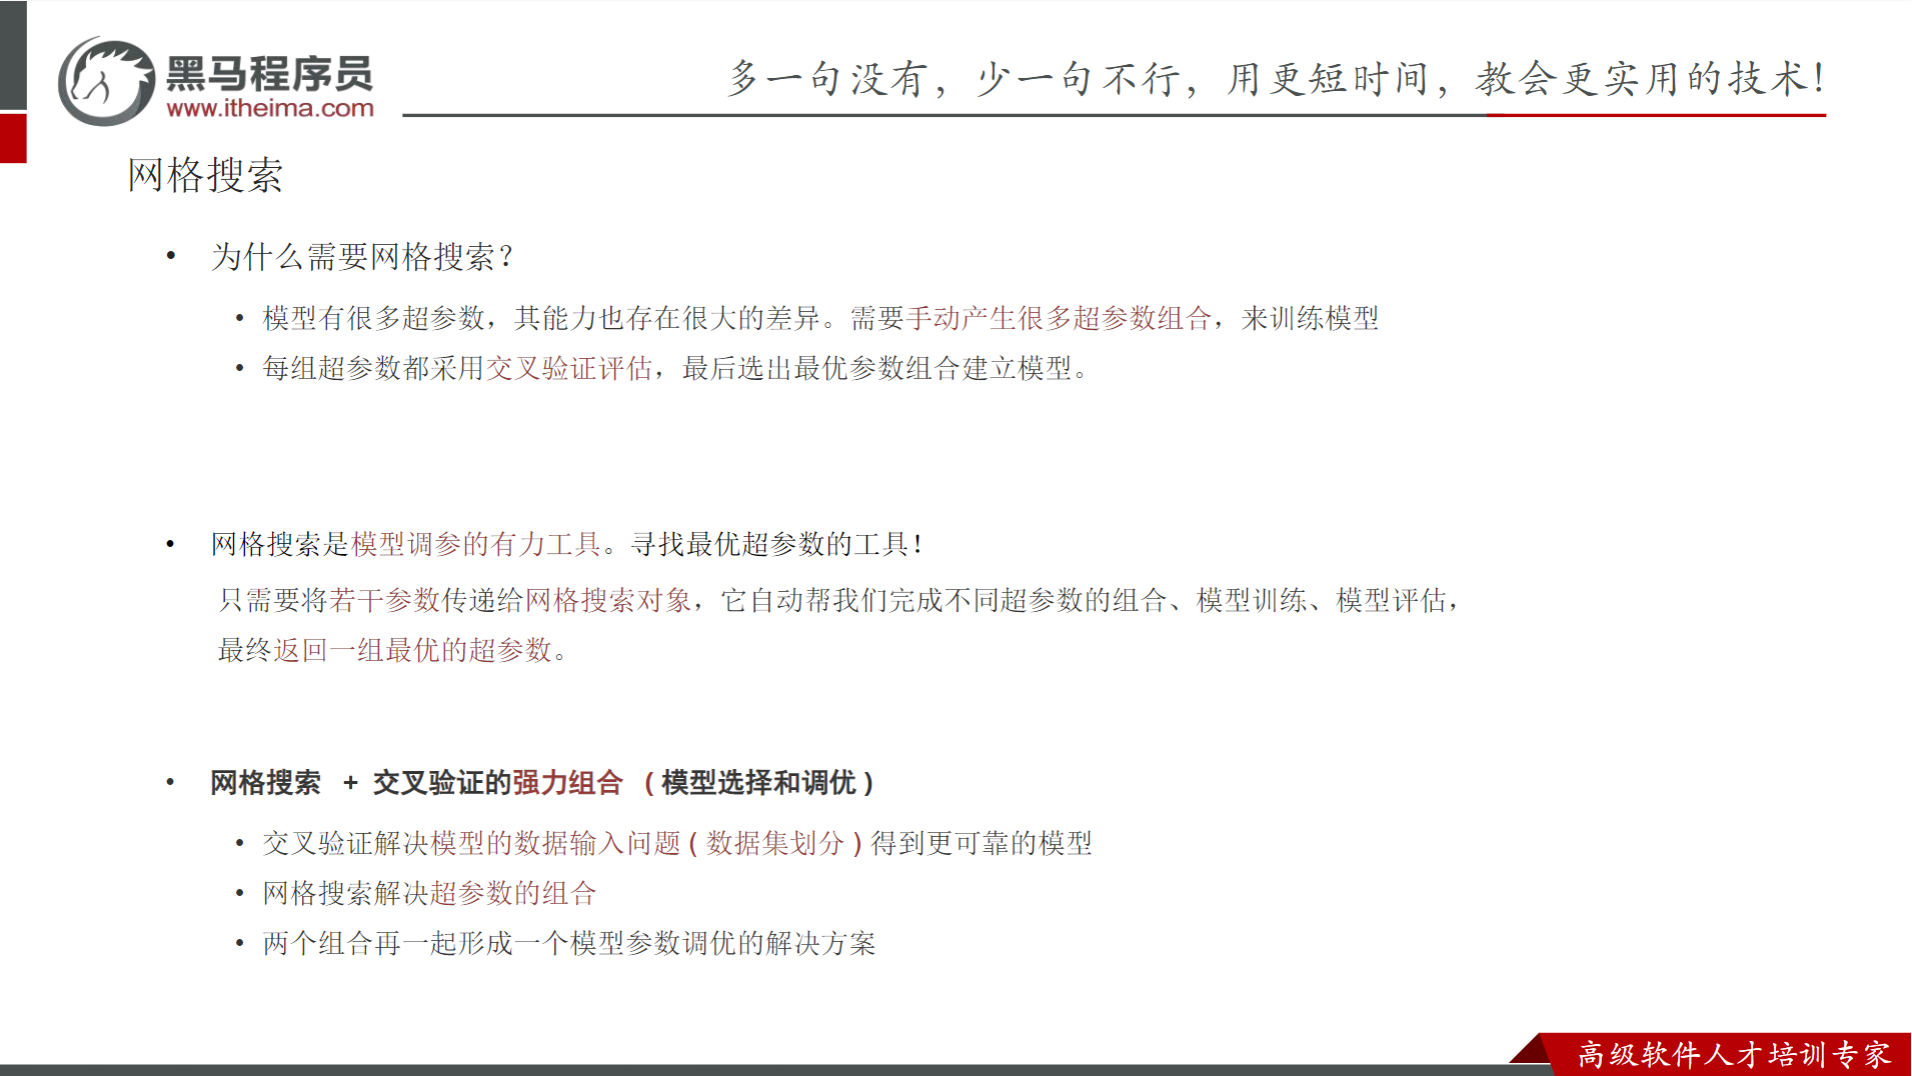
网格搜索:
    目的/作用:
    寻找最优超参数
    原理:
    接收超参可能出现的值,然后针对超参的每个值进行交叉验证,获取到最优超参组合
    超参数:
    需要用户手动录入的数据,不同的超参组合,可能导致不同的模型效果

大白话解释:
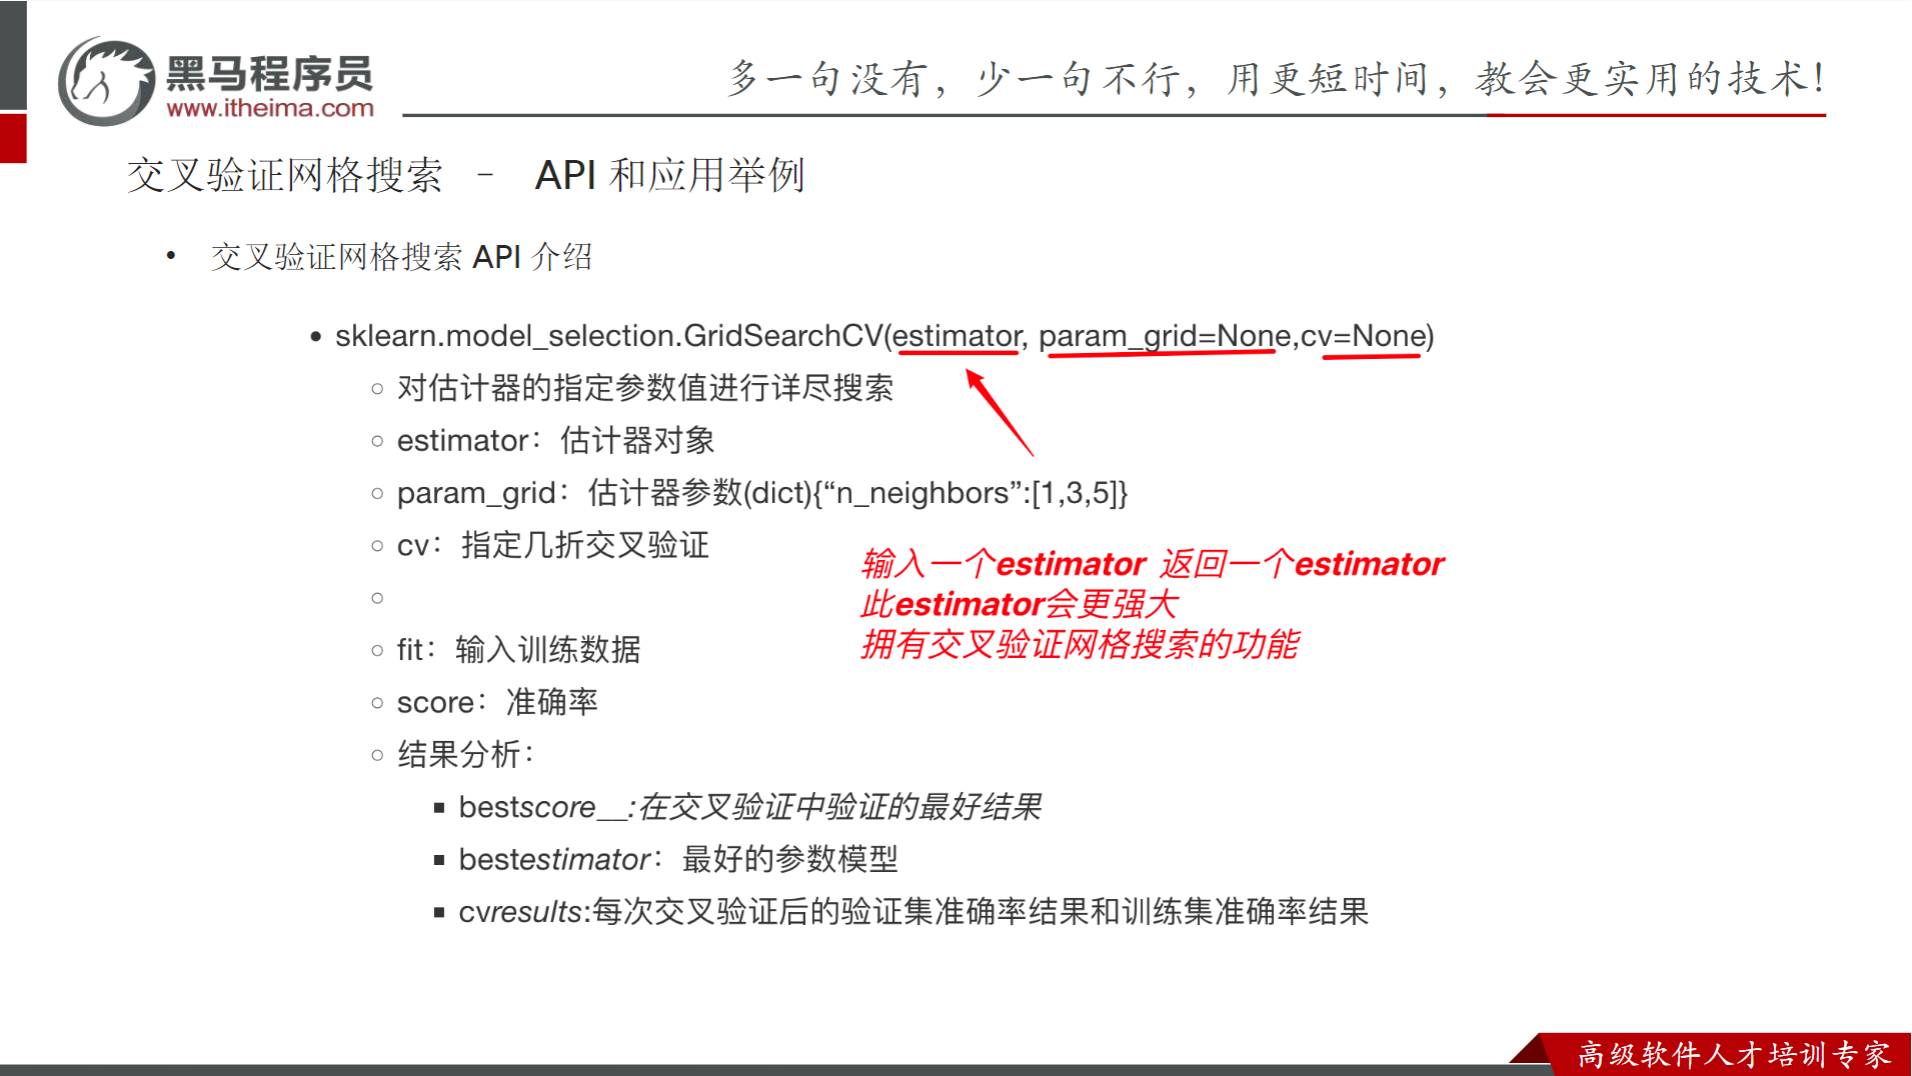
    网格搜索+交叉验证:本质上指的是GridSearchCV这个API,它会帮我们寻找最优超参
'''
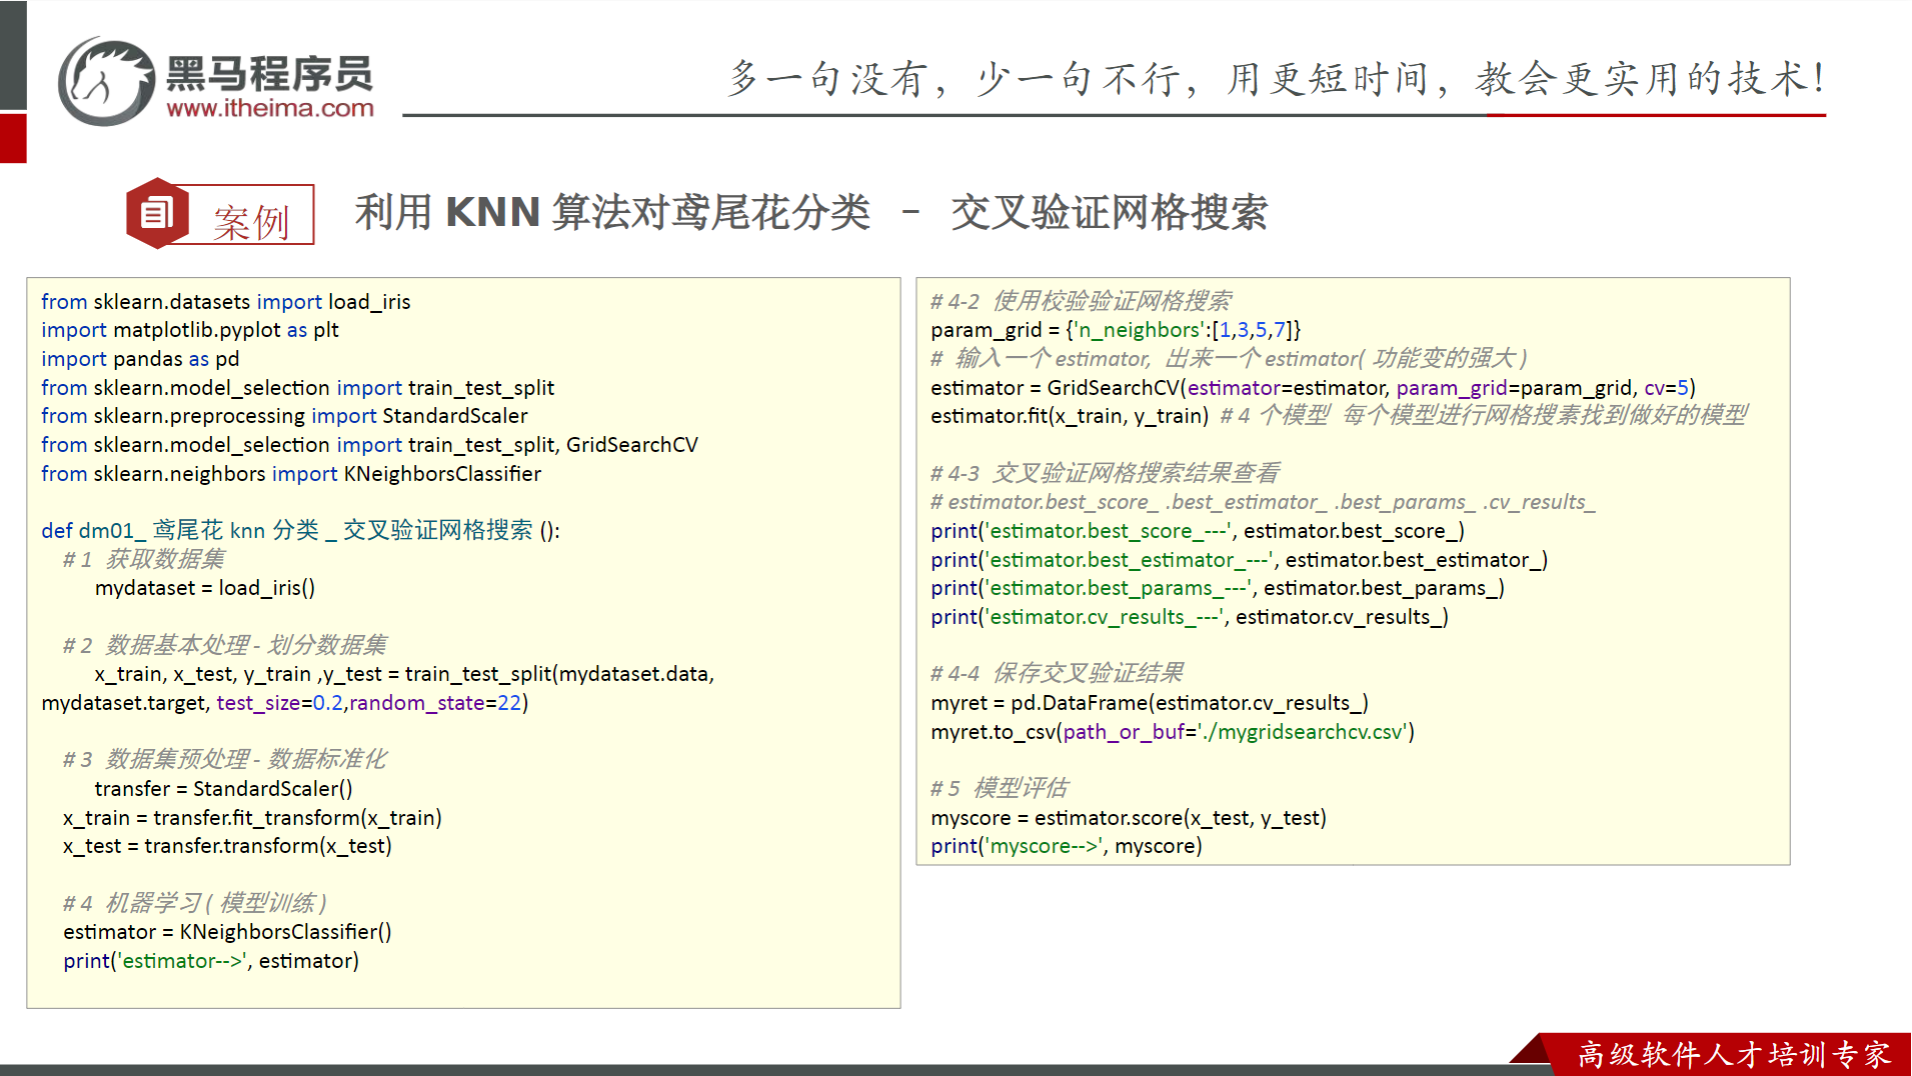
# 导入工具包
from sklearn.datasets import load_iris          # 加载鸢尾花测试集的.
from sklearn.model_selection import train_test_split    # 分割训练集和测试集的,寻找最优超参的(网络搜索+交叉验证)
from sklearn.preprocessing import StandardScaler        # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier      # KNN算法 分类对象
from sklearn.metrics import accuracy_score              # 模型评估的, 计算模型预测的准确率
from sklearn.model_selection import GridSearchCV        # 网格搜索+交叉验证的
#1.加载数据集
iris_data=load_iris()
#2.数据预处理,切分训练集和测试集 8:2
x_train,x_test,y_train,y_test=train_test_split(iris_data.data,iris_data.target,test_size=0.2,random_state=22)
#3.特征工程->特征预处理->标准化
#3.1先创建标准化对象
transfer=StandardScaler()
#3.2对训练集和测试集进行标准化
x_train=transfer.fit_transform(x_train)
x_test=transfer.transform(x_test)
#4.模型训练
#4.1创建KNN分类对象
estimator=KNeighborsClassifier()
#4.2定义字典,记录超参可能出现的值
params_grid={'n_neighbors':[1,2,3,4,5,6,7,8,9,10]}
#4.3创建GridSearchCV对象->寻找最优超参,使用网络搜索+交叉验证
#参1:estimator 模型对象
#参2:params_grid 超参可能出现的值
#参3:cv 交叉验证折数,这里4折表示:每个超参组合,进行4折交叉验证,获取4个准确率,共计4*10次
#返回值:estimator处理后的模型对象
estimator=GridSearchCV(estimator,params_grid,cv=4)
#4.4具体的训练动作
estimator.fit(x_train,y_train)
#4.5打印最优超参组合
print(f'最优评分:{estimator.best_score_}')
print(f'最优超参组合:{estimator.best_params_}')
print(f'最优的估计器对象:{estimator.best_estimator_}')
print(f'具体的交叉验证结果:\n{estimator.cv_results_}')
# 5. 模型评估.
# 5.1 获取最优超参的 模型对象.
# estimator = estimator.best_estimator_                 # 获取最优的模型对象.
estimator = KNeighborsClassifier(n_neighbors=4)
# 5.2 模型训练.
estimator.fit(x_train, y_train)
# 5.3 模型预测.
y_pre = estimator.predict(x_test)
# 5.4 模型评估.
# 参1: 测试集.   参2: 预测集
print(f'准确率: {accuracy_score(y_test, y_pre)}')        # 0.9666666666666667
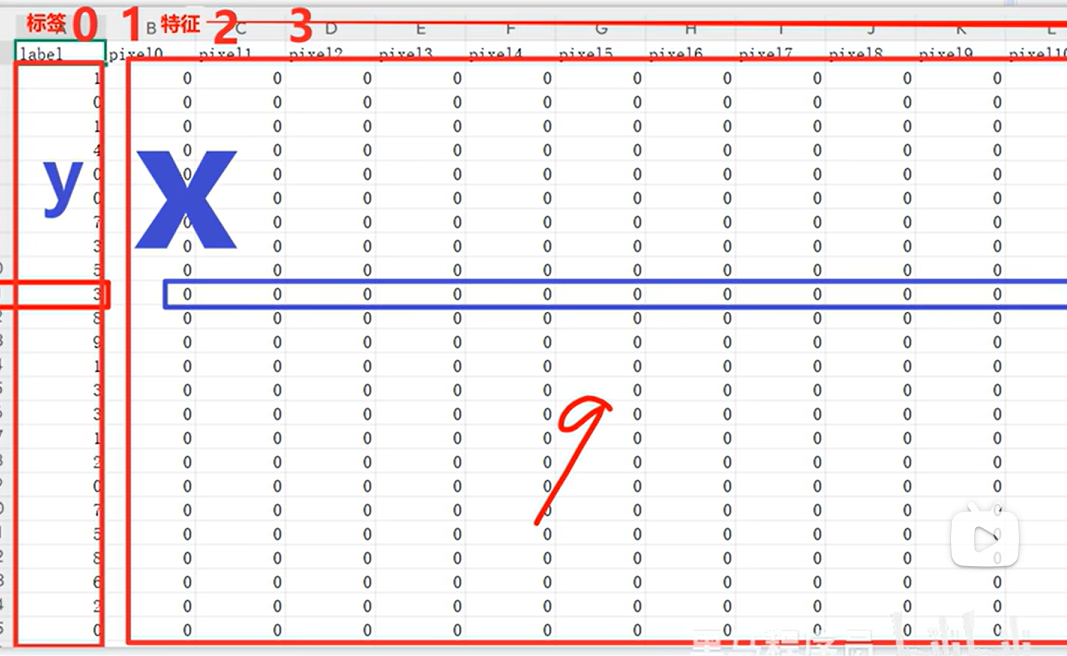
python
"""
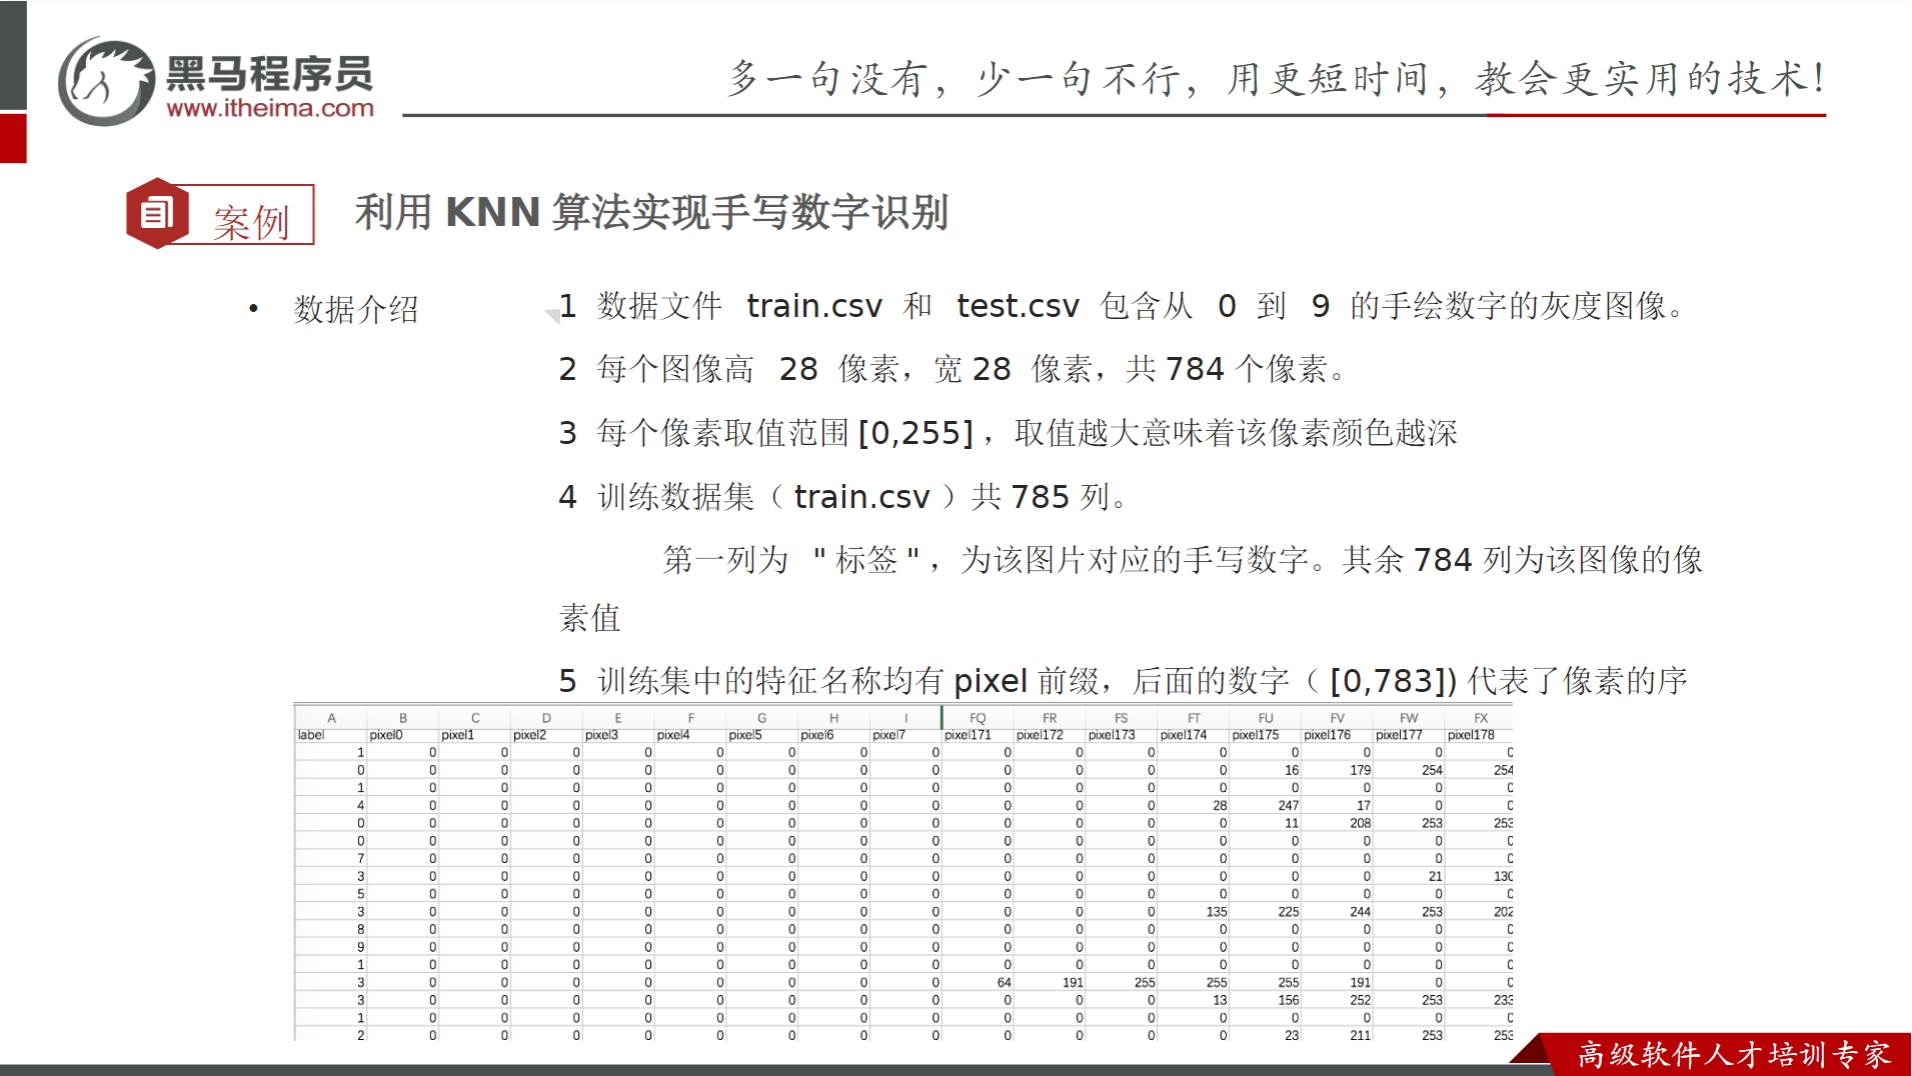
案例: 演示 KNN算法 识别图片, 即: 手写数字识别案例.

介绍:
    每张图片都是由 28 * 28 像素组成的, 即: 我们的csv文件中每一行都有 784个像素点, 表示图片(每个像素)的 颜色.
    最终构成图像.
"""

import matplotlib.pyplot as plt
import pandas as pd
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
import joblib
from collections import Counter

# 扩展: 忽略警告.
import warnings
warnings.filterwarnings('ignore', module='sklearn') # 参1: 忽略警告, 参2: 忽略的模块.
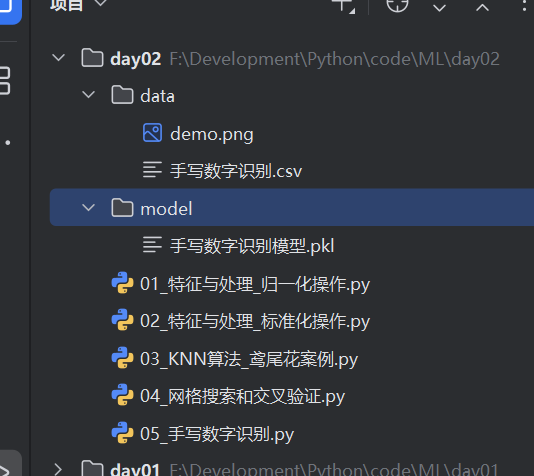
#1.定义函数,接收用户传入的索引,展示该索引对应的图片
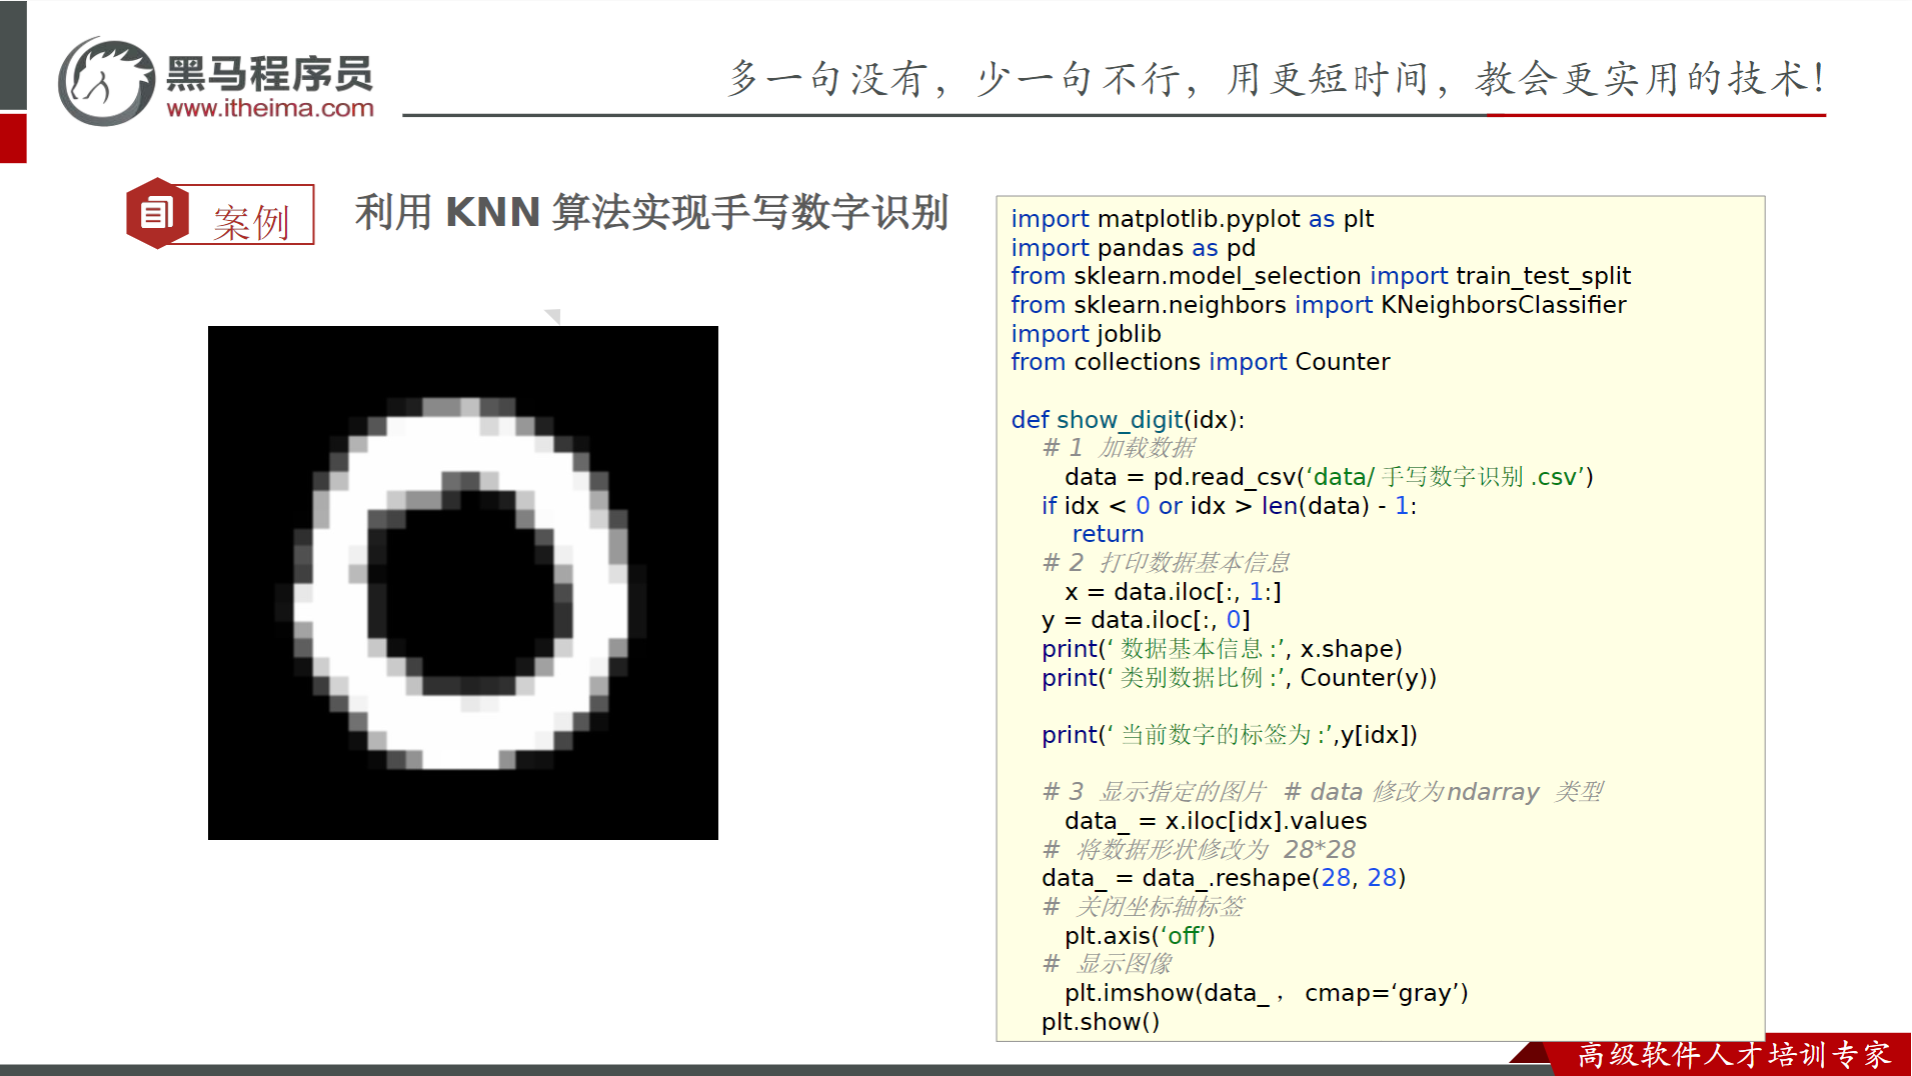
def show_digit(idx):
    #1.读取数据集,获取到源数据
    df = pd.read_csv('./data/手写数字识别.csv')
    #2.判断传入的索引是否越界
    if idx<0 or idx>len(df)-1:
        print('索引越界!')
        return
    #3.走到这里,说明没有月结,就正常获取数据
    #iloc作用: 根据索引获取数据;x是特征数据,y是目标数据
    x = df.iloc[:,1:]
    y = df.iloc[:,0]
    #4.查看用户传入的索引对应的图片->是几?
    print(f'该图片对应的数字是: {y.iloc[idx]}')
    print(f'查看所有的标签分布情况: { Counter(y)}')
    #5.查看下用户传入的索引对应的图片形状
    print(f'该图片的形状是: {x.iloc[idx].shape}')#784我们要将784个像素点,转换为28*28的图片
    print(x.iloc[idx].values)#具体的784个像素点数据
    #6.将784个像素点数据转换为28*28的图片
    x=x.iloc[idx].values.reshape(28,28)
    print(x)#具体的28*28的图片数据
    # 7. 具体的绘制灰度图的动作.
    plt.imshow(x, cmap='gray')      # 灰度图
    plt.axis('off')                 # 不显示坐标轴
    plt.show()
if __name__=='__main__':
    #绘制数字
    show_digit(9)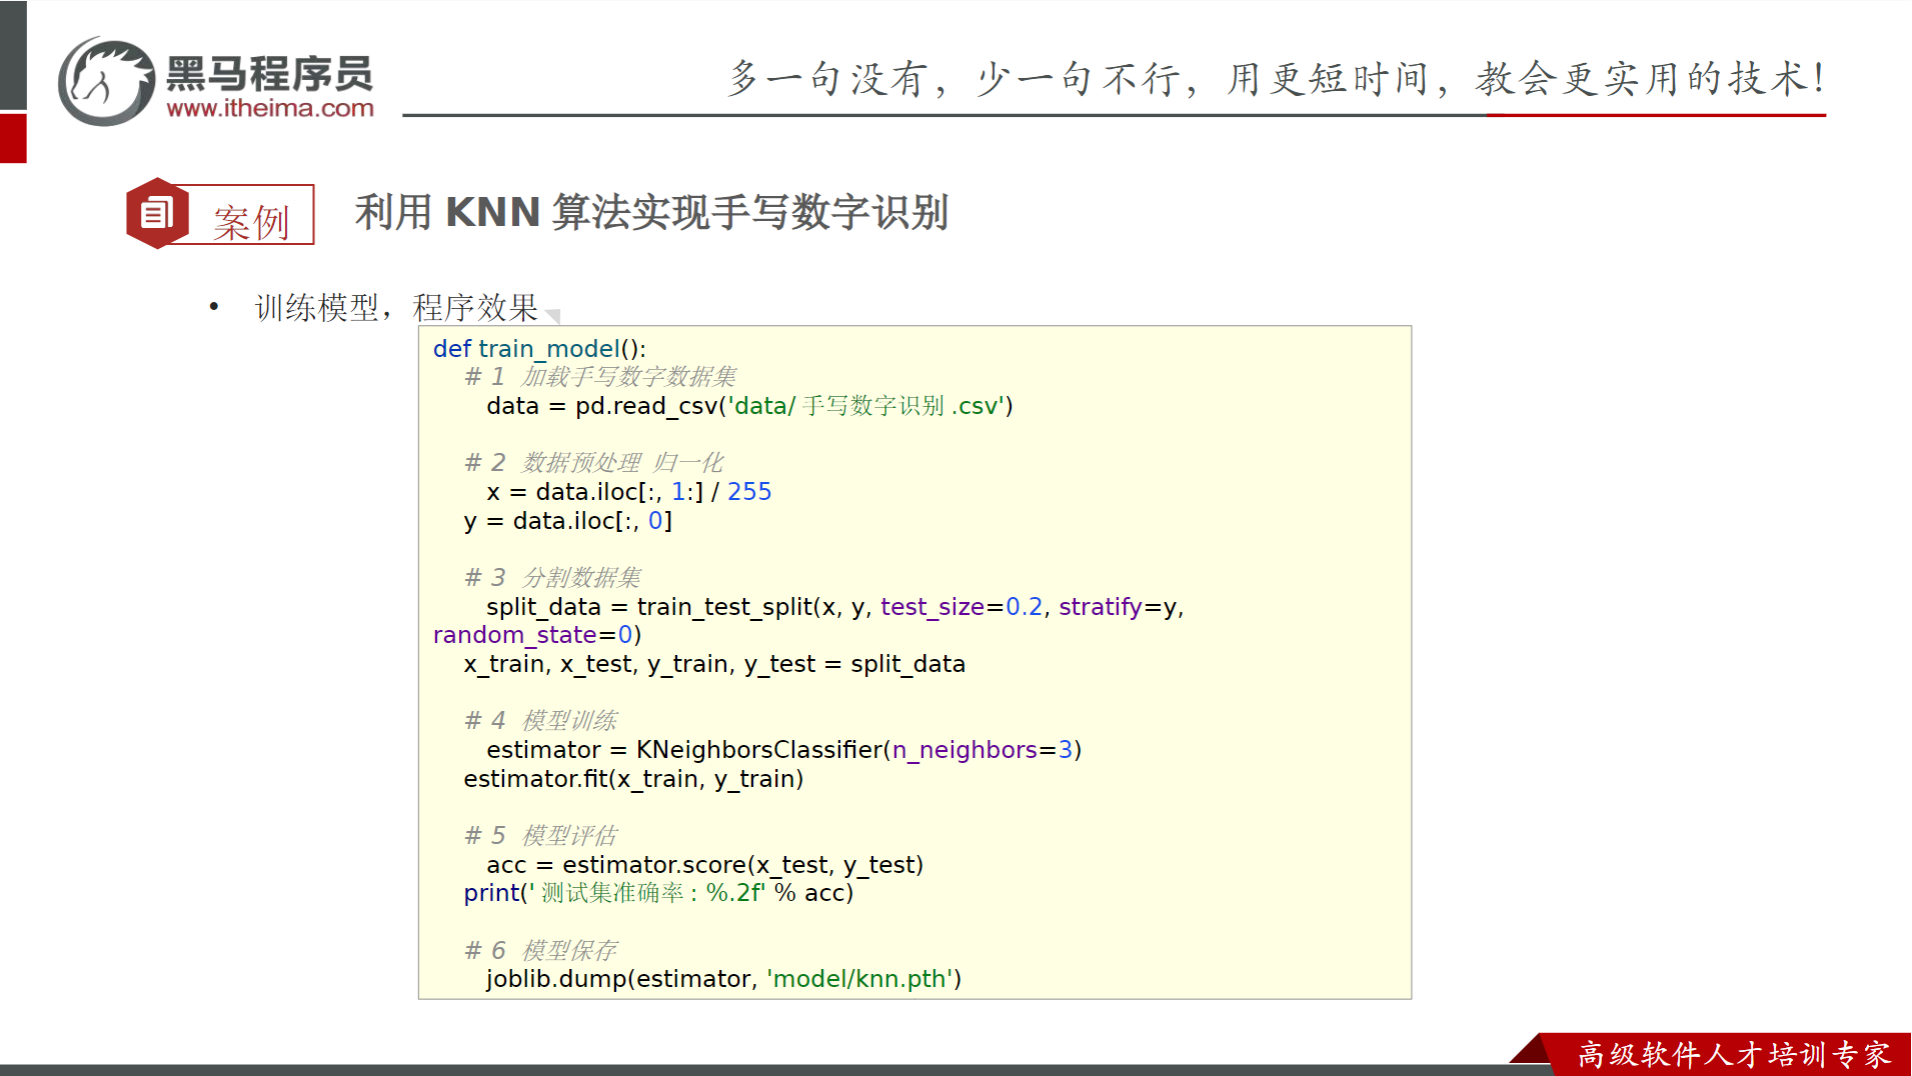
python
"""
案例: 演示 KNN算法 识别图片, 即: 手写数字识别案例.

介绍:
    每张图片都是由 28 * 28 像素组成的, 即: 我们的csv文件中每一行都有 784个像素点, 表示图片(每个像素)的 颜色.
    最终构成图像.
"""

import matplotlib.pyplot as plt
import pandas as pd
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
import joblib
from collections import Counter

# 扩展: 忽略警告.
import warnings
warnings.filterwarnings('ignore', module='sklearn') # 参1: 忽略警告, 参2: 忽略的模块.
#1.定义函数,接收用户传入的索引,展示该索引对应的图片
def show_digit(idx):
    #1.读取数据集,获取到源数据
    df = pd.read_csv('./data/手写数字识别.csv')
    #2.判断传入的索引是否越界
    if idx<0 or idx>len(df)-1:
        print('索引越界!')
        return
    #3.走到这里,说明没有月结,就正常获取数据
    #iloc作用: 根据索引获取数据;x是特征数据,y是目标数据
    x = df.iloc[:,1:]
    y = df.iloc[:,0]
    #4.查看用户传入的索引对应的图片->是几?
    print(f'该图片对应的数字是: {y.iloc[idx]}')
    print(f'查看所有的标签分布情况: { Counter(y)}')
    #5.查看下用户传入的索引对应的图片形状
    print(f'该图片的形状是: {x.iloc[idx].shape}')#784我们要将784个像素点,转换为28*28的图片
    print(x.iloc[idx].values)#具体的784个像素点数据
    #6.将784个像素点数据转换为28*28的图片
    x=x.iloc[idx].values.reshape(28,28)
    print(x)#具体的28*28的图片数据
    # 7. 具体的绘制灰度图的动作.
    plt.imshow(x, cmap='gray')      # 灰度图
    plt.axis('off')                 # 不显示坐标轴
    plt.show()

#2.定义函数,训练模型,并保存训练好的模型
def train_model():
    #1.加载数据集
    df=pd.read_csv('./data/手写数字识别.csv')
    #2.数据预处理
    #2.1拆分出特征列
    x=df.iloc[:,1:]
    #2.2查分出标签列
    y=df.iloc[:,0]
    #2.3打印特征和标签的形状
    print(f'特征列x的形状是: {x.shape}')
    print(f'标签列y的形状是: {y.shape}')
    #2.4对特征列(拆分前)进行归一化
    x=x/255 #当前值-最小值/最大值-最小值
    #2.5拆分训练集和测试集
    #参1 特征列 参2:标签列 参3:测试集占比 参4:随机种子 参5:按标签比例拆分数据,参考y值进行抽取,保持标签的比例
    x_train,x_test,y_train,y_test=train_test_split(x,y,test_size=0.2,random_state=19,stratify=y)
    #3.模型训练
    #3.1创建模型对象
    estimator=KNeighborsClassifier(n_neighbors=3)
    #3.2训练模型
    estimator.fit(x_train,y_train)
    #4.模型评估
    print(f'准确率:{estimator.score(x_test,y_test)}')
    print(f'模型在测试集上的准确率是: {accuracy_score(y_test,estimator.predict(x_test))}')
    #5.模型保存
    #保存模型的意义:跑一次这个模型需要的时间很长,所以我们可以将训练好的模型保存起来,下次使用时直接加载模型即可
    joblib.dump(estimator,'./model/手写数字识别模型.pkl')
    print('模型保存成功!')
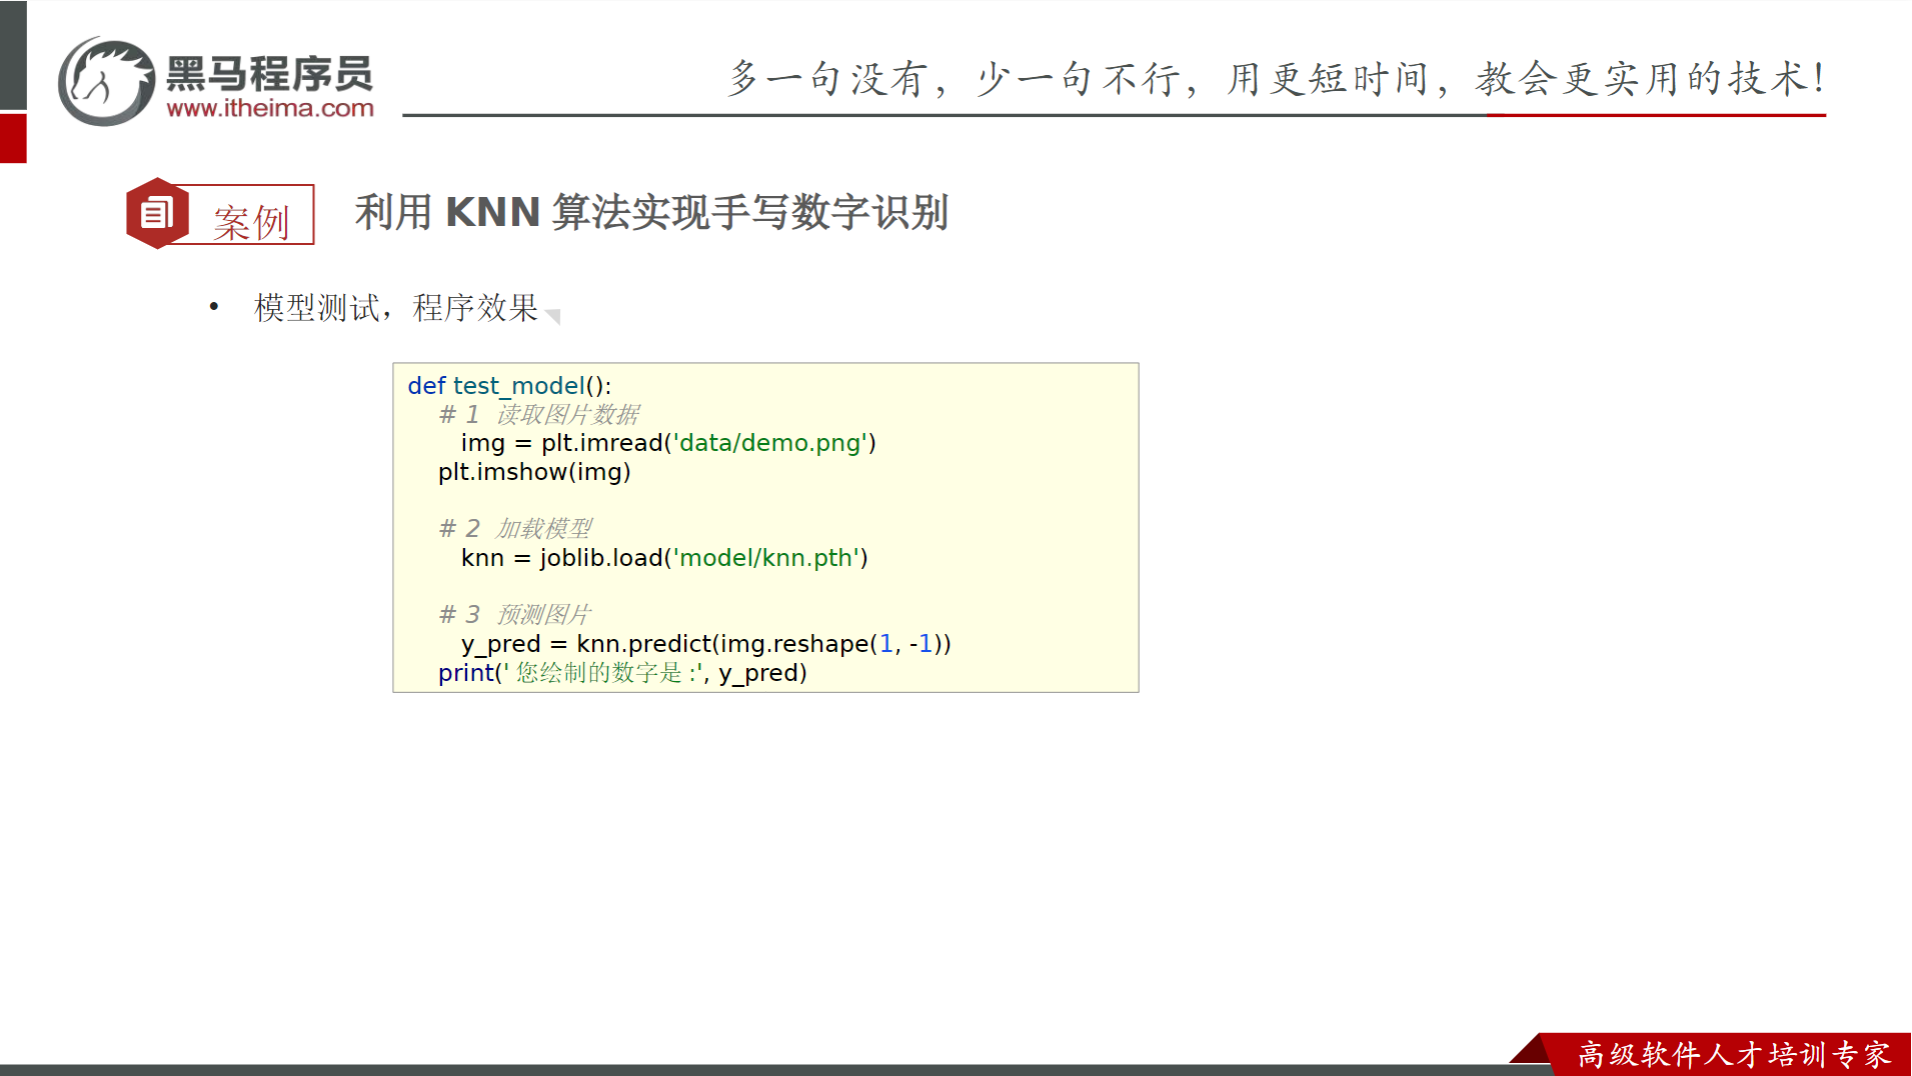
#3.定义函数,加载模型,并使用模型进行预测
def use_model():
    #1.加载图片
    x=plt.imread('./data/demo.png')
    #2.绘制图片
    # plt.imshow(x, cmap='gray')#灰度图
    # plt.axis('off')#不显示坐标轴
    # plt.show()
    #3.加载模型
    estimator=joblib.load('./model/手写数字识别模型.pkl')
    #4.模型预测
    #4.1查看数据集转换
    print(x.shape)#(28, 28)  原本图片是28*28的,但是模型需要的是1*784,所以我们要将图片转换为784个像素点的向量
    print(x.reshape(1,784).shape)#(1, 784)
    # print(x.reshape(1,-1).shape)#效果和上面一样,-1指的是自动计算的列数
    #4.2具体的转换动作,记得:归一化(因为训练模型的时候使用了归一化动作
    # x=x.reshape(1,-1)/255#可能会预测失败,因为读图的时候,像素值可能不是特别精准
    x=x.reshape(1,784)#用原始的读取到的像素值,做预测
    #4.3模型预测
    y_pre=estimator.predict(x)
    #5.打印预测结果
    print(f'该图片对应的数字是: {y_pre}')
if __name__=='__main__':
    #绘制数字
    # show_digit(9)
    # train_model()
    use_model()