相关子查询与性能优化:PostgreSQL 逐行执行的代价与 JOIN 重写
标签:#PostgreSQL #SQL #性能优化 #子查询
一、前言
在 PostgreSQL 中,子查询(Subquery) 是一种在另一个查询内部嵌套的查询。根据子查询是否依赖于外部查询的某些行,可以分成两大类:
- 非相关子查询(Non-Correlated Subquery) :不依赖外部查询,独立执行一次,结果固定;
- 相关子查询(Correlated Subquery) :依赖外部查询的当前行------子查询里的条件或计算基于外部查询当前行的值。
相关子查询的经典例子(找出"工资高于本部门平均工资"的员工):
sql
SELECT e.name, e.salary
FROM employees e
WHERE e.salary > (SELECT avg(salary) FROM employees WHERE department_id = e.department_id);
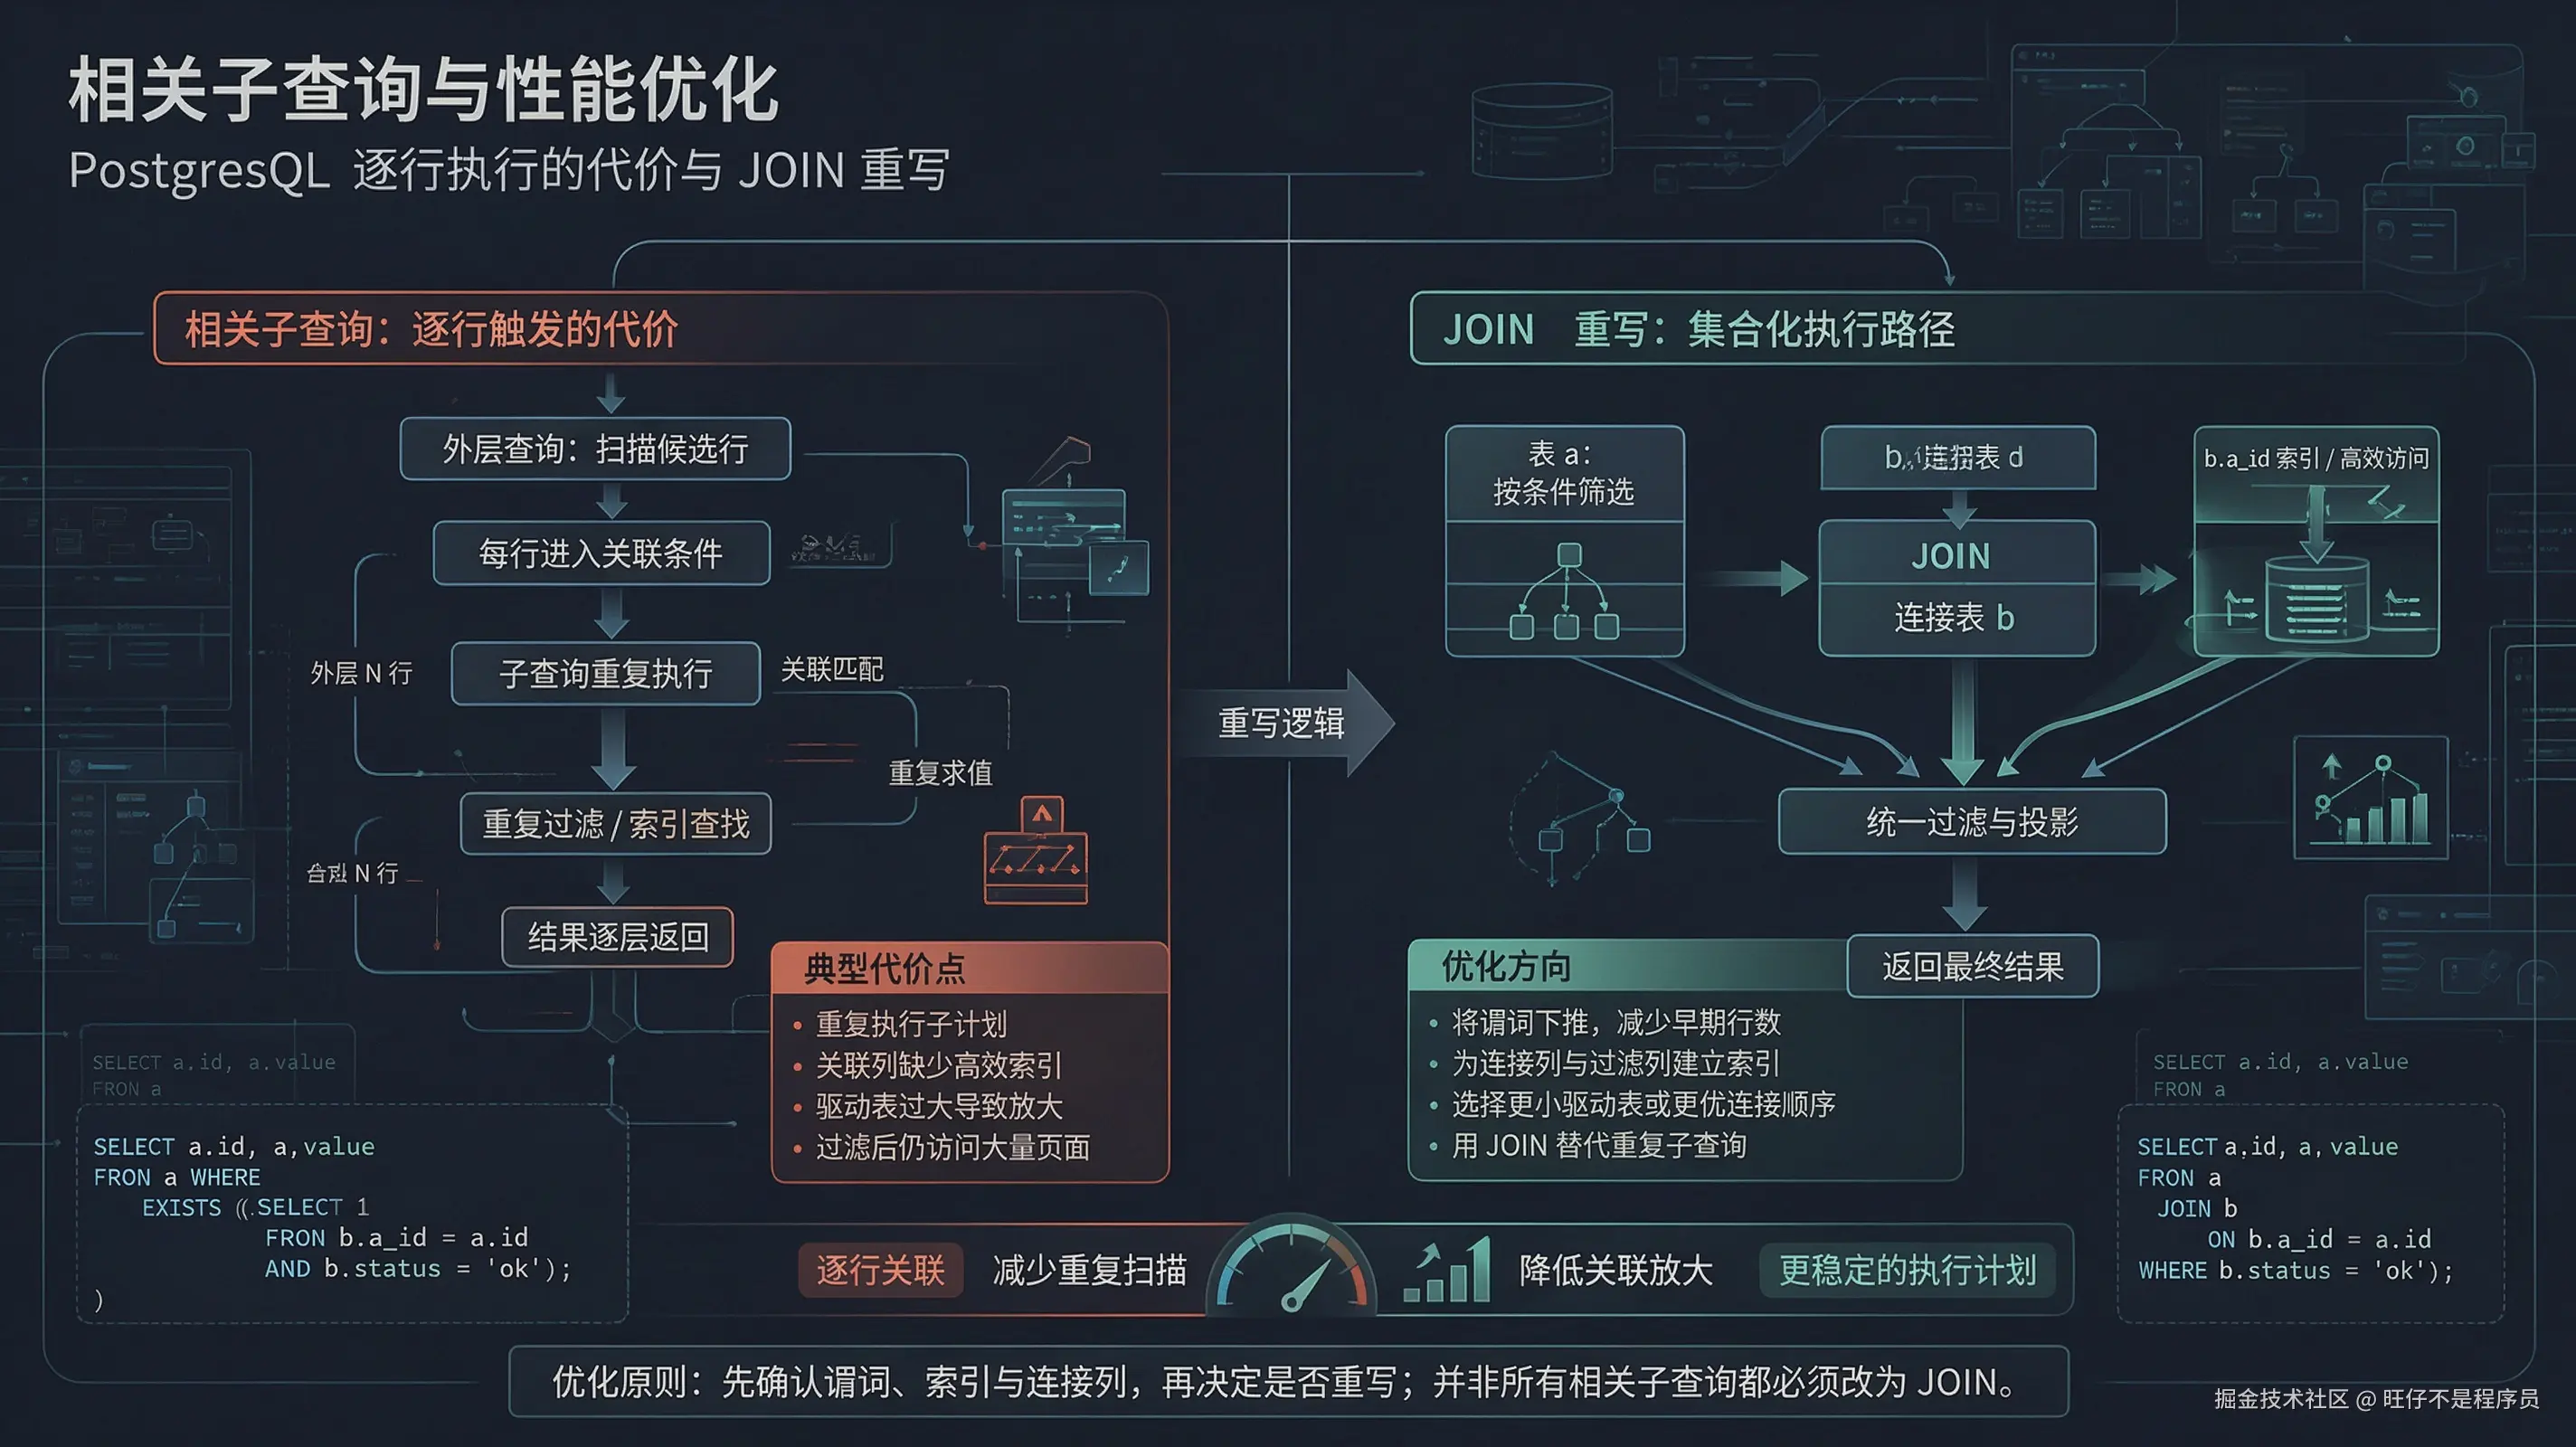
相关子查询可能因为需要多次执行而产生性能问题,尤其是当外部表很大时 ------外部每行都要跑一次子查询。优化三板斧:临时表、CTE(公用表表达式)、重写为 JOIN,通常都能显著提升性能。
二、核心开发规范
- 识别类型 :子查询引用了外部查询的行(如
e.department_id)→ 相关子查询,随外部行逐行执行;不引用外部行 → 非相关子查询,只执行一次; - 性能红线 :外部表很大时,相关子查询可能重复执行 N 次(N = 外部行数),这是性能问题的第一来源------大表上的相关子查询要主动优化;
- 优化三板斧:临时表 / CTE / 重写为 JOIN------共同原理都是让"每行重复计算的子查询"变成"只算一次"。
三、底层原理通俗讲解
- 非相关子查询 :与外部行无关,像独立查询一样执行一次------
WHERE salary > (SELECT avg(salary) FROM employees)里的全局平均工资只算一遍; - 相关子查询的官方语义 :官方 9.23 原文------"子查询可以引用外层查询的变量,这些变量在子查询的任何一次求值中充当常量"------意思是每次求值绑定一行外部行 ,把该行的
e.department_id带进去算; - 逐行执行的成本模型:外部 N 行 → 子查询最多执行 N 次;外部表 1000 万行,就最多跑 1000 万次"求部门平均"------这就是大表上相关子查询慢的根源;
- 优化器不一定总能救你 :PostgreSQL 会把部分相关子查询自动提升(unnest)成 JOIN,但标量子查询、复杂相关条件并不保证转换------显式重写可控、可预期;
- JOIN 重写原理 :先用
GROUP BY一次性算出"每个部门的平均工资"(一次聚合),再与外层员工表做连接------子查询从"每行跑一遍"变成"只算一次 + 哈希查找"; - CTE / 临时表原理 :
WITH子查询可视为"只存在这一次查询的临时表"(官方 7.8),先物化计算一次,外层 JOIN 引用;临时表则物理落一次------都符合"算一次"的思路。
四、实战错误案例&优化方案
场景1:先分清两类子查询
表设计:employees 表(id, name, salary, department_id)
✅ 正确认知(对比两类子查询)
sql
-- ① 非相关子查询:与外部行无关,独立执行一次
SELECT name, salary FROM employees
WHERE salary > (SELECT avg(salary) FROM employees);
-- 全公司平均工资只计算一次,结果固定

-- ② 相关子查询:依赖外部行 e.department_id,逐行执行
SELECT e.name, e.salary FROM employees e
WHERE e.salary > (SELECT avg(salary) FROM employees WHERE department_id = e.department_id);
-- 每个员工一行 → 内部 avg 按该员工部门计算一次
关键结论 :看子查询里有没有引用外层表的列------有就是相关子查询(逐行执行),没有就是非相关(只执行一次);先把类型认清楚,再谈优化。
场景2:大表相关子查询性能问题 → JOIN 重写(核心场景)
表设计:employees 表 500 万行,80 个部门,查询"工资高于本部门平均的员工"
❌ 错误写法(相关子查询,逐行跑 500 万次)
sql
SELECT e.name, e.salary
FROM employees e
WHERE e.salary > (SELECT avg(salary) FROM employees WHERE department_id = e.department_id);
-- 外部 500 万行 → 内部"求部门平均"最多执行 500 万次
-- EXPLAIN 可见 SubPlan 每行反复计算,大表上性能灾难
✅ 正确写法(JOIN 重写,聚合只算一次)
sql
SELECT e.name, e.salary
FROM employees e
JOIN (
    SELECT department_id, avg(salary) AS avg_salary
    FROM employees
    GROUP BY department_id
) dept_avg ON e.department_id = dept_avg.department_id
WHERE e.salary > dept_avg.avg_salary;
-- ① 子查询先按部门聚合:80 个部门只算一次
-- ② 外层与 dept_avg 做 Hash Join
-- ③ 每行比较 salary > avg_salary,无重复计算
关键结论 :相关子查询重写为 JOIN(用户标准姿势)------把"每行重复的子查询"变成"先聚合一次 + 连接",外部表越大收益越明显。
场景3:CTE(公用表表达式)重写
表设计:同上,需求相同
✅ 正确写法(CTE 先算部门平均,外层 JOIN)
sql
WITH dept_avg AS (
    SELECT department_id, avg(salary) AS avg_salary
    FROM employees
    GROUP BY department_id
)
SELECT e.name, e.salary
FROM employees e
JOIN dept_avg ON e.department_id = dept_avg.department_id
WHERE e.salary > dept_avg.avg_salary;
-- WITH 子查询可视为只存在一次的临时表(官方 7.8)
-- 部门平均只计算一次,外层引用
关键结论 :CTE 重写 让"算一次"的意图更显式、可读性更好------WITH 里的聚合先物化,主查询 JOIN 引用,与 JOIN 重写本质等价。
场景4:临时表重写 + 验证性能
表设计:同上;同时需要"部门平均"复用给多个查询
✅ 正确写法(临时表物化一次,多处复用)
sql
CREATE TEMP TABLE dept_avg AS
SELECT department_id, avg(salary) AS avg_salary
FROM employees
GROUP BY department_id;

SELECT e.name, e.salary
FROM employees e
JOIN dept_avg ON e.department_id = dept_avg.department_id
WHERE e.salary > dept_avg.avg_salary;
-- 聚合物理计算一次,同一会话内可被多个查询复用
✅ 验证(EXPLAIN 对比两种写法)
sql
-- 相关子查询版本:
EXPLAIN (ANALYZE, BUFFERS)
SELECT e.name, e.salary FROM employees e
WHERE e.salary > (SELECT avg(salary) FROM employees WHERE department_id = e.department_id);
-- Nested Loop + SubPlan(每行执行)→ Execution time 高

-- JOIN 重写版本:
EXPLAIN (ANALYZE, BUFFERS)
SELECT e.name, e.salary FROM employees e
JOIN (...) dept_avg ON ... WHERE e.salary > dept_avg.avg_salary;
-- Hash Join + HashAggregate(只算一次)→ Execution time 显著下降
关键结论 :临时表适合"算一次 + 多处复用" ;无论哪种重写,都用 EXPLAIN 验证------从 Nested Loop + SubPlan(每行执行) 变成 Hash Join + HashAggregate(只算一次),就是优化生效的铁证。
五、绝对禁止的写法汇总
- 大表上直接用相关子查询而不评估执行次数(外部 1000 万行 = 内部最多执行 1000 万次);
- 相关子查询能重写却图省事不重写(JOIN / CTE / 临时表三板斧成本极低);
- 把非相关子查询也当"逐行执行"过度优化(它只执行一次,不需要重写);
- 重写后不 EXPLAIN 验证 (
Nested Loop + SubPlan没变成Hash Join,说明重写没生效或计划没选对); - 用临时表却不清理 / 在连接池长会话里残留(同名冲突、数据过期);
- CTE 无脑物化(PG 12+ 有 MATERIALIZED / NOT MATERIALIZED 控制,仅引用一次的 CTE 默认可能内联,别一刀切)。
六、最终评审口诀(记住不踩坑)
相关子查询逐行跑,大表陪跑受不了;
临时表CTE或JOIN,一次计算快不少。
七、总结
- 两类子查询 :非相关(独立执行一次)vs 相关(依赖外部查询的当前行,子查询条件/计算基于外部行,官方 9.23:外层变量在每次求值中充当常量);
- 性能红线 :相关子查询可能因逐行执行产生性能问题,外部表很大时尤为严重;
- 优化三板斧 :临时表(物化一次、可复用)、CTE(官方 7.8:视为仅存在一次的临时表)、重写为 JOIN(先聚合一次再连接)------用户示例的 JOIN 重写是标准姿势;
- 验证 :EXPLAIN 对比------
Nested Loop + SubPlan(每行执行)→Hash Join + HashAggregate(只算一次),性能提升以执行计划为准。
标签:PostgreSQL 数据库 性能优化
参考来源
- PostgreSQL 官方文档 9.23 Subquery Expressions(子查询引用外层查询变量、每次求值充当常量)------ www.postgresql.org/docs/curren...
- PostgreSQL 官方文档 7.8 WITH Queries (Common Table Expressions)(CTE 可视为仅存在一次查询的临时表、MATERIALIZED / NOT MATERIALIZED)------ www.postgresql.org/docs/curren...
- PostgreSQL 官方文档 SELECT(WITH 子句:子查询在 FROM 中被引用多次时只计算一次)------ www.postgresql.org/docs/curren...