课程:B站大学
记录学习极客时间团队MySQL45讲,进阶数据分析和数据处理
MySQL主库和备库
- [grant 之后要跟着 flush privileges 吗?](#grant 之后要跟着 flush privileges 吗?)
-
- 一、用户是怎么存在的
- 二、权限范围:从大到小
- [三、grant 到底干了什么](#三、grant 到底干了什么)
-
- [1. 全局权限](#1. 全局权限)
- [2. 库权限](#2. 库权限)
- [3. 表 / 列权限](#3. 表 / 列权限)
- 四、关键结论
- [五、flush privileges 是干嘛的](#五、flush privileges 是干嘛的)
- 六、不规范操作对照
- 七、几个测试/运维容易踩的点
- 八、不推荐的写法
- 要不要使用分区表?
-
- 一、分区表是什么
- 二、引擎层行为:间隙锁只锁命中的分区
-
- [MyISAM 分区表:表锁也只锁分区](#MyISAM 分区表:表锁也只锁分区)
- 三、分区表和手工分表的区别
- 四、分区策略:打开表的问题
- [五、Server 层行为:共用同一个 MDL 锁](#五、Server 层行为:共用同一个 MDL 锁)
- 六、适合的场景
- 实践是检验真理的唯一标准
grant 之后要跟着 flush privileges 吗?
测试/DBA 常见误区:很多文档写"grant 完必须 flush privileges 才生效",其实大多数情况下并不需要。
一、用户是怎么存在的
sql
create user 'ua'@'%' identified by 'pa';MySQL 里 user + host 才是一个用户 ,ua@ip1 和 ua@ip2 是两个不同用户。
这条命令做了两件事:
- 磁盘:
mysql.user插入一行,权限字段全是N - 内存:数组
acl_users插入一个对象,access = 0
用户 ua 在 user 表里的状态:
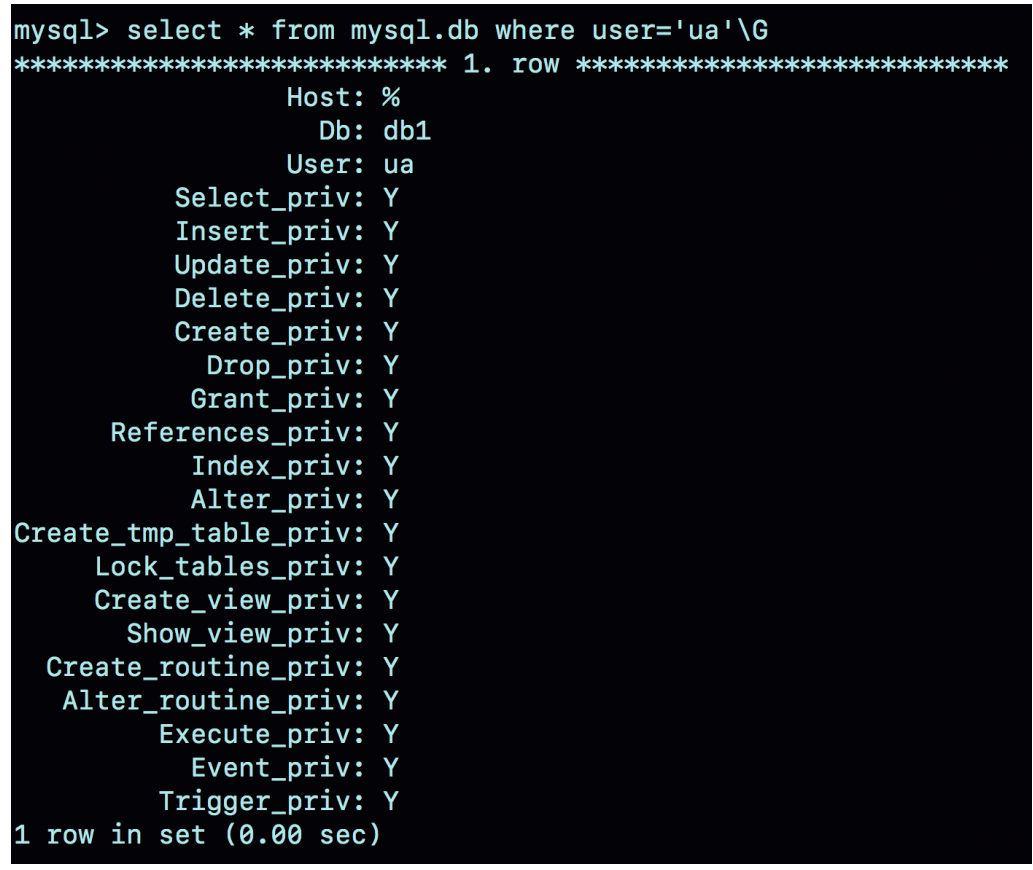
二、权限范围:从大到小
- 全局权限:
mysql.user/ 内存acl_users - 库权限:
mysql.db/ 内存acl_dbs - 表权限:
mysql.tables_priv - 列权限:
mysql.columns_priv - 表+列权限在内存里放在
column_priv_hash
三、grant 到底干了什么
1. 全局权限
sql
grant all privileges on *.* to 'ua'@'%' with grant option;- 磁盘:
mysql.user对应行权限字段改Y - 内存:
acl_users里该用户access改成全 1 - 新连接立即生效
- 已存在的连接:全局权限不受 grant/revoke 影响(权限拷贝在线程对象里了)
回收:
sql
revoke all privileges on *.* from 'ua'@'%';2. 库权限
sql
grant all privileges on db1.* to 'ua'@'%' with grant option;- 磁盘:
mysql.db插入/更新一行 - 内存:
acl_dbs更新 - 已存在连接也会马上受影响 (
acl_dbs是全局数组,每次判权限都查它)
特例:
如果会话已经 use db1,当前库的权限会缓存在会话里,revoke 后不切库还能继续操作该库。
3. 表 / 列权限
sql
grant all privileges on db1.t1 to 'ua'@'%' with grant option;
grant select (id), insert (id,a) on mydb.mytbl to 'ua'@'%';- 磁盘:
tables_priv/columns_priv改 - 内存:
column_priv_hash改 - 已存在连接同样马上生效
四、关键结论
grant / revoke 会同时改磁盘表 + 内存结构,权限判断用内存数据。
所以:规范用 grant/revoke 时,不需要 flush privileges。
五、flush privileges 是干嘛的
sql
flush privileges;作用:
- 清空内存里的权限数组
- 重新从
mysql.user/mysql.db/tables_priv/columns_priv读一遍 - 用磁盘数据重建内存权限
⚠️ 只有一种情况需要它:
内存和磁盘权限不一致了,比如你手贱直接 DML 改系统表:
sql
delete from mysql.user where user='ua';这时候:
- 磁盘没这用户了
- 内存还在
- 老连接 / 新连接还可能登进来
- grant 说找不到用户,create user 又说用户已存在
执行 flush privileges; 后,内存被磁盘修正,用户才真正失效。
六、不规范操作对照
| 操作 | 磁盘 | 内存 | 问题 |
|---|---|---|---|
grant/revoke |
改 | 改 | 正常 |
create/drop user |
改 | 改 | 正常 |
delete from mysql.user |
改 | 不改 | 状态不一致 |
update mysql.db set ... |
改 | 不改 | 状态不一致 |
正确删用户用
drop user 'ua'@'%';
七、几个测试/运维容易踩的点
- 改完
mysql.user不 flush,权限"像没生效又像生效" - 以为 grant 后不 flush 不生效 ------ 其实是文档误导
- 以为 revoke 全局权限能踢掉已登录连接 ------ 踢不掉,要杀线程
- 直接
delete用户,导致后续create user报 1396 - 列权限
select(col)和表权限不是一回事,鉴权粒度不同
八、不推荐的写法
sql
grant super on *.* to 'ua'@'%' identified by 'pa';这条会:
- 用户不存在就建用户
- 用户存在就改密码
一不小心把线上账号密码改了,别这么写。
要不要使用分区表?
一般实际业务不常用分区表不是因为分区表慢,而是它有两个绕不开的问题:第一次访问要打开所有分区文件 + 所有分区共用同一个 MDL 锁。
一、分区表是什么
建一张按年份 range 分区的表:
sql
CREATE TABLE `t` (
  `ftime` datetime NOT NULL,
  `c` int(11) DEFAULT NULL,
  KEY (`ftime`)
) ENGINE=InnoDB DEFAULT CHARSET=latin1
PARTITION BY RANGE (YEAR(ftime)) (
  PARTITION p_2017 VALUES LESS THAN (2017) ENGINE=InnoDB,
  PARTITION p_2018 VALUES LESS THAN (2018) ENGINE=InnoDB,
  PARTITION p_2019 VALUES LESS THAN (2019) ENGINE=InnoDB,
  PARTITION p_others VALUES LESS THAN MAXVALUE ENGINE=InnoDB
);

INSERT INTO t VALUES ('2017-4-1',1),('2018-4-1',1);
两行数据按规则分别落在 p_2018 和 p_2019。磁盘上这个表是 1 个 .frm + 4 个 .ibd,每个分区对应一个 .ibd 文件:
理解分区表最关键的两句话:
- 引擎层看:这是 4 张表(每个分区独立管理数据和索引)
- Server 层看:这是 1 张表
二、引擎层行为:间隙锁只锁命中的分区
在分区表上加间隙锁的实验:
| 时间 | session A | session B |
|---|---|---|
| T1 | begin; select * from t where ftime='2017-5-1' for update; | |
| T2 | insert into t values('2018-2-1',1); → Query OK insert into t values('2017-12-1',1); → blocked |
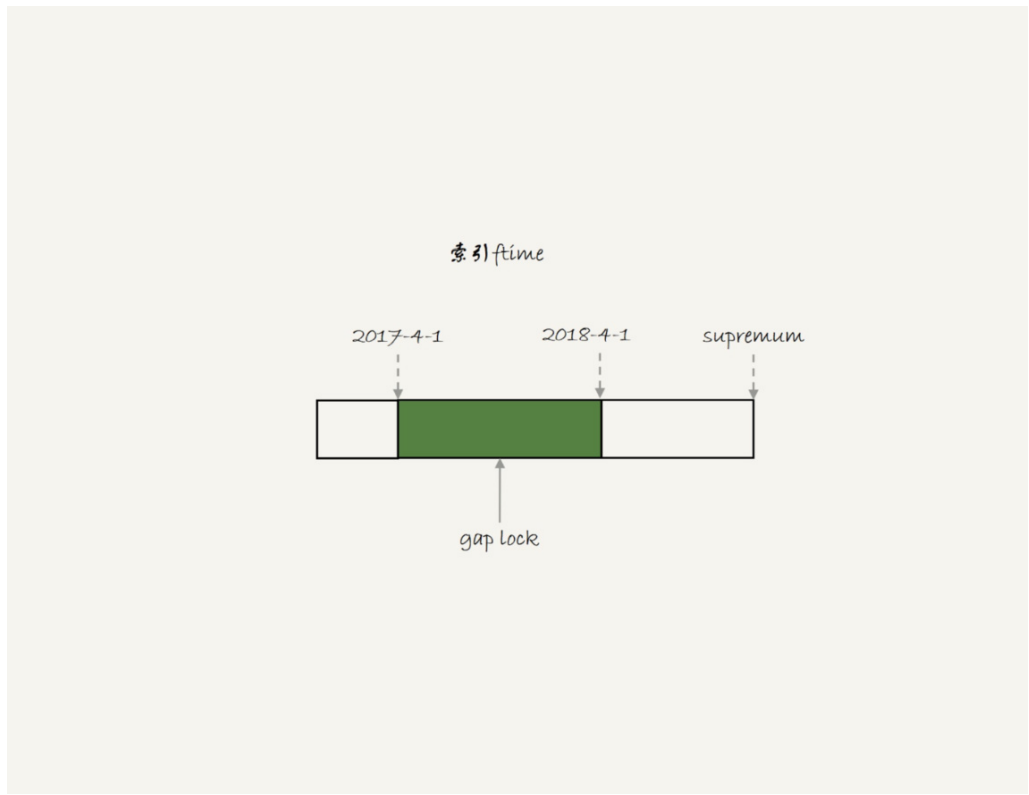
复习第 21 讲的加锁规则:表 t 只有 ftime='2017-4-1' 和 '2018-4-1' 两行。如果是普通表,T1 时刻 ftime 索引上的间隙与加锁状态应该是这样:
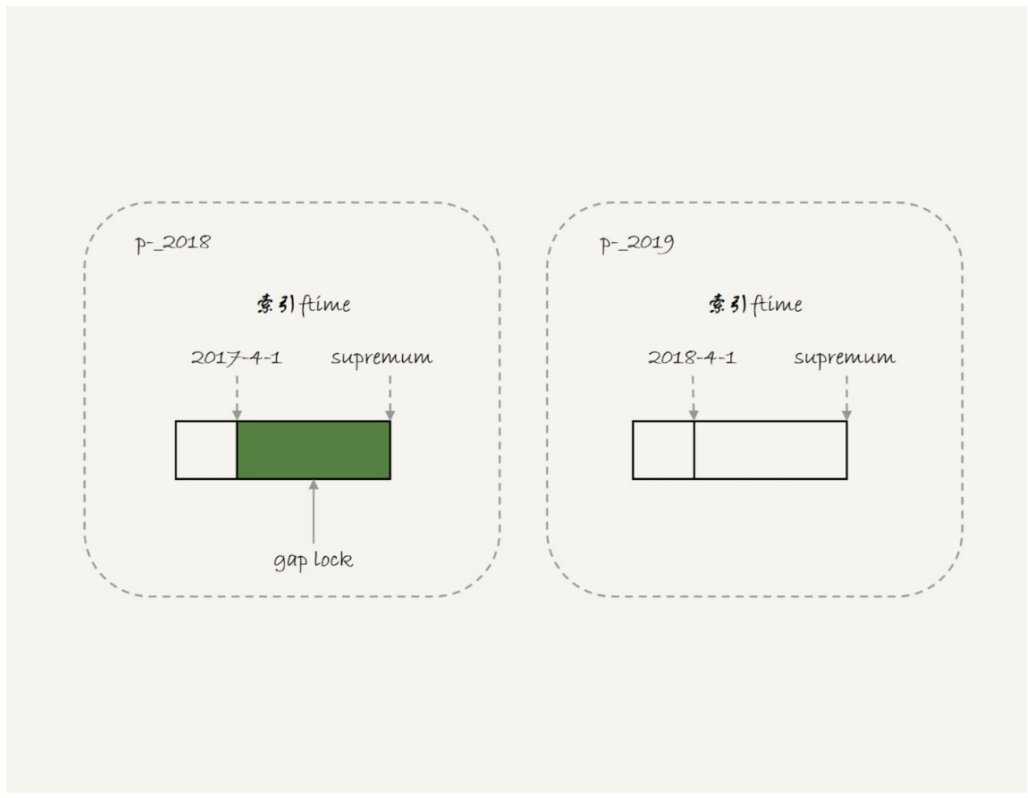
那么 session B 两条插入都该进锁等待。但实验里第一条 insert 成功了------因为对引擎来说 p_2018 和 p_2019 是两张不同的表,2017-4-1 的下一个记录不是 2018-4-1,而是 p_2018 分区的 supremum。实际加锁状态是(下图深绿色部分即真实锁范围):
select 只命中了 p_2018,加锁范围就是图中深绿色部分。所以写 2018-2-1 能成功,写 2017-12-1 要等间隙锁。show engine innodb status 印证只锁了对应分区:

MyISAM 分区表:表锁也只锁分区
sql
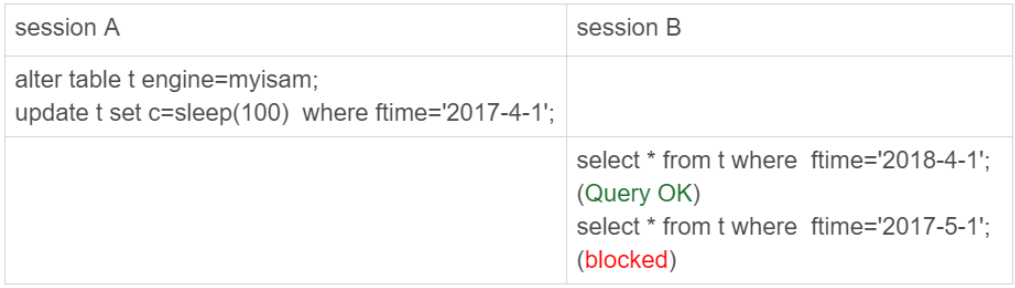
alter table t engine=myisam;MyISAM 只支持表锁,update 会锁住读。但实验结果是:命中其他分区的 select 可以正常执行,只有落在同一分区的查询才进入锁等待。
因为 MyISAM 的表锁是在引擎层实现的,加锁实际只加在分区 p_2018 上:
三、分区表和手工分表的区别
单表过大时的两条路:
| 分区表 | 手工分表 | |
|---|---|---|
| 决定访问哪个分片 | Server 层按规则算 | 应用层代码决定 |
| 引擎层 | 无差别 | 无差别 |
| 差别所在 | Server 层行为 | Server 层行为 |
性能上没有实质差别,区别全在 Server 层。
四、分区策略:打开表的问题
通用分区策略(generic partitioning):MyISAM 在用。每次访问分区都由 Server 层控制,第一次访问分区表时会把所有分区都打开一遍。
典型报错:分区超过 1000 个,open_files_limit 用默认 1024,访问时因打开文件数超上限而报错------哪怕这条 insert 明明只需要访问一个分区:

本地分区策略(native partitioning) :InnoDB 从 5.7.9 起引入,在引擎内部自己管理打开分区的行为,不会报这个错(靠 innodb_open_files 淘汰旧句柄)。
版本时间线:
- 5.7.9:InnoDB 引入本地分区策略
- 5.7.17:MyISAM 分区表标记为 deprecated
- 8.0:不允许创建 MyISAM 分区表,只允实现本地分区策略的引擎(目前只有 InnoDB 和 NDB)
五、Server 层行为:共用同一个 MDL 锁
从 Server 层看,一个分区表就是一张表。操作序列与执行结果:
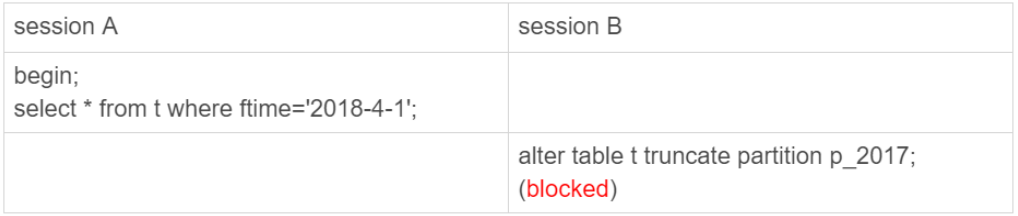
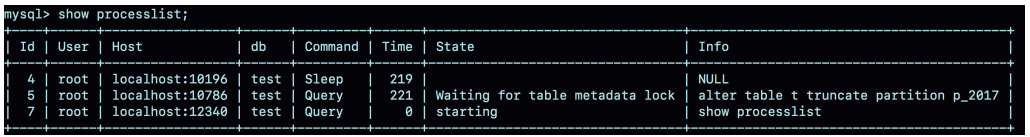
session B 只需操作 p_2017,但因为 session A 持有整表 t 的 MDL 锁,alter 被堵住。这就是 DBA 说的"分区表做 DDL 影响面更大"------换成手工分表 truncate 一个分表,绝不会跟另一个分表上的查询出现 MDL 冲突。
小结:
- 第一次打开分区表,需要访问所有分区
- Server 层认为这是同一张表 → 所有分区共用同一个 MDL 锁
- 引擎层认为这是不同的表 → MDL 锁之后按规则只访问必要的分区
"必要的分区"由 where 条件 + 分区规则决定:
| where 条件 | 访问的分区 |
|---|---|
where ftime='2018-4-1' |
只访问 p_2019 |
where ftime>='2018-4-1' |
访问 p_2019 + p_others |
| 不带分区键 | 全分区扫描 |
不带分区键要全扫,不是分区表的锅------手工分表没带分表 key 照样全部分表都要访问。
六、适合的场景
- 对业务透明:不用在代码里拼表名,业务代码比手工分表简洁
- 清理历史数据方便 :
ALTER TABLE t DROP PARTITION p_2017直接删分区文件,效果等同 drop 普通表,比 DELETE 快、对系统影响小